


Le suivi des requêtes d'exploration et le panneau Performances de l'exploration fournissent des données de performances détaillées pour une requête d'exploration. Ces données peuvent vous aider à identifier les points d'entrée clés pour résoudre les problèmes de performances des requêtes et vous fournir des recommandations d'amélioration.
Suivi des requêtes d'exploration
Le suivi des requêtes d'exploration affiche la progression d'une requête d'exploration au cours des trois phases de la requête pendant son exécution.
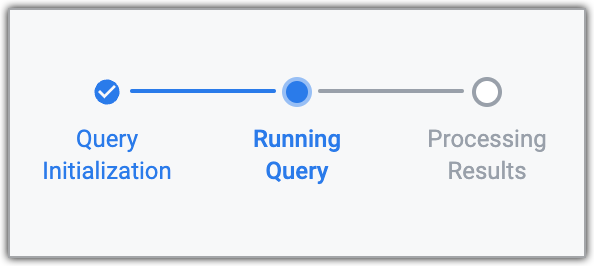
Si l'exécution d'une requête prend beaucoup de temps, le suivi des requêtes peut indiquer quelle phase de la requête est à l'origine du problème de performances. Cela permet d'identifier les endroits où des problèmes de performances peuvent se produire et où les efforts d'optimisation peuvent être les plus efficaces.
Le suivi de requête s'affiche lorsqu'une exploration est en cours d'exécution, tant que le panneau Visualisation ou Données de l'exploration est ouvert.
Explorer le panneau Performances
Pour afficher le panneau Performances d'une exploration, cliquez sur le lien Voir les détails des performances, disponible pour toutes les requêtes d'exploration exécutées.
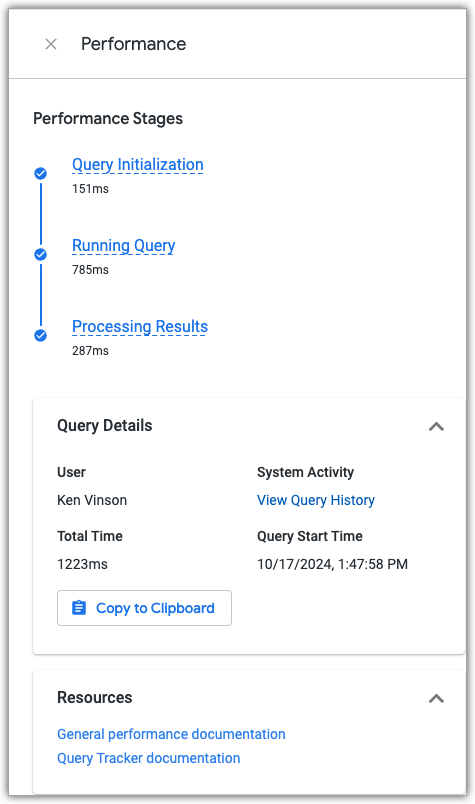
Le panneau Performance indique le temps que la requête a passé dans chacune des trois phases de requête et inclut des liens vers la documentation sur les performances et le tableau de bord des activités du système Historique des requêtes, qui affiche les données de performances actuelles et l'historique des performances de la requête et de l'exploration utilisée pour créer la requête.
Phases de la requête
Lorsqu'une exploration Looker exécute une requête de base de données, celle-ci est exécutée en trois phases :
- La phase d'initialisation de la requête
- Phase d'exécution de la requête
- Phase de traitement des résultats
Phase d'initialisation de la requête
Pendant la phase d'initialisation de la requête, Looker effectue toutes les tâches requises avant l'envoi de la requête à votre base de données. La phase d'initialisation de la requête comprend les tâches suivantes :
- Compiler le modèle LookML
- Vérifier si des tables dérivées persistantes (PDT) doivent être créées
- Générer la requête SQL
- Acquérir la connexion à la base de données
La page de documentation Comprendre les métriques de performances des requêtes explique comment utiliser l'exploration Métriques de performances des requêtes dans Activité du système pour afficher des répartitions détaillées d'une requête. La phase d'initialisation de la requête de l'outil de suivi des requêtes inclut les événements décrits dans la phase de l'outil de travail asynchrone, la phase d'initialisation et la phase de gestion de la connexion de l'exploration Métriques de performances des requêtes.
Si vous rencontrez des problèmes de performances ou des requêtes qui prennent beaucoup de temps pendant la phase d'initialisation de la requête, procédez comme suit :
- Échelonnez les envois planifiés : lorsque de nombreux Looks ou tableaux de bord planifiés se déclenchent simultanément (en particulier au début de l'heure), l'afflux soudain de requêtes simultanées peut surcharger les ressources de l'instance et saturer les pools de connexions. Ce goulot d'étranglement de simultanéité entraîne l'attente ou l'exécution indéfinie des requêtes lors de l'initialisation. Échelonnez vos contenus programmés à des intervalles de 15 ou 30 minutes (par exemple, à
:15,:30ou:45) plutôt que de les programmer tous à:00. Pour en savoir plus, consultez Optimiser les performances du serveur Looker. - Utilisez des groupes de données pour les planifications : dans la mesure du possible, déclenchez les envois planifiés à l'aide de groupes de données qui s'alignent sur votre cycle ETL plutôt qu'à l'aide de déclencheurs temporels. L'utilisation de groupes de données permet de répartir l'exécution des requêtes et d'éviter l'exécution de requêtes redondantes sur des données non actualisées.
- Traitez par lot et limitez les appels d'API : si des scripts automatisés ou des outils externes déclenchent des requêtes ou des rapports via l'API Looker, traitez les requêtes par lot ou introduisez des délais pour éviter de surcharger les files d'attente d'initialisation des requêtes.
- Effacer les processus bloqués : si un pic de simultanéité soudain entraîne le blocage des requêtes et l'absence de réponse de votre instance, redémarrez l'instance pour effacer les tâches en cours et réinitialiser les files d'attente internes.
Phase d'exécution de la requête
La phase Exécution de la requête correspond au moment où Looker contacte et interroge votre base de données, puis renvoie les résultats de la requête. Les problèmes de performances au cours de cette phase peuvent indiquer un problème avec la base de données externe, comme des PDT qui prennent beaucoup de temps à se reconstruire et qui peuvent nécessiter une optimisation, ou des tables de base de données externes qui peuvent nécessiter une optimisation. La phase Exécution de la requête comprend les tâches suivantes :
- Création de toutes les PDT dans la base de données requises pour la requête d'exploration
- Exécution de la requête demandée sur la base de données
La page de documentation Comprendre les métriques de performances des requêtes explique comment utiliser l'exploration Métriques de performances des requêtes dans Activité du système pour afficher des répartitions détaillées d'une requête. La phase Exécution de la requête de l'outil de suivi des requêtes inclut les événements décrits dans la phase des requêtes principales de l'exploration Métriques de performances des requêtes.
Si vous rencontrez des problèmes de performances au cours de cette phase, vous pouvez prendre les mesures suivantes :
- Créez des explorations à l'aide de jointures
many_to_onedans la mesure du possible. Joindre des vues du niveau le plus précis au niveau de détail le plus élevé (many_to_one) offre généralement les meilleures performances de requête. - Maximisez la mise en cache pour vous synchroniser avec vos règles ETL, dans la mesure du possible, afin de réduire le trafic des requêtes de base de données. Par défaut, Looker met en cache les requêtes pendant une heure. Vous pouvez contrôler la règle de mise en cache et synchroniser les actualisations des données Looker avec votre processus ETL en appliquant des groupes de données dans les explorations à l'aide du paramètre
persist_with. Maximiser la mise en cache permet à Looker de s'intégrer plus étroitement au pipeline de données backend afin que l'utilisation du cache puisse être maximisée, sans risque d'analyser des données obsolètes. Les règles de mise en cache nommées peuvent être appliquées à un modèle entier ou à des explorations individuelles et à des tables dérivées persistantes (PDT). - Utilisez la fonctionnalité de reconnaissance d'agrégats de Looker pour créer des tables de cumul ou de synthèse que Looker peut utiliser pour les requêtes chaque fois que cela est possible, en particulier pour les requêtes courantes sur de grandes bases de données. Vous pouvez également utiliser la reconnaissance d'agrégats pour améliorer considérablement les performances de tableaux de bord entiers. Pour en savoir plus, consultez le tutoriel sur la reconnaissance d'agrégats.
- Utilisez des PDT pour accélérer les requêtes. Convertissez les explorations comportant de nombreuses jointures complexes ou peu performantes, ou les dimensions comportant des sous-requêtes ou des sous-sélections, en PDT afin que les vues soient pré-jointes et prêtes avant l'exécution.
- Si votre dialecte de base de données accepte les PDT incrémentales, configurez des PDT incrémentales pour réduire le temps que Looker passe à régénérer les tables PDT.
- Évitez de joindre des vues dans des explorations sur des clés primaires concaténées définies dans Looker. À la place, effectuez la jointure sur les champs de base qui composent la clé primaire concaténée de la vue. Vous pouvez également recréer la vue en tant que PDT avec la clé primaire concaténée prédéfinie dans la définition SQL de la table, plutôt que dans le LookML d'une vue.
- Utilisez l'outil Expliquer dans l'exécuteur SQL pour l'analyse comparative.
EXPLAINgénère un aperçu du plan d'exécution de votre base de données pour une requête SQL donnée, ce qui vous permet de détecter les composants de requête pouvant être optimisés. Pour en savoir plus, consultez le post de la communauté How to optimize SQL withEXPLAIN(Comment optimiser SQL avec ). - Déclarer des index Vous pouvez consulter les index de chaque table directement dans Looker à partir de l'exécuteur SQL en cliquant sur l'icône en forme de roue dentée dans une table, puis en sélectionnant Afficher les index.
Les colonnes les plus courantes pouvant bénéficier d'index sont les dates importantes et les clés étrangères. L'ajout d'index à ces colonnes améliorera les performances de presque toutes les requêtes. Cela s'applique également aux tables PDT. Les paramètres LookML, tels que
indexes,sort keysetdistribution, peuvent être appliqués de manière appropriée.
Phase de traitement des résultats
Pendant la phase Processing Results (Traitement des résultats), Looker traite et affiche les résultats de la requête. La phase Traitement des résultats comprend les tâches suivantes :
- Diffuser en continu les résultats de requête dans le cache
- Résoudre les calculs de table
- Mise en forme des résultats du langage de création de modèles Liquid
- Fusionner des requêtes
- Calculer les totaux et les sous-totaux
La page de documentation Comprendre les métriques de performances des requêtes explique comment utiliser l'exploration Métriques de performances des requêtes dans Activité du système pour afficher des répartitions détaillées d'une requête. La phase Processing Results (Traitement des résultats) de l'outil de suivi des requêtes inclut les événements décrits dans la phase post-requête de l'exploration Query Performance Metrics (Métriques de performances des requêtes).
Voici quelques mesures à prendre si vous rencontrez des problèmes de performances au cours de cette phase :
- Utilisez les fonctionnalités telles que Fusionner les résultats, Champs personnalisés et Calculs de table avec parcimonie. Ces fonctionnalités sont destinées à être utilisées comme démonstrations de faisabilité pour vous aider à concevoir votre modèle. Il est recommandé de coder en dur les calculs et les fonctions fréquemment utilisés dans LookML, qui générera du code SQL à traiter dans votre base de données. Un nombre excessif de calculs peut entraîner une concurrence pour la mémoire Java sur l'instance Looker, ce qui ralentit la réponse de l'instance Looker.
- Limitez le nombre de vues que vous incluez dans un modèle lorsqu'un grand nombre de fichiers de vue sont présents. L'inclusion de toutes les vues dans un seul modèle peut ralentir les performances. Lorsqu'un projet contient un grand nombre de vues, envisagez de n'inclure que les fichiers de vue nécessaires dans chaque modèle. Envisagez d'utiliser des conventions de dénomination stratégiques pour les noms de fichiers de vue afin de permettre l'inclusion de groupes de vues dans un modèle. Un exemple est présenté dans la documentation du paramètre
includes. - Évitez de renvoyer un grand nombre de points de données par défaut dans les vignettes de tableau de bord et les Looks. Les requêtes qui renvoient des milliers de points de données consomment plus de mémoire. Assurez-vous que les données sont limitées autant que possible en appliquant des
filtres d'interface aux tableaux de bord, aux Looks et aux explorations, ainsi qu'au niveau LookML avec les paramètres
required filters,conditionally_filteretsql_always_where. - Téléchargez ou envoyez des requêtes en utilisant l'option Tous les résultats avec parcimonie, car certaines requêtes peuvent être très volumineuses et surcharger le serveur Looker lors de leur traitement.