


איך יוצרים טבלאות ומשתמשים בהן
טבלאות רגילות מאפשרות לאחסן נתונים ב-BigQuery, לשלוח שאילתות לגביהם, לקבוע מי יכול לגשת אליהם ולבצע ביקורת על ההיסטוריה שלהם. במאמר הזה מוסבר איך ליצור טבלאות רגילות (מובנות), לשלוט בגישה אליהן ולקבל מידע עליהן, כמו המטא-נתונים של הטבלה והטבלאות במערך נתונים.
כדי ליצור סוגים אחרים של טבלאות, קראו את המאמרים יצירת טבלאות מחולקות למחיצות ויצירת טבלאות מסודרות באשכולות. כדי לעדכן את מאפייני הטבלה, להעתיק טבלאות או למחוק טבלאות, עיינו במאמר ניהול טבלאות.
לפני שמתחילים
להקצות תפקידים של ניהול זהויות והרשאות גישה (IAM) שנותנים למשתמשים את ההרשאות הנדרשות כדי לבצע כל משימה שמופיעה במסמך הזה.
התפקידים הנדרשים
כדי לקבל את ההרשאות שדרושות ליצירת טבלה, בקשו מהאדמין להקצות לכם את תפקידי ה-IAM הבאים:
- משתמש במשימות ב-BigQuery (
roles/bigquery.jobUser) בפרויקט, אם יוצרים טבלה על ידי טעינת נתונים או שמירת שאילתות שמורות בטבלה. - BigQuery Data Editor (
roles/bigquery.dataEditor) במערך הנתונים שבו יוצרים את הטבלה.
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקידים המוגדרים מראש האלה כוללים את ההרשאות שנדרשות ליצירת טבלה. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי ליצור טבלה, צריך את ההרשאות הבאות:
-
bigquery.tables.createבמערך הנתונים שבו יוצרים את הטבלה. -
bigquery.tables.getDataבכל הטבלאות והתצוגות שהשאילתה מפנה אליהן, אם שומרים את תוצאות השאילתה כטבלה. -
bigquery.jobs.createבפרויקט, אם יוצרים את הטבלה על ידי טעינת נתונים או על ידי שמירת שאילתה שמורה בטבלה. -
bigquery.tables.updateDataבטבלה אם מוסיפים לטבלה או מחליפים אותה בתוצאות של שאילתה.
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
מתן שמות לטבלאות
כשיוצרים טבלה ב-BigQuery, שם הטבלה צריך להיות ייחודי לכל מערך נתונים. שם הטבלה יכול:
- להכיל תווים באורך כולל של עד 1,024 בייטים בקידוד UTF-8.
- להכיל תווי Unicode בקטגוריות הבאות: L (אות), M (סימון), N (מספר), Pc (סימן חיבור, כולל קו תחתון), Pd (קו מפריד), Zs (רווח). מידע נוסף זמין במאמר קטגוריה כללית.
השמות הבאים הם דוגמאות לשמות תקינים של טבלאות:
table 01, ग्राहक, 00_お客様, étudiant-01.
נקודות שצריך לשים לב אליהן:
- כברירת מחדל, שמות של טבלאות הם תלויי אותיות רישיות.
mytableו-MyTableיכולים להתקיים יחד באותה קבוצת נתונים, אלא אם הם חלק מקבוצת נתונים שבה מושבתת האפשרות "תלוי אותיות רישיות". - חלק מהשמות של הטבלאות והתחיליות של שמות הטבלאות שמורים. אם מופיעה הודעת שגיאה שלפיה שם הטבלה או הקידומת שמורים, צריך לבחור שם אחר ולנסות שוב.
אם תכללו כמה אופרטורים של נקודה (
.) ברצף, האופרטורים הכפולים יוסרו באופן משתמע.לדוגמה:
project_name....dataset_name..table_nameהופך לזה:
project_name.dataset_name.table_name
יצירת טבלאות
אפשר ליצור טבלה ב-BigQuery בדרכים הבאות:
- באופן ידני באמצעות מסוף Google Cloud או הפקודה
bq mkשל כלי שורת הפקודה של BigQuery. - באופן פרוגרמטי, על ידי קריאה ל-method
tables.insertב-API. - באמצעות ספריות הלקוח.
- מתוצאות השאילתה.
- מגדירים טבלה שמפנה למקור נתונים חיצוני.
- כשאתם טוענים נתונים.
- באמצעות הצהרה של
CREATE TABLEשפת הגדרת נתונים (DDL).
יצירת טבלה ריקה עם הגדרת סכימה
אפשר ליצור טבלה ריקה עם הגדרת סכימה בדרכים הבאות:
- מזינים את הסכימה באמצעות מסוף Google Cloud .
- לספק את הסכימה בתוך השורה באמצעות כלי שורת הפקודה של BigQuery.
- שליחת קובץ סכימה בפורמט JSON באמצעות כלי שורת הפקודה של BigQuery.
- לספק את הסכימה במשאב טבלה כשקוראים ל-method
tables.insertשל ה-API.
למידע נוסף על הגדרת סכימת טבלה, ראו הגדרת סכימה.
אחרי שיוצרים את הטבלה, אפשר לטעון אליה נתונים או לאכלס אותה על ידי כתיבת תוצאות של שאילתות.
כדי ליצור טבלה ריקה עם הגדרת סכימה:
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
- בקטע Source, בוחרים באפשרות Empty table ברשימה Create table from.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, מזינים את הגדרת הסכימה.
אפשר להזין את פרטי הסכימה באופן ידני באחת מהשיטות הבאות:
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
bq show --format=prettyjson dataset.table
- אפשרות 2: לוחצים על Add field ומזינים את סכימת הטבלה. מציינים את הערכים של השדות Name, Type ו-Mode.
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן.
- אופציונלי: בקטע Advanced options, אם רוצים להשתמש במפתח הצפנה בניהול הלקוח, בוחרים באפשרות Use a customer-managed encryption key (CMEK). כברירת מחדל, BigQuery מצפין תוכן של לקוחות שמאוחסן במצב מנוחה באמצעות Google-owned and Google-managed encryption key.
- לוחצים על Create table.
SQL
בדוגמה הבאה נוצרת טבלה בשם newtable שתוקפה יפוג ב-1 בינואר 2023:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE TABLE mydataset.newtable (
  x INT64 OPTIONS (description = 'An optional INTEGER field'),
  y STRUCT <
    a ARRAY <STRING> OPTIONS (description = 'A repeated STRING field'),
    b BOOL
  >
) OPTIONS (
    expiration_timestamp = TIMESTAMP '2023-01-01 00:00:00 UTC',
    description = 'a table that expires in 2023',
    labels = [('org_unit', 'development')]);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
-
מפעילים את Cloud Shell במסוף Google Cloud .
בחלק התחתון של מסוף Google Cloud יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
משתמשים בפקודה
bq mkעם הדגל--tableאו-t. אתם יכולים לספק את פרטי הסכימה של הטבלה בתוך השורה או באמצעות קובץ סכימה בפורמט JSON. רשימה מלאה של הפרמטרים מופיעה בחומרי העזר שלbq mk --table. הנה כמה פרמטרים אופציונליים:--expiration--description--time_partitioning_field--time_partitioning_type--range_partitioning--clustering_fields--destination_kms_key--label
--time_partitioning_field,--time_partitioning_type,--range_partitioning,--clustering_fieldsו---destination_kms_keyלא מודגמים כאן. בקישורים הבאים תוכלו לקרוא מידע נוסף על הפרמטרים האופציונליים האלה:- מידע נוסף על
--time_partitioning_field,--time_partitioning_typeו---range_partitioningזמין במאמר טבלאות מחולקות למחיצות. - מידע נוסף על
--clustering_fieldsזמין במאמר טבלה מסודרת באשכולות. - מידע נוסף על
--destination_kms_keyזמין במאמר מפתחות הצפנה בניהול הלקוח.
אם אתם יוצרים טבלה בפרויקט שהוא לא פרויקט ברירת המחדל, הוסיפו את מזהה הפרויקט למערך הנתונים בפורמט הבא:
PROJECT_ID:DATASET.כדי ליצור טבלה ריקה במערך נתונים קיים עם הגדרת סכימה, מזינים את הפקודה הבאה:
bq mk \
--table \
--expiration=INTEGER \
--description=DESCRIPTION \
--label=KEY_1:VALUE_1 \
--label=KEY_2:VALUE_2 \
--add_tags=KEY_3:VALUE_3[,...] \
PROJECT_ID:DATASET.TABLE \
SCHEMA
מחליפים את מה שכתוב בשדות הבאים:
-
INTEGERהוא משך החיים שמוגדר כברירת מחדל (בשניות) לטבלה. הערך המינימלי הוא 3,600 שניות (שעה אחת). זמן התפוגה מחושב לפי הזמן הנוכחי ב-UTC בתוספת הערך של המספר השלם. אם מגדירים את זמן התפוגה כשיוצרים טבלה, המערכת מתעלמת מהגדרת ברירת המחדל של זמן התפוגה של הטבלה במערך הנתונים. -
DESCRIPTIONהוא תיאור של הטבלה במירכאות. -
KEY_1:VALUE_1ו-KEY_2:VALUE_2הם צמדי מפתח/ערך שמציינים תוויות. -
KEY_3:VALUE_3הם צמדי מפתח/ערך שמציינים תגים. אפשר להוסיף כמה תגים באותו דגל עם פסיקים בין צמדי מפתח:ערך. -
PROJECT_IDהוא מזהה הפרויקט. -
DATASETהוא מערך נתונים בפרויקט. -
TABLEהוא שם הטבלה שאתם יוצרים. -
SCHEMAהוא הגדרת סכימה בתוך השורה בפורמטFIELD:DATA_TYPE,FIELD:DATA_TYPEאו הנתיב לקובץ הסכימה בפורמט JSON במחשב המקומי.
כשמציינים את הסכימה בשורת הפקודה, אי אפשר לכלול סוג
RECORD(STRUCT), אי אפשר לכלול תיאור עמודה ואי אפשר לציין את מצב העמודה. ברירת המחדל של כל המצבים היאNULLABLE. כדי לכלול תיאורים, מצבים וסוגיRECORD, צריך לספק קובץ סכימה של JSON.דוגמאות:
מזינים את הפקודה הבאה כדי ליצור טבלה באמצעות הגדרת סכימה מוטבעת. הפקודה הזו יוצרת טבלה בשם
mytableב-mydatasetבפרויקט שמוגדר כברירת מחדל. תפוגת הטבלה מוגדרת ל-3,600 שניות (שעה אחת), התיאור מוגדר ל-This is my tableוהתווית מוגדרת ל-organization:development. בפקודה הזו משתמשים במקש הקיצור-tבמקום--table. הסכימה מצוינת בתוך השורה בתור:qtr:STRING,sales:FLOAT,year:STRING.bq mk \ -t \ --expiration 3600 \ --description "This is my table" \ --label organization:development \ mydataset.mytable \ qtr:STRING,sales:FLOAT,year:STRING
מזינים את הפקודה הבאה כדי ליצור טבלה באמצעות קובץ סכימת JSON. הפקודה הזו יוצרת טבלה בשם
mytableב-mydatasetבפרויקט שמוגדר כברירת מחדל. תפוגת הטבלה מוגדרת ל-3,600 שניות (שעה), התיאור מוגדר ל-This is my tableוהתווית מוגדרת ל-organization:development. הנתיב לקובץ הסכימה הוא/tmp/myschema.json.bq mk \ --table \ --expiration 3600 \ --description "This is my table" \ --label organization:development \ mydataset.mytable \ /tmp/myschema.json
מזינים את הפקודה הבאה כדי ליצור טבלה באמצעות קובץ סכימת JSON. הפקודה הזו יוצרת טבלה בשם
mytableב-mydatasetב-myotherproject. תפוגת הטבלה מוגדרת ל-3,600 שניות (שעה), התיאור מוגדר ל-This is my tableוהתווית מוגדרת ל-organization:development. הנתיב לקובץ הסכימה הוא/tmp/myschema.json.bq mk \ --table \ --expiration 3600 \ --description "This is my table" \ --label organization:development \ myotherproject:mydataset.mytable \ /tmp/myschema.json
אחרי שיוצרים את הטבלה, אפשר לעדכן את תאריך התפוגה, התיאור והתוויות שלה. אפשר גם לשנות את הגדרת הסכימה.
Terraform
משתמשים במשאב google_bigquery_table.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
יצירת טבלה
בדוגמה הבאה נוצרת טבלה בשם mytable:
יצירת טבלה והענקת גישה אליה
בדוגמה הבאה נוצרת טבלה בשם mytable, ואז נעשה שימוש במשאב google_bigquery_table_iam_policy כדי לתת גישה אליה. בצעו את השלב הזה רק אם אתם רוצים לתת גישה לטבלה לחשבונות משתמשים שאין להם גישה למערך הנתונים שבו נמצאת הטבלה.
יצירת טבלה עם מפתח הצפנה בניהול הלקוח
בדוגמה הבאה נוצרת טבלה בשם mytable, ונעשה שימוש במשאבים google_kms_crypto_key ו-google_kms_key_ring כדי לציין מפתח Cloud Key Management Service לטבלה. לפני שמריצים את הדוגמה הזו, צריך להפעיל את Cloud Key Management Service API.
כך מחילים את ההגדרות של Terraform בפרויקט ב- Google Cloud :
הכנת Cloud Shell
- מפעילים את Cloud Shell.
-
מגדירים את פרויקט ברירת המחדל ב- Google Cloud שבו רוצים להחיל את ההגדרות של Terraform.
תצטרכו להריץ את הפקודה הזו רק פעם אחת לכל פרויקט, ותוכלו לעשות זאת בכל ספרייה.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
אם תגדירו ערכים ספציפיים בקובץ התצורה של Terraform, הם יבטלו את ערכי ברירת המחדל של משתני הסביבה.
הכנת הספרייה
לכל קובץ תצורה של Terraform צריכה להיות ספרייה משלו (שנקראת גם מודול ברמה הבסיסית).
-
יוצרים ספרייה חדשה ב-Cloud Shell ובה יוצרים קובץ חדש. שם הקובץ חייב לכלול את הסיומת
.tf, למשלmain.tf. במדריך הזה, הקובץ נקראmain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
אם אתם עוקבים אחרי המדריך, תוכלו להעתיק את הקוד לדוגמה בכל קטע או שלב.
מעתיקים את הקוד לדוגמה בקובץ
main.tfהחדש שיצרתם.לחלופין, אפשר גם להעתיק את הקוד מ-GitHub. כדאי לעשות את זה כשקטע הקוד של Terraform הוא חלק מפתרון מקצה לקצה.
- בודקים את הפרמטרים לדוגמה ומשנים אותם בהתאם לסביבה שלכם.
- שומרים את השינויים.
-
מפעילים את Terraform. צריך לעשות זאת רק פעם אחת לכל ספרייה.
terraform init
אופציונלי: תוכלו לכלול את האפשרות
-upgrade, כדי להשתמש בגרסה העדכנית ביותר של הספק של Google:terraform init -upgrade
החלה של השינויים
-
בודקים את ההגדרות ומוודאים שהמשאבים שמערכת Terraform תיצור או תעדכן תואמים לציפיות שלכם:
terraform plan
מתקנים את ההגדרות לפי הצורך.
-
מריצים את הפקודה הבאה ומזינים
yesבהודעה שמופיעה, כדי להחיל את הגדרות Terraform:terraform apply
ממתינים עד שב-Terraform תוצג ההודעה "Apply complete!".
- פותחים את הפרויקט ב- Google Cloud כדי להציג את התוצאות. במסוף Google Cloud , נכנסים למשאבים בממשק המשתמש כדי לוודא שהם נוצרו או עודכנו ב-Terraform.
API
מפעילים את ה-method tables.insert עם משאב טבלה מוגדר.
C#
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של C# במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery C# API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Ruby
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Ruby במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
יצירת טבלה ריקה בלי הגדרת סכימה
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
יצירת טבלה מתוצאת שאילתה
כדי ליצור טבלה מתוצאת שאילתה, כותבים את התוצאות בטבלת יעד.
המסוף
פותחים את הדף BigQuery במסוף Google Cloud .
בחלונית השמאלית, לוחצים על Explorer:
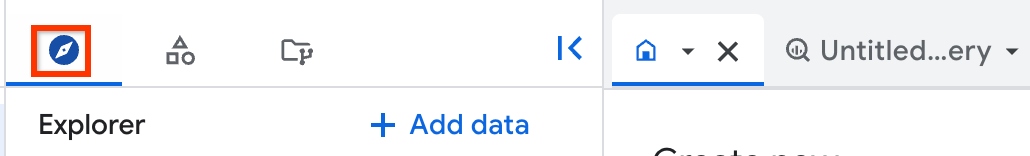
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים קבוצת נתונים.
בעורך השאילתות, מזינים שאילתת SQL תקינה.
לוחצים על עריכה > הגדרות השאילתה.
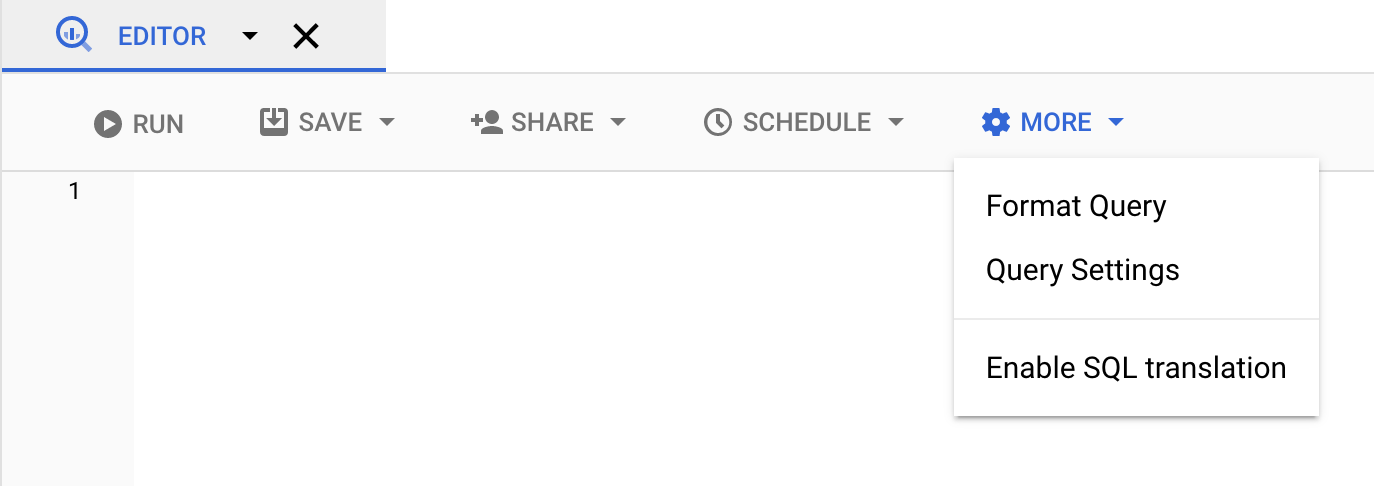
בוחרים באפשרות Set a destination table for query results.
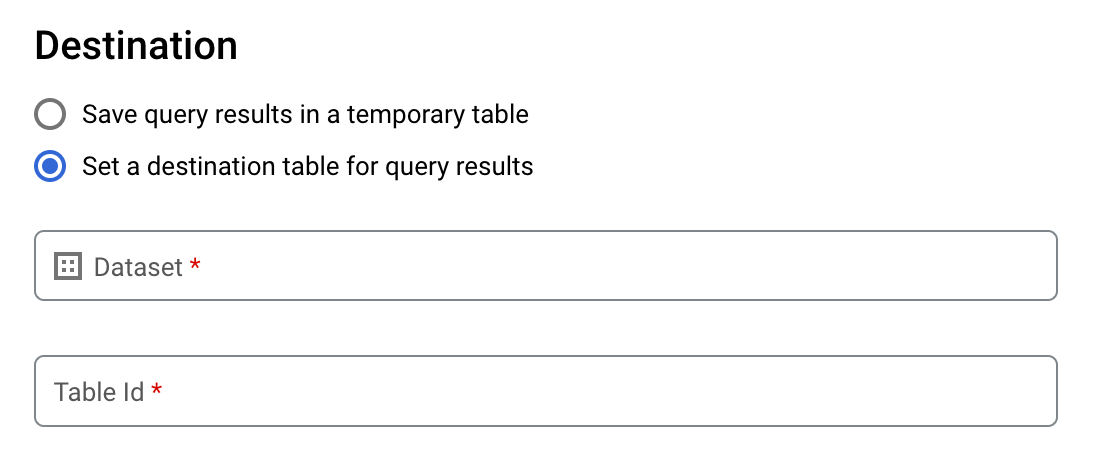
בקטע Destination, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה, ואז בוחרים מזהה טבלה.
בקטע Destination table write preference, בוחרים אחת מהאפשרויות הבאות:
- Write if empty – כתיבת תוצאות השאילתה בטבלה רק אם הטבלה ריקה.
- Append to table – הוספת תוצאות השאילתה לטבלה קיימת.
- Overwrite table – החלפת טבלה קיימת עם אותו שם בתוצאות השאילתה.
אופציונלי: בשדה Data location, בוחרים את המיקום.
כדי לעדכן את הגדרות השאילתה, לוחצים על שמירה.
לוחצים על Run. כך נוצרת משימת שאילתה שכותבת את תוצאות השאילתה בטבלה שציינתם.
לחלופין, אם שכחתם לציין טבלת יעד לפני הרצת השאילתה, תוכלו להעתיק את טבלת התוצאות שנשמרו במטמון לטבלה קבועה על ידי לחיצה על הלחצן Save Results שמעל לעורך.
SQL
בדוגמה הבאה משתמשים בהצהרת CREATE TABLE כדי ליצור את הטבלה trips מהנתונים בטבלה הציבורית bikeshare_trips:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
CREATE TABLE mydataset.trips AS (
  SELECT
    bike_id,
    start_time,
    duration_minutes
  FROM
    bigquery-public-data.austin_bikeshare.bikeshare_trips
);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
למידע נוסף, קראו את המאמר יצירת טבלה חדשה מטבלה קיימת.
BQ
-
מפעילים את Cloud Shell במסוף Google Cloud .
בחלק התחתון של מסוף Google Cloud יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
מזינים את הפקודה
bq queryומציינים את הדגל--destination_tableכדי ליצור טבלה קבועה על סמך תוצאות השאילתה. מציינים את הדגלuse_legacy_sql=falseכדי להשתמש בתחביר GoogleSQL. כדי לכתוב את תוצאות השאילתה בטבלה שלא נמצאת בפרויקט ברירת המחדל, צריך להוסיף את מזהה הפרויקט לשם של קבוצת הנתונים בפורמט הבא:project_id:dataset.אופציונלי: מוסיפים את הדגל
--locationומגדירים את הערך למיקום שלכם.כדי לשלוט בהגדרת הכתיבה של טבלת יעד קיימת, מציינים אחד מהדגלים האופציונליים הבאים:
-
--append_table: אם טבלת היעד קיימת, תוצאות השאילתה מצורפות אליה. --replace: אם טבלת היעד קיימת, היא מוחלפת בתוצאות השאילתה.bq --location=location query \ --destination_table project_id:dataset.table \ --use_legacy_sql=false 'query'
מחליפים את מה שכתוב בשדות הבאים:
locationהוא שם המיקום שבו מעובדת השאילתה. הדגל--locationהוא אופציונלי. לדוגמה, אם אתם משתמשים ב-BigQuery באזור טוקיו, אתם יכולים להגדיר את הערך של הדגל ל-asia-northeast1. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ.bigqueryrc.
project_idהוא מזהה הפרויקט.
datasetהוא השם של קבוצת הנתונים שמכילה את הטבלה שאליה כותבים את תוצאות השאילתה.
tableהוא שם הטבלה שאליה כותבים את תוצאות השאילתה.
queryהיא שאילתה בתחביר של GoogleSQL.אם לא צוין דגל של write disposition, פעולת ברירת המחדל היא לכתוב את התוצאות בטבלה רק אם היא ריקה. אם הטבלה קיימת והיא לא ריקה, תוחזר השגיאה הבאה:
BigQuery error in query operation: Error processing job project_id:bqjob_123abc456789_00000e1234f_1: Already Exists: Table project_id:dataset.table.דוגמאות:
מזינים את הפקודה הבאה כדי לכתוב את תוצאות השאילתה בטבלת יעד בשם
mytableב-mydataset. מערך הנתונים נמצא בפרויקט שמוגדר כברירת מחדל. מכיוון שלא צוין בפקודה דגל של write disposition, הטבלה צריכה להיות חדשה או ריקה. אחרת, תוחזר השגיאהAlready exists. השאילתה מאחזרת נתונים ממערך הנתונים הציבורי USA Name Data.bq query \ --destination_table mydataset.mytable \ --use_legacy_sql=false \ 'SELECT name, number FROM `bigquery-public-data`.usa_names.usa_1910_current WHERE gender = "M" ORDER BY number DESC'
מזינים את הפקודה הבאה כדי להשתמש בתוצאות השאילתה כדי להחליף טבלת יעד בשם
mytableב-mydataset. מערך הנתונים נמצא בפרויקט שמוגדר כברירת מחדל. הפקודה משתמשת בדגל--replaceכדי להחליף את טבלת היעד.bq query \ --destination_table mydataset.mytable \ --replace \ --use_legacy_sql=false \ 'SELECT name, number FROM `bigquery-public-data`.usa_names.usa_1910_current WHERE gender = "M" ORDER BY number DESC'
מזינים את הפקודה הבאה כדי להוסיף את תוצאות השאילתה לטבלת יעד בשם
mytableב-mydataset. מערך הנתונים נמצא ב-my-other-project, ולא בפרויקט שמוגדר כברירת מחדל. הפקודה משתמשת בדגל--append_tableכדי להוסיף את תוצאות השאילתה לטבלת היעד.bq query \ --append_table \ --use_legacy_sql=false \ --destination_table my-other-project:mydataset.mytable \ 'SELECT name, number FROM `bigquery-public-data`.usa_names.usa_1910_current WHERE gender = "M" ORDER BY number DESC'
הפלט של כל אחת מהדוגמאות האלה נראה כך: כדי שהפלט יהיה קריא, חלק ממנו נחתך.
Waiting on bqjob_r123abc456_000001234567_1 ... (2s) Current status: DONE
+---------+--------+
|  name   | number |
+---------+--------+
| Robert  |  10021 |
| John    |   9636 |
| Robert  |   9297 |
| ...              |
+---------+--------+
-
API
כדי לשמור את תוצאות השאילתה בטבלה קבועה, מפעילים את ה-method jobs.insert, מגדירים משימת query וכוללים ערך למאפיין destinationTable. כדי לשלוט בנטיית הכתיבה של טבלת יעד קיימת, מגדירים את המאפיין writeDisposition.
כדי לשלוט במיקום העיבוד של משימת השאילתה, מציינים את המאפיין location בקטע jobReference של משאב המשימה.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי לשמור את תוצאות השאילתה בטבלה קבועה, מגדירים את טבלת היעד ל-TableId הרצוי ב-QueryJobConfiguration.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי לשמור את תוצאות השאילתה בטבלה קבועה, יוצרים QueryJobConfig ומגדירים את destination ל-TableReference הרצוי. מעבירים את הגדרות המשימה לשיטת השאילתה.יצירת טבלה שמפנה למקור נתונים חיצוני
מקור נתונים חיצוני הוא מקור נתונים שאפשר לשלוח אליו שאילתות ישירות מ-BigQuery, למרות שהנתונים לא מאוחסנים ב-BigQuery. לדוגמה, יכול להיות שיש לכם נתונים במסד נתונים אחר של Google Cloud , בקבצים ב-Cloud Storage או במוצר ענן אחר לגמרי, שאתם רוצים לנתח ב-BigQuery אבל אתם לא מוכנים להעביר אותם.
למידע נוסף, ראו מבוא למקורות נתונים חיצוניים.
יצירת טבלה כשאתם טוענים נתונים
כשאתם טוענים נתונים ל-BigQuery, אתם יכולים לטעון אותם לטבלה או למחיצה חדשה, להוסיף אותם לטבלה או למחיצה קיימת או להחליף טבלה או מחיצה. לא צריך ליצור טבלה ריקה לפני שטוענים אליה נתונים. אפשר ליצור את הטבלה החדשה ולטעון את הנתונים בו-זמנית.
כשאתם טוענים נתונים ל-BigQuery, אתם יכולים לספק את הסכימה של הטבלה או המחיצה, או להשתמש בזיהוי אוטומטי של סכימה בפורמטים נתמכים של נתונים.
למידע נוסף על טעינת נתונים, קראו את המאמר מבוא לטעינת נתונים ל-BigQuery.
יצירת טבלה מולטי-מודאלית
אתם יכולים ליצור טבלה עם עמודה אחת או יותר מסוג ObjectRef כדי לאחסן מטא-נתונים על נתונים לא מובְנים שקשורים לנתונים המובְנים האחרים בטבלה. לדוגמה, בטבלת מוצרים, אפשר ליצור עמודת ObjectRef כדי לאחסן את פרטי התמונה של המוצר יחד עם נתוני המוצר האחרים. הנתונים הלא מובנים עצמם מאוחסנים ב-Cloud Storage, וזמינים ב-BigQuery באמצעות טבלת אובייקטים.
במאמר ניתוח נתונים מולטימודליים באמצעות SQL ו-BigQuery DataFrames מוסבר איך ליצור טבלה מולטימודלית.
שליטה בגישה לטבלאות
כדי להגדיר גישה לטבלאות ולתצוגות, אתם יכולים להקצות תפקיד IAM לישות ברמות הבאות, שמפורטות לפי סדר טווח המשאבים המותרים (מהגדול ביותר לקטן ביותר):
- רמה גבוהה בGoogle Cloud היררכיית המשאבים, כמו רמת הפרויקט, התיקייה או הארגון
- רמת מערך הנתונים
- רמת הטבלה או התצוגה
אתם יכולים גם להגביל את הגישה לנתונים בתוך טבלאות, בשיטות הבאות:
הגישה לכל משאב שמוגן על ידי IAM היא מצטברת. לדוגמה, אם לישות אין גישה ברמה גבוהה כמו פרויקט, אפשר לתת לה גישה ברמת מערך הנתונים, ואז תהיה לה גישה לטבלאות ולתצוגות במערך הנתונים. באופן דומה, אם לישות אין גישה ברמה הגבוהה או ברמת מערך הנתונים, אפשר לתת לה גישה ברמת הטבלה או התצוגה.
כשמקצים תפקידי IAM ברמה גבוהה יותר בהיררכיית המשאבים שלGoogle Cloud, כמו ברמת הפרויקט, התיקייה או הארגון, הישות מקבלת גישה לקבוצה רחבה של משאבים. לדוגמה, אם נותנים לישות תפקיד ברמת הפרויקט, הישות מקבלת הרשאות שחלות על כל מערכי הנתונים בפרויקט.
הקצאת תפקיד ברמת מערך הנתונים מגדירה את הפעולות שהישות יכולה לבצע בטבלאות ובתצוגות במערך הנתונים הספציפי הזה, גם אם לישות אין גישה ברמה גבוהה יותר. במאמר שליטה בגישה למערכי נתונים מוסבר איך מגדירים בקרת גישה ברמת מערך הנתונים.
הקצאת תפקיד ברמת הטבלה או התצוגה מגדירה את הפעולות שהישות יכולה לבצע בטבלאות ובתצוגות ספציפיות, גם אם לישות אין גישה ברמה גבוהה יותר. במאמר שליטה בגישה לטבלאות ולתצוגות מוסבר איך מגדירים אמצעי בקרה על הגישה ברמת הטבלה.
אתם יכולים גם ליצור תפקידים בהתאמה אישית ב-IAM. אם אתם יוצרים תפקיד בהתאמה אישית, ההרשאות שאתם נותנים תלויות בפעולות הספציפיות שאתם רוצים שהישות תוכל לבצע.
אי אפשר להגדיר הרשאת "דחייה" במשאב שמוגן על ידי IAM.
למידע נוסף על תפקידים והרשאות, קראו את המאמר הסבר על תפקידים במסמכי התיעוד של IAM ואת המאמר תפקידים והרשאות של IAM ב-BigQuery.
קבלת מידע על טבלאות
אפשר לקבל מידע או מטא-נתונים על טבלאות בדרכים הבאות:
- באמצעות מסוף Google Cloud .
- באמצעות הפקודה
bq showשל כלי שורת הפקודה של BigQuery. - שליחת קריאה ל-method
tables.getשל ה-API. - שימוש בספריות הלקוח.
- שליחת שאילתה לתצוגה
INFORMATION_SCHEMA.VIEWS.
ההרשאות הנדרשות
כדי לקבל מידע על טבלאות, אתם צריכים לפחות את ההרשאות של bigquery.tables.get. התפקידים המוגדרים מראש הבאים ב-IAM כוללים הרשאות bigquery.tables.get:
bigquery.metadataViewerbigquery.dataViewerbigquery.dataOwnerbigquery.dataEditorbigquery.admin
בנוסף, אם למשתמש יש הרשאות bigquery.datasets.create, כשהוא יוצר מערך נתונים, הוא מקבל גישה אליו ברמת bigquery.dataOwner.
גישת bigquery.dataOwner מאפשרת למשתמש לאחזר מטא-נתונים של טבלאות.
במאמר בקרת גישה מוסבר בהרחבה על התפקידים וההרשאות ב-IAM ב-BigQuery.
קבלת מידע על הטבלה
כדי לקבל מידע על טבלאות:
המסוף
בחלונית הניווט, בקטע Resources, מרחיבים את הפרויקט ובוחרים מערך נתונים.
לוחצים על השם של מערך הנתונים כדי להרחיב אותו. הטבלאות והתצוגות במערך הנתונים מופיעות.
לוחצים על שם הטבלה.
בחלונית Details, לוחצים על Details כדי להציג את תיאור הטבלה ואת פרטי הטבלה.
אם רוצים, עוברים לכרטיסייה Schema כדי לראות את הגדרת הסכימה של הטבלה.
BQ
-
מפעילים את Cloud Shell במסוף Google Cloud .
בחלק התחתון של מסוף Google Cloud יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
מריצים את הפקודה
bq showכדי להציג את כל המידע בטבלה. משתמשים בדגל--schemaכדי להציג רק את פרטי הסכימה של הטבלה. אפשר להשתמש בדגל--formatכדי לשלוט בפלט.אם אתם מקבלים מידע על טבלה בפרויקט שהוא לא פרויקט ברירת המחדל, הוסיפו את מזהה הפרויקט למערך הנתונים בפורמט הבא:
PROJECT_ID:DATASET.bq show \ --schema \ --format=prettyjson \ PROJECT_ID:DATASET.TABLE
כאשר:
-
PROJECT_IDהוא מזהה הפרויקט. -
DATASETהוא שם מערך הנתונים. -
TABLEהוא שם הטבלה.
דוגמאות:
מזינים את הפקודה הבאה כדי להציג את כל המידע על
mytableב-mydataset. mydatasetנמצא בפרויקט ברירת המחדל.bq show --format=prettyjson mydataset.mytable
מזינים את הפקודה הבאה כדי להציג את כל המידע על
mytableב-mydataset. mydatasetנמצא ב-myotherproject, ולא בפרויקט שמוגדר כברירת מחדל.bq show --format=prettyjson myotherproject:mydataset.mytable
מזינים את הפקודה הבאה כדי להציג רק מידע על הסכימה של
mytableב-mydataset. mydatasetנמצא ב-myotherproject, ולא בפרויקט ברירת המחדל.bq show --schema --format=prettyjson myotherproject:mydataset.mytable
-
API
מפעילים את השיטה tables.get ומספקים את הפרמטרים הרלוונטיים.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
קבלת מידע על טבלה באמצעות INFORMATION_SCHEMA
INFORMATION_SCHEMA היא סדרה של תצוגות שמספקות גישה למטא-נתונים של מערכי נתונים, שגרות, טבלאות, תצוגות, משימות, הזמנות ונתונים בסטרימינג.
כדי לקבל מידע על הטבלה, אתם יכולים לשלוח שאילתות לתצוגות הבאות:
- משתמשים בתצוגות
INFORMATION_SCHEMA.TABLESו-INFORMATION_SCHEMA.TABLE_OPTIONSכדי לאחזר מטא-נתונים על טבלאות ותצוגות בפרויקט. - משתמשים בתצוגות
INFORMATION_SCHEMA.COLUMNSו-INFORMATION_SCHEMA.COLUMN_FIELD_PATHSכדי לאחזר מטא-נתונים על העמודות (השדות) בטבלה. - אפשר להשתמש בתצוגות
INFORMATION_SCHEMA.TABLE_STORAGEכדי לאחזר מטא-נתונים על נפח האחסון הנדרש הנוכחי וההיסטורי של טבלה.
התצוגות TABLES ו-TABLE_OPTIONS מכילות גם מידע ברמה גבוהה על תצוגות. כדי לקבל מידע מפורט, צריך לשלוח שאילתה לתצוגה INFORMATION_SCHEMA.VIEWS.
צפייה אחת (TABLES)
כששולחים שאילתה לתצוגה INFORMATION_SCHEMA.TABLES, תוצאות השאילתה מכילות שורה אחת לכל טבלה או תצוגה במערך הנתונים. כדי לקבל מידע מפורט על תצוגות, צריך לשלוח שאילתה לתצוגה INFORMATION_SCHEMA.VIEWS.
הסכימה של התצוגה INFORMATION_SCHEMA.TABLES היא:
| שם העמודה | סוג נתונים | ערך |
|---|---|---|
table_catalog |
STRING |
מזהה הפרויקט שמכיל את מערך הנתונים. |
table_schema |
STRING |
שם מערך הנתונים שמכיל את הטבלה או התצוגה. נקרא גם datasetId. |
table_name |
STRING |
שם הטבלה או התצוגה. נקרא גם tableId. |
table_type |
STRING |
סוג הטבלה, אחת מהאפשרויות הבאות:
|
managed_table_type |
STRING |
העמודה הזו נמצאת בגרסת טרום-השקה (Preview). סוג הטבלה המנוהלת, אחת מהאפשרויות הבאות:
|
is_insertable_into |
STRING |
YES או NO, בהתאם לשאלה אם הטבלה תומכת בהצהרות DML INSERT |
is_fine_grained_mutations_enabled |
STRING |
YES או NO, בהתאם להגדרה של מוטציות DML מפורטות בטבלה
|
is_typed |
STRING |
הערך הוא תמיד NO |
is_change_history_enabled |
STRING |
YES או NO, בהתאם להגדרה של היסטוריית השינויים |
creation_time |
TIMESTAMP |
מועד יצירת הטבלה |
base_table_catalog |
STRING |
בטבלאות משוכפלות ובתמונות מצב של טבלאות, הפרויקט של מסד הנתונים הטבלאי. רלוונטי רק לטבלאות שבהן הערך של table_type מוגדר כ-CLONE או כ-SNAPSHOT.
|
base_table_schema |
STRING |
בשיבוטי טבלאות ובתמונות מצב של טבלאות, מערך הנתונים של טבלת הבסיס. רלוונטי רק לטבלאות שבהן הערך של table_type מוגדר כ-CLONE או כ-SNAPSHOT. |
base_table_name |
STRING |
בשיבוטי טבלאות ובתמונות מצב של טבלאות, השם של מסד הנתונים הטבלאי. רלוונטי רק לטבלאות שבהן הערך של table_type מוגדר כ-CLONE או כ-SNAPSHOT. |
snapshot_time_ms |
TIMESTAMP |
בשיבוטי טבלאות ובתמונות מצב של טבלאות, הזמן שבו בוצעה פעולת השיבוט או תמונת המצב בטבלת הבסיס כדי ליצור את הטבלה הזו. אם נעשה שימוש במסע בזמן, השדה הזה מכיל את חותמת הזמן של המסע בזמן. אחרת, השדה snapshot_time_ms זהה לשדה creation_time. רלוונטי רק לטבלאות שבהן הערך של table_type מוגדר כ-CLONE או כ-SNAPSHOT.
|
replica_source_catalog |
STRING |
בעותקים של תצוגות מהותיות, הפרויקט של התצוגה המהותית הבסיסית. |
replica_source_schema |
STRING |
בעותקים משוכפלים של תצוגות מהותיות, מערך הנתונים של התצוגה המהותית הבסיסית. |
replica_source_name |
STRING |
בעותקים של תצוגות מהותיות, השם של התצוגה המהותית הבסיסית. |
replication_status |
STRING |
ברפליקות של תצוגות מהותיות, הסטטוס של הרפליקציה מהתצוגה המהותית הבסיסית לרפליקה של התצוגה המהותית. אחד מהערכים הבאים:
|
replication_error |
STRING |
אם הערך של replication_status מציין בעיה בשכפול של רפליקה של תצוגה מהותית, הערך של replication_error מספק פרטים נוספים על הבעיה. |
ddl |
STRING |
הצהרת ה-DDL שבה אפשר להשתמש כדי ליצור מחדש את הטבלה, כמו CREATE TABLE או CREATE VIEW |
default_collation_name |
STRING |
השם של מפרט ברירת המחדל של ההשוואה, אם הוא קיים. אחרת, NULL.
|
sync_status |
JSON |
סטטוס הסנכרון בין הרפליקות הראשיות והמשניות של מערכי הנתונים של רפליקציה חוצת-אזורים ותוכנית התאוששות מאסון (DR). הפונקציה מחזירה את הערך NULL אם הרפליקה היא רפליקה ראשית או אם מערך הנתונים לא משתמש ברפליקציה. |
upsert_stream_apply_watermark |
TIMESTAMP |
בטבלאות שמשתמשות בסימון נתונים שהשתנו (CDC), הזמן שבו בוצעו השינויים האחרונים בשורות. מידע נוסף זמין במאמר מעקב אחרי ההתקדמות של פעולת העדכון או ההוספה (upsert) בטבלה. |
דוגמאות
דוגמה 1:
בדוגמה הבאה מאחזרים מטא-נתונים של כל הטבלאות במערך הנתונים שנקרא mydataset. המטא-נתונים שמוחזרים הם של כל סוגי הטבלאות ב-mydataset בפרויקט שמוגדר כברירת מחדל.
mydataset מכיל את הטבלאות הבאות:
-
mytable1: טבלה רגילה ב-BigQuery -
myview1: תצוגה ב-BigQuery
כדי להריץ את השאילתה בפרויקט אחר, ולא בפרויקט ברירת המחדל, צריך להוסיף את מזהה הפרויקט למערך הנתונים בפורמט הבא: `project_id`.dataset.INFORMATION_SCHEMA.view, לדוגמה: `myproject`.mydataset.INFORMATION_SCHEMA.TABLES.
SELECT
  table_catalog, table_schema, table_name, table_type,
  is_insertable_into, creation_time, ddl
FROM
  mydataset.INFORMATION_SCHEMA.TABLES;
התוצאה אמורה להיראות כך: כדי שהתוצאה תהיה קריאה, חלק מהעמודות לא נכללות בה.
+----------------+---------------+----------------+------------+--------------------+---------------------+---------------------------------------------+
| table_catalog  | table_schema  |   table_name   | table_type | is_insertable_into |    creation_time    |                     ddl                     |
+----------------+---------------+----------------+------------+--------------------+---------------------+---------------------------------------------+
| myproject      | mydataset     | mytable1       | BASE TABLE | YES                | 2018-10-29 20:34:44 | CREATE TABLE `myproject.mydataset.mytable1` |
|                |               |                |            |                    |                     | (                                           |
|                |               |                |            |                    |                     |   id INT64                                  |
|                |               |                |            |                    |                     | );                                          |
| myproject      | mydataset     | myview1        | VIEW       | NO                 | 2018-12-29 00:19:20 | CREATE VIEW `myproject.mydataset.myview1`   |
|                |               |                |            |                    |                     | AS SELECT 100 as id;                        |
+----------------+---------------+----------------+------------+--------------------+---------------------+---------------------------------------------+
דוגמה 2:
בדוגמה הבאה מאחזרים מטא-נתונים של טבלאות מכל הטבלאות מסוג CLONE או SNAPSHOT מהתצוגה INFORMATION_SCHEMA.TABLES. המטא-נתונים שמוחזרים הם של טבלאות ב-mydataset בפרויקט ברירת המחדל.
כדי להריץ את השאילתה בפרויקט אחר, ולא בפרויקט ברירת המחדל, צריך להוסיף את מזהה הפרויקט למערך הנתונים בפורמט הבא: `project_id`.dataset.INFORMATION_SCHEMA.view, לדוגמה: `myproject`.mydataset.INFORMATION_SCHEMA.TABLES.
  SELECT
    table_name, table_type, base_table_catalog,
    base_table_schema, base_table_name, snapshot_time_ms
  FROM
    mydataset.INFORMATION_SCHEMA.TABLES
  WHERE
    table_type = 'CLONE'
  OR
    table_type = 'SNAPSHOT';
התוצאה אמורה להיראות כך: כדי שהתוצאה תהיה קריאה, חלק מהעמודות לא נכללות בה.
  +--------------+------------+--------------------+-------------------+-----------------+---------------------+
  | table_name   | table_type | base_table_catalog | base_table_schema | base_table_name | snapshot_time_ms    |
  +--------------+------------+--------------------+-------------------+-----------------+---------------------+
  | items_clone  | CLONE      | myproject          | mydataset         | items           | 2018-10-31 22:40:05 |
  | orders_bk    | SNAPSHOT   | myproject          | mydataset         | orders          | 2018-11-01 08:22:39 |
  +--------------+------------+--------------------+-------------------+-----------------+---------------------+
דוגמה 3:
בדוגמה הבאה מאחזרים את העמודות table_name ו-ddl מהתצוגה INFORMATION_SCHEMA.TABLES של הטבלה population_by_zip_2010 במערך הנתונים census_bureau_usa. מערך הנתונים הזה הוא חלק מתוכנית מערכי הנתונים שגלויים לכולם ב-BigQuery.
מכיוון שהטבלה שאתם שולחים אליה שאילתה נמצאת בפרויקט אחר, אתם צריכים להוסיף את מזהה הפרויקט למערך הנתונים בפורמט הבא: `project_id`.dataset.INFORMATION_SCHEMA.view.
בדוגמה הזו, הערך הוא `bigquery-public-data`.census_bureau_usa.INFORMATION_SCHEMA.TABLES.
SELECT
  table_name, ddl
FROM
  `bigquery-public-data`.census_bureau_usa.INFORMATION_SCHEMA.TABLES
WHERE
  table_name = 'population_by_zip_2010';
התוצאה אמורה להיראות כך:
+------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|       table_name       |                                                                                                            ddl                                                                                                             |
+------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| population_by_zip_2010 | CREATE TABLE `bigquery-public-data.census_bureau_usa.population_by_zip_2010`                                                                                                                                               |
|                        | (                                                                                                                                                                                                                          |
|                        |   geo_id STRING OPTIONS(description="Geo code"),                                                                                                                                                                           |
|                        |   zipcode STRING NOT NULL OPTIONS(description="Five digit ZIP Code Tabulation Area Census Code"),                                                                                                                          |
|                        |   population INT64 OPTIONS(description="The total count of the population for this segment."),                                                                                                                             |
|                        |   minimum_age INT64 OPTIONS(description="The minimum age in the age range. If null, this indicates the row as a total for male, female, or overall population."),                                                          |
|                        |   maximum_age INT64 OPTIONS(description="The maximum age in the age range. If null, this indicates the row as having no maximum (such as 85 and over) or the row is a total of the male, female, or overall population."), |
|                        |   gender STRING OPTIONS(description="male or female. If empty, the row is a total population summary.")                                                                                                                    |
|                        | )                                                                                                                                                                                                                          |
|                        | OPTIONS(                                                                                                                                                                                                                   |
|                        |   labels=[("freebqcovid", "")]                                                                                                                                                                                             |
|                        | );                                                                                                                                                                                                                         |
+------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
צפייה אחת (TABLE_OPTIONS)
כששולחים שאילתה לתצוגה INFORMATION_SCHEMA.TABLE_OPTIONS, תוצאות השאילתה מכילות שורה אחת לכל אפשרות, לכל טבלה או תצוגה במערך נתונים. כדי לקבל מידע מפורט על תצוגות, צריך לשלוח שאילתה לתצוגה INFORMATION_SCHEMA.VIEWS.
הסכימה של התצוגה INFORMATION_SCHEMA.TABLE_OPTIONS היא:
| שם העמודה | סוג נתונים | ערך |
|---|---|---|
table_catalog |
STRING |
מזהה הפרויקט שמכיל את מערך הנתונים |
table_schema |
STRING |
שם מערך הנתונים שמכיל את הטבלה או התצוגה, שנקרא גם datasetId |
table_name |
STRING |
שם הטבלה או התצוגה, שנקרא גם tableId |
option_name |
STRING |
אחד מערכי השמות בטבלת האפשרויות |
option_type |
STRING |
אחד מהערכים של סוגי הנתונים בטבלת האפשרויות |
option_value |
STRING |
אחת מהאפשרויות של הערכים בטבלת האפשרויות |
טבלת אפשרויות
|
|
|
|---|---|---|
|
|
תיאור של הטבלה |
|
|
אם הרענון האוטומטי מופעל בתצוגה המהותית |
|
|
השעה שבה פג התוקף של הטבלה הזו |
|
|
השם התיאורי של הטבלה |
|
|
השם של מפתח Cloud KMS שמשמש להצפנת הטבלה |
|
|
מערך של STRUCT שמייצגים את התוויות בטבלה |
|
|
הזמן המקסימלי שמוגדר לטבלה ללא עדכון של פעולות upsert של סימון נתונים שהשתנו (CDC) ב-BigQuery |
|
|
משך החיים שמוגדר כברירת מחדל, בימים, של כל המחיצות בטבלה מחולקת למחיצות |
|
|
באיזו תדירות מתבצע רענון של תצוגה מהותית |
|
|
אם שאילתות בטבלה דורשות מסנן מחיצה |
|
|
תגים שמצורפים לטבלה בתחביר <key, value> במרחב שמות. מידע נוסף זמין במאמר תגים וגישה מותנית. |
בטבלאות חיצוניות, אפשר לבחור את האפשרויות הבאות:
| אפשרויות | |
|---|---|
allow_jagged_rows |
אם הערך הוא רלוונטי לנתונים בפורמט CSV. |
allow_quoted_newlines |
אם הערך הוא רלוונטי לנתונים בפורמט CSV. |
bigtable_options |
נדרש רק כשיוצרים טבלה חיצונית של Bigtable. מציינת את הסכימה של הטבלה החיצונית ב-Bigtable בפורמט JSON. רשימה של אפשרויות להגדרת טבלאות Bigtable מופיעה במאמר |
column_name_character_map |
מגדיר את היקף התווים הנתמכים בשמות של עמודות ואת אופן הטיפול בתווים לא נתמכים. הגדרת ברירת המחדל היא הערכים הנתמכים כוללים:
רלוונטי לנתונים בפורמט CSV ו-Parquet. |
compression |
סוג הדחיסה של מקור הנתונים. הערכים הנתמכים כוללים:
רלוונטי לנתונים בפורמט CSV ו-JSON. |
decimal_target_types |
קובע איך להמיר סוג של דוגמה: |
description |
תיאור של הטבלה הזו. |
enable_list_inference |
אם הערך הוא רלוונטי לנתונים בפורמט Parquet. |
enable_logical_types |
אם הערך הוא רלוונטי לנתוני Avro. |
encoding |
קידוד התווים של הנתונים. ערכים נתמכים:
רלוונטי לנתונים בפורמט CSV. |
enum_as_string |
אם רלוונטי לנתונים בפורמט Parquet. |
expiration_timestamp |
הזמן שבו פג התוקף של הטבלה. אם לא מציינים תאריך תפוגה, הטבלה לא תפוג. דוגמה: |
field_delimiter |
התו שמפריד בין השדות בקובץ CSV. רלוונטי לנתונים בפורמט CSV. |
format |
הפורמט של הנתונים החיצוניים.
ערכים נתמכים של
ערכים נתמכים של
הערך |
hive_partition_uri_prefix |
קידומת משותפת לכל מזהי ה-URI של המקורות לפני שמתחיל הקידוד של מפתח המחיצה. רלוונטי רק לטבלאות חיצוניות שמחולקות למחיצות ב-Hive. רלוונטי לנתונים בפורמטים Avro, CSV, JSON, Parquet ו-ORC. דוגמה: |
file_set_spec_type |
מציין איך לפרש מזהי URI של מקורות למשימות טעינה ולטבלאות חיצוניות. הערכים הנתמכים כוללים:
לדוגמה, אם יש לכם URI של מקור |
ignore_unknown_values |
אם הערך הוא רלוונטי לנתונים בפורמט CSV ו-JSON. |
json_extension |
לנתוני JSON, מציין פורמט מסוים של חילופי JSON. אם לא מציינים סכימה, BigQuery קורא את הנתונים כרשומות JSON כלליות. הערכים הנתמכים כוללים: |
max_bad_records |
המספר המקסימלי של רשומות פגומות שאפשר להתעלם מהן בזמן קריאת הנתונים. רלוונטי לנתונים בפורמטים CSV, JSON ו-Google Sheets. |
max_staleness |
רלוונטי לטבלאות BigLake ולטבלאות אובייקטים. מציין אם פעולות בטבלה משתמשות במטא-נתונים שנשמרו במטמון, ועד כמה המטא-נתונים שנשמרו במטמון צריכים להיות עדכניים כדי שהפעולה תשתמש בהם. כדי להשבית את השמירה של המטא-נתונים במטמון, מציינים את הערך 0. (זוהי ברירת המחדל) כדי להפעיל את האפשרות לשמירת מטא-נתונים במטמון, מציינים ערך של ליטרל מרווח בין 30 דקות ל-7 ימים. לדוגמה, מציינים |
null_marker |
המחרוזת שמייצגת ערכי רלוונטי לנתונים בפורמט CSV. |
null_markers |
רשימת המחרוזות שמייצגות ערכי אי אפשר להשתמש באפשרות הזו עם האפשרות רלוונטי לנתונים בפורמט CSV. |
object_metadata |
נדרש רק כשיוצרים טבלת אובייקטים. צריך להגדיר את הערך של האפשרות הזו בתור |
preserve_ascii_control_characters |
אם רלוונטי לנתונים בפורמט CSV. |
projection_fields |
רשימה של מאפייני ישויות לטעינה. חל על נתונים ב-Datastore. |
quote |
המחרוזת שמשמשת לציטוט קטעי נתונים בקובץ CSV. אם הנתונים מכילים תווי שורה חדשה במירכאות, צריך להגדיר גם את המאפיין רלוונטי לנתונים בפורמט CSV. |
reference_file_schema_uri |
המשתמש סיפק קובץ רפרנס עם סכימת הטבלה. רלוונטי לנתונים בפורמט Parquet, ORC ו-AVRO. דוגמה: |
require_hive_partition_filter |
אם הערך הוא רלוונטי לנתונים בפורמטים Avro, CSV, JSON, Parquet ו-ORC. |
sheet_range |
טווח של גיליון אלקטרוני ב-Google Sheets שממנו תתבצע השאילתה. המידע הזה רלוונטי לנתונים ב-Google Sheets. לדוגמה: |
skip_leading_rows |
מספר השורות בחלק העליון של הקובץ שצריך לדלג עליהן כשקוראים את הנתונים. ההגדרה הזו רלוונטית לנתונים בפורמט CSV וב-Google Sheets. |
source_column_match |
ההגדרה הזו קובעת את השיטה שבה המערכת משתמשת כדי להתאים בין העמודות שנטענו לבין הסכימה. אם לא מציינים ערך, ברירת המחדל מבוססת על האופן שבו הסכימה מסופקת. אם הזיהוי האוטומטי מופעל, פעולת ברירת המחדל היא להתאים עמודות לפי שם. אחרת, ברירת המחדל היא להתאים עמודות לפי מיקום. ההגדרה הזו נועדה לשמור על תאימות לאחור. הערכים הנתמכים כוללים:
|
tags |
<ARRAY<STRUCT<STRING, STRING>>>
מערך של תגי IAM לטבלה, שמיוצגים כצמדי מפתח/ערך. המפתח צריך להיות שם המפתח ממרחב השמות, והערך צריך להיות השם המקוצר. |
time_zone |
אזור הזמן שמוגדר כברירת מחדל, שיחול כשמנתחים ערכים של חותמות זמן שאין להם אזור זמן ספציפי. אם הערך הזה לא קיים, ערכי חותמת הזמן בלי אזור זמן ספציפי מנותחים באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC. רלוונטי לנתונים בפורמט CSV ו-JSON. |
date_format |
רכיבי פורמט שמגדירים את הפורמט של ערכי DATE בקובצי הקלט (לדוגמה, אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של DATE. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATE מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. רלוונטי לנתונים בפורמט CSV ו-JSON. |
datetime_format |
רכיבי פורמט
שמגדירים את הפורמט של ערכי DATETIME בקובצי הקלט
(לדוגמה, אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של DATETIME. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATETIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. רלוונטי לנתונים בפורמט CSV ו-JSON. |
time_format |
רכיבי פורמט שמגדירים את הפורמט של ערכי TIME בקובצי הקלט (לדוגמה, אם הערך הזה קיים, הפורמט הזה הוא הפורמט היחיד שתואם ל-TIME. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. רלוונטי לנתונים בפורמט CSV ו-JSON. |
timestamp_format |
רכיבי פורמט
שמגדירים את הפורמט של ערכי TIMESTAMP בקובצי הקלט
(לדוגמה, אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של TIMESTAMP. הזיהוי האוטומטי של הסכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה, במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIMESTAMP מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. רלוונטי לנתונים בפורמט CSV ו-JSON. |
uris |
בטבלאות חיצוניות, כולל טבלאות אובייקטים, שאינן טבלאות Bigtable:
מערך של מזהי URI מוגדרים במלואם למיקומי הנתונים החיצוניים.
כל URI יכול להכיל כוכבית אחת ( בדוגמאות הבאות מוצגים ערכים תקינים של
לטבלאות Bigtable:
ה-URI שמזהה את טבלת Bigtable שמשמשת כמקור נתונים. אפשר לציין רק URI אחד של Bigtable. לדוגמה:
למידע נוסף על יצירת URI של Bigtable, קראו את המאמר אחזור ה-URI של Bigtable. |
דוגמאות
דוגמה 1:
בדוגמה הבאה, השאילתה בתצוגה INFORMATION_SCHEMA.TABLE_OPTIONS מאחזרת את זמני התפוגה שמוגדרים כברירת מחדל לכל הטבלאות ב-mydataset בפרויקט ברירת המחדל (myproject).
כדי להריץ את השאילתה בפרויקט אחר, ולא בפרויקט ברירת המחדל, צריך להוסיף את מזהה הפרויקט למערך הנתונים בפורמט הבא: `project_id`.dataset.INFORMATION_SCHEMA.view, לדוגמה: `myproject`.mydataset.INFORMATION_SCHEMA.TABLE_OPTIONS.
  SELECT
    *
  FROM
    mydataset.INFORMATION_SCHEMA.TABLE_OPTIONS
  WHERE
    option_name = 'expiration_timestamp';
התוצאה אמורה להיראות כך:
  +----------------+---------------+------------+----------------------+-------------+--------------------------------------+
  | table_catalog  | table_schema  | table_name |     option_name      | option_type |             option_value             |
  +----------------+---------------+------------+----------------------+-------------+--------------------------------------+
  | myproject      | mydataset     | mytable1   | expiration_timestamp | TIMESTAMP   | TIMESTAMP "2020-01-16T21:12:28.000Z" |
  | myproject      | mydataset     | mytable2   | expiration_timestamp | TIMESTAMP   | TIMESTAMP "2021-01-01T21:12:28.000Z" |
  +----------------+---------------+------------+----------------------+-------------+--------------------------------------+
דוגמה 2:
בדוגמה הבאה מאחזרים מטא-נתונים על כל הטבלאות ב-mydataset שמכילות נתוני בדיקה. השאילתה משתמשת בערכים שבאפשרות description כדי למצוא טבלאות שמכילות את המילה test בכל מקום בתיאור. mydataset נמצא בפרויקט ברירת המחדל – myproject.
כדי להריץ את השאילתה בפרויקט אחר, שהוא לא פרויקט ברירת המחדל, צריך להוסיף את מזהה הפרויקט למערך הנתונים בפורמט הבא: `project_id`.dataset.INFORMATION_SCHEMA.view, לדוגמה: `myproject`.mydataset.INFORMATION_SCHEMA.TABLE_OPTIONS.
  SELECT
    *
  FROM
    mydataset.INFORMATION_SCHEMA.TABLE_OPTIONS
  WHERE
    option_name = 'description'
    AND option_value LIKE '%test%';
התוצאה אמורה להיראות כך:
  +----------------+---------------+------------+-------------+-------------+--------------+
  | table_catalog  | table_schema  | table_name | option_name | option_type | option_value |
  +----------------+---------------+------------+-------------+-------------+--------------+
  | myproject      | mydataset     | mytable1   | description | STRING      | "test data"  |
  | myproject      | mydataset     | mytable2   | description | STRING      | "test data"  |
  +----------------+---------------+------------+-------------+-------------+--------------+
צפייה אחת (COLUMNS)
כששולחים שאילתה לתצוגה INFORMATION_SCHEMA.COLUMNS, תוצאות השאילתה מכילות שורה אחת לכל עמודה (שדה) בטבלה.
הסכימה של התצוגה INFORMATION_SCHEMA.COLUMNS היא:
| שם העמודה | סוג נתונים | ערך |
|---|---|---|
table_catalog |
STRING |
מזהה הפרויקט שמכיל את מערך הנתונים. |
table_schema |
STRING |
שם מערך הנתונים שמכיל את הטבלה, שנקרא גם datasetId. |
table_name |
STRING |
שם הטבלה או התצוגה, שנקרא גם tableId. |
column_name |
STRING |
שם העמודה. |
ordinal_position |
INT64 |
ההיסט של העמודה בטבלה, עם אינדקס שמתחיל ב-1. אם זו עמודה מדומה כמו _PARTITIONTIME או _PARTITIONDATE, הערך הוא NULL. |
is_nullable |
STRING |
YES או NO, בהתאם למצב העמודה שמאפשר ערכי NULL. |
data_type |
STRING |
סוג הנתונים של העמודה ב-GoogleSQL. |
is_generated |
STRING |
הערך הוא ALWAYS אם העמודה היא עמודת הטמעה שנוצרה באופן אוטומטי, אחרת הערך הוא NEVER. |
generation_expression |
STRING |
הערך הוא ביטוי היצירה שמשמש להגדרת העמודה, אם העמודה היא עמודת הטמעה שנוצרה באופן אוטומטי. אחרת, הערך הוא NULL. |
is_stored |
STRING |
הערך הוא YES אם העמודה היא עמודת הטמעה שנוצרה באופן אוטומטי, אחרת הערך הוא NULL. |
async_generation_status |
STRUCT |
מכיל שגיאות חסימה של משימות הטמעה ברקע, אם העמודה היא עמודת הטמעה שנוצרה באופן אוטומטי. אחרת, הערך הוא NULL. מידע על שגיאות חסימה מופיע בשדה async_generation_status.blocking_error.message.
דוגמאות לשגיאות חסימה:
async_generation_status נמחקת.
|
is_hidden |
STRING |
YES או NO, בהתאם לשאלה אם העמודה היא עמודה מדומה כמו _PARTITIONTIME או _PARTITIONDATE. |
is_updatable |
STRING |
הערך הוא תמיד NULL. |
is_system_defined |
STRING |
YES או NO, בהתאם לשאלה אם העמודה היא עמודה מדומה כמו _PARTITIONTIME או _PARTITIONDATE. |
is_partitioning_column |
STRING |
YES או NO, בהתאם לשאלה אם העמודה היא עמודת חלוקה למחיצות. |
clustering_ordinal_position |
INT64 |
ההיסט של העמודה בתוך עמודות האשכולות של הטבלה, באינדקס שמתחיל ב-1. הערך הוא NULL אם הטבלה לא מסודרת באשכולות. |
collation_name |
STRING |
השם של מפרט ההשוואה, אם הוא קיים. אחרת, NULL.אם מעבירים STRING או ARRAY<STRING>, מוחזר מפרט ההשוואה אם הוא קיים, אחרת מוחזר NULL.
|
column_default |
STRING |
ערך ברירת המחדל של העמודה, אם הוא קיים. אחרת, הערך הוא NULL.
|
rounding_mode |
STRING |
מצב העיגול שמשמש לערכים שנכתבים בשדה אם הסוג שלו הוא NUMERIC או BIGNUMERIC עם פרמטרים. אחרת, הערך הוא NULL.
|
data_policies.name |
STRING |
רשימת כללי מדיניות הנתונים שמצורפים לעמודה כדי לשלוט בגישה ובמיסוך. השדה הזה נמצא בגרסת טרום-השקה (Preview). |
data_governance_tags |
ARRAY<STRUCT> |
רשימת תגי משילות המידע (data governance) שמצורפים לעמודה כדי לשלוט בגישה ובמיסוך. כל STRUCT מכיל את השדות הבאים של STRING:
STRUCT (או RECORD), תגי משילות מידע שמצורפים לשדות בתצוגת עץ זמינים בתצוגה INFORMATION_SCHEMA.COLUMN_FIELD_PATHS.
|
policy_tags |
ARRAY<STRING> |
רשימת תגי המדיניות שמצורפים לעמודה. |
is_identity |
STRING |
YES או NO, בהתאם לשאלה אם העמודה היא עמודת זהות.
|
identity_generation |
STRING |
ALWAYS או BY DEFAULT, בהתאם למצב היצירה של עמודת הזהות. אם העמודה היא לא עמודת זהות, הערך הוא NULL.
|
identity_start |
INT64 |
הערך הראשון שנוצר על ידי עמודת הזהות, או NULL אם העמודה היא לא עמודת זהות.
|
identity_increment |
INT64 |
ההפרש המינימלי בין מזהים שנוצרו ברצף בעמודת הזהות, או NULL אם העמודה היא לא עמודת זהות.
|
identity_maximum |
INT64 |
הערך המקסימלי שאפשר ליצור לעמודת הזהות, או NULL אם העמודה היא לא עמודת זהות.
|
identity_minimum |
INT64 |
הערך המינימלי שאפשר ליצור לעמודת הזהות, או NULL אם העמודה היא לא עמודת זהות.
|
identity_cycle |
STRING |
אם העמודה היא עמודת זהות, הערך הוא NEVER. אחרת, הערך הוא NULL.
|
דוגמאות
בדוגמה הבאה מאחזרים מטא-נתונים מהתצוגה INFORMATION_SCHEMA.COLUMNS של הטבלה population_by_zip_2010 במערך הנתונים census_bureau_usa. מערך הנתונים הזה הוא חלק מתוכנית מערכי הנתונים שגלויים לכולם ב-BigQuery.
מכיוון שהטבלה שאתם שולחים אליה שאילתה נמצאת בפרויקט אחר, הפרויקט bigquery-public-data, אתם מוסיפים את מזהה הפרויקט למערך הנתונים בפורמט הבא: `project_id`.dataset.INFORMATION_SCHEMA.view, לדוגמה `bigquery-public-data`.census_bureau_usa.INFORMATION_SCHEMA.TABLES.
העמודה הבאה לא נכללת בתוצאות השאילתה:
IS_UPDATABLE
  SELECT
    * EXCEPT(is_updatable)
  FROM
    `bigquery-public-data`.census_bureau_usa.INFORMATION_SCHEMA.COLUMNS
  WHERE
    table_name = 'population_by_zip_2010';
התוצאה אמורה להיראות כך: כדי שהתוצאה תהיה קריאה, חלק מהעמודות לא נכללות בה.
+------------------------+-------------+------------------+-------------+-----------+-----------+-------------------+------------------------+-----------------------------+-------------+
|       table_name       | column_name | ordinal_position | is_nullable | data_type | is_hidden | is_system_defined | is_partitioning_column | clustering_ordinal_position | policy_tags |
+------------------------+-------------+------------------+-------------+-----------+-----------+-------------------+------------------------+-----------------------------+-------------+
| population_by_zip_2010 | zipcode     |                1 | NO          | STRING    | NO        | NO                | NO                     |                        NULL | 0 rows      |
| population_by_zip_2010 | geo_id      |                2 | YES         | STRING    | NO        | NO                | NO                     |                        NULL | 0 rows      |
| population_by_zip_2010 | minimum_age |                3 | YES         | INT64     | NO        | NO                | NO                     |                        NULL | 0 rows      |
| population_by_zip_2010 | maximum_age |                4 | YES         | INT64     | NO        | NO                | NO                     |                        NULL | 0 rows      |
| population_by_zip_2010 | gender      |                5 | YES         | STRING    | NO        | NO                | NO                     |                        NULL | 0 rows      |
| population_by_zip_2010 | population  |                6 | YES         | INT64     | NO        | NO                | NO                     |                        NULL | 0 rows      |
+------------------------+-------------+------------------+-------------+-----------+-----------+-------------------+------------------------+-----------------------------+-------------+
צפייה אחת (COLUMN_FIELD_PATHS)
כששולחים שאילתה לתצוגה INFORMATION_SCHEMA.COLUMN_FIELD_PATHS, תוצאות השאילתה מכילות שורה אחת לכל עמודה שמוטמעת בתוך עמודה מסוג RECORD (או STRUCT).
הסכימה של התצוגה INFORMATION_SCHEMA.COLUMN_FIELD_PATHS היא:
| שם העמודה | סוג נתונים | ערך |
|---|---|---|
table_catalog |
STRING |
מזהה הפרויקט שמכיל את מערך הנתונים. |
table_schema |
STRING |
שם מערך הנתונים שמכיל את הטבלה, שנקרא גם datasetId. |
table_name |
STRING |
שם הטבלה או התצוגה, שנקרא גם tableId. |
column_name |
STRING |
השם של העמודה ברמה העליונה. |
field_path |
STRING |
שם העמודה ברמה העליונה או הנתיב לעמודה המוטמעת בתוך עמודה מסוג RECORD או STRUCT. |
data_type |
STRING |
סוג הנתונים של העמודה ב-GoogleSQL. |
description |
STRING |
תיאור העמודה. |
collation_name |
STRING |
השם של מפרט ההשוואה, אם הוא קיים. אחרת, NULL.אם מועבר שדה STRING, ARRAY<STRING> או STRING ב-STRUCT, מוחזר מפרט ה-collation אם הוא קיים. אחרת, מוחזר NULL.
|
rounding_mode |
STRING |
מצב העיגול שמשמש כשמחילים דיוק וקנה מידה על ערכי NUMERIC או BIGNUMERIC עם פרמטרים. אחרת, הערך הוא NULL.
|
data_policies.name |
STRING |
רשימת כללי מדיניות הנתונים שמצורפים לעמודה כדי לשלוט בגישה ובמיסוך. השדה הזה נמצא בגרסת טרום-השקה (Preview). |
data_governance_tags |
ARRAY<STRUCT> |
רשימת תגי משילות המידע (data governance) שמצורפים לעמודה או לשדה בתצוגת עץ כדי לשלוט בגישה ובמיסוך. כל STRUCT מכיל את השדות הבאים של STRING:
|
policy_tags |
ARRAY<STRING> |
רשימת תגי המדיניות שמצורפים לעמודה. |
דוגמאות
בדוגמה הבאה מאחזרים מטא-נתונים מהתצוגה INFORMATION_SCHEMA.COLUMN_FIELD_PATHS של הטבלה commits במערך הנתונים github_repos.
מערך הנתונים הזה הוא חלק מתוכנית מערכי הנתונים שגלויים לכולם ב-BigQuery.
מכיוון שהטבלה שאתם שולחים אליה שאילתה נמצאת בפרויקט אחר, הפרויקט bigquery-public-data, אתם מוסיפים את מזהה הפרויקט למערך הנתונים בפורמט הבא: `project_id`.dataset.INFORMATION_SCHEMA.view, לדוגמה `bigquery-public-data`.github_repos.INFORMATION_SCHEMA.COLUMN_FIELD_PATHS.
הטבלה commits מכילה את העמודות החוזרות והמקוננות הבאות:
-
author: עמודתRECORDבתצוגת עץ -
committer: עמודתRECORDבתצוגת עץ -
trailer: עמודתRECORDבתוך שדה ושדה חוזר -
difference: עמודתRECORDבתוך שדה ושדה חוזר
כדי לראות את המטא-נתונים של העמודות author ו-difference, מריצים את השאילתה הבאה.
SELECT
  *
FROM
  `bigquery-public-data`.github_repos.INFORMATION_SCHEMA.COLUMN_FIELD_PATHS
WHERE
  table_name = 'commits'
  AND (column_name = 'author' OR column_name = 'difference');
התוצאה אמורה להיראות כך: כדי שהתוצאה תהיה קריאה, חלק מהעמודות לא נכללות בה.
  +------------+-------------+---------------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------+-------------+
  | table_name | column_name |     field_path      |                                                                      data_type                                                                      | description | policy_tags |
  +------------+-------------+---------------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------+-------------+
  | commits    | author      | author              | STRUCT<name STRING, email STRING, time_sec INT64, tz_offset INT64, date TIMESTAMP>                                                                  | NULL        | 0 rows      |
  | commits    | author      | author.name         | STRING                                                                                                                                              | NULL        | 0 rows      |
  | commits    | author      | author.email        | STRING                                                                                                                                              | NULL        | 0 rows      |
  | commits    | author      | author.time_sec     | INT64                                                                                                                                               | NULL        | 0 rows      |
  | commits    | author      | author.tz_offset    | INT64                                                                                                                                               | NULL        | 0 rows      |
  | commits    | author      | author.date         | TIMESTAMP                                                                                                                                           | NULL        | 0 rows      |
  | commits    | difference  | difference          | ARRAY<STRUCT<old_mode INT64, new_mode INT64, old_path STRING, new_path STRING, old_sha1 STRING, new_sha1 STRING, old_repo STRING, new_repo STRING>> | NULL        | 0 rows      |
  | commits    | difference  | difference.old_mode | INT64                                                                                                                                               | NULL        | 0 rows      |
  | commits    | difference  | difference.new_mode | INT64                                                                                                                                               | NULL        | 0 rows      |
  | commits    | difference  | difference.old_path | STRING                                                                                                                                              | NULL        | 0 rows      |
  | commits    | difference  | difference.new_path | STRING                                                                                                                                              | NULL        | 0 rows      |
  | commits    | difference  | difference.old_sha1 | STRING                                                                                                                                              | NULL        | 0 rows      |
  | commits    | difference  | difference.new_sha1 | STRING                                                                                                                                              | NULL        | 0 rows      |
  | commits    | difference  | difference.old_repo | STRING                                                                                                                                              | NULL        | 0 rows      |
  | commits    | difference  | difference.new_repo | STRING                                                                                                                                              | NULL        | 0 rows      |
  +------------+-------------+---------------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------+-------------+
צפייה אחת (TABLE_STORAGE)
הסכימה של התצוגות TABLE_STORAGE ו-TABLE_STORAGE_BY_ORGANIZATION היא:
| שם העמודה | סוג נתונים | ערך |
|---|---|---|
project_id |
STRING |
מזהה הפרויקט שמכיל את מערך הנתונים. |
project_number |
INT64 |
מספר הפרויקט שמכיל את מערך הנתונים. |
table_catalog |
STRING |
מזהה הפרויקט שמכיל את מערך הנתונים. |
table_schema |
STRING |
שם מערך הנתונים שמכיל את הטבלה או את התצוגה המהותית, שנקרא גם datasetId. |
table_name |
STRING |
שם הטבלה או התצוגה המהותית, שנקרא גם tableId. |
creation_time |
TIMESTAMP |
מועד היצירה של הטבלה. |
total_rows |
INT64 |
מספר השורות הכולל בטבלה או בתצוגה המהותית. |
total_partitions |
INT64 |
מספר המחיצות שקיימות בטבלה או בתצוגה המהותית. בטבלאות ללא מחיצות מוחזר הערך 0. |
total_logical_bytes |
INT64 |
מספר הבייטים הלוגיים (לא דחוסים) הכולל בטבלה או בתצוגה המהותית. |
active_logical_bytes |
INT64 |
מספר הבייטים הלוגיים (לא דחוסים) שנוצרו לפני פחות מ-90 יום. |
long_term_logical_bytes |
INT64 |
מספר הבייטים הלוגיים (לא דחוסים) שנוצרו לפני יותר מ-90 ימים. |
current_physical_bytes |
INT64 |
מספר הבייטים הפיזיים הכולל של האחסון הנוכחי של הטבלה בכל המחיצות. |
total_physical_bytes |
INT64 |
מספר הבייטים הפיזיים (הדחוסים) הכולל שמשמשים לאחסון, כולל בייטים פעילים, לטווח ארוך ושל Time Travel (נתונים שנמחקו או שונו). הבייטים של Fail-safe (נתונים שנמחקו או שונו ונשמרו אחרי חלון הזמן של Time Travel) לא נכללים. |
active_physical_bytes |
INT64 |
מספר הבייטים הפיזיים (הדחוסים) שנוצרו לפני פחות מ-90 יום, כולל בייטים של נסיעה בזמן (נתונים שנמחקו או שונו). |
long_term_physical_bytes |
INT64 |
מספר הבייטים הפיזיים (הדחוסים) שנוצרו לפני יותר מ-90 ימים. |
time_travel_physical_bytes |
INT64 |
מספר הבייטים הפיזיים (הדחוסים) שמשמשים לאחסון של נתונים שנמחקו או שונו. |
storage_last_modified_time |
TIMESTAMP |
הפעם האחרונה שבה נכתבו נתונים בטבלה. הפונקציה מחזירה את הערך
NULL אם אין נתונים. |
deleted |
BOOLEAN |
מציין אם הטבלה נמחקה או לא. |
table_type |
STRING |
סוג הטבלה. לדוגמה, BASE TABLE.
|
managed_table_type |
STRING |
העמודה הזו נמצאת בגרסת טרום-השקה (Preview). סוג הניהול של הטבלה. לדוגמה,
NATIVE או BIGLAKE.
|
fail_safe_physical_bytes |
INT64 |
מספר הבייטים הפיזיים (הדחוסים) שמשמשים את האחסון למקרה של כשל (נתונים שנמחקו או שונו). |
last_metadata_index_refresh_time |
TIMESTAMP |
המועד האחרון שבו עודכן אינדקס המטא-נתונים של הטבלה. |
table_deletion_reason |
STRING |
הסיבה למחיקת הטבלה אם השדה deleted הוא TRUE. הערכים האפשריים הם:
|
table_deletion_time |
TIMESTAMP |
זמן המחיקה של הטבלה. |
דוגמאות
דוגמה 1:
בדוגמה הבאה מוצג המספר הכולל של בייטים לוגיים שחויבו בפרויקט הנוכחי.
SELECT
  SUM(total_logical_bytes) AS total_logical_bytes
FROM
  `region-REGION`.INFORMATION_SCHEMA.TABLE_STORAGE;
התוצאה אמורה להיראות כך:
+---------------------+
| total_logical_bytes |
+---------------------+
| 971329178274633     |
+---------------------+
דוגמה 2:
בדוגמה הבאה מוצגים בייטים שונים של אחסון ב-GiB ברמת מערכי הנתונים של הפרויקט הנוכחי.
SELECT
  table_schema AS dataset_name,
  -- Logical
  SUM(total_logical_bytes) / power(1024, 3) AS total_logical_gib,
  SUM(active_logical_bytes) / power(1024, 3) AS active_logical_gib,
  SUM(long_term_logical_bytes) / power(1024, 3) AS long_term_logical_gib,
  -- Physical
  SUM(total_physical_bytes) / power(1024, 3) AS total_physical_gib,
  SUM(active_physical_bytes) / power(1024, 3) AS active_physical_gib,
  SUM(active_physical_bytes - time_travel_physical_bytes) / power(1024, 3) AS active_no_tt_physical_gib,
  SUM(long_term_physical_bytes) / power(1024, 3) AS long_term_physical_gib,
  SUM(time_travel_physical_bytes) / power(1024, 3) AS time_travel_physical_gib,
  SUM(fail_safe_physical_bytes) / power(1024, 3) AS fail_safe_physical_gib
FROM
  `region-REGION`.INFORMATION_SCHEMA.TABLE_STORAGE
WHERE
  table_type ='BASE TABLE'
GROUP BY
  table_schema
ORDER BY
  dataset_name
דוגמה 3:
בדוגמה הבאה מוסבר איך לחזות את ההפרש במחיר לכל קבוצת נתונים בין מודלים של חיוב לוגי ופיזי ב-30 הימים הבאים. בדוגמה הזו, ההנחה היא שנפח האחסון הנדרש בעתיד יהיה קבוע ב-30 הימים הבאים מרגע הרצת השאילתה. חשוב לזכור שהתחזית מוגבלת למסדי נתונים טבלאיים, ולא כוללת את כל סוגי הטבלאות האחרים במערך הנתונים.
המחירים שמופיעים במשתני התמחור בשאילתה הזו הם לאזור us-central1. אם רוצים להריץ את השאילתה הזו באזור אחר, צריך לעדכן את משתני התמחור בהתאם. למידע על מחירים, ראו תמחור של Storage.
פותחים את הדף BigQuery במסוף Google Cloud .
מזינים את שאילתת GoogleSQL הבאה בתיבה Query editor. ב-
INFORMATION_SCHEMAנדרש תחביר GoogleSQL. GoogleSQL הוא תחביר ברירת המחדל במסוף Google Cloud .DECLARE active_logical_gib_price FLOAT64 DEFAULT 0.02; DECLARE long_term_logical_gib_price FLOAT64 DEFAULT 0.01; DECLARE active_physical_gib_price FLOAT64 DEFAULT 0.04; DECLARE long_term_physical_gib_price FLOAT64 DEFAULT 0.02; WITH storage_sizes AS ( SELECT table_schema AS dataset_name, -- Logical SUM(IF(deleted=false, active_logical_bytes, 0)) / power(1024, 3) AS active_logical_gib, SUM(IF(deleted=false, long_term_logical_bytes, 0)) / power(1024, 3) AS long_term_logical_gib, -- Physical SUM(active_physical_bytes) / power(1024, 3) AS active_physical_gib, SUM(active_physical_bytes - time_travel_physical_bytes) / power(1024, 3) AS active_no_tt_physical_gib, SUM(long_term_physical_bytes) / power(1024, 3) AS long_term_physical_gib, -- Restorable previously deleted physical SUM(time_travel_physical_bytes) / power(1024, 3) AS time_travel_physical_gib, SUM(fail_safe_physical_bytes) / power(1024, 3) AS fail_safe_physical_gib, FROM `region-REGION`.INFORMATION_SCHEMA.TABLE_STORAGE_BY_PROJECT WHERE total_physical_bytes + fail_safe_physical_bytes > 0 -- Base the forecast on base tables only for highest precision results AND table_type = 'BASE TABLE' GROUP BY 1 ) SELECT dataset_name, -- Logical ROUND(active_logical_gib, 2) AS active_logical_gib, ROUND(long_term_logical_gib, 2) AS long_term_logical_gib, -- Physical ROUND(active_physical_gib, 2) AS active_physical_gib, ROUND(long_term_physical_gib, 2) AS long_term_physical_gib, ROUND(time_travel_physical_gib, 2) AS time_travel_physical_gib, ROUND(fail_safe_physical_gib, 2) AS fail_safe_physical_gib, -- Compression ratio ROUND(SAFE_DIVIDE(active_logical_gib, active_no_tt_physical_gib), 2) AS active_compression_ratio, ROUND(SAFE_DIVIDE(long_term_logical_gib, long_term_physical_gib), 2) AS long_term_compression_ratio, -- Forecast costs logical ROUND(active_logical_gib * active_logical_gib_price, 2) AS forecast_active_logical_cost, ROUND(long_term_logical_gib * long_term_logical_gib_price, 2) AS forecast_long_term_logical_cost, -- Forecast costs physical ROUND((active_no_tt_physical_gib + time_travel_physical_gib + fail_safe_physical_gib) * active_physical_gib_price, 2) AS forecast_active_physical_cost, ROUND(long_term_physical_gib * long_term_physical_gib_price, 2) AS forecast_long_term_physical_cost, -- Forecast costs total ROUND(((active_logical_gib * active_logical_gib_price) + (long_term_logical_gib * long_term_logical_gib_price)) - (((active_no_tt_physical_gib + time_travel_physical_gib + fail_safe_physical_gib) * active_physical_gib_price) + (long_term_physical_gib * long_term_physical_gib_price)), 2) AS forecast_total_cost_difference FROM storage_sizes ORDER BY (forecast_active_logical_cost + forecast_active_physical_cost) DESC;
לוחצים על Run.
התוצאה אמורה להיראות כך:
+--------------+--------------------+-----------------------+---------------------+------------------------+--------------------------+-----------------------------+------------------------------+----------------------------------+-------------------------------+----------------------------------+--------------------------------+
| dataset_name | active_logical_gib | long_term_logical_gib | active_physical_gib | long_term_physical_gib | active_compression_ratio | long_term_compression_ratio | forecast_active_logical_cost | forecast_long_term_logical_cost | forecast_active_physical_cost | forecast_long_term_physical_cost | forecast_total_cost_difference |
+--------------+--------------------+-----------------------+---------------------+------------------------+--------------------------+-----------------------------+------------------------------+----------------------------------+-------------------------------+----------------------------------+--------------------------------+
| dataset1     |               10.0 |                  10.0 |                 1.0 |                    1.0 |                     10.0 |                        10.0 |                          0.2 |                              0.1 |                          0.04 |                             0.02 |                           0.24 |
פתרון בעיות
כדי להפעיל את התצוגה הזו, אפשר להגדיר את הערך של enable_info_schema_storage ל-TRUE בפרויקט או בארגון. למידע נוסף על ניהול ההגדרות, קראו את המאמר ניהול הגדרות אישיות.
אם לא הגדרתם את ההגדרה הזו, תופיע השגיאה הבאה:
INFORMATION_SCHEMA.TABLE_STORAGE hasn't been enabled for project <myproject>.
Consider using one of the following SQL statements to enable data collection:
ALTER PROJECT `<myproject>`
SET OPTIONS (`region-<region>.enable_info_schema_storage` = TRUE)

Or to enable for the entire organization:
ALTER ORGANIZATION
SET OPTIONS (`region-<region>.enable_info_schema_storage` = TRUE)

After enabling, please allow around 1 day for the complete historical data to
become available.
כדי להפעיל את התצוגה, מריצים את הצהרות ה-SQL שמתוארות בהודעת השגיאה.
הצגת רשימת הטבלאות במערך נתונים
אפשר להציג רשימה של טבלאות במערכי נתונים בדרכים הבאות:
- באמצעות מסוף Google Cloud .
- באמצעות הפקודה
bq lsשל כלי שורת הפקודה של BigQuery. - שליחת קריאה ל-method
tables.listשל ה-API. - שימוש בספריות הלקוח.
ההרשאות הנדרשות
כדי להציג רשימה של טבלאות במערך נתונים, אתם צריכים לקבל לפחות את ההרשאות של bigquery.tables.list. התפקידים המוגדרים מראש הבאים ב-IAM כוללים הרשאות bigquery.tables.list:
bigquery.userbigquery.metadataViewerbigquery.dataViewerbigquery.dataEditorbigquery.dataOwnerbigquery.admin
במאמר בקרת גישה מוסבר בהרחבה על התפקידים וההרשאות ב-IAM ב-BigQuery.
הצגת רשימת הטבלאות
כדי להציג את הטבלאות במערך נתונים:
המסוף
בחלונית הניווט במסוף Google Cloud , לוחצים על מערך הנתונים כדי להרחיב אותו. כך מוצגות הטבלאות והתצוגות במערך הנתונים.
גוללים ברשימה כדי לראות את הטבלאות במערך הנתונים. טבלאות ותצוגות מזוהות באמצעות סמלים שונים.
BQ
-
מפעילים את Cloud Shell במסוף Google Cloud .
בחלק התחתון של מסוף Google Cloud יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
מריצים את הפקודה
bq ls. אפשר להשתמש בדגל--formatכדי לשלוט בפלט. אם אתם מציגים טבלאות בפרויקט שהוא לא פרויקט ברירת המחדל, הוסיפו את מזהה הפרויקט למערך הנתונים בפורמט הבא:PROJECT_ID:DATASET.דגלים נוספים:
-
--max_resultsאו-n: מספר שלם שמציין את המספר המקסימלי של התוצאות. ערך ברירת המחדל הוא50.
bq ls \
--format=pretty \
--max_results INTEGER \
PROJECT_ID:DATASET
כאשר:
-
INTEGERהוא מספר שלם שמייצג את מספר הטבלאות שרוצים להציג. -
PROJECT_IDהוא מזהה הפרויקט. -
DATASETהוא שם מערך הנתונים.
כשמריצים את הפקודה, בשדה
Typeמוצג הערךTABLEאוVIEW. לדוגמה:+-------------------------+-------+----------------------+-------------------+ | tableId | Type | Labels | Time Partitioning | +-------------------------+-------+----------------------+-------------------+ | mytable | TABLE | department:shipping | | | myview | VIEW | | | +-------------------------+-------+----------------------+-------------------+
דוגמאות:
מזינים את הפקודה הבאה כדי להציג את רשימת הטבלאות במערך הנתונים
mydatasetבפרויקט ברירת המחדל.bq ls --format=pretty mydataset
מזינים את הפקודה הבאה כדי להחזיר יותר מ-50 טבלאות (פלט ברירת המחדל) מ-
mydataset. mydatasetנמצא בפרויקט ברירת המחדל.bq ls --format=pretty --max_results 60 mydataset
מזינים את הפקודה הבאה כדי להציג את רשימת הטבלאות במערך הנתונים
mydatasetבפרויקטmyotherproject.bq ls --format=pretty myotherproject:mydataset
-
API
כדי להציג רשימה של טבלאות באמצעות ה-API, מפעילים את ה-method tables.list.
C#
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של C# במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery C# API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Ruby
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Ruby במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
היסטוריית טבלת הביקורת
אתם יכולים לבדוק את ההיסטוריה של טבלאות ב-BigQuery באמצעות שליחת שאילתות ביומני הביקורת של Cloud ב-Logs Explorer. היומנים האלה עוזרים לכם לעקוב אחרי מועדי היצירה, העדכון או המחיקה של הטבלאות, ולזהות את המשתמש או את חשבון השירות שביצעו את השינויים.
ההרשאות הנדרשות
כדי לעיין ביומני הביקורת, צריך את התפקיד roles/logging.privateLogViewer. במאמר בקרת גישה באמצעות IAM תוכלו לקרוא מידע נוסף על התפקידים וההרשאות ב-IAM ב-Cloud Logging.
קבלת נתוני ביקורת
אפשר לגשת למידע על הביקורת ממסוף Google Cloud , משורת הפקודה של gcloud, מ-API בארכיטקטורת REST ומכל השפות הנתמכות באמצעות ספריות לקוח. אפשר להשתמש במסנן הרישום ביומן שמוצג בדוגמה הבאה, בלי קשר לשיטה שבה משתמשים.
נכנסים לדף Logging במסוף Google Cloud .
כדי לגשת לנתוני הביקורת, משתמשים בשאילתה הבאה:
logName = "projects/PROJECT_ID/logs/cloudaudit.googleapis.com%2Factivity"
AND resource.type = "bigquery_dataset"
AND timestamp >= "STARTING_TIMESTAMP"
AND protoPayload.@type = "type.googleapis.com/google.cloud.audit.AuditLog"
AND (
  protoPayload.metadata.tableCreation :*
  OR protoPayload.metadata.tableChange :*
  OR protoPayload.metadata.tableDeletion :*
)
AND protoPayload.resourceName : "projects/PROJECT_ID/datasets/DATASET_ID/tables/"
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: הפרויקט שמכיל את מערכי הנתונים והטבלאות שאתם רוצים. -
STARTING_TIMESTAMP: היומנים הכי ישנים שרוצים לראות. צריך להשתמש בפורמט ISO 8601, כמו2025-01-01או2025-02-03T04:05:06Z. -
DATASET_ID: קבוצת הנתונים שרוצים לסנן לפיה.
איך לפרש את התוצאות
בחלונית התוצאות של Logs Explorer, מרחיבים את הרשומה הרלוונטית ולוחצים על Expand nested fields כדי להציג את כל ההודעה.
הרשומה ביומן מכילה רק אחד מהאובייקטים הבאים, שמציין את הפעולה שבוצעה:
-
protoPayload.metadata.tableCreation: נוצרה טבלה. -
protoPayload.metadata.tableChange: המטא-נתונים של הטבלה השתנו, למשל עדכון הסכימה, שינוי התיאור או החלפת הטבלה. -
protoPayload.metadata.tableDeletion: נמחקה טבלה.
התוכן של האובייקטים האלה מתאר את הפעולה המבוקשת.
לתיאור מפורט, ראו BigQueryAuditMetadata.
הסבר על השאילתה
logName = "projects/PROJECT_ID/logs/cloudaudit.googleapis.com%2Factivity": השורה הזו מסננת את יומני הביקורת של פעילות האדמין בפרויקט Google Cloud. ביומנים האלה מתועדות קריאות ל-API ופעולות שמשנות את ההגדרות או את המטא-נתונים של המשאבים.-
resource.type = "bigquery_dataset": מצמצם את החיפוש לאירועים שקשורים למערכי נתונים ב-BigQuery, שבהם מתועדות פעולות בטבלאות. -
timestamp >= "STARTING_TIMESTAMP": מסנן את רשומות היומן כך שיוצגו רק הרשומות שנוצרו בחותמת הזמן שצוינה או אחריה. protoPayload.@type = "type.googleapis.com/google.cloud.audit.AuditLog": מוודא שההודעה ביומן תואמת למבנה הרגיל של יומן הביקורת של Cloud.-
( ... ): הבלוק הזה מקבץ תנאים כדי למצוא סוגים שונים של אירועי טבלה, כפי שמתואר בקטע הקודם. האופרטור:*מציין שהמפתח חייב להיות קיים. אם אתם מעוניינים רק באירוע אחד, כמו יצירת טבלה, הסירו תנאים מיותרים מהבלוק הזה. protoPayload.resourceName : "projects/PROJECT_ID/datasets/DATASET_ID/tables/": בחירת רשומות ביומן שתואמות לטבלאות שכלולות במערך הנתונים שצוין. האופרטור נקודתיים (:) מבצע חיפוש של מחרוזת משנה.- כדי לסנן רשומות של טבלה אחת, מחליפים את התנאי בתנאי הבא:
protoPayload.resourceName = "projects/PROJECT_ID/datasets/DATASET_ID/tables/TABLE_NAME". - כדי לכלול את כל הטבלאות בכל מערכי הנתונים בפרויקט הספציפי, צריך להסיר את התנאי הזה.
- כדי לסנן רשומות של טבלה אחת, מחליפים את התנאי בתנאי הבא:
מידע נוסף על סינון יומנים זמין במאמר שפת השאילתות של הרישום ביומן.
אבטחת טבלאות
כדי לשלוט בגישה לטבלאות ב-BigQuery, קראו את המאמר בקרת גישה למשאבים באמצעות IAM.
המאמרים הבאים
- מידע נוסף על מערכי נתונים זמין במאמר מבוא למערכי נתונים.
- למידע נוסף על טיפול בנתוני טבלאות, ראו ניהול נתוני טבלאות.
- למידע נוסף על ציון סכימות של טבלאות, ראו ציון סכימה.
- למידע נוסף על שינוי סכימות של טבלאות, ראו שינוי סכימות של טבלאות.
- מידע נוסף על ניהול טבלאות זמין במאמר ניהול טבלאות.
- לסקירה כללית על
INFORMATION_SCHEMA, קראו את המאמר מבוא ל-BigQueryINFORMATION_SCHEMA.
נסו בעצמכם
אנחנו ממליצים למשתמשים חדשים ב-Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של BigQuery בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300 $להרצה, לבדיקה ולפריסה של עומסי העבודה.
לניסיון חינם של BigQuery