


טעינת נתוני CSV מ-Cloud Storage
כשאתם טוענים נתוני CSV מ-Cloud Storage, אתם יכולים לטעון את הנתונים לטבלה או למחיצה חדשה, או להוסיף אותם לטבלה או למחיצה קיימת או להחליף אותם. כשהנתונים נטענים ל-BigQuery, הם מומרים לפורמט עמודות עבור Capacitor (פורמט האחסון של BigQuery).
מידע על טעינת נתוני CSV מקובץ מקומי זמין במאמר טעינת נתונים ל-BigQuery ממקור נתונים מקומי.
נסו בעצמכם
אנחנו ממליצים למשתמשים חדשים ב-Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של BigQuery בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300 $להרצה, לבדיקה ולפריסה של עומסי העבודה.
מתנסים ב-BigQuery בחינםמגבלות
כשאתם טוענים נתונים ל-BigQuery מקטגוריה של Cloud Storage, אתם כפופים למגבלות הבאות:
- BigQuery לא מבטיח עקביות נתונים במקורות נתונים חיצוניים. שינויים בנתוני הבסיס בזמן הרצת שאילתה עלולים לגרום להתנהגות לא צפויה.
- BigQuery לא תומך בניהול גרסאות של אובייקטים ב-Cloud Storage. אם כוללים מספר דור ב-URI של Cloud Storage, עבודת הטעינה נכשלת.
כשאתם טוענים קובצי CSV ל-BigQuery, חשוב לשים לב לנקודות הבאות:
- קובצי CSV לא תומכים בנתונים חוזרים או בנתונים בתצוגת עץ.
- מסירים את התווים של סימן סדר הבייטים (BOM). יכול להיות שהם יגרמו לבעיות לא צפויות.
- אם משתמשים בדחיסת gzip, BigQuery לא יכול לקרוא את הנתונים במקביל. טעינת נתוני CSV דחוסים לתוך BigQuery איטית יותר מטעינת נתונים לא דחוסים. מידע נוסף מופיע במאמר טעינת נתונים דחוסים ולא דחוסים.
- אי אפשר לכלול גם קבצים דחוסים וגם קבצים לא דחוסים באותה משימת טעינה.
- הגודל המקסימלי של קובץ gzip הוא 4GB.
- כשמטעינים נתוני CSV באמצעות זיהוי אוטומטי של סכימה, המערכת לא מזהה כותרות באופן אוטומטי אם כל העמודות הן מסוג מחרוזת. במקרה כזה, צריך להוסיף עמודה מספרית לקלט או להצהיר על הסכימה באופן מפורש.
- כשמעלים נתונים בפורמט CSV או JSON, הערכים בעמודות
DATEצריכים להיות מופרדים במקף (-), והתאריך צריך להיות בפורמט הבא:YYYY-MM-DD(שנה-חודש-יום). - כשמעלים נתונים בפורמט JSON או CSV, הערכים בעמודות
TIMESTAMPחייבים להשתמש במקף (-) או בלוכסן (/) כמפריד בחלק של התאריך בחותמת הזמן, והתאריך חייב להיות באחד מהפורמטים הבאים:YYYY-MM-DD(שנה-חודש-יום) אוYYYY/MM/DD(שנה/חודש/יום). החלק של חותמת הזמן שכולל שעה, דקה ושנייה (hh:mm:ss) צריך להיות מופרד באמצעות נקודתיים (:). - הקבצים צריכים לעמוד במגבלות הגודל של קובצי CSV שמתוארות במגבלות על פעולות טעינה.
לפני שמתחילים
מקצים תפקידים של ניהול זהויות והרשאות גישה (IAM) שנותנים למשתמשים את ההרשאות הדרושות לביצוע כל משימה שמופיעה במסמך הזה, ויוצרים מערך נתונים לאחסון הנתונים.
ההרשאות הנדרשות
כדי לטעון נתונים ל-BigQuery, אתם צריכים הרשאות IAM להרצת משימת טעינה ולטעינת נתונים לטבלאות ולמחיצות ב-BigQuery. אם אתם טוענים נתונים מ-Cloud Storage, אתם צריכים גם הרשאות IAM כדי לגשת לקטגוריה שמכילה את הנתונים.
הרשאות לטעינת נתונים ל-BigQuery
כדי לטעון נתונים לטבלה או למחיצה חדשה ב-BigQuery, או כדי להוסיף נתונים לטבלה או למחיצה קיימת או להחליף אותם, אתם צריכים את הרשאות ה-IAM הבאות:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
כל אחד מהתפקידים הבאים שמוגדרים מראש ב-IAM כולל את ההרשאות שנדרשות לטעינת נתונים לטבלה או למחיצה ב-BigQuery:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(כולל את ההרשאהbigquery.jobs.create)bigquery.user(כולל את ההרשאהbigquery.jobs.create)bigquery.jobUser(כולל את ההרשאהbigquery.jobs.create)
בנוסף, אם יש לכם הרשאה ל-bigquery.datasets.create, אתם יכולים ליצור ולעדכן טבלאות באמצעות משימת טעינה במערכי הנתונים שאתם יוצרים.
במאמר תפקידים והרשאות מוגדרים מראש יש מידע נוסף על תפקידים והרשאות ב-IAM ב-BigQuery.
הרשאות לטעינת נתונים מ-Cloud Storage
כדי לקבל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage, צריך לבקש מהאדמין להקצות לכם את תפקיד ה-IAM אדמין לניהול אחסון (roles/storage.admin) בקטגוריה.
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקיד המוגדר מראש הזה כולל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לטעון נתונים מקטגוריה של Cloud Storage, נדרשות ההרשאות הבאות:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
יצירת מערך נתונים
יוצרים מערך נתונים ב-BigQuery לאחסון הנתונים.
דחיסת קובץ CSV
אפשר להשתמש בכלי gzip כדי לדחוס קובצי CSV. שימו לב ש-gzip מבצע דחיסה מלאה של הקובץ, בניגוד לדחיסת תוכן הקובץ שמבוצעת על ידי קודקים לדחיסה עבור פורמטים אחרים של קבצים, כמו Avro. שימוש ב-gzip כדי לדחוס את קובצי ה-CSV עשוי להשפיע על הביצועים. מידע נוסף על היתרונות והחסרונות זמין במאמר טעינת נתונים דחוסים ולא דחוסים.
טעינת נתוני CSV לטבלה
כדי לטעון נתוני CSV מ-Cloud Storage לטבלת BigQuery חדשה, בוחרים באחת מהאפשרויות הבאות:
המסוף
בלחיצה על תראו לי איך תקבלו הסבר מפורט על המשימה ישירות ב-Cloud Shell Editor:
במסוף Google Cloud , עוברים לדף BigQuery.
- בחלונית הימנית, לוחצים על כלי הניתוחים.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ואז בוחרים מערך נתונים.
- בקטע פרטי מערך הנתונים, לוחצים על יצירת טבלה.
- בחלונית Create table, מציינים את הפרטים הבאים:
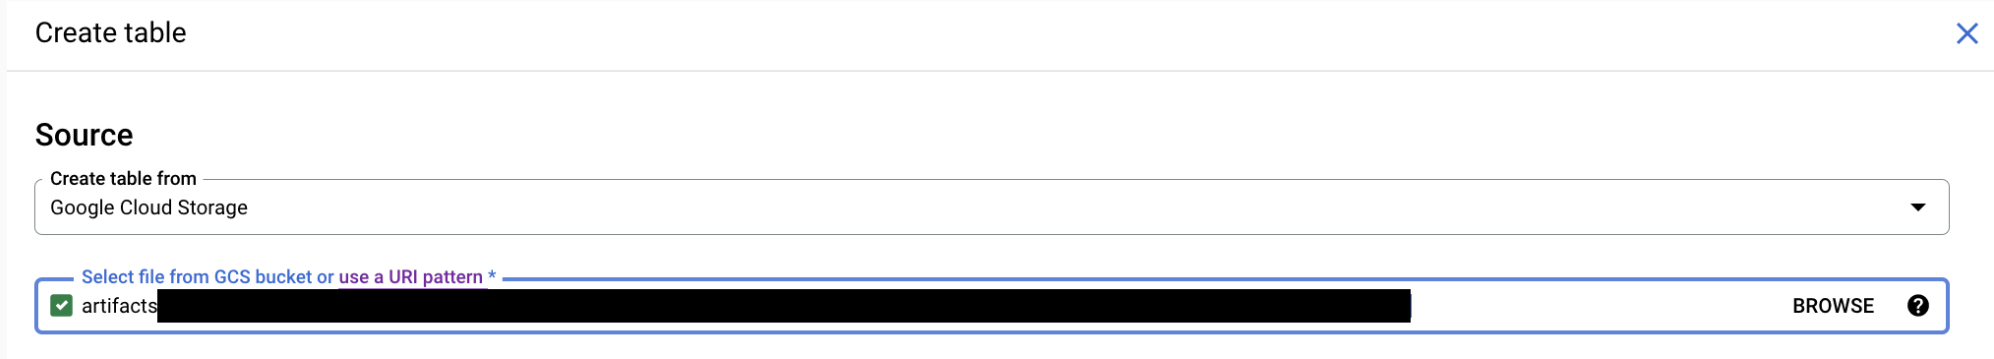
- בקטע מקור, בוחרים באפשרות Google Cloud Storage ברשימה יצירת טבלה מ.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה כתובות URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה נתונים או להחליף אותה.
- בקטע פורמט קובץ, בוחרים באפשרות CSV.
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה כתובות URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה נתונים או להחליף אותה.
- בקטע יעד, מציינים את הפרטים הבאים:
- בקטע Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table (טבלה), מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema (סכימה), מזינים את הגדרת הסכימה.
כדי להפעיל את הזיהוי האוטומטי של סכימה, בוחרים באפשרות זיהוי אוטומטי.
אפשר להזין את פרטי הסכימה באופן ידני באחת מהשיטות הבאות:
- אפשרות 1: לוחצים על Edit as text (עריכה כטקסט) ומדביקים את הסכימה בתור מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שבו יוצרים קובץ סכימת JSON.
כדי לראות את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
bq show --format=prettyjson dataset.table
- אפשרות 2: לוחצים על Add field (הוספת שדה) ומזינים את סכימת הטבלה. מציינים את השם, הסוג, והמצב של כל שדה.
- אפשרות 1: לוחצים על Edit as text (עריכה כטקסט) ומדביקים את הסכימה בתור מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שבו יוצרים קובץ סכימת JSON.
כדי לראות את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
- אופציונלי: מציינים הגדרות של מחיצות ושל אשכולות. מידע נוסף זמין במאמרים בנושא יצירה של טבלאות עם חלוקה למחיצות ויצירה של טבלאות מקובצות ושימוש בהן.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בקטע העדפות כתיבה, משאירים את האפשרות כתיבה אם ריק מסומנת. האפשרות הזו יוצרת טבלה חדשה וטוענת לתוכה את הנתונים.
- בשדה מספר השגיאות המותר, מאשרים את ערך ברירת המחדל
0או מזינים את המספר המקסימלי של שורות שמכילות שגיאות שאפשר להתעלם מהן. אם מספר השורות עם שגיאות גדול מהערך הזה, העבודה תסתיים בהודעהinvalidותיכשל. האפשרות הזו חלה רק על קובצי CSV ו-JSON. - בשדה אזור זמן, מזינים את אזור הזמן שיוגדר כברירת מחדל ויחול על ניתוח של ערכי חותמות זמן שלא צוין עבורם אזור זמן ספציפי. כאן אפשר למצוא שמות נוספים של אזורי זמן תקינים. אם הערך הזה לא מופיע, המערכת מנתחת את ערכי חותמת הזמן בלי אזור זמן ספציפי באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC.
- בשדה פורמט תאריך, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי התאריך בקובצי הקלט. בשדה הזה צריך להזין את הפורמט של SQL (לדוגמה,
MM/DD/YYYY). אם הערך הזה מופיע, זהו פורמט התאריך היחיד שניתן להשתמש בו. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, המערכת מנתחת את השדה DATE באמצעות פורמטים שמוגדרים כברירת מחדל. - בשדה Datetime Format (פורמט של תאריך ושעה), מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי התאריך והשעה בקובצי הקלט.
הפורמט שצריך להזין בשדה הזה הוא פורמט בסגנון SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה מופיע, הפורמט הזה הוא פורמט התאריך והשעה היחיד שנתמך. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, השדה DATETIME מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - בקטע פורמט זמן, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי הזמן בקובצי הקלט. הפורמט שנדרש בשדה הזה הוא פורמט בסגנון SQL (לדוגמה,
HH24:MI:SS.FF3). אם הערך הזה מופיע, זהו פורמט הזמן היחיד שניתן להשתמש בו. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, השדה TIME מנותח באמצעות פורמטי ברירת המחדל. - בשדה פורמט חותמת הזמן, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי חותמת הזמן בקובצי הקלט.
הפורמט שצריך להזין בשדה הזה הוא פורמט בסגנון SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט חותמת הזמן התואם היחיד. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, השדה TIMESTAMP מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - אם רוצים להתעלם מערכים בשורה שלא מופיעים בסכימה של הטבלה, צריך לבחור באפשרות ערכים לא ידועים.
- בקטע Field delimiter (מפריד שדות), בוחרים את התו שמפריד בין התאים בקובץ ה-CSV: Comma (פסיק), Tab (טאב), Pipe (קו אנכי) או Custom (התאמה אישית). אם בוחרים באפשרות בהתאמה אישית, מזינים את התו המפריד בתיבה תו מפריד של שדה בהתאמה אישית. ערך ברירת המחדל הוא Comma.
- בקטע התאמה של עמודת המקור, בוחרים באחת מהאסטרטגיות הבאות שמשמשות להתאמת העמודות שנטענו לסכימה.
-
Default: התנהגות ברירת המחדל נבחרת בהתאם לאופן שבו הסכימה מסופקת. אם ההגדרה 'זיהוי אוטומטי' מופעלת, התנהגות ברירת המחדל היא התאמת עמודות לפי שם. אחרת, ברירת המחדל היא התאמת העמודות לפי מיקום. הפעולה הזו מתבצעת כדי לשמור על תאימות לאחור. -
Position: התאמה בין עמודות לפי מיקום, בהנחה שהעמודות מסודרות באותו אופן כמו הסכימה. -
Name: התאמה לפי שם על ידי קריאת שורת הכותרת כשמות העמודות וסידור מחדש של העמודות כך שיתאימו לשמות השדות בסכימה. שמות העמודות נקראים מהשורה האחרונה שדילגתם עליה, על סמך שורות הכותרת שצריך לדלג עליהן. - בשדה Header rows to skip (שורות כותרת לדילוג), מזינים את מספר שורות הכותרת שרוצים לדלג עליהן בחלק העליון של קובץ ה-CSV. ערך ברירת המחדל הוא
0. - בקטע Quoted newlines (שורות חדשות עם מרכאות), מסמנים את התיבה Allow quoted newlines (התרת שורות חדשות עם מרכאות) כדי לאפשר קטעי נתונים עם מרכאות שמכילים תווי שורה חדשה בקובץ CSV. ערך ברירת המחדל הוא
false. - אם יש שורות לא אחידות, מסמנים את התיבה התרת שורות לא אחידות כדי לאפשר שורות בקובצי CSV שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים כערכי null. אם לא מסמנים את התיבה, רשומות שחסרות בהן עמודות בסוף נחשבות לרשומות פגומות, ואם יש יותר מדי רשומות פגומות, מוחזרת שגיאת פסילה בתוצאת העבודה. ערך ברירת המחדל הוא
false. - בשדה Null markers (סמני ערך NULL), מזינים רשימה של מחרוזות מותאמות אישית שמייצגות ערך NULL בנתוני CSV.
- בקטע הצפנה, לוחצים על מפתח בניהול הלקוח כדי להשתמש במפתח של Cloud Key Management Service. אם לא משנים את ההגדרה Google-managed key, BigQuery יצפין את הנתונים במנוחה.
- לוחצים על יצירת טבלה.
SQL
משתמשים בהצהרת ה-DDL LOAD DATA.
בדוגמה הבאה, קובץ CSV נטען לטבלה החדשה mytable:
במסוף Google Cloud , עוברים לדף BigQuery.
בעורך השאילתות, מזינים את ההצהרה הבאה:
LOAD DATA OVERWRITE mydataset.mytable
(x INT64,y STRING)
FROM FILES (
  format = 'CSV',
  uris = ['gs://bucket/path/file.csv']);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
משתמשים בפקודה bq load, מציינים את CSV באמצעות הדגל --source_format וכוללים URI של Cloud Storage.
אפשר לכלול URI יחיד, רשימה מופרדת בפסיקים של מזהי URI או URI שמכיל תו כללי.
אפשר לספק את הסכימה בשורה, בקובץ הגדרת סכימה או להשתמש בזיהוי אוטומטי של סכימה. אם לא מציינים סכימה, ו---autodetect הוא false, וטבלת היעד קיימת, המערכת משתמשת בסכימה של טבלת היעד.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום.
דגלים אופציונליים אחרים:
-
--allow_jagged_rows: אם מציינים את האפשרות הזו, המערכת מקבלת שורות בקובצי CSV שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים כערכי null. אם לא מסמנים את התיבה, רשומות שחסרות בהן עמודות סופיות נחשבות לרשומות פגומות. אם יש יותר מדי רשומות פגומות, מוחזרת שגיאה לא תקינה בתוצאת העבודה. ערך ברירת המחדל הואfalse. -
--allow_quoted_newlines: כשמציינים את התו הזה, אפשר להשתמש בקובץ CSV בחלקים של נתונים שמוקפים במירכאות ומכילים תווי שורה חדשה. ערך ברירת המחדל הואfalse. -
--field_delimiter: התו שמציין את הגבול בין העמודות בנתונים. אפשר להשתמש גם ב-\tוגם ב-tabכמפרידי טאבים. ערך ברירת המחדל הוא,. -
--null_marker: מחרוזת אופציונלית בהתאמה אישית שמייצגת ערך NULL בנתוני CSV. -
--null_markers: רשימה אופציונלית של מחרוזות מותאמות אישית שמופרדות בפסיקים ומייצגות ערכי NULL בנתוני CSV. אי אפשר להשתמש באפשרות הזו עם הדגל--null_marker. -
--source_column_match: מציין את האסטרטגיה שמשמשת להתאמת העמודות שנטענו לסכימה. אפשר לצייןPOSITIONכדי להתאים עמודות שנטענו לפי מיקום, בהנחה שהעמודות מסודרות באותו אופן כמו הסכימה. אפשר גם לצייןNAMEכדי להתאים לפי שם. לשם כך, צריך לקרוא את שורת הכותרת כשמות העמודות ולשנות את הסדר של העמודות כך שיתאים לשמות השדות בסכימה. אם לא מציינים ערך, ברירת המחדל מבוססת על האופן שבו הסכימה מסופקת. אם ההגדרה--autodetectמופעלת, התנהגות ברירת המחדל היא התאמה של עמודות לפי שם. אחרת, ברירת המחדל היא התאמה בין עמודות לפי מיקום. -
--skip_leading_rows: מציין את מספר שורות הכותרת שצריך לדלג עליהן בחלק העליון של קובץ ה-CSV. ערך ברירת המחדל הוא0. -
--quote: תו המירכאות שמשמש להקפת רשומות. ערך ברירת המחדל הוא". כדי לציין שאין תו מרכאות, משתמשים במחרוזת ריקה. -
--max_bad_records: מספר שלם שמציין את המספר המקסימלי של רשומות פגומות שמותרות לפני שהעבודה כולה נכשלת. ערך ברירת המחדל הוא0. מוחזרות לכל היותר חמש שגיאות מכל סוג, ללא קשר לערך של--max_bad_records. -
--ignore_unknown_values: כשמציינים את הערך הזה, המערכת מתעלמת מערכים נוספים שלא מזוהים בנתוני CSV או JSON. -
--time_zone: אזור זמן אופציונלי שמוגדר כברירת מחדל ויחול על ניתוח של ערכי חותמת זמן שלא צוין להם אזור זמן ספציפי בנתוני CSV או JSON. -
--date_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי התאריך בנתוני CSV או JSON. -
--datetime_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATETIME בנתוני CSV או JSON. -
--time_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIME בנתוני CSV או JSON. -
--timestamp_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי חותמת הזמן בנתוני CSV או JSON. -
--autodetect: אם מציינים את הערך הזה, המערכת מפעילה זיהוי אוטומטי של סכימה לנתוני CSV ו-JSON. -
--time_partitioning_type: הפעלה של חלוקה למחיצות לפי זמן בטבלה והגדרת סוג המחיצה. הערכים האפשריים הםHOUR,DAY,MONTHו-YEAR. הדגל הזה הוא אופציונלי כשיוצרים טבלה עם חלוקה למחיצות בעמודהDATE,DATETIMEאוTIMESTAMP. סוג המחיצה שמוגדר כברירת מחדל לחלוקה למחיצות לפי זמן הואDAY. אי אפשר לשנות את מפרט החלוקה למחיצות בטבלה קיימת. -
--time_partitioning_expiration: מספר שלם שמציין (בשניות) מתי צריך למחוק מחיצה מבוססת-זמן. הערך של תאריך התפוגה הוא התאריך של המחיצה לפי שעון UTC בתוספת הערך המספרי. -
--time_partitioning_field: העמודהDATEאוTIMESTAMPשמשמשת ליצירת טבלה מחולקת למחיצות. אם מפעילים חלוקה למחיצות (partitioning) לפי זמן בלי להגדיר את הערך הזה, נוצרת טבלה מחולקת למחיצות (Partitions) לפי זמני כתיבת הנתונים. -
--require_partition_filter: כשהאפשרות הזו מופעלת, המשתמשים צריכים לכלול פסקהWHEREשמציינת את המחיצות שרוצים לשלוח לגביהן שאילתה. הוספה של מסנן מחיצות יכולה להפחית את העלות ולשפר את הביצועים. מידע נוסף זמין במאמר בנושא שליחת שאילתות לטבלאות מחולקות. -
--clustering_fields: רשימה מופרדת בפסיקים של עד ארבעה שמות עמודות שמשמשים ליצירת טבלה מסודרת באשכולות. -
--destination_kms_key: מפתח Cloud KMS להצפנה של נתוני הטבלה.
--column_name_character_map: מגדיר את ההיקף והטיפול בתווים בשמות העמודות, עם אפשרות להפעיל שמות עמודות גמישים. נדרשת האפשרות--autodetectלקובצי CSV. מידע נוסף זמין במאמרload_option_list.מידע נוסף על הפקודה
bq loadמידע נוסף על טבלאות עם חלוקה למחיצות
מידע נוסף על טבלאות מקובצות זמין במאמרים הבאים:
מידע נוסף על הצפנת טבלאות
כדי לטעון נתוני CSV ל-BigQuery, מזינים את הפקודה הבאה:
bq --location=location load \
--source_format=format \
dataset.table \
path_to_source \
schema
כאשר:
- location הוא המיקום שלכם. הדגל
--locationהוא אופציונלי. לדוגמה, אם אתם משתמשים ב-BigQuery באזור טוקיו, אתם יכולים להגדיר את הערך של הדגל ל-asia-northeast1. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ .bigqueryrc. - format הוא
CSV. - dataset הוא מערך נתונים קיים.
- table הוא שם הטבלה שאליה טוענים את הנתונים.
- path_to_source הוא מזהה URI מלא של Cloud Storage או רשימה של מזהי URI שמופרדים בפסיקים. יש תמיכה גם בתווים כלליים לחיפוש.
- הסכימה schema תקינה. הסכימה יכולה להיות קובץ JSON מקומי, או שאפשר להקליד אותה בשורה כחלק מהפקודה. אפשר גם להשתמש בדגל
--autodetectבמקום לספק הגדרת סכימה.
דוגמאות:
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json.
    bq load \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json. קובץ ה-CSV כולל שתי שורות כותרת.
אם לא מציינים את הערך --skip_leading_rows, ברירת המחדל היא שהקובץ לא מכיל כותרות.
    bq load \
    --source_format=CSV \
    --skip_leading_rows=2
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה מחולקת למחיצות (Partitions) לפי זמני כתיבת הנתונים בשם mytable ב-mydataset. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json.
    bq load \
    --source_format=CSV \
    --time_partitioning_type=DAY \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלת מחיצות חדשה בשם mytable ב-mydataset. הטבלה מחולקת למחיצות לפי העמודה mytimestamp. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json.
    bq load \
    --source_format=CSV \
    --time_partitioning_field mytimestamp \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה בשם mytable ב-mydataset. הסכימה מזוהה באופן אוטומטי.
    bq load \
    --autodetect \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת בשורה בפורמט field:data_type,field:data_type.
    bq load \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    qtr:STRING,sales:FLOAT,year:STRING
הפקודה הבאה טוענת נתונים מכמה קבצים ב-gs://mybucket/ לטבלה בשם mytable ב-mydataset. ה-URI של Cloud Storage משתמש בתו כללי. הסכימה מזוהה באופן אוטומטי.
    bq load \
    --autodetect \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata*.csv
הפקודה הבאה טוענת נתונים מכמה קבצים ב-gs://mybucket/ לטבלה בשם mytable ב-mydataset. הפקודה כוללת רשימה של מזהי URI של Cloud Storage עם תווים כלליים, שמופרדים באמצעות פסיקים. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json.
    bq load \
    --source_format=CSV \
    mydataset.mytable \
    "gs://mybucket/00/*.csv","gs://mybucket/01/*.csv" \
    ./myschema.json
API
יוצרים משימת
loadשמפנה לנתוני המקור ב-Cloud Storage.(אופציונלי) מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשרה.המאפיין
source URIsצריך להיות מוגדר באופן מלא, בפורמטgs://bucket/object. כל URI יכול להכיל תו כללי אחד לחיפוש '*' .מגדירים את מאפיין
sourceFormatלערךCSVכדי לציין את פורמט הנתונים של קובץ ה-CSV.כדי לבדוק את סטטוס העבודה, מתקשרים אל
jobs.get(job_id*), כאשר job_id הוא מזהה העבודה שהוחזר על ידי הבקשה הראשונית.- אם
status.state = DONE, העבודה הושלמה בהצלחה. - אם מאפיין
status.errorResultקיים, הבקשה נכשלה והאובייקט יכלול מידע שמתאר מה השתבש. אם בקשה נכשלת, לא נוצרת טבלה ולא נטען מידע. - אם
status.errorResultלא מופיע, העבודה הסתיימה בהצלחה, אבל יכול להיות שהיו כמה שגיאות לא קריטיות, כמו בעיות בייבוא של כמה שורות. שגיאות לא קריטיות מפורטות במאפייןstatus.errorsשל אובייקט המשימה שמוחזר.
- אם
הערות לגבי ה-API:
משימות הטעינה הן אטומיות ועקביות. אם משימת הטעינה נכשלת, אף אחד מהנתונים לא זמין, ואם משימת הטעינה מצליחה, כל הנתונים זמינים.
מומלץ ליצור מזהה ייחודי ולהעביר אותו כ-
jobReference.jobIdכשמפעילים אתjobs.insertכדי ליצור עבודת טעינה. הגישה הזו עמידה יותר בפני כשלים ברשת, כי הלקוח יכול לבצע בדיקה או לנסות שוב באמצעות מזהה המשימה הידוע.הקריאה אל
jobs.insertעם מזהה משימה נתון היא אידמפוטנטית. אפשר לנסות שוב כמה פעמים שרוצים עם אותו מזהה משימה, ולכל היותר אחת מהפעולות האלה תצליח.
C#
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי C#הוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery C# API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Javaהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי PHPהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
משתמשים בשיטה Client.load_table_from_uri() כדי לטעון נתונים מקובץ CSV ב-Cloud Storage. מספקים הגדרה מפורשת של סכימה על ידי הגדרת המאפיין LoadJobConfig.schema לרשימה של אובייקטים מסוג SchemaField.
Ruby
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Rubyהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
טעינת נתוני CSV לטבלה שמשתמשת בחלוקה למחיצות לפי עמודה
כדי לטעון נתוני CSV מ-Cloud Storage לטבלה ב-BigQuery שמשתמשת בחלוקה לפי זמן שמבוססת על עמודות:
Go
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Javaהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
צירוף נתונים לטבלה או החלפת הנתונים בטבלה באמצעות נתוני CSV
אפשר לטעון נתונים נוספים לטבלה מקובצי מקור או על ידי הוספת תוצאות של שאילתות.
במסוף Google Cloud , משתמשים באפשרות Write preference כדי לציין איזו פעולה לבצע כשמעלים נתונים מקובץ מקור או מתוצאה של שאילתה.
כשמעלים נתונים נוספים לטבלה, יש כמה אפשרויות:
| אפשרות קונסולה | דגל של כלי bq | מאפיין BigQuery API | תיאור |
|---|---|---|---|
| כתיבה אם ריק | לא נתמך | WRITE_EMPTY |
הנתונים ייכתבו רק אם הטבלה ריקה. |
| הוספה לטבלה | --noreplace או --replace=false; אם לא מצוין --[no]replace, ברירת המחדל היא הוספה |
WRITE_APPEND |
(Default) הנתונים מתווספים לסוף הטבלה. |
| החלפת הטבלה | --replace או --replace=true |
WRITE_TRUNCATE |
מוחק את כל הנתונים הקיימים בטבלה לפני כתיבת הנתונים החדשים. הפעולה הזו מוחקת גם את סכימת הטבלה, את האבטחה ברמת השורה ומסירה כל מפתח Cloud KMS. |
אם טוענים נתונים לטבלה קיימת, אפשר להוסיף את הנתונים למשימת הטעינה או להחליף את הטבלה.
המסוף
במסוף Google Cloud , עוברים לדף BigQuery.
- בחלונית הימנית, לוחצים על כלי הניתוחים.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ואז בוחרים מערך נתונים.
- בקטע פרטי מערך הנתונים, לוחצים על יצירת טבלה.
- בחלונית Create table, מציינים את הפרטים הבאים:
- בקטע מקור, בוחרים באפשרות Google Cloud Storage ברשימה יצירת טבלה מ.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה כתובות URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה נתונים או להחליף אותה.
- בקטע פורמט קובץ, בוחרים באפשרות CSV.
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה כתובות URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה נתונים או להחליף אותה.
- בקטע יעד, מציינים את הפרטים הבאים:
- בקטע Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table (טבלה), מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema (סכימה), מזינים את הגדרת הסכימה.
כדי להפעיל את הזיהוי האוטומטי של סכימה, בוחרים באפשרות זיהוי אוטומטי.
אפשר להזין את פרטי הסכימה באופן ידני באחת מהשיטות הבאות:
- אפשרות 1: לוחצים על Edit as text (עריכה כטקסט) ומדביקים את הסכימה בתור מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שבו יוצרים קובץ סכימת JSON.
כדי לראות את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
bq show --format=prettyjson dataset.table
- אפשרות 2: לוחצים על Add field (הוספת שדה) ומזינים את סכימת הטבלה. מציינים את השם, הסוג, והמצב של כל שדה.
- אפשרות 1: לוחצים על Edit as text (עריכה כטקסט) ומדביקים את הסכימה בתור מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שבו יוצרים קובץ סכימת JSON.
כדי לראות את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
- אופציונלי: מציינים הגדרות של מחיצות ושל אשכולות. מידע נוסף זמין במאמרים בנושא יצירה של טבלאות עם חלוקה למחיצות ויצירה של טבלאות מקובצות ושימוש בהן. אי אפשר להמיר טבלה לטבלה מחולקת או לטבלה מסודרת באשכולות על ידי הוספה או החלפה שלה. מסוף Google Cloud לא תומך בהוספה לטבלאות עם חלוקה למחיצות או לטבלאות מקובצות, או בהחלפה שלהן בעבודת טעינה.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בקטע Write preference (העדפת כתיבה), בוחרים באפשרות Append to table (הוספה לטבלה) או Overwrite table (החלפת הטבלה).
- בשדה מספר השגיאות המותר, מאשרים את ערך ברירת המחדל
0או מזינים את המספר המקסימלי של שורות שמכילות שגיאות שאפשר להתעלם מהן. אם מספר השורות עם השגיאות גדול מהערך הזה, העבודה תסתיים בהודעהinvalidותיכשל. האפשרות הזו חלה רק על קובצי CSV ו-JSON. - בשדה אזור זמן, מזינים את אזור הזמן שיוגדר כברירת מחדל ויחול על ניתוח של ערכי חותמות זמן שלא צוין עבורם אזור זמן ספציפי. כאן אפשר למצוא שמות נוספים של אזורי זמן תקינים. אם הערך הזה לא מופיע, המערכת מנתחת את ערכי חותמת הזמן בלי אזור זמן ספציפי באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC.
- בשדה פורמט תאריך, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי התאריך בקובצי הקלט. בשדה הזה צריך להזין את הפורמט של SQL (לדוגמה,
MM/DD/YYYY). אם הערך הזה מופיע, זהו פורמט התאריך היחיד שניתן להשתמש בו. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, המערכת מנתחת את השדה DATE באמצעות פורמטים שמוגדרים כברירת מחדל. - בשדה Datetime Format (פורמט של תאריך ושעה), מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי התאריך והשעה בקובצי הקלט.
הפורמט שצריך להזין בשדה הזה הוא פורמט בסגנון SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה מופיע, הפורמט הזה הוא פורמט התאריך והשעה היחיד שנתמך. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, השדה DATETIME מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - בקטע פורמט זמן, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי הזמן בקובצי הקלט. הפורמט שנדרש בשדה הזה הוא פורמט בסגנון SQL (לדוגמה,
HH24:MI:SS.FF3). אם הערך הזה מופיע, זהו פורמט הזמן היחיד שניתן להשתמש בו. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, השדה TIME מנותח באמצעות פורמטי ברירת המחדל. - בשדה פורמט חותמת הזמן, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי חותמת הזמן בקובצי הקלט.
הפורמט שצריך להזין בשדה הזה הוא פורמט בסגנון SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט חותמת הזמן התואם היחיד. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, השדה TIMESTAMP מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - אם רוצים להתעלם מערכים בשורה שלא מופיעים בסכימה של הטבלה, צריך לבחור באפשרות ערכים לא ידועים.
- בקטע Field delimiter (מפריד שדות), בוחרים את התו שמפריד בין התאים בקובץ ה-CSV: Comma (פסיק), Tab (טאב), Pipe (קו אנכי) או Custom (התאמה אישית). אם בוחרים באפשרות בהתאמה אישית, מזינים את התו המפריד בתיבה תו מפריד של שדה בהתאמה אישית. ערך ברירת המחדל הוא Comma.
- בקטע התאמה של עמודת המקור, בוחרים באחת מהאסטרטגיות הבאות שמשמשות להתאמת העמודות שנטענו לסכימה.
-
Default: התנהגות ברירת המחדל נבחרת בהתאם לאופן שבו הסכימה מסופקת. אם ההגדרה 'זיהוי אוטומטי' מופעלת, התנהגות ברירת המחדל היא התאמת עמודות לפי שם. אחרת, ברירת המחדל היא התאמת העמודות לפי מיקום. הפעולה הזו מתבצעת כדי לשמור על תאימות לאחור. -
Position: התאמה בין עמודות לפי מיקום, בהנחה שהעמודות מסודרות באותו אופן כמו הסכימה. -
Name: התאמה לפי שם על ידי קריאת שורת הכותרת כשמות העמודות וסידור מחדש של העמודות כך שיתאימו לשמות השדות בסכימה. שמות העמודות נקראים מהשורה האחרונה שדילגתם עליה, על סמך שורות הכותרת שצריך לדלג עליהן. - בשדה Header rows to skip (שורות כותרת לדילוג), מזינים את מספר שורות הכותרת שרוצים לדלג עליהן בחלק העליון של קובץ ה-CSV. ערך ברירת המחדל הוא
0. - בקטע Quoted newlines (שורות חדשות עם מרכאות), מסמנים את התיבה Allow quoted newlines (התרת שורות חדשות עם מרכאות) כדי לאפשר קטעי נתונים עם מרכאות שמכילים תווי שורה חדשה בקובץ CSV. ערך ברירת המחדל הוא
false. - אם יש שורות לא אחידות, מסמנים את התיבה התרת שורות לא אחידות כדי לאפשר שורות בקובצי CSV שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים כערכי null. אם לא מסמנים את התיבה, רשומות שחסרות בהן עמודות בסוף נחשבות לרשומות פגומות, ואם יש יותר מדי רשומות פגומות, מוחזרת שגיאת פסילה בתוצאת העבודה. ערך ברירת המחדל הוא
false. - בשדה Null markers (סמני ערך NULL), מזינים רשימה של מחרוזות מותאמות אישית שמייצגות ערך NULL בנתוני CSV.
- בקטע הצפנה, לוחצים על מפתח בניהול הלקוח כדי להשתמש במפתח של Cloud Key Management Service. אם לא משנים את ההגדרה Google-managed key, BigQuery יצפין את הנתונים במנוחה.
- לוחצים על יצירת טבלה.
SQL
משתמשים בהצהרת ה-DDL LOAD DATA.
בדוגמה הבאה, קובץ CSV מצורף לטבלה mytable:
במסוף Google Cloud , עוברים לדף BigQuery.
בעורך השאילתות, מזינים את ההצהרה הבאה:
LOAD DATA INTO mydataset.mytable
FROM FILES (
  format = 'CSV',
  uris = ['gs://bucket/path/file.csv']);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
משתמשים בפקודה bq load, מציינים את CSV באמצעות הדגל --source_format וכוללים URI של Cloud Storage.
אפשר לכלול URI יחיד, רשימה מופרדת בפסיקים של מזהי URI או URI שמכיל תו כללי.
אפשר לספק את הסכימה בשורה, בקובץ הגדרת סכימה או להשתמש בזיהוי אוטומטי של סכימה. אם לא מציינים סכימה, ו---autodetect הוא false, וטבלת היעד קיימת, המערכת משתמשת בסכימה של טבלת היעד.
מציינים את הדגל --replace כדי להחליף את הטבלה. משתמשים בדגל --noreplace כדי לצרף נתונים לטבלה. אם לא מציינים דגל, ברירת המחדל היא הוספת נתונים.
אפשר לשנות את הסכימה של הטבלה כשמוסיפים לה נתונים או מחליפים אותם. מידע נוסף על שינויים נתמכים בסכימה במהלך פעולת טעינה זמין במאמר שינוי סכימות של טבלאות.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום.
דגלים אופציונליים אחרים:
-
--allow_jagged_rows: אם מציינים את האפשרות הזו, המערכת מקבלת שורות בקובצי CSV שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים כערכי null. אם לא מסמנים את התיבה, רשומות שחסרות בהן עמודות סופיות נחשבות לרשומות פגומות. אם יש יותר מדי רשומות פגומות, מוחזרת שגיאה לא תקינה בתוצאת העבודה. ערך ברירת המחדל הואfalse. -
--allow_quoted_newlines: כשמציינים את התו הזה, אפשר להשתמש בקובץ CSV בחלקים של נתונים שמוקפים במירכאות ומכילים תווי שורה חדשה. ערך ברירת המחדל הואfalse. -
--field_delimiter: התו שמציין את הגבול בין העמודות בנתונים. אפשר להשתמש גם ב-\tוגם ב-tabכמפרידי טאבים. ערך ברירת המחדל הוא,. -
--null_marker: מחרוזת אופציונלית בהתאמה אישית שמייצגת ערך NULL בנתוני CSV. -
--null_markers: רשימה אופציונלית של מחרוזות מותאמות אישית מופרדות בפסיקים שמייצגות ערכי NULL בנתוני CSV. אי אפשר להשתמש באפשרות הזו עם הדגל--null_marker. -
--source_column_match: מציין את האסטרטגיה שמשמשת להתאמת העמודות שנטענו לסכימה. אפשר לצייןPOSITIONכדי להתאים עמודות שנטענו לפי מיקום, בהנחה שהעמודות מסודרות באותו אופן כמו הסכימה. אפשר גם לצייןNAMEכדי להתאים לפי שם. לשם כך, צריך לקרוא את שורת הכותרת כשמות העמודות ולשנות את הסדר של העמודות כך שיתאים לשמות השדות בסכימה. אם לא מציינים ערך, ברירת המחדל תהיה תלויה באופן שבו הסכימה מסופקת. אם ההגדרה--autodetectמופעלת, התנהגות ברירת המחדל היא התאמת עמודות לפי שם. אחרת, ברירת המחדל היא התאמת העמודות לפי המיקום. -
--skip_leading_rows: מציין את מספר שורות הכותרת שצריך לדלג עליהן בחלק העליון של קובץ ה-CSV. ערך ברירת המחדל הוא0. -
--quote: תו המירכאות שמשמש להקפת רשומות. ערך ברירת המחדל הוא". כדי לציין שאין תו מרכאות, משתמשים במחרוזת ריקה. -
--max_bad_records: מספר שלם שמציין את המספר המקסימלי של רשומות פגומות שמותרות לפני שהעבודה כולה נכשלת. ערך ברירת המחדל הוא0. מוחזרות לכל היותר חמש שגיאות מכל סוג, ללא קשר לערך של--max_bad_records. -
--ignore_unknown_values: כשמציינים את הערך הזה, המערכת מתעלמת מערכים נוספים שלא מזוהים בנתוני CSV או JSON. -
--time_zone: אזור זמן ברירת מחדל אופציונלי שיחול על ניתוח של ערכי חותמת זמן שלא צוין עבורם אזור זמן ספציפי בנתוני CSV או JSON. -
--date_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי התאריך בנתוני CSV או JSON. -
--datetime_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATETIME בנתוני CSV או JSON. -
--time_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIME בנתוני CSV או JSON. -
--timestamp_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי חותמת הזמן בנתוני CSV או JSON. -
--autodetect: אם מציינים את הערך הזה, המערכת מפעילה זיהוי אוטומטי של סכימה לנתוני CSV ו-JSON. -
--destination_kms_key: מפתח Cloud KMS להצפנה של נתוני הטבלה.
bq --location=location load \
--[no]replace \
--source_format=format \
dataset.table \
path_to_source \
schema
where:
- המיקום שלכם הוא location.
הדגל
--locationהוא אופציונלי. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ .bigqueryrc. - format הוא
CSV. - dataset הוא מערך נתונים קיים.
- table הוא שם הטבלה שאליה טוענים את הנתונים.
- path_to_source הוא מזהה URI מלא של Cloud Storage או רשימה של מזהי URI שמופרדים בפסיקים. יש תמיכה גם בתווים כלליים לחיפוש.
- הסכימה schema תקינה. הסכימה יכולה להיות קובץ JSON מקומי, או שאפשר להקליד אותה בשורה כחלק מהפקודה. אפשר גם להשתמש בדגל
--autodetectבמקום לספק הגדרת סכימה.
דוגמאות:
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv ומחליפה טבלה בשם mytable ב-mydataset. הסכימה מוגדרת באמצעות זיהוי אוטומטי של סכימה.
    bq load \
    --autodetect \
    --replace \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv ומצרפת נתונים לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת באמצעות קובץ סכימת JSON – myschema.json.
    bq load \
    --noreplace \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
API
יוצרים משימת
loadשמפנה לנתוני המקור ב-Cloud Storage.(אופציונלי) מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשרה.המאפיין
source URIsצריך להיות מלא, בפורמטgs://bucket/object. אפשר לכלול כמה מזהי URI ברשימה שמופרדת בפסיקים. שימו לב שאפשר להשתמש גם בתווים כלליים לחיפוש.מגדירים את פורמט הנתונים באמצעות הנכס
configuration.load.sourceFormatלערךCSV.מגדירים את העדפת הכתיבה על ידי הגדרת המאפיין
configuration.load.writeDispositionלערךWRITE_TRUNCATEאוWRITE_APPEND.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Javaהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להחליף את השורות בטבלה קיימת, מגדירים את הערך 'WRITE_TRUNCATE' בפרמטר metadata.writeDisposition
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי PHPהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להחליף את השורות בטבלה קיימת, מגדירים את המאפיין LoadJobConfig.write_disposition לקבוע SourceFormat WRITE_TRUNCATE.
טעינה של נתוני CSV עם חלוקה למחיצות ב-Apache Hive
BigQuery תומך בטעינת נתוני CSV עם חלוקה למחיצות של Apache Hive שמאוחסנים ב-Cloud Storage, ומאכלס את עמודות החלוקה למחיצות של Apache Hive כעמודות בטבלה המנוהלת של BigQuery. מידע נוסף זמין במאמר בנושא טעינה של נתונים שחולקו למחיצות באופן חיצוני.
פרטים על טעינת נתונים בפורמט CSV
בקטע הזה מוסבר איך BigQuery מטפל באפשרויות שונות של עיצוב CSV.
קידוד
ב-BigQuery, נתוני CSV צריכים להיות מקודדים ב-UTF-8. אם יש לכם קובצי CSV עם סוגי קידוד נתמכים אחרים, אתם צריכים לציין במפורש את הקידוד כדי ש-BigQuery יוכל להמיר את הנתונים ל-UTF-8 בצורה תקינה.
BigQuery תומך בסוגי הקידוד הבאים לקובצי CSV:
- UTF-8
- ISO-8859-1
- UTF-16BE (UTF-16 Big Endian)
- UTF-16LE (UTF-16 Little Endian)
- UTF-32BE (UTF-32 Big Endian)
- UTF-32LE (UTF-32 Little Endian)
אם לא מציינים קידוד, או אם מציינים קידוד UTF-8 כשקובץ ה-CSV לא מקודד ב-UTF-8, מערכת BigQuery מנסה להמיר את הנתונים ל-UTF-8. בדרך כלל, אם קובץ ה-CSV מקודד ב-ISO-8859-1, הנתונים ייטענו בהצלחה, אבל יכול להיות שהם לא יהיו בדיוק כמו שציפיתם. אם קובץ ה-CSV מקודד ב-UTF-16BE, ב-UTF-16LE, ב-UTF-32BE או ב-UTF-32LE, יכול להיות שהטעינה תיכשל.
כדי למנוע כשלים לא צפויים, צריך לציין את הקידוד הנכון באמצעות הדגל --encoding.
אם BigQuery לא יכול להמיר תו שהוא לא תו ASCII 0, BigQuery ממיר את התו לתו החלפה סטנדרטי של Unicode: �.
תווי הפרדה בשדות
התווים המפרידים בקובצי CSV יכולים להיות כל תו יחיד של בייט. אם קובץ המקור משתמש בקידוד ISO-8859-1, כל תו יכול להיות תו מפריד. אם קובץ המקור משתמש בקידוד UTF-8, אפשר להשתמש בכל תו בטווח העשרוני 1-127 (U+0001-U+007F) בלי לבצע שינויים. אפשר להוסיף תו ISO-8859-1 מחוץ לטווח הזה כתו מפריד, ו-BigQuery יפרש אותו בצורה נכונה. עם זאת, אם משתמשים בתו מרובה-בייטים כמפריד, חלק מהבייטים יפורשו בצורה שגויה כחלק מערך השדה.
בדרך כלל מומלץ להשתמש בתו מפריד רגיל, כמו Tab, | או ,. ברירת המחדל היא פסיק.
סוגי הנתונים
בוליאני. BigQuery יכול לנתח כל אחת מהזוגות הבאים של נתונים בוליאניים: 1 או 0, true או false, t או f, yes או no, או y או n (כל האפשרויות לא תלויות באותיות רישיות). זיהוי אוטומטי של סכימה מזהה באופן אוטומטי כל אחת מהאפשרויות האלה, חוץ מ-0 ו-1.בייטים. עמודות עם סוגי BYTES חייבות להיות בקידוד Base64.
תאריך. העמודות עם סוגי הנתונים DATE חייבות להיות בפורמט YYYY-MM-DD.
תאריך ושעה. העמודות עם סוגי DATETIME צריכות להיות בפורמט YYYY-MM-DD
HH:MM:SS[.SSSSSS].
מיקום גיאוגרפי. עמודות עם סוגי נתונים מסוג GEOGRAPHY חייבות להכיל מחרוזות באחד מהפורמטים הבאים:
- טקסט מוכר (WKT)
- Well-known binary (WKB)
- GeoJSON
אם משתמשים ב-WKB, הערך צריך להיות מקודד הקסדצימלית.
הרשימה הבאה כוללת דוגמאות לנתונים תקינים:
- WKT:
POINT(1 2) - GeoJSON:
{ "type": "Point", "coordinates": [1, 2] } - WKB מקודד הקסדצימלית:
0101000000feffffffffffef3f0000000000000040
לפני שטוענים נתוני מיקום גיאוגרפי, כדאי לקרוא גם את המאמר בנושא טעינת נתונים גיאו-מרחביים.
אינטרוול. עמודות עם סוגים של INTERVAL צריכות להיות בפורמט Y-M D H:M:S[.F], כאשר:
- Y = שנה. הטווח הנתמך הוא 0 עד 10,000.
- M = Month. הטווח הנתמך הוא 1-12.
- D = יום. הטווח הנתמך הוא 1-[היום האחרון של החודש שצוין].
- H = שעה.
- M = דקה.
- S = Second (שנייה).
- [.F] = חלקיקי שנייה עד שש ספרות, עם דיוק של מיקרו-שנייה.
כדי לציין ערך שלילי, מוסיפים מקף (-) לפני המספר.
הרשימה הבאה כוללת דוגמאות לנתונים תקינים:
10-6 0 0:0:00-0 -5 0:0:00-0 0 0:0:1.25
כדי לטעון נתונים מסוג INTERVAL, צריך להשתמש בפקודה bq load ובדגל --schema כדי לציין סכימה. אי אפשר להעלות נתוני INTERVAL באמצעות המסוף.
JSON. כדי להוסיף תו בריחה לגרשיים, משתמשים ברצף שני התווים "". למידע נוסף, אפשר לעיין בדוגמה של טעינת נתוני JSON מקובץ CSV
זמן. העמודות עם סוגי TIME צריכות להיות בפורמט HH:MM:SS[.SSSSSS].
חותמת זמן. BigQuery מקבל פורמטים שונים של חותמות זמן. חותמת הזמן חייבת לכלול חלק של תאריך וחלק של שעה.
החלק של התאריך יכול להיות בפורמט
YYYY-MM-DDאוYYYY/MM/DD.הפורמט של חותמת הזמן צריך להיות
HH:MM[:SS[.SSSSSS]](השניות והחלקים של השניות הם אופציונליים).התאריך והשעה צריכים להיות מופרדים ברווח או באות T.
אופציונלית, אחרי התאריך והשעה יכולה להופיע סטייה משעון UTC או המזהה של אזור הזמן UTC (
Z). מידע נוסף זמין במאמר בנושא אזורי זמן.
לדוגמה, כל אחד מהערכים הבאים הוא חותמת זמן תקינה:
2018-08-19T12:112018-08-19T12:11:352018-08-19T12:11:35.222018/08/19T12:112018-07-05T12:54:00 UTC2018-08-19T07:11:35.220 -05:002018-08-19T12:11:35.220Z
אם מספקים סכימה, BigQuery מקבל גם זמן יוניקס (Unix epoch) עבור ערכי חותמות זמן. עם זאת, המערכת לא מזהה את המקרה הזה בזיהוי אוטומטי של סכימה, והיא מתייחסת לערך כאל סוג מספרי או מחרוזת.
דוגמאות לערכים של חותמת זמן של מערכת Unix:
- 1534680695
- 1.534680695e12
RANGE. הפורמט בקובצי CSV הוא:
[LOWER_BOUND, UPPER_BOUND),
כאשר LOWER_BOUND ו-UPPER_BOUND
הם מחרוזות תקינות של DATE, DATETIME או TIMESTAMP. NULL ו-UNBOUNDED מייצגים ערכי התחלה או סיום לא מוגבלים.
הדוגמאות הבאות מציגות ערכי CSV עבור RANGE<DATE>:
"[2020-01-01, 2021-01-01)""[UNBOUNDED, 2021-01-01)""[2020-03-01, NULL)""[UNBOUNDED, UNBOUNDED)"
זיהוי אוטומטי של סכימה
בקטע הזה מוסבר איך מתבצע זיהוי אוטומטי של סכימה כשמעלים קובצי CSV.
תו מפריד ב-CSV
מערכת BigQuery מזהה את התווים הבאים להפרדה בין ערכים:
- פסיק ( , )
- קו אנכי ( | )
- Tab ( \t )
כותרת CSV
מערכת BigQuery מסיקה את הכותרות על ידי השוואה בין השורה הראשונה בקובץ לבין שורות אחרות בקובץ. אם השורה הראשונה מכילה רק מחרוזות, והשאר השורות מכילות סוגי נתונים אחרים, מערכת BigQuery מניחה שהשורה הראשונה היא שורת כותרת. מערכת BigQuery מקצה שמות לעמודות על סמך שמות השדות בשורת הכותרת. יכול להיות שהשמות ישתנו כדי לעמוד בכללי מתן השמות לעמודות ב-BigQuery. לדוגמה, רווחים מוחלפים בקווים תחתונים.
אחרת, מערכת BigQuery מניחה שהשורה הראשונה היא שורת נתונים, ומקצה שמות כלליים לעמודות, כמו string_field_1. שימו לב: אחרי שיוצרים טבלה, אי אפשר לעדכן את שמות העמודות בסכימה, אבל אפשר לשנות את השמות באופן ידני אחרי שיוצרים את הטבלה. אפשרות נוספת היא לספק סכימה מפורשת במקום להשתמש בזיהוי אוטומטי.
יכול להיות שיש לכם קובץ CSV עם שורת כותרת, שכל שדות הנתונים בו הם מחרוזות. במקרה כזה, BigQuery לא יזהה אוטומטית שהשורה הראשונה היא כותרת. משתמשים באפשרות --skip_leading_rows כדי לדלג על שורת הכותרת. אחרת, הכותרת מיובאת כנתונים. במקרה כזה, כדאי גם לספק סכימה מפורשת כדי שתוכלו להקצות שמות לעמודות.
שורות חדשות עם מרכאות בקובץ CSV
מערכת BigQuery מזהה תווי שורה חדשים בתוך שדה CSV, ולא מפרשת את תווי השורה החדשים שמוקפים במירכאות כגבול שורה.
פתרון בעיות
כשמזהים באופן אוטומטי סכימה לקובצי CSV, יכול להיות שתיתקלו בשגיאה הבאה:
שגיאה: Error while reading data, error message: CSV processing encountered
too many errors, giving up.
השגיאה הזו יכולה להתרחש אם בקובץ ה-CSV יש שורת כותרת עם ערכי מחרוזת, ו-BigQuery לא זיהה אותה ככותרת. אפשר להשתמש באפשרות --skip_leading_rows כדי לדלג על שורת הכותרת.
פתרון בעיות בטעינת נתוני CSV
בקטעים הבאים מוסבר איך לפתור שגיאות נפוצות בניתוח ובמכסות כשמעלים קובצי CSV ל-BigQuery.
פתרון בעיות בניתוח
אם יש בעיה בניתוח קובצי ה-CSV, פרטי השגיאה יופיעו בerrors משאב של משימת הטעינה.
בדרך כלל, השגיאות האלה מציינות את תחילת השורה הבעייתית עם היסט של בייט. כדי לגשת לשורה הרלוונטית בקבצים לא דחוסים, אפשר להשתמש ב-gcloud storage עם הארגומנט --recursive.
לדוגמה, מריצים את הפקודה bq load ומקבלים שגיאה:
bq load
    --skip_leading_rows=1 \
    --source_format=CSV \
    mydataset.mytable \
    gs://my-bucket/mytable.csv \
    'Number:INTEGER,Name:STRING,TookOffice:STRING,LeftOffice:STRING,Party:STRING'
השגיאה בפלט אמורה להיראות כך:
Waiting on bqjob_r5268069f5f49c9bf_0000018632e903d7_1 ... (0s)
Current status: DONE
BigQuery error in load operation: Error processing job
'myproject:bqjob_r5268069f5f49c9bf_0000018632e903d7_1': Error while reading
data, error message: Error detected while parsing row starting at position: 1405.
Error: Data between close quote character (") and field separator.
File: gs://my-bucket/mytable.csv
Failure details:
- gs://my-bucket/mytable.csv: Error while reading data,
error message: Error detected while parsing row starting at
position: 1405. Error: Data between close quote character (") and
field separator. File: gs://my-bucket/mytable.csv
- Error while reading data, error message: CSV processing encountered
too many errors, giving up. Rows: 22; errors: 1; max bad: 0; error
percent: 0
על סמך השגיאה הקודמת, יש שגיאת פורמט בקובץ.
כדי לראות את תוכן הקובץ, מריצים את הפקודה gcloud storage cat:
gcloud storage cat 1405-1505 gs://my-bucket/mytable.csv --recursive
הפלט אמור להיראות כך:
16,Abraham Lincoln,"March 4, 1861","April 15, "1865,Republican
18,Ulysses S. Grant,"March 4, 1869",
...
על סמך הפלט של הקובץ, הבעיה היא מירכאות במקום לא נכון ב-"April 15, "1865.
קבצי CSV דחוסים
קשה יותר לנפות שגיאות בניתוח של קובצי CSV דחוסים, כי היסט הבייטים שמדווח מתייחס למיקום בקובץ לא דחוס.
הפקודה gcloud storage cat הבאה מעבירה את הקובץ מ-Cloud Storage, מבצעת דקומפרסיה של הקובץ, מזהה את היסט הבייטים המתאים ומדפיסה את השורה עם שגיאת הפורמט:
gcloud storage cat gs://my-bucket/mytable.csv.gz | gunzip - | tail -c +1406 | head -n 1
הפלט אמור להיראות כך:
16,Abraham Lincoln,"March 4, 1861","April 15, "1865,Republican
פתרון בעיות שקשורות למכסות
המידע בקטע הזה יעזור לכם לפתור בעיות שקשורות למכסות או למגבלות בטעינת קובצי CSV ל-BigQuery.
אם טוענים קובץ CSV גדול באמצעות הפקודה bq load עם הדגל --allow_quoted_newlines, יכול להיות שתיתקלו בשגיאה הזו.
הודעת שגיאה
Input CSV files are not splittable and at least one of the files is larger than
the maximum allowed size. Size is: ...
רזולוציה
כדי לפתור את השגיאה שקשורה למכסת השימוש, צריך לבצע את הפעולות הבאות:
- מגדירים את הדגל
--allow_quoted_newlinesלערךfalse. - מפצלים את קובץ ה-CSV לחלקים קטנים יותר, שכל אחד מהם קטן מ-4GB.
מידע נוסף על המגבלות שחלות כשמעלים נתונים ל-BigQuery זמין במאמר בנושא עבודות טעינה.
אפשרויות CSV
כדי לשנות את האופן שבו BigQuery מנתח נתוני CSV, מציינים אפשרויות נוספות ב Google Cloud מסוף, בכלי שורת הפקודה של BigQuery או ב-API.
מידע נוסף על פורמט CSV זמין ב-RFC 4180.
| אפשרות CSV | אפשרות קונסולה | דגל של כלי bq | מאפיין BigQuery API | תיאור |
|---|---|---|---|---|
| תו מפריד בין שדות | תוחם שדות: פסיק, Tab, קו אנכי, בהתאמה אישית | -F או --field_delimiter |
fieldDelimiter
(Java,
Python)
|
(אופציונלי) התו המפריד בין השדות בקובץ CSV. התו המפריד יכול להיות כל תו חד-בייטי בתקן ISO-8859-1. BigQuery ממיר את המחרוזת לקידוד ISO-8859-1, ומשתמש בבייט הראשון של המחרוזת המקודדת כדי לפצל את הנתונים במצב הבינארי הגולמי שלהם. BigQuery תומך גם ברצף התווים '\t' כדי לציין מפריד של טאב. ערך ברירת המחדל הוא פסיק (`,`). |
| שורות כותרת | שורות כותרת לדילוג | --skip_leading_rows |
skipLeadingRows
(Java,
Python)
|
(אופציונלי) מספר שלם שמציין את מספר שורות הכותרת בנתוני המקור. |
| התאמה לעמודת המקור | התאמה של עמודת המקור: ברירת מחדל, מיקום, שם | --source_column_match |
sourceColumnMatch
(Java,
Python) |
(אופציונלי) ההגדרה הזו קובעת את האסטרטגיה שמשמשת להתאמת העמודות שנטענו לסכימה.
הערכים הנתמכים כוללים:
|
| מספר הרשומות הפגומות שמותרות | מספר השגיאות המותר | --max_bad_records |
maxBadRecords
(Java,
Python)
|
(אופציונלי) המספר המקסימלי של רשומות פגומות ש-BigQuery יכול להתעלם מהן במהלך הרצת העבודה. אם מספר הרשומות הפגומות גדול מהערך הזה, תוחזר שגיאה לא תקינה בתוצאת העבודה. ערך ברירת המחדל הוא 0, שמשמעותו שכל הרשומות צריכות להיות תקינות. |
| תווים של שורה חדשה | אפשר להשתמש בתווי שורה חדשה בתוך מרכאות | --allow_quoted_newlines |
allowQuotedNewlines
(Java,
Python)
|
(אופציונלי) מציין אם לאפשר קטעי נתונים עם מרכאות שמכילים תווי שורה חדשה בקובץ CSV. ערך ברירת המחדל הוא False. |
| ערכי null מותאמים אישית | ללא | --null_marker |
nullMarker
(Java,
Python)
|
(אופציונלי) מציין מחרוזת שמייצגת ערך null בקובץ CSV. לדוגמה, אם מציינים את הערך '\N', BigQuery מפרש את הערך '\N' כערך null כשמעלים קובץ CSV. ערך ברירת המחדל הוא מחרוזת ריקה. אם מגדירים את המאפיין הזה לערך מותאם אישית, BigQuery מציג שגיאה אם יש מחרוזת ריקה לכל סוגי הנתונים, למעט STRING ו-BYTE. בעמודות מסוג STRING ו-BYTE, BigQuery מפרש את המחרוזת הריקה כערך ריק. |
| עמודות אופציונליות בסוף | התרת שורות משוננות | --allow_jagged_rows |
allowJaggedRows
(Java,
Python)
|
(אופציונלי) אפשר לאשר שורות שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים כערכי null. אם הערך הוא false, רשומות שחסרות בהן עמודות סופיות מטופלות כרשומות פגומות, ואם יש יותר מדי רשומות פגומות, מוחזרת שגיאה לא תקינה בתוצאת העבודה. ערך ברירת המחדל הוא False. המאפיין הזה רלוונטי רק לקובצי CSV. המערכת מתעלמת ממנו בפורמטים אחרים. |
| ערכים לא ידועים | התעלמות מערכים לא ידועים | --ignore_unknown_values |
ignoreUnknownValues
(Java,
Python)
|
(אופציונלי) מציין אם BigQuery צריך לאפשר ערכים נוספים שלא מיוצגים בסכימת הטבלה. אם הערך הוא true, המערכת מתעלמת מהערכים הנוספים. אם הערך הוא false, רשומות עם עמודות נוספות נחשבות לרשומות פגומות, ואם יש יותר מדי רשומות פגומות, מוחזרת שגיאה לא חוקית בתוצאת העבודה. ערך ברירת המחדל הוא False. המאפיין
sourceFormat קובע מה נחשב ב-BigQuery
כערך נוסף:
|
| ציטוט | תו המירכאות: מירכאות כפולות, מירכאות בודדות, ללא, מותאם אישית | --quote |
quote
(Java,
Python)
|
(אופציונלי) הערך שמשמש להוספת מרכאות לחלקים של נתונים בקובץ CSV.
BigQuery ממיר את המחרוזת לקידוד ISO-8859-1, ואז משתמש בבייט הראשון של המחרוזת המקודדת כדי לפצל את הנתונים במצב הבינארי הגולמי שלהם. ערך ברירת המחדל הוא מירכאות כפולות ("). אם הנתונים לא מכילים חלקים שמוקפים במירכאות, צריך להגדיר את ערך המאפיין כמחרוזת ריקה. אם הנתונים מכילים תווי שורה חדשה בתוך מרכאות, צריך להגדיר את המאפיין allowQuotedNewlines לערך true. כדי לכלול את תו המירכאות הספציפי בתוך ערך שתחום במירכאות, צריך להוסיף לפניו תו מירכאות תואם נוסף. לדוגמה, אם רוצים להשתמש בתו בריחה (escape) לתו ברירת המחדל ' " ', צריך להשתמש ב-' "" '. |
| קידוד | ללא | -E או --encoding |
encoding
(Java,
Python) |
(אופציונלי) קידוד התווים של הנתונים. הערכים הנתמכים הם:
UTF-8, ISO-8859-1, UTF-16BE, UTF-16LE, UTF-32BE, או UTF-32LE.
ערך ברירת המחדל הוא UTF-8. BigQuery מפענח את הנתונים אחרי שהנתונים הגולמיים הבינאריים פוצלו באמצעות הערכים של המאפיינים quote ו-fieldDelimiter. |
| תו בקרה של ASCII | ללא | --preserve_ascii_control_characters |
ללא | (אופציונלי) אם רוצים לאפשר את ASCII 0 ותווי בקרה אחרים של ASCII, צריך להגדיר את --preserve_ascii_control_characters לערך true בעבודות הטעינה. |
| סמני Null | סמני Null | --null_markers |
nullMarkers
(Java,
Python) |
(אופציונלי)
רשימה של מחרוזות מותאמות אישית שמייצגות ערך NULL בנתוני CSV. אי אפשר להשתמש באפשרות הזו עם האפשרות --null_marker. |
| אזור זמן | אזור זמן | --time_zone |
timeZone
(Java,
Python) |
(אופציונלי) אזור הזמן שמוגדר כברירת מחדל שיחול כשמנתחים ערכי חותמת זמן שלא צוין להם אזור זמן ספציפי. בודקים את השמות התקינים של אזורי הזמן. אם הערך הזה לא מופיע, המערכת מנתחת את ערכי חותמת הזמן בלי אזור זמן ספציפי באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC. |
| פורמט התאריך | פורמט התאריך | --date_format |
dateFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי התאריך בקובצי הקלט (לדוגמה, MM/DD/YYYY). אם הערך הזה מופיע, הפורמט הזה הוא פורמט התאריך התואם היחיד.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא מופיע, המערכת מנתחת את שדה התאריך באמצעות פורמטים שמוגדרים כברירת מחדל. |
| פורמט של תאריך ושעה | פורמט של תאריך ושעה | --datetime_format |
datetimeFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי התאריך והשעה בקובצי הקלט (לדוגמה, MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה מופיע,
הפורמט הזה הוא הפורמט היחיד של תאריך ושעה שמתאים.
זיהוי אוטומטי של סכימה
יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום
הפורמט הקיים. אם הערך הזה לא קיים, השדה DATETIME מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. |
| פורמט השעה | פורמט השעה | --time_format |
timeFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי הזמן בקובצי הקלט (לדוגמה, HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט הזמן התואם היחיד.
זיהוי אוטומטי של סכימה
יקבע גם את סוג העמודה TIME על סמך הפורמט הזה במקום
הפורמט הקיים. אם הערך הזה לא מופיע, השדה TIME מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. |
| פורמט חותמת הזמן | פורמט חותמת הזמן | --timestamp_format |
timestampFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי חותמת הזמן בקובצי הקלט (לדוגמה, MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים,
הפורמט הזה הוא הפורמט היחיד של חותמת הזמן שתואם.
זיהוי אוטומטי של סכימה
יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום
הפורמט הקיים. אם הערך הזה לא מופיע, השדה TIMESTAMP מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. |