


Externe Spanner-Datasets erstellen
Mit externen Datasets (auch als föderierte Datasets bezeichnet) können Sie Transaktionsdaten in Spanner von BigQuery aus mit GoogleSQL abfragen, ohne die Daten in den BigQuery-Speicher zu kopieren oder zu importieren. Ein externes Dataset verknüpft ein BigQuery-Dataset mit einer vorhandenen GoogleSQL- oder PostgreSQL-Datenbank in Spanner. Die schreibgeschützten Tabellen spiegeln automatisch die Tabellen und Aktualisierungen in dieser Datenbank wider.
In diesem Dokument wird beschrieben, wie Sie ein externes Spanner-Dataset erstellen, abfragen und verwalten.
Erforderliche Berechtigungen
Bitten Sie Ihren Administrator, Ihnen die IAM-Rolle BigQuery-Nutzer (roles/bigquery.user) zuzuweisen, um die Berechtigung zu erhalten, die Sie zum Erstellen eines externen Datasets benötigen.
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierte Rolle enthält die Berechtigung bigquery.datasets.create, die zum Erstellen eines externen Datasets erforderlich ist.
Sie können diese Berechtigung auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Weitere Informationen zu IAM-Rollen und Berechtigungen in BigQuery finden Sie unter Einführung in IAM.
CLOUD_RESOURCE-Verbindung verwenden
Optional können externe Spanner-Datasets eine CLOUD_RESOURCE-Verbindung verwenden, um mit Ihrer Spanner-Datenbank zu interagieren. So können Sie einem Nutzer über BigQuery Zugriff auf Spanner-Daten gewähren, ohne ihm direkten Zugriff auf die Spanner-Datenbank zu geben. Da das Dienstkonto der Verbindung CLOUD_RESOURCE das Abrufen von Daten aus Cloud Spanner übernimmt, müssen Sie Nutzern nur Zugriff auf das externe Cloud Spanner-Dataset gewähren.
Bevor Sie externe Spanner-Datasets mit einer CLOUD_RESOURCE-Verbindung erstellen, müssen Sie Folgendes tun:
Verbindung herstellen
Sie können eine CLOUD_RESOURCE-Verbindung erstellen oder eine vorhandene verwenden, um eine Verbindung zu Spanner herzustellen. Erstellen Sie die Verbindung am selben Standort, an dem Sie Ihr externes Cloud Spanner-Dataset erstellen möchten.
Console
Rufen Sie die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
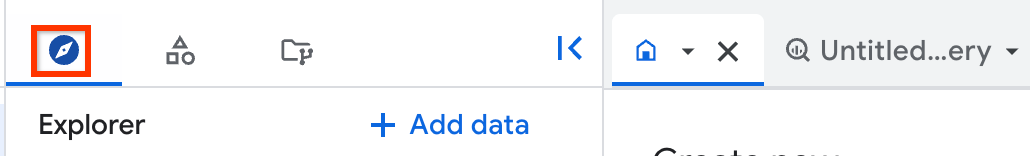
Wenn der linke Bereich nicht angezeigt wird, klicken Sie auf Linken Bereich maximieren, um ihn zu öffnen.
Maximieren Sie im Bereich Explorer den Namen Ihres Projekts und klicken Sie dann auf Verbindungen.
Klicken Sie auf der Seite Verbindungen auf Verbindung erstellen.
Wählen Sie als Verbindungstyp die Option Vertex AI-Remote-Modelle, Remote-Funktionen, BigLake und Cloud Spanner (Cloud-Ressource) aus.
Geben Sie im Feld Verbindungs-ID einen Namen für die Verbindung ein.
Wählen Sie unter Standorttyp einen Standort für die Verbindung aus. Die Verbindung sollte sich am selben Ort wie Ihre anderen Ressourcen, z. B. Datasets, befinden.
Klicken Sie auf Verbindung erstellen.
Klicken Sie auf Zur Verbindung.
Kopieren Sie im Bereich Verbindungsinformationen die Dienstkonto-ID zur Verwendung in einem späteren Schritt.
SQL
Verwenden Sie die Anweisung CREATE CONNECTION:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Geben Sie im Abfrageeditor die folgende Anweisung ein:
CREATE CONNECTION [IF NOT EXISTS] `CONNECTION_NAME`
OPTIONS (
  connection_type = "CLOUD_RESOURCE",
  friendly_name = "FRIENDLY_NAME",
  description = "DESCRIPTION"
  );
Ersetzen Sie Folgendes:
-
CONNECTION_NAME: der Name der Verbindung im FormatPROJECT_ID.LOCATION.CONNECTION_ID,LOCATION.CONNECTION_IDoderCONNECTION_ID. Wenn das Projekt oder der Standort weggelassen wird, werden sie aus dem Projekt und dem Standort abgeleitet, an dem die Anweisung ausgeführt wird. -
FRIENDLY_NAME(optional): Ein beschreibender Name für die Verbindung. -
DESCRIPTION(optional): Eine Beschreibung der Verbindung.
-
Klicken Sie auf Ausführen.
Informationen zum Ausführen von Abfragen finden Sie unter Interaktive Abfrage ausführen.
bq
Erstellen Sie in einer Befehlszeilenumgebung eine Verbindung:
bq mk --connection --location=REGION --project_id=PROJECT_ID \
    --connection_type=CLOUD_RESOURCE CONNECTION_ID
Der Parameter
--project_idüberschreibt das Standardprojekt.Ersetzen Sie dabei Folgendes:
REGION: Ihre VerbindungsregionPROJECT_ID: Ihre Projekt-ID in Google CloudCONNECTION_ID: eine ID für Ihre Verbindung
Wenn Sie eine Verbindungsressource herstellen, erstellt BigQuery ein eindeutiges Systemdienstkonto und ordnet es der Verbindung zu.
Fehlerbehebung:Wird der folgende Verbindungsfehler angezeigt, aktualisieren Sie das Google Cloud SDK:
Flags parsing error: flag --connection_type=CLOUD_RESOURCE: value should be one of...
Rufen Sie die Dienstkonto-ID ab und kopieren Sie sie zur Verwendung in einem späteren Schritt:
bq show --connection PROJECT_ID.REGION.CONNECTION_ID
Die Ausgabe sieht etwa so aus:
name                          properties
1234.REGION.CONNECTION_ID     {"serviceAccountId": "connection-1234-9u56h9@gcp-sa-bigquery-condel.iam.gserviceaccount.com"}
Python
Bevor Sie dieses Beispiel anwenden, folgen Sie den Schritten zur Einrichtung von Python in der BigQuery-Kurzanleitung zur Verwendung von Clientbibliotheken. Weitere Angaben finden Sie in der Referenzdokumentation zur BigQuery Python API.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für Clientbibliotheken einrichten.
Node.js
Bevor Sie dieses Beispiel anwenden, folgen Sie den Schritten zur Einrichtung von Node.js in der BigQuery-Kurzanleitung zur Verwendung von Clientbibliotheken. Weitere Angaben finden Sie in der Referenzdokumentation zur BigQuery Node.js API.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für Clientbibliotheken einrichten.
Terraform
Verwenden Sie die Ressource google_bigquery_connection:
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für Clientbibliotheken einrichten.
Im folgenden Beispiel wird eine Cloud-Ressourcenverbindung mit dem Namen my_cloud_resource_connection in der Region US erstellt:
Führen Sie die Schritte in den folgenden Abschnitten aus, um Ihre Terraform-Konfiguration auf ein Google Cloud -Projekt anzuwenden.
Cloud Shell vorbereiten
- Rufen Sie Cloud Shell auf.
-
Legen Sie das Google Cloud -Standardprojekt fest, auf das Sie Ihre Terraform-Konfigurationen anwenden möchten.
Sie müssen diesen Befehl nur einmal pro Projekt und in jedem beliebigen Verzeichnis ausführen.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
Umgebungsvariablen werden überschrieben, wenn Sie in der Terraform-Konfigurationsdatei explizite Werte festlegen.
Verzeichnis vorbereiten
Jede Terraform-Konfigurationsdatei muss ein eigenes Verzeichnis haben (auch als Stammmodul bezeichnet).
-
Erstellen Sie in Cloud Shell ein Verzeichnis und eine neue Datei in diesem Verzeichnis. Der Dateiname muss die Erweiterung
.tfhaben, z. B.main.tf. In dieser Anleitung wird die Datei alsmain.tfbezeichnet.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
Wenn Sie einer Anleitung folgen, können Sie den Beispielcode in jedem Abschnitt oder Schritt kopieren.
Kopieren Sie den Beispielcode in das neu erstellte
main.tf.Kopieren Sie optional den Code aus GitHub. Dies wird empfohlen, wenn das Terraform-Snippet Teil einer End-to-End-Lösung ist.
- Prüfen und ändern Sie die Beispielparameter, die auf Ihre Umgebung angewendet werden sollen.
- Speichern Sie die Änderungen.
-
Initialisieren Sie Terraform. Dies ist nur einmal für jedes Verzeichnis erforderlich.
terraform init
Fügen Sie optional die Option
-upgradeein, um die neueste Google-Anbieterversion zu verwenden:terraform init -upgrade
Änderungen anwenden
-
Prüfen Sie die Konfiguration und prüfen Sie, ob die Ressourcen, die Terraform erstellen oder aktualisieren wird, Ihren Erwartungen entsprechen:
terraform plan
Korrigieren Sie die Konfiguration nach Bedarf.
-
Wenden Sie die Terraform-Konfiguration an. Führen Sie dazu den folgenden Befehl aus und geben Sie
yesan der Eingabeaufforderung ein:terraform apply
Warten Sie, bis Terraform die Meldung „Apply complete“ anzeigt.
- Öffnen Sie Ihr Google Cloud -Projekt, um die Ergebnisse aufzurufen. Rufen Sie in der Google Cloud Console Ihre Ressourcen in der Benutzeroberfläche auf, um sicherzustellen, dass Terraform sie erstellt oder aktualisiert hat.
Öffnen Sie die Verbindung, nachdem Sie sie erstellt haben, und kopieren Sie im Bereich Verbindungsinformationen die Dienstkonto-ID. Sie benötigen diese ID, wenn Sie Berechtigungen für die Verbindung konfigurieren. Wenn Sie eine Verbindungsressource herstellen, erstellt BigQuery ein eindeutiges Systemdienstkonto und ordnet es der Verbindung zu.
Zugriff einrichten
Sie müssen dem Dienstkonto, das mit der neuen Verbindung verknüpft ist, Lesezugriff auf Ihre Spanner-Instanz oder -Datenbank gewähren. Es wird empfohlen, die vordefinierte IAM-Rolle „Cloud Spanner Database Reader with Data Boost“ (roles/spanner.databaseReaderWithDataBoost) zu verwenden.
So gewähren Sie dem Dienstkonto, das Sie zuvor aus der Verbindung kopiert haben, Zugriff auf Rollen auf Datenbankebene:
Rufen Sie die Spanner-Seite Instanzen auf.
Klicken Sie auf den Namen der Instanz, die Ihre Datenbank enthält, um die Seite Instanzdetails aufzurufen.
Klicken Sie auf dem Tab Übersicht das Kästchen der Datenbank an.
Das Infofeld wird angezeigt.Klicken Sie auf Hauptkonto hinzufügen.
Geben Sie im Bereich Hauptkonten hinzufügen unter Neue Hauptkonten die Dienstkonto-ID ein, die Sie zuvor kopiert haben.
Wählen Sie im Feld Rolle auswählen die Option Cloud Spanner Database Reader with DataBoost role aus.
Klicken Sie auf Speichern.
Externes Dataset erstellen
So erstellen Sie ein externes Dataset:
Console
Öffnen Sie in der Google Cloud Console die Seite „BigQuery“.
Klicken Sie im linken Bereich auf Explorer:
Wenn der linke Bereich nicht angezeigt wird, klicken Sie auf Linken Bereich maximieren, um ihn zu öffnen.
Wählen Sie im Bereich Explorer das Projekt aus, in dem Sie das Dataset erstellen möchten.
Klicken Sie auf Aktionen ansehen und dann auf Dataset erstellen.
Führen Sie auf der Seite Dataset erstellen die folgenden Schritte aus:
- Geben Sie für Dataset-ID einen eindeutigen Dataset-Namen ein.
- Wählen Sie unter Standorttyp einen Standort für das Dataset aus, z. B.
us-central1oder die Multiregionus. Nachdem ein Dataset erstellt wurde, kann der Standort nicht mehr geändert werden. Führen Sie für Externes Dataset die folgenden Schritte aus:
- Klicken Sie auf das Kästchen neben Link zu einem externen Dataset.
- Wählen Sie für Typ des externen Datasets die Option
Spanneraus. - Geben Sie unter Externe Quelle die vollständige Kennung Ihrer Spanner-Datenbank im folgenden Format ein:
projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Beispiel:projects/my_project/instances/my_instance/databases/my_database. - Geben Sie optional unter Datenbankrolle den Namen einer Spanner-Datenbankrolle ein. Weitere Informationen finden Sie unter Spanner-Verbindungen erstellen.
- Optional können Sie das Kästchen neben Cloud-Ressourcenverbindung verwenden anklicken, um das externe Dataset mit einer Verbindung zu erstellen.
Übernehmen Sie die anderen Einstellungen.
Klicken Sie auf Dataset erstellen.
SQL
Verwenden Sie die Datendefinitionssprachen-Anweisung (DDL) CREATE EXTERNAL SCHEMA.
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Geben Sie im Abfrageeditor die folgende Anweisung ein:
CREATE EXTERNAL SCHEMA DATASET_NAME OPTIONS ( external_source = 'SPANNER_EXTERNAL_SOURCE', location = 'LOCATION'); /* Alternatively, create with a connection: */ CREATE EXTERNAL SCHEMA DATASET_NAME WITH CONNECTION
PROJECT_ID.LOCATION.CONNECTION_NAMEOPTIONS ( external_source = 'SPANNER_EXTERNAL_SOURCE', location = 'LOCATION');Ersetzen Sie Folgendes:
DATASET_NAME: der Name Ihres neuen Datasets in BigQuery.SPANNER_EXTERNAL_SOURCE: der vollständige, qualifizierte Spanner-Datenbankname mit einem Präfix, das die Quelle identifiziert, im folgenden Format:google-cloudspanner://[DATABASE_ROLE@]/projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Beispiel:google-cloudspanner://admin@/projects/my_project/instances/my_instance/databases/my_databaseodergoogle-cloudspanner:/projects/my_project/instances/my_instance/databases/my_database.LOCATION: der Standort Ihres neuen Datasets in BigQuery, z. B.us-central1. Nachdem Sie ein Dataset erstellt haben, können Sie seinen Standort nicht mehr ändern.- (Optional)
CONNECTION_NAME: der Name Ihrer Cloud-Ressourcenverbindung.
Klicken Sie auf Ausführen.
Informationen zum Ausführen von Abfragen finden Sie unter Interaktive Abfrage ausführen.
bq
Erstellen Sie in einer Befehlszeilenumgebung mit dem Befehl bq mk ein externes Dataset:
bq --location=LOCATION mk --dataset \
    --external_source SPANNER_EXTERNAL_SOURCE \
    DATASET_NAME
Alternativ können Sie die Tabelle mit einer Verbindung erstellen:
bq --location=LOCATION mk --dataset \
    --external_source SPANNER_EXTERNAL_SOURCE \
    --connection_id PROJECT_ID.LOCATION.CONNECTION_NAME \
    DATASET_NAME
Ersetzen Sie Folgendes:
LOCATION: der Standort Ihres neuen Datasets in BigQuery, z. B.us-central1. Nachdem Sie ein Dataset erstellt haben, können Sie seinen Standort nicht mehr ändern. Mit der Datei.bigqueryrckönnen Sie einen Standardwert für den Standort festlegen.SPANNER_EXTERNAL_SOURCE: der vollständige, qualifizierte Spanner-Datenbankname mit einem Präfix, das die Quelle identifiziert, im folgenden Format:google-cloudspanner://[DATABASE_ROLE@]/projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE. Beispiel:google-cloudspanner://admin@/projects/my_project/instances/my_instance/databases/my_databaseodergoogle-cloudspanner:/projects/my_project/instances/my_instance/databases/my_database.DATASET_NAME: der Name Ihres neuen Datasets in BigQuery. Wenn Sie ein Dataset in einem anderen Projekt als dem Standardprojekt erstellen möchten, fügen Sie die Projekt-ID im FormatPROJECT_ID:DATASET_NAMEdem Dataset-Namen hinzu.- (Optional)
CONNECTION_NAME: der Name Ihrer Cloud-Ressourcenverbindung.
Terraform
Verwenden Sie die Ressource google_bigquery_dataset:
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für Clientbibliotheken einrichten.
Im folgenden Beispiel wird ein externes Spanner-Dataset erstellt:
Führen Sie die Schritte in den folgenden Abschnitten aus, um Ihre Terraform-Konfiguration auf ein Google Cloud -Projekt anzuwenden.
Cloud Shell vorbereiten
- Rufen Sie Cloud Shell auf.
-
Legen Sie das Google Cloud -Standardprojekt fest, auf das Sie Ihre Terraform-Konfigurationen anwenden möchten.
Sie müssen diesen Befehl nur einmal pro Projekt und in jedem beliebigen Verzeichnis ausführen.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
Umgebungsvariablen werden überschrieben, wenn Sie in der Terraform-Konfigurationsdatei explizite Werte festlegen.
Verzeichnis vorbereiten
Jede Terraform-Konfigurationsdatei muss ein eigenes Verzeichnis haben (auch als Stammmodul bezeichnet).
-
Erstellen Sie in Cloud Shell ein Verzeichnis und eine neue Datei in diesem Verzeichnis. Der Dateiname muss die Erweiterung
.tfhaben, z. B.main.tf. In dieser Anleitung wird die Datei alsmain.tfbezeichnet.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
Wenn Sie einer Anleitung folgen, können Sie den Beispielcode in jedem Abschnitt oder Schritt kopieren.
Kopieren Sie den Beispielcode in das neu erstellte
main.tf.Kopieren Sie optional den Code aus GitHub. Dies wird empfohlen, wenn das Terraform-Snippet Teil einer End-to-End-Lösung ist.
- Prüfen und ändern Sie die Beispielparameter, die auf Ihre Umgebung angewendet werden sollen.
- Speichern Sie die Änderungen.
-
Initialisieren Sie Terraform. Dies ist nur einmal für jedes Verzeichnis erforderlich.
terraform init
Fügen Sie optional die Option
-upgradeein, um die neueste Google-Anbieterversion zu verwenden:terraform init -upgrade
Änderungen anwenden
-
Prüfen Sie die Konfiguration und prüfen Sie, ob die Ressourcen, die Terraform erstellen oder aktualisieren wird, Ihren Erwartungen entsprechen:
terraform plan
Korrigieren Sie die Konfiguration nach Bedarf.
-
Wenden Sie die Terraform-Konfiguration an. Führen Sie dazu den folgenden Befehl aus und geben Sie
yesan der Eingabeaufforderung ein:terraform apply
Warten Sie, bis Terraform die Meldung „Apply complete“ anzeigt.
- Öffnen Sie Ihr Google Cloud -Projekt, um die Ergebnisse aufzurufen. Rufen Sie in der Google Cloud Console Ihre Ressourcen in der Benutzeroberfläche auf, um sicherzustellen, dass Terraform sie erstellt oder aktualisiert hat.
API
Rufen Sie die Methode datasets.insert mit einer definierten Dataset-Ressource und dem Feld externalDatasetReference für Ihre Cloud Spanner-Datenbank auf.
Bei den Namen der Tabellen in den externen Datasets wird die Groß-/Kleinschreibung nicht berücksichtigt.
Wenn Sie die externen Datasets mit einer CLOUD_RESOURCE-Verbindung erstellen, benötigen Sie die Berechtigung bigquery.connections.delegate (über die Rolle „BigQuery Connection Admin“ verfügbar) für die Verbindung, die von den externen Datasets verwendet wird.
Zugriff auf Tabellen steuern
Externe Spanner-Datasets unterstützen Endnutzer-Anmeldedaten (EUC). Das bedeutet, dass der Zugriff auf die Cloud Spanner-Tabellen von externen Datasets aus von Cloud Spanner gesteuert wird. Nutzer können diese Tabellen nur abfragen, wenn ihnen in Spanner Zugriff gewährt wurde.
Externe Cloud Spanner-Datasets unterstützen auch die Zugriffsdelegation. Durch die Zugriffsdelegation wird der Zugriff auf die Spanner-Tabellen von externen Datasets und der direkte Zugriff auf die zugrunde liegenden Spanner-Tabellen entkoppelt. Für die Verbindung mit Cloud Spanner wird eine Cloud-Ressourcenverbindung verwendet, die mit einem Dienstkonto verknüpft ist. Nutzer können diese Spanner-Tabellen aus externen Datasets abfragen, auch wenn sie in Spanner keinen Zugriff haben.
Tabellen in einem externen Dataset auflisten
Informationen zum Auflisten der Tabellen, die in Ihrem externen Dataset für Abfragen verfügbar sind, finden Sie unter Datasets auflisten.
Tabelleninformationen abrufen
Informationen zu den Tabellen in Ihrem externen Dataset, z. B. Schemadetails, finden Sie unter Tabelleninformationen abrufen.
Cloud Spanner-Daten abfragen
Das Abfragen von Tabellen in externen Datasets funktioniert genauso wie das Abfragen von Tabellen in jedem anderen BigQuery-Dataset. Datenänderungsvorgänge (DML) werden jedoch nicht unterstützt.
Für Abfragen von Tabellen in externen Spanner-Datasets wird standardmäßig Data Boost verwendet. Dies kann nicht geändert werden. Daher benötigen Sie zusätzliche Berechtigungen, um solche Abfragen auszuführen.
Abfrageergebnisse werden in BigQuery gespeichert. Wenn Sie Spanner abfragen, werden die Abfrageergebnisse standardmäßig in temporären Tabellen gespeichert. Sie können optional auch als neue BigQuery-Tabelle gespeichert, mit anderen Tabellen verknüpft oder mithilfe von DML mit vorhandenen Tabellen zusammengeführt werden.
Ansicht in einem externen Dataset erstellen
Sie können keine Ansicht in einem externen Dataset erstellen. Sie können jedoch eine Ansicht in einem Standard-Dataset erstellen, die auf einer Tabelle in einem externen Dataset basiert. Weitere Informationen finden Sie unter Ansichten erstellen.
Externes Dataset löschen
Das Löschen eines externen Datasets entspricht dem Löschen eines anderen BigQuery-Datasets. Das Löschen externer Datasets hat keine Auswirkungen auf Tabellen in der Cloud Spanner-Datenbank. Weitere Informationen finden Sie unter Datasets löschen.
Nicht inkrementelle materialisierte Ansicht basierend auf Tabellen aus einem externen Dataset erstellen
Bevor Sie fortfahren, müssen Sie das zugrunde liegende externe Spanner-Dataset mit einer CLOUD_RESOURCE-Verbindung erstellen.
Mit der Option allow_non_incremental_definition können Sie nicht inkrementelle materialisierte Ansichten erstellen, die auf externe Spanner-Dataset-Tabellen verweisen.
Im folgenden Beispiel wird eine externe Spanner-Basistabelle verwendet:
/*
  You must create the spanner_external_dataset with a CLOUD_RESOURCE connection.
*/
CREATE MATERIALIZED VIEW sample_dataset.sample_spanner_mv
  OPTIONS (
      enable_refresh = true, refresh_interval_minutes = 60,
      max_staleness = INTERVAL "24" HOUR,
        allow_non_incremental_definition = true)
AS
  SELECT COUNT(*) cnt FROM spanner_external_dataset.spanner_table;
Beschränkungen
- Es gelten die Einschränkungen für föderierte BigQuery-Abfragen.
- In BigQuery sind nur Tabellen aus einem Standard-Spanner-Schema zugänglich. Tabellen aus benannten Schemas werden nicht unterstützt.
- In der Spanner-Datenbank definierte Primär- und Fremdschlüssel sind in BigQuery nicht sichtbar.
- Wenn eine Tabelle in der Spanner-Datenbank eine Spalte mit einem Typ enthält, der von BigQuery nicht unterstützt wird, ist diese Spalte auf der BigQuery-Seite nicht zugänglich.
- Sie können keine Daten oder Metadaten in Tabellen in einem externen Spanner-Dataset hinzufügen, löschen oder aktualisieren.
- In einem externen Spanner-Dataset können Sie keine neuen Tabellen, Ansichten oder materialisierten Ansichten erstellen.
INFORMATION_SCHEMA-Aufrufe werden nicht unterstützt.- Metadaten-Caching wird nicht unterstützt.
- Einstellungen auf Dataset-Ebene, die sich auf Standardeinstellungen für die Tabellenerstellung beziehen, wirken sich nicht auf externe Datasets aus, da Tabellen nicht manuell erstellt werden können.
- Die Write API und die Read API werden nicht unterstützt.
- Sicherheit auf Zeilenebene, Sicherheit auf Spaltenebene und Datenmaskierung werden nicht unterstützt.
- Inkrementelle materialisierte Ansichten, die auf Tabellen aus externen Spanner-Datasets basieren, werden nicht unterstützt. Nicht inkrementelle materialisierte Ansichten werden jedoch in der Vorabversion unterstützt.
- Die Einbindung in Knowledge Catalog wird nicht unterstützt. Datenprofile und Datenqualitätsscans werden beispielsweise nicht unterstützt.
- Tags auf Tabellenebene werden nicht unterstützt.
- Die automatische SQL-Vervollständigung funktioniert beim Schreiben von Abfragen nicht mit externen Spanner-Tabellen.
- Mit Sensitive Data Protection scannen wird für externe Datasets nicht unterstützt.
- Die Freigabe mit BigQuery Sharing (früher Analytics Hub) wird für externe Datasets nicht unterstützt.
- Wenn das externe Spanner-Dataset Endnutzer-Anmeldedaten verwendet, können Sie eine autorisierte Ansicht erstellen, die auf das externe Dataset verweist. Wenn diese Ansicht jedoch abgefragt wird, wird der EUC einer Person, die eine Abfrage ausführt, an Spanner gesendet.
- Wenn das externe Cloud Spanner-Dataset eine Cloud-Ressourcenverbindung für die Zugriffsdelegierung verwendet, können Sie eine autorisierte Ansicht oder eine autorisierte Routine erstellen, die auf das externe Dataset verweist.
Nächste Schritte
- Weitere Informationen zu föderierten Spanner-Abfragen
- Weitere Informationen zum Erstellen materialisierter Ansichten für externe Spanner-Datasets