


במשימות של שאילתות ב-BigQuery מוטמע מידע על תוכנית לביצוע שאילתה ועל תזמון לצורך אבחון. המידע הזה דומה למידע שמתקבל מהצהרות כמו EXPLAIN במערכות אחרות של מסדי נתונים וניתוח נתונים. אפשר לאחזר את המידע הזה מהתגובות מה-API של שיטות כמו jobs.get.
בשאילתות שנמשכות זמן רב, BigQuery מעדכן את הנתונים הסטטיסטיים האלה מדי פעם. העדכונים האלה מתרחשים ללא קשר לקצב שבו נבדק סטטוס המשימה, אבל בדרך כלל הם לא מתרחשים בתדירות גבוהה יותר מאשר כל 30 שניות. בנוסף, משימות של שאילתות שלא משתמשות במשאבי ביצוע, כמו בקשות להרצה יבשה או תוצאות שאפשר להציג מתוצאות שנשמרו במטמון, לא יכללו את פרטי האבחון הנוספים, אבל יכול להיות שיופיעו נתונים סטטיסטיים אחרים.
רקע
כש-BigQuery מריץ שאילתה, הוא ממיר את ה-SQL לתרשים ביצוע שמורכב משלבים. השלבים מורכבים משלבים, הפעולות הבסיסיות שמבצעות את הלוגיקה של השאילתה. ב-BigQuery נעשה שימוש בארכיטקטורה מקבילה ומבוזרת מאוד, שמריצה שלבים במקביל כדי לצמצם את זמן האחזור. השלבים מתקשרים זה עם זה באמצעות shuffle, ארכיטקטורת זיכרון מבוזרת ומהירה.
בתוכנית לביצוע שאילתה, המונחים יחידות עבודה ועובדים מתארים את השלבים המקבילים. במקומות אחרים ב-BigQuery, יכול להיות שתיתקלו במונח חריץ, שהוא ייצוג מופשט של כמה היבטים של ביצוע שאילתות, כולל משאבי מחשוב, זיכרון וקלט/פלט. ה-slots מבצעים במקביל את יחידות העבודה הנפרדות של שלב מסוים. נתונים סטטיסטיים ברמה העליונה של המשימה מספקים עלות של שאילתה ספציפית באמצעות totalSlotMs, על סמך החשבונאות המופשטת הזו.
מאפיין חשוב נוסף של הרצת השאילתה הוא ש-BigQuery יכול לשנות את התוכנית לביצוע השאילתה בזמן שהשאילתה פועלת. לדוגמה, ב-BigQuery יש שלבי חלוקה מחדש כדי לשפר את חלוקת הנתונים בין ה-workers של השאילתות, וכך לשפר את ההקבלה ולהפחית את זמן האחזור של השאילתות.
בנוסף לתוכנית לביצוע שאילתה, משימות של שאילתות חושפות גם ציר זמן של ביצוע, שמספק פירוט של יחידות העבודה שהושלמו, שנמצאות בהמתנה ושהן פעילות. לשאילתה יכולים להיות כמה שלבים עם וורקרים פעילים בו-זמנית, וציר הזמן נועד להציג את ההתקדמות הכוללת של השאילתה.
הצגת תרשים הביצוע באמצעות מסוף Google Cloud
במסוףGoogle Cloud , אפשר לראות את פרטי תוכנית הביצוע של שאילתה שהושלמה בלחיצה על הלחצן Execution Details.
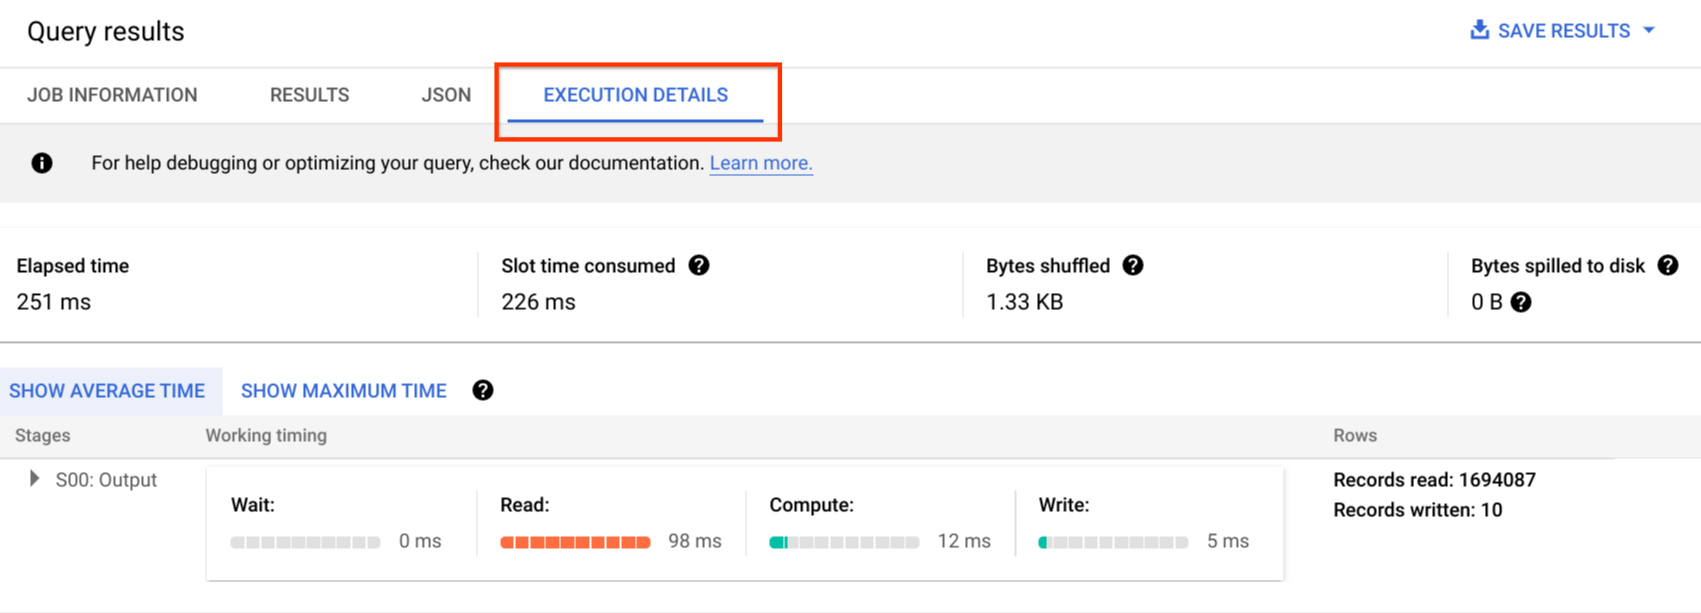
מידע על תוכנית לביצוע שאילתה
בתגובה מה-API, תוכניות לביצוע שאילתות מיוצגות כרשימה של שלבי שאילתות. כל פריט ברשימה מציג נתונים סטטיסטיים של סקירה כללית לכל שלב, מידע מפורט על השלבים וסיווגים של תזמון השלבים. לא כל הפרטים מוצגים במסוף Google Cloud , אבל כולם יכולים להופיע בתגובות מה-API.
הסבר על תרשים הביצוע
במסוף Google Cloud , אפשר לראות את פרטי התוכנית לביצוע השאילתה בלחיצה על הכרטיסייה Execution graph.
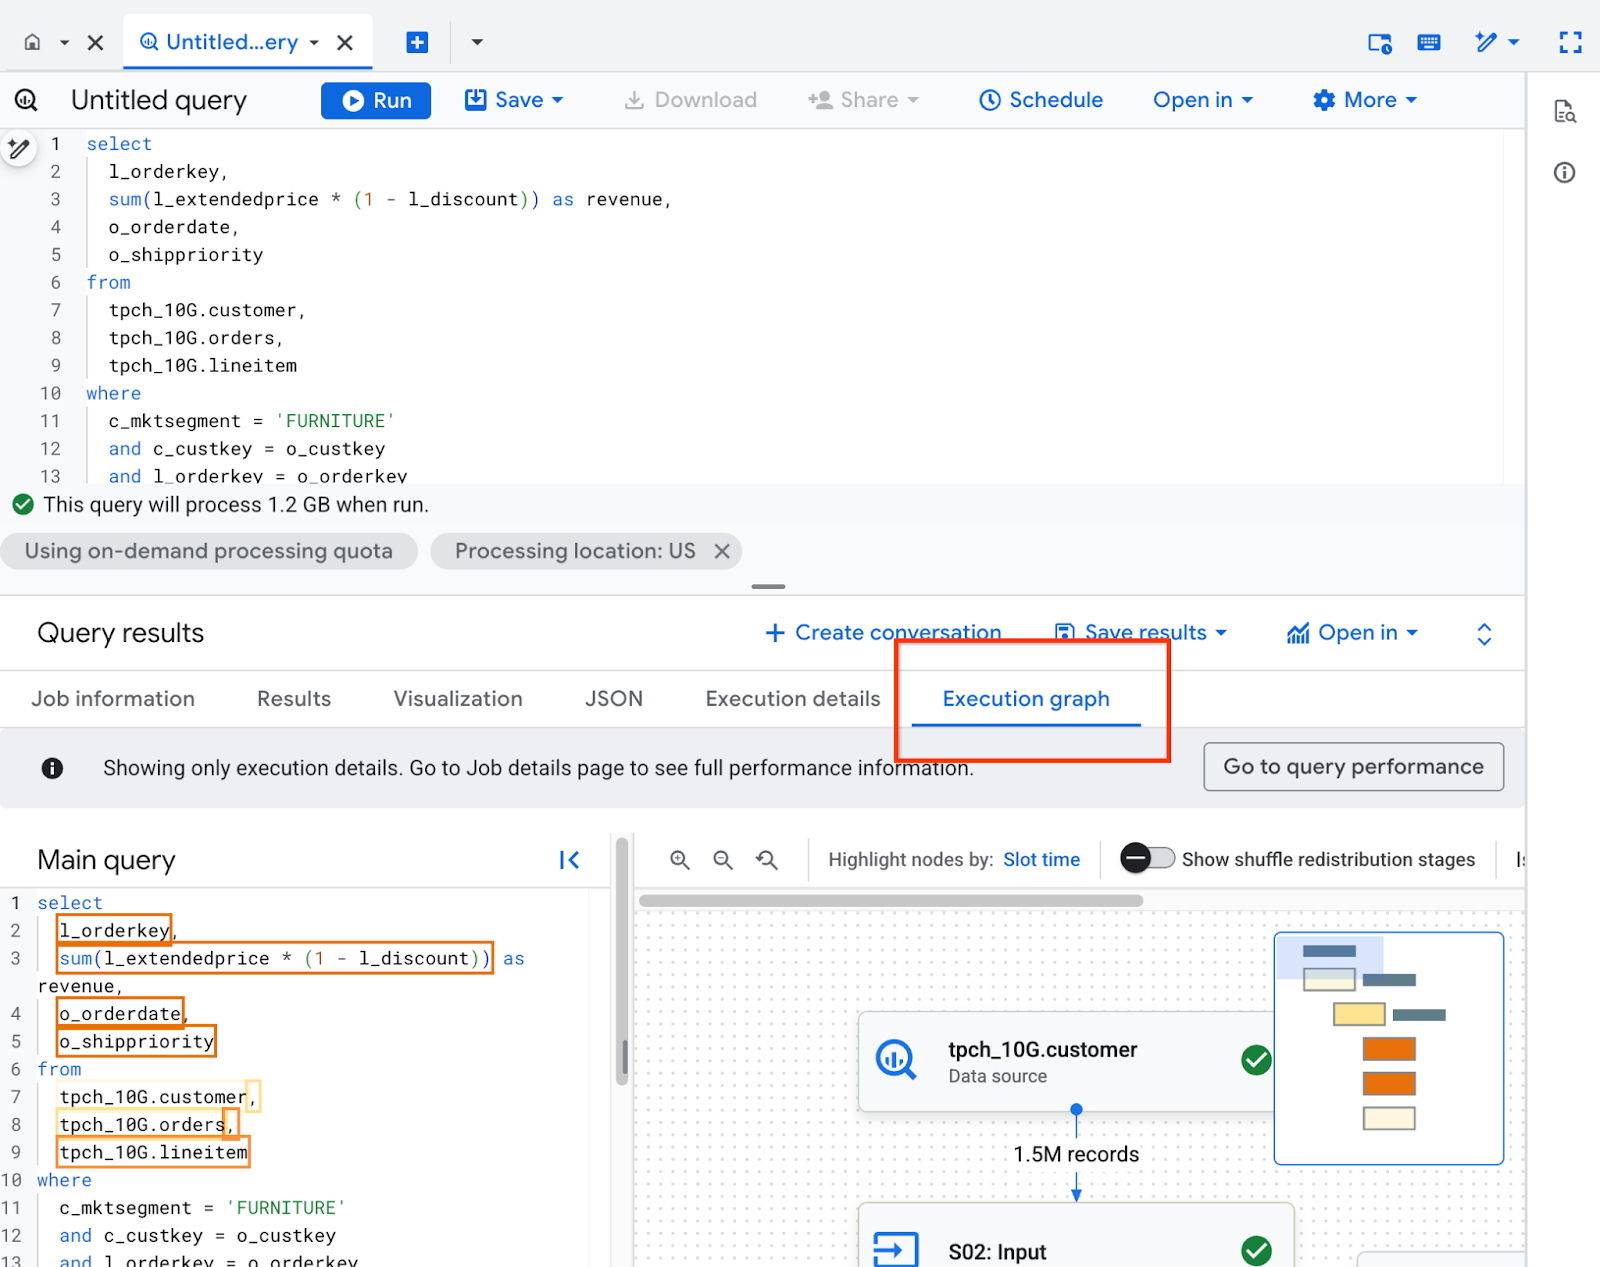
החלונית Execution graph מאורגנת באופן הבא:
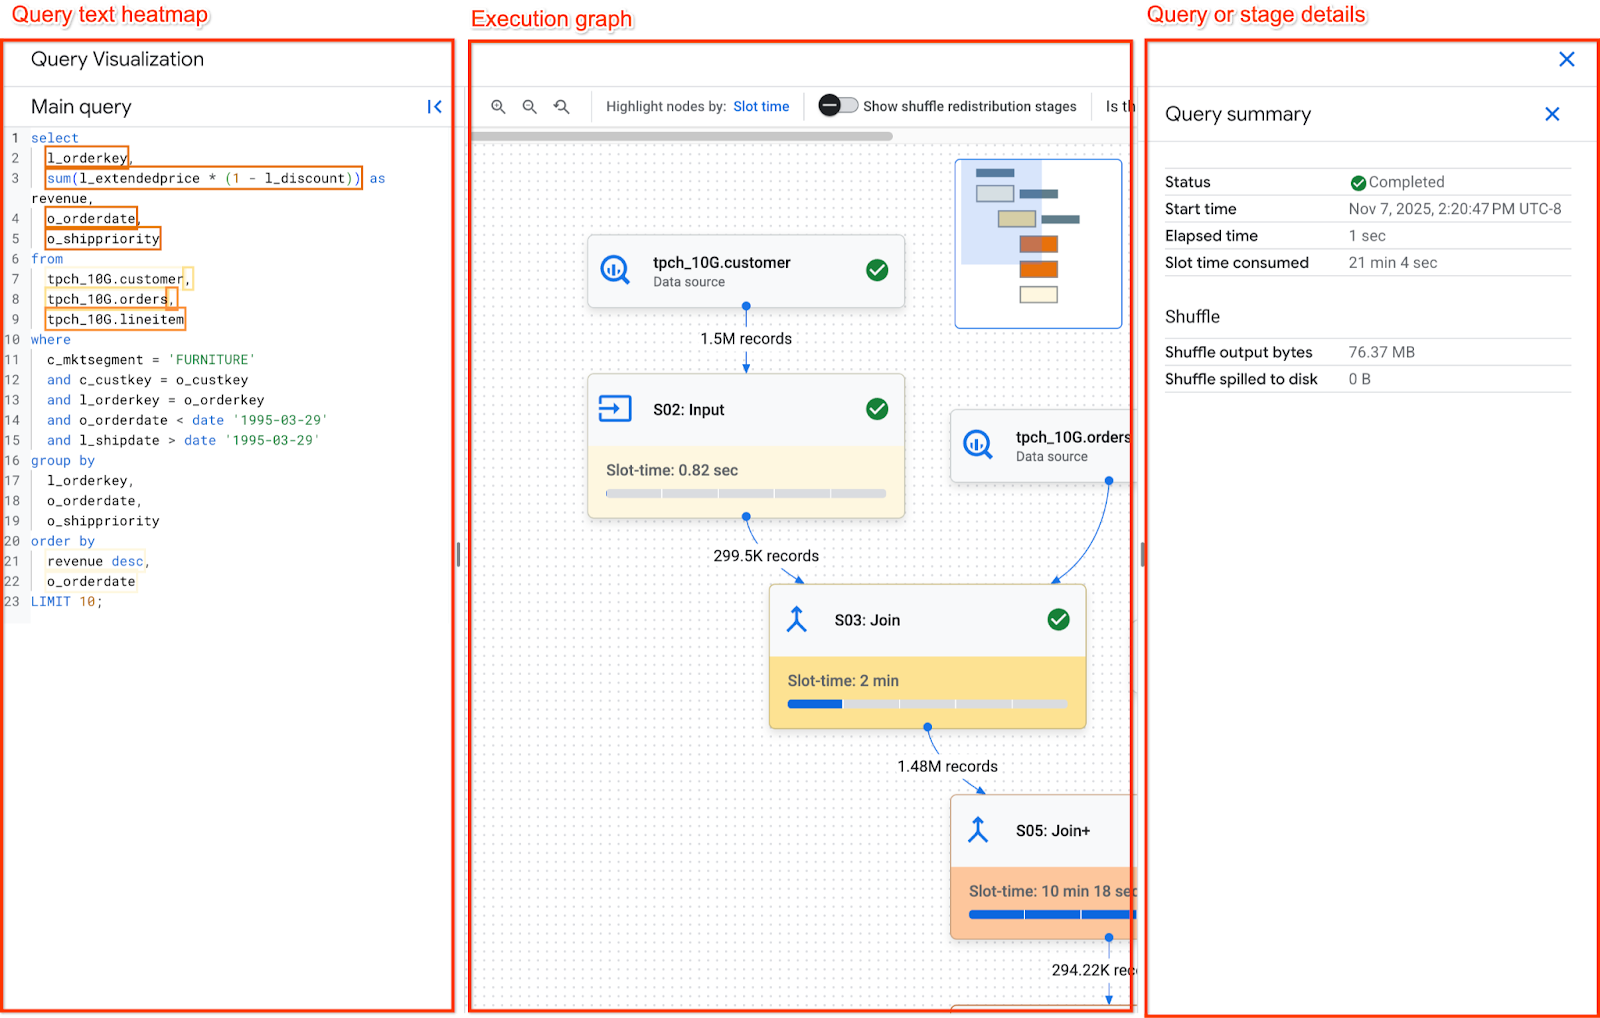
- במרכז נמצא תרשים הביצוע. הוא מציג שלבים כצמתים וזיכרון ערבוב שהוחלף בין שלבים כקצוות.
- בחלונית הימנית מופיעה מפת חום של טקסט השאילתה. הוא מציג את טקסט השאילתה הראשי שהשאילתה הפעילה, יחד עם כל התצוגות שאליהן היא מפנה.
- בחלונית השמאלית מופיעים פרטי השאילתה או השלב.
ניווט בתרשים הביצוע
בתרשים הביצוע, ערכת הצבעים של הצמתים מבוססת על זמן ה-slot. צמתים בצבע אדום כהה יותר צורכים יותר זמן slot ביחס לשאר השלבים בתרשים.
כדי לנווט בתרשים הביצוע, אתם יכולים:
- לוחצים לחיצה ארוכה על הרקע של התרשים כדי להזיז את התצוגה לאזורים שונים בתרשים.
- כדי להגדיל או להקטין את התצוגה של התרשים, משתמשים בגלגל הגלילה של העכבר.
- לוחצים לחיצה ארוכה על המפה הממוזערת בפינה הימנית העליונה כדי להזיז את התצוגה לאזורים שונים בתרשים.
לחיצה על שלב בתרשים מציגה את פרטי השלב שנבחר. פרטי השלב כוללים:
- נתונים סטטיסטיים. בסקירה הכללית של השלבים מפורטים הנתונים הסטטיסטיים.
- פרטי השלב. השלבים מתארים את הפעולות הנפרדות שמבצעות את הלוגיקה של השאילתה.
פרטי השלב
השלבים מורכבים מצעדים, שהם הפעולות הנפרדות שמבצעות את הלוגיקה של השאילתה. השלבים כוללים שלבי משנה שמתארים מה השלב עשה בקוד מדומה. שלבי המשנה משתמשים במשתנים כדי לתאר את הקשרים בין השלבים. משתנים מתחילים בסימן דולר ואחריו מספר ייחודי. מספרי המשתנים לא משותפים בין השלבים.
בתמונה הבאה מוצגים השלבים של שלב:
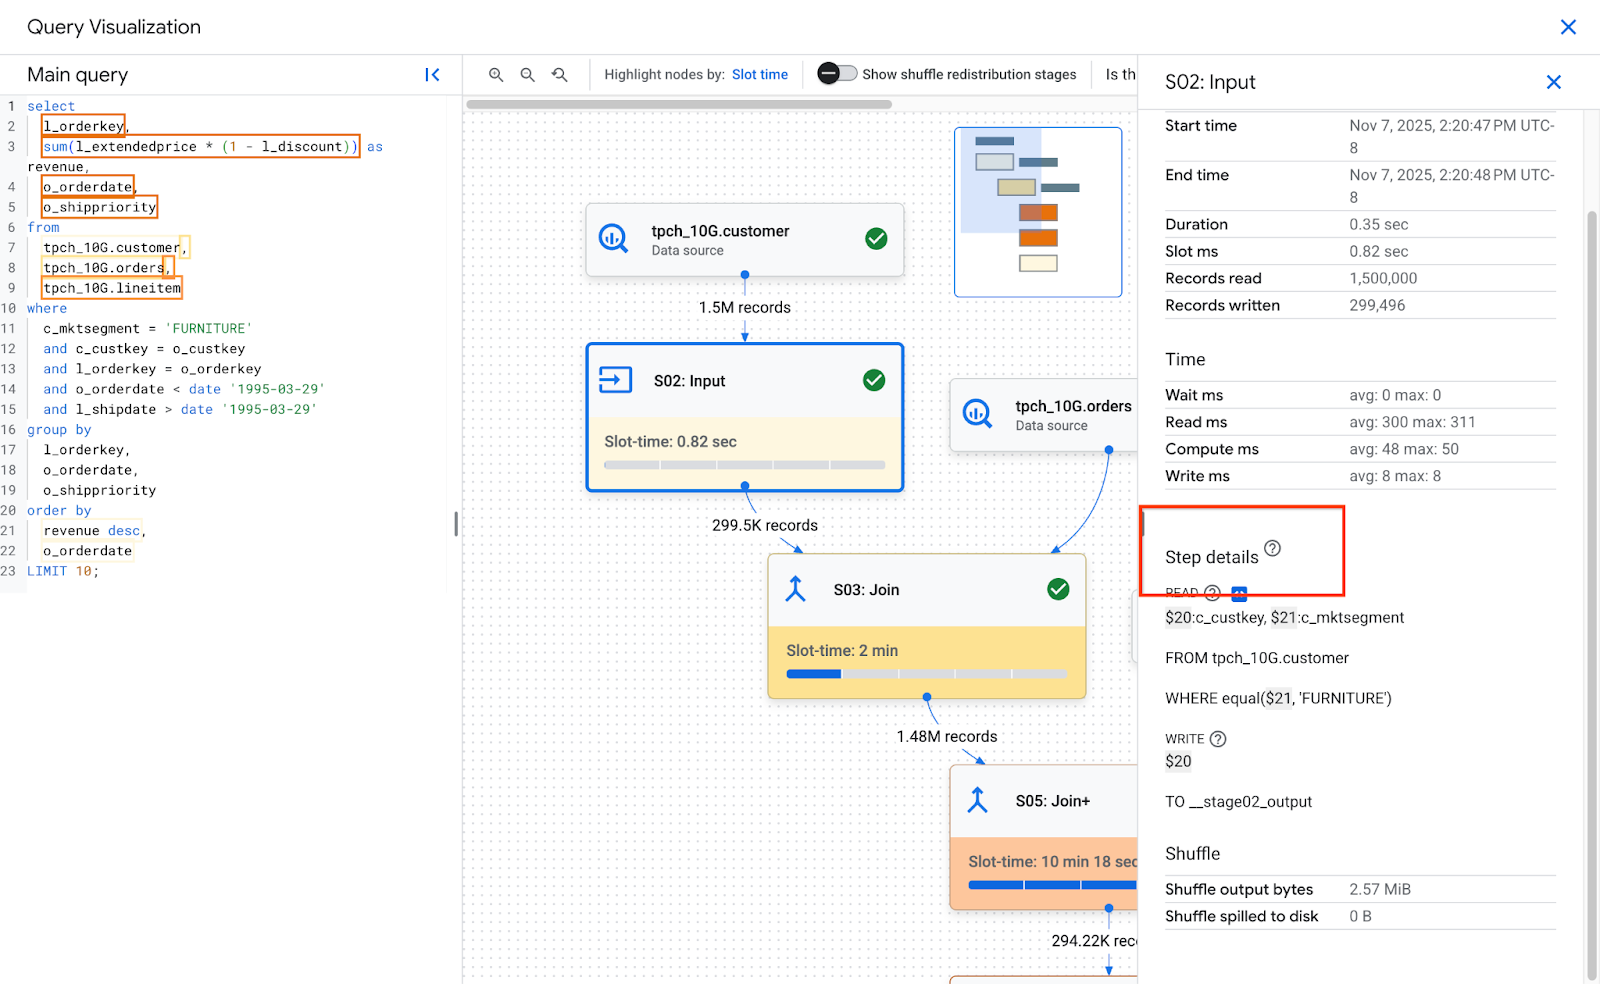
דוגמה לשלבים של שלב:
  READ
  $30:l_orderkey, $31:l_quantity
  FROM lineitem

  AGGREGATE
  GROUP BY $100 := $30
  $70 := SUM($31)

  WRITE
  $100, $70
  TO __stage00_output
  BY HASH($100)
השלבים בדוגמה מתארים את הדברים הבאים:
- השלב קרא את העמודות l_orderkey ו-l_quantity מהטבלה lineitem ושמר את הערכים במשתנים $30 ו- $31, בהתאמה.
- השלב צבר את המשתנים $30 ו- $31, ושמר את הצבירות במשתנים $100 ו- $70, בהתאמה.
- השלב כתב את התוצאות של המשתנים $100 ו-$70 לערבוב. השלב סידר את התוצאות בזיכרון ה-shuffle לפי 100$.
במאמר הסבר על השלבים ואופטימיזציה שלהם מפורטים סוגי השלבים ואיך לבצע אופטימיזציה שלהם.
יכול להיות ש-BigQuery יחתוך שלבי משנה אם תרשים הביצוע של השאילתה היה מורכב מספיק, כך שמתן שלבי משנה מלאים היה גורם לבעיות בגודל המטען הייעודי (payload) בזמן אחזור פרטי השאילתה.
מפת חום של טקסט השאילתה
ב-BigQuery אפשר למפות חלק מהשלבים לחלקים של טקסט השאילתה. מפת החום של טקסט השאילתה מציגה את כל טקסט השאילתה התואם עם שלבי השלב. הוא מדגיש את טקסט השאילתה על סמך זמן החריצים הכולל של השלבים שהצעדים שלהם מיפו את טקסט השאילתה.
בתמונה הבאה מוצג טקסט השאילתה המודגש:
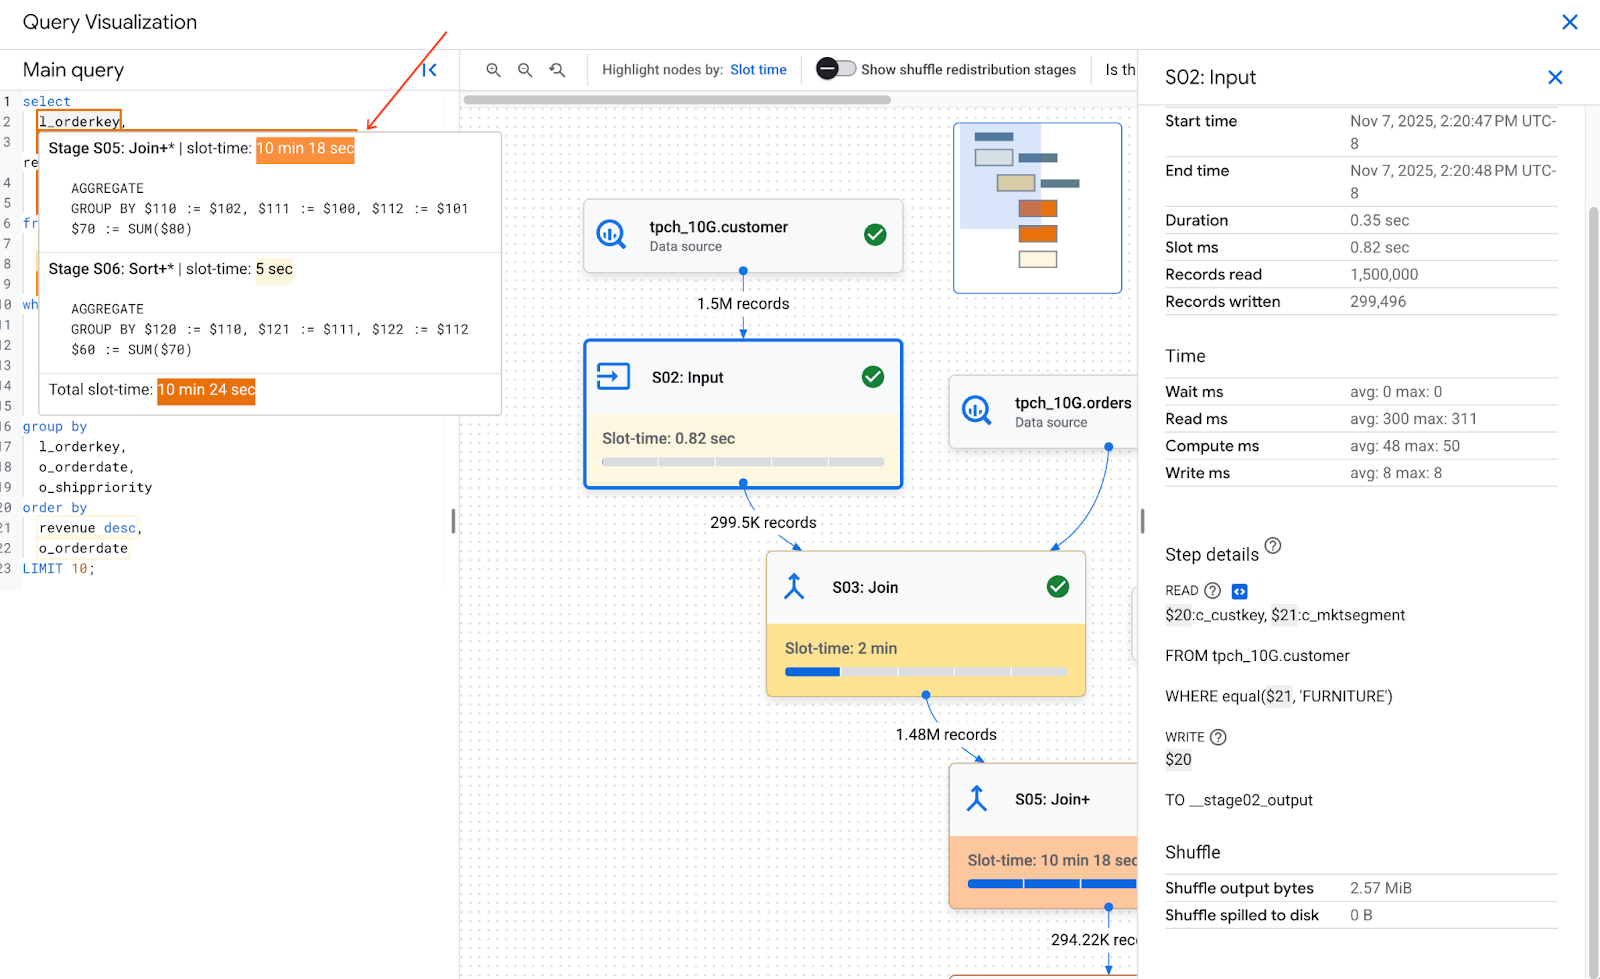
אם תעבירו את העכבר מעל חלק ממופה של טקסט השאילתה, יופיע הסבר קצר עם רשימה של כל השלבים שממופים לטקסט השאילתה, וגם זמן המשבצת של השלב. לחיצה על טקסט של שאילתה ממופה בוחרת את השלב בתרשים הביצוע ופותחת את פרטי השלב בחלונית השמאלית.
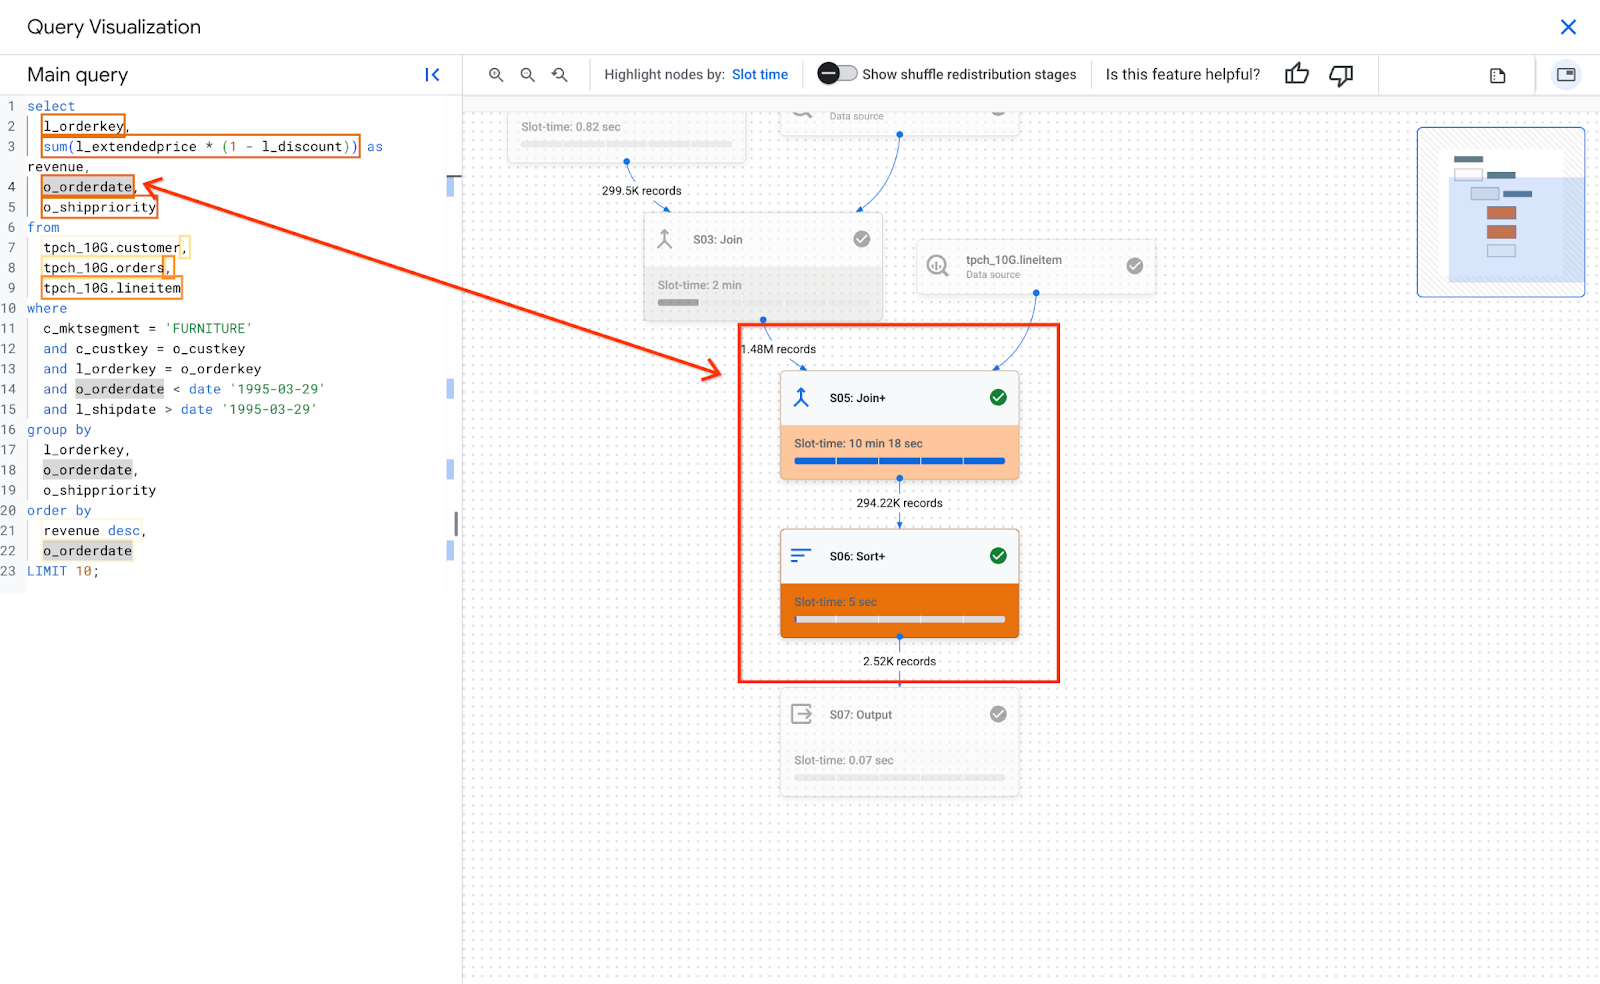
חלק אחד של טקסט השאילתה יכול להתאים לכמה שלבים. בהסבר הקצר מפורטים כל שלב שמופה וזמן המשבצת שלו. לחיצה על טקסט השאילתה מדגישה את השלבים התואמים, והשאר מופיע באפור. אם לוחצים על שלב ספציפי, מוצגים הפרטים שלו.
בתמונה הבאה אפשר לראות איך טקסט השאילתה קשור לפרטי השלב:
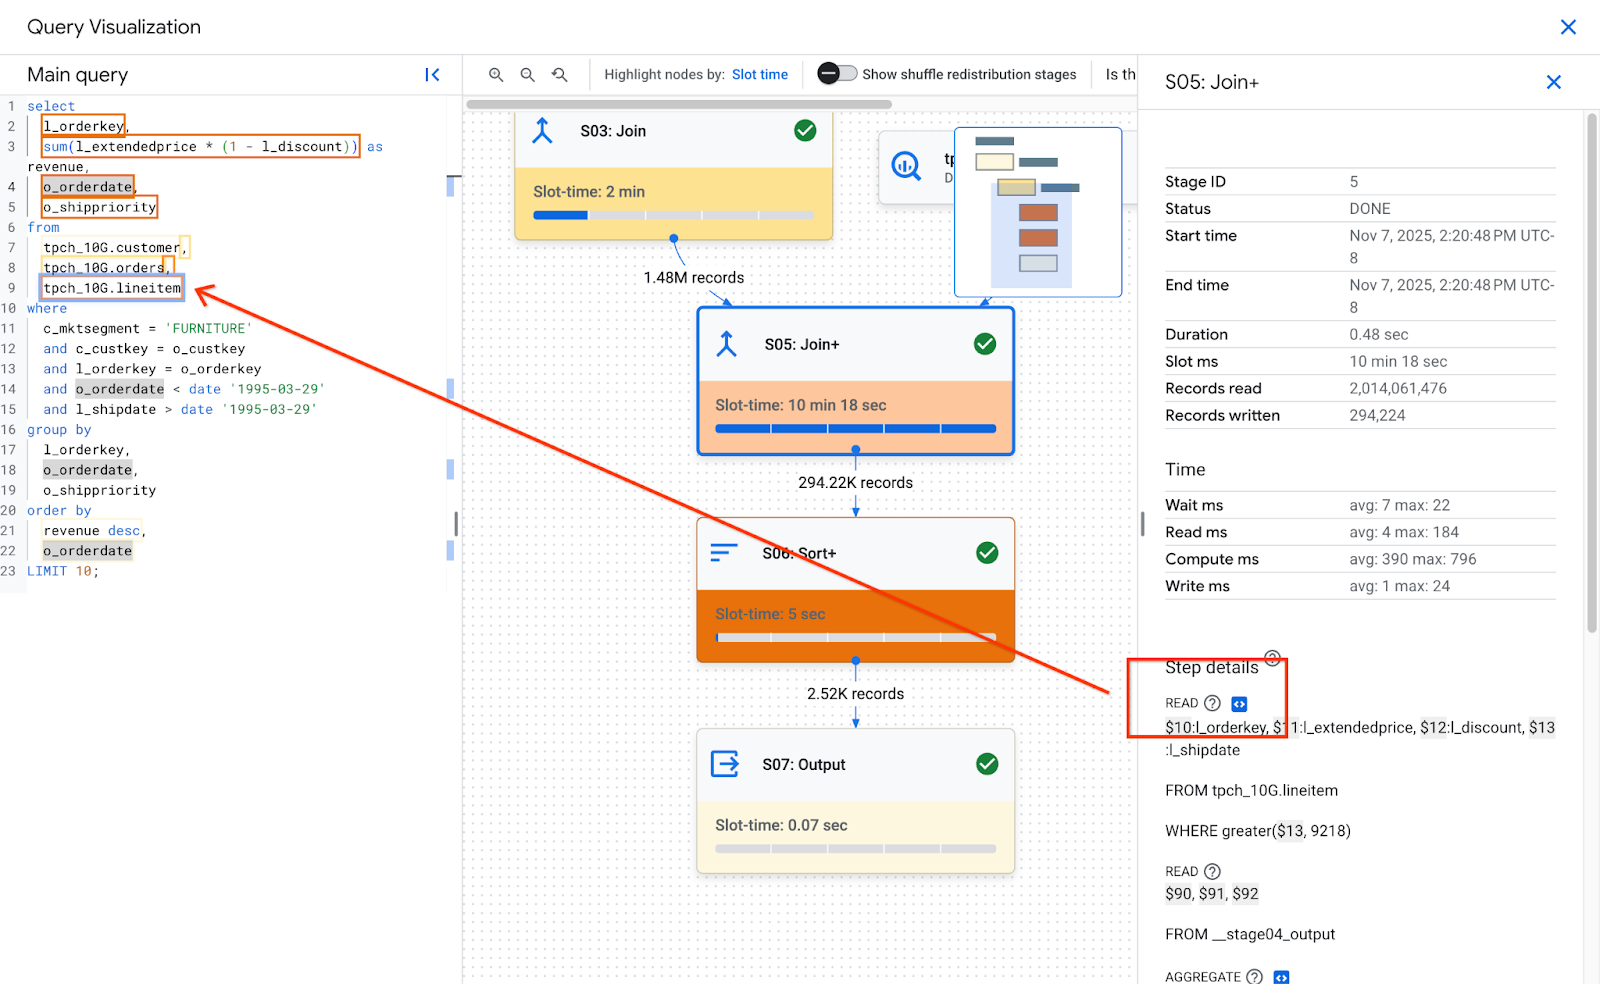
בקטע Step details של שלב, אם השלב ממפה לטקסט של שאילתה, לשלב יש סמל קוד. לחיצה על סמל הקוד מדגישה את החלק הממופה של טקסט השאילתה בצד ימין.
חשוב לזכור שהצבע של מפת החום מבוסס על זמן המשבצת של כל השלב. מכיוון ש-BigQuery לא מודד את זמן ה-slot של השלבים, מפת החום לא מייצגת את זמן ה-slot בפועל של החלק הספציפי הזה בטקסט השאילתה הממופה. ברוב המקרים, שלב מבצע רק פעולה מורכבת אחת, כמו איחוד או צבירה. לכן הצבע של מפת החום מתאים. עם זאת, כששלב מורכב משלבים שמבצעים כמה פעולות מורכבות, הצבע של מפת החום עשוי לייצג יתר על המידה את זמן ה-slot בפועל במפת החום. במקרים כאלה, חשוב להבין את השלבים האחרים שמרכיבים את השלב כדי לקבל הבנה מלאה יותר של ביצועי השאילתה.
אם בשאילתה נעשה שימוש בתצוגות, והשלבים של השלב ממופים לטקסט השאילתה של התצוגה, במפת החום של טקסט השאילתה מוצגים שם התצוגה וטקסט השאילתה של התצוגה עם המיפויים שלהם. עם זאת, אם התצוגה נמחקת או אם אין לכם את הרשאת ה-IAM bigquery.tables.get בתצוגה, מפת החום של טקסט השאילתה לא תציג את המיפויים של שלבי התצוגה.
סקירה כללית של השלבים
השדות של הסקירה הכללית בכל שלב יכולים לכלול את הפרטים הבאים:
| שדה API | תיאור |
|---|---|
id |
מזהה מספרי ייחודי של השלב. |
name |
שם סיכום פשוט של השלב. ה-steps בשלב מספקים פרטים נוספים על שלבי הביצוע. |
status |
סטטוס ההרצה של השלב. הסטטוסים האפשריים הם: PENDING, RUNNING, COMPLETE, FAILED ו-CANCELLED. |
inputStages |
רשימה של המזהים שיוצרים את תרשים התלות של השלב. לדוגמה, שלב JOIN צריך בדרך כלל שני שלבים תלויים שמכינים את הנתונים בצד שמאל ובצד ימין של קשר ה-JOIN. |
startMs |
חותמת זמן, באלפיות השנייה של תקופה, שמייצגת את הזמן שבו ה-worker הראשון בשלב התחיל לפעול. |
endMs |
חותמת זמן, באלפיות השנייה של מערכת Unix, שמייצגת את הזמן שבו ה-worker האחרון סיים את הביצוע. |
steps |
רשימה מפורטת יותר של שלבי הביצוע בתוך השלב. כדי לקבל מידע נוסף, אפשר לעיין בקטע שנמצא בהמשך. |
recordsRead |
גודל הקלט של השלב כמספר הרשומות, בכל ה-workers של השלב. |
recordsWritten |
גודל הפלט של השלב כמספר הרשומות, בכל ה-workers של השלב. |
parallelInputs |
מספר יחידות העבודה שאפשר לבצע במקביל בשלב. בהתאם לשלב ולשאילתה, יכול להיות שהמספר הזה מייצג את מספר המקטעים העמודתיים בטבלה, או את מספר המחיצות בערבוב ביניים. |
completedParallelInputs |
מספר יחידות העבודה שהושלמו בשלב. בחלק מהשאילתות, לא צריך להשלים את כל הקלטים בשלב מסוים כדי שהשלב יושלם. |
shuffleOutputBytes |
מייצג את סך הבייטים שנכתבו בכל ה-workers בשלב של שאילתה. |
shuffleOutputBytesSpilled |
בשאילתות שמעבירות כמות גדולה של נתונים בין שלבים, יכול להיות שיהיה צורך לחזור להעברה מבוססת-דיסק. הנתון הסטטיסטי של הבייטים שזלגו מציין כמה נתונים זלגו לדיסק. הוא תלוי באלגוריתם אופטימיזציה, ולכן הוא לא דטרמיניסטי לשאילתה נתונה. |
סיווג תזמון לפי שלב
שלבי השאילתה מספקים סיווגים של תזמון השלבים, גם בצורה יחסית וגם בצורה מוחלטת. כל שלב בביצוע מייצג עבודה שבוצעה על ידי עובד עצמאי אחד או יותר, ולכן המידע מוצג גם בזמנים ממוצעים וגם בזמנים במקרה הגרוע ביותר. הזמנים האלה מייצגים את הביצועים הממוצעים של כל ה-workers בשלב מסוים, וגם את הביצועים של ה-worker האיטי ביותר ב"זנב הארוך" בסיווג נתון. בנוסף, הזמנים הממוצעים והמקסימליים מחולקים לייצוגים מוחלטים ויחסיים. בסטטיסטיקות שמבוססות על יחס, הנתונים מוצגים כשבר של משך הזמן הארוך ביותר שבו עובד כלשהו השקיע בכל פלח.
במסוף Google Cloud מוצג תזמון השלבים באמצעות ייצוגים של תזמון יחסי.
המידע על תזמון השלבים מדווח באופן הבא:
| תזמון יחסי | תזמון מוחלט | המונה של היחס |
|---|---|---|
waitRatioAvg |
waitMsAvg |
הזמן הממוצע שעובד המתין עד שנקבעה לו משמרת. |
waitRatioMax |
waitMsMax |
הזמן שהעובד האיטי ביותר המתין לתזמון. |
readRatioAvg |
readMsAvg |
הזמן הממוצע ש-worker השקיע בקריאת נתוני קלט. |
readRatioMax |
readMsMax |
הזמן שה-worker האיטי ביותר השקיע בקריאת נתוני הקלט. |
computeRatioAvg |
computeMsAvg |
הזמן הממוצע שבו ה-worker היה מוגבל על ידי המעבד (CPU). |
computeRatioMax |
computeMsMax |
הזמן שבו ה-worker האיטי ביותר היה מוגבל על ידי המעבד (CPU). |
writeRatioAvg |
writeMsAvg |
הזמן הממוצע ש-worker השקיע בכתיבת נתוני פלט. |
writeRatioMax |
writeMsMax |
הזמן שה-worker האיטי ביותר השקיע בכתיבת נתוני הפלט. |
סקירה כללית של השלבים
השלבים מכילים את הפעולות שכל worker מבצע בשלב, והם מוצגים כרשימה מסודרת של פעולות. לכל פעולה בשלב יש קטגוריה, ובחלק מהפעולות יש מידע מפורט יותר. קטגוריות הפעולות שמופיעות בתוכנית לביצוע שאילתה כוללות:
| קטגוריית השלב | תיאור |
|---|---|
READ |
קריאה של עמודה אחת או יותר מטבלת קלט או מ-shuffle ביניים. רק 16 העמודות הראשונות שנקראות מוחזרות בפרטי השלב. |
WRITE |
כתיבה של עמודה אחת או יותר לטבלת פלט או לערבוב ביניים. בפלט של שלב שמחולק ל-HASH מחיצות, זה כולל גם את העמודות שמשמשות כמפתח המחיצה. |
COMPUTE |
הערכת ביטויים ופונקציות SQL. |
FILTER |
בשימוש בסעיפים WHERE, OMIT IF ו-HAVING. |
SORT |
פעולת ORDER BY שכוללת את מפתחות העמודות ואת סדר המיון. |
AGGREGATE |
מיישם צבירות של משפטים כמו GROUP BY או COUNT, בין היתר. |
LIMIT |
מטמיע את הסעיף LIMIT. |
JOIN |
מיישם צירופים לפסוקיות כמו JOIN, בין היתר. כולל את סוג הצירוף ואולי גם את תנאי הצירוף. |
ANALYTIC_FUNCTION |
הפעלה של פונקציה אנליטית (window function). |
USER_DEFINED_FUNCTION |
קריאה לפונקציה בהגדרת המשתמש. |
UPDATE |
שינוי שורות קיימות בטבלת יעד להצהרת UPDATE. כולל את העמודות ששונו ואת טבלת היעד. |
DELETE |
הסרת שורות מטבלת יעד להצהרת DELETE. כוללת את העמודות שאליהן מפנים ואת טבלת היעד. |
MERGE |
שינוי שורות בטבלת יעד להצהרת MERGE. כולל את העמודות ששונו ואת טבלת היעד. |
EXPORT |
כתיבת עמודות פלט לטבלת יעד של פקודות בשפת טיפול בנתונים (DML) או של ייצוא תוצאות של שאילתות. |
הסבר על השלבים ואופטימיזציה שלהם
בקטעים הבאים מוסבר איך לפרש את השלבים בתוכנית לביצוע שאילתה, ומוצגות דרכים לאופטימיזציה של השאילתות.
שלב אחד (READ)
השלב READ מציין ששלב מסוים ניגש לנתונים לצורך עיבוד. אפשר לקרוא נתונים ישירות מהטבלאות שאליהן מפנה השאילתה, או מזיכרון ה-shuffle.
כשנקראים נתונים משלב קודם, BigQuery קורא נתונים מזיכרון ה-shuffle. כמות הנתונים שנסרקים משפיעה על העלות כשמשתמשים במשבצות על פי דרישה, ומשפיעה על הביצועים כשמשתמשים בהזמנות.
בעיות אפשריות בביצועים
- סריקה גדולה של טבלה לא מחולקת: אם השאילתה צריכה רק חלק קטן מהנתונים, יכול להיות שסריקת הטבלה לא יעילה. חלוקה למחיצות יכולה להיות אסטרטגיית אופטימיזציה טובה.
- סריקה של טבלה גדולה עם יחס סינון קטן: מצב כזה מצביע על כך שהמסנן לא מצמצם ביעילות את הנתונים שנסרקים. כדאי לשנות את תנאי הסינון.
- Shuffle bytes spilled over to disk: מציין שהנתונים לא מאוחסנים בצורה יעילה באמצעות שיטות אופטימיזציה כמו אשכולות, שיכולות לשמור נתונים דומים באשכולות.
אופטימיזציה
- סינון ממוקד: משתמשים בסעיפי
WHEREבאופן אסטרטגי כדי לסנן נתונים לא רלוונטיים בשלב מוקדם ככל האפשר בשאילתה. כך מצמצמים את כמות הנתונים שצריך לעבד בשאילתה. - חלוקה למחיצות וסידור באשכולות: ב-BigQuery משתמשים בחלוקה למחיצות ובסידור באשכולות של טבלאות כדי לאתר ביעילות פלחים ספציפיים של נתונים.
כדי לצמצם את כמות הנתונים שנסרקים במהלך שלבי
READ, חשוב לוודא שהטבלאות מחולקות למחיצות ולאשכולות על סמך מבני השאילתות האופייניים. - בחירת עמודות רלוונטיות: הימנעו משימוש בהצהרות
SELECT *. במקום זאת, בחרו עמודות ספציפיות או השתמשו ב-SELECT * EXCEPTכדי להימנע מקריאת נתונים מיותרים. - תצוגות מהותיות: תצוגות מהותיות יכולות לחשב מראש ולאחסן צבירות נתונים שנמצאות בשימוש תכוף, וכך להפחית את הצורך לקרוא מסדי נתונים טבלאיים במהלך שלבי
READלשאילתות שמשתמשות בתצוגות האלה.
שלב אחד (COMPUTE)
בשלב COMPUTE, BigQuery מבצע את הפעולות הבאות על הנתונים:
- הערכת ביטויים בסעיפים
SELECT,WHERE,HAVINGוסעיפים אחרים של השאילתה, כולל חישובים, השוואות ופעולות לוגיות. - מריץ פונקציות SQL מובנות ופונקציות בהגדרת המשתמש.
- מסנן שורות של נתונים על סמך תנאים בשאילתה.
אופטימיזציה
התוכנית לביצוע השאילתה יכולה לחשוף צווארי בקבוק בשלב COMPUTE. חפשו שלבים עם חישובים נרחבים או מספר גבוה של שורות שעובדו.
- התאמה בין השלב
COMPUTEלנפח הנתונים: אם שלב מסוים מציג חישוב משמעותי ומעבד נפח גדול של נתונים, יכול להיות שהוא מועמד טוב לאופטימיזציה. - נתונים מוטים: בשלבים שבהם ערך המקסימום של המחשוב גבוה משמעותית מהממוצע של המחשוב, זה מצביע על כך שהשלב השקיע זמן לא פרופורציונלי בעיבוד של כמה פרוסות נתונים. כדאי לבדוק את התפלגות הנתונים כדי לראות אם יש חלוקת נתונים לא מאוזנת.
- סוגי נתונים: השתמשו בסוגי נתונים שמתאימים לעמודות. לדוגמה, שימוש במספרים שלמים, בתאריכים ובשעות ובחותמות זמן במקום במחרוזות יכול לשפר את הביצועים.
שלב אחד (WRITE)
שלבי WRITE מתרחשים עבור נתוני ביניים ופלט סופי.
- כתיבה לזיכרון של ערבוב: בשאילתה עם כמה שלבים, השלב
WRITEכולל לעיתים קרובות שליחה של הנתונים המעובדים לשלב אחר להמשך עיבוד. זה אופייני לזיכרון ערבוב, שמשלב או צובר נתונים מכמה מקורות. הנתונים שנכתבים בשלב הזה הם בדרך כלל תוצאת ביניים, ולא הפלט הסופי. - פלט סופי: תוצאת השאילתה נכתבת בטבלת היעד או בטבלה זמנית.
חלוקה למחיצות לפי גיבוב (hash)
כששלב בתוכנית לביצוע שאילתה כותב נתונים לפלט של חלוקה למחיצות באמצעות גיבוב, BigQuery כותב את העמודות שנכללות בפלט ואת העמודה שנבחרה כמפתח המחיצה.
אופטימיזציה
יכול להיות שלא תהיה לכם אפשרות לבצע אופטימיזציה ישירה של השלב WRITE, אבל אם תבינו את התפקיד שלו, תוכלו לזהות צווארי בקבוק פוטנציאליים בשלבים מוקדמים יותר:
- צמצום כתיבת הנתונים: מתמקדים באופטימיזציה של השלבים הקודמים באמצעות סינון וצבירה, כדי לצמצם את כמות הנתונים שנכתבים בשלב הזה.
חלוקה למחיצות: כתיבה מפיקה תועלת רבה מחלוקת טבלאות למחיצות. אם הנתונים שאתם כותבים מוגבלים למחיצות ספציפיות, BigQuery יכול לבצע כתיבה מהירה יותר.
אם לפקודת ה-DML יש משפט
WHEREעם תנאי סטטי לעמודת חלוקה למחיצות של טבלה, המערכת של BigQuery משנה רק את המחיצות הרלוונטיות בטבלה.פשרות חלופית לביטול נורמליזציה: ביטול נורמליזציה יכול לפעמים להוביל לקבוצות קטנות יותר של תוצאות בשלב הביניים
WRITE. עם זאת, יש גם חסרונות, כמו שימוש מוגבר בנפח אחסון נדרש ואתגרים שקשורים לעקביות הנתונים.
שלב אחד (JOIN)
בשלב JOIN, BigQuery משלב נתונים משני מקורות נתונים.
הצירופים יכולים לכלול תנאי צירוף. פעולות JOIN דורשות הרבה משאבים. כשמאחדים נתונים גדולים ב-BigQuery, מפתחות האיחוד ממוינים (shuffle) בנפרד כדי להתיישר באותו חריץ, כך שהאיחוד מתבצע באופן מקומי בכל חריץ.
התוכנית לביצוע השאילתה בשלב JOIN בדרך כלל חושפת את הפרטים הבאים:
- תבנית איחוד: מציינת את סוג האיחוד שבו נעשה שימוש. כל סוג מגדיר כמה שורות מהטבלאות המצורפות נכללות בקבוצת התוצאות.
- עמודות איחוד: אלה העמודות שמשמשות להתאמת שורות בין מקורות הנתונים. בחירת העמודות היא קריטית לביצועי הצירוף.
תבניות של איחוד (join)
- איחוד מסוג Broadcast: כשטבלה אחת, בדרך כלל הקטנה יותר, יכולה להתאים לזיכרון בצומת עובד או ב-slot אחד, BigQuery יכולה לשדר אותה לכל הצמתים האחרים כדי לבצע את האיחוד ביעילות. חפשו את
JOIN EACH WITH ALLבפרטי השלב. - צירוף גיבוב (hash): כשהטבלאות גדולות או כשצירוף שידור לא מתאים, אפשר להשתמש בצירוף גיבוב. BigQuery משתמש בפעולות גיבוב (hash) וערבוב (shuffle) כדי לערבב את הטבלאות השמאלית והימנית, כך שהמפתחות התואמים יגיעו לאותו חריץ כדי לבצע איחוד מקומי. פעולות של איחוד גיבוב (hash) הן פעולות יקרות כי צריך להעביר את הנתונים, אבל הן מאפשרות התאמה יעילה של שורות בין גיבובים. חפשו את
JOIN EACH WITH EACHבפרטי השלב. - Self join: תבנית אנטי-פטרן ב-SQL שבה טבלה מאוחדת עם עצמה.
- שאילתת איחוד (cross join): דפוס אנטי-תבניתי ב-SQL שיכול לגרום לבעיות משמעותיות בביצועים, כי הוא יוצר נתוני פלט גדולים יותר מהקלט.
- איחוד מוטה: התפלגות הנתונים במפתח האיחוד בטבלה אחת מוטה מאוד, ויכולה לגרום לבעיות בביצועים. חפשו מקרים שבהם זמן החישוב המקסימלי גדול בהרבה מזמן החישוב הממוצע בתוכנית לביצוע השאילתה. למידע נוסף, קראו את המאמרים High cardinality join ו-Partition skew.
ניפוי באגים
- נפח נתונים גדול: אם בתוכנית לביצוע השאילתה מוצגת כמות משמעותית של נתונים שעובדו במהלך השלב
JOIN, צריך לבדוק את תנאי הצירוף ואת מפתחות הצירוף. כדאי לסנן או להשתמש במפתחות צירוף סלקטיביים יותר. - התפלגות נתונים מוטה: ניתוח התפלגות הנתונים של מפתחות האיחוד (join). אם טבלה אחת מוטה מאוד, כדאי לבדוק אסטרטגיות כמו פיצול השאילתה או סינון מראש.
- איחודים בעלי עוצמה גבוהה: איחודים שמפיקים הרבה יותר שורות ממספר שורות הקלט השמאליות והימניות יכולים להפחית באופן משמעותי את ביצועי השאילתה. הימנעו מצירופים שיוצרים מספר גדול מאוד של שורות.
- סדר שגוי של הטבלה: ודאו שבחרתם את סוג הצירוף המתאים, כמו
INNERאוLEFT, ושהטבלאות מסודרות מהגדולה ביותר לקטנה ביותר בהתאם לדרישות של השאילתה.
אופטימיזציה
- מפתחות איחוד סלקטיביים: למפתחות איחוד, השתמשו ב-
INT64במקום ב-STRINGכשאפשר. השוואות שלSTRINGאיטיות יותר מהשוואות שלINT64כי הן משוות כל תו במחרוזת. מספרים שלמים דורשים רק השוואה אחת. - סינון לפני צירוף: הפעלת מסנני פסוקיות
WHEREעל טבלאות נפרדות לפני הצירוף. כך מצמצמים את כמות הנתונים שמעורבים בפעולת הצירוף. - הימנעו מפונקציות בעמודות של צירוף: הימנעו מקריאה לפונקציות בעמודות של צירוף. במקום זאת, כדאי להשתמש בצינורות עיבוד נתונים של ELT SQL כדי להפוך את נתוני הטבלה לסטנדרטיים במהלך תהליך ההטמעה או אחריו. הגישה הזו מייתרת את הצורך לשנות עמודות איחוד באופן דינמי, וכך מאפשרת איחודים יעילים יותר בלי לפגוע בתקינות הנתונים.
- הימנעו מ-self-join: בדרך כלל משתמשים ב-self-join כדי לחשב קשרים שתלויים בשורות. עם זאת, שאילתות self-join יכולות להגדיל פי 4 את מספר שורות הפלט, וכתוצאה מכך לגרום לבעיות בביצועים. במקום להסתמך על self-join, כדאי להשתמש בפונקציות חלון (אנליטיות).
- טבלאות גדולות קודם: למרות שהכלי לאופטימיזציה של שאילתות SQL יכול לקבוע איזו טבלה צריכה להיות בכל צד של האיחוד, סדרו את הטבלאות המאוחדות בצורה מתאימה. השיטה המומלצת היא למקם את הטבלה הגדולה ביותר בהתחלה, אחריה את הטבלה הקטנה ביותר, ואז את שאר הטבלאות בסדר יורד לפי הגודל שלהן.
- ביטול נורמליזציה: במקרים מסוימים, ביטול נורמליזציה של טבלאות באופן אסטרטגי (הוספת נתונים מיותרים) יכול לבטל את הצורך בצירופים. עם זאת, לגישה הזו יש חסרונות שקשורים לאחסון ולעקביות של הנתונים.
- חלוקה למחיצות וקיבוץ באשכולות: חלוקת טבלאות למחיצות על סמך מפתחות איחוד וקיבוץ באשכולות של נתונים שנמצאים באותו מיקום יכולים להאיץ משמעותית את פעולות האיחוד, כי הם מאפשרים ל-BigQuery לטרגט מחיצות נתונים רלוונטיות.
- אופטימיזציה של שאילתות איחוד לא מאוזנות: כדי למנוע בעיות בביצועים שקשורות לשאילתות איחוד לא מאוזנות, כדאי לסנן מראש את הנתונים מהטבלה מוקדם ככל האפשר, או לפצל את השאילתה לשתי שאילתות או יותר.
שלב אחד (AGGREGATE)
בשלב AGGREGATE, BigQuery צובר ומקבץ נתונים.
ניפוי באגים
- פרטי השלב: בודקים את מספר שורות הקלט והפלט של הצבירה, ואת גודל ערבול הנתונים (data shuffling) כדי לקבוע כמה נתונים צומצמו בשלב הצבירה, ואם היה מעורב ערבול נתונים.
- גודל ה-shuffle: גודל shuffle גדול יכול להצביע על כך שכמות משמעותית של נתונים הועברה בין צומתי העובדים במהלך הצבירה.
- בודקים את התפלגות הנתונים: מוודאים שהנתונים מפוזרים באופן שווה בין המחיצות. התפלגות נתונים מוטה עלולה להוביל לעומסי עבודה לא מאוזנים בשלב הצבירה.
- בדיקת צבירות: מנתחים את סעיפי הצבירה כדי לוודא שהם נחוצים ויעילים.
אופטימיזציה
- אשכולות: כדאי לארגן את הטבלאות באשכולות לפי עמודות שמשתמשים בהן לעיתים קרובות בסעיפי
GROUP BY,COUNTאו בסעיפי צבירה אחרים. - חלוקה למחיצות: בחרו אסטרטגיית חלוקה למחיצות שמתאימה למבנה השאילתות שלכם. כדי לצמצם את כמות הנתונים שנסרקים במהלך הצבירה, מומלץ להשתמש בטבלאות שמחולקות למחיצות לפי זמני כתיבת הנתונים.
- צבירה מוקדמת: אם אפשר, בצעו צבירות בשלב מוקדם יותר בצינור עיבוד הנתונים של השאילתה. כך אפשר לצמצם את כמות הנתונים שצריך לעבד במהלך הצבירה.
- אופטימיזציה של ערבוב: אם הערבוב הוא צוואר בקבוק, כדאי לבדוק איך אפשר לצמצם אותו. לדוגמה, לבטל נורמליזציה של טבלאות או להשתמש באשכולות כדי למקם נתונים רלוונטיים באותו מקום.
מקרי קצה
- צבירות DISTINCT: שאילתות עם צבירות
DISTINCTיכולות להיות יקרות מבחינה חישובית, במיוחד במערכי נתונים גדולים. כדי לקבל תוצאות משוערות, אפשר להשתמש בפונקציות חלופיות כמוAPPROX_COUNT_DISTINCT. - מספר גדול של קבוצות: אם השאילתה יוצרת מספר עצום של קבוצות, היא עלולה לצרוך כמות משמעותית של זיכרון. במקרים כאלה, כדאי להגביל את מספר הקבוצות או להשתמש באסטרטגיית צבירה אחרת.
שלב אחד (REPARTITION)
גם REPARTITION וגם COALESCE הן שיטות אופטימיזציה ש-BigQuery מיישם ישירות על הנתונים שעברו ערבוב בשאילתה.
-
REPARTITION: הפעולה הזו נועדה לאזן מחדש את חלוקת הנתונים בין צומתי העובדים. נניח שאחרי הערבוב, צומת עובד אחד מקבל כמות גדולה באופן לא פרופורציונלי של נתונים. השלבREPARTITIONמפזר את הנתונים בצורה אחידה יותר, ומונע מצב שבו אחד מה-workers הופך לצוואר בקבוק. זה חשוב במיוחד לפעולות שדורשות משאבי מחשוב רבים, כמו צירופים. -
COALESCE: השלב הזה מתרחש כשיש הרבה קטגוריות קטנות של נתונים אחרי הערבוב. בשלבCOALESCE, הקטגוריות האלה משולבות לקטגוריות גדולות יותר, וכך מצטמצם התקורה שקשורה לניהול של הרבה נתונים קטנים. האפשרות הזו יכולה להיות שימושית במיוחד כשעובדים עם קבוצות קטנות מאוד של תוצאות ביניים.
אם מופיעים שלבים של REPARTITION או COALESCE בתוכנית לביצוע השאילתה, זה לא בהכרח אומר שיש בעיה בשאילתה. לרוב זה סימן לכך ש-BigQuery מבצע אופטימיזציה יזומה של הפצת הנתונים כדי לשפר את הביצועים. עם זאת, אם הפעולות האלה מופיעות שוב ושוב, יכול להיות שהנתונים מוטים באופן מהותי או שהשאילתה גורמת לערבול נתונים מוגזם.
אופטימיזציה
כדי לצמצם את מספר השלבים של REPARTITION, אפשר לנסות את הפעולות הבאות:
- הפצת נתונים: חשוב לוודא שהטבלאות מחולקות למחיצות ולאשכולות בצורה יעילה. נתונים שמפוזרים בצורה טובה מפחיתים את הסיכוי לחוסר איזון משמעותי אחרי הערבוב.
- מבנה השאילתה: ניתוח השאילתה כדי לאתר מקורות פוטנציאליים לחלוקת נתונים לא מאוזנת. לדוגמה, האם יש מסננים או איחודים סלקטיביים מאוד שגורמים לעיבוד של קבוצת משנה קטנה של נתונים ב-worker יחיד?
- אסטרטגיות של צירוף: כדאי לנסות אסטרטגיות שונות של צירוף כדי לבדוק אם הן מובילות לפיזור נתונים מאוזן יותר.
כדי לצמצם את מספר השלבים של COALESCE, אפשר לנסות את הפעולות הבאות:
- אסטרטגיות צבירה: כדאי לבצע צבירות בשלב מוקדם יותר בצינור עיבוד הנתונים של השאילתה. כך אפשר לצמצם את מספר קבוצות התוצאות הקטנות של שלבי הביניים, שעלולות לגרום לשלבי
COALESCE. - נפח הנתונים: אם אתם עובדים עם מערכי נתונים קטנים מאוד, יכול להיות ש-
COALESCEלא יהיה בעיה משמעותית.
אל תבצעו אופטימיזציית יתר. אופטימיזציה מוקדמת מדי עלולה להפוך את השאילתות למורכבות יותר בלי להניב יתרונות משמעותיים.
UPDATE, DELETE ו-MERGE צעדים
השלבים UPDATE, DELETE ו-MERGE מופיעים בשלבים שמריצים הצהרות של שפת טיפול בנתונים (DML) בטבלת יעד.
פרטי השלב כוללים בדרך כלל את שלבי המשנה הבאים:
- עמודות: העמודות שנקראות מטבלת היעד או נכתבות אליה.
- טבלת היעד (
FROMאוINTO): טבלת היעד ששונתה על ידי ההצהרה, באמצעותFROMלשלביםUPDATEו-DELETE, ו-INTOלשלביםMERGE.
שלב אחד (EXPORT)
בשלב EXPORT, נתוני הפלט נכתבים בטבלת יעד. השלב הזה מופיע בדרך כלל בשלבים הסופיים של פקודות DML, כמו INSERT, UPDATE, DELETE ו-MERGE, ובשאילתות שיוצרות תוצאות בטבלת יעד.
פרטי השלב כוללים בדרך כלל את שלבי המשנה הבאים:
- עמודות פלט: רשימת המשתנים שנכתבו בטבלת היעד.
- טבלת היעד (
TO): טבלת היעד שמקבלת את השורות שיוצאו.
הסבר על שאילתות לכמה מסדי נתונים
שאילתות מאוחדות מאפשרות לשלוח הצהרת שאילתה למקור נתונים חיצוני באמצעות הפונקציה EXTERNAL_QUERY.
שאילתות לכמה מסדי נתונים כפופות לטכניקת האופטימיזציה שנקראת SQL pushdowns, ובתוכנית לביצוע השאילתה מוצגות פעולות שנדחפו למקור הנתונים החיצוני, אם יש כאלה. לדוגמה, אם מריצים את השאילתה הבאה:
SELECT id, name
FROM EXTERNAL_QUERY("<connection>", "SELECT * FROM company")
WHERE country_code IN ('ee', 'hu') AND name like '%TV%'
בתוכנית לביצוע השאילתה יופיעו השלבים הבאים:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, country_code
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
  WHERE in(country_code, 'ee', 'hu')
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
בתוכנית הזו, table_for_external_query_$_0(...) מייצג את הפונקציה EXTERNAL_QUERY. בסוגריים אפשר לראות את השאילתה שמקור הנתונים החיצוני מריץ. על סמך זה, אפשר לראות ש:
- מקור נתונים חיצוני מחזיר רק 3 עמודות שנבחרו.
- מקור נתונים חיצוני מחזיר רק שורות שבהן הערך של
country_codeהוא'ee'או'hu'. - האופרטור
LIKEלא מועבר למטה, והוא מוערך על ידי BigQuery.
לשם השוואה, אם אין דחיפות, בתוכנית לביצוע השאילתה יוצגו השלבים הבאים:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, description, country_code, primary_address, secondary address
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
הפעם, מקור נתונים חיצוני מחזיר את כל העמודות ואת כל השורות מהטבלה company, ו-BigQuery מבצע סינון.
מטא-נתונים של ציר הזמן
ציר הזמן של השאילתה מדווח על ההתקדמות בנקודות זמן ספציפיות, ומספק תמונות מצב של ההתקדמות הכוללת של השאילתה. ציר הזמן מיוצג כסדרה של דגימות שמדווחות על הפרטים הבאים:
| שדה | תיאור |
|---|---|
elapsedMs |
אלפיות השנייה שחלפו מאז תחילת ביצוע השאילתה. |
totalSlotMs |
ייצוג מצטבר של אלפיות השנייה של משבצות ששימשו את השאילתה. |
pendingUnits |
המספר הכולל של יחידות העבודה שתוזמנו וממתינות לביצוע. |
activeUnits |
המספר הכולל של יחידות עבודה פעילות שמעובדות על ידי ה-workers. |
completedUnits |
סך כל יחידות העבודה שהושלמו במהלך ביצוע השאילתה הזו. |
שאילתה לדוגמה
השאילתה הבאה סופרת את מספר השורות במערך הנתונים הציבורי של שייקספיר, ויש בה ספירה מותנית שנייה שמגבילה את התוצאות לשורות שמפנות ל-'hamlet':
SELECT
  COUNT(1) as rowcount,
  COUNTIF(corpus = 'hamlet') as rowcount_hamlet
FROM `publicdata.samples.shakespeare`
לוחצים על Execution details כדי לראות את תוכנית השאילתה:
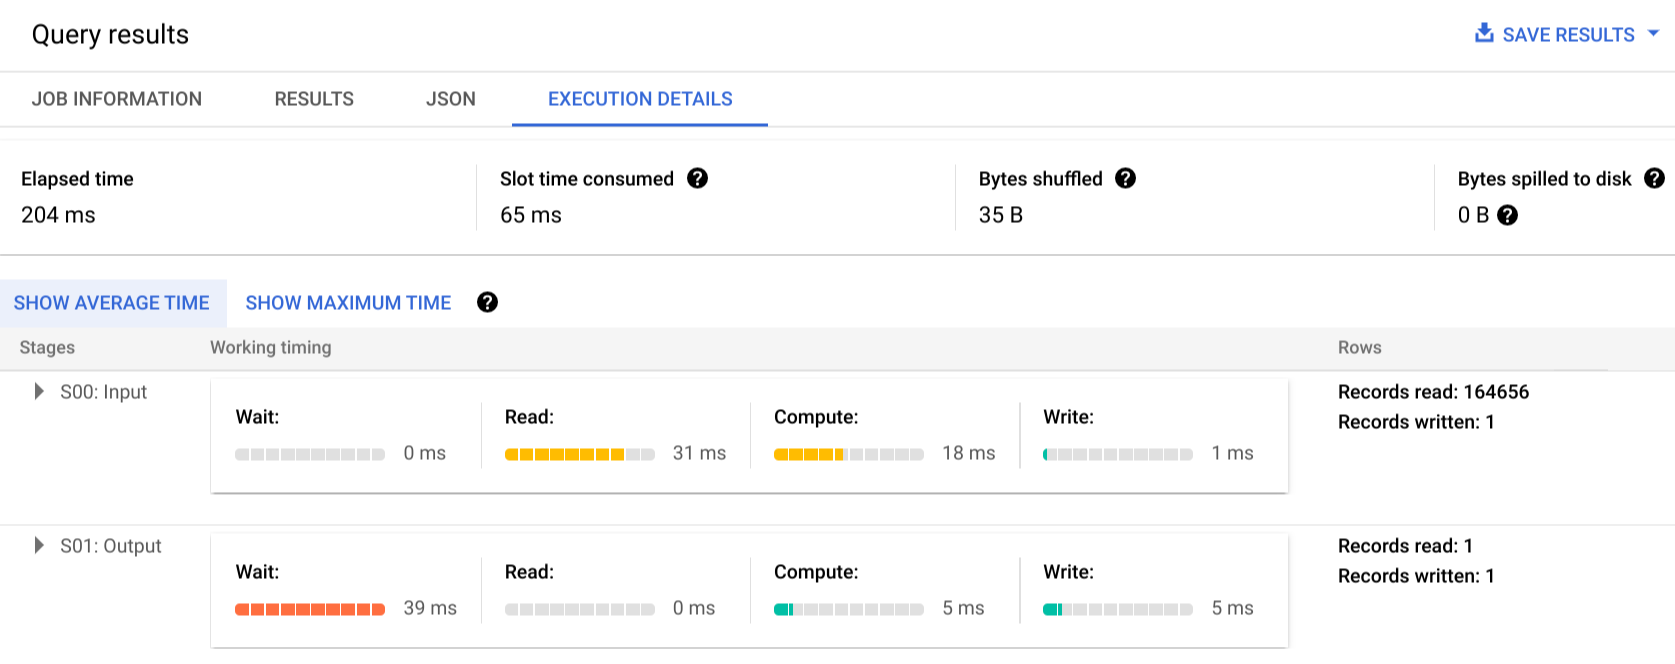
אינדיקטורים של צבעים מציגים את התזמונים היחסיים של כל השלבים בכל השלבים.
כדי לקבל מידע נוסף על השלבים של שלבי הביצוע, לוחצים על כדי להרחיב את פרטי השלב:
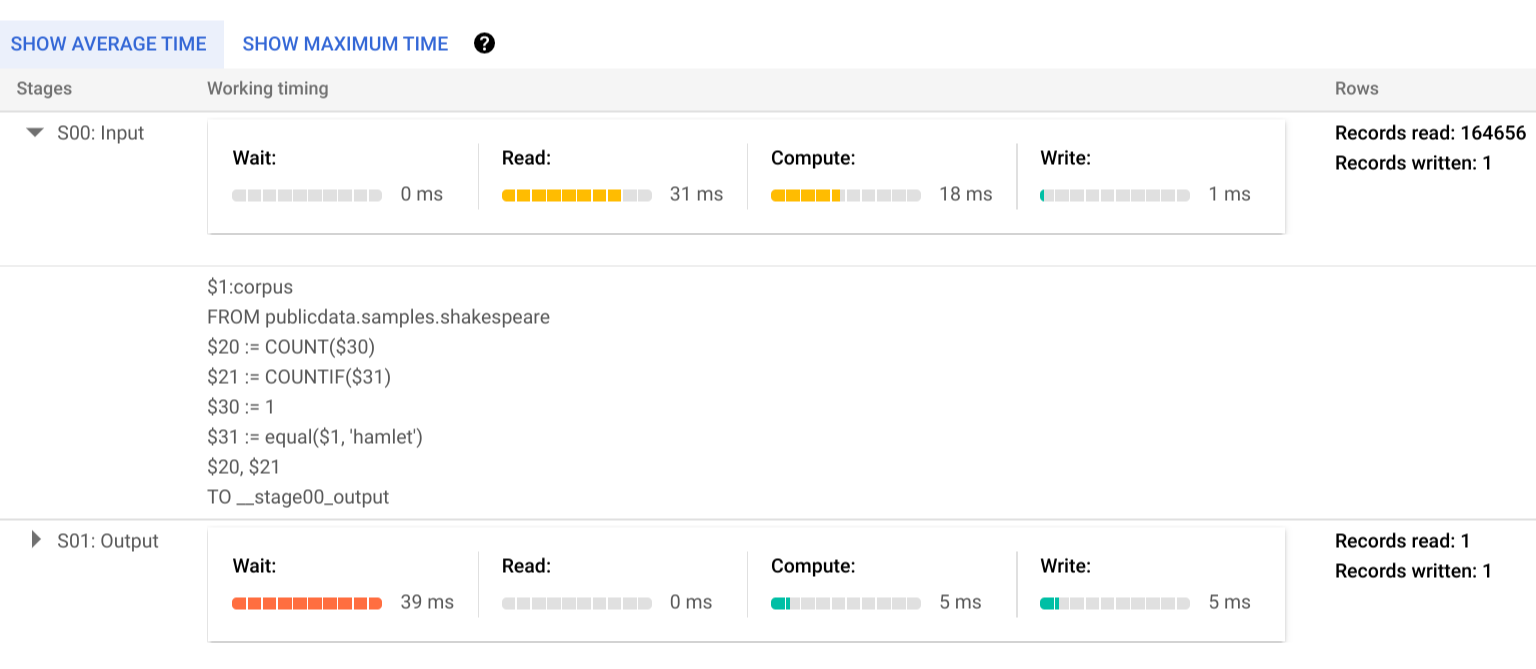
בדוגמה הזו, משך הזמן הארוך ביותר בכל קטע היה הזמן שבו העובד היחיד בשלב 01 המתין להשלמת שלב 00. הסיבה לכך היא ששלב 01 היה תלוי בקלט של שלב 00, ולא יכול היה להתחיל עד שהשלב הראשון כתב את הפלט שלו לערבוב ביניים.
Error Reporting
יכול להיות שמשימות שאילתה ייכשלו באמצע הביצוע. פרטי התוכנית מתעדכנים מדי פעם, כך שאתם יכולים לראות איפה בתרשים הביצוע אירע הכשל. במסוף Google Cloud , שלבים שהצליחו או נכשלו מסומנים בסימן וי או בסימן קריאה ליד שם השלב.
למידע נוסף על פירוש שגיאות וטיפול בהן, עיינו במדריך לפתרון בעיות.
ייצוג לדוגמה של API
המידע על תוכנית לביצוע שאילתה מוטמע במידע על התגובה למשימה, ואפשר לאחזר אותו באמצעות קריאה ל-jobs.get.
לדוגמה, הקטע הבא של תגובת JSON למשימה שמחזירה את שאילתת הדגימה של hamlet, מציג גם את תוכנית לביצוע שאילתה וגם את פרטי ציר הזמן.
"statistics": {
  "creationTime": "1576544129234",
  "startTime": "1576544129348",
  "endTime": "1576544129681",
  "totalBytesProcessed": "2464625",
  "query": {
    "queryPlan": [
      {
        "name": "S00: Input",
        "id": "0",
        "startMs": "1576544129436",
        "endMs": "1576544129465",
        "waitRatioAvg": 0.04,
        "waitMsAvg": "1",
        "waitRatioMax": 0.04,
        "waitMsMax": "1",
        "readRatioAvg": 0.32,
        "readMsAvg": "8",
        "readRatioMax": 0.32,
        "readMsMax": "8",
        "computeRatioAvg": 1,
        "computeMsAvg": "25",
        "computeRatioMax": 1,
        "computeMsMax": "25",
        "writeRatioAvg": 0.08,
        "writeMsAvg": "2",
        "writeRatioMax": 0.08,
        "writeMsMax": "2",
        "shuffleOutputBytes": "18",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "164656",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$1:corpus",
              "FROM publicdata.samples.shakespeare"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$20 := COUNT($30)",
              "$21 := COUNTIF($31)"
            ]
          },
          {
            "kind": "COMPUTE",
            "substeps": [
              "$30 := 1",
              "$31 := equal($1, 'hamlet')"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$20, $21",
              "TO __stage00_output"
            ]
          }
        ]
      },
      {
        "name": "S01: Output",
        "id": "1",
        "startMs": "1576544129465",
        "endMs": "1576544129480",
        "inputStages": [
          "0"
        ],
        "waitRatioAvg": 0.44,
        "waitMsAvg": "11",
        "waitRatioMax": 0.44,
        "waitMsMax": "11",
        "readRatioAvg": 0,
        "readMsAvg": "0",
        "readRatioMax": 0,
        "readMsMax": "0",
        "computeRatioAvg": 0.2,
        "computeMsAvg": "5",
        "computeRatioMax": 0.2,
        "computeMsMax": "5",
        "writeRatioAvg": 0.16,
        "writeMsAvg": "4",
        "writeRatioMax": 0.16,
        "writeMsMax": "4",
        "shuffleOutputBytes": "17",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "1",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$20, $21",
              "FROM __stage00_output"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$10 := SUM_OF_COUNTS($20)",
              "$11 := SUM_OF_COUNTS($21)"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$10, $11",
              "TO __stage01_output"
            ]
          }
        ]
      }
    ],
    "estimatedBytesProcessed": "2464625",
    "timeline": [
      {
        "elapsedMs": "304",
        "totalSlotMs": "50",
        "pendingUnits": "0",
        "completedUnits": "2"
      }
    ],
    "totalPartitionsProcessed": "0",
    "totalBytesProcessed": "2464625",
    "totalBytesBilled": "10485760",
    "billingTier": 1,
    "totalSlotMs": "50",
    "cacheHit": false,
    "referencedTables": [
      {
        "projectId": "publicdata",
        "datasetId": "samples",
        "tableId": "shakespeare"
      }
    ],
    "statementType": "SELECT"
  },
  "totalSlotMs": "50"
},
שימוש בפרטי ההרצה
תוכניות לביצוע שאילתות ב-BigQuery מספקות מידע על האופן שבו השירות מבצע שאילתות, אבל בגלל שהשירות מנוהל, לא תמיד אפשר לבצע פעולות ישירות על סמך הפרטים האלה. הרבה אופטימיזציות מתרחשות באופן אוטומטי באמצעות השירות, מה שיכול להיות שונה מסביבות אחרות שבהן כוונון, הקצאה ומעקב עשויים לדרוש צוות ייעודי ובעל ידע.
במסמכי התיעוד של השיטות המומלצות מפורטות טכניקות ספציפיות לשיפור הביצועים וההרצה של השאילתות. הנתונים הסטטיסטיים של התוכנית לביצוע השאילתה וציר הזמן יכולים לעזור לכם להבין אם שלבים מסוימים משפיעים יותר על ניצול המשאבים. לדוגמה, שלב JOIN שמפיק הרבה יותר שורות פלט מאשר שורות קלט יכול להצביע על הזדמנות לסנן בשלב מוקדם יותר בשאילתה.
בנוסף, המידע על ציר הזמן יכול לעזור לזהות אם שאילתה מסוימת איטית בפני עצמה או בגלל השפעות של שאילתות אחרות שמתחרות על אותם משאבים. אם אתם רואים שמספר היחידות הפעילות נשאר מוגבל לאורך כל משך השאילתה, אבל מספר יחידות העבודה בתור נשאר גבוה, יכול להיות שהפחתת מספר השאילתות בו-זמנית תשפר משמעותית את זמן הביצוע הכולל של שאילתות מסוימות.