


Introdução aos pipelines do BigQuery
É possível usar pipelines do BigQuery para automatizar e simplificar seus processos de dados do BigQuery. Com os pipelines, é possível programar e executar recursos de código em sequência para melhorar a eficiência e reduzir o esforço manual.
Visão geral
Os pipelines são gerados pelo Dataform. Além de executar recursos de código, o Dataform atualiza automaticamente os metadados no Knowledge Catalog para tabelas criadas em um pipeline.
Um pipeline consiste em um ou mais dos seguintes recursos de código:
- Notebooks
- Consultas SQL
- Preparação de dados
- Tarefas do SQLX, incluindo tabelas, visualizações, fontes e testes de qualidade de dados
É possível usar pipelines para programar a execução de recursos de código. Por exemplo, é possível programar uma consulta SQL para ser executada diariamente e atualizar uma tabela com os dados de origem mais recentes, que podem alimentar um painel.
Em um pipeline com vários recursos de código, você define a sequência de execução. Por exemplo, para treinar um modelo de machine learning, você pode criar um fluxo de trabalho em que uma consulta SQL prepara os dados e um notebook subsequente treina o modelo usando esses dados.
Quando você aciona uma execução de pipeline, o BigQuery executa as ações na ordem definida pelas dependências. Para cada ação, o BigQuery realiza as seguintes etapas:
- Executa o SQL compilado no BigQuery.
- Atualiza o status da ação no registro de execução.
- Após a conclusão de uma ação, o Dataform inicia automaticamente uma sincronização de metadados com o Knowledge Catalog. Esse processo de enriquecimento atualiza o Knowledge Catalog com os metadados semânticos definidos na sua configuração do SQLX. A sincronização acontece de forma assíncrona e usa um mecanismo de novas tentativas, garantindo que as atualizações de metadados não afetem a latência do pipeline nem causem falhas no fluxo de trabalho se a API Dataplex estiver temporariamente indisponível.
Recursos
Em um pipeline, é possível fazer o seguinte:
- Crie ou importe consultas SQL, notebooks, preparações de dados ou tarefas SQLX para um pipeline.
- Programe um pipeline para ser executado automaticamente em um horário e frequência especificados.
- Compartilhe um pipeline com usuários ou grupos específicos.
- Compartilhe um link para um pipeline.
Limitações
Os pipelines estão sujeitos às seguintes limitações:
- Os pipelines estão disponíveis apenas no console do Google Cloud .
- Não é possível mudar a região de armazenamento de um pipeline depois que ele é criado.
- É possível conceder acesso a usuários ou grupos a um pipeline selecionado, mas não a tarefas individuais dentro dele.
- Se uma execução programada de pipeline não for concluída antes do início da próxima execução programada, ela será ignorada e marcada com um erro.
Definir a região padrão para recursos de código
Todos os novos recursos de código no seu projeto Google Cloud usam uma região padrão. Depois que o recurso é criado, não é possível mudar a região dele.
Para definir a região padrão dos novos recursos de código, faça o seguinte:
Acessar a página do BigQuery.
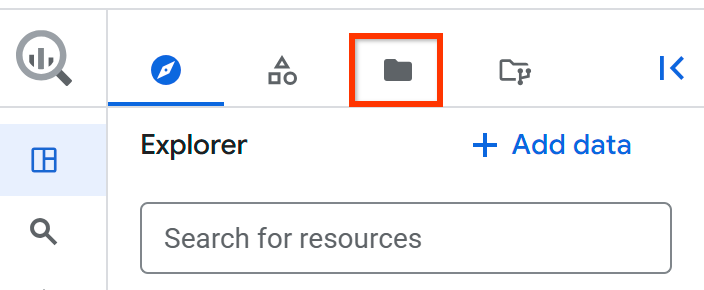
No painel à esquerda, clique em Arquivos para abrir o navegador de arquivos:
Ao lado do nome do projeto, clique em Ver ações do painel de arquivos > Mudar região de código.
Selecione a região de código que você quer usar como padrão.
Clique em Salvar.
Para conferir uma lista de regiões compatíveis, consulte Locais do BigQuery Studio.
Todos os recursos de código são armazenados na sua região padrão para recursos de código. A atualização da região padrão muda a região de todos os recursos de código criados depois desse ponto.
Cotas e limites
Os pipelines do BigQuery estão sujeitos a cotas e limites do Dataform.
Preços
A execução de tarefas de pipeline do BigQuery gera cobranças de computação e armazenamento no BigQuery. Para mais informações, consulte preços do BigQuery.
Os pipelines que contêm notebooks geram cobranças de ambiente de execução do Colab Enterprise com base no tipo de máquina padrão. Para mais detalhes sobre preços, consulte Preços do Colab Enterprise.
Cada execução de pipeline do BigQuery é registrada usando o Cloud Logging. A geração de registros é ativada automaticamente para execuções de pipeline do BigQuery, o que pode gerar cobranças de faturamento do Cloud Logging. Para mais informações, consulte os preços do Cloud Logging.
A seguir
- Saiba como criar pipelines.
- Saiba como gerenciar pipelines.
- Saiba como programar pipelines.