


Gerenciar pipelines
Neste documento, descrevemos como gerenciar pipelines do BigQuery, incluindo como visualizar, programar, implantar e excluir pipelines.
Este documento também descreve como visualizar e gerenciar metadados de pipeline no Knowledge Catalog.
Os pipelines são gerados pelo Dataform. É possível organizar e gerenciar pipelines armazenados em Arquivos e pastas (pastas do usuário e da equipe) ou em repositórios Git do BigQuery Studio (pastas Git) (prévia).
Antes de começar
- Crie um pipeline do BigQuery.
- Para gerenciar metadados de pipeline no Knowledge Catalog, verifique se a API Dataplex está ativada no seu Google Cloud projeto.
Funções exigidas
Para receber as permissões necessárias para gerenciar pipelines, peça ao administrador que conceda a você os seguintes papéis do IAM:
-
Para ver e executar pipelines:
- Leitor do Dataform (
roles/dataform.Viewer) no projeto - Usuário de jobs do BigQuery (
roles/bigquery.jobUser) no projeto
- Leitor do Dataform (
-
Para executar pipelines com credenciais de usuário de uma Conta do Google:
Editor de dados do BigQuery (
roles/bigquery.dataEditor) no projeto ou em conjuntos de dados específicos do BigQuery -
Para excluir pipelines:
Administrador do Dataform (
roles/dataform.Admin) no pipeline -
Para gerenciar pipelines em pastas de usuários:
- Proprietário do código (
roles/dataform.codeOwner) na pasta - Editor de código (
roles/dataform.codeEditor) na pasta - Leitor de código (
roles/dataform.codeViewer) na pasta
- Proprietário do código (
-
Para gerenciar pipelines em pastas da equipe:
- Proprietário da pasta de equipe (
roles/dataform.teamFolderOwner) na pasta de equipe - Colaborador da pasta de equipe (
roles/dataform.teamFolderContributor) na pasta de equipe - Leitor de pastas de equipe (
roles/dataform.teamFolderViewer) na pasta de equipe
- Proprietário da pasta de equipe (
-
Para gerenciar pipelines em repositórios Git:
Usuário do OAuth do Developer Connect (
roles/developerconnect.oauthUser) no projeto -
Para visualizar e gerenciar metadados no Knowledge Catalog:
Editor do catálogo do Dataplex (
roles/dataplex.catalogEditor) no projeto ou grupo de entradas@bigquery
Para mais informações sobre a concessão de papéis, consulte Gerenciar o acesso a projetos, pastas e organizações.
Também é possível conseguir as permissões necessárias usando papéis personalizados ou outros papéis predefinidos.
Para mais informações sobre o IAM do Dataform, consulte Controlar o acesso com o IAM. Para mais informações sobre papéis para pastas, consulte Criar e gerenciar pastas. Para mais informações sobre os papéis dos repositórios Git, consulte Gerenciar código com repositórios Git do BigQuery Studio.
Se você usar uma conta de serviço personalizada para executar pipelines, conceda os seguintes papéis a ela:
- Usuário de jobs do BigQuery
(
roles/bigquery.jobUser) no projeto - Editor de dados do BigQuery
(
roles/bigquery.dataEditor) no projeto ou em conjuntos de dados específicos do BigQuery - Editor do catálogo do Dataplex
(
roles/dataplex.catalogEditor) no projeto ou no grupo de entradas@bigquery
Conferir pipelines
É possível conferir e inspecionar pipelines armazenados em pastas ou pastas do Git no painel Arquivos. É possível conferir pipelines independentes e pipelines armazenados em pastas no painel Explorer. Os pipelines armazenados em pastas do Git não são mostrados no painel Explorer.
Ver pipelines no painel "Arquivos"
Os pipelines armazenados em pastas ou pastas do Git aparecem diretamente no painel Arquivos.
Para conferir um pipeline armazenado em uma pasta ou pasta do Git, siga estas etapas:
No console Google Cloud , acesse a página BigQuery.
No painel à esquerda, clique em Arquivos para abrir o navegador de arquivos.
Se o painel esquerdo não aparecer, clique em Expandir painel esquerdo para abrir.
Abra a pasta Usuário, uma pasta de equipe ou uma pasta de repositório Git conectada.
Os pipelines são mostrados com um ícone Pipeline em vez de um ícone de pasta padrão.
Clique em uma pasta de pipeline para abrir o Visualizador de pipeline.
O Visualizador de pipeline mostra o gráfico acíclico dirigido (DAG) compilado das tarefas do pipeline, o status de execução e as guias de configuração.
Abra o diretório do pipeline no navegador de arquivos para procurar diretórios aninhados (como
definitions/) e arquivos de tarefas individuais.
Ver pipelines no painel do Explorer
Para conferir uma lista de pipelines independentes e pipelines armazenados em pastas, faça o seguinte:
No console Google Cloud , acesse a página BigQuery.
No painel à esquerda, clique em Explorer:
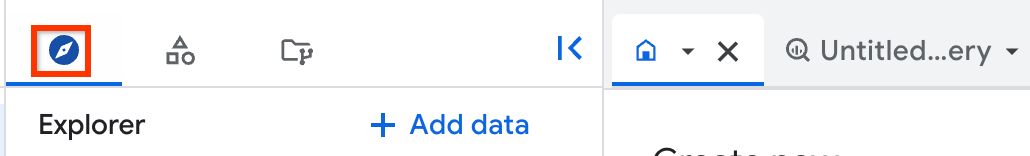
Se o painel esquerdo não aparecer, clique em Expandir painel esquerdo para abrir.
No painel Explorer, expanda o projeto e clique em Pipelines.
Selecione um pipeline para abrir no Visualizador de pipelines.
Conferir execuções manuais anteriores
Para conferir as execuções manuais anteriores de um pipeline selecionado, siga estas etapas:
No console Google Cloud , acesse a página BigQuery.
No painel à esquerda, clique em Explorer:
No painel Explorer, expanda seu projeto, clique em Pipelines e selecione um pipeline.
Clique em Execuções.
Opcional: para atualizar a lista de execuções anteriores, clique em Atualizar.
Configurar alertas para execuções de pipeline com falha
Cada pipeline tem um ID de repositório do Dataform correspondente. Cada execução do pipeline do BigQuery é registrada no Cloud Logging usando o ID do repositório do Dataform correspondente. Você pode usar o Cloud Monitoring para observar tendências nos registros do Cloud Logging para execuções de pipeline do BigQuery e receber notificações quando as condições descritas ocorrerem.
Para receber alertas quando uma execução de pipeline do BigQuery falhar, crie uma política de alertas baseada em registros para o ID de repositório do Dataform correspondente. Para instruções, consulte Configurar alertas para invocações de fluxo de trabalho com falha.
Para encontrar o ID do repositório do Dataform do seu pipeline, faça o seguinte:
No console Google Cloud , acesse a página BigQuery.
No painel à esquerda, clique em Explorer:
No painel Explorer, expanda seu projeto, clique em Pipelines e selecione um pipeline.
Clique em Configurações.
O ID do repositório do Dataform do seu pipeline é exibido na parte de baixo da guia Configurações.
Excluir um pipeline
Para excluir um pipeline de forma permanente, siga estas etapas:
- No console Google Cloud , acesse a página BigQuery. Acessar o BigQuery
Para excluir um pipeline armazenado em uma pasta ou pasta do Git, faça o seguinte:
No painel à esquerda, clique em Arquivos.
Na árvore de arquivos, encontre a pasta de pipeline que você quer excluir.
Clique em Ver ações ao lado da pasta do pipeline e clique em Excluir.
Na caixa de diálogo de confirmação, clique em Excluir.
A pasta do pipeline e todas as tarefas e arquivos contidos nela são excluídos do seu espaço de trabalho.
Para excluir um pipeline listado no painel Explorer, faça o seguinte:
No painel à esquerda, clique em Explorer:
No painel Explorer, expanda o projeto e clique em Pipelines.
Encontre o pipeline que você quer excluir.
Clique em Ver ações ao lado do pipeline e clique em Excluir.
Clique em Excluir.
Gerenciar metadados no Knowledge Catalog
O Knowledge Catalog permite armazenar e gerenciar metadados para pipelines. Os pipelines estão disponíveis no Knowledge Catalog por padrão, sem configuração adicional.
Você pode usar o Knowledge Catalog para gerenciar pipelines em todos os locais de pipeline. O gerenciamento de pipelines no Knowledge Catalog está sujeito às cotas e limites do Knowledge Catalog e aos preços do Knowledge Catalog.
O Knowledge Catalog recupera automaticamente os seguintes metadados dos pipelines:
- Nome do recurso de dados
- Recurso de dados principal
- Local do recurso de dados
- Tipo de recurso de dados
- Projeto Google Cloud correspondente
O Knowledge Catalog registra pipelines como entradas com os seguintes valores:
- Grupo de entradas do sistema
- O grupo de entrada do sistema
para pipelines é
@dataform. Para conferir os detalhes das entradas de pipeline no Knowledge Catalog, acesse o grupo de entradas do sistemadataform. Para instruções sobre como ver uma lista de todas as entradas em um grupo de entradas, consulte Ver detalhes de um grupo de entradas na documentação do Knowledge Catalog. - Tipo de entrada do sistema
- O tipo de entrada do sistema
para pipelines é
dataform-code-asset. Para ver detalhes dos pipelines, é necessário acessar o tipo de entrada do sistemadataform-code-asset, filtrar os resultados com um filtro baseado em aspecto e definir o campotypeno aspectodataform-code-assetcomoWORKFLOW. Em seguida, selecione uma entrada do pipeline escolhido. Para instruções sobre como ver detalhes de um tipo de entrada selecionado, consulte Ver detalhes de um tipo de entrada na documentação do Knowledge Catalog. Para instruções sobre como ver os detalhes de uma entrada selecionada, consulte Ver detalhes de uma entrada na documentação do Knowledge Catalog. - Tipo de aspecto do sistema
- O tipo de aspecto do sistema
para pipelines é
dataform-code-asset. Para fornecer mais contexto aos pipelines no Knowledge Catalog anotando entradas de pipeline de dados com aspectos, veja o tipo de aspectodataform-code-asset, filtre os resultados com um filtro baseado em aspecto e defina o campotypedentro do aspectodataform-code-assetcomoWORKFLOW. Para instruções sobre como anotar entradas com aspectos, consulte Gerenciar aspectos e enriquecer metadados na documentação do Knowledge Catalog. - Tipo
- O tipo para telas de dados é
WORKFLOW. Esse tipo permite filtrar pipelines no tipo de entrada do sistemadataform-code-assete no tipo de aspectodataform-code-assetusando a consultaaspect:dataplex-types.global.dataform-code-asset.type=WORKFLOWem um filtro baseado em aspectos.
Para instruções sobre como pesquisar recursos no Knowledge Catalog, consulte Pesquisar recursos de dados no Knowledge Catalog na documentação do Knowledge Catalog.
Integração de enriquecimento de metadados e painel de qualidade de dados
O Dataform pode publicar os seguintes metadados no Knowledge Catalog:
- Tipo de aspecto de visão geral
- Tipo de aspecto genérico
- Tipo de aspecto da tabela de qualidade de dados
As declarações do Dataform são integradas automaticamente ao painel de qualidade de dados do Knowledge Catalog. Durante a execução do pipeline, os resultados de todas as declarações do Dataform são publicados automaticamente no Knowledge Catalog. Esses resultados preenchem o quadro de indicadores de qualidade de dados do Knowledge Catalog com um status de aprovação ou reprovação.
Para verificar o status de uma atualização de metadados, siga as instruções em Conferir execuções manuais anteriores.
Depois que os metadados forem sincronizados, você poderá pesquisar e visualizar a entrada no Knowledge Catalog. Para mais informações, consulte Pesquisar recursos.
A seguir
- Saiba mais sobre os pipelines do BigQuery.
- Saiba como criar pipelines.
- Saiba como programar pipelines.
- Saiba como gerenciar código com repositórios Git do BigQuery Studio.
- Saiba como organizar recursos de código com pastas.
- Saiba mais sobre as implantações do Dataform.