


Introduzione a BigQuery Omni
Con BigQuery Omni, puoi eseguire analisi BigQuery sui dati archiviati in Amazon Simple Storage Service (Amazon S3) o Azure Blob Storage utilizzando le tabelle BigLake.
Molte organizzazioni archiviano i dati in più cloud pubblici. Spesso questi dati finiscono per essere isolati in silos, rendendo difficile ottenere insight trasversali su tutti i dati. Vuoi poter analizzare i dati con uno strumento di dati multi-cloud economico, veloce e che non crei un overhead aggiuntivo di governance dei dati decentralizzata. Utilizzando BigQuery Omni, riduciamo questi attriti con un'interfaccia unificata.
Per eseguire l'analisi BigQuery sui tuoi dati esterni, devi prima connetterti ad Amazon S3 o a Blob Storage. Se vuoi eseguire query su dati esterni, devi creare una tabella BigLake che faccia riferimento ai dati di Amazon S3 o Blob Storage.
Strumenti di BigQuery Omni
Puoi utilizzare i seguenti strumenti di BigQuery Omni per eseguire analisi BigQuery sui tuoi dati esterni:
- Join di BigQuery Omni: esegui una query direttamente da una regione BigQuery che può unire i dati di una regione BigQuery Omni.
- Viste materializzate di BigQuery Omni: utilizza le repliche delle viste materializzate per replicare continuamente i dati dalle regioni di BigQuery Omni. Supporta il filtro dei dati.
- Trasferimento di BigQuery Omni utilizzando
SELECT: esegui una query utilizzando l'istruzioneCREATE TABLE AS SELECToINSERT INTO SELECTin una regione BigQuery Omni e sposta il risultato in una regione BigQuery. - Trasferimento BigQuery Omni utilizzando
LOAD: utilizza le istruzioniLOAD DATAper caricare i dati direttamente da Amazon Simple Storage Service (Amazon S3) o Azure Blob Storage in BigQuery
La tabella seguente descrive le caratteristiche e le funzionalità principali di ogni strumento BigQuery Omni:
| Join di BigQuery Omni | Vista materializzata BigQuery Omni | Trasferimento BigQuery Omni utilizzando SELECT |
Trasferimento BigQuery Omni utilizzando LOAD |
|
|---|---|---|---|---|
| Utilizzo suggerito | Eseguire query sui dati esterni per un utilizzo una tantum, in cui puoi unire i dati con tabelle locali o unire i dati tra due diverse regioni di BigQuery Omni, ad esempio tra le regioni AWS e Azure Blob Storage. Utilizza i join di BigQuery Omni se i dati non sono di grandi dimensioni e se la memorizzazione nella cache non è un requisito fondamentale | Configura query ripetute o pianificate per trasferire continuamente dati esterni in modo incrementale, dove la memorizzazione nella cache è un requisito fondamentale. Ad esempio, per gestire una dashboard | Eseguire query su dati esterni per un utilizzo una tantum, da una regione BigQuery Omni a una regione BigQuery, dove i controlli manuali come la memorizzazione nella cache e l'ottimizzazione delle query sono un requisito fondamentale e se utilizzi query complesse non supportate dai join BigQuery Omni o dalle viste materializzate BigQuery Omni | Eseguire la migrazione di set di dati di grandi dimensioni così come sono, senza doverli filtrare, utilizzando query pianificate per spostare i dati non elaborati |
| Supporta l'applicazione di filtri prima dello spostamento dei dati | Sì. Si applicano limiti su determinati operatori di query. Per saperne di più, consulta Limitazioni dei join di BigQuery Omni | Sì. Si applicano limiti a determinati operatori di query, come le funzioni di aggregazione e l'operatore UNION |
Sì. Nessun limite per gli operatori di query | No |
| Limitazioni delle dimensioni di trasferimento | 60 GB per trasferimento (ogni subquery a una regione remota produce un trasferimento) | Nessun limite | 60 GB per trasferimento (ogni subquery a una regione remota produce un trasferimento) | Nessun limite |
| Compressione del trasferimento di dati | Compressione dei cavi | A colonne | Compressione dei cavi | Compressione dei cavi |
| Memorizzazione nella cache | Non supportata | Supportato con tabelle abilitate per la cache con viste materializzate | Non supportata | Non supportata |
| Prezzi del traffico in uscita | Costo del traffico in uscita e intercontinentale di AWS | Costo del traffico in uscita e intercontinentale di AWS | Costo del traffico in uscita e intercontinentale di AWS | Costo del traffico in uscita e intercontinentale di AWS |
| Calcola l'utilizzo per il trasferimento di dati | Utilizza gli slot nella regione di origine AWS o Azure Blob Storage (prenotazione o on demand) | Non utilizzata | Utilizza gli slot nella regione di origine AWS o Azure Blob Storage (prenotazione o on demand) | Non utilizzata |
| Utilizzo di computing per i filtri | Utilizza gli slot nella regione di origine AWS o Azure Blob Storage (prenotazione o on demand) | Utilizza gli slot nella regione di origine AWS o Azure Blob Storage (prenotazione o on demand) per calcolare le viste materializzate e i metadati locali | Utilizza gli slot nella regione di origine AWS o Azure Blob Storage (prenotazione o on demand) | Non utilizzata |
| Trasferimento incrementale | Non supportata | Supportato per le viste materializzate non aggregate | Non supportata | Non supportata |
Puoi anche prendere in considerazione le seguenti alternative per trasferire i dati da Amazon Simple Storage Service (Amazon S3) o Azure Blob Storage a Google Cloud:
- Storage Transfer Service: trasferisci i dati tra l'archiviazione di oggetti e file su Google Cloud e Amazon Simple Storage Service (Amazon S3) o Azure Blob Storage.
- BigQuery Data Transfer Service: configura il trasferimento automatico dei dati in BigQuery in base a pianificazioni gestite. Supporta una varietà di origini ed è adatto per la migrazione dei dati. BigQuery Data Transfer Service non supporta il filtro.
Architettura
L'architettura di BigQuery separa il computing dallo spazio di archiviazione, consentendo a BigQuery di fare lo scale out in base alle esigenze per gestire workload molto grandi. BigQuery Omni estende questa architettura eseguendo il motore di query BigQuery in altri cloud. Di conseguenza, non devi spostare fisicamente i dati nello spazio di archiviazione di BigQuery. L'elaborazione avviene dove si trovano già i dati.
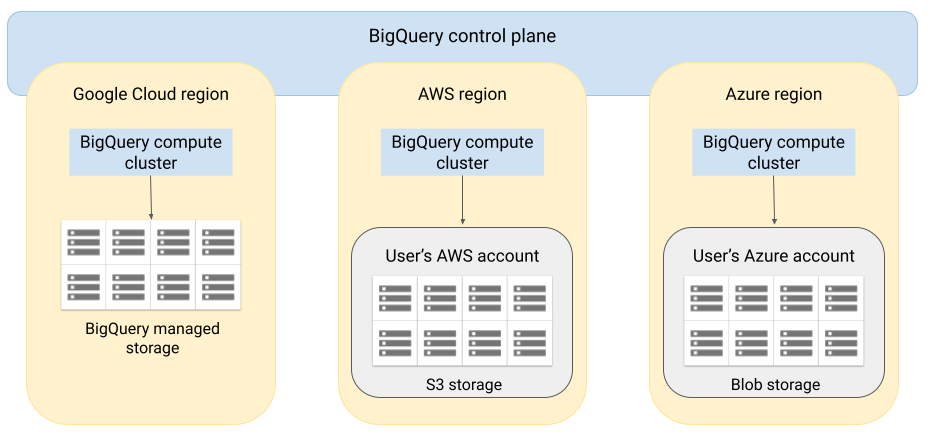
I risultati delle query possono essere restituiti a Google Cloud tramite una connessione sicura, ad esempio per essere visualizzati nella console Google Cloud . In alternativa, puoi scrivere i risultati direttamente nei bucket Amazon S3 o in Blob Storage. In questo caso, non si verifica alcuno spostamento cross-cloud dei risultati della query.
BigQuery Omni utilizza i ruoli IAM AWS standard o le entità Azure Active Directory per accedere ai dati nel tuo abbonamento. Deleghi l'accesso in lettura o scrittura a BigQuery Omni e puoi revocarlo in qualsiasi momento.
Flusso di dati durante l'esecuzione di query sui dati
La seguente immagine descrive come i dati si spostano tra Google Cloud e AWS o Azure per le seguenti query:
SELECTistruzioniCREATE EXTERNAL TABLEistruzioni

- Il control plane di BigQuery riceve i job di query da te tramite la consoleGoogle Cloud , lo strumento a riga di comando bq, un metodo API o una libreria client.
- Il control plane di BigQuery invia i job di query per l'elaborazione al data plane di BigQuery su AWS o Azure.
- Il control plane di BigQuery riceve la query dal control plane tramite una connessione VPN.
- Il piano dati di BigQuery legge i dati della tabella dal tuo bucket Amazon S3 o da Blob Storage.
- Il piano dati di BigQuery esegue il job di query sui dati della tabella. L'elaborazione dei dati della tabella avviene nella regione AWS o Azure specificata.
- Il risultato della query viene trasmesso dal control plane al data plane tramite la connessione VPN.
- Il control plane di BigQuery riceve i risultati del job di query per visualizzarli in risposta al job di query. Questi dati vengono archiviati per un massimo di 24 ore.
- Il risultato della query ti viene restituito.
Per saperne di più, consulta Esegui query sui dati di Amazon S3 e Dati di Blob Storage.
Flusso di dati durante l'esportazione dei dati
L'immagine seguente descrive il modo in cui i dati vengono spostati tra Google Cloud e AWS o Azure durante un'istruzione EXPORT DATA.

- Il control plane di BigQuery riceve i job di query di esportazione da te tramite la console Google Cloud , lo strumento a riga di comando bq, un metodo API o una libreria client. La query contiene il percorso di destinazione per il risultato della query nel tuo bucket Amazon S3 o in Blob Storage.
- Il control plane di BigQuery invia i job di query di esportazione per l'elaborazione al data plane di BigQuery (su AWS o Azure).
- Il piano dati di BigQuery riceve la query di esportazione dal control plane tramite la connessione VPN.
- Il piano dati di BigQuery legge i dati della tabella dal tuo bucket Amazon S3 o da Blob Storage.
- Il piano dati di BigQuery esegue il job di query sui dati della tabella. L'elaborazione dei dati della tabella avviene nella regione AWS o Azure specificata.
- BigQuery scrive il risultato della query nel percorso di destinazione specificato nel bucket Amazon S3 o in Blob Storage.
Per saperne di più, consulta Esporta i risultati delle query in Amazon S3 e Blob Storage.
Vantaggi
Rendimento. Puoi ottenere insight più rapidamente, perché i dati non vengono copiati tra i cloud e le query vengono eseguite nella stessa regione in cui risiedono i tuoi dati.
Costo Risparmi sui costi di trasferimento di dati in uscita perché i dati non vengono spostati. Non sono previsti costi aggiuntivi per il tuo account AWS o Azure relativi all'analisi di BigQuery Omni, perché le query vengono eseguite su cluster gestiti da Google. Ti verrà addebitato solo il costo per l'esecuzione delle query, utilizzando il modello di prezzi di BigQuery.
Sicurezza e governance dei dati. Sei tu a gestire i dati nel tuo abbonamento AWS o Azure. Non è necessario spostare o copiare i dati non elaborati dal cloud pubblico. Tutti i calcoli vengono eseguiti nel servizio multi-tenant BigQuery, che viene eseguito nella stessa regione dei tuoi dati.
Architettura serverless. Come il resto di BigQuery, BigQuery Omni è un'offerta serverless. Google esegue il deployment e la gestione dei cluster che eseguono BigQuery Omni. Non è necessario eseguire il provisioning di risorse o gestire cluster.
Facilità di gestione. BigQuery Omni fornisce un'interfaccia di gestione unificata tramite Google Cloud. BigQuery Omni può utilizzare il tuo account Google Cloud e i tuoi progetti BigQuery esistenti. Puoi scrivere una query GoogleSQL nella console Google Cloud per eseguire query sui dati in AWS o Azure e visualizzare i risultati nella console Google Cloud .
Trasferimento BigQuery Omni. Puoi caricare i dati nelle tabelle BigQuery standard dai bucket S3 e da Blob Storage. Per saperne di più, consulta Trasferisci i dati di Amazon S3 e Trasferisci i dati di Blob Storage a BigQuery.
Memorizzazione nella cache dei metadati per le prestazioni
Puoi utilizzare i metadati memorizzati nella cache per migliorare le prestazioni delle query sulle tabelle BigLake che fanno riferimento ai dati di Amazon S3. È particolarmente utile nei casi in cui lavori con un numero elevato di file o se i dati sono partizionati in Apache Hive.
BigQuery utilizza CMETA come sistema di metadati distribuito per gestire in modo efficiente tabelle di grandi dimensioni. CMETA fornisce metadati granulari a livello di colonna e blocco, accessibili tramite le tabelle di sistema. Questo sistema contribuisce a migliorare le prestazioni delle query ottimizzando l'accesso e l'elaborazione dei dati. Per accelerare ulteriormente le prestazioni delle query su tabelle di grandi dimensioni, BigQuery gestisce una cache dei metadati. I job di aggiornamento CMETA mantengono aggiornata questa cache.I metadati includono nomi file, informazioni sul partizionamento e metadati fisici dei file, come il numero di righe. Puoi scegliere se abilitare o meno la memorizzazione nella cache dei metadati su una tabella. Le query con un numero elevato di file e con filtri di partizione Apache Hive traggono il massimo vantaggio dalla memorizzazione nella cache dei metadati.
Se non attivi la memorizzazione nella cache dei metadati, le query sulla tabella devono leggere l'origine dati esterna per ottenere i metadati degli oggetti. La lettura di questi dati aumenta la latenza delle query; l'elenco di milioni di file dall'origine dati esterna può richiedere diversi minuti. Se abiliti la memorizzazione nella cache dei metadati, le query possono evitare di elencare i file dall'origine dati esterna e possono partizionare e ridurre i file più rapidamente.
La memorizzazione nella cache dei metadati si integra anche con il controllo delle versioni degli oggetti di Cloud Storage. Quando la cache viene compilata o aggiornata, acquisisce i metadati in base alla versione live degli oggetti Cloud Storage in quel momento. Di conseguenza, le query abilitate per la memorizzazione dei metadati nella cache leggono i dati corrispondenti alla versione specifica dell'oggetto memorizzato nella cache, anche se in Cloud Storage sono disponibili versioni più recenti. L'accesso ai dati da qualsiasi versione degli oggetti aggiornata successivamente in Cloud Storage richiede un aggiornamento della cache dei metadati.
Esistono due proprietà che controllano questa funzionalità:
- Staleness massima specifica quando le query utilizzano i metadati memorizzati nella cache.
- La modalità cache dei metadati specifica come vengono raccolti i metadati.
Quando la memorizzazione nella cache dei metadati è abilitata, specifichi l'intervallo massimo di inattività dei metadati accettabile per le operazioni sulla tabella. Ad esempio, se specifichi un intervallo di 1 ora, le operazioni sulla tabella utilizzano i metadati memorizzati nella cache se sono stati aggiornati nell'ultima ora. Se i metadati memorizzati nella cache sono più vecchi, l'operazione torna a recuperare i metadati da Amazon S3. Puoi specificare un intervallo di inattività compreso tra 30 minuti e 7 giorni.
Quando abiliti la memorizzazione nella cache dei metadati per le tabelle BigLake o degli oggetti, BigQuery attiva i job di aggiornamento della generazione dei metadati. Puoi scegliere di aggiornare la cache automaticamente o manualmente:
- Per gli aggiornamenti automatici, la cache viene aggiornata a un intervallo definito dal sistema, in genere compreso tra 30 e 60 minuti. L'aggiornamento automatico della cache è un buon approccio se i file in Amazon S3 vengono aggiunti, eliminati o modificati a intervalli casuali. Se devi controllare i tempi di aggiornamento, ad esempio per attivare l'aggiornamento alla fine di un job di estrazione, trasformazione e caricamento, utilizza l'aggiornamento manuale.
Per gli aggiornamenti manuali, esegui la procedura di sistema
BQ.REFRESH_EXTERNAL_METADATA_CACHEper aggiornare la cache dei metadati in base a una pianificazione che soddisfi i tuoi requisiti. L'aggiornamento manuale della cache è un buon approccio se i file in Amazon S3 vengono aggiunti, eliminati o modificati a intervalli noti, ad esempio come output di una pipeline.Se esegui più aggiornamenti manuali contemporaneamente, solo uno andrà a buon fine.
La cache dei metadati scade dopo 7 giorni se non viene aggiornata.
Gli aggiornamenti della cache sia manuali che automatici vengono eseguiti con la priorità di query INTERACTIVE.
Utilizza le prenotazioni BACKGROUND
Se scegli di utilizzare gli aggiornamenti automatici, ti consigliamo di creare una prenotazione e poi un assegnazione con un tipo di prestazione BACKGROUND per il progetto che esegue i job di aggiornamento della cache dei metadati. Con le prenotazioni BACKGROUND, i job di aggiornamento utilizzano un pool di risorse dedicato che impedisce ai job di aggiornamento di competere con le query degli utenti e di non riuscire se non sono disponibili risorse sufficienti.
Sebbene l'utilizzo di un pool di slot condiviso non comporti costi aggiuntivi, l'utilizzo di prenotazioni BACKGROUND offre prestazioni più coerenti allocando un pool di risorse dedicato e migliora l'affidabilità dei job di aggiornamento e l'efficienza complessiva delle query in BigQuery.
Prima di impostarli, devi considerare l'interazione tra i valori dell'intervallo di inattività e della modalità di memorizzazione nella cache dei metadati. Considera i seguenti esempi:
- Se aggiorni manualmente la cache dei metadati per una tabella e imposti l'intervallo di inattività su 2 giorni, devi eseguire la procedura di sistema
BQ.REFRESH_EXTERNAL_METADATA_CACHEogni 2 giorni o meno se vuoi che le operazioni sulla tabella utilizzino i metadati memorizzati nella cache. - Se aggiorni automaticamente la cache dei metadati per una tabella e imposti l'intervallo di inattività su 30 minuti, è possibile che alcune delle tue operazioni sulla tabella leggano da Amazon S3 se l'aggiornamento della cache dei metadati richiede più tempo rispetto alla consueta finestra di 30-60 minuti.
Per trovare informazioni sui job di aggiornamento dei metadati, esegui una query sulla vista INFORMATION_SCHEMA.JOBS, come mostrato nell'esempio seguente:
SELECT *
FROM `region-us.INFORMATION_SCHEMA.JOBS_BY_PROJECT`
WHERE job_id LIKE '%metadata_cache_refresh%'
AND creation_time > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
ORDER BY start_time DESC
LIMIT 10;
Per saperne di più, consulta Memorizzazione nella cache dei metadati.
Tabelle abilitate per la cache con viste materializzate
Puoi utilizzare le viste materializzate sulle tabelle abilitate per la cache dei metadati di Amazon Simple Storage Service (Amazon S3) per migliorare le prestazioni e l'efficienza durante l'esecuzione di query sui dati strutturati archiviati in Amazon S3. Queste viste materializzate funzionano come le viste materializzate sulle tabelle di archiviazione gestite da BigQuery, inclusi i vantaggi dell'aggiornamento automatico e dell'ottimizzazione intelligente.
Per rendere disponibili i dati di Amazon S3 in una vista materializzata in una regione BigQuery supportata per i join, crea una replica della vista materializzata. Puoi creare repliche di vista materializzata solo su viste materializzate autorizzate.
Limitazioni
Oltre alle limitazioni per le tabelle BigLake, a BigQuery Omni si applicano le seguenti limitazioni, che includono le tabelle BigLake basate sui dati di Amazon S3 e Blob Storage:
- L'utilizzo dei dati in una qualsiasi delle regioni di BigQuery Omni non è supportato dalle versioni Standard ed Enterprise Plus. Per saperne di più sulle versioni, consulta Introduzione alle versioni di BigQuery.
- Le
INFORMATION_SCHEMAvisteOBJECT_PRIVILEGES,STREAMING_TIMELINE_BY_*,TABLE_SNAPSHOTS,TABLE_STORAGE,TABLE_CONSTRAINTS,KEY_COLUMN_USAGE,CONSTRAINT_COLUMN_USAGEePARTITIONSnon sono disponibili per le tabelle BigLake basate sui dati di Amazon S3 e Blob Storage. - Le viste materializzate non sono supportate per Blob Storage.
- Le funzioni definite dall'utente JavaScript non sono supportate.
Le seguenti istruzioni SQL non sono supportate:
- Istruzioni BigQuery ML.
- Istruzioni Data Definition Language (DDL)
che richiedono dati gestiti in BigQuery. Ad esempio,
CREATE EXTERNAL TABLE,CREATE SCHEMAoCREATE RESERVATIONsono supportati, maCREATE TABLEnon lo è. - Istruzioni DML (Data Manipulation Language).
Le seguenti limitazioni si applicano alle query e alla lettura delle tabelle temporanee di destinazione:
- L'esecuzione di query sulle tabelle temporanee di destinazione con l'istruzione
SELECTnon è supportata.
- L'esecuzione di query sulle tabelle temporanee di destinazione con l'istruzione
Le query pianificate sono supportate solo tramite il metodo API o CLI. L'opzione Tabella di destinazione è disabilitata per le query. Sono consentite solo query
EXPORT DATA.L'API BigQuery Storage non è disponibile nelle regioni BigQuery Omni.
Se la query utilizza la clausola
ORDER BYe ha una dimensione dei risultati superiore a 256 MB, la query non va a buon fine. Per risolvere il problema, riduci le dimensioni dei risultati o rimuovi la clausolaORDER BYdalla query. Per saperne di più sulle quote di BigQuery Omni, consulta Quote e limiti.L'utilizzo di chiavi di crittografia gestite dal cliente (CMEK) con set di dati e tabelle esterne non è supportato.
Prezzi
Per informazioni sui prezzi e sulle offerte a tempo limitato in BigQuery Omni, consulta Prezzi di BigQuery Omni.
Quote e limiti
Per informazioni sulle quote di BigQuery Omni, consulta Quote e limiti.
Se il risultato della query è superiore a 20 GiB, valuta la possibilità di esportare i risultati in Amazon S3 o Blob Storage. Per informazioni sulle quote per l'API BigQuery Connection, consulta API BigQuery Connection.
Località
BigQuery Omni elabora le query nella stessa località del set di dati che contiene le tabelle su cui stai eseguendo la query. Dopo aver creato il set di dati, la località non può essere modificata. I tuoi dati risiedono nel tuo account AWS o Azure. Le regioni BigQuery Omni supportano le prenotazioni della versione Enterprise e i prezzi del computing on demand (analisi). Per saperne di più sulle versioni, consulta Introduzione alle versioni di BigQuery.
| Descrizione della regione | Nome regione | Regione BigQuery collocata | |
|---|---|---|---|
| AWS | |||
| AWS - Stati Uniti, costa orientale (Virginia del Nord) | aws-us-east-1 |
us-east4 |
|
| AWS - Stati Uniti occidentali (Oregon) | aws-us-west-2 |
us-west1 |
|
| AWS - Asia Pacifico (Seul) | aws-ap-northeast-2 |
asia-northeast3 |
|
| AWS - Asia Pacifico (Sydney) | aws-ap-southeast-2 |
australia-southeast1 |
|
| AWS - Europa (Irlanda) | aws-eu-west-1 |
europe-west1 |
|
| AWS - Europa (Francoforte) | aws-eu-central-1 |
europe-west3 |
|
| Azure | |||
| Azure - Stati Uniti orientali 2 | azure-eastus2 |
us-east4 |
|
Passaggi successivi
- Scopri come connetterti ad Amazon S3 e a Blob Storage.
- Scopri come creare tabelle BigLake Amazon S3 e Blob Storage.
- Scopri come eseguire query sulle tabelle BigLake di Amazon S3 e Blob Storage.
- Scopri come unire le tabelle BigLake di Amazon S3 e Blob Storage alle tabelle Google Cloud utilizzando i join di BigQuery Omni.
- Scopri come esportare i risultati delle query in Amazon S3 e Blob Storage.
- Scopri come trasferire dati da Amazon S3 e Blob Storage a BigQuery.
- Scopri come configurare il perimetro dei Controlli di servizio VPC.
- Scopri come specificare la tua posizione.