


Validar a migração do data warehouse
O serviço de validação do serviço de migração do BigQuery permite verificar se as tabelas migradas do data warehouse de origem correspondem às tabelas de destino no BigQuery. É possível comparar esquemas e dados de tabelas para identificar discrepâncias durante a migração.
O cliente do serviço de validação se conecta ao banco de dados de origem e extrai o esquema de origem e os dados de linha para um bucket do Cloud Storage que você controla. Depois de extraídos, o serviço de validação compara o esquema e os dados extraídos no bucket do Cloud Storage com as tabelas migradas do BigQuery.
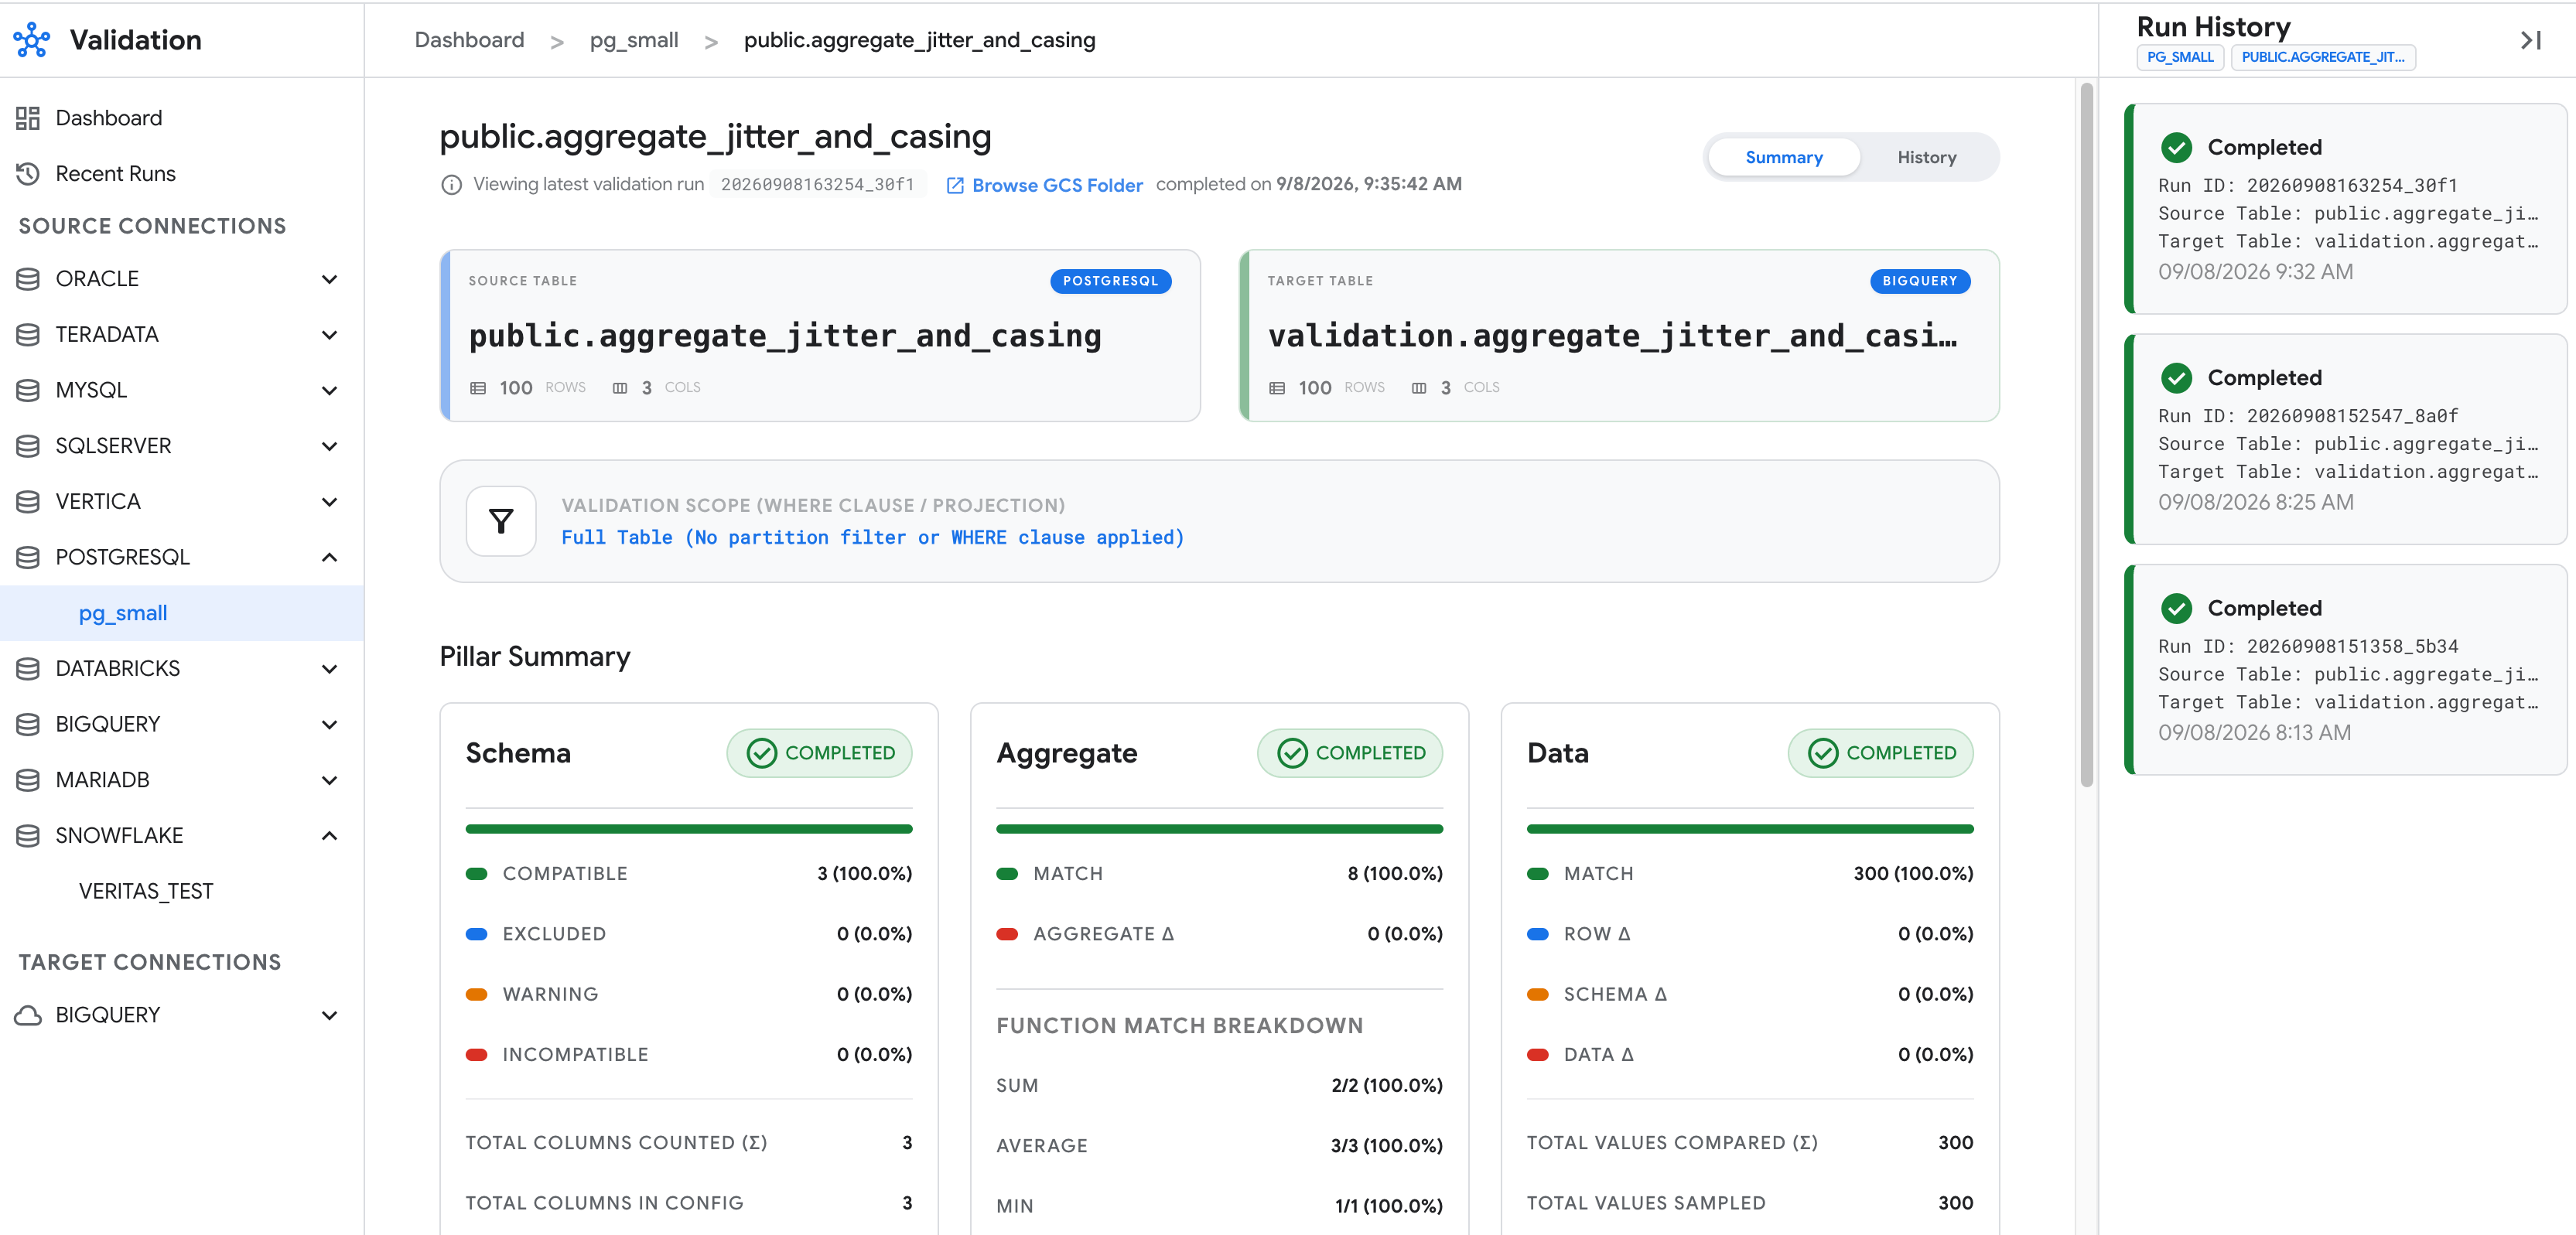
Um fluxo de trabalho de validação compara as tabelas de origem e de destino do BigQuery em três pilares de validação:
- Validação de esquema (
--schema): compara nomes de colunas, tipos de dados e compatibilidade de tipos entre a tabela de origem e a tabela do BigQuery de destino. - Validação agregada (
--aggregate): calcula e compara métricas agregadas no nível da tabela e da coluna, como contagens de linhas,SUM,AVG,MIN,MAX, distribuições booleanas e comprimentos de string, em toda a tabela. - Validação de dados (
--data): realiza uma comparação linha por linha usando uma verificação exaustiva de tabela completa (BRUTE_FORCE) ou uma amostragem aleatória baseada em chave (SAMPLE) para detectar linhas ausentes e desvios de valor no nível da célula.
Locais suportados
O serviço de validação está disponível em alguns locais. Para mais informações, consulte Locais do serviço de migração do BigQuery.
Considerações sobre segurança e tratamento de dados
O serviço de validação extrai e prepara dados diferentes dependendo do pilar de validação que você executa:
- Validação de esquema (
--schema): faz upload apenas de nomes de colunas, tipos de dados e estatísticas de tabela para o arquivosource_query_result.json, sem extrair valores de células. - Validação agregada (
--aggregate): faz upload de métricas agregadas calculadas para o arquivosource_aggregates.parquet, incluindo valores reais de célulasMINeMAXdas colunas incluídas. - Validação de dados (
--data): extrai valores de células brutos e não mascarados de linhas de amostra ou de todas as linhas ao usar a estratégiaBRUTE_FORCE. Ele faz upload desses valores no formato Apache Parquet ou CSV para o bucket de preparo do Cloud Storage e os carrega no conjunto de dadosvalidation_resultsno BigQuery.
Para proteger seus dados e o ambiente de validação, defina as seguintes configurações:
- Excluir colunas sensíveis: adicione colunas sensíveis ao campo
columnSettings.excludepara omiti-las de consultas de extração de origem, comparações de destino e relatórios de validação. - Minimizar o armazenamento local de dados: defina o campo
googleCloudStorage.gcsPathno o arquivosettings.yamlpara transmitir linhas de amostra diretamente para o Cloud Storage sem gravá-las no disco local. Em hosts compartilhados, exclua o diretório de trabalho--output-dirlocal após cada execução para remover metadados, agregações e arquivos de registro locais. - Criptografar dados e resultados em etapas: configure chaves de criptografia gerenciadas pelo cliente (CMEK) com o Cloud Key Management Service no bucket de preparo do Cloud Storage e no conjunto de dados de resultados do BigQuery (
validation_resultspor padrão ou o conjunto de dados especificado no camporesults.dataset) antes de executar a validação. - Restringir o acesso à configuração: armazene arquivos de configuração de validação em um
repositório com controle de versões que exija revisão de código ou em um
bucket do Cloud Storage em que apenas usuários confiáveis tenham a
permissão
storage.objects.create. - Aplique o acesso com privilégio mínimo: conceda ao criador do fluxo de trabalho o papel
roles/bigquery.dataViewerapenas nos conjuntos de dados ou tabelas de destino que estão sendo validados, não no projeto. Use um usuário de banco de dados de origem somente leitura, conforme descrito em Configurar privilégios de banco de dados de origem.
Antes de começar
No console do Google Cloud , na página do seletor de projetos, selecione ou crie um projeto do Google Cloud que contenha os conjuntos de dados de destino do BigQuery.
Verifique se o faturamento foi ativado para o projeto do Google Cloud .
Ative as APIs do BigQuery, do serviço de migração do BigQuery, do Cloud Storage e do Secret Manager (se as senhas do banco de dados estiverem armazenadas no Secret Manager).
Crie ou selecione um bucket do Cloud Storage no mesmo local do conjunto de dados de destino do BigQuery para organizar os metadados extraídos e as amostras de dados. Para mais informações, consulte Criar um bucket.
Papéis e permissões necessárias
Uma execução de validação tem três partes, e cada uma pode ser realizada por um principal diferente:
- Coleta de dados: o cliente de validação lê o banco de dados de origem e faz upload de metadados, agregações e linhas de amostra para o bucket de preparo do Cloud Storage. Ele não chama o BigQuery.
- Validação: um fluxo de trabalho de validação do serviço de migração do BigQuery compara os dados preparados com as tabelas de destino. O fluxo de trabalho é executado com as credenciais do principal que o criou, seja ele o cliente de validação, o
gcloudou o console do Google Cloud . - Visualização de resultados: leitura do conjunto de dados de resultados e dos relatórios do Cloud Storage.
O generate-config não requer nenhuma permissão Google Cloud .
Coleta de dados
Para receber as permissões necessárias para coletar dados de origem, peça ao administrador para conceder a você os seguintes papéis do IAM:
- Criador de objetos do Storage (
roles/storage.objectCreator) no bucket de preparo - Leitor de objetos do Storage (
roles/storage.objectViewer) no bucket de preparo -
Ler arquivos de configuração do Cloud Storage:
Leitor de objetos do Storage (
roles/storage.objectViewer) no bucket de configuração -
Ler senhas de banco de dados do Secret Manager:
Acessador de secrets do Secret Manager (
roles/secretmanager.secretAccessor) no secret
Para mais informações sobre a concessão de papéis, consulte Gerenciar o acesso a projetos, pastas e organizações.
Esses papéis predefinidos contêm as permissões necessárias para coletar dados de origem. Para acessar as permissões exatas necessárias, expanda a seção Permissões necessárias:
Permissões necessárias
As seguintes permissões são necessárias para coletar dados de origem:
-
storage.objects.createno bucket de preparo -
storage.objects.getno bucket de preparo -
Ler arquivos de configuração do Cloud Storage:
-
storage.objects.getno bucket de configuração -
storage.objects.listno bucket de configuração
-
-
Ler senhas de banco de dados do Secret Manager:
secretmanager.versions.accessno secret
Essas permissões também podem ser concedidas com funções personalizadas ou outros papéis predefinidos.
Com o --extract-only, a coleta de dados não precisa de permissões do BigQuery
ou do serviço de migração do BigQuery. Sem ele, o cliente também cria os fluxos de trabalho de validação e precisa dos papéis de validação.
Validação
Para receber as permissões necessárias para criar e executar fluxos de trabalho de validação, peça ao administrador para conceder a você os seguintes papéis do IAM:
- Editor de MigrationWorkflow (
roles/bigquerymigration.editor) no projeto - Usuário de jobs do BigQuery (
roles/bigquery.jobUser) no projeto - Visualizador de dados do BigQuery (
roles/bigquery.dataViewer) em cada conjunto de dados de destino - Editor de dados do BigQuery (
roles/bigquery.dataEditor) no conjunto de dados de resultados - Usuário de objetos do Storage (
roles/storage.objectUser) no bucket de preparo -
Se o conjunto de dados de resultados não existir:
Usuário do BigQuery (
roles/bigquery.user) no projeto
Esses papéis predefinidos contêm as permissões necessárias para criar e executar fluxos de trabalho de validação. Para acessar as permissões exatas necessárias, expanda a seção Permissões necessárias:
Permissões necessárias
As seguintes permissões são necessárias para criar e executar fluxos de trabalho de validação:
-
bigquerymigration.workflows.createno projeto -
bigquerymigration.workflows.getno projeto -
bigquery.jobs.createno projeto -
bigquery.tables.getem cada conjunto de dados de destino -
bigquery.tables.getDataem cada conjunto de dados de destino -
bigquery.datasets.getno conjunto de dados de resultados -
bigquery.tables.getno conjunto de dados de resultados -
bigquery.tables.createno conjunto de dados de resultados -
bigquery.tables.updateno conjunto de dados de resultados -
bigquery.tables.updateDatano conjunto de dados de resultados -
bigquery.tables.getDatano conjunto de dados de resultados -
storage.objects.getno bucket de preparo -
storage.objects.createno bucket de preparo -
storage.objects.deleteno bucket de preparo -
Se o conjunto de dados de resultados não existir:
bigquery.datasets.createno projeto
roles/bigquerymigration.editor contém muitas permissões que a validação
não usa. Para o privilégio mínimo, conceda uma
função personalizada apenas com
bigquerymigration.workflows.create e bigquerymigration.workflows.get.
A validação só lê as tabelas de destino e grava apenas no conjunto de dados de resultados. Recomendamos que você crie o conjunto de dados de resultados com antecedência para que nenhum principal precise de permissão para criar conjuntos de dados no seu projeto.
Como visualizar resultados
Para receber as permissões necessárias para visualizar os resultados da validação, peça ao administrador para conceder a você os seguintes papéis do IAM:
- Usuário de jobs do BigQuery (
roles/bigquery.jobUser) no projeto que contém o conjunto de dados de resultados - Visualizador de dados do BigQuery (
roles/bigquery.dataViewer) no conjunto de dados de resultados -
Ler relatórios no Cloud Storage:
Leitor de objetos do Storage (
roles/storage.objectViewer) no bucket de preparo -
Listar e visualizar fluxos de trabalho de validação no console do Google Cloud :
Leitor do MigrationWorkflow (
roles/bigquerymigration.viewer) no projeto
Esses papéis predefinidos contêm as permissões necessárias para visualizar os resultados da validação. Para acessar as permissões exatas necessárias, expanda a seção Permissões necessárias:
Permissões necessárias
As seguintes permissões são necessárias para visualizar os resultados da validação:
-
bigquery.jobs.createno projeto -
bigquery.tables.getno conjunto de dados de resultados -
bigquery.tables.getDatano conjunto de dados de resultados -
Ler relatórios no Cloud Storage:
-
storage.objects.getno bucket de preparo -
storage.objects.listno bucket de preparo
-
-
Liste e visualize os fluxos de trabalho de validação no console do Google Cloud :
-
bigquerymigration.workflows.listno projeto -
bigquerymigration.workflows.getno projeto
-
Configurar privilégios do banco de dados de origem
Configure o acesso somente leitura ao usuário do banco de dados de origem com os seguintes privilégios:
- Privilégio
SELECTem cada tabela de origem que está sendo validada. - Acesso de leitura às visualizações do catálogo do sistema usadas para descoberta de esquema e chave primária (como tabelas
information_schema,ALL_CONSTRAINTSeALL_TAB_COLUMNSno Oracle ouSVV_COLUMNSepg_attributeno Amazon Redshift).
Não conceda a esse usuário privilégios de gravação, DDL ou administrativos. O cliente de validação executa o SQL da sua configuração de validação como esse usuário. Para mais informações, consulte Considerações sobre segurança e processamento de dados.
Limitações
O serviço de validação está sujeito às seguintes limitações:
- O BigQuery é o único banco de dados de destino compatível. Não é possível validar entre dois bancos de dados que não são do BigQuery ou usar o BigQuery como uma fonte de validação.
- O conjunto de dados de destino do BigQuery, o conjunto de dados de resultados
(
validation_resultspor padrão ou o conjunto de dados personalizado configurado emresultsemsettings.yaml), o bucket de preparo do Cloud Storage e o local do fluxo de trabalho de validação (BQMS_VALIDATION_LOCATION) precisam estar no mesmo local. Quando o serviço de validação cria o conjunto de dados de resultados, ele define o local do conjunto de dados como a região usada pelo bucket de preparo do Cloud Storage e pelo conjunto de dados de destino do BigQuery ouresults.location, se definido explicitamente. - A compatibilidade com tipos de dados varia de acordo com a origem. As colunas com tipos incompatíveis são excluídas da validação. Para mais detalhes, consulte Data warehouses compatíveis.
- As tabelas de comparação por execução criadas no
BigQuery expiram automaticamente com base em
resultTtlHoursemsettings.yaml, que tem como padrão168.0horas ou sete dias. Não configure uma expiração de tabela padrão no nível do conjunto de dadosvalidation_results, porque isso também expira tabelas de auditoria de longa duração, comorun_history,run_metricsecolumn_history. - Os nomes tabela do BigQuery diferenciam maiúsculas de minúsculas. Quando o
generate-configcria configurações de um arquivo de metadados da ferramentadwh-migration-dumpersem um mapeamento de traduçãotables.yaml, os nomes das tabelas de destino preservam as maiúsculas e minúsculas do identificador de origem. Por exemplo, nomes de tabelas em maiúsculas do Oracle ou do Snowflake. Verifique setargetTable.namecorresponde exatamente ao caso da tabela no BigQuery.
Data warehouses compatíveis
O serviço de validação é compatível com os seguintes bancos de dados de origem. Cada seção inclui o driver JDBC que acompanha a instalação, se é possível ou não gerar configurações de tabela automaticamente de um arquivo de metadados da ferramenta dwh-migration-dumper, os tipos de particionamento compatíveis com tabelas grandes desse banco de dados e os tipos de dados compatíveis com a validação.
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
Variantes parametrizadas dos tipos de dados compatíveis, como VARCHAR(255) ou DECIMAL(10,2), também são aceitas.
O serviço de validação carrega todos os arquivos JAR no diretório drivers/ antes
dos drivers transferidos automaticamente por download. Assim, você também pode usar drivers/ para substituir
uma versão de driver incluída.
Se você gerar automaticamente um arquivo de configuração de validação, as colunas com
tipos de dados não compatíveis serão adicionadas automaticamente a columnSettings.exclude. Para
configurações manuais, é preciso excluí-las explicitamente em columnSettings.exclude.
Para a maioria dos bancos de dados de origem compatíveis, a ferramenta de validação faz o download automático
do driver JDBC necessário do Maven Central no primeiro uso, verifica o checksum
SHA-256 e o armazena em cache localmente em ~/.cache/google-cloud-bqms/drivers/ (ou
$XDG_CACHE_HOME/google-cloud-bqms/drivers/). Para data warehouses que usam drivers proprietários, como o Teradata, ou ao executar em um ambiente off-line ou com isolamento físico, faça o seguinte:
- Coloque o arquivo JAR do driver necessário em
./drivers/,<sdk_root>/platform/bqms/drivers/ou no diretório especificado pela variável de ambienteBQMS_DRIVER_DIR. Qualquer JAR de driver colocado nesses diretórios locais tem precedência sobre os downloads automáticos do Maven Central. - Para desativar completamente os downloads automáticos de rede em ambientes com isolamento físico, defina
BQMS_AUTO_DOWNLOAD_DRIVERS=falseouBQMS_MAVEN_MIRRORpara apontar para um espelho de repositório interno do Maven.
Para aprender mais sobre cada fonte de dados compatível com o serviço de validação, selecione uma das seguintes opções:
Teradata
As validações para migrações do Teradata são compatíveis da seguinte maneira:
- Valor de
dialect:teradata - Driver JDBC: fornecido pelo usuário. Faça o download do JAR do driver JDBC do Teradata, como
terajdbc4.jarouterajdbc.jar, do Teradata e copie-o para o diretóriodrivers/ou o diretório especificado porBQMS_DRIVER_DIR. - Geração automática de configuração: compatível com um arquivo de metadados de ferramenta
dwh-migration-dumper(--connector teradata). - Extração particionada:
INTEGER_RANGE,PHYSICAL
| Categoria | Tipos de dados |
|---|---|
| Numérico | BYTEINT, SMALLINT, INTEGER, INT, BIGINT, DECIMAL, DEC, NUMERIC, NUMBER, FLOAT, REAL, DOUBLE PRECISION |
| String | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, LONG VARCHAR |
| Data e hora | DATE, TIME, TIME WITH TIME ZONE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
Ao validar migrações do Teradata, considere o seguinte:
- Quando uma tabela não tem uma chave primária explícita, as chaves de comparação são descobertas
em índices primários exclusivos (
UPI) ou índices secundários exclusivos (USI). Os índices primários não exclusivos (NUPI) não são usados como chaves de comparação. - O
NUMBER(P,S)de precisão fixa é compatível. ONUMBERsem restrições (sem precisão) não é compatível. As colunasNUMBER,CLOB,BLOB,BYTE,VARBYTE,INTERVAL,PERIOD,JSONeXMLsem restrições são excluídas automaticamente pelogenerate-config(ou precisam ser listadas emcolumnSettings.excludepara configurações manuais). - As colunas
CHARde largura fixa são cortadas automaticamente. Os conjuntos de caracteresLATINeUNICODEe os atributosCASESPECIFIC/NOT CASESPECIFICsão aceitos. - Os valores
TIME WITH TIME ZONEeTIMESTAMP WITH TIME ZONEsão normalizados para UTC (AT 0) antes da comparação.
Snowflake
As validações para migrações do Snowflake são compatíveis da seguinte maneira:
- Valor de
dialect:snowflake - Driver JDBC: baixado automaticamente no primeiro uso
(
net.snowflake:snowflake-jdbc) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: compatível com um arquivo de metadados de ferramenta
dwh-migration-dumper(--connector snowflake). - Extração particionada:
INTEGER_RANGE,DATE_RANGE
O serviço de validação é compatível com os seguintes tipos de dados para migrações do Snowflake:
| Categoria | Tipos de dados |
|---|---|
| Numérico | NUMBER, DECIMAL, NUMERIC, FLOAT, REAL, DOUBLE |
| String | CHAR, VARCHAR, STRING, TEXT |
| Data e hora | DATE, TIME, TIMESTAMP_NTZ, TIMESTAMP_LTZ, TIMESTAMP_TZ |
| Booleano | BOOLEAN |
Ao validar migrações do Snowflake, considere o seguinte:
- As colunas
CHARde largura fixa são cortadas automaticamente. - Se você replicou dados com o serviço de transferência de dados do BigQuery, defina
tolerances.timestamp: 0.001para absorver o arredondamento de submilisegundos.
Amazon Redshift
As validações para migrações do Amazon Redshift são compatíveis da seguinte maneira:
- Valor de
dialect:redshift - Driver JDBC: baixado automaticamente no primeiro uso
(
com.amazon.redshift:redshift-jdbc42) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: compatível com um arquivo de metadados de ferramenta
dwh-migration-dumper(--connector redshift). - Extração particionada:
INTEGER_RANGE,PHYSICAL
O serviço de validação é compatível com os seguintes tipos de dados para migrações do Amazon Redshift:
| Categoria | Tipos de dados |
|---|---|
| Numérico | SMALLINT, INTEGER, BIGINT, DECIMAL, NUMERIC, REAL, DOUBLE PRECISION |
| String | CHAR, VARCHAR, TEXT |
| Data e hora | DATE, TIME, TIMETZ, TIMESTAMP, TIMESTAMPTZ |
| Booleano | BOOLEAN |
| Semiestruturados | SUPER |
Ao validar migrações do Amazon Redshift, considere o seguinte:
- A inspeção de esquema usa
SVV_COLUMNS, portanto, as visualizações de vinculação tardia são compatíveis. - Quando uma tabela não tem uma chave primária, as chaves de comparação voltam automaticamente para uma única coluna
DISTKEYouSORTKEY. - As colunas
GEOMETRYnão são compatíveis.
Databricks
As validações para migrações do Databricks são compatíveis da seguinte maneira:
- Valor de
dialect:databricks - Driver JDBC: baixado automaticamente no primeiro uso
(
com.databricks:databricks-jdbc) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: não compatível. Crie um arquivo de configuração de tabela manual.
- Extração particionada:
INTEGER_RANGE
O serviço de validação é compatível com os seguintes tipos de dados para migrações do Databricks:
| Categoria | Tipos de dados |
|---|---|
| Numérico | BYTE, TINYINT, SHORT, SMALLINT, INT, INTEGER, LONG, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| Data e hora | DATE, TIMESTAMP |
| Booleano | BOOLEAN |
| Binário | BINARY |
| Complexo | ARRAY, MAP, STRUCT |
Ao validar migrações do Databricks, considere o seguinte:
- Autenticar com um token de acesso pessoal: defina
user: tokene forneça o token por meio depasswordSecret. - A inspeção de esquema é baseada em consultas (
SELECT * ... WHERE 1=0), portanto, os espaços de trabalho do Unity Catalog e do metastore do Hive são compatíveis.
Apache Hive
As validações para migrações do Apache Hive são compatíveis da seguinte maneira:
- Valor de
dialect:hive - Driver JDBC: transferido automaticamente no primeiro uso
(JAR independente
org.apache.hive:hive-jdbc) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: compatível com um arquivo de metadados de ferramenta
dwh-migration-dumper(--connector hiveql). - Extração particionada:
INTEGER_RANGE
O serviço de validação é compatível com os seguintes tipos de dados para migrações do Hive:
| Categoria | Tipos de dados |
|---|---|
| Numérico | TINYINT, SMALLINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| Data e hora | DATE, TIMESTAMP |
| Booleano | BOOLEAN |
| Binário | BINARY |
| Complexo | ARRAY, MAP, STRUCT |
Ao validar migrações do Hive, considere o seguinte:
- A inspeção de esquema é baseada em consulta (
SELECT * ... WHERE 1=0). - As tabelas do Hive raramente definem chaves primárias. As tabelas sem chaves de comparação usam automaticamente a agregação de hash de linha completa para o pilar de dados.
SQL Server
As validações para migrações do SQL Server são compatíveis da seguinte maneira:
- Valor de
dialect:sqlserver - Driver JDBC: baixado automaticamente no primeiro uso
(
com.microsoft.sqlserver:mssql-jdbc) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: compatível com um arquivo de metadados de ferramenta
dwh-migration-dumper(--connector sqlserver). - Extração particionada:
INTEGER_RANGE
O serviço de validação é compatível com os seguintes tipos de dados para migrações do SQL Server:
| Categoria | Tipos de dados |
|---|---|
| Numérico | INT, BIGINT, DECIMAL, NUMERIC, FLOAT, REAL |
| String | CHAR, VARCHAR, TEXT |
| Data e hora | DATE, DATETIME, TIMESTAMP |
| Booleano | BIT |
Ao validar migrações do SQL Server, considere o seguinte:
- O URL JDBC padrão define
encrypt=true;trustServerCertificate=true;. Substitua-o pela chave de conexãourlse você precisar de uma validação rigorosa do certificado TLS.
MariaDB
As validações para migrações do MariaDB são compatíveis da seguinte maneira:
- Valor de
dialect:mariadb - Driver JDBC: baixado automaticamente no primeiro uso
(
org.mariadb.jdbc:mariadb-java-client) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: crie um arquivo de configuração de tabela manual.
- Extração particionada:
INTEGER_RANGE
O serviço de validação é compatível com os seguintes tipos de dados para migrações do MariaDB:
| Categoria | Tipos de dados |
|---|---|
| Numérico | TINYINT, SMALLINT, MEDIUMINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, ENUM, SET |
| Data e hora | DATE, TIME, DATETIME, TIMESTAMP, YEAR |
| Objetos binários e grandes | BINARY, VARBINARY, TINYBLOB, BLOB, MEDIUMBLOB, LONGBLOB |
MySQL
As validações para migrações do MySQL são compatíveis da seguinte maneira:
- Valor de
dialect:mysql - Driver JDBC: baixado automaticamente no primeiro uso
(
com.mysql:mysql-connector-j) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: crie um arquivo de configuração de tabela manual.
- Extração particionada:
INTEGER_RANGE
O serviço de validação é compatível com os seguintes tipos de dados para migrações do MySQL:
| Categoria | Tipos de dados |
|---|---|
| Numérico | INT, BIGINT, DECIMAL, FLOAT, DOUBLE |
| String | CHAR, VARCHAR, TEXT |
| Data e hora | DATE, TIME, DATETIME, TIMESTAMP |
| Booleano | BOOLEAN |
Oracle
As validações para migrações do Oracle são compatíveis da seguinte maneira:
- Valor de
dialect:oracle - Driver JDBC: baixado automaticamente no primeiro uso
(
com.oracle.database.jdbc:ojdbc11) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: compatível com um arquivo de metadados de ferramenta
dwh-migration-dumper(--connector oracle). - Extração particionada:
INTEGER_RANGE,PHYSICAL
O serviço de validação é compatível com os seguintes tipos de dados para migrações do Oracle:
| Categoria | Tipos de dados |
|---|---|
| Numérico | NUMBER, NUMERIC, INTEGER, FLOAT, DOUBLE |
| String | CHAR, NCHAR, VARCHAR, VARCHAR2, NVARCHAR2 |
| Data e hora | DATE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
| Objetos binários e grandes | RAW, BINARY, BLOB, CLOB, NCLOB |
Ao validar migrações do Oracle, considere o seguinte:
- As colunas
DATEincluem um componente de horário no Oracle. A ferramenta de validação extrai colunasDATEdo Oracle com precisão de dia (YYYY-MM-DD), de modo que as diferenças de hora do dia são truncadas.
PostgreSQL
As validações para migrações do PostgreSQL são compatíveis da seguinte maneira:
- Valor de
dialect:postgresql - Driver JDBC: baixado automaticamente no primeiro uso
(
org.postgresql:postgresql) ou fornecido pelo usuário no diretóriodrivers/para ambientes off-line. - Geração automática de configuração: compatível com um arquivo de metadados de ferramenta
dwh-migration-dumper(--connector postgres). - Extração particionada:
INTEGER_RANGE,DATE_RANGE,PHYSICAL
O serviço de validação é compatível com os seguintes tipos de dados para migrações do PostgreSQL:
| Categoria | Tipos de dados |
|---|---|
| Numérico | SMALLINT, INTEGER, BIGINT, NUMERIC, DOUBLE PRECISION |
| String | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, TEXT |
| Data e hora | DATE, TIME, TIMESTAMP, TIMESTAMP WITHOUT TIME ZONE, TIMESTAMP WITH TIME ZONE, TIMESTAMPTZ |
| Booleano | BOOLEAN |
| Outro | UUID |
Ao validar migrações do PostgreSQL, considere o seguinte:
- Valores de
BIGINTmaiores que 253 podem mostrar pequenas diferenças de precisão emAVG().SUMeCOUNTpermanecem exatos.
Configurar o diretório e os arquivos de configuração de validação
O serviço de validação lê um diretório de configuração modular chamado
validation_config/ que contém os seguintes
arquivos:
- Arquivo de conexões de banco de dados: define o perfil de conexão do data warehouse do
sourcee o perfil de conexão do BigQuery dotarget. - Arquivo de configurações de preparo e resultado: define o caminho de preparo do Cloud Storage (
googleCloudStorage), a configuração do conjunto de dados de resultado do BigQuery (results), a validade da tabela de comparação por execução (resultTtlHours) e os padrões globais opcionais (tolerances,aggregate,labels). - Arquivo de configuração de validação de tabela: contém mapeamentos por tabela
(
sourceTableetargetTable), chaves de comparação (comparisonKeys), estratégia de validação (strategy), configurações de extração particionada (partitioning) e configurações de coluna (columnSettings).
As seções a seguir descrevem as etapas para configurar o diretório de configuração de validação e as etapas para criar os arquivos de configuração necessários para uma validação de migração.
Criar um diretório de configuração de validação
Crie um diretório de configuração de validação chamado validation_config/ para armazenar
os arquivos de configuração de validação. É possível armazenar esse diretório na máquina
que executa o serviço de validação ou em um bucket do Cloud Storage para
que uma equipe possa compartilhar uma configuração entre as execuções.
Criar um arquivo de conexões de banco de dados
No diretório de configuração de validação, crie um arquivo chamado connections.yaml
e configure-o com as informações para se conectar a um banco de dados de origem e a um
banco de dados de destino do BigQuery.
Cada fonte de data warehouse tem recursos e requisitos específicos a serem considerados ao criar o arquivo de conexões de banco de dados. Para mais informações sobre cada fonte de dados, consulte Data warehouses compatíveis.
Quando você especifica passwordSecret em um perfil de conexão, o serviço de validação
busca a versão do secret no Secret Manager na máquina cliente
usando o Application Default Credentials (ADC) local e transmite a senha
resolvida diretamente para o driver JDBC local. Seu banco de dados de origem não precisa de acesso à rede ou ao IAM para o Google Cloud. Portanto, o passwordSecret funciona para bancos de dados locais e hospedados em outras nuvens, como Amazon Redshift ou Snowflake. Como alternativa, é possível omitir
passwordSecret e definir a variável de ambiente BQMS_VALIDATION_SOURCE_PASSWORD
na máquina que executa o serviço de validação.
Para criar um arquivo de conexões de banco de dados para um data warehouse, selecione uma das seguintes opções:
Teradata
Para validações de migração do Teradata, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SOURCE_HOST: o nome do host ou o endereço IP do sistema Teradata.SOURCE_DATABASE: o nome obrigatório do banco de dados do Teradata.SOURCE_USER: o nome de usuário do Teradata.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha ou definaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
Snowflake
Para validações de migração do Snowflake, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SNOWFLAKE_ACCOUNT: o identificador da sua conta do Snowflake (por exemplo,myorg-myaccount).SNOWFLAKE_WAREHOUSE: o warehouse virtual usado para executar consultas de extração.SOURCE_DATABASE: o nome obrigatório do banco de dados do Snowflake.SOURCE_SCHEMA: o nome do esquema obrigatório do Snowflake.SNOWFLAKE_ROLE: papel opcional do Snowflake.SOURCE_USER: o nome de usuário do Snowflake.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha ou definaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
Amazon Redshift
Para validações de migração do Amazon Redshift, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SOURCE_HOST: o nome do host do endpoint do cluster do Amazon Redshift.SOURCE_DATABASE: o nome do banco de dados obrigatório do Amazon Redshift.SOURCE_SCHEMA: o nome do esquema padrão (o padrão épublicse omitido).SOURCE_USER: o nome de usuário do banco de dados.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha ou definaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
Databricks
Para validações de migração do Databricks, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
DATABRICKS_HOST: o nome do host do servidor do cluster ou do SQL warehouse do Databricks.HTTP_PATH: o caminho HTTP do seu SQL warehouse do Databricks (por exemplo,sql/protocolv1/o/1234567890/0123-456789-abcdef).CATALOG_NAME: o nome obrigatório do Unity Catalog (ouhive_metastore).SCHEMA_NAME: o nome do esquema obrigatório.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém seu token de acesso pessoal (PAT) do Databricks ou omitapasswordSecrete definaBQMS_VALIDATION_SOURCE_PASSWORD. O uso deuser: tokencompasswordSecretgarante que o token nunca seja gravado em arquivos de metadados de preparo.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
Apache Hive
Para validações de migração do Apache Hive, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SOURCE_HOST: o nome do host ou o endereço IP do HiveServer2.SOURCE_DATABASE: o nome do banco de dados do Hive obrigatório (por exemplo,default).SOURCE_USER: o nome de usuário do Hive.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha ou definaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
SQL Server
Para validações de migração do SQL Server, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SOURCE_HOST: o nome do host ou endereço IP da instância do SQL Server (especifiqueinstanceNamepara instâncias nomeadas, se quiser).SOURCE_DATABASE: o nome do banco de dados obrigatório.SOURCE_SCHEMA: o nome do esquema padrão (o padrão édbose omitido).SOURCE_USER: o nome de usuário do banco de dados.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha ou definaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
MariaDB
Para validações de migração do MariaDB, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SOURCE_HOST: o nome do host ou o endereço IP do servidor MariaDB.SOURCE_DATABASE: o nome obrigatório do banco de dados MariaDB.SOURCE_USER: o nome de usuário do MariaDB.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha ou definaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
MySQL
Para validações de migração do MySQL, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SOURCE_HOST: o nome do host ou o endereço IP do seu servidor MySQL.SOURCE_DATABASE: o nome do banco de dados MySQL obrigatório.SOURCE_USER: o nome de usuário do MySQL.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha ou definaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
Oracle
Para validações de migração do Oracle, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SOURCE_HOST: o nome do host ou o endereço IP do servidor Oracle.SERVICE_NAME: o nome do serviço Oracle (usado para criarjdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME). Para conexões TNS ou SID personalizadas, especifiqueurlcom o URL JDBC completo.SOURCE_SCHEMA: nome do esquema padrão opcional.SOURCE_USER: o nome de usuário obrigatório do Oracle.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha do banco de dados ou definaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto de destino do Google Cloud.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
PostgreSQL
Para validações de migração do PostgreSQL, configure o arquivo de conexões do banco de dados com as seguintes informações:
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Substitua:
SOURCE_HOST: o nome do host ou o endereço IP do servidor PostgreSQL.SOURCE_DATABASE: o nome do banco de dados PostgreSQL obrigatório.SOURCE_SCHEMA: o nome do esquema padrão (o padrão épublicse omitido).SOURCE_USER: o nome de usuário do banco de dados.SECRET_PROJECT_IDeSECRET_ID: o ID do projeto e o ID do secret no Secret Manager que contém a senha do banco de dados. Como alternativa, omitapasswordSecrete defina a variável de ambienteBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: o ID do projeto do Google Cloud que contém as tabelas migradas do BigQuery e onde o conjunto de dadosvalidation_resultsserá criado.TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery.
Criar um arquivo de configurações
Crie um arquivo de configurações de preparo e resultado chamado settings.yaml no diretório de configuração de validação para configurar o caminho de preparo do Cloud Storage, o conjunto de dados de resultados do BigQuery, a validade da tabela por execução e os padrões globais opcionais.
Configure o arquivo de configurações de preparo e resultado com o seguinte:
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
Substitua:
BUCKET_NAME: o nome do bucket de preparo do Cloud Storage.PATH_PREFIX: o prefixo do URI do Cloud Storage no bucket usado para organizar metadados de esquema extraídos, métricas agregadas, linhas de amostra e relatórios de resumo.FORMAT: o formato do arquivo para amostras de dados em etapas. Os valores compatíveis sãoparquet(padrão) ecsv.RESULTS_PROJECT_ID: o ID do projeto do Google Cloud em que os resultados da validação e as tabelas de histórico de execução são gravados. Se omitido, o padrão serátarget.projectIddeconnections.yaml.RESULTS_DATASET: o nome do conjunto de dados do BigQuery em que os resultados da validação e as tabelas do histórico de execução (run_history,run_metricsecolumn_history) são gravados. Se omitido, o padrão évalidation_results. Se o conjunto de dados não existir, o serviço de validação o criará automaticamente.RESULTS_LOCATION: o local do BigQuery para o conjunto de dados de resultados. Se omitido, um conjunto de dados de resultados criado automaticamente usa como padrão a região do bucket de preparo do Cloud Storage e do conjunto de dados de destino do BigQuery.RESULT_TTL_HOURS: tempo de vida em horas para tabelas de comparação e incompatibilidade por execução criadas no conjunto de dados de resultados. O padrão é168.0horas (7 dias). As tabelas de observabilidade de longa duração (run_history,run_metricsecolumn_history) não são afetadas porresultTtlHours.RESULTS_CONFIG: configura o conjunto de dados de destino do BigQuery para resultados de comparação e histórico de auditoria. Os valores compatíveis sãoprojectId,datasetelocation. Quando omitido, o serviço de validação grava emTARGET_PROJECT_ID.validation_results` e cria automaticamente o conjunto de dados na mesma região do conjunto de dados de destino e do bucket de preparo do Cloud Storage, se ele ainda não existir.
Também é possível especificar padrões de tabela globais especificando tolerances,
aggregate ou labels no nível superior de settings.yaml ou
validation-config.yaml. Esses padrões se aplicam a todas as tabelas, a menos que sejam substituídos
em uma configuração de tabela individual.
Gerar configurações de validação de tabela
Depois de configurar os arquivos de conexões e configurações, defina as configurações de validação de tabela. O comando generate-config grava um arquivo YAML por tabela em validation_config/databases/DATABASE/SCHEMA/TABLE.yaml com uma chave table: de nível superior. Se preferir, crie um arquivo validation_config/tables.yaml manual.
Selecione uma das seguintes opções para saber como gerar configurações de validação de tabela para seu banco de dados de origem:
Teradata
Para validações de migração do Teradata, faça o seguinte para
gerar um arquivo de metadados da ferramenta dwh-migration-dumper dos esquemas de origem:
- Instale a ferramenta
dwh-migration-dumper - Execute
dwh-migration-dumperno banco de dados de origem para produzir um arquivo de metadados da ferramentadwh-migration-dumper.
Com o arquivo de metadados, execute generate-config para gerar arquivos de configuração por tabela. Use a flag --update para preservar os arquivos connections.yaml e settings.yaml que você criou em validation_config/. Por exemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se você também tiver um arquivo de mapeamento de esquema tables.yaml do
tradutor de SQL em lote, inclua a flag
--tables-yaml, sozinha ou com --metadata, para complementar
os mapeamentos de tabelas traduzidos com metadados de partição de origem e exclusões de tipo de dados
do arquivo de metadados. Por exemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
O comando generate-config aceita as seguintes flags:
--metadata PATH_TO_METADATA_ZIP: o caminho para um arquivo de metadados da ferramentadwh-migration-dumper(arquivo ZIP) ou um diretório que contém arquivos de metadados.--tables-yaml PATH_TO_TABLES_YAML: o caminho para um ou mais arquivos ou diretórios de traduçãotables.yaml(separados por vírgulas).--target-dataset TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery que será usado como prefixo nas entradastargetTable.namegeradas.-o, --output-dir DIRECTORY: o diretório de saída para arquivos de configuração modulares. O valor padrão évalidation_config.--schemas SCHEMA_LIST: lista separada por vírgulas de esquemas ou bancos de dados de origem a serem incluídos (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--tables TABLE_LIST: lista separada por vírgulas de nomes de tabelas (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) a serem incluídas (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--filter-file PATH: caminho para um arquivo delimitado por nova linha de nomes de tabelas a serem incluídos (linhas que começam com#são ignoradas).--update: mescla as tabelas descobertas em um diretóriovalidation_config/atual, preservando as substituiçõesconnections.yaml,settings.yamle personalizadas por tabela.--force: permite gravar arquivos de tabela recém-descobertos em um diretório de saída não vazio, mantendo os arquivos de configuração de tabela atuais.--clean: exclui todos os arquivos no diretório de saída antes de gravar os arquivos recém-descobertos.
Snowflake
Para validações de migração do Snowflake, faça o seguinte para gerar um
arquivo de metadados da ferramenta dwh-migration-dumper dos esquemas de origem:
- Instale a ferramenta
dwh-migration-dumper - Execute
dwh-migration-dumperno banco de dados de origem para produzir um arquivo de metadados da ferramentadwh-migration-dumper.
Com o arquivo de metadados, execute generate-config para gerar arquivos de configuração por tabela. Use a flag --update para preservar os arquivos connections.yaml e settings.yaml que você criou em validation_config/. Por exemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se você também tiver um arquivo de mapeamento de esquema tables.yaml do
tradutor de SQL em lote, inclua a flag
--tables-yaml, sozinha ou com --metadata para complementar
os mapeamentos de tabelas traduzidos com chaves de clustering de origem (para particionar tabelas
sem uma chave primária), metadados de partição física e exclusões de tipo de dados
do arquivo de metadados. Por exemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
O comando generate-config aceita as seguintes flags:
--metadata PATH_TO_METADATA_ZIP: o caminho para um arquivo de metadados da ferramentadwh-migration-dumper(arquivo ZIP) ou um diretório que contém arquivos de metadados.--tables-yaml PATH_TO_TABLES_YAML: o caminho para um ou mais arquivos ou diretórios de traduçãotables.yaml(separados por vírgulas).--target-dataset TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery que será usado como prefixo nas entradastargetTable.namegeradas.-o, --output-dir DIRECTORY: o diretório de saída para arquivos de configuração modulares. O valor padrão évalidation_config.--schemas SCHEMA_LIST: lista separada por vírgulas de esquemas ou bancos de dados de origem a serem incluídos (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--tables TABLE_LIST: lista separada por vírgulas de nomes de tabelas (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) a serem incluídas (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--filter-file PATH: caminho para um arquivo delimitado por nova linha de nomes de tabelas a serem incluídos (linhas que começam com#são ignoradas).--update: mescla as tabelas descobertas em um diretóriovalidation_config/atual, preservando as substituiçõesconnections.yaml,settings.yamle personalizadas por tabela.--force: permite gravar arquivos de tabela recém-descobertos em um diretório de saída não vazio, mantendo os arquivos de configuração de tabela atuais.--clean: exclui todos os arquivos no diretório de saída antes de gravar os arquivos recém-descobertos.
Amazon Redshift
Para validações de migração do Amazon Redshift, faça o seguinte para gerar um arquivo ZIP de metadados dos esquemas de origem:
- Instale a ferramenta
dwh-migration-dumper - Execute
dwh-migration-dumperno banco de dados de origem para produzir um arquivo de metadados da ferramentadwh-migration-dumper.
Com o arquivo de metadados, execute generate-config para gerar arquivos de configuração por tabela. Use a flag --update para preservar os arquivos connections.yaml e settings.yaml que você criou em validation_config/. Por exemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se você também tiver um arquivo de mapeamento de esquema tables.yaml do
tradutor de SQL em lote, inclua a flag
--tables-yaml, sozinha ou com --metadata, para complementar
os mapeamentos de tabelas traduzidos com metadados de partição de origem e exclusões de tipo de dados
do arquivo de metadados. Por exemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
O comando generate-config aceita as seguintes flags:
--metadata PATH_TO_METADATA_ZIP: o caminho para um arquivo de metadados da ferramentadwh-migration-dumper(arquivo ZIP) ou um diretório que contém arquivos de metadados.--tables-yaml PATH_TO_TABLES_YAML: o caminho para um ou mais arquivos ou diretórios de traduçãotables.yaml(separados por vírgulas).--target-dataset TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery que será usado como prefixo nas entradastargetTable.namegeradas.-o, --output-dir DIRECTORY: o diretório de saída para arquivos de configuração modulares. O valor padrão évalidation_config.--schemas SCHEMA_LIST: lista separada por vírgulas de esquemas ou bancos de dados de origem a serem incluídos (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--tables TABLE_LIST: lista separada por vírgulas de nomes de tabelas (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) a serem incluídas (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--filter-file PATH: caminho para um arquivo delimitado por nova linha de nomes de tabelas a serem incluídos (linhas que começam com#são ignoradas).--update: mescla as tabelas descobertas em um diretóriovalidation_config/atual, preservando as substituiçõesconnections.yaml,settings.yamle personalizadas por tabela.--force: permite gravar arquivos de tabela recém-descobertos em um diretório de saída não vazio, mantendo os arquivos de configuração de tabela atuais.--clean: exclui todos os arquivos no diretório de saída antes de gravar os arquivos recém-descobertos.
Databricks
A geração automática de configuração não é compatível com o Databricks. Crie um arquivo tables.yaml manualmente no diretório validation_config/ com as seguintes configurações:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
Para validações de migração do Apache Hive, faça o seguinte para gerar um arquivo ZIP de metadados dos esquemas de origem:
- Instale a ferramenta
dwh-migration-dumper - Execute
dwh-migration-dumperno banco de dados de origem para produzir um arquivo de metadados da ferramentadwh-migration-dumper.
Com o arquivo de metadados, execute generate-config para gerar arquivos de configuração por tabela. Use a flag --update para preservar os arquivos connections.yaml e settings.yaml que você criou em validation_config/. Por exemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se você também tiver um arquivo de mapeamento de esquema tables.yaml do
tradutor de SQL em lote, inclua a flag
--tables-yaml, sozinha ou com --metadata, para complementar
os mapeamentos de tabelas traduzidos com metadados de partição de origem e exclusões de tipo de dados
do arquivo de metadados. Por exemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
O comando generate-config aceita as seguintes flags:
--metadata PATH_TO_METADATA_ZIP: o caminho para um arquivo de metadados da ferramentadwh-migration-dumper(arquivo ZIP) ou um diretório que contém arquivos de metadados.--tables-yaml PATH_TO_TABLES_YAML: o caminho para um ou mais arquivos ou diretórios de traduçãotables.yaml(separados por vírgulas).--target-dataset TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery que será usado como prefixo nas entradastargetTable.namegeradas.-o, --output-dir DIRECTORY: o diretório de saída para arquivos de configuração modulares. O valor padrão évalidation_config.--schemas SCHEMA_LIST: lista separada por vírgulas de esquemas ou bancos de dados de origem a serem incluídos (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--tables TABLE_LIST: lista separada por vírgulas de nomes de tabelas (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) a serem incluídas (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--filter-file PATH: caminho para um arquivo delimitado por nova linha de nomes de tabelas a serem incluídos (linhas que começam com#são ignoradas).--update: mescla as tabelas descobertas em um diretóriovalidation_config/atual, preservando as substituiçõesconnections.yaml,settings.yamle personalizadas por tabela.--force: permite gravar arquivos de tabela recém-descobertos em um diretório de saída não vazio, mantendo os arquivos de configuração de tabela atuais.--clean: exclui todos os arquivos no diretório de saída antes de gravar os arquivos recém-descobertos.
SQL Server
Para validações de migração do SQL Server, faça o seguinte para
gerar um arquivo de metadados da ferramenta dwh-migration-dumper dos esquemas de origem:
- Instale a ferramenta
dwh-migration-dumper - Execute
dwh-migration-dumperno banco de dados de origem para produzir um arquivo de metadados da ferramentadwh-migration-dumper.
Com o arquivo de metadados, execute generate-config para gerar arquivos de configuração por tabela. Use a flag --update para preservar os arquivos connections.yaml e settings.yaml que você criou em validation_config/. Por exemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se você também tiver um arquivo de mapeamento de esquema tables.yaml do
tradutor de SQL em lote, inclua a flag
--tables-yaml, sozinha ou com --metadata, para complementar
os mapeamentos de tabelas traduzidos com metadados de partição de origem e exclusões de tipo de dados
do arquivo de metadados. Por exemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
O comando generate-config aceita as seguintes flags:
--metadata PATH_TO_METADATA_ZIP: o caminho para um arquivo de metadados da ferramentadwh-migration-dumper(arquivo ZIP) ou um diretório que contém arquivos de metadados.--tables-yaml PATH_TO_TABLES_YAML: o caminho para um ou mais arquivos ou diretórios de traduçãotables.yaml(separados por vírgulas).--target-dataset TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery que será usado como prefixo nas entradastargetTable.namegeradas.-o, --output-dir DIRECTORY: o diretório de saída para arquivos de configuração modulares. O valor padrão évalidation_config.--schemas SCHEMA_LIST: lista separada por vírgulas de esquemas ou bancos de dados de origem a serem incluídos (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--tables TABLE_LIST: lista separada por vírgulas de nomes de tabelas (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) a serem incluídas (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--filter-file PATH: caminho para um arquivo delimitado por nova linha de nomes de tabelas a serem incluídos (linhas que começam com#são ignoradas).--update: mescla as tabelas descobertas em um diretóriovalidation_config/atual, preservando as substituiçõesconnections.yaml,settings.yamle personalizadas por tabela.--force: permite gravar arquivos de tabela recém-descobertos em um diretório de saída não vazio, mantendo os arquivos de configuração de tabela atuais.--clean: exclui todos os arquivos no diretório de saída antes de gravar os arquivos recém-descobertos.
MariaDB
A geração automática de configuração não é compatível com o MariaDB. Crie um arquivo tables.yaml manualmente no diretório validation_config/ com as seguintes configurações:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
A geração automática de configuração não é compatível com o MySQL. Crie
um arquivo tables.yaml manualmente no diretório validation_config/ com as
seguintes configurações:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
Para validações de migração do Oracle, faça o seguinte para gerar um
arquivo de metadados da ferramenta dwh-migration-dumper dos esquemas de origem:
- Instale a ferramenta
dwh-migration-dumper - Execute
dwh-migration-dumperno banco de dados de origem para produzir um arquivo de metadados da ferramentadwh-migration-dumper.
Com o arquivo de metadados, execute generate-config para gerar arquivos de configuração por tabela. Use a flag --update para preservar os arquivos connections.yaml e settings.yaml que você criou em validation_config/. Por exemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se você também tiver um arquivo de mapeamento de esquema tables.yaml do
tradutor de SQL em lote, inclua a flag
--tables-yaml, sozinha ou com --metadata, para complementar
os mapeamentos de tabelas traduzidos com metadados de partição de origem e exclusões de tipo de dados
do arquivo de metadados. Por exemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
O comando generate-config aceita as seguintes flags:
--metadata PATH_TO_METADATA_ZIP: o caminho para um arquivo de metadados da ferramentadwh-migration-dumper(arquivo ZIP) ou um diretório que contém arquivos de metadados.--tables-yaml PATH_TO_TABLES_YAML: o caminho para um ou mais arquivos ou diretórios de traduçãotables.yaml(separados por vírgulas).--target-dataset TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery que será usado como prefixo nas entradastargetTable.namegeradas.-o, --output-dir DIRECTORY: o diretório de saída para arquivos de configuração modulares. O valor padrão évalidation_config.--schemas SCHEMA_LIST: lista separada por vírgulas de esquemas ou bancos de dados de origem a serem incluídos (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--tables TABLE_LIST: lista separada por vírgulas de nomes de tabelas (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) a serem incluídas (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--filter-file PATH: caminho para um arquivo delimitado por nova linha de nomes de tabelas a serem incluídos (linhas que começam com#são ignoradas).--update: mescla as tabelas descobertas em um diretóriovalidation_config/atual, preservando as substituiçõesconnections.yaml,settings.yamle personalizadas por tabela.--force: permite gravar arquivos de tabela recém-descobertos em um diretório de saída não vazio, mantendo os arquivos de configuração de tabela atuais.--clean: exclui todos os arquivos no diretório de saída antes de gravar os arquivos recém-descobertos.
PostgreSQL
Para validações de migração do PostgreSQL, faça o seguinte para gerar um
arquivo de metadados da ferramenta dwh-migration-dumper dos seus esquemas de origem:
- Instale a ferramenta
dwh-migration-dumper - Execute
dwh-migration-dumperno banco de dados de origem para produzir um arquivo de metadados da ferramentadwh-migration-dumper.
Com o arquivo de metadados, execute generate-config para gerar arquivos de configuração por tabela. Use a flag --update para preservar os arquivos connections.yaml e settings.yaml que você criou em validation_config/. Por exemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se você também tiver um arquivo de mapeamento de esquema tables.yaml do
tradutor de SQL em lote, inclua a flag
--tables-yaml, sozinha ou com --metadata, para complementar
os mapeamentos de tabelas traduzidos com metadados de partição de origem e exclusões de tipo de dados
do arquivo de metadados. Por exemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
O comando generate-config aceita as seguintes flags:
--metadata PATH_TO_METADATA_ZIP: o caminho para um arquivo de metadados da ferramentadwh-migration-dumper(arquivo ZIP) ou um diretório que contém arquivos de metadados.--tables-yaml PATH_TO_TABLES_YAML: o caminho para um ou mais arquivos ou diretórios de traduçãotables.yaml(separados por vírgulas).--target-dataset TARGET_DATASET: o nome do conjunto de dados de destino do BigQuery que será usado como prefixo nas entradastargetTable.namegeradas.-o, --output-dir DIRECTORY: o diretório de saída para arquivos de configuração modulares. O valor padrão évalidation_config.--schemas SCHEMA_LIST: lista separada por vírgulas de esquemas ou bancos de dados de origem a serem incluídos (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--tables TABLE_LIST: lista separada por vírgulas de nomes de tabelas (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) a serem incluídas (diferencia maiúsculas de minúsculas; aceita caracteres curinga*).--filter-file PATH: caminho para um arquivo delimitado por nova linha de nomes de tabelas a serem incluídos (linhas que começam com#são ignoradas).--update: mescla as tabelas descobertas em um diretóriovalidation_config/atual, preservando as substituiçõesconnections.yaml,settings.yamle personalizadas por tabela.--force: permite gravar arquivos de tabela recém-descobertos em um diretório de saída não vazio, mantendo os arquivos de configuração de tabela atuais.--clean: exclui todos os arquivos no diretório de saída antes de gravar os arquivos recém-descobertos.
Personalizar as configurações da tabela
Cada arquivo de tabela gerado por generate-config contém uma seção table: que
pode ser personalizada antes de executar a validação. A tabela a seguir lista todas as chaves opcionais compatíveis com cada entrada de tabela.
| Chave YAML opcional | Valor padrão | Descrição |
|---|---|---|
runSchema, runAggregate, runData |
true |
Booleanos por tabela para ativar ou desativar pilares de validação individuais quando nenhuma flag de linha de comando de pilar é transmitida. |
maxColumnsPerTile |
100 |
Número máximo de colunas agrupadas em um único bloco de comparação em tabelas amplas. |
strategy |
SMART |
Estratégia de execução da validação de dados: SMART (BRUTE_FORCE com menos de 100.000 linhas, caso contrário, SAMPLE), SAMPLE ou BRUTE_FORCE. |
sampleSize |
70000 |
Número de linhas a serem extraídas (por fração quando particionadas) quando a estratégia resolvida é SAMPLE. O padrão de 70.000 linhas oferece uma probabilidade maior que 99,9% de detectar pelo menos uma linha incompatível quando a taxa de defeito é de 0,01% (1 em 10.000 linhas) ou mais. |
whereClause |
Nenhum | Predicado SQL (sem a palavra-chave WHERE) aplicado às consultas de extração de origem e de comparação de destino. Também pode ser definido separadamente em sourceTable.whereClause e targetTable.whereClause. |
skipRandomization |
false |
Quando true, lê até sampleSize linhas na ordem natural da tabela em vez de classificar por uma função aleatória, reduzindo o custo da consulta em tabelas grandes. |
maxConcurrency |
1 |
Número máximo de linhas de execução de extração de fração paralela para uma tabela particionada. |
maxSlices |
0 (ilimitado) |
Número máximo de frações de partição permitidas para uma tabela particionada. Se a contagem de fatias calculada exceder maxSlices (quando maior que 0), o planejamento da partição vai falhar com um erro. |
disablePartitioning |
false |
Quando true, desativa o fatiamento particionado da tabela, mesmo quando um bloco partitioning está configurado ou a contagem de linhas excede 1000000. |
labels |
Mapa vazio | Rótulos de string de chave-valor anexados às métricas de execução de validação em validation_results. |
As seções a seguir descrevem as maneiras de usar essas chaves YAML para personalizar as execuções de validação.
Selecionar uma estratégia de validação
Use a chave strategy em uma entrada de tabela para selecionar uma estratégia de validação
que controla como o pilar --data extrai e
compara linhas. Os valores a seguir são compatíveis:
SMART(padrão): conta primeiro as linhas na tabela de origem. Se a tabela tiver menos de 100.000 linhas, ela vai executarBRUTE_FORCE. Se a tabela tiver 100.000 linhas ou mais, ela vai executarSAMPLE.SAMPLE: extrai uma amostra aleatória de linhas com base no valor desampleSize(o padrão é70,000) e as mescla com a tabela de destino usandocomparisonKeys. Uma amostra de 70.000 linhas oferece mais de 99,9% de confiança de capturar pelo menos uma linha com defeito quando pelo menos 0,01% das linhas (1 em 10.000) contêm uma incompatibilidade.BRUTE_FORCE: extrai e compara cada linha em uma única passagem de consulta não particionada. As configurações de particionamento são ignoradas quandoBRUTE_FORCEé usado.
Configurar chaves de comparação
Uma chave de comparação é a coluna ou as colunas usadas para identificar e mesclar linhas de maneira exclusiva entre os sistemas de origem e de destino. A chave de comparação descreve os atributos que fornecem exclusividade suficiente para uma mesclagem estável.
Ao executar a comparação de dados no nível da linha, é possível configurar chaves de comparação das seguintes maneiras:
- Descoberta automática: omita
comparisonKeysda seçãosourceTablepara que a ferramenta de validação detecte automaticamente as chaves primárias no banco de dados de origem durante a simulação (voltando para as restrições exclusivasNOT NULLno Oracle e no Snowflake, índices exclusivos no Teradata ou uma coluna únicaDISTKEYouSORTKEYno Amazon Redshift). Chaves compostas ou personalizadas manuais: especifique manualmente as chaves de comparação compostas ou personalizadas listando os nomes das colunas de chave de origem em
comparisonKeysemsourceTable. As diferenças de letras maiúsculas e minúsculas entre os nomes das colunas de chave de origem e de destino são correspondidas automaticamente. Se uma coluna de chave de comparação foi renomeada no BigQuery, mapeie-a emcolumnSettings.columns.SOURCE_COLUMN.targetColumn. O exemplo a seguir configura uma chave de comparação composta:table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
Comparação de hash para tabelas sem uma chave exclusiva: se uma tabela não tiver uma chave primária, em
sourceTable, definauseAllColumnsAsKey: true. Isso também é selecionado automaticamente quando a inspeção de metadados de simulação não encontra chaves primárias.
Configurar a extração particionada para tabelas grandes
Quando a estratégia de uma tabela é resolvida como SAMPLE e um bloco partitioning está presente na configuração da tabela (que generate-config grava por padrão) ou a contagem de linhas da tabela excede 1,000,000, a ferramenta de validação divide a tabela em fatias para que as consultas de amostragem verifiquem intervalos limitados em vez de classificar a tabela inteira de uma só vez. Quando particionada, até sampleSize linhas
são extraídas por fração. Para restringir a validação a um subconjunto de linhas, use
whereClause.
Para configurar a extração particionada, use o bloco partitioning
na seção table:. Por exemplo:
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
O bloco partitioning é compatível com os seguintes campos:
type:INTEGER_RANGE: divide a tabela em intervalos numéricos de chave-valor (COLUMN BETWEEN START AND END). Esse é o valor padrão.DATE_RANGE: divide a tabela em intervalos de data ou carimbo de data/hora. Compatível com PostgreSQL e Snowflake.PHYSICAL: usa partições de banco de dados para tabelas do Oracle e do Amazon Redshift quando há metadados de partição física.
column: especifica uma coluna numérica, de data ou de carimbo de data/hora indexada na tabela de origem usada para calcular os limites de fração. As linhas com valoresNULLna coluna de particionamento são excluídas das frações baseadas em intervalo (INTEGER_RANGEeDATE_RANGE).partitionSize: para o tipoINTEGER_RANGE, esse valor especifica a largura do intervalo de chave-valor numérico por fração, em que o valor padrão é1000000. Para o tipoDATE_RANGE, esse valor especifica o número de dias por fração, em que o valor padrão é30.maxSlices: especifica o número total máximo de frações permitidas para a tabela (definido emtable:). Se uma tabela exigir mais frações do quemaxSlices, o planejamento de partição falhará com um erro que exige umpartitionSizeoumaxSlicesmaior.maxConcurrency: especifica o número de linhas de execução de worker paralelas usadas para extrair fatias, em que o valor padrão é1. Defina emtable:.
Personalizar verificações agregadas
A análise agregada é ativada por padrão e complementa a amostragem no nível da linha com verificações agregadas no nível macro. Essa configuração é útil para validar tabelas grandes em que a amostragem aleatória pode não detectar desvios de dados sutis.
Sem configurações de coluna personalizadas, a ferramenta de validação aplica automaticamente verificações agregadas padrão com base nos tipos de coluna:
- Numérico exato (
INTEGER,NUMERIC,BIGNUMERIC):COUNT,SUM,AVG,MIN,MAX - Ponto flutuante (
FLOAT,DOUBLE,REAL):COUNT,MIN,MAX - Booleano (
BOOLEAN):COUNT,COUNT_TRUE,COUNT_FALSE,COUNT_NULL - String (
STRING,VARCHAR,CHAR,TEXT):COUNT,SUM_LENGTH - Data, hora e carimbo de data/hora:
COUNT,MIN,MAX
É possível personalizar ou desativar as verificações agregadas usando a
seção columnSettings. O exemplo a seguir mostra como
configurar tolerâncias agregadas e substituir verificações de colunas específicas:
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
As seguintes regras de configuração agregada se aplicam:
- As chaves de coluna em
columnSettings.columnsprecisam corresponder ao nome da coluna de origem, diferenciando maiúsculas de minúsculas. toleranceagregado é um limite de diferença absoluta (ABS(target - source) <= tolerance). Se nenhumtoleranceagregado for definido (no nível da coluna ou emcolumnSettings.aggregate.tolerance) e a coluna tiver uma configuraçãotolerances.numericno nível da linha,AVG,MINeMAXvão herdartolerances.numericdiretamente, enquantoSUMvai multiplicar a tolerância herdada no nível da linha porCOUNT.- Só é possível substituir
functionspor coluna emcolumnSettings.columns.SOURCE_COLUMN.aggregate.functions.
Excluir colunas, mapear nomes de colunas e aplicar expressões de comparação SQL
É possível usar columnSettings para excluir colunas, definir tolerâncias numéricas
ou temporais, mapear colunas de destino renomeadas ou aplicar transformações
SQL antes da comparação. Cada chave em
columnSettings.columns é o nome da coluna de origem. Use a propriedade
targetColumn dentro dessa entrada quando a coluna tiver um
nome diferente no BigQuery. Por exemplo:
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings é compatível com os seguintes campos:
exclude: especifique uma lista de nomes de colunas que não diferenciam maiúsculas de minúsculas ou padrões glob (*) para excluir de todos os pilares de validação.tolerances:numeric: tolerância para colunas numéricas (ABS(target - source) <= tolerancepara comparação baseada em chave ou arredondada paraceil(-log10(tolerance))casas decimais quandouseAllColumnsAsKey: true).timestamp: tolerância em segundos para colunas de carimbo de data/hora. Por exemplo,0.001para 1 milissegundo.date: tolerância em dias para colunas de data.
columns: mapa de configurações por coluna, com chave pelo nome da coluna de origem (SOURCE_COLUMN):targetColumn: mapeia a coluna de origem para uma coluna de destino com nome diferente no BigQuery.transform: transformação integrada aplicada antes da comparação:TRIM,UPPER,LOWER: compatíveis com todos os dialetos.EMPTY_TO_NULL,NULL_TO_EMPTY,CAST_TO_STRING: compatível com consultas de origem para origens do PostgreSQL, Amazon Redshift, Oracle e Teradata.
transformExpression: expressão SQL personalizada que faz referência ao nome literal da coluna de origem. Por exemplo,"ROUND(SOURCE_COLUMN, 4)". Como a expressão é avaliada na consulta de origem e na consulta de comparação do BigQuery, use funções SQL que sejam válidas no dialeto de origem e no GoogleSQL.
Normalização de valor
Durante a comparação no nível da linha (--data), o serviço de validação
normaliza os valores para que as diferenças de representação entre os mecanismos de origem
e o BigQuery não causem incompatibilidades. O serviço de validação
normaliza os valores das seguintes maneiras:
- Tipos numéricos exatos (
INTEGER,NUMERIC,DECIMAL,BIGNUMERIC): na comparação baseada em chave, os valores são comparados em escala completa (até nove casas decimais paraNUMERICou até 38 casas decimais paraBIGNUMERIC) e, quandotolerances.numericé definido, os valores correspondem quandoABS(target - source) <= tolerance. Na comparação de hash de linha completa (useAllColumnsAsKey: true), os valores são arredondados para nove casas decimais por padrão ou paraceil(-log10(tolerance))casas decimais quando uma tolerância numérica é definida. - Tipos de usar pontos flutuantes (
FLOAT,DOUBLE,REAL): normalizados para seis casas decimais (1e-6) por padrão. - Carimbos de data/hora: normalizados para UTC com precisão de microssegundos.
- Tipos de caracteres de largura fixa (
CHAR,NCHAR,CHARACTER): os espaços à esquerda e à direita são cortados automaticamente para se alinhar à semânticaSTRINGdo BigQuery.
Executar o serviço de validação
Depois de definir a configuração de validação, execute o comando validate
para iniciar a ferramenta de validação de migração. É possível transmitir um caminho local ou um URI do Cloud Storage gs:// que aponta para o diretório validation_config/.
O exemplo a seguir executa o serviço de validação em arquivos de configuração de validação armazenados localmente:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
Substitua PATH_TO_VALIDATION_CONFIG pelo caminho para
o diretório modular validation_config/.
Se a configuração de validação estiver armazenada no Cloud Storage, transmita o URI gs://
do diretório de configuração:
gcloud bq migration validate gs://BUCKET_NAME/validation_config
Substitua BUCKET_NAME pelo nome do bucket do Cloud Storage.
Por padrão, o serviço de validação é executado em todos os três pilares de validação:
--schema: valida apenas o esquema--aggregate: valida apenas o agregado--data: valida apenas dados no nível da linha.
É possível executar o serviço de validação em um pilar de validação específico usando as
sinalizações de pilar. O exemplo a seguir executa a validação de esquema e agregação em duas tabelas específicas com um filtro WHERE personalizado:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
O comando validate aceita as seguintes sinalizações opcionais:
--tableou--tables: lista separada por vírgulas de nomes de tabelas a serem validados. A correspondência de--tablesdiferencia maiúsculas de minúsculas e precisa corresponder ao uso emsourceTable.nameoutargetTable.name.--where SQL_PREDICATE: substituiwhereClausepara as tabelas de origem e de destino durante essa execução.--source-where SQL_PREDICATE: substituiwhereClauseapenas para a tabela de origem.--target-where SQL_PREDICATE: substituiwhereClauseapenas para a tabela de destino.--gcs-path: substituigoogleCloudStorage.gcsPath. Por exemplo,--gcs-path gs://my-bucket/validation.--max-concurrency,--concurrencyou--threads: substituimaxConcurrencypara extração de fração paralela.--no-partitionou--disable-partitioning: desativa a extração de frações particionadas para todas as tabelas na execução.--labels KEY=VALUE[,KEY=VALUE...]: anexa rótulos de chave-valor personalizados aos resultados da execução.--output-dir: diretório local para arquivos de estado e metadados de execução temporários. O valor padrão é/tmp/validation_outputs.-v,--verbose,-dou--debug: ativa a geração de registros detalhados ou de depuração.
Transferência de fluxo de trabalho assíncrono
O validate realiza a extração de origem de forma síncrona e, em seguida, aciona um
fluxo de trabalho assíncrono do serviço de migração do BigQuery para cada tabela.
Se o conjunto de dados de destino estiver em um local diferente de
us, por exemplo,eu, defina a variável de ambienteBQMS_VALIDATION_LOCATIONantes de executarvalidate:export BQMS_VALIDATION_LOCATION=LOCATION
Para cada tabela, verifique se a saída inclui uma linha
Workflow:contendo o nome do recurso de fluxo de trabalho criado. Por exemplo:Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
O código de saída
0indica que a extração e o upload da origem foram bem-sucedidos, não que a comparação de destino foi concluída ou que os dados correspondem. Se a criação do fluxo de trabalho falhar, por exemplo, devido a uma permissão ausente, a CLI vai registrar um aviso de que o acionamento do fluxo de trabalho de validação falhou, vai imprimir um comando de fallbackgcloudmanual e vai omitir a linhaWorkflow:, mesmo que o processo seja encerrado com0.
Ver resultados da validação
Depois que a execução da validação for concluída, confira os resultados no
console doGoogle Cloud consultando o conjunto de dados de resultados validation_results,
consultando o conjunto de dados do BigQuery configurado em results em
settings.yaml ou lendo os relatórios de resumo no
Cloud Storage. Selecione uma das seguintes opções:
Console do Google Cloud
Acesse a página Serviços de migração no console do Google Cloud .
Em Validar migração, clique em Ver recentes.
Clique em Selecionar um projeto e escolha o projeto em que o conjunto de dados
validation_resultsestá armazenado.
GoogleSQL
Consulte TARGET_PROJECT_ID.validation_results.run_history para verificar
o status das execuções de validação recentes:
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
Substitua TARGET_PROJECT_ID pelo ID do projeto
em que o conjunto de dados validation_results está armazenado.
Para métricas detalhadas por coluna e tendências históricas, consulte o seguinte:
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: contagens de incompatibilidade por execução e por coluna, comparações agregadas e status de aprovação ou falha.<var>TARGET_PROJECT_ID</var>.validation_results.column_history: histórico de auditoria de colunas longitudinais em todas as execuções<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: linhas e colunas de amostra em que os valores de origem e de destino eram diferentes
Relatórios do Cloud Storage
Cada execução concluída grava os seguintes artefatos de relatório no diretório gcs_uri da execução (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/):
validation_summary.txt: resumo executivo dos resultados de comparação de esquema, agregação e linhacolumn_details.txt: detalhamento por coluna de incompatibilidades e diferenças agregadasresults.json: relatório JSON estruturado de todas as descobertas de validaçãoqueries.sql: consultas SQL exatas executadas durante a validação
Para imprimir o relatório de resumo de uma execução, use o seguinte comando:
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
Interpretar resultados de validação
Cada execução de validação em validation_results.run_history informa um dos
seguintes valores de status de execução ou status:
| Status | Descrição | Ação recomendada |
|---|---|---|
IN_PROGRESS |
O fluxo de trabalho de validação ainda está em execução no BigQuery. | Aguarde o preenchimento de finished_at e consulte run_history novamente. |
COMPLETED |
O pipeline de validação foi concluído sem incompatibilidades de dados agregados ou no nível da linha. Os detalhes de compatibilidade do tipo de esquema são registrados separadamente em validation_summary.txt e column_history. |
Nenhuma ação é necessária. A tabela foi validada. |
HEALED |
O pipeline de validação foi concluído sem linhas ausentes, e todas as diferenças de valor detectadas foram instabilidade de representação de usar pontos flutuantes microscópico (< 1e-4 para comparações no nível da célula e < 1e-6 para agregações) reconciliados automaticamente pelo validador. |
Tratada como uma execução aprovada. Se quiser, configure um tolerance numérico explícito para suprimir o jitter upstream. |
COMPLETED_WITH_MISMATCHES |
O pipeline de validação foi executado completamente e encontrou linhas ausentes, colunas de destino ausentes, diferenças agregadas ou diferenças de dados no nível da célula entre as tabelas de origem e de destino. Isso indica uma execução de validação concluída, não uma falha do sistema. | Inspecione column_details.txt, run_metrics e run_RUN_ID_mismatches_details para analisar as colunas e linhas incompatíveis. Para mais informações, consulte Tipos de incompatibilidade no nível da coluna. |
ERROR |
Não foi possível concluir o pipeline de validação devido a um erro de sistema ou de configuração. Por exemplo, devido à falta de uma tabela de destino, a um erro de permissão ou a um SQL inválido em um whereClause ou transformExpression personalizado. |
Verifique a coluna error_message em run_history. Para mais informações sobre como resolver erros comuns, consulte Solução de problemas. |
Tipos de incompatibilidade no nível da coluna
Quando uma execução termina com COMPLETED_WITH_MISMATCHES, as tabelas de incompatibilidade por execução
classificam cada comparação de coluna com um dos seguintes resultados:
EXACT_MATCH: os valores de célula comparados para a coluna corresponderam às tolerâncias configuradas.DATA_DRIFT: as linhas corresponderam emcomparisonKeys, mas os valores das células diferiram além da tolerância configuradaSCHEMA: a coluna existe na tabela de origem, mas está ausente na tabela de destinoROW: as linhas de origem estavam ausentes na tabela de destino ou as linhas de destino estavam ausentes na tabela de origem quando unidas emcomparisonKeys.
Resolver erros comuns
A tabela a seguir lista erros comuns de linha de comando e de fluxo de trabalho e como resolvê-los:
| Mensagem de erro ou problema | Causa | Resolução |
|---|---|---|
Failed to load or parse YAML |
Um bloco de tabela, partitioning, columnSettings ou googleCloudStorage contém uma chave não reconhecida ou um valor de tipo enumerado inválido, como SAMPLING em vez de SAMPLE. |
Verifique o recuo do YAML e os nomes dos campos nas opções de configuração da tabela. |
Connection name '...' is invalid. Must be alphanumeric. |
Um nome de perfil em connections: contém sublinhados ou hifens. Por exemplo, my_source. |
Renomeie os perfis de conexão com nomes alfanuméricos, como source e target. |
googleCloudStorage cannot be null |
googleCloudStorage.gcsPath está ausente de validation_config/settings.yaml, e --gcs-path não foi transmitido. |
Defina googleCloudStorage.gcsPath: gs://BUCKET/PREFIX sem barra final em validation_config/settings.yaml. |
Target discovery directory 'validation_config/' is non-empty |
generate-config foi executado sem --update, --force ou --clean quando validation_config/ já continha arquivos YAML. |
Transmita --update para mesclar as tabelas descobertas, mantendo as connections.yaml e settings.yaml atuais. |
tables is required ao executar validate |
Um arquivo validation-config.yaml legado sem uma lista tables: existe no diretório de trabalho e tem precedência sobre validation_config/, ou não há arquivos YAML de tabela em validation_config/. |
Exclua qualquer arquivo validation-config.yaml perdido no diretório de trabalho para que validate carregue validation_config/. |
| Erro de simulação em uma única chave de comparação de baixa cardinalidade | Uma tabela com mais de 1.000 linhas filtradas é configurada com uma única chave de comparação de baixa cardinalidade, o que causaria uma explosão de mesclagem de muitos para muitos. | Especifique todas as colunas que formam uma chave composta exclusiva em comparisonKeys ou defina useAllColumnsAsKey: true em sourceTable. |
Failed to initialize MemoryUtil ou InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
A JVM é Java 17 ou mais recente e foi iniciada sem --add-opens=java.base/java.nio=ALL-UNNAMED, geralmente porque a linha de comando foi iniciada por um wrapper personalizado ou diretamente com java -jar. |
Defina JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" no ambiente ou use o comando gcloud bq migration validate. |
WARNING: Failed to trigger validation workflow |
A extração da origem foi bem-sucedida, mas a chamada de CreateMigrationWorkflow falhou devido à falta de permissões do IAM, a uma API não ativada ou a um local sem suporte. |
Verifique se bigquerymigration.googleapis.com está ativado, se sua conta tem roles/bigquerymigration.editor e se BQMS_VALIDATION_LOCATION corresponde ao local do conjunto de dados. |
Limpar artefatos de validação
Para gerenciar os custos de armazenamento depois de analisar os resultados da validação, faça o seguinte:
- No Cloud Storage, exclua os diretórios de execução antigos no prefixo
gcsPathno bucket de preparo ou configure uma regra de gerenciamento do ciclo de vida de objetos no bucket. - No BigQuery, as tabelas de comparação por execução no conjunto de dados de resultados
(
validation_resultspor padrão) expiram automaticamente apósresultTtlHours(168.0horas ou 7 dias, por padrão). AjusteresultTtlHoursemsettings.yamlpara reduzir ou aumentar a retenção ou remova as tabelas por execução manualmente, deixando as tabelas e visualizações de histórico compartilhadas (run_history,run_metricsecolumn_history) intactas. - Ao trabalhar com arquivos locais, remova o diretório de trabalho local gravado pela
ferramenta de validação em
--output-dir. O diretório padrão é/tmp/validation_outputs.
Preços
O serviço de validação usa os seguintes recursos no seu projeto:
- Computação e armazenamento do BigQuery: consultas agregadas de destino,
mesclagens de comparação de linhas e armazenamento para tabelas no conjunto de dados
validation_resultssão faturados no projeto do Google Cloud oubillingProjectId, se configurado na conexãotarget, de acordo com os preços padrão do BigQuery. - Armazenamento e rede do Cloud Storage: os arquivos de amostra em CSV ou Parquet em etapas e os relatórios de resultados no bucket são faturados de acordo com os preços padrão do Cloud Storage.
- Carga do banco de dados de origem: as consultas de extração são executadas diretamente no banco de dados de origem. Para minimizar a carga em tabelas de origem grandes, use
strategy: SAMPLE, filtre comwhereClauseou definaskipRandomization: truequando a sobrecarga de classificação aleatória for indesejável.
A seguir
- Saiba como gerar metadados para tradução e avaliação
usando a ferramenta
dwh-migration-dumper. - Traduza consultas SQL em lote para converter seus scripts SQL de origem e DDL em GoogleSQL.
- Planeje uma migração com a linhagem de migração para visualizar as dependências de dados no data warehouse de origem.