


Convalida la migrazione del data warehouse
Il servizio di convalida di BigQuery Migration Service ti consente di verificare che le tabelle di cui è stata eseguita la migrazione dal data warehouse di origine corrispondano alle tabelle di destinazione in BigQuery. Puoi confrontare gli schemi e i dati delle tabelle per identificare le discrepanze durante la migrazione.
Il client del servizio di convalida si connette al database di origine ed estrae lo schema di origine e i dati delle righe in un bucket Cloud Storage che controlli. Una volta estratti, il servizio di convalida confronta lo schema e i dati estratti nel bucket Cloud Storage con le tabelle BigQuery migrate.
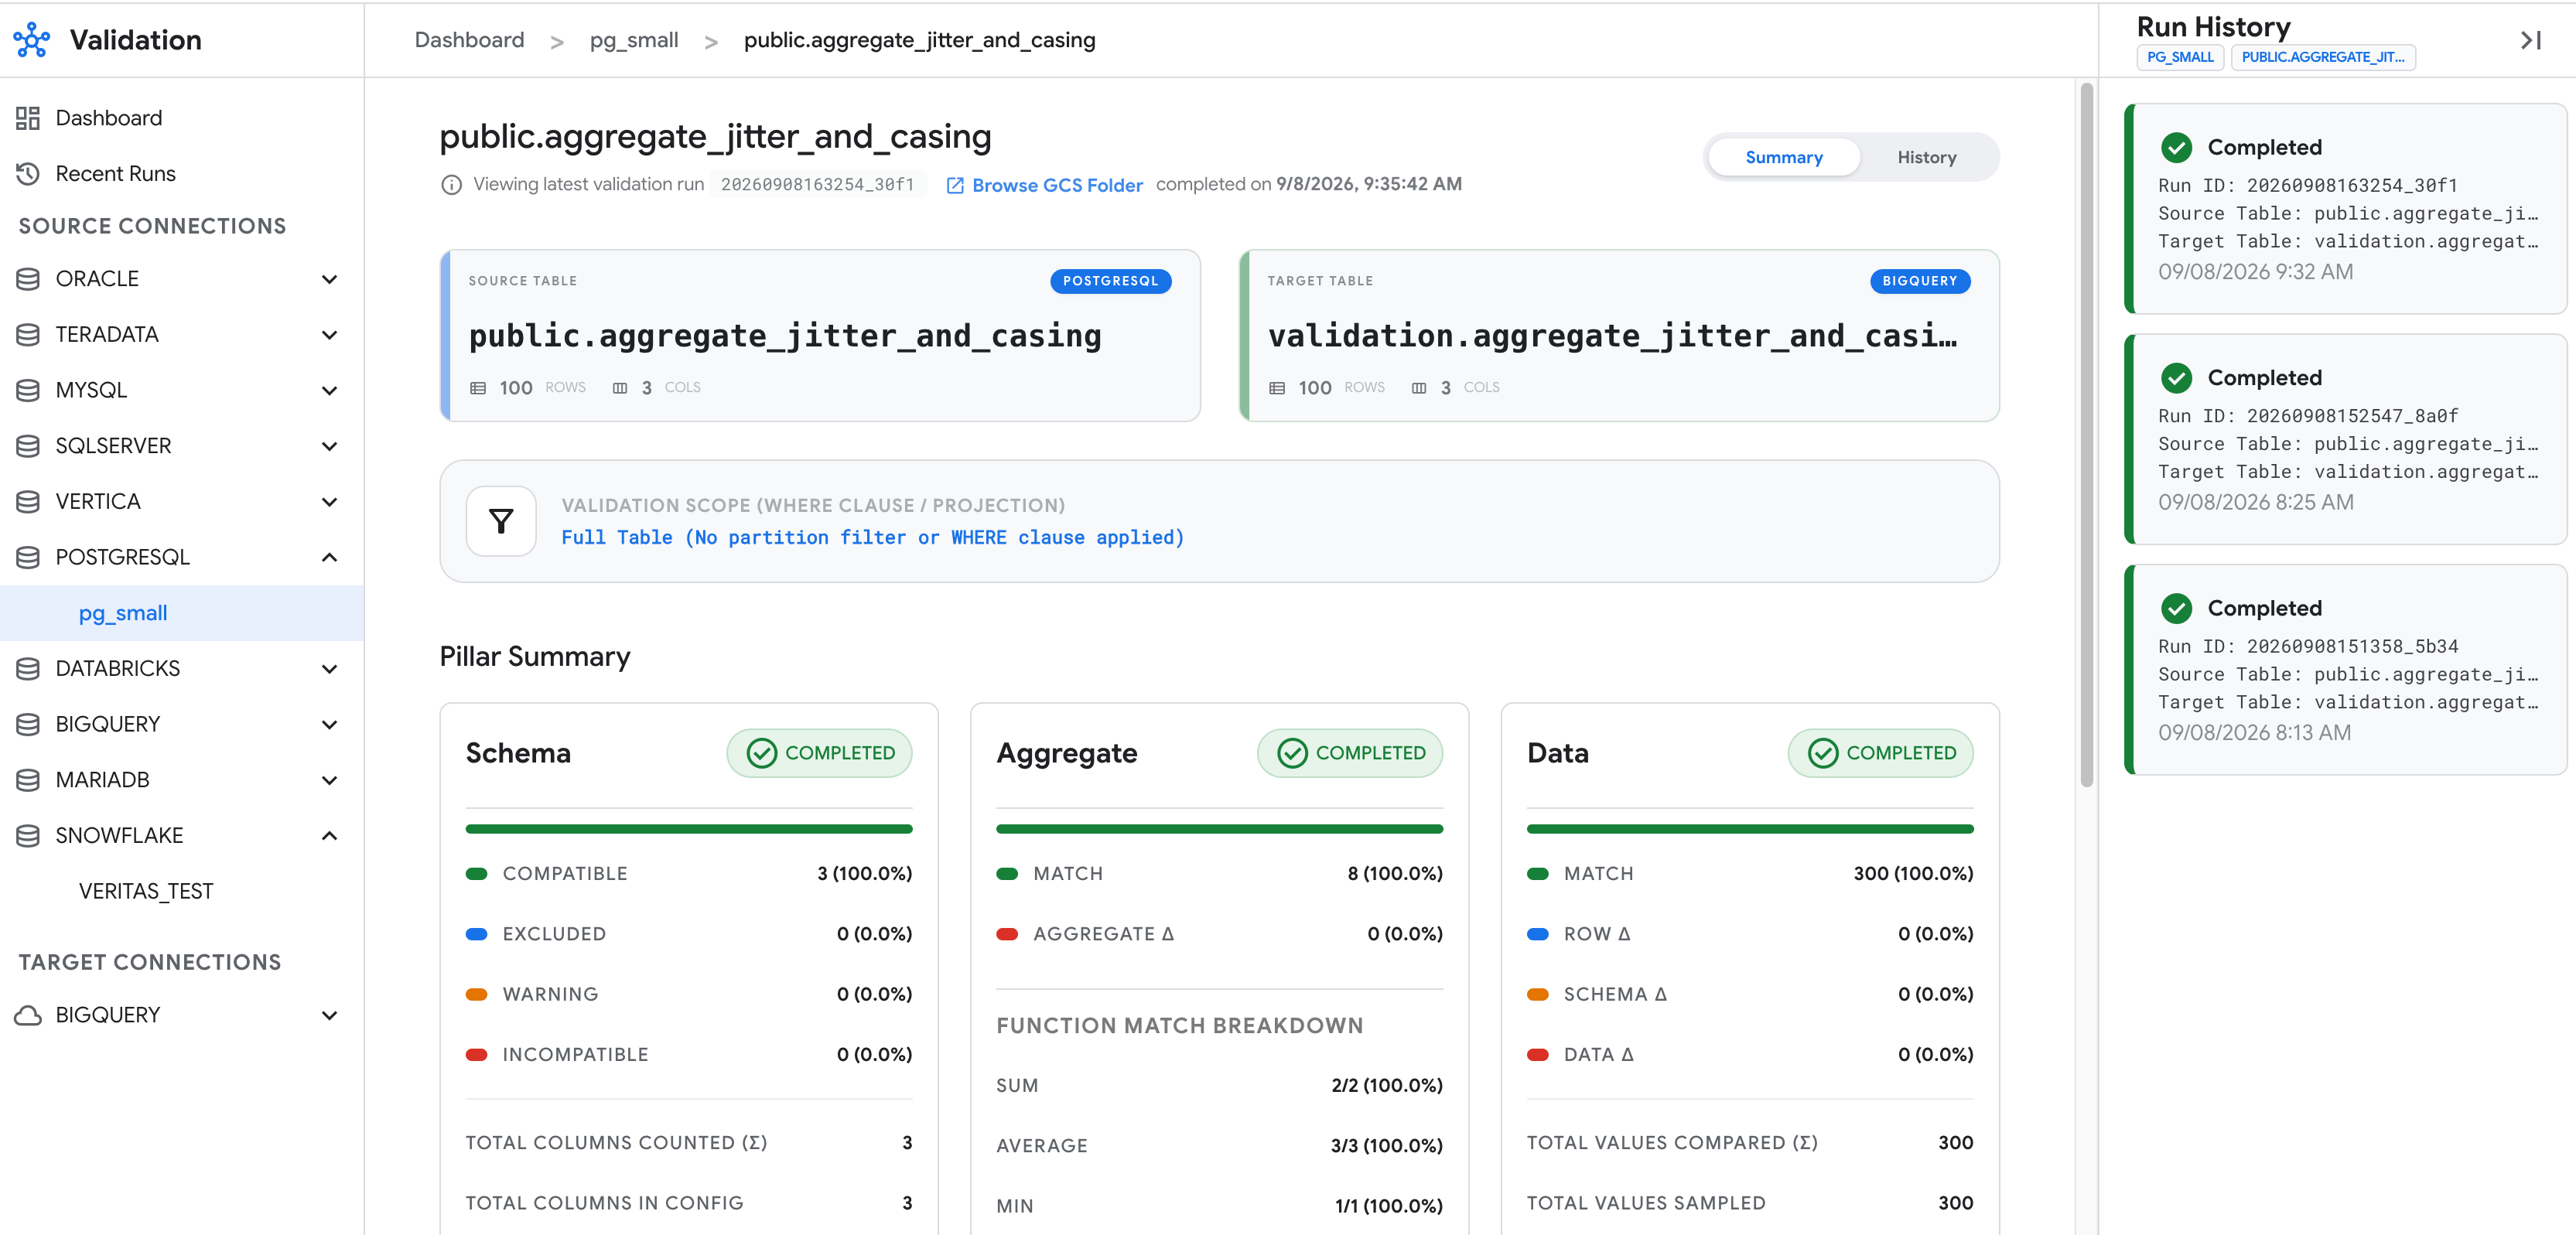
Un workflow di convalida confronta le tabelle di origine e le tabelle BigQuery di destinazione in base a tre pilastri di convalida:
- Convalida dello schema (
--schema): confronta i nomi delle colonne, i tipi di dati e la compatibilità dei tipi tra la tabella di origine e la tabella BigQuery di destinazione. - Convalida aggregata (
--aggregate): calcola e confronta le metriche aggregate a livello di tabella e di colonna, come i conteggi delle righe,SUM,AVG,MIN,MAX, le distribuzioni booleane e le lunghezze delle stringhe, nell'intera tabella. - Convalida dei dati (
--data): esegue un confronto riga per riga utilizzando una scansione completa della tabella (BRUTE_FORCE) o un campionamento casuale basato su chiavi (SAMPLE) per rilevare righe mancanti e deviazioni dei valori a livello di cella.
Località supportate
Il servizio di convalida è disponibile in alcune località. Per saperne di più, consulta Località di BigQuery Migration Service.
Considerazioni sulla gestione e sulla sicurezza dei dati
Il servizio di convalida estrae e prepara dati diversi a seconda del pilastro di convalida che esegui:
- Convalida dello schema (
--schema): carica solo i nomi delle colonne, i tipi di dati e le statistiche della tabella nel filesource_query_result.json, senza estrarre i valori delle celle. - Convalida aggregata (
--aggregate): carica le metriche aggregate calcolate nel filesource_aggregates.parquet, inclusi i valori effettivi delle celleMINeMAXdelle colonne incluse. - Convalida dei dati (
--data): estrae i valori delle celle non mascherati e non elaborati dalle righe campionate o da tutte le righe quando utilizzi la strategiaBRUTE_FORCE. Carica questi valori in formato Apache Parquet o CSV nel tuo bucket di gestione temporanea di Cloud Storage e li carica nel set di dativalidation_resultsin BigQuery.
Per proteggere i tuoi dati e l'ambiente di convalida, configura le seguenti impostazioni:
- Escludi colonne sensibili: aggiungi colonne sensibili al campo
columnSettings.excludeper ometterle dalle query di estrazione dell'origine, dai confronti con i target e dai report di convalida. - Riduci al minimo l'archiviazione locale dei dati: imposta il campo
googleCloudStorage.gcsPathnel filesettings.yamlper trasmettere in streaming le righe campionate direttamente a Cloud Storage senza scriverle sul disco locale. Sugli host condivisi, elimina la directory di lavoro--output-dirlocale dopo ogni esecuzione per rimuovere i file di metadati, aggregati e di log locali. - Cripta i dati e i risultati di gestione temporanea: configura le chiavi di crittografia gestite dal cliente (CMEK) con Cloud Key Management Service nel bucket di gestione temporanea di Cloud Storage e nel set di dati dei risultati di BigQuery (
validation_resultsper impostazione predefinita o il set di dati specificato nel camporesults.dataset) prima di eseguire la convalida. - Limita l'accesso alla configurazione: archivia i file di configurazione della convalida in un repository con controllo della versione che richiede la revisione del codice o in un bucket Cloud Storage in cui solo gli utenti attendibili dispongono dell'autorizzazione
storage.objects.create. - Applica l'accesso con privilegi minimi: concedi al creator del workflow il ruolo
roles/bigquery.dataViewersolo sui set di dati o sulle tabelle di destinazione in fase di convalida, non sul progetto. Utilizza un utente del database di origine di sola lettura come descritto in Configura i privilegi del database di origine.
Prima di iniziare
Nella console Google Cloud , nella pagina di selezione del progetto, seleziona o crea un progetto Google Cloud che contiene i set di dati BigQuery di destinazione.
Verifica che la fatturazione sia abilitata per il tuo progetto Google Cloud .
Abilita le API BigQuery, BigQuery Migration Service, Cloud Storage e (se memorizzi le password del database in Secret Manager) Secret Manager.
Crea o seleziona un bucket Cloud Storage nella stessa località del set di dati BigQuery di destinazione per eseguire lo staging dei metadati estratti e dei campioni di dati. Per saperne di più, consulta Crea un bucket.
Ruoli e autorizzazioni richiesti
Un'esecuzione della convalida è composta da tre parti, ognuna delle quali può essere eseguita da un'entità diversa:
- Raccolta dei dati: il client di convalida legge il database di origine e carica metadati, aggregati e righe campionate nel bucket di gestione temporanea di Cloud Storage. Non chiama BigQuery.
- Convalida: un workflow di convalida di BigQuery Migration Service confronta i dati di gestione temporanea con le tabelle di destinazione. Il workflow viene eseguito con le credenziali dell'entità che lo ha creato, indipendentemente dal fatto che l'entità sia il client di convalida,
gcloudo la console Google Cloud . - Visualizzazione dei risultati: lettura del set di dati dei risultati e dei report di Cloud Storage.
generate-config non richiede Google Cloud autorizzazioni.
Raccolta dei dati
Per ottenere le autorizzazioni necessarie per raccogliere i dati di origine, chiedi all'amministratore di concederti i seguenti ruoli IAM:
- Storage Object Creator (
roles/storage.objectCreator) sul bucket di gestione temporanea - Storage Object Viewer (
roles/storage.objectViewer) sul bucket di gestione temporanea -
Lettura dei file di configurazione da Cloud Storage:
Storage Object Viewer (
roles/storage.objectViewer) sul bucket di configurazione -
Leggi le password del database da Secret Manager:
Secret Manager Secret Accessor (
roles/secretmanager.secretAccessor) sul secret
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questi ruoli predefiniti contengono le autorizzazioni necessarie per raccogliere i dati di origine. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per raccogliere i dati di origine sono necessarie le seguenti autorizzazioni:
-
storage.objects.createsul bucket di gestione temporanea -
storage.objects.getsul bucket di gestione temporanea -
Leggi i file di configurazione da Cloud Storage:
-
storage.objects.getsul bucket di configurazione -
storage.objects.listsul bucket di configurazione
-
-
Leggi le password del database da Secret Manager:
secretmanager.versions.accesssul secret
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Con --extract-only, la raccolta dei dati non richiede autorizzazioni BigQuery o BigQuery Migration Service. Senza questo ruolo, il client crea anche i workflow di convalida e richiede i ruoli di convalida.
Convalida
Per ottenere le autorizzazioni necessarie per creare ed eseguire workflow di convalida, chiedi all'amministratore di concederti i seguenti ruoli IAM:
- MigrationWorkflow Editor (
roles/bigquerymigration.editor) sul progetto - Utente job BigQuery (
roles/bigquery.jobUser) sul progetto - BigQuery Data Viewer (
roles/bigquery.dataViewer) su ogni set di dati di destinazione - BigQuery Data Editor (
roles/bigquery.dataEditor) sul set di dati dei risultati - Storage Object User (
roles/storage.objectUser) sul bucket di gestione temporanea -
Se il set di dati dei risultati non esiste:
BigQuery User (
roles/bigquery.user) sul progetto
Questi ruoli predefiniti contengono le autorizzazioni necessarie per creare ed eseguire workflow di convalida. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per creare ed eseguire workflow di convalida sono necessarie le seguenti autorizzazioni:
-
bigquerymigration.workflows.createsul progetto -
bigquerymigration.workflows.getsul progetto -
bigquery.jobs.createsul progetto -
bigquery.tables.getsu ogni set di dati di destinazione -
bigquery.tables.getDatasu ogni set di dati di destinazione -
bigquery.datasets.getsul set di dati dei risultati -
bigquery.tables.getsul set di dati dei risultati -
bigquery.tables.createsul set di dati dei risultati -
bigquery.tables.updatesul set di dati dei risultati -
bigquery.tables.updateDatasul set di dati dei risultati -
bigquery.tables.getDatasul set di dati dei risultati -
storage.objects.getsul bucket di gestione temporanea -
storage.objects.createsul bucket di gestione temporanea -
storage.objects.deletesul bucket di gestione temporanea -
Se il set di dati dei risultati non esiste:
bigquery.datasets.createsul progetto
roles/bigquerymigration.editor contiene molte autorizzazioni che la convalida non utilizza. Per il privilegio minimo, concedi un ruolo personalizzato solo con bigquerymigration.workflows.create e bigquerymigration.workflows.get.
La convalida legge solo le tabelle di destinazione e scrive solo nel set di dati dei risultati. Ti consigliamo di creare il set di dati dei risultati in anticipo, in modo che nessuna entità debba avere l'autorizzazione per creare set di dati nel tuo progetto.
Visualizzazione dei risultati
Per ottenere le autorizzazioni necessarie per visualizzare i risultati della convalida, chiedi all'amministratore di concederti i seguenti ruoli IAM:
- BigQuery Job User (
roles/bigquery.jobUser) sul progetto che contiene il set di dati dei risultati - Visualizzatore dati BigQuery (
roles/bigquery.dataViewer) sul set di dati dei risultati -
Lettura dei report in Cloud Storage:
Storage Object Viewer (
roles/storage.objectViewer) sul bucket di gestione temporanea -
Elenca e visualizza i workflow di convalida nella console Google Cloud :
MigrationWorkflow Viewer (
roles/bigquerymigration.viewer) sul progetto
Questi ruoli predefiniti contengono le autorizzazioni necessarie per visualizzare i risultati della convalida. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per visualizzare i risultati della convalida sono necessarie le seguenti autorizzazioni:
-
bigquery.jobs.createsul progetto -
bigquery.tables.getsul set di dati dei risultati -
bigquery.tables.getDatasul set di dati dei risultati -
Leggi i report in Cloud Storage:
-
storage.objects.getsul bucket di gestione temporanea -
storage.objects.listsul bucket di gestione temporanea
-
-
Elenca e visualizza i workflow di convalida nella console Google Cloud :
-
bigquerymigration.workflows.listsul progetto -
bigquerymigration.workflows.getsul progetto
-
Configura i privilegi del database di origine
Devi configurare l'accesso di sola lettura all'utente del database di origine con i seguenti privilegi:
- Privilegio
SELECTsu ogni tabella di origine convalidata. - Accesso in lettura alle viste del catalogo di sistema utilizzate per il rilevamento dello schema e della chiave primaria (ad esempio le tabelle
information_schema,ALL_CONSTRAINTSeALL_TAB_COLUMNSsu Oracle oSVV_COLUMNSepg_attributesu Amazon Redshift).
Non concedere a questo utente privilegi di scrittura, DDL o amministrativi. Il client di convalida esegue l'SQL dalla configurazione di convalida come questo utente. Per saperne di più, consulta Considerazioni sulla gestione e sulla sicurezza dei dati.
Limitazioni
Il servizio di convalida è soggetto alle seguenti limitazioni:
- BigQuery è l'unico database di destinazione supportato. La convalida tra due database non BigQuery o l'utilizzo di BigQuery come origine di convalida non sono supportati.
- Il set di dati BigQuery di destinazione, il set di dati dei risultati (
validation_resultsper impostazione predefinita o il set di dati personalizzato configurato inresultsinsettings.yaml), il bucket di gestione temporanea di Cloud Storage e la località del workflow di convalida (BQMS_VALIDATION_LOCATION) devono trovarsi nella stessa località. Quando il servizio di convalida crea il set di dati dei risultati, la località del set di dati viene impostata per impostazione predefinita sulla regione utilizzata dal bucket di gestione temporanea di Cloud Storage e dal set di dati BigQuery di destinazione o suresults.locationse impostata esplicitamente. - Il supporto dei tipi di dati varia in base all'origine. Le colonne con tipi non supportati sono escluse dalla convalida. Per maggiori dettagli, consulta Data warehouse supportati.
- Le tabelle di confronto per esecuzione create in BigQuery scadono automaticamente in base a
resultTtlHoursinsettings.yaml, che per impostazione predefinita è168.0ore o sette giorni. Non configurare una scadenza della tabella predefinita a livello di set di dati nel set di dativalidation_results, perché in questo modo scadono anche le tabelle di controllo di lunga durata comerun_history,run_metricsecolumn_history. - I nomi delle tabelle BigQuery sono sensibili alle maiuscole. Quando
generate-configcrea configurazioni da un archivio di metadati dello strumentodwh-migration-dumpersenza una mappatura di traduzionetables.yaml, i nomi delle tabelle di destinazione conservano l'uso delle maiuscole e delle minuscole dell'identificatore di origine. Ad esempio, i nomi delle tabelle in maiuscolo di Oracle o Snowflake. Verifica chetargetTable.namecorrisponda esattamente al nome della tabella in BigQuery.
Data warehouse supportati
Il servizio di convalida supporta i seguenti database di origine. Ogni sezione include il driver JDBC in bundle con l'installazione, se puoi o meno generare automaticamente le configurazioni delle tabelle da un archivio di metadati dello strumento dwh-migration-dumper, i tipi di partizionamento supportati per le tabelle di grandi dimensioni di questo database e i tipi di dati supportati per la convalida.
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
Sono supportate anche le varianti parametrizzate dei tipi di dati supportati, come VARCHAR(255) o DECIMAL(10,2).
Il servizio di convalida carica tutti i file JAR nella directory drivers/ prima dei driver scaricati automaticamente, quindi puoi utilizzare drivers/ anche per eseguire l'override di una versione del driver in bundle.
Se generi automaticamente un file di configurazione della convalida, le colonne con tipi di dati non supportati vengono aggiunte automaticamente a columnSettings.exclude. Per le configurazioni manuali, devi escluderli esplicitamente in columnSettings.exclude.
Per la maggior parte dei database di origine supportati, lo strumento di convalida scarica automaticamente il driver JDBC richiesto da Maven Central al primo utilizzo, ne verifica il checksum SHA-256 e lo memorizza nella cache locale in ~/.cache/google-cloud-bqms/drivers/ (o $XDG_CACHE_HOME/google-cloud-bqms/drivers/). Per i data warehouse che utilizzano driver proprietari, come Teradata, o quando l'esecuzione avviene in un ambiente offline o con air gap, segui questi passaggi:
- Inserisci il file JAR del driver richiesto in
./drivers/,<sdk_root>/platform/bqms/drivers/o nella directory specificata dalla variabile di ambienteBQMS_DRIVER_DIR. Qualsiasi JAR del driver inserito in queste directory locali ha la precedenza sui download automatici di Maven Central. - Per disattivare completamente i download automatici dalla rete in ambienti con air gap, imposta
BQMS_AUTO_DOWNLOAD_DRIVERS=falseo impostaBQMS_MAVEN_MIRRORin modo che rimandi a un mirror del repository Maven interno.
Per scoprire di più su ogni origine dati supportata dal servizio di convalida, seleziona una delle seguenti opzioni:
Teradata
Le convalide per le migrazioni di Teradata sono supportate come segue:
- Valore
dialect:teradata - Driver JDBC: fornito dall'utente. Scarica il file JAR del driver JDBC Teradata, ad esempio
terajdbc4.jaroterajdbc.jar, da Teradata e copialo nella directorydrivers/o nella directory specificata daBQMS_DRIVER_DIR. -
user
English:
Configure Dataplex to automatically scan and extract metadata from assets.
Italian:
dwh-migration-dumper--connector teradata - Estrazione partizionata:
INTEGER_RANGE,PHYSICAL
| Categoria | Tipi di dati |
|---|---|
| Numerico | BYTEINT, SMALLINT, INTEGER, INT, BIGINT, DECIMAL, DEC, NUMERIC, NUMBER, FLOAT, REAL, DOUBLE PRECISION |
| Stringa | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, LONG VARCHAR |
| Data e ora | DATE, TIME, TIME WITH TIME ZONE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
Quando convalidi le migrazioni da Teradata, tieni presente quanto segue:
- Quando una tabella non ha una chiave primaria esplicita, le chiavi di confronto vengono rilevate dagli indici primari univoci (
UPI) o dagli indici secondari univoci (USI). Gli indici primari non univoci (NUPI) non vengono utilizzati come chiavi di confronto. NUMBER(P,S)con precisione fissa è supportato;NUMBERnon vincolato (senza precisione) non è supportato. Le colonneNUMBER,CLOB,BLOB,BYTE,VARBYTE,INTERVAL,PERIOD,JSONeXMLnon vincolate vengono escluse automaticamente dagenerate-config(o devono essere elencate incolumnSettings.excludeper le configurazioni manuali).- Le colonne
CHARa larghezza fissa vengono tagliate automaticamente. Sono supportati sia i set di caratteriLATINeUNICODEsia gli attributiCASESPECIFIC/NOT CASESPECIFIC. - I valori
TIME WITH TIME ZONEeTIMESTAMP WITH TIME ZONEvengono normalizzati in UTC (AT 0) prima del confronto.
Snowflake
Le convalide per le migrazioni di Snowflake sono supportate come segue:
- Valore
dialect:snowflake - Driver JDBC: scaricato automaticamente al primo utilizzo (
net.snowflake:snowflake-jdbc) o fornito dall'utente nella directorydrivers/per gli ambienti offline. -
user
English:
Configure Dataplex to automatically scan and extract metadata from assets.
Italian:
dwh-migration-dumper--connector snowflake - Estrazione partizionata:
INTEGER_RANGE,DATE_RANGE
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni di Snowflake:
| Categoria | Tipi di dati |
|---|---|
| Numerico | NUMBER, DECIMAL, NUMERIC, FLOAT, REAL, DOUBLE |
| Stringa | CHAR, VARCHAR, STRING, TEXT |
| Data e ora | DATE, TIME, TIMESTAMP_NTZ, TIMESTAMP_LTZ, TIMESTAMP_TZ |
| Booleano | BOOLEAN |
Quando convalidi le migrazioni da Snowflake, tieni presente quanto segue:
- Le colonne
CHARa larghezza fissa vengono tagliate automaticamente. - Se hai replicato i dati con BigQuery Data Transfer Service, imposta
tolerances.timestamp: 0.001per assorbire l'arrotondamento inferiore al millisecondo.
Amazon Redshift
Le convalide per le migrazioni da Amazon Redshift sono supportate come segue:
- Valore
dialect:redshift - Driver JDBC: scaricato automaticamente al primo utilizzo (
com.amazon.redshift:redshift-jdbc42) o fornito dall'utente nella directorydrivers/per gli ambienti offline. - Generazione automatica della configurazione: supportata da un
dwh-migration-dumperarchivio di metadati dello strumento (--connector redshift). - Estrazione partizionata:
INTEGER_RANGE,PHYSICAL
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni di Amazon Redshift:
| Categoria | Tipi di dati |
|---|---|
| Numerico | SMALLINT, INTEGER, BIGINT, DECIMAL, NUMERIC, REAL, DOUBLE PRECISION |
| Stringa | CHAR, VARCHAR, TEXT |
| Data e ora | DATE, TIME, TIMETZ, TIMESTAMP, TIMESTAMPTZ |
| Booleano | BOOLEAN |
| Semistrutturati | SUPER |
Quando convalidi le migrazioni da Amazon Redshift, tieni presente quanto segue:
- L'ispezione dello schema utilizza
SVV_COLUMNS, pertanto sono supportate le visualizzazioni con associazione tardiva. - Quando una tabella non ha una chiave primaria, le chiavi di confronto vengono impostate automaticamente su una singola colonna
DISTKEYoSORTKEY. - Le colonne
GEOMETRYnon sono supportate.
Databricks
Le convalide per le migrazioni di Databricks sono supportate come segue:
- Valore
dialect:databricks - Driver JDBC: scaricato automaticamente al primo utilizzo (
com.databricks:databricks-jdbc) o fornito dall'utente nella directorydrivers/per gli ambienti offline. - Generazione automatica della configurazione: non supportata. Crea un file di configurazione della tabella manuale.
- Estrazione partizionata:
INTEGER_RANGE
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni di Databricks:
| Categoria | Tipi di dati |
|---|---|
| Numerico | BYTE, TINYINT, SHORT, SMALLINT, INT, INTEGER, LONG, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| Stringa | CHAR, VARCHAR, STRING |
| Data e ora | DATE, TIMESTAMP |
| Booleano | BOOLEAN |
| Binario | BINARY |
| Complesso | ARRAY, MAP, STRUCT |
Quando convalidi le migrazioni da Databricks, tieni presente quanto segue:
- Esegui l'autenticazione con un token di accesso personale: imposta
user: tokene fornisci il token tramitepasswordSecret. - L'ispezione dello schema è basata su query (
SELECT * ... WHERE 1=0), pertanto sono supportati sia gli spazi di lavoro Unity Catalog che quelli del metastore Hive.
Apache Hive
Le convalide per le migrazioni di Apache Hive sono supportate come segue:
- Valore
dialect:hive - Driver JDBC: scaricato automaticamente al primo utilizzo (JAR autonomo
org.apache.hive:hive-jdbc) o fornito dall'utente nella directorydrivers/per gli ambienti offline. -
user
English:
Configure Dataplex to automatically scan and extract metadata from assets.
Italian:
dwh-migration-dumper--connector hiveql - Estrazione partizionata:
INTEGER_RANGE
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni Hive:
| Categoria | Tipi di dati |
|---|---|
| Numerico | TINYINT, SMALLINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| Stringa | CHAR, VARCHAR, STRING |
| Data e ora | DATE, TIMESTAMP |
| Booleano | BOOLEAN |
| Binario | BINARY |
| Complesso | ARRAY, MAP, STRUCT |
Quando convalidi le migrazioni da Hive, tieni presente quanto segue:
- L'ispezione dello schema è basata su query (
SELECT * ... WHERE 1=0). - Le tabelle Hive raramente definiscono chiavi primarie. Le tabelle senza chiavi di confronto utilizzano automaticamente l'aggregazione hash di righe intere per il pillar dei dati.
SQL Server
Le convalide per le migrazioni di SQL Server sono supportate come segue:
- Valore
dialect:sqlserver - Driver JDBC: scaricato automaticamente al primo utilizzo (
com.microsoft.sqlserver:mssql-jdbc) o fornito dall'utente nella directorydrivers/per gli ambienti offline. -
user
English:
Configure Dataplex to automatically scan and extract metadata from assets.
Italian:
dwh-migration-dumper--connector sqlserver - Estrazione partizionata:
INTEGER_RANGE
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni di SQL Server:
| Categoria | Tipi di dati |
|---|---|
| Numerico | INT, BIGINT, DECIMAL, NUMERIC, FLOAT, REAL |
| Stringa | CHAR, VARCHAR, TEXT |
| Data e ora | DATE, DATETIME, TIMESTAMP |
| Booleano | BIT |
Quando convalidi le migrazioni da SQL Server, tieni presente quanto segue:
- L'URL JDBC predefinito imposta
encrypt=true;trustServerCertificate=true;. Esegui l'override con la chiave di connessioneurlse hai bisogno di una convalida rigorosa del certificato TLS.
MariaDB
Le convalide per le migrazioni di MariaDB sono supportate come segue:
- Valore
dialect:mariadb - Driver JDBC: scaricato automaticamente al primo utilizzo (
org.mariadb.jdbc:mariadb-java-client) o fornito dall'utente nella directorydrivers/per gli ambienti offline. - Generazione automatica della configurazione: crea un file di configurazione della tabella manuale.
- Estrazione partizionata:
INTEGER_RANGE
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni MariaDB:
| Categoria | Tipi di dati |
|---|---|
| Numerico | TINYINT, SMALLINT, MEDIUMINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| Stringa | CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, ENUM, SET |
| Data e ora | DATE, TIME, DATETIME, TIMESTAMP, YEAR |
| Oggetti binari e di grandi dimensioni | BINARY, VARBINARY, TINYBLOB, BLOB, MEDIUMBLOB, LONGBLOB |
MySQL
Le convalide per le migrazioni MySQL sono supportate come segue:
- Valore
dialect:mysql - Driver JDBC: scaricato automaticamente al primo utilizzo (
com.mysql:mysql-connector-j) o fornito dall'utente nella directorydrivers/per gli ambienti offline. - Generazione automatica della configurazione: crea un file di configurazione della tabella manuale.
- Estrazione partizionata:
INTEGER_RANGE
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni MySQL:
| Categoria | Tipi di dati |
|---|---|
| Numerico | INT, BIGINT, DECIMAL, FLOAT, DOUBLE |
| Stringa | CHAR, VARCHAR, TEXT |
| Data e ora | DATE, TIME, DATETIME, TIMESTAMP |
| Booleano | BOOLEAN |
Oracle
Le convalide per le migrazioni Oracle sono supportate come segue:
- Valore
dialect:oracle - Driver JDBC: scaricato automaticamente al primo utilizzo (
com.oracle.database.jdbc:ojdbc11) o fornito dall'utente nella directorydrivers/per gli ambienti offline. -
user
English:
Configure Dataplex to automatically scan and extract metadata from assets.
Italian:
dwh-migration-dumper--connector oracle - Estrazione partizionata:
INTEGER_RANGE,PHYSICAL
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni Oracle:
| Categoria | Tipi di dati |
|---|---|
| Numerico | NUMBER, NUMERIC, INTEGER, FLOAT, DOUBLE |
| Stringa | CHAR, NCHAR, VARCHAR, VARCHAR2, NVARCHAR2 |
| Data e ora | DATE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
| Oggetti binari e di grandi dimensioni | RAW, BINARY, BLOB, CLOB, NCLOB |
Quando convalidi le migrazioni da Oracle, tieni presente quanto segue:
- Le colonne
DATEincludono un componente temporale in Oracle. Lo strumento di convalida estrae le colonne OracleDATEcon precisione giornaliera (YYYY-MM-DD), pertanto le differenze di ora del giorno vengono troncate.
PostgreSQL
Le convalide per le migrazioni PostgreSQL sono supportate come segue:
- Valore
dialect:postgresql - Driver JDBC: scaricato automaticamente al primo utilizzo (
org.postgresql:postgresql) o fornito dall'utente nella directorydrivers/per gli ambienti offline. -
user
English:
Configure Dataplex to automatically scan and extract metadata from assets.
Italian:
dwh-migration-dumper--connector postgres - Estrazione partizionata:
INTEGER_RANGE,DATE_RANGE,PHYSICAL
Il servizio di convalida supporta i seguenti tipi di dati per le migrazioni PostgreSQL:
| Categoria | Tipi di dati |
|---|---|
| Numerico | SMALLINT, INTEGER, BIGINT, NUMERIC, DOUBLE PRECISION |
| Stringa | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, TEXT |
| Data e ora | DATE, TIME, TIMESTAMP, TIMESTAMP WITHOUT TIME ZONE, TIMESTAMP WITH TIME ZONE, TIMESTAMPTZ |
| Booleano | BOOLEAN |
| Altro | UUID |
Quando convalidi le migrazioni da PostgreSQL, tieni presente quanto segue:
- I valori
BIGINTmaggiori di 253 possono mostrare piccole differenze di precisione suAVG();SUMeCOUNTrimangono esatti.
Configura la directory e i file di configurazione della convalida
Il servizio di convalida legge da una directory di configurazione modulare denominata validation_config/ che contiene i seguenti file:
- File delle connessioni al database: definisce il profilo di connessione al data warehouse
sourcee il profilo di connessione a BigQuerytarget. - File delle impostazioni di gestione temporanea e dei risultati: definisce il percorso di gestione temporanea di Cloud Storage (
googleCloudStorage), la configurazione del set di dati dei risultati di BigQuery (results), la scadenza della tabella di confronto per esecuzione (resultTtlHours) e i valori predefiniti globali facoltativi (tolerances,aggregate,labels). - File di configurazione della convalida delle tabelle: contiene mappature per tabella (
sourceTableetargetTable), chiavi di confronto (comparisonKeys), strategia di convalida (strategy), impostazioni di estrazione partizionata (partitioning) e impostazioni delle colonne (columnSettings).
Le sezioni seguenti descrivono i passaggi per configurare la directory di configurazione della convalida e i passaggi per creare i file di configurazione necessari per una convalida della migrazione.
Crea una directory di configurazione della convalida
Crea una directory di configurazione della convalida denominata validation_config/ per archiviare i file di configurazione della convalida. Puoi archiviare questa directory sulla macchina che esegue il servizio di convalida o in un bucket Cloud Storage in modo che un team possa condividere una configurazione tra le esecuzioni.
Crea un file di connessioni al database
Nella directory di configurazione della convalida, crea un file denominato connections.yaml
e configuralo con le informazioni per connetterti a un database di origine e a un
database BigQuery di destinazione.
Ogni origine del data warehouse ha caratteristiche e requisiti specifici da considerare quando crei il file delle connessioni al database. Per saperne di più su ogni origine dati, consulta Data warehouse supportati.
Quando specifichi passwordSecret in un profilo di connessione, il servizio di convalida recupera la versione del secret da Secret Manager sulla macchina client utilizzando le Credenziali predefinite dell'applicazione (ADC) locali e passa la password risolta direttamente al driver JDBC locale. Il database di origine non richiede l'accesso alla rete o l'accesso IAM a Google Cloud, pertanto passwordSecret funziona per i database on-premise e i database ospitati in altri cloud, come Amazon Redshift o Snowflake. In alternativa, puoi omettere passwordSecret e impostare la variabile di ambiente BQMS_VALIDATION_SOURCE_PASSWORD sulla macchina che esegue il servizio di convalida.
Per creare un file di connessioni al database per un data warehouse, seleziona una delle seguenti opzioni:
Teradata
Per le convalide della migrazione di Teradata, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SOURCE_HOST: il nome host o l'indirizzo IP del tuo sistema Teradata.SOURCE_DATABASE: il nome del database Teradata richiesto.SOURCE_USER: il nome utente Teradata.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password oppure impostaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
Snowflake
Per le convalide della migrazione di Snowflake, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SNOWFLAKE_ACCOUNT: l'identificatore del tuo account Snowflake (ad esempio,myorg-myaccount).SNOWFLAKE_WAREHOUSE: il data warehouse virtuale utilizzato per eseguire le query di estrazione.SOURCE_DATABASE: il nome del database Snowflake richiesto.SOURCE_SCHEMA: il nome dello schema Snowflake richiesto.SNOWFLAKE_ROLE: ruolo Snowflake facoltativo.SOURCE_USER: il nome utente Snowflake.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password oppure impostaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
Amazon Redshift
Per le convalide della migrazione di Amazon Redshift, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SOURCE_HOST: il nome host dell'endpoint del cluster Amazon Redshift.SOURCE_DATABASE: il nome del database Amazon Redshift richiesto.SOURCE_SCHEMA: il nome dello schema predefinito (il valore predefinito èpublicse omesso).SOURCE_USER: il nome utente del database.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password oppure impostaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
Databricks
Per le convalide della migrazione di Databricks, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
DATABRICKS_HOST: il nome host del server del tuo Databricks SQL Warehouse o cluster.HTTP_PATH: il percorso HTTP del tuo Databricks SQL Warehouse (ad esempiosql/protocolv1/o/1234567890/0123-456789-abcdef).CATALOG_NAME: il nome Unity Catalog richiesto (ohive_metastore).SCHEMA_NAME: il nome dello schema richiesto.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti il tuo token di accesso personale (PAT) Databricks oppure omettipasswordSecrete impostaBQMS_VALIDATION_SOURCE_PASSWORD. L'utilizzo diuser: tokenconpasswordSecretgarantisce che il token non venga mai scritto nei file dei metadati di gestione temporanea.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
Apache Hive
Per le convalide della migrazione di Apache Hive, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SOURCE_HOST: il nome host o l'indirizzo IP di HiveServer2.SOURCE_DATABASE: il nome del database Hive richiesto (ad esempio,default).SOURCE_USER: il nome utente Hive.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password o impostati suBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
SQL Server
Per le convalide della migrazione di SQL Server, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SOURCE_HOST: il nome host o l'indirizzo IP della tua istanza SQL Server (facoltativamente, specificainstanceNameper le istanze denominate).SOURCE_DATABASE: il nome del database richiesto.SOURCE_SCHEMA: il nome dello schema predefinito (il valore predefinito èdbose omesso).SOURCE_USER: il nome utente del database.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password oppure impostaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
MariaDB
Per le convalide della migrazione di MariaDB, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SOURCE_HOST: il nome host o l'indirizzo IP del tuo server MariaDB.SOURCE_DATABASE: il nome del database MariaDB richiesto.SOURCE_USER: il nome utente MariaDB.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password oppure impostaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
MySQL
Per le convalide della migrazione di MySQL, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SOURCE_HOST: il nome host o l'indirizzo IP del tuo server MySQL.SOURCE_DATABASE: il nome del database MySQL richiesto.SOURCE_USER: il nome utente MySQL.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password oppure impostaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
Oracle
Per le convalide della migrazione di Oracle, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SOURCE_HOST: il nome host o l'indirizzo IP del tuo server Oracle.SERVICE_NAME: il nome del servizio Oracle (utilizzato per crearejdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME). Per le connessioni TNS o SID personalizzate, specificaurlcon l'URL JDBC completo.SOURCE_SCHEMA: nome dello schema predefinito facoltativo.SOURCE_USER: il nome utente Oracle richiesto.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password del database o impostaBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud di destinazione.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
PostgreSQL
Per le convalide della migrazione di PostgreSQL, configura il file delle connessioni al database con le seguenti informazioni:
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Sostituisci quanto segue:
SOURCE_HOST: il nome host o l'indirizzo IP del tuo server PostgreSQL.SOURCE_DATABASE: il nome del database PostgreSQL richiesto.SOURCE_SCHEMA: il nome dello schema predefinito (il valore predefinito èpublicse omesso).SOURCE_USER: il nome utente del database.SECRET_PROJECT_IDeSECRET_ID: l'ID progetto e l'ID secret in Secret Manager contenenti la password del database. In alternativa, omettipasswordSecrete imposta la variabile di ambienteBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: l'ID progetto Google Cloud che contiene le tabelle BigQuery migrate e in cui verrà creato il set di dativalidation_results.TARGET_DATASET: il nome del set di dati BigQuery di destinazione.
Crea un file di impostazioni
Crea un file di impostazioni di gestione temporanea e dei risultati denominato settings.yaml nella directory di configurazione della convalida per configurare il percorso di gestione temporanea di Cloud Storage, il set di dati dei risultati di BigQuery, la scadenza della tabella per esecuzione e i valori predefiniti globali facoltativi.
Configura il file delle impostazioni di gestione temporanea e dei risultati con quanto segue:
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
Sostituisci quanto segue:
BUCKET_NAME: il nome del bucket di gestione temporanea di Cloud Storage.PATH_PREFIX: il prefisso dell'URI Cloud Storage nel bucket utilizzato per la gestione temporanea dei metadati dello schema estratti, delle metriche aggregate, delle righe campionate e dei report di riepilogo.FORMAT: il formato file per gli esempi di campionamento dei dati. I valori supportati sonoparquet(predefinito) ecsv.RESULTS_PROJECT_ID: l'ID progetto Google Cloud in cui vengono scritti i risultati della convalida e le tabelle della cronologia di esecuzione. Se omesso, il valore predefinito ètarget.projectIddaconnections.yaml.RESULTS_DATASET: il nome del set di dati BigQuery in cui vengono scritte le tabelle dei risultati della convalida e della cronologia delle esecuzioni (run_history,run_metricsecolumn_history). Se omesso, il valore predefinito èvalidation_results. Se il set di dati non esiste, il servizio di convalida lo crea automaticamente.RESULTS_LOCATION: la località BigQuery per il set di dati dei risultati. Se omesso, un set di dati dei risultati creato automaticamente viene impostato per impostazione predefinita sulla regione del bucket di gestione temporanea di Cloud Storage e del set di dati BigQuery di destinazione.RESULT_TTL_HOURS: durata (TTL) in ore per le tabelle di confronto e di mancata corrispondenza per esecuzione create nel set di dati dei risultati. Il valore predefinito è168.0ore (7 giorni). Le tabelle di osservabilità di lunga durata (run_history,run_metricsecolumn_history) non sono interessate daresultTtlHours.RESULTS_CONFIG: configura il set di dati BigQuery di destinazione per i risultati del confronto e la cronologia di controllo. I valori supportati sonoprojectId,datasetelocation. Se omesso, il servizio di convalida scrive inTARGET_PROJECT_ID.validation_results` e crea automaticamente il set di dati nella stessa regione del set di dati di destinazione e del bucket di gestione temporanea di Cloud Storage, se non esiste già.
Puoi anche specificare i valori predefiniti della tabella globale specificando tolerances,
aggregate o labels al livello più alto di settings.yaml o
validation-config.yaml. Queste impostazioni predefinite si applicano a tutte le tabelle, a meno che non venga eseguito l'override in una singola configurazione della tabella.
Genera configurazioni di convalida delle tabelle
Dopo aver configurato i file di connessione e di impostazioni, definisci le configurazioni di convalida della tabella. Il comando generate-config scrive un file YAML per tabella in validation_config/databases/DATABASE/SCHEMA/TABLE.yaml con una chiave table: di primo livello oppure puoi creare un file validation_config/tables.yaml manuale.
Seleziona una delle seguenti opzioni per informazioni sulla generazione delle configurazioni di convalida delle tabelle per il database di origine:
Teradata
Per le convalide della migrazione di Teradata, segui questi passaggi per generare un archivio di metadati dello strumento dwh-migration-dumper degli schemi di origine:
- Installa lo strumento
dwh-migration-dumper. - Esegui
dwh-migration-dumperper il tuo database di origine per produrre un archivio di metadati dello strumentodwh-migration-dumper.
Con l'archivio dei metadati, esegui generate-config per generare i file di configurazione per tabella. Puoi utilizzare il flag --update per conservare i file connections.yaml e settings.yaml esistenti che hai creato in validation_config/. Ad esempio:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se hai anche un file di mappatura dello schema tables.yaml del traduttore SQL batch, includi il flag --tables-yaml, da solo o insieme a --metadata per integrare le mappature delle tabelle tradotte con i metadati della partizione di origine e le esclusioni dei tipi di dati dall'archivio dei metadati. Ad esempio:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Il comando generate-config supporta i seguenti flag:
--metadata PATH_TO_METADATA_ZIP: il percorso di un archivio di metadati dello strumentodwh-migration-dumper(file ZIP) o di una directory contenente archivi di metadati.--tables-yaml PATH_TO_TABLES_YAML: il percorso di uno o più file o directory di traduzionetables.yaml(separati da virgole).--target-dataset TARGET_DATASET: il nome del set di dati BigQuery di destinazione da anteporre alle vocitargetTable.namegenerate.-o, --output-dir DIRECTORY: la directory di output per i file di configurazione modulari. Il valore predefinito èvalidation_config.--schemas SCHEMA_LIST: elenco separato da virgole di schemi o database di origine da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--tables TABLE_LIST: elenco separato da virgole dei nomi delle tabelle (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--filter-file PATH: percorso di un file delimitato da nuove righe contenente i nomi delle tabelle da includere (le righe che iniziano con#vengono ignorate).--update: unisce le tabelle rilevate in una directoryvalidation_config/esistente, conservando le sostituzioni esistenticonnections.yaml,settings.yamle personalizzate per tabella.--force: consente di scrivere i file delle tabelle appena rilevate in una directory di output non vuota, mantenendo i file di configurazione delle tabelle esistenti.--clean: elimina tutti i file esistenti nella directory di output prima di scrivere i file appena rilevati.
Snowflake
Per le convalide della migrazione di Snowflake, segui questi passaggi per generare un archivio di metadati dello strumento dwh-migration-dumper degli schemi di origine:
- Installa lo strumento
dwh-migration-dumper. - Esegui
dwh-migration-dumperper il tuo database di origine per produrre un archivio di metadati dello strumentodwh-migration-dumper.
Con l'archivio dei metadati, esegui generate-config per generare i file di configurazione per tabella. Puoi utilizzare il flag --update per conservare i file connections.yaml e settings.yaml esistenti che hai creato in validation_config/. Ad esempio:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se hai anche un file di mappatura dello schema tables.yaml del traduttore SQL batch, includi il flag --tables-yaml, da solo o insieme a --metadata per integrare le mappature delle tabelle tradotte con le chiavi di clustering di origine (per il partizionamento delle tabelle senza una chiave primaria), i metadati della partizione fisica e le esclusioni dei tipi di dati dall'archivio dei metadati. Ad esempio:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Il comando generate-config supporta i seguenti flag:
--metadata PATH_TO_METADATA_ZIP: il percorso di un archivio di metadati dello strumentodwh-migration-dumper(file ZIP) o di una directory contenente archivi di metadati.--tables-yaml PATH_TO_TABLES_YAML: il percorso di uno o più file o directory di traduzionetables.yaml(separati da virgole).--target-dataset TARGET_DATASET: il nome del set di dati BigQuery di destinazione da anteporre alle vocitargetTable.namegenerate.-o, --output-dir DIRECTORY: la directory di output per i file di configurazione modulari. Il valore predefinito èvalidation_config.--schemas SCHEMA_LIST: elenco separato da virgole di schemi o database di origine da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--tables TABLE_LIST: elenco separato da virgole dei nomi delle tabelle (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--filter-file PATH: percorso di un file delimitato da nuove righe contenente i nomi delle tabelle da includere (le righe che iniziano con#vengono ignorate).--update: unisce le tabelle rilevate in una directoryvalidation_config/esistente, conservando le sostituzioni esistenticonnections.yaml,settings.yamle personalizzate per tabella.--force: consente di scrivere i file delle tabelle appena rilevate in una directory di output non vuota, mantenendo i file di configurazione delle tabelle esistenti.--clean: elimina tutti i file esistenti nella directory di output prima di scrivere i file appena rilevati.
Amazon Redshift
Per le convalide della migrazione di Amazon Redshift, segui questi passaggi per generare un file ZIP di metadati degli schemi di origine:
- Installa lo strumento
dwh-migration-dumper. - Esegui
dwh-migration-dumperper il tuo database di origine per produrre un archivio di metadati dello strumentodwh-migration-dumper.
Con l'archivio dei metadati, esegui generate-config per generare i file di configurazione per tabella. Puoi utilizzare il flag --update per conservare i file connections.yaml e settings.yaml esistenti che hai creato in validation_config/. Ad esempio:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se hai anche un file di mappatura dello schema tables.yaml del traduttore SQL batch, includi il flag --tables-yaml, da solo o insieme a --metadata per integrare le mappature delle tabelle tradotte con i metadati della partizione di origine e le esclusioni dei tipi di dati dall'archivio dei metadati. Ad esempio:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Il comando generate-config supporta i seguenti flag:
--metadata PATH_TO_METADATA_ZIP: il percorso di un archivio di metadati dello strumentodwh-migration-dumper(file ZIP) o di una directory contenente archivi di metadati.--tables-yaml PATH_TO_TABLES_YAML: il percorso di uno o più file o directory di traduzionetables.yaml(separati da virgole).--target-dataset TARGET_DATASET: il nome del set di dati BigQuery di destinazione da anteporre alle vocitargetTable.namegenerate.-o, --output-dir DIRECTORY: la directory di output per i file di configurazione modulari. Il valore predefinito èvalidation_config.--schemas SCHEMA_LIST: elenco separato da virgole di schemi o database di origine da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--tables TABLE_LIST: elenco separato da virgole dei nomi delle tabelle (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--filter-file PATH: percorso di un file delimitato da nuove righe contenente i nomi delle tabelle da includere (le righe che iniziano con#vengono ignorate).--update: unisce le tabelle rilevate in una directoryvalidation_config/esistente, conservando le sostituzioni esistenticonnections.yaml,settings.yamle personalizzate per tabella.--force: consente di scrivere i file delle tabelle appena rilevate in una directory di output non vuota, mantenendo i file di configurazione delle tabelle esistenti.--clean: elimina tutti i file esistenti nella directory di output prima di scrivere i file appena rilevati.
Databricks
La generazione automatica della configurazione non è supportata per Databricks. Crea manualmente un file tables.yaml nella directory validation_config/ con le seguenti configurazioni:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
Per le convalide della migrazione di Apache Hive, segui questi passaggi per generare un file ZIP di metadati degli schemi di origine:
- Installa lo strumento
dwh-migration-dumper. - Esegui
dwh-migration-dumperper il tuo database di origine per produrre un archivio di metadati dello strumentodwh-migration-dumper.
Con l'archivio dei metadati, esegui generate-config per generare i file di configurazione per tabella. Puoi utilizzare il flag --update per conservare i file connections.yaml e settings.yaml esistenti che hai creato in validation_config/. Ad esempio:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se hai anche un file di mappatura dello schema tables.yaml del traduttore SQL batch, includi il flag --tables-yaml, da solo o insieme a --metadata per integrare le mappature delle tabelle tradotte con i metadati della partizione di origine e le esclusioni dei tipi di dati dall'archivio dei metadati. Ad esempio:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Il comando generate-config supporta i seguenti flag:
--metadata PATH_TO_METADATA_ZIP: il percorso di un archivio di metadati dello strumentodwh-migration-dumper(file ZIP) o di una directory contenente archivi di metadati.--tables-yaml PATH_TO_TABLES_YAML: il percorso di uno o più file o directory di traduzionetables.yaml(separati da virgole).--target-dataset TARGET_DATASET: il nome del set di dati BigQuery di destinazione da anteporre alle vocitargetTable.namegenerate.-o, --output-dir DIRECTORY: la directory di output per i file di configurazione modulari. Il valore predefinito èvalidation_config.--schemas SCHEMA_LIST: elenco separato da virgole di schemi o database di origine da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--tables TABLE_LIST: elenco separato da virgole dei nomi delle tabelle (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--filter-file PATH: percorso di un file delimitato da nuove righe contenente i nomi delle tabelle da includere (le righe che iniziano con#vengono ignorate).--update: unisce le tabelle rilevate in una directoryvalidation_config/esistente, conservando le sostituzioni esistenticonnections.yaml,settings.yamle personalizzate per tabella.--force: consente di scrivere i file delle tabelle appena rilevate in una directory di output non vuota, mantenendo i file di configurazione delle tabelle esistenti.--clean: elimina tutti i file esistenti nella directory di output prima di scrivere i file appena rilevati.
SQL Server
Per le convalide della migrazione di SQL Server, segui questi passaggi per generare un archivio di metadati dello strumento dwh-migration-dumper degli schemi di origine:
- Installa lo strumento
dwh-migration-dumper. - Esegui
dwh-migration-dumperper il tuo database di origine per produrre un archivio di metadati dello strumentodwh-migration-dumper.
Con l'archivio dei metadati, esegui generate-config per generare i file di configurazione per tabella. Puoi utilizzare il flag --update per conservare i file connections.yaml e settings.yaml esistenti che hai creato in validation_config/. Ad esempio:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se hai anche un file di mappatura dello schema tables.yaml del traduttore SQL batch, includi il flag --tables-yaml, da solo o insieme a --metadata per integrare le mappature delle tabelle tradotte con i metadati della partizione di origine e le esclusioni dei tipi di dati dall'archivio dei metadati. Ad esempio:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Il comando generate-config supporta i seguenti flag:
--metadata PATH_TO_METADATA_ZIP: il percorso di un archivio di metadati dello strumentodwh-migration-dumper(file ZIP) o di una directory contenente archivi di metadati.--tables-yaml PATH_TO_TABLES_YAML: il percorso di uno o più file o directory di traduzionetables.yaml(separati da virgole).--target-dataset TARGET_DATASET: il nome del set di dati BigQuery di destinazione da anteporre alle vocitargetTable.namegenerate.-o, --output-dir DIRECTORY: la directory di output per i file di configurazione modulari. Il valore predefinito èvalidation_config.--schemas SCHEMA_LIST: elenco separato da virgole di schemi o database di origine da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--tables TABLE_LIST: elenco separato da virgole dei nomi delle tabelle (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--filter-file PATH: percorso di un file delimitato da nuove righe contenente i nomi delle tabelle da includere (le righe che iniziano con#vengono ignorate).--update: unisce le tabelle rilevate in una directoryvalidation_config/esistente, conservando le sostituzioni esistenticonnections.yaml,settings.yamle personalizzate per tabella.--force: consente di scrivere i file delle tabelle appena rilevate in una directory di output non vuota, mantenendo i file di configurazione delle tabelle esistenti.--clean: elimina tutti i file esistenti nella directory di output prima di scrivere i file appena rilevati.
MariaDB
La generazione automatica della configurazione non è supportata per MariaDB. Crea manualmente un file tables.yaml nella directory validation_config/ con le seguenti configurazioni:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
La generazione automatica della configurazione non è supportata per MySQL. Crea manualmente un file tables.yaml nella directory validation_config/ con le seguenti configurazioni:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
Per le convalide della migrazione di Oracle, segui questi passaggi per generare un archivio di metadati dello strumento dwh-migration-dumper degli schemi di origine:
- Installa lo strumento
dwh-migration-dumper. - Esegui
dwh-migration-dumperper il tuo database di origine per produrre un archivio di metadati dello strumentodwh-migration-dumper.
Con l'archivio dei metadati, esegui generate-config per generare i file di configurazione per tabella. Puoi utilizzare il flag --update per conservare i file connections.yaml e settings.yaml esistenti che hai creato in validation_config/. Ad esempio:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se hai anche un file di mappatura dello schema tables.yaml del traduttore SQL batch, includi il flag --tables-yaml, da solo o insieme a --metadata per integrare le mappature delle tabelle tradotte con i metadati della partizione di origine e le esclusioni dei tipi di dati dall'archivio dei metadati. Ad esempio:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Il comando generate-config supporta i seguenti flag:
--metadata PATH_TO_METADATA_ZIP: il percorso di un archivio di metadati dello strumentodwh-migration-dumper(file ZIP) o di una directory contenente archivi di metadati.--tables-yaml PATH_TO_TABLES_YAML: il percorso di uno o più file o directory di traduzionetables.yaml(separati da virgole).--target-dataset TARGET_DATASET: il nome del set di dati BigQuery di destinazione da anteporre alle vocitargetTable.namegenerate.-o, --output-dir DIRECTORY: la directory di output per i file di configurazione modulari. Il valore predefinito èvalidation_config.--schemas SCHEMA_LIST: elenco separato da virgole di schemi o database di origine da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--tables TABLE_LIST: elenco separato da virgole dei nomi delle tabelle (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--filter-file PATH: percorso di un file delimitato da nuove righe contenente i nomi delle tabelle da includere (le righe che iniziano con#vengono ignorate).--update: unisce le tabelle rilevate in una directoryvalidation_config/esistente, conservando le sostituzioni esistenticonnections.yaml,settings.yamle personalizzate per tabella.--force: consente di scrivere i file delle tabelle appena rilevate in una directory di output non vuota, mantenendo i file di configurazione delle tabelle esistenti.--clean: elimina tutti i file esistenti nella directory di output prima di scrivere i file appena rilevati.
PostgreSQL
Per le convalide della migrazione di PostgreSQL, segui questi passaggi per generare un archivio di metadati dello strumento dwh-migration-dumper degli schemi di origine:
- Installa lo strumento
dwh-migration-dumper. - Esegui
dwh-migration-dumperper il tuo database di origine per produrre un archivio di metadati dello strumentodwh-migration-dumper.
Con l'archivio dei metadati, esegui generate-config per generare i file di configurazione per tabella. Puoi utilizzare il flag --update per conservare i file connections.yaml e settings.yaml esistenti che hai creato in validation_config/. Ad esempio:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Se hai anche un file di mappatura dello schema tables.yaml del traduttore SQL batch, includi il flag --tables-yaml, da solo o insieme a --metadata per integrare le mappature delle tabelle tradotte con i metadati della partizione di origine e le esclusioni dei tipi di dati dall'archivio dei metadati. Ad esempio:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Il comando generate-config supporta i seguenti flag:
--metadata PATH_TO_METADATA_ZIP: il percorso di un archivio di metadati dello strumentodwh-migration-dumper(file ZIP) o di una directory contenente archivi di metadati.--tables-yaml PATH_TO_TABLES_YAML: il percorso di uno o più file o directory di traduzionetables.yaml(separati da virgole).--target-dataset TARGET_DATASET: il nome del set di dati BigQuery di destinazione da anteporre alle vocitargetTable.namegenerate.-o, --output-dir DIRECTORY: la directory di output per i file di configurazione modulari. Il valore predefinito èvalidation_config.--schemas SCHEMA_LIST: elenco separato da virgole di schemi o database di origine da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--tables TABLE_LIST: elenco separato da virgole dei nomi delle tabelle (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) da includere (sensibile alle maiuscole; supporta i caratteri jolly*).--filter-file PATH: percorso di un file delimitato da nuove righe contenente i nomi delle tabelle da includere (le righe che iniziano con#vengono ignorate).--update: unisce le tabelle rilevate in una directoryvalidation_config/esistente, conservando le sostituzioni esistenticonnections.yaml,settings.yamle personalizzate per tabella.--force: consente di scrivere i file delle tabelle appena rilevate in una directory di output non vuota, mantenendo i file di configurazione delle tabelle esistenti.--clean: elimina tutti i file esistenti nella directory di output prima di scrivere i file appena rilevati.
Personalizza le impostazioni della tabella
Ogni file di tabella generato da generate-config contiene una sezione table: che puoi personalizzare prima di eseguire la convalida. La tabella seguente elenca tutte le chiavi facoltative supportate in ogni voce della tabella.
| Chiave YAML facoltativa | Valore predefinito | Descrizione |
|---|---|---|
runSchema, runAggregate, runData |
true |
Valori booleani per tabella per attivare o disattivare singoli pilastri di convalida quando non vengono passati flag della riga di comando dei pilastri. |
maxColumnsPerTile |
100 |
Numero massimo di colonne raggruppate in un singolo riquadro di confronto nelle tabelle ampie. |
strategy |
SMART |
Strategia di esecuzione della convalida dei dati: SMART (BRUTE_FORCE con meno di 100.000 righe, altrimenti SAMPLE), SAMPLE o BRUTE_FORCE. |
sampleSize |
70000 |
Numero di righe da estrarre (per sezione quando partizionate) quando la strategia risolta è SAMPLE. Il valore predefinito di 70.000 righe fornisce una probabilità superiore al 99,9% di rilevare almeno una riga non corrispondente quando il tasso di ordini con problemi è pari o superiore allo 0,01% (1 riga su 10.000). |
whereClause |
Nessuno | Predicato SQL (senza la parola chiave WHERE) applicato alle query di estrazione dell'origine e di confronto della destinazione. Può anche essere impostato separatamente su sourceTable.whereClause e targetTable.whereClause. |
skipRandomization |
false |
Se true, legge fino a sampleSize righe nell'ordine naturale della tabella anziché ordinare in base a una funzione casuale, riducendo il costo delle query su tabelle di grandi dimensioni. |
maxConcurrency |
1 |
Numero massimo di thread di estrazione di sezioni parallele per una tabella partizionata. |
maxSlices |
0 (illimitato) |
Numero massimo di sezioni di partizione consentite per una tabella partizionata. Se il numero di sezioni calcolato supera maxSlices (quando è maggiore di 0), la pianificazione della partizione non riesce e viene generato un errore. |
disablePartitioning |
false |
Se impostato su true, disattiva la suddivisione partizionata per la tabella anche se è configurato un blocco partitioning o se il numero di righe supera 1000000. |
labels |
Mappa vuota | Etichette di stringhe coppia chiave-valore associate alle metriche di esecuzione della convalida in validation_results. |
Le sezioni seguenti descrivono i modi in cui puoi utilizzare queste chiavi YAML per personalizzare le esecuzioni di convalida.
Seleziona una strategia di convalida
Utilizza la chiave strategy in una voce della tabella per selezionare una strategia di convalida che controlli il modo in cui il pillar --data estrae e confronta le righe. Sono supportati i seguenti valori:
SMART(predefinito): conteggia prima le righe nella tabella di origine. Se la tabella ha meno di 100.000 righe, esegueBRUTE_FORCE; se la tabella ha 100.000 o più righe, esegueSAMPLE.SAMPLE: estrae un campione randomizzato di righe in base al valore disampleSize(il valore predefinito è70,000) e le unisce alla tabella di destinazione utilizzandocomparisonKeys. Un campione di 70.000 righe offre una confidenza superiore al 99,9% di rilevare almeno una riga difettosa quando almeno lo 0,01% delle righe (1 su 10.000) contiene una mancata corrispondenza.BRUTE_FORCE: estrae e confronta ogni riga in un'unica fase di query non partizionata. Le impostazioni di partizionamento vengono ignorate quando viene utilizzatoBRUTE_FORCE.
Configura le chiavi di confronto
Una chiave di confronto è la colonna o le colonne utilizzate per identificare e unire in modo univoco le righe tra i sistemi di origine e di destinazione. La chiave di confronto descrive gli attributi che forniscono un'univocità sufficiente per un join stabile.
Quando esegui il confronto dei dati a livello di riga, puoi configurare le chiavi di confronto nei seguenti modi:
- Rilevamento automatico: ometti
comparisonKeysdalla sezionesourceTableper fare in modo che lo strumento di convalida rilevi automaticamente le chiavi primarie nel database di origine durante il pre-flight (con fallback ai vincoli univociNOT NULLsu Oracle e Snowflake, agli indici univoci su Teradata o a una singola colonnaDISTKEYoSORTKEYsu Amazon Redshift). Chiavi composte o personalizzate manuali: specifica manualmente le chiavi di confronto composte o personalizzate elencando i nomi delle colonne delle chiavi di origine in
comparisonKeysinsourceTable. Le differenze tra maiuscole e minuscole nei nomi delle colonne chiave di origine e di destinazione vengono abbinate automaticamente. Se una colonna chiave di confronto è stata rinominata in BigQuery, mappala incolumnSettings.columns.SOURCE_COLUMN.targetColumn. L'esempio seguente configura una chiave di confronto composita:table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
Confronto degli hash per le tabelle senza una chiave univoca: se una tabella non ha una chiave primaria, in
sourceTable, impostauseAllColumnsAsKey: true. Questa opzione viene selezionata automaticamente anche quando l'ispezione dei metadati pre-flight non trova chiavi primarie.
Configura l'estrazione partizionata per le tabelle di grandi dimensioni
Quando la strategia di una tabella viene risolta in SAMPLE ed è presente un blocco partitioning nella configurazione della tabella (che generate-config scrive per impostazione predefinita) o il numero di righe della tabella supera 1,000,000, lo strumento di convalida suddivide la tabella in sezioni in modo che le query di campionamento eseguano la scansione di intervalli limitati anziché ordinare l'intera tabella contemporaneamente. Se partizionato, vengono estratte fino a sampleSize righe per sezione. Per limitare la convalida a un sottoinsieme di righe, utilizza invece whereClause.
Per configurare l'estrazione partizionata, utilizza il blocco partitioning nella sezione table:. Ad esempio:
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
Il blocco partitioning supporta i seguenti campi:
type:INTEGER_RANGE: suddivide la tabella in intervalli di coppie chiave-valore numerici (COLUMN BETWEEN START AND END). Questo è il valore predefinito.DATE_RANGE: suddivide la tabella in intervalli di date o timestamp. Supportato per PostgreSQL e Snowflake.PHYSICAL: utilizza le partizioni del database per le tabelle Oracle e Amazon Redshift quando sono presenti i metadati della partizione fisica.
column: specifica una colonna numerica, di data o di timestamp indicizzata nella tabella di origine utilizzata per calcolare i limiti delle sezioni. Le righe con valoriNULLnella colonna di partizionamento sono escluse dalle sezioni basate su intervalli (INTEGER_RANGEeDATE_RANGE).partitionSize: per il tipoINTEGER_RANGE, questo valore specifica la larghezza dell'intervallo numerico coppia chiave-valore per sezione, dove il valore predefinito è1000000. Per il tipoDATE_RANGE, questo valore specifica il numero di giorni per sezione, dove il valore predefinito è30.maxSlices: specifica il numero totale massimo di sezioni consentite per la tabella (impostato intable:). Se una tabella richiede più sezioni dimaxSlices, la pianificazione del partizionamento non va a buon fine e viene visualizzato un errore che richiede un valorepartitionSizeomaxSlicesmaggiore.maxConcurrency: specifica il numero di thread di lavoro paralleli utilizzati per estrarre le sezioni, dove il valore predefinito è1. Imposta su un valore inferiore atable:.
Personalizza i controlli aggregati
L'analisi aggregata è abilitata per impostazione predefinita e integra il campionamento a livello di riga con controlli aggregati a livello macro. Questa configurazione è utile per convalidare tabelle di grandi dimensioni in cui il campionamento casuale potrebbe non rilevare una lieve distorsione dei dati.
Senza configurazioni di colonne personalizzate, lo strumento di convalida applica automaticamente i controlli di aggregazione standard in base ai tipi di colonne:
- Numerico esatto (
INTEGER,NUMERIC,BIGNUMERIC):COUNT,SUM,AVG,MIN,MAX - Rappresentazione in virgola mobile (
FLOAT,DOUBLE,REAL):COUNT,MIN,MAX - Booleano (
BOOLEAN):COUNT,COUNT_TRUE,COUNT_FALSE,COUNT_NULL - Stringa (
STRING,VARCHAR,CHAR,TEXT):COUNT,SUM_LENGTH - Data, ora e timestamp:
COUNT,MIN,MAX
Puoi personalizzare o disattivare i controlli aggregati utilizzando la sezione columnSettings. L'esempio seguente mostra come configurare le tolleranze aggregate e ignorare i controlli di colonne specifiche:
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
Si applicano le seguenti regole di configurazione degli aggregati:
- Le chiavi di colonna in
columnSettings.columnsdevono corrispondere al nome della colonna di origine, con distinzione tra maiuscole e minuscole. - L'aggregato
toleranceè una soglia di differenza assoluta (ABS(target - source) <= tolerance). Se non è impostato alcun aggregatotolerance(a livello di colonna ocolumnSettings.aggregate.tolerance) e la colonna ha un'impostazionetolerances.numerica livello di riga,AVG,MINeMAXereditanotolerances.numericdirettamente, mentreSUMmoltiplica la tolleranza a livello di riga ereditata perCOUNT. - Puoi eseguire l'override di
functionssolo per colonna incolumnSettings.columns.SOURCE_COLUMN.aggregate.functions.
Escludi colonne, mappa i nomi delle colonne e applica espressioni di confronto SQL
Puoi utilizzare columnSettings per escludere colonne, impostare tolleranze numeriche o temporali, mappare le colonne di destinazione rinominate o applicare trasformazioni SQL prima del confronto. Ogni chiave in columnSettings.columns è il nome della colonna di origine. Utilizza la proprietà targetColumn all'interno della voce quando la colonna ha un nome diverso in BigQuery. Ad esempio:
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings supporta i seguenti campi:
exclude: specifica un elenco di nomi di colonne o pattern glob (*) senza distinzione tra maiuscole e minuscole da escludere da tutti i pilastri di convalida.tolerances:numeric: tolleranza per le colonne numeriche (ABS(target - source) <= toleranceper il confronto basato su chiavi o arrotondato aceil(-log10(tolerance))posizioni decimali quandouseAllColumnsAsKey: true).timestamp: tolleranza in secondi per le colonne timestamp. Ad esempio,0.001per 1 millisecondo.date: tolleranza in giorni per le colonne delle date.
columns: mappa delle impostazioni per colonna con chiave in base al nome della colonna di origine (SOURCE_COLUMN):targetColumn: mappa la colonna di origine a una colonna di destinazione con un nome diverso in BigQuery.transform: trasformazione integrata applicata prima del confronto:TRIM,UPPER,LOWER: supportati in tutti i dialetti.EMPTY_TO_NULL,NULL_TO_EMPTY,CAST_TO_STRING: supportati nelle query di origine per le origini PostgreSQL, Amazon Redshift, Oracle e Teradata.
transformExpression: espressione SQL personalizzata che fa riferimento al nome letterale della colonna di origine. Ad esempio,"ROUND(SOURCE_COLUMN, 4)". Poiché l'espressione viene valutata sia sulla query di origine sia sulla query di confronto di BigQuery, utilizza funzioni SQL valide sia nel dialetto di origine sia in GoogleSQL.
Normalizzazione dei valori
Durante il confronto a livello di riga (--data), il servizio di convalida normalizza i valori in modo che le differenze di rappresentazione tra i motori di origine e BigQuery non causino mancate corrispondenze. Il servizio di convalida normalizza i valori nei seguenti modi:
- Tipi numerici esatti (
INTEGER,NUMERIC,DECIMAL,BIGNUMERIC): nel confronto basato su chiavi, i valori vengono confrontati su scala completa (fino a 9 cifre decimali perNUMERICo fino a 38 cifre decimali perBIGNUMERIC) e, quandotolerances.numericè impostato, i valori corrispondono quandoABS(target - source) <= tolerance. Nel confronto degli hash di righe intere (useAllColumnsAsKey: true), i valori vengono arrotondati a 9 cifre decimali per impostazione predefinita o aceil(-log10(tolerance))cifre decimali quando è impostata una tolleranza numerica. - Tipi con rappresentazione in virgola mobile (
FLOAT,DOUBLE,REAL): normalizzati per impostazione predefinita a 6 cifre decimali (1e-6). - Timestamp: normalizzati in base al fuso orario UTC con precisione al microsecondo.
- Tipi di caratteri a larghezza fissa (
CHAR,NCHAR,CHARACTER): gli spazi iniziali e finali vengono tagliati automaticamente per allinearsi alla semanticaSTRINGdi BigQuery.
Esegui il servizio di convalida
Una volta configurata la convalida, esegui il comando validate per avviare lo strumento di convalida della migrazione. Puoi passare un percorso locale o un URI Cloud Storage gs:// che punta alla directory validation_config/.
L'esempio seguente esegue il servizio di convalida sui file di configurazione della convalida archiviati localmente:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
Sostituisci PATH_TO_VALIDATION_CONFIG con il percorso della directory validation_config/ modulare.
Se la configurazione di convalida è archiviata in Cloud Storage, passa l'URI gs:// della directory di configurazione:
gcloud bq migration validate gs://BUCKET_NAME/validation_config
Sostituisci BUCKET_NAME con il nome del tuo bucket Cloud Storage.
Per impostazione predefinita, il servizio di convalida viene eseguito su tutti e tre i pilastri di convalida:
--schema: convalida solo lo schema--aggregate: convalida solo l'aggregato--data: convalida solo i dati a livello di riga
Puoi eseguire il servizio di convalida su un pilastro di convalida specifico utilizzando i flag del pilastro. L'esempio seguente esegue la convalida dello schema e dell'aggregazione su due tabelle specifiche con un filtro WHERE personalizzato:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
Il comando validate supporta i seguenti flag facoltativi:
--tableo--tables: elenco separato da virgole dei nomi delle tabelle da convalidare. La corrispondenza di--tablesè sensibile alle maiuscole e deve corrispondere alle maiuscole utilizzate insourceTable.nameotargetTable.name.--where SQL_PREDICATE: esegue l'override diwhereClauseper le tabelle di origine e di destinazione durante questa esecuzione.--source-where SQL_PREDICATE: esegue l'override diwhereClausesolo per la tabella di origine.--target-where SQL_PREDICATE: esegue l'override diwhereClausesolo per la tabella di destinazione.--gcs-path: overridegoogleCloudStorage.gcsPath. Ad esempio:--gcs-path gs://my-bucket/validation.--max-concurrency,--concurrencyo--threads: esegue l'override dimaxConcurrencyper l'estrazione di sezioni parallele.--no-partitiono--disable-partitioning: disattiva l'estrazione delle sezioni partizionate per tutte le tabelle nell'esecuzione.--labels KEY=VALUE[,KEY=VALUE...]: associa etichette coppia chiave-valore personalizzate ai risultati dell'esecuzione.--output-dir: directory locale per i file di stato e i metadati di esecuzione temporanei. Il valore predefinito è/tmp/validation_outputs.-v,--verbose,-do--debug: attiva il logging dettagliato o di debug.
Handoff del workflow asincrono
validate esegue l'estrazione dell'origine in modo sincrono e poi attiva un workflow asincrono di BigQuery Migration Service per ogni tabella.
Se il set di dati di destinazione si trova in una località diversa da
us, ad esempioeu, imposta la variabile di ambienteBQMS_VALIDATION_LOCATIONprima di eseguirevalidate:export BQMS_VALIDATION_LOCATION=LOCATION
Per ogni tabella, verifica che l'output includa una riga
Workflow:contenente il nome della risorsa del workflow creata. Ad esempio:Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
Il codice di uscita
0indica che l'estrazione e il caricamento dell'origine sono riusciti, non che il confronto della destinazione è stato completato o che i dati corrispondono. Se la creazione del workflow non riesce, ad esempio a causa di un'autorizzazione mancante, l'interfaccia a riga di comando registra un avviso che indica che l'attivazione del workflow di convalida non è riuscita, stampa un comando di fallback manualegcloude omette la rigaWorkflow:anche se il processo termina con0.
Visualizza i risultati della convalida
Al termine dell'esecuzione della convalida, visualizza i risultati della convalida nella consoleGoogle Cloud eseguendo una query sul set di dati dei risultati validation_results, eseguendo una query sul set di dati BigQuery configurato in results insettings.yamlo leggendo i report di riepilogo in Cloud Storage. Seleziona una delle seguenti opzioni:
Console Google Cloud
Vai alla pagina Servizi di migrazione nella console Google Cloud .
In Convalida migrazione, fai clic su Visualizza recenti.
Fai clic su Seleziona un progetto e seleziona il progetto in cui è archiviato il set di dati
validation_results.
GoogleSQL
Esegui una query su TARGET_PROJECT_ID.validation_results.run_history per controllare lo stato delle esecuzioni di convalida recenti:
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
Sostituisci TARGET_PROJECT_ID con l'ID del progetto in cui è archiviato il set di dati validation_results.
Per metriche dettagliate per colonna e tendenze storiche, esegui una query con quanto segue:
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: conteggi delle mancate corrispondenze per esecuzione e per colonna, confronti aggregati e stato di superamento o mancato superamento<var>TARGET_PROJECT_ID</var>.validation_results.column_history: cronologia dei controlli delle colonne longitudinali tra le esecuzioni<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: righe e colonne campionate in cui i valori di origine e di destinazione erano diversi
Report di Cloud Storage
Ogni esecuzione completata scrive i seguenti artefatti del report nella directory dell'esecuzione gcs_uri (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/):
validation_summary.txt: riepilogo esecutivo dei risultati del confronto di schema, aggregazione e rigacolumn_details.txt: suddivisione per colonna delle mancate corrispondenze e delle differenze aggregateresults.json: report JSON strutturato di tutti i risultati della convalidaqueries.sql: query SQL esatte eseguite durante l'esecuzione della convalida
Per stampare il report di riepilogo di un'esecuzione, esegui questo comando:
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
Interpreta i risultati della convalida
Ogni esecuzione della convalida in validation_results.run_history segnala uno dei seguenti valori di stato di esecuzione o status:
| Stato | Descrizione | Azione consigliata |
|---|---|---|
IN_PROGRESS |
Il workflow di convalida è ancora in esecuzione in BigQuery. | Attendi che finished_at venga compilato, quindi esegui di nuovo la query run_history. |
COMPLETED |
La pipeline di convalida è stata completata senza discrepanze nei dati a livello di riga o negli aggregati. I dettagli sulla compatibilità del tipo di schema vengono registrati separatamente in validation_summary.txt e column_history. |
Nessuna azione richiesta. La tabella ha superato la convalida. |
HEALED |
La pipeline di convalida è stata completata senza righe mancanti e tutte le differenze di valore rilevate erano microscopici jitter di rappresentazione in virgola mobile (< 1e-4 per i confronti a livello di cella e < 1e-6 per gli aggregati) riconciliati automaticamente dal validator. |
Considerata come un'esecuzione superata. Se vuoi eliminare il jitter a monte, puoi configurare un valore numerico esplicito per tolerance. |
COMPLETED_WITH_MISMATCHES |
La pipeline di convalida è stata eseguita completamente e ha rilevato righe mancanti, colonne di destinazione mancanti, differenze aggregate o differenze di dati a livello di cella tra le tabelle di origine e di destinazione. Questo indica un'esecuzione di convalida completata, non un arresto anomalo del sistema. | Controlla column_details.txt, run_metrics e run_RUN_ID_mismatches_details per esaminare le colonne e le righe non corrispondenti. Per saperne di più, consulta Tipi di mancata corrispondenza a livello di colonna. |
ERROR |
La pipeline di convalida non è stata completata a causa di un errore di sistema o di configurazione. Ad esempio, a causa di una tabella di destinazione mancante, di un errore di autorizzazione o di un codice SQL non valido in un whereClause o transformExpression personalizzato. |
Controlla la colonna error_message in run_history. Per saperne di più sulla risoluzione degli errori comuni, consulta la sezione Risoluzione dei problemi. |
Tipi di mancata corrispondenza a livello di colonna
Quando un'esecuzione termina con COMPLETED_WITH_MISMATCHES, le tabelle delle mancate corrispondenze per esecuzione classificano ogni confronto di colonne con uno dei seguenti risultati:
EXACT_MATCH: i valori delle celle confrontati per la colonna corrispondono entro le tolleranze configurateDATA_DRIFT: righe corrispondenti sucomparisonKeys, ma i valori delle celle differivano oltre la tolleranza configurataSCHEMA: la colonna esiste nella tabella di origine, ma non è presente nella tabella di destinazioneROW: le righe di origine mancavano nella tabella di destinazione o le righe di destinazione mancavano nella tabella di origine, quando sono state unite incomparisonKeys
Risolvi gli errori comuni
La tabella seguente elenca gli errori comuni della riga di comando e del workflow e come risolverli:
| Messaggio di errore o problema | Causa | Risoluzione |
|---|---|---|
Failed to load or parse YAML |
Un blocco di tabella, partitioning, columnSettings o googleCloudStorage contiene una chiave non riconosciuta o un valore enum non valido, ad esempio SAMPLING anziché SAMPLE. |
Verifica il rientro YAML e i nomi dei campi rispetto alle opzioni di impostazione della tabella. |
Connection name '...' is invalid. Must be alphanumeric. |
Un nome di profilo in connections: contiene trattini bassi o trattini. Ad esempio, my_source. |
Rinomina i profili di connessione con nomi alfanumerici, ad esempio source e target. |
googleCloudStorage cannot be null |
googleCloudStorage.gcsPath non è presente in validation_config/settings.yaml e --gcs-path non è stato trasmesso. |
Imposta googleCloudStorage.gcsPath: gs://BUCKET/PREFIX senza barra finale in validation_config/settings.yaml. |
Target discovery directory 'validation_config/' is non-empty |
generate-config è stato eseguito senza --update, --force o --clean quando validation_config/ conteneva già file YAML. |
Passa --update per unire le tabelle rilevate mantenendo i valori connections.yaml e settings.yaml esistenti. |
tables is required durante l'esecuzione di validate |
Nella directory di lavoro esiste un file validation-config.yaml legacy senza un elenco tables: che ha la precedenza su validation_config/ oppure non esistono file YAML della tabella in validation_config/. |
Elimina eventuali file validation-config.yaml non necessari nella directory di lavoro in modo che validate carichi validation_config/. |
| Errore preflight su una singola chiave di confronto a bassa cardinalità | Una tabella con più di 1000 righe filtrate è configurata con una singola chiave di confronto a bassa cardinalità, il che causerebbe un'esplosione di join many-to-many. | Specifica tutte le colonne che formano una chiave composita univoca in comparisonKeys o imposta useAllColumnsAsKey: true in sourceTable. |
Failed to initialize MemoryUtil o InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
La JVM è Java 17 o versioni successive ed è stata avviata senza --add-opens=java.base/java.nio=ALL-UNNAMED, di solito perché la riga di comando è stata avviata tramite un wrapper personalizzato o direttamente con java -jar. |
Imposta JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" nell'ambiente o utilizza il comando gcloud bq migration validate. |
WARNING: Failed to trigger validation workflow |
L'estrazione dell'origine è riuscita, ma la chiamata a CreateMigrationWorkflow non è riuscita a causa di autorizzazioni IAM mancanti, un'API non abilitata o una località non supportata. |
Verifica che bigquerymigration.googleapis.com sia abilitato, che il tuo account abbia roles/bigquerymigration.editor e che BQMS_VALIDATION_LOCATION corrisponda alla località del set di dati. |
Elimina gli artefatti di convalida
Per gestire i costi di archiviazione dopo aver esaminato i risultati della convalida, segui questi passaggi:
- In Cloud Storage, elimina le directory di esecuzione precedenti con il prefisso
gcsPathnel bucket di gestione temporanea o configura una regola di Gestione del ciclo di vita degli oggetti nel bucket. - In BigQuery, le tabelle di confronto per esecuzione nel set di dati dei risultati (
validation_resultsper impostazione predefinita) scadono automaticamente doporesultTtlHours(168.0ore o 7 giorni per impostazione predefinita). RegolaresultTtlHoursinsettings.yamlper abbreviare o allungare la conservazione oppure elimina manualmente le tabelle per esecuzione, lasciando intatte le tabelle e le viste della cronologia condivisa (run_history,run_metricsecolumn_history). - Quando lavori con file locali, rimuovi la directory di lavoro locale scritta dallo strumento di convalida in
--output-dir. La directory predefinita è/tmp/validation_outputs.
Prezzi
Il servizio di convalida utilizza le seguenti risorse nel tuo progetto:
- Calcolo e archiviazione di BigQuery: le query aggregate target, i join di confronto delle righe e l'archiviazione per le tabelle nel set di dati
validation_resultsvengono fatturati al tuo progetto Google Cloud obillingProjectIdse configurati nella connessionetarget, in base ai prezzi standard di BigQuery. - Archiviazione e rete di Cloud Storage: i file di esempio Parquet o CSV e i report sui risultati nel tuo bucket vengono fatturati in base ai prezzi di Cloud Storage standard.
- Carico del database di origine: le query di estrazione vengono eseguite direttamente sul database di origine. Per ridurre al minimo il carico su tabelle di origine di grandi dimensioni, utilizza
strategy: SAMPLE, filtra conwhereClauseo impostaskipRandomization: truequando l'overhead di ordinamento casuale non è auspicabile.
Passaggi successivi
- Scopri come generare metadati per la traduzione e la valutazione utilizzando lo strumento
dwh-migration-dumper. - Traduci le query SQL in batch per convertire gli script SQL e il DDL di origine in GoogleSQL.
- Pianifica una migrazione con la derivazione della migrazione per visualizzare le dipendenze dei dati nel data warehouse di origine.