


Memvalidasi migrasi data warehouse Anda
Layanan validasi BigQuery Migration Service memungkinkan Anda memverifikasi bahwa tabel yang dimigrasikan dari data warehouse sumber cocok dengan tabel target di BigQuery. Anda dapat membandingkan skema dan data tabel untuk mengidentifikasi perbedaan selama migrasi.
Klien layanan validasi terhubung ke database sumber Anda dan mengekstrak skema sumber dan data baris ke bucket Cloud Storage yang Anda kontrol. Setelah diekstrak, layanan validasi akan membandingkan skema dan data yang diekstrak di bucket Cloud Storage dengan tabel BigQuery yang dimigrasikan.
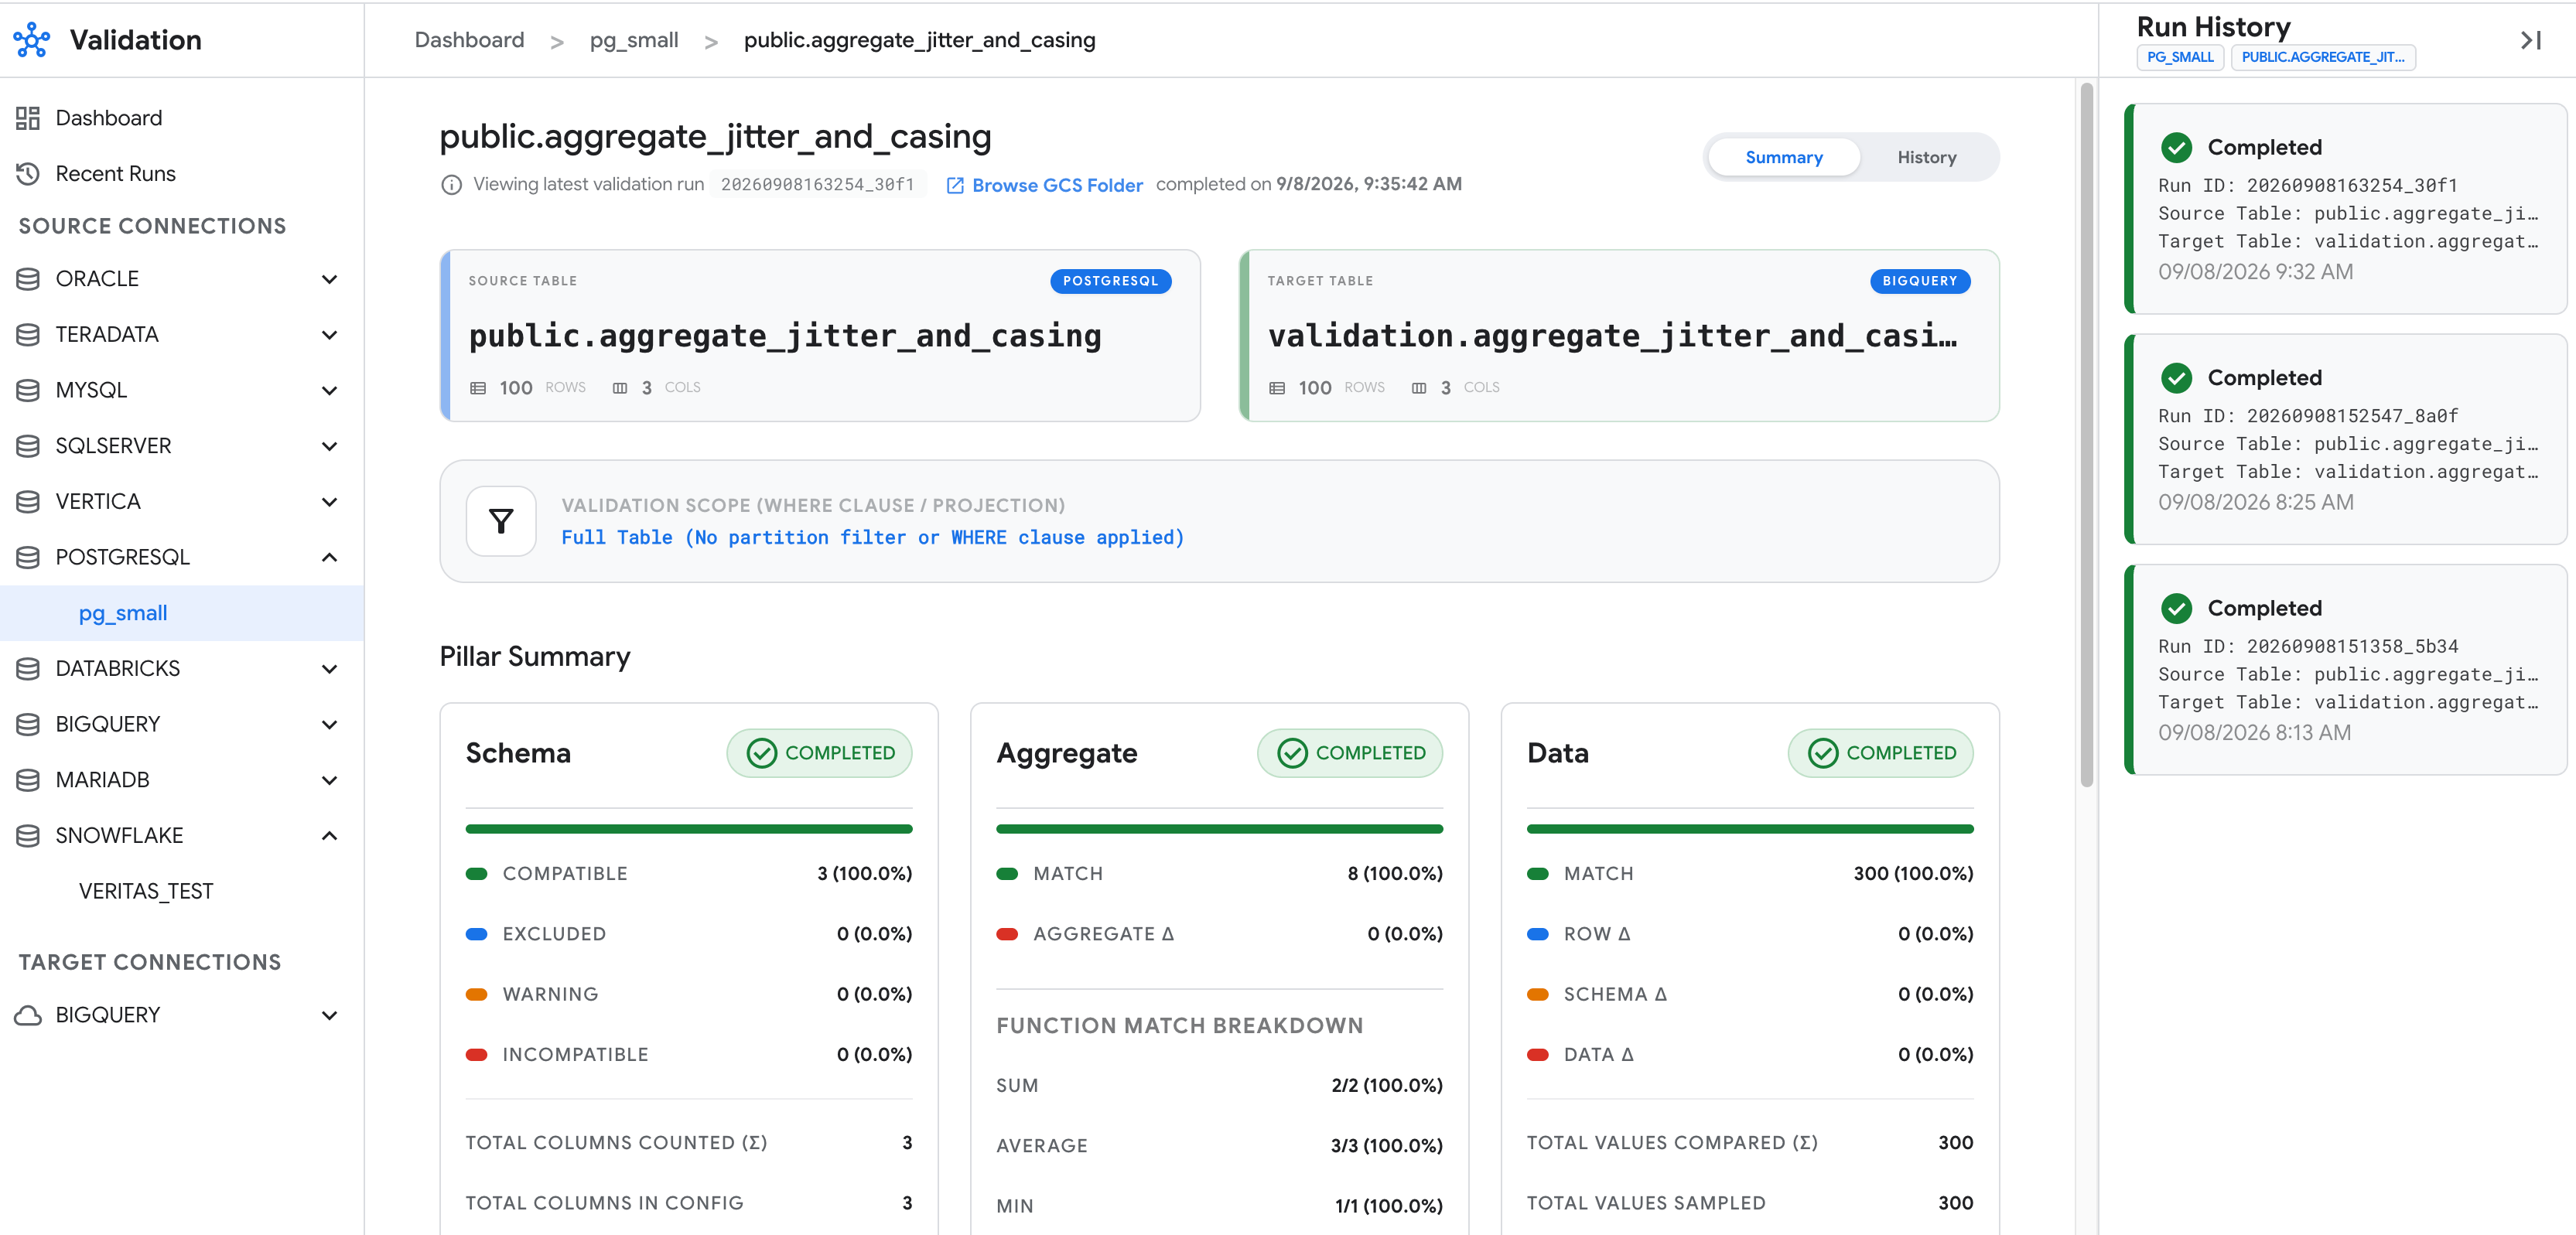
Alur kerja validasi membandingkan tabel sumber dan tabel BigQuery target di tiga pilar validasi:
- Validasi skema (
--schema): membandingkan nama kolom, jenis data, dan kompatibilitas jenis antara tabel sumber dan tabel BigQuery target. - Validasi agregat (
--aggregate): menghitung dan membandingkan metrik agregat tingkat tabel dan tingkat kolom—seperti jumlah baris,SUM,AVG,MIN,MAX, distribusi boolean, dan panjang string—di seluruh tabel. - Validasi data (
--data): melakukan perbandingan baris demi baris menggunakan pemindaian tabel lengkap yang menyeluruh (BRUTE_FORCE) atau pengambilan sampel berbasis kunci acak (SAMPLE) untuk mendeteksi baris yang hilang dan pergeseran nilai tingkat sel.
Lokasi yang didukung
Layanan validasi tersedia di lokasi tertentu. Untuk mengetahui informasi selengkapnya, lihat Lokasi BigQuery Migration Service.
Pertimbangan penanganan dan keamanan data
Layanan validasi mengekstrak dan melakukan staging data yang berbeda, bergantung pada pilar validasi yang Anda jalankan:
- Validasi skema (
--schema): hanya mengupload nama kolom, jenis data, dan statistik tabel ke filesource_query_result.json, tanpa mengekstrak nilai sel. - Validasi agregat (
--aggregate): mengupload metrik agregat yang dihitung ke filesource_aggregates.parquet, termasuk nilai selMINdanMAXaktual dari kolom yang disertakan. - Validasi data (
--data): mengekstrak nilai sel mentah yang tidak disamarkan dari baris sampel, atau dari semua baris saat menggunakan strategiBRUTE_FORCE. Alat ini mengupload nilai ini dalam format Apache Parquet atau CSV ke bucket staging Cloud Storage Anda dan memuatnya ke set datavalidation_resultsdi BigQuery.
Untuk melindungi data dan mengamankan lingkungan validasi Anda, konfigurasikan setelan berikut:
- Kecualikan kolom sensitif: tambahkan kolom sensitif ke kolom
columnSettings.excludeuntuk menghilangkannya dari kueri ekstraksi sumber, perbandingan target, dan laporan validasi. - Minimalkan penyimpanan data lokal: tetapkan kolom
googleCloudStorage.gcsPathdalam filesettings.yamluntuk melakukan streaming baris sampel langsung ke Cloud Storage tanpa menulisnya ke disk lokal. Pada host bersama, hapus direktori kerja--output-dirlokal setelah setiap operasi untuk menghapus file metadata, agregat, dan file log lokal. - Mengenkripsi data dan hasil yang di-stage: mengonfigurasi kunci enkripsi yang dikelola pelanggan (CMEK) dengan Cloud Key Management Service di bucket staging Cloud Storage dan set data hasil BigQuery (
validation_resultssecara default, atau set data yang ditentukan di kolomresults.dataset) sebelum menjalankan validasi. - Batasi akses konfigurasi: simpan file konfigurasi validasi di
repositori yang dikontrol versi yang memerlukan peninjauan kode, atau di
bucket Cloud Storage tempat hanya pengguna tepercaya yang memiliki
izin
storage.objects.create. - Terapkan akses dengan hak istimewa terendah: berikan peran
roles/bigquery.dataViewerkepada pembuat alur kerja hanya pada set data atau tabel target yang divalidasi, bukan pada project. Gunakan pengguna database sumber hanya baca seperti yang dijelaskan dalam Mengonfigurasi hak istimewa database sumber.
Sebelum memulai
Di konsol Google Cloud , pada halaman pemilih project, pilih atau buat project Google Cloud yang berisi set data BigQuery target Anda.
Pastikan penagihan diaktifkan untuk project Google Cloud Anda.
Aktifkan API BigQuery, BigQuery Migration Service, Cloud Storage, dan (jika menyimpan sandi database di Secret Manager) Secret Manager.
Buat atau pilih bucket Cloud Storage di lokasi yang sama dengan set data BigQuery target Anda untuk melakukan staging metadata dan sampel data yang diekstrak. Untuk mengetahui informasi selengkapnya, lihat Membuat bucket.
Peran dan izin yang diperlukan
Proses validasi memiliki tiga bagian, dan masing-masing dapat dilakukan oleh akun utama yang berbeda:
- Pengumpulan data: klien validasi membaca database sumber Anda dan mengupload metadata, agregat, dan baris sampel ke bucket staging Cloud Storage Anda. Fungsi ini tidak memanggil BigQuery.
- Validasi: alur kerja validasi BigQuery Migration Service membandingkan data yang di-stage dengan tabel target Anda. Alur kerja berjalan dengan kredensial akun utama yang membuatnya, baik akun utama tersebut adalah klien validasi,
gcloud, atau konsol Google Cloud . - Melihat hasil: membaca set data hasil dan laporan Cloud Storage.
generate-config tidak memerlukan izin Google Cloud apa pun.
Pengumpulan data
Untuk mendapatkan izin yang Anda perlukan untuk mengumpulkan data sumber, minta administrator untuk memberi Anda peran IAM berikut:
- Storage Object Creator (
roles/storage.objectCreator) di bucket staging - Storage Object Viewer (
roles/storage.objectViewer) di bucket staging -
Membaca file konfigurasi dari Cloud Storage:
Storage Object Viewer (
roles/storage.objectViewer) di bucket konfigurasi -
Membaca sandi database dari Secret Manager:
Secret Manager Secret Accessor (
roles/secretmanager.secretAccessor) pada secret
Untuk mengetahui informasi selengkapnya tentang pemberian peran, lihat Mengelola akses ke project, folder, dan organisasi.
Peran bawaan ini berisi izin yang diperlukan untuk mengumpulkan data sumber. Untuk melihat izin yang benar-benar diperlukan, perluas bagian Izin yang diperlukan:
Izin yang diperlukan
Izin berikut diperlukan untuk mengumpulkan data sumber:
-
storage.objects.createpada bucket staging -
storage.objects.getpada bucket staging -
Membaca file konfigurasi dari Cloud Storage:
-
storage.objects.getpada bucket konfigurasi -
storage.objects.listpada bucket konfigurasi
-
-
Membaca sandi database dari Secret Manager:
secretmanager.versions.accesspada secret
Anda mungkin juga bisa mendapatkan izin ini dengan peran khusus atau peran bawaan lainnya.
Dengan --extract-only, pengumpulan data tidak memerlukan izin BigQuery atau BigQuery Migration Service. Tanpa itu, klien juga membuat
alur kerja validasi dan memerlukan peran validasi.
Validasi
Untuk mendapatkan izin yang Anda perlukan untuk membuat dan menjalankan alur kerja validasi, minta administrator untuk memberi Anda peran IAM berikut:
- MigrationWorkflow Editor (
roles/bigquerymigration.editor) pada project - BigQuery Job User (
roles/bigquery.jobUser) pada project - BigQuery Data Viewer (
roles/bigquery.dataViewer) di setiap set data target - BigQuery Data Editor (
roles/bigquery.dataEditor) di set data hasil - Storage Object User (
roles/storage.objectUser) di bucket staging -
Jika set data hasil tidak ada:
BigQuery User (
roles/bigquery.user) di project
Peran bawaan ini berisi izin yang diperlukan untuk membuat dan menjalankan alur kerja validasi. Untuk melihat izin yang benar-benar diperlukan, perluas bagian Izin yang diperlukan:
Izin yang diperlukan
Izin berikut diperlukan untuk membuat dan menjalankan alur kerja validasi:
-
bigquerymigration.workflows.createpada project -
bigquerymigration.workflows.getpada project -
bigquery.jobs.createpada project -
bigquery.tables.getdi setiap set data target -
bigquery.tables.getDatadi setiap set data target -
bigquery.datasets.getpada set data hasil -
bigquery.tables.getpada set data hasil -
bigquery.tables.createpada set data hasil -
bigquery.tables.updatepada set data hasil -
bigquery.tables.updateDatapada set data hasil -
bigquery.tables.getDatapada set data hasil -
storage.objects.getpada bucket staging -
storage.objects.createpada bucket staging -
storage.objects.deletepada bucket staging -
Jika set data hasil tidak ada:
bigquery.datasets.createpada project
roles/bigquerymigration.editor berisi banyak izin yang tidak digunakan oleh validasi. Untuk hak istimewa terendah, berikan
peran khusus hanya dengan
bigquerymigration.workflows.create dan bigquerymigration.workflows.get.
Validasi hanya membaca tabel target dan hanya menulis ke set data hasil. Sebaiknya buat set data hasil terlebih dahulu agar tidak ada akun utama yang memerlukan izin untuk membuat set data di project Anda.
Melihat hasil
Untuk mendapatkan izin yang Anda perlukan untuk melihat hasil validasi, minta administrator untuk memberi Anda peran IAM berikut:
- BigQuery Job User (
roles/bigquery.jobUser) pada project yang berisi set data hasil - BigQuery Data Viewer (
roles/bigquery.dataViewer) di set data hasil -
Membaca laporan di Cloud Storage:
Storage Object Viewer (
roles/storage.objectViewer) di bucket staging -
Mencantumkan dan melihat alur kerja validasi di konsol Google Cloud :
MigrationWorkflow Viewer (
roles/bigquerymigration.viewer) pada project
Peran bawaan ini berisi izin yang diperlukan untuk melihat hasil validasi. Untuk melihat izin yang benar-benar diperlukan, perluas bagian Izin yang diperlukan:
Izin yang diperlukan
Izin berikut diperlukan untuk melihat hasil validasi:
-
bigquery.jobs.createpada project -
bigquery.tables.getpada set data hasil -
bigquery.tables.getDatapada set data hasil -
Membaca laporan di Cloud Storage:
-
storage.objects.getpada bucket staging -
storage.objects.listpada bucket staging
-
-
Mencantumkan dan melihat alur kerja validasi di konsol Google Cloud :
-
bigquerymigration.workflows.listdalam project -
bigquerymigration.workflows.getdalam project
-
Mengonfigurasi hak istimewa database sumber
Anda harus mengonfigurasi akses hanya baca ke pengguna database sumber dengan hak istimewa berikut:
- Hak istimewa
SELECTpada setiap tabel sumber yang divalidasi. - Akses baca ke tampilan katalog sistem yang digunakan untuk penemuan skema dan kunci utama (seperti tabel
information_schema,ALL_CONSTRAINTS, danALL_TAB_COLUMNSdi Oracle, atauSVV_COLUMNSdanpg_attributedi Amazon Redshift).
Jangan berikan hak istimewa tulis, DDL, atau administratif kepada pengguna ini. Klien validasi menjalankan SQL dari konfigurasi validasi Anda sebagai pengguna ini. Untuk mengetahui informasi selengkapnya, lihat Pertimbangan penanganan dan keamanan data.
Batasan
Layanan validasi tunduk pada batasan berikut:
- BigQuery adalah satu-satunya database target yang didukung. Validasi antara dua database non-BigQuery atau penggunaan BigQuery sebagai sumber validasi tidak didukung.
- Set data BigQuery target Anda, set data hasil
(
validation_resultssecara default, atau set data kustom yang dikonfigurasi di bagianresultsdisettings.yaml), bucket staging Cloud Storage, dan lokasi alur kerja validasi (BQMS_VALIDATION_LOCATION) harus berada di lokasi yang sama. Saat membuat set data hasil, layanan validasi menetapkan lokasi set data secara default ke region yang digunakan oleh bucket staging Cloud Storage dan set data BigQuery target, atauresults.locationjika ditetapkan secara eksplisit. - Dukungan jenis data bervariasi menurut sumber. Kolom dengan jenis yang tidak didukung akan dikecualikan dari validasi. Untuk mengetahui detailnya, lihat Data warehouse yang didukung.
- Tabel perbandingan per operasi yang dibuat di BigQuery akan otomatis berakhir masa berlakunya berdasarkan
resultTtlHoursdisettings.yaml, yang secara default ditetapkan ke168.0jam, atau tujuh hari. Jangan mengonfigurasi masa berlaku tabel default tingkat set data pada set datavalidation_results, karena tindakan ini juga akan mengakhiri masa berlaku tabel audit yang berumur panjang sepertirun_history,run_metrics, dancolumn_history. - Nama tabel BigQuery peka huruf besar/kecil. Saat
generate-configmembuat konfigurasi dari arsip metadata alatdwh-migration-dumpertanpa pemetaantables.yamlterjemahan, nama tabel target mempertahankan kapitalisasi ID sumber. Misalnya, nama tabel dalam huruf besar dari Oracle atau Snowflake. PastikantargetTable.namesama persis dengan huruf besar/kecil tabel Anda di BigQuery.
Data warehouse yang didukung
Layanan validasi mendukung database sumber berikut. Setiap bagian mencakup driver JDBC yang dipaketkan dengan penginstalan, apakah Anda dapat membuat konfigurasi tabel secara otomatis dari arsip metadata alat dwh-migration-dumper atau tidak, jenis partisi yang didukung untuk tabel besar dari database ini, dan jenis data yang didukung untuk validasi.
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
Varian berparameter dari jenis data yang didukung, seperti VARCHAR(255) atau DECIMAL(10,2), juga didukung.
Layanan validasi memuat file JAR apa pun di direktori drivers/ sebelum
driver yang didownload secara otomatis, sehingga Anda juga dapat menggunakan drivers/ untuk mengganti
versi driver yang dipaketkan.
Jika Anda otomatis membuat file konfigurasi validasi, kolom dengan jenis data yang tidak didukung akan otomatis ditambahkan ke columnSettings.exclude. Untuk
konfigurasi manual, Anda harus mengecualikannya secara eksplisit di columnSettings.exclude.
Untuk sebagian besar database sumber yang didukung, alat validasi akan otomatis mendownload
driver JDBC yang diperlukan dari Maven Central pada penggunaan pertama, memverifikasi checksum
SHA-256-nya, dan meng-cache-nya secara lokal di ~/.cache/google-cloud-bqms/drivers/ (atau
$XDG_CACHE_HOME/google-cloud-bqms/drivers/). Untuk data warehouse yang menggunakan driver eksklusif, seperti Teradata, atau saat berjalan di lingkungan offline atau air-gapped, lakukan hal berikut:
- Tempatkan file JAR driver yang diperlukan di
./drivers/,<sdk_root>/platform/bqms/drivers/, atau direktori yang ditentukan oleh variabel lingkunganBQMS_DRIVER_DIR. Setiap JAR driver yang ditempatkan di direktori lokal ini lebih diprioritaskan daripada download otomatis Maven Central. - Untuk menonaktifkan sepenuhnya download jaringan otomatis di lingkungan air-gapped, tetapkan
BQMS_AUTO_DOWNLOAD_DRIVERS=false, atau tetapkanBQMS_MAVEN_MIRRORagar mengarah ke mirror repositori Maven internal.
Untuk mempelajari setiap sumber data yang didukung oleh layanan validasi, pilih salah satu opsi berikut:
Teradata
Validasi untuk migrasi Teradata didukung sebagai berikut:
- Nilai
dialect:teradata - Driver JDBC: Disediakan pengguna. Download JAR driver JDBC Teradata, seperti
terajdbc4.jaratauterajdbc.jar, dari Teradata dan salin ke direktoridrivers/atau direktori yang ditentukan olehBQMS_DRIVER_DIR. - Pembuatan konfigurasi otomatis: Didukung dari arsip metadata alat
dwh-migration-dumper(--connector teradata). - Ekstraksi yang dipartisi:
INTEGER_RANGE,PHYSICAL
| Kategori | Jenis data |
|---|---|
| Angka | BYTEINT, SMALLINT, INTEGER, INT, BIGINT, DECIMAL, DEC, NUMERIC, NUMBER, FLOAT, REAL, DOUBLE PRECISION |
| String | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, LONG VARCHAR |
| Tanggal dan waktu | DATE, TIME, TIME WITH TIME ZONE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
Saat memvalidasi migrasi dari Teradata, pertimbangkan hal berikut:
- Jika tabel tidak memiliki kunci utama eksplisit, kunci perbandingan akan ditemukan
dari indeks utama unik (
UPI) atau indeks sekunder unik (USI). Indeks utama non-unik (NUPI) tidak digunakan sebagai kunci perbandingan. NUMBER(P,S)presisi tetap didukung;NUMBERtanpa batasan (tanpa presisi) tidak didukung. KolomNUMBER,CLOB,BLOB,BYTE,VARBYTE,INTERVAL,PERIOD,JSON, danXMLyang tidak dibatasi akan otomatis dikecualikan olehgenerate-config(atau harus dicantumkan dalamcolumnSettings.excludeuntuk konfigurasi manual).- Kolom
CHARdengan lebar tetap akan dipangkas secara otomatis. Himpunan karakterLATINdanUNICODEserta atributCASESPECIFIC/NOT CASESPECIFICdidukung. - Nilai
TIME WITH TIME ZONEdanTIMESTAMP WITH TIME ZONEdinormalisasi ke UTC (AT 0) sebelum perbandingan.
Snowflake
Validasi untuk migrasi Snowflake didukung sebagai berikut:
- Nilai
dialect:snowflake - Driver JDBC: Didownload otomatis saat pertama kali digunakan
(
net.snowflake:snowflake-jdbc), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Didukung dari arsip metadata alat
dwh-migration-dumper(--connector snowflake). - Ekstraksi yang dipartisi:
INTEGER_RANGE,DATE_RANGE
Layanan validasi mendukung jenis data berikut untuk migrasi Snowflake:
| Kategori | Jenis data |
|---|---|
| Angka | NUMBER, DECIMAL, NUMERIC, FLOAT, REAL, DOUBLE |
| String | CHAR, VARCHAR, STRING, TEXT |
| Tanggal dan waktu | DATE, TIME, TIMESTAMP_NTZ, TIMESTAMP_LTZ, TIMESTAMP_TZ |
| Boolean | BOOLEAN |
Saat memvalidasi migrasi dari Snowflake, pertimbangkan hal berikut:
- Kolom
CHARdengan lebar tetap akan dipangkas secara otomatis. - Jika Anda mereplikasi data dengan BigQuery Data Transfer Service, tetapkan
tolerances.timestamp: 0.001untuk menyerap pembulatan sub-milidetik.
Amazon Redshift
Validasi untuk migrasi Amazon Redshift didukung sebagai berikut:
- Nilai
dialect:redshift - Driver JDBC: Didownload otomatis saat pertama kali digunakan
(
com.amazon.redshift:redshift-jdbc42), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Didukung dari arsip metadata alat
dwh-migration-dumper(--connector redshift). - Ekstraksi yang dipartisi:
INTEGER_RANGE,PHYSICAL
Layanan validasi mendukung jenis data berikut untuk migrasi Amazon Redshift:
| Kategori | Jenis data |
|---|---|
| Angka | SMALLINT, INTEGER, BIGINT, DECIMAL, NUMERIC, REAL, DOUBLE PRECISION |
| String | CHAR, VARCHAR, TEXT |
| Tanggal dan waktu | DATE, TIME, TIMETZ, TIMESTAMP, TIMESTAMPTZ |
| Boolean | BOOLEAN |
| Penyimpanan data | SUPER |
Saat memvalidasi migrasi dari Amazon Redshift, pertimbangkan hal berikut:
- Pemeriksaan skema menggunakan
SVV_COLUMNS, sehingga tampilan late-binding didukung. - Jika tabel tidak memiliki kunci utama, kunci perbandingan akan otomatis kembali ke
DISTKEYatauSORTKEYsatu kolom. - Kolom
GEOMETRYtidak didukung.
Databricks
Validasi untuk migrasi Databricks didukung sebagai berikut:
- Nilai
dialect:databricks - Driver JDBC: Didownload otomatis saat pertama kali digunakan
(
com.databricks:databricks-jdbc), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Tidak didukung. Buat file konfigurasi tabel manual.
- Ekstraksi yang dipartisi:
INTEGER_RANGE
Layanan validasi mendukung jenis data berikut untuk migrasi Databricks:
| Kategori | Jenis data |
|---|---|
| Angka | BYTE, TINYINT, SHORT, SMALLINT, INT, INTEGER, LONG, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| Tanggal dan waktu | DATE, TIMESTAMP |
| Boolean | BOOLEAN |
| Biner | BINARY |
| Kompleks | ARRAY, MAP, STRUCT |
Saat memvalidasi migrasi dari Databricks, pertimbangkan hal berikut:
- Lakukan autentikasi dengan token akses pribadi: tetapkan
user: tokendan berikan token melaluipasswordSecret. - Pemeriksaan skema berbasis kueri (
SELECT * ... WHERE 1=0), sehingga ruang kerja Unity Catalog dan metastore Hive didukung.
Apache Hive
Validasi untuk migrasi Apache Hive didukung sebagai berikut:
- Nilai
dialect:hive - Driver JDBC: Didownload secara otomatis saat pertama kali digunakan
(JAR mandiri
org.apache.hive:hive-jdbc), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Didukung dari arsip metadata alat
dwh-migration-dumper(--connector hiveql). - Ekstraksi yang dipartisi:
INTEGER_RANGE
Layanan validasi mendukung jenis data berikut untuk migrasi Hive:
| Kategori | Jenis data |
|---|---|
| Angka | TINYINT, SMALLINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| Tanggal dan waktu | DATE, TIMESTAMP |
| Boolean | BOOLEAN |
| Biner | BINARY |
| Kompleks | ARRAY, MAP, STRUCT |
Saat memvalidasi migrasi dari Hive, pertimbangkan hal berikut:
- Pemeriksaan skema berbasis kueri (
SELECT * ... WHERE 1=0). - Tabel Hive jarang menentukan kunci utama. Tabel tanpa kunci perbandingan otomatis menggunakan agregasi hash baris penuh untuk pilar data.
SQL Server
Validasi untuk migrasi SQL Server didukung sebagai berikut:
- Nilai
dialect:sqlserver - Driver JDBC: Didownload otomatis saat pertama kali digunakan
(
com.microsoft.sqlserver:mssql-jdbc), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Didukung dari arsip metadata alat
dwh-migration-dumper(--connector sqlserver). - Ekstraksi yang dipartisi:
INTEGER_RANGE
Layanan validasi mendukung jenis data berikut untuk migrasi SQL Server:
| Kategori | Jenis data |
|---|---|
| Angka | INT, BIGINT, DECIMAL, NUMERIC, FLOAT, REAL |
| String | CHAR, VARCHAR, TEXT |
| Tanggal dan waktu | DATE, DATETIME, TIMESTAMP |
| Boolean | BIT |
Saat memvalidasi migrasi dari SQL Server, pertimbangkan hal berikut:
- URL JDBC default menetapkan
encrypt=true;trustServerCertificate=true;. Ganti dengan kunci koneksiurljika Anda memerlukan validasi sertifikat TLS yang ketat.
MariaDB
Validasi untuk migrasi MariaDB didukung sebagai berikut:
- Nilai
dialect:mariadb - Driver JDBC: Didownload otomatis saat pertama kali digunakan
(
org.mariadb.jdbc:mariadb-java-client), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Buat file konfigurasi tabel manual.
- Ekstraksi yang dipartisi:
INTEGER_RANGE
Layanan validasi mendukung jenis data berikut untuk migrasi MariaDB:
| Kategori | Jenis data |
|---|---|
| Angka | TINYINT, SMALLINT, MEDIUMINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, ENUM, SET |
| Tanggal dan waktu | DATE, TIME, DATETIME, TIMESTAMP, YEAR |
| Objek biner dan besar | BINARY, VARBINARY, TINYBLOB, BLOB, MEDIUMBLOB, LONGBLOB |
MySQL
Validasi untuk migrasi MySQL didukung sebagai berikut:
- Nilai
dialect:mysql - Driver JDBC: Didownload otomatis saat pertama kali digunakan
(
com.mysql:mysql-connector-j), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Buat file konfigurasi tabel manual.
- Ekstraksi yang dipartisi:
INTEGER_RANGE
Layanan validasi mendukung jenis data berikut untuk migrasi MySQL:
| Kategori | Jenis data |
|---|---|
| Angka | INT, BIGINT, DECIMAL, FLOAT, DOUBLE |
| String | CHAR, VARCHAR, TEXT |
| Tanggal dan waktu | DATE, TIME, DATETIME, TIMESTAMP |
| Boolean | BOOLEAN |
Oracle
Validasi untuk migrasi Oracle didukung sebagai berikut:
- Nilai
dialect:oracle - Driver JDBC: Didownload otomatis saat pertama kali digunakan
(
com.oracle.database.jdbc:ojdbc11), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Didukung dari arsip metadata alat
dwh-migration-dumper(--connector oracle). - Ekstraksi yang dipartisi:
INTEGER_RANGE,PHYSICAL
Layanan validasi mendukung jenis data berikut untuk migrasi Oracle:
| Kategori | Jenis data |
|---|---|
| Angka | NUMBER, NUMERIC, INTEGER, FLOAT, DOUBLE |
| String | CHAR, NCHAR, VARCHAR, VARCHAR2, NVARCHAR2 |
| Tanggal dan waktu | DATE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
| Objek biner dan besar | RAW, BINARY, BLOB, CLOB, NCLOB |
Saat memvalidasi migrasi dari Oracle, pertimbangkan hal berikut:
- Kolom
DATEmenyertakan komponen waktu di Oracle. Alat validasi mengekstrak kolomDATEOracle pada presisi hari (YYYY-MM-DD), sehingga perbedaan waktu dalam sehari akan dipotong.
PostgreSQL
Validasi untuk migrasi PostgreSQL didukung sebagai berikut:
- Nilai
dialect:postgresql - Driver JDBC: Didownload otomatis saat pertama kali digunakan
(
org.postgresql:postgresql), atau disediakan pengguna di direktoridrivers/untuk lingkungan offline. - Pembuatan konfigurasi otomatis: Didukung dari arsip metadata alat
dwh-migration-dumper(--connector postgres). - Ekstraksi yang dipartisi:
INTEGER_RANGE,DATE_RANGE,PHYSICAL
Layanan validasi mendukung jenis data berikut untuk migrasi PostgreSQL:
| Kategori | Jenis data |
|---|---|
| Angka | SMALLINT, INTEGER, BIGINT, NUMERIC, DOUBLE PRECISION |
| String | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, TEXT |
| Tanggal dan waktu | DATE, TIME, TIMESTAMP, TIMESTAMP WITHOUT TIME ZONE, TIMESTAMP WITH TIME ZONE, TIMESTAMPTZ |
| Boolean | BOOLEAN |
| Lainnya | UUID |
Saat memvalidasi migrasi dari PostgreSQL, pertimbangkan hal berikut:
- Nilai
BIGINTyang lebih besar dari 253 dapat menunjukkan perbedaan presisi kecil padaAVG();SUMdanCOUNTtetap sama.
Menyiapkan direktori dan file konfigurasi validasi
Layanan validasi membaca dari direktori konfigurasi modular bernama
validation_config/ yang berisi file
berikut:
- File koneksi database: menentukan profil koneksi data warehouse
sourcedan profil koneksi BigQuerytargetAnda. - File setelan staging dan hasil: menentukan jalur staging Cloud Storage (
googleCloudStorage), konfigurasi set data hasil BigQuery (results), masa berlaku tabel perbandingan per operasi (resultTtlHours), dan default global opsional (tolerances,aggregate,labels). - File konfigurasi validasi tabel: berisi pemetaan per tabel
(
sourceTabledantargetTable), kunci perbandingan (comparisonKeys), strategi validasi (strategy), setelan ekstraksi yang dipartisi (partitioning), dan setelan kolom (columnSettings).
Bagian berikut menjelaskan langkah-langkah untuk menyiapkan direktori konfigurasi validasi dan langkah-langkah untuk membuat file konfigurasi yang diperlukan untuk validasi migrasi.
Membuat direktori konfigurasi validasi
Buat direktori konfigurasi validasi bernama validation_config/ untuk menyimpan
file konfigurasi validasi Anda. Anda dapat menyimpan direktori ini di mesin yang menjalankan layanan validasi, atau menyimpannya di bucket Cloud Storage sehingga tim dapat berbagi satu konfigurasi di seluruh operasi.
Membuat file koneksi database
Di direktori konfigurasi validasi, buat file bernama connections.yaml
dan konfigurasikan dengan informasi untuk terhubung ke database sumber dan
database BigQuery target.
Setiap sumber data warehouse memiliki fitur dan persyaratan khusus yang perlu dipertimbangkan saat membuat file koneksi database. Untuk mengetahui informasi selengkapnya tentang setiap sumber data, lihat Data warehouse yang didukung.
Saat Anda menentukan passwordSecret di profil koneksi, layanan validasi
akan mengambil versi rahasia dari Secret Manager di mesin klien
menggunakan Kredensial Default Aplikasi (ADC) lokal dan meneruskan sandi yang telah di-resolve
langsung ke driver JDBC lokal. Database sumber Anda tidak memerlukan akses jaringan atau akses IAM ke Google Cloud, sehingga passwordSecret berfungsi untuk database lokal dan database yang dihosting di cloud lain, seperti Amazon Redshift atau Snowflake. Atau, Anda dapat menghilangkan
passwordSecret dan menetapkan variabel lingkungan BQMS_VALIDATION_SOURCE_PASSWORD
pada mesin yang menjalankan layanan validasi.
Untuk membuat file koneksi database untuk data warehouse, pilih salah satu opsi berikut:
Teradata
Untuk validasi migrasi Teradata, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SOURCE_HOST: nama host atau alamat IP sistem Teradata Anda.SOURCE_DATABASE: nama database Teradata yang diperlukan.SOURCE_USER: nama pengguna Teradata.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi, atau tetapkanBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
Snowflake
Untuk validasi migrasi Snowflake, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SNOWFLAKE_ACCOUNT: ID akun Snowflake Anda (misalnya,myorg-myaccount).SNOWFLAKE_WAREHOUSE: virtual warehouse yang digunakan untuk menjalankan kueri ekstraksi.SOURCE_DATABASE: nama database Snowflake yang diperlukan.SOURCE_SCHEMA: nama skema Snowflake yang diperlukan.SNOWFLAKE_ROLE: peran Snowflake opsional.SOURCE_USER: nama pengguna Snowflake.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi, atau tetapkanBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
Amazon Redshift
Untuk validasi migrasi Amazon Redshift, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SOURCE_HOST: nama host endpoint cluster Amazon Redshift Anda.SOURCE_DATABASE: nama database Amazon Redshift yang diperlukan.SOURCE_SCHEMA: nama skema default (defaultnya adalahpublicjika dihilangkan).SOURCE_USER: nama pengguna database.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi, atau tetapkanBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
Databricks
Untuk validasi migrasi Databricks, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
DATABRICKS_HOST: nama host server warehouse atau cluster Databricks SQL Anda.HTTP_PATH: jalur HTTP warehouse Databricks SQL Anda (misalnya,sql/protocolv1/o/1234567890/0123-456789-abcdef).CATALOG_NAME: nama Unity Catalog yang diperlukan (atauhive_metastore).SCHEMA_NAME: nama skema yang diperlukan.SECRET_PROJECT_IDdanSECRET_ID: project ID dan ID secret di Secret Manager yang berisi token akses pribadi (PAT) Databricks Anda, atau hapuspasswordSecretdan tetapkanBQMS_VALIDATION_SOURCE_PASSWORD. Menggunakanuser: tokendenganpasswordSecretmemastikan token Anda tidak pernah ditulis ke file metadata staging.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
Apache Hive
Untuk validasi migrasi Apache Hive, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SOURCE_HOST: nama host atau alamat IP HiveServer2.SOURCE_DATABASE: nama database Hive yang diperlukan (misalnya,default).SOURCE_USER: nama pengguna Hive.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi, atau tetapkanBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
SQL Server
Untuk validasi migrasi SQL Server, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SOURCE_HOST: nama host atau alamat IP instance SQL Server Anda (opsional, tentukaninstanceNameuntuk instance bernama).SOURCE_DATABASE: nama database yang diperlukan.SOURCE_SCHEMA: nama skema default (defaultnya adalahdbojika dihilangkan).SOURCE_USER: nama pengguna database.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi, atau tetapkanBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
MariaDB
Untuk validasi migrasi MariaDB, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SOURCE_HOST: nama host atau alamat IP server MariaDB Anda.SOURCE_DATABASE: nama database MariaDB yang diperlukan.SOURCE_USER: nama pengguna MariaDB.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi, atau tetapkanBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
MySQL
Untuk validasi migrasi MySQL, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SOURCE_HOST: nama host atau alamat IP server MySQL Anda.SOURCE_DATABASE: nama database MySQL yang diperlukan.SOURCE_USER: nama pengguna MySQL.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi, atau tetapkanBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
Oracle
Untuk validasi migrasi Oracle, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SOURCE_HOST: nama host atau alamat IP server Oracle Anda.SERVICE_NAME: nama layanan Oracle (digunakan untuk membuatjdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME). Untuk koneksi TNS atau SID kustom, tentukanurldengan URL JDBC lengkap.SOURCE_SCHEMA: nama skema default opsional.SOURCE_USER: nama pengguna Oracle yang diperlukan.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi database, atau tetapkanBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud target.TARGET_DATASET: nama set data BigQuery target.
PostgreSQL
Untuk validasi migrasi PostgreSQL, konfigurasikan file koneksi database Anda dengan informasi berikut:
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Ganti kode berikut:
SOURCE_HOST: nama host atau alamat IP server PostgreSQL Anda.SOURCE_DATABASE: nama database PostgreSQL yang diperlukan.SOURCE_SCHEMA: nama skema default (defaultnya adalahpublicjika dihilangkan).SOURCE_USER: nama pengguna database.SECRET_PROJECT_IDdanSECRET_ID: project ID dan secret ID di Secret Manager yang berisi sandi database. Atau, hapuspasswordSecretdan tetapkan variabel lingkunganBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: project ID Google Cloud yang berisi tabel BigQuery yang dimigrasikan dan tempat set datavalidation_resultsakan dibuat.TARGET_DATASET: nama set data BigQuery target.
Membuat file setelan
Buat file setelan staging dan hasil bernama settings.yaml di direktori konfigurasi
validasi untuk mengonfigurasi jalur staging Cloud Storage,
set data hasil BigQuery, masa berlaku tabel per operasi, dan
setelan default global opsional.
Konfigurasikan file setelan staging dan hasil dengan hal berikut:
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
Ganti kode berikut:
BUCKET_NAME: nama bucket staging Cloud Storage Anda.PATH_PREFIX: awalan Cloud Storage URI di bucket yang digunakan untuk melakukan staging metadata skema yang diekstrak, metrik gabungan, baris sampel, dan laporan ringkasan.FORMAT: format file untuk sampel data yang di-stage. Nilai yang didukung adalahparquet(default) dancsv.RESULTS_PROJECT_ID: project ID Google Cloud tempat hasil validasi dan tabel histori operasi ditulis. Jika dihilangkan, setelan defaultnya adalahtarget.projectIddariconnections.yaml.RESULTS_DATASET: nama set data BigQuery tempat hasil validasi dan tabel histori operasi (run_history,run_metrics, dancolumn_history) ditulis. Jika dihilangkan, setelan defaultnya adalahvalidation_results. Jika set data tidak ada, layanan validasi akan membuatnya secara otomatis.RESULTS_LOCATION: lokasi BigQuery untuk set data hasil. Jika dihilangkan, set data hasil yang dibuat secara otomatis akan ditetapkan secara default ke region bucket staging Cloud Storage dan set data BigQuery target Anda.RESULT_TTL_HOURS: time to live dalam jam untuk tabel perbandingan dan ketidakcocokan per operasi yang dibuat di set data hasil. Default-nya adalah168.0jam (7 hari). Tabel kemampuan observasi yang berumur panjang (run_history,run_metrics, dancolumn_history) tidak terpengaruh olehresultTtlHours.RESULTS_CONFIG: mengonfigurasi set data BigQuery tujuan untuk hasil perbandingan dan histori audit. Nilai yang didukung adalahprojectId,dataset, danlocation. Jika dihilangkan, layanan validasi akan menulis keTARGET_PROJECT_ID.validation_results` dan otomatis membuat set data di region yang sama dengan set data target dan bucket staging Cloud Storage jika belum ada.
Anda juga dapat menentukan default tabel global dengan menentukan tolerances,
aggregate, atau labels di tingkat teratas settings.yaml atau
validation-config.yaml. Setelan default ini berlaku untuk semua tabel, kecuali jika diganti dalam konfigurasi tabel individual.
Membuat konfigurasi validasi tabel
Setelah mengonfigurasi file koneksi dan setelan, tentukan konfigurasi validasi tabel. Perintah generate-config menulis satu file YAML per tabel di validation_config/databases/DATABASE/SCHEMA/TABLE.yaml dengan kunci table: level teratas, atau Anda dapat membuat file validation_config/tables.yaml manual.
Pilih salah satu opsi berikut untuk mendapatkan informasi tentang cara membuat konfigurasi validasi tabel untuk database sumber Anda:
Teradata
Untuk validasi migrasi Teradata, lakukan hal berikut untuk
membuat arsip metadata alat dwh-migration-dumper dari skema sumber Anda:
- Instal alat
dwh-migration-dumper. - Jalankan
dwh-migration-dumperuntuk database sumber Anda guna menghasilkan arsip metadata alatdwh-migration-dumper.
Dengan arsip metadata, jalankan generate-config untuk membuat file konfigurasi per tabel. Anda dapat menggunakan flag --update untuk mempertahankan file connections.yaml dan settings.yaml yang sudah ada yang Anda buat di validation_config/. Contoh:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Jika Anda juga memiliki file pemetaan skema tables.yaml dari
penerjemah SQL batch, sertakan flag
--tables-yaml, baik sendiri atau bersama dengan --metadata untuk melengkapi
pemetaan tabel yang diterjemahkan dengan metadata partisi sumber dan pengecualian
jenis data dari arsip metadata. Contoh:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Perintah generate-config mendukung flag berikut:
--metadata PATH_TO_METADATA_ZIP: jalur ke arsip metadata alatdwh-migration-dumper(file ZIP) atau direktori yang berisi arsip metadata.--tables-yaml PATH_TO_TABLES_YAML: jalur ke satu atau beberapa file atau direktori terjemahantables.yaml(dipisahkan koma).--target-dataset TARGET_DATASET: nama set data BigQuery target yang akan diberi awalan ke entritargetTable.nameyang dihasilkan.-o, --output-dir DIRECTORY: direktori output untuk file konfigurasi modular. Nilai defaultnya adalahvalidation_config.--schemas SCHEMA_LIST: daftar skema atau database sumber yang dipisahkan koma untuk disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--tables TABLE_LIST: daftar nama tabel yang dipisahkan koma (TABLE,SCHEMA.TABLE, atauDB.SCHEMA.TABLE) yang akan disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--filter-file PATH: jalur ke file nama tabel yang dibatasi baris baru untuk disertakan (baris yang diawali dengan#akan diabaikan).--update: menggabungkan tabel yang ditemukan ke dalam direktorivalidation_config/yang ada sekaligus mempertahankanconnections.yaml,settings.yaml, dan penggantian kustom per tabel yang ada.--force: memungkinkan penulisan file tabel yang baru ditemukan ke dalam direktori output yang tidak kosong sambil mempertahankan file konfigurasi tabel yang ada.--clean: menghapus semua file yang ada di direktori output sebelum menulis file yang baru ditemukan.
Snowflake
Untuk validasi migrasi Snowflake, lakukan hal berikut untuk membuat arsip metadata alat dwh-migration-dumper dari skema sumber Anda:
- Instal alat
dwh-migration-dumper. - Jalankan
dwh-migration-dumperuntuk database sumber Anda guna menghasilkan arsip metadata alatdwh-migration-dumper.
Dengan arsip metadata, jalankan generate-config untuk membuat file konfigurasi per tabel. Anda dapat menggunakan flag --update untuk mempertahankan file connections.yaml dan settings.yaml yang sudah ada yang Anda buat di validation_config/. Contoh:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Jika Anda juga memiliki file pemetaan skema tables.yaml dari
penerjemah SQL batch, sertakan flag
--tables-yaml, baik sendiri maupun bersama dengan --metadata untuk melengkapi
pemetaan tabel yang diterjemahkan dengan kunci pengelompokan sumber (untuk mempartisi tabel
tanpa kunci utama), metadata partisi fisik, dan pengecualian jenis data
dari arsip metadata. Contoh:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Perintah generate-config mendukung flag berikut:
--metadata PATH_TO_METADATA_ZIP: jalur ke arsip metadata alatdwh-migration-dumper(file ZIP) atau direktori yang berisi arsip metadata.--tables-yaml PATH_TO_TABLES_YAML: jalur ke satu atau beberapa file atau direktori terjemahantables.yaml(dipisahkan koma).--target-dataset TARGET_DATASET: nama set data BigQuery target yang akan diberi awalan ke entritargetTable.nameyang dihasilkan.-o, --output-dir DIRECTORY: direktori output untuk file konfigurasi modular. Nilai defaultnya adalahvalidation_config.--schemas SCHEMA_LIST: daftar skema atau database sumber yang dipisahkan koma untuk disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--tables TABLE_LIST: daftar nama tabel yang dipisahkan koma (TABLE,SCHEMA.TABLE, atauDB.SCHEMA.TABLE) yang akan disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--filter-file PATH: jalur ke file nama tabel yang dibatasi baris baru untuk disertakan (baris yang diawali dengan#akan diabaikan).--update: menggabungkan tabel yang ditemukan ke dalam direktorivalidation_config/yang ada sekaligus mempertahankanconnections.yaml,settings.yaml, dan penggantian kustom per tabel yang ada.--force: memungkinkan penulisan file tabel yang baru ditemukan ke dalam direktori output yang tidak kosong sambil mempertahankan file konfigurasi tabel yang ada.--clean: menghapus semua file yang ada di direktori output sebelum menulis file yang baru ditemukan.
Amazon Redshift
Untuk validasi migrasi Amazon Redshift, lakukan hal berikut untuk membuat file ZIP metadata skema sumber Anda:
- Instal alat
dwh-migration-dumper. - Jalankan
dwh-migration-dumperuntuk database sumber Anda guna menghasilkan arsip metadata alatdwh-migration-dumper.
Dengan arsip metadata, jalankan generate-config untuk membuat file konfigurasi per tabel. Anda dapat menggunakan flag --update untuk mempertahankan file connections.yaml dan settings.yaml yang sudah ada yang Anda buat di validation_config/. Contoh:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Jika Anda juga memiliki file pemetaan skema tables.yaml dari
penerjemah SQL batch, sertakan flag
--tables-yaml, baik sendiri atau bersama dengan --metadata untuk melengkapi
pemetaan tabel yang diterjemahkan dengan metadata partisi sumber dan pengecualian
jenis data dari arsip metadata. Contoh:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Perintah generate-config mendukung flag berikut:
--metadata PATH_TO_METADATA_ZIP: jalur ke arsip metadata alatdwh-migration-dumper(file ZIP) atau direktori yang berisi arsip metadata.--tables-yaml PATH_TO_TABLES_YAML: jalur ke satu atau beberapa file atau direktori terjemahantables.yaml(dipisahkan koma).--target-dataset TARGET_DATASET: nama set data BigQuery target yang akan diberi awalan ke entritargetTable.nameyang dihasilkan.-o, --output-dir DIRECTORY: direktori output untuk file konfigurasi modular. Nilai defaultnya adalahvalidation_config.--schemas SCHEMA_LIST: daftar skema atau database sumber yang dipisahkan koma untuk disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--tables TABLE_LIST: daftar nama tabel yang dipisahkan koma (TABLE,SCHEMA.TABLE, atauDB.SCHEMA.TABLE) yang akan disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--filter-file PATH: jalur ke file nama tabel yang dibatasi baris baru untuk disertakan (baris yang diawali dengan#akan diabaikan).--update: menggabungkan tabel yang ditemukan ke dalam direktorivalidation_config/yang ada sekaligus mempertahankanconnections.yaml,settings.yaml, dan penggantian kustom per tabel yang ada.--force: memungkinkan penulisan file tabel yang baru ditemukan ke dalam direktori output yang tidak kosong sambil mempertahankan file konfigurasi tabel yang ada.--clean: menghapus semua file yang ada di direktori output sebelum menulis file yang baru ditemukan.
Databricks
Pembuatan konfigurasi otomatis tidak didukung untuk Databricks. Buat file
tables.yaml secara manual di direktori validation_config/ dengan
konfigurasi berikut:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
Untuk validasi migrasi Apache Hive, lakukan hal berikut untuk membuat file ZIP metadata skema sumber Anda:
- Instal alat
dwh-migration-dumper. - Jalankan
dwh-migration-dumperuntuk database sumber Anda guna menghasilkan arsip metadata alatdwh-migration-dumper.
Dengan arsip metadata, jalankan generate-config untuk membuat file konfigurasi per tabel. Anda dapat menggunakan flag --update untuk mempertahankan file connections.yaml dan settings.yaml yang sudah ada yang Anda buat di validation_config/. Contoh:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Jika Anda juga memiliki file pemetaan skema tables.yaml dari
penerjemah SQL batch, sertakan flag
--tables-yaml, baik sendiri atau bersama dengan --metadata untuk melengkapi
pemetaan tabel yang diterjemahkan dengan metadata partisi sumber dan pengecualian
jenis data dari arsip metadata. Contoh:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Perintah generate-config mendukung flag berikut:
--metadata PATH_TO_METADATA_ZIP: jalur ke arsip metadata alatdwh-migration-dumper(file ZIP) atau direktori yang berisi arsip metadata.--tables-yaml PATH_TO_TABLES_YAML: jalur ke satu atau beberapa file atau direktori terjemahantables.yaml(dipisahkan koma).--target-dataset TARGET_DATASET: nama set data BigQuery target yang akan diberi awalan ke entritargetTable.nameyang dihasilkan.-o, --output-dir DIRECTORY: direktori output untuk file konfigurasi modular. Nilai defaultnya adalahvalidation_config.--schemas SCHEMA_LIST: daftar skema atau database sumber yang dipisahkan koma untuk disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--tables TABLE_LIST: daftar nama tabel yang dipisahkan koma (TABLE,SCHEMA.TABLE, atauDB.SCHEMA.TABLE) yang akan disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--filter-file PATH: jalur ke file nama tabel yang dibatasi baris baru untuk disertakan (baris yang diawali dengan#akan diabaikan).--update: menggabungkan tabel yang ditemukan ke dalam direktorivalidation_config/yang ada sekaligus mempertahankanconnections.yaml,settings.yaml, dan penggantian kustom per tabel yang ada.--force: memungkinkan penulisan file tabel yang baru ditemukan ke dalam direktori output yang tidak kosong sambil mempertahankan file konfigurasi tabel yang ada.--clean: menghapus semua file yang ada di direktori output sebelum menulis file yang baru ditemukan.
SQL Server
Untuk validasi migrasi SQL Server, lakukan hal berikut untuk
membuat arsip metadata alat dwh-migration-dumper dari skema sumber Anda:
- Instal alat
dwh-migration-dumper. - Jalankan
dwh-migration-dumperuntuk database sumber Anda guna menghasilkan arsip metadata alatdwh-migration-dumper.
Dengan arsip metadata, jalankan generate-config untuk membuat file konfigurasi per tabel. Anda dapat menggunakan flag --update untuk mempertahankan file connections.yaml dan settings.yaml yang sudah ada yang Anda buat di validation_config/. Contoh:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Jika Anda juga memiliki file pemetaan skema tables.yaml dari
penerjemah SQL batch, sertakan flag
--tables-yaml, baik sendiri atau bersama dengan --metadata untuk melengkapi
pemetaan tabel yang diterjemahkan dengan metadata partisi sumber dan pengecualian
jenis data dari arsip metadata. Contoh:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Perintah generate-config mendukung flag berikut:
--metadata PATH_TO_METADATA_ZIP: jalur ke arsip metadata alatdwh-migration-dumper(file ZIP) atau direktori yang berisi arsip metadata.--tables-yaml PATH_TO_TABLES_YAML: jalur ke satu atau beberapa file atau direktori terjemahantables.yaml(dipisahkan koma).--target-dataset TARGET_DATASET: nama set data BigQuery target yang akan diberi awalan ke entritargetTable.nameyang dihasilkan.-o, --output-dir DIRECTORY: direktori output untuk file konfigurasi modular. Nilai defaultnya adalahvalidation_config.--schemas SCHEMA_LIST: daftar skema atau database sumber yang dipisahkan koma untuk disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--tables TABLE_LIST: daftar nama tabel yang dipisahkan koma (TABLE,SCHEMA.TABLE, atauDB.SCHEMA.TABLE) yang akan disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--filter-file PATH: jalur ke file nama tabel yang dibatasi baris baru untuk disertakan (baris yang diawali dengan#akan diabaikan).--update: menggabungkan tabel yang ditemukan ke dalam direktorivalidation_config/yang ada sekaligus mempertahankanconnections.yaml,settings.yaml, dan penggantian kustom per tabel yang ada.--force: memungkinkan penulisan file tabel yang baru ditemukan ke dalam direktori output yang tidak kosong sambil mempertahankan file konfigurasi tabel yang ada.--clean: menghapus semua file yang ada di direktori output sebelum menulis file yang baru ditemukan.
MariaDB
Pembuatan konfigurasi otomatis tidak didukung untuk MariaDB. Buat file
tables.yaml secara manual di direktori validation_config/ dengan
konfigurasi berikut:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
Pembuatan konfigurasi otomatis tidak didukung untuk MySQL. Buat
file tables.yaml secara manual di direktori validation_config/ dengan
konfigurasi berikut:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
Untuk validasi migrasi Oracle, lakukan hal berikut untuk membuat
arsip metadata alat dwh-migration-dumper dari skema sumber Anda:
- Instal alat
dwh-migration-dumper. - Jalankan
dwh-migration-dumperuntuk database sumber Anda guna menghasilkan arsip metadata alatdwh-migration-dumper.
Dengan arsip metadata, jalankan generate-config untuk membuat file konfigurasi per tabel. Anda dapat menggunakan flag --update untuk mempertahankan file connections.yaml dan settings.yaml yang sudah ada yang Anda buat di validation_config/. Contoh:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Jika Anda juga memiliki file pemetaan skema tables.yaml dari
penerjemah SQL batch, sertakan flag
--tables-yaml, baik sendiri atau bersama dengan --metadata untuk melengkapi
pemetaan tabel yang diterjemahkan dengan metadata partisi sumber dan pengecualian
jenis data dari arsip metadata. Contoh:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Perintah generate-config mendukung flag berikut:
--metadata PATH_TO_METADATA_ZIP: jalur ke arsip metadata alatdwh-migration-dumper(file ZIP) atau direktori yang berisi arsip metadata.--tables-yaml PATH_TO_TABLES_YAML: jalur ke satu atau beberapa file atau direktori terjemahantables.yaml(dipisahkan koma).--target-dataset TARGET_DATASET: nama set data BigQuery target yang akan diberi awalan ke entritargetTable.nameyang dihasilkan.-o, --output-dir DIRECTORY: direktori output untuk file konfigurasi modular. Nilai defaultnya adalahvalidation_config.--schemas SCHEMA_LIST: daftar skema atau database sumber yang dipisahkan koma untuk disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--tables TABLE_LIST: daftar nama tabel yang dipisahkan koma (TABLE,SCHEMA.TABLE, atauDB.SCHEMA.TABLE) yang akan disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--filter-file PATH: jalur ke file nama tabel yang dibatasi baris baru untuk disertakan (baris yang diawali dengan#akan diabaikan).--update: menggabungkan tabel yang ditemukan ke dalam direktorivalidation_config/yang ada sekaligus mempertahankanconnections.yaml,settings.yaml, dan penggantian kustom per tabel yang ada.--force: memungkinkan penulisan file tabel yang baru ditemukan ke dalam direktori output yang tidak kosong sambil mempertahankan file konfigurasi tabel yang ada.--clean: menghapus semua file yang ada di direktori output sebelum menulis file yang baru ditemukan.
PostgreSQL
Untuk validasi migrasi PostgreSQL, lakukan hal berikut untuk membuat arsip metadata alat dwh-migration-dumper dari skema sumber Anda:
- Instal alat
dwh-migration-dumper. - Jalankan
dwh-migration-dumperuntuk database sumber Anda guna menghasilkan arsip metadata alatdwh-migration-dumper.
Dengan arsip metadata, jalankan generate-config untuk membuat file konfigurasi per tabel. Anda dapat menggunakan flag --update untuk mempertahankan file connections.yaml dan settings.yaml yang sudah ada yang Anda buat di validation_config/. Contoh:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Jika Anda juga memiliki file pemetaan skema tables.yaml dari
penerjemah SQL batch, sertakan flag
--tables-yaml, baik sendiri atau bersama dengan --metadata untuk melengkapi
pemetaan tabel yang diterjemahkan dengan metadata partisi sumber dan pengecualian
jenis data dari arsip metadata. Contoh:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
Perintah generate-config mendukung flag berikut:
--metadata PATH_TO_METADATA_ZIP: jalur ke arsip metadata alatdwh-migration-dumper(file ZIP) atau direktori yang berisi arsip metadata.--tables-yaml PATH_TO_TABLES_YAML: jalur ke satu atau beberapa file atau direktori terjemahantables.yaml(dipisahkan koma).--target-dataset TARGET_DATASET: nama set data BigQuery target yang akan diberi awalan ke entritargetTable.nameyang dihasilkan.-o, --output-dir DIRECTORY: direktori output untuk file konfigurasi modular. Nilai defaultnya adalahvalidation_config.--schemas SCHEMA_LIST: daftar skema atau database sumber yang dipisahkan koma untuk disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--tables TABLE_LIST: daftar nama tabel yang dipisahkan koma (TABLE,SCHEMA.TABLE, atauDB.SCHEMA.TABLE) yang akan disertakan (peka huruf besar/kecil; mendukung karakter pengganti*).--filter-file PATH: jalur ke file nama tabel yang dibatasi baris baru untuk disertakan (baris yang diawali dengan#akan diabaikan).--update: menggabungkan tabel yang ditemukan ke dalam direktorivalidation_config/yang ada sekaligus mempertahankanconnections.yaml,settings.yaml, dan penggantian kustom per tabel yang ada.--force: memungkinkan penulisan file tabel yang baru ditemukan ke dalam direktori output yang tidak kosong sambil mempertahankan file konfigurasi tabel yang ada.--clean: menghapus semua file yang ada di direktori output sebelum menulis file yang baru ditemukan.
Menyesuaikan setelan tabel
Setiap file tabel yang dihasilkan oleh generate-config berisi bagian table: yang
dapat Anda sesuaikan sebelum menjalankan validasi. Tabel berikut mencantumkan semua kunci opsional yang didukung di setiap entri tabel.
| Kunci YAML opsional | Nilai default | Deskripsi |
|---|---|---|
runSchema, runAggregate, runData |
true |
Boolean per tabel untuk mengaktifkan atau menonaktifkan pilar validasi individual saat tidak ada tanda command line pilar yang diteruskan. |
maxColumnsPerTile |
100 |
Jumlah maksimum kolom yang dikelompokkan ke dalam satu kartu perbandingan pada tabel lebar. |
strategy |
SMART |
Strategi eksekusi validasi data: SMART (BRUTE_FORCE di bawah 100.000 baris,jika tidak, SAMPLE), SAMPLE, atau BRUTE_FORCE. |
sampleSize |
70000 |
Jumlah baris yang akan diekstrak (per slice saat dipartisi) saat strategi yang diselesaikan adalah SAMPLE. Nilai default 70.000 baris memberikan probabilitas lebih dari 99,9% untuk mendeteksi setidaknya satu baris yang tidak cocok jika rasio masalahnya adalah 0,01% (1 dari 10.000 baris) atau lebih tinggi. |
whereClause |
Tidak ada | Predikat SQL (tanpa kata kunci WHERE) yang diterapkan ke kueri ekstraksi sumber dan perbandingan target. Dapat juga ditetapkan secara terpisah di sourceTable.whereClause dan targetTable.whereClause. |
skipRandomization |
false |
Jika true, membaca hingga sampleSize baris dalam urutan tabel alami, bukan mengurutkan berdasarkan fungsi acak, sehingga mengurangi biaya kueri pada tabel besar. |
maxConcurrency |
1 |
Jumlah maksimum thread ekstraksi slice paralel untuk tabel berpartisi. |
maxSlices |
0 (tanpa batas) |
Jumlah maksimum irisan partisi yang diizinkan untuk tabel berpartisi. Jika jumlah slice yang dihitung melebihi maxSlices (jika lebih besar dari 0), perencanaan partisi akan gagal dengan menampilkan error. |
disablePartitioning |
false |
Jika true, menonaktifkan pemisahan berpartisi untuk tabel meskipun blok partitioning dikonfigurasi atau jumlah baris melebihi 1000000. |
labels |
Peta kosong | Label string nilai kunci yang dilampirkan ke metrik operasi validasi di validation_results. |
Bagian berikut menjelaskan cara menggunakan kunci YAML ini untuk menyesuaikan operasi validasi Anda.
Memilih strategi validasi
Gunakan kunci strategy pada entri tabel untuk memilih strategi validasi yang mengontrol cara pilar --data mengekstrak dan membandingkan baris. Nilai-nilai berikut didukung:
SMART(default): menghitung baris dalam tabel sumber terlebih dahulu. Jika tabel memiliki kurang dari 100.000 baris, tabel akan menjalankanBRUTE_FORCE; jika tabel memiliki 100.000 baris atau lebih, tabel akan menjalankanSAMPLE.SAMPLE: mengekstrak sampel baris acak berdasarkan nilaisampleSize(defaultnya adalah70,000) dan menggabungkannya dengan tabel target menggunakancomparisonKeys. Sampel sebanyak 70.000 baris memberikan keyakinan lebih dari 99,9% untuk menemukan setidaknya satu baris yang cacat jika setidaknya 0,01% baris (1 dari 10.000) berisi ketidakcocokan.BRUTE_FORCE: mengekstrak dan membandingkan setiap baris dalam satu pass kueri yang tidak dipartisi. Setelan partisi diabaikan saatBRUTE_FORCEdigunakan.
Mengonfigurasi kunci perbandingan
Kunci perbandingan adalah kolom yang digunakan untuk mengidentifikasi dan menggabungkan baris secara unik antara sistem sumber dan target. Kunci perbandingan menjelaskan atribut yang memberikan keunikan yang memadai untuk penggabungan yang stabil.
Saat menjalankan perbandingan data tingkat baris, Anda dapat mengonfigurasi kunci perbandingan dengan cara berikut:
- Penemuan otomatis: hapus
comparisonKeysdari bagiansourceTableagar alat validasi otomatis mendeteksi kunci utama di database sumber Anda selama pre-flight (kembali ke batasan unikNOT NULLdi Oracle dan Snowflake, indeks unik di Teradata, atauDISTKEYatauSORTKEYsatu kolom di Amazon Redshift). Kunci gabungan atau kustom manual: tentukan kunci perbandingan gabungan atau kustom secara manual dengan mencantumkan nama kolom kunci sumber di
comparisonKeysdi bagiansourceTable. Perbedaan huruf antara nama kolom kunci sumber dan target dicocokkan secara otomatis; jika kolom kunci perbandingan diganti namanya di BigQuery, petakan di bagiancolumnSettings.columns.SOURCE_COLUMN.targetColumn. Contoh berikut mengonfigurasi kunci perbandingan gabungan:table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
Perbandingan hash untuk tabel tanpa kunci unik: jika tabel tidak memiliki kunci utama, di bagian
sourceTable, tetapkanuseAllColumnsAsKey: true. Opsi ini juga dipilih secara otomatis saat pemeriksaan metadata pra-penerbangan tidak menemukan kunci utama.
Mengonfigurasi ekstraksi berpartisi untuk tabel besar
Jika strategi tabel ditetapkan ke SAMPLE dan blok partitioning ada dalam konfigurasi tabel (yang ditulis generate-config secara default) atau jumlah baris tabel melebihi 1,000,000, alat validasi akan membagi tabel menjadi beberapa bagian sehingga kueri pengambilan sampel memindai rentang yang dibatasi, bukan mengurutkan seluruh tabel sekaligus. Saat dipartisi, hingga sampleSize baris
akan diekstrak per slice. Untuk membatasi validasi ke subset baris, gunakan
whereClause.
Untuk mengonfigurasi ekstraksi yang dipartisi, gunakan blok partitioning
di bagian table:. Contoh:
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
Blok partitioning mendukung kolom berikut:
type:INTEGER_RANGE: membagi tabel menjadi interval nilai kunci numerik (COLUMN BETWEEN START AND END). Ini adalah nilai default.DATE_RANGE: membagi tabel menjadi interval tanggal atau stempel waktu. Didukung untuk PostgreSQL dan Snowflake.PHYSICAL: menggunakan partisi database untuk tabel Oracle dan Amazon Redshift saat metadata partisi fisik ada.
column: menentukan kolom numerik, tanggal, atau stempel waktu yang diindeks pada tabel sumber yang digunakan untuk menghitung batas slice. Baris dengan nilaiNULLdalam kolom partisi dikecualikan dari slice berbasis rentang (INTEGER_RANGEdanDATE_RANGE).partitionSize: untuk jenisINTEGER_RANGE, nilai ini menentukan lebar rentang nilai kunci numerik per slice, dengan nilai default adalah1000000. Untuk jenisDATE_RANGE, nilai ini menentukan jumlah hari per slice, dengan nilai default30.maxSlices: menentukan jumlah total maksimum irisan yang diizinkan untuk tabel (ditetapkan di bagiantable:). Jika tabel memerlukan lebih banyak irisan daripadamaxSlices, perencanaan partisi akan gagal dengan error yang memerlukanpartitionSizeataumaxSlicesyang lebih besar.maxConcurrency: menentukan jumlah thread pekerja paralel yang digunakan untuk mengekstrak slice, dengan nilai default1. Ditetapkan di bagiantable:.
Menyesuaikan pemeriksaan gabungan
Analisis gabungan diaktifkan secara default dan melengkapi pengambilan sampel tingkat baris dengan pemeriksaan gabungan tingkat makro. Konfigurasi ini berguna untuk memvalidasi tabel besar yang pengambilan sampel acaknya mungkin melewatkan kecondongan data yang tidak kentara.
Tanpa konfigurasi kolom kustom, alat validasi akan otomatis menerapkan pemeriksaan agregat standar berdasarkan jenis kolom:
- Numerik persis (
INTEGER,NUMERIC,BIGNUMERIC):COUNT,SUM,AVG,MIN,MAX - Floating point (
FLOAT,DOUBLE,REAL):COUNT,MIN,MAX - Boolean (
BOOLEAN):COUNT,COUNT_TRUE,COUNT_FALSE,COUNT_NULL - String (
STRING,VARCHAR,CHAR,TEXT):COUNT,SUM_LENGTH - Tanggal, waktu, dan stempel waktu:
COUNT,MIN,MAX
Anda dapat menyesuaikan atau menonaktifkan pemeriksaan gabungan menggunakan bagian columnSettings. Contoh berikut menunjukkan cara
mengonfigurasi toleransi agregat dan mengganti pemeriksaan kolom tertentu:
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
Aturan konfigurasi gabungan berikut berlaku:
- Kunci kolom di bagian
columnSettings.columnsharus cocok dengan nama kolom sumber dengan peka huruf besar/kecil. toleranceagregat adalah nilai minimum perbedaan absolut (ABS(target - source) <= tolerance). Jika tidak adatoleranceagregat yang ditetapkan (di tingkat kolom ataucolumnSettings.aggregate.tolerance) dan kolom memiliki setelantolerances.numerictingkat baris,AVG,MIN, danMAXmewarisitolerances.numericsecara langsung, sedangkanSUMmengalikan toleransi tingkat baris yang diwarisi denganCOUNT.- Anda hanya dapat mengganti
functionsper kolom di bagiancolumnSettings.columns.SOURCE_COLUMN.aggregate.functions.
Mengecualikan kolom, memetakan nama kolom, dan menerapkan ekspresi perbandingan SQL
Anda dapat menggunakan columnSettings untuk mengecualikan kolom, menetapkan toleransi numerik atau temporal, memetakan kolom target yang diganti namanya, atau menerapkan transformasi SQL sebelum perbandingan. Setiap kunci di bagian
columnSettings.columns adalah nama kolom sumber. Gunakan properti targetColumn di dalam entri tersebut jika kolom memiliki nama yang berbeda di BigQuery. Contoh:
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings mendukung kolom berikut:
exclude: menentukan daftar nama kolom yang tidak peka huruf besar/kecil atau pola glob (*) yang akan dikecualikan dari semua pilar validasi.tolerances:numeric: toleransi untuk kolom numerik (ABS(target - source) <= toleranceuntuk perbandingan berbasis kunci, atau dibulatkan keceil(-log10(tolerance))tempat desimal saatuseAllColumnsAsKey: true).timestamp: toleransi dalam detik untuk kolom stempel waktu. Misalnya,0.001selama 1 milidetik.date: toleransi dalam hari untuk kolom tanggal.
columns: peta setelan per kolom yang di-key berdasarkan nama kolom source (SOURCE_COLUMN):targetColumn: memetakan kolom sumber ke kolom target dengan nama berbeda di BigQuery.transform: transformasi bawaan yang diterapkan sebelum perbandingan:TRIM,UPPER,LOWER: didukung di semua dialek.EMPTY_TO_NULL,NULL_TO_EMPTY,CAST_TO_STRING: didukung pada kueri sumber untuk sumber PostgreSQL, Amazon Redshift, Oracle, dan Teradata.
transformExpression: ekspresi SQL kustom yang merujuk ke nama kolom sumber literal. Misalnya,"ROUND(SOURCE_COLUMN, 4)". Karena ekspresi dievaluasi pada kueri sumber dan kueri perbandingan BigQuery, gunakan fungsi SQL yang valid dalam dialek sumber dan GoogleSQL.
Normalisasi nilai
Selama perbandingan tingkat baris (--data), layanan validasi
menormalisasi nilai sehingga perbedaan representasi antara mesin sumber
dan BigQuery tidak menyebabkan ketidakcocokan. Layanan validasi
menormalisasi nilai dengan cara berikut:
- Jenis numerik persis (
INTEGER,NUMERIC,DECIMAL,BIGNUMERIC): dalam perbandingan berbasis kunci, nilai dibandingkan dalam skala penuh (hingga 9 tempat desimal untukNUMERIC, atau hingga 38 tempat desimal untukBIGNUMERIC), dan saattolerances.numericditetapkan, nilai akan cocok jikaABS(target - source) <= tolerance. Dalam perbandingan hash baris penuh (useAllColumnsAsKey: true), nilai dibulatkan ke 9 angka desimal secara default, atau keceil(-log10(tolerance))angka desimal saat toleransi numerik ditetapkan. - Jenis floating point (
FLOAT,DOUBLE,REAL): dinormalisasi menjadi 6 tempat desimal (1e-6) secara default. - Stempel waktu: dinormalisasi ke UTC dengan presisi mikrodetik.
- Jenis karakter dengan lebar tetap (
CHAR,NCHAR,CHARACTER): spasi di awal dan akhir akan otomatis dipangkas agar sesuai dengan semantikSTRINGBigQuery.
Menjalankan layanan validasi
Setelah menyiapkan konfigurasi validasi, jalankan perintah validate
untuk memulai alat validasi migrasi. Anda dapat meneruskan jalur lokal atau URI gs:// Cloud Storage yang mengarah ke direktori validation_config/.
Contoh berikut menjalankan layanan validasi pada file konfigurasi validasi yang disimpan secara lokal:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
Ganti PATH_TO_VALIDATION_CONFIG dengan jalur ke
direktori validation_config/ modular Anda.
Jika konfigurasi validasi Anda disimpan di Cloud Storage, teruskan URI gs://
direktori konfigurasi:
gcloud bq migration validate gs://BUCKET_NAME/validation_config
Ganti BUCKET_NAME dengan nama bucket Cloud Storage Anda.
Secara default, layanan validasi menjalankan layanan validasi di ketiga pilar validasi:
--schema: hanya memvalidasi skema--aggregate: hanya memvalidasi agregat--data: hanya memvalidasi data tingkat baris
Anda dapat menjalankan layanan validasi pada pilar validasi tertentu menggunakan
flag pilar. Contoh berikut menjalankan validasi skema dan agregat pada dua tabel tertentu dengan filter WHERE kustom:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
Perintah validate mendukung flag opsional berikut:
--tableatau--tables: comma separated list nama tabel yang akan divalidasi. Pencocokan--tablespeka huruf besar/kecil dan harus cocok dengan huruf yang digunakan disourceTable.nameatautargetTable.name.--where SQL_PREDICATE: menggantiwhereClauseuntuk tabel sumber dan target selama operasi ini.--source-where SQL_PREDICATE: menggantiwhereClausehanya untuk tabel sumber.--target-where SQL_PREDICATE: menggantiwhereClausehanya untuk tabel target.--gcs-path: penggantiangoogleCloudStorage.gcsPath. Misalnya,--gcs-path gs://my-bucket/validation.--max-concurrency,--concurrency, atau--threads: menggantimaxConcurrencyuntuk ekstraksi slice paralel.--no-partitionatau--disable-partitioning: menonaktifkan ekstraksi slice yang dipartisi untuk semua tabel dalam operasi.--labels KEY=VALUE[,KEY=VALUE...]: melampirkan label nilai kunci kustom ke hasil operasi.--output-dir: direktori lokal untuk metadata operasi sementara dan file status. Nilai defaultnya adalah/tmp/validation_outputs.-v,--verbose,-d, atau--debug: mengaktifkan logging panjang atau log debug.
Peralihan alur kerja asinkron
validate melakukan ekstraksi sumber secara sinkron, lalu memicu alur kerja BigQuery Migration Service asinkron untuk setiap tabel.
Jika set data target Anda berada di lokasi selain
us, misalnya,eu, tetapkan variabel lingkunganBQMS_VALIDATION_LOCATIONsebelum menjalankanvalidate:export BQMS_VALIDATION_LOCATION=LOCATION
Untuk setiap tabel, pastikan output menyertakan baris
Workflow:yang berisi nama resource alur kerja yang dibuat. Contoh:Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
Kode keluar
0menunjukkan bahwa ekstraksi dan upload sumber berhasil, bukan bahwa perbandingan target telah selesai atau data cocok. Jika pembuatan alur kerja gagal, misalnya, karena izin yang tidak ada, CLI akan mencatat peringatan bahwa pemicuan alur kerja validasi gagal, mencetak perintah penggantiangcloudmanual, dan menghilangkan barisWorkflow:meskipun prosesnya keluar dengan0.
Melihat hasil validasi
Setelah operasi validasi selesai, lihat hasil validasi di
konsolGoogle Cloud dengan mengkueri set data hasil validation_results, dengan
mengkueri set data BigQuery yang dikonfigurasi di bagian results di
settings.yaml, atau dengan membaca laporan ringkasan di
Cloud Storage. Pilih salah satu opsi berikut:
Konsol Google Cloud
Buka halaman Migration services di konsol Google Cloud .
Di bagian Validate Migration, klik View recent.
Klik Select a project, lalu pilih project tempat set data
validation_resultsdisimpan.
GoogleSQL
Buat kueri TARGET_PROJECT_ID.validation_results.run_history untuk memeriksa
status operasi validasi terbaru:
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
Ganti TARGET_PROJECT_ID dengan ID project tempat set data validation_results disimpan.
Untuk mengetahui metrik per kolom dan tren historis yang mendetail, buat kueri dengan perintah berikut:
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: jumlah ketidakcocokan per operasi, per kolom, perbandingan gabungan, dan status lulus atau gagal<var>TARGET_PROJECT_ID</var>.validation_results.column_history: histori audit kolom longitudinal di seluruh operasi<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: baris dan kolom yang dijadikan sampel dengan nilai sumber dan target yang berbeda
Laporan Cloud Storage
Setiap operasi yang selesai akan menulis artefak laporan berikut ke direktori gcs_uri operasi (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/):
validation_summary.txt: ringkasan eksekutif hasil perbandingan skema, agregat, dan bariscolumn_details.txt: perincian per kolom untuk ketidakcocokan dan perbedaan agregatresults.json: laporan JSON terstruktur dari semua temuan validasiqueries.sql: kueri SQL persis yang dijalankan selama proses validasi
Untuk mencetak laporan ringkasan untuk suatu operasi, jalankan perintah berikut:
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
Menafsirkan hasil validasi
Setiap operasi validasi di validation_results.run_history melaporkan salah satu
nilai status eksekusi, atau status, berikut:
| Status | Deskripsi | Tindakan yang disarankan |
|---|---|---|
IN_PROGRESS |
Alur kerja validasi masih berjalan di BigQuery. | Tunggu hingga finished_at terisi, lalu buat kueri run_history lagi. |
COMPLETED |
Pipeline validasi selesai tanpa ketidakcocokan data tingkat baris atau agregat. Detail kompatibilitas jenis skema dicatat secara terpisah di validation_summary.txt dan column_history. |
Tindakan tidak diperlukan. Tabel lulus validasi. |
HEALED |
Pipeline validasi selesai tanpa baris yang hilang, dan semua perbedaan nilai yang terdeteksi adalah jitter representasi floating point mikroskopis (< 1e-4 untuk perbandingan tingkat sel dan < 1e-6 untuk agregat) yang otomatis direkonsiliasi oleh validator. |
Diperlakukan sebagai operasi yang lulus. Anda dapat mengonfigurasi tolerance numerik eksplisit jika ingin menyembunyikan jitter upstream. |
COMPLETED_WITH_MISMATCHES |
Pipeline validasi dijalankan sepenuhnya dan menemukan baris yang tidak ada, kolom target yang tidak ada, perbedaan agregat, atau perbedaan data tingkat sel antara tabel sumber dan target. Hal ini menunjukkan bahwa proses validasi telah selesai, bukan sistem mengalami error. | Periksa column_details.txt, run_metrics, dan run_RUN_ID_mismatches_details untuk meninjau kolom dan baris yang tidak cocok. Untuk mengetahui informasi selengkapnya, lihat Jenis ketidakcocokan tingkat kolom. |
ERROR |
Pipeline validasi gagal diselesaikan karena error sistem atau konfigurasi. Misalnya, karena tabel target tidak ada, error izin, atau SQL tidak valid dalam whereClause atau transformExpression kustom. |
Periksa kolom error_message di run_history. Untuk mengetahui informasi selengkapnya tentang cara menyelesaikan error umum, lihat Pemecahan masalah. |
Jenis ketidakcocokan tingkat kolom
Saat operasi selesai dengan COMPLETED_WITH_MISMATCHES, tabel ketidakcocokan per operasi
mengklasifikasikan setiap perbandingan kolom dengan salah satu hasil berikut:
EXACT_MATCH: nilai sel yang dibandingkan untuk kolom cocok dalam toleransi yang dikonfigurasiDATA_DRIFT: baris cocok dicomparisonKeys, tetapi nilai sel berbeda di luar toleransi yang dikonfigurasiSCHEMA: kolom ada di tabel sumber, tetapi tidak ada di tabel targetROW: baris sumber tidak ada di tabel target, atau baris target tidak ada di tabel sumber, saat digabungkan dicomparisonKeys
Memecahkan masalah error umum
Tabel berikut mencantumkan error command line dan alur kerja yang umum serta cara mengatasinya:
| Pesan atau masalah error | Penyebab | Resolusi |
|---|---|---|
Failed to load or parse YAML |
Blok tabel, partitioning, columnSettings, atau googleCloudStorage berisi kunci yang tidak dikenali atau nilai enum yang tidak valid, seperti SAMPLING, bukan SAMPLE. |
Verifikasi indentasi YAML dan nama kolom terhadap opsi setelan tabel. |
Connection name '...' is invalid. Must be alphanumeric. |
Nama profil di bagian connections: berisi garis bawah atau tanda hubung. Contoh, my_source. |
Ganti nama profil koneksi menjadi nama alfanumerik seperti source dan target. |
googleCloudStorage cannot be null |
googleCloudStorage.gcsPath tidak ada di validation_config/settings.yaml dan --gcs-path tidak diteruskan. |
Tetapkan googleCloudStorage.gcsPath: gs://BUCKET/PREFIX tanpa garis miring di akhir di validation_config/settings.yaml. |
Target discovery directory 'validation_config/' is non-empty |
generate-config dijalankan tanpa --update, --force, atau --clean saat validation_config/ sudah berisi file YAML. |
Teruskan --update untuk menggabungkan tabel yang ditemukan sambil mempertahankan connections.yaml dan settings.yaml yang ada. |
tables is required saat menjalankan validate |
File validation-config.yaml lama tanpa daftar tables: ada di direktori kerja dan lebih diprioritaskan daripada validation_config/, atau tidak ada file YAML tabel di validation_config/. |
Hapus file validation-config.yaml yang tidak diperlukan di direktori kerja Anda agar validate memuat validation_config/. |
| Error preflight pada satu kunci perbandingan dengan kardinalitas rendah | Tabel dengan lebih dari 1.000 baris yang difilter dikonfigurasi dengan satu kunci perbandingan kardinalitas rendah, yang akan menyebabkan ledakan penggabungan many-to-many. | Tentukan semua kolom yang membentuk kunci komposit unik di comparisonKeys, atau tetapkan useAllColumnsAsKey: true di bagian sourceTable. |
Failed to initialize MemoryUtil atau InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
JVM adalah Java 17 atau yang lebih baru dan dimulai tanpa --add-opens=java.base/java.nio=ALL-UNNAMED, biasanya karena command line diluncurkan melalui wrapper kustom atau langsung dengan java -jar. |
Tetapkan JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" di lingkungan, atau gunakan perintah gcloud bq migration validate. |
WARNING: Failed to trigger validation workflow |
Ekstraksi sumber berhasil, tetapi pemanggilan CreateMigrationWorkflow gagal karena izin IAM tidak ada, API tidak diaktifkan, atau lokasi tidak didukung. |
Pastikan bigquerymigration.googleapis.com diaktifkan, akun Anda memiliki roles/bigquerymigration.editor, dan BQMS_VALIDATION_LOCATION cocok dengan lokasi set data Anda. |
Membersihkan artefak validasi
Untuk mengelola biaya penyimpanan setelah meninjau hasil validasi, lakukan hal berikut:
- Di Cloud Storage, hapus direktori operasi lama di bawah awalan
gcsPathdi bucket staging Anda, atau konfigurasikan aturan Object Lifecycle Management di bucket. - Di BigQuery, tabel perbandingan per operasi dalam set data hasil Anda
(
validation_resultssecara default) akan otomatis berakhir setelahresultTtlHours(168.0jam, atau 7 hari, secara default). SesuaikanresultTtlHoursdisettings.yamluntuk mempersingkat atau memperpanjang retensi, atau hapus tabel per operasi secara manual sambil membiarkan tabel dan tampilan histori bersama (run_history,run_metrics, dancolumn_history) tetap utuh. - Saat menggunakan file lokal, hapus direktori kerja lokal yang ditulis oleh
alat validasi di bagian
--output-dir. Direktori default-nya adalah/tmp/validation_outputs.
Harga
Layanan validasi menggunakan resource berikut dalam project Anda:
- Komputasi dan penyimpanan BigQuery: kueri agregat target,
gabungan perbandingan baris, dan penyimpanan untuk tabel dalam set data
validation_resultsditagih ke project Google Cloud Anda, ataubillingProjectIdjika dikonfigurasi pada koneksitarget, sesuai dengan harga BigQuery standar. - Penyimpanan dan jaringan Cloud Storage: file contoh Parquet atau CSV yang di-stage dan laporan hasil di bucket Anda ditagih sesuai dengan harga Cloud Storage standar.
- Source database load: kueri ekstraksi dijalankan langsung terhadap database sumber Anda. Untuk meminimalkan beban pada tabel sumber yang besar, gunakan
strategy: SAMPLE, filter denganwhereClause, atau tetapkanskipRandomization: truejika overhead pengurutan acak tidak diinginkan.
Langkah berikutnya
- Pelajari cara membuat metadata untuk terjemahan dan penilaian
menggunakan alat
dwh-migration-dumper. - Terjemahkan kueri SQL dalam batch untuk mengonversi skrip SQL sumber dan DDL Anda ke GoogleSQL.
- Rencanakan migrasi dengan silsilah migrasi untuk memvisualisasikan dependensi data di data warehouse sumber Anda.