


Valider la migration de votre entrepôt de données
Le service de validation du service de migration BigQuery vous permet de vérifier que les tables migrées depuis votre entrepôt de données source correspondent à vos tables cibles dans BigQuery. Vous pouvez comparer les schémas et les données des tables pour identifier les écarts lors de la migration.
Le client du service de validation se connecte à votre base de données source, puis extrait le schéma source et les données de ligne vers un bucket Cloud Storage que vous contrôlez. Une fois l'extraction terminée, le service de validation compare le schéma et les données extraits dans le bucket Cloud Storage à vos tables BigQuery migrées.
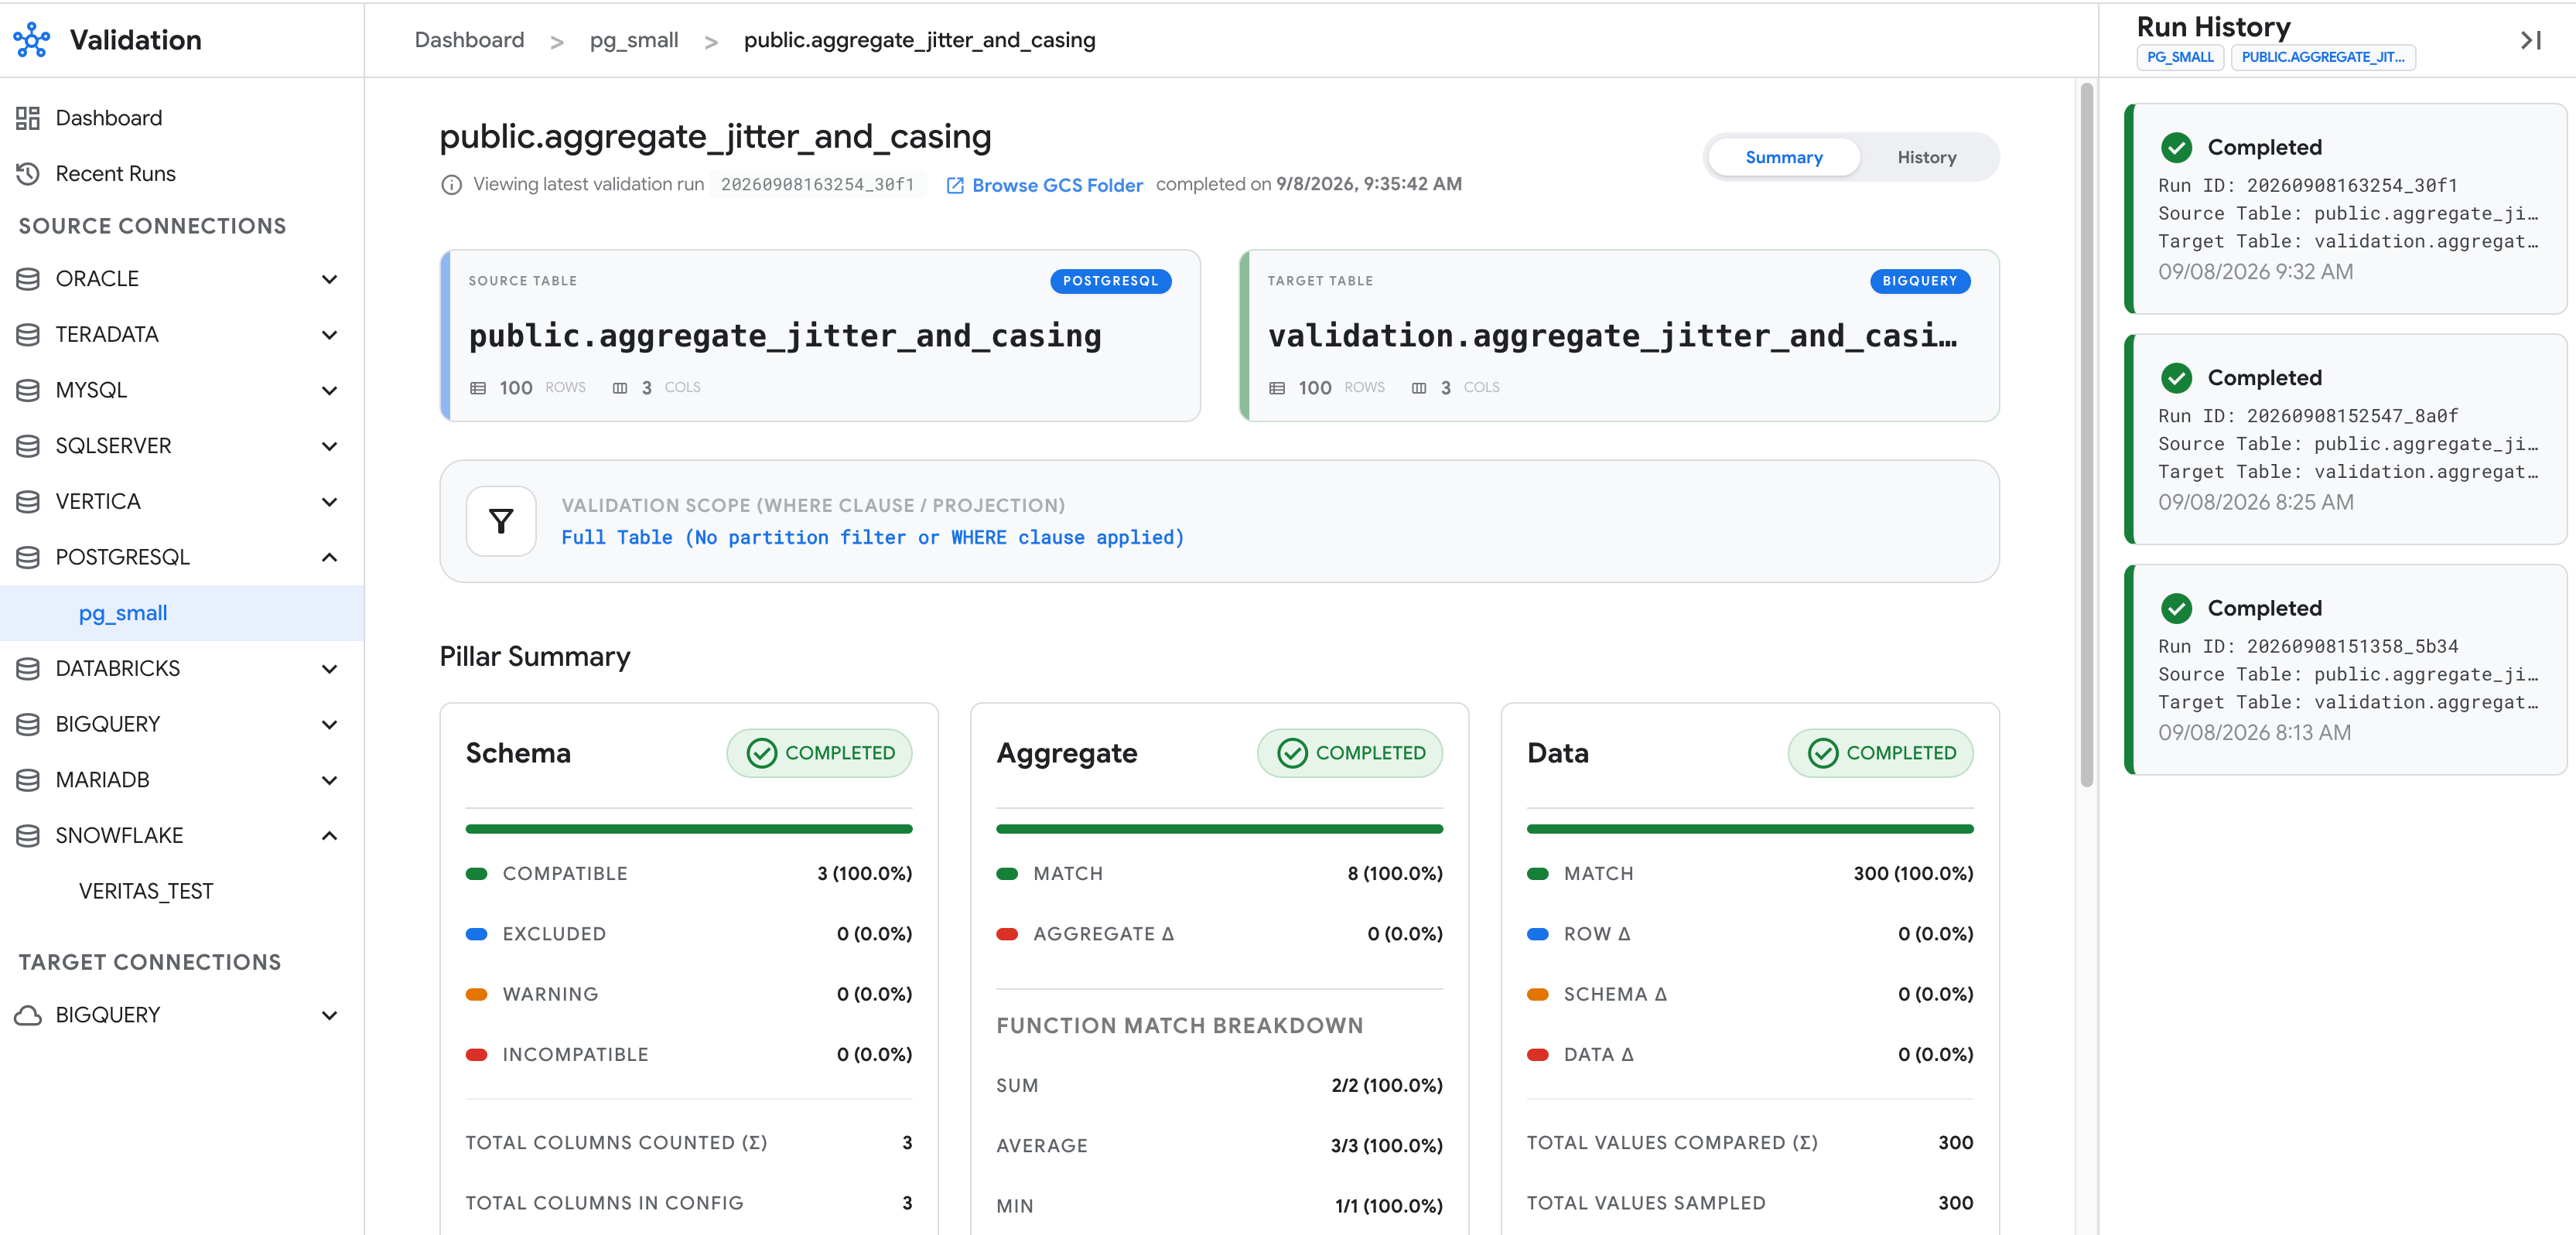
Un workflow de validation compare vos tables sources et vos tables BigQuery cibles selon trois piliers de validation :
- Validation du schéma (
--schema) : compare les noms de colonnes, les types de données et la compatibilité des types entre votre table source et votre table BigQuery cible. - Validation d'agrégation (
--aggregate) : calcule et compare les métriques d'agrégation au niveau de la table et de la colonne (par exemple, le nombre de lignes,SUM,AVG,MIN,MAX, les distributions booléennes et les longueurs de chaîne) sur l'ensemble de la table. - Validation des données (
--data) : effectue une comparaison ligne par ligne à l'aide d'une analyse exhaustive de la table complète (BRUTE_FORCE) ou d'un échantillonnage aléatoire basé sur des clés (SAMPLE) pour détecter les lignes manquantes et la dérive des valeurs au niveau des cellules.
Pays acceptés
Le service de validation est disponible dans certains pays. Pour en savoir plus, consultez Emplacements du service de migration BigQuery.
Points à prendre en compte concernant la gestion et la sécurité des données
Le service de validation extrait et prépare différentes données en fonction du pilier de validation que vous exécutez :
- Validation du schéma (
--schema) : n'importe que les noms de colonnes, les types de données et les statistiques de table dans le fichiersource_query_result.json, sans extraire les valeurs des cellules. - Validation agrégée (
--aggregate) : importe les métriques agrégées calculées dans le fichiersource_aggregates.parquet, y compris les valeurs de celluleMINetMAXréelles des colonnes incluses. - Validation des données (
--data) : extrait les valeurs brutes non masquées des cellules à partir des lignes échantillonnées ou de toutes les lignes lorsque vous utilisez la stratégieBRUTE_FORCE. Il importe ces valeurs au format Apache Parquet ou CSV dans votre bucket de préproduction Cloud Storage, puis les charge dans l'ensemble de donnéesvalidation_resultsdans BigQuery.
Pour protéger vos données et sécuriser votre environnement de validation, configurez les paramètres suivants :
- Exclure les colonnes sensibles : ajoutez des colonnes sensibles au champ
columnSettings.excludepour les omettre des requêtes d'extraction source, des comparaisons cibles et des rapports de validation. - Réduire le stockage local des données : définissez le champ
googleCloudStorage.gcsPathdans le fichiersettings.yamlpour diffuser les lignes échantillonnées directement dans Cloud Storage sans les écrire sur le disque local. Sur les hôtes partagés, supprimez le répertoire de travail--output-dirlocal après chaque exécution pour supprimer les métadonnées, les agrégats et les fichiers journaux locaux. - Chiffrer les données et les résultats de préproduction : configurez des clés de chiffrement gérées par le client (CMEK) avec Cloud Key Management Service sur votre bucket de préproduction Cloud Storage et votre ensemble de données de résultats BigQuery (
validation_resultspar défaut, ou l'ensemble de données spécifié dans le champresults.dataset) avant d'exécuter la validation. - Limiter l'accès à la configuration : stockez les fichiers de configuration de validation dans un dépôt contrôlé par version qui nécessite une revue de code, ou dans un bucket Cloud Storage où seuls les utilisateurs de confiance disposent de l'autorisation
storage.objects.create. - Appliquez le principe du moindre privilège : n'accordez au créateur du workflow le rôle
roles/bigquery.dataViewerque sur les ensembles de données ou les tables cibles en cours de validation, et non sur le projet. Utilisez un utilisateur de base de données source en lecture seule, comme décrit dans Configurer les droits d'accès à la base de données source.
Avant de commencer
Dans la console Google Cloud , sur la page de sélection du projet, sélectionnez ou créez un projet Google Cloud contenant vos ensembles de données BigQuery cibles.
Vérifiez que la facturation est activée pour votre projet Google Cloud .
Activez les API BigQuery, BigQuery Migration Service, Cloud Storage et Secret Manager (si vous stockez les mots de passe de base de données dans Secret Manager).
Créez ou sélectionnez un bucket Cloud Storage au même emplacement que votre ensemble de données BigQuery cible pour stocker les métadonnées et les échantillons de données extraits. Pour en savoir plus, consultez Créer un bucket.
Rôles et autorisations nécessaires
Une exécution de validation comporte trois parties, chacune pouvant être effectuée par un compte principal différent :
- Collecte de données : le client de validation lit votre base de données source et importe les métadonnées, les agrégats et les lignes échantillonnées dans votre bucket de préproduction Cloud Storage. Il n'appelle pas BigQuery.
- Validation : un workflow de validation du service de migration BigQuery compare les données de préproduction à vos tables cibles. Le workflow s'exécute avec les identifiants du compte principal qui l'a créé, qu'il s'agisse du client de validation, de
gcloudou de la console Google Cloud . - Affichage des résultats : lecture de l'ensemble de données de résultats et des rapports Cloud Storage.
generate-config ne nécessite aucune Google Cloud autorisation.
Collecte des données
Pour obtenir les autorisations nécessaires pour collecter des données sources, demandez à votre administrateur de vous accorder les rôles IAM suivants :
- Créateur d'objets Storage (
roles/storage.objectCreator) sur le bucket de préproduction - Lecteur des objets Storage (
roles/storage.objectViewer) sur le bucket de préproduction -
Lire les fichiers de configuration depuis Cloud Storage : Lecteur des objets Storage (
roles/storage.objectViewer) sur le bucket de configuration -
Lire les mots de passe de la base de données depuis Secret Manager : Accesseur de secrets Secret Manager (
roles/secretmanager.secretAccessor) sur le secret
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Ces rôles prédéfinis contiennent les autorisations requises pour collecter les données sources. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Les autorisations suivantes sont requises pour collecter les données sources :
-
storage.objects.createsur le bucket de préproduction -
storage.objects.getsur le bucket de préproduction -
Lire les fichiers de configuration à partir de Cloud Storage :
-
storage.objects.getsur le bucket de configuration -
storage.objects.listsur le bucket de configuration
-
-
Lire les mots de passe de la base de données depuis Secret Manager :
secretmanager.versions.accesssur le secret
Vous pouvez également obtenir ces autorisations avec des rôles personnalisés ou d'autres rôles prédéfinis.
Avec --extract-only, la collecte de données ne nécessite aucune autorisation BigQuery ni du service de migration BigQuery. Sans cela, le client crée également les workflows de validation et a besoin des rôles de validation.
Validation
Pour obtenir les autorisations nécessaires pour créer et exécuter des workflows de validation, demandez à votre administrateur de vous accorder les rôles IAM suivants :
- Éditeur d'objets MigrationWorkflow (
roles/bigquerymigration.editor) sur le projet - Utilisateur de job BigQuery (
roles/bigquery.jobUser) sur le projet - Lecteur de données BigQuery (
roles/bigquery.dataViewer) sur chaque ensemble de données cible - Éditeur de données BigQuery (
roles/bigquery.dataEditor) sur l'ensemble de données de résultats - Utilisateur d'objets Storage (
roles/storage.objectUser) sur le bucket de préproduction -
Si l'ensemble de données de résultats n'existe pas : Utilisateur BigQuery (
roles/bigquery.user) sur le projet
Ces rôles prédéfinis contiennent les autorisations requises pour créer et exécuter des workflows de validation. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Les autorisations suivantes sont requises pour créer et exécuter des workflows de validation :
bigquerymigration.workflows.createsur le projetbigquerymigration.workflows.getsur le projetbigquery.jobs.createsur le projet-
bigquery.tables.getsur chaque ensemble de données cible -
bigquery.tables.getDatasur chaque ensemble de données cible -
bigquery.datasets.getsur l'ensemble de données de résultats -
bigquery.tables.getsur l'ensemble de données de résultats -
bigquery.tables.createsur l'ensemble de données de résultats -
bigquery.tables.updatesur l'ensemble de données de résultats -
bigquery.tables.updateDatasur l'ensemble de données de résultats -
bigquery.tables.getDatasur l'ensemble de données de résultats -
storage.objects.getsur le bucket de préproduction -
storage.objects.createsur le bucket de préproduction -
storage.objects.deletesur le bucket de préproduction -
Si l'ensemble de données de résultats n'existe pas :
bigquery.datasets.createsur le projet
roles/bigquerymigration.editor contient de nombreuses autorisations que la validation n'utilise pas. Pour appliquer le principe du moindre privilège, attribuez un rôle personnalisé avec uniquement bigquerymigration.workflows.create et bigquerymigration.workflows.get.
La validation ne lit que vos tables cibles et n'écrit que dans l'ensemble de données de résultats. Nous vous recommandons de créer l'ensemble de données de résultats à l'avance afin qu'aucun compte principal n'ait besoin d'une autorisation pour créer des ensembles de données dans votre projet.
Afficher les résultats
Pour obtenir les autorisations nécessaires pour afficher les résultats de la validation, demandez à votre administrateur de vous accorder les rôles IAM suivants :
- Utilisateur de job BigQuery (
roles/bigquery.jobUser) sur le projet contenant l'ensemble de données de résultats - Lecteur de données BigQuery (
roles/bigquery.dataViewer) sur l'ensemble de données de résultats -
Lire les rapports dans Cloud Storage : Lecteur des objets Storage (
roles/storage.objectViewer) sur le bucket de préproduction -
Lister et afficher les workflows de validation dans la console Google Cloud : Lecteur d'objets MigrationWorkflow (
roles/bigquerymigration.viewer) sur le projet
Ces rôles prédéfinis contiennent les autorisations requises pour afficher les résultats de la validation. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Les autorisations suivantes sont requises pour afficher les résultats de la validation :
bigquery.jobs.createsur le projet-
bigquery.tables.getsur l'ensemble de données de résultats -
bigquery.tables.getDatasur l'ensemble de données de résultats -
Lire les rapports dans Cloud Storage :
-
storage.objects.getsur le bucket de préproduction -
storage.objects.listsur le bucket de préproduction
-
-
Répertoriez et affichez les workflows de validation dans la console Google Cloud :
bigquerymigration.workflows.listsur le projetbigquerymigration.workflows.getsur le projet
Configurer les droits d'accès à la base de données source
Vous devez configurer l'accès en lecture seule à l'utilisateur de la base de données source avec les droits suivants :
SELECTsur chaque table source en cours de validation.- Accès en lecture aux vues du catalogue système utilisées pour la découverte des schémas et des clés primaires (telles que les tables
information_schema,ALL_CONSTRAINTSetALL_TAB_COLUMNSsur Oracle, ouSVV_COLUMNSetpg_attributesur Amazon Redshift).
N'accordez pas de droits d'écriture, de LDD ou de droits d'administrateur à cet utilisateur. Le client de validation exécute le code SQL à partir de votre configuration de validation en tant que cet utilisateur. Pour en savoir plus, consultez Considérations relatives au traitement et à la sécurité des données.
Limites
Le service de validation est soumis aux limites suivantes :
- BigQuery est la seule base de données cible compatible. La validation entre deux bases de données non BigQuery ou l'utilisation de BigQuery comme source de validation ne sont pas acceptées.
- Votre ensemble de données BigQuery cible, l'ensemble de données de résultats (
validation_resultspar défaut ou l'ensemble de données personnalisé configuré sousresultsdanssettings.yaml), votre bucket de préproduction Cloud Storage et l'emplacement du workflow de validation (BQMS_VALIDATION_LOCATION) doivent se trouver au même emplacement. Lorsque le service de validation crée l'ensemble de données de résultats, il définit par défaut l'emplacement de l'ensemble de données sur la région utilisée par votre bucket de préproduction Cloud Storage et votre ensemble de données BigQuery cible, ou surresults.locations'il est explicitement défini. - La compatibilité des types de données varie selon la source. Les colonnes contenant des types non compatibles sont exclues de la validation. Pour en savoir plus, consultez Entrepôts de données compatibles.
- Les tables de comparaison par exécution créées dans BigQuery expirent automatiquement en fonction de
resultTtlHoursdanssettings.yaml, qui est défini par défaut sur168.0heures, soit sept jours. Ne configurez pas d'expiration de table par défaut au niveau de l'ensemble de données sur l'ensemble de donnéesvalidation_results, car cela entraînerait également l'expiration des tables d'audit de longue durée telles querun_history,run_metricsetcolumn_history. - Les noms des table BigQuery sont sensibles à la casse. Lorsque
generate-configcrée des configurations à partir d'une archive de métadonnées d'outildwh-migration-dumpersans mappage de traductiontables.yaml, les noms des tables cibles conservent la casse de l'identifiant source. Par exemple, les noms de table en majuscules d'Oracle ou de Snowflake. Vérifiez quetargetTable.namecorrespond exactement à la casse de votre table dans BigQuery.
Entrepôts de données compatibles
Le service de validation est compatible avec les bases de données sources suivantes. Chaque section indique le pilote JDBC fourni avec l'installation, si vous pouvez ou non générer automatiquement des configurations de table à partir d'une archive de métadonnées de l'outil dwh-migration-dumper, les types de partitionnement compatibles avec les tables volumineuses de cette base de données et les types de données compatibles avec la validation.
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
Les variantes paramétrées des types de données compatibles, telles que VARCHAR(255) ou DECIMAL(10,2), sont également acceptées.
Le service de validation charge tous les fichiers JAR du répertoire drivers/ avant les pilotes téléchargés automatiquement. Vous pouvez donc également utiliser drivers/ pour remplacer une version de pilote groupée.
Si vous générez automatiquement un fichier de configuration de validation, les colonnes dont les types de données ne sont pas compatibles sont automatiquement ajoutées à columnSettings.exclude. Pour les configurations manuelles, vous devez les exclure explicitement dans columnSettings.exclude.
Pour la plupart des bases de données sources compatibles, l'outil de validation télécharge automatiquement le pilote JDBC requis depuis Maven Central lors de la première utilisation, vérifie sa somme de contrôle SHA-256 et le met en cache localement dans ~/.cache/google-cloud-bqms/drivers/ (ou $XDG_CACHE_HOME/google-cloud-bqms/drivers/). Pour les entrepôts de données qui utilisent des pilotes propriétaires, tels que Teradata, ou lors de l'exécution dans un environnement hors connexion ou sous air gap, procédez comme suit :
- Placez le fichier JAR du pilote requis dans
./drivers/,<sdk_root>/platform/bqms/drivers/ou le répertoire spécifié par la variable d'environnementBQMS_DRIVER_DIR. Tout JAR de pilote placé dans ces répertoires locaux est prioritaire sur les téléchargements automatiques de Maven Central. - Pour désactiver complètement les téléchargements réseau automatiques dans les environnements air gap, définissez
BQMS_AUTO_DOWNLOAD_DRIVERS=falseou définissezBQMS_MAVEN_MIRRORde sorte qu'il pointe vers un miroir de dépôt Maven interne.
Pour en savoir plus sur chaque source de données compatible avec le service de validation, sélectionnez l'une des options suivantes :
Teradata
Les validations pour les migrations Teradata sont acceptées comme suit :
- Valeur
dialect:teradata - Pilote JDBC : fourni par l'utilisateur. Téléchargez le fichier JAR du pilote JDBC Teradata, tel que
terajdbc4.jarouterajdbc.jar, depuis Teradata et copiez-le dans le répertoiredrivers/ou dans le répertoire spécifié parBQMS_DRIVER_DIR. - Génération automatique de la configuration : compatible avec une archive de métadonnées d'outil
dwh-migration-dumper(--connector teradata). - Extraction partitionnée :
INTEGER_RANGE,PHYSICAL
| Catégorie | Types de données |
|---|---|
| Numérique | BYTEINT, SMALLINT, INTEGER, INT, BIGINT, DECIMAL, DEC, NUMERIC, NUMBER, FLOAT, REAL, DOUBLE PRECISION |
| Chaîne | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING et LONG VARCHAR |
| Date et heure | DATE, TIME, TIME WITH TIME ZONE, TIMESTAMP et TIMESTAMP WITH TIME ZONE |
Lorsque vous validez des migrations depuis Teradata, tenez compte des points suivants :
- Lorsqu'une table ne comporte pas de clé primaire explicite, les clés de comparaison sont découvertes à partir d'index primaires uniques (
UPI) ou d'index secondaires uniques (USI). Les index primaires non uniques (NUPI) ne sont pas utilisés comme clés de comparaison. - Le type
NUMBER(P,S)à précision fixe est accepté, mais pas le typeNUMBERsans contrainte (sans précision). Les colonnesNUMBER,CLOB,BLOB,BYTE,VARBYTE,INTERVAL,PERIOD,JSONetXMLnon contraintes sont automatiquement exclues pargenerate-config(ou doivent être listées danscolumnSettings.excludepour les configurations manuelles). - Les colonnes
CHARde largeur fixe sont automatiquement tronquées. Les jeux de caractèresLATINetUNICODE, ainsi que les attributsCASESPECIFIC/NOT CASESPECIFICsont acceptés. - Les valeurs
TIME WITH TIME ZONEetTIMESTAMP WITH TIME ZONEsont normalisées au format UTC (AT 0) avant la comparaison.
Snowflake
Les validations pour les migrations Snowflake sont acceptées comme suit :
- Valeur
dialect:snowflake - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (
net.snowflake:snowflake-jdbc) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : compatible avec une archive de métadonnées d'outil
dwh-migration-dumper(--connector snowflake). - Extraction partitionnée :
INTEGER_RANGE,DATE_RANGE
Le service de validation accepte les types de données suivants pour les migrations Snowflake :
| Catégorie | Types de données |
|---|---|
| Numérique | NUMBER, DECIMAL, NUMERIC, FLOAT, REAL, DOUBLE |
| Chaîne | CHAR, VARCHAR, STRING, TEXT |
| Date et heure | DATE, TIME, TIMESTAMP_NTZ, TIMESTAMP_LTZ et TIMESTAMP_TZ |
| Booléen | BOOLEAN |
Lorsque vous validez des migrations depuis Snowflake, tenez compte des points suivants :
- Les colonnes
CHARde largeur fixe sont automatiquement tronquées. - Si vous avez répliqué des données avec le service de transfert de données BigQuery, définissez
tolerances.timestamp: 0.001pour absorber l'arrondi inférieur à la milliseconde.
Amazon Redshift
Les validations pour les migrations Amazon Redshift sont acceptées comme suit :
- Valeur
dialect:redshift - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (
com.amazon.redshift:redshift-jdbc42) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : compatible avec une archive de métadonnées d'outil
dwh-migration-dumper(--connector redshift). - Extraction partitionnée :
INTEGER_RANGE,PHYSICAL
Le service de validation est compatible avec les types de données suivants pour les migrations Amazon Redshift :
| Catégorie | Types de données |
|---|---|
| Numérique | SMALLINT, INTEGER, BIGINT, DECIMAL, NUMERIC, REAL, DOUBLE PRECISION |
| Chaîne | CHAR, VARCHAR, TEXT |
| Date et heure | DATE, TIME, TIMETZ, TIMESTAMP et TIMESTAMPTZ |
| Booléen | BOOLEAN |
| Semi-structurées | SUPER |
Lorsque vous validez des migrations depuis Amazon Redshift, tenez compte des points suivants :
- L'inspection de schéma utilise
SVV_COLUMNS, de sorte que les vues à liaison tardive sont acceptées. - Lorsqu'une table n'a pas de clé primaire, les clés de comparaison sont automatiquement remplacées par une seule colonne
DISTKEYouSORTKEY. - Les colonnes
GEOMETRYne sont pas acceptées.
Databricks
Les validations pour les migrations Databricks sont acceptées comme suit :
- Valeur
dialect:databricks - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (
com.databricks:databricks-jdbc) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : non compatible. Créez un fichier de configuration de table manuel.
- Extraction partitionnée :
INTEGER_RANGE
Le service de validation accepte les types de données suivants pour les migrations Databricks :
| Catégorie | Types de données |
|---|---|
| Numérique | BYTE, TINYINT, SHORT, SMALLINT, INT, INTEGER, LONG, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| Chaîne | CHAR, VARCHAR, STRING |
| Date et heure | DATE, TIMESTAMP |
| Booléen | BOOLEAN |
| Binaire | BINARY |
| Complexe | ARRAY, MAP, STRUCT |
Lorsque vous validez des migrations depuis Databricks, tenez compte des points suivants :
- Authentification avec un jeton d'accès personnel : définissez
user: tokenet fournissez le jeton viapasswordSecret. - L'inspection de schéma est basée sur des requêtes (
SELECT * ... WHERE 1=0). Les espaces de travail Unity Catalog et Hive Metastore sont donc tous deux compatibles.
Apache Hive
Les validations pour les migrations Apache Hive sont acceptées comme suit :
- Valeur
dialect:hive - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (JAR autonome
org.apache.hive:hive-jdbc) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : compatible avec une archive de métadonnées d'outil
dwh-migration-dumper(--connector hiveql). - Extraction partitionnée :
INTEGER_RANGE
Le service de validation accepte les types de données suivants pour les migrations Hive :
| Catégorie | Types de données |
|---|---|
| Numérique | TINYINT, SMALLINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| Chaîne | CHAR, VARCHAR, STRING |
| Date et heure | DATE, TIMESTAMP |
| Booléen | BOOLEAN |
| Binaire | BINARY |
| Complexe | ARRAY, MAP, STRUCT |
Lorsque vous validez des migrations à partir de Hive, tenez compte des points suivants :
- L'inspection du schéma est basée sur des requêtes (
SELECT * ... WHERE 1=0). - Les tables Hive définissent rarement des clés primaires. Les tables sans clés de comparaison utilisent automatiquement l'agrégation de hachage de ligne complète pour le pilier de données.
SQL Server
Les validations pour les migrations SQL Server sont acceptées comme suit :
- Valeur
dialect:sqlserver - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (
com.microsoft.sqlserver:mssql-jdbc) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : compatible avec une archive de métadonnées d'outil
dwh-migration-dumper(--connector sqlserver). - Extraction partitionnée :
INTEGER_RANGE
Le service de validation accepte les types de données suivants pour les migrations SQL Server :
| Catégorie | Types de données |
|---|---|
| Numérique | INT, BIGINT, DECIMAL, NUMERIC, FLOAT, REAL |
| Chaîne | CHAR, VARCHAR, TEXT |
| Date et heure | DATE, DATETIME, TIMESTAMP |
| Booléen | BIT |
Lorsque vous validez des migrations à partir de SQL Server, tenez compte des points suivants :
- L'URL JDBC par défaut définit
encrypt=true;trustServerCertificate=true;. Remplacez-la par la clé de connexionurlsi vous avez besoin d'une validation stricte du certificat TLS.
MariaDB
Les validations pour les migrations MariaDB sont acceptées comme suit :
- Valeur
dialect:mariadb - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (
org.mariadb.jdbc:mariadb-java-client) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : créez un fichier de configuration de table manuel.
- Extraction partitionnée :
INTEGER_RANGE
Le service de validation accepte les types de données suivants pour les migrations MariaDB :
| Catégorie | Types de données |
|---|---|
| Numérique | TINYINT, SMALLINT, MEDIUMINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| Chaîne | CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, ENUM, SET |
| Date et heure | DATE, TIME, DATETIME, TIMESTAMP et YEAR |
| Objets binaires et volumineux | BINARY, VARBINARY, TINYBLOB, BLOB, MEDIUMBLOB, LONGBLOB |
MySQL
Les validations pour les migrations MySQL sont acceptées comme suit :
- Valeur
dialect:mysql - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (
com.mysql:mysql-connector-j) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : créez un fichier de configuration de table manuel.
- Extraction partitionnée :
INTEGER_RANGE
Le service de validation accepte les types de données suivants pour les migrations MySQL :
| Catégorie | Types de données |
|---|---|
| Numérique | INT, BIGINT, DECIMAL, FLOAT et DOUBLE |
| Chaîne | CHAR, VARCHAR, TEXT |
| Date et heure | DATE, TIME, DATETIME, TIMESTAMP |
| Booléen | BOOLEAN |
Oracle
Les validations pour les migrations Oracle sont acceptées comme suit :
- Valeur
dialect:oracle - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (
com.oracle.database.jdbc:ojdbc11) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : compatible avec une archive de métadonnées d'outil
dwh-migration-dumper(--connector oracle). - Extraction partitionnée :
INTEGER_RANGE,PHYSICAL
Le service de validation accepte les types de données suivants pour les migrations Oracle :
| Catégorie | Types de données |
|---|---|
| Numérique | NUMBER, NUMERIC, INTEGER, FLOAT et DOUBLE |
| Chaîne | CHAR, NCHAR, VARCHAR, VARCHAR2 et NVARCHAR2 |
| Date et heure | DATE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
| Objets binaires et volumineux | RAW, BINARY, BLOB, CLOB et NCLOB |
Lorsque vous validez des migrations depuis Oracle, tenez compte des points suivants :
- Les colonnes
DATEincluent un composant temporel dans Oracle. L'outil de validation extrait les colonnes OracleDATEavec une précision d'un jour (YYYY-MM-DD). Les différences d'heure sont donc tronquées.
PostgreSQL
Les validations pour les migrations PostgreSQL sont acceptées comme suit :
- Valeur
dialect:postgresql - Pilote JDBC : téléchargé automatiquement lors de la première utilisation (
org.postgresql:postgresql) ou fourni par l'utilisateur dans le répertoiredrivers/pour les environnements hors connexion. - Génération automatique de la configuration : compatible avec une archive de métadonnées d'outil
dwh-migration-dumper(--connector postgres). - Extraction partitionnée :
INTEGER_RANGE,DATE_RANGE,PHYSICAL
Le service de validation accepte les types de données suivants pour les migrations PostgreSQL :
| Catégorie | Types de données |
|---|---|
| Numérique | SMALLINT, INTEGER, BIGINT, NUMERIC et DOUBLE PRECISION |
| Chaîne | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING et TEXT |
| Date et heure | DATE, TIME, TIMESTAMP, TIMESTAMP WITHOUT TIME ZONE, TIMESTAMP WITH TIME ZONE, TIMESTAMPTZ |
| Booléen | BOOLEAN |
| Autre | UUID |
Lorsque vous validez des migrations à partir de PostgreSQL, tenez compte des points suivants :
- Les valeurs
BIGINTsupérieures à 253 peuvent présenter des différences de précision mineures surAVG().SUMetCOUNTrestent exacts.
Configurer le répertoire et les fichiers de configuration de la validation
Le service de validation lit les données d'un répertoire de configuration modulaire nommé validation_config/ qui contient les fichiers suivants :
- Fichier de connexions de base de données : définit votre profil de connexion à l'entrepôt de données
sourceet votre profil de connexiontargetBigQuery. - Fichier de paramètres de préproduction et de résultats : définit votre chemin d'accès de préproduction Cloud Storage (
googleCloudStorage), la configuration de l'ensemble de données de résultats BigQuery (results), l'expiration de la table de comparaison par exécution (resultTtlHours) et les valeurs par défaut globales facultatives (tolerances,aggregate,labels). - Fichier de configuration de la validation des tables : contient les mappages par table (
sourceTableettargetTable), les clés de comparaison (comparisonKeys), la stratégie de validation (strategy), les paramètres d'extraction partitionnée (partitioning) et les paramètres de colonne (columnSettings).
Les sections suivantes décrivent les étapes à suivre pour configurer votre répertoire de configuration de validation et créer les fichiers de configuration nécessaires à une validation de migration.
Créer un répertoire de configuration de validation
Créez un répertoire de configuration de validation nommé validation_config/ pour stocker vos fichiers de configuration de validation. Vous pouvez stocker ce répertoire sur la machine qui exécute le service de validation, ou le stocker dans un bucket Cloud Storage afin qu'une équipe puisse partager une configuration entre les exécutions.
Créer un fichier de connexions à la base de données
Dans le répertoire de configuration de la validation, créez un fichier nommé connections.yaml et configurez-le avec les informations permettant de se connecter à une base de données source et à une base de données BigQuery cible.
Chaque source d'entrepôt de données présente des fonctionnalités et des exigences spécifiques à prendre en compte lors de la création du fichier de connexions à la base de données. Pour en savoir plus sur chaque source de données, consultez Entrepôts de données compatibles.
Lorsque vous spécifiez passwordSecret sur un profil de connexion, le service de validation récupère la version du secret depuis Secret Manager sur la machine cliente à l'aide de vos Identifiants par défaut de l'application (ADC) locaux et transmet le mot de passe résolu directement au pilote JDBC local. Votre base de données source n'a pas besoin d'un accès réseau ni d'un accès IAM à Google Cloud. passwordSecret fonctionne donc pour les bases de données sur site et les bases de données hébergées dans d'autres clouds, comme Amazon Redshift ou Snowflake. Vous pouvez également omettre passwordSecret et définir la variable d'environnement BQMS_VALIDATION_SOURCE_PASSWORD sur la machine exécutant le service de validation.
Pour créer un fichier de connexions de base de données pour un entrepôt de données, sélectionnez l'une des options suivantes :
Teradata
Pour les validations de migration Teradata, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SOURCE_HOST: nom d'hôte ou adresse IP de votre système Teradata.SOURCE_DATABASE: nom de la base de données Teradata requis.SOURCE_USER: nom d'utilisateur Teradata.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe, ou définissezBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
Snowflake
Pour les validations de migration Snowflake, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SNOWFLAKE_ACCOUNT: identifiant de votre compte Snowflake (par exemple,myorg-myaccount).SNOWFLAKE_WAREHOUSE: entrepôt virtuel utilisé pour exécuter les requêtes d'extraction.SOURCE_DATABASE: nom de la base de données Snowflake requis.SOURCE_SCHEMA: nom du schéma Snowflake requis.SNOWFLAKE_ROLE: rôle Snowflake facultatif.SOURCE_USER: nom d'utilisateur Snowflake.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe, ou définissezBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
Amazon Redshift
Pour les validations de migration Amazon Redshift, configurez votre fichier de connexions de base de données avec les informations suivantes :
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SOURCE_HOST: nom d'hôte du point de terminaison de votre cluster Amazon Redshift.SOURCE_DATABASE: nom de la base de données Amazon Redshift requise.SOURCE_SCHEMA: nom du schéma par défaut (publicpar défaut en cas d'omission).SOURCE_USER: nom d'utilisateur de la base de données.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe, ou définissezBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
Databricks
Pour les validations de migration Databricks, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
DATABRICKS_HOST: nom d'hôte du serveur de votre entrepôt ou cluster Databricks SQL.HTTP_PATH: chemin HTTP de votre entrepôt Databricks SQL (par exemple,sql/protocolv1/o/1234567890/0123-456789-abcdef).CATALOG_NAME: nom Unity Catalog requis (ouhive_metastore).SCHEMA_NAME: nom du schéma requis.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant votre jeton d'accès personnel (PAT) Databricks, ou omettezpasswordSecretet définissezBQMS_VALIDATION_SOURCE_PASSWORD. L'utilisation deuser: tokenavecpasswordSecretgarantit que votre jeton n'est jamais écrit dans les fichiers de métadonnées de préproduction.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
Apache Hive
Pour les validations de migration Apache Hive, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SOURCE_HOST: nom d'hôte ou adresse IP de HiveServer2.SOURCE_DATABASE: nom de la base de données Hive requise (par exemple,default).SOURCE_USER: nom d'utilisateur Hive.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe, ou définissezBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
SQL Server
Pour les validations de migration SQL Server, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SOURCE_HOST: nom d'hôte ou adresse IP de votre instance SQL Server (vous pouvez éventuellement spécifierinstanceNamepour les instances nommées).SOURCE_DATABASE: nom de la base de données requis.SOURCE_SCHEMA: nom du schéma par défaut (dbopar défaut en cas d'omission).SOURCE_USER: nom d'utilisateur de la base de données.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe, ou définissezBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
MariaDB
Pour les validations de migration MariaDB, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SOURCE_HOST: nom d'hôte ou adresse IP de votre serveur MariaDB.SOURCE_DATABASE: nom de la base de données MariaDB requise.SOURCE_USER: nom d'utilisateur MariaDB.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe, ou définissezBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
MySQL
Pour les validations de migration MySQL, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SOURCE_HOST: nom d'hôte ou adresse IP de votre serveur MySQL.SOURCE_DATABASE: nom de la base de données MySQL requise.SOURCE_USER: nom d'utilisateur MySQL.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe, ou définissezBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
Oracle
Pour les validations de migration Oracle, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SOURCE_HOST: nom d'hôte ou adresse IP de votre serveur Oracle.SERVICE_NAME: nom du service Oracle (utilisé pour construirejdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME). Pour les connexions TNS ou SID personnalisées, spécifiez plutôturlavec l'URL JDBC complète.SOURCE_SCHEMA: nom de schéma par défaut facultatif.SOURCE_USER: nom d'utilisateur Oracle requis.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe de la base de données, ou définissezBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloudcible.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
PostgreSQL
Pour les validations de migration PostgreSQL, configurez votre fichier de connexions à la base de données avec les informations suivantes :
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Remplacez les éléments suivants :
SOURCE_HOST: nom d'hôte ou adresse IP de votre serveur PostgreSQL.SOURCE_DATABASE: nom de la base de données PostgreSQL requise.SOURCE_SCHEMA: nom du schéma par défaut (publicpar défaut en cas d'omission).SOURCE_USER: nom d'utilisateur de la base de données.SECRET_PROJECT_IDetSECRET_ID: ID du projet et ID du secret dans Secret Manager contenant le mot de passe de la base de données. Vous pouvez également omettrepasswordSecretet définir la variable d'environnementBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: ID du projet Google Cloud contenant vos tables BigQuery migrées et dans lequel l'ensemble de donnéesvalidation_resultssera créé.TARGET_DATASET: nom de l'ensemble de données BigQuery cible.
Créer un fichier de paramètres
Créez un fichier de paramètres de préproduction et de résultats nommé settings.yaml dans le répertoire de configuration de la validation pour configurer votre chemin d'accès de préproduction Cloud Storage, votre ensemble de données de résultats BigQuery, l'expiration de la table par exécution et les valeurs par défaut globales facultatives.
Configurez le fichier de paramètres de préproduction et de résultat avec les éléments suivants :
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
Remplacez les éléments suivants :
BUCKET_NAME: nom de votre bucket de préproduction Cloud Storage.PATH_PREFIX: préfixe de l'URI Cloud Storage dans le bucket utilisé pour stocker les métadonnées de schéma extraites, les métriques agrégées, les lignes échantillonnées et les rapports récapitulatifs.FORMAT: format de fichier des exemples de données préparés. Les valeurs acceptées sontparquet(par défaut) etcsv.RESULTS_PROJECT_ID: ID du projet Google Cloud dans lequel les résultats de validation et les tables d'historique d'exécution sont écrits. Si aucune valeur n'est spécifiée, la valeur par défaut esttarget.projectIddeconnections.yaml.RESULTS_DATASET: nom de l'ensemble de données BigQuery dans lequel les résultats de validation et les tables d'historique d'exécution (run_history,run_metricsetcolumn_history) sont écrits. Si aucune valeur n'est spécifiée, la valeur par défaut estvalidation_results. Si l'ensemble de données n'existe pas, le service de validation le crée automatiquement.RESULTS_LOCATION: emplacement BigQuery de l'ensemble de données de résultats. Si cet argument est omis, un ensemble de données de résultats créé automatiquement est défini par défaut sur la région de votre bucket de préproduction Cloud Storage et de votre ensemble de données BigQuery cible.RESULT_TTL_HOURS: valeur TTL (Time to Live) en heures pour les tables de comparaison et de non-concordance par exécution créées dans l'ensemble de données de résultats. La valeur par défaut est de168.0heures (7 jours). Les tables d'observabilité de longue durée (run_history,run_metricsetcolumn_history) ne sont pas affectées parresultTtlHours.RESULTS_CONFIG: configure l'ensemble de données BigQuery de destination pour les résultats de comparaison et l'historique d'audit. Les valeurs acceptées sontprojectId,datasetetlocation. En cas d'omission, le service de validation écrit dansTARGET_PROJECT_ID.validation_results` et crée automatiquement l'ensemble de données dans la même région que votre ensemble de données cible et votre bucket de préproduction Cloud Storage s'il n'existe pas déjà.
Vous pouvez également spécifier des valeurs par défaut globales pour les tables en spécifiant tolerances, aggregate ou labels au niveau supérieur de settings.yaml ou validation-config.yaml. Ces valeurs par défaut s'appliquent à toutes les tables, sauf si elles sont remplacées dans la configuration d'une table individuelle.
Générer des configurations de validation de table
Après avoir configuré vos fichiers de connexions et de paramètres, définissez les configurations de validation de table. La commande generate-config écrit un fichier YAML par table dans validation_config/databases/DATABASE/SCHEMA/TABLE.yaml avec une clé table: de premier niveau. Vous pouvez également créer un fichier validation_config/tables.yaml manuellement.
Sélectionnez l'une des options suivantes pour savoir comment générer des configurations de validation de table pour votre base de données source :
Teradata
Pour les validations de migration Teradata, procédez comme suit pour générer une archive de métadonnées de l'outil dwh-migration-dumper de vos schémas sources :
- Installez l'outil
dwh-migration-dumper. - Exécutez
dwh-migration-dumperpour votre base de données source afin de produire une archive de métadonnées de l'outildwh-migration-dumper.
Avec l'archive de métadonnées, exécutez generate-config pour générer des fichiers de configuration par table. Vous pouvez utiliser l'option --update pour conserver les fichiers connections.yaml et settings.yaml existants que vous avez créés dans validation_config/. Exemple :
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si vous disposez également d'un fichier de mappage de schéma tables.yaml provenant du traducteur SQL par lot, incluez l'option --tables-yaml, seule ou avec --metadata, pour compléter les mappages de tables traduits avec les métadonnées de partition source et les exclusions de types de données de l'archive de métadonnées. Exemple :
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
La commande generate-config accepte les options suivantes :
--metadata PATH_TO_METADATA_ZIP: chemin d'accès à une archive de métadonnées de l'outildwh-migration-dumper(fichier ZIP) ou à un répertoire contenant des archives de métadonnées.--tables-yaml PATH_TO_TABLES_YAML: chemin d'accès à un ou plusieurs fichiers ou répertoires de traductiontables.yaml(séparés par une virgule).--target-dataset TARGET_DATASET: nom de l'ensemble de données BigQuery cible à ajouter en préfixe aux entréestargetTable.namegénérées.-o, --output-dir DIRECTORY: répertoire de sortie des fichiers de configuration modulaires. La valeur par défaut estvalidation_config.--schemas SCHEMA_LIST: liste de schémas ou de bases de données sources à inclure, séparés par une virgule (sensible à la casse ; accepte les caractères génériques*).--tables TABLE_LIST: liste de noms de tables séparés par une virgule (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) à inclure (sensible à la casse ; accepte les caractères génériques*).--filter-file PATH: chemin d'accès à un fichier délimité par un saut de ligne contenant les noms des tables à inclure (les lignes commençant par#sont ignorées).--update: fusionne les tables découvertes dans un répertoirevalidation_config/existant tout en conservant vos remplacementsconnections.yaml,settings.yamlet personnalisés par table.--force: permet d'écrire les fichiers de table nouvellement découverts dans un répertoire de sortie non vide tout en conservant les fichiers de configuration de table existants.--clean: supprime tous les fichiers existants dans le répertoire de sortie avant d'écrire les fichiers nouvellement découverts.
Snowflake
Pour les validations de migration Snowflake, procédez comme suit pour générer une archive de métadonnées de l'outil dwh-migration-dumper de vos schémas sources :
- Installez l'outil
dwh-migration-dumper. - Exécutez
dwh-migration-dumperpour votre base de données source afin de produire une archive de métadonnées de l'outildwh-migration-dumper.
Avec l'archive de métadonnées, exécutez generate-config pour générer des fichiers de configuration par table. Vous pouvez utiliser l'option --update pour conserver les fichiers connections.yaml et settings.yaml existants que vous avez créés dans validation_config/. Exemple :
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si vous disposez également d'un fichier de mappage de schéma tables.yaml provenant du traducteur SQL par lot, incluez l'option --tables-yaml, seule ou avec --metadata, pour compléter les mappages de tables traduits avec des clés de clustering sources (pour partitionner des tables sans clé primaire), des métadonnées de partition physique et des exclusions de types de données de l'archive de métadonnées. Exemple :
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
La commande generate-config accepte les options suivantes :
--metadata PATH_TO_METADATA_ZIP: chemin d'accès à une archive de métadonnées de l'outildwh-migration-dumper(fichier ZIP) ou à un répertoire contenant des archives de métadonnées.--tables-yaml PATH_TO_TABLES_YAML: chemin d'accès à un ou plusieurs fichiers ou répertoires de traductiontables.yaml(séparés par une virgule).--target-dataset TARGET_DATASET: nom de l'ensemble de données BigQuery cible à ajouter en préfixe aux entréestargetTable.namegénérées.-o, --output-dir DIRECTORY: répertoire de sortie des fichiers de configuration modulaires. La valeur par défaut estvalidation_config.--schemas SCHEMA_LIST: liste de schémas ou de bases de données sources à inclure, séparés par une virgule (sensible à la casse ; accepte les caractères génériques*).--tables TABLE_LIST: liste de noms de tables séparés par une virgule (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) à inclure (sensible à la casse ; accepte les caractères génériques*).--filter-file PATH: chemin d'accès à un fichier délimité par un saut de ligne contenant les noms des tables à inclure (les lignes commençant par#sont ignorées).--update: fusionne les tables découvertes dans un répertoirevalidation_config/existant tout en conservant vos remplacementsconnections.yaml,settings.yamlet personnalisés par table.--force: permet d'écrire les fichiers de table nouvellement découverts dans un répertoire de sortie non vide tout en conservant les fichiers de configuration de table existants.--clean: supprime tous les fichiers existants dans le répertoire de sortie avant d'écrire les fichiers nouvellement découverts.
Amazon Redshift
Pour les validations de migration Amazon Redshift, procédez comme suit pour générer une archive ZIP de métadonnées de vos schémas sources :
- Installez l'outil
dwh-migration-dumper. - Exécutez
dwh-migration-dumperpour votre base de données source afin de produire une archive de métadonnées de l'outildwh-migration-dumper.
Avec l'archive de métadonnées, exécutez generate-config pour générer des fichiers de configuration par table. Vous pouvez utiliser l'option --update pour conserver les fichiers connections.yaml et settings.yaml existants que vous avez créés dans validation_config/. Exemple :
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si vous disposez également d'un fichier de mappage de schéma tables.yaml provenant du traducteur SQL par lot, incluez l'option --tables-yaml, seule ou avec --metadata, pour compléter les mappages de tables traduits avec les métadonnées de partition source et les exclusions de types de données de l'archive de métadonnées. Exemple :
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
La commande generate-config accepte les options suivantes :
--metadata PATH_TO_METADATA_ZIP: chemin d'accès à une archive de métadonnées de l'outildwh-migration-dumper(fichier ZIP) ou à un répertoire contenant des archives de métadonnées.--tables-yaml PATH_TO_TABLES_YAML: chemin d'accès à un ou plusieurs fichiers ou répertoires de traductiontables.yaml(séparés par une virgule).--target-dataset TARGET_DATASET: nom de l'ensemble de données BigQuery cible à ajouter en préfixe aux entréestargetTable.namegénérées.-o, --output-dir DIRECTORY: répertoire de sortie des fichiers de configuration modulaires. La valeur par défaut estvalidation_config.--schemas SCHEMA_LIST: liste de schémas ou de bases de données sources à inclure, séparés par une virgule (sensible à la casse ; accepte les caractères génériques*).--tables TABLE_LIST: liste de noms de tables séparés par une virgule (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) à inclure (sensible à la casse ; accepte les caractères génériques*).--filter-file PATH: chemin d'accès à un fichier délimité par un saut de ligne contenant les noms des tables à inclure (les lignes commençant par#sont ignorées).--update: fusionne les tables découvertes dans un répertoirevalidation_config/existant tout en conservant vos remplacementsconnections.yaml,settings.yamlet personnalisés par table.--force: permet d'écrire les fichiers de table nouvellement découverts dans un répertoire de sortie non vide tout en conservant les fichiers de configuration de table existants.--clean: supprime tous les fichiers existants dans le répertoire de sortie avant d'écrire les fichiers nouvellement découverts.
Databricks
La génération automatique de la configuration n'est pas compatible avec Databricks. Créez manuellement un fichier tables.yaml dans le répertoire validation_config/ avec les configurations suivantes :
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
Pour les validations de migration Apache Hive, procédez comme suit pour générer une archive ZIP de métadonnées de vos schémas sources :
- Installez l'outil
dwh-migration-dumper. - Exécutez
dwh-migration-dumperpour votre base de données source afin de produire une archive de métadonnées de l'outildwh-migration-dumper.
Avec l'archive de métadonnées, exécutez generate-config pour générer des fichiers de configuration par table. Vous pouvez utiliser l'option --update pour conserver les fichiers connections.yaml et settings.yaml existants que vous avez créés dans validation_config/. Exemple :
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si vous disposez également d'un fichier de mappage de schéma tables.yaml provenant du traducteur SQL par lot, incluez l'option --tables-yaml, seule ou avec --metadata, pour compléter les mappages de tables traduits avec les métadonnées de partition source et les exclusions de types de données de l'archive de métadonnées. Exemple :
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
La commande generate-config accepte les options suivantes :
--metadata PATH_TO_METADATA_ZIP: chemin d'accès à une archive de métadonnées de l'outildwh-migration-dumper(fichier ZIP) ou à un répertoire contenant des archives de métadonnées.--tables-yaml PATH_TO_TABLES_YAML: chemin d'accès à un ou plusieurs fichiers ou répertoires de traductiontables.yaml(séparés par une virgule).--target-dataset TARGET_DATASET: nom de l'ensemble de données BigQuery cible à ajouter en préfixe aux entréestargetTable.namegénérées.-o, --output-dir DIRECTORY: répertoire de sortie des fichiers de configuration modulaires. La valeur par défaut estvalidation_config.--schemas SCHEMA_LIST: liste de schémas ou de bases de données sources à inclure, séparés par une virgule (sensible à la casse ; accepte les caractères génériques*).--tables TABLE_LIST: liste de noms de tables séparés par une virgule (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) à inclure (sensible à la casse ; accepte les caractères génériques*).--filter-file PATH: chemin d'accès à un fichier délimité par un saut de ligne contenant les noms des tables à inclure (les lignes commençant par#sont ignorées).--update: fusionne les tables découvertes dans un répertoirevalidation_config/existant tout en conservant vos remplacementsconnections.yaml,settings.yamlet personnalisés par table.--force: permet d'écrire les fichiers de table nouvellement découverts dans un répertoire de sortie non vide tout en conservant les fichiers de configuration de table existants.--clean: supprime tous les fichiers existants dans le répertoire de sortie avant d'écrire les fichiers nouvellement découverts.
SQL Server
Pour les validations de migration SQL Server, procédez comme suit pour générer une archive de métadonnées de l'outil dwh-migration-dumper de vos schémas sources :
- Installez l'outil
dwh-migration-dumper. - Exécutez
dwh-migration-dumperpour votre base de données source afin de produire une archive de métadonnées de l'outildwh-migration-dumper.
Avec l'archive de métadonnées, exécutez generate-config pour générer des fichiers de configuration par table. Vous pouvez utiliser l'option --update pour conserver les fichiers connections.yaml et settings.yaml existants que vous avez créés dans validation_config/. Exemple :
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si vous disposez également d'un fichier de mappage de schéma tables.yaml provenant du traducteur SQL par lot, incluez l'option --tables-yaml, seule ou avec --metadata, pour compléter les mappages de tables traduits avec les métadonnées de partition source et les exclusions de types de données de l'archive de métadonnées. Exemple :
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
La commande generate-config accepte les options suivantes :
--metadata PATH_TO_METADATA_ZIP: chemin d'accès à une archive de métadonnées de l'outildwh-migration-dumper(fichier ZIP) ou à un répertoire contenant des archives de métadonnées.--tables-yaml PATH_TO_TABLES_YAML: chemin d'accès à un ou plusieurs fichiers ou répertoires de traductiontables.yaml(séparés par une virgule).--target-dataset TARGET_DATASET: nom de l'ensemble de données BigQuery cible à ajouter en préfixe aux entréestargetTable.namegénérées.-o, --output-dir DIRECTORY: répertoire de sortie des fichiers de configuration modulaires. La valeur par défaut estvalidation_config.--schemas SCHEMA_LIST: liste de schémas ou de bases de données sources à inclure, séparés par une virgule (sensible à la casse ; accepte les caractères génériques*).--tables TABLE_LIST: liste de noms de tables séparés par une virgule (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) à inclure (sensible à la casse ; accepte les caractères génériques*).--filter-file PATH: chemin d'accès à un fichier délimité par un saut de ligne contenant les noms des tables à inclure (les lignes commençant par#sont ignorées).--update: fusionne les tables découvertes dans un répertoirevalidation_config/existant tout en conservant vos remplacementsconnections.yaml,settings.yamlet personnalisés par table.--force: permet d'écrire les fichiers de table nouvellement découverts dans un répertoire de sortie non vide tout en conservant les fichiers de configuration de table existants.--clean: supprime tous les fichiers existants dans le répertoire de sortie avant d'écrire les fichiers nouvellement découverts.
MariaDB
La génération automatique de la configuration n'est pas compatible avec MariaDB. Créez manuellement un fichier tables.yaml dans le répertoire validation_config/ avec les configurations suivantes :
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
La génération automatique de la configuration n'est pas compatible avec MySQL. Créez manuellement un fichier tables.yaml dans le répertoire validation_config/ avec les configurations suivantes :
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
Pour les validations de migration Oracle, procédez comme suit pour générer une archive de métadonnées de l'outil dwh-migration-dumper de vos schémas sources :
- Installez l'outil
dwh-migration-dumper. - Exécutez
dwh-migration-dumperpour votre base de données source afin de produire une archive de métadonnées de l'outildwh-migration-dumper.
Avec l'archive de métadonnées, exécutez generate-config pour générer des fichiers de configuration par table. Vous pouvez utiliser l'option --update pour conserver les fichiers connections.yaml et settings.yaml existants que vous avez créés dans validation_config/. Exemple :
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si vous disposez également d'un fichier de mappage de schéma tables.yaml provenant du traducteur SQL par lot, incluez l'option --tables-yaml, seule ou avec --metadata, pour compléter les mappages de tables traduits avec les métadonnées de partition source et les exclusions de types de données de l'archive de métadonnées. Exemple :
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
La commande generate-config accepte les options suivantes :
--metadata PATH_TO_METADATA_ZIP: chemin d'accès à une archive de métadonnées de l'outildwh-migration-dumper(fichier ZIP) ou à un répertoire contenant des archives de métadonnées.--tables-yaml PATH_TO_TABLES_YAML: chemin d'accès à un ou plusieurs fichiers ou répertoires de traductiontables.yaml(séparés par une virgule).--target-dataset TARGET_DATASET: nom de l'ensemble de données BigQuery cible à ajouter en préfixe aux entréestargetTable.namegénérées.-o, --output-dir DIRECTORY: répertoire de sortie des fichiers de configuration modulaires. La valeur par défaut estvalidation_config.--schemas SCHEMA_LIST: liste de schémas ou de bases de données sources à inclure, séparés par une virgule (sensible à la casse ; accepte les caractères génériques*).--tables TABLE_LIST: liste de noms de tables séparés par une virgule (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) à inclure (sensible à la casse ; accepte les caractères génériques*).--filter-file PATH: chemin d'accès à un fichier délimité par un saut de ligne contenant les noms des tables à inclure (les lignes commençant par#sont ignorées).--update: fusionne les tables découvertes dans un répertoirevalidation_config/existant tout en conservant vos remplacementsconnections.yaml,settings.yamlet personnalisés par table.--force: permet d'écrire les fichiers de table nouvellement découverts dans un répertoire de sortie non vide tout en conservant les fichiers de configuration de table existants.--clean: supprime tous les fichiers existants dans le répertoire de sortie avant d'écrire les fichiers nouvellement découverts.
PostgreSQL
Pour les validations de migration PostgreSQL, procédez comme suit pour générer une archive de métadonnées de l'outil dwh-migration-dumper de vos schémas sources :
- Installez l'outil
dwh-migration-dumper. - Exécutez
dwh-migration-dumperpour votre base de données source afin de produire une archive de métadonnées de l'outildwh-migration-dumper.
Avec l'archive de métadonnées, exécutez generate-config pour générer des fichiers de configuration par table. Vous pouvez utiliser l'option --update pour conserver les fichiers connections.yaml et settings.yaml existants que vous avez créés dans validation_config/. Exemple :
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si vous disposez également d'un fichier de mappage de schéma tables.yaml provenant du traducteur SQL par lot, incluez l'option --tables-yaml, seule ou avec --metadata, pour compléter les mappages de tables traduits avec les métadonnées de partition source et les exclusions de types de données de l'archive de métadonnées. Exemple :
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
La commande generate-config accepte les options suivantes :
--metadata PATH_TO_METADATA_ZIP: chemin d'accès à une archive de métadonnées de l'outildwh-migration-dumper(fichier ZIP) ou à un répertoire contenant des archives de métadonnées.--tables-yaml PATH_TO_TABLES_YAML: chemin d'accès à un ou plusieurs fichiers ou répertoires de traductiontables.yaml(séparés par une virgule).--target-dataset TARGET_DATASET: nom de l'ensemble de données BigQuery cible à ajouter en préfixe aux entréestargetTable.namegénérées.-o, --output-dir DIRECTORY: répertoire de sortie des fichiers de configuration modulaires. La valeur par défaut estvalidation_config.--schemas SCHEMA_LIST: liste de schémas ou de bases de données sources à inclure, séparés par une virgule (sensible à la casse ; accepte les caractères génériques*).--tables TABLE_LIST: liste de noms de tables séparés par une virgule (TABLE,SCHEMA.TABLEouDB.SCHEMA.TABLE) à inclure (sensible à la casse ; accepte les caractères génériques*).--filter-file PATH: chemin d'accès à un fichier délimité par un saut de ligne contenant les noms des tables à inclure (les lignes commençant par#sont ignorées).--update: fusionne les tables découvertes dans un répertoirevalidation_config/existant tout en conservant vos remplacementsconnections.yaml,settings.yamlet personnalisés par table.--force: permet d'écrire les fichiers de table nouvellement découverts dans un répertoire de sortie non vide tout en conservant les fichiers de configuration de table existants.--clean: supprime tous les fichiers existants dans le répertoire de sortie avant d'écrire les fichiers nouvellement découverts.
Personnaliser les paramètres du tableau
Chaque fichier de table généré par generate-config contient une section table: que vous pouvez personnaliser avant d'exécuter la validation. Le tableau suivant liste toutes les clés facultatives acceptées pour chaque entrée de table.
| Clé YAML facultative | Valeur par défaut | Description |
|---|---|---|
runSchema, runAggregate, runData |
true |
Booléens par table pour activer ou désactiver des piliers de validation individuels lorsqu'aucun flag de ligne de commande de pilier n'est transmis. |
maxColumnsPerTile |
100 |
Nombre maximal de colonnes regroupées dans une seule tuile de comparaison sur les tables larges. |
strategy |
SMART |
Stratégie d'exécution de la validation des données : SMART (BRUTE_FORCE pour moins de 100 000 lignes, sinon SAMPLE), SAMPLE ou BRUTE_FORCE. |
sampleSize |
70000 |
Nombre de lignes à extraire (par tranche en cas de partitionnement) lorsque la stratégie résolue est SAMPLE. La valeur par défaut de 70 000 lignes offre une probabilité supérieure à 99,9 % de détecter au moins une ligne non concordante lorsque le taux de commandes défectueuses est de 0,01 % (1 ligne sur 10 000) ou plus. |
whereClause |
Aucun | Prédicat SQL (sans le mot clé WHERE) appliqué aux requêtes d'extraction source et de comparaison cible. Peut également être défini séparément sur sourceTable.whereClause et targetTable.whereClause. |
skipRandomization |
false |
Lorsque la valeur est true, lit jusqu'à sampleSize lignes dans l'ordre naturel de la table au lieu de trier par une fonction aléatoire, ce qui réduit le coût des requêtes sur les tables volumineuses. |
maxConcurrency |
1 |
Nombre maximal de threads d'extraction de segments parallèles pour une table partitionnée. |
maxSlices |
0 (illimité) |
Nombre maximal de tranches de partition autorisées pour une table partitionnée. Si le nombre de tranches calculé dépasse maxSlices (lorsqu'il est supérieur à 0), la planification de la partition échoue avec une erreur. |
disablePartitioning |
false |
Lorsque la valeur est true, désactive le découpage partitionné pour la table, même si un bloc partitioning est configuré ou si le nombre de lignes dépasse 1000000. |
labels |
Carte vide | Étiquettes de chaîne clé/valeur associées aux métriques d'exécution de la validation dans validation_results. |
Les sections suivantes décrivent comment utiliser ces clés YAML pour personnaliser vos exécutions de validation.
Sélectionner une stratégie de validation
Utilisez la clé strategy sur une entrée de table pour sélectionner une stratégie de validation qui contrôle la façon dont le pilier --data extrait et compare les lignes. Les valeurs suivantes sont acceptées :
SMART(par défaut) : compte d'abord les lignes de la table source. Si la table comporte moins de 100 000 lignes, elle exécuteBRUTE_FORCE. Si la table comporte 100 000 lignes ou plus, elle exécuteSAMPLE.SAMPLE: extrait un échantillon aléatoire de lignes en fonction de la valeur desampleSize(la valeur par défaut est70,000) et les joint à la table cible à l'aide decomparisonKeys. Un échantillon de 70 000 lignes offre une probabilité supérieure à 99,9 % de détecter au moins une ligne défectueuse lorsqu'au moins 0,01 % des lignes (1 sur 10 000) contiennent une incohérence.BRUTE_FORCE: extrait et compare chaque ligne d'une seule passe de requête non partitionnée. Les paramètres de partitionnement sont ignorés lorsqueBRUTE_FORCEest utilisé.
Configurer les clés de comparaison
Une clé de comparaison est la ou les colonnes utilisées pour identifier et joindre de manière unique les lignes entre les systèmes source et cible. La clé de comparaison décrit les attributs qui fournissent une unicité suffisante pour une jointure stable.
Lorsque vous exécutez une comparaison de données au niveau des lignes, vous pouvez configurer des clés de comparaison de l'une des manières suivantes :
- Détection automatique : omettez
comparisonKeysde la sectionsourceTablepour que l'outil de validation détecte automatiquement les clés primaires dans votre base de données source lors de la vérification préliminaire (en revenant aux contraintes uniquesNOT NULLsur Oracle et Snowflake, aux index uniques sur Teradata, ou à une seule colonneDISTKEYouSORTKEYsur Amazon Redshift). Clés composites ou personnalisées manuelles : spécifiez manuellement des clés de comparaison composites ou personnalisées en listant les noms des colonnes de clés sources dans
comparisonKeyssoussourceTable. Les différences de casse entre les noms des colonnes de clé source et cible sont automatiquement mises en correspondance. Si une colonne de clé de comparaison a été renommée dans BigQuery, mappez-la souscolumnSettings.columns.SOURCE_COLUMN.targetColumn. L'exemple suivant configure une clé de comparaison composite :table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
Comparaison de hachage pour les tables sans clé unique : si une table n'a pas de clé primaire, sous
sourceTable, définissezuseAllColumnsAsKey: true. Cette option est également sélectionnée automatiquement lorsque l'inspection des métadonnées préliminaire ne trouve aucune clé primaire.
Configurer l'extraction partitionnée pour les tables volumineuses
Lorsque la stratégie d'une table est résolue en SAMPLE et qu'un bloc partitioning est présent dans la configuration de la table (ce que generate-config écrit par défaut) ou que le nombre de lignes de la table dépasse 1,000,000, l'outil de validation divise la table en tranches afin que les requêtes d'échantillonnage analysent des plages limitées au lieu de trier l'intégralité de la table en une seule fois. Lorsqu'elle est partitionnée, jusqu'à sampleSize lignes sont extraites par tranche. Pour limiter la validation à un sous-ensemble de lignes, utilisez plutôt whereClause.
Pour configurer l'extraction partitionnée, utilisez le bloc partitioning dans la section table:. Exemple :
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
Le bloc partitioning accepte les champs suivants :
type:INTEGER_RANGE: divise la table en intervalles de clés-valeurs numériques (COLUMN BETWEEN START AND END). Il s'agit de la valeur par défaut.DATE_RANGE: divise la table en intervalles de date ou de code temporel. Compatible avec PostgreSQL et Snowflake.PHYSICAL: utilise des partitions de base de données pour les tables Oracle et Amazon Redshift lorsque des métadonnées de partition physique sont présentes.
column: spécifie une colonne numérique, de date ou d'horodatage indexée dans votre table source, utilisée pour calculer les limites des tranches. Les lignes contenant des valeursNULLdans la colonne de partitionnement sont exclues des tranches basées sur des plages (INTEGER_RANGEetDATE_RANGE).partitionSize: pour le typeINTEGER_RANGE, cette valeur spécifie la largeur de la plage de clés-valeurs numériques par tranche, où la valeur par défaut est1000000. Pour le typeDATE_RANGE, cette valeur spécifie le nombre de jours par tranche, la valeur par défaut étant30.maxSlices: spécifie le nombre total maximal de tranches autorisées pour la table (défini soustable:). Si une table nécessite plus de tranches quemaxSlices, la planification de la partition échoue avec une erreur nécessitant une valeurpartitionSizeoumaxSlicesplus élevée.maxConcurrency: spécifie le nombre de threads de travail parallèles utilisés pour extraire des segments, où la valeur par défaut est1. Définissez soustable:.
Personnaliser les vérifications globales
L'analyse agrégée est activée par défaut et complète l'échantillonnage au niveau des lignes par des vérifications agrégées au niveau macro. Cette configuration est utile pour valider des tables volumineuses où l'échantillonnage aléatoire peut ne pas détecter un décalage subtil des données.
Sans configuration de colonne personnalisée, l'outil de validation applique automatiquement des vérifications d'agrégation standards en fonction des types de colonnes :
- Valeur numérique exacte (
INTEGER,NUMERIC,BIGNUMERIC) :COUNT,SUM,AVG,MIN,MAX - Virgule flottante (
FLOAT,DOUBLE,REAL) :COUNT,MIN,MAX - Booléen (
BOOLEAN) :COUNT,COUNT_TRUE,COUNT_FALSE,COUNT_NULL - Chaîne (
STRING,VARCHAR,CHAR,TEXT) :COUNT,SUM_LENGTH - Date, heure et code temporel :
COUNT,MIN,MAX
Vous pouvez personnaliser ou désactiver les vérifications d'agrégation à l'aide de la section columnSettings. L'exemple suivant montre comment configurer des tolérances d'agrégation et ignorer des vérifications de colonnes spécifiques :
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
Les règles de configuration d'agrégation suivantes s'appliquent :
- Les clés de colonne sous
columnSettings.columnsdoivent correspondre au nom de la colonne source en respectant la casse. - L'agrégat
toleranceest un seuil de différence absolue (ABS(target - source) <= tolerance). Si aucun agrégattolerancen'est défini (au niveau de la colonne ou decolumnSettings.aggregate.tolerance) et que la colonne comporte un paramètretolerances.numericau niveau de la ligne,AVG,MINetMAXhéritent directement detolerances.numeric, tandis queSUMmultiplie la tolérance héritée au niveau de la ligne parCOUNT. - Vous ne pouvez remplacer
functionsqu'une seule fois par colonne souscolumnSettings.columns.SOURCE_COLUMN.aggregate.functions.
Exclure des colonnes, mapper des noms de colonnes et appliquer des expressions de comparaison SQL
Vous pouvez utiliser columnSettings pour exclure des colonnes, définir des tolérances numériques ou temporelles, mapper des colonnes cibles renommées ou appliquer des transformations SQL avant la comparaison. Chaque clé sous columnSettings.columns correspond au nom de la colonne source. Utilisez la propriété targetColumn dans cette entrée lorsque la colonne porte un nom différent dans BigQuery. Exemple :
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings accepte les champs suivants :
exclude: spécifiez une liste de noms de colonnes ou de formats glob (*) non sensibles à la casse à exclure de tous les piliers de validation.tolerances:numeric: tolérance pour les colonnes numériques (ABS(target - source) <= tolerancepour la comparaison basée sur les clés, ou arrondi àceil(-log10(tolerance))décimales lorsqueuseAllColumnsAsKey: true).timestamp: tolérance en secondes pour les colonnes de code temporel. Par exemple,0.001pour une milliseconde.date: tolérance en jours pour les colonnes de date.
columns: mappage des paramètres par colonne, avec comme clé le nom de la colonne source (SOURCE_COLUMN) :targetColumn: mappe la colonne source à une colonne cible portant un nom différent dans BigQuery.transform: transformation intégrée appliquée avant la comparaison :TRIM,UPPER,LOWER: compatibles avec tous les dialectes.EMPTY_TO_NULL,NULL_TO_EMPTY,CAST_TO_STRING: compatibles avec les requêtes sources pour les sources PostgreSQL, Amazon Redshift, Oracle et Teradata.
transformExpression: expression SQL personnalisée qui fait référence au nom littéral de la colonne source. Exemple :"ROUND(SOURCE_COLUMN, 4)". Étant donné que l'expression est évaluée à la fois sur la requête source et sur la requête de comparaison BigQuery, utilisez des fonctions SQL valides à la fois dans votre dialecte source et dans GoogleSQL.
Normalisation des valeurs
Lors de la comparaison au niveau des lignes (--data), le service de validation normalise les valeurs afin que les différences de représentation entre les moteurs sources et BigQuery ne provoquent pas d'incohérences. Le service de validation normalise les valeurs de la manière suivante :
- Types numériques exacts (
INTEGER,NUMERIC,DECIMAL,BIGNUMERIC) : dans la comparaison basée sur les clés, les valeurs sont comparées à l'échelle complète (jusqu'à 9 décimales pourNUMERICou jusqu'à 38 décimales pourBIGNUMERIC). Lorsquetolerances.numericest défini, les valeurs correspondent quandABS(target - source) <= tolerance. Dans la comparaison de hachage de ligne complète (useAllColumnsAsKey: true), les valeurs sont arrondies à neuf décimales par défaut, ou àceil(-log10(tolerance))décimales lorsqu'une tolérance numérique est définie. - Types à virgule flottante (
FLOAT,DOUBLE,REAL) : normalisés à six décimales (1e-6) par défaut. - Codes temporels : normalisés au format UTC avec une précision de l'ordre de la microseconde.
- Types de caractères à largeur fixe (
CHAR,NCHAR,CHARACTER) : les espaces de début et de fin sont automatiquement supprimés pour s'aligner sur la sémantiqueSTRINGde BigQuery.
Exécuter le service de validation
Une fois que vous avez défini votre configuration de validation, exécutez la commande validate pour démarrer l'outil de validation de la migration. Vous pouvez transmettre un chemin d'accès local ou un URI Cloud Storage gs:// pointant vers le répertoire validation_config/.
L'exemple suivant exécute le service de validation sur des fichiers de configuration de validation stockés localement :
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
Remplacez PATH_TO_VALIDATION_CONFIG par le chemin d'accès à votre répertoire validation_config/ modulaire.
Si votre configuration de validation est stockée dans Cloud Storage, transmettez l'URI gs:// du répertoire de configuration :
gcloud bq migration validate gs://BUCKET_NAME/validation_config
Remplacez BUCKET_NAME par le nom de votre bucket Cloud Storage.
Par défaut, le service de validation exécute le service de validation sur les trois piliers de validation :
--schema: valide uniquement le schéma--aggregate: valide l'agrégat uniquement--data: valide uniquement les données au niveau des lignes
Vous pouvez exécuter le service de validation sur un pilier de validation spécifique à l'aide des options de pilier. L'exemple suivant exécute la validation du schéma et des agrégats sur deux tables spécifiques avec un filtre WHERE personnalisé :
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
La commande validate accepte les options facultatives suivantes :
--tableou--tables: liste de noms de tables à valider, séparés par une virgule. La correspondance--tablesest sensible à la casse et doit correspondre à la casse utilisée danssourceTable.nameoutargetTable.name.--where SQL_PREDICATE: remplacewhereClausepour les tables source et cible lors de cette exécution.--source-where SQL_PREDICATE: remplacewhereClausepour la table source uniquement.--target-where SQL_PREDICATE: remplacewhereClausepour la table cible uniquement.--gcs-path: remplacegoogleCloudStorage.gcsPath. Par exemple,--gcs-path gs://my-bucket/validation.--max-concurrency,--concurrencyou--threads: remplacemaxConcurrencypour l'extraction de tranches parallèles.--no-partitionou--disable-partitioning: désactive l'extraction de tranches partitionnées pour toutes les tables de l'exécution.--labels KEY=VALUE[,KEY=VALUE...]: associe des étiquettes clé-valeur personnalisées aux résultats de l'exécution.--output-dir: répertoire local pour les fichiers d'état et de métadonnées d'exécution temporaires. La valeur par défaut est/tmp/validation_outputs.-v,--verbose,-dou--debug: active la journalisation détaillée ou de débogage.
Transfert de workflow asynchrone
validate effectue l'extraction de la source de manière synchrone, puis déclenche un workflow asynchrone du service de migration BigQuery pour chaque table.
Si votre ensemble de données cible se trouve dans un emplacement autre que
us, par exempleeu, définissez la variable d'environnementBQMS_VALIDATION_LOCATIONavant d'exécutervalidate:export BQMS_VALIDATION_LOCATION=LOCATION
Pour chaque table, vérifiez que le résultat inclut une ligne
Workflow:contenant le nom de la ressource de workflow créée. Exemple :Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
Le code de sortie
0indique que l'extraction et l'importation de la source ont réussi, et non que la comparaison de la cible est terminée ou que les données correspondent. Si la création du workflow échoue, par exemple en raison d'une autorisation manquante, la CLI consigne un avertissement indiquant que le déclenchement du workflow de validation a échoué, affiche une commande de remplacement manuellegcloudet omet la ligneWorkflow:, même si le processus se termine avec0.
Afficher les résultats de validation
Une fois l'exécution de la validation terminée, affichez les résultats de la validation dans la consoleGoogle Cloud en interrogeant l'ensemble de données de résultats validation_results, en interrogeant l'ensemble de données BigQuery configuré sous results dans settings.yaml ou en lisant les rapports récapitulatifs dans Cloud Storage. Sélectionnez l'une des options suivantes :
Console Google Cloud
Accédez à la page Services de migration de la console Google Cloud .
Sous Valider la migration, cliquez sur Afficher les éléments récents.
Cliquez sur Sélectionner un projet, puis sélectionnez le projet dans lequel l'ensemble de données
validation_resultsest stocké.
GoogleSQL
Interrogez TARGET_PROJECT_ID.validation_results.run_history pour vérifier l'état des exécutions de validation récentes :
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
Remplacez TARGET_PROJECT_ID par l'ID du projet dans lequel l'ensemble de données validation_results est stocké.
Pour obtenir des métriques détaillées par colonne et des tendances historiques, exécutez la requête suivante :
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: nombre d'incohérences par exécution et par colonne, comparaisons agrégées et état de réussite ou d'échec<var>TARGET_PROJECT_ID</var>.validation_results.column_history: historique d'audit des colonnes longitudinales sur plusieurs exécutions<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: lignes et colonnes échantillonnées où les valeurs source et cible différaient
Rapports Cloud Storage
Chaque exécution terminée écrit les artefacts de rapport suivants dans le répertoire gcs_uri de l'exécution (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/) :
validation_summary.txt: synthèse des résultats de comparaison des schémas, des agrégats et des lignescolumn_details.txt: répartition par colonne des non-correspondances et des différences agrégéesresults.json: rapport JSON structuré de tous les résultats de validationqueries.sql: requêtes SQL exactes exécutées lors de l'exécution de la validation
Pour imprimer le rapport récapitulatif d'une exécution, exécutez la commande suivante :
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
Interpréter les résultats de la validation
Chaque exécution de validation dans validation_results.run_history renvoie l'une des valeurs d'état d'exécution suivantes, ou status :
| État | Description | Action recommandée |
|---|---|---|
IN_PROGRESS |
Le workflow de validation est toujours en cours d'exécution dans BigQuery. | Attendez que finished_at soit renseigné, puis interrogez à nouveau run_history. |
COMPLETED |
Le pipeline de validation s'est terminé sans aucune incohérence au niveau des lignes ou des agrégats. Les détails de compatibilité des types de schémas sont enregistrés séparément dans validation_summary.txt et column_history. |
Aucune action requise. La table a été validée. |
HEALED |
Le pipeline de validation s'est terminé sans aucune ligne manquante, et toutes les différences de valeurs détectées étaient des variations microscopiques de la représentation en virgule flottante (< 1e-4 pour les comparaisons au niveau des cellules et < 1e-6 pour les agrégats) automatiquement rapprochées par le validateur. |
Considéré comme une exécution réussie. Vous pouvez éventuellement configurer un tolerance numérique explicite si vous souhaitez supprimer la gigue en amont. |
COMPLETED_WITH_MISMATCHES |
Le pipeline de validation s'est exécuté complètement et a détecté des lignes manquantes, des colonnes cibles manquantes, des différences d'agrégation ou des différences de données au niveau des cellules entre les tables source et cible. Cela indique que l'exécution de la validation est terminée, et non un plantage du système. | Inspectez column_details.txt, run_metrics et run_RUN_ID_mismatches_details pour examiner les colonnes et les lignes non concordantes. Pour en savoir plus, consultez Types de non-correspondance au niveau des colonnes. |
ERROR |
Le pipeline de validation n'a pas pu se terminer en raison d'une erreur système ou de configuration. Par exemple, en raison d'une table cible manquante, d'une erreur d'autorisation ou d'un code SQL non valide dans un whereClause ou un transformExpression personnalisé. |
Vérifiez la colonne error_message dans run_history. Pour en savoir plus sur la résolution des erreurs courantes, consultez Dépannage. |
Types de non-correspondance au niveau des colonnes
Lorsqu'une exécution se termine par COMPLETED_WITH_MISMATCHES, les tables de non-concordance par exécution classent chaque comparaison de colonnes avec l'un des résultats suivants :
EXACT_MATCH: les valeurs de cellule comparées pour la colonne correspondent aux tolérances configuréesDATA_DRIFT: lignes correspondant àcomparisonKeys, mais les valeurs des cellules différaient au-delà de la tolérance configuréeSCHEMA: la colonne existe dans la table source, mais est manquante dans la table cible.ROW: des lignes sources étaient manquantes dans la table cible, ou des lignes cibles étaient manquantes dans la table source, lors de la jointure surcomparisonKeys.
Résoudre les erreurs courantes
Le tableau suivant liste les erreurs courantes de ligne de commande et de workflow, et indique comment les résoudre :
| Message d'erreur ou problème | Cause | Solution |
|---|---|---|
Failed to load or parse YAML |
Un bloc de table, partitioning, columnSettings ou googleCloudStorage contient une clé non reconnue ou une valeur d'énumération non valide, telle que SAMPLING au lieu de SAMPLE. |
Vérifiez l'indentation YAML et les noms de champs par rapport aux options de paramétrage de la table. |
Connection name '...' is invalid. Must be alphanumeric. |
Un nom de profil sous connections: contient des traits de soulignement ou des traits d'union. Exemple :my_source |
Renommez les profils de connexion avec des noms alphanumériques tels que source et target. |
googleCloudStorage cannot be null |
googleCloudStorage.gcsPath est manquant dans validation_config/settings.yaml et --gcs-path n'a pas été transmis. |
Définissez googleCloudStorage.gcsPath: gs://BUCKET/PREFIX sans barre oblique finale dans validation_config/settings.yaml. |
Target discovery directory 'validation_config/' is non-empty |
generate-config a été exécuté sans --update, --force ou --clean alors que validation_config/ contenait déjà des fichiers YAML. |
Transmettez --update pour fusionner les tables découvertes tout en conservant vos connections.yaml et settings.yaml existants. |
tables is required lors de l'exécution de validate |
Un ancien fichier validation-config.yaml sans liste tables: existe dans le répertoire de travail et prévaut sur validation_config/, ou aucun fichier YAML de table n'existe sous validation_config/. |
Supprimez tout fichier validation-config.yaml parasite de votre répertoire de travail afin que validate charge validation_config/. |
| Erreur de vérification préliminaire sur une seule clé de comparaison à faible cardinalité | Une table contenant plus de 1 000 lignes filtrées est configurée avec une seule clé de comparaison à faible cardinalité, ce qui entraînerait une explosion de jointure plusieurs à plusieurs. | Spécifiez toutes les colonnes qui forment une clé composite unique dans comparisonKeys ou définissez useAllColumnsAsKey: true sous sourceTable. |
Failed to initialize MemoryUtil ou InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
La JVM est Java 17 ou une version ultérieure, et a été démarrée sans --add-opens=java.base/java.nio=ALL-UNNAMED, généralement parce que la ligne de commande a été lancée via un wrapper personnalisé ou directement avec java -jar. |
Définissez JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" dans l'environnement ou utilisez la commande gcloud bq migration validate. |
WARNING: Failed to trigger validation workflow |
L'extraction de la source a réussi, mais l'appel de CreateMigrationWorkflow a échoué en raison d'autorisations IAM manquantes, d'une API non activée ou d'un emplacement non compatible. |
Vérifiez que bigquerymigration.googleapis.com est activé, que votre compte dispose de roles/bigquerymigration.editor et que BQMS_VALIDATION_LOCATION correspond à l'emplacement de votre ensemble de données. |
Nettoyer les artefacts de validation
Pour gérer les coûts de stockage après avoir examiné les résultats de la validation, procédez comme suit :
- Dans Cloud Storage, supprimez les anciens répertoires d'exécution sous le préfixe
gcsPathde votre bucket de préproduction, ou configurez une règle de gestion du cycle de vie des objets sur le bucket. - Dans BigQuery, les tables de comparaison par exécution de votre ensemble de données de résultats (
validation_resultspar défaut) expirent automatiquement aprèsresultTtlHours(168.0heures ou sept jours par défaut). AjustezresultTtlHoursdanssettings.yamlpour raccourcir ou allonger la durée de conservation, ou supprimez manuellement les tables par exécution tout en laissant intactes les tables et vues d'historique partagées (run_history,run_metricsetcolumn_history). - Lorsque vous travaillez avec des fichiers locaux, supprimez le répertoire de travail local écrit par l'outil de validation sous
--output-dir. Le répertoire par défaut est/tmp/validation_outputs.
Tarifs
Le service de validation utilise les ressources suivantes dans votre projet :
- Calcul et stockage BigQuery : les requêtes d'agrégation cibles, les jointures de comparaison de lignes et le stockage des tables de l'ensemble de données
validation_resultssont facturés à votre projet Google Cloud ou àbillingProjectIds'il est configuré sur la connexiontarget, conformément aux tarifs BigQuery standards. - Stockage et réseau Cloud Storage : les exemples de fichiers Parquet ou CSV, ainsi que les rapports de résultats dans votre bucket sont facturés conformément aux tarifs standards de Cloud Storage.
- Charge de la base de données source : les requêtes d'extraction s'exécutent directement sur votre base de données source. Pour minimiser la charge sur les tables sources volumineuses, utilisez
strategy: SAMPLE, filtrez avecwhereClauseou définissezskipRandomization: truelorsque la surcharge de tri aléatoire n'est pas souhaitable.
Étapes suivantes
- Découvrez comment générer des métadonnées pour la traduction et l'évaluation à l'aide de l'outil
dwh-migration-dumper. - Traduisez des requêtes SQL par lot pour convertir vos scripts SQL et LDD sources en GoogleSQL.
- Planifiez une migration avec la traçabilité de la migration pour visualiser les dépendances aux données dans votre entrepôt de données source.