


Valida la migración de tu almacén de datos
El servicio de validación del Servicio de migración de BigQuery te permite verificar que las tablas migradas desde tu almacén de datos de origen coincidan con las tablas de destino en BigQuery. Puedes comparar esquemas y datos de tablas para identificar discrepancias durante la migración.
El cliente del servicio de validación se conecta a tu base de datos de origen y extrae el esquema de origen y los datos de las filas a un bucket de Cloud Storage que controlas. Una vez extraídos, el servicio de validación compara el esquema y los datos extraídos en el bucket de Cloud Storage con tus tablas de BigQuery migradas.
Un flujo de trabajo de validación compara tus tablas de origen y las tablas de BigQuery de destino en tres pilares de validación:
- Validación de esquemas (
--schema): Compara los nombres de las columnas, los tipos de datos y la compatibilidad de tipos entre la tabla de origen y la tabla de BigQuery de destino. - Validación de agregación (
--aggregate): Calcula y compara métricas de agregación a nivel de tabla y de columna, como recuentos de filas,SUM,AVG,MIN,MAX, distribuciones booleanas y longitudes de cadenas, en toda la tabla. - Validación de datos (
--data): Realiza una comparación fila por fila con un análisis exhaustivo de la tabla completa (BRUTE_FORCE) o un muestreo aleatorio basado en claves (SAMPLE) para detectar filas faltantes y desvío de valores a nivel de celda.
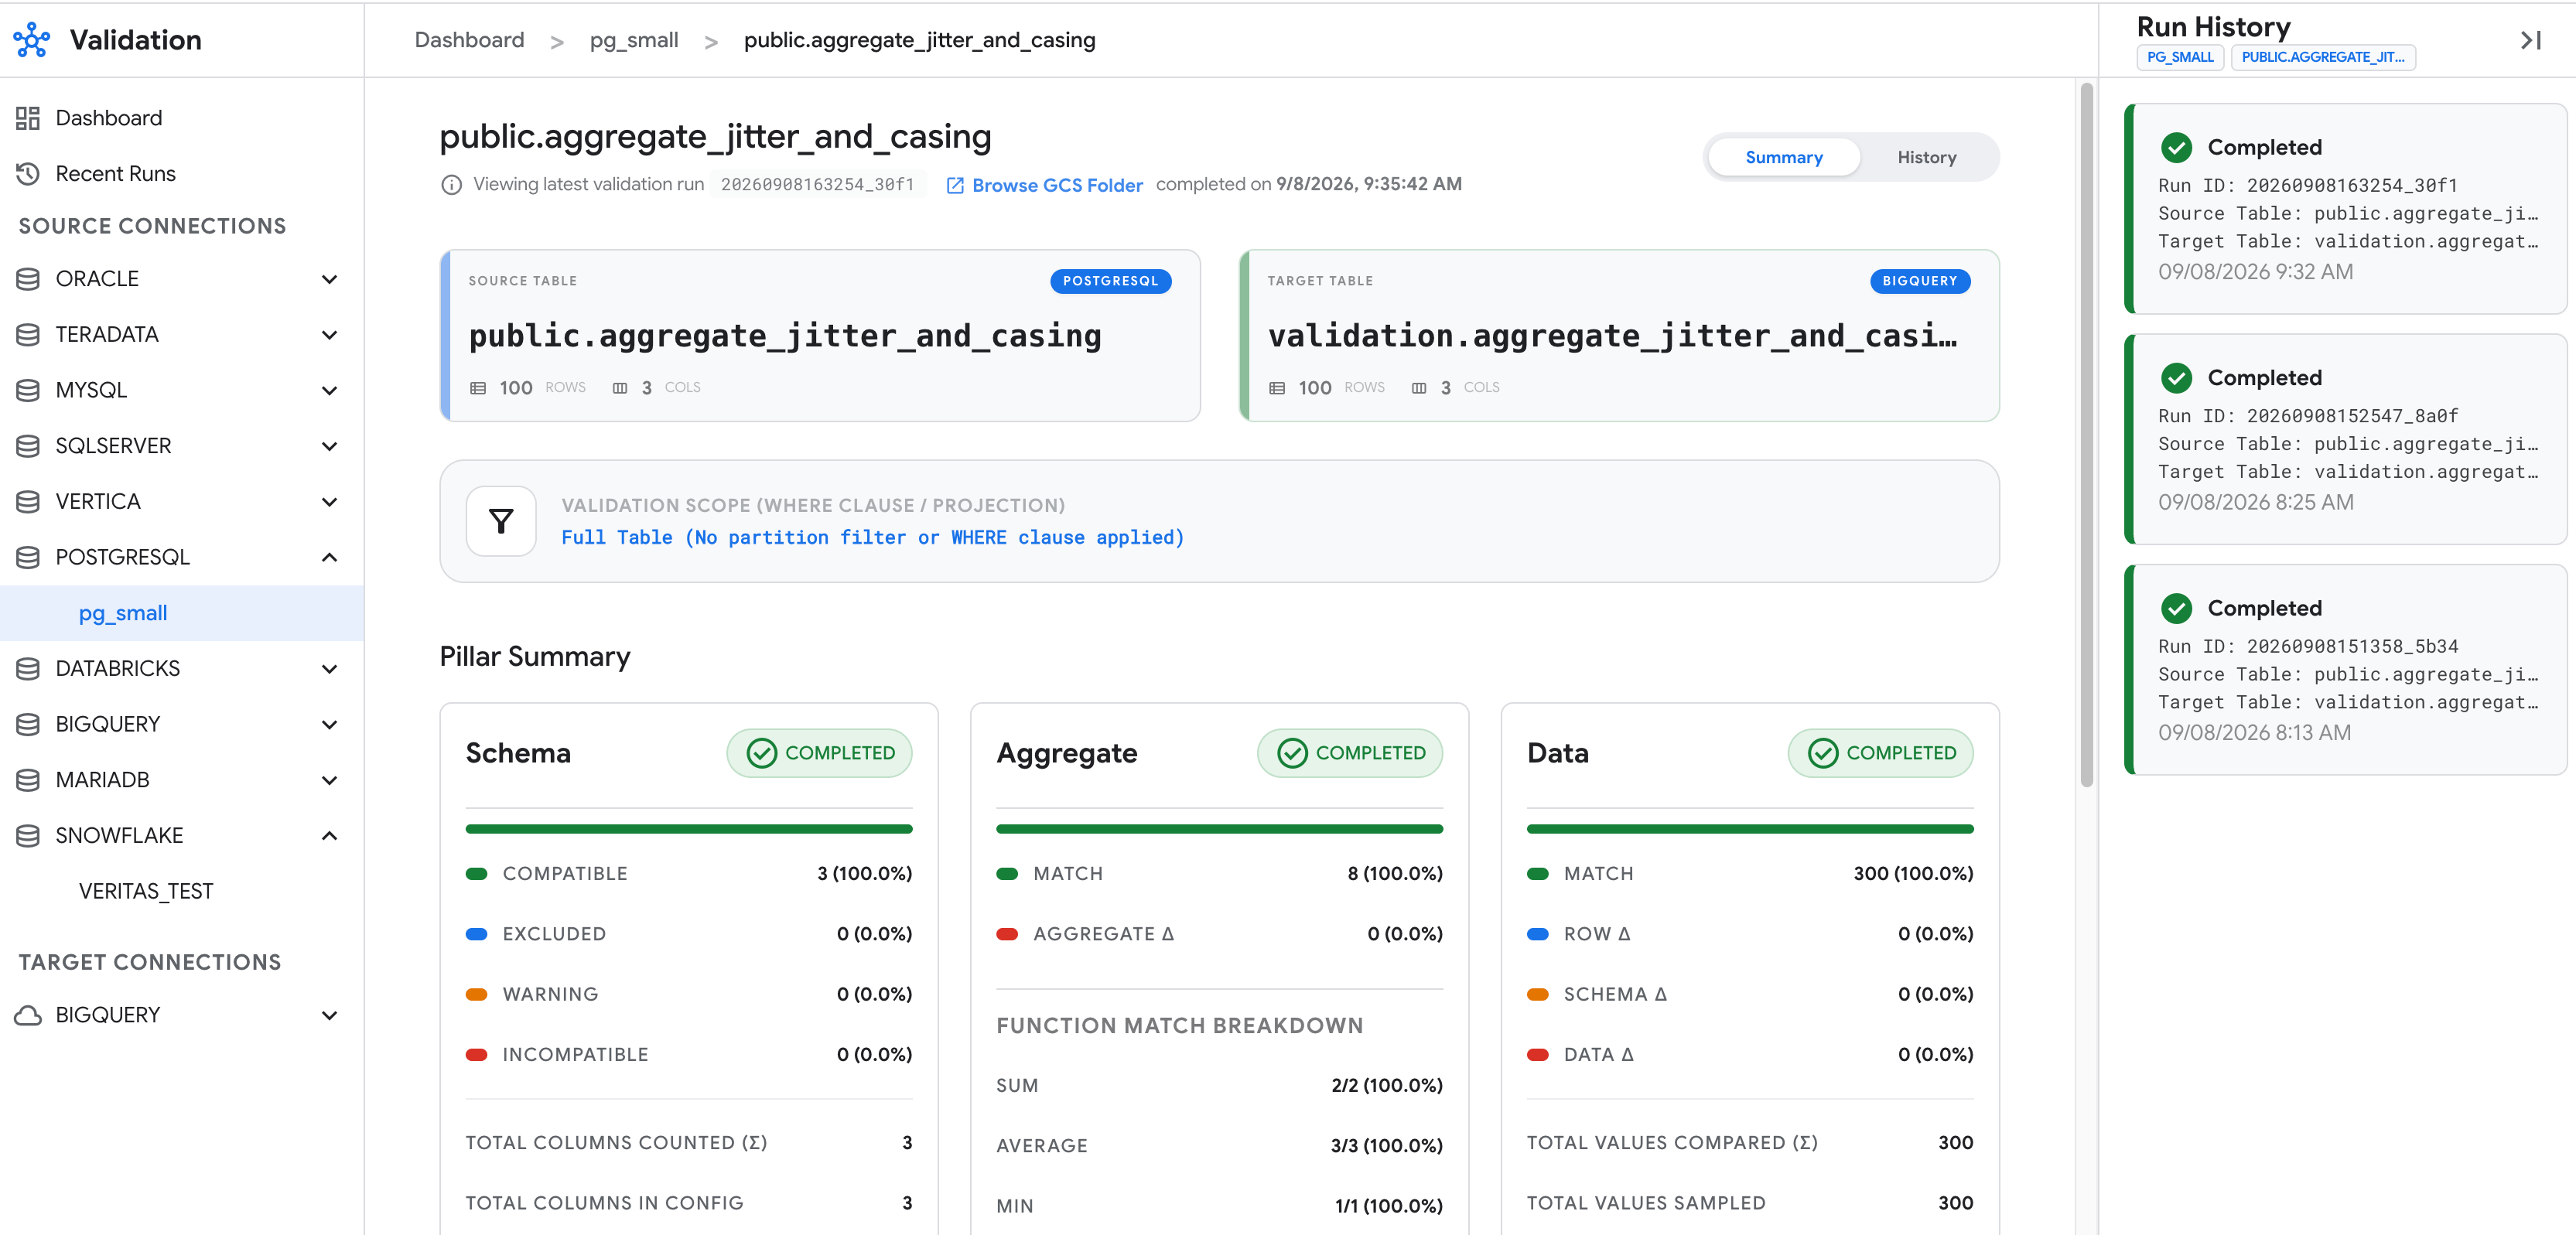
Ubicaciones admitidas
El servicio de validación está disponible en ubicaciones seleccionadas. Para obtener más información, consulta Ubicaciones del Servicio de migración de BigQuery.
Consideraciones sobre el manejo y la seguridad de los datos
El servicio de validación extrae y almacena en etapa intermedia diferentes datos según el pilar de validación que ejecutes:
- Validación de esquema (
--schema): Sube solo nombres de columnas, tipos de datos y estadísticas de tablas al archivosource_query_result.json, sin extraer valores de celda. - Validación de agregación (
--aggregate): Sube métricas de agregación calculadas al archivosource_aggregates.parquet, incluidos los valores reales de las celdasMINyMAXde las columnas incluidas. - Validación de datos (
--data): Extrae valores de celda sin procesar y sin enmascarar de las filas de muestra o de todas las filas cuando se usa la estrategiaBRUTE_FORCE. Sube estos valores en formato Apache Parquet o CSV a tu bucket de etapa de pruebas de Cloud Storage y los carga en el conjunto de datosvalidation_resultsen BigQuery.
Para proteger tus datos y tu entorno de validación, establece los siguientes parámetros de configuración:
- Excluye columnas sensibles: Agrega columnas sensibles al campo
columnSettings.excludepara omitirlas de las consultas de extracción de origen, las comparaciones de destino y los informes de validación. - Minimiza el almacenamiento de datos local: Establece el campo
googleCloudStorage.gcsPathen el archivosettings.yamlpara transmitir las filas de muestra directamente a Cloud Storage sin escribirlas en el disco local. En los hosts compartidos, borra el directorio de trabajo local--output-dirdespués de cada ejecución para quitar los archivos de metadatos, agregados y de registro locales. - Encripta los datos y los resultados en etapa de pruebas: Configura las claves de encriptación administradas por el cliente (CMEK) con Cloud Key Management Service en tu bucket de etapa de pruebas de Cloud Storage y tu conjunto de datos de resultados de BigQuery (
validation_resultsde forma predeterminada o el conjunto de datos especificado en el camporesults.dataset) antes de ejecutar la validación. - Restringe el acceso a la configuración: Almacena los archivos de configuración de validación en un
repositorio con control de versiones que requiera una revisión de código o en un
bucket de Cloud Storage en el que solo los usuarios de confianza tengan el
permiso
storage.objects.create. - Aplica el acceso de privilegio mínimo: otorga al creador del flujo de trabajo el
rol
roles/bigquery.dataViewersolo en los conjuntos de datos o las tablas de destino que se validan, no en el proyecto. Usa un usuario de la base de datos de origen de solo lectura, como se describe en Configura los privilegios de la base de datos de origen.
Antes de comenzar
En la consola de Google Cloud , en la página del selector de proyectos, selecciona o crea un proyecto de Google Cloud que contenga tus conjuntos de datos de BigQuery de destino.
Verifica que la facturación esté habilitada para tu proyecto de Google Cloud .
Habilita las APIs de BigQuery, BigQuery Migration Service, Cloud Storage y (si almacenas contraseñas de bases de datos en Secret Manager) Secret Manager.
Crea o selecciona un bucket de Cloud Storage en la misma ubicación que tu conjunto de datos de BigQuery de destino para almacenar en etapa intermedia los metadatos extraídos y las muestras de datos. Para obtener más información, consulta Crea un bucket.
Roles y permisos requeridos
Una ejecución de validación tiene tres partes, y cada una puede realizarla un principal diferente:
- Recopilación de datos: El cliente de validación lee tu base de datos de origen y sube metadatos, agregaciones y filas de muestra a tu bucket de etapa de pruebas de Cloud Storage. No llama a BigQuery.
- Validación: Un flujo de trabajo de validación del Servicio de migración de BigQuery compara los datos
en etapa de pruebas con tus tablas de destino. El flujo de trabajo se ejecuta con las credenciales de la
principal que lo creó, ya sea que esa principal sea el cliente de validación,
gcloudo la consola de Google Cloud . - Visualización de resultados: lectura del conjunto de datos de resultados y los informes de Cloud Storage.
generate-config no requiere ningún permiso Google Cloud .
Recopilación de datos
Para obtener los permisos que necesitas para recopilar datos de origen, pídele a tu administrador que te otorgue los siguientes roles de IAM:
- Creador de objetos de Storage (
roles/storage.objectCreator) en el bucket de etapa de pruebas - Visualizador de objetos de Storage (
roles/storage.objectViewer) en el bucket de etapa de pruebas -
Lee archivos de configuración de Cloud Storage:
Visualizador de objetos de almacenamiento (
roles/storage.objectViewer) en el bucket de configuración -
Lee las contraseñas de la base de datos desde Secret Manager:
Descriptor de acceso a secretos de Secret Manager (
roles/secretmanager.secretAccessor) en el secreto
Para obtener más información sobre cómo otorgar roles, consulta Administra el acceso a proyectos, carpetas y organizaciones.
Estos roles predefinidos contienen los permisos necesarios para recopilar datos de origen. Para ver los permisos exactos que son necesarios, expande la sección Permisos requeridos:
Permisos necesarios
Se requieren los siguientes permisos para recopilar datos de origen:
-
storage.objects.createen el bucket de etapa de pruebas -
storage.objects.geten el bucket de etapa de pruebas -
Lee archivos de configuración de Cloud Storage:
-
storage.objects.geten el bucket de configuración -
storage.objects.listen el bucket de configuración
-
-
Lee las contraseñas de la base de datos desde Secret Manager:
secretmanager.versions.accessen el Secret
También puedes obtener estos permisos con roles personalizados o con otros roles predefinidos.
Con --extract-only, la recopilación de datos no necesita ningún permiso de BigQuery
ni del Servicio de migración de BigQuery. Sin ella, el cliente también crea los
flujos de trabajo de validación y necesita los roles de validación.
Validación
Para obtener los permisos que necesitas para crear y ejecutar flujos de trabajo de validación, pídele a tu administrador que te otorgue los siguientes roles de IAM:
- Editor de MigrationWorkflow (
roles/bigquerymigration.editor) en el proyecto - Usuario de trabajo de BigQuery (
roles/bigquery.jobUser) en el proyecto - Visualizador de datos de BigQuery (
roles/bigquery.dataViewer) en cada conjunto de datos de destino - Editor de datos de BigQuery (
roles/bigquery.dataEditor) en el conjunto de datos de resultados - Usuario de objetos de almacenamiento (
roles/storage.objectUser) en el bucket de etapa de pruebas -
Si el conjunto de datos de resultados no existe:
Usuario de BigQuery (
roles/bigquery.user) en el proyecto
Estos roles predefinidos contienen los permisos necesarios para crear y ejecutar flujos de trabajo de validación. Para ver los permisos exactos que son necesarios, expande la sección Permisos requeridos:
Permisos necesarios
Se requieren los siguientes permisos para crear y ejecutar flujos de trabajo de validación:
-
bigquerymigration.workflows.createen el proyecto -
bigquerymigration.workflows.geten el proyecto -
bigquery.jobs.createen el proyecto -
bigquery.tables.geten cada conjunto de datos de destino -
bigquery.tables.getDataen cada conjunto de datos de destino -
bigquery.datasets.geten el conjunto de datos de resultados -
bigquery.tables.geten el conjunto de datos de resultados -
bigquery.tables.createen el conjunto de datos de resultados -
bigquery.tables.updateen el conjunto de datos de resultados -
bigquery.tables.updateDataen el conjunto de datos de resultados -
bigquery.tables.getDataen el conjunto de datos de resultados -
storage.objects.geten el bucket de etapa de pruebas -
storage.objects.createen el bucket de etapa de pruebas -
storage.objects.deleteen el bucket de etapa de pruebas -
Si el conjunto de datos de resultados no existe:
bigquery.datasets.createen el proyecto
roles/bigquerymigration.editor contiene muchos permisos que la validación
no usa. Para otorgar el privilegio mínimo, asigna un
rol personalizado solo con
bigquerymigration.workflows.create y bigquerymigration.workflows.get.
La validación solo lee tus tablas de destino y escribe únicamente en el conjunto de datos de resultados. Te recomendamos que crees el conjunto de datos de resultados con anticipación para que ninguna principal necesite permiso para crear conjuntos de datos en tu proyecto.
Visualiza los resultados
Para obtener los permisos que necesitas para ver los resultados de la validación, pídele a tu administrador que te otorgue los siguientes roles de IAM:
- Usuario de trabajos de BigQuery (
roles/bigquery.jobUser) en el proyecto que contiene el conjunto de datos de resultados - Visualizador de datos de BigQuery (
roles/bigquery.dataViewer) en el conjunto de datos de resultados -
Lee informes en Cloud Storage:
Visualizador de objetos de Storage (
roles/storage.objectViewer) en el bucket de etapa de pruebas -
Enumera y visualiza los flujos de trabajo de validación en la consola de Google Cloud :
Visualizador de MigrationWorkflow (
roles/bigquerymigration.viewer) en el proyecto
Estos roles predefinidos contienen los permisos necesarios para ver los resultados de la validación. Para ver los permisos exactos que son necesarios, expande la sección Permisos requeridos:
Permisos necesarios
Se requieren los siguientes permisos para ver los resultados de la validación:
-
bigquery.jobs.createen el proyecto -
bigquery.tables.geten el conjunto de datos de resultados -
bigquery.tables.getDataen el conjunto de datos de resultados -
Lee informes en Cloud Storage:
-
storage.objects.geten el bucket de etapa de pruebas -
storage.objects.listen el bucket de etapa de pruebas
-
-
Enumera y visualiza los flujos de trabajo de validación en la consola de Google Cloud :
bigquerymigration.workflows.listen el proyectobigquerymigration.workflows.geten el proyecto
Configura los privilegios de la base de datos de origen
Debes configurar el acceso de solo lectura al usuario de la base de datos de origen con los siguientes privilegios:
SELECTen cada tabla de origen que se valida.- Acceso de lectura a las vistas del catálogo del sistema que se usan para el descubrimiento de esquemas y claves primarias (como las tablas
information_schema,ALL_CONSTRAINTSyALL_TAB_COLUMNSen Oracle, oSVV_COLUMNSypg_attributeen Amazon Redshift).
No otorgues a este usuario privilegios de escritura, DDL ni administrativos. El cliente de validación ejecuta SQL desde tu configuración de validación como este usuario. Para obtener más información, consulta Consideraciones sobre el manejo y la seguridad de los datos.
Limitaciones
El servicio de validación está sujeto a las siguientes limitaciones:
- BigQuery es la única base de datos de destino compatible. No se admite la validación entre dos bases de datos que no sean de BigQuery ni el uso de BigQuery como fuente de validación.
- El conjunto de datos de BigQuery de destino, el conjunto de datos de resultados
(
validation_resultsde forma predeterminada o el conjunto de datos personalizado configurado enresultsensettings.yaml), el bucket de etapa de pruebas de Cloud Storage y la ubicación del flujo de trabajo de validación (BQMS_VALIDATION_LOCATION) deben estar en la misma ubicación. Cuando el servicio de validación crea el conjunto de datos de resultados, establece de forma predeterminada la ubicación del conjunto de datos en la región que usa tu bucket de etapa de pruebas de Cloud Storage y el conjunto de datos de BigQuery de destino, oresults.locationsi se configura de forma explícita. - La compatibilidad con los tipos de datos varía según la fuente. Las columnas con tipos no admitidos se excluyen de la validación. Para obtener más información, consulta Almacenes de datos compatibles.
- Las tablas de comparación por ejecución que se crean en
BigQuery vencen automáticamente según el valor de
resultTtlHoursensettings.yaml, que, de forma predeterminada, es de168.0horas o siete días. No configures un vencimiento de tabla predeterminado a nivel de conjunto de datos en el conjunto de datosvalidation_results, ya que, si lo haces, también vencerán las tablas de auditoría de larga duración, comorun_history,run_metricsycolumn_history. - Los nombres de las tablas de BigQuery distinguen mayúsculas de minúsculas. Cuando
generate-configcrea parámetros de configuración a partir de un archivo de metadatos de la herramientadwh-migration-dumpersin una asignación de traduccióntables.yaml, los nombres de las tablas de destino conservan las mayúsculas y minúsculas del identificador de origen. Por ejemplo, nombres de tablas en mayúsculas de Oracle o Snowflake. Verifica quetargetTable.namecoincida con el caso exacto de tu tabla en BigQuery.
Almacenes de datos compatibles
El servicio de validación admite las siguientes bases de datos de origen. En cada sección, se incluye qué controlador JDBC se incluye en el paquete de instalación, si puedes generar o no configuraciones de tablas automáticamente a partir de un archivo de metadatos de la herramienta dwh-migration-dumper, los tipos de partición admitidos para tablas grandes de esta base de datos y los tipos de datos admitidos para la validación.
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
También se admiten las variantes parametrizadas de los tipos de datos admitidos, como VARCHAR(255) o DECIMAL(10,2).
El servicio de validación carga cualquier archivo JAR en el directorio drivers/ antes de
los controladores descargados automáticamente, por lo que también puedes usar drivers/ para anular
una versión del controlador empaquetado.
Si generas automáticamente un archivo de configuración de validación, las columnas con
tipos de datos no admitidos se agregan automáticamente a columnSettings.exclude. En el caso de las configuraciones manuales, debes excluirlas de forma explícita en columnSettings.exclude.
Para la mayoría de las bases de datos de origen compatibles, la herramienta de validación descarga automáticamente
el controlador de JDBC requerido de Maven Central en el primer uso, verifica su suma de comprobación
SHA-256 y lo almacena en caché de forma local en ~/.cache/google-cloud-bqms/drivers/ (o
$XDG_CACHE_HOME/google-cloud-bqms/drivers/). Para los almacenes de datos que usan controladores de propiedad, como Teradata, o cuando se ejecutan en un entorno sin conexión o aislado, haz lo siguiente:
- Coloca el archivo JAR del controlador requerido en
./drivers/,<sdk_root>/platform/bqms/drivers/o el directorio especificado por la variable de entornoBQMS_DRIVER_DIR. Cualquier JAR de controlador que se coloque en estos directorios locales tiene prioridad sobre las descargas automáticas de Maven Central. - Para inhabilitar por completo las descargas automáticas de red en entornos aislados, configura
BQMS_AUTO_DOWNLOAD_DRIVERS=falseoBQMS_MAVEN_MIRRORpara que apunten a una réplica interna del repositorio de Maven.
Para obtener información sobre cada fuente de datos que admite el servicio de validación, selecciona una de las siguientes opciones:
Teradata
Las validaciones para las migraciones de Teradata se admiten de la siguiente manera:
- Valor de
dialect:teradata - Controlador de JDBC: Proporcionado por el usuario. Descarga el JAR del controlador de JDBC de Teradata, como
terajdbc4.jaroterajdbc.jar, desde Teradata y cópialo en el directoriodrivers/o en el directorio que especificaBQMS_DRIVER_DIR. - Generación automática de configuración: Se admite desde un archivo de metadatos de la herramienta de
dwh-migration-dumper(--connector teradata). - Extracción particionada:
INTEGER_RANGE,PHYSICAL
| Categoría | Tipos de datos |
|---|---|
| Numérico | BYTEINT, SMALLINT, INTEGER, INT, BIGINT, DECIMAL, DEC, NUMERIC, NUMBER, FLOAT, REAL, DOUBLE PRECISION |
| String | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, LONG VARCHAR |
| Fecha y hora | DATE, TIME, TIME WITH TIME ZONE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
Cuando valides las migraciones desde Teradata, ten en cuenta lo siguiente:
- Cuando una tabla no tiene una clave primaria explícita, las claves de comparación se descubren
a partir de índices primarios únicos (
UPI) o índices secundarios únicos (USI). Los índices primarios no únicos (NUPI) no se usan como claves de comparación. - Se admite
NUMBER(P,S)de precisión fija; no se admiteNUMBERsin restricciones (sin precisión).generate-configexcluye automáticamente las columnasNUMBER,CLOB,BLOB,BYTE,VARBYTE,INTERVAL,PERIOD,JSONyXMLsin restricciones (o deben aparecer encolumnSettings.excludepara las configuraciones manuales). - Las columnas
CHARde ancho fijo se recortan automáticamente. Se admiten los conjuntos de caracteresLATINyUNICODE, y los atributosCASESPECIFICyNOT CASESPECIFIC. - Los valores
TIME WITH TIME ZONEyTIMESTAMP WITH TIME ZONEse normalizan a UTC (AT 0) antes de la comparación.
Snowflake
Las validaciones para las migraciones de Snowflake se admiten de la siguiente manera:
- Valor de
dialect:snowflake - Controlador de JDBC: Se descarga automáticamente en el primer uso
(
net.snowflake:snowflake-jdbc) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de configuración: Se admite desde un archivo de metadatos de la herramienta de
dwh-migration-dumper(--connector snowflake). - Extracción particionada:
INTEGER_RANGE,DATE_RANGE
El servicio de validación admite los siguientes tipos de datos para las migraciones de Snowflake:
| Categoría | Tipos de datos |
|---|---|
| Numérico | NUMBER, DECIMAL, NUMERIC, FLOAT, REAL, DOUBLE |
| String | CHAR, VARCHAR, STRING, TEXT |
| Fecha y hora | DATE, TIME, TIMESTAMP_NTZ, TIMESTAMP_LTZ, TIMESTAMP_TZ |
| Booleano | BOOLEAN |
Cuando valides las migraciones desde Snowflake, ten en cuenta lo siguiente:
- Las columnas
CHARde ancho fijo se recortan automáticamente. - Si replicaste datos con el Servicio de transferencia de datos de BigQuery, configura
tolerances.timestamp: 0.001para absorber el redondeo de menos de un milisegundo.
Amazon Redshift
Las validaciones para las migraciones de Amazon Redshift se admiten de la siguiente manera:
- Valor de
dialect:redshift - Controlador de JDBC: Se descarga automáticamente en el primer uso
(
com.amazon.redshift:redshift-jdbc42) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de configuración: Se admite desde un archivo de metadatos de la herramienta de
dwh-migration-dumper(--connector redshift). - Extracción particionada:
INTEGER_RANGE,PHYSICAL
El servicio de validación admite los siguientes tipos de datos para las migraciones de Amazon Redshift:
| Categoría | Tipos de datos |
|---|---|
| Numérico | SMALLINT, INTEGER, BIGINT, DECIMAL, NUMERIC, REAL, DOUBLE PRECISION |
| String | CHAR, VARCHAR, TEXT |
| Fecha y hora | DATE, TIME, TIMETZ, TIMESTAMP, TIMESTAMPTZ |
| Booleano | BOOLEAN |
| Semiestructurados | SUPER |
Cuando valides las migraciones desde Amazon Redshift, ten en cuenta lo siguiente:
- La inspección de esquemas usa
SVV_COLUMNS, por lo que se admiten las vistas de vinculación tardía. - Cuando una tabla no tiene clave primaria, las claves de comparación recurren automáticamente a una sola columna
DISTKEYoSORTKEY. - No se admiten las columnas
GEOMETRY.
Databricks
Las validaciones para las migraciones de Databricks se admiten de la siguiente manera:
- Valor de
dialect:databricks - Controlador de JDBC: Se descarga automáticamente en el primer uso
(
com.databricks:databricks-jdbc) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de configuración: No se admite. Crea un archivo de configuración de tabla manual.
- Extracción particionada:
INTEGER_RANGE
El servicio de validación admite los siguientes tipos de datos para las migraciones de Databricks:
| Categoría | Tipos de datos |
|---|---|
| Numérico | BYTE, TINYINT, SHORT, SMALLINT, INT, INTEGER, LONG, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| Fecha y hora | DATE, TIMESTAMP |
| Booleano | BOOLEAN |
| Objeto binario | BINARY |
| Complejo | ARRAY, MAP, STRUCT |
Cuando valides las migraciones desde Databricks, ten en cuenta lo siguiente:
- Autentica con un token de acceso personal: establece
user: tokeny proporciona el token a través depasswordSecret. - La inspección de esquemas se basa en consultas (
SELECT * ... WHERE 1=0), por lo que se admiten los espacios de trabajo de Unity Catalog y Hive Metastore.
Apache Hive
Las validaciones para las migraciones de Apache Hive se admiten de la siguiente manera:
- Valor de
dialect:hive - Controlador de JDBC: Se descarga automáticamente en el primer uso
(JAR independiente de
org.apache.hive:hive-jdbc) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de configuración: Se admite desde un archivo de metadatos de la herramienta de
dwh-migration-dumper(--connector hiveql). - Extracción particionada:
INTEGER_RANGE
El servicio de validación admite los siguientes tipos de datos para las migraciones de Hive:
| Categoría | Tipos de datos |
|---|---|
| Numérico | TINYINT, SMALLINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| Fecha y hora | DATE, TIMESTAMP |
| Booleano | BOOLEAN |
| Objeto binario | BINARY |
| Complejo | ARRAY, MAP, STRUCT |
Cuando valides las migraciones desde Hive, ten en cuenta lo siguiente:
- La inspección de esquemas se basa en consultas (
SELECT * ... WHERE 1=0). - Las tablas de Hive rara vez definen claves primarias. Las tablas sin claves de comparación usan automáticamente la agregación de hash de fila completa para el pilar de datos.
SQL Server
Las validaciones para las migraciones de SQL Server se admiten de la siguiente manera:
- Valor de
dialect:sqlserver - Controlador de JDBC: Se descarga automáticamente en el primer uso
(
com.microsoft.sqlserver:mssql-jdbc) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de configuración: Se admite desde un archivo de metadatos de la herramienta de
dwh-migration-dumper(--connector sqlserver). - Extracción particionada:
INTEGER_RANGE
El servicio de validación admite los siguientes tipos de datos para las migraciones de SQL Server:
| Categoría | Tipos de datos |
|---|---|
| Numérico | INT, BIGINT, DECIMAL, NUMERIC, FLOAT, REAL |
| String | CHAR, VARCHAR, TEXT |
| Fecha y hora | DATE, DATETIME, TIMESTAMP |
| Booleano | BIT |
Cuando valides las migraciones desde SQL Server, ten en cuenta lo siguiente:
- La URL de JDBC predeterminada establece
encrypt=true;trustServerCertificate=true;. Anúlala con la clave de conexiónurlsi necesitas una validación estricta del certificado TLS.
MariaDB
Las validaciones para las migraciones de MariaDB se admiten de la siguiente manera:
- Valor de
dialect:mariadb - Controlador de JDBC: Se descarga automáticamente en el primer uso
(
org.mariadb.jdbc:mariadb-java-client) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de la configuración: Crea un archivo de configuración de tabla manual.
- Extracción particionada:
INTEGER_RANGE
El servicio de validación admite los siguientes tipos de datos para las migraciones de MariaDB:
| Categoría | Tipos de datos |
|---|---|
| Numérico | TINYINT, SMALLINT, MEDIUMINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, ENUM, SET |
| Fecha y hora | DATE, TIME, DATETIME, TIMESTAMP, YEAR |
| Objetos binarios y grandes | BINARY, VARBINARY, TINYBLOB, BLOB, MEDIUMBLOB, LONGBLOB |
MySQL
Las validaciones para las migraciones de MySQL se admiten de la siguiente manera:
- Valor de
dialect:mysql - Controlador de JDBC: Se descarga automáticamente en el primer uso
(
com.mysql:mysql-connector-j) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de la configuración: Crea un archivo de configuración de tabla manual.
- Extracción particionada:
INTEGER_RANGE
El servicio de validación admite los siguientes tipos de datos para las migraciones de MySQL:
| Categoría | Tipos de datos |
|---|---|
| Numérico | INT, BIGINT, DECIMAL, FLOAT, DOUBLE |
| String | CHAR, VARCHAR, TEXT |
| Fecha y hora | DATE, TIME, DATETIME, TIMESTAMP |
| Booleano | BOOLEAN |
Oracle
Las validaciones para las migraciones de Oracle se admiten de la siguiente manera:
- Valor de
dialect:oracle - Controlador de JDBC: Se descarga automáticamente en el primer uso
(
com.oracle.database.jdbc:ojdbc11) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de configuración: Se admite desde un archivo de metadatos de la herramienta de
dwh-migration-dumper(--connector oracle). - Extracción particionada:
INTEGER_RANGE,PHYSICAL
El servicio de validación admite los siguientes tipos de datos para las migraciones de Oracle:
| Categoría | Tipos de datos |
|---|---|
| Numérico | NUMBER, NUMERIC, INTEGER, FLOAT, DOUBLE |
| String | CHAR, NCHAR, VARCHAR, VARCHAR2, NVARCHAR2 |
| Fecha y hora | DATE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
| Objetos binarios y grandes | RAW, BINARY, BLOB, CLOB, NCLOB |
Cuando valides las migraciones desde Oracle, ten en cuenta lo siguiente:
- Las columnas
DATEincluyen un componente de hora en Oracle. La herramienta de validación extrae las columnasDATEde Oracle con precisión de día (YYYY-MM-DD), por lo que se truncan las diferencias de hora del día.
PostgreSQL
Las validaciones para las migraciones de PostgreSQL se admiten de la siguiente manera:
- Valor de
dialect:postgresql - Controlador de JDBC: Se descarga automáticamente en el primer uso
(
org.postgresql:postgresql) o lo proporciona el usuario en el directoriodrivers/para entornos sin conexión. - Generación automática de configuración: Se admite desde un archivo de metadatos de la herramienta de
dwh-migration-dumper(--connector postgres). - Extracción particionada:
INTEGER_RANGE,DATE_RANGE,PHYSICAL
El servicio de validación admite los siguientes tipos de datos para las migraciones de PostgreSQL:
| Categoría | Tipos de datos |
|---|---|
| Numérico | SMALLINT, INTEGER, BIGINT, NUMERIC, DOUBLE PRECISION |
| String | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, TEXT |
| Fecha y hora | DATE, TIME, TIMESTAMP, TIMESTAMP WITHOUT TIME ZONE, TIMESTAMP WITH TIME ZONE, TIMESTAMPTZ |
| Booleano | BOOLEAN |
| Otro | UUID |
Cuando valides las migraciones desde PostgreSQL, ten en cuenta lo siguiente:
- Los valores de
BIGINTsuperiores a 253 pueden mostrar diferencias de precisión menores enAVG();SUMyCOUNTsiguen siendo exactos.
Configura el directorio y los archivos de configuración de validación
El servicio de validación lee desde un directorio de configuración modular llamado
validation_config/ que contiene los siguientes
archivos:
- Archivo de conexiones de base de datos: Define tu perfil de conexión del almacén de datos de
sourcey tu perfil de conexión de BigQuery detarget. - Archivo de configuración de etapa de pruebas y resultados: Define la ruta de acceso de etapa de pruebas de Cloud Storage (
googleCloudStorage), la configuración del conjunto de datos de resultados de BigQuery (results), el vencimiento de la tabla de comparación por ejecución (resultTtlHours) y los valores predeterminados globales opcionales (tolerances,aggregate,labels). - Archivo de configuración de validación de tablas: contiene asignaciones por tabla
(
sourceTableytargetTable), claves de comparación (comparisonKeys), estrategia de validación (strategy), configuración de extracción particionada (partitioning) y configuración de columnas (columnSettings).
En las siguientes secciones, se describen los pasos para configurar el directorio de configuración de validación y los pasos para crear los archivos de configuración necesarios para una validación de migración.
Crea un directorio de configuración de validación
Crea un directorio de configuración de validación llamado validation_config/ para almacenar
tus archivos de configuración de validación. Puedes almacenar este directorio en la máquina
que ejecuta el servicio de validación o en un bucket de Cloud Storage para
que un equipo pueda compartir una configuración entre ejecuciones.
Crea un archivo de conexiones de base de datos
En el directorio de configuración de validación, crea un archivo llamado connections.yaml
y configúralo con la información para conectarte a una base de datos de origen y a una
base de datos de BigQuery de destino.
Cada fuente de almacén de datos tiene características y requisitos específicos que se deben tener en cuenta cuando se crea el archivo de conexiones de la base de datos. Para obtener más información sobre cada fuente de datos, consulta Almacenes de datos compatibles.
Cuando especificas passwordSecret en un perfil de conexión, el servicio de validación
recupera la versión del Secret de Secret Manager en la máquina cliente
con tus credenciales predeterminadas de la aplicación (ADC) locales y pasa la contraseña
resuelta directamente al controlador JDBC local. Tu base de datos de origen no necesita
acceso de red ni acceso de IAM a Google Cloud, por lo que
passwordSecret funciona para bases de datos locales y bases de datos alojadas en otras
nubes, como Amazon Redshift o Snowflake. Como alternativa, puedes omitir
passwordSecret y establecer la variable de entorno BQMS_VALIDATION_SOURCE_PASSWORD
en la máquina que ejecuta el servicio de validación.
Para crear un archivo de conexiones de base de datos para un almacén de datos, selecciona una de las siguientes opciones:
Teradata
Para las validaciones de migración de Teradata, configura el archivo de conexiones de la base de datos con la siguiente información:
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SOURCE_HOST: Es el nombre de host o la dirección IP de tu sistema de Teradata.SOURCE_DATABASE: Es el nombre de la base de datos de Teradata obligatorio.SOURCE_USER: Es el nombre de usuario de Teradata.SECRET_PROJECT_IDySECRET_ID: Son el ID del proyecto y el ID del Secret en Secret Manager que contienen la contraseña, o bien estableceBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
Snowflake
Para las validaciones de migración de Snowflake, configura tu archivo de conexiones de base de datos con la siguiente información:
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SNOWFLAKE_ACCOUNT: el identificador de tu cuenta de Snowflake (por ejemplo,myorg-myaccount).SNOWFLAKE_WAREHOUSE: Es el almacén virtual que se usa para ejecutar consultas de extracción.SOURCE_DATABASE: Es el nombre de la base de datos de Snowflake obligatorio.SOURCE_SCHEMA: el nombre del esquema de Snowflake obligatorio.SNOWFLAKE_ROLE: Es el rol opcional de Snowflake.SOURCE_USER: Es el nombre de usuario de Snowflake.SECRET_PROJECT_IDySECRET_ID: Son el ID del proyecto y el ID del Secret en Secret Manager que contienen la contraseña, o bien estableceBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
Amazon Redshift
Para las validaciones de migración de Amazon Redshift, configura el archivo de conexiones de la base de datos con la siguiente información:
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SOURCE_HOST: Es el nombre de host del extremo del clúster de Amazon Redshift.SOURCE_DATABASE: Es el nombre de la base de datos de Amazon Redshift obligatorio.SOURCE_SCHEMA: Es el nombre del esquema predeterminado (el valor predeterminado espublicsi se omite).SOURCE_USER: Es el nombre de usuario de la base de datos.SECRET_PROJECT_IDySECRET_ID: Son el ID del proyecto y el ID del Secret en Secret Manager que contienen la contraseña, o bien estableceBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
Databricks
Para las validaciones de migración de Databricks, configura el archivo de conexiones de la base de datos con la siguiente información:
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
DATABRICKS_HOST: Es el nombre de host del servidor de tu clúster o almacén de SQL de Databricks.HTTP_PATH: Es la ruta de acceso HTTP de tu almacén de Databricks SQL (por ejemplo,sql/protocolv1/o/1234567890/0123-456789-abcdef).CATALOG_NAME: Es el nombre obligatorio del catálogo de Unity (ohive_metastore).SCHEMA_NAME: Es el nombre del esquema requerido.SECRET_PROJECT_IDySECRET_ID: el ID del proyecto y el ID del Secret en Secret Manager que contiene tu token de acceso personal (PAT) de Databricks, o bien omitepasswordSecrety estableceBQMS_VALIDATION_SOURCE_PASSWORD. Si usasuser: tokenconpasswordSecret, te aseguras de que tu token nunca se escriba en los archivos de metadatos de etapa de pruebas.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
Apache Hive
Para las validaciones de migración de Apache Hive, configura tu archivo de conexiones de base de datos con la siguiente información:
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SOURCE_HOST: Es el nombre de host o la dirección IP de HiveServer2.SOURCE_DATABASE: Es el nombre de la base de datos de Hive requerida (por ejemplo,default).SOURCE_USER: Es el nombre de usuario de Hive.SECRET_PROJECT_IDySECRET_ID: Son el ID del proyecto y el ID del Secret en Secret Manager que contienen la contraseña, o bien estableceBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
SQL Server
Para las validaciones de migración de SQL Server, configura tu archivo de conexiones de base de datos con la siguiente información:
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SOURCE_HOST: Es el nombre de host o la dirección IP de tu instancia de SQL Server (de manera opcional, especificainstanceNamepara las instancias con nombre).SOURCE_DATABASE: Es el nombre de la base de datos requerida.SOURCE_SCHEMA: Es el nombre del esquema predeterminado (el valor predeterminado esdbosi se omite).SOURCE_USER: Es el nombre de usuario de la base de datos.SECRET_PROJECT_IDySECRET_ID: Son el ID del proyecto y el ID del Secret en Secret Manager que contienen la contraseña, o bien estableceBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
MariaDB
Para las validaciones de migración de MariaDB, configura el archivo de conexiones de la base de datos con la siguiente información:
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SOURCE_HOST: Es el nombre de host o la dirección IP de tu servidor de MariaDB.SOURCE_DATABASE: Es el nombre de la base de datos de MariaDB requerido.SOURCE_USER: Es el nombre de usuario de MariaDB.SECRET_PROJECT_IDySECRET_ID: Son el ID del proyecto y el ID del Secret en Secret Manager que contienen la contraseña, o bien estableceBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
MySQL
Para las validaciones de migración de MySQL, configura el archivo de conexiones de la base de datos con la siguiente información:
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SOURCE_HOST: Es el nombre de host o la dirección IP de tu servidor de MySQL.SOURCE_DATABASE: el nombre de la base de datos de MySQL requerida.SOURCE_USER: Es el nombre de usuario de MySQL.SECRET_PROJECT_IDySECRET_ID: Son el ID del proyecto y el ID del Secret en Secret Manager que contienen la contraseña, o bien estableceBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
Oracle
Para las validaciones de migración de Oracle, configura tu archivo de conexiones de base de datos con la siguiente información:
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SOURCE_HOST: Es el nombre de host o la dirección IP de tu servidor de Oracle.SERVICE_NAME: Es el nombre del servicio de Oracle (se usa para construirjdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME). En el caso de las conexiones de TNS o SID personalizadas, especificaurlcon la URL de JDBC completa.SOURCE_SCHEMA: Es el nombre opcional del esquema predeterminado.SOURCE_USER: Es el nombre de usuario de Oracle obligatorio.SECRET_PROJECT_IDySECRET_ID: el ID del proyecto y el ID del Secret en Secret Manager que contiene la contraseña de la base de datos, o estableceBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloudde destino.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
PostgreSQL
Para las validaciones de migración de PostgreSQL, configura el archivo de conexiones de la base de datos con la siguiente información:
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
Reemplaza lo siguiente:
SOURCE_HOST: Es el nombre de host o la dirección IP de tu servidor de PostgreSQL.SOURCE_DATABASE: Es el nombre de la base de datos de PostgreSQL obligatorio.SOURCE_SCHEMA: Es el nombre del esquema predeterminado (el valor predeterminado espublicsi se omite).SOURCE_USER: Es el nombre de usuario de la base de datos.SECRET_PROJECT_IDySECRET_ID: el ID del proyecto y el ID del secreto en Secret Manager que contiene la contraseña de la base de datos. Como alternativa, omitepasswordSecrety establece la variable de entornoBQMS_VALIDATION_SOURCE_PASSWORD.TARGET_PROJECT_ID: Es el ID del proyecto de Google Cloud que contiene tus tablas de BigQuery migradas y en el que se creará el conjunto de datosvalidation_results.TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino.
Crea un archivo de configuración
Crea un archivo de configuración de etapa de pruebas y resultados llamado settings.yaml en el directorio de configuración de validación para configurar la ruta de etapa de pruebas de Cloud Storage,
el conjunto de datos de resultados de BigQuery, el vencimiento de la tabla por ejecución y
los valores predeterminados globales opcionales.
Configura el archivo de configuración de etapa de pruebas y resultados con lo siguiente:
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
Reemplaza lo siguiente:
BUCKET_NAME: Es el nombre de tu bucket de etapa de pruebas de Cloud Storage.PATH_PREFIX: Es el prefijo del URI de Cloud Storage en el bucket que se usa para almacenar en etapa intermedia los metadatos del esquema extraídos, las métricas agregadas, las filas muestreadas y los informes de resumen.FORMAT: Es el formato de archivo para las muestras de datos de etapa de pruebas. Los valores admitidos sonparquet(predeterminado) ycsv.RESULTS_PROJECT_ID: Es el ID del proyecto de Google Cloud en el que se escriben los resultados de la validación y las tablas del historial de ejecución. Si se omite, el valor predeterminado estarget.projectIddeconnections.yaml.RESULTS_DATASET: Es el nombre del conjunto de datos de BigQuery en el que se escriben los resultados de la validación y las tablas del historial de ejecuciones (run_history,run_metricsycolumn_history). Si se omite, el valor predeterminado esvalidation_results. Si el conjunto de datos no existe, el servicio de validación lo crea automáticamente.RESULTS_LOCATION: Es la ubicación de BigQuery para el conjunto de datos de resultados. Si se omite, un conjunto de datos de resultados creado de forma automática se establece de forma predeterminada en la región de tu bucket de etapa de pruebas de Cloud Storage y el conjunto de datos de BigQuery de destino.RESULT_TTL_HOURS: Es el tiempo de actividad en horas para las tablas de comparación y discrepancia por ejecución que se crean en el conjunto de datos de resultados. El valor predeterminado es168.0horas (7 días). Las tablas de observabilidad de larga duración (run_history,run_metricsycolumn_history) no se ven afectadas porresultTtlHours.RESULTS_CONFIG: Configura el conjunto de datos de BigQuery de destino para los resultados de la comparación y el historial de auditoría. Los valores admitidos sonprojectId,datasetylocation. Cuando se omite, el servicio de validación escribe enTARGET_PROJECT_ID.validation_results` y crea automáticamente el conjunto de datos en la misma región que el conjunto de datos de destino y el bucket de etapa de pruebas de Cloud Storage si aún no existe.
También puedes especificar los valores predeterminados de la tabla global si especificas tolerances,
aggregate o labels en el nivel superior de settings.yaml o
validation-config.yaml. Estos valores predeterminados se aplican a todas las tablas, a menos que se anulen
en la configuración de una tabla individual.
Genera parámetros de configuración de validación de tablas
Después de configurar los archivos de conexiones y parámetros, define los parámetros de configuración de validación de la tabla. El comando generate-config escribe un archivo YAML por
tabla en
validation_config/databases/DATABASE/SCHEMA/TABLE.yaml
con una clave table: de nivel superior, o puedes crear un archivo
validation_config/tables.yaml manual.
Selecciona una de las siguientes opciones para obtener información sobre cómo generar parámetros de configuración de validación de tablas para tu base de datos de origen:
Teradata
Para las validaciones de migración de Teradata, haz lo siguiente para
generar un archivo de metadatos de la herramienta de dwh-migration-dumper de tus esquemas de origen:
- Instala la herramienta de
dwh-migration-dumper. - Ejecuta
dwh-migration-dumperen tu base de datos de origen para producir un archivo de metadatos de la herramientadwh-migration-dumper.
Con el archivo de metadatos, ejecuta generate-config para generar archivos de configuración por tabla. Puedes usar la marca --update para conservar los archivos connections.yaml y settings.yaml existentes que creaste en validation_config/. Por ejemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si también tienes un archivo de asignación de esquemas tables.yaml del
traductor de SQL por lotes, incluye la marca
--tables-yaml, ya sea sola o junto con --metadata para complementar
las asignaciones de tablas traducidas con metadatos de partición de origen y exclusiones de tipos de datos
del archivo de metadatos. Por ejemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
El comando generate-config admite las siguientes marcas:
--metadata PATH_TO_METADATA_ZIP: Es la ruta de acceso a un archivo de metadatos de la herramienta dedwh-migration-dumper(archivo ZIP) o a un directorio que contiene archivos de metadatos.--tables-yaml PATH_TO_TABLES_YAML: Es la ruta de acceso a uno o más archivos o directorios de traducción detables.yaml(separados por comas).--target-dataset TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino que se agregará como prefijo a las entradastargetTable.namegeneradas.-o, --output-dir DIRECTORY: Es el directorio de salida de los archivos de configuración modulares. El valor predeterminado esvalidation_config.--schemas SCHEMA_LIST: Es la lista separada por comas de los esquemas o las bases de datos de origen que se incluirán (distingue mayúsculas de minúsculas; admite comodines*).--tables TABLE_LIST: Es una lista separada por comas de nombres de tablas (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) que se deben incluir (distingue mayúsculas de minúsculas; admite comodines*).--filter-file PATH: Es la ruta de acceso a un archivo delimitado por saltos de línea de nombres de tablas que se incluirán (se ignoran las líneas que comienzan con#).--update: Combina las tablas descubiertas en un directoriovalidation_config/existente y, al mismo tiempo, conserva las anulaciones existentes deconnections.yaml,settings.yamly personalizadas por tabla.--force: Permite escribir archivos de tablas recién descubiertos en un directorio de salida no vacío y, al mismo tiempo, conservar los archivos de configuración de tablas existentes.--clean: Borra todos los archivos existentes en el directorio de salida antes de escribir los archivos recién descubiertos.
Snowflake
Para las validaciones de migración de Snowflake, haz lo siguiente para generar un
archivo de metadatos de la herramienta de dwh-migration-dumper de tus esquemas de origen:
- Instala la herramienta de
dwh-migration-dumper. - Ejecuta
dwh-migration-dumperen tu base de datos de origen para producir un archivo de metadatos de la herramientadwh-migration-dumper.
Con el archivo de metadatos, ejecuta generate-config para generar archivos de configuración por tabla. Puedes usar la marca --update para conservar los archivos connections.yaml y settings.yaml existentes que creaste en validation_config/. Por ejemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si también tienes un archivo de asignación de esquema tables.yaml del
traductor de SQL por lotes, incluye la marca
--tables-yaml, ya sea sola o junto con --metadata para complementar
las asignaciones de tablas traducidas con claves de agrupamiento en clústeres de origen (para particionar tablas
sin una clave primaria), metadatos de partición física y exclusiones de tipos de datos
del archivo de metadatos. Por ejemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
El comando generate-config admite las siguientes marcas:
--metadata PATH_TO_METADATA_ZIP: Es la ruta de acceso a un archivo de metadatos de la herramienta dedwh-migration-dumper(archivo ZIP) o a un directorio que contiene archivos de metadatos.--tables-yaml PATH_TO_TABLES_YAML: Es la ruta de acceso a uno o más archivos o directorios de traducción detables.yaml(separados por comas).--target-dataset TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino que se agregará como prefijo a las entradastargetTable.namegeneradas.-o, --output-dir DIRECTORY: Es el directorio de salida de los archivos de configuración modulares. El valor predeterminado esvalidation_config.--schemas SCHEMA_LIST: Es la lista separada por comas de los esquemas o las bases de datos de origen que se incluirán (distingue mayúsculas de minúsculas; admite comodines*).--tables TABLE_LIST: Es una lista separada por comas de nombres de tablas (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) que se deben incluir (distingue mayúsculas de minúsculas; admite comodines*).--filter-file PATH: Es la ruta de acceso a un archivo delimitado por saltos de línea de nombres de tablas que se incluirán (se ignoran las líneas que comienzan con#).--update: Combina las tablas descubiertas en un directoriovalidation_config/existente y, al mismo tiempo, conserva las anulaciones existentes deconnections.yaml,settings.yamly personalizadas por tabla.--force: Permite escribir archivos de tablas recién descubiertos en un directorio de salida no vacío y, al mismo tiempo, conservar los archivos de configuración de tablas existentes.--clean: Borra todos los archivos existentes en el directorio de salida antes de escribir los archivos recién descubiertos.
Amazon Redshift
Para las validaciones de migración de Amazon Redshift, haz lo siguiente para generar un archivo ZIP de metadatos de tus esquemas de origen:
- Instala la herramienta de
dwh-migration-dumper. - Ejecuta
dwh-migration-dumperen tu base de datos de origen para producir un archivo de metadatos de la herramientadwh-migration-dumper.
Con el archivo de metadatos, ejecuta generate-config para generar archivos de configuración por tabla. Puedes usar la marca --update para conservar los archivos connections.yaml y settings.yaml existentes que creaste en validation_config/. Por ejemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si también tienes un archivo de asignación de esquemas tables.yaml del
traductor de SQL por lotes, incluye la marca
--tables-yaml, ya sea sola o junto con --metadata para complementar
las asignaciones de tablas traducidas con metadatos de partición de origen y exclusiones de tipos de datos
del archivo de metadatos. Por ejemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
El comando generate-config admite las siguientes marcas:
--metadata PATH_TO_METADATA_ZIP: Es la ruta de acceso a un archivo de metadatos de la herramienta dedwh-migration-dumper(archivo ZIP) o a un directorio que contiene archivos de metadatos.--tables-yaml PATH_TO_TABLES_YAML: Es la ruta de acceso a uno o más archivos o directorios de traducción detables.yaml(separados por comas).--target-dataset TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino que se agregará como prefijo a las entradastargetTable.namegeneradas.-o, --output-dir DIRECTORY: Es el directorio de salida de los archivos de configuración modulares. El valor predeterminado esvalidation_config.--schemas SCHEMA_LIST: Es la lista separada por comas de los esquemas o las bases de datos de origen que se incluirán (distingue mayúsculas de minúsculas; admite comodines*).--tables TABLE_LIST: Es una lista separada por comas de nombres de tablas (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) que se deben incluir (distingue mayúsculas de minúsculas; admite comodines*).--filter-file PATH: Es la ruta de acceso a un archivo delimitado por saltos de línea de nombres de tablas que se incluirán (se ignoran las líneas que comienzan con#).--update: Combina las tablas descubiertas en un directoriovalidation_config/existente y, al mismo tiempo, conserva las anulaciones existentes deconnections.yaml,settings.yamly personalizadas por tabla.--force: Permite escribir archivos de tablas recién descubiertos en un directorio de salida no vacío y, al mismo tiempo, conservar los archivos de configuración de tablas existentes.--clean: Borra todos los archivos existentes en el directorio de salida antes de escribir los archivos recién descubiertos.
Databricks
La generación automática de configuración no es compatible con Databricks. Crea un archivo
tables.yaml de forma manual en el directorio validation_config/ con los
siguientes parámetros de configuración:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
Para las validaciones de migración de Apache Hive, haz lo siguiente para generar un archivo ZIP de metadatos de tus esquemas de origen:
- Instala la herramienta de
dwh-migration-dumper. - Ejecuta
dwh-migration-dumperen tu base de datos de origen para producir un archivo de metadatos de la herramientadwh-migration-dumper.
Con el archivo de metadatos, ejecuta generate-config para generar archivos de configuración por tabla. Puedes usar la marca --update para conservar los archivos connections.yaml y settings.yaml existentes que creaste en validation_config/. Por ejemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si también tienes un archivo de asignación de esquemas tables.yaml del
traductor de SQL por lotes, incluye la marca
--tables-yaml, ya sea sola o junto con --metadata para complementar
las asignaciones de tablas traducidas con metadatos de partición de origen y exclusiones de tipos de datos
del archivo de metadatos. Por ejemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
El comando generate-config admite las siguientes marcas:
--metadata PATH_TO_METADATA_ZIP: Es la ruta de acceso a un archivo de metadatos de la herramienta dedwh-migration-dumper(archivo ZIP) o a un directorio que contiene archivos de metadatos.--tables-yaml PATH_TO_TABLES_YAML: Es la ruta de acceso a uno o más archivos o directorios de traducción detables.yaml(separados por comas).--target-dataset TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino que se agregará como prefijo a las entradastargetTable.namegeneradas.-o, --output-dir DIRECTORY: Es el directorio de salida de los archivos de configuración modulares. El valor predeterminado esvalidation_config.--schemas SCHEMA_LIST: Es la lista separada por comas de los esquemas o las bases de datos de origen que se incluirán (distingue mayúsculas de minúsculas; admite comodines*).--tables TABLE_LIST: Es una lista separada por comas de nombres de tablas (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) que se deben incluir (distingue mayúsculas de minúsculas; admite comodines*).--filter-file PATH: Es la ruta de acceso a un archivo delimitado por saltos de línea de nombres de tablas que se incluirán (se ignoran las líneas que comienzan con#).--update: Combina las tablas descubiertas en un directoriovalidation_config/existente y, al mismo tiempo, conserva las anulaciones existentes deconnections.yaml,settings.yamly personalizadas por tabla.--force: Permite escribir archivos de tablas recién descubiertos en un directorio de salida no vacío y, al mismo tiempo, conservar los archivos de configuración de tablas existentes.--clean: Borra todos los archivos existentes en el directorio de salida antes de escribir los archivos recién descubiertos.
SQL Server
En el caso de las validaciones de migración de SQL Server, haz lo siguiente para
generar un archivo de metadatos de la herramienta de dwh-migration-dumper de tus esquemas de origen:
- Instala la herramienta de
dwh-migration-dumper. - Ejecuta
dwh-migration-dumperen tu base de datos de origen para producir un archivo de metadatos de la herramientadwh-migration-dumper.
Con el archivo de metadatos, ejecuta generate-config para generar archivos de configuración por tabla. Puedes usar la marca --update para conservar los archivos connections.yaml y settings.yaml existentes que creaste en validation_config/. Por ejemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si también tienes un archivo de asignación de esquemas tables.yaml del
traductor de SQL por lotes, incluye la marca
--tables-yaml, ya sea sola o junto con --metadata para complementar
las asignaciones de tablas traducidas con metadatos de partición de origen y exclusiones de tipos de datos
del archivo de metadatos. Por ejemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
El comando generate-config admite las siguientes marcas:
--metadata PATH_TO_METADATA_ZIP: Es la ruta de acceso a un archivo de metadatos de la herramienta dedwh-migration-dumper(archivo ZIP) o a un directorio que contiene archivos de metadatos.--tables-yaml PATH_TO_TABLES_YAML: Es la ruta de acceso a uno o más archivos o directorios de traducción detables.yaml(separados por comas).--target-dataset TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino que se agregará como prefijo a las entradastargetTable.namegeneradas.-o, --output-dir DIRECTORY: Es el directorio de salida de los archivos de configuración modulares. El valor predeterminado esvalidation_config.--schemas SCHEMA_LIST: Es la lista separada por comas de los esquemas o las bases de datos de origen que se incluirán (distingue mayúsculas de minúsculas; admite comodines*).--tables TABLE_LIST: Es una lista separada por comas de nombres de tablas (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) que se deben incluir (distingue mayúsculas de minúsculas; admite comodines*).--filter-file PATH: Es la ruta de acceso a un archivo delimitado por saltos de línea de nombres de tablas que se incluirán (se ignoran las líneas que comienzan con#).--update: Combina las tablas descubiertas en un directoriovalidation_config/existente y, al mismo tiempo, conserva las anulaciones existentes deconnections.yaml,settings.yamly personalizadas por tabla.--force: Permite escribir archivos de tablas recién descubiertos en un directorio de salida no vacío y, al mismo tiempo, conservar los archivos de configuración de tablas existentes.--clean: Borra todos los archivos existentes en el directorio de salida antes de escribir los archivos recién descubiertos.
MariaDB
La generación automática de configuración no es compatible con MariaDB. Crea un archivo
tables.yaml de forma manual en el directorio validation_config/ con los
siguientes parámetros de configuración:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
La generación automática de configuración no es compatible con MySQL. Crea
un archivo tables.yaml de forma manual en el directorio validation_config/ con los
siguientes parámetros de configuración:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
Para las validaciones de migración de Oracle, haz lo siguiente para generar un
archivo de metadatos de la herramienta de dwh-migration-dumper de tus esquemas de origen:
- Instala la herramienta de
dwh-migration-dumper. - Ejecuta
dwh-migration-dumperen tu base de datos de origen para producir un archivo de metadatos de la herramientadwh-migration-dumper.
Con el archivo de metadatos, ejecuta generate-config para generar archivos de configuración por tabla. Puedes usar la marca --update para conservar los archivos connections.yaml y settings.yaml existentes que creaste en validation_config/. Por ejemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si también tienes un archivo de asignación de esquemas tables.yaml del
traductor de SQL por lotes, incluye la marca
--tables-yaml, ya sea sola o junto con --metadata para complementar
las asignaciones de tablas traducidas con metadatos de partición de origen y exclusiones de tipos de datos
del archivo de metadatos. Por ejemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
El comando generate-config admite las siguientes marcas:
--metadata PATH_TO_METADATA_ZIP: Es la ruta de acceso a un archivo de metadatos de la herramienta dedwh-migration-dumper(archivo ZIP) o a un directorio que contiene archivos de metadatos.--tables-yaml PATH_TO_TABLES_YAML: Es la ruta de acceso a uno o más archivos o directorios de traducción detables.yaml(separados por comas).--target-dataset TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino que se agregará como prefijo a las entradastargetTable.namegeneradas.-o, --output-dir DIRECTORY: Es el directorio de salida de los archivos de configuración modulares. El valor predeterminado esvalidation_config.--schemas SCHEMA_LIST: Es la lista separada por comas de los esquemas o las bases de datos de origen que se incluirán (distingue mayúsculas de minúsculas; admite comodines*).--tables TABLE_LIST: Es una lista separada por comas de nombres de tablas (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) que se deben incluir (distingue mayúsculas de minúsculas; admite comodines*).--filter-file PATH: Es la ruta de acceso a un archivo delimitado por saltos de línea de nombres de tablas que se incluirán (se ignoran las líneas que comienzan con#).--update: Combina las tablas descubiertas en un directoriovalidation_config/existente y, al mismo tiempo, conserva las anulaciones existentes deconnections.yaml,settings.yamly personalizadas por tabla.--force: Permite escribir archivos de tablas recién descubiertos en un directorio de salida no vacío y, al mismo tiempo, conservar los archivos de configuración de tablas existentes.--clean: Borra todos los archivos existentes en el directorio de salida antes de escribir los archivos recién descubiertos.
PostgreSQL
Para las validaciones de migración de PostgreSQL, haz lo siguiente para generar un
archivo de metadatos de la herramienta de dwh-migration-dumper de tus esquemas de origen:
- Instala la herramienta de
dwh-migration-dumper. - Ejecuta
dwh-migration-dumperen tu base de datos de origen para producir un archivo de metadatos de la herramientadwh-migration-dumper.
Con el archivo de metadatos, ejecuta generate-config para generar archivos de configuración por tabla. Puedes usar la marca --update para conservar los archivos connections.yaml y settings.yaml existentes que creaste en validation_config/. Por ejemplo:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
Si también tienes un archivo de asignación de esquemas tables.yaml del
traductor de SQL por lotes, incluye la marca
--tables-yaml, ya sea sola o junto con --metadata para complementar
las asignaciones de tablas traducidas con metadatos de partición de origen y exclusiones de tipos de datos
del archivo de metadatos. Por ejemplo:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
El comando generate-config admite las siguientes marcas:
--metadata PATH_TO_METADATA_ZIP: Es la ruta de acceso a un archivo de metadatos de la herramienta dedwh-migration-dumper(archivo ZIP) o a un directorio que contiene archivos de metadatos.--tables-yaml PATH_TO_TABLES_YAML: Es la ruta de acceso a uno o más archivos o directorios de traducción detables.yaml(separados por comas).--target-dataset TARGET_DATASET: Es el nombre del conjunto de datos de BigQuery de destino que se agregará como prefijo a las entradastargetTable.namegeneradas.-o, --output-dir DIRECTORY: Es el directorio de salida de los archivos de configuración modulares. El valor predeterminado esvalidation_config.--schemas SCHEMA_LIST: Es la lista separada por comas de los esquemas o las bases de datos de origen que se incluirán (distingue mayúsculas de minúsculas; admite comodines*).--tables TABLE_LIST: Es una lista separada por comas de nombres de tablas (TABLE,SCHEMA.TABLEoDB.SCHEMA.TABLE) que se deben incluir (distingue mayúsculas de minúsculas; admite comodines*).--filter-file PATH: Es la ruta de acceso a un archivo delimitado por saltos de línea de nombres de tablas que se incluirán (se ignoran las líneas que comienzan con#).--update: Combina las tablas descubiertas en un directoriovalidation_config/existente y, al mismo tiempo, conserva las anulaciones existentes deconnections.yaml,settings.yamly personalizadas por tabla.--force: Permite escribir archivos de tablas recién descubiertos en un directorio de salida no vacío y, al mismo tiempo, conservar los archivos de configuración de tablas existentes.--clean: Borra todos los archivos existentes en el directorio de salida antes de escribir los archivos recién descubiertos.
Cómo personalizar la configuración de la tabla
Cada archivo de tabla que genera generate-config contiene una sección table: que
puedes personalizar antes de ejecutar la validación. En la siguiente tabla, se enumeran todas
las claves opcionales admitidas en cada entrada de la tabla.
| Clave YAML opcional | Valor predeterminado | Descripción |
|---|---|---|
runSchema, runAggregate, runData |
true |
Son valores booleanos por tabla para habilitar o inhabilitar pilares de validación individuales cuando no se pasan marcas de línea de comandos de pilares. |
maxColumnsPerTile |
100 |
Es la cantidad máxima de columnas agrupadas en una sola tarjeta de comparación en tablas anchas. |
strategy |
SMART |
Estrategia de ejecución de la validación de datos: SMART (BRUTE_FORCE con menos de 100,000 filas; de lo contrario, SAMPLE), SAMPLE o BRUTE_FORCE. |
sampleSize |
70000 |
Es la cantidad de filas que se extraerán (por porción cuando se particionen) cuando la estrategia resuelta sea SAMPLE. El valor predeterminado de 70,000 filas proporciona una probabilidad superior al 99.9% de detectar al menos una fila que no coincida cuando la tasa de defectos es del 0.01% (1 en 10,000 filas) o más. |
whereClause |
Ninguno | Es el predicado de SQL (sin la palabra clave WHERE) que se aplica a las consultas de extracción de origen y de comparación de destino. También se puede configurar por separado en sourceTable.whereClause y targetTable.whereClause. |
skipRandomization |
false |
Cuando es true, lee hasta sampleSize filas en el orden natural de la tabla en lugar de ordenarlas por una función aleatoria, lo que reduce el costo de la consulta en tablas grandes. |
maxConcurrency |
1 |
Es la cantidad máxima de subprocesos de extracción de porciones paralelas para una tabla particionada. |
maxSlices |
0 (ilimitado) |
Es la cantidad máxima de porciones de partición permitidas para una tabla particionada. Si el recuento de porciones calculado supera maxSlices (cuando es mayor que 0), la planificación de la partición falla con un error. |
disablePartitioning |
false |
Cuando se establece en true, se inhabilita la división particionada para la tabla, incluso cuando se configura un bloque partitioning o el recuento de filas supera 1000000. |
labels |
Mapa vacío | Son etiquetas de cadena de par clave-valor adjuntas a las métricas de ejecución de validación en validation_results. |
En las siguientes secciones, se describen las formas en que puedes usar estas claves de YAML para personalizar tus ejecuciones de validación.
Selecciona una estrategia de validación
Usa la clave strategy en una entrada de tabla para seleccionar una estrategia de validación
que controle cómo el pilar --data extrae y
compara filas. Se admiten los siguientes valores:
SMART(predeterminado): Primero, cuenta las filas de la tabla de origen. Si la tabla tiene menos de 100,000 filas, se ejecutaBRUTE_FORCE. Si la tabla tiene 100,000 filas o más, se ejecutaSAMPLE.SAMPLE: Extrae una muestra aleatoria de filas según el valor desampleSize(el valor predeterminado es70,000) y las une a la tabla de destino concomparisonKeys. Una muestra de 70,000 filas brinda una confianza superior al 99.9% de detectar al menos una fila defectuosa cuando al menos el 0.01% de las filas (1 en 10,000) contiene una discrepancia.BRUTE_FORCE: Extrae y compara cada fila en un solo pase de consulta sin particiones. La configuración de partición se ignora cuando se usaBRUTE_FORCE.
Configura las claves de comparación
Una clave de comparación es la columna o las columnas que se usan para identificar y unir filas de forma inequívoca entre los sistemas de origen y de destino. La clave de comparación describe los atributos que proporcionan suficiente unicidad para una unión estable.
Cuando ejecutas la comparación de datos a nivel de fila, puedes configurar las claves de comparación de las siguientes maneras:
- Detección automática: Omite
comparisonKeysde la secciónsourceTablepara que la herramienta de validación detecte automáticamente las claves primarias en tu base de datos de origen durante la verificación previa (recurriendo a las restricciones únicasNOT NULLen Oracle y Snowflake, los índices únicos en Teradata o una sola columnaDISTKEYoSORTKEYen Amazon Redshift). Claves compuestas o personalizadas manuales: Especifica de forma manual las claves de comparación compuestas o personalizadas enumerando los nombres de las columnas de claves de origen en
comparisonKeysensourceTable. Las diferencias de mayúsculas y minúsculas entre los nombres de las columnas de clave de origen y de destino se hacen coincidir automáticamente. Si se cambió el nombre de una columna de clave de comparación en BigQuery, asígnala encolumnSettings.columns.SOURCE_COLUMN.targetColumn. En el siguiente ejemplo, se configura una clave de comparación compuesta:table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
Comparación de hash para tablas sin una clave única: Si una tabla no tiene clave primaria, en
sourceTable, estableceuseAllColumnsAsKey: true. Esto también se selecciona automáticamente cuando la inspección de metadatos previa al vuelo no encuentra claves principales.
Configura la extracción particionada para tablas grandes
Cuando la estrategia de una tabla se resuelve en SAMPLE y hay un bloque partitioning presente en la configuración de la tabla (que generate-config escribe de forma predeterminada) o el recuento de filas de la tabla supera 1,000,000, la herramienta de validación divide la tabla en porciones para que las consultas de muestreo analicen rangos limitados en lugar de ordenar toda la tabla a la vez. Cuando se particiona, se extraen hasta sampleSize filas
por porción. Para restringir la validación a un subconjunto de filas, usa
whereClause en su lugar.
Para configurar la extracción particionada, usa el bloque partitioning
en la sección table:. Por ejemplo:
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
El bloque partitioning admite los siguientes campos:
type:INTEGER_RANGE: Divide la tabla en intervalos numéricos de pares clave-valor (COLUMN BETWEEN START AND END). Este es el valor predeterminado.DATE_RANGE: divide la tabla en intervalos de fecha o marca de tiempo. Compatible con PostgreSQL y Snowflake.PHYSICAL: Usa particiones de bases de datos para las tablas de Oracle y Amazon Redshift cuando hay metadatos de particiones físicas.
column: Especifica una columna numérica, de fecha o de marca de tiempo indexada en la tabla de origen que se usa para calcular los límites de las porciones. Las filas con valoresNULLen la columna de partición se excluyen de las porciones basadas en rangos (INTEGER_RANGEyDATE_RANGE).partitionSize: Para el tipoINTEGER_RANGE, este valor especifica el ancho del rango de pares clave-valor numéricos por porción, donde el valor predeterminado es1000000. Para el tipoDATE_RANGE, este valor especifica la cantidad de días por porción, en la que el valor predeterminado es30.maxSlices: Especifica la cantidad máxima total de porciones permitidas para la tabla (se establece entable:). Si una tabla requiere más porciones quemaxSlices, la planificación de la partición falla con un error que requiere unpartitionSizeomaxSlicesmás grande.maxConcurrency: Especifica la cantidad de subprocesos de trabajador paralelos que se usan para extraer porciones, donde el valor predeterminado es1. Se establece entable:.
Personaliza las verificaciones agregadas
El análisis agregado está habilitado de forma predeterminada y complementa el muestreo a nivel de fila con verificaciones agregadas a nivel de macro. Esta configuración es útil para validar tablas grandes en las que el muestreo aleatorio podría pasar por alto un sesgo de datos sutil.
Sin parámetros de configuración de columnas personalizados, la herramienta de validación aplica automáticamente verificaciones de agregación estándar según los tipos de columnas:
- Numérico exacto (
INTEGER,NUMERIC,BIGNUMERIC):COUNT,SUM,AVG,MIN,MAX - Punto flotante (
FLOAT,DOUBLE,REAL):COUNT,MIN,MAX - Booleano (
BOOLEAN):COUNT,COUNT_TRUE,COUNT_FALSE,COUNT_NULL - Cadena (
STRING,VARCHAR,CHAR,TEXT):COUNT,SUM_LENGTH - Fecha, hora y marca de tiempo:
COUNT,MIN,MAX
Puedes personalizar o inhabilitar las verificaciones agregadas con la sección columnSettings. En el siguiente ejemplo, se muestra cómo
configurar tolerancias agregadas y anular verificaciones de columnas específicas:
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
Se aplican las siguientes reglas de configuración agregada:
- Las claves de columna en
columnSettings.columnsdeben coincidir con el nombre de la columna de origen, distinguiendo mayúsculas de minúsculas. - El valor de
toleranceagregado es un umbral de diferencia absoluto (ABS(target - source) <= tolerance). Si no se establece un valor detoleranceagregado (ya sea a nivel de columna ocolumnSettings.aggregate.tolerance) y la columna tiene un parámetro de configuración detolerances.numerica nivel de fila,AVG,MINyMAXheredantolerances.numericdirectamente, mientras queSUMmultiplica la tolerancia heredada a nivel de fila porCOUNT. - Solo puedes anular
functionspor columna encolumnSettings.columns.SOURCE_COLUMN.aggregate.functions.
Excluye columnas, asigna nombres de columnas y aplica expresiones de comparación de SQL
Puedes usar columnSettings para excluir columnas, establecer tolerancias numéricas
o temporales, asignar columnas de destino con nombres cambiados o aplicar transformaciones de SQL
antes de la comparación. Cada clave en
columnSettings.columns es el nombre de la columna de origen. Usa la propiedad targetColumn dentro de esa entrada cuando la columna tenga un nombre diferente en BigQuery. Por ejemplo:
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings admite los siguientes campos:
exclude: Especifica una lista de nombres de columnas que no distinguen mayúsculas de minúsculas o patrones glob (*) para excluir de todos los pilares de validación.tolerances:numeric: tolerancia para las columnas numéricas (ABS(target - source) <= tolerancepara la comparación basada en claves o redondeada aceil(-log10(tolerance))posiciones decimales cuandouseAllColumnsAsKey: true).timestamp: Es la tolerancia en segundos para las columnas de marca de tiempo. Por ejemplo,0.001para 1 milisegundo.date: Es la tolerancia en días para las columnas de fecha.
columns: Es un mapa de la configuración por columna con clave por el nombre de la columna de origen (SOURCE_COLUMN):targetColumn: asigna la columna de origen a una columna de destino con un nombre diferente en BigQuery.transform: Es la transformación integrada que se aplica antes de la comparación:TRIM,UPPERyLOWER: Se admiten en todos los dialectos.EMPTY_TO_NULL,NULL_TO_EMPTY,CAST_TO_STRING: Se admiten en las consultas de origen para las fuentes de PostgreSQL, Amazon Redshift, Oracle y Teradata.
transformExpression: Es la expresión de SQL personalizada que hace referencia al nombre literal de la columna de origen. Por ejemplo,"ROUND(SOURCE_COLUMN, 4)". Debido a que la expresión se evalúa tanto en la consulta de origen como en la consulta de comparación de BigQuery, usa funciones de SQL que sean válidas tanto en tu dialecto de origen como en GoogleSQL.
Normalización de valores
Durante la comparación a nivel de fila (--data), el servicio de validación
normaliza los valores para que las diferencias de representación entre los motores de origen
y BigQuery no causen discrepancias. El servicio de validación
normaliza los valores de las siguientes maneras:
- Tipos numéricos exactos (
INTEGER,NUMERIC,DECIMAL,BIGNUMERIC): En la comparación basada en claves, los valores se comparan a escala completa (hasta 9 decimales paraNUMERICo hasta 38 decimales paraBIGNUMERIC) y, cuando se establecetolerances.numeric, los valores coinciden cuandoABS(target - source) <= tolerance. En la comparación de hash de fila completa (useAllColumnsAsKey: true), los valores se redondean a 9 decimales de forma predeterminada o aceil(-log10(tolerance))decimales cuando se establece una tolerancia numérica. - Tipos de punto flotante (
FLOAT,DOUBLE,REAL): Se normalizan a 6 decimales (1e-6) de forma predeterminada. - Marcas de tiempo: Se normalizan a UTC con precisión de microsegundos.
- Tipos de caracteres de ancho fijo (
CHAR,NCHAR,CHARACTER): Los espacios iniciales y finales se recortan automáticamente para alinearse con la semántica deSTRINGde BigQuery.
Ejecuta el servicio de validación
Una vez que hayas establecido la configuración de validación, ejecuta el comando validate
para iniciar la herramienta de validación de la migración. Puedes pasar una ruta de acceso local o un URI de Cloud Storage gs:// que apunte al directorio validation_config/.
En el siguiente ejemplo, se ejecuta el servicio de validación en los archivos de configuración de validación que se almacenan de forma local:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
Reemplaza PATH_TO_VALIDATION_CONFIG por la ruta de acceso a tu directorio modular validation_config/.
Si tu configuración de validación se almacena en Cloud Storage, pasa el URI de gs://
del directorio de configuración:
gcloud bq migration validate gs://BUCKET_NAME/validation_config
Reemplaza BUCKET_NAME con el nombre de tu depósito de Cloud Storage.
De forma predeterminada, el servicio de validación ejecuta el servicio de validación en los tres pilares de validación:
--schema: Solo valida el esquema.--aggregate: solo valida el agregado--data: Valida solo los datos a nivel de fila.
Puedes ejecutar el servicio de validación en un pilar de validación específico con las
marcas de pilar. En el siguiente ejemplo, se ejecuta la validación de esquemas y agregaciones en dos
tablas específicas con un filtro WHERE personalizado:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
El comando validate admite las siguientes marcas opcionales:
--tableo--tables: Es una lista separada por comas de los nombres de las tablas que se validarán. La coincidencia de--tablesdistingue mayúsculas de minúsculas y debe coincidir con las mayúsculas o minúsculas que se usan ensourceTable.nameotargetTable.name.--where SQL_PREDICATE: anulawhereClausepara las tablas de origen y de destino durante esta ejecución.--source-where SQL_PREDICATE: AnulawhereClausesolo para la tabla de origen.--target-where SQL_PREDICATE: AnulawhereClausesolo para la tabla de destino.--gcs-path: anulagoogleCloudStorage.gcsPath. Por ejemplo,--gcs-path gs://my-bucket/validation.--max-concurrency,--concurrencyo--threads: anulamaxConcurrencypara la extracción de porciones paralelas.--no-partitiono--disable-partitioning: Inhabilita la extracción de porciones particionadas para todas las tablas de la ejecución.--labels KEY=VALUE[,KEY=VALUE...]: Adjunta etiquetas de par clave-valor personalizadas a los resultados de la ejecución.--output-dir: Es el directorio local para los archivos de estado y metadatos de ejecución temporales. El valor predeterminado es/tmp/validation_outputs.-v,--verbose,-do--debug: Habilita el registro detallado o de depuración.
Transferencia asíncrona de flujos de trabajo
validate realiza la extracción de origen de forma síncrona y, luego, activa un
flujo de trabajo asíncrono del Servicio de migración de BigQuery para cada tabla.
Si tu conjunto de datos de destino se encuentra en una ubicación que no sea
us, por ejemplo,eu, establece la variable de entornoBQMS_VALIDATION_LOCATIONantes de ejecutarvalidate:export BQMS_VALIDATION_LOCATION=LOCATION
Para cada tabla, verifica que el resultado incluya una línea
Workflow:que contenga el nombre del recurso de flujo de trabajo creado. Por ejemplo:Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
El código de salida
0indica que la extracción y la carga de la fuente se realizaron correctamente, no que se completó la comparación de destino o que los datos coincidieron. Si la creación del flujo de trabajo falla, por ejemplo, debido a que falta un permiso, la CLI registra una advertencia de que se produjo un error en la activación del flujo de trabajo de validación, imprime un comando de resguardogcloudmanual y omite la líneaWorkflow:, aunque el proceso salga con0.
Visualiza los resultados de la validación
Una vez que se complete la ejecución de la validación, consulta los resultados en la
consola deGoogle Cloud con una consulta al conjunto de datos de resultados validation_results,
con una consulta al conjunto de datos de BigQuery configurado en results en
settings.yaml o con la lectura de los informes de resumen en
Cloud Storage. Selecciona una de las siguientes opciones:
Consola de Google Cloud
Ve a la página Servicios de migración en la consola de Google Cloud .
En Validar migración, haz clic en Ver recientes.
Haz clic en Selecciona un proyecto y elige el proyecto en el que se almacena el conjunto de datos de
validation_results.
GoogleSQL
Consulta TARGET_PROJECT_ID.validation_results.run_history para verificar
el estado de las ejecuciones de validación recientes:
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
Reemplaza TARGET_PROJECT_ID por el ID del proyecto
en el que se almacena el conjunto de datos validation_results.
Para obtener métricas detalladas por columna y tendencias históricas, consulta lo siguiente:
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: Recuentos de discrepancias por ejecución y por columna, comparaciones agregadas y estado de aprobación o falla<var>TARGET_PROJECT_ID</var>.validation_results.column_history: historial de auditoría de columnas longitudinales en todas las ejecuciones<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: filas y columnas de muestra en las que los valores de origen y destino diferían
Informes de Cloud Storage
Cada ejecución completada escribe los siguientes artefactos de informe en el directorio gcs_uri de la ejecución (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/):
validation_summary.txt: resumen ejecutivo de los resultados de la comparación de esquemas, agregaciones y filascolumn_details.txt: desglose por columna de las discrepancias y las diferencias agregadasresults.json: Es un informe JSON estructurado de todos los hallazgos de validación.queries.sql: Son las consultas en SQL exactas que se ejecutaron durante la ejecución de la validación.
Para imprimir el informe de resumen de una ejecución, ejecuta el siguiente comando:
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
Interpreta los resultados de la validación
Cada ejecución de validación en validation_results.run_history informa uno de los
siguientes valores de estado de ejecución o status:
| Estado | Descripción | Acción recomendada |
|---|---|---|
IN_PROGRESS |
El flujo de trabajo de validación aún se está ejecutando en BigQuery. | Espera a que se complete finished_at y, luego, vuelve a consultar run_history. |
COMPLETED |
La canalización de validación se completó sin discrepancias de datos a nivel de fila ni de agregación. Los detalles de compatibilidad del tipo de esquema se registran por separado en validation_summary.txt y column_history. |
No se requiere ninguna acción. La tabla pasó la validación. |
HEALED |
La canalización de validación se completó sin filas faltantes, y todas las diferencias de valores detectadas fueron fluctuaciones microscópicas de representación de punto flotante (< 1e-4 para comparaciones a nivel de celda y < 1e-6 para agregaciones) que el validador reconcilió automáticamente. |
Se trata como una ejecución aprobada. De manera opcional, puedes configurar un tolerance numérico explícito si quieres suprimir la inestabilidad ascendente. |
COMPLETED_WITH_MISMATCHES |
La canalización de validación se ejecutó por completo y encontró filas faltantes, columnas de destino faltantes, diferencias de agregación o diferencias de datos a nivel de celda entre las tablas de origen y de destino. Esto indica que se completó la ejecución de validación, no que el sistema falló. | Inspecciona column_details.txt, run_metrics y run_RUN_ID_mismatches_details para revisar las columnas y filas que no coinciden. Para obtener más información, consulta Tipos de discrepancias a nivel de la columna. |
ERROR |
La canalización de validación no se completó debido a un error del sistema o de configuración. Por ejemplo, debido a que falta una tabla de destino, un error de permiso o un SQL no válido en un whereClause o transformExpression personalizado. |
Verifica la columna error_message en run_history. Para obtener más información sobre cómo resolver errores comunes, consulta Solución de problemas. |
Tipos de discrepancias a nivel de la columna
Cuando una ejecución finaliza con COMPLETED_WITH_MISMATCHES, las tablas de discrepancias por ejecución
clasifican cada comparación de columnas con uno de los siguientes resultados:
EXACT_MATCH: Los valores de celda comparados para la columna coincidieron dentro de las tolerancias configuradas.DATA_DRIFT: Las filas coincidieron encomparisonKeys, pero los valores de las celdas difirieron más allá de la tolerancia configuradaSCHEMA: la columna existe en la tabla de origen, pero falta en la tabla de destinoROW: Faltaban filas de origen en la tabla de destino o faltaban filas de destino en la tabla de origen cuando se unieron encomparisonKeys
Cómo solucionar los errores comunes
En la siguiente tabla, se enumeran los errores comunes de la línea de comandos y del flujo de trabajo, y cómo resolverlos:
| Mensaje de error o problema | Causa | Solución |
|---|---|---|
Failed to load or parse YAML |
Un bloque de tabla, partitioning, columnSettings o googleCloudStorage contiene una clave no reconocida o un valor de enumeración no válido, como SAMPLING en lugar de SAMPLE. |
Verifica la sangría de YAML y los nombres de los campos con las opciones de configuración de la tabla. |
Connection name '...' is invalid. Must be alphanumeric. |
Un nombre de perfil en connections: contiene guiones bajos o guiones. Por ejemplo, my_source |
Cambia el nombre de los perfiles de conexión por nombres alfanuméricos, como source y target. |
googleCloudStorage cannot be null |
Falta googleCloudStorage.gcsPath en validation_config/settings.yaml y no se pasó --gcs-path. |
Establece googleCloudStorage.gcsPath: gs://BUCKET/PREFIX sin barra diagonal final en validation_config/settings.yaml. |
Target discovery directory 'validation_config/' is non-empty |
Se ejecutó generate-config sin --update, --force ni --clean cuando validation_config/ ya contenía archivos YAML. |
Pasa --update para combinar las tablas descubiertas y, al mismo tiempo, conservar tus connections.yaml y settings.yaml existentes. |
tables is required cuando se ejecuta validate |
Existe un archivo validation-config.yaml heredado sin una lista tables: en el directorio de trabajo y tiene prioridad sobre validation_config/, o no existen archivos YAML de tabla en validation_config/. |
Borra cualquier archivo validation-config.yaml que esté suelto en tu directorio de trabajo para que validate cargue validation_config/. |
| Error de solicitud preliminar en una sola clave de comparación de baja cardinalidad | Una tabla con más de 1,000 filas filtradas se configura con una sola clave de comparación de cardinalidad baja, lo que provocaría una explosión de unión de varios a varios. | Especifica todas las columnas que forman una clave compuesta única en comparisonKeys o establece useAllColumnsAsKey: true en sourceTable. |
Failed to initialize MemoryUtil o InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
La JVM es Java 17 o una versión posterior, y se inició sin --add-opens=java.base/java.nio=ALL-UNNAMED, por lo general, porque la línea de comandos se inició a través de un wrapper personalizado o directamente con java -jar. |
Establece JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" en el entorno o usa el comando gcloud bq migration validate. |
WARNING: Failed to trigger validation workflow |
La extracción de la fuente se realizó correctamente, pero la llamada a CreateMigrationWorkflow falló debido a que faltan permisos de IAM, una API no habilitada o una ubicación no admitida. |
Verifica que bigquerymigration.googleapis.com esté habilitada, que tu cuenta tenga roles/bigquerymigration.editor y que BQMS_VALIDATION_LOCATION coincida con la ubicación de tu conjunto de datos. |
Limpia los artefactos de validación
Para administrar los costos de almacenamiento después de revisar los resultados de la validación, haz lo siguiente:
- En Cloud Storage, borra los directorios de ejecución antiguos con el
prefijo
gcsPathen tu bucket de etapa de pruebas o configura una regla de Administración del ciclo de vida de los objetos en el bucket. - En BigQuery, las tablas de comparación por ejecución en tu conjunto de datos de resultados
(
validation_resultsde forma predeterminada) vencen automáticamente después deresultTtlHours(168.0horas o 7 días, de forma predeterminada). AjustaresultTtlHoursensettings.yamlpara acortar o extender la retención, o bien descarta las tablas por ejecución de forma manual mientras dejas intactas las tablas y vistas del historial compartido (run_history,run_metricsycolumn_history). - Cuando trabajes con archivos locales, quita el directorio de trabajo local que escribió
la herramienta de validación en
--output-dir. El directorio predeterminado es/tmp/validation_outputs.
Precios
El servicio de validación usa los siguientes recursos en tu proyecto:
- Procesamiento y almacenamiento de BigQuery: Las consultas de agregación de destino,
las uniones de comparación de filas y el almacenamiento de tablas en el conjunto de datos
validation_resultsse facturan a tu proyecto de Google Cloud o abillingProjectIdsi se configuran en la conexión detarget, según los precios estándar de BigQuery. - Almacenamiento y red de Cloud Storage: Los archivos de muestra de Parquet o CSV en etapa de pruebas y los informes de resultados en tu bucket se facturan según los precios estándar de Cloud Storage.
- Carga de la base de datos de origen: Las consultas de extracción se ejecutan directamente en la base de datos de origen. Para minimizar la carga en tablas de origen grandes, usa
strategy: SAMPLE, filtra conwhereClauseo estableceskipRandomization: truecuando la sobrecarga de orden aleatorio no sea deseable.
¿Qué sigue?
- Aprende a generar metadatos para la traducción y la evaluación
con la herramienta
dwh-migration-dumper. - Traduce consultas en SQL por lotes para convertir tus secuencias de comandos de SQL de origen y DDL en GoogleSQL.
- Planifica una migración con el linaje de migración para visualizar las dependencias de datos en tu almacén de datos de origen.