


במדריך הזה נסביר איך לייבא מודל Open Neural Network Exchange (ONNX) שאומן באמצעות scikit-learn. אתם מייבאים את המודל למערך נתונים ב-BigQuery ומשתמשים בו כדי ליצור חיזויים באמצעות שאילתת SQL.
ONNX מספק פורמט אחיד שמיועד לייצג כל מסגרת של למידת מכונה (ML). התמיכה של BigQuery ML ב-ONNX מאפשרת לכם:
- לאמן מודל באמצעות ה-framework המועדף עליכם.
- ממירים את המודל לפורמט ONNX.
- מייבאים את מודל ה-ONNX ל-BigQuery ומבצעים חיזויים באמצעות BigQuery ML.
מטרות
- יוצרים ומאמנים מודל באמצעות scikit-learn.
- ממירים את המודל לפורמט ONNX באמצעות sklearn-onnx.
- משתמשים בהצהרה
CREATE MODELכדי לייבא את מודל ONNX ל-BigQuery. - משתמשים בפונקציה
ML.PREDICTכדי ליצור תחזיות באמצעות מודל ONNX המיובא.
עלויות
במסמך הזה משתמשים ברכיבים הבאים של Google Cloud, והשימוש בהם כרוך בתשלום:
בעזרת מחשבון העלויות אתם יכולים להעריך את העלויות בהתאם לשימוש הצפוי.
כשמסיימים את המשימות שמתוארות במסמך הזה אפשר למחוק את המשאבים שיצרתם כדי להימנע מחיובים נוספים. מידע נוסף זמין בקטע הסרת המשאבים.
לפני שמתחילים
- נכנסים לחשבון Google Cloud . אנחנו ממליצים למשתמשים חדשים ב- Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של המוצרים שלנו בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300$ להרצה, לבדיקה ולפריסה של עומסי העבודה.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
מפעילים את BigQuery API ואת Cloud Storage API, אם הם עדיין לא מופעלים.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם אתם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, אתם יכולים לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים?- מוודאים שיש לכם את ההרשאות הנדרשות כדי לבצע את המשימות שמפורטות במסמך הזה.
התפקידים הנדרשים
אם אתם יוצרים פרויקט חדש, אתם הבעלים של הפרויקט ומוענקות לכם כל ההרשאות הנדרשות בממשק של ניהול הזהויות והרשאות הגישה (IAM) כדי להשלים את המדריך הזה.
אם אתם משתמשים בפרויקט קיים, בצעו את הפעולות הבאות.
צריך לוודא שיש לכם בפרויקט את התפקיד או התפקידים הבאים:
- אדמין של BigQuery Studio (
roles/bigquery.studioAdmin) - יצירת אובייקטים באחסון (
roles/storage.objectCreator)
בדיקת התפקידים
-
נכנסים לדף IAM במסוף Google Cloud .
כניסה לדף IAM - בוחרים את הפרויקט.
-
בעמודה Principal, מחפשים את כל השורות שמזהות אתכם או קבוצה שאתם חברים בה. כדי לברר לאילו קבוצות אתם שייכים, פנו לאדמין.
- בכל השורות שבהן אתם מופיעים, בודקים בעמודה Role אם רשימת התפקידים כוללת את התפקידים הנדרשים.
מתן התפקידים
-
נכנסים לדף IAM במסוף Google Cloud .
כניסה לדף IAM - בוחרים את הפרויקט.
- לוחצים על Grant access.
-
בשדה New principals, מזינים את מזהה המשתמש. בדרך כלל מזהה המשתמש הוא כתובת האימייל של חשבון Google.
- לוחצים על Select a role ומחפשים את התפקיד.
- כדי לתת עוד תפקידים, לוחצים על Add another role ומוסיפים אותם.
- לוחצים על Save.
למידע נוסף על הרשאות IAM ב-BigQuery, קראו את המאמר הרשאות IAM.
אופציונלי: אימון מודל והמרה שלו לפורמט ONNX
דוגמאות הקוד הבאות מראות איך לאמן מודל סיווג באמצעות scikit-learn ואיך להמיר את צינור עיבוד הנתונים שנוצר לפורמט ONNX. במדריך הזה נעשה שימוש במודל לדוגמה שנוצר מראש ומאוחסן ב-gs://cloud-samples-data/bigquery/ml/onnx/pipeline_rf.onnx. אם אתם משתמשים במודל לדוגמה, אתם לא צריכים לבצע את השלבים האלה.
אימון מודל סיווג באמצעות scikit-learn
משתמשים בקוד לדוגמה הבא כדי ליצור ולאמן צינור עיבוד נתונים של scikit-learn במערך הנתונים Iris. הוראות להתקנה ולשימוש ב-scikit-learn מפורטות במדריך להתקנת scikit-learn.
import numpy
from sklearn.datasets import load_iris
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier

data = load_iris()
X = data.data[:, :4]
y = data.target

ind = numpy.arange(X.shape[0])
numpy.random.shuffle(ind)
X = X[ind, :].copy()
y = y[ind].copy()

pipe = Pipeline([('scaler', StandardScaler()),
                ('clr', RandomForestClassifier())])
pipe.fit(X, y)
המרת צינור עיבוד הנתונים למודל ONNX
משתמשים בקוד לדוגמה הבא ב-sklearn-onnx כדי להמיר את צינור עיבוד הנתונים של scikit-learn למודל ONNX בשם pipeline_rf.onnx.
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType

# Disable zipmap as it is not supported in BigQuery ML.
options = {id(pipe): {'zipmap': False}}

# Define input features. scikit-learn does not store information about the
# training dataset. It is not always possible to retrieve the number of features
# or their types. That's why the function needs another argument called initial_types.
initial_types = [
   ('sepal_length', FloatTensorType([None, 1])),
   ('sepal_width', FloatTensorType([None, 1])),
   ('petal_length', FloatTensorType([None, 1])),
   ('petal_width', FloatTensorType([None, 1])),
]

# Convert the model.
model_onnx = convert_sklearn(
   pipe, 'pipeline_rf', initial_types=initial_types, options=options
)

# And save.
with open('pipeline_rf.onnx', 'wb') as f:
 f.write(model_onnx.SerializeToString())
העלאת מודל ONNX ל-Cloud Storage
אחרי ששומרים את המודל, מבצעים את הפעולות הבאות:
- יוצרים קטגוריה של Cloud Storage כדי לאחסן את המודל.
- מעלים את מודל ה-ONNX לקטגוריה של Cloud Storage.
יצירת קבוצת נתונים
כדי ליצור מערך נתונים ב-BigQuery, בוחרים אחת מהאפשרויות הבאות:המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית הימנית, לוחצים על Explorer:
אם החלונית הימנית לא מוצגת, לוחצים על Expand left pane כדי לפתוח אותה.
ב-Explorer, מרחיבים את הפרויקט ולוחצים על Datasets.
בדף Datasets, לוחצים על Create dataset.
בחלונית Create dataset:
בשדה Dataset ID, מזינים
bqml_tutorial.בקטע Data location (מיקום הנתונים), בוחרים באפשרות US (ארה"ב).
משאירים את שאר הגדרות ברירת המחדל כמו שהן.
לוחצים על Create dataset.
BQ
כדי ליצור קבוצת נתונים חדשה, משתמשים בפקודה bq mk --dataset.
יוצרים מערך נתונים בשם
bqml_tutorialומגדירים את מיקום הנתונים ל-US:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
מוודאים שמערך הנתונים נוצר:
bq ls
API
מפעילים את השיטה datasets.insert עם משאב של מערך נתונים מוגדר:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
BigQuery DataFrames
לפני שתנסו את הדוגמה הזו, פעלו לפי הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה ב-BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
ייבוא של מודל ONNX ל-BigQuery
בשלבים הבאים מוסבר איך לייבא את המודל לדוגמה של ONNX מ-Cloud Storage באמצעות הצהרת CREATE MODEL.
כדי לייבא את מודל ה-ONNX למערך הנתונים, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery Studio במסוף Google Cloud .
בעורך השאילתות, מזינים את הצהרת ה-
CREATE MODELהבאה.CREATE OR REPLACE MODEL `bqml_tutorial.imported_onnx_model` OPTIONS (MODEL_TYPE='ONNX', MODEL_PATH='BUCKET_PATH')
מחליפים את
BUCKET_PATHבנתיב למודל שהעליתם ל-Cloud Storage. אם אתם משתמשים במודל לדוגמה, החליפו אתBUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/pipeline_rf.onnx.בסיום הפעולה, תופיע הודעה דומה לזו:
Successfully created model named imported_onnx_model.המודל החדש מופיע בחלונית משאבים. המודלים מסומנים בסמל המודל:
 . אם בוחרים את המודל החדש בחלונית Resources, המידע על המודל מופיע ליד עורך השאילתות.
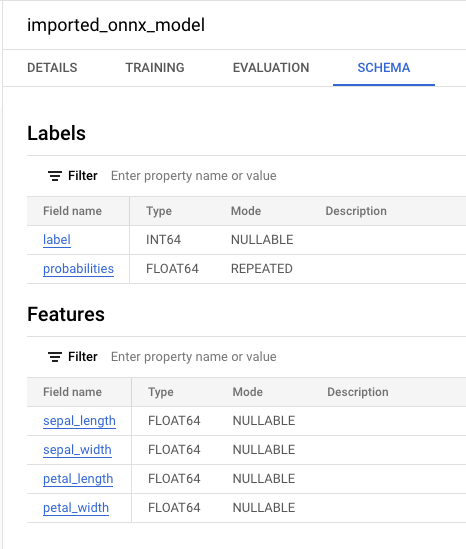
BQ
מייבאים את המודל של ONNX מ-Cloud Storage באמצעות הזנת ההצהרה הבאה של
CREATE MODEL.bq query --use_legacy_sql=false \ "CREATE OR REPLACE MODEL `bqml_tutorial.imported_onnx_model` OPTIONS (MODEL_TYPE='ONNX', MODEL_PATH='BUCKET_PATH')"
מחליפים את
BUCKET_PATHבנתיב למודל שהעליתם ל-Cloud Storage. אם אתם משתמשים במודל לדוגמה, החליפו אתBUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/pipeline_rf.onnx.בסיום הפעולה, תופיע הודעה דומה לזו:
Successfully created model named imported_onnx_model.אחרי שמייבאים את המודל, מוודאים שהוא מופיע במערך הנתונים.
bq ls -m bqml_tutorial
הפלט אמור להיראות כך:
tableId               Type
--------------------- -------
imported_onnx_model  MODEL
BigQuery DataFrames
לפני שתנסו את הדוגמה הזו, פעלו לפי הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה ב-BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
יוצרים את המודל באמצעות הפונקציה bigframes.bigquery.ml.create_model.
מידע נוסף על ייבוא מודלים של ONNX ל-BigQuery, כולל דרישות הפורמט והאחסון, זמין במאמר ההצהרה CREATE MODEL לייבוא מודלים של ONNX.
יצירת חיזויים באמצעות מודל ONNX המיובא
אחרי שמייבאים את מודל ONNX, משתמשים בפונקציה ML.PREDICT כדי ליצור חיזויים באמצעות המודל.
השאילתה בשלבים הבאים משתמשת ב-imported_onnx_model כדי ליצור חיזויים באמצעות נתוני קלט מהטבלה iris במערך הנתונים הציבורי ml_datasets. מודל ONNX מצפה לארבעה ערכי FLOAT כקלט:
sepal_lengthsepal_widthpetal_lengthpetal_width
הקלט הזה תואם ל-initial_types שהוגדרו כשהמרתם את המודל לפורמט ONNX.
הפלטים כוללים את העמודות label ו-probabilities, ואת העמודות מטבלת הקלט. label מייצג את תווית הסיווג החזויה.
probabilities הוא מערך של הסתברויות שמייצגות את ההסתברויות לכל סיווג.
כדי ליצור חיזויים באמצעות מודל ONNX שיובא, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery Studio.
בעורך השאילתות, מזינים את השאילתה הזו שמשתמשת בפונקציה
ML.PREDICT.SELECT * FROM ML.PREDICT(MODEL `bqml_tutorial.imported_onnx_model`, ( SELECT * FROM `bigquery-public-data.ml_datasets.iris` ) )
תוצאות השאילתה אמורות להיראות כך:
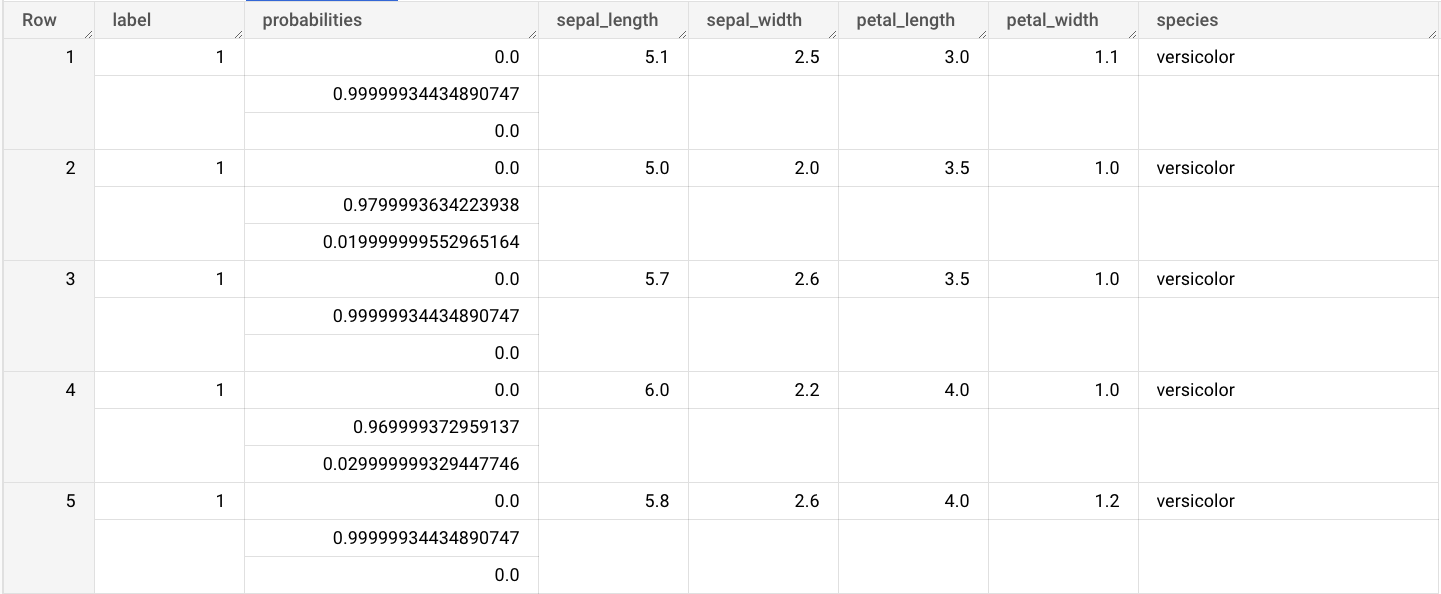
BQ
מריצים את השאילתה שמשתמשת ב-ML.PREDICT.
bq query --use_legacy_sql=false \
'SELECT *
FROM ML.PREDICT(
MODEL `example_dataset.imported_onnx_model`,
(SELECT * FROM `bigquery-public-data.ml_datasets.iris`))'
BigQuery DataFrames
לפני שתנסו את הדוגמה הזו, פעלו לפי הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה ב-BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
משתמשים בפונקציה bigframes.bigquery.ml.predict כדי להריץ את המודל של ONNX.
התוצאה אמורה להיראות כך:
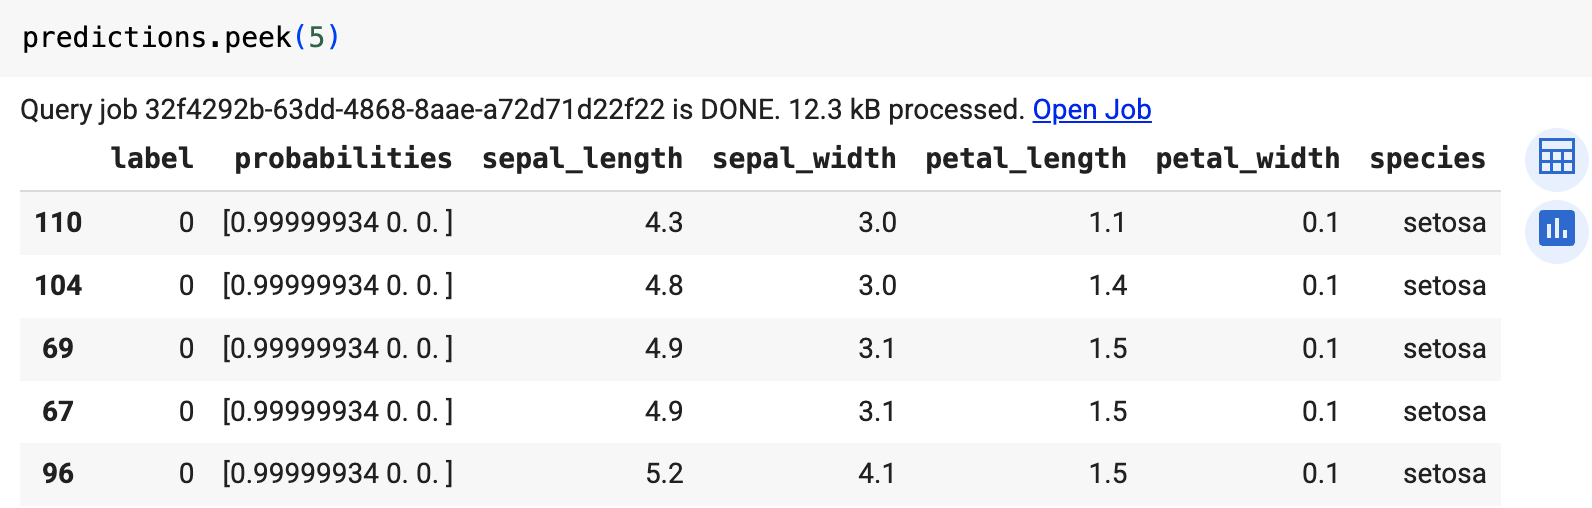
הסרת המשאבים
כדי להימנע מחיובים בחשבון Google Cloud בגלל השימוש במשאבים שנעשה במסגרת המדריך הזה, אפשר למחוק את הפרויקט שמכיל את המשאבים, או להשאיר את הפרויקט ולמחוק את המשאבים הנפרדים.
מחיקת הפרויקט
המסוף
- במסוף Google Cloud , נכנסים לדף Manage resources.
- ברשימת הפרויקטים, בוחרים את הפרויקט שרוצים למחוק ולוחצים על Delete.
- כדי למחוק את הפרויקט, כותבים את מזהה הפרויקט בתיבת הדו-שיח ולוחצים על Shut down.
gcloud
כדי למחוק פרויקט ב- Google Cloud :
gcloud projects delete PROJECT_ID
מחיקת משאבים ספציפיים
לחלופין, כדי להסיר את המשאבים הספציפיים שבהם השתמשתם במדריך הזה:
אופציונלי: מוחקים את מערך הנתונים.
המאמרים הבאים
- מידע נוסף על ייבוא מודלים של ONNX זמין במאמר ההצהרה
CREATE MODELלמודלים של ONNX. - מידע נוסף על ממירי ONNX זמינים ומדריכים זמין במאמר המרת מודלים לפורמט ONNX.
- לסקירה כללית על BigQuery ML, קראו את המאמר מבוא ל-BigQuery ML.
- כדי להתחיל להשתמש ב-BigQuery ML, קראו את המאמר יצירת מודלים של למידת מכונה ב-BigQuery ML.