


Carica dati JSON da Cloud Storage
Puoi caricare dati JSON delimitati da riga (ndJSON) da Cloud Storage in una nuova tabella o partizione oppure aggiungerli o sovrascriverli in una tabella o partizione esistente. Quando i dati vengono caricati in BigQuery, vengono convertiti nel formato colonnare per Capacitor (il formato di archiviazione di BigQuery).
Il formato ndJSON è lo stesso del formato JSON Lines.
Limitazioni
Quando carichi dati in BigQuery da un bucket Cloud Storage, si applicano le seguenti limitazioni:
- BigQuery non garantisce la coerenza dei dati per le origini dati esterne. Le modifiche ai dati sottostanti durante l'esecuzione di una query possono causare comportamenti imprevisti.
- BigQuery non supporta il controllo delle versioni degli oggetti di Cloud Storage. Se includi un numero di generazione nell'URI Cloud Storage, il job di caricamento non va a buon fine.
Quando carichi file JSON in BigQuery, tieni presente quanto segue:
- I dati JSON devono essere delimitati da nuova riga o ndJSON. Ogni oggetto JSON deve trovarsi su una riga separata nel file.
- Se utilizzi la compressione gzip, BigQuery non può leggere i dati in parallelo. Il caricamento di dati JSON compressi in BigQuery è più lento rispetto al caricamento di dati non compressi.
- Non puoi includere file compressi e non compressi nello stesso job di caricamento.
- La dimensione massima di un file gzip è 4 GB.
BigQuery supporta il tipo
JSONanche se le informazioni sullo schema non sono note al momento dell'importazione. Un campo dichiarato come tipoJSONviene caricato con i valori JSON non elaborati.Se utilizzi l'API BigQuery per caricare un numero intero al di fuori dell'intervallo [-253+1, 253-1] (di solito significa maggiore di 9.007.199.254.740.991) in una colonna di numeri interi (INT64), passalo come stringa per evitare il danneggiamento dei dati. Questo problema è causato da una limitazione delle dimensioni degli interi in JSON o ECMAScript. Per saperne di più, consulta la sezione Numbers della RFC 7159.
- Quando carichi dati CSV o JSON, i valori nelle colonne
DATEdevono utilizzare il trattino (-) come separatore e la data deve essere nel seguente formato:YYYY-MM-DD(anno-mese-giorno). - Quando carichi dati JSON o CSV, i valori nelle colonne
TIMESTAMPdevono utilizzare un trattino (-) o una barra (/) come separatore per la parte della data del timestamp, che deve essere in uno dei seguenti formati:YYYY-MM-DD(anno-mese-giorno) oYYYY/MM/DD(anno/mese/giorno). La partehh:mm:ss(ora-minuto-secondo) del timestamp deve utilizzare i due punti (:) come separatore. I file devono rispettare i limiti di dimensione dei file JSON descritti nei limiti dei job di caricamento.
Prima di iniziare
Concedi i ruoli Identity and Access Management (IAM) che forniscono agli utenti le autorizzazioni necessarie per eseguire ogni attività in questo documento e crea un set di dati per archiviare i tuoi dati.
Autorizzazioni obbligatorie
Per caricare i dati in BigQuery, devi disporre delle autorizzazioni IAM per eseguire un job di caricamento e caricare i dati nelle tabelle BigQuery e nelle partizioni. Se carichi dati da Cloud Storage, devi anche disporre delle autorizzazioni IAM per accedere al bucket che contiene i tuoi dati.
Autorizzazioni per caricare i dati in BigQuery
Per caricare i dati in una nuova tabella o partizione BigQuery o per aggiungerli o sovrascriverli in una tabella o partizione esistente, devi disporre delle seguenti autorizzazioni IAM:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
Ognuno dei seguenti ruoli IAM predefiniti include le autorizzazioni necessarie per caricare i dati in una tabella BigQuery o partizione:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(include l'autorizzazionebigquery.jobs.create)bigquery.user(include l'autorizzazionebigquery.jobs.create)bigquery.jobUser(include l'autorizzazionebigquery.jobs.create)
Inoltre, se disponi dell'autorizzazione bigquery.datasets.create, puoi creare e aggiornare le tabelle utilizzando un job di caricamento nei set di dati che crei.
Per saperne di più sui ruoli e sulle autorizzazioni IAM in BigQuery, consulta Ruoli e autorizzazioni predefiniti.
Autorizzazioni per caricare i dati da Cloud Storage
Per ottenere le autorizzazioni necessarie per caricare i dati da un bucket Cloud Storage, chiedi all'amministratore di concederti il ruolo IAM Storage Admin (roles/storage.admin) sul bucket.
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questo ruolo predefinito contiene le autorizzazioni necessarie per caricare i dati da un bucket Cloud Storage. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per caricare i dati da un bucket Cloud Storage sono necessarie le seguenti autorizzazioni:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Crea un set di dati
Crea un set di dati BigQuery per archiviare i tuoi dati.
Compressione JSON
Puoi utilizzare l'utilità gzip per comprimere i file JSON. Tieni presente che gzip esegue la compressione completa dei file, a differenza della compressione dei contenuti dei file eseguita dai codec di compressione per altri formati file, come Avro. L'utilizzo di gzip per comprimere i file JSON potrebbe avere un impatto sulle prestazioni. Per ulteriori informazioni sui compromessi, consulta Caricamento di dati compressi e non compressi.
Caricamento dei dati JSON in una nuova tabella
Per caricare i dati JSON da Cloud Storage in una nuova tabella BigQuery:
Console
Nella console Google Cloud , vai alla pagina BigQuery.
- Nel riquadro a sinistra, fai clic su Explorer.
- Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati e seleziona un set di dati.
- Nella sezione Informazioni set di dati, fai clic su Crea tabella.
- Nel riquadro Crea tabella, specifica i seguenti dettagli:
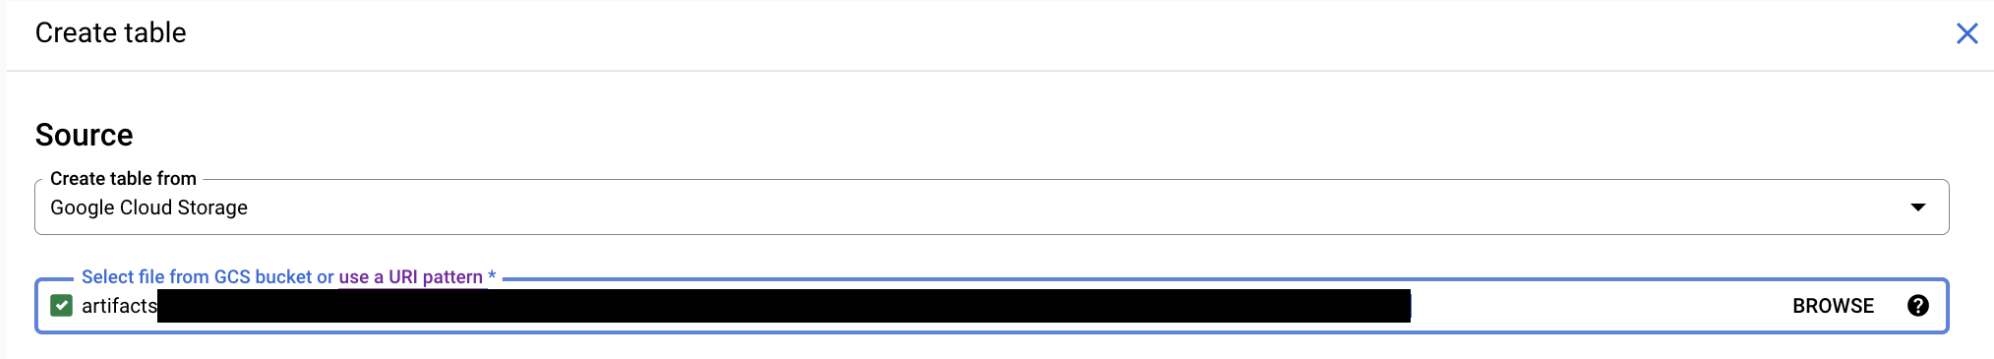
- Nella sezione Origine, seleziona Google Cloud Storage nell'elenco Crea tabella da.
Poi:
- Seleziona un file dal bucket Cloud Storage o inserisci l'URI Cloud Storage.
Non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che vuoi creare, aggiungere o sovrascrivere.
- In Formato file, seleziona JSONL (JSON delimitato da nuova riga).
- Seleziona un file dal bucket Cloud Storage o inserisci l'URI Cloud Storage.
Non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che vuoi creare, aggiungere o sovrascrivere.
- Nella sezione Destinazione, specifica i seguenti dettagli:
- In Set di dati, seleziona il set di dati in cui vuoi creare la tabella.
- Nel campo Table (Tabella), inserisci il nome della tabella che vuoi creare.
- Verifica che il campo Tipo di tabella sia impostato su Tabella nativa.
- Nella sezione Schema, inserisci la definizione dello schema.
Per attivare il rilevamento automatico di uno schema, seleziona Rilevamento automatico.
Puoi inserire le informazioni dello schema manualmente utilizzando uno dei seguenti metodi:
- Opzione 1: fai clic su Modifica come testo e incolla lo schema sotto forma di array JSON. Quando utilizzi un array JSON, generi lo schema utilizzando lo stesso processo di creazione di un file di schema JSON.
Puoi visualizzare lo schema di una tabella esistente in formato JSON inserendo il seguente comando:
bq show --format=prettyjson dataset.table
- Opzione 2: fai clic su Aggiungi campo e inserisci lo schema della tabella. Specifica i valori Nome, Tipo e Modalità di ogni campo.
- Opzione 1: fai clic su Modifica come testo e incolla lo schema sotto forma di array JSON. Quando utilizzi un array JSON, generi lo schema utilizzando lo stesso processo di creazione di un file di schema JSON.
Puoi visualizzare lo schema di una tabella esistente in formato JSON inserendo il seguente comando:
- (Facoltativo) Specifica le Impostazioni di partizionamento e clustering. Per saperne di più, consulta Creazione di tabelle partizionate e Creazione e utilizzo di tabelle in cluster.
- Fai clic su Opzioni avanzate e segui questi passaggi:
- In Preferenza di scrittura, lascia selezionata l'opzione Scrivi se vuota. Questa opzione crea una nuova tabella e vi carica i dati.
- In Numero di errori consentiti, accetta il valore predefinito
0o inserisci il numero massimo di righe contenenti errori che possono essere ignorate. Se il numero di righe con errori supera questo valore, il job darà un messaggioinvalide avrà esito negativo. Questa opzione si applica solo ai file CSV e JSON. - In Fuso orario, inserisci il fuso orario predefinito che verrà applicato durante l'analisi dei valori timestamp che non hanno un fuso orario specifico. Controlla qui per altri nomi di fusi orari validi. Se questo valore non è presente, i valori timestamp senza fuso orario specifico vengono analizzati utilizzando il fuso orario predefinito UTC.
- In Formato data, inserisci gli
elementi di formato che definiscono come vengono formattati i valori DATE nei file di input. Questo campo deve essere negli stili SQL (ad esempio,
MM/DD/YYYY). Se questo valore è presente, questo formato è l'unico formato DATE compatibile. Anche il rilevamento automatico dello schema deciderà il tipo di colonna DATE in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo DATE viene analizzato con i formati predefiniti. - In Formato data/ora, inserisci gli
elementi di formato che definiscono come vengono formattati i valori DATETIME nei file di input.
Questo campo deve essere negli stili SQL (ad esempio,
MM/DD/YYYY HH24:MI:SS.FF3). Se questo valore è presente, questo formato è l'unico formato DATETIME compatibile. Anche il rilevamento automatico dello schema deciderà il tipo di colonna DATETIME in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo DATETIME viene analizzato con i formati predefiniti. - In Formato ora, inserisci gli
elementi di formato che definiscono come vengono formattati i valori TIME nei file di input. Questo campo deve essere negli stili SQL (ad esempio,
HH24:MI:SS.FF3). Se questo valore è presente, questo formato è l'unico formato TIME compatibile. Anche il rilevamento automatico dello schema deciderà il tipo di colonna TIME in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo TIME viene analizzato con i formati predefiniti. - In Formato timestamp, inserisci gli
elementi di formato che definiscono come vengono formattati i valori TIMESTAMP nei file di input.
Questo campo deve essere negli stili SQL (ad esempio,
MM/DD/YYYY HH24:MI:SS.FF3). Se questo valore è presente, questo formato è l'unico formato TIMESTAMP compatibile. Anche il rilevamento automatico dello schema deciderà il tipo di colonna TIMESTAMP in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo TIMESTAMP viene analizzato con i formati predefiniti. - Se vuoi ignorare i valori di una riga che non sono presenti nello schema della tabella, seleziona Valori sconosciuti.
- In Crittografia, fai clic su Chiave gestita dal cliente per utilizzare una chiave di Cloud Key Management Service. Se lasci l'impostazione Google-managed key, BigQuery cripta i dati at-rest.
- Fai clic su Crea tabella.
SQL
Utilizza l'istruzione DDL LOAD DATA.
L'esempio seguente carica un file JSON nella nuova tabella mytable:
Nella console Google Cloud , vai alla pagina BigQuery.
Nell'editor di query, inserisci la seguente istruzione:
LOAD DATA OVERWRITE mydataset.mytable
(x INT64,y STRING)
FROM FILES (
  format = 'JSON',
  uris = ['gs://bucket/path/file.json']);
Fai clic su Esegui.
Per saperne di più su come eseguire le query, consulta Esegui una query interattiva.
bq
Utilizza il comando bq load, specifica NEWLINE_DELIMITED_JSON utilizzando il flag --source_format e includi un URI Cloud Storage.
Puoi includere un singolo URI, un elenco separato da virgole di URI o un URI contenente un carattere jolly.
Fornisci lo schema in linea, in un file di definizione dello schema, oppure utilizza il rilevamento automatico dello schema.
(Facoltativo) Specifica il flag --location e imposta il valore sulla tua località.
Altri flag facoltativi includono:
--max_bad_records: un numero intero che specifica il numero massimo di record non validi consentiti prima che l'intero job non vada a buon fine. Il valore predefinito è0. Vengono restituiti al massimo cinque errori di qualsiasi tipo, indipendentemente dal valore--max_bad_records.--ignore_unknown_values: se specificato, consente e ignora i valori aggiuntivi non riconosciuti nei dati CSV o JSON.--time_zone: (Anteprima) un fuso orario predefinito facoltativo che verrà applicato durante l'analisi dei valori di timestamp che non hanno un fuso orario specifico nei dati CSV o JSON.--date_format: (Anteprima) una stringa personalizzata facoltativa che definisce il modo in cui i valori DATE vengono formattati nei dati CSV o JSON.--datetime_format: (Anteprima) una stringa personalizzata facoltativa che definisce la formattazione dei valori DATETIME nei dati CSV o JSON.--time_format: (Anteprima) una stringa personalizzata facoltativa che definisce la formattazione dei valori TIME nei dati CSV o JSON.--timestamp_format: (Anteprima) una stringa personalizzata facoltativa che definisce la formattazione dei valori TIMESTAMP nei dati CSV o JSON.--autodetect: se specificato, abilita il rilevamento automatico dello schema per i dati CSV e JSON.--time_partitioning_type: attiva il partizionamento basato sul tempo in una tabella e imposta il tipo di partizione. I valori possibili sonoHOUR,DAY,MONTHeYEAR. Questo flag è facoltativo quando crei una tabella partizionata in base a una colonnaDATE,DATETIMEoTIMESTAMP. Il tipo di partizione predefinito per il partizionamento basato sul tempo èDAY. Non puoi modificare la specifica di partizionamento di una tabella esistente.--time_partitioning_expiration: un numero intero che specifica (in secondi) quando deve essere eliminata una partizione basata sul tempo. La data/ora di scadenza viene valutata in base alla data UTC della partizione più il valore intero.--time_partitioning_field: la colonnaDATEoTIMESTAMPutilizzata per creare una tabella partizionata. Se il partizionamento basato sul tempo è abilitato senza questo valore, viene creata una tabella partizionata per data di importazione.--require_partition_filter: se abilitata, questa opzione richiede agli utenti di includere una clausolaWHEREche specifica le partizioni su cui eseguire query. Se il filtro di partizionamento è obbligatorio, i costi possono essere ridotti e le prestazioni migliorate. Per saperne di più, consulta Richiedi un filtro di partizione nelle query.--clustering_fields: un elenco separato da virgole di massimo quattro nomi di colonne utilizzati per creare una tabella in cluster.--destination_kms_key: la chiave Cloud KMS per la crittografia dei dati della tabella.Per ulteriori informazioni sulle tabelle partizionate, consulta:
Per saperne di più sulle tabelle in cluster, consulta:
Per saperne di più sulla crittografia delle tabelle, consulta:
Per caricare i dati JSON in BigQuery, inserisci il seguente comando:
bq --location=LOCATION load \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE \
SCHEMA
Sostituisci quanto segue:
LOCATION: la tua località. Il flag--locationè facoltativo. Ad esempio, se utilizzi BigQuery nella regione di Tokyo, puoi impostare il valore del flag suasia-northeast1. Puoi impostare un valore predefinito per la località utilizzando il file.bigqueryrc.FORMAT:NEWLINE_DELIMITED_JSON.DATASET: un set di dati esistente.TABLE: il nome della tabella in cui stai caricando i dati.PATH_TO_SOURCE: un URI Cloud Storage completo o un elenco separato da virgole di URI. Sono supportati anche i caratteri jolly.SCHEMA: uno schema valido. Lo schema può essere un file JSON locale o può essere digitato in linea come parte del comando. Se utilizzi un file di schema, non assegnargli un'estensione. Puoi anche utilizzare il flag--autodetectanziché fornire una definizione dello schema.
Esempi:
Il seguente comando carica i dati da gs://mybucket/mydata.json in una tabella denominata mytable in mydataset. Lo schema è definito in un file di schema locale denominato myschema.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    ./myschema
Il comando seguente carica i dati da gs://mybucket/mydata.json in una nuova tabella partizionata per data di importazione denominata mytable in mydataset. Lo schema è definito in un file di schema locale denominato myschema.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    --time_partitioning_type=DAY \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    ./myschema
Il seguente comando carica i dati da gs://mybucket/mydata.json in una tabella partizionata denominata mytable in mydataset. La tabella è partizionata in base alla colonna mytimestamp. Lo schema è definito in un file di schema locale denominato myschema.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    --time_partitioning_field mytimestamp \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    ./myschema
Il seguente comando carica i dati da gs://mybucket/mydata.json in una tabella denominata mytable in mydataset. Lo schema viene rilevato automaticamente.
    bq load \
    --autodetect \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json
Il seguente comando carica i dati da gs://mybucket/mydata.json in una tabella denominata mytable in mydataset. Lo schema è definito in linea nel formato FIELD:DATA_TYPE, FIELD:DATA_TYPE.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    qtr:STRING,sales:FLOAT,year:STRING
Il comando seguente carica i dati da più file in gs://mybucket/ in una tabella denominata mytable in mydataset. L'URI Cloud Storage utilizza un carattere jolly. Lo schema viene rilevato automaticamente.
    bq load \
    --autodetect \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata*.json
Il comando seguente carica i dati da più file in gs://mybucket/ in una tabella denominata mytable in mydataset. Il comando include un elenco separato da virgole di URI Cloud Storage con caratteri jolly. Lo schema è definito in un file di schema locale denominato myschema.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    "gs://mybucket/00/*.json","gs://mybucket/01/*.json" \
    ./myschema
API
Crea un job
loadche punti ai dati di origine in Cloud Storage.(Facoltativo) Specifica la tua località nella proprietà
locationnella sezionejobReferencedella risorsa job.La proprietà
source URIsdeve essere un nome completo nel formatogs://BUCKET/OBJECT. Ogni URI può contenere un carattere jolly "*".Specifica il formato dei dati
JSONimpostando la proprietàsourceFormatsuNEWLINE_DELIMITED_JSON.Per controllare lo stato del job, chiama
jobs.get(JOB_ID*), sostituendoJOB_IDcon l'ID del job restituito dalla richiesta iniziale.- Se è
status.state = DONE, il job è stato completato correttamente. - Se la proprietà
status.errorResultè presente, la richiesta non è andata a buon fine e l'oggetto include informazioni che descrivono il problema. Se una richiesta non va a buon fine, non viene creata alcuna tabella e non vengono caricati dati. - Se
status.errorResultnon è presente, il job è stato completato correttamente, anche se potrebbero essersi verificati alcuni errori non irreversibili, ad esempio problemi di importazione di alcune righe. Gli errori non irreversibili sono elencati nella proprietàstatus.errorsdell'oggetto job restituito.
- Se è
Note sull'API:
I job di caricamento sono atomici e coerenti; se un job di caricamento non va a buon fine, non sono disponibili dati, mentre se un job di caricamento va a buon fine, sono disponibili tutti i dati.
Come best practice, genera un ID univoco e passalo come
jobReference.jobIdquando chiamijobs.insertper creare un job di caricamento. Questo approccio è più efficace in caso di errori di rete perché il client può eseguire il polling o riprovare con l'ID job noto.La chiamata di
jobs.insertsu un determinato ID job è idempotente. Puoi riprovare tutte le volte che vuoi con lo stesso ID job e, al massimo, una di queste operazioni andrà a buon fine.
C#
Prima di provare questo esempio, segui le istruzioni di configurazione di C# nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery C#.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Utilizza il metodoBigQueryClient.CreateLoadJob() per avviare un job di caricamento da Cloud Storage. Per utilizzare JSONL, crea un oggetto CreateLoadJobOptions e imposta la relativa proprietà SourceFormat su FileFormat.NewlineDelimitedJson.
Vai
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Go.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Java
Prima di provare questo esempio, segui le istruzioni di configurazione di Java nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Java.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Utilizza il metodo LoadJobConfiguration.builder(tableId, sourceUri) per avviare un job di caricamento da Cloud Storage. Per utilizzare JSON delimitato da nuova riga, utilizza LoadJobConfiguration.setFormatOptions(FormatOptions.json()).
Node.js
Prima di provare questo esempio, segui le istruzioni di configurazione di Node.js nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Node.js.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
PHP
Prima di provare questo esempio, segui le istruzioni di configurazione di PHP nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery PHP.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Python
Prima di provare questo esempio, segui le istruzioni di configurazione di Python nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Python.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Utilizza il metodo Client.load_table_from_uri() per avviare un job di caricamento da Cloud Storage. Per utilizzare JSONL, imposta la proprietà LoadJobConfig.source_format sulla stringaNEWLINE_DELIMITED_JSON e passa la configurazione del job come argomento job_config al metodo load_table_from_uri().
Ruby
Prima di provare questo esempio, segui le istruzioni di configurazione di Ruby nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Ruby.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Utilizza il metodo Dataset.load_job() per avviare un job di caricamento da Cloud Storage. Per utilizzare JSONL, imposta il parametroformat su "json".
Caricamento di dati JSON nidificati e ripetuti
BigQuery supporta il caricamento di dati nidificati e ripetuti da formati di origine che supportano schemi basati su oggetti, come JSON, Avro, ORC, Parquet, Firestore e Datastore.
Ogni riga deve contenere un oggetto JSON, inclusi eventuali campi nidificati o ripetuti.
L'esempio seguente mostra dati nidificati o ripetuti. Questa tabella contiene informazioni sulle persone. È composto dai seguenti campi:
idfirst_namelast_namedob(data di nascita)addresses(un campo nidificato e ripetuto)addresses.status(attuale o precedente)addresses.addressaddresses.cityaddresses.stateaddresses.zipaddresses.numberOfYears(anni all'indirizzo)
Il file di dati JSON sarà simile al seguente. Nota che il campo dell'indirizzo contiene un array di valori (indicato da [ ]).
{"id":"1","first_name":"John","last_name":"Doe","dob":"1968-01-22","addresses":[{"status":"current","address":"123 First Avenue","city":"Seattle","state":"WA","zip":"11111","numberOfYears":"1"},{"status":"previous","address":"456 Main Street","city":"Portland","state":"OR","zip":"22222","numberOfYears":"5"}]}
{"id":"2","first_name":"Jane","last_name":"Doe","dob":"1980-10-16","addresses":[{"status":"current","address":"789 Any Avenue","city":"New York","state":"NY","zip":"33333","numberOfYears":"2"},{"status":"previous","address":"321 Main Street","city":"Hoboken","state":"NJ","zip":"44444","numberOfYears":"3"}]}
Lo schema di questa tabella sarà simile al seguente:
[
    {
        "name": "id",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "first_name",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "last_name",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "dob",
        "type": "DATE",
        "mode": "NULLABLE"
    },
    {
        "name": "addresses",
        "type": "RECORD",
        "mode": "REPEATED",
        "fields": [
            {
                "name": "status",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "address",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "city",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "state",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "zip",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "numberOfYears",
                "type": "STRING",
                "mode": "NULLABLE"
            }
        ]
    }
]
Per informazioni su come specificare uno schema nidificato e ripetuto, consulta Specifica di campi nidificati e ripetuti.
Caricamento di dati JSON semistrutturati
BigQuery supporta il caricamento di dati semistrutturati, in cui un campo può assumere valori di tipi diversi. L'esempio seguente mostra dati simili
all'esempio precedente di
dati JSON nidificati e ripetuti,
con la differenza che il campo address può essere un STRING, un STRUCT o
un ARRAY:
{"id":"1","first_name":"John","last_name":"Doe","dob":"1968-01-22","address":"123 First Avenue, Seattle WA 11111"}

{"id":"2","first_name":"Jane","last_name":"Doe","dob":"1980-10-16","address":{"status":"current","address":"789 Any Avenue","city":"New York","state":"NY","zip":"33333","numberOfYears":"2"}}

{"id":"3","first_name":"Bob","last_name":"Doe","dob":"1982-01-10","address":[{"status":"current","address":"789 Any Avenue","city":"New York","state":"NY","zip":"33333","numberOfYears":"2"}, "321 Main Street Hoboken NJ 44444"]}
Puoi caricare questi dati in BigQuery utilizzando il seguente schema:
[
    {
        "name": "id",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "first_name",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "last_name",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "dob",
        "type": "DATE",
        "mode": "NULLABLE"
    },
    {
        "name": "address",
        "type": "JSON",
        "mode": "NULLABLE"
    }
]
Il campo address viene caricato in una colonna con tipo JSON che consente di contenere i tipi misti nell'esempio. Puoi importare i dati come JSON indipendentemente dal fatto che contengano o meno tipi misti. Ad esempio, puoi specificare JSON anziché STRING come tipo per il campo first_name. Per saperne di più, consulta Utilizzo dei dati JSON in GoogleSQL.
Aggiunta o sovrascrittura di una tabella con dati JSON
Puoi caricare dati aggiuntivi in una tabella dai file di origine o aggiungendo i risultati delle query.
Nella console Google Cloud , utilizza l'opzione Preferenza di scrittura per specificare l'azione da intraprendere quando carichi i dati da un file di origine o da un risultato di una query.
Quando carichi dati aggiuntivi in una tabella, hai le seguenti opzioni:
| Opzione della console | flag dello strumento bq | Proprietà API BigQuery | Descrizione |
|---|---|---|---|
| Scrivi se vuota | Non supportata | WRITE_EMPTY |
Scrive i dati solo se la tabella è vuota. |
| Aggiungi a tabella | --noreplace o --replace=false; se --[no]replace non è specificato, il valore predefinito è append |
WRITE_APPEND |
(Impostazione predefinita) Aggiunge i dati alla fine della tabella. |
| Sovrascrivi tabella | --replace o --replace=true |
WRITE_TRUNCATE |
Cancella tutti i dati esistenti in una tabella prima di scrivere i nuovi dati. Questa azione elimina anche lo schema della tabella, la sicurezza a livello di riga e rimuove qualsiasi chiave Cloud KMS. |
Se carichi i dati in una tabella esistente, il job di caricamento può aggiungere i dati o sovrascrivere la tabella.
Puoi aggiungere o sovrascrivere una tabella utilizzando uno dei seguenti metodi:
- La console Google Cloud
- Il comando
bq loaddello strumento a riga di comando bq - Il metodo API
jobs.inserte la configurazione di un jobload - Librerie client
Console
Nella console Google Cloud , vai alla pagina BigQuery.
- Nel riquadro a sinistra, fai clic su Explorer.
- Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati e seleziona un set di dati.
- Nella sezione Informazioni set di dati, fai clic su Crea tabella.
- Nel riquadro Crea tabella, specifica i seguenti dettagli:
- Nella sezione Origine, seleziona Google Cloud Storage nell'elenco Crea tabella da.
Poi:
- Seleziona un file dal bucket Cloud Storage o inserisci l'URI Cloud Storage.
Non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che vuoi creare, aggiungere o sovrascrivere.
- In Formato file, seleziona JSONL (JSON delimitato da nuova riga).
- Seleziona un file dal bucket Cloud Storage o inserisci l'URI Cloud Storage.
Non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che vuoi creare, aggiungere o sovrascrivere.
- Nella sezione Destinazione, specifica i seguenti dettagli:
- In Set di dati, seleziona il set di dati in cui vuoi creare la tabella.
- Nel campo Table (Tabella), inserisci il nome della tabella che vuoi creare.
- Verifica che il campo Tipo di tabella sia impostato su Tabella nativa.
- Nella sezione Schema, inserisci la definizione dello schema.
Per attivare il rilevamento automatico di uno schema, seleziona Rilevamento automatico.
Puoi inserire le informazioni dello schema manualmente utilizzando uno dei seguenti metodi:
- Opzione 1: fai clic su Modifica come testo e incolla lo schema sotto forma di array JSON. Quando utilizzi un array JSON, generi lo schema utilizzando lo stesso processo di creazione di un file di schema JSON.
Puoi visualizzare lo schema di una tabella esistente in formato JSON inserendo il seguente comando:
bq show --format=prettyjson dataset.table
- Opzione 2: fai clic su Aggiungi campo e inserisci lo schema della tabella. Specifica i valori Nome, Tipo e Modalità di ogni campo.
- Opzione 1: fai clic su Modifica come testo e incolla lo schema sotto forma di array JSON. Quando utilizzi un array JSON, generi lo schema utilizzando lo stesso processo di creazione di un file di schema JSON.
Puoi visualizzare lo schema di una tabella esistente in formato JSON inserendo il seguente comando:
- (Facoltativo) Specifica le Impostazioni di partizionamento e clustering. Per saperne di più, consulta Creazione di tabelle partizionate e Creazione e utilizzo di tabelle in cluster. Non puoi convertire una tabella in una tabella partizionata o in cluster aggiungendola o sovrascrivendola. La console Google Cloud non supporta l'aggiunta o la sovrascrittura di tabelle partizionate o in cluster in un job di caricamento.
- Fai clic su Opzioni avanzate e segui questi passaggi:
- In Preferenza di scrittura, scegli Aggiungi alla tabella o Sovrascrivi tabella.
- In Numero di errori consentiti, accetta il valore predefinito
0o inserisci il numero massimo di righe contenenti errori che possono essere ignorate. Se il numero di righe con errori supera questo valore, il job darà un messaggioinvalide avrà esito negativo. Questa opzione si applica solo ai file CSV e JSON. - In Fuso orario, inserisci il fuso orario predefinito che verrà applicato durante l'analisi dei valori timestamp che non hanno un fuso orario specifico. Controlla qui per altri nomi di fusi orari validi. Se questo valore non è presente, i valori timestamp senza fuso orario specifico vengono analizzati utilizzando il fuso orario predefinito UTC.
- In Formato data, inserisci gli
elementi di formato che definiscono come vengono formattati i valori DATE nei file di input. Questo campo deve essere negli stili SQL (ad esempio,
MM/DD/YYYY). Se questo valore è presente, questo formato è l'unico formato DATE compatibile. Anche il rilevamento automatico dello schema deciderà il tipo di colonna DATE in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo DATE viene analizzato con i formati predefiniti. - In Formato data/ora, inserisci gli
elementi di formato che definiscono come vengono formattati i valori DATETIME nei file di input.
Questo campo deve essere negli stili SQL (ad esempio,
MM/DD/YYYY HH24:MI:SS.FF3). Se questo valore è presente, questo formato è l'unico formato DATETIME compatibile. Anche il rilevamento automatico dello schema deciderà il tipo di colonna DATETIME in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo DATETIME viene analizzato con i formati predefiniti. - In Formato ora, inserisci gli
elementi di formato che definiscono come vengono formattati i valori TIME nei file di input. Questo campo deve essere negli stili SQL (ad esempio,
HH24:MI:SS.FF3). Se questo valore è presente, questo formato è l'unico formato TIME compatibile. Anche il rilevamento automatico dello schema deciderà il tipo di colonna TIME in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo TIME viene analizzato con i formati predefiniti. - In Formato timestamp, inserisci gli
elementi di formato che definiscono come vengono formattati i valori TIMESTAMP nei file di input.
Questo campo deve essere negli stili SQL (ad esempio,
MM/DD/YYYY HH24:MI:SS.FF3). Se questo valore è presente, questo formato è l'unico formato TIMESTAMP compatibile. Anche il rilevamento automatico dello schema deciderà il tipo di colonna TIMESTAMP in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo TIMESTAMP viene analizzato con i formati predefiniti. - Se vuoi ignorare i valori di una riga che non sono presenti nello schema della tabella, seleziona Valori sconosciuti.
- In Crittografia, fai clic su Chiave gestita dal cliente per utilizzare una chiave di Cloud Key Management Service. Se lasci l'impostazione Google-managed key, BigQuery cripta i dati at-rest.
- Fai clic su Crea tabella.
SQL
Utilizza l'istruzione DDL LOAD DATA.
L'esempio seguente aggiunge un file JSON alla tabella mytable:
Nella console Google Cloud , vai alla pagina BigQuery.
Nell'editor di query, inserisci la seguente istruzione:
LOAD DATA INTO mydataset.mytable
FROM FILES (
  format = 'JSON',
  uris = ['gs://bucket/path/file.json']);
Fai clic su Esegui.
Per saperne di più su come eseguire le query, consulta Esegui una query interattiva.
bq
Utilizza il comando bq load, specifica NEWLINE_DELIMITED_JSON utilizzando il flag --source_format e includi un URI Cloud Storage.
Puoi includere un singolo URI, un elenco separato da virgole di URI o un URI contenente un carattere jolly.
Fornisci lo schema in linea, in un file di definizione dello schema, oppure utilizza il rilevamento automatico dello schema.
Specifica il flag --replace per sovrascrivere la tabella. Utilizza il flag --noreplace per aggiungere dati alla tabella. Se non viene specificato alcun flag, per impostazione predefinita i dati vengono aggiunti.
È possibile modificare lo schema della tabella quando la aggiungi o la sovrascrivi. Per ulteriori informazioni sulle modifiche allo schema supportate durante un'operazione di caricamento, consulta Modifica degli schemi delle tabelle.
(Facoltativo) Specifica il flag --location e imposta il valore sulla tua località.
Altri flag facoltativi includono:
--max_bad_records: un numero intero che specifica il numero massimo di record non validi consentiti prima che l'intero job non vada a buon fine. Il valore predefinito è0. Vengono restituiti al massimo cinque errori di qualsiasi tipo, indipendentemente dal valore--max_bad_records.--ignore_unknown_values: se specificato, consente e ignora i valori aggiuntivi non riconosciuti nei dati CSV o JSON.--time_zone: (Anteprima) un fuso orario predefinito facoltativo che verrà applicato durante l'analisi dei valori di timestamp che non hanno un fuso orario specifico nei dati CSV o JSON.--date_format: (Anteprima) una stringa personalizzata facoltativa che definisce il modo in cui i valori DATE vengono formattati nei dati CSV o JSON.--datetime_format: (Anteprima) una stringa personalizzata facoltativa che definisce la formattazione dei valori DATETIME nei dati CSV o JSON.--time_format: (Anteprima) una stringa personalizzata facoltativa che definisce la formattazione dei valori TIME nei dati CSV o JSON.--timestamp_format: (Anteprima) una stringa personalizzata facoltativa che definisce la formattazione dei valori TIMESTAMP nei dati CSV o JSON.--autodetect: se specificato, abilita il rilevamento automatico dello schema per i dati CSV e JSON.--destination_kms_key: la chiave Cloud KMS per la crittografia dei dati della tabella.
bq --location=LOCATION load \
--[no]replace \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE \
SCHEMA
Sostituisci quanto segue:
LOCATION: la tua località. Il flag--locationè facoltativo. Puoi impostare un valore predefinito per la località utilizzando il file.bigqueryrc.FORMAT:NEWLINE_DELIMITED_JSON.DATASET: un set di dati esistente.TABLE: il nome della tabella in cui stai caricando i dati.PATH_TO_SOURCE: un URI Cloud Storage completo o un elenco separato da virgole di URI. Sono supportati anche i caratteri jolly.SCHEMA: uno schema valido. Lo schema può essere un file JSON locale o può essere digitato in linea come parte del comando. Puoi anche utilizzare il flag--autodetectanziché fornire una definizione dello schema.
Esempi:
Il seguente comando carica i dati da gs://mybucket/mydata.json e sovrascrive una tabella denominata mytable in mydataset. Lo schema viene definito utilizzando il rilevamento automatico dello schema.
    bq load \
    --autodetect \
    --replace \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json
Il seguente comando carica i dati da gs://mybucket/mydata.json e li aggiunge a una tabella denominata mytable in mydataset. Lo schema è definito utilizzando un file di schema JSON: myschema.
    bq load \
    --noreplace \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    ./myschema
API
Crea un job
loadche punti ai dati di origine in Cloud Storage.(Facoltativo) Specifica la tua località nella proprietà
locationnella sezionejobReferencedella risorsa job.La proprietà
source URIsdeve essere un nome completo nel formatogs://BUCKET/OBJECT. Puoi includere più URI come elenco separato da virgole. Sono supportati anche i caratteri jolly.Specifica il formato dei dati impostando la proprietà
configuration.load.sourceFormatsuNEWLINE_DELIMITED_JSON.Specifica la preferenza di scrittura impostando la proprietà
configuration.load.writeDispositionsuWRITE_TRUNCATEoWRITE_APPEND.
Vai
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Go.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Java
Node.js
Prima di provare questo esempio, segui le istruzioni di configurazione di Node.js nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Node.js.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
PHP
Prima di provare questo esempio, segui le istruzioni di configurazione di PHP nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery PHP.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Python
Per sostituire le righe in una tabella esistente, imposta la proprietà LoadJobConfig.write_disposition sulla stringa WRITE_TRUNCATE.
Prima di provare questo esempio, segui le istruzioni di configurazione di Python nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Python.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Ruby
Per sostituire le righe di una tabella esistente, imposta il parametro write di
Table.load_job()
su "WRITE_TRUNCATE".
Prima di provare questo esempio, segui le istruzioni di configurazione di Ruby nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Ruby.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Caricamento di dati JSON partizionati in Hive
BigQuery supporta il caricamento di dati JSON partizionati con Hive archiviati su Cloud Storage e compila le colonne di partizionamento Hive come colonne nella tabella gestita di BigQuery di destinazione. Per saperne di più, consulta Carica dati partizionati esternamente.
Dettagli del caricamento dei dati JSON
Questa sezione descrive in che modo BigQuery analizza i vari tipi di dati durante il caricamento dei dati JSON.
Tipi di dati
Boolean. BigQuery può analizzare una qualsiasi delle seguenti coppie per i dati booleani: 1 o 0, true o false, t o f, yes o no o y o n (tutte senza distinzione tra maiuscole e minuscole). Il rilevamento automatico dello schema rileva automaticamente uno di questi valori, ad eccezione di 0 e 1.Bytes. Le colonne con tipi BYTES devono essere codificate in Base64.
Data. Le colonne con tipi DATE devono essere nel formato YYYY-MM-DD.
Datetime. Le colonne con tipi DATETIME devono essere nel formato YYYY-MM-DD
HH:MM:SS[.SSSSSS].
Area geografica. Le colonne con tipi GEOGRAPHY devono contenere stringhe in uno dei seguenti formati:
- Well-Known Text (WKT)
- Well-Known Binary (WKB)
- GeoJSON
Se utilizzi WKB, il valore deve essere codificato in formato esadecimale.
Il seguente elenco mostra esempi di dati validi:
- WKT:
POINT(1 2) - GeoJSON:
{ "type": "Point", "coordinates": [1, 2] } - WKB con codifica esadecimale:
0101000000feffffffffffef3f0000000000000040
Prima di caricare i dati GEOGRAPHY, leggi anche Caricamento dei dati geospaziali.
Intervallo. Le colonne con tipi INTERVAL devono essere nel formato ISO 8601 PYMDTHMS, dove:
- P = indicatore che indica che il valore rappresenta una durata. Devi sempre includerlo.
- Y = anno
- M = mese
- D = Day (giorno)
- T = indicatore che indica la parte dell'ora della durata. Devi sempre includerlo.
- H = ora
- M = minuto
- S = secondo. I secondi possono essere indicati come un valore intero o come un valore frazionario fino a sei cifre, con precisione al microsecondo.
Puoi indicare un valore negativo anteponendo un trattino (-).
Il seguente elenco mostra esempi di dati validi:
P-10000Y0M-3660000DT-87840000H0M0SP0Y0M0DT0H0M0.000001SP10000Y0M3660000DT87840000H0M0S
Per caricare i dati INTERVAL, devi utilizzare il comando bq load e il flag --schema per specificare uno schema. Non puoi caricare dati INTERVAL utilizzando la console.
Ora. Le colonne con tipi TIME devono essere nel formato HH:MM:SS[.SSSSSS].
Timestamp. BigQuery accetta vari formati di timestamp. Il timestamp deve includere una parte relativa alla data e una relativa all'ora.
La parte della data può essere formattata come
YYYY-MM-DDoYYYY/MM/DD.La parte del timestamp deve essere formattata come
HH:MM[:SS[.SSSSSS]](i secondi e le frazioni di secondo sono facoltativi).La data e l'ora devono essere separate da uno spazio o da "T".
Facoltativamente, la data e l'ora possono essere seguite da un offset UTC o dall'indicatore di fuso orario UTC (
Z). Per ulteriori informazioni, vedi Fusi orari.
Ad esempio, i seguenti sono valori di timestamp validi:
2018-08-19T12:112018-08-19T12:11:352018-08-19T12:11:35.222018/08/19T12:112018-07-05T12:54:00 UTC2018-08-19T07:11:35.220 -05:002018-08-19T12:11:35.220Z
Se fornisci uno schema, BigQuery accetta anche l'epoca di Unix per i valori di timestamp. Tuttavia, il rilevamento automatico dello schema non rileva questo caso e tratta il valore come un tipo numerico o stringa.
Esempi di valori di timestamp dell'epoca di Unix:
- 1534680695
- 1.534680695e12
Array (campo ripetuto). Il valore deve essere un array JSON o null. Il tipo JSON null viene convertito nel tipo SQL NULL. L'array stesso non può contenere valori null.
Rilevamento automatico dello schema
Questa sezione descrive il comportamento del rilevamento automatico dello schema durante il caricamento dei file JSON.
Campi JSON nidificati e ripetuti
BigQuery deduce i campi nidificati e ripetuti nei file JSON. Se il valore di un campo è un oggetto JSON, BigQuery carica la colonna come tipo RECORD. Se il valore di un campo è un array, BigQuery carica la colonna come colonna ripetuta. Per un esempio di dati JSON con dati nidificati e ripetuti, consulta Caricamento di dati JSON nidificati e ripetuti.
Conversione di stringhe
Se attivi il rilevamento automatico dello schema, BigQuery converte le stringhe in tipi booleani, numerici o di data/ora, se possibile. Ad esempio, utilizzando i seguenti dati JSON, il rilevamento automatico dello schema converte il campo id in una colonna INTEGER:
{ "name":"Alice","id":"12"}
{ "name":"Bob","id":"34"}
{ "name":"Charles","id":"45"}
Tipi di codifica
BigQuery si aspetta che i dati JSON siano codificati in UTF-8. Se hai file JSON con altri tipi di codifica supportati, devi specificare esplicitamente la codifica utilizzando il flag --encoding in modo che BigQuery converta i dati in UTF-8.
BigQuery supporta i seguenti tipi di codifica per i file JSON:
- UTF-8
- ISO-8859-1
- UTF-16BE (UTF-16 Big Endian)
- UTF-16LE (UTF-16 Little Endian)
- UTF-32BE (UTF-32 Big Endian)
- UTF-32LE (UTF-32 Little Endian)
Opzioni JSON
Per modificare il modo in cui BigQuery analizza i dati JSON, specifica opzioni aggiuntive nella console Google Cloud , nello strumento a riga di comando bq, nell'API o nelle librerie client.
| Opzione JSON | Opzione della console | flag dello strumento bq | Proprietà API BigQuery | Descrizione |
|---|---|---|---|---|
| Numero di record non validi consentiti | Numero di errori consentiti | --max_bad_records |
maxBadRecords
(Java,
Python)
|
(Facoltativo) Il numero massimo di record non validi che BigQuery può ignorare durante l'esecuzione del job. Se il numero di record non validi supera questo valore, nel risultato del job viene restituito un errore non valido. Il valore predefinito è "0", il che significa che tutti i record devono essere validi. |
| Valori sconosciuti | Ignora valori sconosciuti | --ignore_unknown_values |
ignoreUnknownValues
(Java,
Python)
|
(Facoltativo) Indica se BigQuery deve consentire valori aggiuntivi non rappresentati nello schema della tabella. Se true, i valori aggiuntivi vengono ignorati. Se false, i record con colonne aggiuntive vengono trattati come record non validi e, se sono presenti troppi record non validi, nel risultato del job viene restituito un errore non valido. Il valore predefinito è false. La proprietà "sourceFormat" determina ciò che BigQuery considera un valore aggiuntivo: CSV: colonne finali, JSON: valori denominati che non corrispondono ad alcun nome di colonna. |
| Codifica | Nessuno | -E o --encoding |
encoding
(Python) |
(Facoltativo) La codifica dei caratteri dei dati. I valori supportati sono UTF-8, ISO-8859-1, UTF-16BE, UTF-16LE, UTF-32BE o UTF-32LE. Il valore predefinito è UTF-8. |
| Fuso orario | Fuso orario | --time_zone |
timeZone
(Java,
Python) |
(Facoltativo) Fuso orario predefinito che viene applicato durante l'analisi dei valori timestamp che non hanno un fuso orario specifico. Controlla i nomi dei fusi orari validi. Se questo valore non è presente, i valori timestamp senza fuso orario specifico vengono analizzati utilizzando il fuso orario predefinito UTC. |
| Formato data | Formato data | --date_format |
dateFormat
(Java,
Python) |
(Facoltativo)
Elementi di formato
che definiscono come vengono formattati i valori DATE nei file di input (ad
esempio, MM/DD/YYYY). Se questo valore è presente, questo formato è
l'unico formato DATE compatibile.
Anche il rilevamento automatico dello schema deciderà il tipo di colonna DATE in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo DATE viene analizzato con i formati predefiniti. |
| Formato data/ora | Formato data/ora | --datetime_format |
datetimeFormat
(Java,
Python) |
(Facoltativo)
Elementi di formato
che definiscono come vengono formattati i valori DATETIME nei file di input (ad
esempio, MM/DD/YYYY HH24:MI:SS.FF3). Se questo valore è presente,
questo formato è l'unico formato DATETIME compatibile.
Anche il rilevamento automatico dello schema deciderà il tipo di colonna DATETIME in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo DATETIME viene analizzato con i formati predefiniti. |
| Formato ora | Formato ora | --time_format |
timeFormat
(Java,
Python) |
(Facoltativo)
Elementi di formato
che definiscono come vengono formattati i valori TIME nei file di input (ad
esempio, HH24:MI:SS.FF3). Se questo valore è presente, questo formato
è l'unico formato TIME compatibile.
Anche il rilevamento automatico dello schema deciderà il tipo di colonna TIME in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo TIME viene analizzato con i formati predefiniti. |
| Formato timestamp | Formato timestamp | --timestamp_format |
timestampFormat
(Java,
Python) |
(Facoltativo) Elementi di formato che definiscono come vengono formattati i valori TIMESTAMP nei file di input (ad esempio, MM/DD/YYYY HH24:MI:SS.FF3). Se questo valore è presente, questo formato è l'unico formato TIMESTAMP compatibile.
Anche il rilevamento automatico dello schema deciderà il tipo di colonna TIMESTAMP in base a questo formato anziché a quello esistente. Se questo valore non è presente, il campo TIMESTAMP viene analizzato con i formati predefiniti. |
Passaggi successivi
- Per informazioni sul caricamento di dati JSON da un file locale, consulta Caricamento dei dati dai file locali.
- Per saperne di più sulla creazione, l'importazione e l'esecuzione di query sui dati JSON, consulta Utilizza i dati JSON in GoogleSQL.