


Sistemi di griglie per l'analisi spaziale
I sistemi di griglia geospaziale, come S2 e H3, ti consentono di organizzare i dati spaziali in aree geografiche standardizzate per l'analisi. La scelta del sistema di griglia multirisoluzione giusto ti consente di aggregare i dati in modo affidabile, confrontare le aree localizzate e monitorare le modifiche nel tempo senza fare affidamento su confini amministrativi incoerenti.
Panoramica e sfide dell'utilizzo dell'analisi spaziale
L'analisi spaziale aiuta a mostrare la relazione tra entità (negozi o case) ed eventi in uno spazio fisico. L'analisi spaziale che utilizza la superficie della Terra come spazio fisico è chiamata analisi geospaziale. BigQuery include funzionalità e funzioni geospaziali che ti consentono di eseguire analisi geospaziali su larga scala.
Molti casi d'uso geospaziali prevedono l'aggregazione di dati all'interno di aree localizzate e il confronto delle aggregazioni statistiche di queste aree tra loro. Queste aree localizzate sono rappresentate come poligoni in una tabella di database spaziale. In alcuni contesti, questo metodo è chiamato geografia statistica. Il metodo per determinare l'estensione delle aree geografiche deve essere standardizzato per migliorare i report, l'analisi e l'indicizzazione spaziale. Ad esempio, un rivenditore potrebbe voler analizzare i cambiamenti demografici nel tempo nelle aree in cui si trovano i suoi negozi o in quelle in cui sta valutando di aprire un nuovo negozio. In alternativa, una compagnia assicurativa potrebbe voler comprendere meglio i rischi legati alle proprietà analizzando i rischi di calamità naturali prevalenti in una determinata area.
A causa delle rigide normative sulla privacy dei dati in molte aree, i set di dati che contengono dati sulla posizione devono essere anonimizzati o parzialmente anonimizzati per proteggere la privacy delle persone rappresentate nei dati. Ad esempio, potresti dover eseguire un'analisi del rischio di concentrazione del credito geografico su un set di dati che contiene dati sui mutui ipotecari in essere. Per anonimizzare il set di dati in modo da renderlo adatto a un'analisi conforme, devi conservare le informazioni pertinenti sulla posizione delle proprietà, ma evitare di utilizzare un indirizzo specifico o le coordinate di longitudine e latitudine.
Negli esempi precedenti, i progettisti di queste analisi si trovano ad affrontare le seguenti sfide:
- Come tracciare i confini dell'area all'interno della quale analizzi le variazioni nel tempo?
- Come utilizzare i confini amministrativi esistenti, come le sezioni di censimento o un sistema di griglia multirisoluzione?
Questo documento mira a rispondere a queste domande spiegando ogni opzione, descrivendo le best practice e aiutandoti a evitare errori comuni.
Errori comuni nella scelta delle aree statistiche
I set di dati aziendali, come le vendite immobiliari, le campagne di marketing, le spedizioni di e-commerce e le polizze assicurative, sono adatti per l'analisi spaziale. Spesso questi set di dati contengono quella che sembra essere una comoda chiave di join spaziale, come una sezione di censimento, un codice postale o il nome di una città. I set di dati pubblici che contengono rappresentazioni di sezioni di censimento, codici postali e città sono facilmente disponibili, il che li rende allettanti da utilizzare come confini amministrativi per l'aggregazione statistica.
Sebbene siano apparentemente convenienti, questi e altri confini amministrativi presentano degli svantaggi. Inoltre, questi limiti potrebbero funzionare bene nelle fasi iniziali di un progetto di analisi, ma gli svantaggi possono essere notati nelle fasi successive.
Codici postali
I codici postali vengono utilizzati per l'instradamento della posta in vari paesi del mondo e, data questa ubiquità, vengono spesso utilizzati per fare riferimento a località e aree sia nei set di dati spaziali che in quelli non spaziali. Facendo riferimento all'esempio precedente sul mutuo, spesso un set di dati deve essere anonimizzato prima di poter eseguire l'analisi downstream. Poiché ogni indirizzo di proprietà contiene un codice postale, le tabelle di riferimento dei codici postali sono accessibili, il che le rende un'opzione pratica per una chiave di join per l'analisi spaziale.
Un problema nell'utilizzo dei codici postali è che non sono rappresentati come poligoni e non esiste un'unica fonte di attendibilità corretta per le aree dei codici postali. Inoltre, i codici postali non rappresentano bene il comportamento umano reale. I dati sui codici postali di uso comune negli Stati Uniti provengono dagli shapefile TIGER/Line dello US Census Bureau, che contengono un set di dati denominato ZCTA5 (Zip Code Tabulation Area). Questo set di dati rappresenta un'approssimazione dei confini dei codici postali derivati dai percorsi di consegna della posta. Tuttavia, alcuni codici postali che rappresentano singoli edifici non hanno alcun confine. Questo problema è presente anche in altri paesi, il che rende difficile formare un'unica tabella dei fatti globale che contenga un insieme autorevole di confini dei codici postali che possa essere utilizzato tra sistemi e set di dati.
Inoltre, non esiste un formato standardizzato per i codici postali utilizzato in tutto il mondo. Alcuni sono numerici, con un numero di cifre compreso tra tre e dieci, mentre altri sono alfanumerici. Esiste anche una sovrapposizione tra i paesi, il che rende necessario memorizzare il paese di origine in una colonna separata insieme al codice postale. Alcuni paesi non utilizzano i codici postali, il che complica ulteriormente l'analisi.
Sezioni di censimento, città e contee
Esistono alcune unità amministrative, come sezioni di censimento, città e contee, che non risentono della mancanza di un confine ufficiale. I confini delle città, ad esempio, sono nella maggior parte dei casi ben definiti dalle autorità governative. Le sezioni di censimento sono ben definite dallo US Census Bureau e dalle istituzioni analoghe nella maggior parte degli altri paesi.
Uno svantaggio dell'utilizzo di questi e altri confini amministrativi è che cambiano nel tempo e non sono geograficamente coerenti tra loro. Le contee e le città si fondono o si separano l'una dall'altra e, a volte, vengono rinominate. Le sezioni di censimento vengono aggiornate una volta ogni dieci anni negli Stati Uniti e in momenti diversi negli altri paesi. In alcuni casi, il confine geografico può cambiare, ma il suo identificatore univoco rimane lo stesso, il che rende difficile analizzare e comprendere i cambiamenti nel tempo.
Un altro svantaggio comune ad alcuni confini amministrativi è che si tratta di aree distinte senza gerarchia geografica. Oltre a confrontare singole aree tra loro, un requisito comune è confrontare le aggregazioni delle aree stesse con altre aggregazioni. Ad esempio, un rivenditore che implementa il modello di Huff potrebbe voler eseguire questa analisi utilizzando più distanze, che potrebbero non corrispondere alle aree amministrative utilizzate altrove nell'attività.
Griglie a risoluzione singola e multipla
Le griglie a risoluzione singola sono costituite da unità discrete che non hanno alcuna relazione geografica con aree più grandi che contengono queste unità. Ad esempio, i codici postali hanno una relazione geografica incoerente con i confini di unità amministrative più grandi, come città o contee che potrebbero contenere codici postali. Per l'analisi spaziale, è importante capire in che modo le diverse aree sono correlate tra loro senza una conoscenza approfondita della storia e della legislazione che definisce il poligono dell'area.
Le griglie multirisoluzione sono talvolta chiamate griglie gerarchiche perché le celle di ogni livello di zoom sono suddivise in celle più piccole a livelli di zoom più elevati. Le griglie multirisoluzione sono costituite da una gerarchia ben definita di unità contenute all'interno di unità più grandi. Ad esempio, le sezioni di censimento contengono gruppi di isolati, che a loro volta contengono isolati. Questa relazione gerarchica coerente può essere utile per l'aggregazione statistica. Ad esempio, calcolando la media dei redditi di tutti i gruppi di isolati contenuti in una sezione, puoi mostrare il reddito medio per la sezione di censimento contenente i gruppi di isolati. Questo non sarebbe possibile con i codici postali, perché tutte le aree postali si trovano a un'unica risoluzione. Sarebbe difficile confrontare il reddito di un'area con quello delle aree circostanti, poiché non esiste un modo standardizzato per definire l'adiacenza o per confrontare il reddito in paesi diversi.
Sistemi di griglia S2 e H3
Questa sezione fornisce una panoramica dei sistemi di griglia S2 e H3.
S2
La geometria S2 è un sistema di griglia gerarchica open source sviluppato da Google e rilasciato al pubblico nel 2011. Puoi utilizzare il sistema di griglia S2 per organizzare e indicizzare i dati spaziali assegnando un numero intero univoco a 64 bit a ogni cella. Esistono 31 livelli di risoluzione. Ogni cella è rappresentata come un quadrato ed è progettata per operazioni su geometrie sferiche (a volte chiamate geografie). Ogni quadrato è suddiviso in quattro quadrati più piccoli. L'attraversamento dei vicini, ovvero la capacità di identificare le celle S2 vicine, è meno ben definito perché i quadrati possono avere quattro o otto vicini pertinenti a seconda del tipo di analisi. Di seguito è riportato un esempio di celle della griglia S2 con più risoluzioni:
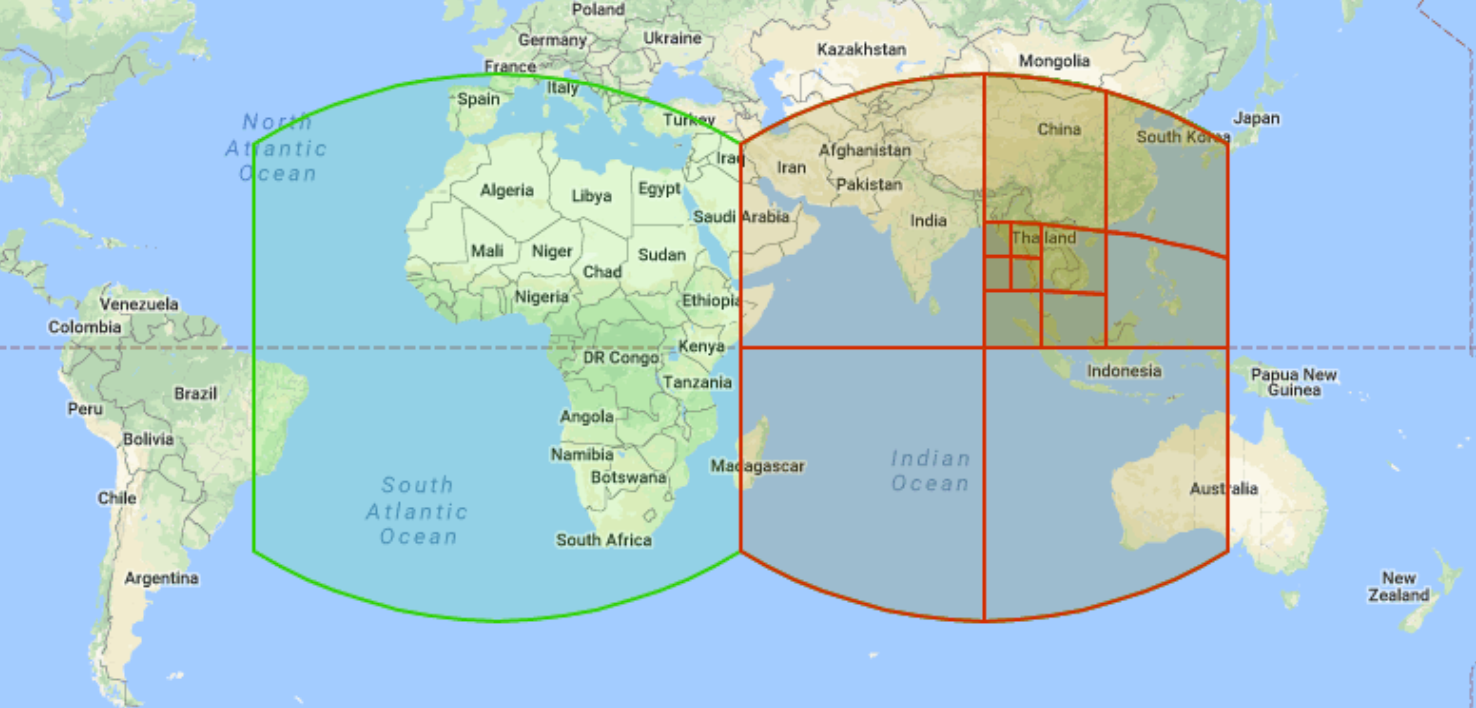
BigQuery utilizza le celle S2 per indicizzare i dati spaziali ed espone più funzioni. Ad esempio, S2_CELLIDFROMPOINT restituisce l'ID cella S2 che contiene un punto sulla superficie terrestre a un determinato livello.
H3
H3 è un sistema di griglia gerarchica open source sviluppato da Uber e utilizzato da Overture Maps. Esistono 16 livelli di risoluzione. Ogni cella è rappresentata come un esagono e, come per S2, a ogni cella viene assegnato un numero intero univoco a 64 bit. Nell'esempio relativo alla visualizzazione delle celle H3 che coprono il Golfo del Messico, le celle H3 più piccole non sono perfettamente contenute in quelle più grandi.
Ogni cella si suddivide in sette esagoni più piccoli. La suddivisione non è esatta, ma è adeguata per molti casi d'uso. Ogni cella condivide un bordo con sei celle adiacenti, semplificando l'attraversamento delle celle adiacenti. Ad esempio, a ogni livello ci sono 12 pentagoni, che condividono un bordo con cinque vicini anziché sei. Sebbene H3 non sia supportato in BigQuery, puoi aggiungere il supporto di H3 a BigQuery utilizzando Carto Analytics Toolbox for BigQuery.
Sebbene entrambe le librerie S2 e H3 siano open source e disponibili con la licenza Apache 2, la libreria H3 ha una documentazione più dettagliata.
HEALPix
Un altro schema per suddividere la sfera in una griglia, di uso comune nel campo dell'astronomia, è noto come HEALPix (Hierarchical Equal Area isoLatitude Pixelation). HEALPix è indipendente dalla profondità dei pixel gerarchica, ma il tempo di calcolo rimane costante.
HEALPix è uno schema di pixelizzazione gerarchica ad area equivalente per la sfera. Viene utilizzato per rappresentare e analizzare i dati sulla sfera celeste (o su un'altra sfera). Oltre al tempo di calcolo costante, la griglia HEALPix ha le seguenti caratteristiche:
- Le celle della griglia sono gerarchiche e mantengono le relazioni principale-secondario.
- A una gerarchia specifica, le celle hanno aree uguali.
- Le celle seguono una distribuzione a isolatitudine, consentendo prestazioni più elevate per i metodi spettrali.
BigQuery non supporta HEALPix, ma esistono numerose implementazioni in vari linguaggi, tra cui JavaScript, il che lo rende comodo per l'utilizzo nelle funzioni definite dall'utente (UDF) di BigQuery.
Esempi di casi d'uso per ogni strategia di indicizzazione
Questa sezione fornisce alcuni esempi che ti aiutano a valutare qual è il sistema di griglia migliore per il tuo caso d'uso.
Molti casi d'uso di analisi e reportistica prevedono la visualizzazione, nell'ambito dell'analisi stessa o per la reportistica agli stakeholder aziendali. Queste visualizzazioni vengono comunemente presentate in Web Mercator, che è la proiezione planare utilizzata da Google Maps e da molte altre applicazioni di mappatura web. Nei casi in cui la visualizzazione svolge un ruolo fondamentale, le celle H3 offrono un'esperienza di visualizzazione soggettivamente migliore. Le celle S2, soprattutto alle latitudini più elevate, tendono ad apparire più distorte rispetto alle celle H3 e non sembrano coerenti con le celle delle latitudini più basse se presentate in una proiezione planare.
Le celle H3 semplificano l'implementazione quando il confronto con i vicini svolge un ruolo importante nell'analisi. Ad esempio, un'analisi comparativa tra le sezioni di una città potrebbe aiutare a decidere quale località è adatta per l'apertura di un nuovo negozio di vendita al dettaglio o di un centro di distribuzione. L'analisi richiede calcoli statistici per gli attributi di una determinata cella che viene confrontata con le celle adiacenti.
Le celle S2 possono funzionare meglio nelle analisi di natura globale, ad esempio quelle che prevedono misurazioni di distanze e angoli. Pokémon Go di Niantic utilizza le celle S2 per determinare dove vengono posizionati gli asset di gioco e come vengono distribuiti. La proprietà di suddivisione esatta delle celle S2 garantisce che gli asset di gioco possano essere distribuiti in modo uniforme in tutto il mondo.
Passaggi successivi
- Per le best practice per il clustering spaziale, consulta Clustering spaziale su BigQuery - Best practice.
- Scopri come creare una gerarchia spaziale da dati imperfetti.
- Scopri di più sulla geometria S2 su GitHub.
- Scopri di più sulla geometria H3 su GitHub.
- Guarda gli esempi che utilizzano H3, BigQuery ed Earth Engine.