


Gerar texto usando a função AI.GENERATE_TEXT
Neste documento, mostramos como criar um modelo remoto do BigQuery ML que representa um modelo da Gemini Enterprise Agent Platform e, em seguida, usar esse modelo remoto com a função AI.GENERATE_TEXT para gerar texto.
Os seguintes tipos de modelos remotos são compatíveis:
- Modelos remotos em qualquer um dos modelos do Gemini com disponibilidade geral ou em pré-lançamento.
- Modelos remotos em modelos do Anthropic Claude.
- Modelos remotos em modelos Llama
- Modelos remotos sobre modelos de IA da Mistral
- Modelos remotos em modelos abertos compatíveis.
Dependendo do modelo da plataforma de agentes escolhido, é possível gerar texto com base em dados não estruturados de tabelas de objetos ou em texto de tabelas padrão.
Funções exigidas
Para criar um modelo remoto e gerar texto, você precisa dos seguintes papéis do Identity and Access Management (IAM):
- Criar e usar conjuntos de dados, tabelas e modelos do BigQuery:
Editor de dados do BigQuery (
roles/bigquery.dataEditor) no projeto. Criar, delegar e usar conexões do BigQuery: administrador de conexões do BigQuery (
roles/bigquery.connectionsAdmin) no seu projeto.Se você não tiver uma conexão padrão configurada, crie e defina uma como parte da execução da instrução
CREATE MODEL. Para fazer isso, é preciso ter o papel de administrador do BigQuery (roles/bigquery.admin) no projeto. Para mais informações, consulte Configurar a conexão padrão.Conceda permissões à conta de serviço da conexão: administrador do IAM do projeto (
roles/resourcemanager.projectIamAdmin) no projeto que contém o endpoint da Gemini Enterprise Agent Platform. Este é o projeto atual para modelos remotos criados especificando o nome do modelo como um endpoint. Esse é o projeto identificado no URL para modelos remotos que você cria especificando um URL como um endpoint.Se você usar o modelo remoto para analisar dados não estruturados de uma tabela de objetos, e o bucket do Cloud Storage usado na tabela de objetos estiver em um projeto diferente do endpoint da plataforma de agentes, também será necessário ter o papel de Administrador do Storage (
roles/storage.admin) no bucket do Cloud Storage usado pela tabela de objetos.Criar jobs do BigQuery: usuário de jobs do BigQuery (
roles/bigquery.jobUser) no projeto.
Esses papéis predefinidos contêm as permissões necessárias para executar as tarefas neste documento. Para acessar as permissões exatas necessárias, expanda a seção Permissões necessárias:
Permissões necessárias
- Crie um conjunto de dados:
bigquery.datasets.create - Criar, delegar e usar uma conexão:
bigquery.connections.* - Defina as permissões da conta de serviço:
resourcemanager.projects.getIamPolicyeresourcemanager.projects.setIamPolicy - Crie um modelo e execute a inferência:
bigquery.jobs.createbigquery.models.createbigquery.models.getDatabigquery.models.updateDatabigquery.models.updateMetadata
Essas permissões também podem ser concedidas com papéis personalizados ou outros papéis predefinidos.
Antes de começar
-
No console do Google Cloud , na página do seletor de projetos, selecione ou crie um projeto do Google Cloud .
Papéis necessários para selecionar ou criar um projeto
- Selecionar um projeto: para selecionar um projeto, não é necessário ter um papel do IAM específico. É possível selecionar qualquer projeto em que você tenha um papel.
-
Criar um projeto: para criar um projeto, é preciso ter o papel de Criador de projetos
(
roles/resourcemanager.projectCreator), que contém a permissãoresourcemanager.projects.create. Saiba como conceder papéis.
-
Verifique se o faturamento está ativado para o projeto do Google Cloud .
-
Ative as APIs BigQuery, BigQuery Connection e Agent Platform, se ainda não estiverem ativadas.
Funções necessárias para ativar APIs
Para ativar APIs, você precisa da permissão
serviceusage.services.enable. Se você criou o projeto, provavelmente já tem essa permissão pelo papel de proprietário (roles/owner). Caso contrário, é possível conseguir essa permissão pelo papel de administrador do Service Usage (roles/serviceusage.serviceUsageAdmin). Saiba como conceder papéis.
Criar um conjunto de dados
Crie um conjunto de dados do BigQuery para conter seus recursos:
Console
No console do Google Cloud , acesse a página BigQuery.
No painel à esquerda, clique em Explorer:
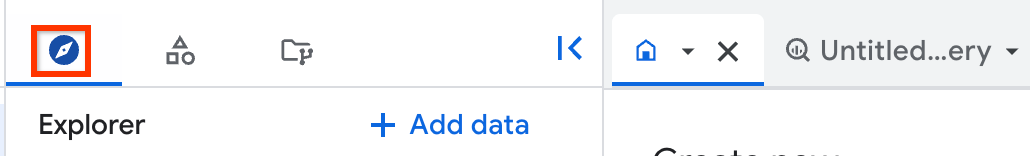
Se o painel esquerdo não aparecer, clique em Expandir painel esquerdo para abrir.
No painel Explorer, clique no nome do seu projeto.
Clique em Conferir ações > Criar conjunto de dados.
Na página Criar conjunto de dados, faça o seguinte:
Em ID do conjunto de dados, digite um nome para o conjunto de dados.
Em Tipo de local, selecione Região ou Multirregional.
- Se você selecionou Região, escolha um local na lista Região.
- Se você selecionou Multirregional, selecione EUA ou Europa na lista Multirregional.
Clique em Criar conjunto de dados.
bq
Crie uma conexão
Crie uma conexão a recursos do Cloud para o modelo remoto usar e tenha acesso à conta de serviço da conexão. Crie a conexão no mesmo local do conjunto de dados criado na etapa anterior.
Pule esta etapa se você tiver uma conexão padrão configurada ou o papel de administrador do BigQuery.
Selecione uma das seguintes opções:Console
Acessar a página do BigQuery.
No painel à esquerda, clique em Explorer:
Se o painel esquerdo não aparecer, clique em Expandir painel esquerdo para abrir.
No painel Explorer, expanda o nome do projeto e clique em Conexões.
Na página Conexões, clique em Criar conexão.
Em Tipo de conexão, escolha Modelos remotos da Vertex AI, funções remotas, BigLake e Spanner (recurso do Cloud).
No campo ID da conexão, insira um nome para a conexão.
Em Tipo de local, selecione um local para a conexão. A conexão precisa estar no mesmo local que os outros recursos, como conjuntos de dados.
Clique em Criar conexão.
Clique em Ir para conexão.
No painel Informações da conexão, copie o ID da conta de serviço para uso em uma etapa posterior.
SQL
Use a instrução CREATE CONNECTION:
No console do Google Cloud , acesse a página BigQuery.
No editor de consultas, digite a seguinte instrução:
CREATE CONNECTION [IF NOT EXISTS] `CONNECTION_NAME`
OPTIONS (
  connection_type = "CLOUD_RESOURCE",
  friendly_name = "FRIENDLY_NAME",
  description = "DESCRIPTION"
  );
Substitua:
-
CONNECTION_NAME: o nome da conexão no formatoPROJECT_ID.LOCATION.CONNECTION_ID,LOCATION.CONNECTION_IDouCONNECTION_ID. Se o projeto ou o local forem omitidos, eles serão inferidos do projeto e do local em que a instrução é executada. -
FRIENDLY_NAME(opcional): um nome descritivo para a conexão. -
DESCRIPTION(opcional): uma descrição da conexão.
-
Clique em Executar.
Para mais informações sobre como executar consultas, acesse Executar uma consulta interativa.
bq
Em um ambiente de linha de comando, crie uma conexão:
bq mk --connection --location=REGION --project_id=PROJECT_ID \
    --connection_type=CLOUD_RESOURCE CONNECTION_ID
O parâmetro
--project_idsubstitui o projeto padrão.Substitua:
REGION: sua região de conexãoPROJECT_ID: o ID do projeto do Google Cloud .CONNECTION_ID: um ID para sua conexão
Quando você cria um recurso de conexão, o BigQuery cria uma conta de serviço do sistema exclusiva e a associa à conexão.
Solução de problemas: se você receber o seguinte erro de conexão, atualize o SDK Google Cloud:
Flags parsing error: flag --connection_type=CLOUD_RESOURCE: value should be one of...
Recupere e copie o ID da conta de serviço para uso em uma etapa posterior:
bq show --connection PROJECT_ID.REGION.CONNECTION_ID
O resultado será o seguinte:
name                          properties
1234.REGION.CONNECTION_ID     {"serviceAccountId": "connection-1234-9u56h9@gcp-sa-bigquery-condel.iam.gserviceaccount.com"}
Python
Antes de testar esta amostra, siga as instruções de configuração do Python no Guia de início rápido do BigQuery: como usar bibliotecas de cliente. Para mais informações, consulte a documentação de referência da API BigQuery em Python.
Para autenticar no BigQuery, configure o Application Default Credentials. Para mais informações, acesse Configurar a autenticação para bibliotecas de cliente.
Node.js
Antes de testar esta amostra, siga as instruções de configuração do Node.js no Guia de início rápido do BigQuery: como usar bibliotecas de cliente. Para mais informações, consulte a documentação de referência da API BigQuery em Node.js.
Para autenticar no BigQuery, configure o Application Default Credentials. Para mais informações, acesse Configurar a autenticação para bibliotecas de cliente.
Java
Antes de testar esta amostra, siga as instruções de configuração do Java no Guia de início rápido do BigQuery: como usar bibliotecas de cliente. Para mais informações, consulte a documentação de referência da API BigQuery em Java.
Para autenticar no BigQuery, configure o Application Default Credentials. Para mais informações, acesse Configurar a autenticação para bibliotecas de cliente.
Terraform
Use o
recurso
google_bigquery_connection.
Para autenticar no BigQuery, configure o Application Default Credentials. Para mais informações, acesse Configurar a autenticação para bibliotecas de cliente.
O exemplo a seguir cria uma conexão a recursos do Cloud chamada
my_cloud_resource_connection na região US:
Para aplicar a configuração do Terraform em um projeto do Google Cloud , conclua as etapas nas seções a seguir.
Preparar o Cloud Shell
- Inicie o Cloud Shell.
-
Defina o projeto padrão do Google Cloud em que você quer aplicar as configurações do Terraform.
Você só precisa executar esse comando uma vez por projeto, e ele pode ser executado em qualquer diretório.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
As variáveis de ambiente serão substituídas se você definir valores explícitos no arquivo de configuração do Terraform.
Preparar o diretório
Cada arquivo de configuração do Terraform precisa ter o próprio diretório, também chamado de módulo raiz.
-
No Cloud Shell, crie um diretório e um novo
arquivo dentro dele. O nome do arquivo precisa ter a extensão
.tf, por exemplo,main.tf. Neste tutorial, o arquivo é chamado demain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
Se você estiver seguindo um tutorial, poderá copiar o exemplo de código em cada seção ou etapa.
Copie o exemplo de código no
main.tfrecém-criado.Se preferir, copie o código do GitHub. Isso é recomendado quando o snippet do Terraform faz parte de uma solução de ponta a ponta.
- Revise e modifique os parâmetros de amostra para aplicar ao seu ambiente.
- Salve as alterações.
-
Inicialize o Terraform. Você só precisa fazer isso uma vez por diretório.
terraform init
Opcionalmente, para usar a versão mais recente do provedor do Google, inclua a opção
-upgrade:terraform init -upgrade
Aplique as alterações
-
Revise a configuração e verifique se os recursos que o Terraform vai criar ou
atualizar correspondem às suas expectativas:
terraform plan
Faça as correções necessárias na configuração.
-
Para aplicar a configuração do Terraform, execute o comando a seguir e digite
yesno prompt:terraform apply
Aguarde até que o Terraform exiba a mensagem "Apply complete!".
- Abra seu projeto do Google Cloud para ver os resultados. No console do Google Cloud , navegue até seus recursos na UI para verificar se foram criados ou atualizados pelo Terraform.
Conceder um papel à conta de serviço da conexão do modelo remoto
É preciso conceder o papel de usuário da Agent Platform à conta de serviço da conexão que o modelo remoto usa.
Se você planeja especificar o endpoint do modelo remoto como um URL,
por exemplo, endpoint = 'https://us-central1-aiplatform.googleapis.com/v1/projects/myproject/locations/us-central1/publishers/google/models/gemini-2.0-flash',
conceda esse papel no mesmo projeto especificado no URL.
Se você planeja especificar o endpoint do modelo remoto usando o nome do modelo,
por exemplo, endpoint = 'gemini-2.0-flash', conceda esse papel
no mesmo projeto em que planeja criar o modelo remoto.
Conceder o papel em um projeto diferente resulta no erro bqcx-1234567890-wxyz@gcp-sa-bigquery-condel.iam.gserviceaccount.com does not have the permission to access resource.
Para conceder o papel de usuário da Agent Platform, siga estas etapas:
Console
Acesse a página IAM e administrador.
Clique em Adicionar.
A caixa de diálogo Adicionar principais é aberta.
No campo Novos principais, digite o ID da conta de serviço que você copiou anteriormente.
No campo Selecionar um papel, pesquise Usuário da Agent Platform.
Clique em Salvar.
gcloud
Use o comando gcloud projects add-iam-policy-binding.
gcloud projects add-iam-policy-binding 'PROJECT_NUMBER' --member='serviceAccount:MEMBER' --role='roles/aiplatform.user' --condition=None
Substitua:
PROJECT_NUMBER: o ID do seu projetoMEMBER: o ID da conta de serviço que você copiou anteriormente
Conceder um papel à conta de serviço da conexão da tabela de objetos
Se você estiver usando o modelo remoto para gerar texto com base em dados de tabelas de objetos, conceda à conta de serviço da conexão da tabela de objetos o papel de Usuário da Agent Platform no mesmo projeto em que planeja criar o modelo remoto. Caso contrário, pule esta etapa.
Para encontrar a conta de serviço da conexão da tabela de objetos, siga estas etapas:
Acessar a página do BigQuery.
No painel à esquerda, clique em Explorer:
Se o painel esquerdo não aparecer, clique em Expandir painel esquerdo para abrir.
No painel Explorer, clique em Conjuntos de dados e selecione um conjunto de dados que contenha a tabela de objetos.
Clique em Visão geral > Tabelas e selecione a tabela de objetos.
No painel do editor, clique na guia Detalhes.
Anote o nome da conexão no campo ID da conexão.
No painel Explorer, clique em Conexões.
Selecione a conexão que corresponde à do campo ID da conexão da tabela de objetos.
Copie o valor no campo ID da conta de serviço.
Para conceder o papel, siga estas etapas:
Console
Acesse a página IAM e administrador.
Clique em Adicionar.
A caixa de diálogo Adicionar principais é aberta.
No campo Novos principais, digite o ID da conta de serviço que você copiou anteriormente.
No campo Selecionar um papel, pesquise Usuário da Agent Platform.
Clique em Salvar.
gcloud
Use o comando gcloud projects add-iam-policy-binding.
gcloud projects add-iam-policy-binding 'PROJECT_NUMBER' --member='serviceAccount:MEMBER' --role='roles/aiplatform.user' --condition=None
Substitua:
PROJECT_NUMBER: o ID do seu projetoMEMBER: o ID da conta de serviço que você copiou anteriormente
Ativar um modelo de parceiro
Esta etapa só é necessária se você quiser usar os modelos de IA Claude, Llama ou Mistral da Anthropic.
No console do Google Cloud , acesse a página Model Garden da plataforma de agentes.
Pesquise ou procure o modelo de parceiro que você quer usar.
Clique no card de modelo.
Na página do modelo, clique em Ativar.
Preencha as informações de ativação solicitadas e clique em Avançar.
Na seção Termos e condições, marque a caixa de seleção.
Clique em Concordar para aceitar os Termos e Condições e ativar o modelo.
Escolher um método de implantação de modelo aberto
Se você estiver criando um modelo remoto com base em um
modelo aberto compatível,
poderá implantar automaticamente o modelo aberto ao mesmo tempo em que
cria o modelo remoto especificando o ID do modelo do Model Garden da Agent Platform
ou do Hugging Face na instrução CREATE MODEL.
Como alternativa, é possível implantar manualmente o modelo aberto primeiro e, em seguida, usá-lo com o modelo remoto especificando o endpoint do modelo na instrução CREATE MODEL. Para mais informações, consulte
Implantar modelos abertos.
Criar um modelo remoto do BigQuery ML
Crie um modelo remoto:
Modelos da Agent Platform
No console do Google Cloud , acesse a página BigQuery.
Usando o editor de SQL, crie um modelo remoto:
CREATE OR REPLACE MODEL
`PROJECT_ID.DATASET_ID.MODEL_NAME`
REMOTE WITH CONNECTION {DEFAULT | `PROJECT_ID.REGION.CONNECTION_ID`}
OPTIONS (ENDPOINT = 'ENDPOINT');
Substitua:
PROJECT_ID: o ID do projeto.DATASET_ID: o ID do conjunto de dados para conter o modelo. Esse conjunto de dados precisa estar no mesmo local que a conexão que você está usando.MODEL_NAME: o nome do modeloREGION: a região usada pela conexão.CONNECTION_ID: o ID da conexão do BigQueryPara conseguir esse valor, acesse os detalhes da conexão no console do Google Cloud e copie o valor na última seção do ID da conexão totalmente qualificado, mostrado em ID da conexão. Por exemplo:
projects/myproject/locations/connection_location/connections/myconnection.ENDPOINT: o endpoint do modelo da Agent Platform a ser usado.Para modelos de IA pré-treinados da Agent Platform, modelos Claude e modelos Mistral AI, especifique o nome do modelo. Em alguns desses modelos, é possível especificar uma versão específica como parte do nome. Para os modelos do Gemini compatíveis, é possível especificar o endpoint global para melhorar a disponibilidade.
Para modelos Llama, especifique um endpoint da API OpenAI no formato
openapi/<publisher_name>/<model_name>. Por exemplo,openapi/meta/llama-3.1-405b-instruct-maas.Para mais informações sobre os nomes e as versões de modelos compatíveis, consulte
ENDPOINT.O modelo da Agent Platform especificado precisa estar disponível no local em que você está criando o modelo remoto. Veja mais informações em Locais.
Novos modelos abertos
No console do Google Cloud , acesse a página BigQuery.
Usando o editor de SQL, crie um modelo remoto:
CREATE OR REPLACE MODEL
`PROJECT_ID.DATASET_ID.MODEL_NAME`
REMOTE WITH CONNECTION {DEFAULT | `PROJECT_ID.REGION.CONNECTION_ID`}
OPTIONS (
  {HUGGING_FACE_MODEL_ID = 'HUGGING_FACE_MODEL_ID' |
     MODEL_GARDEN_MODEL_NAME = 'MODEL_GARDEN_MODEL_NAME'}
  [, HUGGING_FACE_TOKEN = 'HUGGING_FACE_TOKEN' ]
  [, MACHINE_TYPE = 'MACHINE_TYPE' ]
  [, MIN_REPLICA_COUNT = MIN_REPLICA_COUNT ]
  [, MAX_REPLICA_COUNT = MAX_REPLICA_COUNT ]
  [, RESERVATION_AFFINITY_TYPE = {'NO_RESERVATION' | 'ANY_RESERVATION' | 'SPECIFIC_RESERVATION'} ]
  [, RESERVATION_AFFINITY_KEY = 'compute.googleapis.com/reservation-name' ]
  [, RESERVATION_AFFINITY_VALUES = RESERVATION_AFFINITY_VALUES ]
  [, ENDPOINT_IDLE_TTL = ENDPOINT_IDLE_TTL ]
);
Substitua:
PROJECT_ID: o ID do projeto.DATASET_ID: o ID do conjunto de dados para conter o modelo. Esse conjunto de dados precisa estar no mesmo local que a conexão que você está usando.MODEL_NAME: o nome do modeloREGION: a região usada pela conexão.CONNECTION_ID: o ID da conexão do BigQueryPara conseguir esse valor, acesse os detalhes da conexão no console do Google Cloud e copie o valor na última seção do ID da conexão totalmente qualificado, mostrado em ID da conexão. Por exemplo:
projects/myproject/locations/connection_location/connections/myconnection.HUGGING_FACE_MODEL_ID: um valorSTRINGque especifica o ID de um modelo compatível do Hugging Face, no formatoprovider_name/model_name. Por exemplo,deepseek-ai/DeepSeek-R1. Para encontrar o ID do modelo, clique no nome dele no Hub de modelos do Hugging Face e copie o ID na parte de cima do card do modelo.MODEL_GARDEN_MODEL_NAME: um valorSTRINGque especifica o ID e a versão de um modelo compatível do Model Garden da Gemini Enterprise Agent Platform, no formatopublishers/publisher/models/model_name@model_version. Exemplo:publishers/openai/models/gpt-oss@gpt-oss-120b. Para encontrar o ID do modelo, clique no card do modelo no Model Garden da Agent Platform e copie o ID do campo ID do modelo. Para acessar a versão padrão do modelo, copie-a do campo Versão no card do modelo. Para ver outras versões de modelo que podem ser usadas, clique em Implantar modelo e, em seguida, no campo ID do recurso.HUGGING_FACE_TOKEN: um valorSTRINGque especifica o token de acesso de usuário do Hugging Face a ser usado. Só é possível especificar um valor para essa opção se você também especificar um valor para a opçãoHUGGING_FACE_MODEL_ID.O token precisa ter pelo menos o papel
read, mas tokens com um escopo mais amplo também são aceitáveis. Essa opção é obrigatória quando o modelo identificado pelo valorHUGGING_FACE_MODEL_IDé um modelo restrito ou privado do Hugging Face.Alguns modelos restritos exigem que você concorde explicitamente com os Termos de Serviço antes de receber acesso. Para aceitar esses termos, siga estas etapas:
- Acesse a página do modelo no site do Hugging Face.
- Localize e leia os Termos de Serviço do modelo. Um link para o contrato de serviço geralmente é encontrado no card de modelo.
- Aceite os termos conforme solicitado na página.
MACHINE_TYPE: um valorSTRINGque especifica o tipo de máquina a ser usado ao implantar o modelo na Agent Platform. Para informações sobre os tipos de máquina compatíveis, consulte Tipos de máquina. Se você não especificar um valor para a opçãoMACHINE_TYPE, será usado o tipo de máquina padrão do Model Garden da plataforma de agente para o modelo.MIN_REPLICA_COUNT: um valorINT64que especifica o número mínimo de réplicas de máquina usadas ao implantar o modelo em um endpoint da plataforma de agentes. O serviço aumenta ou diminui a contagem de réplicas conforme exigido pela carga de inferência no endpoint. O número de réplicas usadas nunca é menor que o valor deMIN_REPLICA_COUNTe nunca maior que o valor deMAX_REPLICA_COUNT. O valorMIN_REPLICA_COUNTprecisa estar no intervalo[1, 4096]. O valor padrão é1.MAX_REPLICA_COUNT: um valorINT64que especifica o número máximo de réplicas de máquina usadas ao implantar o modelo em um endpoint da plataforma de agentes. O serviço aumenta ou diminui a contagem de réplicas conforme exigido pela carga de inferência no endpoint. O número de réplicas usadas nunca é menor que o valor deMIN_REPLICA_COUNTe nunca maior que o valor deMAX_REPLICA_COUNT. O valorMAX_REPLICA_COUNTprecisa estar no intervalo[1, 4096]. O valor padrão é o valorMIN_REPLICA_COUNT.RESERVATION_AFFINITY_TYPE: determina se o modelo implantado usa reservas do Compute Engine para garantir a disponibilidade da máquina virtual (VM) ao exibir previsões e especifica se o modelo usa VMs de todas as reservas disponíveis ou apenas de uma reserva específica. Para mais informações, consulte Afinidade de reserva do Compute Engine.Só é possível usar as reservas do Compute Engine que são compartilhadas com a Agent Platform. Para mais informações, consulte Permitir que uma reserva seja consumida.
Os valores compatíveis são os seguintes:
NO_RESERVATION: nenhuma reserva é consumida quando o modelo é implantado em um endpoint da Agent Platform. EspecificarNO_RESERVATIONtem o mesmo efeito que não especificar uma afinidade de reserva.ANY_RESERVATION: a implantação do modelo da Agent Platform consome máquinas virtuais (VMs) de reservas do Compute Engine que estão no projeto atual ou que são compartilhadas com o projeto e que estão configuradas para consumo automático. Somente as VMs que atendem às seguintes qualificações são usadas:- Eles usam o tipo de máquina especificado pelo
valor
MACHINE_TYPE. - Se o conjunto de dados do BigQuery em que você está criando o
modelo remoto for uma única região, a reserva precisará estar na
mesma região. Se o conjunto de dados
estiver na multirregião
US, a reserva precisará estar na regiãous-central1. Se o conjunto de dados estiver na multirregiãoEU, a reserva precisará estar na regiãoeurope-west4.
Se não houver capacidade suficiente nas reservas disponíveis ou se nenhuma reserva adequada for encontrada, o sistema provisionará VMs do Compute Engine on demand para atender aos requisitos de recursos.
- Eles usam o tipo de máquina especificado pelo
valor
SPECIFIC_RESERVATION: a implantação do modelo da Agent Platform consome VMs apenas da reserva especificada no valorRESERVATION_AFFINITY_VALUES. Essa reserva precisa ser configurada para consumo segmentado especificamente. A implantação falhará se a reserva especificada não tiver capacidade suficiente.
RESERVATION_AFFINITY_KEY: a stringcompute.googleapis.com/reservation-name. É necessário especificar essa opção quando o valor deRESERVATION_AFFINITY_TYPEforSPECIFIC_RESERVATION.RESERVATION_AFFINITY_VALUES: um valorARRAY<STRING>que especifica o nome completo do recurso da reserva do Compute Engine, no seguinte formato:
projects/myproject/zones/reservation_zone/reservations/reservation_namePor exemplo,
RESERVATION_AFFINITY_values = ['projects/myProject/zones/us-central1-a/reservations/myReservationName'].É possível conferir o nome e a zona da reserva na página Reservas do console do Google Cloud . Para mais informações, consulte Ver reservas.
É necessário especificar essa opção quando o valor de
RESERVATION_AFFINITY_TYPEforSPECIFIC_RESERVATION.ENDPOINT_IDLE_TTL: um valorINTERVALque especifica a duração da inatividade após a qual o modelo aberto é automaticamente removido do endpoint da Agent Platform.Para ativar o cancelamento automático da implantação, especifique um valor de literal de intervalo entre 390 minutos (6,5 horas) e 7 dias. Por exemplo, especifique
INTERVAL 8 HOURpara que o modelo seja removido após 8 horas de inatividade. O valor padrão é 390 minutos (6,5 horas).A inatividade do modelo é definida como o tempo decorrido desde que qualquer uma das seguintes operações foi realizada no modelo:
- Executar a
instrução
CREATE MODEL. - Executar a
instrução
ALTER MODELcom o argumentoDEPLOY_MODELdefinido comoTRUE. - Enviar uma solicitação de inferência ao endpoint do modelo. Por exemplo, executando a função
AI.GENERATE_EMBEDDINGouAI.GENERATE_TEXT.
Cada uma dessas operações redefine o timer de inatividade para zero. A redefinição é acionada no início do job do BigQuery que executa a operação.
Depois que a implantação do modelo é cancelada, as solicitações de inferência enviadas a ele retornam um erro. O objeto do modelo do BigQuery permanece inalterado, incluindo os metadados do modelo. Para usar o modelo para inferência novamente, é necessário reimplantá-lo executando a instrução
ALTER MODELno modelo e definindo a opçãoDEPLOY_MODELcomoTRUE.- Executar a
instrução
Modelos abertos implantados
No console do Google Cloud , acesse a página BigQuery.
Usando o editor de SQL, crie um modelo remoto:
CREATE OR REPLACE MODEL
`PROJECT_ID.DATASET_ID.MODEL_NAME`
REMOTE WITH CONNECTION {DEFAULT | `PROJECT_ID.REGION.CONNECTION_ID`}
OPTIONS (
  ENDPOINT = 'https://ENDPOINT_REGION-aiplatform.googleapis.com/v1/projects/ENDPOINT_PROJECT_ID/locations/ENDPOINT_REGION/endpoints/ENDPOINT_ID'
);
Substitua:
PROJECT_ID: o ID do projeto.DATASET_ID: o ID do conjunto de dados para conter o modelo. Esse conjunto de dados precisa estar no mesmo local que a conexão que você está usando.MODEL_NAME: o nome do modeloREGION: a região usada pela conexão.CONNECTION_ID: o ID da conexão do BigQueryPara conseguir esse valor, acesse os detalhes da conexão no console do Google Cloud e copie o valor na última seção do ID da conexão totalmente qualificado, mostrado em ID da conexão. Por exemplo:
projects/myproject/locations/connection_location/connections/myconnection.ENDPOINT_REGION: a região em que o modelo aberto está implantado.ENDPOINT_PROJECT_ID: o projeto em que o modelo aberto está implantado.ENDPOINT_ID: o ID do endpoint HTTPS usado pelo modelo aberto. Para conseguir o ID do endpoint, localize o modelo aberto na página Previsão on-line e copie o valor no campo ID.
Gerar texto usando dados de tabelas padrão
Gere texto usando a
função AI.GENERATE_TEXT
com dados de comando de uma tabela padrão:
Gemini
SELECT *
FROM AI.GENERATE_TEXT(
  MODEL `PROJECT_ID.DATASET_ID.MODEL_NAME`,
  {TABLE PROJECT_ID.DATASET_ID.TABLE_NAME | (PROMPT_QUERY)},
  STRUCT(
  {
    {
      [MAX_OUTPUT_TOKENS AS max_output_tokens]
      [, TOP_P AS top_p]
      [, TEMPERATURE AS temperature]
      [, STOP_SEQUENCES AS stop_sequences]
      [, GROUND_WITH_GOOGLE_SEARCH AS ground_with_google_search]
      [, SAFETY_SETTINGS AS safety_settings]
    }
    |
    [, MODEL_PARAMS AS model_params]
  }
  [, REQUEST_TYPE AS request_type])
);
Substitua:
PROJECT_ID: o ID do projeto.DATASET_ID: o ID do conjunto de dados que contém o modelo.MODEL_NAME: o nome do modeloTABLE_NAME: o nome da tabela que contém o comando. Essa tabela precisa ter uma tabela chamadapromptou é possível utilizar um alias para usar uma coluna com um nome diferente.PROMPT_QUERY: uma consulta que fornece os dados do comando. Essa consulta precisa produzir uma coluna chamadaprompt.TOKENS: um valorINT64que define o número máximo de tokens que podem ser gerados na resposta. Esse valor deve estar no intervalo[1,8192]. Especifique um valor mais baixo para respostas mais curtas e um valor mais alto para respostas mais longas. O padrão é128.TEMPERATURE: um valorFLOAT64no intervalo[0.0,1.0]que controla o grau de aleatoriedade na seleção de token. O padrão é0.Valores mais baixos para
temperaturesão bons para comandos que exigem uma resposta mais determinista e menos aberta ou criativa, enquanto valores mais altos paratemperaturepodem gerar resultados mais diversos ou criativos. Um valor de0paratemperatureé determinista, o que significa que a resposta de maior probabilidade é sempre selecionada.TOP_P: um valorFLOAT64no intervalo[0.0,1.0]ajuda a determinar a probabilidade dos tokens selecionados. Especifique um valor mais baixo para respostas menos aleatórias e um valor mais alto para respostas mais aleatórias. O padrão é0.95.STOP_SEQUENCES: um valorARRAY<STRING>que remove as strings especificadas se elas estiverem incluídas nas respostas do modelo. As strings têm correspondência exata, incluindo as letras maiúsculas. O padrão é uma matriz vazia.GROUND_WITH_GOOGLE_SEARCH: um valor deBOOLque determina se o modelo da Gemini Enterprise Agent Platform usa o [embasamento com a Pesquisa Google](/vertex-ai/generative-ai/docs/grounding/overview#ground-public) ao gerar respostas. O embasamento permite que o modelo use informações adicionais da Internet ao gerar uma resposta para torná-las mais específicas e factuais. Quando esse campo é definido comoTrue, uma colunagrounding_resultextra é incluída nos resultados, fornecendo as fontes usadas pelo modelo para coletar mais informações. O padrão éFALSE;SAFETY_SETTINGS: um valor deARRAY<STRUCT<STRING AS category, STRING AS threshold>>que configura limites de segurança de conteúdo para filtrar respostas. O primeiro elemento no struct especifica uma categoria de dano, e o segundo especifica um limite de bloqueio correspondente. O modelo filtra o conteúdo que viola essas configurações. Só é possível especificar cada categoria uma vez. Por exemplo, não é possível especificarSTRUCT('HARM_CATEGORY_DANGEROUS_CONTENT' AS category, 'BLOCK_MEDIUM_AND_ABOVE' AS threshold)eSTRUCT('HARM_CATEGORY_DANGEROUS_CONTENT' AS category, 'BLOCK_ONLY_HIGH' AS threshold)ao mesmo tempo. Se não houver uma configuração de segurança para uma determinada categoria, a configuração de segurançaBLOCK_MEDIUM_AND_ABOVEserá usada. As categorias compatíveis são as seguintes:HARM_CATEGORY_HATE_SPEECHHARM_CATEGORY_DANGEROUS_CONTENTHARM_CATEGORY_HARASSMENTHARM_CATEGORY_SEXUALLY_EXPLICIT
BLOCK_NONE(Restrito)BLOCK_LOW_AND_ABOVEBLOCK_MEDIUM_AND_ABOVE(padrão)BLOCK_ONLY_HIGHHARM_BLOCK_THRESHOLD_UNSPECIFIED
REQUEST_TYPE: um valorSTRINGque especifica o tipo de solicitação de inferência a ser enviada ao modelo do Gemini. O tipo de solicitação determina qual cota a solicitação usa. Estes são os valores válidos:DEDICATED: a funçãoAI.GENERATE_TEXTusa apenas a cota de capacidade de processamento provisionada. A funçãoAI.GENERATE_TEXTretorna o erroProvisioned throughput is not purchased or is not activese a cota de capacidade de processamento provisionada não estiver disponível.SHARED: a funçãoAI.GENERATE_TEXTusa apenas a cota compartilhada dinâmica (DSQ), mesmo que você tenha comprado uma cota de Capacidade de Processamento Provisionada.UNSPECIFIED: a funçãoAI.GENERATE_TEXTusa a cota da seguinte maneira:- Se você não tiver comprado a cota de capacidade de processamento provisionada,
a função
AI.GENERATE_TEXTvai usar a cota de DSQ. - Se você comprou uma cota de capacidade de processamento provisionada,
a função
AI.GENERATE_TEXTvai usar essa cota primeiro. Se as solicitações excederem a cota de capacidade de processamento provisionada, o tráfego excedente vai usar a cota de DSQ.
- Se você não tiver comprado a cota de capacidade de processamento provisionada,
a função
O valor padrão é
UNSPECIFIED.Para mais informações, consulte Usar a capacidade de processamento provisionada da plataforma de agentes.
MODEL_PARAMS: um literal de string formatado em JSON que fornece parâmetros para o modelo. O valor precisa estar de acordo com o formato do corpo da solicitaçãogenerateContent. É possível fornecer um valor para qualquer campo no corpo da solicitação, exceto para o campocontents[]. Se você definir esse campo, não será possível especificar parâmetros de modelo no argumento de struct de nível superior para a funçãoAI.GENERATE_TEXT. É necessário especificar todos os parâmetros do modelo no campoMODEL_PARAMSou omitir esse campo e especificar cada parâmetro separadamente.
Exemplo 1
O exemplo a seguir mostra uma solicitação com estas características:
- Solicita um resumo do texto na coluna
bodyda tabelaarticles.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT('Summarize this text', body) AS prompt
      FROM mydataset.articles
    ));
Exemplo 2
O exemplo a seguir mostra uma solicitação com estas características:
- Usa uma consulta para criar os dados do prompt, concatenando as strings que fornecem prefixos do prompt com as colunas da tabela.
- Retorna uma resposta curta.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT(question, 'Text:', description, 'Category') AS prompt
      FROM mydataset.input_table
    ),
    STRUCT(
      100 AS max_output_tokens));
Exemplo 3:
O exemplo a seguir mostra uma solicitação com estas características:
- Usa a coluna
promptda tabelapromptspara a solicitação.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    TABLE mydataset.prompts);
Exemplo 4
O exemplo a seguir mostra uma solicitação com estas características:
- Usa a coluna
promptda tabelapromptspara a solicitação. - Retorna uma resposta curta.
- Recupera e retorna dados públicos da Web para embasamento de resposta.
- Filtra respostas não seguras usando duas configurações de segurança.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    TABLE mydataset.prompts,
    STRUCT(
      100 AS max_output_tokens, 0.5 AS top_p,
      TRUE AS ground_with_google_search,
      [STRUCT('HARM_CATEGORY_HATE_SPEECH' AS category,
        'BLOCK_LOW_AND_ABOVE' AS threshold),
      STRUCT('HARM_CATEGORY_DANGEROUS_CONTENT' AS category,
        'BLOCK_MEDIUM_AND_ABOVE' AS threshold)] AS safety_settings));
Exemplo 5
O exemplo a seguir mostra uma solicitação com estas características:
- Usa a coluna
promptda tabelapromptspara a solicitação. - Retorna uma resposta mais longa.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.flash_2_model`,
    TABLE mydataset.prompts,
    STRUCT(
      0.4 AS temperature, 8192 AS max_output_tokens));
Exemplo 6
O exemplo a seguir mostra uma solicitação com estas características:
- Solicita um resumo do texto na coluna
bodyda tabelaarticles. - Recupera e retorna dados públicos da Web para embasamento de resposta.
- Filtra respostas não seguras usando duas configurações de segurança.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT('Summarize this text', body) AS prompt
      FROM mydataset.articles
    ),
    STRUCT(
      .1 AS TEMPERATURE,
      TRUE AS ground_with_google_search,
      [STRUCT('HARM_CATEGORY_HATE_SPEECH' AS category,
        'BLOCK_LOW_AND_ABOVE' AS threshold),
      STRUCT('HARM_CATEGORY_DANGEROUS_CONTENT' AS category,
        'BLOCK_MEDIUM_AND_ABOVE' AS threshold)] AS safety_settings));
Claude
SELECT *
FROM AI.GENERATE_TEXT(
  MODEL `PROJECT_ID.DATASET_ID.MODEL_NAME`,
  {TABLE PROJECT_ID.DATASET_ID.TABLE_NAME | (PROMPT_QUERY)},
  STRUCT(
  {
    {
      [MAX_OUTPUT_TOKENS AS max_output_tokens]
      [, TOP_K AS top_k]
      [, TOP_P AS top_p]
    }
    |
    [, MODEL_PARAMS AS model_params]
  })
);
Substitua:
PROJECT_ID: o ID do projeto.DATASET_ID: o ID do conjunto de dados que contém o modelo.MODEL_NAME: o nome do modeloTABLE_NAME: o nome da tabela que contém o comando. Essa tabela precisa ter uma tabela chamadapromptou é possível utilizar um alias para usar uma coluna com um nome diferente.PROMPT_QUERY: uma consulta que fornece os dados do comando. Essa consulta precisa produzir uma coluna chamadaprompt.TOKENS: um valorINT64que define o número máximo de tokens que podem ser gerados na resposta. Esse valor deve estar no intervalo[1,4096]. Especifique um valor mais baixo para respostas mais curtas e um valor mais alto para respostas mais longas. O padrão é128.TOP_K: um valorINT64no intervalo[1,40]que determina o pool inicial de tokens que o modelo considera para seleção. Especifique um valor mais baixo para respostas menos aleatórias e um valor mais alto para respostas mais aleatórias. Se você não especificar um valor, o modelo vai determinar um valor apropriado.TOP_P: um valorFLOAT64no intervalo[0.0,1.0]ajuda a determinar a probabilidade dos tokens selecionados. Especifique um valor mais baixo para respostas menos aleatórias e um valor mais alto para respostas mais aleatórias. Se você não especificar um valor, o modelo vai determinar um valor apropriado.MODEL_PARAMS: um literal de string formatado em JSON que fornece parâmetros para o modelo. O valor precisa estar de acordo com o formato do corpo da solicitaçãogenerateContent. É possível fornecer um valor para qualquer campo no corpo da solicitação, exceto para o campocontents[]. Se você definir esse campo, não será possível especificar parâmetros de modelo no argumento de struct de nível superior para a funçãoAI.GENERATE_TEXT. É necessário especificar todos os parâmetros do modelo no campoMODEL_PARAMSou omitir esse campo e especificar cada parâmetro separadamente.
Exemplo 1
O exemplo a seguir mostra uma solicitação com estas características:
- Solicita um resumo do texto na coluna
bodyda tabelaarticles.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT('Summarize this text', body) AS prompt
      FROM mydataset.articles
    ));
Exemplo 2
O exemplo a seguir mostra uma solicitação com estas características:
- Usa uma consulta para criar os dados do prompt, concatenando as strings que fornecem prefixos do prompt com as colunas da tabela.
- Retorna uma resposta curta.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT(question, 'Text:', description, 'Category') AS prompt
      FROM mydataset.input_table
    ),
    STRUCT(
      100 AS max_output_tokens));
Exemplo 3:
O exemplo a seguir mostra uma solicitação com estas características:
- Usa a coluna
promptda tabelapromptspara a solicitação.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    TABLE mydataset.prompts);
Llama
SELECT *
FROM AI.GENERATE_TEXT(
  MODEL `PROJECT_ID.DATASET_ID.MODEL_NAME`,
  {TABLE PROJECT_ID.DATASET_ID.TABLE_NAME | (PROMPT_QUERY)},
  STRUCT(
  {
    {
      [MAX_OUTPUT_TOKENS AS max_output_tokens]
      [, TOP_P AS top_p]
      [, TEMPERATURE AS temperature]
      [, STOP_SEQUENCES AS stop_sequences]
    |
    }
    [, MODEL_PARAMS AS model_params]
  })
);
Substitua:
PROJECT_ID: o ID do projeto.DATASET_ID: o ID do conjunto de dados que contém o modelo.MODEL_NAME: o nome do modeloTABLE_NAME: o nome da tabela que contém o comando. Essa tabela precisa ter uma tabela chamadapromptou é possível utilizar um alias para usar uma coluna com um nome diferente.PROMPT_QUERY: uma consulta que fornece os dados do comando. Essa consulta precisa produzir uma coluna chamadaprompt.TOKENS: um valorINT64que define o número máximo de tokens que podem ser gerados na resposta. Esse valor deve estar no intervalo[1,4096]. Especifique um valor mais baixo para respostas mais curtas e um valor mais alto para respostas mais longas. O padrão é128.TEMPERATURE: um valorFLOAT64no intervalo[0.0,1.0]que controla o grau de aleatoriedade na seleção de token. O padrão é0.Valores mais baixos para
temperaturesão bons para comandos que exigem uma resposta mais determinista e menos aberta ou criativa, enquanto valores mais altos paratemperaturepodem gerar resultados mais diversos ou criativos. Um valor de0paratemperatureé determinista, o que significa que a resposta de maior probabilidade é sempre selecionada.TOP_P: um valorFLOAT64no intervalo[0.0,1.0]ajuda a determinar a probabilidade dos tokens selecionados. Especifique um valor mais baixo para respostas menos aleatórias e um valor mais alto para respostas mais aleatórias. O padrão é0.95.STOP_SEQUENCES: um valorARRAY<STRING>que remove as strings especificadas se elas estiverem incluídas nas respostas do modelo. As strings têm correspondência exata, incluindo as letras maiúsculas. O padrão é uma matriz vazia.MODEL_PARAMS: um literal de string formatado em JSON que fornece parâmetros para o modelo. O valor precisa estar de acordo com o formato do corpo da solicitaçãogenerateContent. É possível fornecer um valor para qualquer campo no corpo da solicitação, exceto para o campocontents[]. Se você definir esse campo, não será possível especificar parâmetros de modelo no argumento de struct de nível superior para a funçãoAI.GENERATE_TEXT. É necessário especificar todos os parâmetros do modelo no campoMODEL_PARAMSou omitir esse campo e especificar cada parâmetro separadamente.
Exemplo 1
O exemplo a seguir mostra uma solicitação com estas características:
- Solicita um resumo do texto na coluna
bodyda tabelaarticles.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT('Summarize this text', body) AS prompt
      FROM mydataset.articles
    ));
Exemplo 2
O exemplo a seguir mostra uma solicitação com estas características:
- Usa uma consulta para criar os dados do prompt, concatenando as strings que fornecem prefixos do prompt com as colunas da tabela.
- Retorna uma resposta curta.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT(question, 'Text:', description, 'Category') AS prompt
      FROM mydataset.input_table
    ),
    STRUCT(
      100 AS max_output_tokens));
Exemplo 3:
O exemplo a seguir mostra uma solicitação com estas características:
- Usa a coluna
promptda tabelapromptspara a solicitação.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    TABLE mydataset.prompts);
Mistral AI
SELECT *
FROM AI.GENERATE_TEXT(
  MODEL `PROJECT_ID.DATASET_ID.MODEL_NAME`,
  {TABLE PROJECT_ID.DATASET_ID.TABLE_NAME | (PROMPT_QUERY)},
  STRUCT(
  {
    {
      [MAX_OUTPUT_TOKENS AS max_output_tokens]
      [, TOP_P AS top_p]
      [, TEMPERATURE AS temperature]
      [, STOP_SEQUENCES AS stop_sequences]
    |
    }
    [, MODEL_PARAMS AS model_params]
  })
);
Substitua:
PROJECT_ID: o ID do projeto.DATASET_ID: o ID do conjunto de dados que contém o modelo.MODEL_NAME: o nome do modeloTABLE_NAME: o nome da tabela que contém o comando. Essa tabela precisa ter uma tabela chamadapromptou é possível utilizar um alias para usar uma coluna com um nome diferente.PROMPT_QUERY: uma consulta que fornece os dados do comando. Essa consulta precisa produzir uma coluna chamadaprompt.TOKENS: um valorINT64que define o número máximo de tokens que podem ser gerados na resposta. Esse valor deve estar no intervalo[1,4096]. Especifique um valor mais baixo para respostas mais curtas e um valor mais alto para respostas mais longas. O padrão é128.TEMPERATURE: um valorFLOAT64no intervalo[0.0,1.0]que controla o grau de aleatoriedade na seleção de token. O padrão é0.Valores mais baixos para
temperaturesão bons para comandos que exigem uma resposta mais determinista e menos aberta ou criativa, enquanto valores mais altos paratemperaturepodem gerar resultados mais diversos ou criativos. Um valor de0paratemperatureé determinista, o que significa que a resposta de maior probabilidade é sempre selecionada.TOP_P: um valorFLOAT64no intervalo[0.0,1.0]ajuda a determinar a probabilidade dos tokens selecionados. Especifique um valor mais baixo para respostas menos aleatórias e um valor mais alto para respostas mais aleatórias. O padrão é0.95.STOP_SEQUENCES: um valorARRAY<STRING>que remove as strings especificadas se elas estiverem incluídas nas respostas do modelo. As strings têm correspondência exata, incluindo as letras maiúsculas. O padrão é uma matriz vazia.MODEL_PARAMS: um literal de string formatado em JSON que fornece parâmetros para o modelo. O valor precisa estar de acordo com o formato do corpo da solicitaçãogenerateContent. É possível fornecer um valor para qualquer campo no corpo da solicitação, exceto para o campocontents[]. Se você definir esse campo, não será possível especificar parâmetros de modelo no argumento de struct de nível superior para a funçãoAI.GENERATE_TEXT. É necessário especificar todos os parâmetros do modelo no campoMODEL_PARAMSou omitir esse campo e especificar cada parâmetro separadamente.
Exemplo 1
O exemplo a seguir mostra uma solicitação com estas características:
- Solicita um resumo do texto na coluna
bodyda tabelaarticles.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT('Summarize this text', body) AS prompt
      FROM mydataset.articles
    ));
Exemplo 2
O exemplo a seguir mostra uma solicitação com estas características:
- Usa uma consulta para criar os dados do prompt, concatenando as strings que fornecem prefixos do prompt com as colunas da tabela.
- Retorna uma resposta curta.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT(question, 'Text:', description, 'Category') AS prompt
      FROM mydataset.input_table
    ),
    STRUCT(
      100 AS max_output_tokens));
Exemplo 3:
O exemplo a seguir mostra uma solicitação com estas características:
- Usa a coluna
promptda tabelapromptspara a solicitação.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    TABLE mydataset.prompts);
Modelos abertos
SELECT *
FROM AI.GENERATE_TEXT(
  MODEL `PROJECT_ID.DATASET_ID.MODEL_NAME`,
  {TABLE PROJECT_ID.DATASET_ID.TABLE_NAME | (PROMPT_QUERY)},
  STRUCT(
  {
    {
      [MAX_OUTPUT_TOKENS AS max_output_tokens]
      [, TOP_K AS top_k]
      [, TOP_P AS top_p]
      [, TEMPERATURE AS temperature]
    }
    |
    [, MODEL_PARAMS AS model_params]
  })
);
Substitua:
PROJECT_ID: o ID do projeto.DATASET_ID: o ID do conjunto de dados que contém o modelo.MODEL_NAME: o nome do modeloTABLE_NAME: o nome da tabela que contém o comando. Essa tabela precisa ter uma tabela chamadapromptou é possível utilizar um alias para usar uma coluna com um nome diferente.PROMPT_QUERY: uma consulta que fornece os dados do comando. Essa consulta precisa produzir uma coluna chamadaprompt.TOKENS: um valorINT64que define o número máximo de tokens que podem ser gerados na resposta. Esse valor deve estar no intervalo[1,4096]. Especifique um valor mais baixo para respostas mais curtas e um valor mais alto para respostas mais longas. Se você não especificar um valor, o modelo vai determinar um valor apropriado.TEMPERATURE: um valorFLOAT64no intervalo[0.0,1.0]que controla o grau de aleatoriedade na seleção de token. Se você não especificar um valor, o modelo vai determinar um valor apropriado.Valores mais baixos para
temperaturesão bons para comandos que exigem uma resposta mais determinista e menos aberta ou criativa, enquanto valores mais altos paratemperaturepodem gerar resultados mais diversos ou criativos. Um valor de0paratemperatureé determinista, o que significa que a resposta de maior probabilidade é sempre selecionada.TOP_K: um valorINT64no intervalo[1,40]que determina o pool inicial de tokens que o modelo considera para seleção. Especifique um valor mais baixo para respostas menos aleatórias e um valor mais alto para respostas mais aleatórias. Se você não especificar um valor, o modelo vai determinar um valor apropriado.TOP_P: um valorFLOAT64no intervalo[0.0,1.0]ajuda a determinar a probabilidade dos tokens selecionados. Especifique um valor mais baixo para respostas menos aleatórias e um valor mais alto para respostas mais aleatórias. Se você não especificar um valor, o modelo vai determinar um valor apropriado.MODEL_PARAMS: um literal de string formatado em JSON que fornece parâmetros para o modelo. O valor precisa estar de acordo com o formato do corpo da solicitaçãogenerateContent. É possível fornecer um valor para qualquer campo no corpo da solicitação, exceto para o campocontents[]. Se você definir esse campo, não será possível especificar parâmetros de modelo no argumento de struct de nível superior para a funçãoAI.GENERATE_TEXT. É necessário especificar todos os parâmetros do modelo no campoMODEL_PARAMSou omitir esse campo e especificar cada parâmetro separadamente.
Exemplo 1
O exemplo a seguir mostra uma solicitação com estas características:
- Solicita um resumo do texto na coluna
bodyda tabelaarticles.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT('Summarize this text', body) AS prompt
      FROM mydataset.articles
    ));
Exemplo 2
O exemplo a seguir mostra uma solicitação com estas características:
- Usa uma consulta para criar os dados do prompt, concatenando as strings que fornecem prefixos do prompt com as colunas da tabela.
- Retorna uma resposta curta.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    (
      SELECT CONCAT(question, 'Text:', description, 'Category') AS prompt
      FROM mydataset.input_table
    ),
    STRUCT(
      100 AS max_output_tokens));
Exemplo 3:
O exemplo a seguir mostra uma solicitação com estas características:
- Usa a coluna
promptda tabelapromptspara a solicitação.
SELECT *
FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.text_model`,
    TABLE mydataset.prompts);
Gerar texto usando dados da tabela de objetos
Gere texto usando a
função AI.GENERATE_TEXT
com um modelo do Gemini para analisar dados não estruturados de uma tabela de
objetos. Você fornece os dados do comando no parâmetro prompt.
SELECT *
FROM AI.GENERATE_TEXT(
MODEL `PROJECT_ID.DATASET.MODEL`,
{ TABLE `PROJECT_ID.DATASET.TABLE` | (QUERY_STATEMENT) },
STRUCT(
  PROMPT AS prompt
  {
    {
      [, MAX_OUTPUT_TOKENS AS max_output_tokens]
      [, TOP_P AS top_p]
      [, TEMPERATURE AS temperature]
      [, STOP_SEQUENCES AS stop_sequences]
      [, SAFETY_SETTINGS AS safety_settings]
    }
    |
    [, MODEL_PARAMS AS model_params]
  })
);
Substitua:
PROJECT_ID: o projeto que contém o recurso.DATASET: o conjunto de dados que contém o recurso.MODEL: o nome do modelo remoto sobre o modelo da Gemini Enterprise Agent Platform. Para mais informações sobre como criar esse tipo de modelo remoto, consulte A instruçãoCREATE MODELpara modelos remotos em LLMs .Para confirmar qual modelo é usado pelo modelo remoto, abra o console do Google Cloud e consulte o campo Endpoint remoto na página de detalhes do modelo.
Observação: o uso de um modelo remoto baseado em um modelo do Gemini 2.5 gera cobranças pelo processo de pensamento.
TABLE: o nome da tabela de objetos que contém o conteúdo a ser analisado. Para saber mais sobre os tipos de conteúdo que podem ser analisados, consulte Entrada.O bucket do Cloud Storage usado pela tabela de objetos de entrada precisa estar no mesmo projeto em que você criou o modelo e em que está chamando a função
AI.GENERATE_TEXT.QUERY_STATEMENT: a consulta do GoogleSQL que gera os dados da imagem. Só é possível especificar as cláusulasWHEREeORDER BYna consulta.PROMPT: um valorSTRINGque contém o comando a ser usado para analisar o conteúdo visual. O valorpromptprecisa conter menos de 16.000 tokens. Um token pode ser menor do que uma palavra e ter aproximadamente quatro caracteres. Cem tokens correspondem a cerca de 60 a 80 palavras.MAX_OUTPUT_TOKENS: um valorINT64que define o número máximo de tokens que podem ser gerados na resposta. Esse valor deve estar no intervalo[1,8192]. Especifique um valor mais baixo para respostas mais curtas e um valor mais alto para respostas mais longas. O padrão é1024.TOP_P: um valorFLOAT64no intervalo[0.0,1.0]que altera o modo como o modelo seleciona tokens de saída. Especifique um valor mais baixo para respostas menos aleatórias e um valor mais alto para respostas mais aleatórias. O padrão é0.95.Os tokens são selecionados do mais provável ao menos provável até que a soma das probabilidades seja igual ao valor de
TOP_P. Por exemplo, se os tokens A, B e C tiverem uma probabilidade de0.3,0.2e0.1e o valorTOP_Pfor0.5, o modelo selecionará A ou B como o próximo token usando o valorTEMPERATURE, desconsiderando C.TEMPERATURE: um valorFLOAT64no intervalo[0.0,1.0]que controla o grau de aleatoriedade na seleção de token. ValoresTEMPERATUREmais baixos são bons para comandos que exigem uma resposta mais determinista e menos aberta ou criativa, enquanto valoresTEMPERATUREmaiores podem levar a resultados mais diversos ou criativos. Um valorTEMPERATUREde0é determinista, o que significa que a resposta de maior probabilidade é sempre selecionada. O padrão é0.STOP_SEQUENCES: um valorARRAYque remove as strings especificadas se elas estiverem incluídas nas respostas do modelo. As strings têm correspondência exata, incluindo as letras maiúsculas. O padrão é uma matriz vazia.SAFETY_SETTINGS: um valor deARRAYque configura limites de segurança de conteúdo para filtrar respostas. O primeiro elemento no struct especifica uma categoria de dano, e o segundo especifica um limite de bloqueio correspondente. O modelo filtra o conteúdo que viola essas configurações. Só é possível especificar cada categoria uma vez. Por exemplo, não é possível especificarSTRUCT('HARM_CATEGORY_DANGEROUS_CONTENT' AS category, 'BLOCK_MEDIUM_AND_ABOVE' AS threshold)eSTRUCT('HARM_CATEGORY_DANGEROUS_CONTENT' AS category, 'BLOCK_ONLY_HIGH' AS threshold)ao mesmo tempo. Se não houver uma configuração de segurança para uma determinada categoria, a configuração de segurançaBLOCK_MEDIUM_AND_ABOVEserá usada.As categorias compatíveis são as seguintes:
HARM_CATEGORY_HATE_SPEECHHARM_CATEGORY_DANGEROUS_CONTENTHARM_CATEGORY_HARASSMENTHARM_CATEGORY_SEXUALLY_EXPLICIT
Os limites aceitos são os seguintes:
BLOCK_NONE( Restrito )BLOCK_LOW_AND_ABOVEBLOCK_MEDIUM_AND_ABOVE(padrão)BLOCK_ONLY_HIGHHARM_BLOCK_THRESHOLD_UNSPECIFIED
Para mais informações, consulte a definição de categoria de segurança e de limite de bloqueio .
MODEL_PARAMS: uma string literal formatada em JSON que fornece parâmetros adicionais ao modelo. O valor precisa estar de acordo com o formato do corpo da solicitaçãogenerateContent. É possível fornecer um valor para qualquer campo no corpo da solicitação, exceto para o campocontents[]. Se você definir esse campo, não será possível especificar parâmetros de modelo no argumento de struct de nível superior para a funçãoAI.GENERATE_TEXT.
Mostrar outros parâmetros opcionais
Exemplos
Este exemplo traduz e transcreve o conteúdo de áudio de uma tabela de objetos
chamada feedback:
SELECT * FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.audio_model`,
    TABLE `mydataset.feedback`,
      STRUCT('What is the content of this audio clip, translated into Spanish?' AS PROMPT));
Neste exemplo, classificamos o conteúdo PDF de uma tabela de objetos
chamada invoices:
SELECT * FROM
  AI.GENERATE_TEXT(
    MODEL `mydataset.classify_model`,
    TABLE `mydataset.invoices`,
      STRUCT('Classify this document based on the invoice total, using the following categories: 0 to 100, 101 to 200, greater than 200' AS PROMPT));