


הרצת שאילתה
במאמר הזה מוסבר איך להריץ שאילתה ב-BigQuery ולהבין כמה נתונים השאילתה תעבד לפני ההרצה, באמצעות ביצוע הרצה יבשה.
סוגי שאילתות
אפשר להריץ שאילתות על נתוני BigQuery באמצעות אחד מסוגי משימות השאילתות הבאים:
משימות של שאילתות אינטראקטיביות. כברירת מחדל, BigQuery מריץ שאילתות כמשימות של שאילתות אינטראקטיביות, שמיועדות להתחיל לפעול כמה שיותר מהר.
משימות של שאילתות באצווה. לשאילתות אצווה יש עדיפות נמוכה יותר מאשר לשאילתות אינטראקטיביות. כשפרויקט או הזמנה משתמשים בכל משאבי ה-Compute הזמינים שלהם, סביר יותר ששאילתות באצווה יוכנסו לתור וישארו בו. אחרי שמתחילים להריץ שאילתה באצווה, היא פועלת כמו שאילתה אינטראקטיבית. מידע נוסף זמין במאמר בנושא תורים של שאילתות.
משימות של שאילתות מתמשכות. בעזרת המשימות האלה, השאילתה פועלת באופן רציף, כך שאפשר לנתח נתונים נכנסים ב-BigQuery בזמן אמת, ואז לכתוב את התוצאות בטבלה ב-BigQuery או לייצא את התוצאות ל-Bigtable או ל-Pub/Sub. אתם יכולים להשתמש ביכולת הזו כדי לבצע משימות רגישות לזמן, כמו יצירת תובנות ופעולה מיידית לפיהן, הפעלת הסקה של למידת מכונה (ML) בזמן אמת ובניית צינורות נתונים מבוססי-אירועים.
אפשר להריץ משימות של שאילתות בדרכים הבאות:
- לכתוב ולהריץ שאילתה במסוףGoogle Cloud .
- מריצים את הפקודה
bq queryבכלי שורת הפקודה של BigQuery. - קוראים באופן פרוגרמטי ל-method
jobs.queryאו ל-methodjobs.insertב-API בארכיטקטורת REST של BigQuery. - שימוש בספריות הלקוח של BigQuery.
המערכת של BigQuery שומרת את התוצאות של השאילתה בטבלה זמנית (ברירת מחדל) או בטבלה קבועה. כשמציינים טבלה קבועה כטבלת היעד של התוצאות, אפשר לבחור אם להוסיף לטבלה קיימת או להחליף אותה, או ליצור טבלה חדשה עם שם ייחודי.
התפקידים הנדרשים
כדי לקבל את ההרשאות שדרושות להרצת שאילתה, אתם צריכים לבקש מהאדמין להקצות לכם את תפקידי ה-IAM הבאים:
- BigQuery Job User (
roles/bigquery.jobUser) בפרויקט. - BigQuery Data Viewer (צפייה בנתוני BigQuery) (
roles/bigquery.dataViewer) בכל הטבלאות והתצוגות שהשאילתה מתייחסת אליהן. כדי לשלוח שאילתות לתצוגות, צריך גם את התפקיד הזה בכל הטבלאות והתצוגות הבסיסיות. אם אתם משתמשים בתצוגות מורשות או בקבוצות נתונים מורשות, אתם לא צריכים גישה לנתוני המקור הבסיסיים.
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקידים המוגדרים מראש האלה כוללים את ההרשאות שנדרשות להרצת משימת שאילתה. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי להריץ עבודת שאילתה, צריך את ההרשאות הבאות:
-
bigquery.jobs.createבפרויקט שממנו מריצים את השאילתה, לא משנה איפה הנתונים מאוחסנים. -
bigquery.tables.getDataבכל הטבלאות והתצוגות שהשאילתה מתייחסת אליהן. כדי לשלוח שאילתות לתצוגות, אתם צריכים את ההרשאה הזו גם לכל הטבלאות והתצוגות הבסיסיות. אם אתם משתמשים בתצוגות מורשות או בקבוצות נתונים מורשות, אתם לא צריכים גישה לנתוני המקור הבסיסיים.
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
פתרון בעיות
Access Denied: Project [project_id]: User does not have bigquery.jobs.create
permission in project [project_id].
השגיאה הזו מתרחשת כשאין לחשבון משתמש הרשאה ליצור משימות של שאילתות בפרויקט.
פתרון: אדמין צריך להעניק לכם את ההרשאה bigquery.jobs.create בפרויקט שאתם שולחים אליו את השאילתה. ההרשאה הזו נדרשת בנוסף לכל הרשאה שנדרשת כדי לגשת לנתונים שעליהם מורצת השאילתה.
מידע נוסף על הרשאות ב-BigQuery זמין במאמר בקרת גישה באמצעות IAM.
הרצת שאילתה אינטראקטיבית
כדי להריץ שאילתה אינטראקטיבית, בוחרים באחת מהאפשרויות הבאות:
המסוף
עוברים לדף BigQuery.
לוחצים על שאילתת SQL.
בעורך השאילתות, מזינים שאילתת GoogleSQL תקינה.
לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לזהות את השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;אפשר גם להשתמש בחלונית ההפניה כדי ליצור שאילתות חדשות.
אופציונלי: כדי שהצעות לקוד יוצגו אוטומטית כשמקלידים שאילתה, לוחצים על כלים > השלמה אוטומטית מבוססת-ניתוח. אם אתם לא צריכים הצעות להשלמה אוטומטית, מבטלים את הסימון של האפשרות השלמה אוטומטית מבוססת-ניתוח. הפעולה הזו משביתה גם את ההצעות למילוי אוטומטי של שם הפרויקט.
אופציונלי: כדי לבחור הגדרות נוספות של שאילתות, לוחצים על עריכה > הגדרות שאילתה.
לוחצים על הפעלה.
אם לא מציינים טבלת יעד, משימת השאילתה כותבת את הפלט לטבלה זמנית (מטמון).
עכשיו אפשר לעיין בתוצאות השאילתה בכרטיסייה Results בחלונית Query results.
אופציונלי: כדי למיין את תוצאות השאילתה לפי עמודה, לוחצים על פתיחת תפריט המיון ליד שם העמודה ובוחרים סדר מיון. אם מספר הבייטים המשוער שמעובד עבור המיון גדול מאפס, מספר הבייטים מוצג בחלק העליון של התפריט.
אופציונלי: כדי לראות תצוגה חזותית של תוצאות השאילתה, עוברים לכרטיסייה תצוגה חזותית. אפשר להגדיל או להקטין את התרשים, להוריד אותו כקובץ PNG או להפעיל או להשבית את התצוגה של מקרא התרשים.
בחלונית Visualization configuration (הגדרת התצוגה החזותית), אפשר לשנות את סוג התצוגה החזותית ולהגדיר את המדדים והמאפיינים של התצוגה החזותית. השדות בחלונית הזו מאוכלסים מראש בהגדרה הראשונית שמוסקת מסכימת טבלת היעד של השאילתה. ההגדרה נשמרת בין הרצות של שאילתות בעורך השאילתות.
במקרה של תרשימי קו, עמודות או פיזור, סוגי הנתונים של המימדים הנתמכים הם
INT64,FLOAT64,NUMERIC,BIGNUMERIC,TIMESTAMP,DATE,DATETIME,TIMEו-STRING, וסוגי הנתונים של המדדים הנתמכים הםINT64,FLOAT64,NUMERICו-BIGNUMERIC.אם תוצאות השאילתה כוללות את הסוג
GEOGRAPHY, סוג ההדמיה שמוגדר כברירת מחדל הוא מפה, שמאפשרת לכם להציג את התוצאות במפה אינטראקטיבית.אופציונלי: בכרטיסייה JSON, אפשר לעיין בתוצאות השאילתה בפורמט JSON, שבו המפתח הוא שם העמודה והערך הוא התוצאה של העמודה הזו.
BQ
-
במסוף Google Cloud , מפעילים את Cloud Shell.
בחלק התחתון של Google Cloud המסוף יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
משתמשים בפקודה
bq query. בדוגמה הבאה, הדגל--use_legacy_sql=falseמאפשר להשתמש בתחביר של GoogleSQL.bq query \ --use_legacy_sql=false \ 'QUERY'
מחליפים את QUERY בשאילתת GoogleSQL תקינה. לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לקבוע מהם השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:bq query \ --use_legacy_sql=false \ 'SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;'משימת השאילתה כותבת את הפלט לטבלה זמנית (מטמון).
אפשר גם לציין את טבלת היעד ואת המיקום של תוצאות השאילתה. כדי לכתוב את התוצאות לטבלה קיימת, צריך לכלול את הדגל המתאים כדי לצרף (
--append_table=true) או להחליף (--replace=true) את הטבלה.bq query \ --location=LOCATION \ --destination_table=TABLE \ --use_legacy_sql=false \ 'QUERY'
מחליפים את מה שכתוב בשדות הבאים:
LOCATION: האזור או האזור המרובה של טבלת היעד, לדוגמה
USבדוגמה הזו, מערך הנתונים
usa_namesמאוחסן במיקום של מספר אזורים בארה"ב. אם מציינים טבלת יעד לשאילתה הזו, מערך הנתונים שמכיל את טבלת היעד צריך להיות גם הוא באזור רב-אזורי בארה"ב. אי אפשר להריץ שאילתה על מערך נתונים במיקום אחד ולכתוב את התוצאות בטבלה במיקום אחר.אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ .bigqueryrc.
TABLE: שם טבלת היעד, למשל
myDataset.myTableאם טבלת היעד היא טבלה חדשה, BigQuery יוצר את הטבלה כשמריצים את השאילתה. עם זאת, צריך לציין מערך נתונים קיים.
אם הטבלה לא נמצאת בפרויקט הנוכחי, צריך להוסיף את מזהה הפרויקטGoogle Cloud בפורמט
PROJECT_ID:DATASET.TABLE. לדוגמה:myProject:myDataset.myTable. אם לא מציינים את--destination_table, נוצרת משימת שאילתה שכותבת את הפלט לטבלה זמנית.
Terraform
משתמשים במשאב google_bigquery_job.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
בדוגמה הבאה מריצים שאילתה. אפשר לאחזר את תוצאות השאילתה על ידי צפייה בפרטי העבודה:
כדי להחיל את הגדרות Terraform בפרויקט ב- Google Cloud , מבצעים את השלבים בקטעים הבאים.
הכנת Cloud Shell
- מפעילים את Cloud Shell.
-
מגדירים את Google Cloud פרויקט ברירת המחדל שבו רוצים להחיל את ההגדרות של Terraform.
תצטרכו להריץ את הפקודה הזו רק פעם אחת לכל פרויקט, ותוכלו לעשות זאת בכל ספרייה.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
אם תגדירו ערכים ספציפיים בקובץ התצורה של Terraform, הם יבטלו את ערכי ברירת המחדל של משתני הסביבה.
הכנת הספרייה
לכל קובץ תצורה של Terraform צריכה להיות ספרייה משלו (שנקראת גם מודול ברמה הבסיסית).
-
יוצרים ספרייה חדשה ב-Cloud Shell ובה יוצרים קובץ חדש. שם הקובץ חייב לכלול את הסיומת
.tf, למשלmain.tf. במדריך הזה, הקובץ נקראmain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
אם אתם עוקבים אחרי המדריך, תוכלו להעתיק את הקוד לדוגמה בכל קטע או שלב.
מעתיקים את הקוד לדוגמה בקובץ
main.tfהחדש שיצרתם.לחלופין, אפשר גם להעתיק את הקוד מ-GitHub. כדאי לעשות את זה כשקטע הקוד של Terraform הוא חלק מפתרון מקצה לקצה.
- בודקים את הפרמטרים לדוגמה ומשנים אותם בהתאם לסביבה שלכם.
- שומרים את השינויים.
-
מפעילים את Terraform. צריך לעשות זאת רק פעם אחת לכל ספרייה.
terraform init
אופציונלי: תוכלו לכלול את האפשרות
-upgrade, כדי להשתמש בגרסה העדכנית ביותר של הספק של Google:terraform init -upgrade
החלה של השינויים
-
בודקים את ההגדרות ומוודאים שהמשאבים שמערכת Terraform תיצור או תעדכן תואמים לציפיות שלכם:
terraform plan
מתקנים את ההגדרות לפי הצורך.
-
מריצים את הפקודה הבאה ומזינים
yesבהודעה שמופיעה, כדי להחיל את הגדרות Terraform:terraform apply
ממתינים עד שב-Terraform תוצג ההודעה "Apply complete!".
- פותחים את Google Cloud הפרויקט כדי לראות את התוצאות. במסוף Google Cloud , נכנסים למשאבים בממשק המשתמש כדי לוודא שהם נוצרו או עודכנו ב-Terraform.
API
כדי להריץ שאילתה באמצעות ה-API, צריך להוסיף עבודה חדשה ולאכלס את מאפיין ההגדרה של העבודה query. אפשר גם לציין את המיקום שלכם במאפיין location בקטע jobReference של משאב המשרה.
כדי לקבל את תוצאות הסקר, צריך להתקשר למספר getQueryResults.
סקר עד ש-jobComplete שווה ל-true. בודקים אם יש שגיאות ואזהרות ברשימה errors.
C#
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי C#הוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery C# API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Javaהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להריץ שאילתה עם שרת proxy, אפשר לעיין במאמר הגדרת שרת proxy.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי PHPהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Ruby
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Rubyהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
הרצה יבשה
הרצת סימולציה ב-BigQuery מספקת את המידע הבא:
- הערכה של החיובים במצב על פי דרישה
- אימות השאילתה
- מספר הבייטים המשוער שעובדו על ידי השאילתה במצב קיבולת
ההרצה היבשה לא משתמשת במשבצות של שאילתות, ולא נגבה מכם תשלום על הרצה יבשה. אפשר להשתמש באומדן שמוחזר מהרצת ניסיון כדי לחשב את עלויות השאילתות במחשבון התמחור.
ביצוע הרצת בדיקה
כדי לבצע הרצה יבשה:
המסוף
עוברים לדף BigQuery.
מזינים את השאילתה בעורך השאילתות.
אם השאילתה תקינה, יופיע אוטומטית סימן וי לצד כמות הנתונים שהשאילתה תעבד. אם השאילתה לא תקינה, יופיע סימן קריאה לצד הודעת שגיאה.
BQ
מזינים שאילתה כמו זו שבהמשך באמצעות הדגל --dry_run.
bq query \
--use_legacy_sql=false \
--dry_run \
'SELECT
   COUNTRY,
   AIRPORT,
   IATA
 FROM
   `project_id`.dataset.airports
 LIMIT
   1000'
אם השאילתה תקינה, הפקודה תחזיר את התגובה הבאה:
Query successfully validated. Assuming the tables are not modified,
running this query will process 10918 bytes of data.
API
כדי לבצע הרצה יבשה באמצעות ה-API, שולחים עבודת שאילתה עם dryRun שמוגדר ל-true בסוג JobConfiguration.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Javaהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי PHPהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
מגדירים את המאפיין QueryJobConfig.dry_run לערך True.
Client.query()
תמיד מחזירה QueryJob
שהסתיים כשמספקים הגדרה של שאילתת הרצה יבשה.
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
פתרון בעיות שקשורות לשאילתות
מידע על פתרון בעיות בשאילתות זמין במאמר פתרון בעיות בשאילתות.
הרצת שאילתה באצווה
כדי להריץ שאילתת אצווה, בוחרים באחת מהאפשרויות הבאות:
המסוף
עוברים לדף BigQuery.
לוחצים על שאילתת SQL.
בעורך השאילתות, מזינים שאילתת GoogleSQL תקינה.
לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לזהות את השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;לוחצים על עריכה > הגדרות שאילתה.
בקטע ניהול משאבים, בוחרים באפשרות Batch.
אופציונלי: משנים את הגדרות השאילתה.
לוחצים על Save.
לוחצים על הפעלה.
אם לא מציינים טבלת יעד, עבודת השאילתה כותבת את הפלט לטבלה זמנית (מטמון).
BQ
-
במסוף Google Cloud , מפעילים את Cloud Shell.
בחלק התחתון של Google Cloud המסוף יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
משתמשים בפקודה
bq queryומציינים את הדגל--batch. בדוגמה הבאה, הדגל--use_legacy_sql=falseמאפשר להשתמש בתחביר GoogleSQL.bq query \ --batch \ --use_legacy_sql=false \ 'QUERY'
מחליפים את QUERY בשאילתת GoogleSQL תקינה. לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לקבוע מהם השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:bq query \ --batch \ --use_legacy_sql=false \ 'SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;'משימת השאילתה כותבת את הפלט לטבלה זמנית (מטמון).
אפשר גם לציין את טבלת היעד ואת המיקום של תוצאות השאילתה. כדי לכתוב את התוצאות לטבלה קיימת, צריך לכלול את הדגל המתאים כדי לצרף (
--append_table=true) או להחליף (--replace=true) את הטבלה.bq query \ --batch \ --location=LOCATION \ --destination_table=TABLE \ --use_legacy_sql=false \ 'QUERY'
מחליפים את מה שכתוב בשדות הבאים:
LOCATION: האזור או האזור המרובה של טבלת היעד, לדוגמה
USבדוגמה הזו, מערך הנתונים
usa_namesמאוחסן במיקום של מספר אזורים בארה"ב. אם מציינים טבלת יעד לשאילתה הזו, מערך הנתונים שמכיל את טבלת היעד צריך להיות גם הוא באזור רב-אזורי בארה"ב. אי אפשר להריץ שאילתה על מערך נתונים במיקום אחד ולכתוב את התוצאות בטבלה במיקום אחר.אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ .bigqueryrc.
TABLE: שם טבלת היעד, למשל
myDataset.myTableאם טבלת היעד היא טבלה חדשה, BigQuery יוצר את הטבלה כשמריצים את השאילתה. עם זאת, צריך לציין מערך נתונים קיים.
אם הטבלה לא נמצאת בפרויקט הנוכחי, צריך להוסיף את מזהה הפרויקטGoogle Cloud בפורמט
PROJECT_ID:DATASET.TABLE. לדוגמה:myProject:myDataset.myTable. אם לא מציינים את--destination_table, נוצרת משימת שאילתה שכותבת את הפלט לטבלה זמנית.
API
כדי להריץ שאילתה באמצעות ה-API, צריך להוסיף עבודה חדשה ולאכלס את מאפיין ההגדרה של העבודה query. אפשר גם לציין את המיקום שלכם במאפיין location בקטע jobReference של משאב המשרה.
כשמאכלסים את מאפייני עבודת השאילתה, צריך לכלול את המאפיין configuration.query.priority ולהגדיר את הערך שלו ל-BATCH.
כדי לקבל את תוצאות הסקר, צריך להתקשר למספר getQueryResults.
סקר עד ש-jobComplete שווה ל-true. בודקים אם יש שגיאות ואזהרות ברשימה errors.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
כדי להריץ שאילתת אצווה, מגדירים את העדיפות של השאילתה ל-QueryJobConfiguration.Priority.BATCH כשיוצרים QueryJobConfiguration.
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Javaהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
הרצת שאילתה מתמשכת
כדי להריץ עבודת שאילתה מתמשכת, צריך לבצע הגדרה נוספת. מידע נוסף זמין במאמר בנושא יצירת שאילתות רציפות.
שימוש בחלונית הפניה
בחלונית הפניה בכלי לעריכת שאילתות מוצג באופן דינמי מידע רלוונטי על טבלאות, תמונות מצב, תצוגות ותצוגות חומריות. בחלונית אפשר לראות תצוגה מקדימה של פרטי הסכימה של המשאבים האלה, או לפתוח אותם בכרטיסייה חדשה. אפשר גם להשתמש בחלונית Reference כדי ליצור שאילתות חדשות או לערוך שאילתות קיימות על ידי הוספת קטעי שאילתות או שמות שדות.
כדי ליצור שאילתה חדשה באמצעות החלונית Reference, פועלים לפי השלבים הבאים:
במסוף Google Cloud , עוברים לדף BigQuery.
לוחצים על שאילתת SQL.
לוחצים על quick_reference_all Reference.
לוחצים על טבלה או תצוגה שנוספו לאחרונה או סומנו בכוכב. אפשר גם להשתמש בשורת החיפוש כדי למצוא טבלאות ותצוגות.
לוחצים על View actions (הצגת פעולות) ואז על Insert query snippet (הוספת קטע קוד של שאילתה).
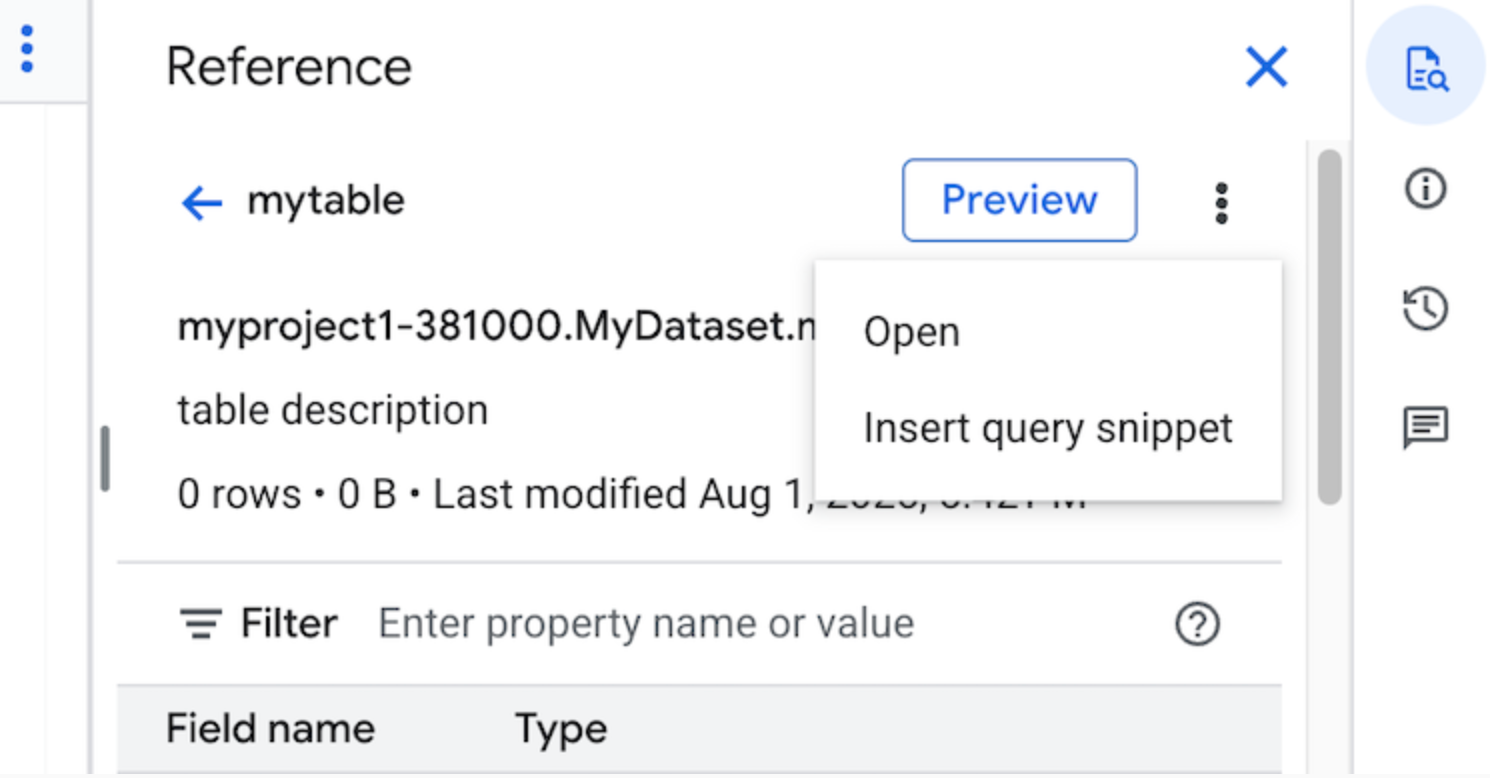
אופציונלי: אפשר לראות תצוגה מקדימה של פרטי הסכימה של הטבלה או התצוגה, או לפתוח אותם בכרטיסייה חדשה.
עכשיו אפשר לערוך את השאילתה באופן ידני או להוסיף שמות של שדות ישירות לשאילתה. כדי להוסיף שם של שדה, מצביעים על המקום בכלי לעריכת שאילתות שבו רוצים להוסיף את שם השדה ולוחצים עליו בחלונית הפניה.
הגדרות השאילתה
כשמריצים שאילתה, אפשר לציין את ההגדרות הבאות:
טבלת יעד לתוצאות השאילתה.
העדיפות של העבודה.
האם להשתמש בתוצאות של שאילתות שנשמרו במטמון.
הזמן הקצוב לתפוגה של העבודה באלפיות השנייה.
האם להשתמש במצב סשן.
סוג ההצפנה שבה רוצים להשתמש.
מספר הבייטים המקסימלי שהחיוב על השאילתה יתבסס עליו.
ניב ה-SQL שבו רוצים להשתמש.
המיקום שבו רוצים להריץ את השאילתה. השאילתה צריכה לפעול באותו מיקום שבו נמצאות הטבלאות שאליהן מתייחסים בשאילתה.
ההזמנה שבה רוצים להריץ את השאילתה.
מצב יצירה אופציונלית של משימות
מצב יצירה אופציונלית של משימות יכול לשפר את זמן האחזור הכולל של שאילתות שפועלות לפרק זמן קצר, כמו שאילתות מלוחות בקרה או מעומסי עבודה של חיפוש נתונים. במצב הזה, השאילתה מופעלת והתוצאות מוחזרות בשורה עבור הצהרות SELECT בלי שצריך להשתמש ב-jobs.getQueryResults כדי לאחזר את התוצאות. שאילתות שמופעלות באמצעות מצב יצירה אופציונלית של משימות לא יוצרות משימה כשהן מופעלות, אלא אם BigQuery קובע שיצירת משימה נדרשת כדי להשלים את השאילתה.
כדי להפעיל את מצב יצירה אופציונלית של משימות, מגדירים את השדה jobCreationMode של המופע QueryRequest לערך JOB_CREATION_OPTIONAL בגוף הבקשה jobs.query.
כשהערך של השדה הזה מוגדר ל-JOB_CREATION_OPTIONAL, מערכת BigQuery קובעת אם אפשר להשתמש בשאילתה במצב אופציונלי של יצירת משימה. אם כן, BigQuery מריץ את השאילתה ומחזיר את כל התוצאות בשדה rows של התגובה. מכיוון שלא נוצרת משימה עבור השאילתה הזו, BigQuery לא מחזיר jobReference בגוף התגובה. במקום זאת, היא מחזירה שדה queryId, שבו אפשר להשתמש כדי לקבל תובנות לגבי השאילתה באמצעות התצוגה INFORMATION_SCHEMA.JOBS. מכיוון שלא נוצרת משימה, אין jobReference שאפשר להעביר אל ממשקי ה-API jobs.get ו-jobs.getQueryResults כדי לחפש את השאילתות האלה.
אם BigQuery קובע שנדרשת משימה כדי להשלים את השאילתה, מוחזרת jobReference. כדי לגלות למה נוצרה עבודה עבור השאילתה, אפשר לבדוק את השדה job_creation_reason בתצוגה INFORMATION_SCHEMA.JOBS. במקרה כזה, צריך להשתמש ב-jobs.getQueryResults כדי לאחזר את התוצאות כשהשאילתה מסתיימת.
כשמשתמשים בערך JOB_CREATION_OPTIONAL, יכול להיות שהשדה jobReference לא יופיע בתגובה. לפני שאתם ניגשים לשדה, כדאי לבדוק אם הוא קיים.
כשמציינים את JOB_CREATION_OPTIONAL בשאילתות מרובות הצהרות (סקריפטים), יכול להיות ש-BigQuery יבצע אופטימיזציה של תהליך ההפעלה. כחלק מהאופטימיזציה הזו, יכול להיות ש-BigQuery יקבע שאפשר להשלים את הסקריפט על ידי יצירת פחות משאבי עבודה ממספר ההצהרות הנפרדות, ואולי אפילו יבצע את הסקריפט כולו בלי ליצור עבודה בכלל.
האופטימיזציה הזו תלויה בהערכה של התסריט ב-BigQuery, ויכול להיות שהיא לא תתבצע בכל המקרים. האופטימיזציה מתבצעת באופן אוטומטי לגמרי על ידי המערכת. לא נדרשים אמצעי בקרה או פעולות מצד המשתמש.
כדי להריץ שאילתה באמצעות מצב יצירה אופציונלית של משימות, בוחרים באחת מהאפשרויות הבאות:
המסוף
עוברים לדף BigQuery.
לוחצים על שאילתת SQL.
בעורך השאילתות, מזינים שאילתת GoogleSQL תקינה.
לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לזהות את השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;לוחצים על עריכה > מצב שאילתה > יצירת משימה אופציונלית. כדי לאשר את הבחירה, לוחצים על אישור.
לוחצים על הפעלה.
BQ
-
במסוף Google Cloud , מפעילים את Cloud Shell.
בחלק התחתון של Google Cloud המסוף יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
משתמשים בפקודה
bq queryומציינים את הדגל--job_creation_mode=JOB_CREATION_OPTIONAL. בדוגמה הבאה, הדגל--use_legacy_sql=falseמאפשר להשתמש בתחביר GoogleSQL.bq query \ --rpc=true \ --use_legacy_sql=false \ --job_creation_mode=JOB_CREATION_OPTIONAL \ --location=LOCATION \ 'QUERY'
מחליפים את QUERY בשאילתת GoogleSQL תקינה, ואת LOCATION באזור תקין שבו נמצא מערך הנתונים. לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לקבוע מהם השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:bq query \ --rpc=true \ --use_legacy_sql=false \ --job_creation_mode=JOB_CREATION_OPTIONAL \ --location=us \ 'SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;'עבודת השאילתה מחזירה את הפלט בשורה בתגובה.
API
כדי להריץ שאילתה במצב יצירה אופציונלית של משימות באמצעות ה-API, מריצים שאילתה באופן סינכרוני ומאכלסים את המאפיין QueryRequest. מוסיפים את המאפיין jobCreationMode ומגדירים את הערך שלו ל-JOB_CREATION_OPTIONAL.
בודקים את התשובה. אם jobComplete שווה ל-true והשדה jobReference ריק, קוראים את התוצאות מהשדה rows. אפשר גם לקבל את queryId מהתשובה.
אם jobReference מופיע, אפשר לבדוק ב-jobCreationReason למה נוצרה משימה על ידי BigQuery. כדי לקבל את תוצאות הסקר, צריך להתקשר למספר getQueryResults.
סקר עד ש-jobComplete שווה ל-true. בודקים אם יש שגיאות ואזהרות ברשימה errors.
Java
הגרסה הזמינה: 2.51.0 ואילך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Javaהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להריץ שאילתה עם שרת proxy, אפשר לעיין במאמר הגדרת שרת proxy.
Python
גרסה זמינה: 3.34.0 ומעלה
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
צומת
הגרסה הזמינה: 8.1.0 ואילך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
המשך
הגרסה הזמינה: 1.69.0 ומעלה
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
דרייבר JDBC
הגרסה הזמינה: JDBC v1.6.1 ואילך
צריך להגדיר את JobCreationMode=2 במחרוזת החיבור.
jdbc:bigquery://https://www.googleapis.com/bigquery/v2:443;JobCreationMode=2;Location=US;
דרייבר ODBC
גרסה זמינה: ODBC v3.0.7.1016 ואילך
צריך להגדיר את הערך JobCreationMode=2 בקובץ .ini.
    [ODBC Data Sources]
    Sample DSN=Simba Google BigQuery ODBC Connector 64-bit
    [Sample DSN]
    JobCreationMode=2
שאילתות גלובליות
השאילתות מורצות במיקום של הנתונים שהן מפנות אליהם. עם זאת, אם שאילתה מפנה לנתונים שמאוחסנים ביותר ממיקום אחד, מתבצעת שאילתה גלובלית. כשמריצים שאילתה עם אחזור נתונים גלובלי, מערכת BigQuery יכולה לאסוף את כל הנתונים הנדרשים ממיקומים שונים במקום אחד, להריץ שאילתה ולהחזיר את התוצאות. שאילתות גלובליות מחייבות העברת נתונים בין מיקומים, ולכן הן דורשות הרשאות נוספות ועשויות להיות כרוכות בעלויות נוספות.
מידע נוסף על שאילתות גלובליות זמין במאמר שאילתות גלובליות.
מכסות
מידע על מכסות שקשורות לשאילתות אינטראקטיביות ולשאילתות אצווה זמין במאמר בנושא עבודות של שאילתות.
כדי לפתור בעיות שקשורות למכסות של שאילתות, אפשר לעיין בדף פתרון הבעיות ב-BigQuery. השגיאות הבאות שקשורות למכסת נפח האחסון והמידע לפתרון בעיות שקשורות אליהן קשורות ישירות לשאילתות:
מעקב אחרי שאילתות
אפשר לקבל מידע על שאילתות בזמן שהן מופעלות באמצעות כלי הבדיקה של משימות או באמצעות שאילתה של התצוגה INFORMATION_SCHEMA.JOBS_BY_PROJECT.
סביבת זמן ריצה מתקדמת
סביבת זמן הריצה המתקדמת של BigQuery היא אוסף של שיפורים בביצועים שנועדו להאיץ באופן אוטומטי עומסי עבודה אנליטיים, בלי לדרוש פעולה מצד המשתמש או שינויים בקוד. השאילתות נהנות מאופטימיזציות מתקדמות בזמן ריצה באופן אוטומטי, כשהאופטימיזציות המשופרות של וקטוריזציה או של שאילתות קצרות זמינות.
וקטוריזציה משופרת
ביצוע וקטורי הוא מודל לעיבוד שאילתות שפועל על עמודות של נתונים בבלוקים שתואמים לגודל המטמון של המעבד, ומשתמש בהוראות SIMD (הוראה יחידה, נתונים מרובים). התכונה 'וקטוריזציה משופרת' מרחיבה את הביצוע הווקטורי של שאילתות ב-BigQuery להיבטים הבאים של עיבוד שאילתות:
- באמצעות קידודים מיוחדים של נתונים בפורמט האחסון של Capacitor, אפשר לבצע פעולות של הערכת מסננים על הנתונים המקודדים.
- קידודים מיוחדים מועברים דרך תוכנית לביצוע שאילתה, מה שמאפשר לעבד יותר נתונים בזמן שהם עדיין מקודדים.
- באמצעות הטמעה של קיפול ביטויים להערכת פונקציות דטרמיניסטיות וביטויים קבועים, BigQuery יכול לפשט פרדיקטים מורכבים לערכים קבועים.
אופטימיזציות של שאילתות קצרות
בדרך כלל, BigQuery מריץ שאילתות בסביבה מבוזרת באמצעות שכבת ביניים של ערבוב. אופטימיזציות של שאילתות קצרות מזהות באופן דינמי שאילתות שאפשר להריץ בשלב אחד, וכך מקטינות את זמן האחזור ואת צריכת המשבצות. אפשר להשתמש בקידודים מיוחדים בצורה יעילה יותר כשמריצים שאילתה בשלב אחד. האופטימיזציות האלה יעילות במיוחד כשמשתמשים במצב יצירה אופציונלית של משימות, שמצמצם את זמן האחזור של הפעלת המשימות, התחזוקה ואחזור התוצאות.
הזכאות לאופטימיזציות של שאילתות קצרות היא דינמית ומושפעת מהגורמים הבאים:
- הגודל הצפוי של סריקת הנתונים.
- כמות הנתונים שצריך להעביר.
- הסלקטיביות של מסנני שאילתות.
- הסוג והפריסה הפיזית של הנתונים באחסון.
- המבנה הכולל של השאילתה.
- הנתונים הסטטיסטיים ההיסטוריים של הפעלות קודמות של שאילתות.
הערכת ההשפעה של זמן הריצה המתקדם
כדי להעריך את ההשפעה של סביבת זמן ריצה מתקדמת, אפשר להשתמש בשאילתת SQL הבאה כדי לזהות שאילתות בפרויקט עם השיפור המשוער הגדול ביותר בזמן הביצוע:
WITH
  jobs AS (
    SELECT
      *,
      query_info.query_hashes.normalized_literals AS query_hash,
      TIMESTAMP_DIFF(end_time, start_time, MILLISECOND) AS elapsed_ms,
      EXISTS(
        SELECT 1
        FROM UNNEST(JSON_QUERY_ARRAY(query_info.optimization_details.optimizations)) AS o
        WHERE JSON_VALUE(o, '$.enhanced_vectorization') = 'applied'
      ) AS has_advanced_runtime
    FROM region-LOCATION.INFORMATION_SCHEMA.JOBS_BY_PROJECT
    WHERE EXTRACT(DATE FROM creation_time) > DATE_SUB(CURRENT_DATE(), INTERVAL 30 DAY)
  ),
  most_recent_jobs_without_advanced_runtime AS (
    SELECT *
    FROM jobs
    WHERE NOT has_advanced_runtime
    QUALIFY ROW_NUMBER() OVER (PARTITION BY query_hash ORDER BY end_time DESC) = 1
  )
SELECT
  job.job_id,
  100 * SAFE_DIVIDE(
    original_job.elapsed_ms - job.elapsed_ms,
    original_job.elapsed_ms) AS percent_execution_time_saved,
  job.elapsed_ms AS new_elapsed_ms,
  original_job.elapsed_ms AS original_elapsed_ms,
FROM jobs AS job
INNER JOIN most_recent_jobs_without_advanced_runtime AS original_job
  USING (query_hash)
WHERE
  job.has_advanced_runtime
  AND original_job.end_time < job.start_time
ORDER BY percent_execution_time_saved DESC
LIMIT 10;
מחליפים את מה שכתוב בשדות הבאים:
-
LOCATION: המיקום שבו צריך למדוד את ביצועי המשימה
אם הופעלה סביבת זמן הריצה המתקדמת, התוצאות של השאילתה הזו עשויות להיות דומות לתוצאות הבאות:
/*--------------+----------------------------+----------------+---------------------*
 |    job_id    | percent_elapsed_time_saved | new_elapsed_ms | original_elapsed_ms |
 +--------------+----------------------------+----------------+---------------------+
 | sample_job1  |         45.38834951456311  |            225 |                 412 |
 | sample_job2  |         45.19480519480519  |            211 |                 385 |
 | sample_job3  |         33.246753246753244 |            257 |                 385 |
 | sample_job4  |         29.28802588996764  |           1311 |                1854 |
 | sample_job5  |         28.18181818181818  |           1027 |                1430 |
 | sample_job6  |         25.804195804195807 |           1061 |                1430 |
 | sample_job7  |         25.734265734265733 |           1062 |                1430 |
 | sample_job8  |         25.454545454545453 |           1066 |                1430 |
 | sample_job9  |         25.384615384615383 |           1067 |                1430 |
 | sample_job10 |         25.034965034965033 |           1072 |                1430 |
 *--------------+----------------------------+----------------+---------------------*/
תוצאות השאילתה הזו הן רק אומדן של ההשפעה של זמן הריצה המתקדם. יש הרבה גורמים שיכולים להשפיע על הביצועים של שאילתות, כולל, בין היתר, הזמינות של משבצות, שינויים בנתונים לאורך זמן, הגדרות של תצוגות או פונקציות מוגדרות על ידי המשתמש (UDF), והבדלים בערכים של פרמטרים של שאילתות.
אם התוצאות של השאילתה הזו ריקות, זה אומר שאף עבודה לא השתמשה בזמן ריצה מתקדם, או שכל העבודות עברו אופטימיזציה לפני יותר מ-30 ימים.
אפשר להחיל את השאילתה הזו על מדדי ביצועים אחרים של שאילתות, כמו total_slot_ms ו-total_bytes_billed. מידע נוסף זמין בסכימה של INFORMATION_SCHEMA.JOBS_BY_PROJECT.
המאמרים הבאים
- איך מנהלים עבודות של שאילתות
- איך צופים בהיסטוריית השאילתות
- איך שומרים ומשתפים שאילתות
- מידע על תורים של שאילתות
- איך כותבים תוצאות של שאילתות