


Puoi utilizzare la privacy differenziale con BigQuery per proteggere le informazioni personali nei tuoi dati, continuando a eseguire calcoli e ottenere insight. Questo standard di privacy limita le informazioni personali rivelate dagli output dei dati, aiutandoti a condividere i dati e a fare inferenze sui gruppi senza esporre i singoli individui. La privacy differenziale è particolarmente utile quando esiste il rischio di reidentificazione o quando è necessario quantificare il compromesso tra il rischio per la privacy e l'utilità analitica.
Per i dettagli sulla sintassi, consulta la clausola di privacy differenziale. Per un elenco di funzioni che puoi utilizzare con questa sintassi, consulta Funzioni aggregate con privacy differenziale.
Esempio di caso d'uso per la privacy differenziale
Per comprendere meglio la privacy differenziale, vediamo un semplice esempio.
Questo grafico a barre mostra l'affollamento di un piccolo ristorante in una determinata serata. Molti ospiti arrivano alle 19:00 e il ristorante è completamente vuoto all'01:00:
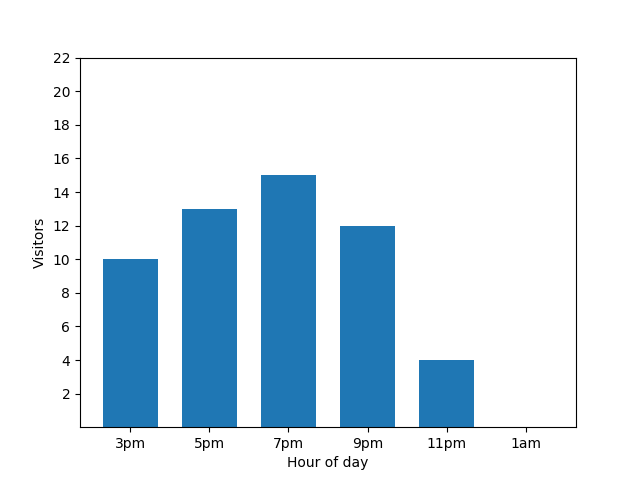
Questo grafico sembra utile, ma c'è un problema. Quando arriva un nuovo ospite, questo fatto viene immediatamente rivelato dal grafico a barre. Nel grafico seguente, è chiaro che c'è un nuovo ospite e che è arrivato intorno all'01:00:
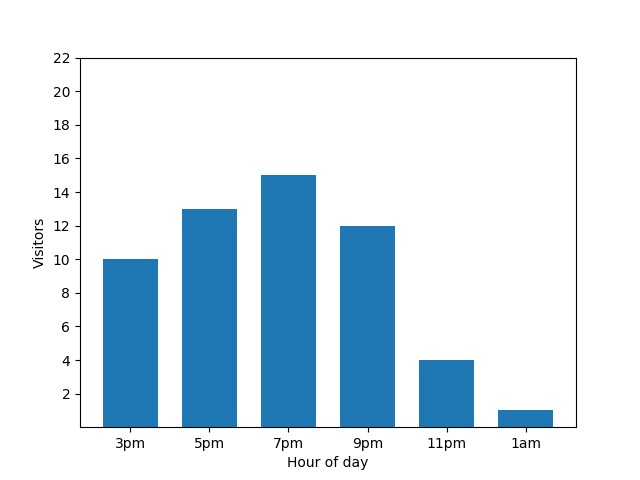
La visualizzazione di questo dettaglio non è ottimale dal punto di vista della privacy, in quanto le statistiche anonimizzate non dovrebbero rivelare i contributi individuali. Se mettiamo i due grafici uno accanto all'altro, la differenza è ancora più evidente: il grafico a barre arancione ha un ospite in più che è arrivato intorno all'1:00:
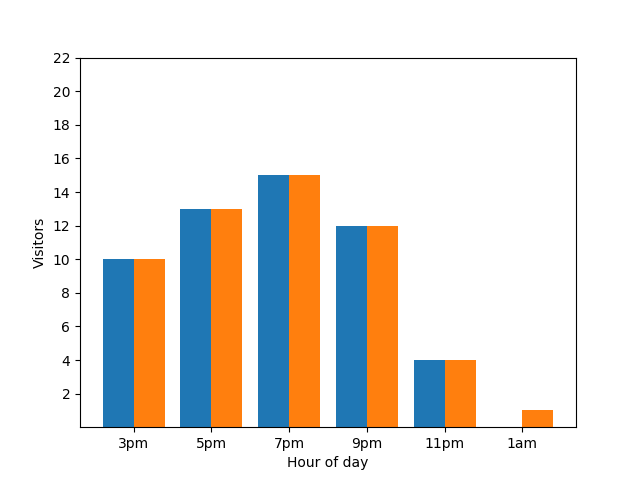
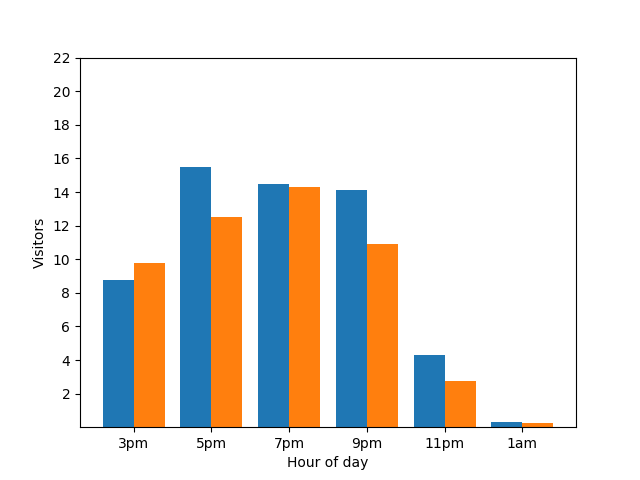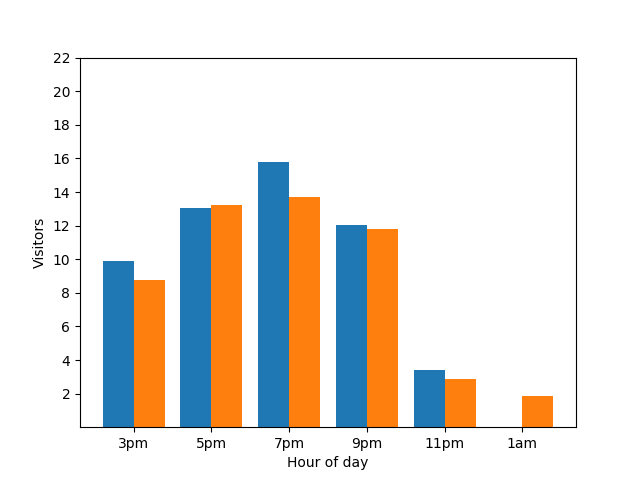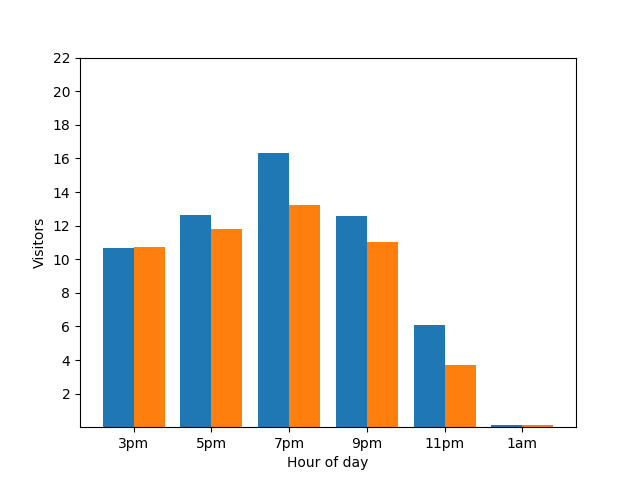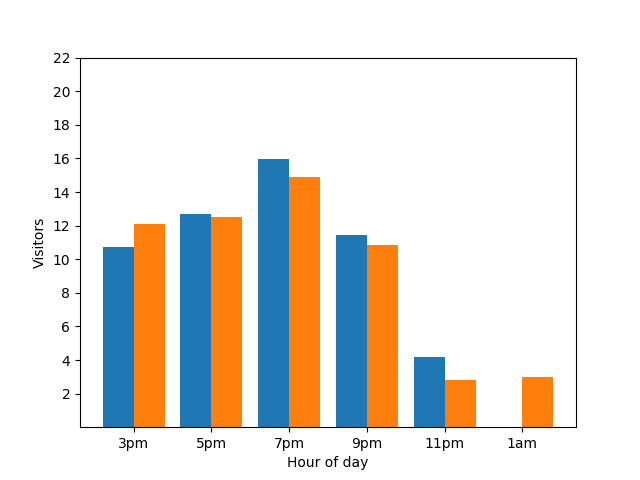
Anche in questo caso, non è il massimo. Per evitare questo tipo di problema di privacy, puoi aggiungere un rumore casuale ai grafici a barre utilizzando la privacy differenziale. Nel seguente grafico di confronto, i risultati sono anonimizzati e non rivelano più i contributi individuali.
Come funziona la privacy differenziale per le query
L'obiettivo della privacy differenziale è mitigare il rischio di divulgazione, ovvero il rischio che qualcuno possa ottenere informazioni su un'entità in un set di dati. La privacy differenziale bilancia la necessità di salvaguardare la privacy con quella di un'utilità analitica statistica. All'aumentare della privacy, l'utilità dell'analisi statistica diminuisce e viceversa.
Con GoogleSQL per BigQuery, puoi trasformare i risultati di una query con aggregazioni con privacy differenziale. Quando viene eseguita, la query esegue le seguenti operazioni:
- Calcola le aggregazioni per entità per ogni gruppo se i gruppi sono specificati con una clausola
GROUP BY. Limita il numero di gruppi a cui ogni entità può contribuire, in base al parametro di privacy differenzialemax_groups_contributed. - Blocca ogni contributo aggregato per entità in modo che rientri nei limiti di blocco. Se i limiti di blocco non sono specificati, vengono calcolati implicitamente in modo da garantire la privacy differenziale.
- Aggrega i contributi aggregati bloccati per entità per ogni gruppo.
- Aggiunge rumore al valore aggregato finale per ogni gruppo. La portata del rumore casuale è una funzione di tutti i limiti fissati e dei parametri di privacy.
- Calcola un conteggio delle entità con rumore per ogni gruppo ed elimina i gruppi con poche entità. Un conteggio delle entità con rumore aiuta a eliminare un insieme non deterministico di gruppi.
Il risultato finale è un set di dati in cui ogni gruppo dispone di risultati aggregati sul rumore, mentre i gruppi piccoli vengono eliminati.
Per ulteriori informazioni sulla privacy differenziale e sui relativi casi d'uso, consulta i seguenti articoli:
- Un'introduzione semplice e non tecnica alla privacy differenziale
- SQL con privacy differenziale e contributo utente limitato
- Privacy differenziale su Wikipedia
Generare una query con privacy differenziale valida
Perché la query con privacy differenziale sia valida, devono essere soddisfatte le seguenti regole:
- È definita una colonna unità privacy.
- L'elenco
SELECTcontiene una clausola di privacy differenziale. - Solo le funzioni aggregate con privacy differenziale sono presenti nell'elenco
SELECTcon la clausola di privacy differenziale.
Definisci una colonna unità privacy
Un'unità di privacy è l'entità di un set di dati che viene protetta utilizzando la privacy differenziale. Un'entità può essere un privato, un'azienda, una località o qualsiasi colonna scelta.
Una query con privacy differenziale deve includere una e una sola colonna unità privacy. Una colonna unità privacy è un identificatore univoco di un'unità privacy e può esistere all'interno di più gruppi. Poiché sono supportati più gruppi, il tipo di dati della colonna unità privacy deve essere raggruppabile.
Puoi definire una colonna unità privacy nella clausola OPTIONS di una clausola di privacy differenziale con l'identificatore univoco privacy_unit_column.
Negli esempi seguenti, una colonna unità privacy viene aggiunta a una clausola di privacy differenziale. id rappresenta una colonna che proviene da una tabella denominata students.
SELECT WITH DIFFERENTIAL_PRIVACY
  OPTIONS (epsilon=10, delta=.01, privacy_unit_column=id)
  item,
  COUNT(*, contribution_bounds_per_group=>(0, 100))
FROM students;
SELECT WITH DIFFERENTIAL_PRIVACY
  OPTIONS (epsilon=10, delta=.01, privacy_unit_column=members.id)
  item,
  COUNT(*, contribution_bounds_per_group=>(0, 100))
FROM (SELECT * FROM students) AS members;
Rimuovi il rumore da una query con privacy differenziale
Nella sezione "Sintassi delle query", consulta Rimuovi rumore.
Aggiungi rumore a una query con privacy differenziale
Nella sezione "Sintassi delle query", consulta Aggiungi rumore.
Limita i gruppi in cui può esistere un ID unità di privacy
Nel riferimento "Sintassi delle query", consulta Limita i gruppi in cui può esistere un ID unità di privacy.
Limitazioni
Questa sezione descrive le limitazioni della privacy differenziale.
Implicazioni della privacy differenziale sulle prestazioni
Le query con privacy differenziale vengono eseguite più lentamente rispetto alle query standard perché viene eseguita l'aggregazione per entità e viene applicata la limitazione max_groups_contributed. La limitazione dei limiti di contributo può contribuire a migliorare le prestazioni delle query con privacy differenziale.
I profili di prestazioni delle seguenti query non sono simili:
SELECT
  WITH DIFFERENTIAL_PRIVACY OPTIONS(epsilon=1, delta=1e-10, privacy_unit_column=id)
  column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
SELECT column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
La differenza di prestazioni è dovuta al fatto che per le query con privacy differenziale viene eseguito un ulteriore livello di raggruppamento con granularità più fine, poiché deve essere eseguita anche l'aggregazione per entità.
I profili di prestazioni delle seguenti query dovrebbero essere simili, anche se la query con privacy differenziale è leggermente più lenta:
SELECT
  WITH DIFFERENTIAL_PRIVACY OPTIONS(epsilon=1, delta=1e-10, privacy_unit_column=id)
  column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
SELECT column_a, id, COUNT(column_b)
FROM table_a
GROUP BY column_a, id;
La query con privacy differenziale viene eseguita più lentamente perché contiene un numero elevato di valori distinti per la colonna dell'unità di privacy.
Limitazioni implicite dei limiti per set di dati di piccole dimensioni
La delimitazione implicita funziona meglio se calcolata utilizzando set di dati di grandi dimensioni. La limitazione implicita può non riuscire con set di dati che contengono un numero ridotto di unità di privacy, senza restituire risultati. Inoltre, la limitazione implicita su un set di dati con un numero ridotto di unità di privacy può limitare una gran parte dei non outlier, causando aggregazioni sottostimate e risultati alterati più dalla limitazione che dal rumore aggiunto. I set di dati che hanno un numero ridotto di unità di privacy o sono partizionati in modo limitato devono utilizzare il clamping esplicito anziché quello implicito.
Vulnerabilità di privacy
Qualsiasi algoritmo di privacy differenziale, incluso questo, comporta il rischio di una fuga di dati privati quando un analista agisce in malafede, soprattutto quando calcola statistiche di base come le somme, a causa di limitazioni aritmetiche.
Limitazioni alle garanzie sulla privacy
Sebbene la privacy differenziale di BigQuery applichi l'algoritmo di privacy differenziale, non garantisce le proprietà di privacy del set di dati risultante.
Errori di runtime
Un analista che agisce in malafede con la possibilità di scrivere query o controllare i dati di input potrebbe attivare un errore di runtime sui dati privati.
Rumore della virgola mobile
Prima di utilizzare la privacy differenziale, è necessario considerare le vulnerabilità relative agli attacchi di arrotondamento, arrotondamento ripetuto e riordinamento. Queste vulnerabilità sono particolarmente preoccupanti quando un malintenzionato può controllare alcuni dei contenuti di un set di dati o l'ordine dei contenuti in un set di dati.
Le aggiunte di rumore con privacy differenziale sui tipi di dati in rappresentazione in virgola mobile sono soggette alle vulnerabilità descritte in Widespread Underestimation of Sensitivity in Differentially Private Libraries and Come risolvere il problema. Le aggiunte di rumore ai tipi di dati interi non sono soggette alle vulnerabilità descritte nel documento.
Rischi di attacchi di sincronizzazione
Un analista che agisce in malafede potrebbe eseguire una query sufficientemente complessa per fare un'inferenza sui dati di input in base alla durata di esecuzione di una query.
Classificazione errata
La creazione di una query di privacy differenziale presuppone che i dati siano in una struttura ben nota e compresa. Se applichi la privacy differenziale agli identificatori sbagliati, ad esempio uno che rappresenta un ID transazione anziché l'ID di un individuo, potresti esporre dati sensibili.
Se hai bisogno di aiuto per comprendere i tuoi dati, valuta la possibilità di utilizzare servizi e strumenti come i seguenti:
Prezzi
L'utilizzo della privacy differenziale non comporta costi aggiuntivi, ma si applicano i prezzi di BigQuery standard per l'analisi.