Visualiza gráficos con BigQuery DataFrames

Puedes usar la biblioteca de visualización de BigQuery DataFrames para trazar varios tipos de gráficos y explorar y comprender tus datos de forma visual. La API de bigframes.pandas te permite combinar sin problemas operaciones estadísticas avanzadas con herramientas de trazado de Python conocidas, incluido el muestreo integrado para conjuntos de datos grandes.

Histograma

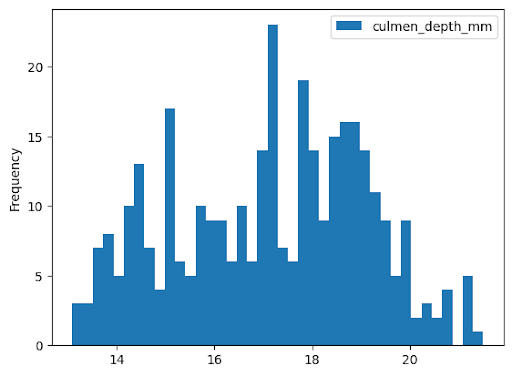
En el siguiente ejemplo, se leen datos de la tabla bigquery-public-data.ml_datasets.penguins para trazar un histograma sobre la distribución de las profundidades del culmen de los pingüinos:
import bigframes.pandas as bpd

penguins = bpd.read_gbq("bigquery-public-data.ml_datasets.penguins")
penguins["culmen_depth_mm"].plot.hist(bins=40)

Ejemplo de un histograma en BigQuery DataFrames.

Gráfico de líneas

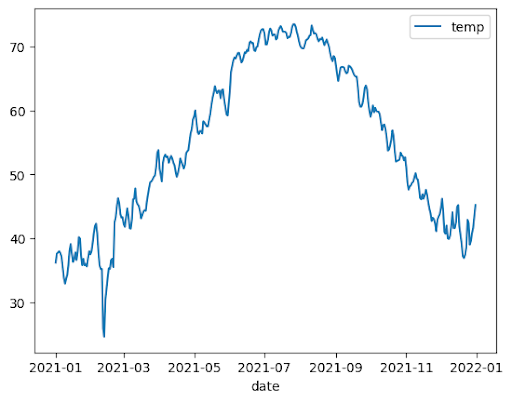
En el siguiente ejemplo, se usan datos de la tabla bigquery-public-data.noaa_gsod.gsod2021 para trazar un gráfico de líneas de los cambios de temperatura mediana durante el año:
import bigframes.pandas as bpd

noaa_surface = bpd.read_gbq("bigquery-public-data.noaa_gsod.gsod2021")

# Calculate median temperature for each day
noaa_surface_median_temps = noaa_surface[["date", "temp"]].groupby("date").median()

noaa_surface_median_temps.plot.line()

Ejemplo de un gráfico de líneas en BigQuery DataFrames.

Gráfico de áreas

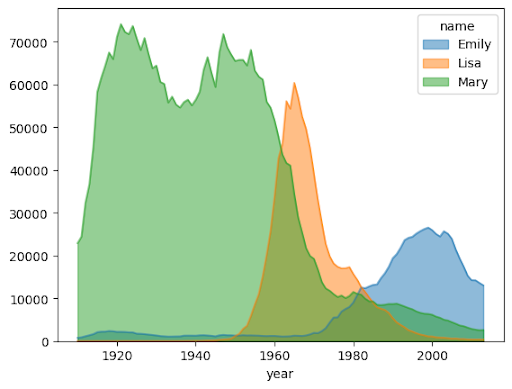
En el siguiente ejemplo, se usa la tabla bigquery-public-data.usa_names.usa_1910_2013 para hacer un seguimiento de la popularidad de los nombres en la historia de EE.UU. y se enfoca en los nombres Mary, Emily y Lisa:
import bigframes.pandas as bpd

usa_names = bpd.read_gbq("bigquery-public-data.usa_names.usa_1910_2013")

# Count the occurences of the target names each year. The result is a dataframe with a multi-index.
name_counts = (
    usa_names[usa_names["name"].isin(("Mary", "Emily", "Lisa"))]
    .groupby(("year", "name"))["number"]
    .sum()
)

# Flatten the index of the dataframe so that the counts for each name has their own columns.
name_counts = name_counts.unstack(level=1).fillna(0)

name_counts.plot.area(stacked=False, alpha=0.5)

Ejemplo de un gráfico de áreas en BigQuery DataFrames.

Gráfico de barras

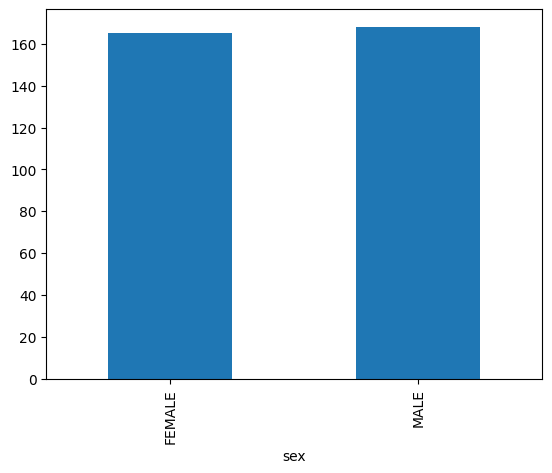
En el siguiente ejemplo, se usa la tabla bigquery-public-data.ml_datasets.penguins para visualizar la distribución de los sexos de los pingüinos:
import bigframes.pandas as bpd

penguins = bpd.read_gbq("bigquery-public-data.ml_datasets.penguins")

penguin_count_by_sex = (
    penguins[penguins["sex"].isin(("MALE", "FEMALE"))]
    .groupby("sex")["species"]
    .count()
)
penguin_count_by_sex.plot.bar()

Ejemplo de un gráfico de barras en BigQuery DataFrames.

Diagrama de dispersión

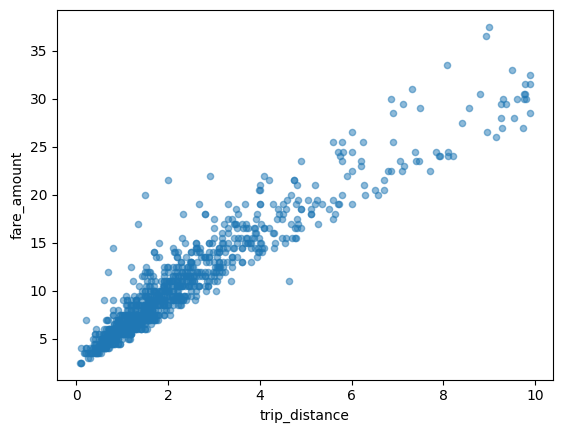
En el siguiente ejemplo, se usa la tabla bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021 para explorar la relación entre los importes de las tarifas de taxi y las distancias de los viajes:
import bigframes.pandas as bpd

taxi_trips = bpd.read_gbq(
    "bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021"
).dropna()

# Data Cleaning
taxi_trips = taxi_trips[
    taxi_trips["trip_distance"].between(0, 10, inclusive="right")
]
taxi_trips = taxi_trips[taxi_trips["fare_amount"].between(0, 50, inclusive="right")]

# If you are using partial ordering mode, you will also need to assign an order to your dataset.
# Otherwise, the next line can be skipped.
taxi_trips = taxi_trips.sort_values("pickup_datetime")

taxi_trips.plot.scatter(x="trip_distance", y="fare_amount", alpha=0.5)

Ejemplo de un diagrama de dispersión en BigQuery DataFrames.

Visualiza un conjunto de datos grande

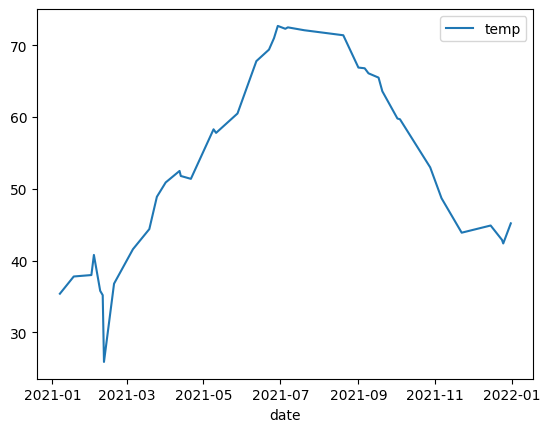
BigQuery DataFrames descarga datos en tu máquina local para visualizarlos. La cantidad de datos que se descargarán tiene un límite predeterminado de 1,000. Si la cantidad de datos supera el límite, BigQuery DataFrames muestra de forma aleatoria la cantidad de datos igual al límite.

Puedes anular este límite configurando el parámetro sampling_n cuando trazas un gráfico, como se muestra en el siguiente ejemplo:
import bigframes.pandas as bpd

noaa_surface = bpd.read_gbq("bigquery-public-data.noaa_gsod.gsod2021")

# Calculate median temperature for each day
noaa_surface_median_temps = noaa_surface[["date", "temp"]].groupby("date").median()

noaa_surface_median_temps.plot.line(sampling_n=40)

Ejemplo de un gráfico de líneas que visualiza un conjunto de datos grande en BigQuery DataFrames.

Trazado avanzado con parámetros de pandas y Matplotlib

Puedes pasar más parámetros para ajustar tu gráfico, como puedes hacerlo con pandas, ya que la biblioteca de trazado de BigQuery DataFrames funciona con pandas y Matplotlib. En las siguientes secciones, se describen algunos ejemplos.

Tendencia de popularidad de nombres con diagramas secundarios

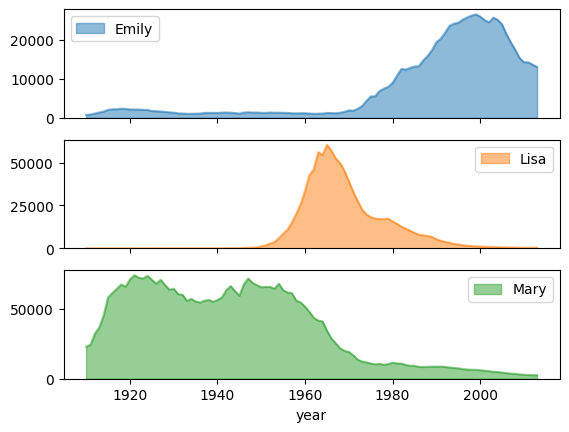
Con los datos del historial de nombres del ejemplo de gráfico de áreas, en el siguiente ejemplo, se crean gráficos individuales para cada nombre configurando subplots=True en la llamada a función plot.area():
import bigframes.pandas as bpd

usa_names = bpd.read_gbq("bigquery-public-data.usa_names.usa_1910_2013")

# Count the occurences of the target names each year. The result is a dataframe with a multi-index.
name_counts = (
    usa_names[usa_names["name"].isin(("Mary", "Emily", "Lisa"))]
    .groupby(("year", "name"))["number"]
    .sum()
)

# Flatten the index of the dataframe so that the counts for each name has their own columns.
name_counts = name_counts.unstack(level=1).fillna(0)

name_counts.plot.area(subplots=True, alpha=0.5)

Ejemplo de gráficos individuales con diagramas secundarios en BigQuery DataFrames.

Diagrama de dispersión de viajes en taxi con varias dimensiones

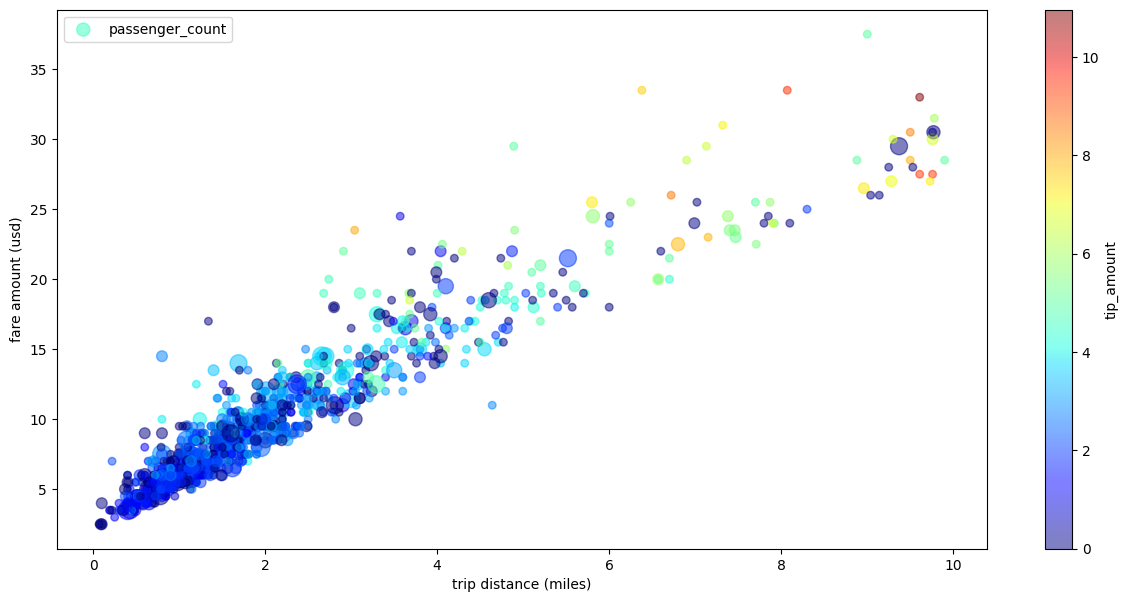
Con los datos del ejemplo de diagrama de dispersión, en el siguiente ejemplo, se cambian los nombres de las etiquetas de los ejes X e Y, se usa el parámetro passenger_count para los tamaños de los puntos, se usan puntos de color con el parámetro tip_amount y se cambia el tamaño de la figura:
import bigframes.pandas as bpd

taxi_trips = bpd.read_gbq(
    "bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2021"
).dropna()

# Data Cleaning
taxi_trips = taxi_trips[
    taxi_trips["trip_distance"].between(0, 10, inclusive="right")
]
taxi_trips = taxi_trips[taxi_trips["fare_amount"].between(0, 50, inclusive="right")]

# If you are using partial ordering mode, you also need to assign an order to your dataset.
# Otherwise, the next line can be skipped.
taxi_trips = taxi_trips.sort_values("pickup_datetime")

taxi_trips["passenger_count_scaled"] = taxi_trips["passenger_count"] * 30

taxi_trips.plot.scatter(
    x="trip_distance",
    xlabel="trip distance (miles)",
    y="fare_amount",
    ylabel="fare amount (usd)",
    alpha=0.5,
    s="passenger_count_scaled",
    label="passenger_count",
    c="tip_amount",
    cmap="jet",
    colorbar=True,
    legend=True,
    figsize=(15, 7),
    sampling_n=1000,
)

Ejemplo de diagrama de dispersión con varias dimensiones en BigQuery DataFrames.

¿Qué sigue?