


Usar BigQuery DataFrames no dbt
Para executar transformações de dados modulares do Python diretamente no
BigQuery, integre os BigQuery DataFrames à
ferramenta de criação de dados (dbt) de código aberto.
Usar o adaptador dbt-bigquery
para executar modelos do Python permite
realizar transformações complexas de extração, carregamento e transformação (ELT) que são
ineficientes para expressar em SQL, enquanto ainda se beneficia da robusta
orquestração, gerenciamento de dependências e recursos de teste do dbt.
Visão geral do dbt
O dbt é um framework de linha de comando de código aberto projetado para transformação de dados em data warehouses modernos. O dbt facilita transformações de dados modulares com a criação de modelos reutilizáveis baseados em SQL e Python. A ferramenta orquestra a execução dessas transformações no data warehouse de destino, com foco na etapa de transformação do pipeline de ELT. Para mais informações, consulte a documentação do dbt.
No dbt, um modelo do Python é uma transformação de dados definida e executada usando o código Python no projeto do dbt. Em vez de escrever SQL para a lógica de transformação, você escreve scripts Python que o dbt orquestra para serem executados no ambiente do data warehouse. Com um modelo em Python, é possível realizar transformações de dados que podem ser complexas ou ineficientes para expressar em SQL. Isso aproveita os recursos do Python e, ao mesmo tempo, se beneficia da estrutura do projeto, da orquestração, do gerenciamento de dependências, dos testes e dos recursos de documentação do dbt. Para mais informações, consulte Modelos do Python.
O adaptador dbt-bigquery oferece suporte à execução de código Python definido em BigQuery DataFrames. Esse recurso está disponível no
dbt Cloud e no
dbt Core.
Antes de começar
Para usar o adaptador dbt-bigquery, ative as seguintes APIs no seu projeto:
- API BigQuery (
bigquery.googleapis.com) - API Cloud Storage (
storage.googleapis.com) - API Compute Engine (
compute.googleapis.com) - API Dataform (
dataform.googleapis.com) - API Identity and Access Management (
iam.googleapis.com) - API Vertex AI (
aiplatform.googleapis.com)
Funções necessárias para ativar APIs
Para ativar APIs, você precisa da permissão serviceusage.services.enable. Se você
criou o projeto, provavelmente já tem essa permissão pelo
papel de proprietário (roles/owner). Caso contrário, é possível conseguir essa permissão pelo
papel de administrador do Service Usage (roles/serviceusage.serviceUsageAdmin).
Saiba como conceder papéis.
Funções exigidas
O adaptador dbt-bigquery é compatível com a autenticação baseada em OAuth e em conta de serviço. As seções a seguir descrevem os papéis necessários, dependendo de
como você planeja fazer a autenticação.
OAuth
Se você planeja se autenticar no adaptador do dbt-bigquery usando o OAuth, peça ao
administrador para conceder a você os seguintes papéis:
- Papel de usuário do BigQuery
(
roles/bigquery.user) no projeto - Papel de Editor de dados do BigQuery
(
roles/bigquery.dataEditor) no projeto ou no conjunto de dados em que as tabelas são salvas - Papel de usuário corporativo do Colab Enterprise
(
roles/colabEnterprise.user) no projeto - Papel de administrador do Storage
(
roles/storage.admin) no bucket do Cloud Storage de preparo para código e registros de preparo
Conta de serviço
Se você planeja se autenticar no adaptador do dbt-bigquery usando uma conta de serviço no seu projeto, peça ao administrador para conceder os seguintes papéis à conta de serviço que você planeja usar:
- Papel de usuário do BigQuery
(
roles/bigquery.user) - Papel de editor de dados do BigQuery
(
roles/bigquery.dataEditor) - Papel de usuário corporativo do Colab Enterprise
(
roles/colabEnterprise.user) - Papel de administrador do Storage
(
roles/storage.admin)
Se você estiver se autenticando com uma conta de serviço, verifique também se tem o
papel de usuário da conta de serviço
(roles/iam.serviceAccountUser) concedido para a conta de serviço que planeja usar.
Identidade temporária de conta de serviço
Se você planeja se autenticar no adaptador do dbt-bigquery usando o OAuth, mas quer que o tratamento de dados e a execução do notebook ocorram sob a identidade de uma conta de serviço no mesmo projeto em que os jobs são executados, peça ao administrador para conceder a você os seguintes papéis:
- Papel Criador de token da conta de serviço
(
roles/iam.serviceAccountTokenCreator) - Usuário da conta de serviço
(
roles/iam.serviceAccountUser)
A conta de serviço representada também precisa ter todos os papéis necessários para autenticação.
Contas de serviço de projetos cruzados
Se você planeja se autenticar no adaptador do dbt-bigquery usando uma conta de serviço em um projeto diferente, o projeto de credencial, de onde os jobs são executados, o projeto de execução, peça ao administrador para fazer o seguinte:
- Desative a restrição
constraints/iam.disableCrossProjectServiceAccountUsageno projeto de credencial. Além de todos os papéis necessários para a autenticação da conta de serviço, conceda os seguintes papéis à conta de serviço no projeto de credencial:
- Papel de agente de serviço da Vertex AI
(roles/aiplatform.serviceAgent) para
service-PROJECT_NUMBER@gcp-sa-aiplatform.iam.gserviceaccount.com - Papel de agente de serviço do Vertex AI Colab
(roles/aiplatform.colabServiceAgent) para
service-PROJECT_NUMBER@gcp-sa-vertex-nb.iam.gserviceaccount.com - Papel de agente de serviço do Compute Engine
(roles/compute.serviceAgent) para
service-PROJECT_NUMBER@compute-system.iam.gserviceaccount.com
- Papel de agente de serviço da Vertex AI
(roles/aiplatform.serviceAgent) para
Se você planeja se autenticar no adaptador do dbt-bigquery usando o OAuth, mas quer que o tratamento de dados e a execução do notebook ocorram com a identidade de uma conta de serviço em um projeto diferente daquele em que os jobs são executados, peça ao administrador para fazer o seguinte:
- Siga as etapas descritas anteriormente para contas de serviço entre projetos para a conta de serviço em outro projeto.
- Conceda a você e à conta de serviço os papéis necessários para a identidade temporária de conta de serviço.
VPC compartilhada
Se você estiver usando o Colab Enterprise em um ambiente de VPC compartilhada, peça ao administrador para conceder os seguintes papéis e permissões:
Permissão
compute.subnetworks.use: conceda essa permissão à conta de serviço usada pelo ambiente de execução do Colab Enterprise no projeto host ou em sub-redes específicas. Essa permissão está incluída no papel de usuário de rede do Compute (roles/compute.networkUser).Permissão
compute.subnetworks.get: conceda essa permissão à conta de serviço usada pelo ambiente de execução do Colab Enterprise no projeto host ou em sub-redes específicas. Essa permissão está incluída no papel de Leitor da rede do Compute (roles/compute.networkViewer).Papel de usuário da rede do Compute (
roles/compute.networkUser): conceda esse papel ao agente de serviço da Gemini Enterprise Agent Platform,service-PROJECT_NUMBER@gcp-sa-aiplatform.iam.gserviceaccount.com, no projeto host da VPC compartilhada.Papel de usuário da rede do Compute (
roles/compute.networkUser): se o recurso de job de execução de notebook estiver sendo usado, conceda esse papel ao agente de serviço do Colab Enterprise,service-PROJECT_NUMBER@gcp-sa-vertex-nb.iam.gserviceaccount.com, no projeto host da VPC compartilhada.
Para mais informações sobre a concessão de papéis, consulte Gerenciar o acesso a projetos, pastas e organizações.
Também é possível conseguir as permissões necessárias via papéis personalizados ou outros papéis predefinidos.
Ambiente de execução do Python
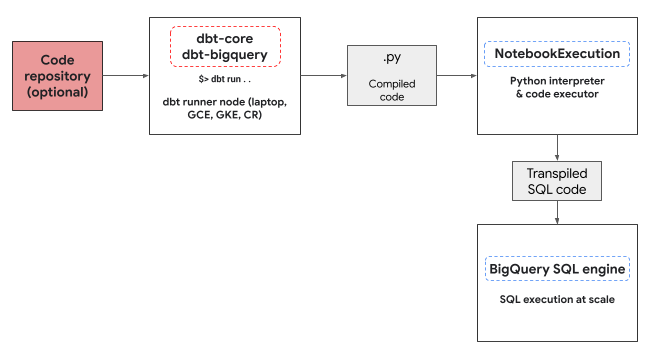
O adaptador dbt-bigquery usa o
serviço executor de notebooks do Colab Enterprise
para executar o código Python do BigQuery DataFrames. Um notebook do Colab Enterprise é criado e executado automaticamente pelo adaptador dbt-bigquery para cada modelo do Python. É possível escolher o
projeto doGoogle Cloud para executar o notebook. O notebook executa o código Python
do modelo, que é convertido em SQL do BigQuery pela
biblioteca BigQuery DataFrames. O SQL do BigQuery é executado
no projeto configurado. O diagrama a seguir apresenta o fluxo de
controle:
Se não houver um modelo de notebook disponível no projeto e o usuário
que executa o código tiver as permissões para criar o modelo, o adaptador dbt-bigquery
vai criar e usar automaticamente o modelo de notebook padrão. Também é possível especificar um modelo de notebook diferente usando uma configuração do dbt.
A execução do notebook requer um bucket do Cloud Storage de preparo para armazenar o código e os registros. No entanto, o adaptador dbt-bigquery copia os registros para os
registros do dbt, então você não precisa
procurar no bucket.
Recursos compatíveis
O adaptador dbt-bigquery oferece suporte aos seguintes recursos para modelos dbt Python
que executam BigQuery DataFrames:
- Carregar dados de uma tabela do BigQuery com a macro
dbt.source(). - Carregar dados de outros modelos do dbt com a macro
dbt.ref()para criar dependências e gráficos acíclicos dirigidos (DAGs) com modelos do Python. - Especificar e usar pacotes Python do PyPi que podem ser usados com a execução de código Python. Para mais informações, consulte Configurações.
- Especificar um modelo de ambiente de execução de notebook personalizado para seus modelos do BigQuery DataFrames.
O adaptador dbt-bigquery é compatível com as seguintes estratégias de materialização:
- Materialização de tabela, em que os dados são recriados como uma tabela em cada execução.
- Materialização incremental com uma estratégia de mesclagem, em que dados novos ou atualizados são adicionados a uma tabela, geralmente usando uma estratégia de mesclagem para lidar com mudanças.
Configurar o dbt para usar o BigQuery DataFrames
Se você estiver usando o
dbt Core,
precisará usar um arquivo profiles.yml para uso com o BigQuery DataFrames.
O exemplo a seguir usa o método oauth:
your_project_name:
  outputs:
    dev:
      compute_region: us-central1
      dataset: your_bq_dateset
      gcs_bucket: your_gcs_bucket
      job_execution_timeout_seconds: 300
      job_retries: 1
      location: US
      method: oauth
      priority: interactive
      project: your_gcp_project
      threads: 1
      type: bigquery
  target: dev
Se você estiver usando o
dbt Cloud,
poderá
se conectar à sua plataforma de dados
diretamente na interface do dbt Cloud. Nesse cenário, você não precisa de um arquivo profiles.yml. Para mais informações, consulte
Sobre profiles.yml.
Este é um exemplo de configuração para envolvidos no projeto para o arquivo
dbt_project.yml:
# Name your project! Project names should contain only lowercase characters
# and underscores. A good package name should reflect your organization's
# name or the intended use of these models.
name: 'your_project_name'
version: '1.0.0'

# Configuring models
# Full documentation: https://docs.getdbt.com/docs/configuring-models

# In this example config, we tell dbt to build all models in the example/
# directory as views. These settings can be overridden in the individual model
# files using the config(...) macro.

models:
  your_project_name:
    submission_method: bigframes
    notebook_template_id: 7018811640745295872
    packages: ["scikit-learn", "mlflow"]
    timeout: 3000
    # Config indicated by + and applies to all files under models/example/
    example:
      +materialized: view
Alguns parâmetros também podem ser configurados usando o método dbt.config
no código Python. Se essas configurações entrarem em conflito com o arquivo
dbt_project.yml, as configurações com dbt.config terão
prioridade.
Para mais informações, consulte Configurações de modelo e dbt_project.yml.
Configurações
É possível definir as configurações a seguir usando o método dbt.config no modelo do Python. Essas configurações substituem as configurações para envolvidos no projeto.
| Configuração | Obrigatório | Uso |
|---|---|---|
submission_method |
Sim | submission_method=bigframes |
notebook_template_id |
Não | Se não for especificado, um modelo padrão será criado e usado. |
packages |
Não | Especifique a lista adicional de pacotes do Python, se necessário. |
timeout |
Não | Opcional: aumente o tempo limite de execução do job. |
Exemplos de modelos do Python
As seções a seguir apresentam exemplos de cenários e modelos em Python.
Carregar dados de uma tabela do BigQuery
Para usar dados de uma tabela do BigQuery como fonte no seu modelo do Python, primeiro defina essa fonte em um arquivo YAML. O exemplo a seguir é definido em um arquivo source.yml.
version: 2

sources:
  - name: my_project_source   # A custom name for this source group
    database: bigframes-dev   # Your Google Cloud project ID
    schema: yyy_test_us       # The BigQuery dataset containing the table
    tables:
      - name: dev_sql1        # The name of your BigQuery table
Em seguida, crie o modelo do Python, que pode usar as fontes de dados configuradas neste arquivo YAML:
def model(dbt, session):
    # Configure the model to use BigFrames for submission
    dbt.config(submission_method="bigframes")

    # Load data from the 'dev_sql1' table within 'my_project_source'
    source_data = dbt.source('my_project_source', 'dev_sql1')

    # Example transformation: Create a new column 'id_new'
    source_data['id_new'] = source_data['id'] * 10

    return source_data
Como referenciar outro modelo
É possível criar modelos que dependem da saída de outros modelos do dbt, conforme mostrado no exemplo a seguir. Isso é útil para criar pipelines de dados modulares.
def model(dbt, session):
    # Configure the model to use BigFrames
    dbt.config(submission_method="bigframes")

    # Reference another dbt model named 'dev_sql1'.
    # It assumes you have a model defined in 'dev_sql1.sql' or 'dev_sql1.py'.
    df_from_sql = dbt.ref("dev_sql1")

    # Example transformation on the data from the referenced model
    df_from_sql['id'] = df_from_sql['id'] * 100

    return df_from_sql
Como especificar uma dependência de pacote
Se o modelo do Python exigir bibliotecas de terceiros específicas, como MLflow ou Boto3, declare o pacote na configuração do modelo, conforme mostrado no exemplo a seguir. Esses pacotes são instalados no ambiente de execução.
def model(dbt, session):
    # Configure the model for BigFrames and specify required packages
    dbt.config(
        submission_method="bigframes",
        packages=["mlflow", "boto3"]  # List the packages your model needs
    )

    # Import the specified packages for use in your model
    import mlflow
    import boto3

    # Example: Create a DataFrame showing the versions of the imported packages
    data = {
        "mlflow_version": [mlflow.__version__],
        "boto3_version": [boto3.__version__],
        "note": ["This demonstrates accessing package versions after import."]
    }
    bdf = bpd.DataFrame(data)

    return bdf
Como especificar um modelo não padrão
Para ter mais controle sobre o ambiente de execução ou usar configurações pré-configuradas, especifique um modelo de notebook não padrão para o modelo do BigQuery DataFrames, conforme mostrado no exemplo a seguir.
def model(dbt, session):
    dbt.config(
        submission_method="bigframes",
     # ID of your pre-created notebook template
        notebook_template_id="857350349023451yyyy",
    )

    data = {"int": [1, 2, 3], "str": ['a', 'b', 'c']}
    return bpd.DataFrame(data=data)
Materializar as tabelas
Quando o dbt executa seus modelos do Python, ele precisa saber como salvar os resultados no data warehouse. Isso é chamado de materialização.
Para a materialização de tabelas padrão, o dbt cria ou substitui totalmente uma tabela no
seu warehouse pela saída do modelo sempre que ele é executado. Isso é feito
por padrão ou definindo explicitamente a propriedade materialized='table', como
mostrado no exemplo a seguir.
def model(dbt, session):
    dbt.config(
        submission_method="bigframes",
     # Instructs dbt to create/replace this model as a table
        materialized='table',
    )

    data = {"int_column": [1, 2], "str_column": ['a', 'b']}
    return bpd.DataFrame(data=data)
A materialização incremental com uma estratégia de mesclagem permite que o dbt atualize sua tabela apenas com linhas novas ou modificadas. Isso é útil para grandes conjuntos de dados, porque recriar completamente uma tabela todas as vezes pode ser ineficiente. A estratégia de mesclagem é uma maneira comum de lidar com essas atualizações.
Essa abordagem integra as mudanças de forma inteligente, fazendo o seguinte:
- Atualizar as linhas atuais que foram alteradas.
- Adicionar novas linhas.
- Opcional, dependendo da configuração: excluir linhas que não estão mais presentes na origem.
Para usar a estratégia de mesclagem, é preciso especificar uma propriedade unique_key que o dbt possa usar para identificar as linhas correspondentes entre a saída do modelo e a tabela atual, conforme mostrado no exemplo a seguir.
def model(dbt, session):
    dbt.config(
        submission_method="bigframes",
        materialized='incremental',
        incremental_strategy='merge',
        unique_key='int',  # Specifies the column to identify unique rows
    )

    # In this example:
    # - Row with 'int' value 1 remains unchanged.
    # - Row with 'int' value 2 has been updated.
    # - Row with 'int' value 4 is a new addition.
    # The 'merge' strategy will ensure that only the updated row ('int 2')
    # and the new row ('int 4') are processed and integrated into the table.
    data = {"int": [1, 2, 4], "str": ['a', 'bbbb', 'd']}
    return bpd.DataFrame(data=data)
Solução de problemas
É possível observar a execução do Python nos registros do dbt.
Além disso, é possível conferir o código e os registros (incluindo execuções anteriores) na página Execuções do Colab Enterprise.
Acessar as execuções do Colab Enterprise
Faturamento
Ao usar o adaptador dbt-bigquery com o BigQuery DataFrames,
há cobranças do Google Cloud por:
Execução do notebook: você é cobrado pela execução do ambiente de execução do notebook. Para mais informações, consulte Preços do ambiente de execução do notebook.
Execução de consultas do BigQuery: no notebook, os BigQuery DataFrames convertem Python em SQL e executam o código no BigQuery. As cobranças são feitas de acordo com a configuração do projeto e a consulta, conforme descrito nos preços do BigQuery DataFrames.
Use o seguinte rótulo de faturamento no console de faturamento do BigQuery para filtrar o relatório de faturamento da execução de notebooks e das execuções do BigQuery acionadas pelo adaptador dbt-bigquery:
- Rótulo de execução do BigQuery:
bigframes-dbt-api
A seguir
- Para saber mais sobre o dbt e os BigQuery DataFrames, consulte Como usar BigQuery DataFrames com modelos Python do dbt.
- Para saber mais sobre os modelos dbt Python, consulte Modelos Python e Configuração de modelos Python.
- Para saber mais sobre os notebooks do Colab Enterprise, consulte Criar um notebook do Colab Enterprise usando o console do Google Cloud .
- Para saber mais sobre os parceiros do Google Cloud , consulte Pronto paraGoogle Cloud - Parceiros do BigQuery.