


Regionsübergreifende Dataset-Replikation
Mit der BigQuery-Dataset-Replikation können Sie die automatische Replikation eines Datasets zwischen zwei verschiedenen Regionen oder Multi-Regionen einrichten.
Übersicht
Beim Erstellen eines Datasets in BigQuery wählen Sie die Region oder Multi-Region aus, in der die Daten gespeichert werden. Eine Region ist eine Sammlung von Rechenzentren innerhalb eines geografischen Bereichs. Eine Multiregion ist ein großes geografisches Gebiet, das zwei oder mehr geografische Regionen enthält. Ihre Daten werden in einer der enthaltenen Regionen gespeichert und nicht innerhalb der Multiregion repliziert. Weitere Informationen zu Regionen und Multiregionen finden Sie unter BigQuery-Standorte.
BigQuery speichert Kopien Ihrer Daten immer in zwei verschiedenenGoogle Cloud -Zonen innerhalb des Dataset-Standorts. Eine Zone ist ein Bereitstellungsbereich für Google Cloud -Ressourcen innerhalb einer Region. In allen Regionen verwendet die Replikation zwischen Zonen synchrone zweifache Exporte. Die Auswahl eines multiregionalen Standorts bietet keine regionsübergreifende Replikation oder regionale Redundanz, sodass die Verfügbarkeit der Datasets im Falle eines regionalen Ausfalls nicht erhöht wird. Die Daten werden in einer einzelnen Region innerhalb des geografischen Standorts gespeichert.
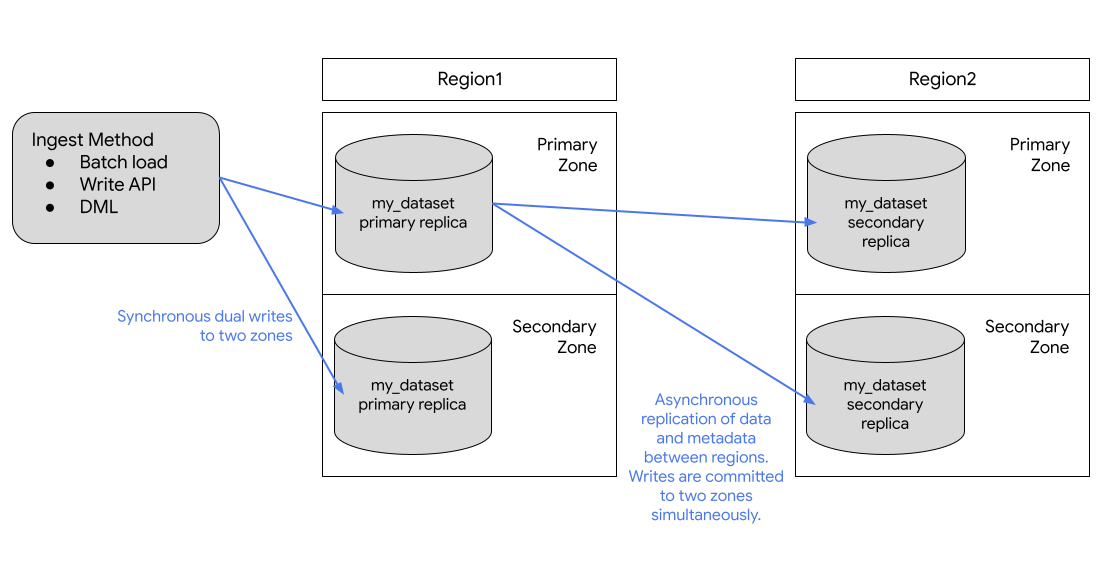
Sie können Datasets für zusätzliche Georedundanzen replizieren. BigQuery erstellt ein sekundäres Replikat des Datasets in einer anderen von Ihnen angegebenen Region. Dieses Replikat wird dann asynchron zwischen zwei Zonen mit der anderen Region repliziert. Es gibt dann insgesamt vier zonale Kopien.
Dataset-Replikation
Wenn Sie ein Dataset replizieren, speichert BigQuery die Daten in der von Ihnen angegebenen Region.
Primäre Region. Wenn Sie ein Dataset zum ersten Mal erstellen, platziert BigQuery es in der primären Region.
Sekundäre Region. Wenn Sie ein Dataset-Replikat hinzufügen, platziert BigQuery das Replikat in der sekundären Region.
Anfänglich ist das Replikat in der primären Region das primäre Replikat und das Replikat in der sekundären Region das sekundäre Replikat.
Das primäre Replikat ist beschreibbar, das sekundäre Replikat schreibgeschützt. Schreibvorgänge auf dem primären Replikat werden asynchron auf das sekundäre Replikat repliziert. In den einzelnen Regionen werden die Daten redundant in zwei Zonen gespeichert. Der Netzwerkverkehr verlässt das Google Cloud Netzwerk nie.
Das folgende Diagramm zeigt die Replikation, die beim Replizieren eines Datasets erfolgt:
Wenn die primäre Region online ist, können Sie manuell zum sekundären Replikat wechseln. Weitere Informationen finden Sie unter Sekundäres Replikat hochstufen.
Replikation und DML
BigQuery speichert Daten in unveränderlichen Blöcken. Bei DML-Vorgängen (Datenbearbeitungssprache, z. B. UPDATE-, DELETE- oder MERGE-Anweisungen) werden sowohl die geänderten als auch die unveränderten Daten aus den betroffenen Dateien in neue zugrunde liegende Speicherblöcke geschrieben. Da die regionenübergreifende Replikation auf Dateiebene erfolgt, muss BigQuery nach dem Ausführen eines DML-Vorgangs die gesamte neue Datei in die sekundäre Region replizieren.
Wenn Sie beispielsweise 100 MB Daten in einer 1-GB-Speicherdatei aktualisieren, muss BigQuery die gesamte neu rekonstruierte 1-GB-Datei replizieren, nicht nur die aktualisierten 100 MB. Häufige DML-Vorgänge für große oder nicht partitionierte Tabellen können die Gesamtmenge der übertragenen Daten erheblich erhöhen.
Aufgrund dieses Verhaltens können häufige DML-Vorgänge für replizierte Daten zu einem Anstieg der Datenübertragungskosten führen. Verschieben Sie stattdessen Ihre DML-lastigen Tabellen in ein separates Dataset, das nicht repliziert wird.
Preise
Für replizierte Datasets wird Ihnen Folgendes in Rechnung gestellt:
- Storage. Speicherbyte in der sekundären Region werden als separate Kopie in der sekundären Region abgerechnet. Tabellen und Partitionen im Langzeitspeicher werden im sekundären Replikat nicht auf den aktiven Speicher zurückgesetzt.
- Datenreplikation. Weitere Informationen zu den Preisen für die Datenreplikation finden Sie unter Preise für die Datenreplikation.
Die Datenreplikation wird von BigQuery verwaltet und verwendet nicht Ihre Slot-Ressourcen. Die Datenreplikation wird separat in Rechnung gestellt.
Rechenkapazität in der sekundären Region
Wenn Sie Jobs und Abfragen für das Replikat in der sekundären Region ausführen möchten, müssen Sie Slots in der sekundären Region erwerben oder eine On-Demand-Abfrage ausführen.
Sie können die Slots verwenden, um schreibgeschützte Abfragen aus dem sekundären Replikat auszuführen. Wenn Sie das sekundäre Replikat zur primären Instanz hochstufen, können Sie diese Slots auch zum Schreiben in das Replikat verwenden.
Sie können die gleiche Anzahl von Slots wie in der primären Region oder eine andere Anzahl an Slots erwerben. Wenn Sie weniger Slots erwerben, kann sich das auf die Abfrageleistung auswirken.
Überlegungen zum Standort
Bevor Sie ein Dataset-Replikat hinzufügen, müssen Sie das ursprüngliche Dataset erstellen, das Sie in BigQuery replizieren möchten, falls es noch nicht vorhanden ist. Der Speicherort des hinzugefügten Replikats ist auf den Standort festgelegt, den Sie beim Hinzufügen des Replikats angeben. Der Standort des hinzugefügten Replikats muss sich vom Standort des ursprünglichen Datasets unterscheiden. Das bedeutet, dass die Daten in Ihrem Dataset kontinuierlich zwischen dem Standort, an dem das Dataset erstellt wurde, und dem Standort des Replikats repliziert werden. Für Replikate, die am selben Standort gespeichert sein müssen, z. B. Ansichten, materialisierte Ansichten oder externe Nicht-BigLake-Tabellen, fügen Sie ein Replikat an einem Speicherort hinzu, der sich von Ihrer Quelle unterscheidet oder mit dieser nicht kompatibel ist. Der Standort der Daten kann dann zu Jobfehlern führen.
Wenn Kunden ein Dataset über Regionen hinweg replizieren, sorgt BigQuery dafür, dass sich die Daten nur an den Standorten befinden, an denen die Replikate erstellt wurden.
Colocation-Anforderungen
Die Verwendung der Dataset-Replikation hängt von den folgenden Anforderungen an die Zusammenstellung ab.
Cloud Storage
Zum Abfragen von Daten in Cloud Storage muss sich der Cloud Storage-Bucket am selben Standort wie das Replikat befinden. Berücksichtigen Sie bei der Wahl des Speicherorts des Replikats die Überlegungen zum externen Tabellenstandort.
Beschränkungen
Die BigQuery-Dataset-Replikation unterliegt den folgenden Einschränkungen:
- Streamingdaten, die über die BigQuery Storage Write API (gRPC) oder die BigQuery Storage Write API (REST) in das primäre Replikat geschrieben und dann in das sekundäre Replikat repliziert werden, werden auf Best-Effort-Basis verarbeitet und können zu einer hohen Replikationsverzögerung führen.
- Streaming-Upserts, die von Datastream oder der BigQuery Change Data Capture-Aufnahme in das primäre Replikat geschrieben und dann in das sekundäre Replikat repliziert werden, erfolgen auf Best-Effort-Basis und können zu einer hohen Replikationsverzögerung führen. Nach der Replikation werden die Upserts im sekundären Replikat gemäß dem konfigurierten
max_staleness-Wert der Tabelle in die Tabellen-Baseline des sekundären Replikats zusammengeführt. - Die regionenübergreifende Replikation wird für Tabellen mit aktivierter feingranularer DML nicht unterstützt. Das System blockiert zwar die Erstellung replizierter Datasets, die bereits solche Tabellen enthalten, aber es blockiert nicht die Aktivierung von detaillierter DML für Tabellen in vorhandenen replizierten Datasets. Dies kann jedoch zu falschen Abfrageergebnissen in der sekundären Tabelle für die Tabelle mit aktivierter detaillierter DML führen.
- Replikation und Switchover können über die Google Cloud -Konsole oder DDL-Anweisungen (Data Definition Language, Datendefinitionssprache) verwaltet werden.
- Sie sind auf jeweils ein Replikat jedes Datasets pro Region oder Multi-Region beschränkt. Sie können nicht zwei sekundäre Replikate desselben Datasets in derselben Zielregion erstellen.
- Ressourcen innerhalb von Replikaten unterliegen den unter Ressourcenverhalten beschriebenen Einschränkungen.
- Richtlinien-Tags und zugehörige Datenrichtlinien werden nicht in das sekundäre Replikat repliziert. Alle Abfragen, die außerhalb der primären Region ausgeführt werden, schlagen fehl, wenn Richtlinien-Tags für Spalten vorhanden sind, auf die in der Abfrage verwiesen wird, es sei denn, der Nutzer hat die Rolle
roles/datacatalog.categoryFineGrainedReaderauf Projekt-, Ordner- oder Organisationsebene. Durch das Hochstufen eines Replikats werden diese Bindungen nicht automatisch korrigiert. Sie müssen sie aktualisieren, damit sie auf eine gültige Taxonomie in der neuen primären Region verweisen. - Zeitreisen sind im sekundären Replikat erst verfügbar, nachdem das Erstellen des sekundären Replikats abgeschlossen wurde.
- Das Größenlimit der Zielregion (in logischen Byte) für die Aktivierung der regionenübergreifenden Replikation für ein Dataset beträgt standardmäßig 10 PB für die Multiregionen
usundeuund 500 TB für andere Regionen. Diese Limits sind konfigurierbar. Weitere Informationen erhalten Sie vom Google Cloud -Support. - Das Kontingent gilt für logische Ressourcen.
- Sie können ein Dataset nur mit weniger als 100.000 Tabellen replizieren.
- Es können maximal vier Replikate pro Dataset und Tag für dieselbe Region hinzugefügt (und später gelöscht) werden.
- Sie sind durch die Bandbreite eingeschränkt.
- Tabellen mit vom Kunden verwalteten Verschlüsselungsschlüsseln (CMEK) können in der sekundären Region nicht abgefragt werden, wenn der Wert
replica_kms_keynicht konfiguriert ist. - BigLake-Tabellen werden nicht unterstützt.
- Externe oder föderierte Datasets können nicht repliziert werden.
- BigQuery Omni-Standorte werden nicht unterstützt.
- Die folgenden Regionspaare können nicht konfiguriert werden, wenn Sie die Datenreplikation für die Notfallwiederherstellung konfigurieren:
us-central1-usMultiregional- Multiregion
us-west1-us - Multiregion
eu-west1-eu - Multiregion
eu-west4-eu
- Zugriffssteuerungen auf Routineebene können nicht repliziert werden. Sie können jedoch Zugriffssteuerungen auf Dataset-Ebene für Routinen replizieren.
- Das folgende Verhalten gilt für Suchindexe:
- Nur die Metadaten des Suchindex werden in die sekundäre Region repliziert, nicht die Indexdaten selbst.
- Wenn Sie zum Replikat wechseln, wird Ihr Index aus der vorherigen primären Region gelöscht und in der hochgestuften Region neu generiert.
- Wenn Sie innerhalb von 8 Stunden hin- und herwechseln, verzögert sich die Indexgenerierung um 8 Stunden.
- Geplante Abfragen werden nicht automatisch an einen neuen primären Standort weitergeleitet, wenn Sie ein sekundäres Replikat hochstufen. Sie bleiben an die Region gebunden, die zum Zeitpunkt ihrer Erstellung angegeben wurde.
- Wenn das ursprüngliche primäre Replikat nach der Hochstufung zu einem sekundären Replikat mit Lesezugriff wird, schlagen geplante Abfragen fehl, die versuchen, Daten in das Dataset zu schreiben.
- Wenn die ursprüngliche primäre Region nicht mehr verfügbar ist, schlagen geplante Abfragen fehl, auch wenn sie nur Lesevorgänge ausführen.
- Damit geplante Abfragen weiterhin für das hochgestufte primäre Replikat ausgeführt werden, müssen Sie sie manuell am neuen primären Standort neu erstellen.
- Ausgeblendete Datasets können nicht repliziert werden.
- Die regionenübergreifende Replikation wird für Datasets, die bedingte IAM-Richtlinien enthalten, nicht unterstützt. Wenn Sie feststellen möchten, ob dieser Fehler die Replikation unterbricht, können Sie die Spalte
sync_statusin der AnsichtINFORMATION_SCHEMA.SCHEMATA_REPLICASprüfen.
Ressourcenverhalten
Die folgenden Vorgänge werden für Ressourcen im sekundären Replikat nicht unterstützt:
Das sekundäre Replikat ist schreibgeschützt. Wenn Sie eine Kopie einer Ressource in einem sekundären Replikat erstellen müssen, müssen Sie die Ressource entweder kopieren oder zuerst abfragen und dann die Ergebnisse außerhalb des sekundären Replikats materialisieren. Verwenden Sie beispielsweise CREATE TABLE AS SELECT, um eine neue Ressource aus der sekundären Replikatressource zu erstellen.
Für primäre und sekundäre Replikate gelten die folgenden Unterschiede:
| Primäres Replikat aus Region 1 | Sekundäres Replikat aus Region 2 | Hinweise |
|---|---|---|
| Autorisiertes Dataset | Autorisiertes Dataset | Sie können kein autorisiertes Dataset in einem sekundären Replikat erstellen. Sie müssen im primären Replikat erstellt werden und können dann von der sekundären Region aus abgefragt werden. |
| Autorisierte Routine | Autorisierte Routine | Sie können keine autorisierte Routine in einem sekundären Replikat erstellen. Sie müssen im primären Replikat erstellt werden und können dann von der sekundären Region aus abgefragt werden. |
| Autorisierte Ansicht | Autorisierte Ansicht | Sie können keine autorisierte Ansicht in einem sekundären Replikat erstellen. Sie müssen im primären Replikat erstellt werden und können dann von der sekundären Region aus abgefragt werden. |
| BigLake-Tabelle | BigLake-Tabelle | Nicht unterstützt. |
| BigLake Apache Iceberg-Tabelle | BigLake Apache Iceberg-Tabelle | Weitere Informationen finden Sie unter Regionenübergreifende Replikation und Notfallwiederherstellung im Lakehouse-Laufzeitkatalog. |
| Externe Tabelle | Externe Tabelle | Nur die externe Tabellendefinition wird repliziert. Die Abfrage schlägt fehl, wenn sich der Cloud Storage-Bucket nicht am selben Standort wie ein Replikat befindet. |
| Logische Ansicht | Logische Ansicht | Logische Ansichten, die auf ein nicht am selben Standort wie die logische Ansicht befindlichen Dataset oder eine Ressource verweisen, schlagen bei der Abfrage fehl. |
| Verwaltete Tabelle | Verwaltete Tabelle | Kein Unterschied |
| Materialisierte Ansicht | Materialisierte Ansicht | Wenn sich eine referenzierte Tabelle nicht in derselben Region wie die materialisierte Ansicht befindet, schlägt die Abfrage fehl. Replizierte materialisierte Ansichten sind möglicherweise älter als es das maximale Verwerfsalter der Ansicht erlaubt. |
| Modell | Modell | Als verwaltete Tabellen gespeichert. |
| Remote-Funktion | Remote-Funktion | Verbindungen sind regional. Remote-Funktionen, die auf ein nicht am selben Standort wie die Remote-Funktion befindliches Dataset oder eine solche Ressource (Verbindung) verweisen, schlagen bei der Ausführung fehl. |
| Routinen | Benutzerdefinierte Funktion (UDFs, User-Defined Functions) oder gespeicherte Prozedur | Routinen, die auf ein nicht am selben Standort wie die Routine befindliches Dataset oder eine solche Ressource verweisen, schlagen bei der Ausführung fehl. Routinen, die auf eine Verbindung verweisen, z. B. Remote-Funktionen, funktionieren nicht außerhalb der Quellregion. |
| Zeilenzugriffsrichtlinie | Zeilenzugriffsrichtlinie | Kein Unterschied |
| Google-Suchindex | Google-Suchindex | Es werden nur Indexmetadaten repliziert. Indexdaten sind nur in der primären Region vorhanden. |
| Gespeicherte Prozedur | Gespeicherte Prozedur | Gespeicherte Prozeduren, die auf ein nicht am selben Standort wie die gespeicherte Prozedur befindliches Dataset oder eine solche Ressource verweisen, schlagen bei der Ausführung fehl. |
| Tabellenklon | Verwaltete Tabelle | Wird als Deep Copy im sekundären Replikat abgerechnet. |
| Tabellen-Snapshot | Tabellen-Snapshot | Wird als Deep Copy im sekundären Replikat abgerechnet. |
| Tabellenwertfunktion (TVF) | TVF | TVFs, die auf ein nicht am selben Standort wie die TVF befindliches Dataset oder eine solche Ressource verweisen, schlagen bei der Ausführung fehl. |
| UDF | UDF | UDFs, die auf ein nicht am selben Standort wie die UDF befindliches Dataset oder eine solche Ressource verweisen, schlagen bei der Ausführung fehl. |
| Datenrichtlinie für eine Spalte | Datenrichtlinie für eine Spalte | Benutzerdefinierte Datenrichtlinien, die auf eine UDF verweisen, die sich nicht am selben Standort wie die Richtlinie befindet, schlagen bei der Abfrage der Tabelle fehl, an die die Richtlinie angehängt ist. |
Ausfallszenarien
Die regionenübergreifende Replikation ist nicht für die Verwendung als Notfallwiederherstellungsplan bei einem Ausfall der gesamten Region vorgesehen. Bei einem regionalen Gesamtausfall in der Region des primären Replikats können Sie das sekundäre Replikat nicht hochstufen. Da sekundäre Replikate Lesezugriff haben, können Sie keine Schreibjobs auf dem sekundären Replikat ausführen und die sekundäre Region erst hochstufen, wenn die Region des primären Replikats wiederhergestellt ist. Weitere Informationen zur Vorbereitung auf die Notfallwiederherstellung finden Sie unter Verwaltete Notfallwiederherstellung.
In der folgenden Tabelle werden die Auswirkungen von gesamtregionalen Ausfällen auf Ihre replizierten Daten erläutert:
| Region 1 | Region 2 | Ausfallregion | Auswirkungen |
|---|---|---|---|
| Primäres Replikat | Sekundäres Replikat | Region 2 | Schreibgeschützte Jobs, die in Region 2 ausgeführt werden, schlagen fehl. |
| Primäres Replikat | Sekundäres Replikat | Region 1 | Alle in Region 1 ausgeführten Jobs schlagen fehl. Schreibgeschützte Jobs werden weiterhin in Region 2 ausgeführt, in der sich das sekundäre Replikat befindet. Der Inhalt von Region 2 ist veraltet, bis er erfolgreich mit Region 1 synchronisiert wird. |
Dataset-Replikation verwenden
In diesem Abschnitt wird beschrieben, wie Sie ein Dataset replizieren, das sekundäre Replikat hochstufen und BigQuery-Lesejobs in der sekundären Region ausführen.
Erforderliche Berechtigungen
Bitten Sie Ihren Administrator, Ihnen die Berechtigung bigquery.datasets.update zu erteilen, um die Berechtigungen zu erhalten, die Sie zum Verwalten von Replikaten benötigen.
Dataset replizieren
Wählen Sie eine der folgenden Optionen aus, um ein Dataset zu replizieren:
Console
Rufen Sie die Seite BigQuery auf.
Klicken Sie im Bereich Explorer auf das Dataset, das Sie replizieren möchten.
Klicken Sie auf den Tab Details.
Klicken Sie im Abschnitt Replikate auf Replikat erstellen.
Führen Sie im Bereich Dataset-Replikat erstellen die folgenden Schritte aus:
- Wählen Sie im Abschnitt Standorttyp einen Standorttyp für das Replikat aus.
- Wählen Sie in der Liste Region eine Region für das Replikat aus.
- Optional: Wenn Sie kundenverwaltete Verschlüsselungsschlüssel (CMEK) verwenden möchten, maximieren Sie den Abschnitt Erweiterte Optionen und wählen Sie dann die Option Kundenverwalteter Verschlüsselungsschlüssel (CMEK) aus.
Klicken Sie auf Replikat erstellen.
SQL
Zum Replizieren eines Datasets verwenden Sie die ALTER SCHEMA ADD REPLICA-DDL-Anweisung.
Sie können ein Replikat zu jedem Dataset hinzufügen, das sich in einer Region oder Multi-Region befindet und noch nicht in dieser Region oder Multi-Region repliziert wurde. Nachdem Sie ein Replikat hinzugefügt haben, dauert es einige Zeit, bis der erste Kopiervorgang abgeschlossen ist. Sie können weiterhin Abfragen ausführen, die auf das primäre Replikat verweisen, während die Daten repliziert werden, ohne dass die Abfrageverarbeitungskapazität reduziert wird. Sie können Daten an den geografischen Standorten innerhalb einer Multi-Region nicht replizieren.
Im folgenden Beispiel wird ein Dataset mit dem Namen my_dataset in der Region us-central1 erstellt und dann ein Replikat in der Region us-east4 hinzugefügt:
-- Create the primary replica in the us-central1 region.
CREATE SCHEMA my_dataset OPTIONS(location='us-central1');

-- Create a replica in the secondary region.
ALTER SCHEMA my_dataset
ADD REPLICA `my_replica`
OPTIONS(location='us-east4');
Wenn Sie wissen möchten, wann das sekundäre Replikat erfolgreich erstellt wurde, können Sie in der Ansicht INFORMATION_SCHEMA.SCHEMATA_REPLICAS die Spalte creation_complete abfragen.
Nachdem das sekundäre Replikat erstellt wurde, können Sie es abfragen, indem Sie den Standort der Abfrage explizit auf die sekundäre Region festlegen. Wenn kein Standort explizit festgelegt ist, verwendet BigQuery die Region des primären Replikats des Datasets.
Sekundäres Replikat hochstufen
Wenn die primäre Region online ist, können Sie das sekundäre Replikat hochstufen. Eine „Hochstufung“ macht das sekundäre Replikat zur beschreibbaren primären Instanz. Dieser Vorgang ist innerhalb weniger Sekunden abgeschlossen, wenn das sekundäre Replikat mit dem primären Replikat synchronisiert ist. Ist das sekundäre Replikat nicht aktuell, kann das Hochstufen erst abgeschlossen werden, wenn es aktuell ist. Das sekundäre Replikat kann nicht zur primären Instanz hochgestuft werden, wenn die Region mit der primären Instanz ausfällt.
Bitte beachten Sie dabei Folgendes:
- Alle Schreibvorgänge in Tabellen geben Fehler zurück, während die Hochstufung läuft. In das alte primäre Replikat kann ab Beginn der Hochstufung nicht mehr geschrieben werden.
- Tabellen, die zur Zeit der Initiierung der Hochstufung nicht vollständig repliziert waren, geben veraltete Lesevorgänge zurück.
Wählen Sie eine der folgenden Optionen aus, um ein Replikat zu einem primären Replikat hochzustufen:
Console
Rufen Sie die Seite BigQuery auf.
Klicken Sie im Bereich Explorer auf das Dataset, das Sie hochstufen möchten.
Klicken Sie auf den Tab Details.
Suchen Sie im Abschnitt Replikate das Replikat, das Sie hochstufen möchten, und klicken Sie dann auf Als primär festlegen.
Geben Sie im Dialogfeld Replikat hochstufen
confirmin das Textfeld ein und klicken Sie dann auf Bestätigen.
SQL
Verwenden Sie die DDL-Anweisung ALTER SCHEMA SET
OPTIONS und legen Sie die Option primary_replica fest, um ein Replikat zu einem primären Replikat hochzustufen.
Wichtige Hinweise:
- Sie müssen den Jobstandort in den Abfrageeinstellungen explizit auf die sekundäre Region festlegen. Weitere Informationen finden Sie unter BigQuery-Standorte angeben.
Im folgenden Beispiel wird das Replikat us-east4 zum primären Replikat hochgestuft:
ALTER SCHEMA my_dataset SET OPTIONS(primary_replica = 'us-east4');
Wenn Sie wissen möchten, wann das sekundäre Replikat erfolgreich hochgestuft wurde, können Sie in der Ansicht INFORMATION_SCHEMA.SCHEMATA_REPLICAS die Spalte replica_primary_assignment_complete abfragen.
Dataset-Replikat entfernen
Wählen Sie eine der folgenden Optionen aus, um ein Replikat zu entfernen und die Replikation des Datasets zu beenden:
Console
Rufen Sie die Seite BigQuery auf.
Klicken Sie im Bereich Explorer auf das Dataset, aus dem Sie ein Replikat entfernen möchten.
Klicken Sie auf den Tab Details.
Suchen Sie im Abschnitt Replikate das Replikat, das Sie entfernen möchten, klicken Sie auf Weitere Aktionen und dann auf Löschen.
Geben Sie im Dialogfeld Dataset-Replikat löschen?
deletein das Textfeld ein und klicken Sie auf Löschen.
SQL
Wenn Sie ein Replikat entfernen und die Replikation des Datasets beenden möchten, verwenden Sie die DDL-Anweisung ALTER SCHEMA DROP REPLICA.
Im folgenden Beispiel wird das Replikat us entfernt:
ALTER SCHEMA my_dataset
DROP REPLICA IF EXISTS `us`;
Sie müssen zuerst alle sekundären Replikate löschen, um das gesamte Dataset zu löschen. Wenn Sie das gesamte Dataset löschen, z. B. mit der Anweisung DROP
SCHEMA, ohne alle sekundären Replikate zu löschen, erhalten Sie die folgende Fehlermeldung:
The dataset replica of the cross region dataset 'project_id:dataset_id' in region 'REGION' is not yet writable because the primary assignment is not yet complete.
Weitere Informationen finden Sie unter Sekundäres Replikat hochstufen.
Replikation überwachen
Sie können den Status Ihrer Dataset-Replikate über BigQuery, Cloud Monitoring oder INFORMATION_SCHEMA-Ansichten überwachen.
Informationen zum Erstellen von Benachrichtigungen für diese Messwerte finden Sie unter Dashboards, Diagramme und Benachrichtigungen erstellen.
Replikationsstatus mit BigQuery ansehen
So rufen Sie den Replikationsstatus und die Latenz für ein Dataset in derGoogle Cloud Console auf:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Maximieren Sie im Bereich Explorer Ihr Projekt.
Klicken Sie auf das Dataset, das Sie überwachen möchten.
Klicken Sie im Bereich mit den Dataset-Details auf den Tab Details.
Sehen Sie sich im Abschnitt Replikate die Replikationslatenz und den Status an. Wenn Sie weitere Details sehen möchten, einschließlich eines Diagramms zur Replikationslatenz, klicken Sie auf Details ansehen.
Replikationsstatus mit Cloud Monitoring ansehen
BigQuery bietet die folgenden Messwerte in Monitoring, mit denen Sie den Replikationsstatus überwachen können:
- Replikationslatenz: Die Veralterung der Daten in der sekundären Region, die im Rahmen der regionenübergreifenden Replikation oder der verwalteten Notfallwiederherstellung repliziert wurden. Dieser Messwert dient als Proxy für Ihr Recovery Point Objective (RPO).
- Ausgehender Netzwerktraffic (Byte): Das abgerechnete Datenvolumen (in Byte), das von der primären Region in die sekundäre Region repliziert wird. Mit diesem Messwert können Sie die Auslastung des Bandbreitenkontingents überwachen.
So rufen Sie diese Messwerte in Monitoring auf:
Rufen Sie in der Google Cloud Console die Seite Monitoring auf.
Klicken Sie auf Metrics Explorer.
Suchen Sie im Feld Messwert auswählen nach BigQuery-Dataset und wählen Sie es aus.
Wählen Sie Replikationslatenz (
bigquery.googleapis.com/storage/replication/dataset_staleness) oder Ausgehende Netzwerkbytes (bigquery.googleapis.com/storage/replication/network_egress_bytes_count) aus.Klicken Sie auf Übernehmen.
Wählen Sie im Abschnitt Aggregation eine Aggregationsmethode aus. Für den Messwert „Replikationslatenz“ empfehlen wir, das 99. Perzentil auszuwählen. Diese Aggregation zeigt die Leistung im schlimmsten Fall besser als der Durchschnitt oder andere Aggregationen.
Optional: Wenn Sie Messwerte für ein bestimmtes Dataset oder eine sekundäre Region aufrufen möchten, klicken Sie auf Filter hinzufügen, wählen Sie die Option dataset_id oder location aus und geben Sie dann einen Wert ein. Wenn Sie Daten in mehrere sekundäre Regionen replizieren, können Sie nach Standort gruppieren, um Messwerte für jede Region aufzurufen.
Replikationsstatus mit INFORMATION_SCHEMA ansehen
Wenn Sie die Dataset-Replikate in einem Projekt auflisten möchten, fragen Sie die Ansicht INFORMATION_SCHEMA.SCHEMATA_REPLICAS ab.
Datasets migrieren
Mit der regionsübergreifenden Dataset-Replikation können Sie Ihre Datasets von einer Region in eine andere migrieren. Das folgende Beispiel zeigt den Prozess der Migration des vorhandenen Datasets my_migration von der Multi-Region US mithilfe der regionenübergreifenden Replikation auf die Multi-Region EU.
Dataset replizieren
Wenn Sie mit der Migration beginnen möchten, replizieren Sie zuerst das Dataset in der Region, in die Sie die Daten migrieren möchten. In diesem Szenario migrieren Sie das Dataset my_migration zur Multi-Region EU.
-- Create a replica in the secondary region.
ALTER SCHEMA my_migration
ADD REPLICA `eu`
OPTIONS(location='eu');
Dadurch wird ein sekundäres Replikat mit dem Namen eu am multiregionalen Standort EU erstellt.
Das primäre Replikat ist das Dataset my_migration am multiregionalen Standort US.
Sekundäres Replikat hochstufen
Wenn Sie das Dataset weiter zur Multi-Region EU migrieren möchten, stufen Sie das sekundäre Replikat hoch:
ALTER SCHEMA my_migration SET OPTIONS(primary_replica = 'eu')
Nach Abschluss des Hochstufens ist eu das primäre Replikat. Es ist ein beschreibbares Replikat.
Migration abschließen
Um die Migration von der US-Multi-Region zur EU-Multi-Region abzuschließen, löschen Sie das us-Replikat. Dieser Schritt ist nicht erforderlich, aber nützlich, wenn Sie nach der Migration kein Dataset-Replikat mehr benötigen.
ALTER SCHEMA my_migration
DROP REPLICA IF EXISTS us;
Ihr Dataset befindet sich in der EU-Multi-Region und es gibt keine Replikate des my_migration-Datasets. Sie haben Ihr Dataset erfolgreich in die Multi-Region EU migriert. Eine vollständige Liste der migrierten Ressourcen finden Sie unter Ressourcenverhalten.
Kunden-verwaltete Verschlüsselungsschlüssel (CMEK)
Vom Kunden verwaltete Cloud Key Management Service-Schlüssel werden nicht automatisch repliziert, wenn Sie ein sekundäres Replikat erstellen. Damit die Verschlüsselung für Ihr repliziertes Dataset beibehalten wird, müssen Sie den replica_kms_key für den Standort des hinzugefügten Replikats festlegen. Sie können replica_kms_key mit der DDL-Anweisung ALTER SCHEMA ADD REPLICA festlegen.
Die Replikation von Datasets mit CMEK verhält sich wie in den folgenden Szenarien beschrieben:
Wenn das Quell-Dataset ein
default_kms_keyhat, müssen Siereplica_kms_keyangeben, das in der Region des Replikat-Datasets erstellt wurde, wenn die DDL-AnweisungALTER SCHEMA ADD REPLICAverwendet wird.Wenn für das Quell-Dataset kein Wert für
default_kms_keyfestgelegt ist, können Siereplica_kms_keynicht festlegen.Wenn Sie die Cloud KMS-Schlüsselrotation für
default_kms_keyoderreplica_kms_key(oder für beide Elemente) verwenden, kann das replizierte Dataset nach der Schlüsselrotation weiterhin abgefragt werden.- Die Schlüsselrotation in der primären Region aktualisiert die Schlüsselversion nur in Tabellen, die nach der Rotation erstellt wurden. Tabellen, die vor der Schlüsselrotation vorhanden waren, verwenden weiterhin die Schlüsselversion, die vor der Rotation festgelegt war.
- Durch die Schlüsselrotation in der sekundären Region werden alle Tabellen im sekundären Replikat auf die neue Schlüsselversion aktualisiert.
- Wenn Sie das primäre Replikat auf das sekundäre Replikat umstellen, werden alle Tabellen im sekundären Replikat (das zuvor das primäre Replikat war) auf die neue Schlüsselversion aktualisiert.
- Wenn die Schlüsselversion, die für Tabellen im primären Replikat vor der Schlüsselrotation festgelegt wurde, gelöscht wird, können Tabellen, die noch die Schlüsselversion verwenden, die vor der Schlüsselrotation festgelegt war, erst abgefragt werden, wenn die Schlüsselversion aktualisiert wurde. Damit die Schlüsselversion aktualisiert werden kann, muss die alte Schlüsselversion aktiv sein (d. h. weder deaktiviert noch gelöscht).
Wenn für das Quell-Dataset kein Wert für
default_kms_keyfestgelegt ist, aber einzelne Tabellen im Quell-Dataset mit CMEK vorhanden sind, können diese Tabellen im replizierten Dataset nicht abgefragt werden. So fragen Sie die Tabellen ab:- Fügen Sie einen
default_kms_key-Wert für das Quell-Dataset hinzu. - Wenn Sie ein neues Replikat mit der DDL-Anweisung
ALTER SCHEMA ADD REPLICAerstellen, legen Sie einen Wert für die Optionreplica_kms_keyfest. Die CMEK-Tabellen können in der Zielregion abgefragt werden.
Alle CMEK-Tabellen in der Zielregion verwenden denselben
replica_kms_key, unabhängig vom Schlüssel, der in der Quellregion verwendet wird.- Fügen Sie einen
Replikat mit CMEK erstellen
Im folgenden Beispiel wird ein Replikat in der Region us-west1 mit einem festgelegten replica_kms_key-Wert erstellt. Gewähren Sie dem CMEK-Schlüssel die BigQuery-Dienstkonto-Berechtigung zum Verschlüsseln und Entschlüsseln.
-- Create a replica in the secondary region.
ALTER SCHEMA my_dataset
ADD REPLICA `us-west1`
OPTIONS(location='us-west1',
  replica_kms_key='my_us_west1_kms_key_name');
CMEK-Einschränkungen
Für das Replizieren von Datasets mit CMEK gelten die folgenden Einschränkungen:
Sie können den replizierten Cloud KMS-Schlüssel nach dem Erstellen des Replikats nicht mehr aktualisieren.
Sie können den Wert
default_kms_keyim Quell-Dataset nicht mehr aktualisieren, nachdem die Dataset-Replikate erstellt wurden.Wenn der angegebene
replica_kms_keyin der Zielregion nicht gültig ist, wird das Dataset nicht repliziert.
Datenrichtlinien, die einer Spalte oder einem Data-Governance-Tag zugewiesen sind
In den folgenden Abschnitten wird beschrieben, wie Datenrichtlinien, die einer Spalte direkt zugewiesen sind, und Datenrichtlinien, die Data-Governance-Tags zugewiesen sind (Vorabversion), mit der regionenübergreifenden Replikation interagieren.
Datenrichtlinien, die Spalten oder Data-Governance-Tags zugewiesen sind, sind regionale Ressourcen. Das bedeutet, dass sich die Datenrichtlinie und die zugehörige Tabelle in derselben Region befinden müssen. Datenrichtlinien werden automatisch repliziert, wenn Sie ein sekundäres Replikat erstellen. Wenn eine Datenrichtlinie an eine Tabelle in einem replizierten Dataset angehängt ist oder einem Data-Governance-Tag für diese Tabelle zugewiesen ist, erstellt oder aktualisiert BigQuery die Datenrichtlinie und die entsprechenden IAM-Richtlinien in der sekundären Region.
Veränderlichkeit
Replizierte Datenrichtlinien haben in sekundären Regionen Lesezugriff. Sie können die Datenrichtlinie in einer sekundären Region nicht aktualisieren. Die ursprüngliche Datenrichtlinie, die der Tabelle in der primären Region zugeordnet ist, bleibt änderbar. Eine Datenrichtlinie in einer Region ist nur dann änderbar, wenn sie nicht an sekundäre Tabellen angehängt ist. Wenn er an Tabellen in sekundären Regionen angehängt ist, wird er unveränderlich. BigQuery lehnt alle Vorgänge ab, die IAM-Richtlinien aktualisieren oder festlegen, wenn die Datenrichtlinie unveränderlich ist.
Namenskonflikte
Die Datenrichtlinienressource ist in der primären und sekundären Region identisch, mit Ausnahme des Standorts. Für eine Datenrichtlinie und ihr Replikat in den sekundären Regionen sind die IDs im Format projects/PROJECT_NUMBER/locations/LOCATION_ID/dataPolicies/DATA_POLICY_ID identisch, mit Ausnahme des Werts von LOCATION_ID.
Die Replikation schlägt fehl, wenn in der sekundären Region bereits eine Datenrichtlinie mit einer in Konflikt stehenden ID vorhanden ist. Sie müssen den Namenskonflikt entweder in der primären oder sekundären Region beheben, bevor die Replikation fortgesetzt wird.
Benutzerdefinierte Maskierungsrichtlinien
Wenn Sie eine benutzerdefinierte Maskierungsroutine verwenden, müssen Sie die benutzerdefinierten UDFs replizieren. Sie können diese UDFs in das Dataset aufnehmen, das Sie replizieren.
Datenrichtlinien an Tabellenspalten anhängen, davon trennen oder daraus löschen
Das Anhängen, Trennen oder Löschen einer Datenrichtlinie an oder von einer Spalte in der primären Region ist eine Änderung des Tabellenschemas. Die Tabellenschemas in allen sekundären Regionen werden entsprechend aktualisiert. Wenn Sie jedoch eine Datenrichtlinie von allen Tabellenspalten in der primären Region trennen, wird die Datenrichtlinie in der sekundären Region verwaist. Sie müssen sie dann manuell bereinigen. Das manuelle Anhängen einer replizierten Datenrichtlinie in der sekundären Region wird nicht empfohlen, da dies zu komplizierten Situationen führen kann, z. B. dass FGAC-Berechtigungen nicht hinzugefügt oder entfernt werden können.
Wenn Sie eine getrennte Datenrichtlinie löschen, wird sie durch einen Hintergrundjob aus dem Tabellenschema entfernt. In diesem Fall wird die Änderung des Tabellenschemas an die Zielregion weitergegeben. Wie beim Trennen von Richtlinien müssen Sie die Datenrichtlinie in der sekundären Region manuell löschen.
Replikat löschen
Wenn Sie das Replikat löschen, werden die angehängten Datenrichtlinien nicht automatisch gelöscht. Wie beim Trennen von Richtlinien müssen Sie die Datenrichtlinie in der sekundären Region manuell löschen.