


Nach Problemen mit der Datenqualität suchen
Mit der automatischen Datenqualität von Knowledge Catalog können Sie die Datenqualität in Ihren BigQuery-Tabellen definieren und messen. Sie können Datenscans automatisieren, Daten anhand definierter Regeln validieren und Benachrichtigungen protokollieren, wenn Ihre Daten die Qualitätsanforderungen nicht erfüllen.
Sie können Datenqualitätsscans für Ihr gesamtes Projekt oder für eine bestimmte Tabelle verwalten. Weitere Informationen zur automatischen Datenqualität finden Sie unter Automatische Datenqualität – Übersicht.
Hinweis
-
Aktivieren Sie die Dataplex API, falls sie noch nicht aktiviert ist.
Erforderliche Rollen zum Aktivieren von APIs
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Inhaberrolle (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen - Optional: Wenn Knowledge Catalog Empfehlungen für Datenqualitätsregeln basierend auf den Ergebnissen eines Datenprofilscans generieren soll, erstellen Sie den Datenprofilscan und führen Sie ihn aus.
Erforderliche Rollen
In diesem Abschnitt werden die IAM-Rollen und -Berechtigungen beschrieben, die für die Verwendung von Knowledge Catalog-Datenqualitätsscans erforderlich sind.
Nutzerrollen und Berechtigungen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Ausführen und Verwalten von Datenqualitätsscans benötigen:
-
Datenqualitätsscan für eine BigQuery-Tabelle ausführen:
- BigQuery-Jobnutzer (
roles/bigquery.jobUser) für das Projekt, um Scanjobs auszuführen - BigQuery-Datenbetrachter (
roles/bigquery.dataViewer) für die zu scannende BigQuery-Tabelle
- BigQuery-Jobnutzer (
-
Ergebnisse des Datenqualitätsscans in Knowledge Catalog veröffentlichen:
- BigQuery-Dateneditor (
roles/bigquery.dataEditor) für die gescannte Tabelle - Dataplex Catalog Editor (
roles/dataplex.catalogEditor) für die Eintragsgruppe@bigqueryam selben Standort wie die Tabelle
- BigQuery-Dateneditor (
-
Bestimmte Aufgaben für
DataScan-Ressourcen ausführen:- Dataplex DataScan-Administrator (
roles/dataplex.dataScanAdmin) für das Projekt, um vollen Zugriff zu erhalten - Dataplex DataScan Creator (
roles/dataplex.dataScanCreator) für das Projekt, um Scans zu erstellen - Dataplex DataScan-Bearbeiter (
roles/dataplex.dataScanEditor) für das Projekt für Schreibzugriff - Dataplex DataScan Viewer (
roles/dataplex.dataScanViewer) für das Projekt, um Scan-Metadaten zu lesen - Dataplex DataScan DataViewer (
roles/dataplex.dataScanDataViewer) für das Projekt, um Scandaten einschließlich Regeln und Ergebnissen zu lesen
- Dataplex DataScan-Administrator (
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Ausführen und Verwalten von Datenqualitätsscans erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um Datenqualitätsscans auszuführen und zu verwalten:
-
Datenqualitätsscan für eine BigQuery-Tabelle ausführen:
-
bigquery.jobs.createfür das Projekt, um Scanjobs auszuführen -
bigquery.tables.getfür die zu scannende BigQuery-Tabelle -
bigquery.tables.getDatafür die zu scannende BigQuery-Tabelle
-
-
Ergebnisse des Datenqualitätsscans in Knowledge Catalog veröffentlichen:
-
bigquery.tables.updatefür die gescannte Tabelle -
dataplex.entryGroups.useDataQualityScorecardAspectfür die Eintraggruppe@bigqueryam selben Standort wie die Tabelle
-
-
Erstellen Sie ein
DataScan:dataplex.datascans.createfür das Projekt -
Um ein
DataScanzu löschen:dataplex.datascans.deletefür das Projekt -
DataScan-Metadaten aufrufen:dataplex.datascans.getfür das Projekt -
DataScan-Details einschließlich Regeln und Ergebnissen ansehen:dataplex.datascans.getDatafür das Projekt -
DataScans auflisten:dataplex.datascans.listim Projekt -
Führen Sie
DataScan:dataplex.datascans.runfür das Projekt aus. -
DataScanaktualisieren:dataplex.datascans.updatefür das Projekt -
IAM-Richtlinie für ein
DataScanabrufen oder festlegen:dataplex.datascans.getIamPolicyfür das Projektdataplex.datascans.setIamPolicyfür das Projekt
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Wenn Sie auf Spalten zugreifen müssen, die durch BigQuery-Zugriffsrichtlinien auf Spaltenebene geschützt sind, benötigen Sie auch Berechtigungen für diese Spalten.
Rollen und Berechtigungen für Knowledge Catalog-Dienstkonten
Wenn Sie noch keine Datenqualitäts- oder Datenprofilscans erstellt haben oder dieses Projekt keinen Knowledge Catalog-Lake enthält, erstellen Sie eine Dienstkennung, indem Sie Folgendes ausführen:
gcloud beta services identity create --service=dataplex.googleapis.com.
Dieser Befehl gibt eine Knowledge Catalog-Dienstkennung zurück, sofern sie vorhanden ist.
Damit das Knowledge Catalog-Dienstkonto des Projekts, das den Datenqualitätsscan enthält, die erforderlichen Berechtigungen zum Lesen von Daten aus verschiedenen Quellen und zum Exportieren von Ergebnissen hat, bitten Sie Ihren Administrator, dem Knowledge Catalog-Dienstkonto des Projekts, das den Datenqualitätsscan enthält, die folgenden IAM-Rollen zuzuweisen:
-
BigQuery-Tabellendaten lesen:
BigQuery-Datenbetrachter (
roles/bigquery.dataViewer) für zu scannende Tabellen und alle anderen Tabellen, auf die in Regeln verwiesen wird -
Iceberg REST Catalog-, SAP Business Data Cloud Delta Lake- und Apache Hive-Daten in Google Cloud Lakehouse-Tabellen lesen:
BigLake Viewer (
roles/biglake.viewer) für die zu scannenden Tabellen und alle anderen in Regeln referenzierten Tabellen -
Scanergebnisse in eine BigQuery-Tabelle exportieren: BigQuery Data Editor (
roles/bigquery.dataEditor) für das Ergebnis-Dataset und die Ergebnistabelle -
BigQuery-Daten scannen, die in einem Knowledge Catalog-Lake organisiert sind:
- Dataplex-Metadatenleser (
roles/dataplex.metadataReader) für Dataplex-Ressourcen - Dataplex-Betrachter (
roles/dataplex.viewer) für Dataplex-Ressourcen
- Dataplex-Metadatenleser (
-
Externe BigQuery-Tabelle aus Cloud Storage scannen: Storage-Objekt-Betrachter (
roles/storage.objectViewer) für den Cloud Storage-Bucket
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Lesen von Daten aus verschiedenen Quellen und zum Exportieren von Ergebnissen erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um Daten aus verschiedenen Quellen zu lesen und Ergebnisse zu exportieren:
-
BigQuery-Tabellendaten lesen:
-
bigquery.tables.getfür BigQuery-Tabellen -
bigquery.tables.getDatafür BigQuery-Tabellen
-
-
Scanergebnisse in eine BigQuery-Tabelle exportieren:
-
bigquery.datasets.getfür das Ergebnis-Dataset und die Ergebnistabelle -
bigquery.tables.createfür das Ergebnis-Dataset und die Ergebnistabelle -
bigquery.tables.getfür das Ergebnis-Dataset und die Ergebnistabelle -
bigquery.tables.getDatafür das Ergebnis-Dataset und die Ergebnistabelle -
bigquery.tables.updatefür das Ergebnis-Dataset und die Ergebnistabelle -
bigquery.tables.updateDatafür das Ergebnis-Dataset und die Ergebnistabelle
-
-
BigQuery-Daten scannen, die in einem Knowledge Catalog-Lake organisiert sind:
-
dataplex.lakes.listfür Dataplex-Ressourcen -
dataplex.lakes.getfür Dataplex-Ressourcen -
dataplex.zones.listfür Dataplex-Ressourcen -
dataplex.zones.getfür Dataplex-Ressourcen -
dataplex.entities.listfür Dataplex-Ressourcen -
dataplex.entities.getfür Dataplex-Ressourcen -
dataplex.operations.getfür Dataplex-Ressourcen
-
-
Externe BigQuery-Tabelle aus Cloud Storage scannen:
-
storage.buckets.getfür den Cloud Storage-Bucket -
storage.objects.getfür den Cloud Storage-Bucket
-
Ihr Administrator kann dem Knowledge Catalog-Dienstkonto des Projekts, das den Datenqualitätsscan enthält, diese Berechtigungen möglicherweise auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erteilen.
Wenn Sie auf Spalten zugreifen müssen, die durch BigQuery-Zugriffsrichtlinien auf Spaltenebene geschützt sind, weisen Sie dem Knowledge Catalog-Dienstkonto Berechtigungen für diese Spalten zu.
Wenn für eine Tabelle BigQuery-Zugriffsrichtlinien auf Zeilenebene aktiviert sind, können Sie nur Zeilen scannen, die für das Knowledge Catalog-Dienstkonto sichtbar sind. Die Zugriffsberechtigungen des einzelnen Nutzers werden bei Richtlinien auf Zeilenebene nicht berücksichtigt.
Datenqualitätsscan erstellen
Console
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Klicken Sie auf Datenqualitätsscan erstellen.
Füllen Sie im Fenster Scan definieren die folgenden Felder aus:
Optional: Geben Sie einen Anzeigenamen ein.
Geben Sie eine ID ein. Weitere Informationen finden Sie unter Namenskonventionen für Ressourcen.
Optional: Geben Sie eine Beschreibung ein.
Klicken Sie im Feld Tabelle auf Durchsuchen. Wählen Sie die Tabelle aus, die gescannt werden soll, und klicken Sie dann auf Auswählen. Es werden nur Standard-BigQuery-, Iceberg REST Catalog-, SAP BDC Delta- und Hive-Tabellen in Google CloudLakehouse unterstützt.
Wählen Sie für Tabellen in multiregionalen Datasets eine Region aus, in der der Datenscan erstellt werden soll.
Wenn Sie die Tabellen in Knowledge Catalog-Lakes durchsuchen möchten, klicken Sie auf In Knowledge Catalog-Lakes suchen.
Wählen Sie im Feld Umfang die Option Inkrementell oder Gesamte Daten aus.
- Wenn Sie Inkrementell auswählen, wählen Sie im Feld Spalte für Zeitstempel eine Spalte vom Typ
DATEoderTIMESTAMPaus Ihrer BigQuery-Tabelle aus, die mit dem Hinzufügen neuer Einträge zunimmt und zum Identifizieren neuer Einträge verwendet werden kann. Das kann eine Spalte sein, die die Tabelle partitioniert.
- Wenn Sie Inkrementell auswählen, wählen Sie im Feld Spalte für Zeitstempel eine Spalte vom Typ
Optional: Wenn Sie Ihre Daten filtern möchten, setzen Sie ein Häkchen bei Zeilen filtern. Geben Sie einen Zeilenfilter an, der aus einem gültigen SQL-Ausdruck besteht, der als Teil einer
WHERE-Anweisung in GoogleSQL-Syntax verwendet werden kann. Beispiel:col1 >= 0Der Filter kann eine Kombination aus mehreren Spaltenbedingungen sein. Beispiel:col1 >= 0 AND col2 < 10.Wenn Sie eine Stichprobe Ihrer Daten erstellen möchten, wählen Sie in der Liste Stichprobengröße einen Prozentsatz für die Stichprobe aus. Wählen Sie einen Prozentwert zwischen 0,0% und 100,0% mit bis zu drei Dezimalstellen aus. Wählen Sie bei größeren Datasets einen niedrigeren Prozentsatz für die Stichprobenerhebung aus. Wenn Sie beispielsweise für eine Tabelle mit einem Umfang von 1 PB einen Wert zwischen 0, 1% und 1, 0 % eingeben, werden beim Datenqualitätsscan 1–10 TB an Daten als Stichprobe erhoben. Bei Scans inkrementeller Daten wird die Stichprobe für den Datenqualitätsscan aus dem neuesten Inkrement erhoben.
Optional: Wenn Sie die Ergebnisse des Datenqualitätsscans als Knowledge Catalog-Metadaten veröffentlichen möchten, wählen Sie das Kästchen Ergebnisse in Knowledge Catalog veröffentlichen aus.
Sie können die neuesten Scanergebnisse auf den BigQuery- und Knowledge Catalog-Seiten für die Quelltabelle auf dem Tab Datenqualität ansehen. Wie Sie Nutzern Zugriff auf die veröffentlichten Scanergebnisse gewähren, erfahren Sie im Abschnitt Zugriff auf Ergebnisse des Datenqualitätsscans gewähren in diesem Dokument.
Informationen zum Anmeldedatentyp finden Sie unter Ausführungsidentität konfigurieren.
Wenn Sie einen Datenqualitätsscan mit Regeln erstellen möchten, wählen Sie Regeltyp > Mit eintragbasierter Regel erstellen aus.
Wählen Sie im Bereich Zeitplan eine der folgenden Optionen aus:
Wiederholen: Der Datenqualitätsscan wird nach einem Zeitplan ausgeführt: stündlich, täglich, wöchentlich, monatlich oder benutzerdefiniert. Geben Sie an, wie oft und zu welcher Uhrzeit der Scan ausgeführt werden soll. Wenn Sie „benutzerdefiniert“ auswählen, geben Sie den Zeitplan im Cron-Format an.
On-Demand: Der Datenqualitätsscan wird bei Bedarf ausgeführt.
Einmalige Ausführung: Führen Sie den Datenqualitätsscan jetzt einmal aus und entfernen Sie ihn nach der automatischen Löschung. Diese Feature befindet sich im Vorschaumodus.
- Automatisches Löschen von Scanergebnissen festlegen: Die Zeitspanne für das automatische Löschen ist die Zeit zwischen der Ausführung des Scans und dem Löschen des Scans. Ein Datenqualitätsscan ohne angegebene Zeit für das automatische Löschen wird 24 Stunden nach der Ausführung automatisch gelöscht. Die Zeit bis zum automatischen Löschen kann zwischen 0 Sekunden (sofortiges Löschen) und 365 Tagen liegen.
Klicken Sie auf Weiter.
Definieren Sie im Fenster Datenqualitätsregeln die Regeln, die für diesen Datenqualitätsscan konfiguriert werden sollen.
Klicken Sie auf Regeln hinzufügen und wählen Sie dann eine der folgenden Optionen aus.
Profilbasierte Empfehlungen: Erstellen Sie Regeln aus den Empfehlungen, die auf einem vorhandenen Datenprofilscan basieren.
Spalten auswählen: Wählen Sie die Spalten aus, für die Sie empfohlene Regeln erhalten möchten.
Scanprojekt auswählen: Wenn sich der Datenprofilscan in einem anderen Projekt befindet als das Projekt, in dem Sie den Datenqualitätsscan erstellen, wählen Sie das Projekt aus, aus dem Profilscans abgerufen werden sollen.
Profilergebnisse auswählen: Wählen Sie ein oder mehrere Profilergebnisse aus und klicken Sie dann auf OK. Dadurch wird eine Liste mit vorgeschlagenen Regeln ausgefüllt, die Sie als Ausgangspunkt verwenden können.
Klicken Sie das Kästchen für die Regeln an, die Sie hinzufügen möchten, und klicken Sie dann auf Auswählen. Nach der Auswahl werden die Regeln Ihrer aktuellen Regelliste hinzugefügt. Anschließend können Sie die Regeln bearbeiten.
Integrierte Regeltypen: Regeln aus vordefinierten Regeln erstellen. Liste der vordefinierten Regeln
Spalten auswählen: Wählen Sie die Spalten aus, für die Sie Regeln festlegen möchten.
Regeltypen auswählen: Wählen Sie die Regeltypen aus, die Sie verwenden möchten, und klicken Sie dann auf OK. Welche Regeltypen angezeigt werden, hängt von den ausgewählten Spalten ab.
Klicken Sie das Kästchen für die Regeln an, die Sie hinzufügen möchten, und klicken Sie dann auf Auswählen. Nach der Auswahl werden die Regeln der Liste der aktuellen Regeln hinzugefügt. Anschließend können Sie die Regeln bearbeiten.
Prüfregel für SQL-Zeilen: Erstellen Sie eine benutzerdefinierte SQL-Regel, die auf jede Zeile angewendet wird.
Wählen Sie unter Dimension eine Dimension aus.
Wählen Sie unter Schwellenwert für Bestehen einen Prozentsatz der Datensätze aus, die die Prüfung bestehen müssen.
Wählen Sie unter Spaltenname eine Spalte aus.
Geben Sie im Feld SQL-Ausdruck angeben einen SQL-Ausdruck ein, der als boolescher Wert
true(bestanden) oderfalse(nicht bestanden) ausgewertet wird. Weitere Informationen finden Sie unter Unterstützte benutzerdefinierte SQL-Regeltypen und in den Beispielen unter Datenqualitätsregeln definieren.Klicken Sie auf Hinzufügen.
Prüfregel für SQL-Aggregate: Erstellen Sie eine benutzerdefinierte SQL-Regel für Tabellenbedingungen.
Wählen Sie unter Dimension eine Dimension aus.
Wählen Sie unter Spaltenname eine Spalte aus.
Geben Sie im Feld SQL-Ausdruck angeben einen SQL-Ausdruck ein, der als boolescher Wert
true(bestanden) oderfalse(nicht bestanden) ausgewertet wird. Weitere Informationen finden Sie unter Unterstützte benutzerdefinierte SQL-Regeltypen und in den Beispielen unter Datenqualitätsregeln definieren.Klicken Sie auf Hinzufügen.
SQL-Assertion-Regel: Erstellen Sie eine benutzerdefinierte SQL-Assertion-Regel, um nach einem ungültigen Status der Daten zu suchen.
Wählen Sie unter Dimension eine Dimension aus.
Optional: Wählen Sie unter Spaltenname eine Spalte aus.
Geben Sie im Feld SQL-Anweisung angeben eine SQL-Anweisung ein, die Zeilen zurückgibt, die dem ungültigen Status entsprechen. Wenn Zeilen zurückgegeben werden, schlägt die Regel fehl. Lassen Sie das abschließende Semikolon in der SQL-Anweisung weg. Weitere Informationen finden Sie unter Unterstützte benutzerdefinierte SQL-Regeltypen und in den Beispielen unter Datenqualitätsregeln definieren.
Klicken Sie auf Hinzufügen.
Optional: Sie können jeder Datenqualitätsregel einen benutzerdefinierten Regelnamen für das Monitoring und die Benachrichtigung sowie eine Beschreibung zuweisen. Bearbeiten Sie dazu eine Regel und geben Sie die folgenden Details an:
- Regelname: Geben Sie einen benutzerdefinierten Regelnamen mit bis zu 63 Zeichen ein. Der Regelname kann Buchstaben (a–z, A–Z), Ziffern (0–9) und Bindestriche (-) enthalten und muss mit einem Buchstaben beginnen und mit einer Ziffer oder einem Buchstaben enden.
- Beschreibung: Geben Sie eine Regelbeschreibung mit maximal 1.024 Zeichen ein.
Wiederholen Sie die vorherigen Schritte, um dem Datenqualitätsscan weitere Regeln hinzuzufügen. Klicken Sie anschließend auf Weiter.
Optional: Exportieren Sie die Scanergebnisse in eine BigQuery-Standardtabelle. Führen Sie im Abschnitt Scanergebnisse in BigQuery-Tabelle exportieren folgende Schritte aus:
Klicken Sie im Feld BigQuery-Dataset auswählen auf Durchsuchen. Wählen Sie ein BigQuery-Dataset aus, in dem die Ergebnisse des Datenqualitätsscans gespeichert werden sollen.
Geben Sie im Feld BigQuery-Tabelle die Tabelle an, in der die Ergebnisse des Datenqualitätsscans gespeichert werden sollen. Wenn Sie eine vorhandene Tabelle verwenden, muss sie mit dem Schema der Exporttabelle kompatibel sein. Wenn die angegebene Tabelle nicht vorhanden ist, wird sie von Knowledge Catalog erstellt.
Optional: Fügen Sie Labels hinzu. Labels sind Schlüssel/Wert-Paare, mit denen Sie verwandte Objekte miteinander oder mit anderen Google Cloud -Ressourcen gruppieren können.
Optional: Richten Sie E-Mail-Benachrichtigungsberichte ein, um Personen über den Status und die Ergebnisse eines Jobs für Datenqualitätsscans zu informieren. Klicken Sie im Bereich Benachrichtigungsbericht auf E-Mail-ID hinzufügen und geben Sie bis zu fünf E-Mail-Adressen ein. Wählen Sie dann die Szenarien aus, für die Sie Berichte senden möchten:
- Wert für Qualität (<=): Sendet einen Bericht, wenn ein Job mit einem Datenqualitätsfaktor erfolgreich ist, der unter dem angegebenen Zielwert liegt. Geben Sie einen Ziel-Qualitätsfaktor zwischen 0 und 100 ein.
- Jobfehler: Es wird ein Bericht gesendet, wenn der Job selbst fehlschlägt, unabhängig von den Ergebnissen der Datenqualitätsprüfung.
- Jobabschluss (Erfolg oder Fehler): Sendet einen Bericht, wenn der Job beendet wird, unabhängig von den Ergebnissen der Datenqualität.
Klicken Sie auf Erstellen.
Nachdem der Scan erstellt wurde, können Sie ihn jederzeit ausführen, indem Sie auf Jetzt ausführen klicken.
gcloud
Verwenden Sie zum Erstellen eines Datenqualitätsscans den Befehl gcloud dataplex datascans create data-quality.
Wenn die Quelldaten in einem Knowledge Catalog-Lake organisiert sind, fügen Sie das Flag --data-source-entity ein:
gcloud dataplex datascans create data-quality DATASCAN \
    --location=LOCATION \
    --data-quality-spec-file=DATA_QUALITY_SPEC_FILE \
    --data-source-entity=DATA_SOURCE_ENTITY
Wenn die Quelldaten nicht in einem Knowledge Catalog-Lake organisiert sind, fügen Sie das Flag --data-source-resource ein:
gcloud dataplex datascans create data-quality DATASCAN \
    --location=LOCATION \
    --data-quality-spec-file=DATA_QUALITY_SPEC_FILE \
    --data-source-resource=DATA_SOURCE_RESOURCE
Ersetzen Sie die folgenden Variablen:
DATASCAN: Der Name des Datenqualitätsscans.LOCATION: Die Google Cloud -Region, in der der Datenqualitätsscan erstellt werden soll.DATA_QUALITY_SPEC_FILE: Der Pfad zur JSON- oder YAML-Datei, die die Spezifikationen für den Datenqualitätsscan enthält. Die Datei kann eine lokale Datei oder ein Cloud Storage-Pfad mit dem Präfixgs://sein. In dieser Datei werden die Datenqualitätsregeln für den Scan angegeben. Sie können in dieser Datei auch zusätzliche Details angeben, z. B. Filter, Stichprobenprozentsatz und Aktionen nach dem Scan, z. B. Export nach BigQuery oder Senden von E-Mail-Benachrichtigungsberichten. Weitere Informationen finden Sie in der Dokumentation zur JSON-Darstellung und im Beispiel für die YAML-Darstellung.DATA_SOURCE_ENTITY: Die Knowledge Catalog-Entität, die die Daten für den Datenqualitätsscan enthält. Beispiel:projects/test-project/locations/test-location/lakes/test-lake/zones/test-zone/entities/test-entityDATA_SOURCE_RESOURCE: Der Name der Ressource, die die Daten für den Datenqualitätsscan enthält. Beispiel://bigquery.googleapis.com/projects/test-project/datasets/test-dataset/tables/test-table
C#
C#
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Go
Go
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Java
Java
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Node.js
Node.js
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Python
Python
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Ruby
Ruby
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
REST
Verwenden Sie zum Erstellen eines Datenqualitätsscans die Methode dataScans.create.
Mit der folgenden Anfrage wird ein einmaliger Datenqualitätsscan erstellt:
POST https://dataplex.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/dataScans?data_scan_id=DATASCAN_ID

{
"data": {
  "resource": "//bigquery.googleapis.com/projects/PROJECT_ID/datasets/DATASET_ID/tables/TABLE_ID"
},
"type": "DATA_QUALITY",
"executionSpec": {
  "trigger": {
    "oneTime": {
      "ttl_after_scan_completion": "120s"
    }
  }
},
"dataQualitySpec": {
  "rules": [
    {
      "nonNullExpectation": {},
      "column": "COLUMN_NAME",
      "dimension": "DIMENSION",
      "threshold": 1
    }
  ],
  "filter": "FILTER_CONDITION"
}
}
Ersetzen Sie Folgendes:
PROJECT_ID: Ihre Projekt-ID.LOCATION: Die Region, in der der Datenqualitätsscan erstellt werden soll.DATASCAN_ID: Die ID des Datenqualitätsscans.DATASET_ID: Die ID des BigQuery-Datasets.TABLE_ID: Die ID der BigQuery-Tabelle.COLUMN_NAME: Der Spaltenname für die Regel.DIMENSION: Die Dimension für die Regel, z. B.VALIDITY.FILTER_CONDITION: Ein optionaler AIP-160-Filterstring, um Regeln selektiv auszuführen (z. B.name = \"RULE_NAME\").
Wenn Sie Regeln für den Datenqualitätsscan mithilfe von Regelempfehlungen erstellen möchten, die auf den Ergebnissen eines Datenprofilscans basieren, rufen Sie die Empfehlungen ab, indem Sie die Methode dataScans.jobs.generateDataQualityRules für den Datenprofilscan aufrufen.
Datenqualitätsscan ausführen
Console
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Klicken Sie auf den Datenqualitätsscan, der ausgeführt werden soll.
Klicken Sie auf Jetzt ausführen.
gcloud
Verwenden Sie den Befehl gcloud dataplex datascans run, um einen Datenqualitäts-Scan auszuführen:
gcloud dataplex datascans run DATASCAN \
--location=LOCATION \
Ersetzen Sie die folgenden Variablen:
LOCATION: Die Google Cloud -Region, in der der Datenqualitätsscan erstellt wurde.DATASCAN: Der Name des Datenqualitätsscans.
C#
C#
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Go
Go
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Java
Java
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Python
Python
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Ruby
Ruby
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
REST
Verwenden Sie die Methode dataScans.run, um einen Datenqualitätsscan auszuführen.
Airflow
Wenn Sie einen Datenqualitätsscan mit einem gerichteten azyklischen Graphen (Directed Acyclic Graph, DAG) in Managed Service for Apache Airflow (Cloud Composer) ausführen möchten, verwenden Sie den DataplexRunDataQualityScanOperator:
from datetime import datetime
from airflow import DAG
from airflow.providers.google.cloud.operators.dataplex import DataplexRunDataQualityScanOperator

with DAG(
  "dataplex_auto_dq_scan",
  start_date=datetime(2026, 1, 1),
  schedule_interval="@daily",
  catchup=False,
) as dag:

  run_dq_scan = DataplexRunDataQualityScanOperator(
      task_id="run_dataplex_dq_scan",
      project_id="PROJECT_ID",
      region="REGION",
      data_scan_id="DATASCAN_ID",
  )
Ersetzen Sie Folgendes:
PROJECT_ID: Ihre Google Cloud Projekt-IDREGION: Die Google Cloud -Region, in der der Datenqualitätsscan erstellt wurde.DATASCAN_ID: Die ID Ihres Datenqualitätsscans.
Ergebnisse des Datenqualitätsscans ansehen
Console
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Klicken Sie auf den Namen eines Datenqualitätsscans.
Im Bereich Übersicht werden Informationen zu den letzten Jobs angezeigt, einschließlich des Zeitpunkts, zu dem der Scan ausgeführt wurde, der Anzahl der in jedem Job gescannten Einträge, ob alle Datenqualitätsprüfungen erfolgreich waren und, falls Fehler aufgetreten sind, der Anzahl der fehlgeschlagenen Datenqualitätsprüfungen.
Im Bereich Konfiguration des Datenqualitätsscans werden Details zum Scan angezeigt.
Wenn Sie detaillierte Informationen zu einem Job aufrufen möchten, z. B. Datenqualitätswerte, die den Prozentsatz der bestandenen Regeln, die fehlgeschlagenen Regeln und die Joblogs angeben, klicken Sie auf den Tab Jobverlauf. Klicken Sie dann auf eine Job-ID.
gcloud
Verwenden Sie den Befehl gcloud dataplex datascans jobs describe, um die Ergebnisse eines Datenqualitätsscan-Jobs aufzurufen:
gcloud dataplex datascans jobs describe JOB \
--location=LOCATION \
--datascan=DATASCAN \
--view=FULL
Ersetzen Sie die folgenden Variablen:
JOB: Die Job-ID des Datenqualitätsscan-Jobs.LOCATION: Die Google Cloud -Region, in der der Datenqualitätsscan erstellt wurde.DATASCAN: Der Name des Datenqualitätsscans, zu dem der Job gehört.--view=FULL: Wenn Sie das Ergebnis des Scanjobs sehen möchten, geben SieFULLan.
C#
C#
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Go
Go
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Java
Java
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Python
Python
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Ruby
Ruby
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
REST
Verwenden Sie die Methode dataScans.get, um die Ergebnisse eines Datenqualitätsscans aufzurufen.
Veröffentlichte Ergebnisse ansehen
Wenn die Ergebnisse des Datenqualitätsscans als Knowledge Catalog-Metadaten veröffentlicht werden, können Sie die neuesten Scanergebnisse auf den BigQuery- und Knowledge Catalog-Seiten in derGoogle Cloud Console auf dem Tab Datenqualität der Quelltabelle sehen.
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
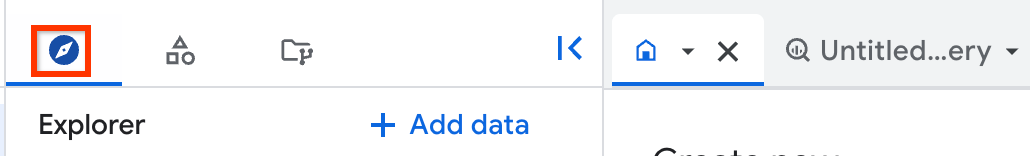
Wenn der linke Bereich nicht angezeigt wird, klicken Sie auf Linken Bereich maximieren, um ihn zu öffnen.
Klicken Sie im Bereich Explorer auf Datasets und dann auf Ihr Dataset.
Klicken Sie auf Übersicht > Tabellen und wählen Sie die Tabelle aus, deren Ergebnisse des Datenqualitätsscans Sie sehen möchten.
Klicken Sie auf den Tab Datenqualität.
Die zuletzt veröffentlichten Ergebnisse werden angezeigt.
Historische Scanergebnisse ansehen
In Knowledge Catalog wird der Verlauf der Datenqualitätsscans der letzten 300 Jobs oder des letzten Jahres gespeichert (der kürzere Zeitraum gilt).
Console
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Klicken Sie auf den Namen eines Datenqualitätsscans.
Klicken Sie auf den Tab Jobverlauf.
Auf dem Tab Jobverlauf finden Sie Informationen zu früheren Jobs, z. B. die Anzahl der in jedem Job gescannten Einträge, den Jobstatus, die Uhrzeit der Jobausführung und ob die einzelnen Regeln bestanden wurden oder fehlgeschlagen sind.
Wenn Sie die Details zu einem Job aufrufen möchten, klicken Sie in der Spalte Job-ID auf einen der Jobs.
gcloud
Verwenden Sie den Befehl gcloud dataplex datascans jobs list, um Jobs für Datenqualitätsscans im Verlauf aufzurufen:
gcloud dataplex datascans jobs list \
--location=LOCATION \
--datascan=DATASCAN \
Ersetzen Sie die folgenden Variablen:
LOCATION: Die Google Cloud -Region, in der der Datenqualitätsscan erstellt wurde.DATASCAN: Der Name des Datenqualitätsscans, für den Sie historische Jobs ansehen möchten.
C#
C#
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Go
Go
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Java
Java
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Python
Python
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Ruby
Ruby
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
REST
Verwenden Sie die Methode dataScans.jobs.list, um Jobs für Datenqualitätsscans aus der Vergangenheit aufzurufen.
Jobstatus
Datenscanjobs können die folgenden Status haben:
PENDING: Der Job wurde erstellt, aber noch nicht gestartet. In diesem Status richtet der Scan aktiv die Infrastruktur ein oder ruft Slots ab. Diese Phase kann je nach Schemakomplexität und Ressourcenkonflikten 10 bis 20 Sekunden oder länger dauern.RUNNING: Der Job wird ausgeführt.CANCELING: Der Job wird abgebrochen.CANCELLED: Der Job wurde abgebrochen.SUCCEEDED: Der Job wurde erfolgreich abgeschlossen. Der Abschlussstatus kann aufgrund von Nachbearbeitungsschritten wie Aggregation und Metadatensynchronisierung bis zu 60 Sekunden hinter dem tatsächlichen Abschluss der Abfrage liegen.FAILED: Der Job schlägt aufgrund eines Fehlers fehl. Der Abschlussstatus kann aufgrund von Nachbearbeitungsschritten wie Aggregation und Metadatensynchronisierung bis zu 60 Sekunden hinter dem tatsächlichen Abschluss der Abfrage liegen.SUCCEEDED_WITH_ERRORS: Der Job wird erfolgreich abgeschlossen, aber während der Ausführung treten einige Fehler auf.
Best Practices für das Monitoring
Beachten Sie beim Überwachen Ihrer Datenscanjobs die folgenden Best Practices:
Aggressive Abfragen vermeiden: Vermeiden Sie aggressive Abfragen (z. B. alle 1 bis 5 Sekunden
GetJoboder Ähnliches aufrufen). Aggressives Abfragen verschwendet API-Kontingent und beschleunigt Statusübergänge nicht.Exponentiellen Backoff verwenden: Wenn wiederholtes Abfragen unvermeidlich ist, verwenden Sie einen exponentiellen Backoff, der bei 10 bis 15 Sekunden beginnt.
Asynchrone ereignisgesteuerte Entkopplung verwenden (empfohlen): Verwenden Sie anstelle von synchronem API-Polling Eventarc-Trigger, die auf Cloud-Audit-Logs (
cloudaudit.googleapis.com) warten. Mit diesen Triggern können Sie nachgelagerte Workflows sofort nach Abschluss von DataScan-Jobs initiieren. Bei diesem Ansatz werden die Limits für API-Abfragen umgangen, das Kontingent wird geschont und die wahrgenommene Latenz wird reduziert.
Zugriff auf Ergebnisse von Datenqualitätsscans gewähren
So ermöglichen Sie den Nutzern in Ihrer Organisation, die Scanergebnisse aufzurufen:
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Klicken Sie auf den Datenqualitätsscan, dessen Ergebnisse Sie freigeben möchten.
Klicken Sie auf den Tab Berechtigungen.
Gehen Sie dazu so vor:
- Klicken Sie auf Zugriff gewähren, um einem Hauptkonto Zugriff zu gewähren. Weisen Sie dem zugehörigen Hauptkonto die Rolle Dataplex DataScan DataViewer zu.
- Wenn Sie den Zugriff für ein Hauptkonto entfernen möchten, wählen Sie das Hauptkonto aus, für das Sie die Rolle Dataplex DataScan DataViewer entfernen möchten. Klicken Sie auf Zugriff entfernen und bestätigen Sie den Vorgang, wenn Sie dazu aufgefordert werden.
Fehler bei der Datenqualität beheben
Sie können Benachrichtigungen für Datenqualitätsfehler mithilfe der Logs in Cloud Logging einrichten. Weitere Informationen, einschließlich Beispielabfragen, finden Sie unter Benachrichtigungen in Cloud Logging festlegen.
Für jeden Job mit Regeln auf Zeilenebene, die fehlschlagen, stellt Knowledge Catalog eine Abfrage bereit, mit der Sie die fehlgeschlagenen Einträge abrufen können. Führen Sie diese Abfrage aus, um die Datensätze aufzurufen, die nicht mit Ihrer Regel übereinstimmen.
Console
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Klicken Sie auf den Namen des Datenqualitätsscans, dessen Datensätze Sie beheben möchten.
Klicken Sie auf den Tab Jobverlauf.
Klicken Sie auf die Job-ID des Jobs, bei dem Datenqualitätsprobleme festgestellt wurden.
Suchen Sie im Fenster mit den Jobergebnissen im Abschnitt Regeln nach der Spalte Abfrage zum Abrufen fehlgeschlagener Einträge. Klicken Sie für die fehlgeschlagene Regel auf Abfrage in die Zwischenablage kopieren.
Führen Sie die Abfrage in BigQuery aus, um die Datensätze zu sehen, die zum Fehlschlagen des Jobs geführt haben.
gcloud
Nicht unterstützt.
REST
Verwenden Sie die Methode
dataScans.get, um den Job abzurufen, der die Datenqualitätsprobleme identifiziert hat.Im Antwortobjekt wird die Abfrage im Feld
failingRowsQueryangezeigt.Führen Sie die Abfrage in BigQuery aus, um die Datensätze zu sehen, die zum Fehlschlagen des Jobs geführt haben.
Knowledge Catalog führt auch die Debug-Abfrage aus, sofern sie bei der Regelerstellung angegeben wurde. Die Ergebnisse der Debug-Abfrage sind in der Ausgabe jeder Regel enthalten. Dieses Feature befindet sich im Vorschaumodus.
Console
Nicht unterstützt.
gcloud
Nicht unterstützt.
REST
Verwenden Sie die Methode dataScans.get, um den Job abzurufen, der die Datenqualitätsprobleme identifiziert hat.
Im Antwortobjekt werden im Feld debugQueriesResultSets die Ergebnisse der Debug-Abfragen angezeigt.
Datenqualitätsscans für eine bestimmte Tabelle verwalten
In diesem Dokument wird beschrieben, wie Sie Scans zur Datenqualität in Ihrem Projekt verwalten. Verwenden Sie dazu in derGoogle Cloud Console die BigQuery-Seite Metadatenkuratierung > Datenprofilerstellung und ‑qualität.
Sie können Datenqualitätsscans auch erstellen und verwalten, wenn Sie mit einer bestimmten Tabelle arbeiten. Rufen Sie in der Google Cloud Console auf der BigQuery-Seite für die Tabelle den Tab Datenqualität auf. Gehen Sie dazu so vor:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im Bereich Explorer (im linken Bereich) auf Datasets und dann auf Ihr Dataset. Klicken Sie auf Übersicht > Tabellen und wählen Sie die Tabelle aus, deren Ergebnisse des Datenqualitätsscans Sie sehen möchten.
Klicken Sie auf den Tab Datenqualität.
Je nachdem, ob für die Tabelle ein Datenqualitätsscan vorhanden ist, dessen Ergebnisse als Knowledge Catalog-Metadaten veröffentlicht werden, können Sie mit den Datenqualitätsscans der Tabelle auf folgende Weise arbeiten:
Ergebnisse des Datenqualitätsscans werden veröffentlicht: Die neuesten Scanergebnisse werden auf der Seite angezeigt.
Wenn Sie die Datenqualitätsscans für diese Tabelle verwalten möchten, klicken Sie auf Datenqualitätsscan und wählen Sie eine der folgenden Optionen aus:
Neuen Scan erstellen: Erstellen Sie einen neuen Datenqualitätsscan. Weitere Informationen finden Sie im Abschnitt Datenqualitätsscan erstellen in diesem Dokument. Wenn Sie einen Scan auf der Detailseite einer Tabelle erstellen, ist die Tabelle bereits ausgewählt.
Jetzt ausführen: Der Scan wird ausgeführt.
Scankonfiguration bearbeiten: Bearbeiten Sie Einstellungen wie den Anzeigenamen, Filter und den Zeitplan.
Wenn Sie die Datenqualitätsregeln bearbeiten möchten, klicken Sie auf dem Tab Datenqualität auf den Tab Regeln. Klicken Sie auf Regeln ändern. Aktualisieren Sie die Regeln und klicken Sie dann auf Speichern.
Scanberechtigungen verwalten: Sie können festlegen, wer auf die Scanergebnisse zugreifen darf. Weitere Informationen finden Sie im Abschnitt Zugriff auf Ergebnisse des Datenqualitätsscans gewähren in diesem Dokument.
Verlaufsergebnisse ansehen: Hier finden Sie detaillierte Informationen zu früheren Datenqualitätsscan-Jobs. Weitere Informationen finden Sie in den Abschnitten Ergebnisse des Datenqualitätsscans ansehen und Historische Scanergebnisse ansehen in diesem Dokument.
Alle Scans ansehen: Eine Liste der Datenqualitätsscans aufrufen, die für diese Tabelle gelten.
Ergebnisse des Datenqualitätsscans werden nicht veröffentlicht: Wählen Sie eine der folgenden Optionen aus:
Datenqualitätsscan erstellen: Erstellen Sie einen neuen Datenqualitätsscan. Weitere Informationen finden Sie im Abschnitt Datenqualitätsscan erstellen in diesem Dokument. Wenn Sie einen Scan auf der Detailseite einer Tabelle erstellen, ist die Tabelle bereits ausgewählt.
Vorhandene Scans ansehen: Eine Liste der Datenqualitätsscans für diese Tabelle ansehen.
Datenqualitätsscans für eine Tabelle ansehen
So rufen Sie die Datenqualitätsscans für eine bestimmte Tabelle auf:
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Filtern Sie die Liste nach Tabellenname und Scantyp.
Datenqualitätsscan aktualisieren
Sie können verschiedene Einstellungen für einen vorhandenen Datenqualitätsscan bearbeiten, z. B. den Anzeigenamen, Filter, den Zeitplan und Datenqualitätsregeln.
Console
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Klicken Sie auf den Namen eines Datenqualitätsscans.
Wenn Sie Einstellungen wie den Anzeigenamen, Filter und den Zeitplan bearbeiten möchten, klicken Sie auf Bearbeiten. Bearbeiten Sie die Werte und klicken Sie dann auf Speichern.
Wenn Sie die Datenqualitätsregeln bearbeiten möchten, klicken Sie auf der Scan-Detailseite auf den Tab Aktuelle Regeln. Klicken Sie auf Regeln ändern. Aktualisieren Sie die Regeln und klicken Sie dann auf Speichern.
gcloud
Verwenden Sie den Befehl gcloud dataplex datascans update data-quality, um die Beschreibung eines Datenqualitätsscans zu aktualisieren:
gcloud dataplex datascans update data-quality DATASCAN \
--location=LOCATION \
--description=DESCRIPTION
Ersetzen Sie Folgendes:
DATASCAN: Der Name des zu aktualisierenden Datenqualitätsscans.LOCATION: Die Google Cloud -Region, in der der Datenqualitätsscan erstellt wurde.DESCRIPTION: Die neue Beschreibung für den Datenqualitätsscan.
C#
C#
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Go
Go
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Java
Java
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Python
Python
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Ruby
Ruby
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
REST
Verwenden Sie zum Bearbeiten eines Datenqualitätsscans die Methode dataScans.patch.
Datenqualitätsscan löschen
Console
Console
Rufen Sie in der Google Cloud Console auf der BigQuery-Seite Metadatenkuratierung den Tab Datenprofilerstellung und ‑qualität auf.
Klicken Sie auf den Scan, den Sie löschen möchten.
Klicken Sie auf Löschen und bestätigen Sie den Löschvorgang, wenn Sie dazu aufgefordert werden.
gcloud
gcloud
Verwenden Sie den Befehl gcloud dataplex datascans delete, um einen Datenqualitätsscan zu löschen:
gcloud dataplex datascans delete DATASCAN \
--location=LOCATION \
--async
Ersetzen Sie die folgenden Variablen:
DATASCAN: Der Name des zu löschenden Datenqualitätsscans.LOCATION: Die Google Cloud -Region, in der der Datenqualitätsscan erstellt wurde.
C#
C#
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Go
Go
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Java
Java
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Python
Python
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Ruby
Ruby
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
REST
REST
Verwenden Sie zum Löschen eines Datenqualitätsscans die Methode dataScans.delete.