


Mit Knowledge Catalog (früher Dataplex Universal Catalog) können Sie die Qualität der Daten in Ihren BigQuery- und Iceberg REST Catalog-Tabellen definieren und messen. Sie können das Scannen von Daten automatisieren, Daten anhand definierter Regeln validieren und Warnungen protokollieren, wenn Ihre Daten die Qualitätsanforderungen nicht erfüllen. Mit der automatischen Datenqualität können Sie Datenqualitätsregeln und Bereitstellungen als Code verwalten und so die Integrität von Pipelines für die Datenproduktion verbessern.
Informationen zum Scannen von Daten auf Anomalien finden Sie unter Knowledge Catalog-Datenprofilscan. Der Scan kann Datenqualitätsregeln generieren. Sie können auch integrierte Qualitätsregeln verwenden oder benutzerdefinierte Regeln erstellen.
Knowledge Catalog bietet Monitoring, Fehlerbehebung und Cloud Logging-Benachrichtigungen, die in die automatische Datenqualität eingebunden sind.
Konzeptionelles Modell
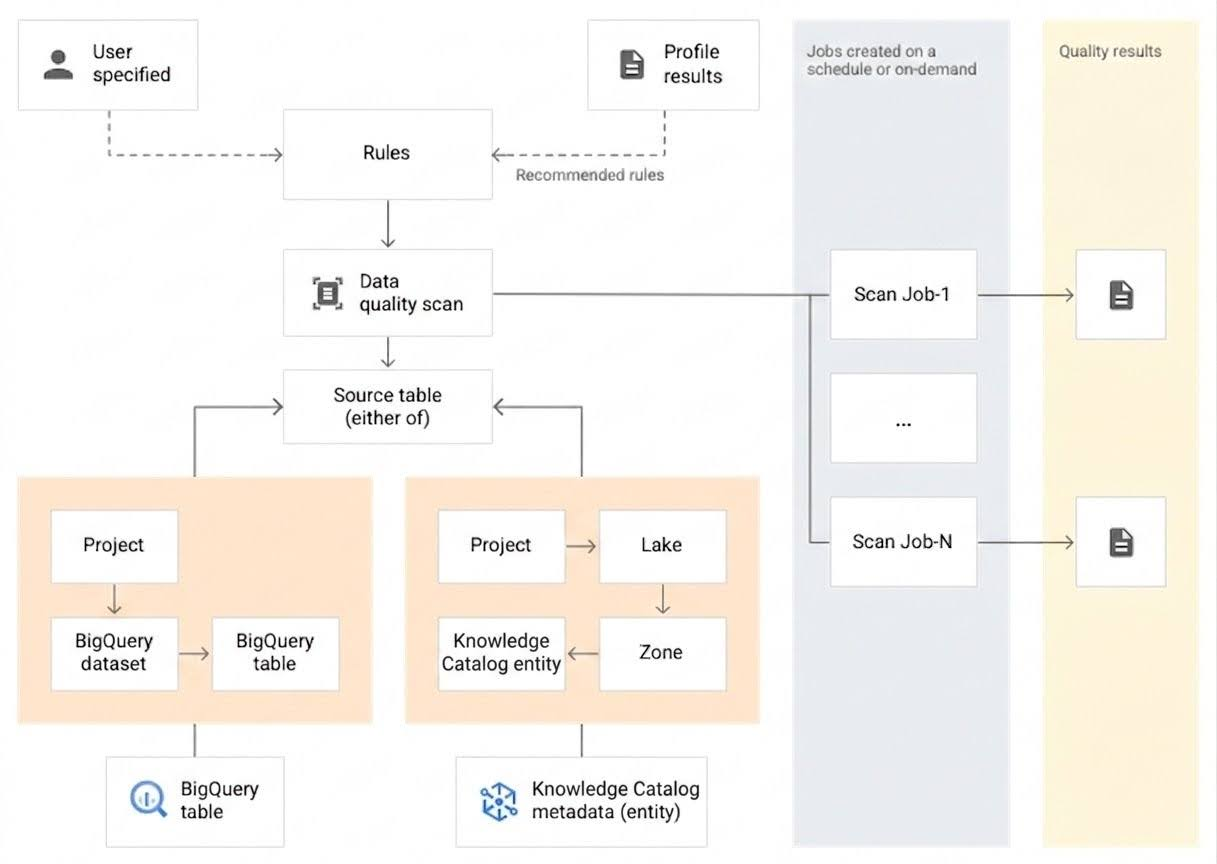
Ein Datenqualitätsscan ist ein Knowledge Catalog-Datenscan, bei dem Ihre Daten anhand einer Reihe integrierter Regeln validiert werden. Ein Datenscan ist ein Knowledge Catalog-Job, der Stichproben von Daten aus BigQuery und Cloud Storage (über externe BigQuery-Tabellen) nimmt und verschiedene Arten von Metadaten ableitet. Wenn Sie die Qualität einer Tabelle mit der automatischen Datenqualität messen möchten, erstellen Sie ein DataScan-Objekt vom Typ data quality. Der Scan wird nur für eine BigQuery-Tabelle ausgeführt.
Beim Scan werden Ressourcen in einem Mandantenprojekt von Google verwendet, sodass Sie keine eigene Infrastruktur einrichten müssen.
Das Erstellen und Verwenden eines Datenqualitätsscans umfasst die folgenden Schritte:
- Datenqualitätsregeln definieren
- Regelausführung konfigurieren
- Ergebnisse des Datenqualitätsscans analysieren
- Monitoring und Benachrichtigungen einrichten
- Probleme mit der Datenqualität beheben
Regeldefinition
Datenqualitätsregeln, die mit einem Datenqualitätsscan verknüpft sind, definieren die Erwartungen an die Daten. Sie können Datenqualitätsregeln auf folgende Arten erstellen:
- Empfehlungen aus dem Data Profiling in Knowledge Catalog verwenden
- Integrierte Regeln oder Systemregelvorlagen verwenden
- Benutzerdefinierte SQL-Regeln erstellen
- Datenqualitätsregeln wiederverwenden
Integrierte Regeln
Knowledge Catalog unterstützt die folgenden Kategorien von integrierten Regeln:
- Auf Zeilenebene
Bei Kategorie-Regeln auf Zeilenebene wird die Erwartung auf jede Datenzeile angewendet. Jede Zeile erfüllt die Bedingung unabhängig oder nicht. Beispiel:
column_A_value < 1.Für Prüfungen auf Zeilenebene müssen Sie einen Schwellenwert für das Bestehen angeben. Wenn der Prozentsatz der Zeilen, die die Regel erfüllen, unter den Schwellenwert fällt, schlägt die Regel fehl.
- Aggregieren
Bei Aggregatregeln wird die Erwartung auf einen einzelnen Wert angewendet, der über die gesamten Daten aggregiert wird. Beispiel:
Avg(someCol) >= 10Damit die Prüfung bestanden wird, muss sie den booleschen Werttrueergeben. Bei Aggregationsregeln wird nicht für jede Zeile eine unabhängige Anzahl von bestandenen oder nicht bestandenen Prüfungen angegeben.
Für beide Regelkategorien können Sie die folgenden Parameter festlegen:
- Die Spalte, für die die Regel gilt
- Eine Dimension
In der folgenden Tabelle sind die unterstützten Regeltypen auf Zeilenebene und aggregierten Regeltypen aufgeführt:
| Regeltyp (Name in der Google Cloud Konsole) |
Regel auf Zeilenebene oder aggregierte Regel | Beschreibung | Unterstützte Spaltentypen | Regelspezifische Parameter |
|---|---|---|---|---|
RangeExpectation(Bereichsprüfung) |
Auf Zeilenebene | Prüfen Sie, ob der Wert zwischen dem Mindest- und dem Höchstwert liegt. | Alle Spalten mit numerischen, Datums- und Zeitstempeltypen. | Erforderlich:
|
NonNullExpectation(Nullprüfung) |
Auf Zeilenebene | Prüfen Sie, ob die Spaltenwerte nicht NULL sind. | Alle unterstützten Spaltentypen. | Erforderlich:
|
SetExpectation(Prüfung festlegen) |
Auf Zeilenebene | Prüft, ob die Werte in einer Spalte einem der angegebenen Werte in einer Gruppe entsprechen. | Alle unterstützten Spaltentypen, außer Record und Struct. |
Erforderlich:
|
RegexExpectation(Prüfung mit regulärem Ausdruck) |
Auf Zeilenebene | Die Werte werden mit einem angegebenen regulären Ausdruck abgeglichen. | String | Erforderlich:
|
Uniqueness(Eindeutigkeitsprüfung) |
Aggregieren | Prüfen, ob alle Werte in einer Spalte eindeutig sind. | Alle unterstützten Spaltentypen, außer Record und Struct. |
Erforderlich:
|
StatisticRangeExpectation(Statistikprüfung) |
Aggregieren | Prüfen, ob das angegebene statistische Maß dem erwarteten Bereich entspricht. | Alle unterstützten numerischen Spaltentypen. | Erforderlich:
|
Unterstützte benutzerdefinierte SQL-Regeltypen
SQL-Regeln bieten die Flexibilität, die Validierung mit benutzerdefinierter Logik zu erweitern. Diese Regeln gibt es in den folgenden Typen.
| Regeltyp | Regel auf Zeilenebene oder aggregierte Regel | Beschreibung | Unterstützte Spaltentypen | Regelspezifische Parameter | Beispiel |
|---|---|---|---|---|---|
| Zeilenbedingung | Auf Zeilenebene | Geben Sie für jede Zeile eine Erwartung an, indem Sie einen SQL-Ausdruck in einer WHERE-Klausel definieren. Der SQL-Ausdruck sollte pro Zeile als true (bestanden) oder false (nicht bestanden) ausgewertet werden.Knowledge Catalog berechnet den Prozentsatz der Zeilen, die diese Erwartung erfüllen, und vergleicht diesen Wert mit dem Prozentsatz des Schwellenwerts für das Bestehen, um zu bestimmen, ob die Regel erfüllt wurde oder nicht. Der Ausdruck kann einen Verweis auf eine andere Tabelle enthalten, um beispielsweise Prüfungen der referenziellen Integrität zu erstellen. |
Alle Spalten | Erforderlich:
|
grossWeight <= netWeight |
| Tabellenbedingung (aggregierter SQL-Ausdruck) |
Aggregieren | Diese Regeln werden einmal pro Tabelle ausgeführt. Geben Sie einen SQL-Ausdruck an, der als boolescher Wert true (bestanden) oder false (nicht bestanden) ausgewertet wird.Der SQL-Ausdruck kann mithilfe von Ausdruck-Unterabfragen auf eine andere Tabelle verweisen. |
Alle Spalten | Erforderlich:
|
Einfaches Aggregatbeispiel:avg(price) > 100Ausdrucksunterabfrage zum Vergleichen von Werten in einer anderen Tabelle verwenden: (SELECT COUNT(*) FROM `example_project.example_dataset.different-table`) < COUNT(*) |
| SQL-Assertion | Aggregieren | Eine Assertionsregel verwendet eine Datenqualitätsabfrage, um Zeilen zu finden, die eine oder mehrere in der Abfrage angegebene Bedingungen nicht erfüllen. Geben Sie eine SQL-Anweisung an, die ausgewertet wird, um Zeilen zurückzugeben, die dem ungültigen Status entsprechen. Wenn die Abfrage Zeilen zurückgibt, schlägt die Regel fehl. Lassen Sie das abschließende Semikolon in der SQL-Anweisung weg. Die SQL-Anweisung kann mithilfe von Ausdruck-Unterabfragen einen Verweis auf eine andere Tabelle enthalten. |
Alle Spalten | Erforderlich:
|
Einfaches Aggregatbeispiel, um sicherzustellen, dass discount_pct nicht größer als 100 ist:SELECT * FROM example_project.example_dataset.table WHERE discount_pct > 100Verwendung einer Ausdrucksunterabfrage, um Werte in einer anderen Tabelle zu vergleichen: SELECT * FROM `example_project.example_dataset.different-table` WHERE gross_weight > (SELECT avg(gross_weight) FROM `example_project.example_dataset.different-table`)
|
Beispielregeln finden Sie unter Beispielregeln für die automatische Datenqualität.
Informationen zu den unterstützten SQL-Funktionen finden Sie in der GoogleSQL-Referenz.
Datenqualitätsregeln wiederverwenden
Sie können Datenqualitätsregeln aus Knowledge Catalog wiederverwenden, um komplexe oder standardisierte Geschäftsregeldefinitionen mithilfe von Regelvorlagen für mehrere Datenqualitätsregeln freizugeben. Sie können beispielsweise eine Regelvorlage für eine E-Mail-Validierung oder für die Validierung von Fremdschlüsseln zwischen zwei Tabellen erstellen und diese Vorlagen dann für Ihre Datenscans wiederverwenden.
Die Wiederverwendbarkeit von Regeln bietet die folgenden wichtigen Funktionen:
- Vorlagen für Datenqualitätsregeln: Erstellen Sie benutzerdefinierte Regelvorlagen, um komplexe oder standardisierte Geschäftsregeldefinitionen zu speichern, die für mehrere Datenqualitätsregeln verwendet werden können. Erstellen Sie einen
data-quality-rule-template-Eintrag und fügen Sie ihm einendata-quality-rule-template-Aspekt hinzu, um die Vorlagenlogik zu definieren. - Datenregeln als Metadaten: Deklarieren Sie Datenqualitätsregeln als Aspekte in Knowledge Catalog für Einträge wie BigQuery-Tabellen oder Begriffe im Unternehmensglossar. Verwenden Sie den Aspekttyp
data-rules, um diese Regeln an Einträge anzuhängen. - Systemregelvorlagen: Verwenden Sie Systemregelvorlagen für häufig verwendete Regeln.
Weitere Informationen finden Sie unter Datenqualitätsregeln wiederverwenden.
Dimensionen
Mit Dimensionen können Sie die Ergebnisse mehrerer Datenqualitätsregeln für das Monitoring und die Benachrichtigung zusammenfassen. Sie müssen jede Datenqualitätsregel mit einer Dimension verknüpfen. Knowledge Catalog bietet die folgenden Dimensionen:
- Aktualität
- Die Aktualität gibt an, wann die Daten zuletzt aktualisiert wurden. Anhand dieser Informationen können Sie feststellen, ob die Daten aktuell genug sind, um nützlich zu sein.
- Volumen
- Das Volumen gibt an, ob alle erwarteten Daten vorhanden sind.
- Vollständigkeit
- Mit der Vollständigkeit wird bewertet, ob die Daten alle Informationen enthalten, die für den beabsichtigten Zweck erforderlich sind.
- Gültigkeit
- Mit der Prüfung auf Gültigkeit wird ermittelt, ob die Daten den integrierten Standards für Format, akzeptable Bereiche oder andere Kriterien entsprechen. Wenn ein gültiges Datum beispielsweise das Format
YYYY/mm/ddhaben muss, ist 08-12-2019 ungültig. Ein weiteres Beispiel: Wenn ein gültiger Sonderangebotspreis für einen Artikel zwischen 10 € und 20 € liegt, ist ein Sonderangebotspreis von 100 € ungültig. - Konsistenz
- Konsistenz bedeutet, dass die Daten in mehreren Instanzen, z. B. Tabellen und Spalten, dieselben Werte haben. Inkonsistenzen in Daten entstehen beispielsweise, wenn der Umsatz eines Produkts unterschiedlich ist, wenn er aus einer Verkaufsdatenbank oder einer Nutzungsdatenbank gelesen wird.
- Genauigkeit
- Die Genauigkeit bezieht sich auf die Korrektheit der Daten. Beachten Sie, dass gültige Daten nicht unbedingt korrekt sind. Beispielsweise ist „braun“ eine gültige Haarfarbe, aber wenn eine Person keine braunen Haare hat, sind diese Daten ungenau.
- Eindeutigkeit
- Die Einzigartigkeit gibt an, ob die Daten eindeutig sind und keine Duplikate enthalten.
Eingabe mit Typ in Regeln
Alle Wertparameter werden als Stringwerte an die API übergeben. Knowledge Catalog erfordert, dass Eingaben dem von BigQuery angegebenen Format entsprechen.
Parameter vom Typ „Binär“ können als Base64-codierter String übergeben werden.
| Typ | Unterstützte Formate | Beispiele |
|---|---|---|
| Binär | Base64-codierter Wert | YXBwbGU= |
| Zeitstempel | YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]] [time_zone] ODER YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]][time_zone_offset] |
2014-09-27 12:30:00.45-08 |
| Datum | YYYY-M[M]-D[D] | 2014-09-27 |
| Zeit | [H]H:[M]M:[S]S[.DDDDDD] | 12:30:00.45 |
| DateTime | YYYY-[M]M-[D]D [[H]H:[M]M:[S]S[.DDDDDD]] | 2014-09-27 12:30:00.45 |
Datenreferenzparameter
Wenn Sie eine benutzerdefinierte SQL-Regel erstellen, können Sie auf eine Datenquellentabelle und alle ihre Vorbedingungsfilter verweisen, indem Sie den Datenreferenzparameter ${data()} in der Regel verwenden, anstatt die Quelltabelle und ihre Filter explizit zu erwähnen.
Knowledge Catalog interpretiert den Parameter als Verweis auf die Quelltabelle und ihre Filter. Beispiele für Vorbedingungsfilter sind Zeilenfilter, Stichprobenprozentsätze und inkrementelle Filter.
Angenommen, Sie haben eine Datenquellentabelle mit dem Namen my_project_id.dim_dataset.dim_currency. Sie möchten einen inkrementellen Datenqualitätsscan ausführen, der nur neue tägliche Daten scannt. Auf die Tabelle wird ein Zeilenfilter angewendet, der nach den heutigen Einträgen (transaction_timestamp >= current_date()) filtert.
Eine benutzerdefinierte SQL-Regel zum Suchen von Zeilen mit discount_pct für heute sieht so aus:
discount_pct IN (SELECT discount_pct FROM my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date())
Wenn Sie den Parameter für die Datenreferenz verwenden, können Sie die Regel vereinfachen. Ersetzen Sie die Erwähnung der Tabelle und ihrer Vorbedingungsfilter durch den Parameter ${data()}:
discount_pct IN (SELECT discount_pct FROM ${data()})
Knowledge Catalog interpretiert den Parameter ${data()} als Verweis auf die Datenquellentabelle mit den heutigen Einträgen, my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date().
In diesem Beispiel bezieht sich der Datenreferenzparameter nur auf die inkrementellen Daten.
Beim Parameter ${data()} wird zwischen Groß- und Kleinschreibung unterschieden.
Wenn Sie einen Alias in einer Unterabfrage verwenden, um auf Spalten in der Quelltabelle zu verweisen, verwenden Sie entweder den Datenreferenzparameter, um auf die Quelltabelle zu verweisen, oder lassen Sie den Tabellenverweis weg. Verweisen Sie nicht mit einem direkten Tabellenverweis in der WHERE-Klausel auf die Spalten in der Quelltabelle.
Empfohlen:
Verwenden Sie den Datenreferenzparameter, um auf die Quelltabelle zu verweisen:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = ${data()}.timestamp
)
Lassen Sie die Tabellenreferenz weg:
discount_pct IN (
SELECT discount_pct FROM
`another_project.another_dataset.another_table` AS temp-table
WHERE
temp-table.transaction_timestamp = timestamp
Nicht empfohlen:
Verwenden Sie keinen direkten Tabellenverweis, um auf Spalten in der Quelltabelle zu verweisen:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `my_project_id.dim_dataset.dim_currency`.timestamp
)
Gültige Verwendung verschiedener Tabellen:
Sie können einen direkten Tabellenverweis verwenden, wenn Sie Spalten aus einer anderen Tabelle vergleichen:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `another_project.another_dataset.another_table`.timestamp
)
Debugging-Abfragen
Wenn Sie eine Regel erstellen, können Sie optional eine Debug-Abfrage einfügen, die zusammen mit der Regel ausgeführt wird. Eine Debugging-Abfrage ist eine SQL-Anweisung, die bis zu 10 Skalarwerte zurückgibt. Diese Werte können bei der Diagnose der Ursache helfen, wenn die Regel fehlschlägt. Sie können pro Regel maximal eine Debug-Abfrage hinzufügen. Sie darf nicht länger als 1.024 Zeichen sein.
Betrachten Sie die folgende SQL-Assertionsregel für die Tabelle example_project.example_dataset.table, mit der geprüft wird, ob der durchschnittliche Umsatz pro Artikel 100 übersteigt:
SELECT
  *
FROM
  `example_project.example_dataset.table`
WHERE
  SUM(revenue) / COUNT(DISTINCT item_id) > 100
Wenn die vorherige Regel fehlschlägt, können Sie sich Messwerte wie Gesamteinnahmen, Anzahl der unterschiedlichen Artikel und durchschnittliche Einnahmen pro Artikel ansehen, um das Problem zu diagnostizieren. Die folgende Debug-Abfrage gibt diese Messwerte zurück:
SELECT
  SUM(revenue),
  COUNT(DISTINCT item_id),
  SUM(revenue) / COUNT(DISTINCT item_id)
FROM `example_project.example_dataset.table`
Regelausführung
Sie können Datenqualitätsscans so planen, dass sie in einem bestimmten Intervall ausgeführt werden, oder einen Scan bei Bedarf ausführen.
Ausführungsidentität
Standardmäßig verwendet Knowledge Catalog einen zentralen Dienst-Agent (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com), um Datenqualitätsscans auszuführen.
Sie können diese Standardausführungsidentität überschreiben, indem Sie ein benutzerdefiniertes Dienstkonto angeben oder Ihre eigenen Endnutzer-Anmeldedaten (EUC) verwenden. Das hat mehrere Vorteile:
- Prinzip der geringsten Berechtigung: Gewähren Sie einem dedizierten Dienstkonto nur die genauen IAM-Berechtigungen, die für bestimmte Datenqualitätsaufgaben erforderlich sind, um übermäßige Berechtigungen zu minimieren.
- Detaillierte Zugriffssteuerung: Berechtigungen auf bestimmte Ressourcen beschränken, um die Integration in Zugriffsrichtlinien auf Zeilen- und Spaltenebene in BigQuery zu ermöglichen.
- Verbesserte Prüfbarkeit: Sie können bestimmten Scans benutzerdefinierte Dienstkonten oder Nutzeranmeldedaten zuweisen, um die Nachverfolgung und Protokollierung von Aktivitäten in Audit-Logs zu vereinfachen.
- Vereinheitlichung der Abrechnung: Wenn Sie eine benutzerdefinierte Ausführungsidentität verwenden, werden die Verarbeitungs- und Speicherkosten direkt unter BigQuery zentralisiert (ohne Knowledge Catalog Premium-SKUs). So können Sie die BigQuery-Unternehmensrabatte und Slot-Zusicherungen nutzen.
Eine Anleitung zum Konfigurieren einer benutzerdefinierten Ausführungsidentität finden Sie unter Ausführungsidentität konfigurieren.
Netzwerkanforderungen
Wenn Sie einen Scan ausführen möchten, müssen Sie den privaten Google-Zugriff für das VPC-Subnetz aktivieren, das Sie für den Scan verwenden. Wenn Sie kein Subnetz angeben, muss für Ihr Standardsubnetz der privater Google-Zugriff aktiviert sein.
Wenn Sie einen Datenqualitätsscan ausführen, erstellt Knowledge Catalog einen Job. Wenn ein Job falsch konfiguriert ist oder länger als erwartet ausgeführt wird, können Sie den Job abbrechen.
Im Rahmen der Spezifikation eines Datenqualitätsscans können Sie den Umfang eines Jobs so festlegen:
- Vollständige Tabelle
- Mit jedem Job wird die gesamte Tabelle validiert.
- Inkrementell
- In jedem Job werden inkrementelle Daten validiert. Geben Sie zum Bestimmen von Inkrementen eine
Date- oderTimestamp-Spalte in der Tabelle an, die als Markierung verwendet werden kann. In der Regel ist dies die Spalte, nach der die Tabelle partitioniert ist.
Daten filtern
Sie können Daten, die auf Datenqualität geprüft werden sollen, mithilfe eines Zeilenfilters filtern. Wenn Sie einen Zeilenfilter erstellen, können Sie sich auf Daten innerhalb eines bestimmten Zeitraums oder Segments konzentrieren, z. B. auf eine bestimmte Region. Durch die Verwendung von Filtern können Sie die Laufzeit und die Kosten reduzieren. Sie können beispielsweise Daten mit einem Zeitstempel vor einem bestimmten Datum herausfiltern.
Beispieldaten
Sie können einen Prozentsatz der Datensätze aus Ihren Daten angeben, die für die Ausführung eines Datenqualitätsscans herangezogen werden sollen. Wenn Sie Datenqualitätsscans für eine kleinere Datenstichprobe erstellen, können Sie die Laufzeit und die Kosten im Vergleich zur Abfrage des gesamten Datasets reduzieren.
Filterregeln
Wenn Sie einen Datenqualitätsscan ausführen, können Sie die Filtersyntax AIP-160 verwenden, um bestimmte Regeln selektiv auszuführen. Knowledge Catalog filtert die Metadaten der im Scan definierten Regeln oder der Regeln, die dem Katalogeintrag über den Aspekt data-rules zugeordnet sind.
Filtersyntax
Die Filtersyntax entspricht den AIP-160-Richtlinien. Sie können Standard-AIP-160-Operatoren (z. B. =, !=, >, <, =~) verwenden und mehrere Bedingungen mit AND oder OR kombinieren.
Wenn Sie einen AIP-160-Filterstring verwenden, gehen Sie so vor:
- In der Google Cloud Console: Geben Sie den Filter direkt mit der AIP-160-Syntax ein, z. B.
name = "critical_check". - In einem API-Aufruf: Der Filterstring ist oft ein Wert innerhalb eines anderen JSON-Stringliterals. Dazu müssen doppelte Anführungszeichen im AIP-160-String maskiert werden. Beispiel:
"filter": "name = \"critical_check\"".
Filterbare Felder
Sie können nach den meisten Feldern filtern, die in der Regeldefinition verfügbar sind:
name: Der Anzeigename der Regel.dimension: Die Datenqualitätsdimension (z. B.VALIDITY).column: Der Name der Spalte, für die die Regel gilt.threshold: Der Schwellenwert für die Regel.ignore_null: Ein boolescher Wert. Wenntrue, werdenNULLZeilen als bestanden betrachtet.attributes: Benutzerdefinierte Schlüssel/Wert-Paare, die der Regel zugewiesen sind.
Die folgenden Beispiele zeigen gängige Filtermuster. Numerische und boolesche Werte werden nicht in Anführungszeichen gesetzt.
Nach Name filtern
- Genaue Übereinstimmung:
name = "critical_check" - Muster abgleichen:
name =~ "temp_.*"
Nach Dimension filtern
- Übereinstimmung mit einer bestimmten Dimension:
dimension = "COMPLETENESS" - Mehrere Dimensionen abgleichen:
dimension = "VALIDITY" OR dimension = "ACCURACY"
Nach Spalte und Grenzwert filtern
- Bestimmte Spalte abgleichen:
column = "user_id" - Übereinstimmung mit einem Grenzwert:
threshold > 0.95 - Bereich abgleichen:
threshold >= 0.8 AND threshold < 0.9
Nach ignore_null filtern
- Boolescher Wert für Übereinstimmung:
ignore_null = true
Nach benutzerdefinierten Attributen filtern
- Auf Vorhandensein des Schlüssels prüfen:
attributes:environment - Schlüssel und Wert abgleichen:
attributes.environment = "prod" - Übereinstimmung mit regulären Ausdrücken:
attributes.tag =~ "prio-.*" - Übereinstimmende Kombinationen:
attributes.environment = "prod" AND attributes.criticality = "high"
Ergebnisse des Datenqualitätsscans
Die Ergebnisse Ihrer Datenqualitätsscans sind in Knowledge Catalog und BigQuery verfügbar. Sie können die Scanergebnisse auch mit den folgenden Methoden prüfen und analysieren:
Ergebnisse nach BigQuery exportieren
Sie können die Scanergebnisse zur weiteren Analyse in eine BigQuery-Tabelle exportieren. Wenn Sie die Berichterstellung anpassen möchten, können Sie die BigQuery-Tabellendaten mit einem Looker-Dashboard verbinden. Sie können einen aggregierten Bericht erstellen, indem Sie dieselbe Ergebnistabelle für mehrere Scans verwenden.
Ergebnisse als Knowledge Catalog-Metadaten veröffentlichen
Sie können die Ergebnisse des Datenqualitätsscans als Knowledge Catalog-Metadaten veröffentlichen. Die neuesten Ergebnisse werden im Knowledge Catalog-Eintrag, der die Quelltabelle darstellt, unter dem Systemaspekttyp
data-quality-scorecardgespeichert. Sie können die Ergebnisse auf den BigQuery- und Knowledge Catalog-Seiten der Quelltabelle in der Google Cloud Console auf dem Tab Datenqualität ansehen. Sie können die Ergebnisse auch über die API abrufen.Weitere Informationen zu Knowledge Catalog-Metadaten finden Sie unter Metadatenverwaltung in Knowledge Catalog.
Datenqualitätsfaktoren prüfen
Jedes Scanergebnis enthält Datenqualitätswerte, die den Prozentsatz der bestandenen Regeln angeben. Die Punktzahlen werden auf der Ebene des gesamten Jobs, der Spalte (wenn die Regel für eine Spalte ausgewertet wird) und der Dimension angegeben. Verwenden Sie die Datenqualitätswerte, um die Datenqualität über Tabellen oder Spalten hinweg zu normalisieren, Trends zu verfolgen und Daten zu identifizieren, die die Qualitätsanforderungen nicht erfüllen.
Weitere Informationen finden Sie unter Ergebnisse des Datenqualitätsscans ansehen.
Monitoring und Benachrichtigungen
Sie können Datenqualitätsscans mit den folgenden Methoden überwachen und Benachrichtigungen dazu erhalten:
Benachrichtigungen in Cloud Logging einrichten
Sie können die Datenqualitätsjobs mit den Logs
data_scanunddata_quality_scan_rule_resultim Log-Explorer überwachen.Für jeden Datenqualitätsjob enthält das
data_scan-Log, bei dem das Felddata_scan_typeaufDATA_QUALITYgesetzt ist, die folgenden Informationen:- Datenquelle, die für den Datenscan verwendet wird.
- Details zur Jobausführung, z. B. Erstellungszeit, Beginn, Ende und Jobstatus.
- Ergebnis des Datenqualitätsjobs: bestanden oder nicht bestanden.
- Bestanden oder nicht bestanden auf Dimensionsebene.
Jeder erfolgreiche Job enthält ein
data_quality_scan_rule_result-Log mit den folgenden detaillierten Informationen zu jeder Regel in diesem Job:- Konfigurationsinformationen wie Regelname, Regeltyp, Bewertungstyp und Dimension.
- Ergebnisinformationen wie „Bestanden“ oder „Fehlgeschlagen“, Gesamtzeilenanzahl, Anzahl der bestandenen Zeilen, Anzahl der Nullzeilen und Anzahl der ausgewerteten Zeilen.
Die Informationen in den Logs sind über die API und dieGoogle Cloud -Konsole verfügbar. Anhand dieser Informationen können Sie Benachrichtigungen einrichten. Weitere Informationen finden Sie unter Benachrichtigungen in Logging festlegen.
E-Mail-Benachrichtigungsberichte senden
Sie können E-Mail-Benachrichtigungsberichte senden, um Personen über den Status und die Ergebnisse eines Datenqualitätsjobs zu informieren. Benachrichtigungsberichte sind für die folgenden Szenarien verfügbar:
- Der Datenqualitätsfaktor ist niedriger als ein bestimmter Zielwert.
- Der Job ist fehlgeschlagen.
- Der Job ist abgeschlossen.
Sie konfigurieren Benachrichtigungsberichte, wenn Sie einen Datenqualitätsscan erstellen.
DCU-Computing-Kosten in Cloud Billing im Blick behalten
Das serverlose Computing für Datenqualitätsscans gibt keine Zeitachsenmesswerte an Cloud Monitoring aus. Wenn Sie die DCU-Kosten für die Datenqualität nach Projekt, Scan-ID oder Tabelle verfolgen und zuordnen möchten, fragen Sie den Cloud Billing-Export in BigQuery mit den Systemlabels
goog-dataplex-datascan-*ab. Weitere Informationen finden Sie unter Dataplex-DCU-Kosten mit Cloud Billing-Export überwachen und zuordnen.
Fehler bei der Datenqualität beheben
Wenn die Ausführung einer Regel fehlschlägt, stellt Knowledge Catalog eine Abfrage bereit, mit der Sie die fehlgeschlagenen Einträge abrufen können. Führen Sie diese Abfrage aus, um die Datensätze zu sehen, die nicht mit Ihrer Regel übereinstimmen. Weitere Informationen finden Sie unter Fehlerbehebung bei Datenqualitätsproblemen.
Beschränkungen
- Regelempfehlungen werden in der gcloud CLI nicht unterstützt.
- Die Auswahl der Dimensionen ist auf eine der sieben vordefinierten Dimensionen festgelegt.
- Die Anzahl der Regeln pro Datenqualitätsscan ist auf 1.000 begrenzt.
- Datenqualitätswerte, die auf Spaltenebene gemeldet werden, werden nur in der API unterstützt.
- Sie können Datenqualitätsregeln nur für BigQuery-, Iceberg REST Catalog-, SAP Business Data Cloud Delta Lake- und Apache Hive-Tabellen ausführen.
Preise
- Weitere Informationen zu den Preisen finden Sie unter Knowledge Catalog-Preise.
- Informationen zum Erfassen und Zuordnen der DCU-Nutzung und -Kosten für Datenqualitätsscans mithilfe des Cloud Billing-Exports nach BigQuery finden Sie unter Dataplex-DCU-Kosten mit Cloud Billing-Export überwachen und zuordnen.
Nächste Schritte
- Informationen zur Verwendung der automatischen Datenqualität
- Datenqualitätsregeln wiederverwenden
- Datenqualitätsregeln als Code verwalten
- Folgen Sie einer Anleitung, um einen Datenqualitäts-Workflow mit Policy-as-Code zu erstellen.
- Informationen zu den verfügbaren Terraform-Ressourcen für die Datenprofilerstellung Weitere Informationen finden Sie hier:
- Dataplex-Datenscan-Ressource in der Terraform-Registry.
- Die Dokumentation zur Dataplex-Datenscanressource auf GitHub, die die YAML-basierte Regelkonfiguration unterstützt.
- Weitere Informationen zur Datenprofilerstellung
- Informationen zur Verwendung der Datenprofilerstellung