


데이터 엔지니어링 에이전트를 사용하여 데이터 파이프라인 빌드 및 수정
이 문서에서는 BigQuery 및 Dataform에서 데이터 엔지니어링 에이전트를 사용하여 데이터 파이프라인을 만들고 수정하는 방법을 보여줍니다.
데이터 엔지니어링 에이전트를 사용하면 BigQuery에서 데이터를 로드하고 처리하는 데이터 파이프라인을 빌드, 수정, 관리할 수 있습니다. 데이터 엔지니어링 에이전트를 사용하면 자연어 프롬프트를 사용하여 다양한 데이터 소스에서 데이터 파이프라인을 생성하거나 기존 데이터 파이프라인을 데이터 엔지니어링 요구사항에 맞게 조정할 수 있습니다.
에이전트는 Dataform 저장소 내에서 데이터 파이프라인 코드를 직접 생성하고 정리합니다. 에이전트는 Dataform 워크스페이스에서 작동하므로 Dataform 파이프라인을 에이전트가 자동으로 사용할 수 있습니다.
데이터 엔지니어링 에이전트와 함께 사용할 수 있는 프롬프트의 더 많은 예는 샘플 프롬프트를 참고하세요.
A2A 프로토콜을 사용하는 Data Engineering Agent API를 사용하여 에이전트와 상호작용할 수도 있습니다.
제한사항
데이터 엔지니어링 에이전트에는 다음과 같은 제한사항이 있습니다.
- 데이터 엔지니어링 에이전트는 다음 파일 형식에 대한 자연어 명령어를 지원하지 않습니다.
- 노트북
- 데이터 준비
- 데이터 엔지니어링 에이전트는 파이프라인을 실행할 수 없습니다. 파이프라인을 검토하고 실행하거나 예약해야 합니다.
- 데이터 엔지니어링 에이전트는 안내 또는 직접 프롬프트를 통해 제공된 웹 링크나 URL을 검색할 수 없습니다.
- 에이전트 명령 파일에서 파일을 가져올 때
@가져오기 문법은./,/또는 문자로 시작하는 경로만 지원합니다. - 데이터 미리보기 기능은
hasOutput플래그가true로 설정된 테이블, 선언 또는 쿼리에만 지원됩니다. - 데이터 엔지니어링 에이전트에는 AI 기술의 일반적인 제한사항이 적용됩니다.
- Lakehouse 런타임 카탈로그 (이전 명칭: BigLake Metastore)에서 관리하는 Apache Iceberg 외부 테이블을 통해 파이프라인을 만들 때는 모든 Lakehouse 런타임 카탈로그 제한사항이 적용됩니다. 특히 에이전트는 Iceberg 테이블에서 쓰기 변이 (예:
INSERT,UPDATE,DELETE,MERGE) 또는 DDL 문 (예:CREATE TABLE,DROP TABLE)을 생성할 수 없습니다. 자세한 내용은 Apache Iceberg REST 카탈로그 엔드포인트 개념을 참고하세요.
시작하기 전에
데이터 엔지니어링 에이전트를 사용하기 전에 이 섹션의 단계를 수행하세요.
BigQuery의 Gemini 사용 설정
Google Cloud 프로젝트에 BigQuery의 Gemini가 사용 설정되어 있는지 확인합니다. 자세한 내용은 BigQuery의 Gemini 설정을 참고하세요.
필요한 API 사용 설정
콘솔
Conversational Analytics API로 사용할 Google Cloud프로젝트의 Google Cloud 콘솔에서 다음 API를 사용 설정합니다.
gcloud
Gemini 데이터 분석 API, Gemini for Google Cloud
API, BigQuery API를 사용 설정하려면 Google Cloud CLI를 사용하여 다음 gcloud
services enable 명령어를 실행합니다.
gcloud services enable geminidataanalytics.googleapis.com --project=PROJECT_ID gcloud services enable cloudaicompanion.googleapis.com --project=PROJECT_ID gcloud services enable bigquery.googleapis.com --project=PROJECT_ID
PROJECT_ID를 Google Cloud 프로젝트 ID로 바꿉니다.
필요한 역할
데이터 엔지니어링 에이전트를 사용하는 데 필요한 권한을 얻으려면 관리자에게 프로젝트에 대한 다음 IAM 역할을 부여해 달라고 요청하세요.
- Dataform 코드 편집기 (
roles/dataform.codeEditor) - BigQuery 작업 사용자 (
roles/bigquery.jobUser) - Gemini 데이터 분석 스테이트리스(Stateless) 채팅 사용자 (
roles/geminidataanalytics.dataAgentStatelessUser)
역할 부여에 대한 자세한 내용은 프로젝트, 폴더, 조직에 대한 액세스 관리를 참조하세요.
이 사전 정의된 역할에는 데이터 엔지니어링 에이전트를 사용하는 데 필요한 geminidataanalytics.locations.useDataEngineeringAgent 권한이 포함되어 있습니다.
커스텀 역할이나 다른 사전 정의된 역할을 사용하여 이 권한을 가져올 수도 있습니다.
Apache Iceberg 테이블을 쿼리하는 데 필요한 역할에 대한 자세한 내용은 Lakehouse Apache Iceberg 지원에 필요한 역할을 참고하세요.
Knowledge Catalog 통합 기본 요건
Data Engineering Agent를 Knowledge Catalog와 통합하는 데 필요한 권한을 얻으려면 관리자에게 프로젝트에 대한 Dataplex 카탈로그 편집자 (roles/dataplex.catalogEditor) IAM 역할을 부여해 달라고 요청하세요.
역할 부여에 대한 자세한 내용은 프로젝트, 폴더, 조직에 대한 액세스 관리를 참조하세요.
이 사전 정의된 역할에는 Data Engineering Agent를 Knowledge Catalog와 통합하는 데 필요한 geminidataanalytics.locations.useDataEngineeringAgent 권한이 포함되어 있습니다.
커스텀 역할이나 다른 사전 정의된 역할을 사용하여 이 권한을 가져올 수도 있습니다.
커스텀 서비스 계정을 사용하여 파이프라인을 실행하는 경우 프로젝트 또는 @bigquery 항목 그룹에 Dataplex 카탈로그 편집자(roles/dataplex.catalogEditor) 역할을 부여해야 합니다.
또한 Dataplex API를 사용 설정해야 합니다.
Cloud Key Management Service 키로 데이터 암호화
BigQuery에서 기본 고객 관리 Cloud Key Management Service 키를 사용하여 데이터 세트 또는 프로젝트 수준에서 데이터를 암호화할 수 있습니다. 자세한 내용은 데이터 세트 기본 키 설정 및 프로젝트 기본 키 설정을 참고하세요.
기본 Dataform Cloud Key Management Service 키를 설정하여 프로젝트 수준에서 파이프라인 코드를 암호화할 수 있습니다.
VPC 서비스 제어 경계 구성
VPC 서비스 제어를 사용하는 경우 Dataform, BigQuery, Conversational Analytics API를 보호하도록 경계를 구성해야 합니다. 자세한 내용은 Dataform, BigQuery, Conversational Analytics API를 참고하세요.
데이터 엔지니어링 에이전트로 데이터 파이프라인 생성
BigQuery에서 데이터 엔지니어링 에이전트를 사용하려면 다음 옵션 중 하나를 선택하세요.
BigQuery 파이프라인
다음과 같이 BigQuery 파이프라인 인터페이스에서 데이터 엔지니어링 에이전트를 사용할 수 있습니다.
BigQuery 페이지로 이동합니다.
쿼리 편집기에서 arrow_drop_down 새로 만들기 > 파이프라인을 클릭합니다.
파이프라인 인터페이스에서 에이전트에게 질문하기를 클릭합니다.
에이전트에게 질문하기 필드에 자연어 프롬프트를 입력하여 데이터 파이프라인을 생성합니다. 예를 들면 다음과 같습니다.
  Create dimension tables for a taxi trips star schema from
  new_york_taxi_trips.tlc_green_trips_2022. Generate surrogate keys and all
  the descriptive attributes.
프롬프트를 입력한 후 보내기를 클릭합니다.
데이터 엔지니어링 에이전트는 프롬프트에 따라 데이터 파이프라인을 생성합니다.
데이터 엔지니어링 에이전트가 데이터 파이프라인의 제안된 초안을 생성합니다. 파이프라인 노드를 클릭하여 생성된 SQLX 쿼리를 검토할 수 있습니다. 에이전트가 제안한 데이터 파이프라인을 적용하려면 적용을 클릭합니다.
Dataform
다음과 같이 Dataform에서 데이터 엔지니어링 에이전트를 사용할 수 있습니다.
Dataform으로 이동합니다.
저장소를 선택합니다.
개발 작업공간을 선택하거나 만듭니다.
작업공간에서 에이전트에게 질문하기를 클릭합니다.
표시되는 에이전트에게 질문 프롬프트에 데이터 파이프라인을 생성하기 위한 자연어 프롬프트를 입력합니다(예:
  Create dimension tables for a taxi trips star schema from
  new_york_taxi_trips.tlc_green_trips_2022. Generate surrogate keys and all
  the descriptive attributes.
프롬프트를 입력한 후 보내기를 클릭합니다.
프롬프트가 전송되면 데이터 엔지니어링 에이전트가 데이터 파이프라인을 생성하고 프롬프트에 따라 Dataform SQLX 파일을 수정합니다. 에이전트는 이러한 변경사항을 작업공간 파일에 직접 적용합니다.
데이터 파이프라인 수정
데이터 파이프라인을 수정하려면 에이전트에게 질문하기를 클릭한 다음 데이터 파이프라인의 변경사항을 제안하는 프롬프트를 입력합니다.

데이터 엔지니어링 에이전트가 제안한 변경사항을 검토한 다음 적용을 클릭하여 변경사항을 적용합니다.
파이프라인 노드를 선택한 다음 열기를 클릭하여 SQLX 쿼리를 수동으로 수정할 수도 있습니다.
데이터 파이프라인 검토
데이터 엔지니어링 에이전트가 생성한 데이터 파이프라인에서 파이프라인 노드를 클릭하여 검토할 수 있습니다.
- 구성 탭에는 노드와 연결된 생성된 SQLX 쿼리가 표시됩니다.
- 데이터 미리보기 탭에는 파일의 입력 및 출력 테이블이 표시됩니다. 작업 실행을 클릭하여 종속 항목이 있거나 없는 작업을 실행하면 이 노드를 통해 데이터 변환을 미리 볼 수 있습니다.
데이터 파이프라인 오류 문제 해결
데이터 파이프라인 생성 중에 오류가 발생하면 데이터 엔지니어링 에이전트를 실행하기 위한 모든 기본 요건을 완료했는지 확인합니다. 자세한 내용은 시작하기 전에를 참고하세요.
Gemini Cloud Assist 조사 실행
파이프라인 문제 해결을 위해 데이터 엔지니어링 에이전트를 사용하여 근본 원인 분석을 실행하고 문제 해결 권장사항을 제안할 수 있습니다.
이 기능은 Gemini Cloud Assist 조사(프리뷰)를 사용하며 프리미엄 지원 계약이 있는 사용자만 사용할 수 있습니다. Gemini Cloud Assist 조사를 사용 설정하는 방법에 대한 자세한 내용은 Gemini Cloud Assist 조사로 문제 해결을 참고하세요.
다음 단계에 따라 데이터 엔지니어링 에이전트를 사용하여 데이터 파이프라인 오류를 해결할 수 있습니다.
- 파이프라인 또는 개발 작업공간에서 실행 탭을 클릭합니다.
실행 목록에서 실패한 데이터 파이프라인 실행을 찾습니다. 상태 열에서 실패한 실행을 확인할 수 있습니다.
아이콘 위로 마우스를 가져간 다음 조사를 클릭합니다. 데이터 엔지니어링 에이전트는 데이터 파이프라인 실행에 대한 근본 원인 분석 (RCA)을 실행하여 오류를 파악합니다.
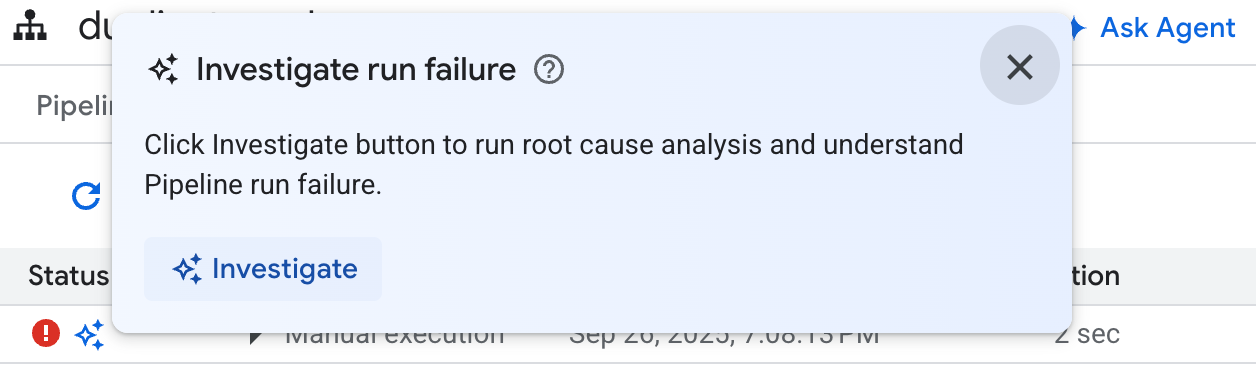
분석이 완료되면 데이터 엔지니어링 에이전트가 관찰 및 가설 섹션에 보고서를 생성합니다. 보고서에는 다음이 포함됩니다.
- 데이터 파이프라인 실행 로그에서 추출된 관측치 및 데이터 포인트입니다.
- 실패의 가능한 원인입니다.
- 식별된 문제를 해결하기 위한 실행 가능한 단계 또는 권장사항의 집합입니다.
데이터 엔지니어링 에이전트의 문제 해결 보고서를 사용하면 추천을 수동으로 구현할 수 있습니다. 다음 단계를 수행하여 데이터 엔지니어링 에이전트가 수정사항을 적용하도록 지시할 수도 있습니다.
- 문제 해결 보고서의 제안사항을 복사합니다.
- 데이터 엔지니어링 에이전트로 돌아갑니다.
- BigQuery 파이프라인을 사용하는 경우 파이프라인 페이지로 이동한 다음 상담사에게 문의를 클릭합니다.
- Dataform을 사용하는 경우 상담사에게 문의를 클릭합니다.
- 추천을 프롬프트에 붙여넣은 다음 데이터 엔지니어링 에이전트에게 데이터 파이프라인을 직접 수정하도록 지시합니다.
- 보내기를 클릭합니다.
에이전트 요청 사항 만들기
에이전트 요청 사항은 데이터 엔지니어링 에이전트를 위한 자연어 요청 사항으로, 에이전트가 사전 정의된 맞춤 규칙을 따르도록 영구 요청 사항을 저장할 수 있습니다. 조직 전체에서 에이전트의 결과가 일관되도록 하려면(예: 명명 규칙을 사용하거나 스타일 가이드를 적용) 에이전트 지침을 사용하세요.
GEMINI.MD 컨텍스트 파일을 데이터 엔지니어링 에이전트의 에이전트 명령 파일로 만들 수 있습니다. 로컬 작업공간에서 사용할 에이전트 명령 파일 또는 외부 저장소와 함께 여러 데이터 파이프라인에서 동일한 명령 파일을 사용할 수 있습니다.
상담사 안내를 만들려면 다음 단계를 따르세요.
- 에이전트에게 질문하기에서 파이프라인 안내를 클릭합니다.
- 파이프라인 안내 창에서 안내 파일 만들기를 클릭합니다.
표시되는
GEMINI.MD파일에 자연어로 지침을 입력합니다.다음 예시는 여러 규칙이 있는 에이전트 명령 파일입니다.
1. All event-specific tables MUST be prefixed with `cs_event_`. 2. The primary key for any player activity table is a composite key of `player_id` and `event_timestamp_micros`. 3. Filter out any player actions where `mana_spent` is greater than `max_mana_pool`. This is considered a data anomaly.저장을 클릭합니다.
에이전트 명령어 파일을 가장 잘 구조화하는 방법에 관한 자세한 내용은 에이전트 명령어 파일 관련 권장사항을 참고하세요.
외부 저장소에서 에이전트 요청 사항 로드
여러 데이터 파이프라인에서 에이전트 명령어 세트를 재사용하려면 외부 저장소를 연결하세요.
- 에이전트에게 질문하기에서 파이프라인 안내를 클릭합니다.
- 외부 저장소에서 외부 저장소의 안내 사용을 선택합니다.
- 제공된 필드에 데이터 파이프라인과 함께 사용할 에이전트 명령어가 포함된 저장소를 지정합니다.
- 저장을 클릭합니다.
샘플 프롬프트
다음 섹션에서는 데이터 엔지니어링 에이전트와 함께 사용하여 데이터 파이프라인을 개발할 수 있는 샘플 프롬프트를 제공합니다.
기존 데이터를 새 테이블로 집계
이 프롬프트에서 데이터 엔지니어링 에이전트는 스키마와 샘플을 사용하여 키별 데이터 그룹화를 추론합니다. 일반적으로 에이전트는 테이블 및 열 설명이 포함된 새 테이블 구성을 설정합니다.
  Create a daily sales report from the
  bigquery-public-data.thelook_ecommerce.order_items table into a
  reporting.daily_sales_aggregation table.
새 파생 열을 만들고 새 테이블에 데이터 품질 검사 추가
이 프롬프트는 테이블과 열을 추가하고 동시에 테이블에 품질 검사를 지정하는 방법을 보여줍니다.
  Create a new table named staging.products from
  bigquery-public-data.thelook_ecommerce.products and add a calculated column
  named gross_profit, which is the retail_price minus the cost.


  Also, add the following assertions: ID must not be null and must be unique.
  The retail_price must be greater than or equal to the cost. The department
  column can only contain 'Men' or 'Women'.
모델 정의의 일부로 UDF 만들기
데이터 엔지니어링 에이전트는 사용자 정의 함수 (UDF)를 만드는 DDL을 설정할 수도 있습니다. 에이전트가 실제로 UDF를 만들지는 않지만 데이터 파이프라인을 실행하여 UDF를 만들 수 있습니다. 이러한 UDF는 데이터 파이프라인의 모델 정의에서 사용할 수 있습니다.
  Create a user-defined function (UDF) named get_age_group that takes an integer
  age as input and returns a string representing the age group ('Gen Z',
  'Millennial', 'Gen X', 'Baby Boomer').


  Use this UDF on the age column from the
  bigquery-public-data.thelook_ecommerce.users table to create a new view called
  reporting.user_age_demographics that includes user_id, age, and the calculated
  age_group.
권장사항
데이터 엔지니어링 에이전트 및 Dataform을 사용할 때 결과를 개선하려면 다음을 수행하는 것이 좋습니다.
일반적인 요청에 에이전트 안내 사용 특정 기법을 자주 적용하거나 에이전트에 동일한 수정을 자주 적용하는 경우 에이전트 요청 사항을 사용하여 일반적인 요청 사항과 요청을 저장하는 중앙 집중식 위치로 사용하세요.
에이전트 계획 활용: 에이전트 계획은 복잡한 파이프라인 작업을 분류하는 데 유용합니다. 상담사 계획에는 상담사의 가정과 의도도 표시되므로 상담사에게 올바른 컨텍스트가 제공되도록 계획을 검토하는 것이 좋습니다.
계획을 검토한 후에는 피드백과 변경사항을 사용하여 데이터 엔지니어링 에이전트에게 프롬프트를 표시하여 계획을 수정할 수 있습니다. 예를 들면 다음과 같습니다.
In the plan, ensure that all of the intermediate tables are views.
경우에 따라 에이전트에게 명시적인 승인이 필요하지 않은 계획을 생성해 달라고 요청하는 것이 유용할 수 있습니다. 에이전트가 계획을 세우도록 하면 데이터 엔지니어링 에이전트가 작업을 분류하게 되며, 이는 더 나은 결과로 이어지는 경우가 많습니다. 에이전트가 계획을 생성하고 자동으로 실행하도록 강제할 수 있습니다. 예를 들면 다음과 같습니다.
Create a plan for a pipeline that finds the
top N pick up and drop off locations in NYC. You have my explicit pre-approval
to go ahead and execute this plan.
명확하게 작성합니다. 요청을 명확하게 서술하고 모호하게 표현하지 마세요. 가능한 경우 다음 예와 같이 프롬프트할 때 소스 및 대상 데이터 소스를 제공하세요.
  Extract data from the sales.customers table in the us_west_1 region, and load
  it into the reporting.dim_customers table in BigQuery. Match the schema of the
  destination table.
직접적이고 범위가 지정된 요청을 제공하세요. 한 번에 하나의 질문을 하고 프롬프트는 간결하게 유지하세요. 질문이 두 개 이상인 프롬프트의 경우 다음 예와 같이 질문의 각 부분을 명확하게 구분하여 나열하세요.
  1. Create a new table named staging.events_cleaned. Use raw.events as the
     source. This new table should filter out any records where the user_agent
     matches the pattern '%bot%'. All original columns should be included.

  2. Next, create a table named analytics.user_sessions. Use
     staging.events_cleaned as the source. This table should calculate the
     duration for each session by grouping by session_id and finding the
     difference between the MAX(event_timestamp) and MIN(event_timestamp).
명시적인 요청 사항을 제공하고 주요 용어를 강조합니다. 다음 예와 같이 프롬프트에서 주요 용어나 개념을 강조하고 특정 요구사항을 중요하다고 표시할 수 있습니다.
  When creating the staging.customers table, it is *VERY IMPORTANT* that you
  transform the email column from the source table bronze.raw_customers.
  Coalesce any NULL values in the email column to an empty string ''.
작업 순서를 지정합니다. 순서가 지정된 작업의 경우 다음 예와 같이 목록에 프롬프트를 구조화합니다. 목록 항목은 집중적으로 수행할 수 있는 작은 단계로 나뉩니다.
  Create a pipeline with the following steps:
  1. Extract data from the ecomm.orders table.
  2. Join the extracted data with the marts.customers table on customer_id.
  3. Load the final result into the reporting.customer_orders table.
수정하고 반복하세요. 다양한 문구와 접근 방식을 시도하여 가장 좋은 결과를 얻는 방법을 알아보세요. 에이전트가 잘못된 SQL을 생성하거나 다른 실수를 하는 경우 예시나 공개 문서를 사용하여 에이전트를 안내하세요.
  The previous query was incorrect because it removed the timestamp. Please
  correct the SQL. Use the TIMESTAMP_TRUNC function to truncate the
  event_timestamp to the nearest hour, instead of casting it as a DATE. For
  example: TIMESTAMP_TRUNC(event_timestamp, HOUR).