


KI-Datenagenten erstellen
In diesem Dokument wird beschrieben, wie Sie KI-Datenagenten in BigQuery erstellen, bearbeiten, verwalten und löschen.
In BigQuery können Sie Unterhaltungen mit Daten-Agents führen, um Fragen zu BigQuery-Daten in natürlicher Sprache zu stellen. Daten-Agenten enthalten Tabellenmetadaten und anwendungsspezifische Anweisungen zur Abfrageverarbeitung, die die beste Methode zum Beantworten von Nutzerfragen zu einer Reihe von Wissensquellen wie Tabellen, Ansichten oder benutzerdefinierten Funktionen (UDFs) definieren, die Sie auswählen.
Hinweis
-
Prüfen Sie, ob die Abrechnung für Ihr Google Cloud Projekt aktiviert ist.
-
Aktivieren Sie die BigQuery, Gemini Data Analytics, Gemini for Google Cloudund Knowledge Catalog APIs, falls sie noch nicht aktiviert sind.
Erforderliche Rollen zum Aktivieren von APIs
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Rolle „Inhaber“ (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen
Erforderliche Rollen
Wenn Sie mit KI-Datenagenten arbeiten möchten, benötigen Sie IAM-Berechtigungen (Identity and Access Management), die Ihrem Anwendungsfall entsprechen. In den folgenden Abschnitten sind die erforderlichen Rollen aufgeführt, je nachdem, ob Sie KI-Agenten erstellen und veröffentlichen, KI-Agenten in Gemini Enterprise bereitstellen oder KI-Agenten auf verschiedenen Oberflächen finden und verwenden. Weitere Informationen finden Sie unter IAM-Rollen für die Conversational Analytics API.
- Agenten erstellen, bearbeiten, veröffentlichen, freigeben und löschen:
- Zum Erstellen von Daten-Agents in einem Projekt: Gemini Data Analytics Data Agent Creator (
roles/geminidataanalytics.dataAgentCreator) für das Projekt. Mit dieser Rolle erhalten Sie automatisch die Rolle „Gemini Data Analytics Data Agent Owner“ für die von Ihnen erstellten Daten-Agents. - Um einen Data Agent zu bearbeiten, freizugeben oder zu löschen, benötigen Sie die Rolle „Gemini Data Analytics Data Agent Owner“ (
roles/geminidataanalytics.dataAgentOwner) für den Agent oder das Projekt. - Zum Bearbeiten eines KI-Datenagenten in einem Projekt: Gemini Data Analytics Data Agent Editor (
roles/geminidataanalytics.dataAgentEditor) für das Projekt. - Zum Ansehen von Daten-Agents in einem Projekt: Gemini Data Analytics Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer) für das Projekt.
- Zum Erstellen von Daten-Agents in einem Projekt: Gemini Data Analytics Data Agent Creator (
- KI-Agenten in Gemini Enterprise bereitstellen:
- Damit ein veröffentlichter Agent für Nutzer in Gemini Enterprise verfügbar ist, benötigen Sie Berechtigungen zum Registrieren und Verwalten benutzerdefinierter Agenten und zum Konfigurieren eines Agent Gateway in der Gemini Enterprise-Verwaltungskonsole.
- KI-Agents entdecken und verwenden:
- Um mit KI-Datenagenten zu chatten: Gemini Data Analytics Data Agent User (
roles/geminidataanalytics.dataAgentUser). - Zum Ansehen aller KI-Datenagenten im Projekt: Gemini Data Analytics Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer). - Um mit der Gemini-basierten Chat-Oberfläche in Data Studio zu interagieren, benötigen Sie die Rolle „BigQuery Studio User“ (
roles/bigquery.studioUser) oder „Gemini for Google Cloud User“ (roles/cloudaicompanion.user). Beide Rollen enthalten die Berechtigungcloudaicompanion.topics.create. Weisen Sie diese Rollen auf Projektebene zu. Nutzer benötigen außerdem die Rolle „Data Studio-Asset-Betrachter“ (roles/datastudio.viewer).
- Um mit KI-Datenagenten zu chatten: Gemini Data Analytics Data Agent User (
- Wissensquellen zu einem Agenten hinzufügen:
- Data Catalog-Betrachter (
roles/datacatalog.viewer) für das Projekt.
- Data Catalog-Betrachter (
Informationen zu den erforderlichen Rollen für Unterhaltungen finden Sie unter Erforderliche Rollen für Unterhaltungen.
Agenten handeln in Ihrem Namen und verwenden Ihre Berechtigungen. KI-Agenten können nur auf Daten und Ressourcen zugreifen, für die Sie die Berechtigung haben.
Best Practices
Die konversationelle Analyse führt automatisch Abfragen in Ihrem Namen aus, um Ihre Fragen zu beantworten. Berücksichtigen Sie folgende Faktoren, die die Abfragekosten erhöhen können:
- Große Tabellen
- Verwendung der Zusammenführung von Daten in Abfragen
- Häufige Aufrufe von KI-Funktionen in Abfragen
Insights generieren
Sie können optional Datenerkenntnisse in Knowledge Catalog generieren, und zwar für jede Tabelle, die Sie als Wissensquelle verwenden möchten.
KI-Insights liefern Tabellenmetadaten, die der KI-Datenagent verwenden kann, um Antworten auf Ihre Fragen zu generieren.
Wenn Sie keine Statistiken im Voraus generieren, werden sie automatisch generiert, wenn Sie beim Erstellen eines Daten-Agents eine Tabelle als Wissensquelle auswählen.
Mit dem Beispieldaten-Agenten arbeiten
Wenn Sie mit der Konfiguration von KI-Agenten für die konversationelle Analyse nicht vertraut sind, können Sie sich optional den vordefinierten Beispiel-Agenten ansehen, der für jedesGoogle Cloud -Projekt generiert wird. Sie können mit dem Modell chatten und sich seine Parameter ansehen, um zu sehen, wie es erstellt wurde. Sie können es jedoch nicht ändern.
So rufen Sie den Beispiel-Agent auf:
Rufen Sie in der Google Cloud Console die BigQuery-Seite Agents auf.
Wählen Sie den Tab Agentenkatalog aus.
Klicken Sie im Abschnitt Beispiel-KI-Agenten von Google auf die Karte des Beispiel-KI-Agenten.
KI-Datenagenten erstellen
In den folgenden Abschnitten wird beschrieben, wie Sie einen KI-Datenagenten erstellen.
Nachdem Sie einen Agent erstellt haben, können Sie seine Einstellungen bearbeiten.
Erste Schritte
Rufen Sie in der Google Cloud Console die BigQuery-Seite Agents auf.
Wählen Sie den Tab Agentenkatalog aus.
Klicken Sie auf Neuer Agent. Die Seite Neuer KI-Agent wird geöffnet.
Geben Sie im Abschnitt Editor im Feld Agentenname einen aussagekräftigen Namen für den KI-Datenagenten ein, z. B.
Q4 sales dataoderUser activity logs.Geben Sie im Feld Beschreibung des KI-Datenagenten eine Beschreibung des KI-Datenagenten ein. Eine gute Beschreibung erklärt, was der KI-Agent tut und welche Daten er verwendet. So können Sie leichter entscheiden, ob er der richtige KI-Agent für Ihren Chat ist, z. B.
Ask questions about customer orders and revenue.Klicken Sie im Abschnitt Wissensquellen auf Quelle hinzufügen. Die Seite Wissensquelle hinzufügen wird geöffnet.
Wählen Sie im Bereich Letzte alle Tabellen, Ansichten, Diagramme oder benutzerdefinierten Funktionen aus, die Sie als Wissensquellen verwenden möchten. UDFs sind in der Google Cloud Console mit dem Präfix „fx“ gekennzeichnet.
Wenn Sie weitere Wissensquellen sehen möchten, wählen Sie Mehr anzeigen aus.
Optional: Fügen Sie eine Wissensquelle hinzu, die nicht im Abschnitt Zuletzt verwendet aufgeführt ist:
Geben Sie im Abschnitt Suchen den Namen der Quelle in das Feld Nach Tabellen suchen ein und drücken Sie die Eingabetaste. Der Name der Quelle muss nicht exakt sein.
Wählen Sie im Bereich Suchergebnisse eine oder mehrere Quellen aus.
Klicken Sie auf Hinzufügen. Die Seite für den neuen KI-Agenten wird wieder geöffnet.
Tabellen- und Feldbeschreibungen anpassen
Um die Genauigkeit von KI-Datenagenten zu verbessern, können Sie optional zusätzliche Tabellenmetadaten angeben. Nur der KI-Datenagent verwendet diese Metadaten. Sie haben keine Auswirkungen auf die Quelltabelle.
Beachten Sie beim Erstellen von Tabellen- und Feldbeschreibungen die folgenden Best Practices:
Anhand dieser Beschreibungen können Sie nachvollziehen, wie der KI-Datenagent das Schema interpretiert. Wenn die vom Kundenservicemitarbeiter vorgeschlagenen Beschreibungen korrekt sind, können Sie sie akzeptieren.
Wenn der KI-Datenagent das Schema nach der Konfiguration dieser Beschreibungen nicht versteht, passen Sie die Beschreibungen manuell an, um die richtigen Informationen bereitzustellen.
So konfigurieren Sie Tabellen- und Feldbeschreibungen:
Klicken Sie im Abschnitt Wissensquellen für eine Tabelle auf den Link Anpassen.
Tabellenbeschreibung erstellen Sie können eine Beschreibung in das Feld Tabellenbeschreibung eingeben oder den Vorschlag von Gemini akzeptieren.
Prüfen Sie im Abschnitt Felder die von Gemini vorgeschlagenen Feldbeschreibungen.
Wählen Sie die Feldbeschreibungen aus, die Sie übernehmen möchten, und klicken Sie auf Vorschläge akzeptieren. Wählen Sie die Beschreibungen aus, die Sie ablehnen möchten, und klicken Sie auf Vorschläge ablehnen.
Sie können die Beschreibung eines Felds manuell bearbeiten, indem Sie neben dem Feld auf Bearbeiten klicken. Der Bereich Feld bearbeiten wird geöffnet.
- Geben Sie im Feld Beschreibung eine Beschreibung des Felds ein.
- Klicken Sie auf Aktualisieren, um die Feldbeschreibung zu speichern.
Klicken Sie auf Aktualisieren, um die Beschreibung und die Feldaktualisierungen zu speichern. Die Seite des neuen KI-Agents wird wieder geöffnet.
Wiederholen Sie diese Schritte für jede Tabelle, die angepasst werden muss.
Anweisungen für den KI-Agenten erstellen
Der Agent sollte den Kontext von Nutzerfragen verstehen, ohne dass benutzerdefinierte Anweisungen erforderlich sind. Erstellen Sie benutzerdefinierte Anweisungen für den Agenten nur, wenn Sie das Verhalten des Agenten ändern oder den Kontext auf eine Weise verbessern müssen, die nicht bereits von anderen Kontextfunktionen unterstützt wird, z. B. benutzerdefinierte Tabellen- und Feldmetadaten oder bestätigte Abfragen.
Geben Sie im Abschnitt Anweisungen im Feld Anweisungen für den KI-Agenten Anweisungen für den KI-Datenagenten ein. Da der KI-Datenagent diese Anweisungen verwendet, um den Kontext von Nutzerfragen zu verstehen und Antworten zu geben, sollten die Anweisungen so klar wie möglich sein.
Wenn Sie vom KI-Agenten keine zufriedenstellende Antwort erhalten, fügen Sie strukturierten Kontext wie Beschreibungen, Beispiele oder Glossarbegriffe hinzu. Wenn Sie immer noch keine zufriedenstellende Antwort erhalten, fügen Sie benutzerdefinierte Anweisungen hinzu, wie in den Beispielen in der folgenden Tabelle.
Wenn Sie weitere Beispiele für Anweisungen sehen möchten, klicken Sie auf Beispiele anzeigen.
| Informationstyp | Beschreibung | Beispiele |
|---|---|---|
| Schlüsselfelder | Die wichtigsten Felder für die Analyse | „Die wichtigsten Felder in dieser Tabelle sind: Kundennummer, Produkt-ID, Bestelldatum.“ |
| Filtern und gruppieren | Felder, die der KI-Agent zum Filtern und Gruppieren von Daten verwenden soll. | „Wenn es in einer Frage um einen Zeitraum oder um die Entwicklung im Zeitverlauf geht, verwenden Sie immer die Spalte ‚order_created_date‘.“ „Wenn jemand ‚nach Produkt‘ sagt, gruppiere nach der Spalte ‚product_category‘.“ |
| Standardfilterung | Felder, nach denen standardmäßig gefiltert werden soll. | „Sofern nicht anders angegeben, filtern Sie die Daten immer nach order_status = ‚Complete‘.“ |
| Synonyme und Geschäftsbegriffe | Alternative Begriffe für die wichtigsten Felder | „Wenn jemand nach ‚Umsatz‘ oder ‚Verkäufe‘ fragt, verwende die Spalte ‚total_sale_amount‘.“ „Wir betrachten Kunden mit ‚purchase_count‘ > 5 als treue Kunden.“ |
| Ausgeschlossene Felder | Felder, die der Daten-KI-Agent vermeiden soll. | „Verwenden Sie keinesfalls die Felder mit diesen Informationen: Transaktionsdatum (abgeleitet), Stadt (abgeleitet).“ |
| Join-Beziehungen | Wie zwei oder mehr Tabellen miteinander in Beziehung stehen und welche Spalten für die Zusammenführung verwendet werden. Der Agent muss Standard-SQL-JOINs für Spaltenpaare verwenden, um Daten zusammenzuführen. Sehen Sie sich die Spalte „Beispiel“ an. |
Kundenaktivität
|
Bestätigte Abfragen erstellen
Ein Agent verwendet verifizierte Abfragen auf zwei Arten:
- Wenn ein KI-Agent eine verifizierte Abfrage verwenden kann, um eine von Ihnen gestellte Frage zu beantworten, ruft er die Abfrage genau so auf, wie sie geschrieben wurde, um eine vertrauenswürdige Antwort zu liefern.
- Wenn der KI-Agent die verifizierte Abfrage nicht verwenden kann, um eine Frage zu beantworten, verwendet er die Abfrage dennoch als Referenz, um die Daten und die Best Practices für die Abfrage zu verstehen.
Sie können verifizierte Abfragen aus einer vom System generierten Liste auswählen oder eigene erstellen.
So erstellen Sie eine bestätigte Abfrage für den Daten-Agenten, die früher als Golden Query bezeichnet wurde:
Wählen Sie eine oder mehrere von Gemini vorgeschlagene verifizierte Abfragen aus:
- Klicken Sie im Bereich Bestätigte Anfragen auf Vorschläge überprüfen. Die Seite Vorgeschlagene bestätigte Abfragen überprüfen wird geöffnet.
- Sehen Sie sich die vorgeschlagenen bestätigten Abfragen an. Wählen Sie alle zutreffenden Optionen aus.
- Klicken Sie auf Hinzufügen. Die Seite für den neuen KI-Agenten wird wieder geöffnet.
Wenn Sie eine eigene verifizierte Anfrage erstellen möchten, klicken Sie auf Anfrage hinzufügen. Die Seite Bestätigte Abfrage hinzufügen wird geöffnet.
- Geben Sie im Feld Frage die Nutzerfrage ein, die mit der verifizierten Abfrage beantwortet wird.
- Klicken Sie auf SQL generieren, damit Gemini eine geprüfte Abfrage generiert, die der von Ihnen angegebenen Nutzerfrage entspricht.
- Ändern Sie die bestätigte Abfrage, wenn Sie möchten.
- Klicken Sie auf Ausführen und prüfen Sie, ob die Abfrage die erwarteten Ergebnisse zurückgibt.
- Klicken Sie auf Hinzufügen. Die Seite für den neuen KI-Agenten wird wieder geöffnet.
Wiederholen Sie diese Schritte nach Bedarf, um weitere verifizierte Abfragen zu erstellen.
Parametrisierte verifizierte Abfragen erstellen
Bei parametrisierten bestätigten Anfragen werden Werte aus der Frage eines Nutzers für den Conversational Analytics-Agent extrahiert und maßgeschneiderte Ergebnisse bereitgestellt.
Analysten und Entwickler können wiederverwendbare SQL-Vorlagen mit Platzhaltern für diese Werte erstellen. Die Vorlagen ersetzen Parameter dynamisch zur Laufzeit, um eine größere Bandbreite an Nutzerfragen zu beantworten als reguläre verifizierte Abfragen.
Wenn ein Nutzer eine Frage stellt, die dem Muster der Vorlage entspricht, extrahiert der Agent für konversationelle Analysen Parameterwerte aus der Frage, z. B. Produktname, Region und Datum. Anschließend werden diese Werte in die parametrisierte Abfrage eingefügt. Übereinstimmende Antworten aus der Abfragevorlage werden als bestätigt angezeigt.
Parametrisierte verifizierte Abfragen verbessern die Leistungsfähigkeit und Flexibilität verifizierter Abfragen erheblich. Sie sorgen für konsistente, vertrauenswürdige Antworten bei verschiedenen Eingaben und reduzieren die Anzahl der zu verwaltenden individuellen Abfragen.
Funktionsweise
Ein Experte, z. B. ein Datenanalyst, definiert eine verifizierte Abfrage mithilfe einer Vorlagenfrage, z. B. „Wie hoch war der Umsatz für @product im Jahr @region?“. Anschließend erstellt oder ändert der Experte die verifizierte Abfrage mithilfe von SQL-Parametern, wie im folgenden Beispiel gezeigt:
SELECT * FROM sales WHERE region = @region AND product = @product
Nachdem die verifizierte Abfrage gespeichert wurde, kann ein Nutzer dem Agenten für konversationelle Analysen eine Frage in natürlicher Sprache stellen, z. B. „Wie hoch war der Umsatz mit Laptops in Nordamerika?“
Um die Frage des Nutzers zu beantworten, führt der Kundenservicemitarbeiter die folgenden Schritte aus:
- Die Frage wird mit dem Muster abgeglichen, das mit der parametrisierten, bestätigten Abfrage verknüpft ist. Der Agent verwendet Natural Language Understanding (NLU), um die Werte für
@region(Nordamerika) und@product(Laptops) aus der Frage des Nutzers zu identifizieren und zu extrahieren. - Ersetzt die extrahierten Werte in den Platzhaltern
@regionund@productin der SQL-Vorlage. - Führt die vollständige SQL-Abfrage aus, z. B.
SELECT * FROM sales WHERE
region = 'North America' AND product = 'Laptops'
. - Gibt die Ergebnisse an den Nutzer zurück. Übereinstimmungen werden immer als bestätigt markiert.
Tipps zum Erstellen effektiver parametrisierter Abfragen
- Verwenden Sie klare Parameternamen. Verwenden Sie aussagekräftige Namen für Parameter, z. B.
@start_dateanstelle von@d1. - Detaillierte Parameterbeschreibungen erstellen: Das Large Language Model (LLM) für die Konversationsanalyse verwendet Parameterbeschreibungen, um die Parameter und ihre Werte aus Nutzerfragen zu ermitteln.
num_enrollmentsist beispielsweise ein effektiver Parametername, währendnumber of student enrollments from ages 5-14eine Parameterbeschreibung ist, die mehr Kontext zur Abfrage liefert. - Für konsistente Datentypen sorgen: Achten Sie darauf, dass die von der SQL-Abfrage erwarteten Datentypen mit den Datentypen übereinstimmen, die wahrscheinlich aus der Frage des Nutzers extrahiert werden.
- Einen klar definierten Umfang angeben: Erstellen Sie Vorlagen für gängige und wichtige Fragemuster, bei denen die Abfragekonstruktion komplex oder die Logik nicht intuitiv ist. So kann das LLM optimale Ergebnisse liefern.
- Gründlich testen: Testen Sie mit verschiedenen Formulierungen in natürlicher Sprache, um sicherzustellen, dass die Parameter korrekt extrahiert werden.
Parametrisierte verifizierte Abfrage erstellen
Sie können verifizierte Abfragen aus einer vom System generierten Liste auswählen oder eigene erstellen.
Bevor Sie eine Abfrage erstellen oder ändern, sollten Sie sie unter Berücksichtigung des Musters für natürliche Sprache und Ihrer Frage entwerfen. Wenn Sie beispielsweise fragen: „Kennen wir den Gesamtbestand an Bio-Bananen im Lager US-EAST?“, können Sie die Frage als parametrisierte verifizierte Abfrage so umschreiben: „Wie hoch ist der Gesamtbestand für @product im Lager @region?“ Der Agent wandelt diese Frage in eine SQL-Abfrage um, die Sie mit Standardwerten aktualisieren.
Wenn Sie eine parametrisierte bestätigte Anfrage für einen Daten-Agent erstellen möchten, können Sie entweder beim Erstellen eines neuen Agents eine neue Anfrage erstellen oder eine vorhandene bestätigte Anfrage für einen neuen oder vorhandenen Agent bearbeiten.
In der folgenden Anleitung wird eine Beispielabfrage verwendet, die bereits verifiziert wurde, um die Konfiguration mit Parametern zu demonstrieren.
Vorhandene, von Gemini vorgeschlagene bestätigte Anfrage auswählen
- Klicken Sie im Abschnitt Verifizierte Abfragen eines neuen oder vorhandenen KI-Agenten auf Vorschläge prüfen. Die Seite Vorgeschlagene bestätigte Abfragen überprüfen wird geöffnet.
- Klicken Sie das Kästchen neben einer vorgeschlagenen verifizierten Abfrage an.
- Klicken Sie im Abfragefenster auf Mehr anzeigen, um die Abfragebeschreibung zu maximieren.
- Klicken Sie zum Öffnen der vorhandenen Abfrage auf Bearbeiten.
- Informationen zum Abschließen der Konfiguration der Abfrage finden Sie unter Parameter für die verifizierte Abfrage konfigurieren.
Agenten erstellen und dann eine verifizierte Abfrage erstellen
- Weitere Informationen finden Sie unter Erste Schritte. Fahren Sie dann mit den restlichen Konfigurationsschritten bis zu Bestätigte Abfragen fort.
- Klicken Sie in der Google Cloud Console im Abschnitt Verifizierte Abfragen des neuen KI-Agenten auf Abfrage hinzufügen. Die Seite Bestätigte Abfrage hinzufügen wird geöffnet.
- Informationen zum Abschließen der Konfiguration der Abfrage finden Sie unter Parameter für die verifizierte Abfrage konfigurieren.
Parameter für die bestätigte Anfrage konfigurieren
- Geben Sie im Feld Frage die Nutzerfrage ein, die durch die verifizierte Abfrage beantwortet wird.
- Verwenden Sie das Symbol
@gefolgt von einem Parameternamen, um Parameter anzugeben. Diese Syntax kennzeichnet einen Platzhalter, der einen Wert aus der Nutzerfrage aufnimmt. Verwenden Sie eine Frage in natürlicher Sprache, die zeigt, wie die Parameter in Nutzerfragen verwendet werden. Beispiel: „What is the total stock for @product in the @region warehouse?“ (Wie hoch ist der Gesamtbestand für @product im Lager @region?) Klicken Sie auf Generate SQL (SQL generieren). Der SQL-Code sieht so aus:
   SELECT
       SUM(stock) AS total_stock
   FROM
       inventory
   WHERE
       product_id = @product
       AND region = @region;
Wenn Sie den Platzhaltern in der Abfrage Standardwerte hinzufügen möchten, klicken Sie auf Abfrageparameter verwalten und dann auf Abfrageparameter hinzufügen.
Für den ersten Parameter werden vier Felder angezeigt: Name, Typ, Wert und Beschreibung.
- Kopieren Sie für Name den Wert
@productaus Ihrer Frage und fügen Sie ihn in dieses Feld ein. - Wählen Sie für Typ die Option STRING aus.
- Für Wert geben Sie
organic bananasein. - Geben Sie unter Beschreibung eine möglichst genaue Beschreibung ein. Beispiel: Ein Produkt, das sich in einem regionalen Lager befindet.
- Kopieren Sie für Name den Wert
Klicken Sie für den zweiten Parameter auf Abfrageparameter hinzufügen.
- Kopieren Sie für Name den Wert
@regionaus Ihrer Frage und fügen Sie ihn in dieses Feld ein. - Wählen Sie für Typ die Option STRING aus.
- Für Wert geben Sie
US-EASTein. - Geben Sie unter Beschreibung eine möglichst genaue Beschreibung ein, z. B.
a regional warehouse where products are located..
- Kopieren Sie für Name den Wert
Wenn Sie Felder für beide Parameter ausgefüllt haben, klicken Sie auf Speichern.
Parametrisierte verifizierte Abfrage testen
- Klicken Sie auf Ausführen und prüfen Sie, ob die Abfrage die erwarteten Ergebnisse zurückgibt.
- Wenn Sie die Abfrage später für Nutzer testen möchten, kopieren Sie das gesamte Fragefeld.
- Klicken Sie auf Speichern, um den Bildschirm Abfrage hinzufügen zu schließen und zur Seite Bearbeiten des KI-Agenten zurückzukehren.
- Fügen Sie auf der Seite Bearbeiten des KI-Agenten das zuvor kopierte Fragefeld in das Fenster Vorschau ein.
- Ersetzen Sie die Variable
@productdurchorganic bananas. - Ersetzen Sie die Variable
@regiondurchUS-EAST.
- Ersetzen Sie die Variable
- Drücken Sie die Eingabetaste. Prüfen Sie das Ergebnis. In diesem Fall ist eine gültige Antwort die Gesamtanzahl der Bananen in der Region US-EAST, z. B. 1.000.
- Wenn Sie weitere bestätigte Abfragen erstellen oder bearbeiten möchten, wiederholen Sie diese Schritte nach Bedarf.
Nachdem Sie die Abfrage gespeichert haben, kann ein Nutzer die Frage stellen: „Kennen wir den Gesamtbestand an Bio-Bananen im Lager US-EAST?“ Die konversationelle Analyse führt dann Folgendes aus:
- Gleicht diese Frage mit dem Muster ab.
- Extrahiert den Parameter
@productals@product= „Bio-Bananen“ und den Parameter@region= „US-EAST“ aus der Frage. - Führt die Abfrage aus:
SELECT SUM(stock) AS total_stock FROM inventory WHERE product_id = 'organic bananas' AND region = 'US-EAST'; - Gibt den berechneten
total_stockzurück.
Glossarbegriffe erstellen oder prüfen
Sie können benutzerdefinierte BigQuery-Glossarbegriffe erstellen, die lokal für einen KI-Agenten gelten, oder Glossarbegriffe aus dem Unternehmensglossar prüfen, die aus dem Knowledge Catalog importiert wurden und für die Wissensquellen gelten, die Sie für einen KI-Agenten ausgewählt haben.
- Da Unternehmensglossarbegriffe aus Knowledge Catalog global für BigQuery-Ressourcen gelten, sollten Sie, wenn Sie Knowledge Catalog verwenden, Unternehmensglossarbegriffe in Knowledge Catalog erstellen und verwalten, anstatt für einzelne Agenten.
- Wenn Sie aus Knowledge Catalog importierte Unternehmensglossarbegriffe ändern müssen, müssen Sie sie in Knowledge Catalog bearbeiten und dann zu BigQuery zurückkehren, um sie zu sehen.
- Benutzerdefinierte BigQuery-Glossarbegriffe bleiben in BigQuery. Sie werden nicht in Knowledge Catalog angezeigt.
- Wenn Sie Knowledge Catalog nicht verwenden, können Sie benutzerdefinierte BigQuery-Glossarbegriffe für Begriffe erstellen, die Sie für einen bestimmten Agenten definieren müssen.
So erstellen Sie benutzerdefinierte Glossarbegriffe für einen Agenten:
- Klicken Sie im Abschnitt Glossar auf der Seite Editor des KI-Agenten auf Begriff hinzufügen.
- Im Bereich Benutzerdefinierte Begriffe können Sie vorhandene benutzerdefinierte Begriffe bearbeiten oder löschen.
- Wenn Sie einen oder mehrere neue Begriffe erstellen möchten, klicken Sie auf Begriff erstellen.
- Geben Sie einen Begriff, eine Definition und ein oder mehrere Synonyme durch Kommas getrennt ein.
- Klicken Sie auf Hinzufügen, um den Begriff zu erstellen.
- Wenn Sie den neuen Begriff löschen möchten, klicken Sie auf Löschen.
- Wenn Sie weitere benutzerdefinierte Begriffe erstellen möchten, wiederholen Sie diese Schritte.
So rufen Sie aus Knowledge Catalog importierte Begriffe des Unternehmensglossars auf:
- Klicken Sie im Abschnitt Glossar auf der Seite Editor des KI-Agenten auf Begriff hinzufügen.
- Rufen Sie den Seitenbereich Aus Dataplex importiert auf.
- Wenn Sie importierte Begriffe in Knowledge Catalog ändern möchten, klicken Sie auf Zu Dataplex-Glossaren.
- Nachdem Sie die Begriffe in Knowledge Catalog geändert haben, können Sie zur Seite Editor des KI-Agenten zurückkehren, um die geänderten Begriffe anzusehen.
Einstellungen konfigurieren
Im Abschnitt Einstellungen können Sie die folgenden optionalen Einstellungen konfigurieren:
Wählen Sie im Abschnitt Modell aus, welche Arten von Modellen Nutzern in einer Unterhaltung mit dem Agenten zur Verfügung stehen. Sowohl Modelle der Vorabversion als auch allgemein verfügbare Modelle sind standardmäßig verfügbar. Modelle in der Vorschauphase verwenden möglicherweise den globalen Endpunkt.
Erstellen Sie Labels, um IhreGoogle Cloud -Ressourcen zu organisieren. Labels sind Schlüssel/Wert-Paare, mit denen Sie verwandte Objekte miteinander oder mit anderen Google Cloud -Ressourcen gruppieren können.
- Klicken Sie im Bereich Einstellungen auf Labels verwalten.
- Klicken Sie auf Label hinzufügen.
- Geben Sie in den Feldern Schlüssel und Wert das Schlüssel/Wert-Paar für das Label ein.
- Wenn Sie weitere Labels hinzufügen möchten, klicken Sie noch einmal auf Label hinzufügen.
- Wenn Sie ein Label löschen möchten, klicken Sie auf Löschen.
- Wenn Sie fertig sind, klicken Sie auf Hinzufügen. Die Seite für den neuen KI-Agenten wird wieder geöffnet.
Legen Sie ein Größenlimit für die vom KI-Datenagenten verarbeiteten Abfragen fest. Geben Sie im Abschnitt Einstellungen einen Wert in das Feld Maximale Menge abgerechneter Byte ein. Sie müssen dieses Limit auf
10485760oder höher festlegen, da Sie sonst die folgende Fehlermeldung erhalten:
Value error. In BigQuery on-demand pricing charges are
rounded up to the nearest MB, with a minimum of 10 MB of data processed
per query. So, max bytes billed must be set to greater or equal to
10485760.
Wenn Sie keinen Wert angeben, wird für maximum bytes billed standardmäßig das Kontingent für die Abfragenutzung pro Tag des Projekts verwendet. Das Kontingent für die tägliche Nutzung ist unbegrenzt, sofern Sie kein benutzerdefiniertes Kontingent angegeben haben.
Fahren Sie mit dem nächsten Abschnitt fort, um den Agent in den Entwurfsmodus zu versetzen oder zu veröffentlichen.
Agent als Vorschau ansehen und veröffentlichen
Geben Sie im Abschnitt Vorschau eine Beispielfrage eines Nutzers in das Feld Frage stellen ein und drücken Sie die Eingabetaste. Prüfen Sie die Antwort des KI-Datenagenten, um festzustellen, ob er die erwarteten Daten zurückgibt. Wenn die Antwort nicht Ihren Erwartungen entspricht, ändern Sie die Einstellungen im Abschnitt Editor, um die Konfiguration des KI-Datenagenten zu verfeinern, bis Sie zufriedenstellende Antworten erhalten. Sie können Ihren Agenten weiterhin testen und ändern, um die Ergebnisse zu optimieren.
Klicken Sie auf Speichern.
Wenn Sie den Daten-Agenten in den Entwurfsmodus versetzen möchten, um ihn später noch einmal zu bearbeiten, klicken Sie auf Zurück, um zur Seite Agent-Katalog zurückzukehren. Da sich Ihr KI-Agent jetzt im Entwurfsmodus befindet, wird er im Bereich Meine Agentenentwürfe auf dem Tab Agentenkatalog angezeigt.
Wenn Sie Ihren KI-Agenten veröffentlichen möchten, bleiben Sie auf der Seite für die Erstellung von KI-Agenten und fahren Sie mit dem nächsten Schritt fort.
Klicken Sie auf Veröffentlichen, um den Bereich Veröffentlichungskanäle zu öffnen und den KI-Datenagenten zu veröffentlichen, damit er im Projekt verwendet werden kann.
Optional: Klicken Sie im Dialogfeld Ihr KI-Agent wurde veröffentlicht auf Teilen, um den KI-Datenagenten für andere Nutzer freizugeben.
Klicken Sie im Bereich Berechtigungen freigeben auf Hauptkonto hinzufügen.
Geben Sie im Feld Neue Hauptkonten ein oder mehrere Hauptkonten ein.
Klicken Sie auf die Liste Rolle auswählen.
Wählen Sie in der Liste Rolle eine der folgenden Rollen aus:
- Gemini Data Analytics Data Agent User (
roles/geminidataanalytics.dataAgentUser): Gewährt die Berechtigung, mit dem KI-Datenagenten zu chatten. - Gemini Data Analytics Data Agent Editor (
roles/geminidataanalytics.dataAgentEditor): Gewährt die Berechtigung zum Bearbeiten des KI-Datenagenten. - Gemini Data Analytics Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer): Gewährt die Berechtigung zum Aufrufen des Data Agents.
- Gemini Data Analytics Data Agent User (
Klicken Sie auf Speichern.
Klicken Sie auf Schließen, um zur Seite des neuen Agents zurückzukehren. Unmittelbar nach dem Speichern oder Veröffentlichen Ihres KI-Agenten wird er im Agentenkatalog angezeigt.
Sie können Unterhaltungen mit dem Daten-KI-Agenten über BigQuery Studio oder Data Studio erstellen. Sie können auch eine eigene Benutzeroberfläche erstellen, um über die Conversational Analytics API mit dem KI-Datenagenten zu chatten. Informationen zum Veröffentlichen in Data Studio finden Sie unter KI-Datenagenten in Data Studio veröffentlichen. Informationen zum Veröffentlichen in Gemini Enterprise finden Sie unter Daten-Agent in Gemini Enterprise veröffentlichen.
Daten-Agents verwalten
Vorhandene Agents finden Sie auf dem Tab Agentenkatalog, der aus drei Abschnitten besteht:
- Meine Agents: Eine Liste aller Agents, die Sie erstellen und veröffentlichen. Sie können veröffentlichte KI-Agenten ändern und für andere freigeben.
- Meine Agent-Entwürfe: Agenten, die Sie noch nicht veröffentlicht haben. Sie können keine Agentenentwürfe freigeben.
- Von anderen Personen in Ihrer Organisation freigegeben: Agenten, die von anderen erstellt und für Sie freigegeben wurden. Wenn andere Ihnen Berechtigungen gewähren, können Sie diese freigegebenen KI-Agenten bearbeiten.
KI-Datenagenten bearbeiten
So bearbeiten Sie einen Daten-Agenten:
Rufen Sie die BigQuery-Seite Agenten auf.
Wählen Sie den Tab Agentenkatalog aus.
Suchen Sie die Agentenkarte des KI-Datenagenten, den Sie ändern möchten.
Klicken Sie auf der Agentenkarte auf Aktionen öffnen > Bearbeiten, um den KI-Datenagenten im Agenten-Editor zu öffnen.
Bearbeiten Sie die Konfiguration des Data Agents nach Bedarf.
Wenn Sie die Änderungen speichern möchten, ohne sie zu veröffentlichen, klicken Sie auf Speichern.
Klicken Sie auf Veröffentlichen, um die Änderungen zu veröffentlichen . Im Dialogfeld Freigeben können Sie den Agenten entweder für andere freigeben oder auf Abbrechen klicken.
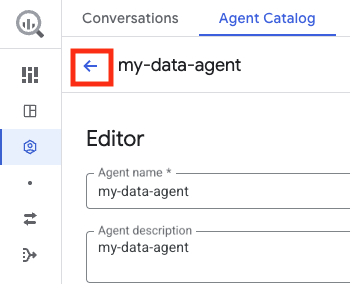
Wenn Sie zum Bereich Agents zurückkehren möchten, klicken Sie auf Zurück.
KI-Datenagenten freigeben
So geben Sie einen veröffentlichten Daten-Agenten frei: Sie können keine KI-Agenten im Entwurfsstatus freigeben.
Rufen Sie die BigQuery-Seite Agents auf.
Wählen Sie den Tab Agentenkatalog aus.
Suchen Sie die Agentenkarte des KI-Datenagenten, den Sie ändern möchten.
Klicken Sie auf der Agent-Karte auf Bearbeiten, um den Datenagenten im Agent-Editor zu öffnen Aktionen öffnen >.
Wenn Sie den KI-Datenagenten für andere Nutzer freigeben möchten, klicken Sie auf Teilen.
Klicken Sie im Bereich Berechtigungen freigeben auf Hauptkonto hinzufügen.
Geben Sie im Feld Neue Hauptkonten ein oder mehrere Hauptkonten ein.
Klicken Sie auf die Liste Rolle auswählen.
Wählen Sie in der Liste Rolle eine der folgenden Rollen aus:
- Gemini Data Analytics Data Agent User (
roles/geminidataanalytics.dataAgentUser): Berechtigung zum Chatten mit dem Data Agent. - „Gemini Data Analytics Data Agent Editor“ (
roles/geminidataanalytics.dataAgentEditor): Berechtigung zum Bearbeiten des Data Agents. - Gemini Data Analytics Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer): Berechtigung zum Aufrufen des KI-Datenagenten.
- Gemini Data Analytics Data Agent User (
Klicken Sie auf Speichern.
Wenn Sie zur Seite zum Bearbeiten des Agents zurückkehren möchten, klicken Sie auf Schließen.
Wenn Sie zum Bereich Agents zurückkehren möchten, klicken Sie auf Zurück.
KI-Datenagenten löschen
Rufen Sie die BigQuery-Seite Agents auf.
Wählen Sie den Tab Agentenkatalog aus.
Suchen Sie auf dem Tab Agent Catalog im Bereich Meine KI-Agenten oder Meine KI-Agentenentwürfe nach der Agent-Karte des Daten-Agents, den Sie löschen möchten.
Klicken Sie auf Aktionen öffnen > Löschen.
Klicken Sie im Dialogfeld Agent löschen? auf Löschen.
KI-Datenagenten in Data Studio veröffentlichen
Wenn Sie Ihren Agenten veröffentlichen und für Data Studio-Nutzer freigeben, wird er diesen Nutzern automatisch auf der Seite Mit Ihren Daten chatten in Data Studio angezeigt.
Agent erstellen und in Data Studio veröffentlichen
Als Datenanalyst können Sie mit den folgenden Schritten einen Agenten erstellen, bearbeiten und in Data Studio veröffentlichen:
- Erstellen oder bearbeiten Sie Ihren KI-Datenagenten in BigQuery.
- Veröffentlichen Sie den KI-Agenten. Wählen Sie beim Veröffentlichen des KI-Agenten Data Studio als Veröffentlichungsoption aus.
- Geben Sie den Agent frei und weisen Sie Ihren Data Studio-Nutzern die entsprechenden Identity and Access Management-Rollen zu.
Agent für Data Studio-Nutzer freigeben
Sie können KI-Agents direkt für Data Studio-Nutzer freigeben, indem Sie einen Link kopieren, über den eine Unterhaltung mit dem KI-Agenten in Data Studio geöffnet wird. Alternativ können Sie dem Nutzer eine E-Mail senden, um ihn darüber zu informieren, dass er Zugriff auf einen KI-Agenten hat.
So können Sie einen direkten Link zum Agenten teilen:
- Über den Agentenkatalog: Wählen Sie Aktionen öffnen > Link kopieren > Data Studio aus.
- In der Detailansicht des KI-Agenten: Wählen Sie Link zum KI-Agenten kopieren > Data Studio aus.
- Über das Dreipunkt-Menü Teilen: Wählen Sie Link zum KI-Agenten in Data Studio kopieren aus.
- Nachdem Sie im Bereich Freigabeberechtigungen auf Speichern geklickt haben, wählen Sie Link kopieren aus.
Wenn Sie eine E‑Mail-Benachrichtigung senden möchten, in der die Empfänger über ihren Zugriff auf einen Agent informiert werden, wählen Sie im Bereich Freigabeberechtigungen die Option E‑Mail senden aus. E‑Mail-Benachrichtigungen werden nur an die Nutzer oder Gruppen gesendet, für die Sie den Agenten in der jeweiligen Bearbeitungssitzung freigegeben haben. Alle Mitglieder einer Gruppe erhalten die E-Mail-Benachrichtigung, auch wenn ein bestimmter Nutzer bereits eine Berechtigung auf Agentenebene für den Agenten hat. Die E-Mail enthält den Namen des Nutzers, der den KI-Agenten geteilt hat, den Namen des KI-Agenten und einen Link zum Öffnen des KI-Agenten in Data Studio.
KI-Datenagenten in Gemini Enterprise veröffentlichen
Sie können einen BigQuery-Daten-Agenten in Gemini Enterprise veröffentlichen, damit geschäftliche Nutzer Daten direkt in Gemini Enterprise mit natürlicher Sprache abfragen und analysieren können. Dieser Prozess erfordert in der Regel die Zusammenarbeit zwischen Datenanalysten, Gemini Enterprise-Administratoren und Geschäftsnutzern. Weitere Informationen zu den für diese Nutzer erforderlichen Rollen finden Sie unter Erforderliche Rollen.
So veröffentlichen Sie einen Daten-Agenten in Gemini Enterprise:
- Voraussetzungen ansehen
- Erstellen und veröffentlichen Sie den Daten-Agent in BigQuery.
- Stellen Sie den Agenten in Gemini Enterprise bereit.
- Entdecken Sie den KI-Agenten und chatten Sie mit ihm.
Voraussetzungen ansehen
Die empfohlene Methode zum Veröffentlichen von BigQuery-Agenten für konversationelle Analysen ist die Verwendung der Agent Registry. Beachten Sie die Voraussetzungen in diesem Abschnitt, damit der Agent in Gemini Enterprise gefunden werden kann.
Alternativ können Sie den Agenten auch mit dem A2A-Karten-JSON veröffentlichen. Wenn Sie diese Methode verwenden, lesen Sie den Abschnitt Daten-Agent in BigQuery erstellen und veröffentlichen.
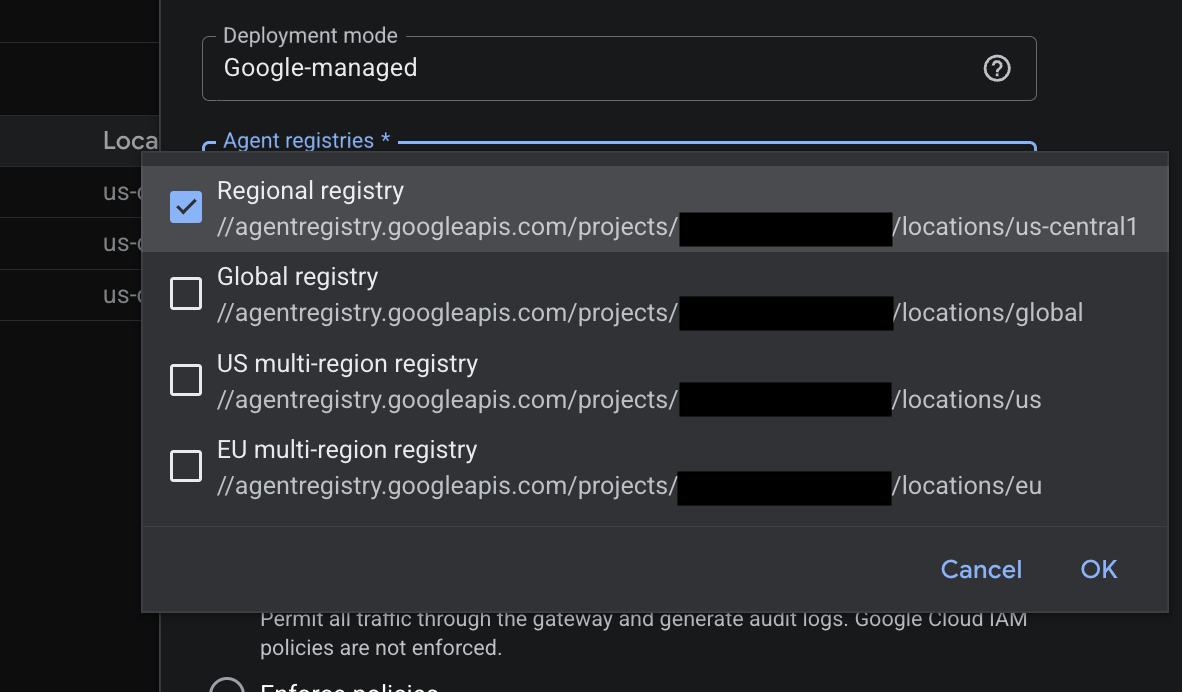
Wenn Sie die Agent Registry verwenden möchten, müssen Sie zuerst das Agent Gateway mit der entsprechenden Regionszuordnung konfigurieren. Die Speicherregion für den BigQuery-Daten-Agent und die Agent Gateway-Registry-Bindung in Gemini Enterprise müssen übereinstimmen.
Sie konfigurieren die Speicherregion für den Agenten im Bereich Region des Agenteneditors in der BigQuery-Weboberfläche. Sie können die Region nicht mehr ändern, nachdem der KI-Agent gespeichert wurde.
In der folgenden Abbildung sind die verfügbaren Regionsoptionen in Agent Gateway zu sehen:
Als Gemini Enterprise-Administrator können Sie ein Agent Gateway für Ihre Gemini Enterprise-Anwendung konfigurieren. Gehen Sie dazu so vor:
- Richten Sie ein Agent Gateway ein, das die Agent Registry-Bindung enthält, die der Region Ihres Data Agents entspricht. Zu den Optionen gehören USA, EU und Global.
- Öffnen Sie in Gemini Enterprise Ihre Anwendung, rufen Sie Sicherheit > Konfiguration auf und geben Sie dann den Namen der Gateway-Ressource im Abschnitt Konfiguration des KI-Agenten-Gateways ein. Eine ausführliche Anleitung finden Sie unter Gemini Enterprise-Traffic über Agent Gateway weiterleiten.
Daten-Agent in BigQuery erstellen und veröffentlichen
Als Datenanalyst erstellen, konfigurieren und veröffentlichen Sie einen Agenten in BigQuery, indem Sie die folgenden Schritte ausführen:
- Erstellen oder bearbeiten Sie Ihren KI-Datenagenten in BigQuery.
- Prüfen Sie im Bereich Region, ob die Speicherregion mit Ihren Datenquellen und Ihrer Agent Gateway-Konfiguration übereinstimmt. Zu den Optionen gehören USA, EU oder Global.
- Klicken Sie auf Veröffentlichen oder auf Aktualisierungen veröffentlichen, wenn der KI-Agent bereits veröffentlicht wurde.
- Wählen Sie im Bereich Veröffentlichungskanäle unter Zusätzliche Kanäle Ihre Veröffentlichungsmethode aus:
- Wenn sich BigQuery und Gemini Enterprise im selben Projekt befinden, wählen Sie im Abschnitt Agent Registry das Kästchen Diesen Agenten registrieren aus.
- Wenn Sie den KI-Agent aus der Registrierung entfernen möchten, klicken Sie auf Registrierung aufheben.
- Wenn sich BigQuery und Gemini Enterprise in verschiedenen Projekten befinden, klicken Sie im Abschnitt Über A2A (Agent2Agent) integrieren auf JSON kopieren, um die JSON-Daten des A2A-Endpunkts zu kopieren. Geben Sie die JSON-Daten dann an Ihren Gemini Enterprise-Administrator weiter. Diese JSON-Daten werden verwendet, wenn Sie den Agenten im Abschnitt Agenten in Gemini Enterprise bereitstellen bereitstellen.
- Wenn sich BigQuery und Gemini Enterprise im selben Projekt befinden, wählen Sie im Abschnitt Agent Registry das Kästchen Diesen Agenten registrieren aus.
- Klicken Sie auf Veröffentlichen oder Aktualisierungen veröffentlichen.
- Teilen Sie den Agent mit den Nutzern und Gruppen, die Zugriff benötigen, und weisen Sie ihnen die Rolle „Gemini Data Analytics Data Agent User“ (
roles/geminidataanalytics.dataAgentUser) zu.
KI-Agenten in Gemini Enterprise bereitstellen
Als Gemini Enterprise-Administrator können Sie den Daten-Agenten mit einer der folgenden Methoden für Nutzer in Ihrer Anwendung verfügbar machen:
Option 1: Aus Agent Registry importieren
So importieren Sie den registrierten Agenten:
- Wenn sich Gemini Enterprise in einem anderen Projekt als das BigQuery-Projekt befindet, führen Sie die folgenden Schritte aus, um den Agent manuell in der Agent Registry zu registrieren. Andernfalls überspringen Sie diesen Schritt:
- Rufen Sie in der Google Cloud -Konsole im selben Projekt wie Gemini Enterprise die Agent Registry auf, wählen Sie den Tab Agents aus und klicken Sie dann auf Add agent.
- Wählen Sie im Bereich Agentendetails für Typ die Option A2A aus.
- Wählen Sie für Region die Region aus, die mit der Konfiguration Ihres Daten-Agents und Agent-Gateways übereinstimmt.
- Wählen Sie JSON einfügen aus, fügen Sie die JSON-Daten des A2A-Endpunkts aus BigQuery ein und klicken Sie dann auf Speichern.
- Klicken Sie in Gemini Enterprise auf den Namen der App, der Sie den Agenten hinzufügen möchten.
- Klicken Sie im Navigationsmenü auf Agenten > Agent hinzufügen.
- Suchen Sie im Bereich Agenttyp auswählen nach Agents from Agent Registry (Agenten aus der Agent-Registrierung) und klicken Sie auf Hinzufügen.
- Suchen Sie im Bereich Agent hinzufügen nach dem Agenten anhand des Namens, der Registry-ID, des Typs, des Erstellers oder des Anwendungsfalls oder suchen Sie in der Liste nach der Agentenkarte.
- Klicken Sie auf der Agent-Karte auf KI-Agent hinzufügen.
- Prüfen Sie im Schritt Agentendetails prüfen die Metadaten des Agenten, die aus der A2A-Karte des Agenten übernommen wurden, einschließlich Name, Beschreibung, Agenten-URL, Funktionen und Skills. Klicken Sie dann auf Weiter.
- Wählen Sie im Schritt Agent authentifizieren aus, wie sich Gemini Enterprise beim Agent-Anbieter authentifiziert:
- Von Google verwaltete Standardanmeldedaten: Google verwaltet die OAuth-Anmeldedaten automatisch. Sie müssen keine Clientanmeldedaten manuell konfigurieren oder eingeben.
- Benutzerdefiniertes OAuth: Wählen Sie diese Option nur aus, wenn Ihre Organisation benutzerdefinierte OAuth-Clientanmeldedaten erfordert, und geben Sie die Client-ID, den Clientschlüssel, die Autorisierungs-URL und die Token-URL ein.
- Klicken Sie auf Beenden.
- Der Agent wird in der Agententabelle mit dem Status Aktiviert und dem Agententyp A2A (Benutzerdefiniert) angezeigt.
- Geben Sie den Agenten für die Nutzer oder Gruppen frei, die Zugriff benötigen.
Option 2: Mit JSON-Datei der A2A-Karte importieren
Wenn sich BigQuery und Gemini Enterprise in verschiedenen Projekten befinden, gehen Sie so vor, um den Agenten mit der JSON-Datei der A2A-Karte zu importieren:
- Klicken Sie in Gemini Enterprise auf den Namen der App, der Sie den Agenten hinzufügen möchten.
- Klicken Sie im Navigationsmenü auf Agents > klicken Sie auf Add agent (Agent hinzufügen).
- Suchen Sie im Bereich Agenttyp auswählen nach Benutzerdefinierter Agent über A2A und klicken Sie auf Hinzufügen.
- Geben Sie im Feld JSON-Agentenkarte die JSON-Agentenkarte ein, die Sie vom Datenanalysten erhalten haben.
- Klicken Sie auf Agentendetails ansehen > Weiter.
- Wählen Sie im Schritt Agentenautorisierung die Authentifizierungsmethode aus:
- Von Google verwaltete Standardanmeldedaten: Google verwaltet die OAuth-Anmeldedaten automatisch, ohne dass Sie eine Client-ID und einen Clientschlüssel manuell eingeben oder generieren müssen.
- Benutzerdefiniertes OAuth: Wählen Sie diese Option aus, wenn Sie benutzerdefinierte OAuth-Anmeldedaten manuell angeben möchten. Folgen Sie dazu der Anleitung unter A2A-Agents registrieren und verwalten.
- Klicken Sie im Schritt Tool-Autorisierungen auf Fertigstellen.
- Der Agent wird in der Agententabelle mit dem Status Aktiviert und dem Agententyp A2A (Benutzerdefiniert) angezeigt.
- Geben Sie den KI-Agenten für die Nutzer oder Gruppen frei, die Zugriff benötigen.
KI-Agenten finden und verwenden
Sie können einen Daten-Agenten in Gemini Enterprise auf eine der folgenden Arten finden und verwenden:
- Manuelle Suche: Suchen Sie in der Agentengalerie nach einem Daten-Agenten und verwenden Sie ihn mit einer der folgenden Methoden:
- Galerie durchsuchen: Wählen Sie den KI-Agenten aus und starten Sie einen speziellen Chat.
- Direktlink: Verwenden Sie die spezielle URL des Agents, um Gemini Enterprise direkt in einer Sitzung mit diesem bestimmten BigQuery-Datenagenten zu öffnen.
- Gezielte Absicht: Rufen Sie den Agenten im Gemini Enterprise-Kernchat mit
@mention(z. B.@sales_pipeline_agent) auf. - Nahtlose Orchestrierung: Stellen Sie eine allgemeine analytische Frage (z. B. „Wie hat sich unsere Vertriebspipeline in den letzten drei Monaten entwickelt?“), und Gemini Enterprise leitet die Anfrage automatisch an den entsprechenden Daten-Agent weiter.
Nachdem Sie den Agent gefunden haben, können Sie mit ihm interagieren. Gehen Sie dazu so vor:
- Authentifizieren: Schließen Sie die einmalige OAuth-Anmeldung ab, um sich sicher bei BigQuery zu authentifizieren.
- Chat: Stellen Sie dem KI-Agenten Fragen in natürlicher Sprache. Die Anfragen werden vom Agenten verarbeitet und die Antwort wird als Text, Markdown, Diagramme oder Tabellen an Gemini Enterprise zurückgegeben.
- Unterhaltungsverlauf ansehen: Unterhaltungen werden automatisch im Bereich „Verlauf“ gespeichert.
KI-Agenten und Unterhaltungen überwachen
Mit Google Cloud Observability in BigQuery können Sie die Leistung, Akzeptanz, Latenz und Kosten Ihrer KI-Datenagenten und ihrer Unterhaltungen im Blick behalten. Wenn Sie die Beobachtbarkeit von KI-Agenten aktivieren, können Sie Messwerte wie die folgenden aufrufen:
- Die Anzahl der in Unterhaltungen verwendeten KI-Agenten
- Anzahl der Nutzer, die Fragen gestellt haben
- Anzahl der erstellten Unterhaltungen
- Die Kundenservicemitarbeiter, die die meisten Fragen beantwortet haben
- Die am häufigsten verwendeten Wissensquellen
- Nutzer-Engagement
- Voraussichtliche Tokennutzung
- Antwortlatenz pro Stunde
Hinweis
Aktivieren Sie die APIs Cloud Trace, Cloud Monitoring und Cloud Logging, falls sie noch nicht aktiviert sind.
Rollen, die zum Aktivieren von APIs erforderlich sind
Zum Aktivieren von APIs benötigen Sie die Berechtigung serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Inhaberrolle (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen
Erforderliche Rollen und Berechtigungen
Zum Aktivieren der Beobachtbarkeit von KI-Agenten benötigen Sie die folgenden Berechtigungen für Ihr Projekt:
cloudaicompanion.gibqObservabilitySettings.createcloudaicompanion.gibqObservabilitySettings.listcloudaicompanion.gibqObservabilitySettings.updatecloudaicompanion.settingBindings.gibqObservabilitySettingsCreatecloudaicompanion.settingBindings.gibqObservabilitySettingsListcloudaicompanion.settingBindings.gibqObservabilitySettingsUsegeminidataanalytics.dataAgents.creategeminidataanalytics.operations.getobservability.traceScopes.createresourcemanager.projects.updateserviceusage.services.enableserviceusage.values.test
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen für Ihr Projekt zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Überwachen Ihrer Agents mithilfe von Messwerten, Traces und Logs benötigen:
-
Monitoringdaten und -konfigurationen ansehen:
Monitoring-Betrachter (
roles/monitoring.viewer) -
Traces ansehen:
Cloud Trace-Nutzer (
roles/cloudtrace.user) -
Logs ansehen:
Loganzeige (
roles/logging.viewer) -
Datasets und deren Inhalte ansehen: BigQuery-Datenbetrachter (
roles/bigquery.dataViewer) -
Administratoreinstellungen ansehen:
Gemini for Google Cloud User (
roles/cloudaicompanion.user)
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Sie können die erforderlichen Berechtigungen auch über benutzerdefinierte Rollen oder andere vordefinierte Rollen erhalten.
Beobachtbarkeit aktivieren
Die Beobachtbarkeit von KI-Agenten ist standardmäßig deaktiviert. Ein Administrator kann es für Ihr Projekt oder Ihre Organisation aktivieren. Wählen Sie eine der folgenden Optionen aus, um die Beobachtbarkeit für Ihre Agents zu aktivieren:
Console
Rufen Sie in der Google Cloud Console die BigQuery-Seite Agents auf.
Wählen Sie den Tab Monitoring aus.
Wenn die Beobachtbarkeit deaktiviert ist, folgen Sie den Aufforderungen, um sie zu aktivieren.
Google Cloud CLI
Erstellen Sie eine Einstellung für die Beobachtbarkeit:
gcloud gemini gibq-observability-settings create SETTING_NAME \
  --conversational-analytics-setting-metrics-enabled \
  --conversational-analytics-setting-traces-enabled \
  --project=PROJECT_ID \
  --location=global
Ersetzen Sie Folgendes:
SETTING_NAME: Ein Name für die Observability-Einstellung.PROJECT_ID: Ihre Projekt-ID.
Binden Sie die Einstellung für die Beobachtbarkeit an Ihr Projekt:
gcloud gemini gibq-observability-settings setting-bindings create BINDING_NAME \
  --gibq-observability-setting=SETTING_NAME \
  --target=projects/PROJECT_ID \
  --location=global \
  --project=PROJECT_ID
Ersetzen Sie
BINDING_NAMEdurch einen Namen für die Einstellungsbindung. Wir empfehlen,binding-PROJECT_IDals Bindungsnamen zu verwenden.
API
Erstellen Sie eine Einstellung für die Beobachtbarkeit:
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d '{
          "conversational_analytics_setting": {
            "metrics_enabled": true
          }
        }' \
    "https://cloudaicompanion.googleapis.com/v1/projects/PROJECT_ID/locations/global/gibqObservabilitySettings?gibq_observability_setting_id=SETTING_NAME"
Ersetzen Sie Folgendes:
SETTING_NAME: Ein Name für die Observability-Einstellung.PROJECT_ID: Ihre Projekt-ID.
Binden Sie die Einstellung für die Beobachtbarkeit an Ihr Projekt:
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d '{
          "target": "projects/PROJECT_ID",
          "product": "GEMINI_IN_BIGQUERY"
        }' \
    "https://cloudaicompanion.googleapis.com/v1/projects/PROJECT_ID/locations/global/gibqObservabilitySettings/SETTING_NAME/settingBindings?setting_binding_id=BINDING_NAME"
Ersetzen Sie
BINDING_NAMEdurch einen Namen für die Einstellungsbindung. Wir empfehlen, für den Bindungsnamenbinding-PROJECT_IDzu verwenden.
Messwerte aufrufen
Messwerte werden erfasst, nachdem Sie die Beobachtbarkeit aktiviert haben. Daten werden nicht nachgetragen. Wählen Sie eine der folgenden Optionen aus, um Agent-Messwerte aufzurufen:
BigQuery
Rufen Sie in der Google Cloud Console die BigQuery-Seite Agents auf.
Wählen Sie den Tab Monitoring aus.
Cloud Monitoring
Rufen Sie in der Google Cloud Console die Seite Dashboards von Cloud Monitoring auf.
Suchen Sie im Bereich Meine Dashboards nach dem Dashboard mit dem Namen
BigQuery Conversational Analytics.Klicken Sie auf den Namen des Dashboards, um es zu öffnen.
Optional: Erstellen Sie ein benutzerdefiniertes Dashboard.
Optional: Wenn Sie Messwerte einzeln ansehen möchten, rufen Sie die Seite Metrics Explorer auf.
Zu den Agent-Messwerten gehören Agent-Nutzung, Modellaufrufe, Toolnutzung, Zustand, Latenz und Tokennutzung.
Fehlerbehebung bei Modellaufrufen
Sie können die Reihenfolge der Vorgänge in einem Gesprächsabschnitt visualisieren, z. B. Modellaufrufe und Tool-Aufrufe, um Fehler und Latenz zu beheben.
Rufen Sie in der Google Cloud Console die Seite Trace Explorer von Cloud Monitoring auf.
Klicken Sie auf einen Span, um ihn zu untersuchen.
Sehen Sie sich die Informationen im Bereich Details an.
Optional: Erstellen Sie ein benutzerdefiniertes Trace-Dashboard.
Traces beibehalten
Ihre Cloud Trace-Daten werden 30 Tage lang in einem Beobachtbarkeits-Dataset gespeichert. Wenn Sie Ihre Trace-Daten länger speichern möchten, verschieben Sie sie in ein BigQuery-Dataset.
Erforderliche Rollen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen für Ihr Projekt zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Offenlegen von Live-Traces in BigQuery durch Erstellen eines verknüpften Datasets benötigen:
- Cloud Trace-Administrator (
roles/cloudtrace.admin) - Observability Editor (
roles/observability.editor) - BigQuery User (
roles/bigquery.user)
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Sie können die erforderlichen Berechtigungen auch über benutzerdefinierte Rollen oder andere vordefinierte Rollen erhalten.
Trace-Daten nach BigQuery verschieben
So behalten Sie Ihre Trace-Daten:
Öffnen Sie Cloud Shell.
So finden Sie den Standort Ihres
_Trace-Buckets:gcloud beta observability buckets list --location=-
Notieren Sie sich den Speicherort des
_Trace-Buckets für den nächsten Schritt.Erstellen Sie in Ihrem BigQuery-Projekt ein verknüpftes Dataset, das auf Ihren
_Trace-Bucket verweist:gcloud beta observability buckets datasets links create \ projects/PROJECT_ID/locations/LOCATION/buckets/_Trace/datasets/Spans/links/LINK_NAME \ --dataset=Spans \ --bucket=_Trace \ --location=LOCATION \ --project=PROJECT_ID
Ersetzen Sie Folgendes:
PROJECT_ID: Ihre Projekt-ID.LOCATION: der Speicherort Ihres_Trace-Buckets aus dem vorherigen SchrittLINK_NAME: ein Name für das verknüpfte Dataset
Erstellen Sie ein Standard-Dataset, in dem Sie Ihre historischen Traces speichern können. Mit dem folgenden Befehl wird der Standardablauf für Partitionen auf 90 Tage (7.776.000 Sekunden) festgelegt:
bq --location=LOCATION mk \
    --dataset \
    --default_partition_expiration=7776000 \
    --description="Archive storage for historical traces" \
    PROJECT_ID:STORAGE_DATASET
Ersetzen Sie
STORAGE_DATASETdurch einen Namen für das Dataset.Erstellen Sie in Ihrem Speicher-Dataset eine leere partitionierte Tabelle mit demselben Schema wie das verknüpfte Dataset. Durch die Partitionierung nach Datum können Sie die Datenaufbewahrung und die Abfragekosten verwalten. Führen Sie die folgende Abfrage im SQL-Editor aus, um die Tabelle zu erstellen:
CREATE TABLE `PROJECT_ID.STORAGE_DATASET.TABLE_NAME`
PARTITION BY DATE(start_time)
AS
SELECT *
FROM `PROJECT_ID.LINK_NAME._AllSpans`
WHERE FALSE;
Ersetzen Sie
TABLE_NAMEdurch einen Namen für die Tabelle.Erstellen Sie eine geplante Abfrage, um täglich Trace-Daten aus dem verknüpften Dataset in Ihre Archivtabelle zu kopieren. Mit der folgenden Abfrage werden Daten vom Vortag kopiert:
INSERT INTO `PROJECT_ID.STORAGE_DATASET.TABLE_NAME`
SELECT *
FROM `PROJECT_ID.LINK_NAME._AllSpans`
WHERE start_time >=
  TIMESTAMP_SUB(TIMESTAMP_TRUNC(CURRENT_TIMESTAMP(), DAY), INTERVAL 1 DAY)
  AND start_time < TIMESTAMP_TRUNC(CURRENT_TIMESTAMP(), DAY);
Weitere Informationen zum Suchen und Analysieren von Traces
Beobachtbarkeit deaktivieren
Wenn Sie die Beobachtbarkeit für Ihre Daten-Agents deaktivieren möchten, aktualisieren Sie die entsprechende Einstellung:
gcloud gemini gibq-observability-settings update SETTING_NAME \
    --no-conversational-analytics-setting-metrics-enabled \
    --no-conversational-analytics-setting-traces-enabled \
    --project=PROJECT_ID \
    --location=global
Ersetzen Sie Folgendes:
SETTING_NAME: Der Name der Einstellung für die Beobachtbarkeit, die Sie erstellt haben, um die Beobachtbarkeit zu aktivieren. Wenn Sie die Beobachtbarkeit über die Google Cloud Console aktiviert haben, lautet der Name der Einstellungdefault.PROJECT_ID: Ihre Projekt-ID.
Nächste Schritte
- Weitere Informationen zur konversationellen Analyse in BigQuery
- Weitere Informationen zur Conversational Analytics API
- Daten mithilfe von Unterhaltungen analysieren
- Weitere Informationen dazu, wie die Rolle Gemini Data Analytics Data Agent Viewer (
roles/geminidataanalytics.dataAgentViewer) die Berechtigung zum Aufrufen des KI-Datenagenten gewährt.