


データ エージェントを作成する
このドキュメントでは、BigQuery でデータ エージェントを作成、編集、管理、削除する方法について説明します。
BigQuery では、データ エージェントと会話し、自然言語で BigQuery データに関する質問をすることができます。データ エージェントには、テーブル メタデータとユースケース固有のクエリ処理の指示が含まれています。これらにより、選択した一連のナレッジ ソース(テーブル、ビュー、ユーザー定義関数(UDF)など)に関するユーザーからの質問に答える最適な方法を定義します。
始める前に
-
BigQuery、Gemini Data Analytics、Gemini for Google Cloud、Knowledge Catalog の各 API がまだ有効になっていない場合は、有効にします。
API を有効にするために必要なロール
API を有効にするには、
serviceusage.services.enable権限が必要です。プロジェクトを作成した場合は、オーナーロール(roles/owner)を通じてこの権限がすでに付与されている可能性があります。それ以外の場合は、Service Usage 管理者ロール(roles/serviceusage.serviceUsageAdmin)を通じてこの権限を取得できます。ロールを付与する方法を確認する。
必要なロール
データ エージェントを使用するには、ユースケースに一致する Identity and Access Management(IAM)権限が必要です。以降のセクションでは、エージェントの作成と公開、Gemini Enterprise でのエージェントのプロビジョニング、さまざまなサーフェスでのエージェントの検出と使用のいずれを行うかに応じて、必要なロールを示します。詳細については、Conversational Analytics API の IAM ロールをご覧ください。
- エージェントの作成、編集、公開、共有、削除:
- プロジェクトにデータ エージェントを作成する: プロジェクトに対する Gemini Data Agent Creator(
roles/geminidataanalytics.dataAgentCreator)。このロールにより、作成したデータ エージェントに対する Gemini データ分析 Data Agent Owner のロールが自動的に付与されます。 - データ エージェントを編集、共有、削除する: エージェントまたはプロジェクトに対する Gemini データ分析データ エージェント オーナー(
roles/geminidataanalytics.dataAgentOwner)。 - プロジェクト内のデータ エージェントを編集する: プロジェクトに対する Gemini データ分析データ エージェント編集者(
roles/geminidataanalytics.dataAgentEditor)。 - プロジェクト内のデータ エージェントを表示する: プロジェクトに対する Gemini データ分析データ エージェント閲覧者(
roles/geminidataanalytics.dataAgentViewer)。
- プロジェクトにデータ エージェントを作成する: プロジェクトに対する Gemini Data Agent Creator(
- Gemini Enterprise でエージェントをプロビジョニングする:
- 公開されたエージェントを Gemini Enterprise のユーザーが利用できるようにするには、Gemini Enterprise 管理コンソールでカスタム エージェントを登録して管理する権限と、Agent Gateway を構成する権限が必要です。
- エージェントを見つけて使用する:
- データ エージェントとチャットする: Gemini データ分析 Data Agent User(
roles/geminidataanalytics.dataAgentUser)。 - プロジェクト内のすべてのデータ エージェントを表示する: Gemini データ分析データ エージェント閲覧者(
roles/geminidataanalytics.dataAgentViewer)。 - データポータルの Gemini を活用したチャット インターフェースを操作するには: BigQuery Studio ユーザー(
roles/bigquery.studioUser)または Gemini for Google Cloud ユーザー(roles/cloudaicompanion.user)。それぞれにcloudaicompanion.topics.create権限が付与されています。これらのロールは、プロジェクト レベルで付与します。また、データポータル アセット閲覧者(roles/datastudio.viewer)のロールも必要です。
- データ エージェントとチャットする: Gemini データ分析 Data Agent User(
- エージェントにナレッジソースを追加する:
- プロジェクトに対する Data Catalog 閲覧者(
roles/datacatalog.viewer)。
- プロジェクトに対する Data Catalog 閲覧者(
会話を行うには、会話に必要なロールをご覧ください。
エージェントはユーザーに代わって動作し、ユーザーの権限を使用します。エージェントは、アクセス権を持つデータとリソースにのみアクセスできます。
ベスト プラクティス
会話分析は、ユーザーの質問に答えるために、ユーザーに代わってクエリを自動的に実行します。クエリ費用が増加する可能性がある次の要因を考慮してください。
- 大きなテーブルサイズ
- クエリでのデータ結合の使用
- クエリ内の AI 関数への頻繁な呼び出し
分析情報を生成する
必要に応じて、ナレッジソースとして使用するテーブルのデータ分析情報を Knowledge Catalog で生成できます。
生成インサイトは、データ エージェントが質問に対する回答を生成するために利用できるテーブル メタデータを提供します。
分析情報を事前に生成していない場合は、データ エージェントの作成時にテーブルをナレッジソースとして選択すると、分析情報が自動的に生成されます。
サンプルデータ エージェントを使用する
会話型分析用のエージェントの構成に慣れていない場合は、必要に応じて、すべてのGoogle Cloud プロジェクト用に生成された事前定義済みのサンプル エージェントを表示できます。チャットしてパラメータを表示し、作成方法を確認できますが、変更はできません。
サンプル エージェントを表示するには、次の操作を行います。
Google Cloud コンソールで、BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
[Google によるサンプル エージェント] セクションで、サンプル エージェント カードをクリックします。
データ エージェントを作成する
以降のセクションでは、データ エージェントを作成する方法について説明します。
エージェントを作成したら、設定を編集できます。
最初の手順
Google Cloud コンソールで、BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
[新しいエージェント] をクリックします。[新しいエージェント] ページが開きます。
[エディタ] セクションの [エージェント名] フィールドに、データ エージェントのわかりやすい名前(
Q4 sales dataやUser activity logsなど)を入力します。[エージェントの説明] フィールドに、データ エージェントの説明を入力します。適切な説明を付けておくと、エージェントの機能や使用するデータがわかり、チャット相手とするデータ エージェントを選択する際に役立ちます(例:
Ask questions about customer orders and revenue)。[ナレッジソース] セクションで、[ソースを追加] をクリックします。[ナレッジソースを追加] ページが開きます。
[最近使用したアイテム] セクションで、ナレッジソースとして使用するテーブル、ビュー、グラフ、UDF を選択します。UDF には、 Google Cloud コンソールで「fx」という接頭辞が付いています。
他のナレッジソースを表示するには、 [さらに表示] を選択します。
省略可: [最近使用したアイテム] セクションにリストされていないナレッジソースを追加します。
[検索] セクションの [テーブルを検索] フィールドにソース名を入力し、Enter キーを押します。ソース名は正確でなくてもかまいません。
[検索結果] セクションで、1 つ以上のソースを選択します。
[追加] をクリックします。新しいエージェント ページが再度開きます。
テーブルとフィールドの説明をカスタマイズする
データ エージェントの精度を高めるために、必要に応じて追加のテーブル メタデータを提供できます。このメタデータはデータ エージェントによってのみ使用されるもので、ソーステーブルには影響しません。
テーブルとフィールドの説明を作成する際は、次のベスト プラクティスに従ってください。
これらの説明を参考に、データ エージェントがスキーマをどのように理解しているかを確認してください。エージェントが提案した説明が正しい場合は、承認できます。
これらの説明を構成した後、データ エージェントがスキーマを理解していない場合は、説明を手動で調整して正しい情報を提供します。
テーブルとフィールドの説明を構成する手順は次のとおりです。
[ナレッジ ソース] セクションで、テーブルの [カスタマイズ] リンクをクリックします。
テーブルの説明を作成します。[テーブルの説明] フィールドに説明を入力するか、Gemini からの提案を受け入れます。
[フィールド] セクションで、Gemini から提案されたフィールドの説明を確認します。
受け入れるフィールドの説明を選択して、[提案を承認する] をクリックします。却下する説明文を選択して、[提案を拒否] をクリックします。
フィールドの説明を手動で編集するには、フィールドの横にある [編集] をクリックします。[フィールドを編集] ペインが開きます。
- [説明] フィールドに、フィールドの説明を入力します。
- フィールドの説明を保存するには、[更新] をクリックします。
説明とフィールドの更新を保存するには、[更新] をクリックします。新しいエージェント ページが再度開きます。
カスタマイズが必要なテーブルごとに、この手順を繰り返します。
エージェントへの指示を作成する
エージェントは、カスタム指示がなくてもユーザーの質問のコンテキストを理解する必要があります。エージェントの動作を変更する必要がある場合や、他のコンテキスト機能(カスタム テーブルやフィールドのメタデータ、検証済みのクエリなど)でサポートされていない方法でコンテキストを改善する必要がある場合にのみ、エージェントのカスタム指示を作成します。
[手順] セクションの [エージェントへの指示] フィールドに、データ エージェントへの指示を入力します。データ エージェントは、これらの指示に基づいてユーザーからの質問のコンテキストを理解し、回答を提供するため、指示はできるだけ明確にしてください。
エージェントから満足のいく回答が得られない場合は、説明、例、用語集の用語などの構造化されたコンテキストを追加します。それでも満足のいく回答が得られない場合は、次の表の例のようなカスタム指示を追加します。
[例を表示] をクリックすると、指示の例がさらに表示されます。
| 情報の種類 | 説明 | 例 |
|---|---|---|
| 主なフィールド | 分析に関して最も重要なフィールド。 | 「このテーブルで最も重要なフィールドは、[お客様 ID]、[商品 ID]、[注文日] です。」 |
| フィルタリングとグループ化 | エージェントがデータのフィルタリングとグループ化に使用するフィールド。 | 「質問がタイムラインや「経時的」なものである場合は、常に order_created_date 列を使用します。」「ユーザーが『商品別』と発言したら、product_category 列でグループ化します。」 |
| デフォルトのフィルタリング | デフォルトでフィルタリングするフィールド。 | 「特に記載がない限り、常に order_status = 'Complete' でデータをフィルタします。」 |
| 類義語とビジネス用語 | 主なフィールドの代替用語。 | 「収益または売上について質問された場合は、total_sale_amount 列を使用します。」「購入回数が 5 回を超えるお客様を『ロイヤル』顧客と見なします。」 |
| 除外済みフィールド | データ エージェントが使用を避けるべきフィールド。 | 「[取得された取引日]、[取得された市区町村] のフィールドは使用しないでください。」 |
| 結合関係 | 2 つ以上のテーブルが互いにどのように関連付けられているか、およびどの列で結合されているか。エージェントは、列ペアに対して標準 SQL JOIN を使用してデータを結合する必要があります。例の列をご覧ください。 | Customer Activity
|
検証済みクエリを作成する
エージェントは、確認済みのクエリを次の 2 つの方法で使用します。
- エージェントが検証済みのクエリを使用して質問に回答できる場合、信頼できる回答を保証するために、エージェントはクエリを記述されたとおりに呼び出します。
- エージェントが検証済みのクエリを使用して質問に回答できない場合でも、クエリをリファレンスとして使用して、データとクエリのベスト プラクティスを理解します。
システムによって生成されたリストから検証済みのクエリを選択することも、独自のクエリを作成することもできます。
データ エージェントの検証済みクエリ(以前はゴールデン クエリと呼ばれていました)を作成する手順は次のとおりです。
Gemini から提案された検証済みクエリを 1 つ以上選択します。
- [検証済みクエリ] セクションで、[候補の確認] をクリックします。[検証済みクエリの候補を確認する] ページが開きます。
- 検証済みクエリの候補を確認します。ユースケースに該当するものを選択します。
- [追加] をクリックします。新しいエージェント ページが再度開きます。
独自の検証済みクエリを作成するには、[クエリを追加] をクリックします。[検証済みクエリを追加] ページが開きます。
- [質問] フィールドに、検証済みクエリで回答するユーザーからの質問を入力します。
- [SQL を生成] をクリックして、指定したユーザーの質問に対応する検証済みクエリを Gemini に生成させます。
- 必要に応じて、検証済みクエリを修正します。
- [実行] をクリックし、クエリが想定どおりの結果を返すことを確認します。
- [追加] をクリックします。新しいエージェント ページが再度開きます。
必要に応じて、上記の手順を繰り返して追加の検証済みクエリを作成します。
パラメータ化された検証済みクエリを作成する
パラメータ化された検証済みクエリは、会話型分析エージェントのユーザーの質問から値を抽出し、カスタマイズされた結果を提供します。
アナリストとビルダーは、これらの値のプレースホルダを含む再利用可能な SQL テンプレートを作成できます。テンプレートは、実行時にパラメータを動的に置き換えて、通常の検証済みクエリよりも幅広いユーザーの質問に回答します。
ユーザーがテンプレートのパターンに一致する質問をすると、会話型分析エージェントは質問からパラメータ値(商品名、地域、日付など)を抽出します。次に、これらの値をパラメータ化されたクエリに挿入します。クエリ テンプレートと一致するレスポンスは、検証済みとして表示されます。
パラメータ化された検証済みクエリを使用すると、検証済みクエリの機能と柔軟性が大幅に向上します。さまざまな入力に対して一貫性のある信頼できる回答を保証し、維持する個々のクエリの数を減らします。
仕組み
データ アナリストなどのエキスパートは、テンプレートの質問(「@region の @product の売上高はいくらでしたか?」など)を使用して、検証済みクエリを定義します。次に、エキスパートは、次の例に示すように、SQL パラメータを使用して検証済みクエリを作成または変更します。
SELECT * FROM sales WHERE region = @region AND product = @product
検証済みのクエリが保存されると、ユーザーは会話分析エージェントに自然言語で質問できます(「北米でのノートパソコンの売上高は?」など)。
お客様の質問に答えるため、エージェントは次の手順を行います。
- 質問を、パラメータ化された検証済みクエリに関連付けられたパターンと照合します。エージェントは自然言語理解(NLU)を使用して、ユーザーの質問から
@region(北米)と@product(ノートパソコン)の値を特定して抽出します。 - 抽出された値を SQL テンプレートの
@regionプレースホルダと@productプレースホルダに代入します。 - 完全な SQL クエリ(
SELECT * FROM sales WHERE
region = 'North America' AND product = 'Laptops'
など)を実行します。 - 結果をユーザーに返します。一致は常に確認済みとしてマークされます。
効果的なパラメータ化されたクエリを作成するためのヒント
- 明確なパラメータ名を使用する。パラメータにはわかりやすい名前を使用します(例:
@d1ではなく@start_date)。 - パラメータの詳細な説明を作成します。会話型分析の大規模言語モデル(LLM)は、パラメータの説明を使用して、ユーザーの質問からパラメータとその値を識別します。たとえば、
num_enrollmentsは有効なパラメータ名ですが、number of student enrollments from ages 5-14はクエリに関するコンテキストをより多く提供するパラメータの説明です。 - データ型の一貫性を確保します。SQL クエリで想定されるデータ型が、ユーザーの質問から抽出される可能性のあるデータ型と一致していることを確認します。
- 明確なスコープを指定する。クエリの作成が複雑な場合や、ロジックが直感的でない一般的な質問パターンのテンプレートを作成します。これにより、LLM は最適な結果を返すことができます。
- 徹底的にテストする。さまざまな自然言語の言い回しでテストして、パラメータが正しく抽出されることを確認します。
パラメータ化された検証済みクエリを作成する
システムによって生成されたリストから検証済みのクエリを選択することも、独自のクエリを作成することもできます。
クエリを作成または変更する前に、自然言語パターンと質問を考慮してクエリの下書きを作成します。たとえば、「米国東部倉庫の有機バナナの総在庫はわかりますか?」という質問は、「@リージョン倉庫の @商品の総在庫は?」というパラメータ化された検証済みクエリに書き換えることができます。エージェントは、この質問を SQL クエリに変換します。このクエリは、デフォルト値で更新します。
データ エージェントのパラメータ化された検証済みクエリを作成するには、新しいエージェントを作成するときに新しいクエリを作成するか、新しいエージェントまたは既存のエージェントの既存の検証済みクエリを編集します。
次の手順では、パラメータを使用して構成する検証済みクエリのサンプルを使用します。
Gemini から提案された既存の確認済みクエリを選択する
- 新しいエージェントまたは既存のエージェントの [検証済みクエリ] セクションで、[候補の確認] をクリックします。[検証済みクエリの候補を確認する] ページが開きます。
- 提案された確認済みクエリの横にあるチェックボックスをオンにします。
- クエリ ウィンドウで [もっと見る] をクリックして、クエリの説明を展開します。
- 既存のクエリを開くには、[編集] をクリックします。
- クエリの構成を完了するには、検証済みクエリのパラメータを構成するをご覧ください。
エージェントを作成してから、検証済みクエリを作成する
- 最初の手順を参照し、残りの構成手順を完了してクエリを確認します。
- Google Cloud コンソールで、新しいエージェントの [検証済みクエリ] セクションで、[クエリを追加] をクリックします。[検証済みクエリを追加] ページが開きます。
- クエリの構成を完了するには、検証済みクエリのパラメータを構成するをご覧ください。
検証済みクエリのパラメータを構成する
- [質問] フィールドに、検証済みクエリで回答するユーザーからの質問を入力します。
- パラメータを指定するには、
@記号の後にパラメータ名を続けます。この構文は、ユーザーの質問から値を取り込むプレースホルダを識別します。ユーザーの質問でパラメータがどのように使用されるかを示す自然言語の質問を使用します。例: 「@region の倉庫にある @product の在庫の合計は?」 [SQL を生成] をクリックします。SQL は次の例のようになります。
SELECT SUM(stock) AS total_stock FROM inventory WHERE product_id = @product AND region = @region;クエリのプレースホルダにデフォルト値を追加するには、[クエリ パラメータを管理] をクリックし、[クエリ パラメータを追加] をクリックします。
最初のパラメータには、[名前]、[タイプ]、[値]、[説明] の 4 つのフィールドが表示されます。
- [名前] に、質問から
@productをコピーして貼り付けます。 - [タイプ] で [STRING] を選択します。
- [値] に「
organic bananas」と入力します。 - [説明] に、できるだけ具体的な説明を入力します。たとえば、地域別の倉庫に保管されている商品などです。
- [名前] に、質問から
2 つ目のパラメータで、[クエリ パラメータを追加] をクリックします。
- [名前] に、質問から
@regionをコピーして貼り付けます。 - [タイプ] で [STRING] を選択します。
- [値] に「
US-EAST」と入力します。 - [説明] に、できるだけ具体的な説明を入力します(例:
a regional warehouse where products are located.)。
- [名前] に、質問から
両方のパラメータのフィールドに入力したら、[保存] をクリックします。
パラメータ化された検証済みクエリをテストする
- [実行] をクリックし、クエリが想定どおりの結果を返すことを確認します。
- 後の画面でユーザーのクエリをテストするには、質問フィールド全体をコピーします。
- [保存] をクリックして [クエリを追加] 画面を終了し、エージェントの [編集] ページに戻ります。
- エージェントの [編集] ページで、以前にコピーした質問フィールドを [プレビュー] ウィンドウに貼り付けます。
@product変数をorganic bananasに置き換えます。@region変数をUS-EASTに置き換えます。
- Enter キーを押します。結果を確認してみましょう。この場合、有効な回答は US-EAST リージョンのバナナの在庫数の合計です(例: 1,000)。
- 必要に応じて、上記の手順を繰り返して、追加の検証済みクエリを作成または編集します。
クエリを保存したので、ユーザーは「米国東部倉庫の有機バナナの総在庫数はわかりますか?」という質問をすることができます。会話分析は次の処理を行います。
- この質問をパターンと照合します。
- 質問から
@productパラメータを@product= 「organic bananas」、@regionパラメータを「US-EAST」として抽出します。 - クエリを実行します:
SELECT SUM(stock) AS total_stock FROM inventory WHERE product_id = 'organic bananas' AND region = 'US-EAST'; - 計算された
total_stockを返します。
用語集の用語を作成または確認する
エージェントにローカルな BigQuery カスタム用語集の用語を作成したり、Knowledge Catalog からインポートされたビジネス用語集の用語を確認して、エージェント用に選択したナレッジソースに適用できます。
- Knowledge Catalog のビジネス用語集の用語は BigQuery リソースにグローバルに適用されるため、Knowledge Catalog を使用する場合は、個々のエージェントではなく Knowledge Catalog でビジネス用語集の用語を作成して管理します。
- Knowledge Catalog からインポートしたビジネス用語集の用語を変更する必要がある場合は、Knowledge Catalog で編集し、BigQuery に戻って確認する必要があります。
- BigQuery のカスタム用語集の用語は BigQuery に残ります。Knowledge Catalog には表示されない。
- Knowledge Catalog を使用していない場合は、特定のエージェントで定義する必要がある用語に対して、BigQuery カスタム用語集の用語を作成できます。
エージェントのカスタム用語集を作成する手順は次のとおりです。
- エージェントの [エディタ] ページの [用語集] セクションで、[用語を追加] をクリックします。
- [カスタム用語] セクションで、既存のカスタム用語を編集または削除できます。
- 1 つ以上の新しい用語を作成するには、[用語を作成] をクリックします。
- 用語、定義、1 つ以上の類義語をカンマで区切って入力します。
- 用語を作成するには、[追加] をクリックします。
- 新しい用語を削除する場合は、[削除] をクリックします。
- カスタム用語をさらに作成するには、上記の手順を繰り返します。
Knowledge Catalog からインポートしたビジネス用語集の用語を表示する手順は次のとおりです。
- エージェントの [エディタ] ページの [用語集] セクションで、[用語を追加] をクリックします。
- [Dataplex からインポート] というページ セクションに移動します。
- Knowledge Catalog でインポートした用語を変更するには、[Dataplex 用語集に移動] をクリックします。
- Knowledge Catalog で用語を変更したら、エージェントの [エディタ] ページに戻って、変更した用語を確認できます。
構成の設定
[設定] セクションでは、次のオプション設定を構成できます。
[モデル] セクションで、エージェントとの会話でユーザーが利用できるモデルのタイプを選択します。プレビュー版と一般提供版の両方のモデルがデフォルトで使用できます。プレビュー版のモデルはグローバル エンドポイントを使用する場合があります。
Google Cloud リソースの整理に役立つラベルを作成します。ラベルは、関連するオブジェクトをまとめてグループ化したり、他の Google Cloud リソースと組み合わせてグループ化できる Key-Value ペアです。
- [設定] セクションで [ラベルを管理] をクリックします。
- [ラベルを追加] をクリックします。
- [キー] フィールドと [値] フィールドに、ラベルの Key-Value ペアを入力します。
- さらにラベルを追加する場合は、[ラベルを追加] をもう一度クリックします。
- ラベルを削除するには、[削除] をクリックします。
- 完了したら、[追加] をクリックします。新しいエージェント ページが再度開きます。
データ エージェントによって処理されるクエリのサイズ上限を設定します。[設定] セクションの [課金される最大バイト数] フィールドに値を入力します。この上限は
10485760以上に設定する必要があります。それ以外の場合は、次のエラー メッセージが表示されます。
Value error. In BigQuery on-demand pricing charges are
rounded up to the nearest MB, with a minimum of 10 MB of data processed
per query. So, max bytes billed must be set to greater or equal to
10485760.
値を指定しない場合、maximum bytes billed はプロジェクトの 1 日あたりのクエリ使用量の割り当てにデフォルト設定されます。カスタム割り当てを指定していない限り、1 日あたりの使用量の割り当ては無制限です。
次のセクションに進んで、エージェントをドラフト モードにするか、エージェントを公開します。
エージェントをプレビューして公開する
[プレビュー] セクションの [質問する] フィールドにユーザーからの質問の例を入力し、Enter キーを押します。データ エージェントが想定どおりのデータを返していることを確認するには、エージェントのレスポンスを確認します。回答が適切でない場合は、[エディタ] セクションで設定を変更して、満足のいく回答が得られるまでデータ エージェントの構成を調整します。エージェントのテストと修正を反復することで、エージェントの結果を改善できます。
[保存] をクリックします。
データ エージェントをドラフト モードにして後で再編集できるようにするには、 [戻る] をクリックして [エージェント カタログ] ページに戻ります。エージェントが下書きモードになったため、[エージェント カタログ] タブの [下書きエージェント] セクションに表示されます。
エージェントを公開するには、エージェントの作成ページで次の手順に進みます。
[公開] をクリックして [公開チャネル] ペインを開き、データ エージェントを公開して、プロジェクトで使用できるようにします。
省略可: [エージェントが公開されました] ダイアログで [共有] をクリックして、データ エージェントを他のユーザーと共有します。
[共有権限] ペインで、[プリンシパルを追加] をクリックします。
[新しいプリンシパル] フィールドに、1 つ以上のプリンシパルを入力します。
[ロールを選択] リストをクリックします。
[ロール] リストで、次のいずれかのロールを選択します。
- Gemini Data Analytics Data Agent User(
roles/geminidataanalytics.dataAgentUser): データ エージェントとチャットする権限を付与します。 - Gemini データ分析データ エージェント編集者(
roles/geminidataanalytics.dataAgentEditor): データ エージェントを編集する権限を付与します。 - Gemini Data Analytics Data Agent Viewer(
roles/geminidataanalytics.dataAgentViewer): データ エージェントを表示する権限を付与します。
- Gemini Data Analytics Data Agent User(
[保存] をクリックします。
新しいエージェント ページに戻るには、[閉じる] をクリックします。エージェントを保存または公開すると、すぐに Agent Catalog に表示されます。
BigQuery Studio またはデータポータルを使用して、データ エージェントとの会話を作成できます。また、Conversational Analytics API を使用して、データ エージェントとチャットする独自のインターフェースを構築することもできます。データポータルへの公開については、データポータルでデータ エージェントを公開するをご覧ください。Gemini Enterprise への公開については、Gemini Enterprise でデータ エージェントを公開するをご覧ください。
データ エージェントを管理する
既存のエージェントは、[エージェント カタログ] タブで確認できます。このタブは次の 3 つのセクションで構成されています。
- マイ エージェント: 作成して公開したすべてのエージェントのリスト。公開したエージェントは、変更して他のユーザーと共有できます。
- 下書きのエージェント: まだ公開していないエージェント。下書きエージェントは共有できません。
- 組織内の他のユーザーが共有: 他のユーザーが作成して共有したエージェント。他のユーザーから権限が付与されている場合は、これらの共有エージェントを編集できます。
データ エージェントを編集する
データ エージェントを編集する手順は次のとおりです。
BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
変更するデータ エージェントのエージェント カードを見つけます。
エージェント エディタでデータ エージェントを開くには、 [アクションを開く] > エージェント カードで [編集] をクリックします。
必要に応じてデータ エージェントの構成を編集します。
公開せずに変更を保存するには、[保存] をクリックします。
変更を公開するには、[公開] をクリックします。[共有] ダイアログで、エージェントを他のユーザーと共有するか、[キャンセル] をクリックします。
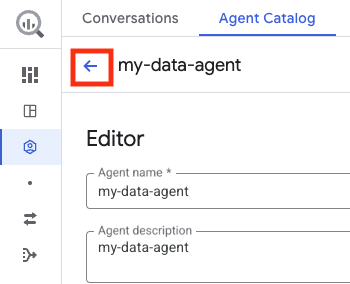
[エージェント] ペインに戻るには、 [戻る] をクリックします。
データ エージェントを共有する
公開されたデータ エージェントを共有する手順は次のとおりです。下書きエージェントは共有できません。
BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
変更するデータ エージェントのエージェント カードを見つけます。
エージェント エディタでデータ エージェントを開くには、 [アクションを開く] > エージェント カードで [編集] をクリックします。
データ エージェントを他のユーザーと共有するには、[共有] をクリックします。
[共有権限] ペインで、[プリンシパルを追加] をクリックします。
[新しいプリンシパル] フィールドに、1 つ以上のプリンシパルを入力します。
[ロールを選択] リストをクリックします。
[ロール] リストで、次のいずれかのロールを選択します。
- Gemini Data Analytics Data Agent User(
roles/geminidataanalytics.dataAgentUser): データ エージェントとチャットする権限を付与します。 - Gemini データ分析データ エージェント編集者(
roles/geminidataanalytics.dataAgentEditor): データ エージェントを編集する権限を付与します。 - Gemini データ分析 Data Agent Viewer(
roles/geminidataanalytics.dataAgentViewer): データ エージェントを表示する権限を付与します。
- Gemini Data Analytics Data Agent User(
[保存] をクリックします。
エージェントの編集ページに戻るには、[閉じる] をクリックします。
[エージェント] ペインに戻るには、 [戻る] をクリックします。
データ エージェントを削除する
BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
[エージェント カタログ] タブの [自分のエージェント] セクションまたは [自分の下書きエージェント] セクションで、削除するデータ エージェントのエージェント カードを見つけます。
[アクションを開く] > [削除] をクリックします。
[エージェントを削除しますか?] ダイアログで、[削除] をクリックします。
データポータルでデータ エージェントを公開する
エージェントを公開してデータポータル ユーザーと共有すると、データポータルの [データとチャット] ページにエージェントが自動的に表示され、ユーザーがチャットできるようになります。
エージェントを作成してデータポータルに公開する
データ アナリストは、次の手順でエージェントを作成、編集、公開して、データポータルに接続できます。
- BigQuery でデータ エージェントを作成または編集します。
- エージェントを公開します。エージェントを公開するときに、公開オプションとして [データポータル] を選択します。
- 手順に沿ってエージェントを共有し、データポータル ユーザーに適切な Identity and Access Management ロールを付与します。
データポータル ユーザーとエージェントを共有する
データポータルでエージェントとの会話を開くリンクをコピーして、データポータル ユーザーとエージェントを直接共有できます。また、ユーザーがエージェントにアクセスできることを知らせるメールを送信することもできます。
エージェントへの直接リンクを共有するには、次の方法でエージェントの専用 URL をコピーします。
- エージェント カタログから: [アクションを開く] > [リンクをコピー] > [データポータル] を選択します。
- エージェントの詳細ビューから: [Copy agent link] > [データポータル] を選択します。
- [共有] オーバーフロー メニューから、[データポータルのエージェントへのリンクをコピー] を選択します。
- [共有権限] パネルで [保存] をクリックしたら、[リンクをコピー] を選択します。
エージェントへのアクセス権を付与したことを受信者に通知するメール通知を送信するには、[権限を共有] パネルで [メールを送信] を選択します。メール通知は、その編集セッションでエージェントを共有したユーザーまたはグループにのみ送信されます。グループのすべてのメンバーにメール通知が届きます。特定のユーザーがエージェントに対してエージェント レベルの権限をすでに持っている場合でも同様です。メールには、エージェントを共有したユーザーの名前、エージェントの名前、データポータルでエージェントを開くためのリンクが含まれています。
Gemini Enterprise でデータ エージェントを公開する
Gemini Enterprise で BigQuery データ エージェントを公開すると、ビジネス ユーザーは Gemini Enterprise 内で自然言語を使用してデータを直接クエリして分析できます。このプロセスには通常、データ アナリスト、Gemini Enterprise 管理者、ビジネス ユーザー間のコラボレーションが含まれます。これらのユーザーに必要なロールの詳細については、必要なロールをご覧ください。
Gemini Enterprise でデータ エージェントを公開する手順は次のとおりです。
- 前提条件とリージョン マッピングを確認します。
- BigQuery でデータ エージェントを作成して公開します。
- Gemini Enterprise で Agent Gateway を構成します。
- Gemini Enterprise でエージェントをプロビジョニングします。
- エージェントを見つけてチャットします。
始める前に
データ エージェントを公開する前に、プロジェクトの設定とリージョンに基づいて要件を確認してください。
BigQuery データ エージェントと Gemini Enterprise アプリケーションが同じ Google Cloudプロジェクトにあるかどうかによって、データ エージェントを公開するワークフローは 2 つあります。
- BigQuery と Gemini Enterprise が同じ Google Cloud プロジェクトにある場合は、公開時にエージェントを Agent Registry に登録し、Google マネージド認証情報を使用してエージェントを Gemini Enterprise にインポートできます。JSON データをコピーしたり、OAuth クライアント認証情報を手動で構成したりする必要はありません。
- BigQuery と Gemini Enterprise が異なる Google Cloud プロジェクトにある場合は、BigQuery から Agent-to-Agent(A2A)JSON カードをコピーして、Gemini Enterprise に貼り付ける必要があります。ただし、[デフォルトの Google 管理の認証情報] を選択することはできるため、OAuth クライアント ID とクライアント シークレットを作成または入力する必要はありません。
Agent Registry を使用する場合、Gemini Enterprise の BigQuery データ エージェントのストレージ リージョンと Agent Gateway レジストリ バインディングは一致している必要があります。
エージェントのストレージ リージョンは、BigQuery ウェブ UI のエージェント エディタの [リージョン] セクションで構成します。エージェントを保存した後は、リージョンを変更できません。
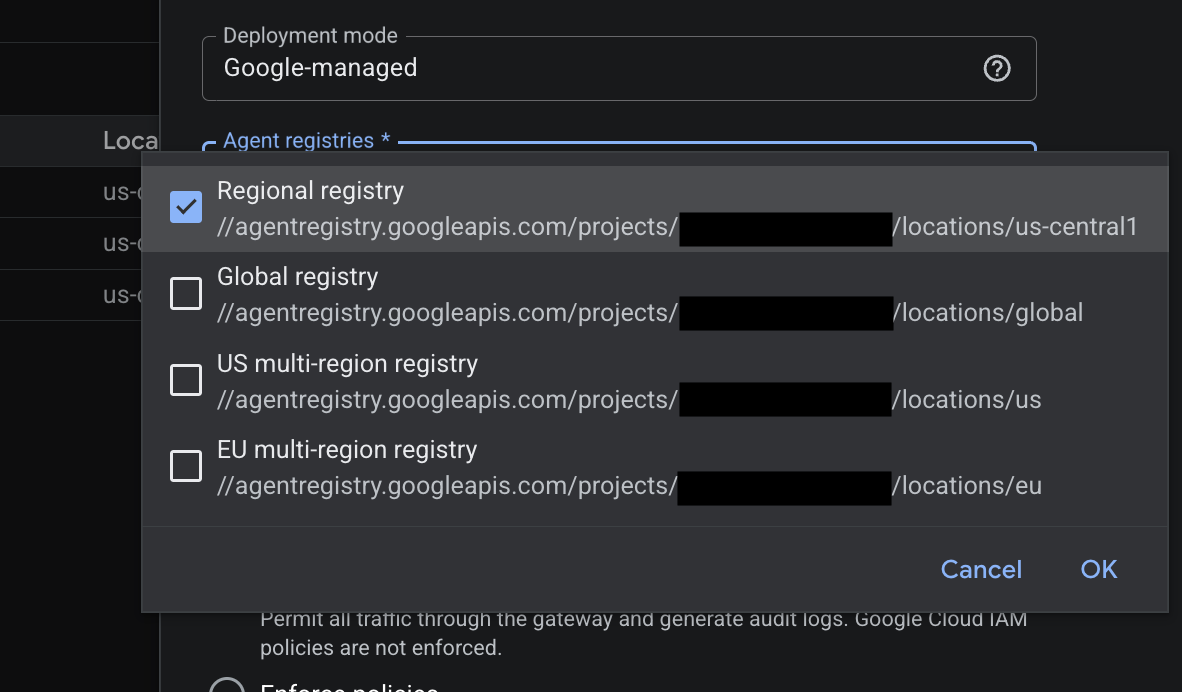
次の図は、Agent Gateway で使用可能なリージョン オプションを示しています。
BigQuery でデータ エージェントを作成して公開する
データアナリストは、次の手順で BigQuery でエージェントを作成、構成、公開します。
- BigQuery で、データ エージェントを作成または編集します。
- [リージョン] セクションで、ストレージ リージョンがデータソースと Agent Gateway の構成と一致していることを確認します。オプションには、US、EU、Global があります。
- [公開] をクリックします。エージェントが以前に公開されている場合は、[更新を公開] をクリックします。
- [チャンネルの公開] ペインの [その他のチャンネル] で、公開方法を選択します。
- BigQuery と Gemini Enterprise が同じプロジェクトにある場合は、[Agent Registry] セクションで、[このエージェントを登録する] チェックボックスをオンにします。
- エージェントをレジストリから削除する場合は、[登録解除] をクリックします。
- BigQuery と Gemini Enterprise が異なるプロジェクトにある場合は、[A2A(Agent2Agent)経由で統合] セクションで [JSON をコピー] をクリックして A2A エンドポイントの JSON データをコピーし、Gemini Enterprise 管理者と共有します。
- BigQuery と Gemini Enterprise が同じプロジェクトにある場合は、[Agent Registry] セクションで、[このエージェントを登録する] チェックボックスをオンにします。
- [公開] または [更新を公開] をクリックします。
- アクセスが必要なユーザーとグループとエージェントを共有し、Gemini データ分析データ エージェント ユーザー(
roles/geminidataanalytics.dataAgentUser)のロールを付与します。
Gemini Enterprise で Agent Gateway を構成する
Gemini Enterprise 管理者が Agent Registry からエージェントをインポートする場合は、次の手順に沿って Gemini Enterprise アプリケーションの Agent Gateway を構成する必要があります。
- データ エージェントのリージョンと一致する Agent Registry バインディングを含む Agent Gateway を設定します。オプションには、[US]、[EU]、[Global] があります。
- Gemini Enterprise でアプリケーションを開き、[セキュリティ] > [構成] に移動して、[Agent Gateway 構成] セクションにゲートウェイ リソース名を入力します。詳細な手順については、Agent Gateway を介して Gemini Enterprise トラフィックを転送するをご覧ください。
Gemini Enterprise でエージェントをプロビジョニングする
Gemini Enterprise 管理者は、次のいずれかの方法で、アプリケーションのユーザーがデータ エージェントを利用できるようにします。
オプション 1: Agent Registry からインポートする
BigQuery と Gemini Enterprise が同じプロジェクトにある場合は、次の手順で登録済みエージェントをインポートします。
- Gemini Enterprise で、エージェントを追加するアプリの名前をクリックします。
- ナビゲーション メニューで、[エージェント] > [エージェントを追加] をクリックします。
- [エージェント タイプの選択] ペインで、[Agent Registry のエージェント] を見つけて [追加] をクリックします。
- [エージェントを追加] ペインで、名前、Agent Registry ID、タイプ、プロデューサー、ユースケースでエージェントを検索するか、リストでエージェント カードを見つけます。
- エージェント カードで [エージェントを追加] をクリックします。
- [エージェントの詳細を確認] ステップで、名前、説明、エージェント URL、機能、スキルなど、エージェントの A2A カードから入力されたエージェントのメタデータを確認し、[次へ] をクリックします。
- [エージェントを認証する] ステップで、Gemini Enterprise がエージェント プロバイダに対して認証を行う方法を選択します。
- Google が管理するデフォルトの認証情報: Google が OAuth 認証情報を自動的に管理します。クライアント認証情報を手動で構成したり入力したりする必要はありません。
- カスタム OAuth: 組織でカスタム OAuth クライアント認証情報が必要な場合にのみ、このオプションを選択し、クライアント ID、クライアント シークレット、認証 URL、トークン URL を入力します。
- [完了] をクリックします。
- エージェントが [エージェント テーブル] に表示され、状態が [有効]、エージェント タイプが [A2A(カスタム)] になります。
- アクセス権が必要なユーザーまたはグループとエージェントを共有します。
オプション 2: A2A カードの JSON を使用してインポートする
BigQuery と Gemini Enterprise が異なるプロジェクトにある場合は、次の手順で A2A カードの JSON を使用してエージェントをインポートします。
- Gemini Enterprise で、エージェントを追加するアプリの名前をクリックします。
- ナビゲーション メニューで、[エージェント] > [エージェントを追加] をクリックします。
- [エージェント タイプの選択] ペインで、[A2A によるカスタム エージェント] を見つけて [追加] をクリックします。
- [エージェント カードの JSON] フィールドに、データ アナリストから受け取ったエージェント カードの JSON を入力します。
- [エージェントの詳細をプレビュー] > [次へ] をクリックします。
- [エージェントの承認] ステップで、認証方法を選択します。
- デフォルトの Google 管理認証情報: Google は、クライアント ID とクライアント シークレットを手動で入力または生成することなく、OAuth 認証情報を自動的に管理します。
- カスタム OAuth: A2A エージェントを登録して管理するの手順に沿って、カスタム OAuth 認証情報を手動で指定する場合は、このオプションを選択します。
- [ツールの承認] ステップで、[完了] をクリックします。
- エージェントが [エージェント テーブル] に表示され、状態が [有効]、エージェント タイプが [A2A(カスタム)] になります。
- アクセス権が必要なユーザーまたはグループとエージェントを共有します。
エージェントを見つけて使用する
Gemini Enterprise でデータ エージェントを検出して使用するには、次のいずれかの方法を使用します。
- 手動検出: Agent Gallery でデータ エージェントを見つけて、次のいずれかの方法で使用します。
- ギャラリーを閲覧する: エージェントを選択して、専用のチャットを開始します。
- 直接リンク: エージェントの専用 URL を使用して、特定の BigQuery データ エージェントとのセッションで Gemini Enterprise を直接開きます。
- Directed intent: Gemini Enterprise のコアチャットで
@mention(@sales_pipeline_agentなど)を使用してエージェントを呼び出します。 - シームレスなオーケストレーション: 一般的な分析に関する質問(「過去 3 か月間のセールス パイプラインの傾向はどうですか?」など)をすると、Gemini Enterprise はクエリを関連するデータ エージェントに自動的に転送します。
エージェントを検出したら、次の手順でエージェントとやり取りできます。
- 認証: 1 回限りの OAuth ログインを完了して、BigQuery に対して安全に認証します。
- チャット: エージェントに自然言語で質問します。リクエストはエージェントによって処理され、レスポンスはテキスト、マークダウン、グラフ、テーブルとして Gemini Enterprise にストリーミングされます。
- 会話の履歴を表示する: 会話は履歴ペインに自動的に保存されます。
エージェントと会話をモニタリングする
BigQuery で Google Cloud Observability を使用すると、データ エージェントとその会話のパフォーマンス、導入、レイテンシ、費用をモニタリングできます。エージェントのオブザーバビリティを有効にすると、次のような指標を表示できます。
- 会話で使用されたエージェントの数
- 質問したユーザーの数
- 作成された会話の数
- 最も多くの質問に回答したエージェント
- 最もよく使用されるナレッジソース
- ユーザー エンゲージメント
- 予測トークン使用量
- 1 時間あたりの回答レイテンシ
始める前に
Cloud Trace、Cloud Monitoring、Cloud Logging の各 API が有効になっていない場合は、有効にします。
API を有効にするために必要なロール
API を有効にするには、serviceusage.services.enable 権限が必要です。プロジェクトを作成した場合は、オーナーロール(roles/owner)を通じてこの権限がすでに付与されている可能性があります。それ以外の場合は、Service Usage 管理者ロール(roles/serviceusage.serviceUsageAdmin)を通じてこの権限を取得できます。ロールを付与する方法を確認する。
必要なロールと権限
エージェントのオブザーバビリティを有効にするには、プロジェクトに対する次の権限が必要です。
cloudaicompanion.gibqObservabilitySettings.createcloudaicompanion.gibqObservabilitySettings.listcloudaicompanion.gibqObservabilitySettings.updategeminidataanalytics.dataAgents.creategeminidataanalytics.operations.getobservability.traceScopes.createresourcemanager.projects.updateserviceusage.services.enableserviceusage.values.test
指標、トレース、ログを使用してエージェントをモニタリングするために必要な権限を取得するには、プロジェクトに対する次の IAM ロールを付与するよう管理者に依頼してください。
-
モニタリング データと構成を表示する: モニタリング閲覧者 (
roles/monitoring.viewer) -
トレースを表示する: Cloud Trace ユーザー (
roles/cloudtrace.user) -
ログを表示する: ログビューア (
roles/logging.viewer) -
データセットとそのコンテンツを表示する: BigQuery データ閲覧者 (
roles/bigquery.dataViewer) -
管理者設定を表示する: Gemini for Google Cloud ユーザー (
roles/cloudaicompanion.user)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
必要な権限は、カスタムロールや他の事前定義ロールから取得することもできます。
オブザーバビリティを有効にする
エージェントのオブザーバビリティはデフォルトで無効になっています。管理者は、プロジェクトまたは組織でこの機能を有効にできます。エージェントのオブザーバビリティを有効にするには、次のいずれかのオプションを選択します。
コンソール
Google Cloud コンソールで、BigQuery の [エージェント] ページに移動します。
[モニタリング] タブを選択します。
オブザーバビリティが無効になっている場合は、プロンプトに沿って有効にします。
Google Cloud CLI
オブザーバビリティ設定を作成します。
gcloud gemini gibq-observability-settings create SETTING_NAME \
  --conversational-analytics-setting-metrics-enabled \
  --conversational-analytics-setting-traces-enabled \
  --project=PROJECT_ID \
  --location=global
次のように置き換えます。
SETTING_NAME: オブザーバビリティ設定の名前。PROJECT_ID: プロジェクト ID。
オブザーバビリティ設定をプロジェクトにバインドします。
gcloud gemini gibq-observability-settings setting-bindings create BINDING_NAME \
  --gibq-observability-setting=SETTING_NAME \
  --target=projects/PROJECT_ID \
  --location=global \
  --project=PROJECT_ID
BINDING_NAMEは、設定バインディングの名前に置き換えます。バインディング名にはbinding-PROJECT_IDを使用することをおすすめします。
API
オブザーバビリティ設定を作成します。
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d '{
          "conversational_analytics_setting": {
            "metrics_enabled": true
          }
        }' \
    "https://cloudaicompanion.googleapis.com/v1/projects/PROJECT_ID/locations/global/gibqObservabilitySettings?gibq_observability_setting_id=SETTING_NAME"
次のように置き換えます。
SETTING_NAME: オブザーバビリティ設定の名前。PROJECT_ID: プロジェクト ID。
オブザーバビリティ設定をプロジェクトにバインドします。
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d '{
          "target": "projects/PROJECT_ID",
          "product": "GEMINI_IN_BIGQUERY"
        }' \
    "https://cloudaicompanion.googleapis.com/v1/projects/PROJECT_ID/locations/global/gibqObservabilitySettings/SETTING_NAME/settingBindings?setting_binding_id=BINDING_NAME"
BINDING_NAMEは、設定バインディングの名前に置き換えます。バインディング名にはbinding-PROJECT_IDを使用することをおすすめします。
指標を表示
指標は、オブザーバビリティを有効にした後に収集されます。データはバックフィルされません。エージェントの指標を表示するには、次のいずれかのオプションを選択します。
BigQuery
Google Cloud コンソールで、BigQuery の [エージェント] ページに移動します。
[モニタリング] タブを選択します。
Cloud Monitoring
Google Cloud コンソールで、Cloud Monitoring の [ダッシュボード] ページに移動します。
[マイ ダッシュボード] ペインで、
BigQuery Conversational Analyticsという名前のダッシュボードを検索します。ダッシュボードを開くには、ダッシュボードの名前をクリックします。
省略可: カスタム ダッシュボードを作成します。
省略可: 指標を個別に表示するには、[Metrics Explorer] ページに移動します。
エージェント指標には、エージェントの使用状況、モデル呼び出し、ツールの使用状況、健全性、レイテンシ、トークンの使用状況が含まれます。
モデルの呼び出しをデバッグする
会話ターンの操作シーケンス(モデル呼び出しやツール呼び出しなど)を可視化して、エラーやレイテンシのトラブルシューティングに役立てることができます。
Google Cloud コンソールで、Cloud Monitoring の [Trace エクスプローラ] ページに移動します。
調べるスパンをクリックします。
[詳細] ペインの情報を確認します。
省略可: カスタム トレース ダッシュボードを作成します。
トレースを保持する
Cloud Trace データは、オブザーバビリティ データセットに 30 日間保存されます。トレースデータを長期間保存するには、トレースデータを BigQuery データセットに移動します。
必要なロール
リンクされたデータセットを作成してライブ トレースを BigQuery に公開するために必要な権限を取得するには、プロジェクトに対する次の IAM ロールを付与するよう管理者に依頼してください。
- Cloud Trace 管理者 (
roles/cloudtrace.admin) - オブザーバビリティ編集者 (
roles/observability.editor) - BigQuery ユーザー(
roles/bigquery.user)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
必要な権限は、カスタムロールや他の事前定義ロールから取得することもできます。
トレースデータを BigQuery に移動する
トレースデータを保持するには、次の操作を行います。
Cloud Shell を開きます。
_Traceバケットのロケーションを確認します。gcloud beta observability buckets list --location=-
次のステップで使用するため、
_Traceバケットの場所をメモしておきます。_Traceバケットを指すリンクされたデータセットを BigQuery プロジェクトに作成します。gcloud beta observability buckets datasets links create \ projects/PROJECT_ID/locations/LOCATION/buckets/_Trace/datasets/Spans/links/LINK_NAME \ --dataset=Spans \ --bucket=_Trace \ --location=LOCATION \ --project=PROJECT_ID
次のように置き換えます。
PROJECT_ID: プロジェクト IDLOCATION: 前のステップの_TraceバケットのロケーションLINK_NAME: リンクされたデータセットの名前
履歴トレースを保存する標準データセットを作成します。次のコマンドは、デフォルトのパーティション有効期限を 90 日(7,776,000 秒)に設定します。
bq --location=LOCATION mk \
    --dataset \
    --default_partition_expiration=7776000 \
    --description="Archive storage for historical traces" \
    PROJECT_ID:STORAGE_DATASET
STORAGE_DATASETは、データセットの名前に置き換えます。リンクされたデータセットと同じスキーマで、ストレージ データセットに空のパーティション分割テーブルを作成します。日付でパーティショニングすると、データ保持とクエリ費用を管理できます。テーブルを作成するには、SQL エディタで次のクエリを実行します。
CREATE TABLE `PROJECT_ID.STORAGE_DATASET.TABLE_NAME`
PARTITION BY DATE(start_time)
AS
SELECT *
FROM `PROJECT_ID.LINK_NAME._AllSpans`
WHERE FALSE;
TABLE_NAMEは、テーブルの名前に置き換えます。スケジュール設定されたクエリを作成して、リンクされたデータセットからアーカイブ テーブルに毎日のトレースデータをコピーします。次のクエリは、前日のデータをコピーします。
INSERT INTO `PROJECT_ID.STORAGE_DATASET.TABLE_NAME`
SELECT *
FROM `PROJECT_ID.LINK_NAME._AllSpans`
WHERE start_time >=
  TIMESTAMP_SUB(TIMESTAMP_TRUNC(CURRENT_TIMESTAMP(), DAY), INTERVAL 1 DAY)
  AND start_time < TIMESTAMP_TRUNC(CURRENT_TIMESTAMP(), DAY);
詳細については、トレースを検索して調査するをご覧ください。
オブザーバビリティをオフにする
データ エージェントのオブザーバビリティをオフにするには、オブザーバビリティ設定を更新します。
gcloud gemini gibq-observability-settings update SETTING_NAME \
    --no-conversational-analytics-setting-metrics-enabled \
    --no-conversational-analytics-setting-traces-enabled \
    --project=PROJECT_ID \
    --location=global
次のように置き換えます。
SETTING_NAME: 可観測性を有効にするために作成した可観測性設定の名前。 Google Cloud コンソールを使用してオブザーバビリティを有効にした場合、設定名はdefaultです。PROJECT_ID: プロジェクト ID。
次のステップ
- BigQuery の会話型分析について詳細を確認する。
- Conversational Analytics API について詳細を確認する。
- 会話でデータを分析する。
- Gemini データ分析データ エージェント閲覧者(
roles/geminidataanalytics.dataAgentViewer)ロールでデータ エージェントを表示する権限が付与される仕組みについて確認する。