


Introduzione al mascheramento dei dati
BigQuery supporta il mascheramento dei dati a livello di colonna. Puoi utilizzare il mascheramento dei dati per oscurare selettivamente i dati della colonna per gruppi di utenti, consentendo loro comunque di accedere alla colonna. La funzionalità di mascheramento dei dati si basa sul controllo dell'accesso a livello di colonna, quindi dovresti acquisire familiarità con questa funzionalità prima di procedere.
Quando utilizzi il mascheramento dei dati in combinazione con controllo dell'accesso a livello di colonna, puoi configurare un intervallo di accesso ai dati delle colonne, dall'accesso completo a nessun accesso, in base alle esigenze di diversi gruppi di utenti. Ad esempio, per i dati ID fiscale, potresti voler concedere l'accesso completo al gruppo di contabilità, l'accesso mascherato al gruppo di analisti e nessun accesso al gruppo di vendita.
Questo documento descrive l'utilizzo dei tag di policy per il mascheramento dei dati. In alternativa, puoi utilizzare i tag di governance dei dati, che sono tag Resource Manager utilizzati per la mascheratura dei dati e il controllo dell'accesso a livello di colonna.
Vantaggi
Il mascheramento dei dati offre i seguenti vantaggi:
- Semplifica il processo di condivisione dei dati. Puoi mascherare le colonne sensibili per consentire la condivisione delle tabelle con gruppi più ampi.
- A differenza del controllo dell'accesso a livello di colonna, non devi modificare le query esistenti escludendo le colonne a cui l'utente non può accedere. Quando configuri il mascheramento dei dati, le query esistenti mascherano automaticamente i dati delle colonne in base ai ruoli concessi all'utente.
- Puoi applicare criteri di accesso ai dati su larga scala. Puoi scrivere una policy dei dati, associarla a un tag di criteri e applicare il tag di criteri a un numero qualsiasi di colonne.
- Consente il controllo dell'accesso basato su attributi. Un tag di criteri collegato a una colonna fornisce l'accesso ai dati contestuali, determinato dalla policy dei dati e dalle entità associate al tag di criteri.
Workflow di mascheramento dei dati
Per mascherare i dati, puoi creare una tassonomia e tag di policy, quindi configurare i criteri dei dati sui tag di policy. In alternativa, puoi eseguire una delle seguenti operazioni:
- Imposta una policy dei dati direttamente su una colonna. Mappa una regola di mascheramento dei dati ai tuoi dati senza gestire i tag di policy o creare tassonomie aggiuntive.
- Utilizza i tag di governance dei dati. Utilizza i tag di governance dei dati (anteprima) per controllo dell'accesso e il mascheramento dei dati a livello di colonna.
Impostare una policy dei dati direttamente su una colonna
Puoi configurare il mascheramento dinamico dei dati direttamente su una colonna. Per farlo, segui questi passaggi:
Assegna una policy dei dati a una colonna.
Maschera i dati con i tag di policy
La figura 1 mostra il flusso di lavoro per la configurazione della maschera dei dati:
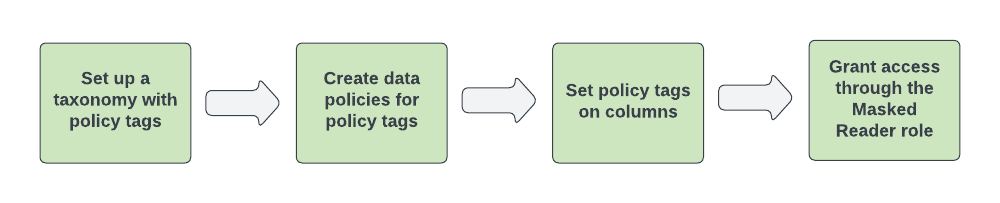 Figura 1. Componenti del mascheramento dei dati.
Per configurare l'oscuramento dei dati, segui questi passaggi:
- Configura una tassonomia e uno o più tag di policy.
Configura le policy dei dati per i tag di policy. Un criterio per i dati mappa una regola di mascheramento dei dati e uno o più principal, che rappresentano utenti o gruppi, al tag di criteri.
Quando crei una norma sui dati utilizzando la console Google Cloud , crei la regola di mascheramento dei dati e specifichi i principal in un unico passaggio. Quando crei una policy dei dati utilizzando l'API BigQuery Data Policy, crei la policy dei dati e la regola di mascheramento dei dati in un unico passaggio e specifichi le entità per la policy dei dati in un secondo passaggio.
Assegna i tag di policy alle colonne delle tabelle BigQuery per applicare le policy dei dati.
Assegna gli utenti che devono avere accesso ai dati mascherati al ruolo BigQuery Masked Reader. Come best practice, assegna il ruolo BigQuery Masked Reader a livello di policy dei dati. L'assegnazione del ruolo a livello di progetto o superiore concede agli utenti le autorizzazioni per tutte le policy relative ai dati del progetto, il che può causare problemi dovuti a un numero eccessivo di autorizzazioni.
Il tag di criteri associato a una policy dei dati può essere utilizzato anche per controllo dell'accesso a livello di colonna. In questo caso, il tag di criteri è associato anche a una o più entità a cui è stato concesso il ruolo Lettore granulare di Data Catalog. In questo modo, questi principal possono accedere ai dati delle colonne originali non mascherati.
La Figura 2 mostra come funzionano insieme il controllo dell'accesso a livello di colonna e il mascheramento dei dati:
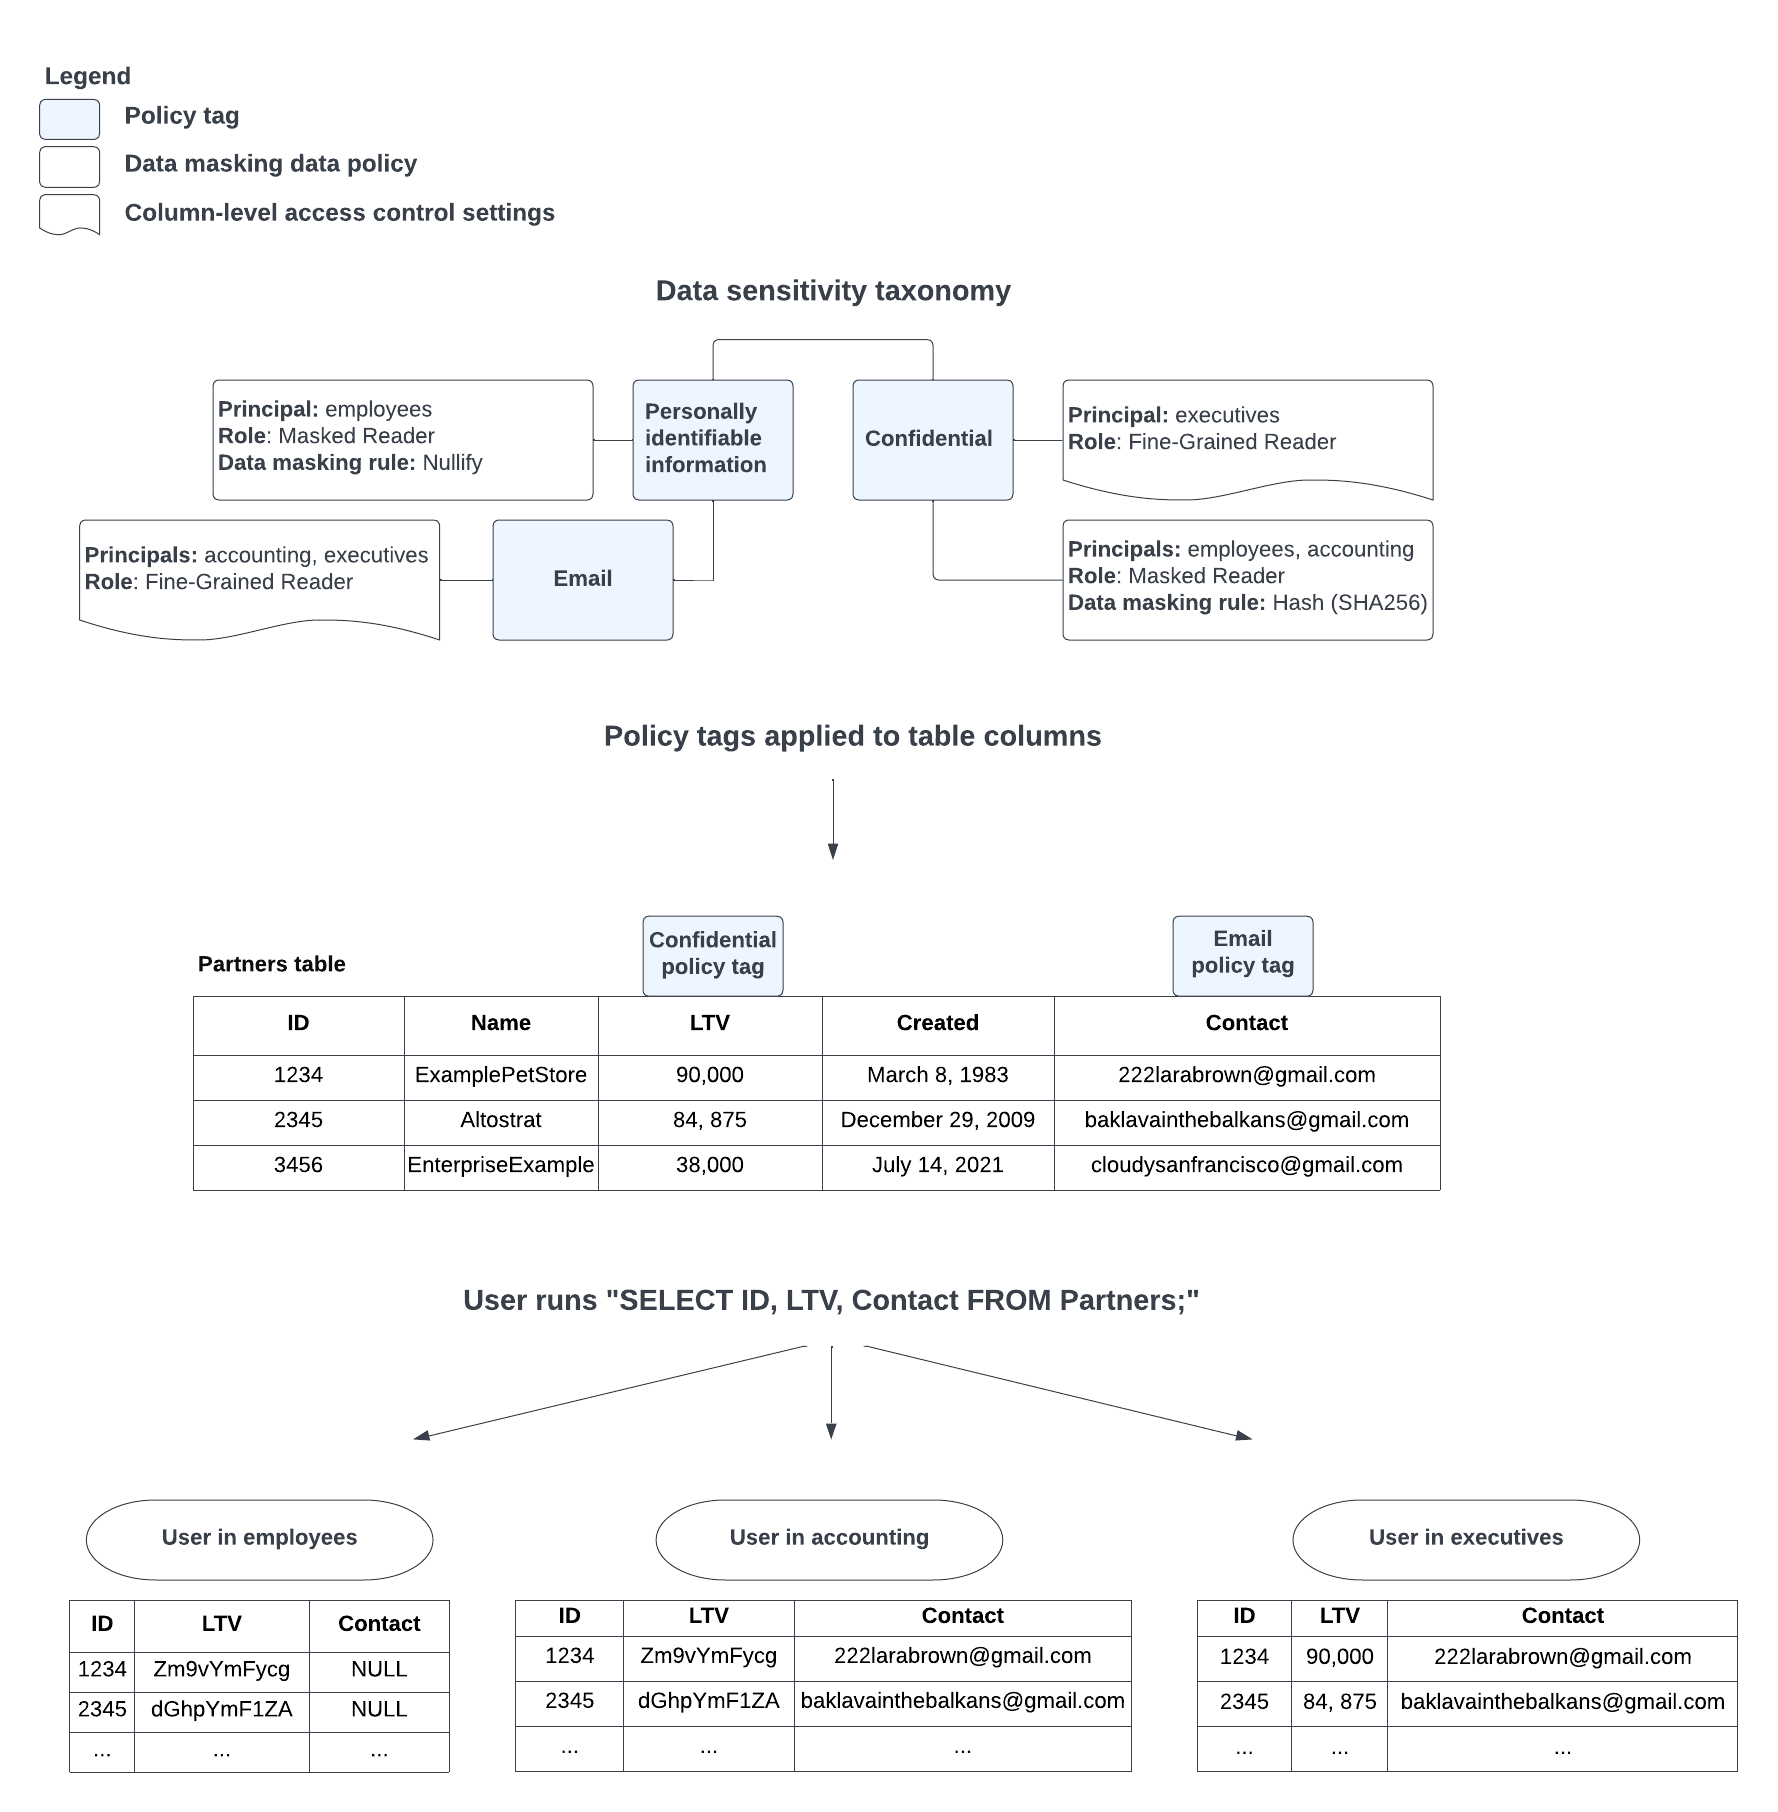 Figura 2. Componenti di mascheramento dei dati.
Per saperne di più sull'interazione tra i ruoli, consulta Come interagiscono i ruoli Lettore mascherato e Lettore granulare. Per saperne di più sull'ereditarietà dei tag di criteri, consulta Ruoli e gerarchia dei tag di criteri policy.
Regole di mascheramento dei dati
Quando utilizzi il mascheramento dei dati, una regola di mascheramento dei dati viene applicata a una colonna in fase di esecuzione della query, in base al ruolo dell'utente che esegue la query. La maschera ha la precedenza su qualsiasi altra operazione coinvolta nella query. La regola di mascheramento dei dati determina il tipo di mascheramento dei dati applicato ai dati della colonna.
Puoi utilizzare le seguenti regole di mascheramento dei dati:
Routine di mascheramento personalizzata. Restituisce il valore della colonna dopo aver applicato una funzione definita dall'utente (UDF) alla colonna. Per gestire la regola di mascheramento sono necessarie le autorizzazioni di routine. Questa regola, per progettazione, supporta tutti i tipi di dati BigQuery, ad eccezione del tipo di dati
STRUCT. Tuttavia, il supporto per i tipi di dati diversi daSTRINGeBYTESè limitato. L'output dipende dalla funzione definita.Per saperne di più sulla creazione di UDF per routine di mascheramento personalizzate, consulta Creare routine di mascheramento personalizzate.
Maschera data anno. Restituisce il valore della colonna dopo averlo troncato all'anno, impostando tutte le parti del valore diverse dall'anno all'inizio dell'anno. Puoi utilizzare questa regola solo con le colonne che utilizzano i tipi di dati
DATE,DATETIMEeTIMESTAMP. Ad esempio:Tipo Originale Mascherato DATE2030-07-17 2030-01-01 DATETIME2030-07-17T01:45:06 2030-01-01T00:00:00 TIMESTAMP2030-07-17 01:45:06 2030-01-01 00:00:00 Valore di mascheramento predefinito. Restituisce un valore di mascheramento predefinito per la colonna in base al tipo di dati della colonna. Utilizza questa opzione se vuoi nascondere il valore della colonna, ma mostrare il tipo di dati. Quando questa regola di mascheramento dei dati viene applicata a una colonna, la rende meno utile nelle operazioni di query
JOINper gli utenti con accesso di lettura mascherata. Questo perché un valore predefinito non è sufficientemente univoco da essere utile quando si uniscono le tabelle.La tabella seguente mostra il valore di mascheramento predefinito per ogni tipo di dati:
Tipo di dati Valore di mascheramento predefinito STRING"" BYTESb'' INTEGER0 FLOAT0.0 NUMERIC0 BOOLEANFALSETIMESTAMP1970-01-01 00:00:00 UTC DATE1970-01-01 TIME00:00:00 DATETIME1970-01-01T00:00:00 GEOGRAPHYPOINT(0 0) BIGNUMERIC0 ARRAY[] STRUCTNOT_APPLICABLE
I tag di policy non possono essere applicati alle colonne che utilizzano il tipo di dati
STRUCT, ma possono essere associati ai campi foglia di queste colonne.JSONnull Maschera email. Restituisce il valore della colonna dopo aver sostituito il nome utente di un'email valida con
XXXXX. Se il valore della colonna non è un indirizzo email valido, restituisce il valore della colonna dopo che è stato eseguito tramite la funzione hash SHA-256. Puoi utilizzare questa regola solo con le colonne che utilizzano il tipo di datiSTRING. Ad esempio:Originale Mascherato abc123@gmail.comXXXXX@gmail.comrandomtextjQHDyQuj7vJcveEe59ygb3Zcvj0B5FJINBzgM6Bypgw=test@gmail@gmail.comQdje6MO+GLwI0u+KyRyAICDjHbLF1ImxRqaW08tY52k=Primi quattro caratteri. Restituisce i primi 4 caratteri del valore della colonna, sostituendo il resto della stringa con
XXXXX. Se il valore della colonna è pari o inferiore a 4 caratteri, restituisce il valore della colonna dopo che è stato eseguito tramite la funzione hash SHA-256. Puoi utilizzare questa regola solo con le colonne che utilizzano il tipo di datiSTRING.Hash (SHA-256). Restituisce il valore della colonna dopo che è stato eseguito tramite la funzione hash SHA-256. Utilizza questa opzione quando vuoi che l'utente finale possa utilizzare questa colonna in un'operazione
JOINper una query. Puoi utilizzare questa regola solo con le colonne che utilizzano i tipi di datiSTRINGoBYTES.La funzione SHA-256 utilizzata nel mascheramento dei dati conserva il tipo, quindi il valore hash restituito ha lo stesso tipo di dati del valore della colonna. Ad esempio, il valore hash per un valore di colonna
STRINGha anche un tipo di datiSTRING.Hash casuale. Restituisce un hash del valore della colonna utilizzando un algoritmo di hash con sale. L'hash casuale offre una sicurezza maggiore rispetto alla regola
Hash
(SHA-256)
standard. Puoi utilizzare questa regola solo con le colonne che utilizzano i tipi di datiSTRINGoBYTES.- Non deterministica: viene generato un valore casuale univoco (salt) per ogni query. Lo stesso valore di colonna produce risultati di hashing diversi in query diverse. In questo modo, si evitano attacchi brute force e l'analisi dei pattern di dati mascherati nel tempo.
- Controllo di unione:
- I join sulle colonne mascherate con
RANDOM_HASHsono possibili solo all'interno della stessa query. - I join tra query diverse non sono possibili a causa del salt casuale per query.
- I join sono supportati solo se le norme sui dati applicate alle colonne appartengono allo stesso Google Cloud progetto. Ciò viene applicato includendo l'ID progetto delle norme sui dati nell'input hash.
- I join sulle colonne mascherate con
- Limitazioni:
- L'hash casuale è supportato solo con le policy dei dati impostate sulle colonne, non sui tag di policy.
Ultimi quattro caratteri. Restituisce gli ultimi 4 caratteri del valore della colonna, sostituendo il resto della stringa con
XXXXX. Se il valore della colonna è uguale o inferiore a 4 caratteri, restituisce il valore della colonna dopo che è stato eseguito tramite la funzione hash SHA-256. Puoi utilizzare questa regola solo con le colonne che utilizzano il tipo di datiSTRING.Nullify. Restituisce
NULLanziché il valore della colonna. Utilizza questa opzione se vuoi nascondere sia il valore sia il tipo di dati della colonna. Quando questa regola di mascheramento dei dati viene applicata a una colonna, la rende meno utile nelle operazioni di queryJOINper gli utenti con accesso Lettore mascherato. Questo perché un valoreNULLnon è sufficientemente univoco da essere utile per unire le tabelle.
Confronto delle regole di mascheramento dei dati
La seguente tabella confronta le diverse opzioni di mascheramento dei dati disponibili in BigQuery, considerando la loro capacità di essere utilizzate nei join e la loro relativa sicurezza:
- Unibilità:indica se i dati mascherati possono essere utilizzati nelle operazioni SQL
JOIN. È possibile utilizzare metodi di mascheramento che producono un output coerente per un determinato input (deterministico per l'ambito dell'unione) e preservano un'unicità sufficiente. - Livello di sicurezza:indica il livello di protezione contro la deanonimizzazione o il reverse engineering dei dati originali. Questo è un confronto relativo.
| Opzione di mascheramento | Tipo | Possibilità di partecipazione | Livello di sicurezza |
|---|---|---|---|
| Annulla | Predefinito | No | Massimo:sostituisce i dati con NULL. Nessuna
perdita di informazioni sul valore originale. |
| Valore di mascheramento predefinito | Predefinito | No | Massimo:sostituisce i dati con un valore predefinito in base al tipo di dati. Nessuna fuga di informazioni sul valore originale. |
| Maschera email | Predefinito | No | Moderata:oscura il nome utente (ad esempio, user@example.com diventa XXXXX@example.com), ma il nome di dominio rimane visibile. Il dominio non mascherato può essere sensibile, in quanto rivela l'affiliazione all'organizzazione. Queste informazioni possono potenzialmente essere
utilizzate negli sforzi di deanomizzazione mediante la correlazione con altri dati. L'efficacia di questa maschera si riduce se il pool di potenziali individui all'interno del dominio è piccolo, il che rende più facile dedurre l'utente originale.
Se il valore non è un indirizzo email valido, viene sottoposto ad hashing utilizzando SHA-256
(Moderata:livello di sicurezza). |
| Primi quattro caratteri | Predefinito | No | Basso-moderato:restituisce i primi 4 caratteri,
sostituendo il resto con XXXXX. Se la stringa è composta da 4 caratteri o meno, viene sottoposta ad hashing utilizzando SHA-256. Quando si utilizza SHA-256 su queste stringhe brevi, la sicurezza è Molto bassa perché lo spazio di input limitato (1-4 caratteri) rende banale il calcolo di una tabella arcobaleno per tutti i possibili input, consentendo la ricerca inversa. |
| Ultimi quattro caratteri | Predefinito | No | Da basso a moderato: restituisce gli ultimi 4 caratteri,
anteponendo XXXXX per sostituire il resto. Se la stringa è composta da 4
caratteri o meno, viene sottoposta ad hashing utilizzando SHA-256. Analogamente a "Primi quattro caratteri", la sicurezza è Molto bassa quando SHA-256 viene utilizzato su stringhe brevi a causa della facilità delle ricerche inverse. |
| Maschera data anno | Predefinito | No | Moderata: mostra solo l'anno, troncando il resto della data (ad esempio, 2030-07-17 diventa 2030-01-01). Divulga informazioni parziali ed è vulnerabile all'analisi statistica. |
| Hash casuale | Predefinito | Sì (all'interno della stessa query) | Alto:utilizza un sale casuale segreto univoco generato dal servizio per l'esecuzione della query nel calcolo dell'hashing. Ciò offre una buona sicurezza contro gli attacchi alle tabelle precalcolate (ad esempio, le tabelle arcobaleno). L'output è coerente per lo stesso valore di input solo all'interno della stessa esecuzione della query. I join tra diverse esecuzioni di query non sono possibili a causa della modifica del sale per query. |
| Hash (SHA-256) | Predefinito | Sì | Moderato:sebbene SHA-256 offra una forte resistenza alle collisioni in senso crittografico, è suscettibile a vari attacchi in questo contesto di mascheramento. In quanto hash deterministico, è vulnerabile agli attacchi alla tabella arcobaleno, agli attacchi con testo non cifrato noto e all'analisi statistica. Qui sono possibili join tra diverse esecuzioni di query. |
| Routine di mascheramento personalizzata: SHA-256 | Personalizzato | Sì | Moderata:stesse proprietà di sicurezza di SHA-256 predefinita. Offre una forte resistenza alle collisioni, ma è vulnerabile ad attacchi di analisi statistica, di testo normale noto e di tabelle arcobaleno a causa della sua natura deterministica. |
| Routine di mascheramento personalizzata: SHA-256 con salt | Personalizzato | Sì | Alto (subordinato a una protezione corretta del sale): maggiore
sicurezza rispetto allo standard SHA-256 utilizzando un sale coerente e segreto
codificato nell'ambito della definizione della UDF personalizzata. La sicurezza dipende dalla segretezza del salt. L'accesso alla definizione della funzione definita dall'utente deve essere limitato.
La rimozione delle costanti dai dettagli di esecuzione di BigQuery aiuta a prevenire l'esposizione del salt. A differenza di RANDOM_HASH, il sale è
coerente tra le query che utilizzano questa funzione definita dall'utente specifica, supportando
i join tra le query. |
| Routine di mascheramento personalizzata: crittografia AEAD | Personalizzato | Sì | Alto (subordinato a una corretta gestione delle chiavi): può
fornire una sicurezza e una combinabilità elevate. Considerazione importante:per utilizzare la crittografia AEAD con un keyset con wrapping KMS, l'utente che esegue la query in genere ha bisogno dell'autorizzazione cloudkms.cryptoKeyVersions.useToDecryptViaDelegation
per la chiave KMS. Questa autorizzazione consente all'utente di utilizzare il keyset con wrapping per sia la crittografia che la decrittografia. Pertanto, il keyset con wrapping deve essere protetto. Se l'utente ha accesso alla chiave con wrapping, potrà decriptare (mostrare) i dati delle colonne sensibili. |
Collisioni hash e integrità dei join
Le tecniche di hashing, come SHA-256 e Random Hash, comportano un rischio teorico di
collisioni hash, in cui due
valori originali diversi producono lo stesso valore hash. Quando le colonne vengono mascherate
utilizzando queste regole e successivamente utilizzate in un'operazione JOIN, una collisione può
portare ad associazioni di dati improprie (corrispondenze false) nei risultati della query.
Tuttavia, la probabilità statistica di una collisione SHA-256 è praticamente trascurabile per qualsiasi set di dati reale. Gli utenti possono quindi fare affidamento sulle regole di mascheramento basate sull'hashing per l'integrità dei join con un'affidabilità estremamente elevata.
Gerarchia delle regole di mascheramento dei dati
Puoi configurare fino a nove policy dei dati per un tag di criteri, ciascuna con una regola di mascheramento dei dati diversa associata. Una di queste policy è riservata alle impostazioni di controllo dell'accesso a livello di colonna. In questo modo, è possibile applicare più policy sui dati a una colonna nella query di un utente, in base ai gruppi di cui l'utente è membro. In questo caso, BigQuery sceglie quale regola di mascheramento dei dati applicare in base alla seguente gerarchia:
- Routine di mascheramento personalizzata
- Hash casuale
- Hash (SHA-256)
- Maschera email
- Ultimi quattro caratteri
- Primi quattro caratteri
- Maschera data anno
- Valore di mascheramento predefinito
- Annulla
Ad esempio, l'utente A è membro dei gruppi Dipendenti e Contabilità. L'utente A esegue una query che include il campo sales_total, a cui è applicato il tag di criteri confidential. Il tag di criteri confidential ha due policy dei dati associate: una con il ruolo dei dipendenti come entità e applica la regola di mascheramento dei dati di annullamento e una con il ruolo di contabilità come entità e applica la regola di mascheramento dei dati hash (SHA-256). In questo caso, la regola di mascheramento dei dati hash (SHA-256) ha la priorità sulla regola di mascheramento dei dati di annullamento, pertanto la regola hash (SHA-256) viene applicata al valore del campo sales_total nella query dell'utente A.
La Figura 3 mostra questo scenario:
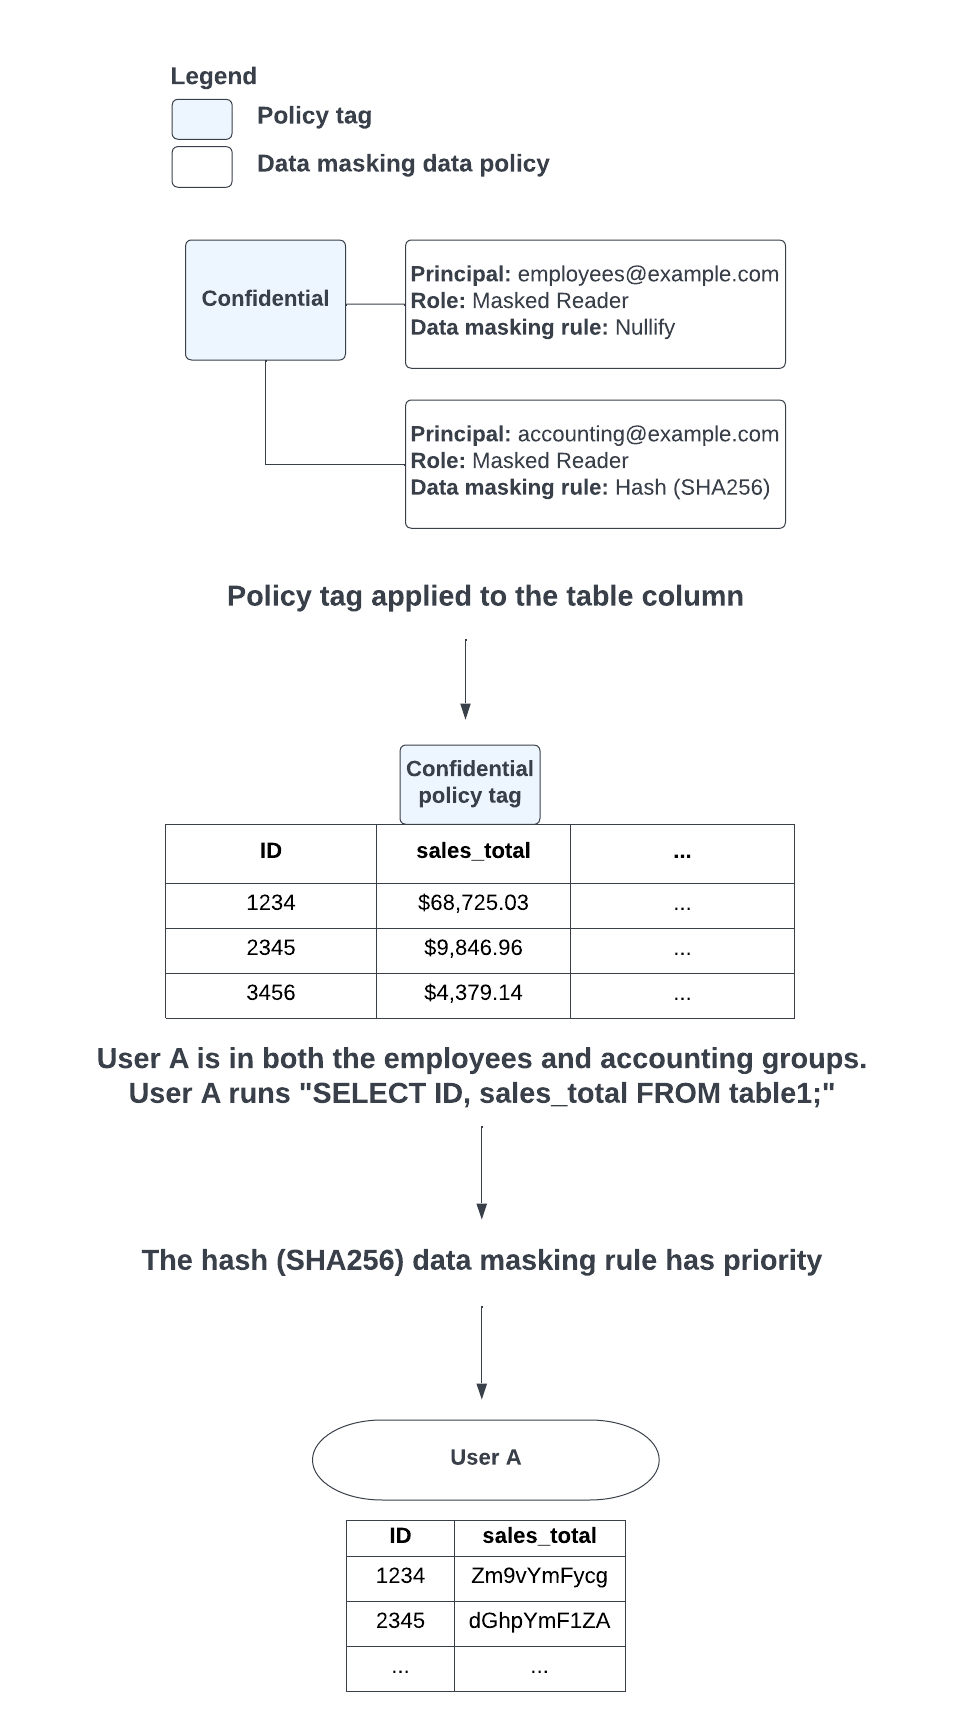
Figura 3. Assegnazione della priorità alle regole di mascheramento dei dati.
Ruoli e autorizzazioni
Ruoli per la gestione delle tassonomie e dei tag di policy
Per creare e gestire tassonomie e tag di policy, devi disporre del ruolo Amministratore tag di policy di Data Catalog.
| Ruolo/ID | Autorizzazioni | Descrizione |
|---|---|---|
Data Catalog Policy Tag Admin (datacatalog.categoryAdmin)
|
datacatalog.categories.getIamPolicydatacatalog.categories.setIamPolicydatacatalog.taxonomies.createdatacatalog.taxonomies.deletedatacatalog.taxonomies.getdatacatalog.taxonomies.getIamPolicydatacatalog.taxonomies.listdatacatalog.taxonomies.setIamPolicydatacatalog.taxonomies.updateresourcemanager.projects.getresourcemanager.projects.list
|
Si applica a livello di progetto. Questo ruolo concede la possibilità di:
|
Ruoli per la creazione e la gestione delle policy dei dati
Per creare e gestire le policy dei dati, devi disporre di uno dei seguenti ruoli BigQuery:
| Ruolo/ID | Autorizzazioni | Descrizione |
|---|---|---|
Amministratore delle norme sui dati BigQuery (bigquerydatapolicy.admin) Amministratore BigQuery ( bigquery.admin) Proprietario dei dati BigQuery ( bigquery.dataOwner)
|
bigquery.dataPolicies.createbigquery.dataPolicies.deletebigquery.dataPolicies.getbigquery.dataPolicies.getIamPolicybigquery.dataPolicies.listbigquery.dataPolicies.setIamPolicybigquery.dataPolicies.update
|
Le autorizzazioni Questo ruolo concede la possibilità di:
|
datacatalog.taxonomies.get, che puoi ottenere da diversi ruoli predefiniti di Data Catalog.
Ruoli per collegare i tag di policy alle colonne
Devi disporre delle autorizzazioni datacatalog.taxonomies.get e bigquery.tables.setCategory per collegare i tag di policy alle colonne.
datacatalog.taxonomies.get è incluso nei ruoli
Amministratore e Visualizzatore dei tag di policy di Data Catalog.
bigquery.tables.setCategory è incluso nei ruoli Amministratore BigQuery (roles/bigquery.admin) e Proprietario dati BigQuery (roles/bigquery.dataOwner).
Ruoli per l'esecuzione di query sui dati mascherati
Per eseguire query sui dati di una colonna a cui è applicato il mascheramento dei dati, devi disporre del ruolo BigQuery Masked Reader.
| Ruolo/ID | Autorizzazioni | Descrizione |
|---|---|---|
Masked Reader (bigquerydatapolicy.maskedReader)
|
bigquery.dataPolicies.maskedGet |
Questo ruolo può essere concesso solo per le risorse di Resource Manager (progetti, cartelle e organizzazioni). Questo ruolo concede la possibilità di visualizzare i dati mascherati di una colonna associata a una policy dei dati. Inoltre, un utente deve disporre delle autorizzazioni appropriate per eseguire query sulla tabella. Per maggiori informazioni, consulta Autorizzazioni richieste. |
Come interagiscono i ruoli Masked Reader e Fine-Grained Reader
Il mascheramento dei dati si basa sul controllo dell'accesso a livello di colonna. Per una determinata colonna, è possibile che alcuni utenti con il ruolo Lettore mascherato BigQuery possano leggere i dati mascherati, alcuni utenti con il ruolo Lettore granulare Data Catalog possano leggere i dati non mascherati, alcuni utenti con entrambi e alcuni utenti senza nessuno dei due. Questi ruoli interagiscono nel seguente modo:
- Utente con i ruoli Lettore granulare e Lettore mascherato: ciò che l'utente vede dipende dalla posizione nella gerarchia dei tag di criteri in cui viene concesso ciascun ruolo. Per saperne di più, consulta Ereditarietà dell'autorizzazione in una tag di criteri di policy.
- Utente con ruolo Lettore granulare: può visualizzare i dati della colonna non mascherati (non oscurati).
- Utente con il ruolo Masked Reader: può visualizzare i dati delle colonne mascherati (oscurati).
- Utente senza nessuno dei due ruoli: autorizzazione negata.
Nel caso in cui una tabella abbia colonne protette o protette e
mascherate, per eseguire un'istruzione SELECT * FROM su quella tabella,
un utente deve essere membro di gruppi appropriati in modo che gli vengano concessi
i ruoli Lettore mascherato o Lettore granulare su tutte queste colonne.
Un utente a cui non sono concessi questi ruoli deve invece specificare solo le colonne a cui ha accesso nell'istruzione SELECT oppure utilizzare SELECT * EXCEPT
(restricted_columns) FROM per escludere le colonne protette o mascherate.
Ereditarietà dell'autorizzazione in una gerarchia di tag di criteri
I ruoli vengono valutati a partire dal tag di criteri associato a una colonna, quindi controllati a ogni livello ascendente della tassonomia, finché non viene stabilito che l'utente dispone delle autorizzazioni appropriate o non viene raggiunto il livello più alto della gerarchia dei tag di criteri.
Ad esempio, prendi la configurazione del tag di criteri e dei criteri relativi ai dati mostrata nella Figura 4:
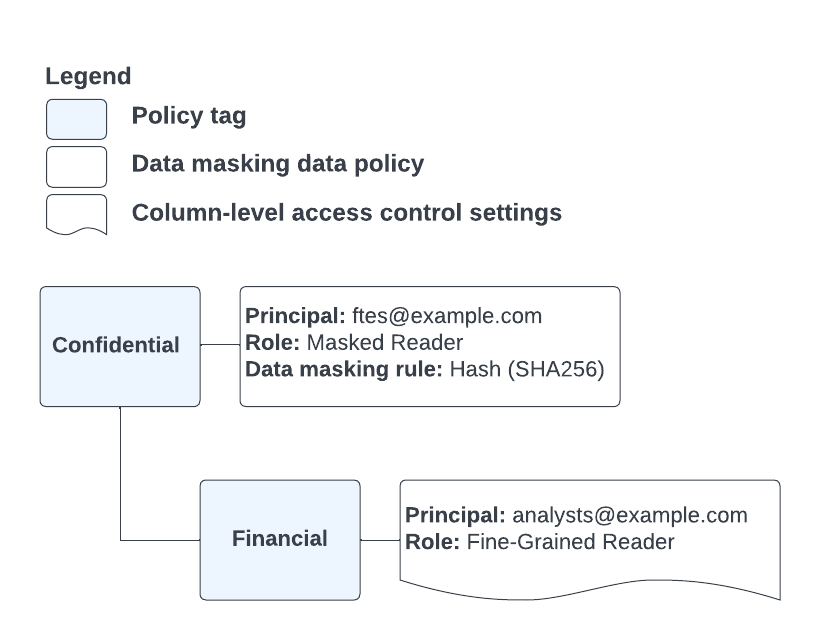
Immagine 4. Configurazione del tag di policy e della policy dei dati.
Hai una colonna della tabella annotata con il tag di criteri Financial e un utente che è membro dei gruppi ftes@example.com e analysts@example.com. Quando questo utente esegue una query che include la colonna annotata, il suo accesso è determinato dalla gerarchia definita nella tassonomia dei tag di criteri. Poiché all'utente viene concesso il ruolo Lettore granulare di Data Catalog dal tag di criteri Financial, la query restituisce i dati della colonna non mascherati.
Se un altro utente che è solo un membro del ruolo ftes@example.com esegue una query che include la colonna annotata, la query restituisce i dati della colonna sottoposti ad hashing utilizzando l'algoritmo SHA-256, perché all'utente viene concesso il ruolo BigQuery Masked Reader dal tag di criteri Confidential, che è l'elemento principale del tag di criteri Financial.
Un utente che non è membro di nessuno di questi ruoli riceve un errore di accesso negato se tenta di eseguire una query sulla colonna annotata.
A differenza dello scenario precedente, prendi il tag di criteri e la configurazione della policy dei dati mostrati nella Figura 5:
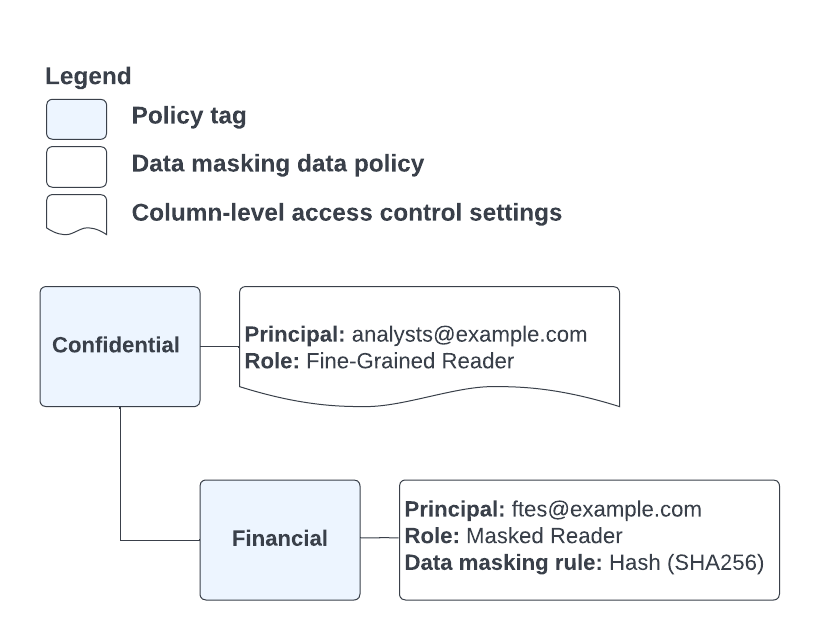
Figura 5. Configurazione del tag di policy e della policy dei dati.
La situazione è la stessa mostrata nella Figura 4, ma all'utente viene concesso il ruolo Lettore granulare a un livello superiore della gerarchia dei tag di criteri e il ruolo Lettore mascherato a un livello inferiore della gerarchia dei tag di criteri. Per questo motivo, la query restituisce dati di colonna mascherati per questo utente. Questo accade anche se all'utente viene concesso il ruolo Fine-Grained Reader più in alto nella gerarchia dei tag, perché il servizio utilizza il primo ruolo assegnato che incontra mentre sale nella gerarchia tag di criteri per verificare l'accesso dell'utente.
Se vuoi creare una singola policy dei dati e applicarla a più livelli di una gerarchia di tag di criteri, puoi impostare la policy dei dati sul tag di criteri che rappresenta il livello più alto della gerarchia a cui deve essere applicata. Ad esempio, prendi una tassonomia con la seguente struttura:
- Tag di policy 1
- Tag di policy 1a
- Tag di policy 1ai
- Tag di policy 1b
- Tag di policy 1bi
- Tag di policy 1bii
- Tag di policy 1a
Se vuoi che una norma sui dati venga applicata a tutti questi tag di policy, imposta la norma sui dati sul tag di criteri 1. Se vuoi che una policy dei dati venga applicata al tag di criteri 1b e ai relativi elementi secondari, imposta la policy dei dati sul tag di criteri 1b.
Mascheramento dei dati con funzionalità incompatibili
Quando utilizzi le funzionalità di BigQuery non compatibili con il mascheramento dei dati, il servizio tratta la colonna mascherata come una colonna protetta e concede l'accesso solo agli utenti con il ruolo Lettore granulare di Data Catalog.
Ad esempio, prendi la configurazione dei tag di criteri e delle policy di dati mostrata nella Figura 6:
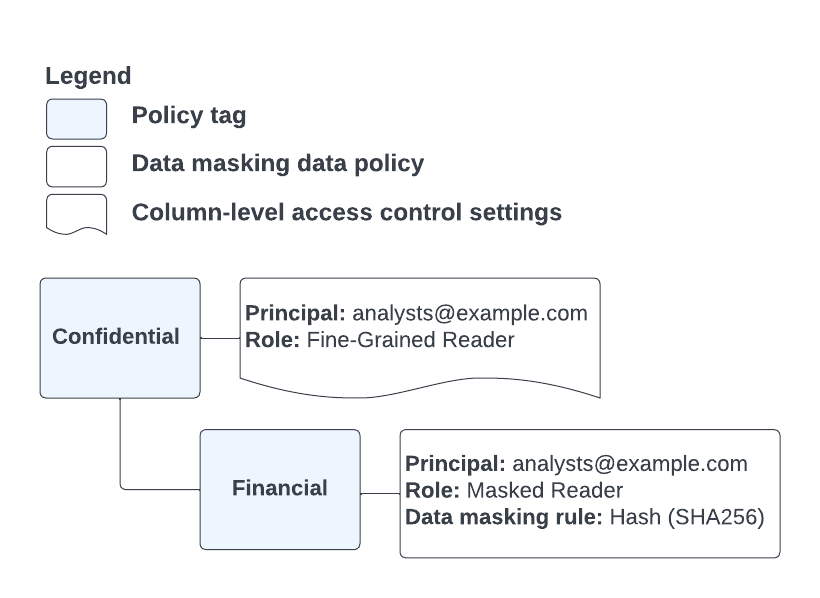
Immagine 6. Configurazione del tag di policy e della policy dei dati.
Hai una colonna della tabella annotata con il tag di criteri Financial e un utente che è membro del gruppo analysts@example.com. Quando questo utente tenta di accedere alla colonna annotata tramite una delle funzionalità incompatibili, riceve un errore di accesso negato. Questo perché gli viene concesso il tag di criteri BigQuery Masked Reader da Financial, ma in questo caso deve avere il ruolo Data Catalog Fine-Grained Reader.
Poiché il servizio ha già determinato un ruolo applicabile per l'utente, non continua a controllare più in alto nella gerarchia dei tag di criteri per ulteriori autorizzazioni.
Esempio di mascheramento dei dati con output
Per capire come funzionano insieme tag, entità e ruoli, considera questo esempio.
In example.com, l'accesso di base viene concesso tramite il gruppo data-users@example.com. Tutti i dipendenti che hanno bisogno di accedere regolarmente ai dati BigQuery sono membri di questo gruppo, a cui vengono assegnate tutte le autorizzazioni necessarie per leggere dalle tabelle, nonché il ruolo Lettore mascherato BigQuery.
I dipendenti vengono assegnati a gruppi aggiuntivi che forniscono l'accesso a colonne protette o mascherate, se necessario per il loro lavoro. Tutti i membri di questi gruppi aggiuntivi sono anche membri di data-users@example.com. Puoi vedere come questi gruppi sono associati ai ruoli appropriati nella Figura 7:
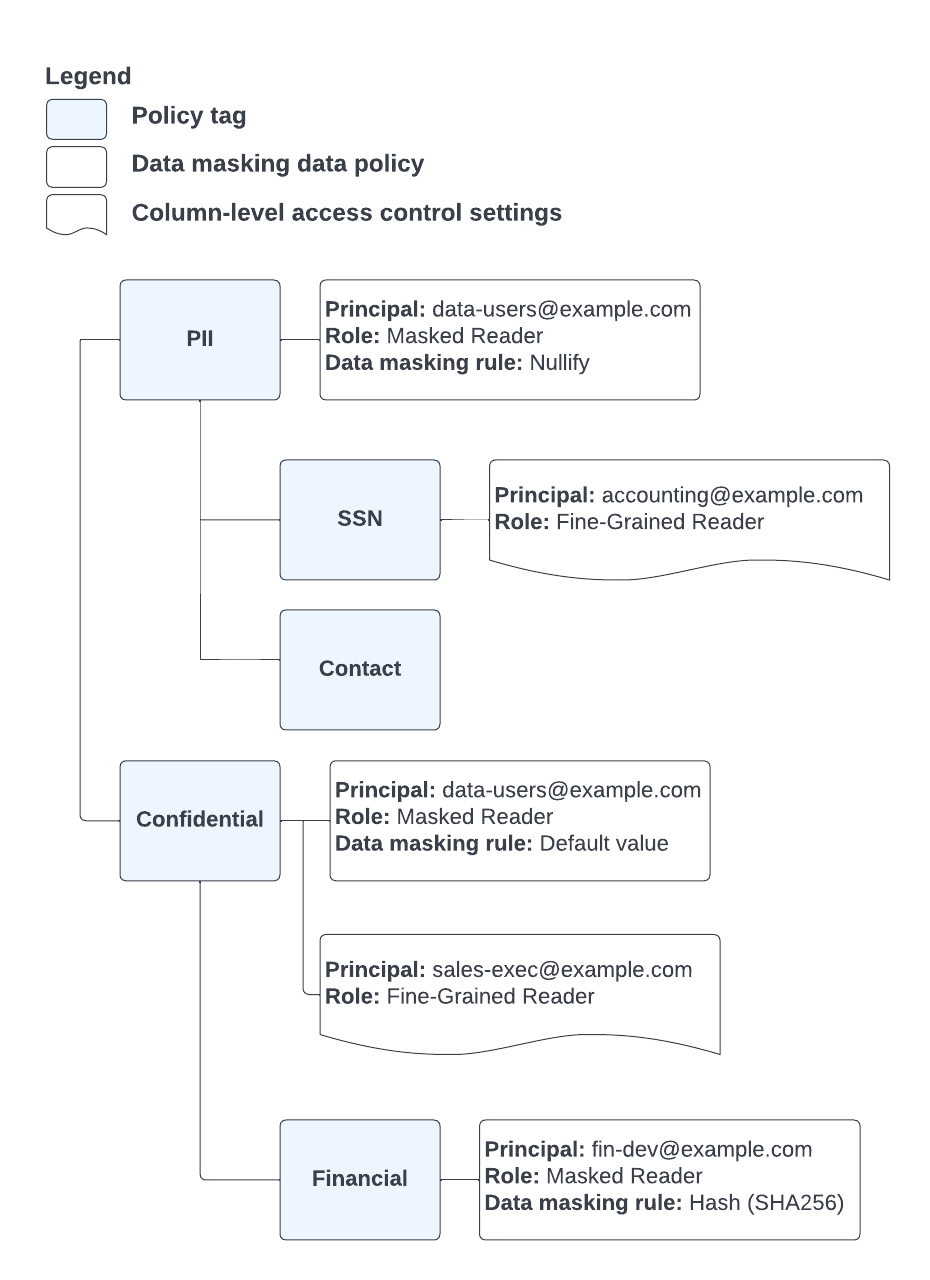
Immagine 7. Tag di policy e policy dei dati per example.com.
I tag di policy vengono quindi associati alle colonne della tabella, come mostrato nella Figura 8:
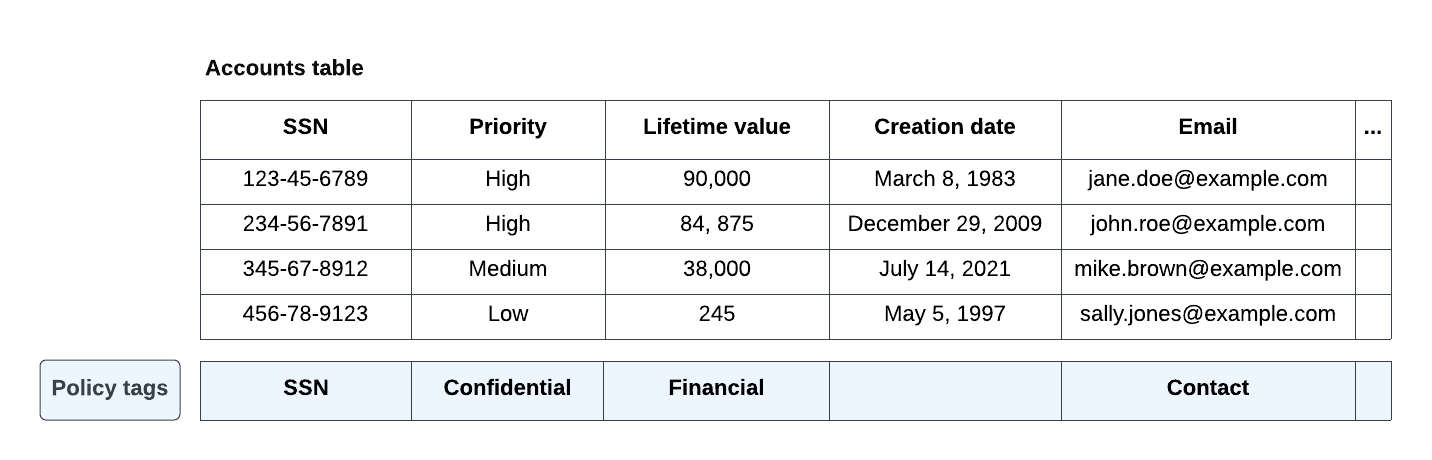
Immagine 8. Tag di policy di Example.com associati alle colonne della tabella.
Dati i tag associati alle colonne, l'esecuzione di
SELECT * FROM Accounts; porta ai
seguenti risultati per i diversi gruppi:
data-users@example.com: a questo gruppo è stato concesso il ruolo BigQuery Masked Reader per i tag di policy
PIIeConfidential. Vengono restituiti i seguenti risultati:SSN Priorità Lifetime value Data di creazione Email NULL "" 0 8 marzo 1983 NULL NULL "" 0 29 dicembre 2009 NULL NULL "" 0 14 luglio 2021 NULL NULL "" 0 5 maggio 1997 NULL accounting@example.com: a questo gruppo è stato concesso il ruolo Lettore granulare Data Catalog sul tag di criteri
SSN. Vengono restituiti i seguenti risultati:SSN Priorità Lifetime value Data di creazione NULL 123-45-6789 "" 0 8 marzo 1983 NULL 234-56-7891 "" 0 29 dicembre 2009 NULL 345-67-8912 "" 0 14 luglio 2021 NULL 456-78-9123 "" 0 5 maggio 1997 NULL sales-exec@example.com: a questo gruppo è stato concesso il ruolo Lettore granulare Data Catalog per il tag di criteri
Confidential. Vengono restituiti i seguenti risultati:SSN Priorità Lifetime value Data di creazione Email NULL Alta 90.000 8 marzo 1983 NULL NULL Alta 84.875 29 dicembre 2009 NULL NULL Media 38.000 14 luglio 2021 NULL NULL Bassa 245 5 maggio 1997 NULL fin-dev@example.com: a questo gruppo è stato concesso il ruolo BigQuery Masked Reader sul tag di criteri
Financial. Vengono restituiti i seguenti risultati:SSN Priorità Lifetime value Data di creazione Email NULL "" Zmy9vydG5q= 8 marzo 1983 NULL NULL "" GhwTwq6Ynm= 29 dicembre 2009 NULL NULL "" B6y7dsgaT9= 14 luglio 2021 NULL NULL "" Uh02hnR1sg= 5 maggio 1997 NULL Tutti gli altri utenti: qualsiasi utente che non appartiene a uno dei gruppi elencati riceve un errore di accesso negato, perché non gli sono stati concessi i ruoli Lettore granulare di Data Catalog o Lettore mascherato di BigQuery. Per eseguire query sulla tabella
Accounts, devono invece specificare solo le colonne a cui hanno accesso inSELECT * EXCEPT (restricted_columns) FROM Accountsper escludere le colonne protette o mascherate.
Considerazioni sui costi
Il mascheramento dei dati potrebbe influire indirettamente sul numero di byte elaborati e, di conseguenza, sul costo della query. Se un utente esegue una query su una colonna mascherata per lui con le regole Annulla o Valore di mascheramento predefinito, la colonna non viene analizzata, il che comporta un minor numero di byte elaborati.
Limitazioni e restrizioni
Le sezioni seguenti descrivono le categorie di restrizioni e limitazioni a cui è soggetto il mascheramento dei dati.
Gestione delle policy dei dati
- Questa funzionalità potrebbe non essere disponibile se utilizzi prenotazioni create con determinate versioni di BigQuery. Per ulteriori informazioni sulle funzionalità abilitate in ciascuna versione, consulta Introduzione alle versioni di BigQuery.
- Puoi creare fino a nove policy dei dati per ogni tag di criteri. Una di queste policy è riservata alle impostazioni di controllo dell'accesso a livello di colonna.
- Le policy dei dati, i tag di policy associati e tutte le routine che li utilizzano devono trovarsi nello stesso progetto.
Tag di policy
- Il progetto contenente la tassonomia dei tag di criteri deve appartenere a un'organizzazione.
- Le tassonomie dei tag di policy hanno come ambito un'organizzazione. Se esegui la migrazione di un progetto a un'altra organizzazione, il progetto perde l'accesso alla tassonomia Data Catalog originale. I tag di policy obsoleti potrebbero essere ancora visualizzati nelle colonne della tabella nell'editor dello schema, ma vengono rimossi dalla UI dei tag di criteri nella console Google Cloud e non possono essere applicati alle nuove tabelle. Se
migri un progetto a una nuova organizzazione, devi eseguire le seguenti operazioni:
- Ricrea manualmente le tassonomie dei tag di criteri, i tag di policy e le policy dei dati associate in un progetto all'interno dell'organizzazione di destinazione.
- Concedi esplicitamente i ruoli Amministratore BigQuery (
roles/bigquery.admin) e Amministratore Data Catalog (roles/datacatalog.adminoroles/datacatalog.categoryAdmin) a livello di cartella nell'organizzazione di destinazione. - Aggiorna le colonne della tabella nel progetto di cui è stata eseguita la migrazione in modo che facciano riferimento ai tag di policy appena creati nell'organizzazione di destinazione.
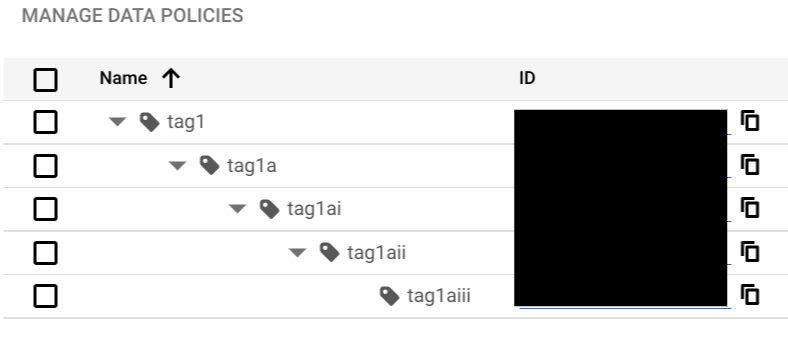
Una gerarchia di tag di criteri non può avere più di cinque livelli dal nodo principale al sottotag di livello più basso, come mostrato nello screenshot seguente:
Impostare controllo dell'accesso
Dopo che a una tassonomia è stata associata una policy dei dati con almeno uno dei suoi tag di policy, il controllo degli accessi viene applicato automaticamente. Se vuoi disattivare controllo dell'accesso, devi prima eliminare tutte le policy dei dati associate alla tassonomia.
Viste materializzate e query di mascheramento dei record ripetuti
Se hai viste materializzate esistenti, le query di mascheramento dei record ripetuti sulla tabella di base associata non vanno a buon fine. Per risolvere il problema, elimina la vista materializzata. Se la vista materializzata è necessaria per altri motivi, puoi crearla in un altro set di dati.
Eseguire query sulle colonne mascherate nelle tabelle partizionate
Le query che includono il mascheramento dei dati sulle colonne partizionate o raggruppate in cluster non sono supportate.
Dialetti SQL
L'SQL precedente non è supportato.
Routine di mascheramento personalizzate
Le routine di mascheramento personalizzate sono soggette alle seguenti limitazioni:
- Il mascheramento dei dati personalizzato supporta tutti i
tipi di dati BigQuery
tranne
STRUCT, perché il mascheramento dei dati può essere applicato solo ai campi foglia del tipo di datiSTRUCT. - L'eliminazione di una routine di mascheramento personalizzata non comporta l'eliminazione di tutte le norme relative ai dati che la utilizzano. Tuttavia, le policy dei dati che utilizzano la routine di mascheramento eliminata rimangono con una regola di mascheramento vuota. Gli utenti con il ruolo Masked Reader in altre policy dei dati con lo stesso tag possono visualizzare i dati mascherati. Gli altri utenti vedono il messaggio
Permission denied.I riferimenti in sospeso a regole di mascheramento vuote potrebbero essere eliminati da processi automatici dopo sette giorni. - È consentita una sola routine di mascheramento personalizzata per tag di criteri.
Compatibilità con altre funzionalità di BigQuery
API BigQuery
Non compatibile con il metodo tabledata.list. Per chiamare tabledata.list, devi disporre dell'accesso completo a tutte le colonne restituite da questo metodo. Il ruolo Data Catalog Fine-Grained Reader concede l'accesso appropriato.
Tabelle BigLake
Compatibile. Le policy di mascheramento dei dati vengono applicate alle tabelle BigLake.
API BigQuery Storage Read
Compatibile. I criteri di mascheramento dei dati vengono applicati nell'API BigQuery Storage Read.
BigQuery BI Engine
Compatibile. Le policy di mascheramento dei dati vengono applicate in BI Engine. Le query con mascheramento dei dati attivo non vengono accelerate da BI Engine. L'utilizzo di queste query in Data Studio potrebbe rendere i report o le dashboard correlati più lenti e costosi.
BigQuery Omni
Compatibile. Le policy di mascheramento dei dati vengono applicate alle tabelle BigQuery Omni.
Regole di confronto
Parzialmente compatibile. Puoi applicare il mascheramento dinamico dei dati alle colonne raggruppate, ma il mascheramento viene applicato prima del raggruppamento. Questo ordine di operazioni può portare a risultati inaspettati, in quanto le regole di confronto potrebbero non influire sui valori mascherati come previsto (ad esempio, la corrispondenza senza distinzione tra maiuscole e minuscole potrebbe non funzionare dopo la mascheratura). Sono possibili soluzioni alternative, come l'utilizzo di routine di mascheramento personalizzate che normalizzano i dati prima di applicare la funzione di mascheramento.
Job di copia
Non compatibile. Per copiare una tabella dall'origine alla destinazione, devi disporre dell'accesso completo a tutte le colonne della tabella di origine. Il ruolo Lettore granulare di Data Catalog concede l'accesso appropriato.
Esportazione dei dati
Compatibile. Se hai il ruolo BigQuery Masked Reader, i dati esportati vengono mascherati. Se disponi del ruolo Lettore granulare di Data Catalog, i dati esportati non vengono mascherati.
Sicurezza a livello di riga
Compatibile solo con query che hanno policy di accesso alle righe non di subquery. Il mascheramento dei dati
viene applicato in aggiunta alla sicurezza a livello di riga. Ad esempio, se è applicato un criterio di accesso alle righe su location = "US" e location è mascherato, gli utenti possono visualizzare le righe in cui location = "US", ma il campo della località è mascherato nei risultati.
Le query che coinvolgono una policy di accesso alle righe della sottoquery richiedono l'accesso di lettura granulare alle colonne a cui fanno riferimento le policy di accesso alle righe.
Cerca in BigQuery
Parzialmente compatibile. Puoi chiamare la funzione SEARCH su colonne indicizzate o non indicizzate a cui è applicato il mascheramento dei dati.
Quando chiami la funzione SEARCH sulle colonne a cui è applicato il mascheramento dei dati, devi utilizzare criteri di ricerca compatibili con il tuo livello di accesso. Ad esempio, se hai l'accesso Masked Reader con una regola di mascheramento dei dati Hash (SHA-256), utilizzerai il valore hash nella clausola SEARCH, in modo simile al seguente:
SELECT * FROM myDataset.Customers WHERE SEARCH(Email, "sg172y34shw94fujaweu");
Se disponi dell'accesso Fine-Grained Reader, utilizzerai il valore effettivo della colonna nella clausola SEARCH, in modo simile al seguente:
SELECT * FROM myDataset.Customers WHERE SEARCH(Email, "jane.doe@example.com");
La ricerca ha meno probabilità di essere utile se disponi dell'accesso Lettore mascherato a una colonna in cui la regola di mascheramento dei dati utilizzata è Annulla o Valore di mascheramento predefinito. Questo perché i risultati mascherati che utilizzeresti come criteri di ricerca, come NULL o "", non sono sufficientemente univoci per essere utili.
Quando esegui una ricerca su una colonna indicizzata a cui è applicato il mascheramento dei dati, l'indice della Ricerca viene utilizzato solo se hai l'accesso Fine-Grained Reader alla colonna.
Snapshot
Non compatibile. Per creare uno snapshot di una tabella, devi disporre dell'accesso completo a tutte le colonne della tabella di origine. Il ruolo Lettore con accesso granulare di Data Catalog concede l'accesso appropriato.
Rinomina tabella
Compatibile. La ridenominazione delle tabelle non è interessata dal mascheramento dei dati.
Viaggio nel tempo
Compatibile sia con i
decoratori temporali sia con l'opzione
FOR SYSTEM_TIME AS OF
nelle istruzioni SELECT. I tag di policy per lo schema del set di dati corrente vengono applicati ai dati recuperati.
Memorizzazione nella cache delle query
Parzialmente compatibile. BigQuery memorizza nella cache i risultati delle query per circa 24 ore, anche se la cache viene invalidata se vengono apportate modifiche ai dati o allo schema della tabella prima di questo periodo. Nella seguente circostanza, è possibile che un utente a cui non è stato concesso il ruolo Lettore granulare di Data Catalog su una colonna possa comunque visualizzare i dati della colonna quando esegue una query:
- A un utente è stato concesso il ruolo Lettore granulare di Data Catalog su una colonna.
- L'utente esegue una query che include la colonna con limitazioni e i dati vengono memorizzati nella cache.
- Entro 24 ore dal passaggio 2, all'utente viene concesso il ruolo BigQuery Masked Reader e viene revocato il ruolo Data Catalog Fine-Grained Reader.
- Entro 24 ore dal passaggio 2, l'utente esegue la stessa query e vengono restituiti i dati memorizzati nella cache.
Query di tabelle con funzione carattere jolly
Non compatibile. Devi disporre dell'accesso completo a tutte le colonne a cui viene fatto riferimento in tutte le tabelle corrispondenti alla query con caratteri jolly. Il ruolo Data Catalog Fine-Grained Reader concede l'accesso appropriato.
Passaggi successivi
- Ricevi istruzioni passo passo per attivare l'oscuramento dei dati.