


BigLake 資料表簡介
本文提供 BigLake 總覽,並假設您熟悉資料庫資料表和 Identity and Access Management (IAM)。如要查詢儲存在支援的資料儲存庫中的資料,您必須先建立 BigLake 資料表,然後使用 GoogleSQL 語法查詢:
- 建立 Cloud Storage BigLake 資料表,然後查詢。
- 建立 Amazon S3 BigLake 資料表,然後執行查詢。
- 建立 Azure Blob 儲存體 BigLake 資料表,然後查詢。
您也可以將外部資料表升級為 BigLake。詳情請參閱「將外部資料表升級為 BigLake」。
BigLake 資料表可讓您透過存取權委派功能,查詢外部資料儲存庫中的結構化資料。存取權委派功能會將 BigLake 資料表的存取權,與基礎資料儲存庫的存取權分開。與服務帳戶相關聯的外部連線,會用於連線至資料儲存庫。由於服務帳戶會處理從資料儲存庫擷取資料的作業,因此您只需授予使用者 BigLake 資料表的存取權。這可讓您在資料表層級強制執行精細的安全防護機制,包括資料列層級和資料欄層級安全性。如果是以 Cloud Storage 為基礎的 BigLake 資料表,您也可以使用動態資料遮蓋。如要進一步瞭解如何使用 BigLake 資料表搭配 Amazon S3 或 Blob 儲存體資料的多雲端分析解決方案,請參閱「BigQuery Omni」。
支援的資料儲存庫
BigLake 資料表可與下列資料儲存庫搭配使用:
- 使用 BigQuery Omni 存取 Amazon S3
- 使用 BigQuery Omni 存取 Blob Storage
- Cloud Storage
臨時資料表支援
以 Cloud Storage 為基礎的 BigLake 資料表可以是臨時或永久資料表。以 Amazon S3 或 Blob 儲存體為基礎的 BigLake 資料表必須是永久資料表。
多個來源檔案
您可以根據多個外部資料來源建立 BigLake 資料表,前提是這些資料來源具有相同的結構定義。
BigQuery Omni 彙整
BigQuery Omni 彙整功能可讓您執行跨Google Cloud 和 BigQuery Omni 區域的查詢。您可以使用 GoogleSQL JOIN 作業,分析多種不同儲存空間解決方案中的資料,例如 AWS、Azure、公開資料集和其他 Google Cloud 服務。BigQuery Omni 彙整功能可讓您在執行查詢前,不必跨來源複製資料。
您可以在 SELECT 陳述式的任何位置參照 BigLake 資料表,就像參照標準 BigQuery 資料表一樣,包括使用子查詢擷取資料的data manipulation language (DML) 和資料定義語言 (DDL) 陳述式。您可以在同一查詢中使用來自不同雲端的 BigLake 資料表和 BigQuery 資料表。所有 BigQuery 資料表都必須位於相同區域。
BigQuery Omni join 必要權限
如要取得執行 BigQuery Omni join 所需的權限,請要求管理員在執行 join 的專案中,授予您下列 IAM 角色:
- BigQuery 資料檢視者 (
roles/bigquery.dataViewer) - BigQuery 工作使用者 (
roles/bigquery.jobUser)
如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這些預先定義的角色具備執行 BigQuery Omni join 所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
必須具備下列權限,才能執行 BigQuery Omni join:
-
bigquery.jobs.create -
bigquery.tables.getData
BigQuery Omni join 費用
執行 BigQuery Omni 彙整作業時,BigQuery 會將查詢剖析為本機和遠端部分。本機部分會視為 BigQuery 區域中的標準查詢。遠端部分會轉換為 CREATE TABLE AS SELECT (CTAS) 作業,在 BigQuery Omni 區域中參照的 BigLake 資料表上執行,在 BigQuery 區域中建立臨時資料表。接著,BigQuery 會使用這個臨時資料表執行 BigQuery Omni 彙整作業,並在八小時後自動刪除資料表。
您需要支付參照 BigLake 資料表的資料移轉費用。不過,BigQuery 只會移轉 BigLake 資料表中查詢參照的資料欄和資料列,而非整個資料表,因此有助於降低這些費用。建議您盡可能指定範圍較小的資料欄篩選器,進一步降低移轉費用。CTAS 工作會顯示在工作記錄中,並顯示轉移的位元組數等資訊。即使主要查詢工作失敗,成功轉移仍會產生費用。詳情請參閱「BigQuery Omni 定價」。
請參考以下查詢範例:
SELECT *
FROM bigquery_dataset.bigquery_table AS clients
WHERE clients.sales_rep IN (
  SELECT id
  FROM aws_dataset.aws_table1 AS employees
  INNER JOIN aws_dataset.aws_table2 AS active_employees
    ON employees.id = active_employees.id
  WHERE employees.level > 3
);
這個範例有兩項移轉作業:一項來自員工資料表 (含層級篩選器),另一項來自在職員工資料表。移轉作業完成後,系統會在 BigQuery 區域執行彙整作業。如果其中一項移轉作業失敗,另一項成功,則成功的移轉作業仍會收取資料移轉費用。
BigQuery Omni join 限制
- BigQuery 免費方案和 BigQuery 沙箱不支援 BigQuery Omni 彙整。
- 如果查詢包含
JOIN陳述式,匯總可能不會下推至 BigQuery Omni 區域。 - 每個臨時資料表僅用於單一 BigQuery Omni 查詢,即使多次重複相同查詢,也不會重複使用。
- 每次轉移的大小上限為 60 GB。具體來說,如果您對 BigLake 資料表套用篩選器並載入結果,結果必須小於 60 GB。如要提高配額,請聯絡支援團隊。掃描的位元組數量沒有限制。
- BigQuery Omni 彙整查詢會對查詢速率採用內部配額。如果查詢率超過配額,您可能會收到
All our servers are busy processing data transferred between regions錯誤。在多數情況下,重試查詢應可解決問題。如要提高內部配額,以便支援更高的查詢率,請與支援團隊聯絡。 - BigQuery Omni 彙整作業僅支援共置 BigQuery 區域及其對應的 BigQuery Omni 區域,以及
US和EU多區域。在US或EU多區域中執行的 BigQuery Omni 彙整作業,只能分別存取美國或歐盟 BigQuery Omni 區域中的資料。 - 如果 BigQuery Omni 彙整查詢參照 10 個以上 BigQuery Omni 區域的資料集,可能會失敗並顯示錯誤
Not found: Dataset <BigQuery dataset> was not found in
location <BigQuery Omni region>
。為避免這個問題,建議您在執行參照超過 10 個資料集的 BigQuery Omni 彙整作業時,明確指定位置。請注意,如果您明確指定 BigQuery 區域,且查詢僅包含 BigLake 資料表,則查詢會以 BigQuery Omni 查詢的形式執行,並產生資料移轉費用。 - 您無法使用 BigQuery Omni 彙整查詢
_FILE_NAME虛擬資料欄。 - 在
WHERE子句中參照 BigLake 資料表的資料欄時,無法使用INTERVAL或RANGE常值。 - BigQuery Omni join 工作不會回報從其他雲端處理及移轉的位元組數。這項資訊可在執行 BigQuery Omni 查詢時建立的子 CTAS 工作中找到。
- 參照 BigQuery Omni 資料表或檢視表的授權檢視表和授權常式,僅適用於 BigQuery Omni 區域。
- 如果 BigQuery Omni 查詢參照
STRUCT資料欄,則不會對任何遠端子查詢套用下推。為達到最佳效能,建議您在 BigQuery Omni 區域建立檢視表,將STRUCT資料欄中的必要欄位拆解成個別資料欄。 - BigQuery Omni 彙整不支援定序。
- BigQuery Omni 彙整不支援使用
ORDER BY子句彙整 BigQuery Omni 檢視表。
BigQuery Omni join 範例
下列查詢會將 BigQuery 區域中的 orders 資料表,與 BigQuery Omni 區域中的 lineitem 資料表彙整:
SELECT
  l_shipmode,
  o_orderpriority,
  count(l_linenumber) AS num_lineitems
FROM bigquery_dataset.orders
JOIN aws_dataset.lineitem
  ON orders.o_orderkey = lineitem.l_orderkey
WHERE
  l_shipmode IN ('AIR', 'REG AIR')
  AND l_commitdate < l_receiptdate
  AND l_shipdate < l_commitdate
  AND l_receiptdate >= DATE '1997-01-01'
  AND l_receiptdate < DATE '1997-02-01'
GROUP BY l_shipmode, o_orderpriority
ORDER BY l_shipmode, o_orderpriority;
這項查詢會分成地端和遠端兩部分。下列查詢會先傳送至 BigQuery Omni 區域執行。結果會是 BigQuery 區域中的臨時資料表。您可以在工作記錄中查看這個子 CTAS 工作及其中繼資料。
CREATE OR REPLACE TABLE temp_table
AS (
  SELECT
    l_shipmode,
    l_linenumber,
    l_orderkey
  FROM aws_dataset.lineitem
  WHERE
    l_shipmode IN ('AIR', 'REG AIR')
    AND l_commitdate < l_receiptdate
    AND l_shipdate < l_commitdate
    AND l_receiptdate >= DATE '1997-01-01'
    AND l_receiptdate < DATE '1997-02-01'
);
建立臨時資料表後,JOIN 作業會完成,並執行下列查詢:
SELECT
  l_shipmode,
  o_orderpriority,
  count(l_linenumber) AS num_lineitems
FROM bigquery_dataset.orders
JOIN temp_table
  ON orders.o_orderkey = lineitem.l_orderkey
GROUP BY l_shipmode, o_orderpriority
ORDER BY l_shipmode, o_orderpriority;
再舉一個例子,請考慮下列 BigQuery Omni 彙整:
SELECT c_mktsegment, c_name
FROM bigquery_dataset.customer
WHERE c_mktsegment = 'BUILDING'
UNION ALL
SELECT c_mktsegment, c_name
FROM aws_dataset.customer
WHERE c_mktsegment = 'FURNITURE'
LIMIT 10;
在這項查詢中,LIMIT 子句不會下推至 BigQuery Omni 區域。FURNITURE 市場區隔中的所有客戶會先轉移至 BigQuery 區域,然後套用 10 的限制。
連接器
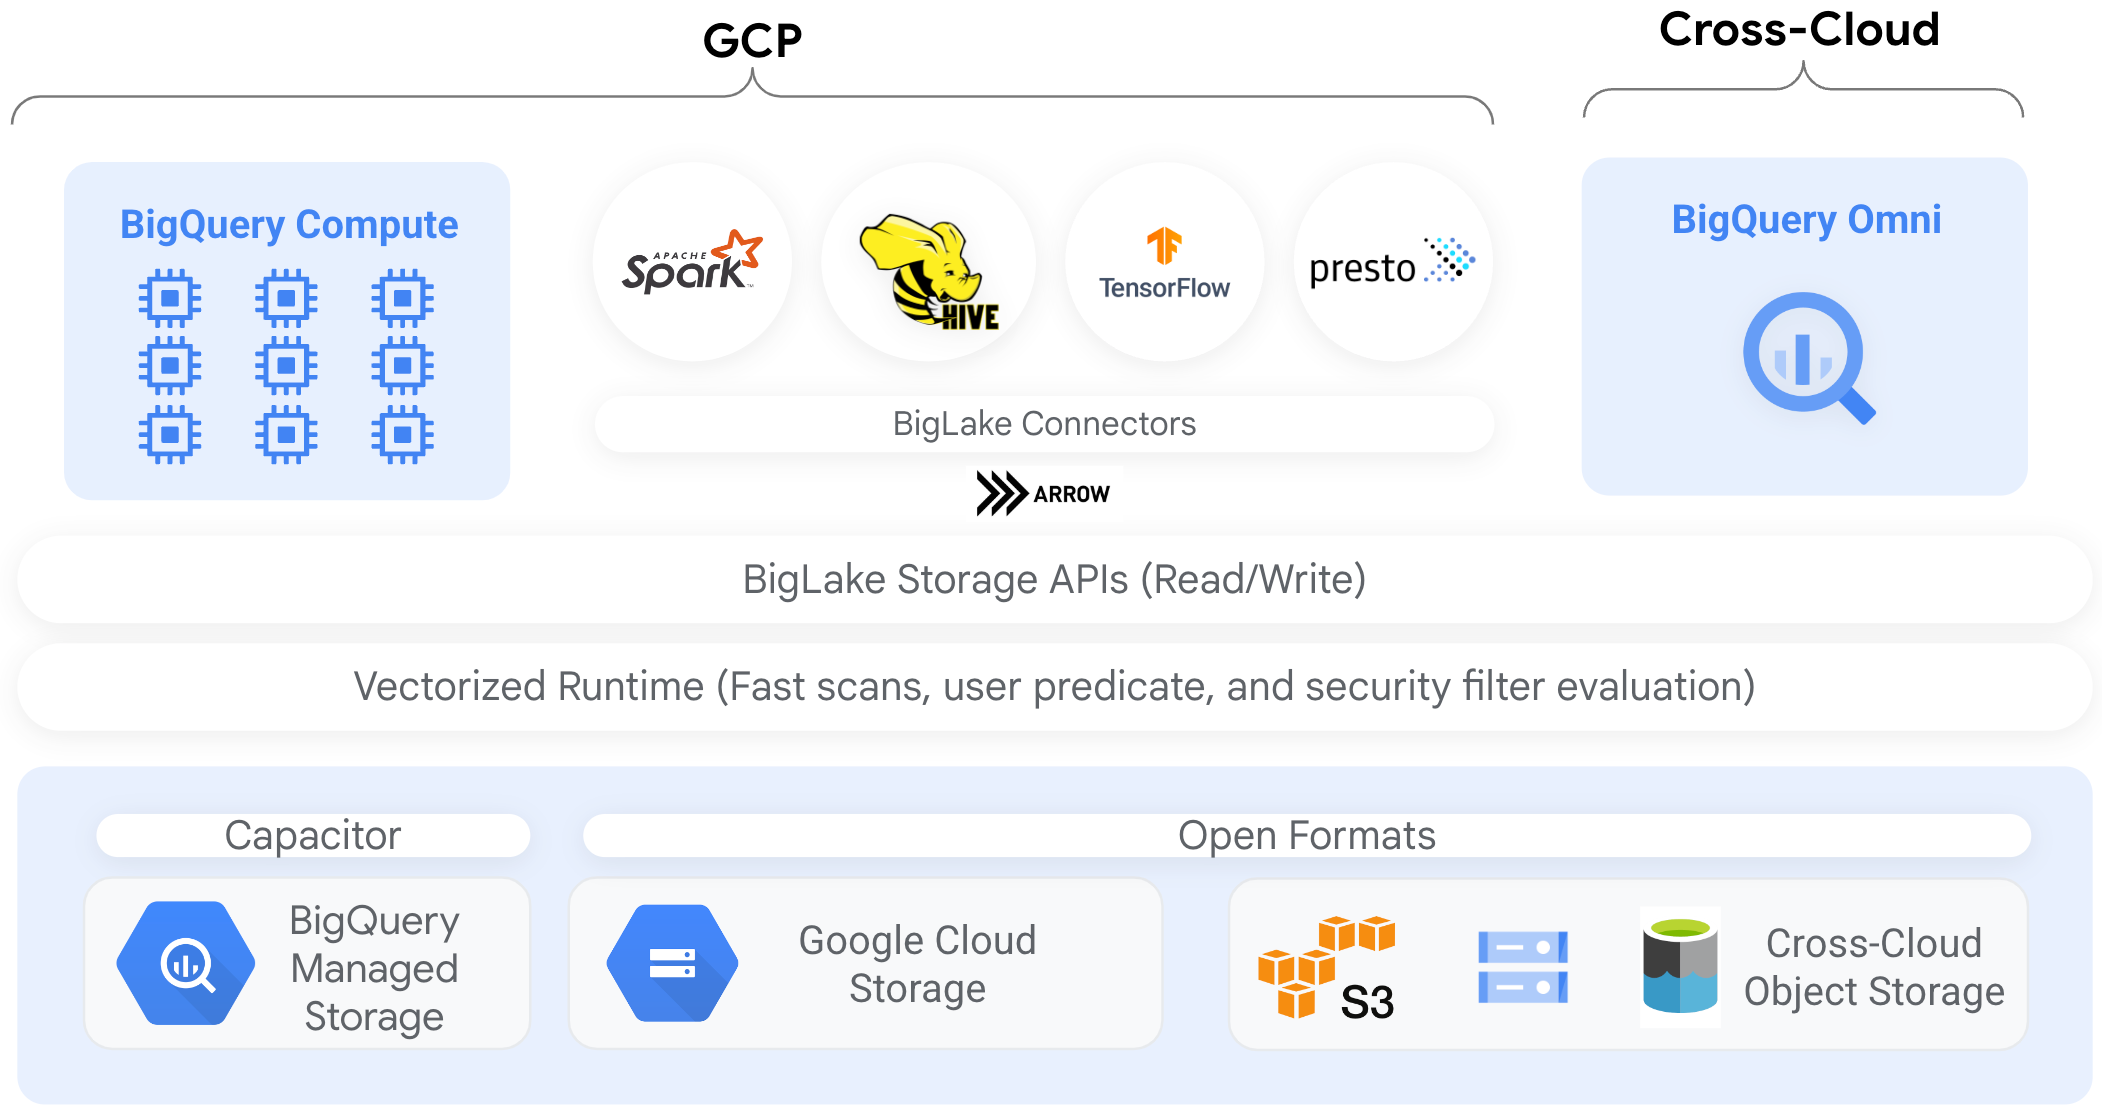
您可以使用 BigQuery 連接器,從其他資料處理工具存取 Cloud Storage 中的 BigLake 資料表。舉例來說,您可以從 Apache Spark、Apache Hive、TensorFlow、Trino 或 Presto 存取 BigLake 資料表中的資料。BigQuery Storage API 會對 BigLake 資料表的所有資料存取活動 (包括透過連接器進行的活動),強制執行資料列和資料欄層級的控管政策。
舉例來說,下圖說明 BigQuery Storage API 如何讓使用者透過 Apache Spark 等開放原始碼查詢引擎,存取自己有權限存取的資料:
如要進一步瞭解 BigQuery 支援的連接器,請參閱「BigQuery 連接器」。
物件儲存庫中的 BigLake 資料表
資料湖泊管理員可透過 BigLake 設定資料表的存取控管機制,而非檔案,因此在設定使用者對資料湖泊中資料的存取權時,可提供更精細的選項。
BigLake 資料表可簡化存取控管,因此建議您使用 BigLake 資料表,建立及維護與外部物件儲存庫的連線。
如果不需要管理,或需要臨時探索及操控資料,可以使用外部資料表。
限制
- 外部資料表的所有限制都適用於 BigLake 資料表。
- 物件儲存庫中的 BigLake 資料表與 BigQuery 資料表受相同限制。詳情請參閱「配額」。
BigLake 不支援 Managed Service for Apache Spark 個人叢集驗證中範圍縮小的憑證。如要使用啟用個人叢集驗證功能的叢集,請透過空白的憑證存取權邊界和
--access-boundary=<(echo -n "{}")旗標插入憑證。舉例來說,下列指令會在名為myproject的專案中,為名為mycluster的叢集啟用憑證傳播工作階段:gcloud dataproc clusters enable-personal-auth-session \ --region=us \ --project=myproject \ --access-boundary=<(echo -n "{}") \ myclusterBigLake 資料表為唯讀。您無法使用 DML 陳述式或其他方法修改 BigLake 資料表。
BigLake 資料表支援下列格式:
- Avro
- CSV
- Delta Lake
- Iceberg
- JSON
- ORC
- Parquet
您無法將快取中繼資料與 Apache Iceberg 外部資料表搭配使用;BigQuery 已使用 Iceberg 在資訊清單檔案中擷取的中繼資料。
BigQuery Storage API 不適用於其他雲端環境,例如 AWS 和 Azure。
如果使用快取中繼資料,則適用下列限制:
- 快取中繼資料只能用於採用 Avro、ORC、Parquet、JSON 和 CSV 格式的 BigLake 資料表。
- 如果您在 Amazon S3 中建立、更新或刪除檔案,則查詢檔案時不會傳回更新後的資料,直到下次重新整理中繼資料快取為止。這可能會導致非預期的結果。 舉例來說,如果您刪除檔案並寫入新檔案,查詢結果可能會排除舊檔案和新檔案,具體取決於快取中繼資料上次更新的時間。
- 如果 BigLake 資料表參照 Amazon S3 或 Blob 儲存體資料,則不支援搭配使用客戶自行管理的加密金鑰 (CMEK) 和快取中繼資料。
安全性模型
管理及使用 BigLake 資料表時,通常會涉及下列組織角色:
- 資料湖泊管理員:這類管理員通常會管理 Cloud Storage bucket 和物件的身分與存取權管理 (IAM) 政策。
- 資料倉儲管理員:這類管理員通常會建立、刪除及更新資料表。
- 資料分析師:分析人員通常會讀取資料及執行查詢。
資料湖泊管理員負責建立連線,並與資料倉儲管理員共用。資料倉儲管理員則會建立資料表、設定適當的存取控管機制,並與資料分析師共用資料表。
中繼資料快取,提升效能
您可以使用快取中繼資料,提升某些類型 BigLake 資料表的查詢效能。如果您要處理大量檔案,或資料已進行 Hive 分區,中繼資料快取功能就特別實用。下列類型的 BigLake 資料表支援中繼資料快取:
- Amazon S3 BigLake 資料表
- Cloud Storage BigLake 資料表
中繼資料包括檔案名稱、分區資訊,以及檔案的實體中繼資料,例如列數。您可以選擇是否要啟用資料表的中繼資料快取功能。含有大量檔案和 Apache Hive 分區篩選器的查詢,最能發揮中繼資料快取的效益。
如未啟用中繼資料快取功能,資料表查詢就必須讀取外部資料來源,才能取得物件中繼資料。讀取這類資料會增加查詢延遲時間;從外部資料來源列出數百萬個檔案可能需要幾分鐘的時間。啟用中繼資料快取功能後,查詢作業就不必列出外部資料來源中的檔案,而且能更快分區及剪除檔案。
中繼資料快取也與 Cloud Storage 物件版本管理功能整合。填入或重新整理快取時,系統會根據當時 Cloud Storage 物件的使用中版本擷取中繼資料。因此,啟用中繼資料快取的查詢會讀取與特定快取物件版本對應的資料,即使 Cloud Storage 中有較新的版本也一樣。如要存取 Cloud Storage 中後續更新的物件版本資料,必須重新整理中繼資料快取。
有兩個屬性可控制這項功能:
- 最大過時時間指定查詢使用快取中繼資料的時間。
- 中繼資料快取模式會指定中繼資料的收集方式。
啟用中繼資料快取功能後,您可以指定資料表作業可接受的中繼資料過時時間間隔上限。舉例來說,如果您指定 1 小時的間隔,則資料表作業會使用過去一小時內重新整理的快取中繼資料。如果快取的中繼資料超過這個時間,作業就會改為從資料儲存庫 (Amazon S3 或 Cloud Storage) 擷取中繼資料。您可以指定 30 分鐘至 7 天的過時間隔。
為 BigLake 或物件資料表啟用中繼資料快取時,BigQuery 會觸發中繼資料生成重新整理工作。您可以選擇自動或手動重新整理快取:
- 如果是自動重新整理,快取會按照系統定義的時間間隔重新整理,通常介於 30 到 60 分鐘之間。如果資料儲存庫中的檔案會不定期新增、刪除或修改,自動重新整理快取是不錯的做法。如需控制重新整理的時間點 (例如在擷取、轉換和載入工作結束時觸發重新整理),請使用手動重新整理。
如要手動重新整理,請執行
BQ.REFRESH_EXTERNAL_METADATA_CACHE系統程序,按照符合需求的時間表重新整理中繼資料快取。如果是 BigLake 資料表,您可以提供資料表資料目錄的子目錄,選擇性重新整理中繼資料。這樣一來,您就能避免不必要的中繼資料處理。如果資料儲存庫中的檔案會以已知間隔新增、刪除或修改 (例如做為管道的輸出內容),手動重新整理快取是不錯的做法。如果同時發出多個手動重新整理要求,只有一個會成功。
如果未重新整理,中繼資料快取會在 7 天後過期。
手動和自動快取重新整理都會以 INTERACTIVE 查詢優先順序執行。
使用 BACKGROUND 預留項目
如果您選擇使用自動重新整理功能,建議您建立預留項目,然後為執行中繼資料快取重新整理工作的專案建立具有 BACKGROUND 工作類型的指派作業。使用 BACKGROUND 預留項目時,重新整理工作會使用專屬資源集區,因此不會與使用者查詢競爭資源,也不會因資源不足而失敗。
雖然使用共用運算單元集區不會產生額外費用,但改用 BACKGROUND 預留項目可分配專屬資源集區,提供更穩定的效能,並提高 BigQuery 重新整理工作的可靠性和整體查詢效率。
設定過時時間間隔和中繼資料快取模式值之前,請先考量兩者之間的互動方式。請見以下範例:
- 如果您手動重新整理資料表的中繼資料快取,並將過時時間間隔設為 2 天,則必須每 2 天 (或更短時間) 執行一次
BQ.REFRESH_EXTERNAL_METADATA_CACHE系統程序,才能對資料表執行作業,使用快取的中繼資料。 - 如果您自動重新整理資料表的中繼資料快取,並將過時時間間隔設為 30 分鐘,則對資料表執行的部分作業可能會從資料儲存庫讀取,前提是中繼資料快取重新整理作業所需的時間超過一般的 30 到 60 分鐘。
如要查看中繼資料重新整理工作的相關資訊,請查詢 INFORMATION_SCHEMA.JOBS 檢視表,如下例所示:
SELECT *
FROM `region-us.INFORMATION_SCHEMA.JOBS_BY_PROJECT`
WHERE job_id LIKE '%metadata_cache_refresh%'
AND creation_time > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
ORDER BY start_time DESC
LIMIT 10;
如果是以 Parquet 檔案為基礎的 Cloud Storage BigLake 資料表,系統會在重新整理中繼資料快取時收集資料表統計資料,並用於改善查詢計畫。
詳情請參閱「中繼資料快取」。
如要進一步瞭解如何設定中繼資料快取選項,請參閱「建立 Amazon S3 BigLake 資料表」或「建立 Cloud Storage BigLake 資料表」。
啟用快取且含 materialized view 的資料表
您可以在已啟用 BigLake 中繼資料快取的資料表上使用 materialized view,提高查詢 Cloud Storage 或 Amazon Simple Storage Service (Amazon S3) 中結構化資料的效能和效率。這些 materialized view 的運作方式與 BigQuery 代管儲存空間資料表的 materialized view 相同,包括自動重新整理和智慧微調等優點。
整合
您可以透過許多其他 BigQuery 功能和 gcloud CLI 服務存取 BigLake 資料表,包括下列重點服務。
BigQuery sharing (舊稱 Analytics Hub)
BigLake 資料表與共用功能相容。含有 BigLake 資料表的資料集可發布為共用項目。共用訂閱者可以訂閱這些清單,在專案中佈建唯讀資料集,稱為連結資料集。訂閱者可以查詢連結資料集中的所有資料表,包括所有 BigLake 資料表。詳情請參閱「查看及訂閱產品資訊」。
BigQuery ML
您可以使用 BigQuery ML,在 Cloud Storage 的 BigLake 中訓練及執行模型。
Sensitive Data Protection
Sensitive Data Protection 會掃描 BigLake 資料表,找出機密資料並分類。如果偵測到機密資料,Sensitive Data Protection 去識別化轉換功能可以遮蓋、刪除或模糊處理該資料。
費用
BigLake 資料表的費用與下列項目有關:
- 查詢資料表。
- 重新整理中繼資料快取。
如果您有預留運算單元,則查詢外部資料表時不會產生費用。而是會耗用運算單元。
下表說明定價模式如何影響這些費用的套用方式:
隨選定價 |
Standard、Enterprise 和 Enterprise Plus 版本 |
|
|---|---|---|
查詢 |
系統會根據使用者查詢處理的位元組數計費。 |
預留項目指派作業中 QUERY工作類型的運算單元會在查詢期間耗用。 |
手動重新整理中繼資料快取。 |
系統會根據重新整理快取時處理的位元組數向您收費。 |
預留項目指派作業中 QUERY工作類型的運算單元,會在快取重新整理期間耗用。 |
自動重新整理中繼資料快取。 |
系統會根據重新整理快取時處理的位元組數向您收費。 |
預留項目指派作業中 BACKGROUND工作類型的運算單元,會在快取重新整理期間耗用。如果沒有可用的 BACKGROUND 預留項目來重新整理中繼資料快取,且您使用的是 Enterprise 或 Enterprise Plus 版本,BigQuery 會自動改用 QUERY 預留項目中的運算單元。 |
此外,Cloud Storage、Amazon S3 和 Azure Blob Storage 也會根據各產品的定價指南,向您收取儲存空間和資料存取費用。
BigQuery 與 Cloud Storage 互動時,可能會產生下列 Cloud Storage 費用:
- 資料儲存費用,依儲存的資料量計算。
- 存取 Nearline、Coldline 和 Archive 儲存空間級別中的資料時,會產生資料擷取費用。對這些儲存空間級別查詢資料表或重新整理中繼資料快取時,請務必謹慎,因為費用可能相當高昂。
- 跨區域讀取資料的網路用量費用,例如 BigQuery 資料集和 Cloud Storage bucket 位於不同區域時。
- 資料處理費用。不過,BigQuery 代表您發出的 API 呼叫 (例如列出或取得資源) 不會產生費用。
後續步驟
- 瞭解如何將外部資料表升級為 BigLake 資料表。
- 瞭解如何建立 Cloud Storage BigLake 資料表。
- 瞭解如何建立 Amazon S3 BigLake 資料表。
- 瞭解如何建立 Blob 儲存體 BigLake 資料表。
- 瞭解如何使用 Knowledge Catalog 建立資料品質檢查。