


Introduzione alle tabelle BigLake
Questo documento fornisce una panoramica di BigLake e presuppone la familiarità con le tabelle di database e Identity and Access Management (IAM). Per eseguire query sui dati archiviati nei datastore supportati, devi prima creare tabelle BigLake e poi eseguire query utilizzando la sintassi GoogleSQL:
- Crea tabelle BigLake di Cloud Storage e poi esegui query.
- Crea tabelle BigLake di Amazon S3 e poi esegui query.
- Crea tabelle BigLake di Azure Blob Storage e poi esegui query.
Puoi anche eseguire l'upgrade di una tabella esterna a BigLake. Per saperne di più, consulta Esegui l'upgrade di una tabella esterna a BigLake.
Le tabelle BigLake ti consentono di eseguire query su dati strutturati in datastore esterni con delega di accesso. La delega dell'accesso disaccoppia l'accesso alla tabella BigLake dall'accesso al datastore sottostante. Per connettersi al datastore viene utilizzata una connessione esterna associata a un account di servizio. Poiché il account di servizio gestisce il recupero dei dati dal datastore, devi solo concedere agli utenti l'accesso alla tabella BigLake. In questo modo, puoi applicare una sicurezza granulare a livello di tabella, inclusa la sicurezza a livello di riga e a livello di colonna. Per le tabelle BigLake basate su Cloud Storage, puoi anche utilizzare il mascheramento dinamico dei dati. Per scoprire di più sulle soluzioni di analisi multi-cloud che utilizzano tabelle BigLake con dati Amazon S3 o Blob Storage, consulta BigQuery Omni.
Datastore supportati
Puoi utilizzare le tabelle BigLake con i seguenti datastore:
- Amazon S3 utilizzando BigQuery Omni
- Blob Storage utilizzando BigQuery Omni
- Cloud Storage
Supporto delle tabelle temporanee
Le tabelle BigLake basate su Cloud Storage possono essere temporanee o permanenti. Le tabelle BigLake basate su Amazon S3 o Blob Storage devono essere permanenti.
Più file di origine
Puoi creare una tabella BigLake basata su più origini dati esterne, a condizione che queste origini dati abbiano lo stesso schema.
Join di BigQuery Omni
I join di BigQuery Omni ti consentono di eseguire query che interessano sia le regioniGoogle Cloud sia quelle di BigQuery Omni. Puoi utilizzare le operazioni GoogleSQL JOIN per analizzare i dati in molte soluzioni di archiviazione diverse, come AWS, Azure, set di dati pubblici e altri servizi Google Cloud .
I join di BigQuery Omni eliminano la necessità di copiare i dati tra le origini prima di eseguire le query.
Puoi fare riferimento alle tabelle BigLake in qualsiasi punto di un'istruzione SELECT come se fossero tabelle BigQuery standard, anche nelle istruzioni Data Manipulation Language (DML) e Data Definition Language (DDL) che utilizzano subquery per recuperare i dati. Puoi utilizzare più tabelle BigLake di cloud diversi e tabelle BigQuery nella stessa query. Tutte le tabelle BigQuery devono trovarsi nella stessa regione.
Autorizzazioni richieste per il join di BigQuery Omni
Per ottenere le autorizzazioni necessarie per eseguire un join BigQuery Omni, chiedi all'amministratore di concederti i seguenti ruoli IAM nel progetto in cui viene eseguito il join:
- BigQuery Data Viewer (
roles/bigquery.dataViewer) - Utente job BigQuery (
roles/bigquery.jobUser)
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questi ruoli predefiniti contengono le autorizzazioni necessarie per eseguire un join BigQuery Omni. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per eseguire un join BigQuery Omni sono necessarie le seguenti autorizzazioni:
-
bigquery.jobs.create -
bigquery.tables.getData
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Costi di join di BigQuery Omni
Quando esegui un'operazione di join di BigQuery Omni, BigQuery analizza la query in parti locali e remote. La parte locale viene trattata come una query standard nella regione BigQuery. La parte remota viene convertita in un'operazione CREATE TABLE AS SELECT (CTAS) sulla tabella BigLake di riferimento nella regione BigQuery Omni, che crea una tabella temporanea nella regione BigQuery.
BigQuery utilizza quindi questa tabella temporanea per eseguire il join di BigQuery Omni ed elimina automaticamente la tabella dopo otto ore.
I costi di trasferimento di dati si applicano ai dati nelle tabelle BigLake di riferimento. Tuttavia, BigQuery aiuta a ridurre questi costi trasferendo solo le colonne e le righe della tabella BigLake a cui viene fatto riferimento nella query, anziché l'intera tabella. Ti consigliamo di specificare un filtro di colonna il più ristretto possibile per ridurre ulteriormente i costi di trasferimento. Il job CTAS viene visualizzato nella cronologia dei job e mostra informazioni come il numero di byte trasferiti. I trasferimenti riusciti comportano costi anche se il job di query principale non va a buon fine. Per saperne di più, consulta la pagina relativa ai prezzi di BigQuery Omni.
Considera la seguente query di esempio:
SELECT *
FROM bigquery_dataset.bigquery_table AS clients
WHERE clients.sales_rep IN (
  SELECT id
  FROM aws_dataset.aws_table1 AS employees
  INNER JOIN aws_dataset.aws_table2 AS active_employees
    ON employees.id = active_employees.id
  WHERE employees.level > 3
);
Questo esempio prevede due trasferimenti: uno da una tabella dei dipendenti (con un filtro per livello) e uno da una tabella dei dipendenti attivi. L'unione viene eseguita nella regione BigQuery dopo il trasferimento. Se un trasferimento non va a buon fine e l'altro sì, vengono comunque applicati i costi per il trasferimento di dati riuscito.
Limitazioni dei join di BigQuery Omni
- I join di BigQuery Omni non sono supportati nel livello senza costi di BigQuery e nella sandbox di BigQuery.
- Le aggregazioni potrebbero non essere trasferite alle regioni BigQuery Omni se la query contiene istruzioni
JOIN. - Ogni tabella temporanea viene utilizzata solo per una singola query BigQuery Omni e non viene riutilizzata anche se la stessa query viene ripetuta più volte.
- Il limite di dimensioni per ogni trasferimento è di 60 GB. In particolare, se applichi un filtro a una tabella BigLake e carichi il risultato, questo deve essere inferiore a 60 GB. Per richiedere un aumento, contatta l'assistenza. Non sono previsti limiti per i byte analizzati.
- Le query di join di BigQuery Omni utilizzano una quota interna sulla frequenza delle query. Se la frequenza delle query supera la quota, potresti ricevere un errore
All our servers are busy processing data transferred between regions. Nella maggior parte dei casi, la ripetizione della query dovrebbe funzionare. Contatta l'assistenza per aumentare la quota interna in modo da supportare una frequenza di query più elevata. - Le join di BigQuery Omni sono supportate solo nelle regioni BigQuery collocate con le regioni BigQuery Omni corrispondenti e nelle
USeEUmultiregioni. I join di BigQuery Omni eseguiti nelle multiregioniUSoEUpossono accedere ai dati solo nelle regioni BigQuery Omni rispettivamente degli Stati Uniti o dell'UE. - Se una query di join di BigQuery Omni fa riferimento a 10 o più set di dati di regioni BigQuery Omni, potrebbe non riuscire e generare un errore
Not found: Dataset <BigQuery dataset> was not found in
location <BigQuery Omni region>
. Per evitare questo problema, ti consigliamo di specificare esplicitamente una località quando esegui un join BigQuery Omni che fa riferimento a più di 10 set di dati. Tieni presente che se specifichi esplicitamente una regione BigQuery e la query contiene solo tabelle BigLake, la query viene eseguita come query BigQuery Omni e comporta costi di trasferimento di dati. - Non puoi eseguire query sulla pseudo-colonna
_FILE_NAMEcon i join di BigQuery Omni. - Quando fai riferimento alle colonne di una tabella BigLake in una clausola
WHERE, non puoi utilizzare valori letteraliINTERVALoRANGE. - I job di join di BigQuery Omni non segnalano il numero di byte elaborati e trasferiti da altri cloud. Queste informazioni sono disponibili nei job CTAS secondari creati nell'ambito dell'esecuzione delle query di BigQuery Omni.
- Le viste autorizzate e le routine autorizzate che fanno riferimento a tabelle o viste BigQuery Omni sono supportate solo nelle regioni BigQuery Omni.
- Se la query BigQuery Omni fa riferimento a colonne
STRUCT, non vengono applicati pushdown alle sottoquery remote. Per ottimizzare le prestazioni, valuta la possibilità di creare una vista nella regione di BigQuery Omni che estrae i campi necessari dalle colonneSTRUCTin singole colonne. - La regola di confronto non è supportata dai join di BigQuery Omni.
- I join di BigQuery Omni non supportano l'unione di viste BigQuery Omni utilizzando la clausola
ORDER BY.
Esempi di join di BigQuery Omni
La seguente query unisce una tabella orders in una regione BigQuery con una tabella lineitem in una regione BigQuery Omni:
SELECT
  l_shipmode,
  o_orderpriority,
  count(l_linenumber) AS num_lineitems
FROM bigquery_dataset.orders
JOIN aws_dataset.lineitem
  ON orders.o_orderkey = lineitem.l_orderkey
WHERE
  l_shipmode IN ('AIR', 'REG AIR')
  AND l_commitdate < l_receiptdate
  AND l_shipdate < l_commitdate
  AND l_receiptdate >= DATE '1997-01-01'
  AND l_receiptdate < DATE '1997-02-01'
GROUP BY l_shipmode, o_orderpriority
ORDER BY l_shipmode, o_orderpriority;
Questa query è suddivisa in parti locali e remote. La seguente query viene inviata alla regione BigQuery Omni per essere eseguita per prima. Il risultato è una tabella temporanea nella regione BigQuery. Puoi visualizzare questo job CTAS secondario e i relativi metadati nella cronologia dei job.
CREATE OR REPLACE TABLE temp_table
AS (
  SELECT
    l_shipmode,
    l_linenumber,
    l_orderkey
  FROM aws_dataset.lineitem
  WHERE
    l_shipmode IN ('AIR', 'REG AIR')
    AND l_commitdate < l_receiptdate
    AND l_shipdate < l_commitdate
    AND l_receiptdate >= DATE '1997-01-01'
    AND l_receiptdate < DATE '1997-02-01'
);
Dopo la creazione della tabella temporanea, l'operazione JOIN viene completata e viene eseguita la seguente query:
SELECT
  l_shipmode,
  o_orderpriority,
  count(l_linenumber) AS num_lineitems
FROM bigquery_dataset.orders
JOIN temp_table
  ON orders.o_orderkey = lineitem.l_orderkey
GROUP BY l_shipmode, o_orderpriority
ORDER BY l_shipmode, o_orderpriority;
Un altro esempio è la seguente unione di BigQuery Omni:
SELECT c_mktsegment, c_name
FROM bigquery_dataset.customer
WHERE c_mktsegment = 'BUILDING'
UNION ALL
SELECT c_mktsegment, c_name
FROM aws_dataset.customer
WHERE c_mktsegment = 'FURNITURE'
LIMIT 10;
In questa query, la clausola LIMIT non viene inviata alla regione BigQuery Omni. Tutti i clienti nel segmento di mercato FURNITURE vengono prima trasferiti nella regione BigQuery, quindi viene applicato il limite di 10.
Connettori
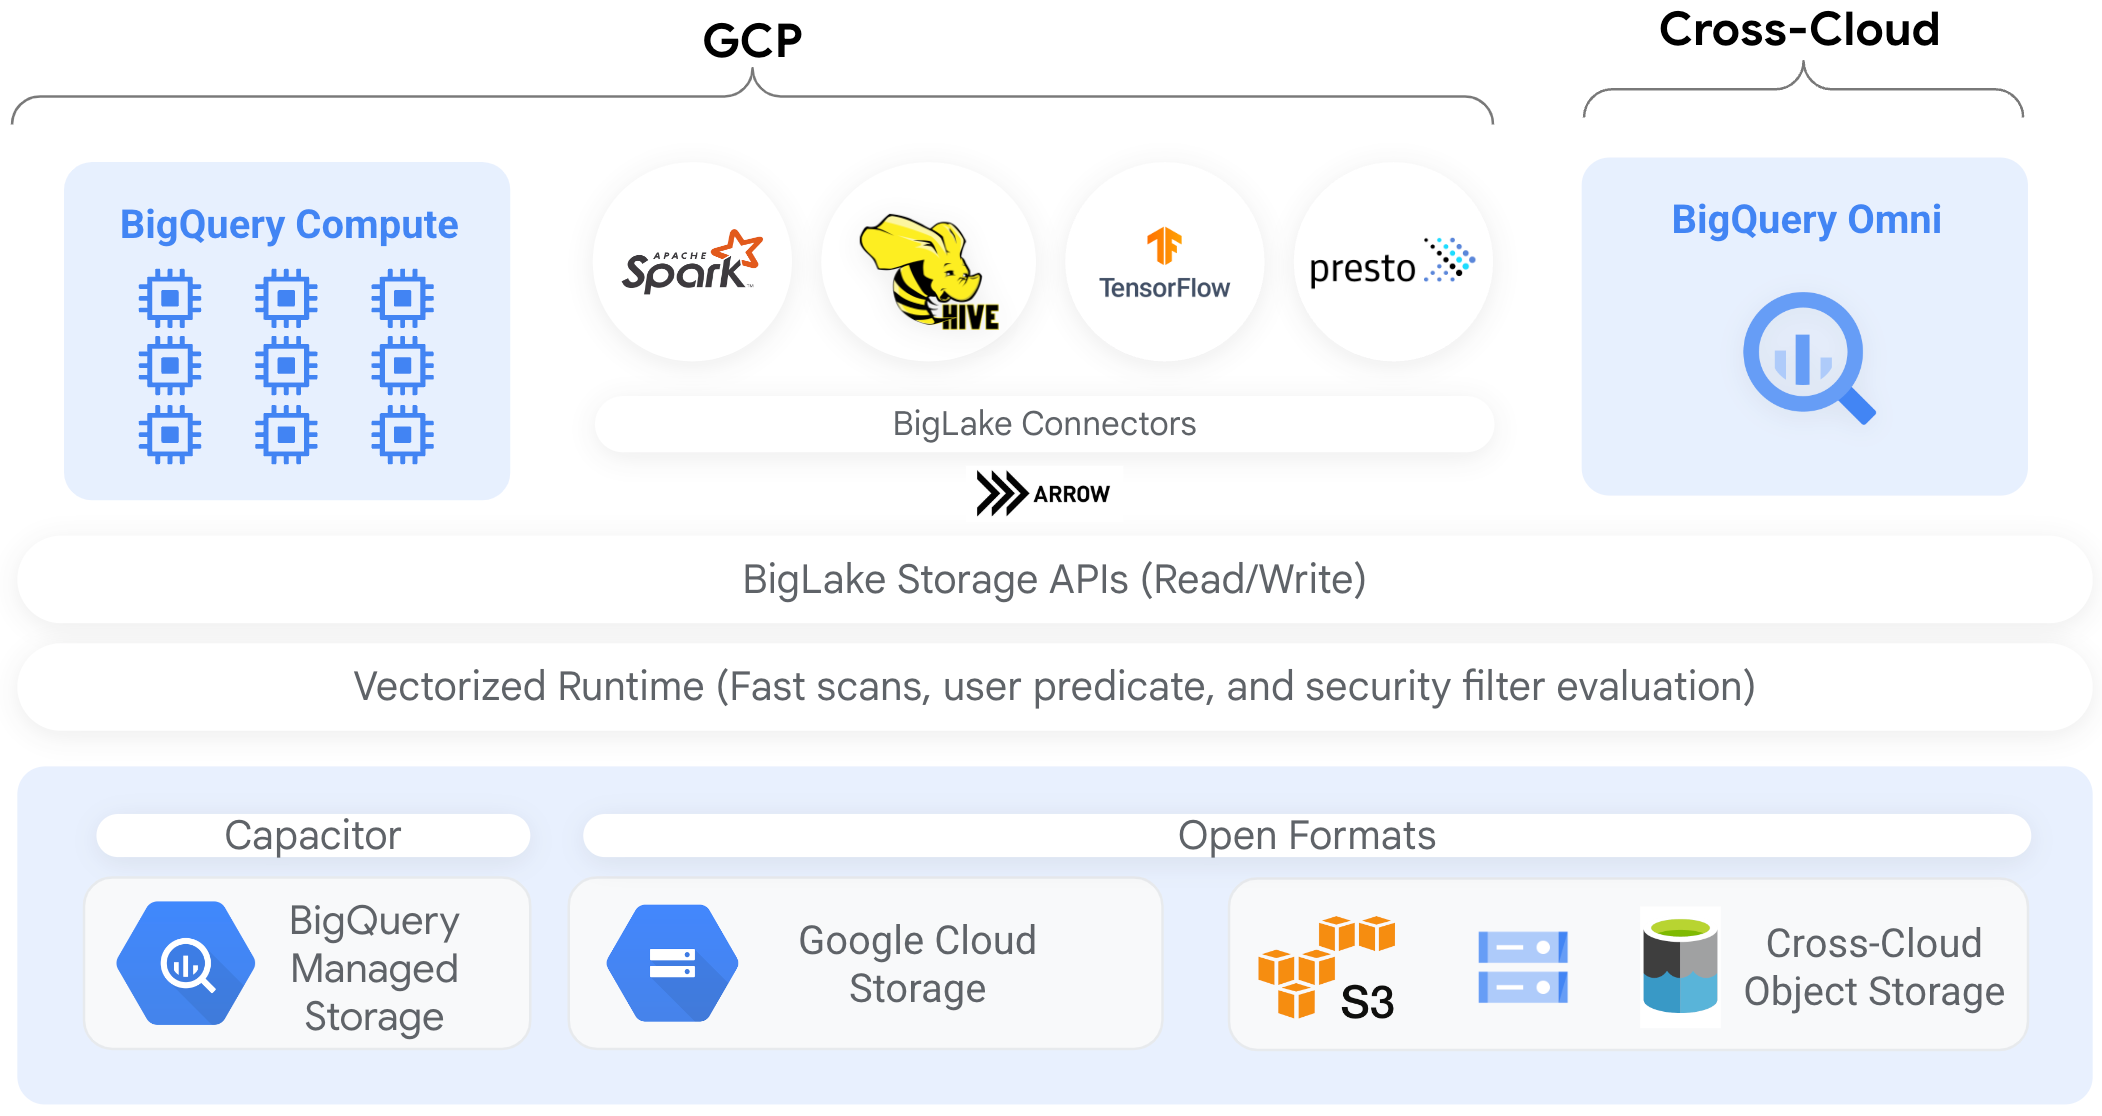
Puoi accedere ai dati nelle tabelle BigLake basate su Cloud Storage da altri strumenti di trattamento dati utilizzando i connettori BigQuery. Ad esempio, puoi accedere ai dati nelle tabelle BigLake da Apache Spark, Apache Hive, TensorFlow, Trino o Presto. L'API BigQuery Storage applica policy di governance a livello di riga e di colonna a tutti gli accessi ai dati delle tabelle BigLake, anche tramite connettori.
Ad esempio, il seguente diagramma mostra in che modo l'API BigQuery Storage consente agli utenti di accedere ai dati autorizzati utilizzando motori di query open source come Apache Spark:
Per saperne di più sui connettori supportati da BigQuery, consulta Connettori BigQuery.
Tabelle BigLake negli archivi di oggetti
Per gli amministratori di data lake, BigLake consente di impostare i controlli degli accessi sulle tabelle anziché sui file, offrendo opzioni più granulari per l'impostazione dell'accesso degli utenti ai dati nel data lake.
Poiché le tabelle BigLake semplificano controllo dell'accesso in questo modo, ti consigliamo di utilizzarle per creare e mantenere le connessioni agli archivi di oggetti esterni.
Puoi utilizzare le tabelle esterne nei casi in cui la governance non è un requisito o per l'esplorazione e la manipolazione dei dati ad hoc.
Limitazioni
- Tutte le limitazioni per le tabelle esterne si applicano alle tabelle BigLake.
- Le tabelle BigLake negli archivi di oggetti sono soggette alle stesse limitazioni delle tabelle BigQuery. Per scoprire di più, consulta Quote.
BigLake non supporta le credenziali con ambito ridotto provenienti dall'autenticazione del cluster personale di Managed Service for Apache Spark. Come soluzione alternativa, per utilizzare i cluster con l'autenticazione del cluster personale, devi inserire le tue credenziali utilizzando un Credential Access Boundary vuoto con il flag
--access-boundary=<(echo -n "{}"). Ad esempio, il seguente comando attiva una sessione di propagazione delle credenziali in un progetto denominatomyprojectper il cluster denominatomycluster:gcloud dataproc clusters enable-personal-auth-session \ --region=us \ --project=myproject \ --access-boundary=<(echo -n "{}") \ myclusterLe tabelle BigLake sono di sola lettura. Non puoi modificare le tabelle BigLake utilizzando istruzioni DML o altri metodi.
Le tabelle BigLake supportano i seguenti formati:
- Avro
- CSV
- Delta Lake
- Iceberg
- JSON
- ORC
- Parquet
Non puoi utilizzare i metadati memorizzati nella cache con le tabelle esterne Apache Iceberg; BigQuery utilizza già i metadati acquisiti da Iceberg nei file manifest.
L'API BigQuery Storage non è disponibile in altri ambienti cloud, come AWS e Azure.
Se utilizzi i metadati memorizzati nella cache, si applicano le seguenti limitazioni:
- Puoi utilizzare i metadati memorizzati nella cache solo con le tabelle BigLake che utilizzano i formati Avro, ORC, Parquet, JSON e CSV.
- Se crei, aggiorni o elimini file in Amazon S3, l'esecuzione di query sui file non restituisce i dati aggiornati fino al successivo aggiornamento della cache dei metadati. Questo può portare a risultati imprevisti. Ad esempio, se elimini un file e ne scrivi uno nuovo, i risultati della query potrebbero escludere sia il file precedente che quello nuovo, a seconda di quando sono stati aggiornati l'ultima volta i metadati memorizzati nella cache.
- L'utilizzo di chiavi di crittografia gestite dal cliente (CMEK) con metadati memorizzati nella cache non è supportato per le tabelle BigLake che fanno riferimento ai dati di Amazon S3 o Blob Storage.
Modello di sicurezza
I seguenti ruoli dell'organizzazione sono in genere coinvolti nella gestione e nell'utilizzo delle tabelle BigLake:
- Amministratori di data lake. In genere, questi amministratori gestiscono le policy di Identity and Access Management (IAM) su bucket Cloud Storage e oggetti.
- Amministratori di data warehouse. In genere, questi amministratori creano, eliminano e aggiornano le tabelle.
- Analisti di dati. Gli analisti in genere leggono i dati ed eseguono query.
Gli amministratori dei data lake sono responsabili della creazione delle connessioni e della loro condivisione con gli amministratori dei data warehouse. A loro volta, gli amministratori del data warehouse creano tabelle, impostano i controlli di accesso appropriati e condividono le tabelle con gli analisti di dati.
Memorizzazione nella cache dei metadati per le prestazioni
Puoi utilizzare i metadati memorizzati nella cache per migliorare le prestazioni delle query su alcuni tipi di tabelle BigLake. La memorizzazione nella cache dei metadati è particolarmente utile nei casi in cui lavori con un numero elevato di file o se i dati sono partizionati in Hive. I seguenti tipi di tabelle BigLake supportano la memorizzazione dei metadati nella cache:
- Tabelle BigLake Amazon S3
- Tabelle BigLake di Cloud Storage
I metadati includono nomi di file, informazioni di partizionamento e metadati fisici dei file, come i conteggi delle righe. Puoi scegliere se abilitare o meno la memorizzazione nella cache dei metadati su una tabella. Le query con un numero elevato di file e con filtri di partizione Apache Hive traggono il massimo vantaggio dalla memorizzazione nella cache dei metadati.
Se non attivi la memorizzazione nella cache dei metadati, le query sulla tabella devono leggere l'origine dati esterna per ottenere i metadati degli oggetti. La lettura di questi dati aumenta la latenza delle query; l'elenco di milioni di file dall'origine dati esterna può richiedere diversi minuti. Se abiliti la memorizzazione nella cache dei metadati, le query possono evitare di elencare i file dall'origine dati esterna e possono partizionare e ridurre i file più rapidamente.
La memorizzazione nella cache dei metadati si integra anche con il controllo delle versioni degli oggetti di Cloud Storage. Quando la cache viene compilata o aggiornata, acquisisce i metadati in base alla versione live degli oggetti Cloud Storage in quel momento. Di conseguenza, le query abilitate per la memorizzazione dei metadati nella cache leggono i dati corrispondenti alla versione specifica dell'oggetto memorizzato nella cache, anche se in Cloud Storage sono disponibili versioni più recenti. L'accesso ai dati da qualsiasi versione degli oggetti aggiornata successivamente in Cloud Storage richiede un aggiornamento della cache dei metadati.
Esistono due proprietà che controllano questa funzionalità:
- Staleness massima specifica quando le query utilizzano i metadati memorizzati nella cache.
- La modalità cache dei metadati specifica come vengono raccolti i metadati.
Quando la memorizzazione nella cache dei metadati è abilitata, specifichi l'intervallo massimo di inattività dei metadati accettabile per le operazioni sulla tabella. Ad esempio, se specifichi un intervallo di 1 ora, le operazioni sulla tabella utilizzano i metadati memorizzati nella cache se sono stati aggiornati nell'ultima ora. Se i metadati memorizzati nella cache sono più vecchi, l'operazione recupera i metadati dal datastore (Amazon S3 o Cloud Storage). Puoi specificare un intervallo di inattività compreso tra 30 minuti e 7 giorni.
Quando abiliti la memorizzazione nella cache dei metadati per le tabelle BigLake o degli oggetti, BigQuery attiva i job di aggiornamento della generazione dei metadati. Puoi scegliere di aggiornare la cache automaticamente o manualmente:
- Per gli aggiornamenti automatici, la cache viene aggiornata a un intervallo definito dal sistema, in genere compreso tra 30 e 60 minuti. L'aggiornamento automatico della cache è un buon approccio se i file nel datastore vengono aggiunti, eliminati o modificati a intervalli casuali. Se devi controllare i tempi di aggiornamento, ad esempio per attivare l'aggiornamento alla fine di un job di estrazione, trasformazione e caricamento, utilizza l'aggiornamento manuale.
Per gli aggiornamenti manuali, esegui la procedura di sistema
BQ.REFRESH_EXTERNAL_METADATA_CACHEper aggiornare la cache dei metadati in base a una pianificazione che soddisfi i tuoi requisiti. Per le tabelle BigLake, puoi aggiornare i metadati in modo selettivo fornendo le sottodirectory della directory dei dati della tabella. In questo modo puoi evitare l'elaborazione non necessaria dei metadati. L'aggiornamento manuale della cache è un buon approccio se i file nel datastore vengono aggiunti, eliminati o modificati a intervalli noti, ad esempio come output di una pipeline.Se esegui più aggiornamenti manuali contemporaneamente, solo uno andrà a buon fine.
La cache dei metadati scade dopo 7 giorni se non viene aggiornata.
Gli aggiornamenti della cache sia manuali che automatici vengono eseguiti con la priorità di query INTERACTIVE.
Utilizza le prenotazioni BACKGROUND
Se scegli di utilizzare gli aggiornamenti automatici, ti consigliamo di creare una prenotazione e poi un assegnazione con un tipo di prestazione BACKGROUND per il progetto che esegue i job di aggiornamento della cache dei metadati. Con le prenotazioni BACKGROUND, i job di aggiornamento utilizzano un pool di risorse dedicato che impedisce ai job di aggiornamento di competere con le query degli utenti e di non riuscire se non sono disponibili risorse sufficienti.
Sebbene l'utilizzo di un pool di slot condiviso non comporti costi aggiuntivi, l'utilizzo di prenotazioni BACKGROUND offre prestazioni più coerenti allocando un pool di risorse dedicato e migliora l'affidabilità dei job di aggiornamento e l'efficienza complessiva delle query in BigQuery.
Prima di impostarli, devi considerare l'interazione tra i valori dell'intervallo di inattività e della modalità di memorizzazione nella cache dei metadati. Considera i seguenti esempi:
- Se aggiorni manualmente la cache dei metadati per una tabella e imposti l'intervallo di inattività su 2 giorni, devi eseguire la procedura di sistema
BQ.REFRESH_EXTERNAL_METADATA_CACHEogni 2 giorni o meno se vuoi che le operazioni sulla tabella utilizzino i metadati memorizzati nella cache. - Se aggiorni automaticamente la cache dei metadati per una tabella e imposti l'intervallo di inattività su 30 minuti, è possibile che alcune delle tue operazioni sulla tabella leggano dal datastore se l'aggiornamento della cache dei metadati richiede più tempo rispetto alla consueta finestra di 30-60 minuti.
Per trovare informazioni sui job di aggiornamento dei metadati, esegui una query sulla vista INFORMATION_SCHEMA.JOBS, come mostrato nell'esempio seguente:
SELECT *
FROM `region-us.INFORMATION_SCHEMA.JOBS_BY_PROJECT`
WHERE job_id LIKE '%metadata_cache_refresh%'
AND creation_time > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 6 HOUR)
ORDER BY start_time DESC
LIMIT 10;
Per le tabelle BigLake di Cloud Storage basate su file Parquet, le statistiche della tabella vengono raccolte durante l'aggiornamento della cache dei metadati e utilizzate per migliorare i piani di query.
Per saperne di più, consulta Memorizzazione dei metadati nella cache.
Per saperne di più sull'impostazione delle opzioni di memorizzazione nella cache dei metadati, consulta Crea tabelle BigLake Amazon S3 o Crea tabelle BigLake Cloud Storage.
Tabelle abilitate per la cache con viste materializzate
Puoi utilizzare le viste materializzate sulle tabelle abilitate per la cache dei metadati di BigLake per migliorare le prestazioni e l'efficienza durante l'esecuzione di query sui dati strutturati archiviati in Cloud Storage o Amazon Simple Storage Service (Amazon S3). Queste viste materializzate funzionano come le viste materializzate sulle tabelle di archiviazione gestite da BigQuery, inclusi i vantaggi dell'aggiornamento automatico e dell'ottimizzazione intelligente.
Integrazioni
Le tabelle BigLake sono accessibili da una serie di altre funzionalità di BigQuery e servizi gcloud CLI, tra cui i seguenti servizi evidenziati.
BigQuery sharing (in precedenza Analytics Hub)
Le tabelle BigLake sono compatibili con la condivisione. I set di dati contenenti tabelle BigLake possono essere pubblicati come schede di condivisione. Gli abbonati alla condivisione possono iscriversi a queste schede, che eseguono il provisioning di un set di dati di sola lettura, chiamato set di dati collegato, nel loro progetto. Gli abbonati possono eseguire query su tutte le tabelle del set di dati collegato, incluse tutte le tabelle BigLake. Per saperne di più, consulta Visualizza e sottoscrivi le schede.
BigQuery ML
Puoi utilizzare BigQuery ML per addestrare ed eseguire modelli su BigLake in Cloud Storage.
Sensitive Data Protection
Sensitive Data Protection analizza le tabelle BigLake per identificare e classificare i dati sensibili. Se vengono rilevati dati sensibili, le trasformazioni di anonimizzazione di Sensitive Data Protection possono mascherare, eliminare o oscurare in altro modo questi dati.
Costi
I costi sono associati ai seguenti aspetti delle tabelle BigLake:
- Esecuzione di query sulle tabelle.
- Aggiornamento della cache dei metadati.
Se hai prenotazioni di slot, non ti vengono addebitati costi per le query su tabelle esterne. Invece, per queste query vengono consumati slot.
La tabella seguente mostra in che modo il modello di prezzi influisce sull'applicazione di questi costi:
Prezzi on demand |
Versioni Standard, Enterprise ed Enterprise Plus |
|
|---|---|---|
Query |
Ti vengono addebitati i byte elaborati dalle query degli utenti. |
Gli slot nelle assegnazioni di prenotazione con un QUERYtipo di prestazione vengono utilizzati durante il tempo di query. |
Aggiornamento manuale della cache dei metadati. |
Ti vengono addebitati i byte elaborati per aggiornare la cache. |
Gli slot nelle assegnazioni di prenotazioni con un tipo di job QUERY vengono utilizzati durante l'aggiornamento della cache. |
Aggiornamento automatico della cache dei metadati. |
Ti vengono addebitati i byte elaborati per aggiornare la cache. |
Gli slot nelle assegnazioni di prenotazioni con un tipo di job BACKGROUND vengono utilizzati durante l'aggiornamento della cache.Se non sono disponibili prenotazioni BACKGROUND per l'aggiornamento della cache dei metadati, BigQuery utilizza automaticamente gli slot nelle prenotazioni QUERY se utilizzi la versione Enterprise o Enterprise Plus. |
Ti vengono addebitati anche i costi per l'archiviazione e l'accesso ai dati da parte di Cloud Storage, Amazon S3 e Azure Blob Storage, in base alle linee guida sui prezzi di ciascun prodotto.
Quando BigQuery interagisce con Cloud Storage, potresti incorrere nei seguenti costi di Cloud Storage:
- Costi di archiviazione dei dati per la quantità di dati archiviati.
- Costi di recupero dei dati per l'accesso ai dati nelle classi di archiviazione Nearline, Coldline e Archive. Presta attenzione quando esegui query sulle tabelle o aggiorni la cache dei metadati per queste classi di archiviazione, poiché i costi possono essere significativi.
- Costi di utilizzo della rete per i dati che leggi in regioni diverse, ad esempio quando il set di dati BigQuery e il bucket Cloud Storage si trovano in regioni diverse.
- Costi per il trattamento dei dati. Tuttavia, non ti vengono addebitati costi per le chiamate API effettuate da BigQuery per tuo conto, ad esempio per elencare o recuperare risorse.
Passaggi successivi
- Scopri come eseguire l'upgrade delle tabelle esterne alle tabelle BigLake.
- Scopri come creare una tabella BigLake di Cloud Storage.
- Scopri come creare una tabella BigLake Amazon S3.
- Scopri come creare una tabella BigLake di Blob Storage.
- Scopri come creare controlli della qualità dei dati con Knowledge Catalog.