


Code mit dem Batch-SQL-Übersetzer migrieren
In diesem Dokument wird beschrieben, wie Sie mit dem Batch-SQL-Übersetzer in BigQuery Skripts, die in anderen SQL-Dialekten geschrieben sind, in GoogleSQL-Abfragen übersetzen. Sie können die Ergebnisse eines Übersetzungsjobs über die Google Cloud Console oder über die Befehlszeile einreichen und prüfen.
Eine Liste der von diesem SQL-Übersetzer unterstützten SQL-Dialekte finden Sie unter Unterstützte SQL-Dialekte.
Eine Liste der unterstützten Verarbeitungsstandorte finden Sie unter Standorte.
Hinweis
Führen Sie die folgenden Schritte aus, bevor Sie einen Übersetzungsjob senden.
SQL-Übersetzungen aktivieren
Aktivieren Sie die erforderliche API und rufen Sie die Berechtigungen ab, die für die Verwendung eines BigQuery-SQL-Übersetzers erforderlich sind. Weitere Informationen finden Sie unter SQL-Übersetzungen aktivieren.
Erforderliche Berechtigungen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen für die Ressource parent zuzuweisen, damit Sie die nötigen Berechtigungen zum Erstellen von Übersetzungsjobs mit dem interaktiven Übersetzer, der Übersetzungs-API oder dem Batch-SQL-Übersetzer haben:
-
Migrationsjobs ansehen und überwachen:
MigrationWorkflow-Betrachter (
roles/bigquerymigration.viewer) -
Migrationsjobs einreichen:
MigrationWorkflow-Bearbeiter (
roles/bigquerymigration.editor) -
Zugriff auf die Cloud Storage-Buckets für Eingabe- und Ausgabedateien:
Storage-Objekt-Administrator (
roles/storage.objectAdmin) für den Cloud Storage-Quell- und -Ziel-Bucket.
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Erstellen von Übersetzungsjobs mit dem interaktiven Übersetzer, der Übersetzungs-API oder dem Batch-SQL-Übersetzer erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um Übersetzungsjobs mit dem interaktiven Übersetzer, der Übersetzungs-API oder dem Batch-SQL-Übersetzer zu erstellen:
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.workflows.list -
bigquerymigration.workflows.delete -
bigquerymigration.subtasks.get -
bigquerymigration.subtasks.list -
storage.objects.get -
storage.objects.list -
storage.objects.create
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Quelldateien erfassen
Quelldateien müssen Textdateien sein, die gültigen SQL-Code für den Quelldialekt enthalten. Quelldateien können auch Kommentare enthalten. Versuchen Sie mithilfe der verfügbaren Methoden, die SQL-Gültigkeit zu prüfen.
Metadatendateien erstellen
Damit der Dienst genauere Übersetzungsergebnisse generieren kann, empfehlen wir die Bereitstellung von Metadatendateien. Dies ist jedoch nicht obligatorisch.
Zum Generieren der Metadateninformationen können Sie das dwh-migration-dumper-Befehlszeilentool verwenden. Nachdem Sie die Metadatendateien vorbereitet haben, können Sie diese zusammen mit den Quelldateien in den Quellordner für die Übersetzung aufnehmen. Der Übersetzer erkennt sie automatisch und nutzt sie zum Übersetzen von Quelldateien. Sie müssen keine zusätzlichen Einstellungen konfigurieren, um dies zu aktivieren.
Informationen zum Generieren von Metadateninformationen mit dem dwh-migration-dumper-Tool finden Sie unter Metadaten für die Übersetzung generieren.
YAML-Konfigurationsdateien erstellen
Optional können Sie YAML-Konfigurationsdateien erstellen und verwenden, um Ihre Batchübersetzungen anzupassen. Mit diesen Dateien können Sie Ihre Übersetzungsausgabe auf verschiedene Weise transformieren. Sie können beispielsweise eine YAML-Konfigurationsdatei erstellen, um die Groß-/Kleinschreibung eines SQL-Objekts während der Übersetzung zu ändern.
Wenn Sie eine YAML-Konfigurationsdatei verwenden möchten, laden Sie sie in den Cloud Storage-Bucket mit den Quelldateien hoch.
Eingabedateien nach Cloud Storage hochladen
Laden Sie die Quelldateien mit den Abfragen und Skripts, die Sie übersetzen möchten, in Cloud Storage hoch. Sie können auch beliebige Metadatendateien oder YAML-Konfigurationsdateien in denselben Cloud Storage-Bucket und dasselbe Verzeichnis hochladen, die die Quelldateien enthalten. Weitere Informationen zum Erstellen von Buckets und zum Hochladen von Dateien in Cloud Storage erhalten Sie unter Buckets erstellen und Objekte aus einem Dateisystem hochladen.
Auswählen, wie der Übersetzungsjob gesendet werden soll
Zum Senden eines Batchübersetzungsjobs haben Sie zwei Möglichkeiten:
Google Cloud Console: Job über eine Benutzeroberfläche konfigurieren und senden.
Befehlszeilentools: Beschreiben Sie den Job in einer Übersetzungs-Konfigurationsdatei und senden Sie ihn mit der Google Cloud CLI oder dem bq-Befehlszeilentool.
Bei beiden Optionen müssen Sie Ihre Quelldateien in Cloud Storage hochladen und bei beiden wird dieselbe Art von Übersetzungsjob erstellt. Ein Job, den Sie über die Befehlszeile einreichen, wird weiterhin in der Liste der Übersetzungsjobs in derGoogle Cloud -Konsole angezeigt.
Übersetzungsjob senden
Verwenden Sie eine der folgenden Optionen, um einen Übersetzungsjob zu starten und seinen Fortschritt anzuzeigen. Informationen zum Prüfen der Ergebnisse finden Sie unter Übersetzungsergebnisse ansehen.
Console
Bei diesen Schritten wird davon ausgegangen, dass Sie Quelldateien in einen Cloud Storage-Bucket hochgeladen haben.
So reichen Sie einen Batchübersetzungsjob über die Google Cloud Console ein:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Klicken Sie im Bereich SQL-Übersetzung auf Übersetzung starten.
Geben Sie unter Übersetzungskonfiguration Folgendes ein:
- Geben Sie unter Anzeigename einen Namen für den Übersetzungsjob ein. Der Name kann Buchstaben, Ziffern und Unterstriche enthalten.
- Wählen Sie unter Verarbeitungsort den Ort aus, an dem der Übersetzungsjob ausgeführt werden soll. Wenn Sie sich beispielsweise in Europa befinden und Ihre Daten keine Standortgrenzen überschreiten möchten, wählen Sie die Region
euaus. Der Übersetzungsjob funktioniert am besten, wenn Sie denselben Speicherort wie der Quelldatei-Bucket auswählen. - Wählen Sie unter Quelldialekt den SQL-Dialekt aus, den Sie übersetzen möchten.
- Wählen Sie als Zieldialekt die Option GoogleSQL aus.
Klicken Sie auf Weiter.
Geben Sie unter Details zum Dateispeicherort die Cloud Storage-Pfade an, die für die Übersetzungseingabe und -ausgabe verwendet werden sollen. Sie können die Pfade im Format
bucket_name/folder_name/eingeben oder die Option Durchsuchen verwenden, um zu einem Ordner zu navigieren.- Geben Sie unter Speicherort des Ausgabeverzeichnisses einen Pfad zum Cloud Storage-Zielordner für die übersetzten Dateien an. Dies dient als Stammverzeichnis für alle Übersetzungen.
- Wählen Sie einen oder mehrere Speicherorte für Eingabeverzeichnisse mit dem Pfad zu den zu übersetzenden SQL-Dateien aus.
- Jedem Eingabeverzeichnis kann bei Bedarf optional ein Name des Unterverzeichnisses für die Ausgabe unter dem Stamm-Ausgabeverzeichnis zugewiesen werden.
Klicken Sie auf Weiter.
Wählen Sie optionale Einstellungen aus, um Metadaten und zusätzliche Übersetzungen anzupassen.
Optional: Wenn Sie das Übersetzungsverhalten weiter anpassen möchten, erstellen Sie YAML-Konfigurationsdateien und legen Sie diese Dateien im Cloud Storage-Eingabe-Bucket ab. Mit diesen Dateien können Sie Objekte umbenennen, Optimierungen aktivieren, Übersetzungen mit Gemini verbessern und vieles mehr. Weitere Informationen zu YAML-Konfigurationsdateien finden Sie unter YAML-Konfigurationsdatei erstellen.
Klicken Sie auf Erstellen, um den Übersetzungsjob zu starten.
Nachdem Sie den Übersetzungsjob erstellt haben, können Sie den Status in der Liste der Übersetzungsjobs sehen.
bq
Wenn Sie die gcloud CLI oder das bq-Befehlszeilentool verwenden möchten, um einen Batchübersetzungsjob zu senden, führen Sie die folgenden Schritte aus.
Bei diesen Schritten wird davon ausgegangen, dass Sie Quelldateien in einen Cloud Storage-Bucket hochgeladen haben.
Übersetzungskonfigurationsdatei erstellen
In einer Übersetzungs-Konfigurationsdatei werden der Pfad zu den Quelldateien, das Ausgabeziel sowie die Quell- und Zielsprache Ihrer Übersetzung definiert. Sie können diese Datei entweder in YAML oder JSON schreiben.
Das folgende Beispiel zeigt eine YAML-Datei für die Übersetzungskonfiguration für eine Übersetzung von Teradata zu BigQuery:
tasks:
  translation_task:
    type: Teradata2BigQuery_Translation
    translationDetails:
      sourceTargetMapping:
      - sourceSpec:
          baseUri: gs://bq-translations/input
        targetSpec:
          relativePath: output
      targetBaseUri: gs://bq-translations
      targetTypes:
      - sql
      sourceEnvironment:
        defaultDatabase: default_db
        schemaSearchPath:
        - foo
Das folgende Beispiel zeigt eine JSON-Datei mit der Übersetzungskonfiguration für eine Übersetzung von Teradata zu BigQuery:
{
  "tasks": {
    "translation_task": {
      "type": "Teradata2BigQuery_Translation",
      "translationDetails": {
        "sourceTargetMapping": [
          {
            "sourceSpec": {
              "literal": {
                "literalString": "sel 1",
                "relativePath": "my_input_1"
              },
              "encoding": "UTF-8"
            }
          },
          {
            "sourceSpec": {
              "literal": {
                "literalString": "sel 2",
                "relativePath": "my_input_2"
              },
              "encoding": "UTF-8"
            }
          }
        ],
        "targetReturnLiterals": [
          "sql/my_input_1",
          "sql/my_input_2"
        ]
      }
    }
  }
}
Job mit der Google Cloud CLI einreichen
Verwenden Sie den folgenden Befehl, um einen Übersetzungsjob zu erstellen und den Workflow auszuführen:
gcloud bq migration-workflows create --location=LOCATION --config-file=CONFIG_FILE
Wenn Sie den Workflow erstellen und ausführen und sofort mit einem Link zum Workflow zurückkehren möchten, fügen Sie das Flag --async hinzu:
gcloud bq migration-workflows create --location=LOCATION --config-file=CONFIG_FILE --async
Verwenden Sie den folgenden Befehl, um Ihre Übersetzungsjobs aufzulisten:
gcloud bq migration-workflows list --location=LOCATION
Mit dem folgenden Befehl können Sie die Details eines bestimmten Übersetzungsjobs aufrufen:
gcloud bq migration-workflows describe projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Ersetzen Sie Folgendes:
LOCATION: Der Standort des Google Cloud -Projekts, in dem dieser Übersetzungsjob ausgeführt wird.CONFIG_FILE: der Pfad zu Ihrer Konfigurationsdatei für die Übersetzung.PROJECT_ID: Die ID des Google Cloud -Projekts, in dem dieser Übersetzungsjob ausgeführt wird.WORKFLOW_ID: die ID des Übersetzungsjobs.
Job mit dem bq-Befehlszeilentool einreichen
Verwenden Sie den folgenden Befehl, um den Übersetzungsjob auszuführen:
bq mk --migration_workflow --location=LOCATION --config_file=CONFIG_FILE
Verwenden Sie den folgenden Befehl, um alle Ihre Übersetzungsaufträge aufzulisten:
bq ls --migration_workflow --location=LOCATION
Mit dem folgenden Befehl können Sie Details zu einem bestimmten Übersetzungsjob aufrufen:
bq show --migration_workflow projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Verwenden Sie den folgenden Befehl, um einen Übersetzungsjob aus der Liste zu entfernen:
bq rm --migration_workflow projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Ersetzen Sie Folgendes:
LOCATION: Der Standort des Google Cloud -Projekts, in dem dieser Übersetzungsjob ausgeführt wird.CONFIG_FILE: der Pfad zu Ihrer Konfigurationsdatei für die Übersetzung.PROJECT_ID: Die ID des Google Cloud -Projekts, in dem dieser Übersetzungsjob ausgeführt wird.WORKFLOW_ID: die ID des Übersetzungsjobs.
Ausgabedateien abrufen
Die Ergebnisse des Übersetzungsjobs werden in das Cloud Storage-Verzeichnis geschrieben, das Sie im Feld targetBaseUri der Konfigurationsdatei für die Übersetzung festgelegt haben. Dieses Zielverzeichnis enthält die übersetzten Dateien, den Zusammenfassungsbericht zur Übersetzung und alle Dateien mit KI-Vorschlägen.
Verwenden Sie den folgenden Befehl, um die Ausgabe auf Ihren lokalen Computer zu kopieren:
gcloud storage cp --recursive TARGET_URI LOCAL_DIRECTORY
Ersetzen Sie Folgendes:
TARGET_URI: Ihr Zielbasis-URI, z. B.gs://my_data_bucket/teradata/output/.LOCAL_DIRECTORY: das lokale Verzeichnis, in dem die Dateien gespeichert werden.
Ihr Job wird auch in der Liste der Übersetzungsjobs in derGoogle Cloud Console angezeigt, obwohl Sie ihn über die Befehlszeile eingereicht haben. Informationen zum Prüfen der Qualität einer Übersetzungsausgabe finden Sie unter Übersetzungsausgabe ansehen.
Übersetzungsausgabe ansehen
Sie können die Ergebnisse eines Übersetzungsjobs in der Google Cloud Console ansehen, unabhängig davon, ob der Job über die Befehlszeile oder die Google Cloud Console eingereicht wurde. Der Batch-SQL-Übersetzer gibt die folgenden Dateien an das angegebene Ziel aus:
- Die übersetzten Dateien.
- Der Zusammenfassungsbericht für Übersetzungen im CSV-Format.
- Die Dateien mit KI-Vorschlägen.
Google Cloud Console-Ausgabe
So rufen Sie Details zu Übersetzungsjobs auf:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem Job, für den Sie die Übersetzungsdetails aufrufen möchten. Klicken Sie dann auf den Namen des Übersetzungsjobs. Sie sehen eine Sankey-Visualisierung, die die Gesamtqualität des Jobs, die Anzahl der Eingabezeilen mit Code (ohne Leerzeilen und Kommentare) und eine Liste der Probleme veranschaulicht, die während des Übersetzungsprozesses aufgetreten sind. Sie sollten die Fehlerbehebung von links nach rechts priorisieren. Probleme in einer frühen Phase können in späteren Phasen zu zusätzlichen Problemen führen.
Bewegen Sie den Mauszeiger auf die Fehler- oder Warnungsbalken und sehen Sie sich die Vorschläge an, um die nächsten Schritte zur Fehlerbehebung des Übersetzungsjobs zu ermitteln.
Wählen Sie den Tab Logzusammenfassung aus, um eine Übersicht über die Übersetzungsprobleme aufzurufen, einschließlich Problemkategorien, vorgeschlagene Aktionen und der Häufigkeit des jeweiligen Problems. Sie können auf die Balken der Sankey-Visualisierung klicken, um Probleme zu filtern. Sie können auch eine Problemkategorie auswählen, um die mit dieser Problemkategorie verknüpften Logeinträge aufzurufen.
Wählen Sie den Tab Logeinträge aus, um weitere Informationen zu jedem Übersetzungsproblem aufzurufen, einschließlich der Problemkategorie, des spezifischen Problemeintrags und eines Links zu der Datei, in der das Problem aufgetreten ist. Sie können auf die Balken der Sankey-Visualisierung klicken, um Probleme zu filtern. Sie können auf dem Tab Logeinträge ein Problem auswählen, um den Tab Code zu öffnen, der die Eingabe- und Ausgabedatei anzeigt, wenn zutreffend.
Klicken Sie auf den Tab Jobdetails, um Details zur Konfiguration des Übersetzungsjobs aufzurufen.
Zusammenfassender Bericht
Der Zusammenfassungsbericht ist eine CSV-Datei, die eine Tabelle aller Warn- und Fehlermeldungen enthält, die während des Übersetzungsjobs aufgetreten sind.
So rufen Sie die Zusammenfassungsdatei in der Google Cloud Console auf:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf den Jobnamen oder auf Weitere Optionen> Details anzeigen.
Klicken Sie auf dem Tab Jobdetails im Abschnitt Übersetzungsbericht auf translation_report.csv.
Klicken Sie auf der Seite Objektdetails auf den Wert in der Zeile Authentifizierte URL, um die Datei in Ihrem Browser anzuzeigen.
In der folgenden Tabelle werden die Spalten der Zusammenfassungsdatei beschrieben:
| Spalte | Beschreibung |
|---|---|
| Zeitstempel | Der Zeitstempel, zu dem das Problem aufgetreten ist. |
| FilePath | Der Pfad zur Quelldatei, mit der das Problem verknüpft ist. |
| FileName | Der Name der Quelldatei, mit der das Problem verknüpft ist. |
| Skriptzeile | Die Zeilennummer, in der das Problem aufgetreten ist |
| Skriptspalte | Die Spaltennummer, in der das Problem aufgetreten ist. |
| TranspilerComponent | Die interne Komponente des Übersetzungsmoduls, in der die Warnung oder der Fehler aufgetreten ist. Diese Spalte ist möglicherweise leer. |
| Umgebung | Die Übersetzungsdialektsumgebung, die der Warnung oder dem Fehler zugeordnet ist. Diese Spalte ist möglicherweise leer. |
| ObjectName | Das SQL-Objekt in der Quelldatei, die der Warnung oder dem Fehler zugeordnet ist. Diese Spalte ist möglicherweise leer. |
| Schweregrad | Der Schweregrad des Problems, entweder eine Warnung oder ein Fehler. |
| Kategorie | Die Kategorie des Übersetzungsproblems. |
| SourceType | Die Ursache des Problems. Der Wert in dieser Spalte kann entweder SQL sein, was auf ein Problem mit den SQL-Eingabedateien hinweist, oder METADATA, was auf ein Problem im Metadatenpaket hinweist. |
| Meldung | Warnmeldung oder Fehlermeldung des Übersetzungsproblems |
| ScriptContext | Das SQL-Snippet in der Quelldatei, die mit dem Problem verknüpft ist. |
| Aktion | Wir empfehlen, das Problem zu beheben. |
Tab „Code“
Auf dem Tab „Code“ haben Sie die Möglichkeit, weitere Informationen zu den Eingabe- und Ausgabedateien für einen bestimmten Übersetzungsjob zu prüfen. Auf dem Tab „Code“ können Sie die in einem Übersetzungsjob verwendeten Dateien untersuchen, einen direkten Vergleich einer Eingabedatei und ihrer Übersetzung ausführen und dabei Ungenauigkeiten ermitteln sowie Logzusammenfassungen und -einträge für eine bestimmte Datei in einem Job aufrufen.
So greifen Sie auf den Tab „Code“ zu:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf den Jobnamen oder auf Weitere Optionen> Details anzeigen.
Wählen Sie den Tab Code aus. Der Tab „Code“ besteht aus den folgenden Bereichen:

- Dateiexplorer: Enthält alle SQL-Dateien, die für die Übersetzung verwendet werden. Klicken Sie auf eine Datei, um die Ein- und Ausgabe der Übersetzung sowie alle Übersetzungsprobleme der Übersetzung aufzurufen.
- Gemini-optimierte Eingabe: Der Eingabe-SQL-Code, der von der Übersetzungs-Engine übersetzt wurde. Wenn Sie in der Gemini-Konfiguration benutzerdefinierte Gemini-Regeln für den Quell-SQL-Code angegeben haben, transformiert der Übersetzer zuerst die ursprüngliche Eingabe und übersetzt dann die Gemini-optimierte Eingabe. Wenn Sie die ursprüngliche Eingabe ansehen möchten, klicken Sie auf Ursprüngliche Eingabe ansehen.
- Übersetzungsausgabe: Das Übersetzungsergebnis. Wenn Sie in der Gemini-Konfiguration Gemini-Anpassungsregeln für das Ziel-SQL angegeben haben, wird die Transformation als Gemini-optimierte Ausgabe auf das übersetzte Ergebnis angewendet. Wenn eine mit Gemini optimierte Ausgabe verfügbar ist, können Sie auf die Schaltfläche Gemini-Vorschlag klicken, um sie anzusehen.
Optional: Wenn Sie eine Eingabedatei und die zugehörige Ausgabedatei im interaktiven BigQuery-SQL-Übersetzer ansehen möchten, klicken Sie auf Bearbeiten. Sie können die Dateien bearbeiten und die Ausgabedatei wieder in Cloud Storage speichern.
Tab "Konfiguration"
Auf dem Tab Konfiguration können Sie Ihre YAML-Konfigurationsdateien hinzufügen, umbenennen, aufrufen oder bearbeiten. Im Schema Explorer finden Sie die Dokumentation für unterstützte Konfigurationstypen, die Ihnen beim Schreiben Ihrer YAML-Konfigurationsdateien helfen. Nachdem Sie die YAML-Konfigurationsdateien bearbeitet haben, können Sie den Job noch einmal ausführen, um die neue Konfiguration zu verwenden.
So greifen Sie auf den Tab „Konfiguration“ zu:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf den Jobnamen oder auf Weitere Optionen> Details anzeigen.
Klicken Sie im Fenster Übersetzungsdetails auf den Tab Konfiguration.
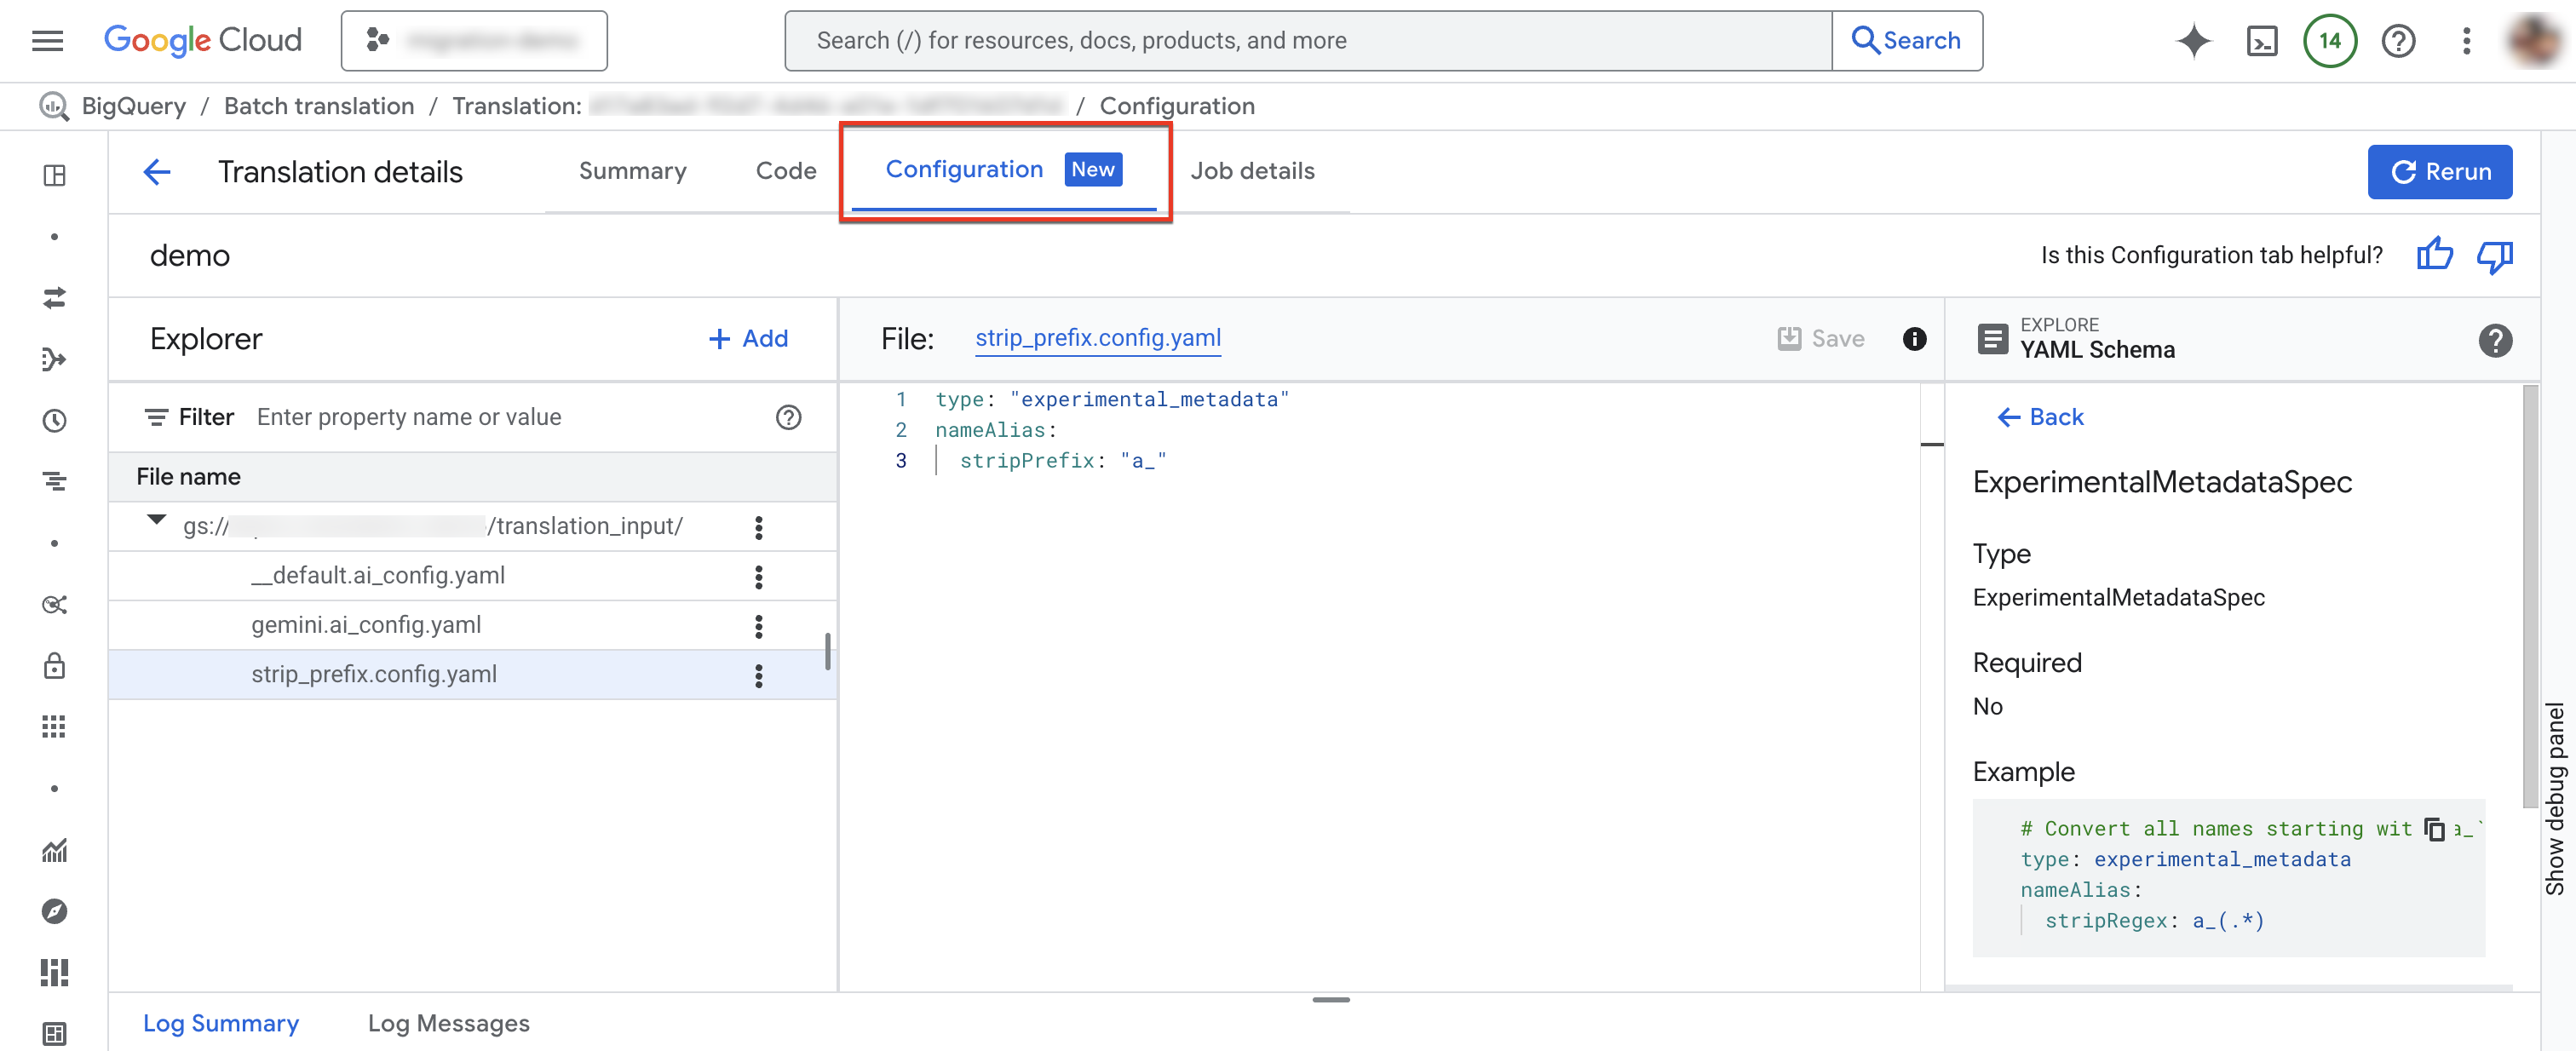
So fügen Sie eine neue Konfigurationsdatei hinzu:
- Klicken Sie auf more_vert Weitere Optionen > YAML-Konfigurationsdatei erstellen.
- Es wird ein Bereich angezeigt, in dem Sie den Typ, den Speicherort und den Namen der neuen YAML-Konfigurationsdatei auswählen können.
- Klicken Sie auf Erstellen.
So bearbeiten Sie eine vorhandene Konfigurationsdatei:
- Klicken Sie auf die YAML-Konfigurationsdatei.
- Bearbeiten Sie die Datei und klicken Sie dann auf Speichern.
- Klicken Sie auf Nochmal ausführen, um einen neuen Übersetzungsjob auszuführen, der die bearbeiteten YAML-Konfigurationsdateien verwendet.
Sie können eine vorhandene Konfigurationsdatei umbenennen, indem Sie auf das more_vert Weitere Optionen > Umbenennen klicken.
Übersetzte Dateien
Für jede Quelldatei wird eine entsprechende Ausgabedatei im Zielpfad generiert. Die Ausgabedatei enthält die übersetzte Abfrage.
Nicht unterstützte SQL-Funktionen mit Hilfs-UDFs verarbeiten
Beim Übersetzen von SQL aus einem Quelldialekt in BigQuery gibt es für einige Funktionen möglicherweise keine direkte Entsprechung. Um dieses Problem zu beheben, stellt der BigQuery-Migrationsdienst (und die BigQuery-Community im Allgemeinen) benutzerdefinierte Hilfsfunktionen (UDFs) bereit, die das Verhalten dieser nicht unterstützten Funktionen des Quelldialekts nachbilden.
Diese nutzerdefinierten Funktionen sind häufig im öffentlichen Dataset bqutil zu finden, sodass übersetzte Anfragen anfangs im Format bqutil.<dataset>.<function>() darauf verweisen können. Beispiel: bqutil.fn.cw_count()
Überlegungen zu Produktionsumgebungen
bqutil bietet zwar einen praktischen Zugriff auf diese Hilfs-UDFs für die erste Übersetzung und das Testen, die direkte Verwendung von bqutil für Produktionsarbeitslasten wird jedoch aus den folgenden Gründen nicht empfohlen:
- Versionsverwaltung: Das
bqutil-Projekt enthält die aktuelle Version dieser UDFs. Ihre Definitionen können sich also im Laufe der Zeit ändern. Wenn Sie sich direkt aufbqutilverlassen, kann es zu unerwartetem Verhalten oder Breaking Changes in Ihren Produktionsabfragen kommen, wenn die Logik einer UDF aktualisiert wird. - Abhängigkeitsisolation: Wenn Sie UDFs in Ihrem eigenen Projekt bereitstellen, wird Ihre Produktionsumgebung von externen Änderungen isoliert.
- Anpassung: Möglicherweise müssen Sie diese benutzerdefinierten Funktionen ändern oder optimieren, damit sie besser zu Ihrer spezifischen Geschäftslogik oder Ihren Leistungsanforderungen passen. Das ist nur möglich, wenn sie sich in Ihrem eigenen Projekt befinden.
- Sicherheit und Governance: Die Sicherheitsrichtlinien Ihrer Organisation schränken möglicherweise den direkten Zugriff auf öffentliche Datasets wie
bqutilfür die Verarbeitung von Produktionsdaten ein. Das Kopieren von UDFs in Ihre kontrollierte Umgebung entspricht solchen Richtlinien.
Hilfs-UDFs in Ihrem Projekt bereitstellen
Damit Sie die volle Kontrolle über die UDF-Version, die Anpassung und den Zugriff haben, empfehlen wir, Helper-UDFs in Ihrem eigenen Projekt und Dataset für eine zuverlässige und stabile Produktionsnutzung bereitzustellen. Weitere Informationen zu den erforderlichen Skripts und Schritten zum Bereitstellen von Hilfs-UDFs in Ihrer Umgebung finden Sie unter UDFs bereitstellen.
Fehlerbehebung
In diesem Abschnitt wird beschrieben, wie Sie einzelne Anfragen debuggen und die häufigsten Übersetzungsfehler beheben.
Batch-übersetzte SQL-Abfragen mit dem interaktiven SQL-Übersetzer debuggen
Mit dem interaktiven BigQuery-SQL-Übersetzer können Sie eine SQL-Abfrage mit denselben Metadaten oder Informationen zur Objektzuordnung wie Ihre Quelldatenbank überprüfen oder debuggen. Nachdem Sie einen Batchübersetzungsjob abgeschlossen haben, generiert BigQuery eine Übersetzungskonfigurations-ID, die Informationen zu den Metadaten des Jobs, zur Objektzuordnung oder zum Schemasuchpfad enthält, je nachdem, was für die Abfrage gilt. Sie verwenden die ID der Batchübersetzungskonfiguration mit dem interaktiven SQL-Übersetzer, um SQL-Abfragen mit der angegebenen Konfiguration auszuführen.
So starten Sie eine interaktive SQL-Übersetzung mithilfe einer Batchübersetzungskonfigurations-ID:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf Weitere Optionen> Interaktive Übersetzung öffnen.
Der interaktive BigQuery-SQL-Übersetzer wird jetzt mit der entsprechenden Batch-Übersetzungskonfigurations-ID geöffnet. Wenn Sie die ID der Übersetzungskonfiguration für die interaktive Übersetzung aufrufen möchten, klicken Sie im interaktiven SQL-Übersetzer auf Tools > Abfrageübersetzung > Übersetzungseinstellungen.
So debuggen Sie eine Batchübersetzungsdatei im interaktiven SQL-Übersetzer:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf den Jobnamen oder auf das Dreipunkt-Menü > Details anzeigen.
Klicken Sie im Fenster Übersetzungsdetails auf den Tab Code.
Klicken Sie im Datei-Explorer auf den Dateinamen, um die Datei zu öffnen.
Klicken Sie neben dem Ausgabedateinamen auf Bearbeiten, um die Dateien im interaktiven SQL-Übersetzer (Vorschau) zu öffnen.
Die Ein- und Ausgabedateien werden im interaktiven SQL-Übersetzer angezeigt, der jetzt die entsprechende Batchübersetzungskonfigurations-ID verwendet.
Wenn Sie die bearbeitete Ausgabedatei wieder in Cloud Storage speichern möchten, klicken Sie im interaktiven SQL-Übersetzer auf Speichern> In GCS speichern.
Übersetzungsfehler beheben
In den folgenden Abschnitten werden häufige Fehler bei der Verwendung des Batch-SQL-Übersetzers beschrieben.
Übersetzungsprobleme bei RelationNotFound oder AttributeNotFound
Nachdem Sie eine Abfrage mit dem Batch-SQL-Übersetzer übersetzt haben, kann es vorkommen, dass die Übersetzung mit dem Fehler RelationNotFound oder AttributeNotFound fehlschlägt.
Fehlgeschlagene Übersetzungen finden Sie in BigQuery in der Google Cloud Console auf der Seite Übersetzungsdetails auf dem Tab Log Messages (Log-Nachrichten).
Übersetzung funktioniert am besten mit Metadaten-DDLs. Wenn SQL-Objektdefinitionen nicht gefunden werden können, gibt die Übersetzungs-Engine RelationNotFound- oder AttributeNotFound-Probleme aus. Wir empfehlen die Verwendung des Metadaten-Extrahierers zum Generieren von Metadatenpaketen, um dafür zu sorgen, dass alle Objektdefinitionen vorhanden sind. Das Hinzufügen von Metadaten ist der erste empfohlene Schritt, um die meisten Übersetzungsfehler zu beheben, da oft viele andere Fehler behoben werden können, die indirekt durch ein Fehlen von Metadaten verursacht werden.
Weitere Informationen finden Sie unter Metadaten für Übersetzung und Bewertung generieren.
Übersetzungsprobleme mit Gemini beheben
Um fehlgeschlagene Übersetzungsjobs mit den Fehlern RelationNotFound oder AttributeNotFound zu beheben, können Sie auch Gemini verwenden:
- Rufen Sie die Seite Übersetzungsdetails auf und öffnen Sie den Tab Protokollnachrichten.
- Klicken Sie in der Spalte Kategorie auf die Abfrage mit der Meldung
RelationNotFoundoderAttributeNotFound. Wenn Sie zur Datei und Zeile mit dem Fehler auf dem Tab „Code“ wechseln möchten, klicken Sie auf das
Fehlermeldung.
Klicken Sie in der Spalte Aktion auf Vorgeschlagene Korrektur.
Wählen Sie eine der folgenden Optionen aus: Übernehmen oder Übernehmen und noch einmal ausführen:
- Wenn Sie die generierte Schemadatei aus dem Ausgabeverzeichnis in das Eingabeverzeichnis kopieren möchten, klicken Sie auf Übernehmen.
- Wenn Sie die generierte Schemadatei aus dem Ausgabeverzeichnis in das Eingabeverzeichnis kopieren und ein Fenster für die erneute Ausführung öffnen möchten, klicken Sie auf Übernehmen und noch einmal ausführen.
Kontingent und Limits
- Dafür gelten die Kontingente der BigQuery Migration API.
- Jedes Projekt kann höchstens 10 aktive Übersetzungsaufgaben haben.
- Die Gesamtzahl der Quell- und Metadatendateien ist zwar nicht begrenzt, es empfiehlt sich jedoch, die Anzahl der Dateien unter 1.000 zu halten, um eine bessere Leistung zu erzielen.
Preise
Für die Verwendung des Batch-SQL-Übersetzers fallen keine Kosten an. Für die Speicherung von Eingabe- und Ausgabedateien werden jedoch die normalen Gebühren berechnet. Weitere Informationen finden Sie unter Speicherpreise.
Nächste Schritte
Mehr über die folgenden Schritte bei der Data Warehouse-Migration erfahren:
- Übersicht über die Migration
- Migrationsbewertung
- Schema- und Datenübertragung
- Datenpipelines
- Interaktive SQL-Übersetzung
- Datensicherheit und Governance
- Datenvalidierungstool