


Code mit dem Batch-SQL-Übersetzer migrieren
In diesem Dokument wird beschrieben, wie Sie mit dem Batch-SQL-Übersetzer in BigQuery Skripts, die in anderen SQL-Dialekten geschrieben sind, in GoogleSQL-Abfragen übersetzen. Sie können die Ergebnisse eines Übersetzungsjobs über die Google Cloud Console oder die Befehlszeile einreichen und prüfen.
Eine Liste der von diesem SQL-Übersetzer unterstützten SQL-Dialekte finden Sie unter Unterstützte SQL-Dialekte.
Eine Liste der unterstützten Verarbeitungsstandorte finden Sie unter Standorte.
Hinweis
Führen Sie die folgenden Schritte aus, bevor Sie einen Übersetzungsjob senden.
SQL-Übersetzungen aktivieren
Aktivieren Sie die erforderliche API und rufen Sie die Berechtigungen ab, die für die Verwendung eines BigQuery-SQL-Übersetzers erforderlich sind. Weitere Informationen finden Sie unter SQL-Übersetzungen aktivieren.
Erforderliche Berechtigungen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen für die Ressource parent zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Erstellen von Übersetzungsjobs mit dem interaktiven Übersetzer, der Translation API oder dem Batch-SQL-Übersetzer benötigen:
-
Migrationsjobs ansehen und überwachen:
MigrationWorkflow-Betrachter (
roles/bigquerymigration.viewer) -
Migrationsjobs senden:
MigrationWorkflow-Bearbeiter (
roles/bigquerymigration.editor) -
Auf die Cloud Storage-Buckets für Eingabe und Dateien zugreifen: Storage-Objekt-Administrator (
roles/storage.objectAdmin) für den Cloud Storage-Quell- und -Ziel-Bucket.
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Erstellen von Übersetzungsjobs mit dem interaktiven Übersetzer, der Translation API oder dem Batch-SQL-Übersetzer erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um Übersetzungsjobs mit dem interaktiven Übersetzer, der Translation API oder dem Batch-SQL-Übersetzer zu erstellen:
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.workflows.list -
bigquerymigration.workflows.delete -
bigquerymigration.subtasks.get -
bigquerymigration.subtasks.list -
storage.objects.get -
storage.objects.list -
storage.objects.create
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Quelldateien erfassen
Quelldateien müssen Textdateien sein, die gültigen SQL-Code für den Quelldialekt enthalten. Quelldateien können auch Kommentare enthalten. Versuchen Sie mithilfe der verfügbaren Methoden, die SQL-Gültigkeit zu prüfen.
Metadatendateien erstellen
Damit der Dienst genauere Übersetzungsergebnisse generieren kann, empfehlen wir die Bereitstellung von Metadatendateien. Dies ist jedoch nicht obligatorisch.
Zum Generieren der Metadateninformationen können Sie das dwh-migration-dumper-Befehlszeilentool verwenden. Nachdem Sie die Metadatendateien vorbereitet haben, können Sie diese zusammen mit den Quelldateien in den Quellordner für die Übersetzung aufnehmen. Der Übersetzer erkennt sie automatisch und nutzt sie zum Übersetzen von Quelldateien. Sie müssen keine zusätzlichen Einstellungen konfigurieren, um dies zu aktivieren.
Informationen zum Generieren von Metadateninformationen mit dem dwh-migration-dumper-Tool finden Sie unter Metadaten für die Übersetzung generieren.
YAML-Konfigurationsdateien erstellen
Sie können optional YAML-Konfigurationsdateien erstellen und verwenden, um Ihre Batchübersetzungen anzupassen. Mit diesen Dateien können Sie die Übersetzungsausgabe auf verschiedene Weise transformieren. Sie können beispielsweise eine YAML-Konfigurationsdatei erstellen, um die Groß-/Kleinschreibung eines SQL-Objekts während der Übersetzung zu ändern.
Verwenden Sie eine der folgenden Optionen, um eine YAML-Konfigurationsdatei in Ihren Übersetzungsjob einzubinden.
Console
Laden Sie die YAML-Konfigurationsdatei in das Cloud Storage-Verzeichnis hoch, das Ihre Quelldateien enthält. Wenn Sie dieses Verzeichnis als Eingabespeicherort auswählen, wird die YAML-Konfigurationsdatei automatisch in den Übersetzungsjob einbezogen.
gcloud
Die Flags, die Sie mit dem Befehl gcloud alpha bq translation translate-batch verwenden, hängen davon ab, wo die YAML-Konfigurationsdatei gespeichert ist:
- Wenn sich die YAML-Konfigurationsdatei im selben Verzeichnis wie Ihre Quelldateien befindet, benötigen Sie keine zusätzlichen Flags. Wenn Sie dieses Verzeichnis im Flag
--source-gcs-urisoder--source-local-dirsfestlegen, enthält der Job die YAML-Konfigurationsdatei automatisch. - Wenn die YAML-Konfigurationsdatei separat auf Ihrem lokalen Computer gespeichert ist, verwenden Sie das Flag
--source-local-files, um sie hochzuladen und dem Job hinzuzufügen. - Wenn die YAML-Konfigurationsdatei separat in Cloud Storage gespeichert ist, verwenden Sie das Flag
--source-gcs-files, um sie dem Job hinzuzufügen.
Mit dem folgenden Befehl werden beispielsweise Ihre Quelldateien und eine separat gespeicherte YAML-Konfigurationsdatei von Ihrem lokalen Computer hochgeladen und dann der Übersetzungsjob ausgeführt:
gcloud alpha bq translation translate-batch \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --source-local-dirs=LOCAL_DIR=SOURCE_URI \
  --source-local-files=LOCAL_CONFIG_YAML=CONFIG_YAML_URI \
  --target-gcs-path=TARGET_URI
Ersetzen Sie Folgendes:
LOCAL_CONFIG_YAML: der lokale Pfad zur YAML-Konfigurationsdatei, z. B../configs/change-case.config.yaml.CONFIG_YAML_URI: der Cloud Storage-URI, in den der Befehl die YAML-Konfigurationsdatei hochlädt, z. B.gs://my_data_bucket/teradata/configs/change-case.config.yaml. Dieser URI muss sich außerhalb des VerzeichnissesSOURCE_URIbefinden.
Beschreibungen der anderen Platzhalter finden Sie unter Übersetzungsjob senden.
Eingabedateien nach Cloud Storage hochladen
Laden Sie die Quelldateien mit den Abfragen und Skripts, die Sie übersetzen möchten, in Cloud Storage hoch. Sie können auch beliebige Metadatendateien oder YAML-Konfigurationsdateien in denselben Cloud Storage-Bucket und dasselbe Verzeichnis hochladen, die die Quelldateien enthalten. Weitere Informationen zum Erstellen von Buckets und zum Hochladen von Dateien in Cloud Storage erhalten Sie unter Buckets erstellen und Objekte aus einem Dateisystem hochladen.
Auswählen, wie der Übersetzungsjob gesendet werden soll
Zum Senden eines Batchübersetzungsjobs haben Sie zwei Möglichkeiten:
Google Cloud Console: Job über eine Benutzeroberfläche konfigurieren und senden. Bei diesem Ansatz müssen Sie Quelldateien in Cloud Storage hochladen.
Google Cloud CLI: Senden Sie einen Job über die Befehlszeile mit der gcloud CLI. Der Befehl
translate-batchakzeptiert Ihre Quell- und Zielorte als Flags und kann lokale Verzeichnisse und Dateien für Sie in Cloud Storage hochladen. Weitere Informationen finden Sie unter Übersetzungsjob senden.
Bei beiden Optionen müssen Ihre Quelldateien in Cloud Storage zugänglich sein und beide erstellen dieselbe Art von Übersetzungsjob. Ein Job, den Sie über die Befehlszeile senden, wird weiterhin in der Liste der Übersetzungsjobs in derGoogle Cloud Console angezeigt.
Übersetzungsjob senden
Verwenden Sie eine der folgenden Optionen, um einen Übersetzungsjob zu starten und den Fortschritt zu verfolgen. Informationen zum Prüfen der Ergebnisse finden Sie unter Übersetzungsausgabe ansehen.
Console
Bei diesen Schritten wird davon ausgegangen, dass Sie Quelldateien in einen Cloud Storage-Bucket hochgeladen haben.
So senden Sie einen Batchübersetzungsjob über die Google Cloud Console:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Klicken Sie im Bereich SQL-Übersetzung auf Übersetzung starten.
Geben Sie unter Übersetzungskonfiguration Folgendes ein:
- Geben Sie unter Anzeigename einen Namen für den Übersetzungsjob ein. Der Name kann Buchstaben, Ziffern und Unterstriche enthalten.
- Wählen Sie unter Verarbeitungsort den Ort aus, an dem der Übersetzungsjob ausgeführt werden soll. Wenn Sie sich beispielsweise in Europa befinden und Ihre Daten keine Standortgrenzen überschreiten möchten, wählen Sie die Region
euaus. Der Übersetzungsjob funktioniert am besten, wenn Sie denselben Speicherort wie der Quelldatei-Bucket auswählen. - Wählen Sie unter Quelldialekt den SQL-Dialekt aus, den Sie übersetzen möchten.
- Wählen Sie als Zieldialekt GoogleSQL aus.
Klicken Sie auf Weiter.
Geben Sie unter Details zum Dateispeicherort die Cloud Storage-Pfade an, die für die Übersetzungseingabe und -ausgabe verwendet werden sollen. Sie können die Pfade im Format
bucket_name/folder_name/eingeben oder die Option Durchsuchen verwenden, um zu einem Ordner zu gelangen.- Geben Sie unter Speicherort des Ausgabeverzeichnisses den Pfad zum Cloud Storage-Zielordner für die übersetzten Dateien an. Dies dient als Stammverzeichnis für alle Übersetzungsausgaben.
- Wählen Sie einen oder mehrere Eingabeverzeichnisspeicherorte aus, die den Pfad zu den zu übersetzenden SQL-Dateien enthalten.
- Jedem Eingabeverzeichnis kann bei Bedarf optional ein Name für das Ausgabeunterverzeichnis unter dem Stammverzeichnis für die Ausgabe zugewiesen werden.
Klicken Sie auf Weiter.
Wählen Sie optionale Einstellungen aus, die Sie zum Anpassen von Metadaten und zusätzlichen Übersetzungsausgaben benötigen.
Optional: Wenn Sie das Übersetzungsverhalten weiter anpassen möchten, erstellen Sie YAML-Konfigurationsdateien und legen Sie diese im Cloud Storage-Eingabe-Bucket ab. Mit diesen Dateien können Sie Objekte umbenennen, Optimierungen aktivieren, Übersetzungen mit Gemini verbessern und vieles mehr. Weitere Informationen zu YAML-Konfigurationsdateien finden Sie unter YAML-Konfigurationsdatei erstellen.
Klicken Sie auf Erstellen, um den Übersetzungsjob zu starten.
Nachdem Sie den Übersetzungsjob erstellt haben, können Sie den Status in der Liste der Übersetzungsjobs sehen.
gcloud
Verwenden Sie den Befehl gcloud alpha bq translation translate-batch, um einen Batchübersetzungsjob zu senden.
Welche Flags Sie zum Identifizieren Ihrer Quelldateien verwenden, hängt davon ab, ob sich die Dateien in Cloud Storage oder auf Ihrem lokalen Computer befinden.
SQL-Dateien in Cloud Storage übersetzen
Wenn Sie SQL-Dateien übersetzen möchten, die Sie bereits in Cloud Storage hochgeladen haben, geben Sie die Quellverzeichnisse mit dem Flag --source-gcs-uris an. Wenn Sie Dateien einbeziehen möchten, die sich nicht in --source-gcs-uris befinden, können Sie das Flag --source-gcs-files verwenden:
gcloud alpha bq translation translate-batch \
    --source-dialect=SOURCE_DIALECT \
    --target-dialect=TARGET_DIALECT \
    --location=LOCATION \
    --source-gcs-uris=SOURCE_URI \
    --target-gcs-path=TARGET_URI
Ersetzen Sie Folgendes:
SOURCE_DIALECT: der Dialekt der SQL-Quelldateien, z. B.teradata. Die unterstützten Werte finden Sie unter Unterstützte SQL-Dialekte.TARGET_DIALECT: der Dialekt, in den die Quelldateien übersetzt werden sollen. Beispiel:bigquery.LOCATION: Der Standort, an dem der Job verarbeitet wird, z. B.us.SOURCE_URI: das Cloud Storage-Verzeichnis, das die Quelldateien enthält, z. B.gs://my_data_bucket/teradata/input/.TARGET_URI: das Cloud Storage-Verzeichnis, in dem die übersetzten Dateien gespeichert werden, z. B.gs://my_data_bucket/teradata/output/.
SQL-Dateien auf Ihrem lokalen Computer übersetzen
Wenn Sie Dateien auf Ihrem lokalen Computer übersetzen möchten, ordnen Sie jedes lokale Verzeichnis mit dem Flag --source-local-dirs einem Cloud Storage-URI zu. Mit dem Befehl wird das Verzeichnis in diesen URI hochgeladen und der URI dann in den Übersetzungsjob eingefügt. Sie müssen die Dateien also nicht selbst hochladen:
gcloud alpha bq translation translate-batch \
    --source-dialect=SOURCE_DIALECT \
    --target-dialect=TARGET_DIALECT \
    --location=LOCATION \
    --source-local-dirs=LOCAL_DIR=SOURCE_URI \
    --target-gcs-path=TARGET_URI
Ersetzen Sie LOCAL_DIR durch das lokale Verzeichnis, das die Quelldateien enthält, z. B. ./teradata_queries. Beschreibungen der anderen Platzhalter finden Sie unter SQL-Dateien in Cloud Storage übersetzen.
Wenn Sie einzelne Dateien anstelle von Verzeichnissen zuordnen möchten, verwenden Sie das Flag --source-local-files.
Optionale Flags hinzufügen
Wenn Sie Gemini-Vorschläge zusammen mit dem übersetzten SQL-Code generieren möchten, fügen Sie das Flag --enable-ai-suggestion hinzu.
Standardmäßig wartet der Befehl, bis der Übersetzungsjob abgeschlossen ist. Wenn Sie den Job senden und sofort zurückkehren möchten, fügen Sie das Flag --async hinzu. Der Befehl gibt dann eine Übersetzungs-ID aus, die Sie an den Befehl gcloud alpha bq translation describe übergeben können, um den Jobstatus zu prüfen:
gcloud alpha bq translation describe TRANSLATION_ID \
    --location=LOCATION
Ausgabedateien abrufen
Der Übersetzungsjob schreibt seine Ergebnisse in das Cloud Storage-Verzeichnis, das Sie im Flag --target-gcs-path festgelegt haben. Dieses Zielverzeichnis enthält die übersetzten Dateien, den Zusammenfassungsbericht der Übersetzung und alle KI-Vorschlagsdateien.
Verwenden Sie den folgenden Befehl, um die Ausgabe auf Ihren lokalen Computer zu kopieren:
gcloud storage cp --recursive TARGET_URI LOCAL_DIRECTORY
Ersetzen Sie Folgendes:
TARGET_URI: Ihr Ziel-Basis-URI, z. B.gs://my_data_bucket/teradata/output/.LOCAL_DIRECTORY: das lokale Verzeichnis, in dem die Dateien gespeichert werden.
Ihr Job wird auch in der Liste der Übersetzungsjobs in derGoogle Cloud Console angezeigt, obwohl Sie ihn über die Befehlszeile gesendet haben. Informationen zum Prüfen der Qualität einer Übersetzungsausgabe finden Sie unter Übersetzungsausgabe ansehen.
Metadaten übersetzen
Sie können nicht nur SQL-Skripts übersetzen, sondern auch die Metadaten, die Ihr Quell-Data-Warehouse beschreiben. Ein Metadatenübersetzungsjob liest die Metadatendateien, die Sie aus Ihrem Quellsystem extrahiert haben, und schreibt GoogleSQL-Anweisungen für die Datendefinitionssprache (DDL), die diese Objekte in BigQuery neu erstellen.
Die Eingabe besteht aus einer oder mehreren ZIP-Metadatendateien. Informationen zum Erstellen dieser Dateien mit dem dwh-migration-dumper-Tool finden Sie unter Metadaten für die Übersetzung generieren.
Sie können Metadaten entweder über die Google Cloud Console oder die gcloud CLI übersetzen. Wählen Sie eine der folgenden Optionen aus:
Console
Die Metadatenübersetzung ist eine Ausgabeoption für einen regulären Übersetzungsjob:
- Folgen Sie der Anleitung unter Übersetzungsjob senden, um einen Job zu konfigurieren. Verwenden Sie dabei das Cloud Storage-Verzeichnis, das Ihre Metadaten-ZIP-Dateien enthält, als Eingabespeicherort.
- Wählen Sie unter Optionale Einstellungen die Option DDL aus.
- Klicken Sie auf Erstellen, um den Job anzulegen.
Der Job schreibt die übersetzten DDL-Anweisungen zusammen mit dem übersetzten SQL-Code in Ihr Ausgabeverzeichnis.
gcloud
Sie können Metadaten entweder als eigenen Job oder als zusätzliche Ausgabe eines Batch-SQL-Übersetzungsjobs übersetzen.
Nur Metadaten übersetzen
Verwenden Sie den Befehl gcloud alpha bq translation translate-metadata, wenn Ihre Eingaben Metadaten-ZIP-Dateien sind und Sie keine SQL-Anweisungen zum Übersetzen haben:
gcloud alpha bq translation translate-metadata \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --source-gcs-uris=SOURCE_URI \
  --target-gcs-path=TARGET_URI
Ersetzen Sie Folgendes:
SOURCE_DIALECT: der Dialekt der Quellmetadaten, z. B.teradata. Die unterstützten Werte finden Sie unter Unterstützte SQL-Dialekte.TARGET_DIALECT: der Dialekt der Zieltabellen. Beispiel:bigquery.LOCATION: der Standort, an dem der Job verarbeitet wird, z. B.us.SOURCE_URI: das Cloud Storage-Verzeichnis, das die ZIP-Metadatendateien enthält, z. B.gs://my_data_bucket/teradata/metadata/.TARGET_URI: das Cloud Storage-Verzeichnis, in dem die übersetzten DDL-Anweisungen gespeichert werden, z. B.gs://my_data_bucket/teradata/ddl_output/.
Wenn Sie auf einzelne Metadaten-ZIP-Dateien statt auf ein Verzeichnis verweisen möchten, verwenden Sie das Flag --source-gcs-files. Wenn Sie Metadatendateien von Ihrem lokalen Computer als Teil des Jobs hochladen möchten, verwenden Sie das Flag --source-local-dirs oder --source-local-files.
Wie bei einem Batchübersetzungsjob wartet der Befehl, bis der Job abgeschlossen ist. Fügen Sie das Flag --async hinzu, um den Job zu senden und sofort eine Übersetzungs-ID zurückzugeben.
Metadaten im Rahmen einer Batch-SQL-Übersetzung übersetzen
Wenn Ihre Batchübersetzungseingaben bereits Ihre Metadaten-ZIP-Dateien enthalten, benötigen Sie keinen zweiten Job. Fügen Sie den Übersetzungsausgaben des Batchjobs mit dem Flag --target-types metadata hinzu. Der Job schreibt dann die übersetzten SQL- und DDL-Anweisungen in einem einzigen Durchlauf:
gcloud alpha bq translation translate-batch \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --source-gcs-uris=SOURCE_URI \
  --target-gcs-path=TARGET_URI \
  --target-types=sql,metadata
Informationen zu den anderen Flags, die der Befehl translate-batch akzeptiert, finden Sie unter Übersetzungsjob senden.
Quell-DDL generieren
Wenn Ihre SQL-Quelle auf Tabellen verweist, deren Definitionen Sie nicht haben, kann der Übersetzer die Objekte nicht immer auflösen. Dies führt zu RelationNotFound- oder AttributeNotFound-Problemen.
Am besten beheben Sie diese Probleme, indem Sie die tatsächlichen Definitionen Ihrer Quellobjekte angeben. Führen Sie das dwh-migration-dumper-Tool für Ihr Quellsystem aus und fügen Sie die resultierende Metadaten-ZIP-Datei in die Übersetzungseingaben ein. Eine Anleitung finden Sie unter Metadaten für die Übersetzung generieren.
Die extrahierten Metadaten beschreiben Ihre Objekte genau, sodass der Übersetzer sie ohne Rätselraten auflöst.
Wenn Sie keine Metadaten extrahieren können, z. B. weil Sie keinen Zugriff mehr auf das Quellsystem haben, können Sie Gemini bitten, die fehlenden DDL-Anweisungen stattdessen aus Ihrem Quell-SQL abzuleiten. Gemini leitet diese DDL-Anweisungen aus der Verwendung der Objekte in Ihren Abfragen ab. Prüfen und verifizieren Sie diese Anweisungen daher immer, bevor Sie sie verwenden.
Sie können Quell-DDL für Ihre Übersetzungen entweder mit derGoogle Cloud Console oder der gcloud CLI generieren. Wählen Sie eine der folgenden Optionen aus:
Console
Gemini generiert im Rahmen eines regulären Übersetzungsjobs Vorschläge für die Quell-DDL:
- Folgen Sie der Anleitung unter Übersetzungsjob senden, um einen Job zu konfigurieren.
- Wählen Sie unter Optionale Einstellungen die Option Google AI-Vorschläge aus.
- Klicken Sie auf Erstellen, um den Job anzulegen.
Wenn die Übersetzung zu RelationNotFound- oder AttributeNotFound-Problemen führt, generiert der Job vorgeschlagene Quell-DDL-Anweisungen für die nicht aufgelösten Objekte. Der Job übersetzt auch Ihren SQL-Code, sodass Sie keinen separaten Job benötigen.
gcloud
Der Befehl gcloud alpha bq translation generate-source-ddl liest Ihre Quell-SQL-Anweisungen und gibt vorgeschlagene Quell-DDL-Anweisungen zurück:
gcloud alpha bq translation generate-source-ddl \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --source-gcs-uris=SOURCE_URI \
  --target-gcs-path=TARGET_URI
Ersetzen Sie SOURCE_URI durch das Cloud Storage-Verzeichnis, das die SQL-Quelldateien enthält, und TARGET_URI durch das Cloud Storage-Verzeichnis, in dem die generierten DDL-Anweisungen gespeichert werden. Die anderen Platzhalter sind dieselben wie unter Metadaten übersetzen beschrieben.
Wenn Sie stattdessen Vorschläge im Rahmen eines Übersetzungsjobs generieren möchten, fügen Sie dem translate-batch-Befehl das Flag --enable-ai-suggestion hinzu.
Sie können die generierten DDL-Anweisungen dann als Eingabe für einen späteren Übersetzungsjob bereitstellen, um die Übersetzungsqualität zu verbessern. Weitere Informationen finden Sie unter Übersetzungsprobleme bei RelationNotFound oder AttributeNotFound.
Übersetzungsausgabe ansehen
Sie können die Ergebnisse eines Übersetzungsjobs in der Google Cloud Console prüfen, unabhängig davon, ob der Job über die Befehlszeile oder die Google Cloud Console gesendet wurde. Der Batch-SQL-Übersetzer gibt die folgenden Dateien an das angegebene Ziel aus:
- Die übersetzten Dateien.
- Der Zusammenfassungsbericht für Übersetzungen im CSV-Format.
- Die KI-Vorschlagsdateien.
Google Cloud Console-Ausgabe
So rufen Sie Details zu Übersetzungsjobs auf:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem Job, für den Sie die Übersetzungsdetails aufrufen möchten. Klicken Sie dann auf den Namen des Übersetzungsjobs. Sie sehen eine Sankey-Visualisierung, die die Gesamtqualität des Jobs, die Anzahl der Eingabezeilen des Codes (ohne Leerzeilen und Kommentare) und eine Liste der Probleme zeigt, die während des Übersetzungsprozesses aufgetreten sind. Sie sollten Korrekturen von links nach rechts priorisieren. Probleme in einer frühen Phase können in nachfolgenden Phasen zu weiteren Problemen führen.
Bewegen Sie den Mauszeiger auf die Fehler- oder Warnbalken und sehen Sie sich die Vorschläge an, um die nächsten Schritte zur Fehlerbehebung für den Übersetzungsjob zu ermitteln.
Wählen Sie den Tab Logzusammenfassung aus, um eine Übersicht über die Übersetzungsprobleme aufzurufen, einschließlich Problemkategorien, vorgeschlagene Aktionen und der Häufigkeit des jeweiligen Problems. Sie können auf die Balken der Sankey-Visualisierung klicken, um Probleme zu filtern. Sie können auch eine Problemkategorie auswählen, um die mit dieser Problemkategorie verknüpften Logeinträge aufzurufen.
Wählen Sie den Tab Logeinträge aus, um weitere Informationen zu jedem Übersetzungsproblem aufzurufen, einschließlich der Problemkategorie, des spezifischen Problemeintrags und eines Links zu der Datei, in der das Problem aufgetreten ist. Sie können auf die Balken der Sankey-Visualisierung klicken, um Probleme zu filtern. Sie können auf dem Tab Logeinträge ein Problem auswählen, um den Tab Code zu öffnen, der die Eingabe- und Ausgabedatei anzeigt, wenn zutreffend.
Klicken Sie auf den Tab Jobdetails, um Details zur Konfiguration des Übersetzungsjobs aufzurufen.
Zusammenfassender Bericht
Der Zusammenfassungsbericht ist eine CSV-Datei, die eine Tabelle aller Warn- und Fehlermeldungen enthält, die während des Übersetzungsjobs aufgetreten sind.
So rufen Sie die Zusammenfassungsdatei in der Google Cloud Console auf:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf den Jobnamen oder auf Weitere Optionen > Details anzeigen.
Klicken Sie auf dem Tab Jobdetails im Abschnitt Übersetzungsbericht auf translation_report.csv.
Klicken Sie auf der Seite Objektdetails auf den Wert in der Zeile Authentifizierte URL, um die Datei in Ihrem Browser anzuzeigen.
In der folgenden Tabelle werden die Spalten der Zusammenfassungsdatei beschrieben:
| Spalte | Beschreibung |
|---|---|
| Zeitstempel | Der Zeitstempel, zu dem das Problem aufgetreten ist. |
| FilePath | Der Pfad zur Quelldatei, mit der das Problem verknüpft ist. |
| FileName | Der Name der Quelldatei, mit der das Problem verknüpft ist. |
| Skriptzeile | Die Zeilennummer, in der das Problem aufgetreten ist |
| Skriptspalte | Die Spaltennummer, in der das Problem aufgetreten ist. |
| TranspilerComponent | Die interne Komponente des Übersetzungsmoduls, in der die Warnung oder der Fehler aufgetreten ist. Diese Spalte ist möglicherweise leer. |
| Umgebung | Die Übersetzungsdialektsumgebung, die der Warnung oder dem Fehler zugeordnet ist. Diese Spalte ist möglicherweise leer. |
| ObjectName | Das SQL-Objekt in der Quelldatei, die der Warnung oder dem Fehler zugeordnet ist. Diese Spalte ist möglicherweise leer. |
| Schweregrad | Der Schweregrad des Problems, entweder eine Warnung oder ein Fehler. |
| Kategorie | Die Kategorie des Übersetzungsproblems. |
| SourceType | Die Ursache des Problems. Der Wert in dieser Spalte kann entweder SQL sein, was auf ein Problem mit den SQL-Eingabedateien hinweist, oder METADATA, was auf ein Problem im Metadatenpaket hinweist. |
| Meldung | Warnmeldung oder Fehlermeldung des Übersetzungsproblems |
| ScriptContext | Das SQL-Snippet in der Quelldatei, die mit dem Problem verknüpft ist. |
| Aktion | Wir empfehlen, das Problem zu beheben. |
Tab „Code“
Auf dem Tab „Code“ haben Sie die Möglichkeit, weitere Informationen zu den Eingabe- und Ausgabedateien für einen bestimmten Übersetzungsjob zu prüfen. Auf dem Tab „Code“ können Sie die in einem Übersetzungsjob verwendeten Dateien untersuchen, einen direkten Vergleich einer Eingabedatei und ihrer Übersetzung ausführen und dabei Ungenauigkeiten ermitteln sowie Logzusammenfassungen und -einträge für eine bestimmte Datei in einem Job aufrufen.
So greifen Sie auf den Tab „Code“ zu:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf den Jobnamen oder auf Weitere Optionen > Details anzeigen.
Wählen Sie den Tab Code aus. Der Tab „Code“ enthält die folgenden Bereiche:
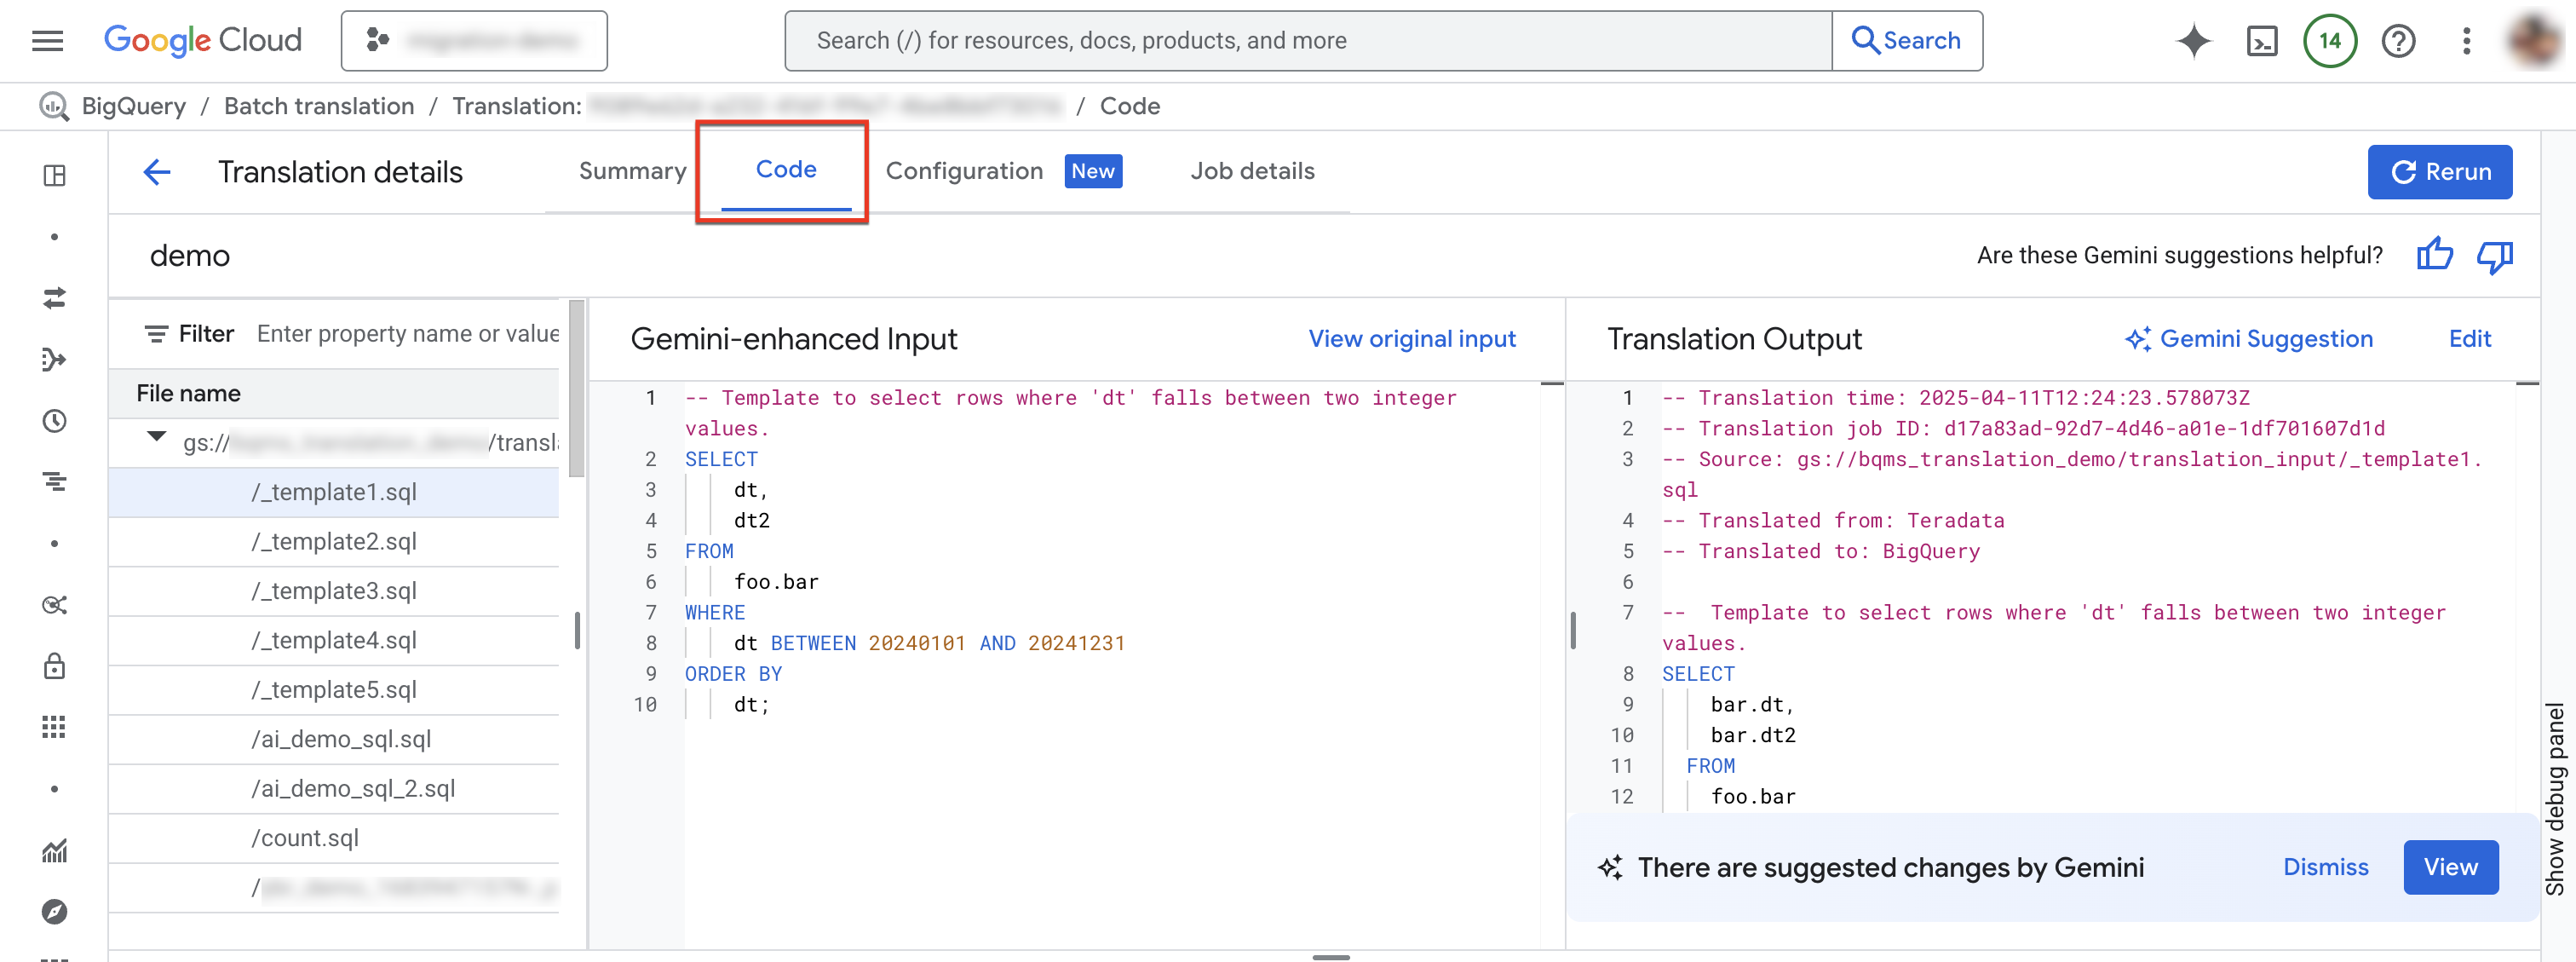
- Datei-Explorer: Enthält alle SQL-Dateien, die für die Übersetzung verwendet werden. Klicken Sie auf eine Datei, um die Übersetzungseingabe und -ausgabe sowie alle Übersetzungsprobleme aus der Übersetzung aufzurufen.
- Gemini-optimierte Eingabe: Der Eingabe-SQL-Code, der von der Übersetzungs-Engine übersetzt wurde. Wenn Sie in der Gemini-Konfiguration Gemini-Anpassungsregeln für das Quell-SQL angegeben haben, transformiert der Übersetzer zuerst die ursprüngliche Eingabe und übersetzt dann die von Gemini optimierte Eingabe. Klicken Sie auf Ursprüngliche Eingabe ansehen, um die ursprüngliche Eingabe aufzurufen.
- Übersetzungsausgabe: Das Übersetzungsergebnis. Wenn Sie in der Gemini-Konfiguration Gemini-Anpassungsregeln für die Ziel-SQL angegeben haben, wird die Transformation auf das übersetzte Ergebnis als Gemini-optimierte Ausgabe angewendet. Wenn eine mit Gemini optimierte Ausgabe verfügbar ist, können Sie auf den Button Gemini-Vorschlag klicken, um sie sich anzusehen.
Optional: Wenn Sie eine Eingabedatei und die zugehörige Ausgabedatei im interaktiven SQL-Übersetzer von BigQuery ansehen möchten, klicken Sie auf Bearbeiten. Sie können die Dateien bearbeiten und die Ausgabedatei wieder in Cloud Storage speichern.
Tab "Konfiguration"
Auf dem Tab Konfiguration können Sie Ihre YAML-Konfigurationsdateien hinzufügen, umbenennen, ansehen oder bearbeiten. Im Schema Explorer finden Sie die Dokumentation zu unterstützten Konfigurationstypen, die Ihnen beim Schreiben Ihrer YAML-Konfigurationsdateien hilft. Nachdem Sie die YAML-Konfigurationsdateien bearbeitet haben, können Sie den Job noch einmal ausführen, um die neue Konfiguration zu verwenden.
So greifen Sie auf den Tab „Konfiguration“ zu:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf den Jobnamen oder auf Weitere Optionen > Details anzeigen.
Klicken Sie im Fenster Übersetzungsdetails auf den Tab Konfiguration.
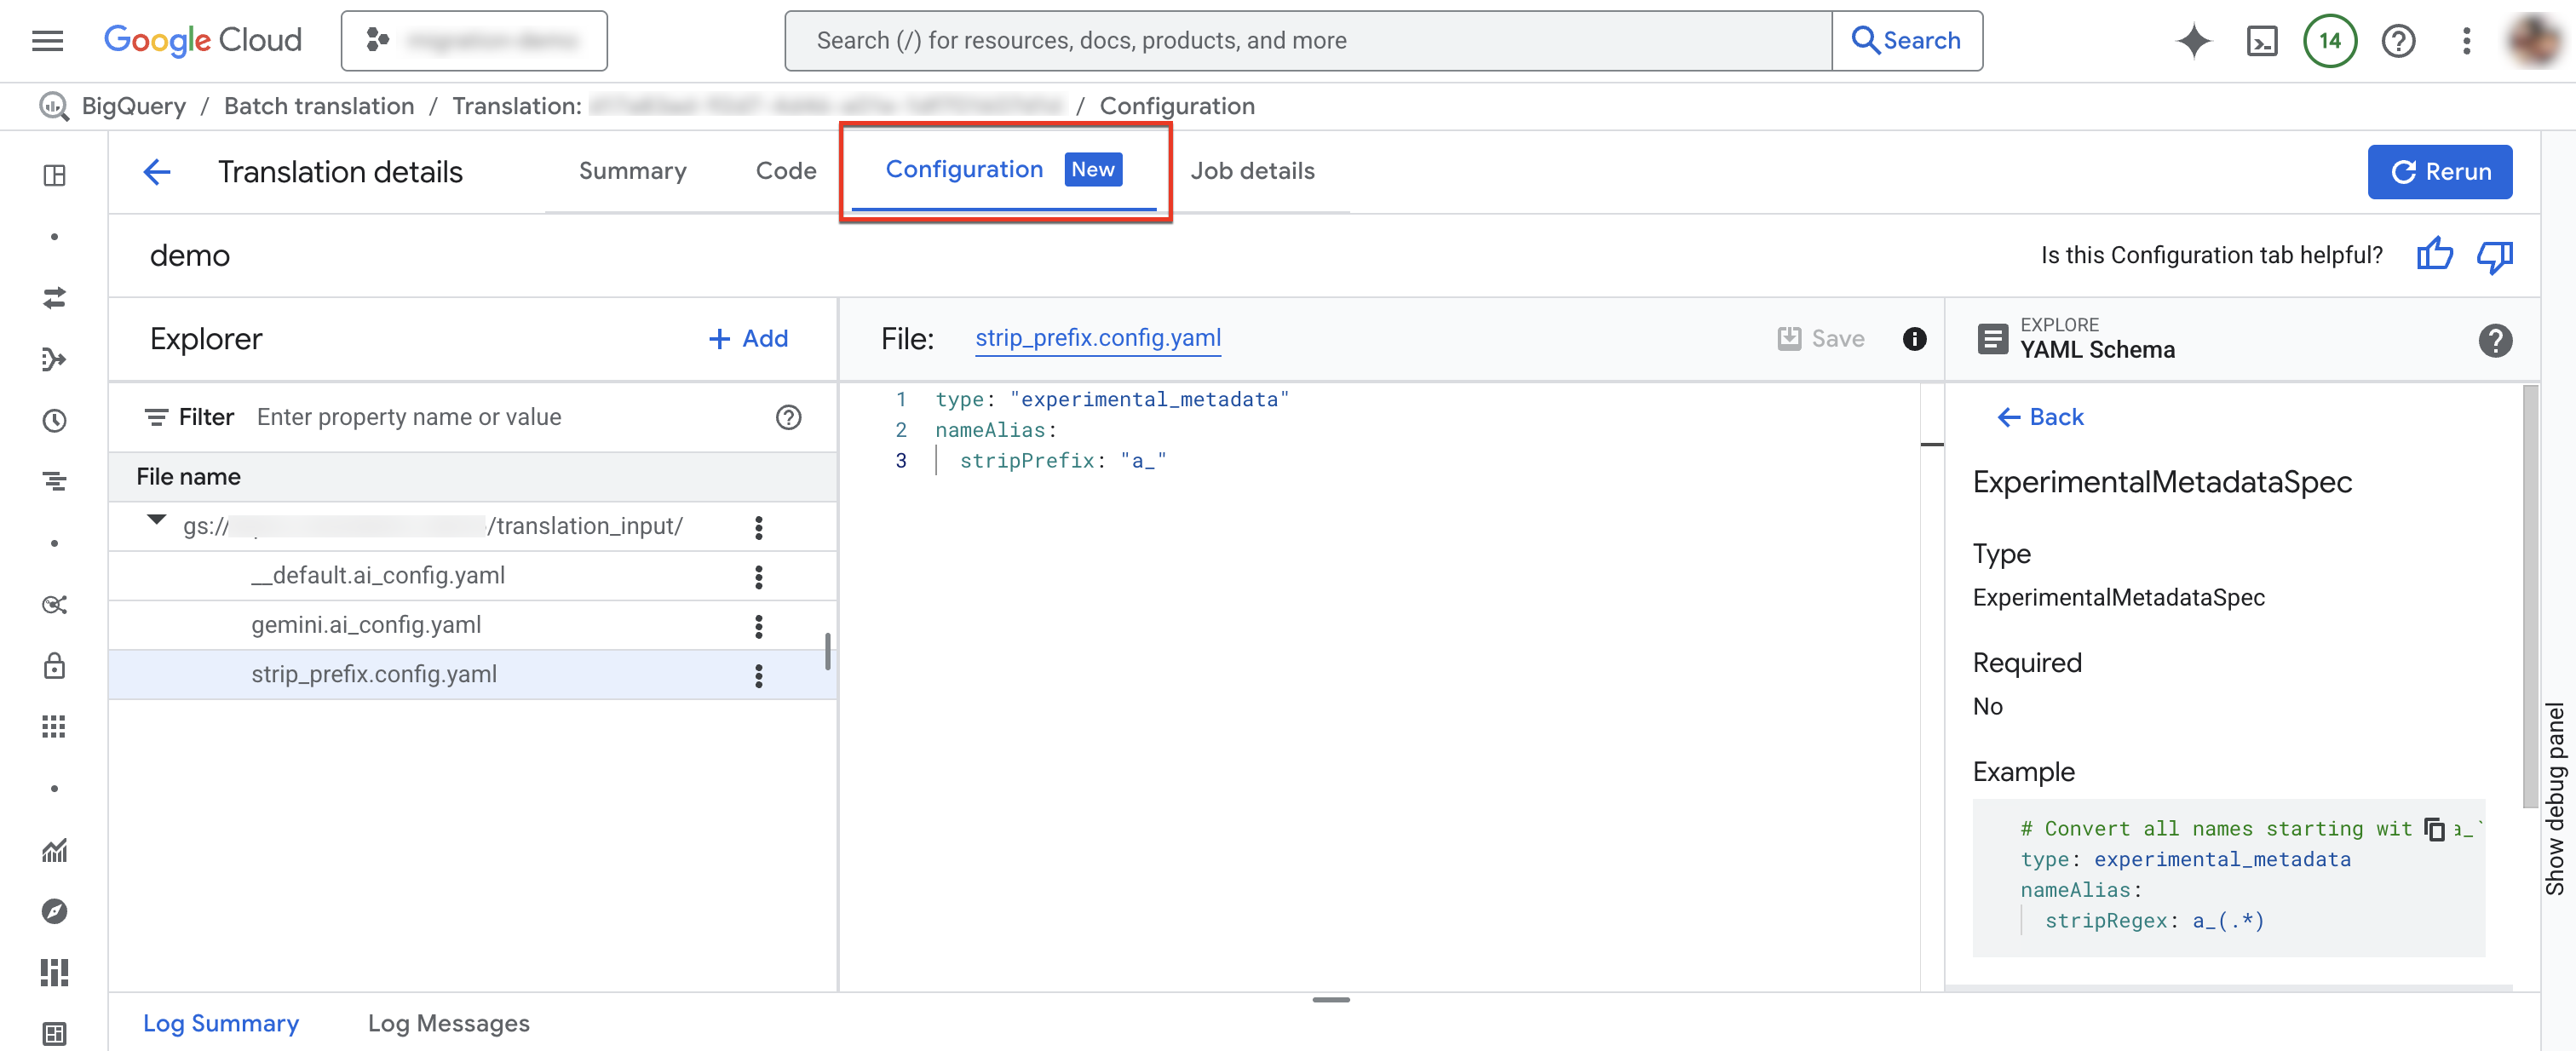
So fügen Sie eine neue Konfigurationsdatei hinzu:
- Klicken Sie auf more_vert Weitere Optionen > YAML-Konfigurationsdatei erstellen.
- Es wird ein Bereich angezeigt, in dem Sie den Typ, den Speicherort und den Namen der neuen YAML-Konfigurationsdatei auswählen können.
- Klicken Sie auf Erstellen.
So bearbeiten Sie eine vorhandene Konfigurationsdatei:
- Klicken Sie auf die YAML-Konfigurationsdatei.
- Bearbeiten Sie die Datei und klicken Sie dann auf Speichern.
- Klicken Sie auf Noch einmal ausführen, um einen neuen Übersetzungsjob auszuführen, der die bearbeiteten YAML-Konfigurationsdateien verwendet.
Sie können eine vorhandene Konfigurationsdatei umbenennen, indem Sie auf more_vert Weitere Optionen > Umbenennen klicken.
Übersetzte Dateien
Für jede Quelldatei wird eine entsprechende Ausgabedatei im Zielpfad generiert. Die Ausgabedatei enthält die übersetzte Abfrage.
Nicht unterstützte SQL-Funktionen mit Hilfs-UDFs verarbeiten
Wenn Sie SQL von einem Quelldialekt in BigQuery übersetzen, gibt es für einige Funktionen möglicherweise keine direkte Entsprechung. Um dieses Problem zu beheben, stellt der BigQuery-Migrationsdienst (und die BigQuery-Community im Allgemeinen) benutzerdefinierte Hilfsfunktionen (UDFs) bereit, die das Verhalten dieser nicht unterstützten Quelldialektfunktionen replizieren.
Diese UDFs befinden sich häufig im öffentlichen Dataset bqutil, sodass übersetzte Abfragen sie anfangs im Format bqutil.<dataset>.<function>() referenzieren können. Beispiel: bqutil.fn.cw_count()
Überlegungen zu Produktionsumgebungen
bqutil bietet zwar bequemen Zugriff auf diese Hilfs-UDFs für die erste Übersetzung und Tests, aber aus den folgenden Gründen wird nicht empfohlen, sich bei Produktionsarbeitslasten direkt auf bqutil zu verlassen:
- Versionsverwaltung: Das Projekt
bqutilhostet die neueste Version dieser UDFs. Das bedeutet, dass sich ihre Definitionen im Laufe der Zeit ändern können. Wenn Sie sich direkt aufbqutilverlassen, kann dies zu unerwartetem Verhalten oder funktionsgefährdenden Änderungen in Ihren Produktionsabfragen führen, wenn die Logik einer UDF aktualisiert wird. - Abhängigkeitsisolation: Wenn Sie UDFs in Ihrem eigenen Projekt bereitstellen, wird Ihre Produktionsumgebung von externen Änderungen isoliert.
- Anpassung: Möglicherweise müssen Sie diese UDFs ändern oder optimieren, um sie besser an Ihre spezifische Geschäftslogik oder Ihre Leistungsanforderungen anzupassen. Dies ist nur möglich, wenn sie sich in Ihrem eigenen Projekt befinden.
- Sicherheit und Governance: Die Sicherheitsrichtlinien Ihrer Organisation schränken möglicherweise den direkten Zugriff auf öffentliche Datasets wie
bqutilfür die Verarbeitung von Produktionsdaten ein. Das Kopieren von UDFs in Ihre kontrollierte Umgebung entspricht diesen Richtlinien.
Hilfs-UDFs in Ihrem Projekt bereitstellen
Damit Sie die volle Kontrolle über die UDF-Version, die Anpassung und den Zugriff haben, empfehlen wir, Hilfs-UDFs in Ihrem eigenen Projekt und Dataset bereitzustellen, um eine zuverlässige und stabile Produktion zu ermöglichen. Weitere Informationen zu den erforderlichen Skripts und Schritten zum Bereitstellen von Hilfs-UDFs in Ihrer Umgebung finden Sie unter UDFs bereitstellen.
Fehlerbehebung
In diesem Abschnitt wird beschrieben, wie Sie einzelne Abfragen debuggen und die häufigsten Übersetzungsfehler beheben.
SQL-Abfragen, die per Batch-Übersetzung übersetzt wurden, mit dem interaktiven SQL-Übersetzer debuggen
Mit dem interaktiven SQL-Übersetzer von BigQuery können Sie eine SQL-Abfrage mit denselben Metadaten oder Objektzuordnungsinformationen wie in Ihrer Quelldatenbank prüfen oder debuggen. Nachdem Sie einen Batchübersetzungsjob abgeschlossen haben, generiert BigQuery eine Übersetzungskonfigurations-ID, die Informationen zu den Metadaten des Jobs, zur Objektzuordnung oder zum Schemasuchpfad enthält, je nachdem, was für die Abfrage gilt. Sie verwenden die Konfigurations-ID für die Batchübersetzung mit dem interaktiven SQL-Übersetzer, um SQL-Abfragen mit der angegebenen Konfiguration auszuführen.
Sie können im Batch übersetzte SQL-Abfragen entweder mit derGoogle Cloud Console oder der gcloud CLI debuggen. Wählen Sie eine der folgenden Optionen aus:
Console
So starten Sie eine interaktive SQL-Übersetzung mit einer Batchübersetzungskonfigurations-ID:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf Weitere Optionen > Interaktive Übersetzung öffnen.
Der interaktive BigQuery-SQL-Übersetzer wird jetzt mit der entsprechenden Konfigurations-ID für die Batchübersetzung geöffnet. Wenn Sie die Übersetzungskonfigurations-ID für die interaktive Übersetzung aufrufen möchten, klicken Sie im interaktiven SQL-Übersetzer auf Tools > Abfrageübersetzung > Übersetzungseinstellungen.
So debuggen Sie eine Batchübersetzungsdatei im interaktiven SQL-Übersetzer:
Rufen Sie in der Google Cloud Console die Seite SQL-Übersetzung auf.
Suchen Sie in der Liste der Übersetzungsjobs nach dem gewünschten Job und klicken Sie dann auf den Jobnamen oder auf Weitere Optionen > Details anzeigen.
Klicken Sie im Fenster Übersetzungsdetails auf den Tab Code.
Klicken Sie im Datei-Explorer auf den Dateinamen, um die Datei zu öffnen.
Klicken Sie neben dem Namen der Ausgabedatei auf Bearbeiten, um die Dateien im interaktiven SQL-Übersetzer (Vorschau) zu öffnen.
Die Eingabe- und Ausgabedateien werden im interaktiven SQL-Übersetzer ausgefüllt, der jetzt die entsprechende Batch-Konfigurations-ID verwendet.
Wenn Sie die bearbeitete Ausgabedatei wieder in Cloud Storage speichern möchten, klicken Sie im interaktiven SQL-Übersetzer auf Speichern > In GCS speichern.
gcloud
Wenn Sie eine einzelne Abfrage noch einmal übersetzen und prüfen möchten, ohne dieGoogle Cloud Console zu öffnen, verwenden Sie den Befehl gcloud alpha bq translation translate.
Dies ist nützlich, wenn Sie ein Problem mit der Batchübersetzung auf eine Abfrage eingegrenzt haben und diese lokal iterieren möchten.
gcloud alpha bq translation translate \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --input-file=INPUT_FILE \
  --output-file=OUTPUT_FILE \
  --translation-log-file=LOG_FILE \
  --explanation-output-file=EXPLANATION_FILE
Ersetzen Sie Folgendes:
INPUT_FILE: die lokale Datei mit der zu übersetzenden Abfrage. Wenn Sie dieses Flag weglassen, liest der Befehl die Abfrage aus der Standardeingabe.OUTPUT_FILE: die lokale Datei, die die übersetzte Abfrage empfängt. Wenn Sie dieses Flag weglassen, wird die Abfrage in die Standardausgabe geschrieben.LOG_FILE: die lokale YAML-Datei, die die Übersetzungslogs empfängt, die dieselben Problemmeldungen enthalten, die in derGoogle Cloud -Konsole auf dem Tab Logeinträge angezeigt werden.EXPLANATION_FILE: die lokale Datei, die eine von Gemini generierte Erklärung der Übersetzung erhält.
Wenn Sie die Metadaten aus Ihrem Batchjob wiederverwenden möchten, damit die Abfrage dieselben Objekte auflöst, fügen Sie das Flag --metadata-gcs-uri hinzu. Weitere Informationen finden Sie unter Abfrage in GoogleSQL übersetzen.
Fehler bei der Übersetzung beheben
In den folgenden Abschnitten werden häufig auftretende Fehler bei der Verwendung des Batch-SQL-Übersetzers beschrieben.
Probleme mit der Übersetzung von RelationNotFound oder AttributeNotFound
Nachdem Sie eine Abfrage mit dem Batch-SQL-Übersetzer übersetzt haben, kann es zu einer fehlgeschlagenen Übersetzung mit dem Fehler RelationNotFound oder AttributeNotFound kommen.
Fehlgeschlagene Übersetzungen finden Sie in BigQuery in der Google Cloud Console auf der Seite Übersetzungsdetails. Öffnen Sie dort den Tab Logeinträge.
Übersetzung funktioniert am besten mit Metadaten-DDLs. Wenn SQL-Objektdefinitionen nicht gefunden werden können, gibt die Übersetzungs-Engine RelationNotFound- oder AttributeNotFound-Probleme aus. Wir empfehlen die Verwendung des Metadaten-Extrahierers zum Generieren von Metadatenpaketen, um dafür zu sorgen, dass alle Objektdefinitionen vorhanden sind. Das Hinzufügen von Metadaten ist der erste empfohlene Schritt, um die meisten Übersetzungsfehler zu beheben, da oft viele andere Fehler behoben werden können, die indirekt durch ein Fehlen von Metadaten verursacht werden.
Weitere Informationen finden Sie unter Metadaten für Übersetzung und Bewertung generieren.
Übersetzungsprobleme mit Gemini beheben
Wenn Sie fehlgeschlagene Übersetzungsjobs mit den Fehlern RelationNotFound oder AttributeNotFound beheben möchten, können Sie diese Probleme auch mit Gemini lösen:
- Rufen Sie die Seite Übersetzungsdetails auf und öffnen Sie den Tab Logeinträge.
- Klicken Sie auf die Abfrage, die in der Spalte Kategorie die Meldung
RelationNotFoundoderAttributeNotFoundenthält. Wenn Sie die Datei und die Zeile mit dem Fehler auf dem Tab „Code“ aufrufen möchten, klicken Sie auf den
Fehlermeldung.
Klicken Sie in der Spalte Aktion auf Vorgeschlagene Korrektur.
Wählen Sie eine der folgenden Optionen aus: Anwenden oder Anwenden und noch einmal ausführen:
- Klicken Sie auf Anwenden, um die generierte Schemadatei aus dem Ausgabeverzeichnis in das Eingabeverzeichnis zu kopieren.
- Klicken Sie auf Anwenden und noch einmal ausführen, um die generierte Schemadatei aus dem Ausgabeverzeichnis in das Eingabeverzeichnis zu kopieren und ein Fenster für die erneute Ausführung zu öffnen.
Kontingent und Limits
- Dafür gelten die Kontingente der BigQuery Migration API.
- Jedes Projekt kann höchstens 10 aktive Übersetzungsaufgaben haben.
- Die Gesamtzahl der Quell- und Metadatendateien ist zwar nicht begrenzt, es empfiehlt sich jedoch, die Anzahl der Dateien unter 1.000 zu halten, um eine bessere Leistung zu erzielen.
Preise
Für die Verwendung des Batch-SQL-Übersetzers fallen keine Kosten an. Für die Speicherung von Eingabe- und Ausgabedateien werden jedoch die normalen Gebühren berechnet. Weitere Informationen finden Sie unter Speicherpreise.
Befehlszeilentools für alternative Migrationsworkflows
Sie können einen Batch-Übersetzungsjob auch mit einer Konfigurationsdatei mit der Google Cloud CLI (gcloud bq migration-workflows) oder mit dem bq-Befehlszeilentool senden.
Bei diesen Schritten wird davon ausgegangen, dass Sie Quelldateien in einen Cloud Storage-Bucket hochgeladen haben.
Konfigurationsdatei erstellen
In einer Übersetzungskonfigurationsdatei werden der Pfad zu den Quelldateien, das Ausgabeziel sowie die Quell- und Zieldialekte Ihrer Übersetzung definiert. Sie können diese Datei entweder in YAML oder JSON schreiben.
Das folgende Beispiel zeigt eine YAML-Übersetzungskonfigurationsdatei für eine Teradata-zu-BigQuery-Übersetzung:
tasks:
  translation_task:
    type: Teradata2BigQuery_Translation
    translationDetails:
      sourceTargetMapping:
      - sourceSpec:
          baseUri: gs://bq-translations/input
        targetSpec:
          relativePath: output
      targetBaseUri: gs://bq-translations
      targetTypes:
      - sql
      sourceEnvironment:
        defaultDatabase: default_db
        schemaSearchPath:
        - foo
Das folgende Beispiel zeigt eine JSON-Datei mit einer Übersetzungskonfiguration für eine Übersetzung von Teradata zu BigQuery:
{
  "tasks": {
    "translation_task": {
      "type": "Teradata2BigQuery_Translation",
      "translationDetails": {
        "sourceTargetMapping": [
          {
            "sourceSpec": {
              "literal": {
                "literalString": "sel 1",
                "relativePath": "my_input_1"
              },
              "encoding": "UTF-8"
            }
          },
          {
            "sourceSpec": {
              "literal": {
                "literalString": "sel 2",
                "relativePath": "my_input_2"
              },
              "encoding": "UTF-8"
            }
          }
        ],
        "targetReturnLiterals": [
          "sql/my_input_1",
          "sql/my_input_2"
        ]
      }
    }
  }
}
Übersetzungsjobs senden und verwalten
Verwenden Sie eines der folgenden Befehlszeilentools, um Ihre Übersetzungsjobs einzureichen und zu verwalten.
gcloud
Verwenden Sie den folgenden Befehl, um einen Übersetzungsjob zu erstellen und den Workflow auszuführen:
gcloud bq migration-workflows create --location=LOCATION --config-file=CONFIG_FILE
Wenn Sie den Workflow erstellen und ausführen und sofort einen Link zum Workflow zurückgeben möchten, fügen Sie das Flag --async hinzu:
gcloud bq migration-workflows create --location=LOCATION --config-file=CONFIG_FILE --async
Verwenden Sie den folgenden Befehl, um Ihre Übersetzungsjobs aufzulisten:
gcloud bq migration-workflows list --location=LOCATION
Verwenden Sie den folgenden Befehl, um die Details eines bestimmten Übersetzungsjobs aufzurufen:
gcloud bq migration-workflows describe projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Ersetzen Sie Folgendes:
LOCATION: der Standort des Google Cloud -Projekts, in dem dieser Übersetzungsjob ausgeführt wird.CONFIG_FILE: der Pfad zu Ihrer Übersetzungskonfigurationsdatei.PROJECT_ID: die ID des Google Cloud -Projekts, in dem dieser Übersetzungsjob ausgeführt wird.WORKFLOW_ID: die ID des Übersetzungsjobs.
bq
Führen Sie den Übersetzungsjob mit dem folgenden Befehl aus:
bq mk --migration_workflow --location=LOCATION --config_file=CONFIG_FILE
Verwenden Sie den folgenden Befehl, um alle Ihre Übersetzungsjobs aufzulisten:
bq ls --migration_workflow --location=LOCATION
Verwenden Sie den folgenden Befehl, um Details zu einem bestimmten Übersetzungsjob aufzurufen:
bq show --migration_workflow projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Verwenden Sie den folgenden Befehl, um einen Übersetzungsjob aus der Liste zu entfernen:
bq rm --migration_workflow projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Ersetzen Sie Folgendes:
LOCATION: der Standort des Google Cloud -Projekts, in dem dieser Übersetzungsjob ausgeführt wird.CONFIG_FILE: der Pfad zu Ihrer Übersetzungskonfigurationsdatei.PROJECT_ID: die ID des Google Cloud -Projekts, in dem dieser Übersetzungsjob ausgeführt wird.WORKFLOW_ID: die ID des Übersetzungsjobs.
Ausgabedateien abrufen
Wenn Sie die Ausgabedateien nach Abschluss des Jobs herunterladen möchten, verwenden Sie gcloud storage cp, wie unter Ausgabedateien abrufen beschrieben. Informationen zum Prüfen des Jobs in der Google Cloud Console finden Sie unter Übersetzungsausgabe ansehen.
Nächste Schritte
Mehr über die folgenden Schritte bei der Data Warehouse-Migration erfahren:
- Übersicht über die Migration
- Migrationsbewertung
- Schema- und Datenübertragung
- Datenpipelines
- Interaktive SQL-Übersetzung
- Datensicherheit und Governance
- Datenvalidierungstool