


Scopri e cataloga i dati di Cloud Storage
Questo documento spiega come utilizzare il rilevamento automatico di Knowledge Catalog, una funzionalità di BigQuery che consente di analizzare i dati nei bucket Cloud Storage per estrarre e catalogare i metadati. Nell'ambito della scansione di rilevamento, il rilevamento automatico crea tabelle BigLake o esterne per i dati strutturati e tabelle degli oggetti per i dati non strutturati. Le tabelle BigLake e le tabelle esterne consentono di eseguire query su dati strutturati in datastore esterni (consulta Introduzione alle tabelle BigLake e Introduzione alle tabelle esterne), mentre le tabelle di oggetti forniscono un indice dei metadati sui dati non strutturati in Cloud Storage (consulta Introduzione alle tabelle di oggetti). Questi dati delle tabelle centralizzati semplificano gli insight sui dati, la sicurezza dei dati e la governance basati sull'AI.
Per utilizzare il rilevamento automatico dei dati di Cloud Storage, crea ed esegui una scansione di rilevamento.
Il rilevamento automatico è chiamato anche rilevamento autonomo.
Panoramica della scansione di rilevamento
Una scansione di rilevamento esegue le seguenti operazioni:
- Scansiona i dati nel bucket Cloud Storage o nel percorso.
- Raggruppa i dati strutturati e semistrutturati in tabelle.
- Raccoglie i metadati, come il nome della tabella, lo schema e la definizione della partizione.
- Crea e aggiorna tabelle BigLake esterne, esterne non BigLake o oggetti BigLake in BigQuery utilizzando lo schema e la definizione della partizione.
Dati strutturati e semistrutturati
I dati strutturati e semistrutturati includono formati come Avro, Parquet e CSV. La scansione di rilevamento registra gruppi di questi file come tabelle esterne di BigLake. L'analisi rileva i file solo se si trovano in cartelle che contengono lo stesso formato dei dati e uno schema compatibile.
- Caso d'uso: centralizza i file strutturati con tipizzazione forte in BigQuery per eseguire query SQL analitiche senza definire manualmente gli schemi.
- Workflow:
- Organizza i file strutturati in cartelle. Assicurati che i file in ogni cartella condividano lo stesso formato dei dati e abbiano uno schema compatibile.
- Crea una scansione di rilevamento e fornisci l'ID connessione alla risorsa Google Cloud .
- L'analisi raggruppa i dati e li registra come tabelle esterne BigLake.
- Esegui query sulle tabelle pubblicate direttamente in BigQuery utilizzando SQL.
Formati supportati
- Parquet
- Avro
- ORC
- JSON (solo il formato delimitato da nuova riga)
- CSV (ma non i file CSV con righe di commento)
Formati di compressione
Per i dati strutturati e semistrutturati, l'analisi di rilevamento supporta i seguenti formati di compressione:
Compressione interna per i seguenti formati:
Compressione Esempio di estensione del file Formato supportato gzip .gz.parquetParquet lz4 .lz4.parquetParquet Rapido .snappy.parquetParquet, ORC, Avro lzo .lzo.parquetParquet, ORC Compressione esterna per i file JSON e CSV:
- gzip
- bzip2
Dati non strutturati
Per i dati non strutturati, come immagini e video, l'analisi di rilevamento rileva e registra gruppi di file che condividono lo stesso formato file di dati. I file devono trovarsi in cartelle che contengono lo stesso formato file. Ad esempio, gs://images/group1 deve contenere solo immagini GIF e gs://images/group2 deve contenere solo immagini JPEG affinché l'analisi di rilevamento rilevi e registri due tabelle di oggetti BigLake.
- Caso d'uso: catalogare file non strutturati come immagini o documenti per eseguire l'inferenza di machine learning utilizzando BigQuery ML o funzioni remote.
- Workflow:
- Organizza i file non strutturati in cartelle. Assicurati che i file in ogni cartella condividano lo stesso formato file.
- Crea una scansione di rilevamento.
- La scansione raggruppa i dati non strutturati e li registra come tabelle di oggetti BigLake.
- Esegui l'inferenza sui file non strutturati direttamente in BigQuery.
Formati supportati
La scansione di rilevamento supporta i seguenti formati non strutturati:
- Immagine (ad esempio JPEG, PNG e BMP)
- Documenti (ad esempio PDF, presentazioni e report di testo)
- Audio o video (ad esempio WAV, MP3 e MP4)
Per ulteriori informazioni, consulta File oggetto supportati.
Formati di compressione
Per le tabelle di oggetti, la compressione viene gestita principalmente tramite i metadati degli oggetti Cloud Storage, anziché tramite le impostazioni interne di BigQuery.
- Compressione dei metadati standard: BigQuery riconosce automaticamente i file compressi con gzip e bzip2 se utilizzano le estensioni standard .gz o .bz2.
- Content-Encoding: puoi utilizzare i metadati Content-Encoding gzip in Cloud Storage per pubblicare file compressi mantenendo il tipo di contenuto originale.
- Compressione interna dei contenuti multimediali: i formati intrinsecamente compressi (come JPEG per le immagini, MP3 per l'audio, MP4 per i video) sono supportati in modo nativo.
Registrazione e disponibilità della tabella
Le tabelle rilevate vengono registrate in BigQuery come uno dei seguenti tipi di tabella, a seconda del formato dei dati e della configurazione della scansione:
- Tabelle di oggetti BigLake. Creato per dati non strutturati, come immagini e video.
- Tabelle esterne BigLake. Creato per i dati strutturati e semistrutturati quando fornisci un ID connessione alla risorsa Google Cloud durante la configurazione della scansione.
- Tabelle esterne (non BigLake): create per dati strutturati e semistrutturati se non fornisci un ID connessione alle risorse.
Questa registrazione rende i dati disponibili per l'analisi in BigQuery. È abilitata anche la memorizzazione nella cache dei metadati per le tabelle BigLake e le tabelle degli oggetti. Tutte le tabelle BigLake vengono importate automaticamente in Knowledge Catalog per la ricerca e la scoperta.
Per iniziare a lavorare con le tabelle appena registrate, puoi:
- Esegui una query in BigQuery.
- Cerca le risorse in Knowledge Catalog.
Limitazioni e quote
Una scansione di rilevamento non supporta i formati di tabella Apache Iceberg e Delta Lake.
Per conoscere il limite di tabelle supportate da una scansione di discovery, consulta Quote e limiti.
Prima di iniziare
Abilita l'API Dataplex, se non è già abilitata.
Ruoli richiesti per abilitare le API
Per abilitare le API, devi disporre dell'autorizzazione serviceusage.services.enable. Se hai creato il progetto, probabilmente disponi già di questa autorizzazione tramite il ruolo Proprietario (roles/owner). In caso contrario, puoi ottenere questa autorizzazione tramite il ruolo Amministratore Service Usage (roles/serviceusage.serviceUsageAdmin).
Scopri come concedere i ruoli.
Ruoli richiesti per il account di servizio Knowledge Catalog
Prima di iniziare, assegna le autorizzazioni IAM al account di servizio Knowledge Catalog nel tuo progetto.
service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com
Sostituisci PROJECT_NUMBER con il progetto in cui è abilitata l'API Dataplex.
Per assicurarti che il account di servizio di Knowledge Catalog disponga delle autorizzazioni necessarie per creare ed eseguire una scansione di rilevamento, chiedi all'amministratore di concedere i seguenti ruoli IAM al account di servizio di Knowledge Catalog:
- Dataplex Discovery Service Agent (
roles/dataplex.discoveryServiceAgent) sul bucket di archiviazione - Dataplex Discovery Publishing Service Agent (
roles/dataplex.discoveryPublishingServiceAgent) sul progetto utente -
Creare tabelle BigLake:
Dataplex Discovery BigLake Publishing Service Agent (
roles/dataplex.discoveryBigLakePublishingServiceAgent) sulla connessione BigQuery
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questi ruoli predefiniti contengono le autorizzazioni necessarie per creare ed eseguire una scansione di rilevamento. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per creare ed eseguire una scansione di rilevamento sono necessarie le seguenti autorizzazioni:
-
bigquery.datasets.createsul progetto dell'origine dati -
storage.buckets.getsul bucket dell'origine dati -
storage.objects.getsul bucket dell'origine dati -
storage.objects.listsul bucket dell'origine dati -
bigquery.datasets.getsul progetto dell'origine dati -
Fornisci una connessione:
-
bigquery.connections.delegatesulla connessione BigQuery -
bigquery.connections.usesulla connessione BigQuery
-
L'amministratore potrebbe anche essere in grado di concedere al account di servizio Knowledge Catalog queste autorizzazioni tramite ruoli personalizzati o altri ruoli predefiniti.
Ruoli richiesti per il account di servizio di connessione BigQuery
Per assicurarti che l'account BigQuery Connection Service disponga delle autorizzazioni necessarie per creare un'analisi di rilevamento, chiedi all'amministratore di concedere il ruolo IAM Dataplex Discovery Service Agent (roles/dataplex.discoveryServiceAgent) all'account BigQuery Connection Service sul bucket Cloud Storage.
Questo ruolo predefinito contiene le autorizzazioni necessarie per creare una scansione di rilevamento. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per creare una scansione di rilevamento sono necessarie le seguenti autorizzazioni:
-
bigquery.datasets.createsul progetto dell'origine dati -
storage.buckets.getsul bucket dell'origine dati -
storage.objects.getsul bucket dell'origine dati -
storage.objects.listsul bucket dell'origine dati -
bigquery.datasets.getsul progetto dell'origine dati -
Fornisci una connessione:
-
bigquery.connections.delegatesulla connessione BigQuery -
bigquery.connections.usesulla connessione BigQuery
-
L'amministratore potrebbe anche essere in grado di concedere all'account di servizio di connessione BigQuery queste autorizzazioni tramite ruoli personalizzati o altri ruoli predefiniti.
Ruoli richiesti per gli utenti finali
Per ottenere le autorizzazioni necessarie per creare e gestire le scansioni di rilevamento dei dati, chiedi all'amministratore di concederti i seguenti ruoli IAM sul bucket Cloud Storage:
-
Accesso completo alle risorse DataScan:
Dataplex DataScan Administrator (
roles/dataplex.dataScanAdmin) - il tuo progetto -
Accesso in scrittura alle risorse DataScan:
Dataplex DataScan Editor (
roles/dataplex.dataScanEditor) - il tuo progetto -
Accesso in lettura alle risorse DataScan, esclusi i risultati:
Dataplex DataScan Viewer (
roles/dataplex.dataScanViewer) - il tuo progetto -
Accesso in lettura alle risorse DataScan, inclusi i risultati:
Dataplex DataScan DataViewer (
roles/dataplex.dataScanDataViewer) - il tuo progetto
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questi ruoli predefiniti contengono le autorizzazioni necessarie per creare e gestire le scansioni di rilevamento dei dati. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per creare e gestire le scansioni di rilevamento dei dati sono necessarie le seguenti autorizzazioni:
-
Crea un DataScan:
dataplex.datascans.createsul progetto -
Elimina un DataScan:
dataplex.datascans.deletesul tuo progetto o su una risorsa DataScan -
Visualizza i dettagli di DataScan, esclusi i risultati:
dataplex.datascans.getsul tuo progetto o su una risorsa DataScan -
Visualizza i dettagli di DataScan, inclusi i risultati:
dataplex.datascans.getDatasul tuo progetto o su una risorsa DataScan -
Elenco DataScan:
dataplex.datascans.listsul progetto o su una risorsa DataScan -
Esegui un DataScan:
dataplex.datascans.runsul tuo progetto o su una risorsa DataScan -
Aggiorna la descrizione di un DataScan:
dataplex.datascans.updatenel tuo progetto o in una risorsa DataScan -
Visualizza le autorizzazioni IAM di DataScan:
dataplex.datascans.getIamPolicysul tuo progetto o su una risorsa DataScan -
Imposta le autorizzazioni IAM su DataScan:
dataplex.datascans.setIamPolicysul tuo progetto o su una risorsa DataScan
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Crea una scansione di rilevamento
Per rilevare i dati, devi creare ed eseguire una scansione di rilevamento. Puoi impostare una pianificazione per l'analisi o eseguirla on demand.
Quando viene eseguita l'analisi di rilevamento, viene creato un nuovo set di dati in BigQuery che corrisponde al bucket Cloud Storage analizzato. Il nome del set di dati BigQuery è lo stesso del nome del bucket Cloud Storage. I caratteri non validi nel nome del bucket vengono sostituiti da un trattino basso. Se il nome del set di dati non è disponibile, viene aggiunto un suffisso (ad esempio _discovered_001). Il set di dati contiene le tabelle esterne BigLake o non BigLake create dall'analisi di rilevamento per ulteriori analisi.
Console
Nella console Google Cloud , vai alla pagina Curation dei metadati.
Nella scheda Discovery di Cloud Storage, fai clic su Crea.
Nel riquadro Crea scansione di rilevamento, configura i dettagli dei dati da scansionare.
Inserisci un nome per la scansione.
Nel campo ID scansione, inserisci un ID univoco che segua le convenzioni di denominazione delle risorse in Google Cloud. Se non fornisci un ID, la scansione di rilevamento genera l'ID scansione.
(Facoltativo) Fornisci una descrizione dell'analisi.
Per specificare il bucket Cloud Storage che contiene i file da scansionare, nel campo Bucket, vai al bucket e selezionalo.
(Facoltativo) Definisci i dati da includere o escludere dalla scansione di rilevamento fornendo un elenco di pattern glob per il filtro dei file. Knowledge Catalog supporta i seguenti pattern glob:
*: corrisponde a zero o più caratteri, senza superare i limiti della directory. Ad esempio,*.csvcorrisponde afile.csv, ma non afolder/file.csv.**: corrisponde a zero o più caratteri, superando i confini della directory. Ad esempio,**/*.csvcorrisponde afile.csvefolder/subfolder/file.csv.?: corrisponde esattamente a un carattere. Ad esempio,file_?.csvcorrisponde afile_1.csvefile_a.csv, ma non afile_10.csv.[...]: trova un carattere incluso in un insieme di caratteri. Ad esempio,[abc]corrisponde aa,boce[a-z]corrisponde a qualsiasi lettera minuscola.{...}: corrisponde a un elenco separato da virgole di pattern secondari. Ad esempio,{sun,moon,stars}corrisponde asun,moonostars.\: esegue l'escape di un carattere (*,?o\). Ad esempio,file\*.csvcorrisponde al nome file letteralefile*.csv.
Puoi specificare i seguenti tipi di pattern:
- Includi: se deve essere analizzato solo un sottoinsieme dei dati, fornisci un elenco di pattern glob che corrispondono agli oggetti da includere.
- Escludi: fornisci un elenco di pattern glob che corrispondono agli oggetti da escludere.
Ad esempio, se vuoi escludere
gs://test_bucket/foo/..dalla scansione di discovery, inserisci**/foo/**come percorso di esclusione. Le virgolette causano errori. Assicurati di inserire**/foo/**anziché"**/foo/**".Se fornisci sia pattern di inclusione sia pattern di esclusione, questi ultimi vengono applicati per primi.
In Opzioni per i dati non strutturati, seleziona Abilita l'inferenza semantica.
Questa opzione è obbligatoria se vuoi visualizzare gli insight sui dati non strutturati in Knowledge Catalog. Per saperne di più, consulta Informazioni sugli insight sui dati non strutturati.
(Facoltativo) In Progetto, seleziona il progetto del set di dati BigQuery che contiene le tabelle esterne BigLake o non BigLake create dall'analisi di rilevamento. Se non viene fornito, il set di dati viene creato nel progetto che contiene il bucket Cloud Storage.
In Tipo di località, seleziona Regione o Multiregionale (a seconda di quale sia disponibile) in cui viene creato il set di dati di pubblicazione BigQuery.
Per creare tabelle BigLake dai dati scansionati, nel campo ID connessione, fornisci l'ID connessione della risorsa Google Cloud . Per saperne di più, consulta le connessioni alle risorseGoogle Cloud in BigQuery.
Puoi creare un nuovo ID connessione nella stessa località del set di dati BigQuery, che è compatibile con la località del bucket Cloud Storage.
Se non fornisci un ID connessione alle risorse, l'analisi di rilevamento crea tabelle esterne non BigLake. Per comprendere le differenze tra questi tipi di tabelle esterne e il motivo per cui il servizio di rilevamento potrebbe scegliere l'uno rispetto all'altro, consulta il confronto delle differenze di comportamento.
Nella sezione Frequenza di rilevamento, configura quando vuoi eseguire la scansione di rilevamento:
Ripeti: l'analisi viene eseguita in base a una pianificazione predefinita. Specifica l'ora di inizio, i giorni in cui eseguire l'analisi e la frequenza, ad esempio ogni ora.
On demand: la scansione viene eseguita on demand.
(Facoltativo) Nella sezione Specifiche JSON o CSV, specifica in che modo l'analisi deve elaborare i file JSON e CSV. Fai clic su Specifiche JSON o CSV.
- Per configurare le opzioni JSON, seleziona Abilita opzioni di analisi JSON.
- Disabilita inferenza dei tipi: indica se la scansione di rilevamento deve dedurre i tipi di dati durante la scansione dei dati. Se disattivi l'inferenza del tipo per i dati JSON, tutte le colonne vengono registrate come tipi primitivi, ad esempio stringa, numero o booleano.
- Formato di codifica: la codifica dei caratteri dei dati, ad esempio UTF-8, US-ASCII o ISO-8859-1. Se non specifichi un valore, viene utilizzato UTF-8 come valore predefinito.
- Per configurare le opzioni CSV, seleziona Abilita opzioni di analisi CSV.
- Disabilita inferenza dei tipi: indica se la scansione di rilevamento deve dedurre i tipi di dati durante la scansione dei dati. Se disattivi l'inferenza del tipo per i dati CSV, tutte le colonne vengono registrate come stringhe.
- Righe di intestazione: il numero di righe di intestazione,
0o1. Se specifichi il valore0, l'analisi di rilevamento deduce le intestazioni ed estrae i nomi delle colonne dal file. Il valore predefinito è0. - Carattere delimitatore di colonna: il carattere utilizzato per separare i valori. Specifica un singolo carattere,
\r(ritorno a capo) o\n(nuova riga). Il valore predefinito è una virgola (,). - Formato di codifica: la codifica dei caratteri dei dati, ad esempio
UTF-8,US-ASCIIoISO-8859-1. Se non specifichi un valore, viene utilizzato UTF-8 come valore predefinito.
- Per configurare le opzioni JSON, seleziona Abilita opzioni di analisi JSON.
Fai clic su Crea (per una scansione pianificata), Esegui ora (per una scansione on demand) o Crea ed esegui (per una scansione una tantum).
- Analisi pianificata: viene eseguita in base alla pianificazione impostata.
- Analisi on demand: viene eseguita una volta inizialmente quando la crei e puoi eseguirla in qualsiasi momento. L'esecuzione della scansione di rilevamento può richiedere diversi minuti.
- Scansione una tantum: viene eseguita automaticamente. Viene eliminato automaticamente quando raggiunge la soglia di durata (TTL) definita, un valore che determina la durata di un'analisi di rilevamento attiva dopo l'esecuzione. Il valore TTL può variare da 0 secondi (eliminazione immediata) a 365 giorni. Una scansione di rilevamento senza un TTL specificato viene eliminata automaticamente dopo 24 ore.
gcloud
Per creare un'analisi di rilevamento, utilizza il comando gcloud dataplex datascans create data-discovery.
gcloud dataplex datascans create data-discovery --location=LOCATION
--data-source-resource=BUCKET_PATH
Sostituisci quanto segue:
LOCATION: la località in cui vuoi creare l'analisi di rilevamentoBUCKET_PATH: il percorso Cloud Storage del bucket che vuoi scansionare
REST
Per creare una scansione di rilevamento, utilizza il metodo dataScans.create.
Esegui query sulle tabelle BigLake pubblicate
Dopo aver eseguito l'analisi di rilevamento, le tabelle BigLake vengono pubblicate in un nuovo set di dati in BigQuery. Le tabelle sono quindi disponibili per l'analisi in BigQuery utilizzando SQL o in Managed Service for Apache Spark utilizzando Apache Spark o HiveQL.
SQL
Puoi visualizzare o eseguire query sulle tabelle in BigQuery. Per saperne di più su come eseguire query in BigQuery, consulta Esegui una query.
Apache Spark
Per eseguire query sulle tabelle BigLake utilizzando Spark SQL su un job serverless di Managed Service for Apache Spark, segui questi passaggi:
Crea uno script PySpark simile allo script di esempio seguente:
from pyspark.sql import SparkSession
session = (
  SparkSession.builder.appName("testing")
    .config("viewsEnabled","true")
    .config("materializationDataset", "DATASET_ID")
    .config("spark.hive.metastore.bigquery.project.id", "PROJECT_ID")
    .config("spark.hive.metastore.client.factory.class", "com.google.cloud.bigquery.metastore.client.BigQueryMetastoreClientFactory")
    .enableHiveSupport()
    .getOrCreate()
)

session.sql("show databases").show()
session.sql("use TABLE_NAME").show()
session.sql("show tables").show()

sql = "SELECT * FROM DATASET_ID.TABLE_ID LIMIT 10"
df = session.read.format("bigquery").option("dataset", "DATASET_ID").load(sql)
df.show()
Sostituisci quanto segue:
DATASET_ID: ID del set di dati per cui gli utenti dispongono dell'autorizzazione di creazionePROJECT_ID: ID del progetto con la tabella BigLake.TABLE_NAME: il nome della tabella BigLakeTABLE_ID: l'ID della tabella BigLake
Gestisci le tabelle BigLake pubblicate
Le tabelle BigLake pubblicate vengono create e gestite in BigQuery tramite l'analisi di rilevamento. Per impostazione predefinita, la scansione di rilevamento gestisce il rilevamento di nuovi dati, le inferenze dello schema e l'evoluzione dello schema ogni volta che vengono eseguite le scansioni pianificate o on demand. Per indicare che i metadati sono gestiti dall'analisi, quest'ultima pubblica le tabelle con l'etichetta metadata-managed-mode impostata su discovery-managed.
Se vuoi gestire autonomamente lo schema e altri metadati, come le opzioni CSV o JSON, imposta l'etichetta metadata-managed-mode su user_managed. In questo modo, lo schema rimane invariato quando viene eseguita la scansione di rilevamento successiva. Questo approccio può essere utile in scenari in cui lo schema dedotto dalla scansione di rilevamento è errato o diverso da quello previsto per una determinata tabella. Quando l'etichetta metadata-managed-mode è impostata su user_managed, può ridurre il costo.
Per aggiornare l'etichetta, puoi modificare il valore della chiave dell'etichetta
metadata-managed-mode in user_managed anziché discovery-managed. In questo caso, l'analisi di rilevamento non aggiorna lo schema della tabella finché l'etichetta user_managed è associata alla tabella.
Aggiorna le tabelle BigLake pubblicate
Per le tabelle BigLake pubblicate utilizzando i job di scansione di rilevamento con la configurazione predefinita, lo schema e altri metadati vengono aggiornati automaticamente a ogni esecuzione del job di scansione di rilevamento alla frequenza pianificata.
Per aggiornare una tabella BigLake pubblicata, segui questi passaggi:
Nella console Google Cloud , vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
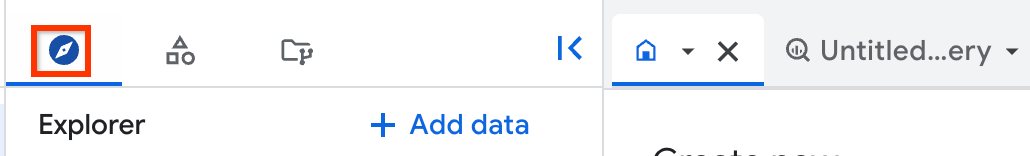
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro sinistro per aprirlo.
Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati, quindi seleziona un set di dati.
Fai clic su Panoramica > Tabelle, quindi seleziona la tabella.
Nella scheda Dettagli, nella sezione Etichette, assicurati che l'etichetta metadata-managed-mode sia impostata su user_managed. Se è impostato su un valore diverso, segui questi passaggi:
Fai clic su Modifica dettagli.
Accanto alla chiave metadata-managed-mode, nel campo valore, inserisci
user_managed.
Elimina le tabelle BigLake pubblicate
Per eliminare una tabella BigLake pubblicata, segui questi passaggi:
Elimina i file di dati della tabella nel bucket Cloud Storage.
Nella console Google Cloud , vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati, quindi seleziona un set di dati.
Fai clic su Panoramica > Tabelle, quindi seleziona la tabella.
Nel riquadro Dettagli, nella sezione Etichette, assicurati che l'etichetta metadata-managed-mode non sia impostata su
user_managed. Se è impostato suuser_managed, segui questi passaggi:Fai clic su Modifica dettagli .
Accanto alla chiave metadata-managed-mode, nel campo valore, inserisci
discovery-managed.
Fai clic su Esegui. La scansione di rilevamento viene eseguita on demand.
Dopo l'esecuzione dell'analisi di rilevamento, la tabella BigLake viene eliminata in BigQuery e non è disponibile per l'elenco o la query tramite Spark.
Esegui una scansione di rilevamento on demand
Per eseguire un'analisi di rilevamento on demand, seleziona una delle seguenti opzioni.
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel menu di navigazione, fai clic su Governance > Curatela dei metadati.
Nel riquadro Rilevamento di Cloud Storage, fai clic sull'analisi di rilevamento che vuoi eseguire.
Fai clic su Esegui ora.
gcloud
Per eseguire una scansione di rilevamento, utilizza il comando gcloud dataplex datascans run:
gcloud dataplex datascans runDATASCAN\ --location=LOCATION
Sostituisci le seguenti variabili:
LOCATION: la regione Google Cloud in cui è stata creata l'analisi di rilevamento.DATASCAN: il nome della scansione di rilevamento.
REST
Per eseguire una scansione di rilevamento on demand, utilizza il
metodo dataScans.run
nell'API Dataplex.
Elenca le scansioni di rilevamento
Per elencare le scansioni di rilevamento, seleziona una delle seguenti opzioni.
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel menu di navigazione, fai clic su Governance > Curatela dei metadati.
Nel riquadro Discovery di Cloud Storage sono elencate le scansioni di discovery create nel progetto.
gcloud
gcloud dataplex datascans list --location=LOCATION --project=PROJECT_ID
Sostituisci quanto segue:
LOCATION: la località del progettoPROJECT_ID: il tuo ID progetto Google Cloud
REST
Per recuperare l'elenco delle scansioni di rilevamento nel tuo progetto, utilizza il
metodo dataScans.list
nell'API Dataplex.
Visualizza una scansione di rilevamento
Per visualizzare una scansione di rilevamento, seleziona una delle seguenti opzioni.
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel menu di navigazione, fai clic su Governance > Cura dei metadati.
Nel riquadro Discovery di Cloud Storage, fai clic sulla scansione di discovery di cui vuoi visualizzare i dettagli.
- La sezione Dettagli scansione mostra i dettagli della scansione di rilevamento.
- La sezione Stato scansione mostra i risultati del rilevamento dell'ultimo job di scansione.
gcloud
gcloud dataplex datascans jobs describe JOB \
    --location=LOCATION \
    --datascan=DATASCAN \
    --view=FULL
Sostituisci quanto segue:
JOB: l'ID job del job di scansione di rilevamento.LOCATION: la regione Google Cloud in cui è stata creata l'analisi di rilevamento.DATASCAN: il nome della scansione di rilevamento a cui appartiene il job.
REST
Per visualizzare i risultati di una scansione di rilevamento dei dati, utilizza il
metodo dataScans.get
nell'API Dataplex.
Visualizza i risultati storici della scansione di rilevamento
Per visualizzare i risultati storici della scansione di rilevamento, seleziona una delle seguenti opzioni.
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel menu di navigazione, fai clic su Governance > Cura dei metadati.
Nel riquadro Discovery di Cloud Storage, fai clic sulla scansione di discovery di cui vuoi visualizzare i dettagli.
Fai clic sul riquadro Cronologia scansioni. Il riquadro Cronologia scansioni fornisce informazioni sui job passati, tra cui il numero di record scansionati in ogni job, lo stato di ogni job e l'ora di esecuzione dei job.
Per visualizzare informazioni dettagliate su un job, fai clic sul job nella colonna ID job.
gcloud
gcloud dataplex datascans jobs list \
    --location=LOCATION \
    --datascan=DATASCAN
Sostituisci quanto segue:
LOCATION: la regione Google Cloud in cui è stata creata l'analisi di rilevamento.DATASCAN: il nome della scansione di rilevamento a cui appartiene il job.
REST
Per visualizzare tutti i job di una scansione di rilevamento, utilizza il
metodo dataScans.jobs.list
nell'API Dataplex.
Aggiorna una scansione di rilevamento
Per modificare la pianificazione di una scansione di rilevamento, ad esempio per passare da on demand a ricorrente, aggiorna la scansione di rilevamento.
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel menu di navigazione, fai clic su Governance > Cura dei metadati.
Nel riquadro Discovery di Cloud Storage, per la scansione di discovery che vuoi aggiornare, fai clic su Azioni > Modifica.
Modifica i valori.
Fai clic su Salva.
gcloud
Per aggiornare una scansione di rilevamento, utilizza il comando gcloud dataplex datascans update data-discovery.
gcloud dataplex datascans update data-discovery SCAN_ID --location=LOCATION --description=DESCRIPTION
Sostituisci quanto segue:
SCAN_ID: l'ID della scansione di rilevamento che vuoi aggiornareLOCATION: la regione Google Cloud in cui è stata creata l'analisi di rilevamentoDESCRIPTION: la nuova descrizione per l'analisi di rilevamento
REST
Per aggiornare una scansione di rilevamento, utilizza il metodo dataScans.patch nell'API Dataplex.
Elimina una scansione di rilevamento
Per eliminare una scansione di rilevamento, seleziona una delle seguenti opzioni.
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel menu di navigazione, fai clic su Governance > Cura dei metadati.
Nel riquadro Discovery di Cloud Storage, per l'analisi di discovery che vuoi eliminare, fai clic su Azioni > Elimina.
Fai clic su Elimina.
gcloud
gcloud dataplex datascans delete SCAN_ID --location=LOCATION --async
Sostituisci quanto segue:
SCAN_ID: l'ID della scansione di rilevamento che vuoi eliminare.LOCATION: la regione Google Cloud in cui è stata creata l'analisi di rilevamento.
REST
Per eliminare una scansione di rilevamento, utilizza il metodo dataScans.delete nell'API Dataplex.