


In dieser Anleitung erfahren Sie, wie Sie ein univariates Zeitachsenmodell ARIMA_PLUS verwenden, um den zukünftigen Wert einer bestimmten Spalte basierend auf den bisherigen Werten dieser Spalte vorherzusagen.
In dieser Anleitung werden Prognosen für mehrere Zeitreihen erstellt. Prognostizierte Werte werden für jeden Zeitpunkt und für jeden Wert in einer oder mehreren angegebenen Spalten berechnet. Wenn Sie beispielsweise das Wetter vorhersagen möchten und eine Spalte mit Städtedaten angeben, enthalten die prognostizierten Daten Vorhersagen für alle Zeitpunkte für Stadt A, dann prognostizierte Werte für alle Zeitpunkte für Stadt B usw.
In dieser Anleitung werden Daten aus der öffentlichen Tabelle bigquery-public-data.new_york.citibike_trips verwendet. Diese Tabelle enthält Informationen zu Citi Bike-Fahrten in New York City.
Bevor Sie diese Anleitung lesen, sollten Sie sich unbedingt mit Prognosen für einzelne Zeitachsen mit einem univariaten Modell erstellen vertraut machen.
Ziele
In dieser Anleitung werden Sie durch die folgenden Aufgaben geführt:
- Erstellen Sie ein Zeitachsenmodell, um die Anzahl der Fahrradtouren mit der Anweisung
CREATE MODELvorherzusagen. - Bewerten der ARIMA-Informationen (Autoregressive Integrated Moving Average) im Modell mit der
ML.ARIMA_EVALUATE-Funktion. - Prüfen der Modellkoeffizienten mit der Funktion
ML.ARIMA_COEFFICIENTS. - Abrufen der prognostizierten Informationen zur Fahrradtour aus dem Modell mithilfe der Funktion
ML.FORECAST. - Komponenten der Zeitreihe wie Saisonalität und Trend mit der Funktion
ML.EXPLAIN_FORECASTabrufen. Sie können diese Zeitreihenkomponenten untersuchen, um die prognostizierten Werte zu erklären.
Kosten
In dieser Anleitung werden kostenpflichtige Komponenten von Google Cloudverwendet, darunter:
- BigQuery
- BigQuery ML
Weitere Informationen zu den Kosten von BigQuery finden Sie auf der Seite BigQuery-Preise.
Weitere Informationen zu den Kosten für BigQuery ML finden Sie unter BigQuery ML-Preise.
Hinweis
- Melden Sie sich in Ihrem Google Cloud -Konto an. Wenn Sie mit Google Cloudnoch nicht vertraut sind, erstellen Sie ein Konto, um die Leistungsfähigkeit unserer Produkte in der Praxis sehen und bewerten zu können. Neukunden erhalten außerdem ein Guthaben von 300 $, um Arbeitslasten auszuführen, zu testen und bereitzustellen.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
- BigQuery ist in neuen Projekten automatisch aktiviert.
Zum Aktivieren von BigQuery in einem vorhandenen Projekt wechseln Sie zu
Aktivieren Sie die BigQuery API, falls sie noch nicht aktiviert ist.
Rollen, die zum Aktivieren von APIs erforderlich sind
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Rolle „Inhaber“ (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen
Erforderliche Berechtigungen
Sie benötigen die IAM-Berechtigung
bigquery.datasets.create, um das Dataset zu erstellen.Zum Erstellen des Modells benötigen Sie die folgenden Berechtigungen:
bigquery.jobs.createbigquery.models.createbigquery.models.getDatabigquery.models.updateData
Zum Ausführen von Inferenzen benötigen Sie die folgenden Berechtigungen:
bigquery.models.getDatabigquery.jobs.create
Weitere Informationen zu IAM-Rollen und Berechtigungen in BigQuery finden Sie unter Einführung in IAM.
Dataset erstellen
Wählen Sie eine der folgenden Optionen aus, um ein BigQuery-Dataset zu erstellen:Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
Wenn das linke Steuerfeld nicht angezeigt wird, klicken Sie auf Linkes Steuerfeld maximieren, um es zu öffnen.
Maximieren Sie im Explorer Ihr Projekt und klicken Sie dann auf Datasets.
Klicken Sie auf der Seite Datasets auf Dataset erstellen.
Führen Sie im Bereich Dataset erstellen die folgenden Schritte aus:
Geben Sie unter Dataset-ID
bqml_tutorialein.Wählen Sie unter Speicherort der Daten die Option USA aus.
Übernehmen Sie die anderen Standardeinstellungen.
Klicken Sie auf Dataset erstellen.
bq
Verwenden Sie den Befehl bq mk --dataset, um ein neues Dataset zu erstellen.
Erstellen Sie ein Dataset mit dem Namen
bqml_tutorialund dem DatenspeicherortUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Prüfen Sie, ob das Dataset erstellt wurde:
bq ls
API
Rufen Sie die Methode datasets.insert mit einer definierten Dataset-Ressource auf:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Eingabedaten visualisieren
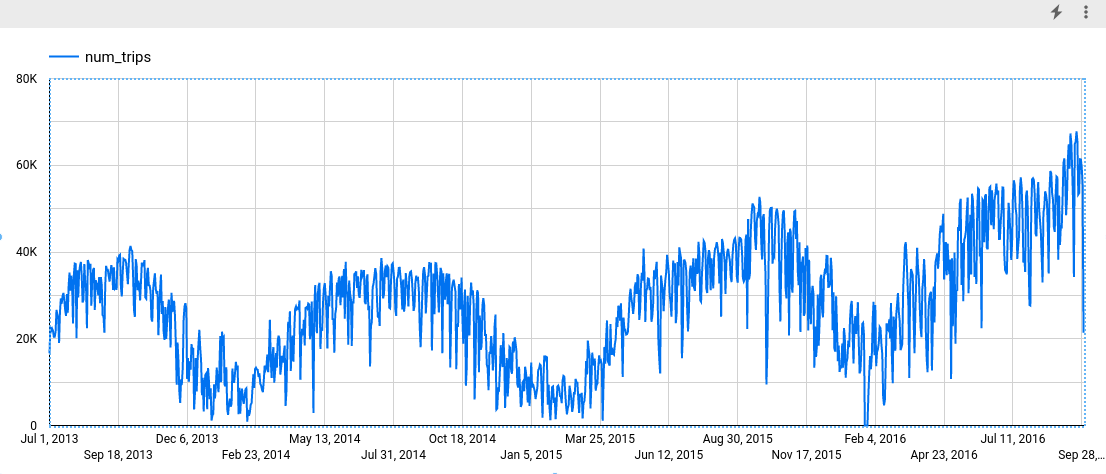
Bevor Sie das Modell erstellen, können Sie Ihre Eingabezeitreihendaten optional visualisieren, um einen Eindruck von der Verteilung zu erhalten. Verwenden Sie dazu Data Studio.
SQL
In der SELECT-Anweisung der folgenden Abfrage wird die EXTRACT-Funktion verwendet, um die Datumsinformationen aus der Spalte starttime zu extrahieren. Die Abfrage verwendet die COUNT(*)-Klausel, um die Gesamtzahl der Citi Bike-Touren pro Tag abzurufen.
So visualisieren Sie die Zeitreihendaten:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Fügen Sie die folgende Abfrage in den Abfrageeditor ein und klicken Sie auf Ausführen:
SELECT
 EXTRACT(DATE from starttime) AS date,
 COUNT(*) AS num_trips
FROM
`bigquery-public-data.new_york.citibike_trips`
GROUP BY date;
Klicken Sie nach Abschluss der Abfrage auf Öffnen in > Data Studio. Data Studio wird in einem neuen Tab geöffnet. Führen Sie die folgenden Schritte in dem neuen Tab aus.
Klicken Sie in Data Studio auf Einfügen > Zeitreihendiagramm.
Wählen Sie im Bereich Diagramm den Tab Einrichtung aus.
Fügen Sie im Bereich Messwert das Feld num_trips hinzu und entfernen Sie den Standardmesswert Anzahl der Datensätze. Das resultierende Diagramm sieht in etwa so aus:
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Zeitachsenmodell erstellen
Sie möchten die Anzahl der Fahrradfahrten für jede Citi Bike-Station prognostizieren. Dazu sind viele Zeitreihenmodelle erforderlich, nämlich eines für jede Citi Bike-Station in den Eingabedaten. Sie können mehrere Modelle erstellen, um dies zu erreichen. Das kann jedoch mühsam und zeitaufwendig sein, insbesondere wenn Sie sehr viele Zeitachsen haben. Stattdessen können Sie mit einer einzigen Abfrage eine Reihe von Zeitachsenmodellen erstellen und anpassen, um mehrere Zeitachsen gleichzeitig vorherzusagen.
SQL
In der folgenden Abfrage gibt die OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...)-Anweisung an, dass Sie ein ARIMA-basiertes Zeitachsenmodell erstellen. Mit der time_series_id_col-Option der CREATE MODEL-Anweisung geben Sie eine oder mehrere Spalten in den Eingabedaten an, für die Sie Prognosen erstellen möchten. In diesem Fall ist das die Citi Bike-Station, die durch die Spalte start_station_name dargestellt wird. Mit der WHERE-Klausel werden die Startstationen auf diejenigen mit Central Park in ihren Namen beschränkt. Mit der auto_arima_max_order-Option der CREATE MODEL-Anweisung wird der Suchbereich für die Hyperparameter-Abstimmung im auto.ARIMA-Algorithmus gesteuert. Die decompose_time_series-Option der CREATE MODEL-Anweisung hat standardmäßig den Wert TRUE. Daher werden Informationen zu den Zeitreihendaten zurückgegeben, wenn Sie das Modell im nächsten Schritt bewerten.
So erstellen Sie das Modell:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Fügen Sie die folgende Abfrage in den Abfrageeditor ein und klicken Sie auf Ausführen:
CREATE OR REPLACE MODEL `bqml_tutorial.nyc_citibike_arima_model_group`
OPTIONS
(model_type = 'ARIMA_PLUS',
 time_series_timestamp_col = 'date',
 time_series_data_col = 'num_trips',
 time_series_id_col = 'start_station_name',
 auto_arima_max_order = 5
) AS
SELECT
 start_station_name,
 EXTRACT(DATE from starttime) AS date,
 COUNT(*) AS num_trips
FROM
`bigquery-public-data.new_york.citibike_trips`
WHERE start_station_name LIKE '%Central Park%'
GROUP BY start_station_name, date;
Die Abfrage dauert ungefähr 24 Sekunden. Anschließend können Sie auf das Modell
nyc_citibike_arima_model_groupzugreifen. Da die Abfrage eineCREATE MODEL-Anweisung verwendet, werden keine Abfrageergebnisse angezeigt.
Mit dieser Abfrage werden zwölf Zeitreihenmodelle erstellt, eines für jede der zwölf Citi Bike-Startstationen in den Eingabedaten. Der Zeitaufwand ist mit etwa 24 Sekunden aufgrund der Parallelität nur 1,4-mal höher als bei der Erstellung eines Modells mit nur einer Zeitreihe. Wenn Sie die WHERE ... LIKE ...-Klausel entfernen, gibt es jedoch mehr als 600 Zeitachsen für die Prognose, die aufgrund der Slot-Kapazität nicht vollständig parallel prognostiziert werden. In diesem Fall würde es etwa 15 Minuten dauern, bis die Abfrage abgeschlossen ist. Wenn Sie die Abfragelaufzeit reduzieren möchten, ohne dass sich die Modellqualität möglicherweise verschlechtert, können Sie den Wert von auto_arima_max_order verringern.
Dadurch wird der Suchbereich der Hyperparameter-Abstimmung im auto.ARIMA-Algorithmus verkleinert. Weitere Informationen finden Sie unter Large-scale time series forecasting best practices.
BigQuery DataFrames
Im folgenden Snippet erstellen Sie ein ARIMA-basiertes Zeitachsenmodell.
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Dadurch werden zwölf Zeitachsenmodelle erstellt, eines für jede der zwölf Citi Bike-Startstationen in den Eingabedaten. Der Zeitaufwand ist mit etwa 24 Sekunden aufgrund der Parallelität nur 1,4-mal höher als bei der Erstellung eines Modells mit nur einer Zeitreihe.
Modell bewerten
SQL
Bewerten Sie das Zeitreihenmodell mit der Funktion ML.ARIMA_EVALUATE. Die Funktion ML.ARIMA_EVALUATE zeigt die Bewertungsmesswerte an, die während der automatischen Hyperparameter-Abstimmung für das Modell generiert wurden.
So bewerten Sie das Modell:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Fügen Sie die folgende Abfrage in den Abfrageeditor ein und klicken Sie auf Ausführen:
SELECT
*
FROM
ML.ARIMA_EVALUATE(MODEL `bqml_tutorial.nyc_citibike_arima_model_group`);
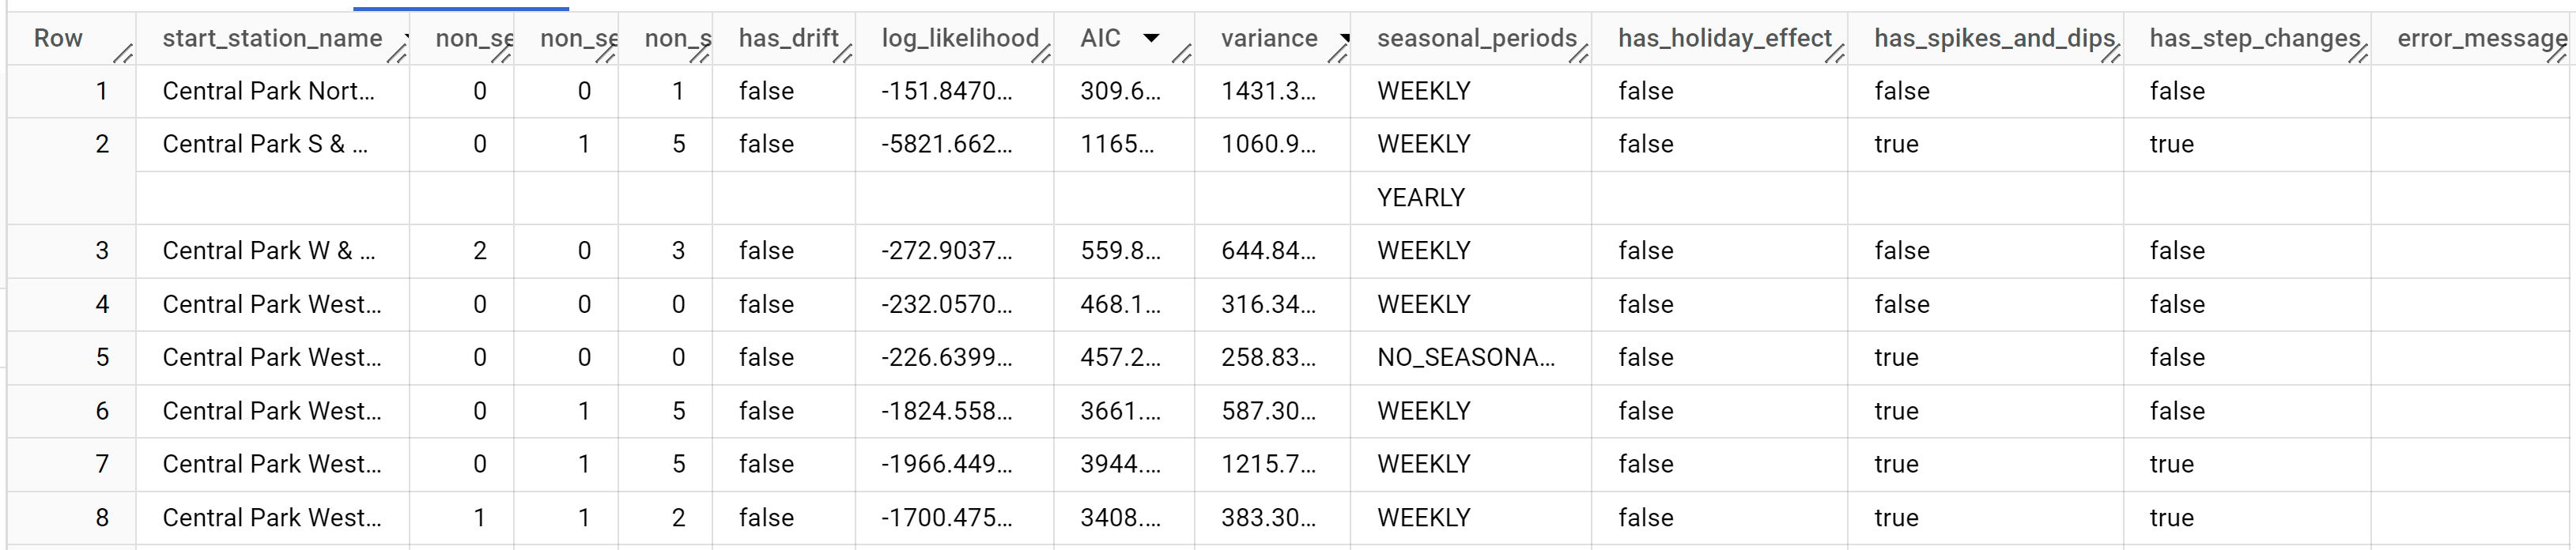
Die Ergebnisse sollten so aussehen:
Während
auto.ARIMADutzende von ARIMA-Kandidatenmodellen für jede Zeitreihe auswertet, gibtML.ARIMA_EVALUATEstandardmäßig nur die Informationen des besten Modells aus, um die Ausgabetabelle kompakt zu gestalten. Wenn Sie alle Kandidatenmodelle aufrufen möchten, können Sie dasshow_all_candidate_model-Argument der FunktionML.ARIMA_EVALUATEaufTRUEfestlegen.
BigQuery DataFrames
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
In der Spalte start_station_name wird die Eingabedatenspalte angegeben, für die Zeitreihen erstellt wurden. Dies ist die Spalte, die Sie beim Erstellen des Modells mit der Option time_series_id_col angegeben haben.
Die Ausgabespalten non_seasonal_p, non_seasonal_d, non_seasonal_q und has_drift definieren ein ARIMA-Modell in der Trainingspipeline. Die Ausgabespalten log_likelihood, AIC und variance sind für den ARIMA-Modellanpassungsprozess relevant. Der Anpassungsprozess ermittelt mit dem Algorithmus auto.ARIMA das beste ARIMA-Modell, eines für jede Zeitreihe.
Der auto.ARIMA-Algorithmus verwendet den KPSS-Test, um den besten Wert für non_seasonal_d zu ermitteln, der in diesem Fall 1 ist. Wenn non_seasonal_d gleich 1 ist, trainiert der auto.ARIMA-Algorithmus 42 verschiedene ARIMA-Kandidatenmodelle parallel.
In diesem Beispiel sind alle 42 Kandidatenmodelle gültig. Die Ausgabe enthält also 42 Zeilen, eine für jedes ARIMA-Kandidatenmodell. Wenn einige der Modelle ungültig sind, werden sie aus der Ausgabe ausgeschlossen. Diese Kandidatenmodelle werden in aufsteigender Reihenfolge nach AIC zurückgegeben. Das Modell in der ersten Zeile hat den niedrigsten AIC und gilt als das beste Modell. Dieses beste Modell wird als endgültiges Modell gespeichert und verwendet, wenn Sie Daten prognostizieren, das Modell bewerten und die Koeffizienten des Modells untersuchen, wie in den folgenden Schritten beschrieben.
Die Spalte seasonal_periods enthält Informationen zum saisonalen Muster, das in den Zeitachsendaten ermittelt wurde. Jede Zeitreihe kann unterschiedliche saisonale Muster haben. In der Abbildung sehen Sie beispielsweise, dass eine Zeitreihe ein Jahresmuster aufweist, andere hingegen nicht.
Die Spalten has_holiday_effect, has_spikes_and_dips und has_step_changes werden nur ausgefüllt, wenn decompose_time_series=TRUE. Diese Spalten enthalten auch Informationen zu den Eingabezeitreihendaten und stehen nicht im Zusammenhang mit der ARIMA-Modellierung. Diese Spalten haben auch in allen Ausgabezeilen dieselben Werte.
Koeffizienten des Modells prüfen
SQL
Prüfen Sie die Koeffizienten des Zeitreihenmodells mit der Funktion ML.ARIMA_COEFFICIENTS.
So rufen Sie die Koeffizienten des Modells ab:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Fügen Sie die folgende Abfrage in den Abfrageeditor ein und klicken Sie auf Ausführen:
SELECT
*
FROM
ML.ARIMA_COEFFICIENTS(MODEL `bqml_tutorial.nyc_citibike_arima_model_group`);
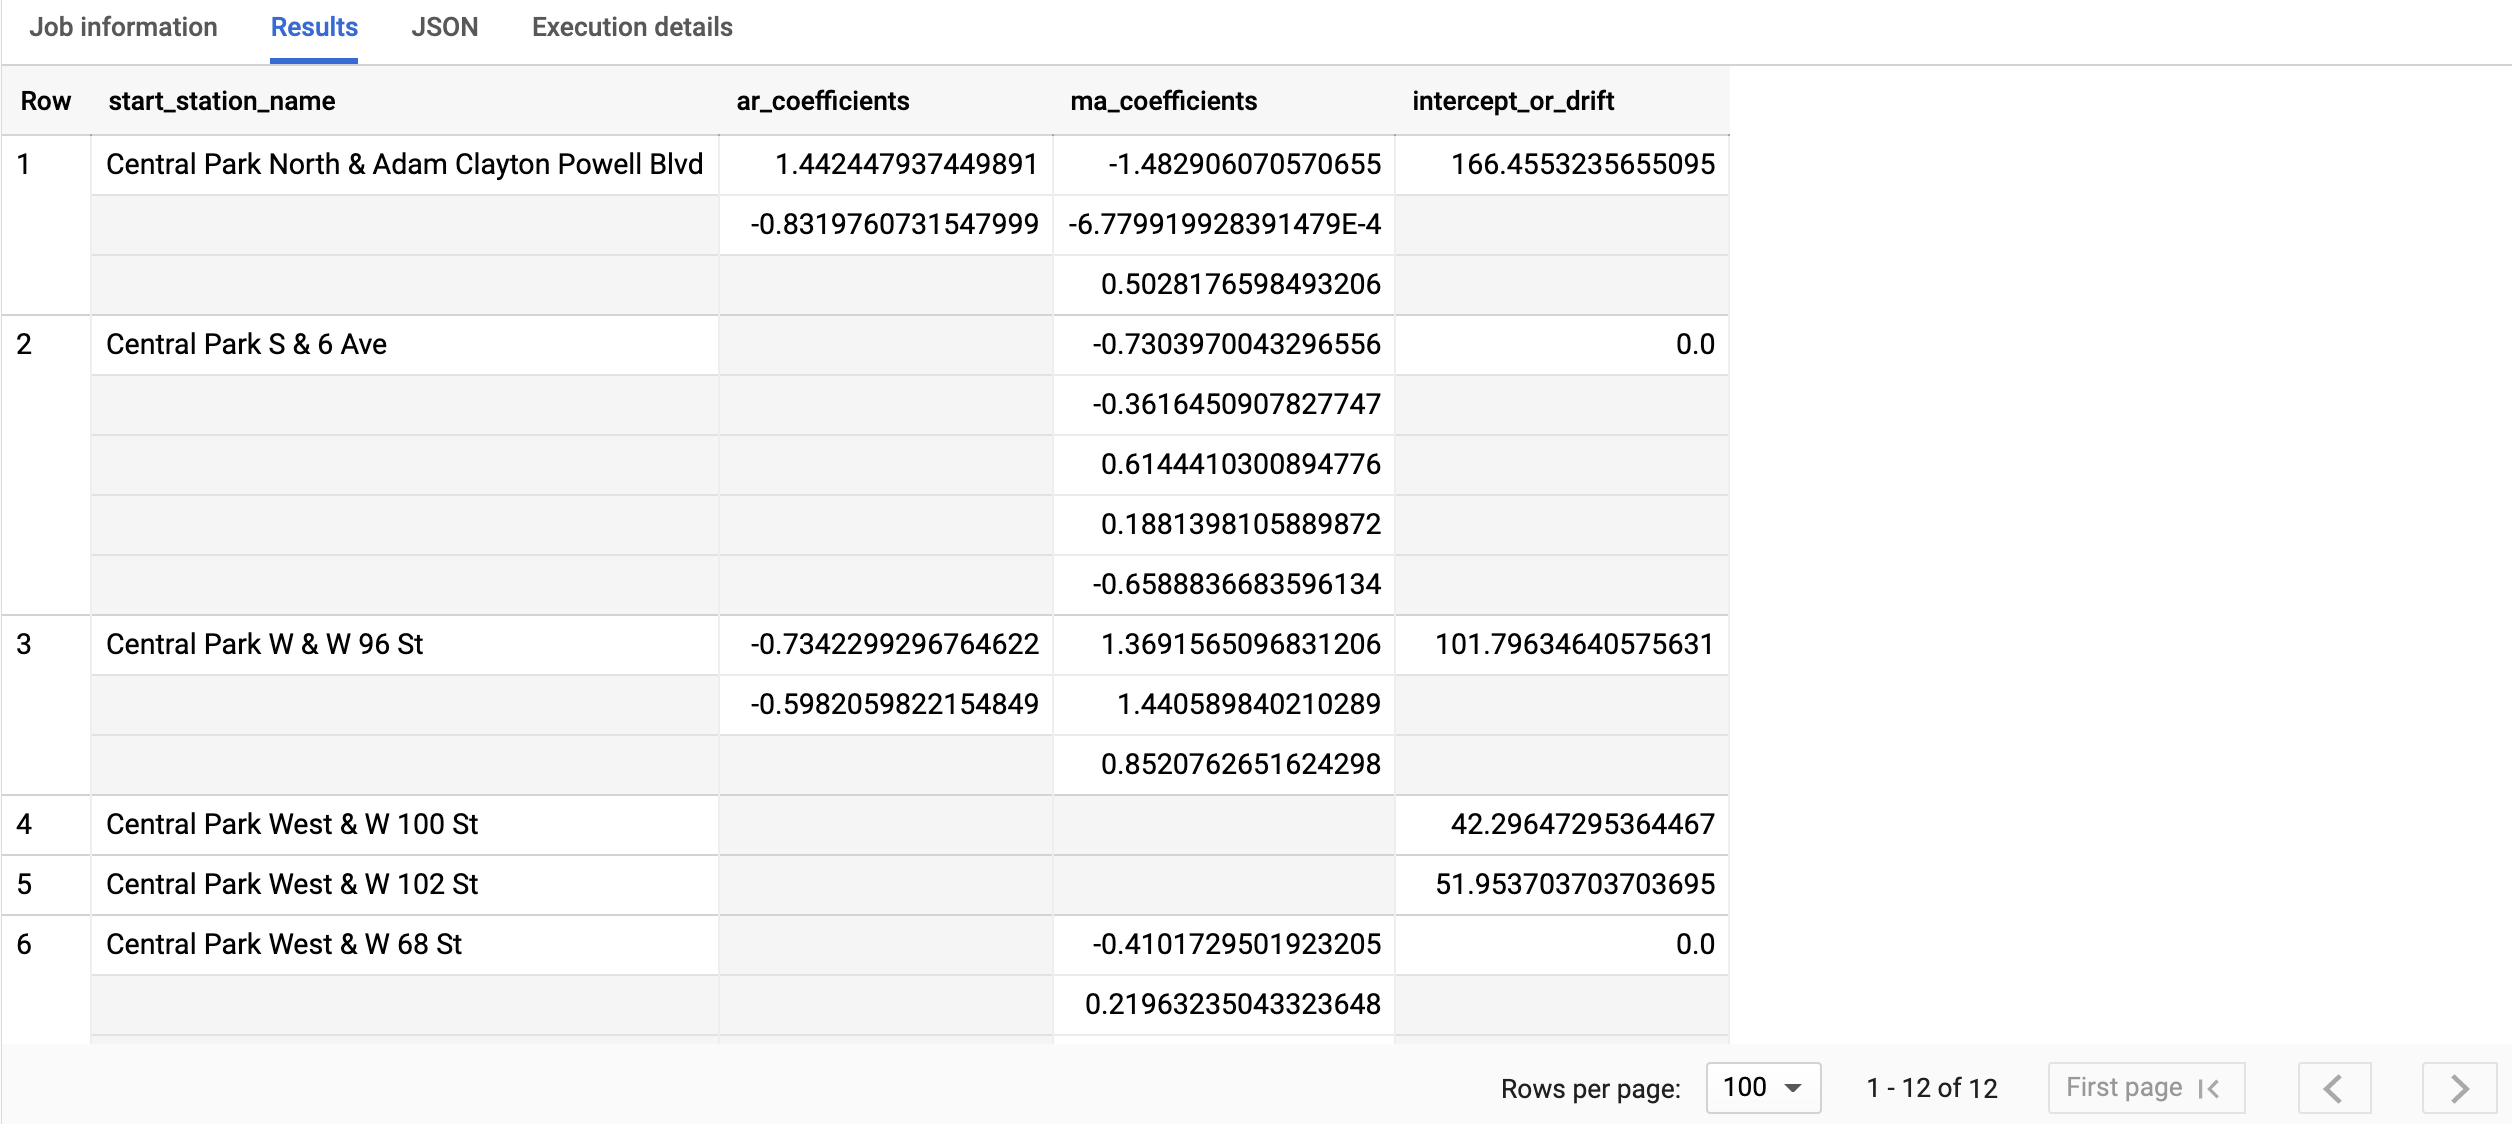
Die Abfrage dauert weniger als eine Sekunde. Die Antwort sollte in etwa so aussehen:
Weitere Informationen zu den Ausgabespalten finden Sie unter
ML.ARIMA_COEFFICIENTS-Funktion.
BigQuery DataFrames
Prüfen Sie die Koeffizienten des Zeitachsenmodells mit der Funktion coef_.
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
In der Spalte start_station_name wird die Eingabedatenspalte angegeben, für die Zeitreihen erstellt wurden. Dies ist die Spalte, die Sie beim Erstellen des Modells in der Option time_series_id_col angegeben haben.
In der Ausgabespalte ar_coefficients werden die Modellkoeffizienten des autoregressiven (AR) Teils des ARIMA-Modells angezeigt. Entsprechend werden in der Ausgabespalte ma_coefficients die Modellkoeffizienten des Teils des gleitenden Durchschnitts (Moving Average, MA) des ARIMA-Modells angezeigt. Beide Spalten enthalten Arraywerte, deren Länge non_seasonal_p bzw. non_seasonal_q entspricht. Der Wert intercept_or_drift ist der konstante Term im ARIMA-Modell.
Modell zum Vorhersagen von Daten verwenden
SQL
Mit der Funktion ML.FORECAST können Sie zukünftige Zeitreihenwerte prognostizieren.
In der folgenden GoogleSQL-Abfrage gibt die STRUCT(3 AS horizon, 0.9 AS confidence_level)-Klausel an, dass die Abfrage 3 zukünftige Zeitpunkte prognostiziert und ein Vorhersageintervall mit einem Konfidenzniveau von 90% generiert.
So prognostizieren Sie Daten mit dem Modell:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Fügen Sie die folgende Abfrage in den Abfrageeditor ein und klicken Sie auf Ausführen:
SELECT
*
FROM
ML.FORECAST(MODEL `bqml_tutorial.nyc_citibike_arima_model_group`,
 STRUCT(3 AS horizon, 0.9 AS confidence_level))
Klicken Sie auf Ausführen.
Die Abfrage dauert weniger als eine Sekunde. Die Ergebnisse sollten so aussehen:
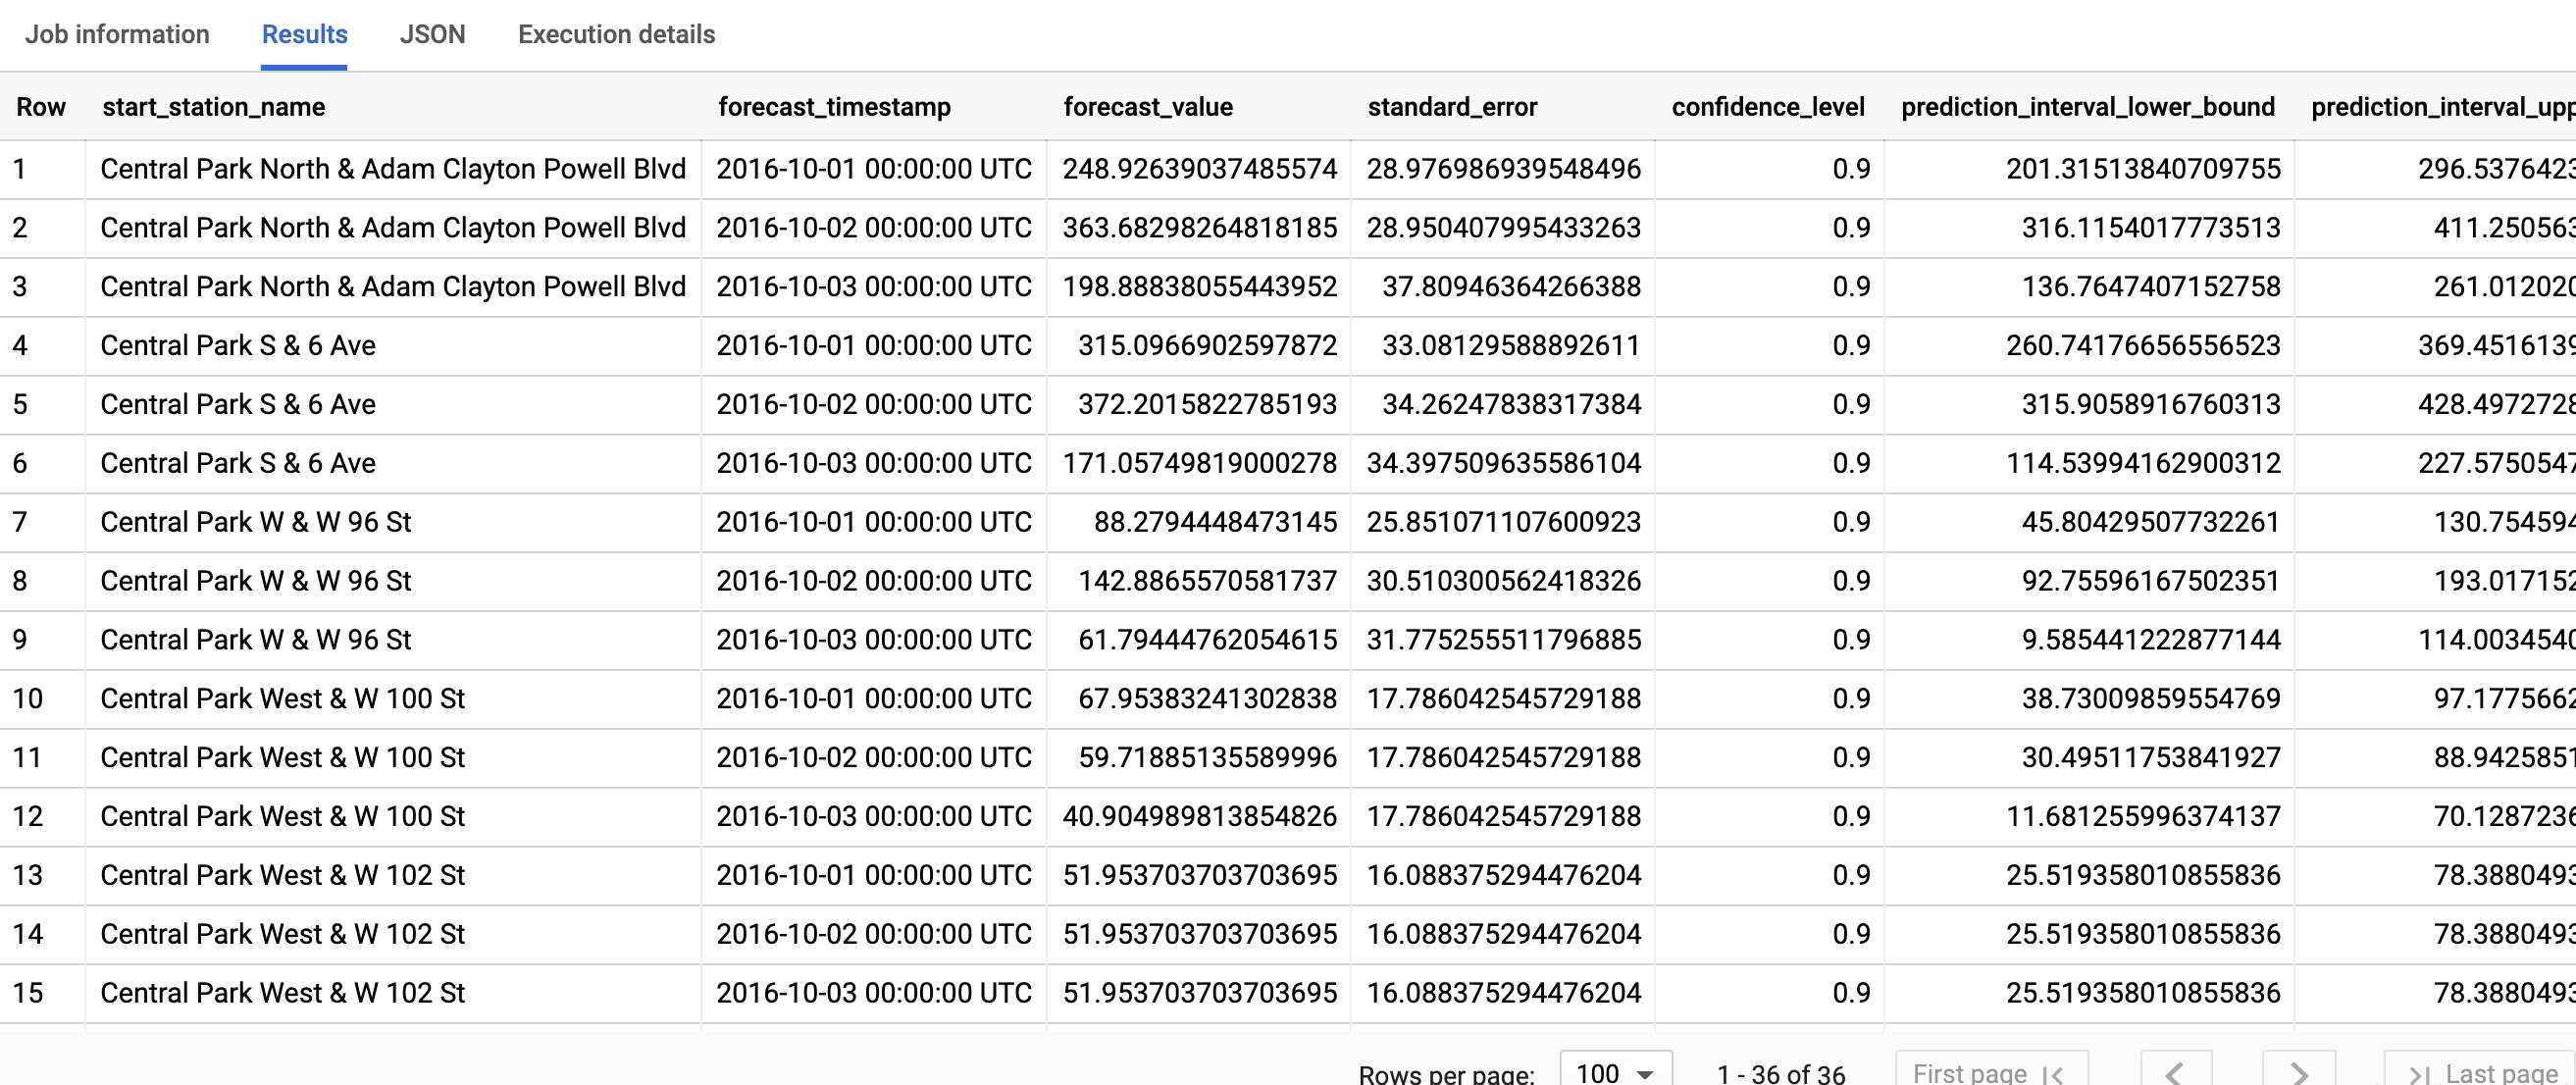
Weitere Informationen zu den Ausgabespalten finden Sie unter ML.FORECAST-Funktion.
BigQuery DataFrames
Mit der Funktion predict können Sie zukünftige Zeitreihenwerte prognostizieren.
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die erste Spalte, start_station_name, annotiert die Zeitreihe, an die das jeweilige Zeitreihenmodell angepasst wird. Jeder start_station_name hat drei Zeilen mit prognostizierten Ergebnissen, wie durch den Wert horizon angegeben.
Bei jedem start_station_name sind die Ausgabezeilen in chronologischer Reihenfolge nach dem Spaltenwert forecast_timestamp angeordnet. Bei der Zeitreihenprognose ist das Vorhersageintervall, das durch die Spaltenwerte prediction_interval_lower_bound und prediction_interval_upper_bound dargestellt wird, genauso wichtig wie der Spaltenwert forecast_value. Der forecast_value-Wert ist der Mittelpunkt des Vorhersageintervalls. Das Vorhersageintervall hängt von den Spaltenwerten standard_error und confidence_level ab.
Prognoseergebnisse erklären
SQL
Mit der Funktion ML.EXPLAIN_FORECAST können Sie neben Prognosedaten auch Messwerte zur Erklärbarkeit abrufen. Die Funktion ML.EXPLAIN_FORECAST prognostiziert zukünftige Zeitreihenwerte und gibt auch alle separaten Komponenten der Zeitreihe zurück. Wenn Sie nur Vorhersagedaten zurückgeben möchten, verwenden Sie stattdessen die Funktion ML.FORECAST, wie unter Modell zum Vorhersagen von Daten verwenden beschrieben.
Die in der Funktion ML.EXPLAIN_FORECAST verwendete STRUCT(3 AS horizon, 0.9 AS confidence_level)-Klausel gibt an, dass die Abfrage drei zukünftige Zeitpunkte prognostiziert und ein Vorhersageintervall mit einer Konfidenz von 90% generiert.
So erklären Sie die Ergebnisse des Modells:
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Fügen Sie die folgende Abfrage in den Abfrageeditor ein und klicken Sie auf Ausführen:
SELECT
*
FROM
ML.EXPLAIN_FORECAST(MODEL `bqml_tutorial.nyc_citibike_arima_model_group`,
 STRUCT(3 AS horizon, 0.9 AS confidence_level));
Die Abfrage dauert weniger als eine Sekunde. Die Ergebnisse sollten so aussehen:
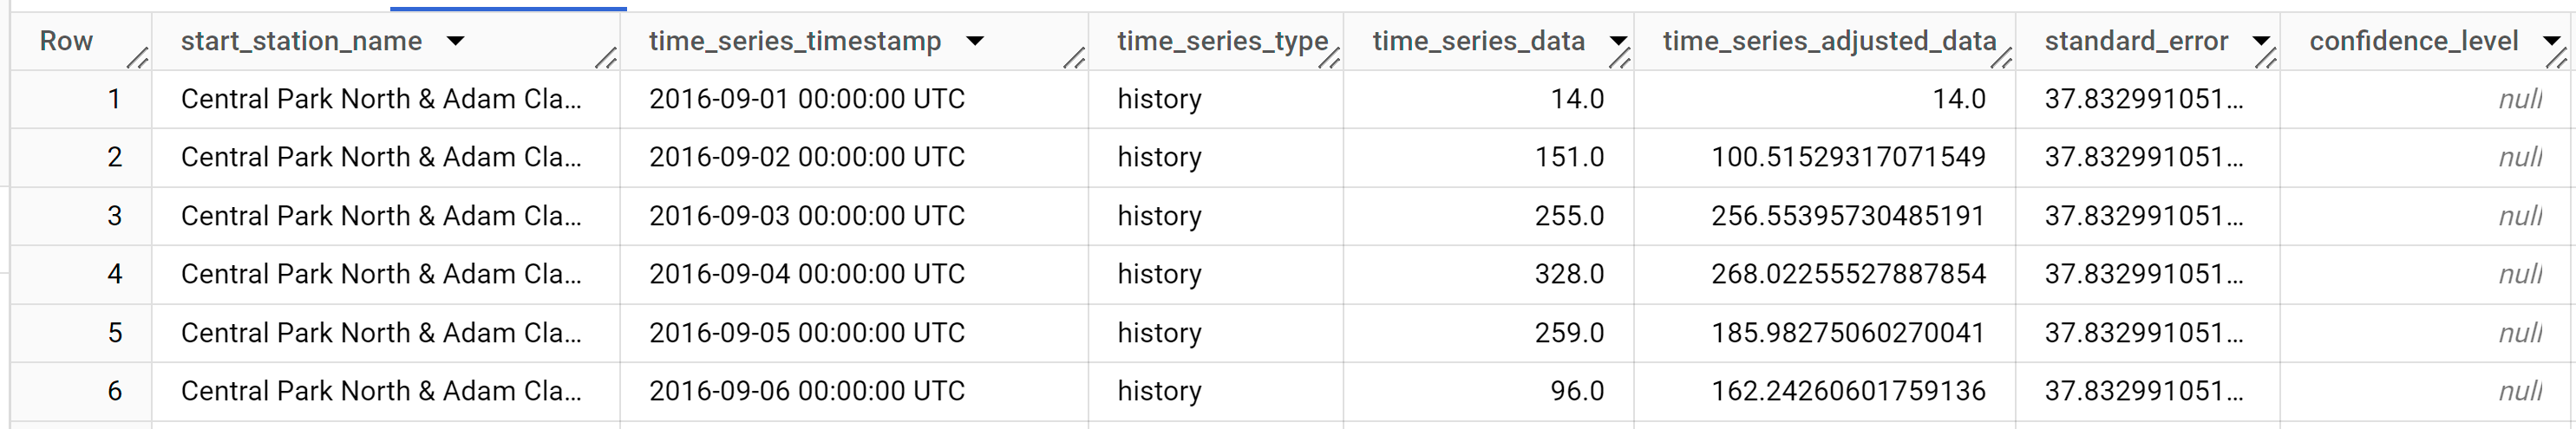
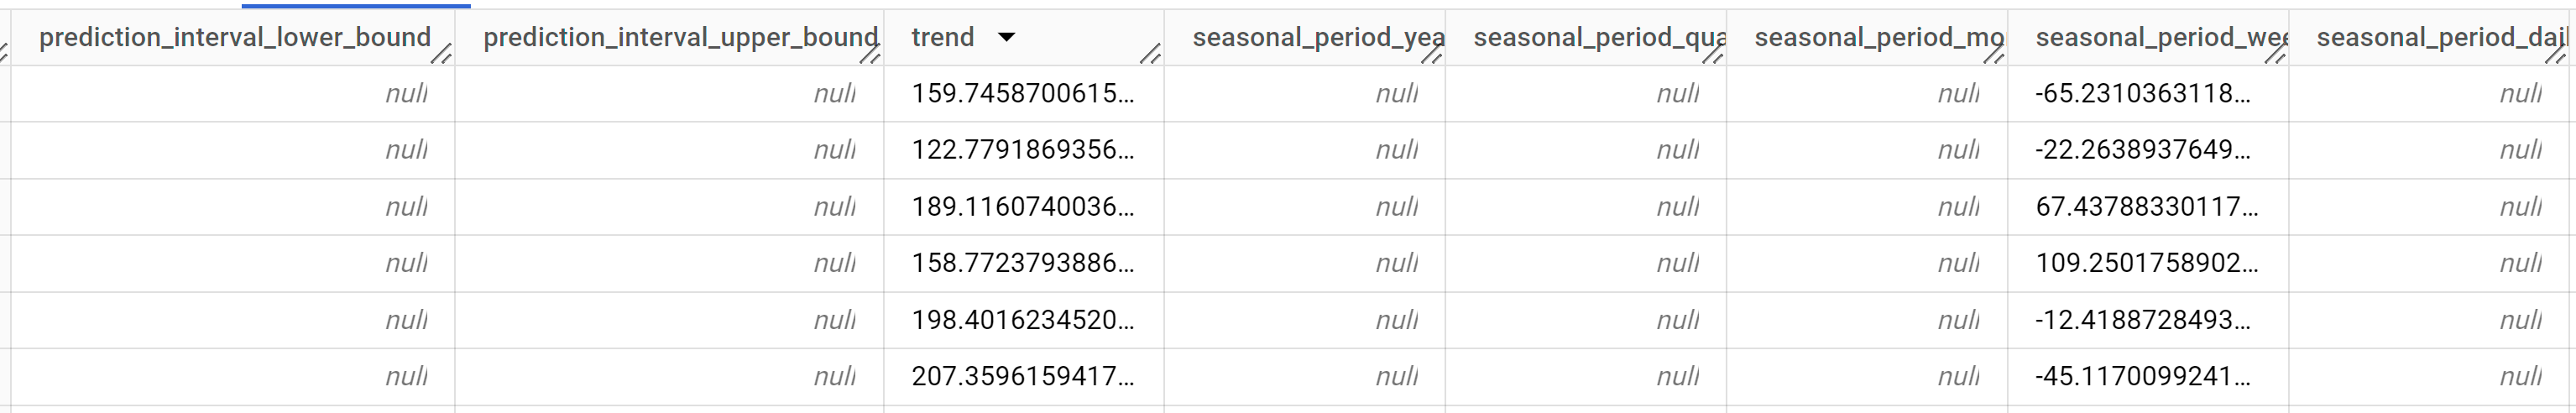
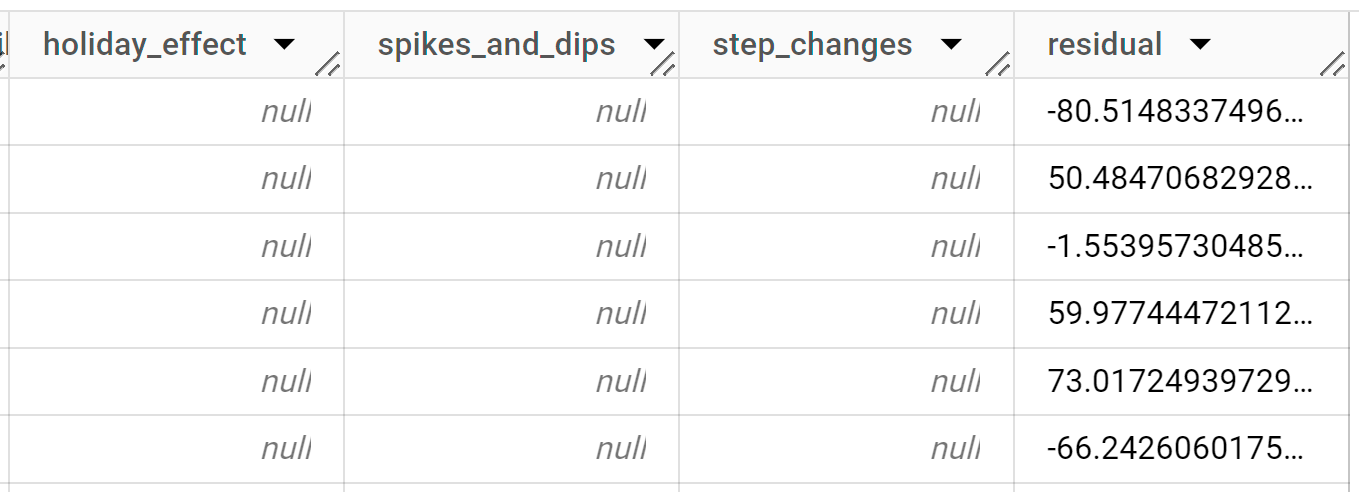
Die ersten tausend zurückgegebenen Zeilen enthalten alle Verlaufsdaten. Sie müssen durch die Ergebnisse scrollen, um die Prognosedaten zu sehen.
Die Ausgabezeilen werden zuerst nach
start_station_nameund dann chronologisch nach dem Spaltenwerttime_series_timestampsortiert. Bei der Zeitreihenprognose ist das Vorhersageintervall, das durch die Spaltenwerteprediction_interval_lower_boundundprediction_interval_upper_bounddargestellt wird, genauso wichtig wie der Spaltenwertforecast_value. Derforecast_value-Wert ist der Mittelpunkt des Vorhersageintervalls. Das Vorhersageintervall hängt von den Spaltenwertenstandard_errorundconfidence_levelab.Weitere Informationen zu den Ausgabespalten finden Sie unter
ML.EXPLAIN_FORECAST.
BigQuery DataFrames
Mit der Funktion predict_explain können Sie neben Prognosedaten auch Messwerte zur Erklärbarkeit abrufen. Die Funktion predict_explain prognostiziert zukünftige Zeitreihenwerte und gibt auch alle separaten Komponenten der Zeitreihe zurück. Wenn Sie nur Vorhersagedaten zurückgeben möchten, verwenden Sie stattdessen die Funktion predict, wie unter Modell zum Vorhersagen von Daten verwenden beschrieben.
Die in der Funktion predict_explain verwendete horizon=3, confidence_level=0.9-Klausel gibt an, dass die Abfrage drei zukünftige Zeitpunkte prognostiziert und ein Vorhersageintervall mit einer Konfidenz von 90% generiert.
Bevor Sie dieses Beispiel ausprobieren, folgen Sie den Schritten zur Einrichtung von BigQuery DataFrames in der BigQuery-Kurzanleitung: BigQuery DataFrames verwenden. Weitere Informationen finden Sie in der Referenzdokumentation zu BigQuery DataFrames.
Richten Sie zur Authentifizierung bei BigQuery die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter ADC für eine lokale Entwicklungsumgebung einrichten.
Die Ausgabezeilen werden zuerst nach time_series_timestamp und dann chronologisch nach dem Spaltenwert start_station_name sortiert. Bei der Zeitreihenprognose ist das Vorhersageintervall, das durch die Spaltenwerte prediction_interval_lower_bound und prediction_interval_upper_bound dargestellt wird, genauso wichtig wie der Spaltenwert forecast_value. Der forecast_value-Wert ist der Mittelpunkt des Vorhersageintervalls. Das Vorhersageintervall hängt von den Spaltenwerten standard_error und confidence_level ab.
Bereinigen
Damit Ihrem Google Cloud-Konto die in dieser Anleitung verwendeten Ressourcen nicht in Rechnung gestellt werden, löschen Sie entweder das Projekt, das die Ressourcen enthält, oder Sie behalten das Projekt und löschen die einzelnen Ressourcen.
- Sie können das von Ihnen erstellte Projekt löschen.
- Sie können das Projekt aber auch behalten und das Dataset löschen.
Dataset löschen
Wenn Sie Ihr Projekt löschen, werden alle Datasets und Tabellen entfernt. Wenn Sie das Projekt wieder verwenden möchten, können Sie das in dieser Anleitung erstellte Dataset löschen:
Rufen Sie, falls erforderlich, die Seite „BigQuery“ in derGoogle Cloud Console auf.
Wählen Sie im Navigationsbereich das Dataset bqml_tutorial aus, das Sie erstellt haben.
Klicken Sie auf Dataset löschen, um das Dataset, die Tabelle und alle Daten zu löschen.
Bestätigen Sie im Dialogfeld Dataset löschen den Löschbefehl. Geben Sie dazu den Namen des Datasets (
bqml_tutorial) ein und klicken Sie auf Löschen.
Projekt löschen
So löschen Sie das Projekt:
- Wechseln Sie in der Google Cloud -Console zur Seite Ressourcen verwalten.
- Wählen Sie in der Projektliste das Projekt aus, das Sie löschen möchten, und klicken Sie dann auf Löschen.
- Geben Sie im Dialogfeld die Projekt-ID ein und klicken Sie auf Shut down (Beenden), um das Projekt zu löschen.
Nächste Schritte
- Weitere Informationen zum Prognostizieren einer einzelnen Zeitreihe mit einem univariaten Modell
- Weitere Informationen zum Prognostizieren einer einzelnen Zeitreihe mit einem multivariaten Modell
- Informationen zum Skalieren eines univariaten Modells bei der Prognose mehrerer Zeitreihen über viele Zeilen hinweg
- Hierarchische Prognosen für mehrere Zeitreihen mit einem univariaten Modell erstellen
- Eine Übersicht über BigQuery ML finden Sie unter Einführung in KI und ML in BigQuery.