


Este documento no Google Cloud Well-Architected Framework descreve princípios e recomendações para ajudar você a projetar, criar e gerenciar aplicativos de serviços financeiros (FS, na sigla em inglês) no Google Cloud que atendam às suas metas operacionais, de segurança, confiabilidade, custo e meta de performance.
O público-alvo deste documento inclui tomadores de decisão, arquitetos, administradores, desenvolvedores e operadores que projetam, criam, implantam e mantêm cargas de trabalho de FS no Google Cloud. Exemplos de organizações de SF que podem se beneficiar dessas orientações incluem bancos, participantes de infraestrutura de pagamento, provedores de seguros e operadores de mercado de capitais.
As organizações de FS têm considerações específicas, principalmente para arquitetura e resiliência. Essas considerações são motivadas principalmente por requisitos regulatórios, de risco e de desempenho. Este documento fornece orientações de alto nível com base em considerações de design que observamos em uma ampla variedade de clientes de FS no mundo todo. Se as cargas de trabalho estão totalmente na nuvem ou em transição para implantações híbridas ou multicloud, as orientações neste documento ajudam a projetar cargas de trabalho no Google Cloud para atender aos requisitos regulatórios e às diversas perspectivas de risco. As orientações podem não abordar os desafios específicos de cada organização. Ele fornece uma base que atende a muitos dos principais requisitos regulatórios das organizações de FS.
Um dos principais desafios ao projetar cargas de trabalho na nuvem é alinhar as implantações na nuvem com os ambientes locais, especialmente quando você busca abordagens consistentes de segurança, confiabilidade e resiliência. Os serviços de nuvem criam oportunidades para repensar fundamentalmente sua arquitetura, a fim de reduzir a sobrecarga de gerenciamento, otimizar custos, aumentar a segurança e melhorar a confiabilidade e a resiliência.
As páginas a seguir descrevem princípios e recomendações específicos para cargas de trabalho de FS para cada pilar do Well-Architected Framework:
- Perspectiva de FS: excelência operacional
- Perspectiva de FS: segurança
- Perspectiva de FS: confiabilidade
- Perspectiva de FS: otimização de custos
- Perspectiva do FS: otimização de desempenho
Colaboradores
Autores:
- Alex Stepney | Arquiteto principal líder
- Phil Bryan | Arquiteto principal de liderança de FSI da EMEA
- Stathis Onasoglou | Arquiteto principal de FSI da EMEA
- Sam Moss | Líder de serviços profissionais de FinOps da EMEA
Outros colaboradores:
- Daniel Lees | Arquiteto de segurança do Cloud
- Danielle Fisla | Líder de portfólio de FS dos EUA, PSO
- Filipe Gracio, PhD | Engenheiro de clientes, especialista em IA/ML
- Gino Pelliccia | Arquiteto principal
- Henry Cheng | Arquiteto principal
- John Bacon | Arquiteto de soluções de parceiros
- Jose Andrade | Engenheiro de clientes, especialista em SRE
- Kumar Dhanagopal | Desenvolvedor de soluções para vários produtos
- Laura Hyatt | Engenheiro de clientes, FSI
- Michael Yang | Líder de consultoria de IA para soluções do setor, FSI
- Nicolas Pintaux | Engenheiro de clientes, especialista em modernização de aplicativos
- Omar Saenz | Engenheiro de parceiros da EMEA, segurança
- Radhika Kanakam | Líder de programa, Google Cloud Well-Architected Framework
- Steve McGhee | Defensor de confiabilidade
- Tarun Sharma | Arquiteto principal
- Yuriy Babenko | Engenheiro de clientes, FSI
Perspectiva de serviços financeiros: excelência operacional
Este documento no Google Cloud Well-Architected Framework: perspectiva de serviços financeiros (FS) fornece uma visão geral dos princípios e recomendações para criar, implantar e operar cargas de trabalho de FS robustas no Google Cloud. Essas recomendações ajudam a configurar elementos básicos, como observabilidade, automação e escalonabilidade. As recomendações neste documento estão alinhadas com o pilar de excelência operacional do Well-Architected Framework.
A excelência operacional é fundamental para as cargas de trabalho de FS no Google Cloud devido à natureza altamente regulamentada e sensível dessas cargas de trabalho. A excelência operacional garante que as soluções de nuvem possam se adaptar às necessidades em evolução e atender aos requisitos de valor, desempenho, segurança e confiabilidade. Falhas nessas áreas podem resultar em perdas financeiras significativas, penalidades regulatórias e danos à reputação.
A excelência operacional oferece os seguintes benefícios para cargas de trabalho de FS:
- Manter a confiança e a reputação: as instituições financeiras dependem muito da confiança dos clientes. Interrupções operacionais ou violações de segurança podem prejudicar gravemente essa confiança e causar a perda de clientes. A excelência operacional ajuda a minimizar esses riscos.
Atender a requisitos rigorosos de compliance regulatório: os serviços financeiros estão sujeitos a regulamentações numerosas e complexas, como as seguintes:
- Regulamento geral de proteção de dados (GDPR) da União Europeia
- Lei de Resiliência Operacional Digital (DORA) da UE
- Lei de Privacidade do Consumidor da Califórnia (CCPA)
- Regulamentações específicas do setor
Processos operacionais, monitoramento e gerenciamento de incidentes robustos são essenciais para demonstrar conformidade com as regulamentações e evitar penalidades.
Garantir a continuidade e a resiliência dos negócios: os mercados e serviços financeiros geralmente operam de forma contínua. Por isso, a alta disponibilidade e a recuperação de desastres eficaz são fundamentais. Os princípios de excelência operacional orientam o design e a implementação de sistemas resilientes. O pilar de confiabilidade oferece mais orientações nessa área.
Proteção de dados sensíveis: as instituições financeiras lidam com grandes volumes de dados financeiros e de clientes altamente sensíveis. Controles operacionais fortes, monitoramento de segurança e resposta rápida a incidentes são cruciais para evitar violações de dados e manter a privacidade. O pilar de segurança oferece mais orientações nessa área.
Otimizar o desempenho de aplicativos essenciais: muitos aplicativos financeiros, como plataformas de negociação e análises em tempo real, exigem alto desempenho e baixa latência. Para atender a esses requisitos de desempenho, você precisa de um design de computação, rede e armazenamento altamente otimizado. O pilar de otimização de desempenho fornece mais orientações nessa área.
Gerenciar custos de maneira eficaz: além da segurança e da confiabilidade, as instituições financeiras também se preocupam com a eficiência de custos. A excelência operacional inclui práticas para otimizar a utilização de recursos e gerenciar os gastos na nuvem. O pilar de otimização de custos oferece mais orientações nessa área.
As recomendações de excelência operacional neste documento são mapeadas para os seguintes princípios fundamentais:
- Definir SLAs e os SLOs e SLIs correspondentes
- Definir e testar processos de gerenciamento de incidentes
- Aprimoramento e inovação contínuos
Definir SLAs e os SLOs e SLIs correspondentes
Em muitas organizações de SF, a disponibilidade de aplicativos normalmente é classificada com base nas métricas de objetivo de tempo de recuperação (RTO) e objetivo de ponto de recuperação (RPO). Para aplicativos essenciais aos negócios que atendem a clientes externos, um contrato de nível de serviço (SLA) também pode ser definido.
Os SLAs precisam de um framework de métricas que represente o comportamento do sistema sob a perspectiva da satisfação do usuário. As práticas de engenharia de confiabilidade do site (SRE) oferecem uma maneira de alcançar o nível de confiabilidade do sistema que você quer. Criar um framework de métricas envolve definir e monitorar os principais indicadores numéricos para entender a integridade do sistema do ponto de vista do usuário. Por exemplo, métricas como latência e taxas de erro quantificam o desempenho de um serviço. Essas métricas são chamadas de indicadores de nível de serviço (SLIs). Desenvolver SLIs eficazes é crucial, porque eles fornecem os dados brutos necessários para avaliar objetivamente a confiabilidade.
Para definir SLAs, SLIs e SLOs significativos, considere as seguintes recomendações:
- Desenvolver e definir SLIs para cada serviço crítico. Defina valores de meta que definem os níveis de desempenho aceitáveis.
- Desenvolva e defina os objetivos de nível de serviço (SLO) que correspondem aos SLIs. Por exemplo, um SLO pode declarar que 99,9% das solicitações precisam ter uma latência inferior a 200 milissegundos.
- Identifique as ações corretivas internas que precisam ser tomadas se um serviço não atender aos SLOs. Por exemplo, para melhorar a resiliência da plataforma, talvez seja necessário concentrar os recursos de desenvolvimento na correção de problemas.
- Validar o requisito de SLA para cada serviço e reconhecer o SLA como o contrato formal com os usuários do serviço.
Exemplos de níveis de serviço
A tabela a seguir mostra exemplos de SLIs, SLOs e SLAs para uma plataforma de pagamento:
| Métrica de negócios | SLI | SLO | SLA |
|---|---|---|---|
| Transação de pagamento concluída | Uma medida quantitativa da porcentagem de todas as transações de pagamento iniciadas que são processadas e confirmadas com sucesso. Exemplo: (número de transações bem-sucedidas ÷ número total de transações válidas) × 100, medido em uma janela contínua de 5 minutos. |
Uma meta interna para manter uma alta porcentagem de transações de pagamento bem-sucedidas durante um período específico. Exemplo: manter uma taxa de sucesso de transações de pagamento de 99,98% em um período de 30 dias, excluindo solicitações inválidas e manutenção planejada. |
Uma garantia contratual para a taxa de sucesso e a velocidade do processamento de transações de pagamento. Exemplo: o provedor de serviços garante que 99,0% das transações de pagamento iniciadas pelo cliente serão processadas e confirmadas em até um segundo. |
| Latência de processamento de pagamentos | O tempo médio que uma transação de pagamento leva para ser processada, desde o início pelo cliente até a confirmação final. Exemplo: tempo médio de resposta em milissegundos para confirmação de transação, medido em uma janela contínua de 5 minutos. |
Uma meta interna para a velocidade com que as transações de pagamento são processadas. Exemplo: garantir que 99,5% das transações de pagamento sejam processadas em até 400 milissegundos em uma janela contínua de 30 dias. |
Um compromisso contratual de resolver problemas críticos de processamento de pagamentos em um período especificado. Exemplo: para problemas críticos de processamento de pagamentos (definidos como uma interrupção que afeta mais de 1% das transações), o provedor de serviços se compromete a resolver o problema em até duas horas a partir do momento em que ele é relatado ou detectado. |
| Disponibilidade da plataforma | A porcentagem de tempo em que a API principal de processamento de pagamentos e a interface do usuário estão operacionais e acessíveis aos clientes. Exemplo: (tempo operacional total − inatividade) ÷ tempo operacional total × 100, medido por minuto. |
Uma meta interna para o tempo de atividade da plataforma de pagamento principal. Exemplo: alcançar 99,995% de disponibilidade da plataforma por mês, excluindo as janelas de manutenção programadas. |
Um compromisso formal e juridicamente vinculativo com os clientes em relação ao tempo de atividade mínimo da plataforma de pagamento, incluindo as consequências em caso de descumprimento. Exemplo: a plataforma vai manter uma disponibilidade mínima de 99,9% por mês, excluindo as janelas de manutenção programadas. Se a disponibilidade ficar abaixo do nível mínimo, o cliente receberá um crédito de serviço de 5% da taxa de serviço mensal para cada queda de 0,1%. |
Use os dados de SLI para monitorar se os sistemas estão dentro dos SLOs definidos e garantir que os SLAs sejam atendidos. Ao usar um conjunto de SLIs bem definidos, engenheiros e desenvolvedores podem monitorar aplicativos de FS nos seguintes níveis:
- Diretamente no serviço em que os aplicativos são implantados, como o Google Kubernetes Engine ou o Cloud Run.
- Usando registros fornecidos por componentes de infraestrutura, como o balanceador de carga.
O OpenTelemetry fornece um padrão de código aberto e um conjunto de tecnologias para capturar todos os tipos de telemetria, incluindo métricas, traces e registros. O Serviço gerenciado do Google Cloud para Prometheus oferece um back-end totalmente gerenciado e altamente escalonável para métricas e operação do Prometheus em grande escala.
Para mais informações sobre SLI, SLO e margens de erro, consulte o manual de SRE.
Para desenvolver mecanismos e painéis de alerta e monitoramento eficazes, use as ferramentas do Google Cloud Observability com o Cloud Monitoring. Para informações sobre recursos de monitoramento e detecção específicos de segurança, consulte o pilar de segurança.
Definir e testar processos de gerenciamento de incidentes
Processos de gerenciamento de incidentes bem definidos e testados regularmente contribuem diretamente para o valor, o desempenho, a segurança e a confiabilidade das cargas de trabalho de FS no Google Cloud. Esses processos ajudam as instituições financeiras a atender aos requisitos regulatórios rigorosos, proteger dados sensíveis, manter a continuidade dos negócios e preservar a confiança dos clientes.
O teste regular dos processos de gerenciamento de incidentes oferece os seguintes benefícios:
- Manter o desempenho sob cargas de pico: testes regulares de desempenho e carga ajudam as instituições financeiras a garantir que os aplicativos e a infraestrutura baseados na nuvem possam lidar com volumes de transações de pico, volatilidade do mercado e outros cenários de alta demanda sem degradação do desempenho. Essa capacidade é crucial para manter uma experiência do usuário perfeita e atender às demandas dos mercados financeiros.
- Identificar possíveis gargalos e limitações: os testes de estresse levam os sistemas ao limite e permitem que as instituições financeiras identifiquem possíveis gargalos e limitações de desempenho antes que afetem as operações críticas. Essa abordagem proativa permite que as instituições financeiras ajustem a infraestrutura e os aplicativos para otimizar o desempenho e a escalonabilidade.
- Validar a confiabilidade e a resiliência: testes regulares, incluindo engenharia de caos ou falhas simuladas, ajudam a validar a confiabilidade e a resiliência dos sistemas financeiros. Esse teste garante que os sistemas possam se recuperar de falhas sem problemas e manter a alta disponibilidade, o que é essencial para a continuidade dos negócios.
- Realizar um planejamento de capacidade eficaz: os testes de desempenho fornecem dados valiosos sobre a utilização de recursos em diferentes condições de carga, o que é crucial para um planejamento de capacidade preciso. As instituições financeiras podem usar esses dados para antecipar proativamente as necessidades futuras de capacidade e evitar problemas de desempenho devido a restrições de recursos.
- Implantar novos recursos e mudanças de código com sucesso: a integração de testes automatizados em pipelines de CI/CD ajuda a garantir que as mudanças e as novas implantações sejam totalmente validadas antes de serem lançadas em ambientes de produção. Essa abordagem reduz significativamente o risco de erros e regressões que podem levar a interrupções operacionais.
- Atender aos requisitos regulatórios de estabilidade do sistema: as regulamentações financeiras geralmente exigem que as instituições tenham práticas de teste robustas para garantir a estabilidade e a confiabilidade dos sistemas críticos. Testes regulares ajudam a demonstrar a conformidade com esses requisitos.
Para definir e testar seus processos de gerenciamento de incidentes, considere as seguintes recomendações.
Estabelecer procedimentos claros de resposta a incidentes
Um conjunto bem estabelecido de procedimentos de resposta a incidentes envolve os seguintes elementos:
- Funções e responsabilidades definidas para comandantes de incidentes, investigadores, comunicadores e especialistas técnicos para garantir uma resposta eficaz e coordenada.
- Protocolos de comunicação e caminhos de escalonamento definidos para garantir que as informações sejam compartilhadas de maneira rápida e eficaz durante incidentes.
- Procedimentos documentados em um runbook ou playbook que descreve as etapas de comunicação, triagem, investigação e resolução.
- Treinamento e preparação regulares que capacitam as equipes com o conhecimento e as habilidades para responder de forma eficaz.
Implementar testes de desempenho e carga regularmente
Os testes regulares de desempenho e carga ajudam a garantir que os aplicativos e a infraestrutura baseados na nuvem possam lidar com cargas de pico e manter o desempenho ideal. O teste de carga simula padrões de tráfego realistas. O teste de estresse leva o sistema ao limite para identificar possíveis gargalos e limitações de desempenho. É possível usar produtos como o Cloud Load Balancing e serviços de teste de carga para simular o tráfego real. Com base nos resultados do teste, é possível ajustar a infraestrutura em nuvem e os aplicativos para otimizar o desempenho e a escalonabilidade. Por exemplo, é possível ajustar a alocação de recursos ou as configurações do aplicativo.
Automatizar testes em pipelines de CI/CD
A incorporação de testes automatizados aos pipelines de CI/CD ajuda a garantir a qualidade e a confiabilidade dos aplicativos em nuvem, validando as mudanças antes da implantação. Essa abordagem reduz significativamente o risco de erros e regressões e ajuda a criar um sistema de software mais estável e robusto. É possível incorporar diferentes tipos de teste nos pipelines de CI/CD, incluindo teste de unidade, de integração e completos. Use produtos como o Cloud Build e o Cloud Deploy para criar e gerenciar seus pipelines de CI/CD.
Melhorar e inovar continuamente
Para cargas de trabalho de serviços financeiros na nuvem, a migração para a nuvem é apenas a etapa inicial. A melhoria e a inovação contínuas são essenciais pelos seguintes motivos:
- Acelere a inovação: aproveite as novas tecnologias, como a IA, para melhorar seus serviços.
- Reduzir custos: elimine ineficiências e otimize o uso de recursos.
- Aumente a agilidade: adapte-se rapidamente às mudanças regulatórias e de mercado.
- Melhorar a tomada de decisões: use produtos de análise de dados, como o BigQuery e o Looker, para tomar decisões fundamentadas.
Para garantir a melhoria e a inovação contínuas, considere as seguintes recomendações.
Realizar retrospectivas regulares
As retrospectivas são vitais para melhorar continuamente os procedimentos de resposta a incidentes e otimizar as estratégias de teste com base nos resultados de testes regulares de desempenho e carga. Para garantir que as retrospectivas sejam eficazes, faça o seguinte:
- Dê às equipes a oportunidade de refletir sobre as experiências, identificar o que deu certo e apontar áreas de melhoria.
- Realize retrospectivas após marcos do projeto, incidentes graves ou ciclos de teste significativos. As equipes podem aprender com os sucessos e fracassos e refinar continuamente os processos e as práticas.
- Use uma abordagem estruturada, como o modelo começar-parar-continuar, para garantir que as sessões de retrospectiva sejam produtivas e levem a etapas acionáveis.
- Use retrospectivas para identificar áreas em que a automação do gerenciamento de mudanças pode ser aprimorada para melhorar a confiabilidade e reduzir os riscos.
Promover uma cultura de aprendizado
Uma cultura de aprendizado facilita a exploração segura de novas tecnologias em Google Cloud, como recursos de IA e ML para melhorar serviços como detecção de fraudes e consultoria financeira personalizada. Para promover uma cultura de aprendizado, faça o seguinte:
- Incentive as equipes a testar, compartilhar conhecimento e aprender continuamente.
- Adote uma cultura livre de humilhação, em que as falhas são vistas como oportunidades de crescimento e melhoria.
- Crie um ambiente psicologicamente seguro que permita que as equipes assumam riscos e considerem soluções inovadoras. As equipes aprendem com os sucessos e os fracassos, o que leva a uma organização mais resiliente e adaptável.
- Desenvolva uma cultura que facilite o compartilhamento do conhecimento adquirido com processos de gerenciamento de incidentes e exercícios de teste.
Ficar por dentro das tecnologias de nuvem
O aprendizado contínuo é essencial para entender e implementar novas medidas de segurança, aproveitar a análise de dados avançada para gerar insights melhores e adotar soluções inovadoras relevantes para os serviços financeiros.
- Maximize o potencial dos serviços do Google Cloud ficando por dentro dos avanços, recursos e práticas recomendadas mais recentes.
- Quando novos recursos e serviços do Google Cloud forem lançados, identifique oportunidades para automatizar ainda mais os processos, aumentar a segurança e melhorar o desempenho e a escalonabilidade dos seus aplicativos.
- Participe de conferências, webinars e sessões de treinamento relevantes para ampliar seu conhecimento e entender os novos recursos.
- Incentive os membros da equipe a obter certificações doGoogle Cloud para garantir que a organização tenha as habilidades necessárias para o sucesso na nuvem.
Perspectiva dos serviços financeiros: segurança, privacidade e compliance
Este documento no Google Cloud Well-Architected Framework: perspectiva de serviços financeiros (FS) oferece uma visão geral dos princípios e recomendações para atender aos requisitos de segurança, privacidade e conformidade das cargas de trabalho de serviços financeiros (FS) no Google Cloud. As recomendações ajudam você a criar uma infraestrutura resiliente e em conformidade, proteger dados sensíveis, manter a confiança do cliente, navegar pelo cenário complexo de requisitos regulatórios e gerenciar ameaças cibernéticas de maneira eficaz. As recomendações neste documento estão alinhadas com o pilar de segurança do Well-Architected Framework.
A segurança na computação em nuvem é uma preocupação crítica para as organizações de SF, que são muito atraentes para os cibercriminosos devido às grandes quantidades de dados confidenciais que gerenciam, incluindo detalhes de clientes e registros financeiros. As consequências de uma violação de segurança são excepcionalmente graves, incluindo perdas financeiras significativas, danos à reputação de longo prazo e multas regulatórias significativas. Portanto, as cargas de trabalho de FS precisam de controles de segurança rigorosos.
Para garantir segurança e conformidade abrangentes, é preciso entender as responsabilidades compartilhadas entre você (organizações de FS) e o Google Cloud. O Google Cloud é responsável por proteger a infraestrutura subjacente, incluindo a segurança física e a segurança de rede. Você é responsável por proteger dados e aplicativos, configurar o controle de acesso e configurar e gerenciar serviços de segurança. Para ajudar você nas suas iniciativas de segurança, o ecossistema de parceiros doGoogle Cloud oferece integração de segurança e serviços gerenciados.
As recomendações de segurança neste documento são mapeadas para os seguintes princípios básicos:
- Implementar a segurança incorporada ao design
- Implementar a confiança zero
- Implementar a segurança shift left
- Implementar a defesa cibernética preventiva
- Use a IA de forma segura e responsável, e use a IA para segurança
- Atender às necessidades regulatórias, de compliance e de privacidade
- Priorizar iniciativas de segurança
Implementar a segurança incorporada ao design
Regulamentações financeiras, como o Padrão de Segurança de Dados do Setor de Cartões de Pagamento (PCI DSS), a Lei Gramm-Leach-Bliley (GLBA) nos Estados Unidos e várias leis nacionais de proteção de dados financeiros, exigem que a segurança seja integrada aos sistemas desde o início. O princípio de segurança incorporada ao design enfatiza a integração da segurança em todo o ciclo de vida de desenvolvimento para ajudar a garantir que as vulnerabilidades sejam minimizadas desde o início.
Para aplicar o princípio de segurança por design às cargas de trabalho de FS no Google Cloud, considere as seguintes recomendações:
- Garanta que apenas as permissões necessárias sejam concedidas aplicando o princípio de privilégio mínimo por meio do controle de acesso granular baseado em papéis (RBAC) no Identity and Access Management (IAM). O uso do RBAC é um requisito fundamental em muitas regulamentações financeiras.
- Aplique perímetros de segurança em torno dos seus serviços e dados confidenciais no Google Cloud usando o VPC Service Controls. Os perímetros de segurança ajudam a segmentar e proteger dados e recursos sensíveis, além de evitar a exfiltração de dados e o acesso não autorizado, conforme exigido pelas regulamentações.
- Defina as configurações de segurança como código usando ferramentas de infraestrutura como código (IaC, na sigla em inglês), como o Terraform. Essa abordagem incorpora controles de segurança desde a fase inicial de implantação, o que ajuda a garantir consistência e auditabilidade.
- Verifique o código do aplicativo integrando o teste estático de segurança de aplicativos (SAST) ao pipeline de CI/CD com o Cloud Build. Estabeleça portões de segurança automatizados para evitar a implantação de códigos que não estejam em conformidade.
- Forneça uma interface unificada para insights de segurança usando o Security Command Center. O uso do Security Command Center permite o monitoramento contínuo e a detecção precoce de configurações incorretas ou ameaças que podem levar a violações regulatórias. Para atender aos requisitos de padrões como ISO 27001 e NIST 800-53, use modelos de gerenciamento de postura.
- Acompanhe a redução nas vulnerabilidades identificadas em implantações de produção e a porcentagem de implantações de IaC que seguem as práticas recomendadas de segurança. É possível detectar e visualizar vulnerabilidades e informações sobre conformidade com padrões de segurança usando o Security Command Center. Para mais informações, consulte Descobertas de vulnerabilidade.
Implementar a confiança zero
As regulamentações financeiras modernas enfatizam cada vez mais a necessidade de controles de acesso rigorosos e verificação contínua. Esses requisitos refletem o princípio de confiança zero, que visa proteger as cargas de trabalho contra ameaças internas e externas e agentes nocivos. O princípio de zero trust defende a verificação contínua de cada usuário e dispositivo, o que elimina a confiança implícita e reduz o movimento lateral.
Para implementar a confiança zero, considere as seguintes recomendações:
- Ative o acesso baseado no contexto com base na identidade do usuário, na segurança do dispositivo, no local e em outros fatores combinando os controles do IAM com o Chrome Enterprise Premium. Essa abordagem garante a verificação contínua antes que o acesso a dados e sistemas financeiros seja concedido.
- Forneça um gerenciamento de identidade e acesso seguro e escalonável configurando o Identity Platform (ou seu provedor de identidade externo, se você usar a federação de identidade de colaboradores). Configure a autenticação multifator (MFA) e outros controles que são cruciais para implementar a confiança zero e ajudar a garantir a conformidade regulatória.
- Implemente a MFA para todas as contas de usuário, especialmente para aquelas com acesso a dados ou sistemas sensíveis.
- Ofereça suporte a auditorias e investigações relacionadas à conformidade regulatória estabelecendo registros e monitoramento abrangentes do acesso do usuário e da atividade da rede.
- Ative a comunicação particular e segura entre serviços no Google Cloud e em ambientes locais sem expor o tráfego à Internet pública usando o Private Service Connect.
- Implemente controles de identidade granulares e autorize o acesso no nível do aplicativo usando o Identity-Aware Proxy (IAP) em vez de depender de mecanismos de segurança baseados em rede, como túneis de VPN. Essa abordagem ajuda a reduzir o movimento lateral no ambiente.
Implementar a segurança shift left
Os reguladores financeiros incentivam medidas de segurança proativas. Identificar e resolver vulnerabilidades no início do ciclo de vida de desenvolvimento ajuda a reduzir o risco de incidentes de segurança e o potencial de penalidades por não conformidade. O princípio da segurança shift-left promove testes e integração de segurança antecipados, o que ajuda a reduzir o custo e a complexidade da correção.
Para implementar a segurança shift-left, considere as seguintes recomendações:
Garanta verificações de segurança automatizadas no início do processo de desenvolvimento integrando ferramentas de verificação de segurança, como verificação de vulnerabilidades de contêiner e análise de código estático, ao pipeline de CI/CD com o Cloud Build.
Garanta que apenas artefatos seguros sejam implantados usando o Artifact Registry para fornecer um repositório seguro e centralizado para pacotes de software e imagens de contêiner com verificação de vulnerabilidades integrada. Use repositórios virtuais para mitigar ataques de confusão de dependência, priorizando seus artefatos particulares em relação aos repositórios remotos.
Verifique automaticamente se há vulnerabilidades comuns em aplicativos da Web integrando o Web Security Scanner, que faz parte do Security Command Center, aos pipelines de desenvolvimento.
Implemente verificações de segurança para o código-fonte, o processo de build e a procedência do código usando o framework de níveis da cadeia de suprimentos para artefatos de software (SLSA, na sigla em inglês). Aplique a procedência das cargas de trabalho executadas nos ambientes usando soluções como a autorização binária. Verifique se as cargas de trabalho usam apenas bibliotecas de software de código aberto verificadas usando o Assured Open Source Software.
Acompanhe o número de vulnerabilidades identificadas e corrigidas no ciclo de vida de desenvolvimento, a porcentagem de implantações de código que passam nas verificações de segurança e a redução de incidentes de segurança causados por vulnerabilidades de software. O Google Cloud oferece ferramentas para ajudar nesse acompanhamento para diferentes tipos de cargas de trabalho. Por exemplo, para cargas de trabalho conteinerizadas, use o recurso de verificação de contêineres do Artifact Registry.
Implementa a defesa cibernética preventiva
As instituições financeiras são os principais alvos de ataques cibernéticos sofisticados. As regulamentações geralmente exigem inteligência contra ameaças robusta e mecanismos de defesa proativos. A defesa cibernética preventiva se concentra na detecção e resposta proativas a ameaças usando análises avançadas e automação.
Recomendações:
- Identifique e mitigue possíveis ameaças de forma proativa usando os serviços de inteligência contra ameaças, resposta a incidentes e validação de segurança da Mandiant.
- Proteja aplicativos da Web e APIs contra exploits da Web e ataques DDoS na borda da rede usando o Google Cloud Armor.
- Agregue e priorize as descobertas e recomendações de segurança usando o Security Command Center, que permite que as equipes de segurança lidem de forma proativa com possíveis riscos.
- Valide as defesas preventivas e os planos de resposta a incidentes realizando simulações de segurança e testes de penetração regulares.
- Meça o tempo para detectar e responder a incidentes de segurança, a eficácia dos esforços de mitigação de DDoS e o número de ataques cibernéticos evitados. É possível acessar as métricas e os dados necessários nos painéis do Google Security Operations SOAR.
Use a IA de forma segura e responsável, e use a IA para segurança
A IA e o ML são cada vez mais usados para casos de uso de serviços financeiros, como detecção de fraudes e negociação algorítmica. As regulamentações exigem que essas tecnologias sejam usadas de forma ética, transparente e segura. A IA também pode ajudar a melhorar seus recursos de segurança. Considere as seguintes recomendações para usar a IA:
- Desenvolva e implante modelos de ML em um ambiente seguro e controlado usando a Gemini Enterprise Agent Platform. Recursos como explicabilidade do modelo e métricas de imparcialidade podem ajudar a resolver preocupações com IA responsável.
- Aproveite os recursos de operações e análise de segurança do Google Security Operations, que usa IA e ML para analisar grandes volumes de dados de segurança, detectar anomalias e automatizar a resposta a ameaças. Esses recursos ajudam a melhorar sua postura de segurança geral e auxiliam no monitoramento de conformidade.
- Estabeleça políticas de governança claras para o desenvolvimento e a implantação de IA e ML, incluindo considerações relacionadas à segurança e à ética.
- Alinhar-se aos elementos do Framework de IA Segura (SAIF), que oferece uma abordagem prática para lidar com as preocupações de segurança e risco dos sistemas de IA.
- Acompanhe a precisão e a eficácia dos sistemas de detecção de fraudes com tecnologia de IA, a redução de falsos positivos em alertas de segurança e os ganhos de eficiência com a automação de segurança baseada em IA.
Atender às necessidades regulatórias, de compliance e de privacidade
Os serviços financeiros estão sujeitos a uma ampla gama de regulamentações, incluindo requisitos de residência de dados, trilhas de auditoria específicas e padrões de proteção de dados. Para garantir que os dados sensíveis sejam identificados, protegidos e gerenciados adequadamente, as organizações de SF precisam de políticas robustas de governança de dados e esquemas de classificação de dados. Considere as seguintes recomendações para ajudar você a atender aos requisitos regulamentares:
- Configure limites de dados no Google Cloud para cargas de trabalho sensíveis e regulamentadas usando o Assured Workloads. Isso ajuda você a atender aos requisitos de conformidade governamentais e específicos do setor, como FedRAMP e CJIS.
- Identifique, classifique e proteja dados sensíveis, incluindo informações financeiras, implementando a Proteção de Dados Sensíveis. Isso ajuda você a cumprir regulamentos de privacidade de dados, como o GDPR e a CCPA.
- Acompanhe detalhes de atividades administrativas e acesso a recursos usando os Registros de auditoria do Cloud. Esses registros são essenciais para atender aos requisitos de auditoria estipulados por muitas regulamentações financeiras.
- Ao escolher as regiões doGoogle Cloud para suas cargas de trabalho e dados, considere as regulamentações locais relacionadas à residência de dados. A infraestrutura global do Google Cloud permite escolher regiões que podem ajudar você a atender aos requisitos de residência de dados.
- Gerencie as chaves usadas para criptografar dados financeiros sensíveis em repouso e em trânsito usando o Cloud Key Management Service. Essa criptografia é um requisito fundamental de muitos regulamentos de segurança e privacidade.
- Implemente os controles necessários para atender aos requisitos regulatórios. Verifique se os controles funcionam conforme o esperado. Peça para um auditor externo validar os controles novamente para provar ao regulador que suas cargas de trabalho estão em conformidade com as regulamentações.
Priorizar iniciativas de segurança
Dada a amplitude dos requisitos de segurança, as instituições financeiras precisam priorizar iniciativas baseadas em avaliações de risco e mandatos regulatórios. Recomendamos a seguinte abordagem em fases:
- Estabeleça uma base de segurança sólida: concentre-se nas principais áreas de segurança, incluindo gerenciamento de identidade e acesso, segurança de rede e proteção de dados. Esse foco ajuda a criar uma postura de segurança robusta e a garantir uma defesa abrangente contra ameaças em evolução.
- Abordar regulamentações críticas: priorize a conformidade com regulamentações importantes, como PCI DSS, GDPR e leis nacionais relevantes. Isso ajuda a garantir a proteção de dados, reduz os riscos legais e gera confiança entre os clientes.
- Implementar segurança avançada: adote gradualmente práticas de segurança avançadas, como zero trust, soluções de segurança orientadas por IA e busca proativa de ameaças.
Perspectiva de serviços financeiros: confiabilidade
Este documento no Google Cloud Well-Architected Framework: perspectiva de serviços financeiros (FS) oferece uma visão geral dos princípios e recomendações para projetar, implantar e operar cargas de trabalho de FS confiáveis no Google Cloud. O documento explica como integrar práticas avançadas de confiabilidade e observabilidade aos seus blueprints de arquitetura. As recomendações neste documento estão alinhadas com o pilar de confiabilidade do Well-Architected Framework.
Para as instituições financeiras, uma infraestrutura confiável e resiliente é uma necessidade comercial e um imperativo regulatório. Para garantir que as cargas de trabalho de FS em Google Cloud sejam confiáveis, é preciso entender e mitigar possíveis pontos de falha, implantar recursos de forma redundante e planejar a recuperação. A resiliência operacional é um resultado da confiabilidade. É a capacidade de absorver, se adaptar e se recuperar de interrupções. A resiliência operacional ajuda as organizações de FS a atender a requisitos regulatórios rigorosos. Isso também ajuda a evitar danos intoleráveis aos clientes.
Os principais elementos de confiabilidade no Google Cloud são regiões, zonas e os vários escopos de localização de recursos de nuvem: zonal, regional, multirregional e global. É possível melhorar a disponibilidade usando serviços gerenciados, distribuindo recursos, implementando padrões de alta disponibilidade e automatizando processos.
Requisitos regulatórios
As organizações de FS operam sob mandatos de confiabilidade rigorosos de agências reguladoras, como o Federal Reserve System nos EUA, a Autoridade Bancária Europeia na UE e a Autoridade de Regulação Prudencial no Reino Unido. Em todo o mundo, os reguladores enfatizam a resiliência operacional, que é vital para a estabilidade financeira e a proteção do consumidor. A resiliência operacional é a capacidade de resistir a interrupções, se recuperar de maneira eficaz e manter serviços críticos. Isso exige uma abordagem harmonizada para gerenciar riscos tecnológicos e dependências de terceiros.
Os requisitos regulatórios na maioria das jurisdições têm os seguintes temas comuns:
- Cibersegurança e resiliência tecnológica: fortalecimento das defesas contra ameaças cibernéticas e garantia da resiliência dos sistemas de TI.
- Gerenciamento de riscos de terceiros: gerenciar os riscos associados à terceirização de serviços para provedores de tecnologia da informação e comunicação (TIC).
- Continuidade dos negócios e resposta a incidentes: planejamento robusto para manter as operações críticas durante interrupções e se recuperar de maneira eficaz.
- Proteção da estabilidade financeira: garantir a solidez e a estabilidade do sistema financeiro como um todo.
As recomendações de confiabilidade neste documento são mapeadas para os seguintes princípios fundamentais:
- Priorizar implantações multizona e multirregionais
- Eliminar pontos únicos de falha (SPOFs)
- Entender e gerenciar a disponibilidade agregada
- Implementar uma estratégia de DR robusta
- Aproveitar os serviços gerenciados
- Automatizar os processos de provisionamento e recuperação da infraestrutura
Priorizar implantações multizona e multirregionais
Para aplicativos de serviços financeiros críticos, recomendamos o uso de uma topologia multirregional distribuída em pelo menos duas regiões e em três zonas dentro de cada região. Essa abordagem é importante para a resiliência contra interrupções de zona e região. As regulamentações geralmente prescrevem essa abordagem, porque, se ocorrer uma falha em uma zona ou região, a maioria das jurisdições considera uma interrupção grave em uma segunda zona como uma consequência plausível. A lógica é que, quando um local falha, o outro pode receber uma quantidade excepcionalmente alta de tráfego extra.
Considere as seguintes recomendações para aumentar a resiliência contra falhas de zona e região:
- Dê preferência a recursos com um escopo de localização mais amplo. Sempre que possível, use recursos regionais em vez de zonais e use recursos multirregionais ou globais em vez de regionais. Essa abordagem ajuda a evitar a necessidade de restaurar operações usando backups.
- Em cada região, use três zonas em vez de duas. Para lidar com failovers, provisione uma capacidade um terço maior do que a estimativa.
- Minimize as etapas de recuperação manual implementando implantações ativo-ativo,
como nos exemplos a seguir:
- Bancos de dados distribuídos, como o Spanner, oferecem redundância e sincronização integradas entre regiões.
- O recurso de alta disponibilidade do Cloud SQL oferece uma topologia quase ativa-ativa, com réplicas de leitura em várias zonas. Ele fornece um objetivo de ponto de recuperação (RPO) entre regiões que é próximo de 0.
- Distribua o tráfego de usuários entre as regiões usando o Cloud DNS e implante um balanceador de carga regional em cada região. Um balanceador de carga global é outra opção que você pode considerar, dependendo dos seus requisitos e da importância. Para mais informações, consulte Benefícios e riscos do balanceamento de carga global para implantações multirregionais.
- Para armazenar dados, use serviços multirregionais, como o Spanner e o Cloud Storage.
Eliminar pontos únicos de falha
Distribua recursos em diferentes locais e use recursos redundantes para evitar que um único ponto de falha (SPOF, na sigla em inglês) afete toda a pilha de aplicativos.
Considere as seguintes recomendações para evitar SPOFs:
- Evite implantar apenas um servidor de aplicativos ou banco de dados.
- Garanta a recriação automática de VMs com falha usando grupos gerenciados de instâncias (MIGs).
- Distribua o tráfego de maneira uniforme entre os recursos disponíveis implementando o balanceamento de carga.
- Use configurações de alta disponibilidade para bancos de dados como o Cloud SQL.
- Melhore a disponibilidade de dados usando discos permanentes regionais com replicação síncrona.
Para mais informações, consulte Criar uma infraestrutura confiável para suas cargas de trabalho no Google Cloud.
Entender e gerenciar a disponibilidade agregada
A disponibilidade geral ou agregada de um sistema é afetada pela disponibilidade de cada nível ou componente do sistema. O número de níveis em uma pilha de aplicativos tem uma relação inversa com a disponibilidade agregada da pilha. Considere as seguintes recomendações para gerenciar a disponibilidade agregada:
Calcule a disponibilidade agregada de uma pilha de vários níveis usando a fórmula tier1_availability × tier2_availability × tierN_availability.
O diagrama a seguir mostra o cálculo da disponibilidade agregada para um sistema de vários níveis que consiste em quatro serviços:
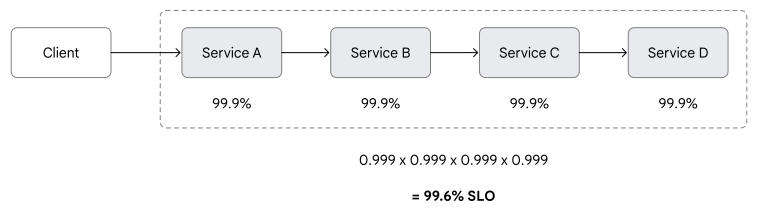
No diagrama anterior, o serviço em cada nível oferece 99,9% de disponibilidade, mas a disponibilidade agregada do sistema é menor, de 99,6% (0,999 × 0,999 × 0,999 × 0,999). Em geral, a disponibilidade agregada de uma pilha de vários níveis é menor que a disponibilidade do nível que fornece a menor disponibilidade.
Sempre que possível, escolha a paralelização em vez do encadeamento. Com serviços paralelizados, a disponibilidade de ponta a ponta é maior do que a disponibilidade de cada serviço individual.
O diagrama a seguir mostra dois serviços, A e B, que são implantados usando as abordagens de encadeamento e paralelização:
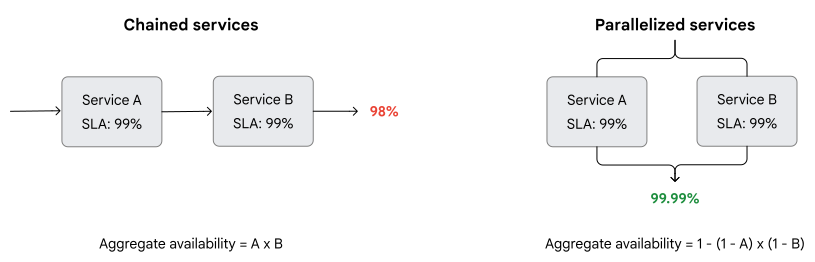
Nos exemplos anteriores, os dois serviços têm um SLA de 99%, o que resulta na seguinte disponibilidade agregada, dependendo da abordagem de implementação:
- Serviços encadeados geram uma disponibilidade agregada de apenas 98% (0,99 × 0,99).
- Os serviços paralelizados geram uma disponibilidade agregada maior de 99,99%, porque cada serviço é executado de forma independente e os serviços individuais não são afetados pela disponibilidade dos outros serviços. A fórmula para serviços paralelizados agregados é 1 − (1 − A) × (1 − B).
Escolha serviços do Google Cloud com SLAs de tempo de atividade que possam ajudar a atender ao nível necessário de tempo de atividade geral para sua pilha de aplicativos.
Ao projetar sua arquitetura, considere as vantagens e desvantagens entre disponibilidade, complexidade operacional, latência e custo. Aumentar o número de noves de disponibilidade geralmente custa mais, mas ajuda a atender aos requisitos regulatórios.
Por exemplo, 99,9% de disponibilidade (três noves) significa um tempo de inatividade potencial de 86 segundos em um dia de 24 horas. Por outro lado, 99% (dois noves) significa uma inatividade de 864 segundos no mesmo período, o que é 10 vezes mais inatividade do que com três noves de disponibilidade.
Para serviços financeiros críticos, as opções de arquitetura podem ser limitadas. No entanto, é fundamental identificar os requisitos de disponibilidade e calculá-la com precisão. Essa avaliação ajuda você a avaliar as implicações das suas decisões de design na arquitetura e no orçamento.
Implementar uma estratégia de DR robusta
Crie planos bem definidos para diferentes cenários de desastre, incluindo interrupções zonais e regionais. Uma estratégia de recuperação de desastres (DR) bem definida permite que você se recupere de uma interrupção e retome as operações normais com o mínimo de impacto.
DR e alta disponibilidade (HA) são conceitos diferentes. Com implantações na nuvem, em geral, a DR se aplica a implantações multirregionais, e a HA se aplica a implantações regionais. Esses arquétipos de implantação oferecem suporte a diferentes mecanismos de replicação.
- HA: muitos serviços gerenciados oferecem replicação síncrona entre zonas em uma única região por padrão. Esses serviços oferecem suporte a um objetivo de tempo de recuperação (RTO) e um objetivo de ponto de recuperação (RPO) de zero ou quase zero. Esse suporte permite criar uma topologia de implantação ativo-ativo que não tem SPOF.
- DR: para cargas de trabalho implantadas em duas ou mais regiões, se você não usar serviços multirregionais ou globais, será necessário definir uma estratégia de replicação. A estratégia de replicação normalmente é assíncrona. Avalie com cuidado como essa replicação afeta o RTO e o RPO de aplicativos críticos. Identifique as operações manuais ou semiautomatizadas necessárias para o failover.
Para instituições financeiras, a escolha da região de failover pode ser limitada por regulamentações sobre soberania de dados e residência de dados. Se você precisar de uma topologia ativo-ativo em duas regiões, recomendamos que escolha serviços multirregionais gerenciados, como o Spanner e o Cloud Storage, especialmente quando a replicação de dados for essencial.
Recomendações:
- Usar serviços de armazenamento multirregional gerenciados para dados.
- Crie snapshots de dados em discos permanentes e armazene-os em locais multirregionais.
- Ao usar recursos regionais ou zonais, configure a replicação de dados para outras regiões.
- Teste o plano de DR regularmente para garantir que ele seja eficaz.
- Esteja ciente do RTO e do RPO e da correlação deles com a tolerância ao impacto estipulada pelas regulamentações financeiras na sua jurisdição.
Para mais informações, consulte Como arquitetar a recuperação de desastres para interrupções da infraestrutura em nuvem.
Aproveitar os serviços gerenciados
Sempre que possível, use serviços gerenciados para aproveitar os recursos integrados de backups, alta disponibilidade e escalonabilidade. Considere as seguintes recomendações para usar serviços gerenciados:
- Usar serviços gerenciados no Google Cloud. Eles fornecem HA com suporte de SLAs. Eles também oferecem mecanismos de backup integrados e recursos de resiliência.
- Para o gerenciamento de dados, considere serviços como Cloud SQL, Cloud Storage e Spanner.
- Para hospedagem de computação e aplicativos, considere os grupos gerenciados de instâncias (MIGs) do Compute Engine e os clusters do Google Kubernetes Engine (GKE). Os MIGs regionais e os clusters regionais do GKE são resilientes a falhas temporárias de zonas.
- Para melhorar a resiliência contra interrupções de região, use serviços multirregionais gerenciados.
- Identifique a necessidade de planos de saída para serviços com características exclusivas e defina os planos necessários. Reguladores financeiros como a FCA, a PRA e a EBA exigem que as empresas tenham estratégias e planos de contingência para recuperação de dados e continuidade operacional se o relacionamento com um provedor de nuvem terminar. As empresas precisam avaliar a viabilidade de saída antes de firmar contratos de nuvem e manter a capacidade de mudar de provedor sem interrupção operacional.
- Verifique se os serviços escolhidos são compatíveis com a exportação de dados para um formato aberto, como CSV, Parquet e Avro. Verifique se os serviços são baseados em tecnologias abertas, como o suporte do GKE ao formato Open Container Initiative (OCI) ou ao serviço gerenciado para Apache Airflow.
Automatizar os processos de provisionamento e recuperação da infraestrutura
Automation ajuda a minimizar erros humanos e a reduzir o tempo e os recursos necessários para responder a incidentes. O uso da automação pode ajudar a garantir uma recuperação mais rápida de falhas e resultados mais consistentes. Considere as seguintes recomendações para automatizar o provisionamento e a recuperação de recursos:
- Minimize erros humanos usando ferramentas de infraestrutura como código (IaC), como o Terraform.
- Reduza a intervenção manual automatizando os processos de failover. As respostas automatizadas também podem ajudar a reduzir o impacto das falhas. Por exemplo, é possível usar o Eventarc ou o Workflows para acionar automaticamente ações corretivas em resposta a problemas observados nos registros de auditoria.
- Aumente a capacidade dos recursos de nuvem durante o failover usando o escalonamento automático.
- Aplique automaticamente políticas e proteções para requisitos regulatórios em toda a topologia de nuvem durante a implantação do serviço adotando a engenharia de plataforma.
Perspectiva de serviços financeiros: otimização de custos
Este documento no Google Cloud Well-Architected Framework: perspectiva de serviços financeiros (FS) fornece uma visão geral dos princípios e recomendações para otimizar o custo das suas cargas de trabalho de FS no Google Cloud. As recomendações neste documento estão alinhadas com o pilar de otimização de custos do Well-Architected Framework.
A otimização de custos robusta para cargas de trabalho de serviços financeiros requer os seguintes elementos fundamentais:
- A capacidade de identificar o uso de recursos que gera desperdício em comparação com o que gera valor.
- Uma cultura incorporada de responsabilidade financeira.
Para otimizar os custos, é necessário entender de forma abrangente os fatores de custo e as necessidades de recursos em toda a organização. Em algumas grandes organizações, especialmente aquelas que estão no início da Cloud Journey, uma única equipe costuma ser responsável por otimizar os gastos em um grande número de domínios. Essa abordagem pressupõe que uma equipe central é a mais indicada para identificar oportunidades de alto valor para melhorar a eficiência.
A abordagem centralizada pode ter algum sucesso durante as fases iniciais da adoção da nuvem ou para cargas de trabalho não críticas. No entanto, uma única equipe não pode impulsionar a otimização de custos em toda a organização. Quando o uso de recursos ou o nível de escrutínio regulatório aumenta, a abordagem centralizada não é sustentável. As equipes centralizadas enfrentam desafios de escalonabilidade, principalmente ao lidar com um grande número de produtos e serviços financeiros. As equipes de projeto que possuem os produtos e serviços podem resistir a mudanças feitas por uma equipe externa.
Para uma otimização de custos eficaz, os dados relacionados aos gastos precisam ser altamente visíveis, e os engenheiros e outros usuários da nuvem que estão próximos às cargas de trabalho precisam ser motivados a entrar em ação para otimizar os custos. Do ponto de vista organizacional, o desafio da otimização de custos é identificar quais áreas devem ser otimizadas, identificar os engenheiros responsáveis por essas áreas e convencê-los a realizar a ação de otimização necessária. Este documento fornece recomendações para enfrentar esse desafio.
As recomendações de otimização de custos neste documento são mapeadas para os seguintes princípios fundamentais:
- Identificar desperdícios usando as ferramentas do Google Cloud
- Identificar valor analisando e enriquecendo os dados de gastos
- Alocar gastos para aumentar a responsabilidade
- Promover a responsabilidade e motivar os engenheiros a entrar em ação
- Foque no valor e no TCO, não no custo
Identificar desperdícios usando as ferramentas do Google Cloud
OGoogle Cloud oferece vários produtos, ferramentas e recursos para ajudar você a identificar desperdícios. Considere as seguintes recomendações.
Usar a automação e a IA para identificar sistematicamente o que otimizar
O Active Assist fornece recomendações inteligentes em serviços como Cloud Run para microsserviços, BigQuery para análise de dados, Compute Engine para aplicativos principais e Cloud SQL para bancos de dados relacionais. As recomendações do Active Assist são fornecidas sem custo financeiro e sem qualquer configuração da sua parte. As recomendações ajudam a identificar recursos de inatividade e compromissos subutilizados.
Centralize o monitoramento e o controle de FinOps em uma interface unificada
Os relatórios de faturamento do Cloud Billing e o hub de FinOps permitem que você implemente um monitoramento de custos abrangente. Essa visão abrangente é vital para que auditores financeiros e equipes financeiras internas acompanhem os gastos com nuvem, avaliem a postura financeira, avaliem a maturidade do FinOps em várias unidades de negócios ou centros de custo e forneçam uma narrativa financeira consistente.
Identificar valor analisando e enriquecendo os dados de gastos
O Active Assist é eficaz na identificação de desperdícios óbvios. No entanto, identificar o valor pode ser mais desafiador, principalmente quando as cargas de trabalho estão em produtos inadequados ou quando não estão claramente alinhadas ao valor comercial. Para cargas de trabalho de FS, o valor comercial vai além da redução de custos. O valor inclui redução de riscos, conformidade regulatória e vantagens competitivas.
Para entender os gastos e o valor da nuvem de maneira holística, é necessário ter uma compreensão completa em vários níveis: de onde vêm os gastos, qual função de negócios eles estão impulsionando e a viabilidade técnica de refatorar ou otimizar a carga de trabalho em questão.
O diagrama a seguir mostra como aplicar a pirâmide de dados, informações, conhecimento e sabedoria (DIKW, na sigla em inglês) e as ferramentas do Google Cloud para ter uma compreensão holística dos custos e do valor da nuvem.
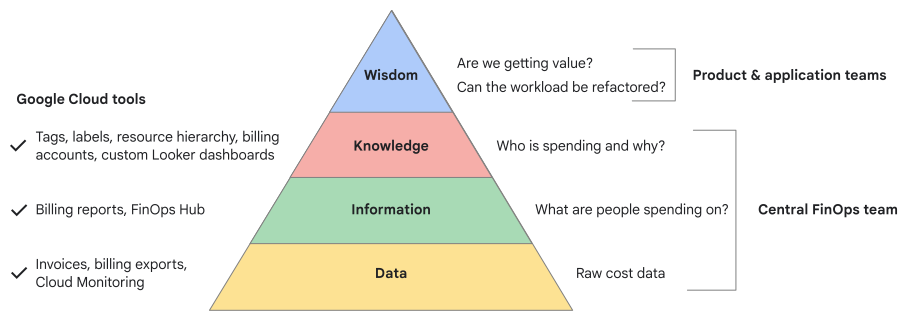
O diagrama anterior mostra como usar a abordagem DIKW para refinar dados brutos de gastos com nuvem em insights acionáveis e decisões que geram valor comercial.
- Dados: nessa camada, você coleta fluxos brutos e não processados de dados de uso e custo dos seus recursos de nuvem. Sua equipe central de FinOps usa ferramentas
como faturas do Cloud Billing, exportações de faturamento e
Cloud Monitoring para receber dados granulares e detalhados. Por exemplo, um ponto de dados pode ser que uma VM chamada
app1-test-vmAfoi executada por 730 horas na regiãous-central1e custou US$ 70. - Informações: nessa camada, sua equipe central de FinOps usa ferramentas como relatórios de faturamento do Cloud Billing e o hub de FinOps para estruturar os dados brutos e ajudar a responder a perguntas como "Em quais categorias de recursos as pessoas estão gastando dinheiro?" Por exemplo, você pode descobrir que um total de USD 1.050 foi gasto em VMs do tipo de máquina n4-standard-2 em duas regiões dos EUA.
- Conhecimento: nessa camada, sua equipe central de FinOps enriquece as informações com o contexto de negócios apropriado sobre quem gastou dinheiro e com que finalidade. Você usa mecanismos como tags, rótulos, hierarquia de recursos, contas de faturamento e painéis personalizados do Looker. Por
exemplo, é possível determinar que a equipe de teste
app1nos EUA gastou US$ 650 durante a segunda semana de julho como parte de um exercício de teste de estresse. - Sabedoria: nessa camada, as equipes de produtos e aplicativos usam o
conhecimento contextualizado para avaliar o valor comercial dos gastos com a nuvem e
tomar decisões estratégicas e fundamentadas. Suas equipes podem responder a perguntas
como as seguintes:
- Os US$ 5.000 gastos em um pipeline de análise de dados estão gerando valor comercial?
- Podemos reestruturar o pipeline para que ele seja mais eficiente sem reduzir o desempenho?
Considere as seguintes recomendações para analisar os dados de gastos na nuvem.
Analisar os dados de gastos fornecidos pelo Google Cloud
Comece com dados detalhados do Cloud Billing que são exportados para o BigQuery e dados que estão disponíveis nos registros do Monitoring. Para gerar insights úteis e tomar decisões, é preciso estruturar esses dados e enriquecê-los com o contexto de negócios.
Visualizar dados com as ferramentas disponíveis
Aumente os painéis integrados do Google Cloud com relatórios personalizados usando ferramentas como o Data Studio com base nas exportações do BigQuery. As equipes financeiras podem criar painéis personalizados que contextualizam os gastos com nuvem em relação a métricas financeiras, requisitos de relatórios regulamentares e lucratividade da unidade de negócios. Assim, eles podem fornecer uma narrativa financeira clara para análise e tomada de decisões por partes interessadas executivas.
Alocar gastos para promover a responsabilidade
Depois de entender o que está impulsionando os gastos com a nuvem, você precisa identificar quem
está gastando dinheiro e por quê. Esse nível de compreensão requer uma prática robusta de alocação de custos, que envolve anexar metadados relevantes para os negócios aos recursos de nuvem. Por exemplo, se um recurso específico for usado pela
equipe Banking-AppDev, será possível anexar uma tag como team=banking_appdev ao
recurso para acompanhar o custo que a equipe gera nesse recurso. O ideal é
alocar 100% dos custos de nuvem para a origem do gasto. Na
prática, é possível começar com uma meta menor, porque criar uma estrutura de metadados
para oferecer suporte à alocação de custos de 100% é um esforço complexo.
Considere as seguintes recomendações para desenvolver uma estratégia de metadados que apoie a alocação de custos:
- Validade: garanta que as tags ajudem a identificar indicadores principais de desempenho (KPIs) relacionados aos negócios e requisitos regulatórios. Essa
associação é fundamental para estornos internos, relatórios regulamentares e
alinhamento dos gastos com a nuvem com as metas da unidade de negócios. Por exemplo, as seguintes
tags identificam claramente uma equipe de gastos, a região dela e o produto em que
ela trabalha:
team=banking_appdev,region=emea,product=frontend. - Automação: para alcançar um alto nível de conformidade de inclusão de tags, aplique a inclusão de tags por meio da automação. A inclusão manual de tags é propensa a erros e inconsistências, o que é inaceitável em ambientes de FS, em que a auditabilidade e a precisão financeira são fundamentais. A inclusão automática de tags garante que os recursos sejam categorizados corretamente quando criados.
- Simplicidade: meça fatores simples e não correlacionados. Os ambientes de FS são complexos. Para garantir que as regras de alocação de custos em um ambiente como esse sejam fáceis de entender e aplicar, elas precisam ser o mais simples possível. Evite o excesso de engenharia nas regras para casos altamente específicos (limite). Regras complexas podem causar confusão e resistência das equipes operacionais.
Depois de definir uma estratégia de alocação usando tags, você precisa decidir o nível de granularidade em que a estratégia será implementada. A granularidade necessária depende das necessidades da sua empresa. Por exemplo, algumas organizações podem precisar rastrear o custo no nível do produto, outras podem precisar de dados de custo para cada centro de custo e outras podem precisar de dados de custo por ambiente (desenvolvimento, preparo e produção).
Considere as seguintes abordagens para alcançar o nível apropriado de granularidade de alocação de custos para sua organização:
- Use a hierarquia do projeto no Google Cloud como um ponto de partida natural para a alocação de custos. Os projetos representam pontos de aplicação de políticas no Google Cloud. Por padrão, as permissões do Identity and Access Management (IAM), as políticas de segurança e o custo são atribuídos a projetos e pastas. Ao analisar os dados de custo exportados do Cloud Billing, é possível ver a hierarquia de pastas e os projetos associados aos dados de custo. Se a Google Cloud hierarquia de recursos refletir a estrutura de responsabilidade da sua organização para gastos, essa será a maneira mais simples de implementar a alocação de custos.
- Use tags e rótulos para mais granularidade. Eles oferecem maneiras flexíveis de categorizar recursos em exportações de faturamento. As tags e os rótulos facilitam o detalhamento de custos por aplicativo e ambiente.
Muitas vezes, é necessário usar a hierarquia do projeto combinada com tags e rótulos para uma alocação de custos eficaz. Independentemente da abordagem de alocação de custos escolhida, siga as recomendações descritas anteriormente para desenvolver uma estratégia de metadados robusta: validade, automação e simplicidade.
Promover a responsabilidade e motivar os engenheiros a entrar em ação
A equipe de FinOps na nuvem é responsável por conscientizar uma organização sobre custos e valor. As equipes de produtos e de engenharia precisam tomar as medidas necessárias para otimizar os custos. Essas equipes também são responsáveis pelo comportamento de custo das cargas de trabalho de serviços financeiros e por garantir que as cargas de trabalho forneçam o valor comercial necessário.
Considere as recomendações a seguir para incentivar a responsabilidade e motivar as equipes a otimizar os custos.
Estabelecer uma equipe centralizada de FinOps para governança
As práticas de Cloud FinOps não crescem organicamente. Uma equipe de FinOps dedicada precisa definir e estabelecer práticas de FinOps fazendo o seguinte:
- Crie os processos, as ferramentas e as orientações necessárias.
- Crie, comunique e aplique as políticas necessárias, como marcação obrigatória, revisões de orçamento e processos de otimização.
- Incentive as equipes de engenharia a assumir a responsabilidade pelos custos.
- Intervir quando as equipes de engenharia não assumirem a responsabilidade pelos custos.
Conseguir patrocínio executivo e mandatos
A liderança sênior, incluindo o CTO, o CFO e o CIO, precisa defender ativamente uma mudança em toda a organização para uma cultura de FinOps. O apoio deles é crucial para priorizar a responsabilidade de custos, alocar recursos para o programa de FinOps, garantir a participação multifuncional e impulsionar a conformidade com os requisitos de FinOps.
Incentivar as equipes a otimizar os custos
Os engenheiros e as equipes de engenharia podem não ter motivação própria para se concentrar na otimização de custos. É importante alinhar as metas individuais e da equipe com a eficiência de custos, implementando incentivos como os seguintes:
- Reinvista uma parte da economia gerada pela otimização de custos nas equipes que alcançaram a otimização.
- Reconheça e comemore publicamente os esforços e sucessos na otimização de custos.
- Use técnicas de gamificação para recompensar as equipes que otimizam os custos de maneira eficaz.
- Integrar métricas de eficiência às metas de performance.
Implementar técnicas de showback e estorno
Garantir que as equipes tenham visibilidade clara dos recursos e custos de nuvem que possuem. Atribua responsabilidade financeira às pessoas apropriadas nas equipes. Use mecanismos formais para aplicar uma marcação rigorosa e implementar regras transparentes para alocar custos compartilhados.
Foco no valor e no TCO, não no custo
Ao avaliar soluções em nuvem, considere o custo total de propriedade (TCO) de longo prazo. Por exemplo, a auto-hospedagem de um banco de dados para um aplicativo pode parecer mais barata do que usar um serviço de banco de dados gerenciado, como o Cloud SQL. No entanto, para avaliar o valor de longo prazo e o TCO, é preciso considerar os custos ocultos associados aos bancos de dados auto-hospedados. Esses custos incluem o esforço de engenharia dedicado para aplicação de patches, escalonamento, aumento de segurança e recuperação de desastres, que são requisitos essenciais para cargas de trabalho de FS. Os serviços gerenciados oferecem um valor de longo prazo significativamente maior, o que compensa os custos de infraestrutura. Os serviços gerenciados oferecem recursos de conformidade robustos, têm recursos de confiabilidade integrados e podem ajudar a reduzir a sobrecarga operacional.
Considere as recomendações a seguir para se concentrar no valor e no TCO.
Usar técnicas e ferramentas específicas do produto para otimizar recursos
Aproveite as ferramentas e os recursos de otimização de custos fornecidos pelos produtos do Google Cloud, como:
- Compute Engine: escalonamento automático, tipos de máquina personalizados e VMs spot
- Google Kubernetes Engine: escalonador automático de cluster e provisionamento automático de nós
- Cloud Storage: Gerenciamento do ciclo de vida de objetos e Autoclass
- BigQuery: preços baseados em capacidade e técnicas de otimização de custos
- Google Cloud VMware Engine: descontos por compromisso de uso (CUDs), armazenamento otimizado e outras estratégias de otimização de custos
Aproveite os descontos
Garanta que a taxa de faturamento dos seus recursos de nuvem seja a mais baixa possível usando os descontos que o Google oferece. As equipes individuais de produto e engenharia geralmente gerenciam a otimização de recursos. A equipe central de FinOps é responsável por otimizar as taxas de faturamento porque tem visibilidade dos requisitos de recursos em toda a organização. Portanto, eles podem agregar os requisitos e maximizar os descontos baseados em compromisso.
É possível aproveitar os seguintes tipos de descontos para recursos doGoogle Cloud :
- Os descontos corporativos são negociados com base no compromisso da sua organização com um gasto total mínimo no Google Cloud a uma taxa de faturamento reduzida.
- Os CUDs baseados em recursos são concedidos em troca do compromisso de usar uma quantidade mínima de recursos do Compute Engine por um período de um ou três anos. Os CUDs baseados em recursos são aplicáveis aos recursos que estão em uma região específica. Na maioria das contas do Cloud Billing, o Google Cloud ativa o compartilhamento de CUD com base em recursos e compartilha CUDs em todos os projetos associados a essa conta.
- Os CUDs com base em gastos são concedidos em troca do compromisso de gastar um valor mínimo em um produto específico por um período de um ou três anos. Os descontos baseados em gastos são aplicáveis no nível da conta de faturamento. Os descontos são aplicados regional ou globalmente, dependendo do produto.
É possível economizar muito usando CUDs além dos descontos corporativos.
Além dos CUDs, use as seguintes abordagens para reduzir as taxas de faturamento:
- Use VMs spot para cargas de trabalho tolerantes a falhas e flexíveis. As VMs spot são mais de 80% mais baratas do que as VMs comuns.
- O BigQuery oferece vários modelos de preços, que incluem preços on demand e preços baseados em edição, que se baseiam em compromissos e requisitos de escalonamento automático. Se você usa um volume significativo de recursos do BigQuery, escolha uma edição adequada para reduzir o custo por slot para cargas de trabalho de análise.
- Avalie cuidadosamente as Google Cloud regiões disponíveis para os serviços que você precisa usar. Escolha regiões que estejam alinhadas aos seus objetivos de custo e fatores como latência e requisitos de conformidade. Para entender as compensações entre custo, sustentabilidade e latência, use o Seletor de região doGoogle Cloud .
Perspectiva de serviços financeiros: otimização de desempenho
Este documento no Google Cloud Well-Architected Framework: perspectiva de serviços financeiros (FS) fornece uma visão geral dos princípios e recomendações para otimizar o desempenho das suas cargas de trabalho de FS no Google Cloud. As recomendações neste documento estão alinhadas com o pilar de otimização de desempenho do Well-Architected Framework.
A otimização de desempenho tem uma longa história nos serviços financeiros. Ela tem ajudado as organizações de FS a superar desafios técnicos e quase sempre tem sido um facilitador ou acelerador para a criação de novos modelos de negócios. Por exemplo, os caixas eletrônicos (lançados em 1967) automatizaram o processo de distribuição de dinheiro e ajudaram os bancos a reduzir o custo do negócio principal. Técnicas como ignorar o kernel do SO e fixar linhas de execução de aplicativos em núcleos de computação ajudaram a alcançar latência determinística e baixa para aplicativos de negociação. A redução da latência facilitou uma liquidez maior e mais firme, com spreads mais apertados nos mercados financeiros.
A nuvem cria novas oportunidades para otimizar a performance. Ele também desafia alguns dos padrões de otimização historicamente aceitos. Especificamente, as seguintes compensações são mais transparentes e controláveis na nuvem:
- Tempo de lançamento no mercado versus custo.
- Desempenho de ponta a ponta no nível do sistema em comparação com o desempenho no nível do nó.
- Disponibilidade de talentos versus agilidade na tomada de decisões relacionadas à tecnologia.
Por exemplo, adaptar hardware e recursos de TI a requisitos de habilidades específicos é uma tarefa simples na nuvem. Para dar suporte à programação de GPU, é possível criar VMs baseadas em GPU. É possível escalonar a capacidade na nuvem para acomodar picos de demanda sem provisionar recursos em excesso. Esse recurso ajuda a garantir que as cargas de trabalho possam lidar com cargas de pico, como em dias de folha de pagamento não agrícola e quando os volumes de negociação são significativamente maiores do que os níveis históricos. Em vez de gastar para escrever código altamente otimizado no nível de servidores individuais (como código altamente ajustado na linguagem C) ou escrever código para ambientes convencionais de computação de alto desempenho (HPC), é possível escalonar horizontalmente de maneira ideal usando um sistema distribuído bem arquitetado baseado em Kubernetes.
As recomendações de otimização de desempenho neste documento são mapeadas para os seguintes princípios fundamentais:
- Alinhar as métricas de performance tecnológica com os principais indicadores de negócios
- Priorize a segurança sem sacrificar o desempenho para riscos não comprovados
- Repense sua arquitetura para se adaptar a novas oportunidades e requisitos
- Prepare sua tecnologia para o futuro e atenda às necessidades de negócios atuais e futuras
Alinhar as métricas de performance de tecnologia com os principais indicadores de negócios
É possível mapear a otimização de desempenho para resultados de valor comercial de várias maneiras. Por exemplo, em uma mesa de pesquisa de buy-side, um objetivo de negócio pode ser otimizar a produção por hora de pesquisa ou priorizar experimentos de equipes com um histórico comprovado, como índices de Sharpe mais altos. No lado da venda, é possível usar análises para acompanhar o interesse do cliente e, consequentemente, priorizar a capacidade de processamento para modelos de IA que apoiam as pesquisas mais interessantes.
Conectar metas de performance aos indicadores principais de desempenho (KPIs) de negócios também é importante para financiar melhorias de performance. As iniciativas de inovação e transformação de negócios (às vezes chamadas de esforços de mudança do banco) têm orçamentos diferentes e podem ter diferentes graus de acesso a recursos em comparação com as operações normais (BAU, na sigla em inglês) ou de execução do banco. Por exemplo, o Google Cloud ajudou as equipes de gerenciamento de riscos e tecnologia de uma G-SIFI a colaborar com os analistas quantitativos de front-office em uma solução para realizar cálculos de análise de risco (como XVA) em minutos, em vez de horas ou dias. Essa solução ajudou a organização a atender aos requisitos de compliance relevantes. Também permitiu que os traders tivessem conversas de maior qualidade com os clientes, oferecendo spreads mais apertados, liquidez mais firme e cobertura mais econômica.
Ao alinhar suas métricas de performance com os indicadores de negócios, considere as seguintes recomendações:
- Conecte cada iniciativa de tecnologia aos objetivos e resultados-chave (OKRs) relevantes, como aumentar a receita ou o lucro, reduzir custos e mitigar riscos de maneira mais eficiente ou holística.
- Foco na otimização do desempenho no nível do sistema. Vá além da separação convencional entre mudança e execução do banco e dos silos de front-office e back-office.
Priorize a segurança sem sacrificar o desempenho para riscos não comprovados
A segurança e a conformidade regulatória nas organizações de SF precisam ser, sem dúvida, de alto padrão. Manter um padrão elevado é essencial para evitar a perda de clientes e danos irreparáveis à marca de uma organização. Muitas vezes, o maior valor é derivado de inovações tecnológicas, como IA generativa e serviços gerenciados exclusivos, como o Spanner. Não descarte automaticamente essas opções de tecnologia devido a um equívoco geral sobre o risco operacional proibitivo ou a uma postura inadequada de conformidade regulatória.
Google Cloud trabalhou em estreita colaboração com as G-SIFIs para garantir que uma abordagem baseada em IA para combate à lavagem de dinheiro (AML, na sigla em inglês) possa ser usada em todas as jurisdições em que as instituições atendem clientes. Por exemplo, o HSBC melhorou significativamente o desempenho da unidade de crimes financeiros (Fincrime) com os seguintes resultados:
- Cerca de duas a quatro vezes mais atividades suspeitas confirmadas.
- Custos operacionais mais baixos devido à eliminação de mais de 60% dos falsos positivos e ao tempo de investigação focado apenas em alertas acionáveis de alto risco.
- Resultados auditáveis e explicáveis para apoiar a conformidade regulatória.
Recomendações:
- Confirme se os produtos que você pretende usar podem ajudar a atender aos requisitos de segurança, resiliência e compliance das jurisdições em que você opera. Para atingir esse objetivo, trabalhe com as equipes Google Cloud de contas, de risco e de produtos.
- Crie modelos mais eficientes e ofereça transparência aos clientes aproveitando a explicabilidade da IA.
Alcance transparência para cargas de trabalho de IA generativa usando técnicas como citações de fontes, embasamento e RAG.
Quando a explicabilidade não for suficiente, separe as etapas de tomada de decisão nos fluxos de valor e use a IA para automatizar apenas as etapas que não envolvem tomada de decisão. Em alguns casos, a IA explicável pode não ser suficiente ou um processo pode exigir intervenção humana devido a preocupações regulatórias (por exemplo, GDPR, Artigo 22). Nesses casos, apresente todas as informações necessárias para o agente humano tomar decisões em um único painel de controle, mas automatize as tarefas de coleta, ingestão, manipulação e resumo de dados.
Repense sua arquitetura para se adaptar a novas oportunidades e requisitos
Aumentar suas arquiteturas atuais com recursos baseados na nuvem pode agregar um valor significativo. Para alcançar resultados mais transformadores, é preciso repensar periodicamente sua arquitetura usando uma abordagem de priorização da nuvem.
Considere as recomendações a seguir para repensar periodicamente a arquitetura das suas cargas de trabalho para otimizar ainda mais o desempenho.
Usar alternativas baseadas na nuvem para sistemas e programadores de HPC no local
Para aproveitar uma maior elasticidade, uma postura de segurança aprimorada e recursos abrangentes de monitoramento e governança, execute cargas de trabalho de HPC na nuvem ou interrompa as cargas de trabalho locais para a nuvem. No entanto, para determinados casos de uso de modelagem numérica, como simulação de estratégias de investimento ou modelagem XVA, combinar o Kubernetes com o Kueue pode oferecer uma solução mais eficiente.
Mudar para a programação baseada em gráficos para simulações
As simulações de Monte Carlo podem ter um desempenho muito melhor em um sistema de execução baseado em gráficos, como o Dataflow. Por exemplo, o HSBC usa o Dataflow para executar cálculos de risco 16 vezes mais rápido em comparação com a abordagem anterior.
Executar plataformas de câmbio e negociação baseadas na nuvem
Conversas com Google Cloud clientes revelam que o princípio de Pareto 80/20 se aplica aos requisitos de desempenho de mercados e aplicativos de negociação.
- Mais de 80% dos aplicativos de trading não precisam de uma latência extremamente baixa. No entanto, eles se beneficiam significativamente dos recursos de resiliência, segurança e elasticidade da nuvem. Por exemplo, a BidFX, uma plataforma de câmbio com vários revendedores, usa a nuvem para lançar novos produtos rapidamente e aumentar significativamente a disponibilidade e a presença deles sem aumentar os recursos.
- Os aplicativos restantes (menos de 20%) precisam de baixa latência (menos de um milissegundo), determinismo e imparcialidade na entrega de mensagens. Normalmente, esses sistemas são executados em instalações de colocation rígidas e caras. Cada vez mais, até mesmo essa categoria de aplicativos está sendo replatformada na nuvem, seja na borda ou como aplicativos com priorização da nuvem.
Prepare sua tecnologia para o futuro para atender às necessidades de negócios atuais e futuras
Historicamente, muitas organizações de SF criaram tecnologias próprias para ganhar uma vantagem competitiva. Por exemplo, no início dos anos 2000, bancos de investimento e empresas de trading bem-sucedidos tinham as próprias implementações de tecnologias fundamentais, como sistemas de publicação/assinatura e agentes de mensagens. Com a evolução das tecnologias de código aberto e da nuvem, essas tecnologias se tornaram commodities e não oferecem valor comercial incremental.
Considere as recomendações a seguir para preparar sua tecnologia para o futuro.
Adote uma abordagem de dados como serviço (DaaS) para acelerar o tempo de lançamento no mercado e a transparência de custos
As organizações de FS geralmente evoluem por meio de uma combinação de crescimento orgânico e fusões e aquisições (M&A). Como resultado, as organizações precisam integrar tecnologias diferentes. Eles também precisam gerenciar recursos duplicados, como fornecedores de dados, licenças de dados e pontos de integração. O Google Cloud oferece oportunidades para criar valor diferenciado em integrações pós-fusão.
Por exemplo, é possível usar serviços como o BigQuery Sharing para criar uma plataforma de dados como serviço (DaaS) pronta para análise. A plataforma pode fornecer dados de mercado e entradas de fontes alternativas. Essa abordagem elimina a necessidade de criar pipelines de dados redundantes e permite que você se concentre em iniciativas mais valiosas. Além disso, as empresas que passaram por fusão ou aquisição podem racionalizar de forma rápida e eficiente as necessidades de licenciamento de dados e infraestrutura pós-fusão. Em vez de se esforçar para adaptar e mesclar propriedades e operações de dados legados, a empresa combinada pode se concentrar em novas oportunidades de negócios.
Criar uma camada de abstração para isolar os sistemas atuais e abordar os modelos de negócios emergentes
Cada vez mais, a vantagem competitiva dos bancos não é o sistema bancário principal, mas a camada de experiência do cliente. No entanto, os sistemas bancários legados costumam usar aplicativos monolíticos que foram desenvolvidos em linguagens como Cobol e são integrados em toda a cadeia de valor bancária. Essa integração dificultava a separação das camadas da cadeia de valor, o que tornava quase impossível fazer upgrade e modernizar esses sistemas.
Uma solução para resolver esse desafio é usar uma camada de isolamento, como um sistema de gerenciamento de APIs, ou uma camada de preparo, como o Spanner, que duplica o livro de registros e facilita a modernização de serviços com análise avançada e IA. Por exemplo, o Deutsche Bank usou o Spanner para isolar o patrimônio bancário principal legado e iniciar a jornada de inovação.