


במאמר הזה נסביר על שיטות להטמעה ולאוטומציה של אינטגרציה רציפה (CI), פיתוח רציף (CD) ואימון רציף (CT) למערכות של למידת מכונה (ML). המסמך הזה מתייחס בעיקר למערכות AI חזויות.
מדע הנתונים ולמידת המכונה הופכים ליכולות ליבה לפתרון בעיות מורכבות בעולם האמיתי, לשינוי תעשיות ולמתן ערך בכל התחומים. כרגע, יש לכם את כל מה שצריך כדי להשתמש ב-ML בצורה יעילה:
- קבוצות נתונים גדולות
- משאבי מחשוב זולים על פי דרישה
- מאיצים ייעודיים ל-ML בפלטפורמות ענן שונות
- התקדמות מהירה בתחומים שונים של מחקר למידת מכונה (כמו ראייה ממוחשבת, הבנת שפה טבעית, AI גנרטיבי ומערכות AI להמלצות).
לכן, עסקים רבים משקיעים בצוותי מדעי הנתונים וביכולות ה-ML שלהם כדי לפתח מודלים של חיזוי שיכולים לספק ערך עסקי למשתמשים שלהם.
המסמך הזה מיועד למדעני נתונים ולמהנדסי למידת מכונה שרוצים ליישם עקרונות של DevOps במערכות של למידת מכונה (MLOps). MLOps היא תרבות ושיטה של הנדסת למידת מכונה, שמטרתה לאחד בין פיתוח מערכת למידת מכונה (Dev) לבין תפעול מערכת למידת מכונה (Ops). המשמעות של תרגול MLOps היא שאתם תומכים באוטומציה ובמעקב בכל השלבים של בניית מערכת למידת מכונה, כולל שילוב, בדיקה, הפצה, פריסה וניהול תשתית.
מדעני נתונים יכולים להטמיע ולאמן מודל ML עם ביצועי חיזוי בקבוצת נתונים להחזקה אופליין, בהינתן נתוני אימון רלוונטיים לתרחיש השימוש שלהם. עם זאת, האתגר האמיתי הוא לא ליצור מודל ML, אלא ליצור מערכת ML משולבת ולהפעיל אותה באופן רציף בסביבת הייצור. ב-Google יש היסטוריה ארוכה של שירותי ML בסביבת ייצור, ולמדנו שיכולות להיות הרבה מלכודות בהפעלה של מערכות מבוססות ML בסביבת ייצור. חלק מהמלכודות האלה מסוכמות במאמר למידת מכונה (ML): The High Interest Credit Card of Technical Debt.
כפי שמוצג בדיאגרמה הבאה, רק חלק קטן ממערכת ML בעולם האמיתי מורכב מקוד ML. האלמנטים שצריך להוסיף מסביב הם רבים ומורכבים.
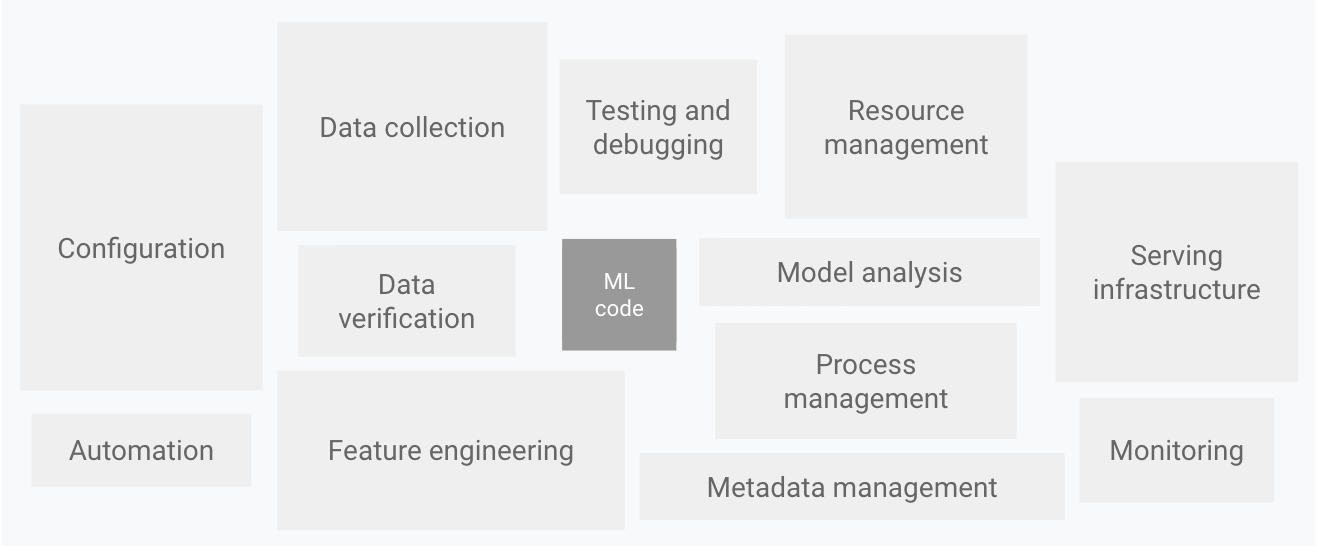
איור 1. רכיבים של מערכות ML. התרשים מבוסס על המאמר Hidden Technical Debt in Machine Learning Systems.
בתרשים הקודם מוצגים רכיבי המערכת הבאים:
- הגדרות אישיות
- אוטומציה
- איסוף נתונים
- אימות נתונים
- בדיקה וניפוי באגים
- ניהול המשאבים
- ניתוח מודלים
- ניהול תהליכים ומטא-נתונים
- תשתית להצגת מודעות
- מעקב
כדי לפתח ולהפעיל מערכות מורכבות כאלה, אפשר ליישם עקרונות של DevOps במערכות למידת מכונה (MLOps). במאמר הזה נסביר מושגים שצריך להביא בחשבון כשמגדירים סביבת MLOps לשיטות של מדעי הנתונים, כמו CI, CD ו-CT ב-ML.
הנושאים הבאים נדונים:
- DevOps לעומת MLOps
- שלבים לפיתוח מודלים של למידת מכונה
- רמות הבשלות של MLOps
- MLOps ל-AI גנרטיבי
DevOps לעומת MLOps
DevOps היא שיטה פופולרית לפיתוח ולתפעול של מערכות תוכנה בקנה מידה גדול. היתרונות של העבודה בצורה הזאת כוללים, בין השאר, את היכולת לקצר את מחזורי הפיתוח, להגביר את מהירות הפריסה ולשחרר גרסאות בצורה אמינה. כדי ליהנות מהיתרונות האלה, צריך להכניס שני מושגים לפיתוח של מערכת התוכנה:
מערכת ML היא מערכת תוכנה, ולכן שיטות דומות חלות כדי להבטיח שתוכלו לבנות ולהפעיל מערכות ML באופן אמין ובקנה מידה נרחב.
עם זאת, מערכות ML שונות ממערכות תוכנה אחרות בדרכים הבאות:
מיומנויות הצוות: בפרויקט ML, הצוות בדרך כלל כולל מדעני נתונים או חוקרי למידת מכונה, שמתמקדים בניתוח נתונים, בפיתוח מודלים ובניסויים. יכול להיות שהם לא מהנדסי תוכנה מנוסים שיכולים לבנות שירותים ברמת ייצור.
פיתוח: ML הוא ניסיוני מטבעו. כדאי לנסות תכונות, אלגוריתמים, טכניקות ליצירת מודלים והגדרות פרמטרים שונות כדי למצוא את הפתרון הטוב ביותר לבעיה במהירות האפשרית. האתגר הוא לעקוב אחרי מה שעבד ומה שלא עבד, ולשמור על יכולת השחזור תוך מקסום השימוש החוזר בקוד.
בדיקה: בדיקה של מערכת ML היא מורכבת יותר מבדיקה של מערכות תוכנה אחרות. בנוסף לבדיקות יחידה ובדיקות שילוב רגילות, צריך לבצע אימות נתונים, הערכת איכות של המודל המאומן ואימות מודל.
פריסה: במערכות למידת מכונה, הפריסה היא לא רק פריסה של מודל למידת מכונה שאומן אופליין כשירות חיזוי. במערכות ML, יכול להיות שתצטרכו לפרוס פייפליין עם כמה שלבים כדי לאמן מחדש ולפרוס מודלים באופן אוטומטי. הצינור הזה מוסיף מורכבות ומחייב אתכם להפוך לאוטומטיים שלבים שמדעני נתונים מבצעים באופן ידני לפני הפריסה, כדי לאמן ולאמת מודלים חדשים.
ייצור: הביצועים של מודלים של למידת מכונה יכולים לרדת לא רק בגלל קידוד לא אופטימלי, אלא גם בגלל פרופילי נתונים שמתפתחים כל הזמן. במילים אחרות, מודלים יכולים להתדרדר ביותר דרכים מאשר מערכות תוכנה רגילות, וצריך לקחת בחשבון את ההתדרדרות הזו. לכן, אתם צריכים לעקוב אחרי הנתונים הסטטיסטיים המסכמים של הנתונים ולנטר את הביצועים של המודל אונליין, כדי לשלוח התראות או לחזור לגרסה קודמת כשהערכים חורגים מהציפיות שלכם.
מערכות ML ומערכות תוכנה אחרות דומות ב<b>אינטגרציה רציפה (CI)</b> של בקרת המקור, <b>בדיקות יחידה (unit testing)</b>, בדיקות שילוב ו<b>פיתוח רציף (continuous delivery)</b> של מודול התוכנה או החבילה. אבל בלמידת מכונה יש כמה הבדלים חשובים:
- CI כבר לא עוסק רק בבדיקה ובאימות של קוד ורכיבים, אלא גם בבדיקה ובאימות של נתונים, סכימות של נתונים ומודלים.
- ב-ML, CD הוא לא חבילת תוכנה או שירות, אלא מערכת (צינור עיבוד נתונים לאימון ML) שצריכה לפרוס באופן אוטומטי שירות אחר (שירות חיזוי של מודל).
- אימון מתמשך הוא מאפיין חדש, ייחודי למערכות ML, שקשור לאימון מחדש ולהכניס לשימוש בסביבת הייצור של המודלים באופן אוטומטי.
בקטע הבא נסביר על השלבים הרגילים לאימון ולהערכה של מודל למידת מכונה, כדי שישמש כשירות חיזוי.
שלבים במדעי הנתונים ללמידת מכונה
בכל פרויקט של ML, אחרי שמגדירים את תרחיש השימוש העסקי וקובעים את הקריטריונים להצלחה, תהליך ההעברה של מודל ML לסביבת הייצור כולל את השלבים הבאים. אפשר לבצע את השלבים האלה באופן ידני או באמצעות צינור עיבוד נתונים אוטומטי.
- חילוץ נתונים: בוחרים ומשלבים את הנתונים הרלוונטיים ממקורות נתונים שונים למשימת למידת המכונה.
- ניתוח נתונים: מבצעים ניתוח נתונים חקירתי (EDA) כדי להבין את הנתונים הזמינים לבניית מודל למידת המכונה. התהליך הזה מוביל לתוצאות הבאות:
- להבין את סכימת הנתונים והמאפיינים שהמודל מצפה לקבל.
- זיהוי הכנת הנתונים והנדסת הפיצ'רים שנדרשים למודל.
- הכנת הנתונים: הנתונים מוכנים למשימת למידת המכונה. ההכנה הזו כוללת ניקוי נתונים, שבו מפצלים את הנתונים לקבוצות אימון, אימות ובדיקה. בנוסף, אתם מחילים טרנספורמציות של נתונים והנדסת פיצ'רים על המודל שפותר את משימת היעד. הפלט של השלב הזה הוא פיצולי הנתונים בפורמט המוכן.
- אימון המודל: מדען הנתונים מטמיע אלגוריתמים שונים עם הנתונים המוכנים כדי לאמן מודלים שונים של למידת מכונה. בנוסף, אתם מבצעים כוונון של היפר-פרמטרים באלגוריתמים שהטמעתם כדי לקבל את מודל ה-ML עם הביצועים הטובים ביותר. הפלט של השלב הזה הוא מודל מאומן.
- הערכת המודל: המודל מוערך לפי קבוצת נתונים לבדיקה כדי להעריך את איכות המודל. הפלט של השלב הזה הוא קבוצה של מדדים להערכת איכות המודל.
- אימות המודל: המודל נחשב מתאים לפריסה, כלומר הביצועים החזויים שלו טובים יותר מקו בסיס מסוים.
- פרסום המודל: המודל המאומת נפרס בסביבת יעד כדי להציג תחזיות. הפריסה יכולה להיות אחת מהאפשרויות הבאות:
- מיקרו-שירותים עם API בארכיטקטורת REST כדי להציג חיזויים אונליין.
- מודל מוטמע במכשיר קצה או במכשיר נייד.
- חלק ממערכת חיזוי באצווה.
- מעקב אחרי המודל: מעקב אחרי ביצועי החיזוי של המודל כדי להפעיל איטרציה חדשה בתהליך למידת המכונה.
רמת האוטומציה של השלבים האלה מגדירה את הבשלות של תהליך למידת המכונה, שמשקפת את מהירות האימון של מודלים חדשים בהינתן נתונים חדשים, או את מהירות האימון של מודלים חדשים בהינתן הטמעות חדשות. בקטעים הבאים מתוארות שלוש רמות של MLOps, החל מהרמה הנפוצה ביותר, שלא כוללת אוטומציה, ועד לאוטומציה של צינורות עיבוד נתונים של למידת מכונה ושל CI/CD.
MLOps ברמה 0: תהליך ידני
בצוותים רבים יש מדעני נתונים וחוקרי למידת מכונה שיכולים ליצור מודלים מתקדמים, אבל התהליך של יצירת המודלים ופריסתם הוא ידני לחלוטין. זוהי רמת הבשלות הבסיסית, או רמה 0. בתרשים הבא מוצג תהליך העבודה של התהליך הזה.
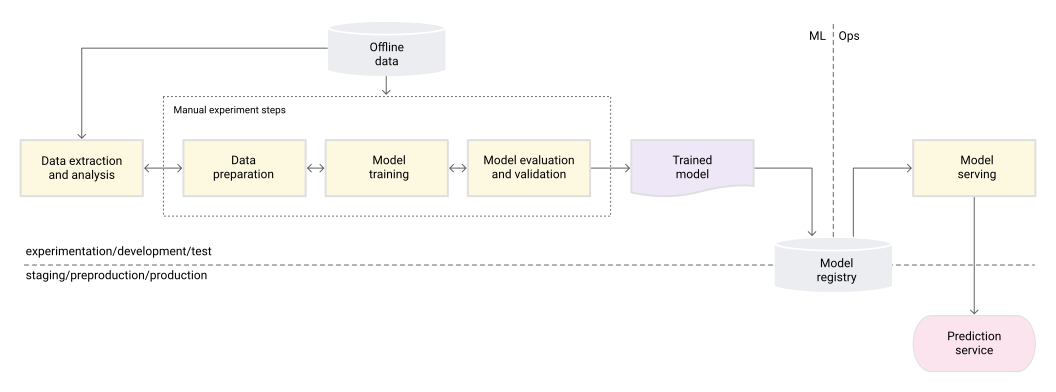
איור 2. שלבים ידניים של ML כדי להכניס את המודל לשימוש בסביבת הייצור כשירות חיזוי.
מאפיינים
ברשימה הבאה מודגשים המאפיינים של תהליך MLOps ברמה 0, כפי שמוצג באיור 2:
תהליך ידני, מבוסס-סקריפט ואינטראקטיבי: כל שלב הוא ידני, כולל ניתוח נתונים, הכנת נתונים, אימון מודלים ואימות. צריך לבצע כל שלב באופן ידני, ולעבור ידנית משלב לשלב. התהליך הזה בדרך כלל מונע על ידי קוד ניסיוני שנכתב ומופעל באופן אינטראקטיבי ב-notebooks על ידי מדעני נתונים, עד שנוצר מודל שניתן לעבוד איתו.
חוסר קשר בין ML לבין התפעול: התהליך מפריד בין מדעני הנתונים שיוצרים את המודל לבין המהנדסים שמכניסים את המודל לשימוש בסביבת הייצור כשירות חיזוי. מדעני הנתונים מעבירים את המודל המאומן כפריט מידע שנוצר בתהליך הפיתוח (artifact) לצוות ההנדסה, כדי לפרוס אותו בתשתית ה-API שלהם. ההעברה הזו יכולה לכלול את הצבת המודל שאומן במיקום אחסון, העברת אובייקט המודל למאגר המקורות של הקוד או העלאה שלו למרשם המודלים. לאחר מכן, המהנדסים שפורסים את המודל צריכים להפוך את המאפיינים הנדרשים לזמינים בסביבת הייצור, כדי שהשירות יהיה עם זמן אחזור קצר. זה יכול להוביל להטיה בין האימון להצגה.
גרסאות שמשוחררות לעיתים רחוקות: התהליך מניח שצוות מדע הנתונים מנהל כמה מודלים שלא משתנים לעיתים קרובות – בין אם מדובר בשינוי הטמעת המודל או באימון מחדש של המודל עם נתונים חדשים. גרסה חדשה של המודל נפרסת רק כמה פעמים בשנה.
אין CI: כי ההנחה היא שאין הרבה שינויים בהטמעה, ולכן המערכת מתעלמת מה-CI. בדרך כלל, בדיקת הקוד היא חלק מהרצת הסקריפט או ה-notebook. הסקריפטים וה-notebooks שמיישמים את שלבי הניסוי מנוהלים בבקרת גרסאות, והם מייצרים פריטי מידע כמו מודלים מאומנים, מדדי הערכה והמחשות חזותיות.
אין CD: מכיוון שאין פריסות תכופות של גרסאות מודלים, לא מתייחסים ל-CD.
הפריסה מתייחסת לשירות החיזוי: התהליך עוסק רק בפריסת המודל המאומן כשירות חיזוי (לדוגמה, מיקרו-שירות עם API בארכיטקטורת REST), ולא בפריסת כל מערכת ה-ML.
חוסר במעקב פעיל אחרי הביצועים: התהליך לא עוקב אחרי החיזויים והפעולות של המודל ולא מתעד אותם, וזה נדרש כדי לזהות ירידה בביצועים של המודל ושינויים אחרים בהתנהגות שלו.
לצוות ההנדסה יכולה להיות הגדרה מורכבת משלו להגדרת API, לבדיקה ולפריסה, כולל אבטחה, רגרסיה, עומס ובדיקות קנריות. בנוסף, פריסה בסביבת ייצור של גרסה חדשה של מודל ML בדרך כלל עוברת בדיקת A/B או ניסויים אונליין לפני שהמודל מקודם כדי להכניס לשימוש בסביבת הייצור את כל התנועה של בקשות החיזוי.
אתגרים
רמה 0 של MLOps נפוצה בהרבה עסקים שמתחילים ליישם למידת מכונה בתרחישים לדוגמה שלהם. התהליך הידני הזה, שמונע על ידי מדעני נתונים, עשוי להספיק כשמודלים משתנים או מאומנים לעיתים רחוקות. בפועל, מודלים לעיתים קרובות נכשלים כשהם נפרסים בעולם האמיתי. המודלים לא מצליחים להסתגל לשינויים בדינמיקה של הסביבה, או לשינויים בנתונים שמתארים את הסביבה. למידע נוסף, קראו את המאמר Why Machine Learning Models Crash and Burn in Production.
כדי להתמודד עם האתגרים האלה ולשמור על הדיוק של המודל בסביבת הייצור, צריך לבצע את הפעולות הבאות:
מעקב פעיל אחרי איכות המודל בסביבת הייצור: המעקב מאפשר לזהות ירידה בביצועים והתיישנות של המודל. הוא משמש כרמז לסבב חדש של ניסויים ואימון מחדש (ידני) של המודל על נתונים חדשים.
לאמן מחדש את המודלים בסביבת הייצור לעיתים קרובות: כדי לזהות דפוסים חדשים ומתפתחים, צריך לאמן מחדש את המודל עם הנתונים העדכניים ביותר. לדוגמה, אם האפליקציה ממליצה על מוצרי אופנה באמצעות ML, ההמלצות שלה צריכות להתאים לטרנדים ולמוצרים העדכניים ביותר.
התנסות מתמשכת בהטמעות חדשות כדי ליצור את המודל: כדי לרתום את הרעיונות וההתקדמויות האחרונות בטכנולוגיה, צריך לנסות הטמעות חדשות כמו הנדסת פיצ'רים (feature engineering), ארכיטקטורת מודלים והיפר-פרמטרים. לדוגמה, אם אתם משתמשים בראייה ממוחשבת לזיהוי פנים, תבניות הפנים קבועות, אבל טכניקות חדשות וטובות יותר יכולות לשפר את דיוק הזיהוי.
כדי להתמודד עם האתגרים של התהליך הידני הזה, כדאי להשתמש בשיטות MLOps ל-CI/CD ול-CT. פריסת פייפליין אימון של ML מאפשרת להפעיל CT, ולהגדיר מערכת CI/CD כדי לבדוק, ליצור ולפרוס במהירות הטמעות חדשות של פייפליין ה-ML. התכונות האלה מפורטות בהרחבה בקטעים הבאים.
MLOps רמה 1: אוטומציה של צינור עיבוד הנתונים של למידת המכונה
המטרה של רמה 1 היא לבצע אימון רציף של המודל על ידי אוטומציה של צינור עיבוד הנתונים של למידת המכונה. כך תוכלו להשיג פיתוח רציף של שירות החיזוי של המודל. כדי להפוך את התהליך של שימוש בנתונים חדשים לאוטומטי, לצורך אימון מחדש של מודלים בסביבת הייצור, צריך להוסיף לצינור העיבוד שלבים אוטומטיים של אימות נתונים ומודלים, וגם טריגרים של צינור עיבוד וניהול מטא-נתונים.
התרשים הבא הוא ייצוג סכמטי של פייפליין ML אוטומטי ל-CT.
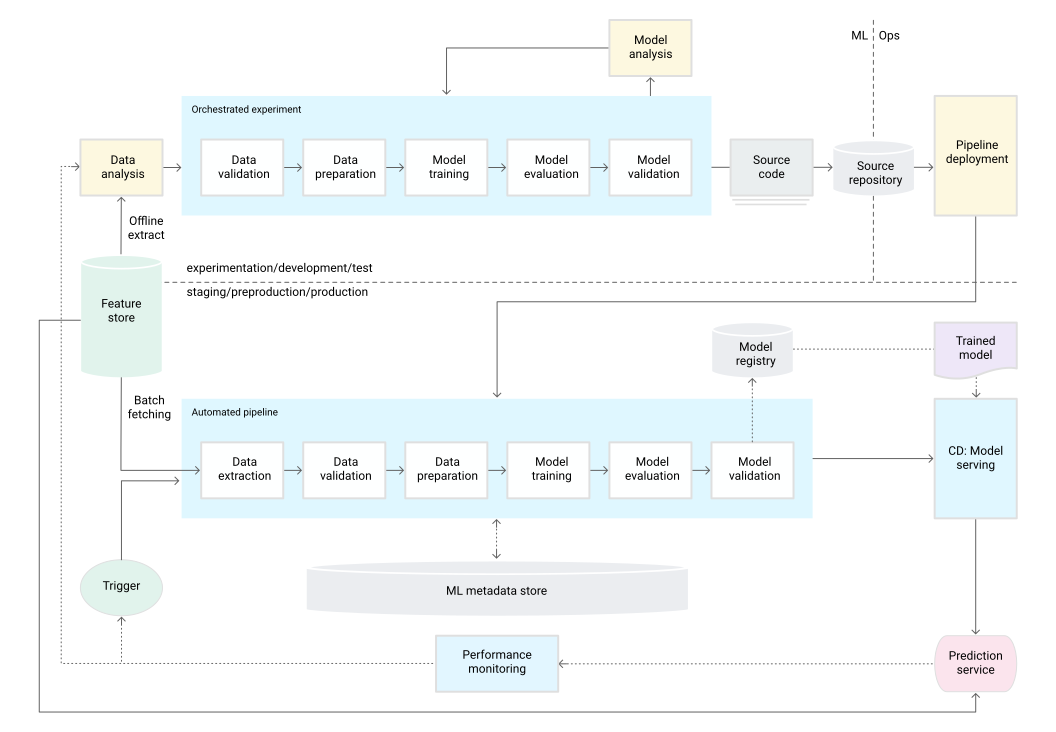
איור 3. אוטומציה של פייפליין ML לאימון מתמשך.
מאפיינים
ברשימה הבאה מודגשים המאפיינים של הגדרת MLOps ברמה 1, כפי שמוצג באיור 3:
ניסוי מהיר: השלבים של הניסוי בלמידת מכונה מתוזמרים. המעבר בין השלבים הוא אוטומטי, מה שמוביל לחזרה מהירה על ניסויים ולמוכנות טובה יותר להעביר את כל צינור עיבוד הנתונים לסביבת הייצור.
CT של המודל בסביבת הייצור: המודל מאומן באופן אוטומטי בסביבת הייצור באמצעות נתונים עדכניים, על סמך טריגרים של צינור עיבוד נתונים פעיל, שנדון בהם בקטע הבא.
סימטריה ניסיונית-תפעולית: הטמעת צינור עיבוד הנתונים שמשמשת בסביבת הפיתוח או הניסוי משמשת גם בסביבת טרום-הייצור ובסביבת הייצור, וזה היבט מרכזי בשיטת MLOps לאיחוד DevOps.
קוד מודולרי לרכיבים ולפייפליינים: כדי לבנות פייפליינים של ML, הרכיבים צריכים להיות ניתנים לשימוש חוזר, קומפוזביליים ואולי גם ניתנים לשיתוף בין פייפליינים של ML. לכן, למרות שקוד ה-EDA עדיין יכול להיות ב-notebooks, קוד המקור של הרכיבים חייב להיות מודולרי. בנוסף, רצוי שהרכיבים יהיו בקונטיינרים כדי:
- הפרדה בין סביבת ההרצה לבין זמן הריצה של הקוד בהתאמה אישית.
- הקוד צריך להיות ניתן לשחזור בין סביבות הפיתוח והייצור.
- מבודדים כל רכיב בצינור עיבוד הנתונים. לרכיבים יכולה להיות גרסה משלהם של סביבת זמן הריצה, והם יכולים להכיל שפות וספריות שונות.
פיתוח רציף (continuous delivery) של מודלים: צינור עיבוד נתונים של למידת מכונה בסביבת הייצור מספק באופן רציף שירותי חיזוי למודלים חדשים, שמאומנים על נתונים חדשים. שלב פריסת המודל, שבו המודל המאומן והמאומת משמש כשירות חיזוי לחיזויים אונליין, הוא אוטומטי.
פריסת צינור עיבוד נתונים: ברמה 0, פורסים מודל מאומן כשירות חיזוי בסביבת הייצור. ברמה 1, פורסים צינור עיבוד נתונים שלם לאימון, שפועל באופן אוטומטי וחוזר כדי להציג את המודל המאומן כשירות החיזוי.
רכיבים נוספים
בקטע הזה נדון ברכיבים שצריך להוסיף לארכיטקטורה כדי לאפשר אימון מתמשך של למידת מכונה.
אימות נתונים ומודלים
כשפורסים את פייפליין ה-ML בסביבת הייצור, אחד או יותר מהטריגרים שמופיעים בקטע טריגרים של פייפליין ML מפעיל אוטומטית את הפייפליין. הצינור מצפה לנתונים חדשים בזמן אמת כדי ליצור גרסת מודל חדשה שמאומנת על הנתונים החדשים (כפי שמוצג באיור 3). לכן, צריך להוסיף שלבים אוטומטיים של אימות נתונים ואימות מודל לצינור עיבוד הנתונים בסביבת הייצור, כדי לוודא שההתנהגות הבאה תתקיים:
אימות נתונים: השלב הזה נדרש לפני אימון המודל כדי להחליט אם לאמן מחדש את המודל או להפסיק את הפעלת צינור עיבוד הנתונים. ההחלטה הזו מתקבלת באופן אוטומטי אם צינור עיבוד הנתונים מזהה את הדברים הבאים:
- סטיות בסכימת הנתונים: הסטיות האלה נחשבות לחריגות בנתוני הקלט. לכן, נתוני קלט שלא תואמים לסכימה הצפויה מתקבלים בשלבים הבאים של צינור עיבוד הנתונים, כולל שלבי עיבוד הנתונים ואימון המודל. במקרה כזה, צריך לעצור את צינור עיבוד הנתונים כדי שצוות מדעי הנתונים יוכל לבדוק את הבעיה. יכול להיות שהצוות יוציא תיקון או עדכון לצינור עיבוד הנתונים כדי לטפל בשינויים האלה בסכימה. הטיות בסכימה כוללות קבלת מאפיינים לא צפויים, אי קבלת כל המאפיינים הצפויים או קבלת מאפיינים עם ערכים לא צפויים.
- סטיות בערכי הנתונים: הסטיות האלה הן שינויים משמעותיים במאפיינים הסטטיסטיים של הנתונים, כלומר דפוסי הנתונים משתנים, וצריך להפעיל אימון מחדש של המודל כדי לתעד את השינויים האלה.
אימות המודל: השלב הזה מתרחש אחרי שמאמנים את המודל בהצלחה על סמך הנתונים החדשים. אתם בודקים ומאמתים את המודל לפני שהוא עובר לייצור. שלב אימות המודל אופליין כולל את הפעולות הבאות:
- יצירת ערכים של מדדי הערכה באמצעות המודל שאומן על מערך נתונים לבדיקה, כדי להעריך את איכות החיזוי של המודל.
- השוואה בין ערכי מדדי ההערכה של המודל החדש שאומן לבין המודל הנוכחי, למשל מודל הייצור, מודל הבסיס או מודלים אחרים של דרישות עסקיות. אתם מוודאים שהמודל החדש מניב ביצועים טובים יותר מהמודל הנוכחי לפני שאתם מעבירים אותו לסביבת הייצור.
- לוודא שהביצועים של המודל עקביים בפלחים שונים של הנתונים. לדוגמה, יכול להיות שהמודל החדש שאומן לחיזוי נטישת לקוחות יפיק דיוק חיזוי כולל טוב יותר בהשוואה למודל הקודם, אבל ערכי הדיוק לפי אזור הלקוח עשויים להיות שונים מאוד.
- חשוב לבדוק את המודל לפני הפריסה, כולל תאימות לתשתית ועקביות עם ה-API של שירות החיזוי.
בנוסף לאימות המודל אופליין, מודל שנפרס לאחרונה עובר אימות מודל אונליין – בפריסה של גרסה ראשונית (canary) או בהגדרה של בדיקת A/B – לפני שהוא משמש לחיזוי לתנועה אונליין.
Feature Store
רכיב אופציונלי נוסף לאוטומציה של פייפליין ML ברמה 1 הוא Feature Store. Feature Store הוא מאגר מרכזי שבו אתם יכולים להגדיר, לאחסן ולגשת לתכונות לאימון ולהכניס לשימוש בסביבת הייצור באופן אחיד. Feature Store צריך לספק API לשליפת נתונים ב-batch עם תפוקה גבוהה וגם לשליפת נתונים בזמן אמת עם זמן אחזור קצר, ולתמוך בעומסי עבודה של אימון ושל הצגת מודעות.
מאגר התכונות עוזר למדעני נתונים לבצע את הפעולות הבאות:
- לגלות קבוצות של מאפיינים זמינים לישויות שלהם ולהשתמש בהן שוב, במקום ליצור מחדש קבוצות זהות או דומות.
- כדי להימנע ממצב שבו יש מאפיינים דומים עם הגדרות שונות, צריך לתחזק את המאפיינים ואת המטא-נתונים שקשורים אליהם.
- להציג ערכי מאפיינים עדכניים מ-Feature Store.
כדי למנוע training-serving skew, כדאי להשתמש ב-Feature Store כמקור הנתונים לניסויים, לאימון מתמשך ולמילוי בקשות באופן מיידי. כך אפשר לוודא שהמאפיינים שמשמשים לאימון הם אותם מאפיינים שמשמשים להצגה:
- לצורך ניסויים, מדעני נתונים יכולים לקבל תמצית אופליין מ-Feature Store כדי להריץ את הניסויים שלהם.
- כדי לאמן את המודל באופן רציף, צינור עיבוד הנתונים האוטומטי לאימון ML יכול לאחזר קבוצה של ערכי המאפיינים העדכניים של מערך הנתונים שמשמשים למשימת האימון.
- לחיזוי אונליין, שירות החיזוי יכול לאחזר באצווה את ערכי המאפיינים שקשורים לישות המבוקשת, כמו מאפיינים דמוגרפיים של לקוחות, מאפייני מוצרים ומאפייני צבירה של הסשן הנוכחי.
- כדי לבצע חיזוי אונליין ואחזור מאפיינים, שירות החיזוי מזהה את המאפיינים הרלוונטיים לישות. לדוגמה, אם הישות היא לקוח, המאפיינים הרלוונטיים יכולים לכלול גיל, היסטוריית רכישות והתנהגות גלישה. השירות מקבץ את ערכי המאפיינים האלה ומאחזר את כל המאפיינים הנדרשים לישות בבת אחת, במקום בנפרד. השיטה הזו עוזרת לשלוף נתונים ביעילות, במיוחד כשצריך לנהל כמה ישויות.
ניהול מטא-נתונים
המידע על כל הרצה של פייפליין ה-ML מתועד כדי לעזור בשושלת הנתונים והארטיפקטים, בשחזור ובהשוואות. הוא גם עוזר לנפות באגים בשגיאות ובחריגות. בכל פעם שמריצים את הפייפליין, מאגר המטא-נתונים של ML מתעד את המטא-נתונים הבאים:
- גרסאות הרכיבים וצינור עיבוד הנתונים שהופעלו.
- תאריך ההתחלה והסיום, השעה ומשך הזמן שלקח לצינור עיבוד הנתונים להשלים כל אחד מהשלבים.
- הגורם שמפעיל את צינור עיבוד הנתונים.
- הארגומנטים של הפרמטרים שהועברו לצינור עיבוד הנתונים.
- המצביעים (pointers) לארטיפקטים שנוצרו בכל שלב בצינור עיבוד הנתונים, כמו מיקום הנתונים המוכנים, חריגות באימות, נתונים סטטיסטיים מחושבים ואוצר המילים שחולץ מהמאפיינים הקטגוריים. מעקב אחרי הפלטים האלה עוזר להמשיך את הצינור מהשלב האחרון אם הצינור נעצר בגלל שלב שנכשל, בלי להפעיל מחדש את השלבים שכבר הושלמו.
- מצביע למודל הקודם שאומן, למקרה שצריך לחזור לגרסה קודמת של המודל או להפיק מדדי הערכה לגרסה קודמת של המודל כשצינור עיבוד הנתונים מקבל נתוני בדיקה חדשים במהלך שלב אימות המודל.
- מדדי הערכת המודל שנוצרו במהלך שלב הערכת המודל, גם לקבוצות האימון וגם לקבוצות הבדיקה. המדדים האלה עוזרים להשוות בין הביצועים של מודל שאומן לאחרונה לבין הביצועים המתועדים של המודל הקודם במהלך שלב אימות המודל.
טריגרים של פייפליינים של ML
אתם יכולים להפוך את פייפליינים של ML בסביבת הייצור לאוטומטיים, כדי לאמן מחדש את המודלים באמצעות נתונים חדשים, בהתאם לתרחיש שימוש:
- לפי דרישה: הפעלה ידנית אד-הוק של צינור עיבוד הנתונים.
- לפי לוח זמנים: נתונים חדשים עם תוויות זמינים באופן שיטתי למערכת ה-ML על בסיס יומי, שבועי או חודשי. תדירות האימון מחדש תלויה גם בתדירות שבה משתנות תבניות הנתונים, ובעלות של אימון המודלים מחדש.
- זמינות של נתוני אימון חדשים: נתונים חדשים לא זמינים באופן שיטתי למערכת ה-ML, אלא זמינים באופן אד-הוק כשנאספים נתונים חדשים והם זמינים במסדי הנתונים של המקור.
- כשיש ירידה בביצועי המודל: המודל עובר אימון מחדש כשיש ירידה משמעותית בביצועים.
- כשיש שינויים משמעותיים בהתפלגות הנתונים (שינוי בקונספט). קשה להעריך את הביצועים המלאים של המודל אונליין, אבל אתם מבחינים בשינויים משמעותיים בהתפלגות הנתונים של המאפיינים שמשמשים לביצוע החיזוי. השינויים האלה מצביעים על כך שהמודל התיישן, וצריך לאמן אותו מחדש על נתונים עדכניים.
אתגרים
אם אתם לא פורסים לעיתים קרובות הטמעות חדשות של צינור עיבוד הנתונים, ואתם מנהלים רק כמה צינורות עיבוד נתונים, בדרך כלל אתם בודקים ידנית את צינור עיבוד הנתונים ואת הרכיבים שלו. בנוסף, אתם פורסים באופן ידני הטמעות חדשות של צינור עיבוד נתונים. בנוסף, אתם שולחים את קוד המקור שנבדק של צינור עיבוד הנתונים לצוות ה-IT כדי לפרוס אותו בסביבת היעד. ההגדרה הזו מתאימה כשפורסים מודלים חדשים שמבוססים על נתונים חדשים, ולא על רעיונות חדשים של למידת מכונה.
עם זאת, אתם צריכים לנסות רעיונות חדשים ל-ML ולפרוס במהירות הטמעות חדשות של רכיבי ה-ML. אם אתם מנהלים הרבה פייפליינים של ML בסביבת הייצור, אתם צריכים הגדרת CI/CD כדי להפוך את ה-build, הבדיקה והפריסה של פייפליינים של ML לאוטומטיים.
MLOps רמה 2: אוטומציה של צינור עיבוד נתונים של CI/CD
כדי לעדכן במהירות ובאמינות את צינורות עיבוד הנתונים בסביבת הייצור, צריך מערכת CI/CD אוטומטית חזקה. מערכת ה-CI/CD האוטומטית הזו מאפשרת למדעני הנתונים לבחון במהירות רעיונות חדשים בנושא הנדסת פיצ'רים (feature engineering), ארכיטקטורת מודלים והיפר-פרמטרים. הם יכולים ליישם את הרעיונות האלה וליצור, לבדוק ולפרוס באופן אוטומטי את רכיבי צינור עיבוד הנתונים החדשים בסביבת היעד.
בתרשים הבא מוצגת ההטמעה של צינור עיבוד הנתונים של למידת המכונה באמצעות CI/CD, שכוללת את המאפיינים של הגדרת צינורות עיבוד הנתונים האוטומטיים של למידת המכונה, בנוסף לשגרות ה-CI/CD האוטומטיות.
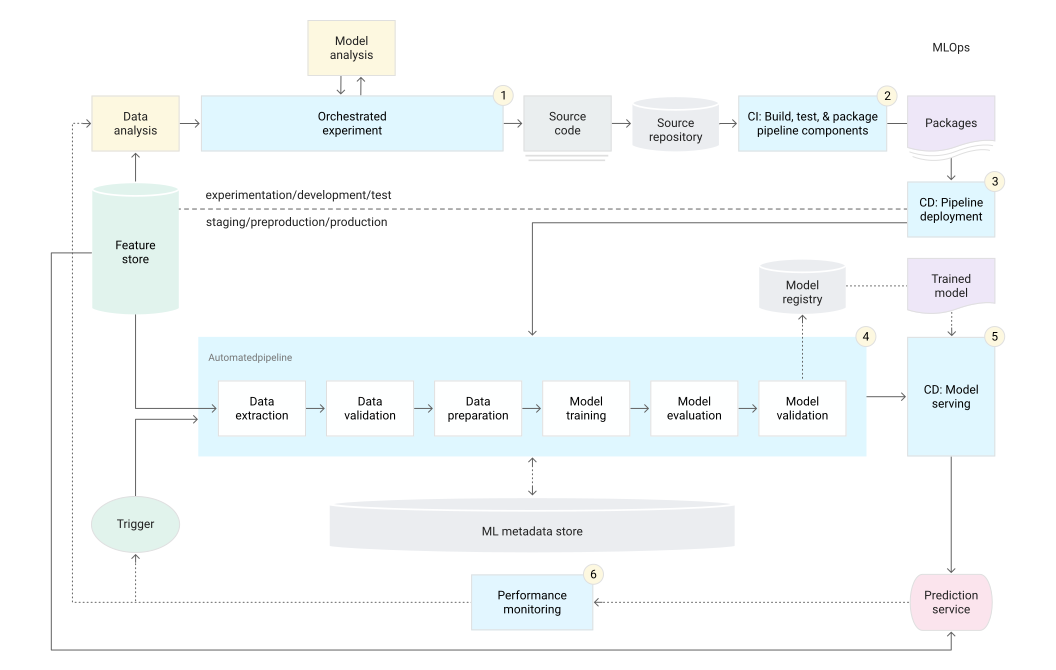
איור 4. CI/CD ופייפליין אוטומטי של ML.
ההגדרה הזו של MLOps כוללת את הרכיבים הבאים:
- בקרת מקורות
- בדיקה ופיתוח של שירותים
- שירותי פריסה
- מרשם המודלים
- Feature Store
- מאגר מטא-נתונים של למידת מכונה
- כלי תזמור של פייפליין ML
מאפיינים
בתרשים הבא מוצגים השלבים של צינור עיבוד הנתונים של אוטומציית CI/CD ללמידת מכונה:
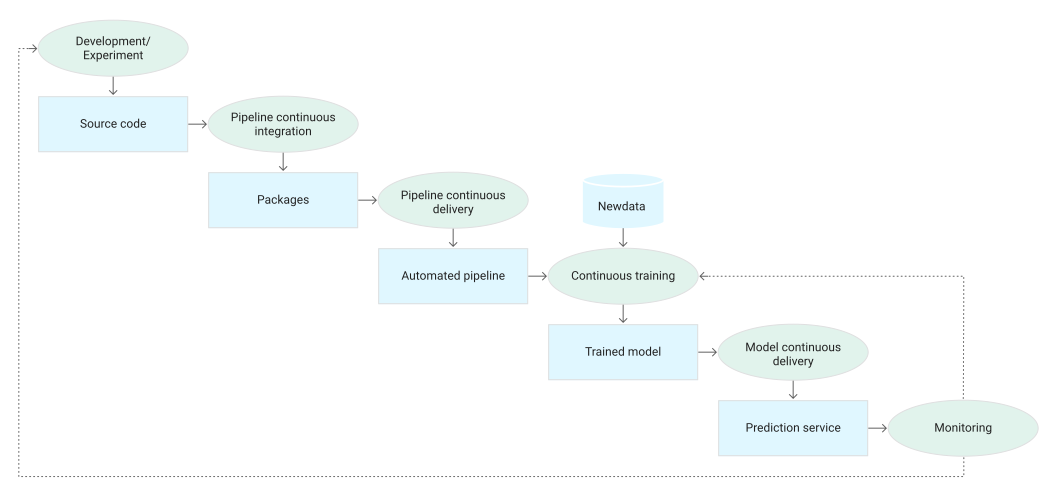
איור 5. שלבים בצינור עיבוד הנתונים האוטומטי של CI/CD ללמידת מכונה.
התהליך מורכב מהשלבים הבאים:
פיתוח וניסויים: אתם מנסים באופן איטרטיבי אלגוריתמים חדשים של ML ומודלים חדשים, שבהם שלבי הניסוי מתוזמרים. הפלט של השלב הזה הוא קוד המקור של השלבים ב-פייפליין של ML, שמועברים למאגר מקור.
אינטגרציה רציפה של צינור עיבוד נתונים: אתם יוצרים קוד מקור ומריצים בדיקות שונות. הפלט של השלב הזה הוא רכיבי צינור עיבוד נתונים (חבילות, קובצי הפעלה ופריטי מידע שנוצרו בתהליך הפיתוח) שייפרסו בשלב מאוחר יותר.
פיתוח רציף (CD) של צינור עיבוד נתונים: פורסים את פריטי המידע שנוצרו בשלב ה-CI בסביבת היעד. הפלט של השלב הזה הוא צינור עיבוד נתונים פרוס עם ההטמעה החדשה של המודל.
הפעלה אוטומטית: צינור עיבוד הנתונים מופעל באופן אוטומטי בסביבת הייצור, לפי לוח זמנים או בתגובה לטריגר. הפלט של השלב הזה הוא מודל מאומן שמועבר למרשם המודלים.
פיתוח רציף (continuous delivery) של המודל: אתם מציגים את המודל המאומן כשירות חיזוי. הפלט של השלב הזה הוא שירות חיזוי של מודל שנפרס.
מעקב: אתם אוספים נתונים סטטיסטיים על ביצועי המודל על סמך נתונים בזמן אמת. הפלט של השלב הזה הוא טריגר להפעלת צינור עיבוד הנתונים או להפעלת מחזור ניסוי חדש.
שלב ניתוח הנתונים הוא עדיין תהליך ידני שמדעני נתונים מבצעים לפני שהצינור מתחיל איטרציה חדשה של הניסוי. גם שלב ניתוח המודל הוא תהליך ידני.
אינטגרציה רציפה (CI)
בהגדרה הזו, צינור עיבוד הנתונים והרכיבים שלו נבנים, נבדקים ונארזים כשקוד מקור חדש נשלח או נדחף למאגר המקורות של הקוד. בנוסף ליצירת חבילות, קובצי אימג' של קונטיינרים וקובצי הפעלה, תהליך ה-CI יכול לכלול את הבדיקות הבאות:
בדיקת יחידה של הלוגיקה של הנדסת הפיצ'רים.
בדיקת יחידה של השיטות השונות שמוטמעות במודל. לדוגמה, אם יש לכם פונקציה שמקבלת עמודת נתונים קטגוריים, אתם יכולים לקודד את הפונקציה כמאפיין one-hot.
בדיקה שאימון המודל מתכנס (כלומר, ההפסד של המודל יורד באיטרציות ומתאים יתר על המידה לכמה רשומות לדוגמה).
בדיקה שאימון המודל לא מייצר ערכי NaN בגלל חלוקה באפס או שינוי של ערכים קטנים או גדולים.
בדיקה שכל רכיב בצינור עיבוד הנתונים מפיק את פריטי המידע שציפיתם להם.
בדיקת השילוב בין רכיבי צינור עיבוד הנתונים.
פיתוח רציף (continuous delivery)
ברמה הזו, המערכת מספקת באופן רציף הטמעות חדשות של צינור עיבוד נתונים לסביבת היעד, שבתורה מספקת שירותי חיזוי של המודל שאומן מחדש. כדי להבטיח פיתוח רציף (continuous delivery) מהיר ואמין של צינורות עיבוד נתונים ומודלים, כדאי להביא בחשבון את הדברים הבאים:
אימות התאימות של המודל לתשתית היעד לפני פריסת המודל. לדוגמה, צריך לוודא שהחבילות שהמודל דורש מותקנות בסביבת השירות, ושהמשאבים הנדרשים של הזיכרון, המחשוב והמאיץ זמינים.
בדיקת שירות החיזוי על ידי קריאה ל-API של השירות עם הקלט הצפוי, ולוודא שמתקבלת התגובה הצפויה. הבדיקה הזו בדרך כלל מזהה בעיות שעלולות להתרחש כשמעדכנים את גרסת המודל והוא מצפה לקלט אחר.
בדיקת הביצועים של שירות החיזוי, שכוללת בדיקת עומסים של השירות כדי לתעד מדדים כמו שאילתות לשנייה (QPS) וזמן האחזור של המודל.
אימות הנתונים לאימון מחדש או לחיזוי באצווה.
מוודאים שהמודלים עומדים ביעדי הביצועים החזויים לפני הפריסה שלהם.
פריסה אוטומטית לסביבת בדיקה, למשל פריסה שמופעלת על ידי דחיפת קוד לענף הפיתוח.
פריסה חצי אוטומטית לסביבת טרום-ייצור, למשל פריסה שמופעלת על ידי מיזוג קוד להסתעפות הראשית אחרי שהבודקים מאשרים את השינויים.
פריסה ידנית בסביבת ייצור אחרי כמה הפעלות מוצלחות של צינור עיבוד הנתונים בסביבת טרום-ייצור.
לסיכום, הטמעת למידת מכונה בסביבת ייצור לא כוללת רק פריסה של המודל כ-API לחיזוי. במקום זאת, המשמעות היא פריסה של פייפליין ML שיכול להפוך את האימון מחדש ואת הפריסה של מודלים חדשים לאוטומטיים. הגדרת מערכת CI/CD מאפשרת לבדוק ולפרוס באופן אוטומטי הטמעות חדשות של צינורות עיבוד נתונים. המערכת הזו מאפשרת לכם להתמודד עם שינויים מהירים בנתונים ובסביבה העסקית. אתם לא חייבים להעביר מיד את כל התהליכים מרמה אחת לאחרת. אתם יכולים להטמיע את השיטות האלה בהדרגה כדי לשפר את האוטומציה של הפיתוח והייצור של מערכת למידת המכונה.
המאמרים הבאים
- ארכיטקטורה ל-MLOps באמצעות TensorFlow Extended, צינורות עיבוד נתונים של Gemini Enterprise Agent Platform ו-Cloud Build
- מדריך למשתמשים בתפעול למידת מכונה (MLOps)
- צפייה בסרטון MLOps Best Practices on Google Cloud (Cloud Next '19) ב-YouTube.
- במאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework מפורטים עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- יארק קזמירצ'אק | ארכיטקט פתרונות
- חאליד סלאמה | מהנדס תוכנה בכיר, למידת מכונה
- ולנטין הוארטה | מהנדס AI
משתתף נוסף: Sunil Kumar Jang Bahadur | Customer Engineer