


이 문서에서는 단편화된 멀티모달 데이터를 검색 가능한 지식 그래프로 통합하는 멀티 에이전트 시스템의 대략적인 아키텍처를 제공합니다. 이 시스템을 사용하면 사용자가 데이터를 업로드한 후 지식 그래프를 사용하여 잠재적인 문제 또는 시스템 위험을 식별할 수 있습니다. 이 아키텍처를 사용하면 에이전트가 복잡한 데이터 웹을 탐색하고 장기적인 맞춤설정을 유지할 수 있습니다. 또한 분산 리소스가 연속성을 유지하면서 검색 요구사항과 일치하도록 보장합니다.
GraphRAG 는 검색 증강 생성 (RAG)에 대한 그래프 기반 접근 방식입니다. RAG는 벡터 검색을 사용하여 검색된 컨텍스트와 관련된 데이터로 프롬프트를 보강하여 AI 생성 응답을 그라운딩하는 데 도움이 됩니다. GraphRAG는 벡터 검색과 지식 그래프 쿼리를 결합하여 다양한 소스의 데이터 상호 연결성을 더 잘 반영하는 컨텍스트 데이터를 검색합니다. GraphRAG를 사용하여 보강된 프롬프트는 더 세부적이고 관련성 높은 AI 응답을 생성할 수 있습니다.
이 문서의 주요 대상에는 클라우드에서 AI 인프라 및 애플리케이션을 빌드하고 관리하는 설계자, 개발자, 관리자가 포함됩니다. 이 문서에서는 사용자가 AI 에이전트 및 모델에 대한 기본적인 이해를 갖추고 있다고 가정합니다. 이 문서에서는 AI 에이전트 설계 및 코딩에 대한 구체적인 안내를 제공하지 않습니다.
이 문서의 배포 섹션에서는 Spanner Graph 스키마를 정의하고 에이전트 검색을 위해 멀티모달 항목을 연결하는 방법을 보여주는 코드 샘플을 제공합니다.
아키텍처
다음은 멀티모달 GraphRAG 리소스 오케스트레이션을 지원하는 멀티 에이전트 AI 시스템의 아키텍처를 대략적으로 보여줍니다.
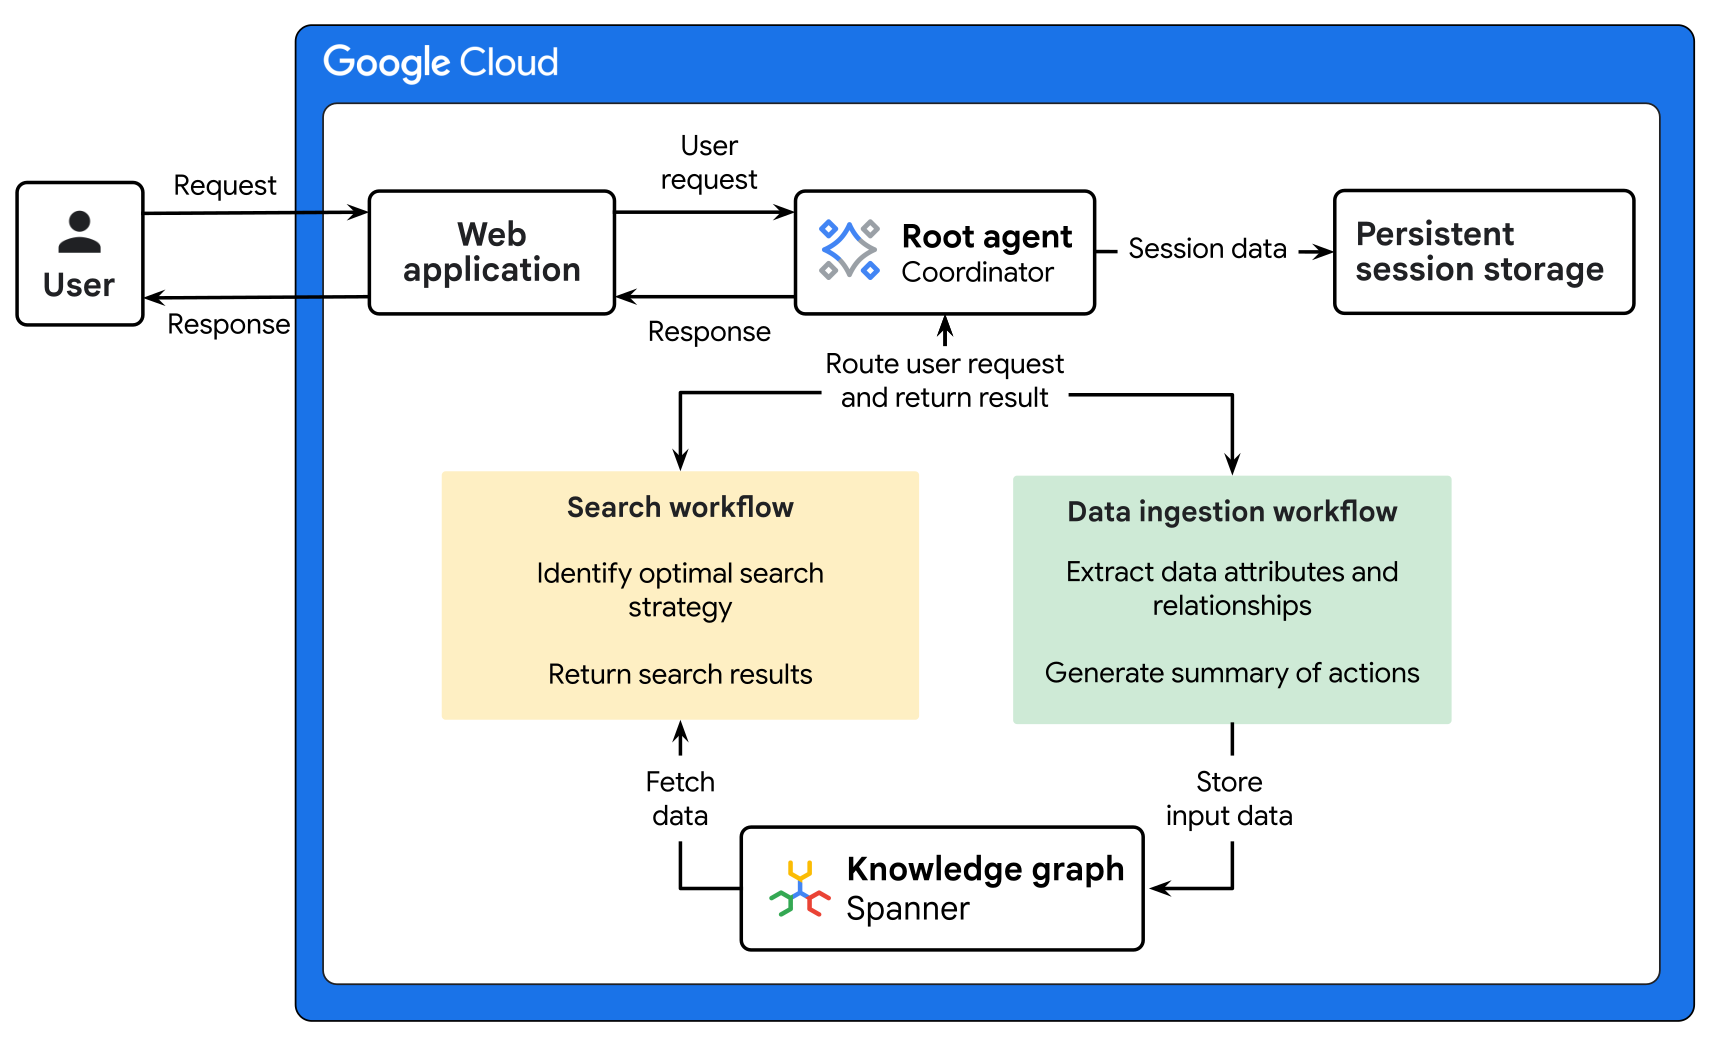
위 다이어그램의 아키텍처에는 데이터 수집과 검색이라는 두 가지 워크플로가 있습니다.
- 데이터 수집 워크플로는 단편화된 멀티모달 레코드를 통합 지식 그래프로 통합합니다. 이 워크플로는 순차적 멀티 에이전트 패턴을 사용하여 Cloud Storage에 원시 데이터를 업로드하고, Gemini를 사용하여 복잡한 관계를 추출하고, Spanner Graph 지식 그래프를 업데이트하여 데이터를 검색에 사용할 수 있도록 합니다.
- 검색 워크플로를 사용하면 GraphRAG 프로세스를 통해 통찰력과 그라운딩된 응답을 검색할 수 있습니다. 이 워크플로는 Gemini와 전문 하위 에이전트를 사용하여 지식 그래프를 탐색하고 이전 세션 데이터를 기반으로 발견항목을 통합합니다.
다음 탭에서는 데이터 수집 및 검색 워크플로를 보여주는 아키텍처를 제공합니다.
데이터 수집 워크플로
다음 다이어그램은 데이터 수집 워크플로의 세부 아키텍처를 보여줍니다.
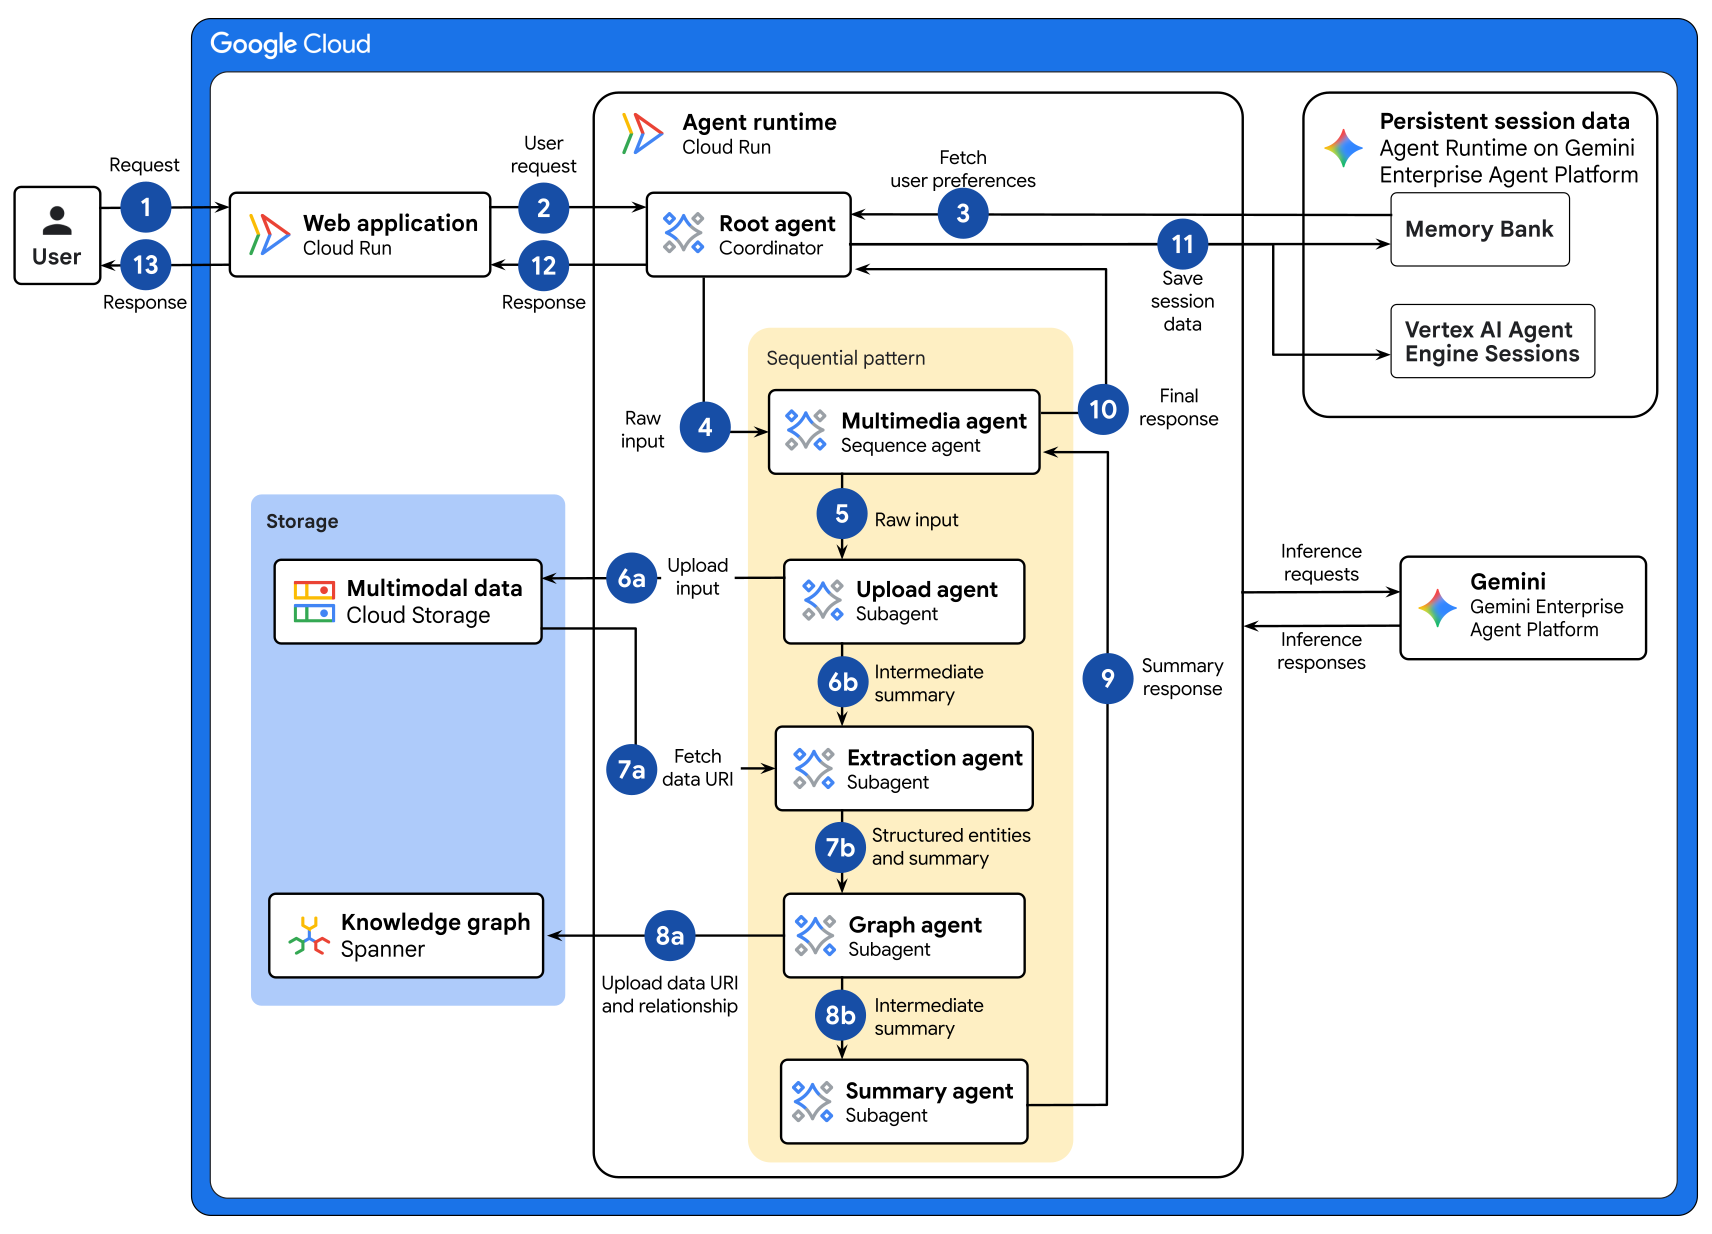
위 다이어그램에서는 다음과 같은 데이터 흐름을 보여줍니다.
- 사용자가 웹 애플리케이션과 상호작용하여 새 데이터를 업로드합니다. 예를 들어, 재무 분석가는 순익 PDF, 주주 회의 녹음 파일 또는 시장 성능 차트를 업로드할 수 있습니다.
- 웹 애플리케이션은 요청을 루트 에이전트로 전달합니다. 루트 에이전트 는 요청을 수신하고 Cloud Run 서비스에 배포되는 코디네이터 에이전트입니다.
- 루트 에이전트는 메모리 뱅크 에서 영구 세션 데이터를 검색하여 이전 세션의 사용자 환경설정을 기반으로 검색 결과를 맞춤설정합니다.
- 루트 에이전트는 Gemini Enterprise Agent Platform의 Gemini를 사용하여 요청을 해석하고 멀티미디어 에이전트에 데이터 수집 파이프라인을 실행하는 작업을 위임합니다.
- 멀티미디어 에이전트는 순차적 패턴을 시작하고 원시 입력을 업로드 에이전트로 전달합니다.
- 업로드 에이전트는 다음 작업을 실행합니다.
- Cloud Storage 버킷에 원시 파일을 저장하고 미디어 유형을 감지합니다.
- 실행한 작업의 중간 요약을 추출 에이전트로 전달합니다.
- 추출 에이전트는 다음 작업을 실행합니다.
- 스토리지 버킷에서 데이터 URI를 가져오고 Gemini를 사용하여 데이터를 파싱하고 정형 항목을 식별합니다. 예를 들어 금융 데이터의 항목에는 기업 자회사, 회계 분기, 수익 감정이 포함될 수 있습니다.
- 실행한 작업의 정형 항목과 중간 요약을 그래프 에이전트로 전달합니다.
- 그래프 에이전트는 다음 작업을 실행합니다.
- 정형 항목을 수신하고 데이터를 지식 그래프에 업로드합니다. Spanner Graph 발행자, 이해관계자, 시장 상품을 나타내는 노드를 만들거나 연결합니다.
- 실행한 작업의 중간 요약을 요약 에이전트로 전달합니다.
- 요약 에이전트는 수집 결과의 텍스트 요약과 모든 하위 에이전트가 수행한 작업이 포함된 응답을 생성합니다. 요약 에이전트는 응답을 멀티미디어 에이전트로 전송합니다.
- 멀티미디어 에이전트는 요약 응답을 루트 에이전트로 다시 전달합니다.
- 루트 에이전트는 콜백 함수를 트리거하여 세션 데이터를 Gemini Enterprise Agent Platform 세션 에 저장합니다. 루트 에이전트는 세션에서 맞춤 메모리 주제를 추출하여 중요한 관심 분야에 대한 정보를 저장합니다. 예를 들어 재무 분석가는 메모리 주제를 만들어 규제 플래그 또는 부문별 추세를 추적할 수 있습니다.
- 루트 에이전트는 요약 응답을 웹 애플리케이션으로 전달합니다.
- 웹 애플리케이션은 응답을 사용자에게 다시 전달합니다.
검색 워크플로
다음 다이어그램은 검색 워크플로의 세부 아키텍처를 보여줍니다.
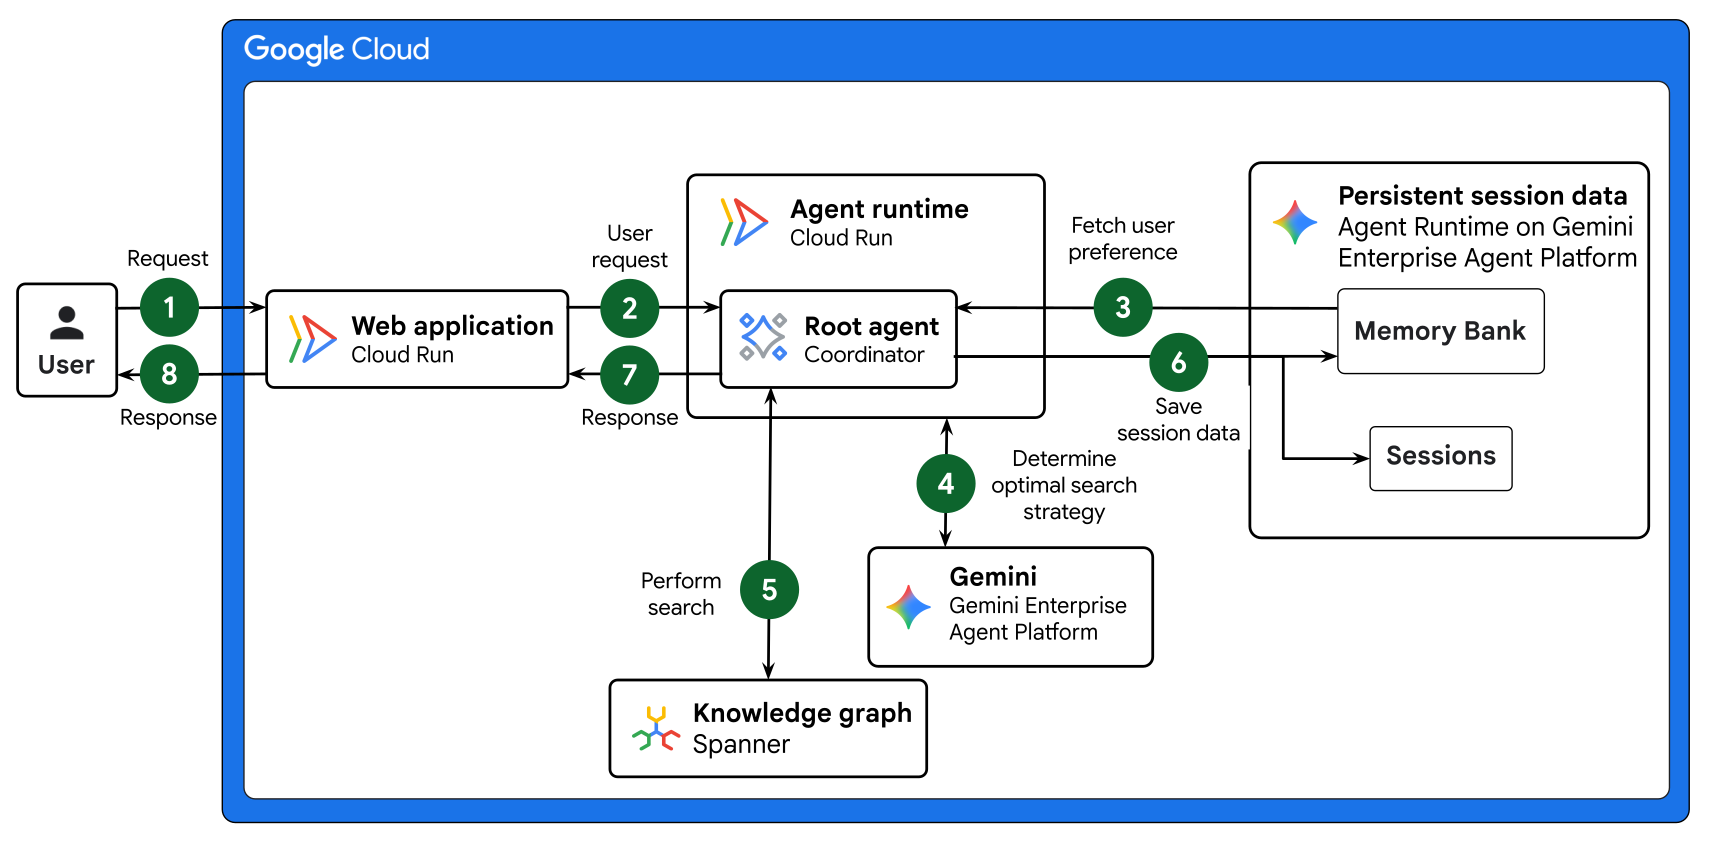
위 다이어그램에서는 다음과 같은 데이터 흐름을 보여줍니다.
- 사용자가 웹 애플리케이션에 검색 요청을 시작합니다. 예를 들어 포트폴리오 관리자는 24시간 내에 총 거래량이 100만 달러를 초과하는 3개 이상의 항목이 포함된 순환 거래 패턴을 감지하는 요청을 제출합니다.
- 웹 애플리케이션은 요청을 루트 에이전트로 전달합니다. 루트 에이전트 는 요청을 수신하고 Cloud Run 서비스에 배포되는 코디네이터 에이전트입니다.
- 루트 에이전트는 메모리 뱅크 에서 영구 세션 데이터를 검색하여 포트폴리오 관리자의 이전 환경설정 및 환자 컨텍스트를 기반으로 검색 결과를 맞춤설정합니다.
- 루트 에이전트는 Agent Platform의 Gemini를 사용하여 최적의 검색 전략을 결정합니다:
- 키워드 검색: SQL
LIKE절을 사용하여 정확한 카테고리 또는 위치를 일치시킵니다. - 시맨틱 RAG 검색: 임베딩 모델과 코사인 거리를 사용하여 시맨틱으로 유사한 데이터 항목을 찾습니다.
- 하이브리드 검색: 키워드 검색과 시맨틱 RAG 검색을 실행하고 상호 순위 융합 (RRF)을 사용하여 결과를 병합하여 높은 관련성과 커버리지를 보장합니다.
- 키워드 검색: SQL
- 루트 에이전트는 Spanner Graph에 저장된 지식 그래프에서 적절한 검색 전략을 실행합니다.
- 지식 그래프는 검색 결과를 루트 에이전트로 전달합니다.
- 루트 에이전트는 다음 작업을 실행하여 에이전트 AI 시스템
을 업데이트하여 애플리케이션에 응답합니다.
- 콜백 함수를 트리거하여 세션 데이터를 Gemini Enterprise Agent Platform 세션의 Agent Runtime에 저장합니다.
- 세션에서 맞춤 메모리 주제를 추출합니다. 예를 들어 재무 분석가는 메모리 주제를 만들어 규제 플래그 또는 새로운 부문별 추세를 추적할 수 있습니다.
- 요약 응답을 웹 애플리케이션으로 전달합니다.
- 웹 애플리케이션은 응답을 사용자에게 다시 전달합니다.
사용 제품
이 참조 아키텍처에는 다음과 같은 Google Cloud 제품과 기능이 사용됩니다.
- Cloud Run: Google의 확장 가능한 인프라에서 직접 컨테이너를 실행할 수 있게 해주는 서버리스 컴퓨팅 플랫폼입니다.
- Gemini: Google에서 개발한 멀티모달 AI 모델 제품군입니다.
- Gemini Enterprise Agent Platform: 엔터프라이즈급 AI 에이전트를 빌드, 확장, 제어, 최적화할 수 있는 포괄적인 플랫폼입니다.
- Cloud Storage: 다양한 데이터 유형에 적합한 저비용, 무제한 객체 스토어입니다. 내부 및 외부에서 데이터에 액세스할 수 있고 Google Cloud중복성을 위해 여러 위치에 복제됩니다.
- Spanner Graph: Spanner의 확장성, 가용성, 일관성 기능을 제공하는 그래프 데이터베이스입니다.
- Gemini Enterprise Agent Platform 세션: 사용자와 에이전트 간의 상호작용 기록을 저장하고 검색하는 영구 스토리지 서비스입니다.
- 메모리 뱅크: 사용자가 에이전트와 나눈 대화를 기반으로 장기 메모리를 생성, 개선, 관리, 검색하는 영구 스토리지 서비스입니다.
프레임워크, 에이전트 런타임, 도구, 메모리, 설계 패턴을 비롯한 에이전트 AI 시스템의 대체 구성요소 선택에 대한 자세한 내용은 다음 항목을 참고하세요. 에이전트 AI 아키텍처 구성요소 선택
사용 사례
이 아키텍처는 단편화된 멀티모달 데이터를 통합하고 분석하여 리소스 할당 및 정보 검색을 최적화하는 사용 사례를 위해 설계되었습니다. 독립적인 하위 에이전트를 유지함으로써 시스템은 모듈식 업데이트를 지원하고 분산 리소스가 연속성을 유지하면서 검색 요구사항과 일치하도록 보장합니다. Spanner Graph를 지식 그래프로 통합하면 에이전트 AI 시스템이 복잡하고 상호 연결된 데이터를 모델링할 수 있습니다. 이 통합은 관계형 또는 NoSQL 데이터베이스에서 어렵거나 비효율적일 수 있는 풍부한 컨텍스트 이해와 정교한 쿼리 기능을 지원합니다.
다음 사용 사례의 경우 그래프 데이터베이스는 멀티모달 데이터에서 파생되는 임의의 진화하는 연결을 나타내는 데 탁월합니다. 이러한 연결에는 관계형 데이터베이스에서 복잡하고 엄격한 스키마 관리가 필요합니다.
다음은 이 문서에 설명된 아키텍처의 사용 사례 예시입니다.
- 엔터프라이즈 HR 인재 이동: 시맨틱 확장을 통해 자격을 갖춘 내부 후보자를 식별하여 대규모 채용 검색의 키워드 검색을 개선합니다. 이 아키텍처는 멀티모달 포트폴리오와 동영상 소개에서 기술 및 소프트 스킬 평가를 추출하여 포괄적인 인재 그래프를 빌드합니다. Spanner 지식 그래프는 직원, 역량, 프로젝트 기록 간의 관계를 추적합니다. 추적 결과는 개념적 깊이를 기반으로 전문가를 식별하고 인력이 부족한 프로젝트에 플래그를 지정합니다.
- 소셜 미디어 콘텐츠 분석: 소셜 미디어 플랫폼에서 고급 콘텐츠 검색 및 네트워크 분석을 실행하여 특정 메모리 또는 추세를 식별합니다. 이 시스템은 동영상, 음성 메모, 브이로그와 같은 업로드를 처리한 다음 항목, 주제, 감정, 언급을 추출합니다. Spanner 지식 그래프는 사용자, 연결 (친구 및 팔로워), 게시물, 좋아요, 댓글, 공유 주제, 추세 간의 관계를 추적합니다.
설계 고려사항
다음 섹션에서는 AI 에이전트를 설계하고 프로덕션을 위해 이 아키텍처를 구현하기 위한 일반적인 권장사항을 제공합니다.
AI 에이전트 설계
에이전트의 비용과 성능을 개선하려면 다음 권장사항을 고려하세요.
- 에이전트 시스템 설계: 모놀리식 에이전트 대신 명확하게 정의된 책임이 있는 여러 전문 에이전트로 복잡한 워크플로를 분해합니다. 이렇게 관심사를 분리하면 프롬프트 엔지니어링이 간소화되고, 명령어 드리프트가 최소화되며, 세분화된 모델 확장이 가능합니다. 이 아키텍처는 대량의 잘 정의된 작업을 더 작고 빠른 모델로 라우팅하는 동시에 복잡한 추론을 고용량 모델에 예약합니다.
- 루트 에이전트 라우팅: 지연 시간을 최소화하고 불필요한 하위 에이전트 호출을 방지하려면 에이전트 명령어에서 라우팅 로직을 명확하게 정의합니다. 모델이 올바른 도구를 선택할 수 있도록 각 도구의 목적, 입력 매개변수, 예상 출력이 문자열 리터럴에 문서화되어 있는지 확인합니다.
- 도구 설계: 단일 모놀리식 메서드를 사용하는 대신 도구를 여러 개의 집중된 메서드로 분리합니다. 이 접근 방식은 코드베이스 전반에서 일관성을 보장하고, 로직 분기를 줄이며, 직접 검색 메서드가 호출될 때 쿼리 분석을 건너뛰는 것과 같은 특정 최적화 경로를 지원합니다.
- 에이전트 컨텍스트: 순차적 파이프라인에서 다운스트림 에이전트가 업스트림 데이터에 대해 쿼리를 반복하지 않도록 에이전트 상태를 통해 충분한 컨텍스트를 전달합니다. 각 에이전트가 데이터를 안정적으로 파싱할 수 있도록 공유 상태에 대해 잘 정의된 JSON 구조를 사용합니다.
- 세션 상태 스토리지: 즉각적인 대화 기록에는 세션 상태를 사용하고 세션 전반에서 추출된 사실에는 메모리 뱅크를 사용합니다. 에이전트가 긴 대화 기록을 다시 처리하지 않고도 환경설정을 참조할 수 있도록 세션 시작 시 메모리 컨텍스트를 삽입합니다.
- 메모리 품질: 사용자의 환경설정 또는 역할이 시간이 지남에 따라 변경되는 경우 사용자가 오래된 메모리를 삭제하거나 업데이트 할 수 있도록 합니다.
- 데이터베이스 내 AI 모델: 지연 시간을 줄이려면 Spanner
ML.PREDICT함수를 사용하여 SQL 쿼리 내에서 모델을 인라인으로 호출합니다. 하이브리드 검색 워크로드는 쿼리당 여러 모델 호출을 트리거할 수 있으므로 Agent Platform 할당량 사용량을 모니터링합니다.
프로덕션 설계
프로덕션을 위해 이 아키텍처를 구현하려면 다음 권장사항을 고려하세요.
- 세분화된 액세스 제어 구현: 세분화된 액세스 제어를 사용하여 테이블 및 열 수준에서 액세스를 승인합니다. Cloud Run 서비스 계정만 액세스할 수 있도록 Cloud Storage 버킷 정책을 제한합니다.
- 추론 및 응답 정리: Model Armor를 사용하여 추론 요청과 모델 응답을 모두 검사하고 정리합니다. 이 정리는 사용자가 업로드하는 멀티모달 콘텐츠의 프롬프트 인젝션 위험을 완화합니다. 또한 에이전트 출력에서 개인 식별 정보 (PII) 또는 민감한 정보가 실수로 유출되는 것을 방지하는 데 도움이 됩니다.
- 에이전트 재시도 로직 구현: 할당량 한도와 같은 일시적인 오류를 처리하려면 재시도 로직을 지수 백오프와 함께 구현하여 Agent Platform 엔드포인트 및 Spanner를 호출합니다.
- 파일 한도 설정: 대용량 파일로 인한 API 제한 시간을 방지하려면 명시적 업로드 크기 한도를 설정하고 데이터 항목 을 추출하기 전에 대용량 동영상을 청크로 분리합니다. 자세한 내용은 동영상 처리 맞춤설정을 참고하세요.
- 비용 분석 및 관리: Agent Platform 비용을 분석하고 관리하려면 초당 쿼리 수 (QPS) 및 초당 토큰 수 (TPS)에 대한 기준 측정항목을 만드는 것이 좋습니다. 그런 다음 배포 후 이러한 측정항목을 모니터링합니다. 비용 관리의 일부로 만드는 기준은 용량 계획을 결정하는 데 도움이 될 수 있습니다. 예를 들어 기준 은 프로비저닝된 처리량이 필요할 수 있는 시점을 결정하는 데 도움이 됩니다.
- 스토리지 수명 주기 자동화: 스토리지 비용을 줄이려면 객체 수명 주기 관리를 사용하여 정의된 보관 기간이 지난 후 파일을 Nearline 또는 Coldline Storage 등급으로 이동합니다.
- 정형 로깅 사용: 정형 메타데이터를 사용하여 모든 에이전트 도구 호출 및 파이프라인 결과를 로깅합니다. 정형 로그를 사용하면 Cloud Monitoring에서 로그와 대시보드를 쿼리할 수 있습니다.
- 추적 구현: 지연 시간 핫스팟을 진단하려면 Cloud Trace를 사용하여 에이전트 실행기 및 도구 실행 전반에서 엔드 투 엔드 요청 추적을 캡처합니다.
- 에이전트 품질 평가: Gen AI Evaluation Service를 사용하여 에이전트 출력 품질을 주기적으로 평가하여 도구 선택 궤적과 응답 품질을 확인합니다.
- 리소스 할당: 성능 요구사항에 따라 Cloud Run 서비스에 할당할 메모리 한도 및 CPU 한도를 구성합니다.
멀티 에이전트 AI 시스템 빌드 및 배포를 위한 설계 요소, 권장사항, 권장사항에 대한 자세한 내용은 의 멀티 에이전트 AI 시스템을 참고하세요. Google Cloud
배포
이 아키텍처의 샘플 구현을 배포하려면 Way Back Home Level 2 Codelab을 사용해 보세요.
다음 단계
- Cloud Run에서 AI 에이전트를 호스팅하는 방법을 알아보세요.
- Agent Platform 및 Spanner Graph를 사용하여 생성형 AI용 GraphRAG 인프라를 빌드하는 방법을 알아보세요.
- Spanner Graph 스키마 설계 권장사항을 알아보세요.
- 멀티모달 임베딩을 가져오는 방법을 알아보세요.
- 에서 멀티 에이전트 AI 시스템을 빌드하는 방법을 알아보세요 Google Cloud.
- Gemini Enterprise Agent Ready (GEAR)를 사용하여 엔터프라이즈급 에이전트를 빌드하고 배포하기 위한 학습 리소스를 살펴보세요.
- 에서 AI 및 ML 워크로드와 관련된 아키텍처 원칙 및 권장사항에 대한 개요는 Google Cloud Well-Architected Framework의 AI 및 ML 관점 을 참고하세요.
- 그 밖의 참조 아키텍처, 다이어그램, 튜토리얼, 권장사항을 알아보려면 Cloud 아키텍처 센터를 확인하세요.
참여자
저자:
기타 참여자: