


המחברים מקבלים נתונים ממקורות נתונים של Google ושל צד שלישי ב-Gemini Enterprise, ושומרים אותם במאגרי נתונים ייעודיים. במאמר הזה נסביר בקצרה על המחברים האלה. ריכוז הנתונים ב-Gemini Enterprise משפר את הנגישות לנתונים, את פונקציונליות החיפוש ואת יכולות הניתוח.
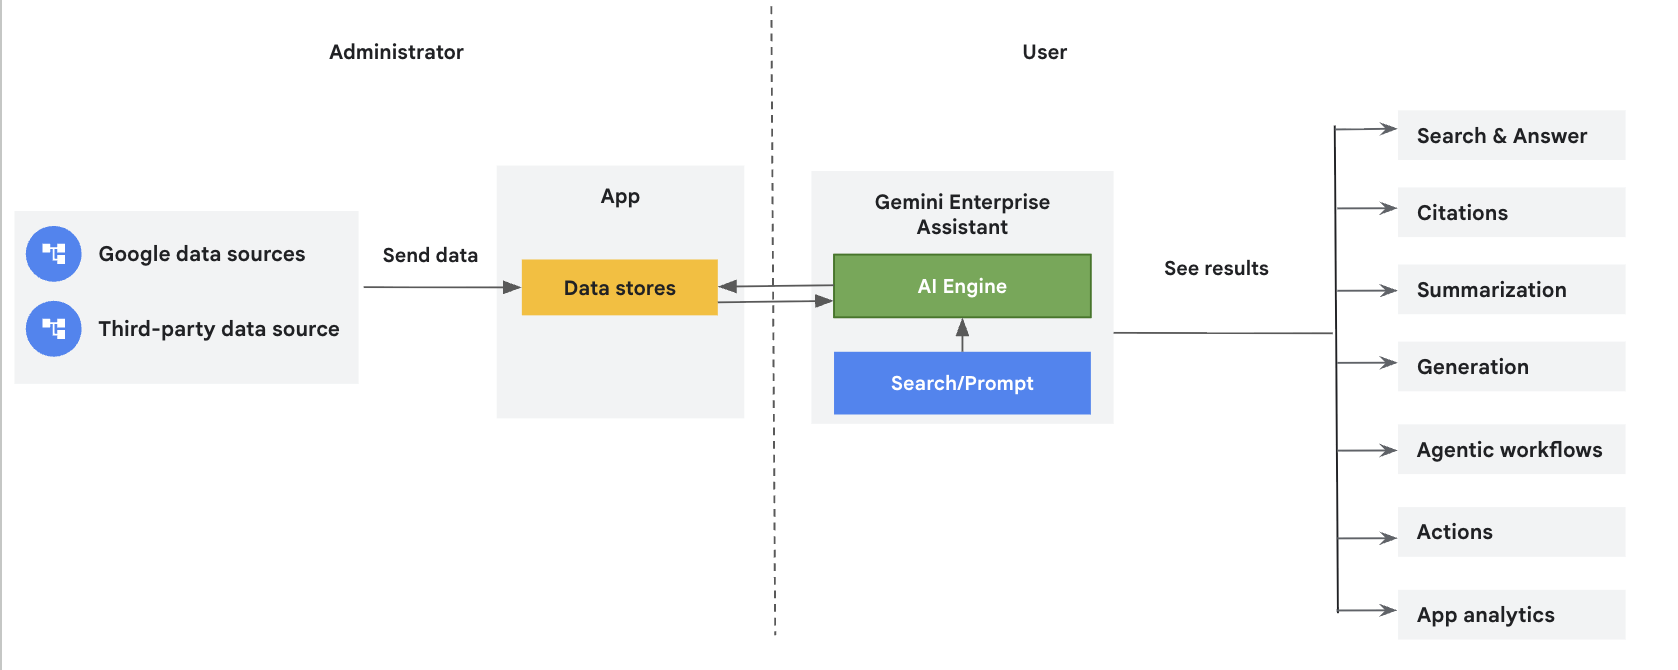
מושגים שקשורים למחברים ולמאגרי נתונים
מאגרי נתונים |
| כל מקור נתונים תומך בקבוצה של סוגי ישויות. לדוגמה, ב-Jira Cloud יש ישויות כמו בעיות, קבצים מצורפים, תגובות ויומני עבודה, שהן ייחודיות למקור הנתונים. Gemini Enterprise יוצר מאגר נתונים נפרד לכל ישות. לכן, כשיוצרים מאגר נתונים באמצעות מסוף Google Cloud , מקבלים אוסף של מאגרי נתונים שמייצגים את ישויות הנתונים האלה שהוטמעו. |
איחוד נתונים לעומת הטמעה (הוספה לאינדקס) |
| איחוד נתונים מאחזר מידע ישירות ממקור הנתונים שצוין. הנתונים לא מועתקים לאינדקס של Gemini Enterprise, אז אתם לא צריכים לדאוג לגבי אחסון הנתונים. עם זאת, מכיוון שהנתונים לא נוספים לאינדקס, יכול להיות שאיכות החיפוש תהיה נמוכה יותר. הטמעת נתונים (הוספה לאינדקס) מעתיקה נתונים לאינדקס של Gemini Enterprise. כך אפשר לשפר את איכות החיפוש. עם זאת, התהליך הזה דורש יותר נפח אחסון וזמן. אם המחבר תומך גם באיחוד נתונים וגם בהטמעת נתונים, בוחרים את שיטת חיבור הנתונים המועדפת. |
נתונים לא מובְנים |
| פורמט הנתונים הנתמך הוא ספציפי למקור הנתונים ולסוג הישות. אם התוכן בישות מאוחסן בפורמט לא מובנה, כמו PDF, HTML, DOCX, PPTX, XLSX ו-XLSM, Gemini Enterprise יוצר מאגר נתונים לא מובנים. למידע נוסף ולסוגי הקבצים הנתמכים, ראו חיפוש לא מובנה. |
נתונים מובְנים |
| פורמט הנתונים הנתמך הוא ספציפי למקור הנתונים ולסוג הישות. אם התוכן בישות מאוחסן בפורמט מובנה, Gemini Enterprise יוצר מאגר נתונים מובנה. מידע נוסף זמין במאמר חיפוש מובנה. |
סכימות של נתונים |
| סכימת הנתונים מגדירה את מבנה הנתונים. כשמייבאים נתונים מובְנים באמצעות Gemini Enterprise, המערכת מזהה את הסכימה באופן אוטומטי. אפשר להשתמש בסכימה שזוהתה באופן אוטומטי או להגדיר את הסכימה באמצעות ה-API. מידע נוסף זמין במאמר הגדרת סכימה או זיהוי אוטומטי שלה. |
אזורים של מאגרי נתונים |
| כשמטמיעים נתונים, צריך לבחור את האזור שבו רוצים לאחסן את הנתונים, למשל גלובלי, ארה"ב או האיחוד האירופי. מידע נוסף זמין במאמר התחייבויות לגבי מיקום אחסון הנתונים ועיבוד אזורי של למידת מכונה. נתונים שמאוחסנים באזורים בארה"ב או באיחוד האירופי דורשים הצפנת נתונים. הצפנת ברירת המחדל היא באמצעות Google-owned and Google-managed encryption key, אבל אפשר גם להשתמש במפתחות הצפנה בניהול הלקוח. |
סנכרון נתונים |
סנכרון נתונים שולף ומעדכן נתוני זהות (כמו תפקידים, הרשאות ומשתמשים) ונתוני ישויות (כמו נתונים שקשורים למקור נתונים ספציפי) ממקור הנתונים המקורי. מידע נוסף זמין במאמר סוגים ולוחות זמנים של סנכרון נתונים. |
סוגים ולוחות זמנים של סנכרון נתונים
סנכרון נתונים מתעד נתוני ישויות, נתוני זהויות או את שניהם, ומעדכן את התוכן של מאגר הנתונים ב-Gemini Enterprise.
סוגי סנכרון
מאגרי הנתונים ב-Gemini Enterprise משתמשים בשני סוגים חיוניים של סנכרון נתונים:
סנכרון מלא מתעד את כל המצב של האפליקציה או השירות של הצד השלישי. זה כולל הוספות, עדכונים ומחיקות. סנכרון מלא מחליף את התוכן הקיים במאגר הנתונים.
סנכרון מצטבר מתעד מדי פעם נתוני ישויות שנוספו או עודכנו מאז הסנכרון האחרון. הוא לא מסנכרן נתוני זהות או מחיקות של נתוני ישויות.
אפשר לתזמן סנכרון מלא בנפרד לסוגי הנתונים הבאים:
סנכרון ישויות מתעד נתונים ספציפיים למקור הנתונים של הצד השלישי. לדוגמה, מאגר נתונים של מערכת כמו Jira יכול לסנכרן בעיות, יומני עבודה, תגובות וקבצים מצורפים. סנכרוני ישויות לא כוללים פרטי זהות.
סנכרון זהויות מתעד נתונים על חשבונות משתמשים שמשויכים לקבוצת ACL.
האינטראקציה בין סנכרון זהויות לסנכרון מלא
כדי להבין איך פועלת הרצה של סנכרון זהויות ספציפיות עם הרצה של סנכרון מלא, נבחן תרחיש לדוגמה שכולל שני דפים: page_1, שמקושר לקבוצת ACL group_1; ו-page_2, שמקושר לקבוצת ACL group_2.
מתבצע סנכרון זהויות ראשוני, ומאחזר מידע על הקבוצות
group_1ו-group_2.נניח ש-
group_1מכיל את המשתמשuser_1.נניח ש-
group_2מכיל את המשתמשuser_2.
סנכרון הזהויות הזה יוצר את המיפוי הבא:
user_1ממופה אלgroup_1.user_2ממופה אלgroup_2.
במקביל לסנכרון הזהויות, פועל סנכרון מלא שמאחזר גם את
page_1וגם אתpage_2.הסנכרון המלא הזה יוצר את המיפוי הבא:
לאפליקציה
user_1יש גישה אלpage_1(באמצעותgroup_1).לאפליקציה
user_2יש גישה אלpage_2(באמצעותgroup_2).
לוחות זמנים לסנכרון
לכל מאגר נתונים, אתם יכולים לבחור תדירות לסוגי סנכרון שונים:
אפשר לתזמן סנכרון מלא של כל נתוני הזהויות ונתוני הישויות בו-זמנית כל 3 שעות, 6 שעות, 12 שעות, יום אחד או 3 ימים.
אפשר לתזמן בנפרד סנכרונים מלאים ועצמאיים של כל נתוני הזהויות וסנכרונים מלאים ועצמאיים של כל נתוני הישויות, באמצעות כל אחת מתדירויות הסנכרון הבאות בהתאמה אישית:
נתוני ישויות: כל 3 שעות, 6 שעות, 12 שעות, יום אחד, 3 ימים, 5 ימים וכל 7 ימים.
נתוני זהות: כל 30 דקות, שעה, 3 שעות, 6 שעות, 12 שעות, יום, 3 ימים, 5 ימים ו-7 ימים.
אפשר לתזמן סנכרונים מצטברים של נתוני ישויות מעודכנים או חדשים כל 3 שעות, 6 שעות, 12 שעות, יום אחד, 3 ימים, 5 ימים או כל 7 ימים. כברירת מחדל, סנכרון מצטבר מתבצע כל 3 שעות.
המלצות לגבי תדירות
בחרו תדירות סנכרון נתונים שתואמת לנפח הרשומות שנשלפות ולמספר השאילתות המומלץ לשנייה (QPS).
בטבלה הבאה מוצג המספר האופייני של רשומות שאוחזרו בסנכרון של יום אחד, שלושה ימים, חמישה ימים ושבעה ימים. מספר הרשומות בפועל עשוי להשתנות בהתאם למקור הנתונים ולהגדרות שלו.
| QPS | נפח ההקלטות לסנכרון של יום אחד | נפח ההקלטה לסנכרון של 3 ימים | נפח ההקלטות לסנכרון של 5 ימים | נפח ההקלטות לסנכרון של 7 ימים |
|---|---|---|---|---|
| 5 | 432 אלף | 1.296M | 2.16M | 3 מיליון |
| 10 | 864 אלף | 2.592M | 4.32 מיליון | 6 חודשים |
| 20 | 1.7 מיליון | 5.1M | 8.5 מיליון | 11.9 מיליון |
| 50 | 4.3M | 12.9M | 21.5 מיליון | 30.1 מיליון |
| 100 | 8.6 מיליון | 25.8M | 43M | 60.2 מיליון |
השהיה והמשך של סנכרונים
אפשר להשהות ולהמשיך גם סנכרונים מלאים וגם סנכרונים מצטברים:
כשמשהים סוג סנכרון, מאגר הנתונים מבטל את הסנכרונים הפעילים מהסוג הזה ומפסיק לתזמן סנכרונים חדשים מהסוג הזה.
כשממשיכים סוג סנכרון, מאגר הנתונים מתזמן את הסנכרון החדש לפי זמן הסנכרון המתוזמן האחרון, אבל לא ממשיך את הסנכרון שהופסק.
לדוגמה, אם משהים את הסנכרון המלא בזמן שהוא מתבצע, מאגר הנתונים מבטל את הסנכרון הזה. אם תחדשו את הסנכרון המלא מאוחר יותר, מאגר הנתונים יתזמן אוטומטית סנכרון מלא חדש בהתאם ללוח הזמנים של הסנכרון המלא.
מקורות נתונים של Google
אתם יכולים להתחבר למקורות נתונים של Google, כמו BigQuery, Spanner ו-Google Drive.
רשימת משימות למקורות נתונים של Google
לפני ששולחים נתונים ל-Gemini Enterprise, כדאי לעבור על רשימת המשימות הבאה:
מגדירים בקרת גישה למקור הנתונים. מידע נוסף זמין במאמר זהות והרשאות.
מחליטים אם הנתונים צריכים להיות מאוחדים או מוטמעים (נוספים לאינדקס).
בוחרים באיזו תדירות הנתונים יסונכרנו.
אם אתם משתמשים במפתחות הצפנה בניהול הלקוח (CMEK), צרו מפתחות במספר אזורים. מידע נוסף מופיע במאמר רישום מפתחות לאזור יחיד בשביל מקורות נתונים של צד שלישי.
אם יש לכם פרטים אישיים מזהים (PII) ואתם מתכוונים להשתמש בהשלמה אוטומטית להצעות לשאילתות, קראו את המאמר הגנה מפני דליפות של פרטים אישיים מזהים.
מקורות הנתונים בחשבון Google נתמכים
| Google Drive | Gmail | יומן Google | חיפוש אנשים |

|

|

|

|
מקורות נתונים של צד שלישי
מאגרי נתונים של צד שלישי מעבירים נתונים מאפליקציות של צד שלישי אל Gemini Enterprise.
רשימת משימות למקורות נתונים של צדדים שלישיים
לפני שמקשרים מקור נתונים של צד שלישי ל-Gemini Enterprise, חשוב לעבור על רשימת המשימות הבאה:
במקורות נתונים מסוימים צריך להגדיר היקפים והרשאות ספציפיים. אדמין של אפליקציית הצד השלישי צריך לבדוק את פרטי הכניסה הנדרשים כדי לקשר מקור נתונים ולהגדיר אימות והרשאות. למידע על ההיקפים וההרשאות הספציפיים, עיינו במסמכי התיעוד של מקור הנתונים הרלוונטי של הצד השלישי.
מגדירים בקרת גישה למאגר הנתונים. למידע נוסף, קראו את המאמר זהות והרשאות.
מחליטים אם הנתונים צריכים להיות מאוחדים או מוטמעים (נוספים לאינדקס).
אם הנתונים נטמעים, ודאו שהמשאבים לא מוגבלים לפרטי הכניסה של המשתמש שבהם אתם משתמשים כדי להטמיע נתונים במקור הנתונים.
בוחרים באיזו תדירות הנתונים יסונכרנו.
אם אתם משתמשים במפתחות הצפנה בניהול הלקוח (CMEK), צרו מפתחות למספר אזורים ולאזור יחיד. מידע נוסף זמין במאמר רישום מפתחות לאזור יחיד במאגרי נתונים של צד שלישי.
אם יש לכם פרטים אישיים מזהים (PII) ואתם מתכוונים להשתמש בהשלמה אוטומטית להצעות לשאילתות, קראו את המאמר הגנה מפני דליפות של פרטים אישיים מזהים.
אם אתם רוצים שתנועה יוצאת ממאגר הנתונים תגיע מקבוצה קבועה של כתובות IP (לדוגמה, כדי להוסיף אותן לרשימת ההיתרים במערכת המקור), ואם מאגר הנתונים תומך בכך, עיינו במאמר הגדרת תנועה יוצאת של כתובת IP סטטית.
מקורות נתונים נתמכים של צדדים שלישיים
| Microsoft Entra ID | Microsoft OneDrive | Microsoft Outlook | Microsoft SharePoint |

|

|

|

|
| Jira Cloud | Confluence Cloud | ServiceNow | |

|

|

|