


本指南提供完整逐步說明,引導您在 Google Distributed Cloud (GDC) 實體隔離環境中,跨三個區域部署高可用性 PostgreSQL 堆疊。您將瞭解如何準備必要的軟體構件、啟動目標 VM,以及使用 Autobase 自動執行整個佈建程序。在本指南中,Patroni 是主要管理層,用於協調 PostgreSQL 生命週期和處理自動容錯移轉。
架構
這個架構包含三個 VM 環境,分布在三個可用區。
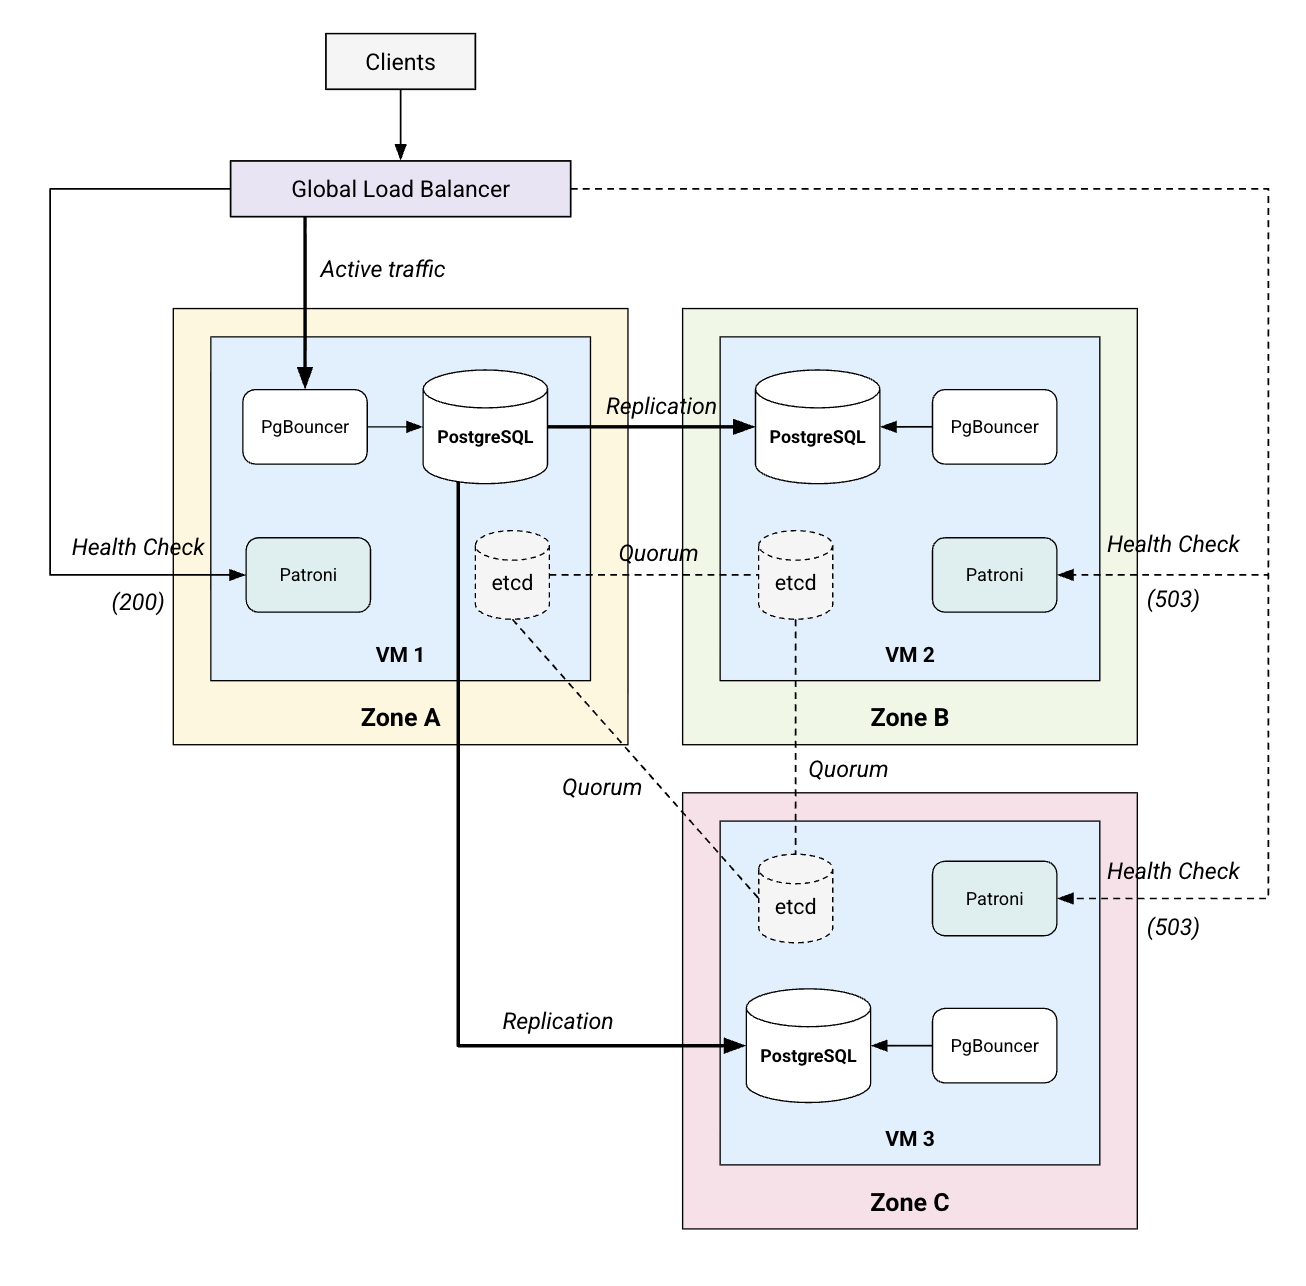
每個 VM 都相同,且執行共置服務堆疊:
- PostgreSQL 17:核心關聯式資料庫引擎。
- Patroni:高可用性管理工具。可處理 PostgreSQL 程序的生命週期,並執行自動容錯移轉。這個服務會在通訊埠
8008上公開 HTTPS REST API (端點/primary),負載平衡器會使用這個 API 識別目前的領導者。 - etcd:分散式設定儲存庫 (DCS)。這個服務提供領導者選舉的共識層,並儲存 Patroni 的設定。
- PgBouncer:位於 PostgreSQL 前方的連線集區器,可穩定連線負荷。並提供通訊埠
6432上應用程式流量的建議進入點。
這個堆疊也包含 GDC 氣隙式全域 L4 負載平衡器,這項平台代管服務可提供穩定的虛擬 IP (VIP)。應用程式會連線至通訊埠 6432 上的穩定 VIP,負載平衡器會將該 VIP 路由至目前領導者 VM 上的 PgBouncer。PgBouncer 接著會將要求 Proxy 至本機 PostgreSQL 執行個體。為管理流量,負載平衡器會持續輪詢 Patroni HTTPS 端點,進行健康狀態檢查。
領導者 VM 的健康狀態檢查會傳回 HTTP 200 OK,表示 VM 已準備好接收流量;副本 VM 的健康狀態檢查則會傳回 HTTP 503 Service Unavailable,表示負載平衡器應略過這些 VM。如果領導者發生故障,系統會選出新的領導者,而該領導者的 Patroni 執行個體會開始傳回 HTTP 200 OK,導致負載平衡器自動將流量重新導向至新 VM 的 PgBouncer 連接埠。
為確保高可用性並避免資料遺失,堆疊採用仲裁的概念。如果使用 3 個 VM,系統需要至少有兩個成員健康狀態良好且能通訊,才能選出領導者並維持運作。這項以多數為準的共識由 etcd 和 Patroni 管理,可讓堆疊自動容許任何單一 VM 或區域全面故障。
效能注意事項
規劃部署作業時,請考量下列具體因素,以盡可能提升效能和可靠性:
- 硬體大小:雖然需求因工作負載而異,但您可以將下列標準設定檔做為每個 VM 的起點:
- 開發/概念驗證:2 個 vCPU、8 GB RAM (穩定運作的最低需求)。
- 小型正式環境:4 個 vCPU,16 GB RAM。適合並行程度中等的內部工具。
- 標準生產環境:8 個 vCPU、32 GB RAM。建議用於重要應用程式的基準。
- 高輸送量:16 個以上 vCPU、64 GB 以上 RAM。適用於需要大量記憶體內資料快取 (PostgreSQL 共用緩衝區) 的工作負載。
- 儲存空間效能:高效能儲存空間至關重要。強烈建議使用 SSD 磁碟,確保 etcd 穩定性。etcd 對磁碟寫入延遲時間極為敏感;官方 etcd 硬體指南建議磁碟 WAL fdatasync 延遲時間的第 99 個百分位數應小於 10 毫秒。
- 網路延遲:VM 之間的延遲時間會直接影響複製效能:
- etcd Quorum:平均封包往返時間 (RTT) 應 < 50 毫秒 (理想情況下 < 10 毫秒),以避免選舉逾時和叢集不穩定。
- 同步複製:如果已設定,每筆寫入交易都必須等待副本確認。GDC 氣隙中的區域間延遲時間通常 < 1 毫秒,非常適合將寫入負擔降至最低 (通常為 10% 至 30%)。
- PgBouncer 的角色:PostgreSQL 會為每個連線建立新的 OS 程序,這會耗用約 10 MB 的 RAM,並產生 CPU 內容切換成本。PgBouncer 會維護持續連線集區,藉此減少這項額外負擔,讓資料庫能以大幅減少的後端程序,處理數千個應用程式連線。
- 補充元件:Patroni 和 etcd 輕量,但需要持續提供 CPU。在高負載情境中,請確保 VM 在管理程序層級不會過度訂閱,以免「竊取」心跳和領導者維護所需的 CPU 週期。
- 核心微調:Autobase 自動化程序會套用對 PostgreSQL 有益的最佳化設定,例如設定 sysctl 參數 (例如
vm.swappiness、net.core.somaxconn) 和停用透明巨頁 (THP)。這些變更可減少記憶體管理負擔,並提升高流量資料庫執行個體的網路輸送量。
事前準備
開始部署前,請務必確認您的環境符合下列需求。
查看 VM 需求
為符合本教學課程的目的,您必須在 GDC 氣隙專案中建立三部 VM。您需要考量 VM 的下列要點和需求:
- 可用區分配:如要確保這個部署作業能真正抵禦可用區故障,您應將 VM 分配到三個不同的可用區。不過,如果 VM 位於兩個可用區,甚至是單一可用區,部署作業仍會相同。最重要的是,所有 VM 都能透過網路,使用內部 IP 位址相互通訊。
- 作業系統:本教學課程假設您使用 Ubuntu 22.04 映像檔。如果您使用其他發行版本,本指南的後續步驟可能有所不同。
- 資源:在本教學課程中,您應為每個 VM 至少佈建 2 個 CPU 和 8 GB 記憶體。在實際工作環境中,您必須為特定工作負載佈建適當的資源 (請參閱效能考量事項)。
- 網路 IP:請記下每個 VM 的內部和外部 IP 位址。在本指南中,您會使用外部 IP 進行 Ansible 控制,因為您是從外部工作站執行指令。內部 IP 用於服務間通訊和繫結。如果您在網路內佈建了啟動程序 VM,則只需要內部 IP。
- 存取權:部署使用者必須具備無密碼 sudo 存取權,因為 Ansible 自動化程序需要執行管理工作 (安裝套件、修改系統設定),且不得因密碼提示而遭到封鎖。
- SSH:必須啟用金鑰型驗證,Ansible 才能安全地以非互動方式連線至目標 VM。
準備本機工作站軟體
如要管理部署作業及準備與外部網路隔離的構件,您需要在本機工作站安裝一組自動化和容器化工具。
- Ansible 2.17.0 以上版本:自動化引擎,可執行部署應對手冊和角色。
- Docker:用於在與目標 VM (Ubuntu 22.04) 相同的環境中,提取及封裝 OS 依附元件。
- PostgreSQL 用戶端 (
psql):必須執行測試查詢,並從本機工作站驗證資料複製作業。 Autobase 存放區:
- 複製存放區,存取自動化劇本和角色: https://github.com/vitabaks/autobase
簽出特定版本 (本指南使用 2.5.2 版):
git checkout 2.5.2如果您使用其他發行版本,本指南的後續步驟可能有所不同。
如要執行本指南中的劇本,請務必將本機
autobase原始碼安裝為 Ansible 集合,以便解析角色前置字元:cd autobase/automation ansible-galaxy collection install . --force
建立一些環境變數
在本指南中,您會使用下列環境變數簡化指令。這些變數會儲存重要參數,例如專案 ID、VM 的可用區、主機名稱,以及負載平衡器用來識別叢集的標籤。在目前的殼層工作階段中,使用環境的實際值設定這些變數 (請確保時區以空格分隔)。
請注意,雖然您可以為 VM 設定任何名稱,但本指南會使用 postgres-vm-1、postgres-vm-2 和 postgres-vm-3 做為叢集節點的任意範例名稱:
export PROJECT_ID="your-project-id"
export ZONES="zone1 zone2 zone3"
export VM1_NAME="postgres-vm-1"
export VM2_NAME="postgres-vm-2"
export VM3_NAME="postgres-vm-3"
export VM_LABEL="app=my-postgres-cluster"
export CLUSTER_NAME="my-postgres-cluster"
設定 Ansible
使用下列範本,在 inventory.ini 檔案中定義 VM 環境:
[master]
postgres-vm-1 ansible_host=XX.XX.XX.XX hostname=postgres-vm-1 bind_address=XX.XX.XX.XX

[replica]
postgres-vm-2 ansible_host=XX.XX.XX.XX hostname=postgres-vm-2 bind_address=XX.XX.XX.XX
postgres-vm-3 ansible_host=XX.XX.XX.XX hostname=postgres-vm-3 bind_address=XX.XX.XX.XX

[postgres_cluster:children]
master
replica

[etcd_cluster]
postgres-vm-1
postgres-vm-2
postgres-vm-3

[all:vars]
ansible_user=...
ansible_ssh_private_key_file=~/.ssh/...
postgresql_version=17
with_haproxy_load_balancing=false
patroni_superuser_password=...
etcd_package_repo="file:///tmp/packages/etcd-v3.5.25-linux-amd64.tar.gz"
installation_method="packages"
install_postgresql_repo=false
install_timescale_repo=false
install_citus_repo=false
apt_repository=[]
yum_repository=[]
install_system_packages=false
patroni_installation_method=deb
瞭解設定:
[master]和[replica]:定義主要和次要資料庫 VM。請務必使用VM1_NAME、VM2_NAME和VM3_NAME環境變數中設定的實際 VM 名稱。[postgres_cluster:children]:這個群組會彙整主要節點和副本節點,讓 Ansible 能以單一指令鎖定整個資料庫叢集。[etcd_cluster]:定義將參與 etcd 共識叢集的節點。包括所有三個資料庫節點,確保高可用性。ansible_host:(適用於每個 VM) Ansible 用來連線至該 VM 的 VM 外部連入 IP。將XX.XX.XX.XX替換為實際的外部 IP。bind_address:(每個 VM) VM 的內部 IP 位址。將XX.XX.XX.XX替換為實際內部 IP。ansible_user:Ansible 用來透過 SSH 連線至目標 VM 的遠端使用者。將...替換為實際使用者名稱。ansible_ssh_private_key_file:用於驗證目標 VM 的私密 SSH 金鑰本機路徑。將~/.ssh/...替換為實際路徑。patroni_superuser_password:postgres使用者的密碼。 請務必使用高強度安全密碼。with_haproxy_load_balancing=false:停用本機 HAProxy,因為您使用的是平台原生 L4 負載平衡器。etcd_package_repo:指向 VM 啟動程序目錄內的 etcd 二進位檔本機路徑。installation_method="packages":指示自動化程序使用 OS 套件安裝元件,而非從來源編譯或使用 Python pip。install_..._repo=false和_repository=[]:這些覆寫會防止 Ansible 嘗試連上網際網路,新增外部存放區或更新套件清單。install_system_packages=false:防止自動化程序嘗試下載及安裝您在初始化或啟動階段已佈建的套件。patroni_installation_method=deb:明確告知角色使用您安裝的.deb套件。
初始化 VM
資料庫堆疊需要多個 OS 套件和程式庫,這些可能未包含在 Ubuntu 基本映像檔中。由於 VM 位於無法存取網際網路的實體隔離環境,因此無法自行下載這些依附元件。
如要解決這個問題,請按照下列步驟操作:
在本機工作站上使用 Docker 容器,下載所有必要檔案。下列指令會使用
apt-rdepends遞迴識別目標應用程式所需的每個共用程式庫和依附元件。這個指令會在容器中設定官方 PostgreSQL 存放區,以擷取 17 版構件,然後逐一檢查依附元件清單,下載個別.deb檔案,同時篩除核心系統程式庫 (例如libc6或hostname),避免目標 VM 發生版本衝突。最後,它會直接從 GitHub 擷取獨立的 etcd 二進位檔。首先,請建立目錄來存放套件:
mkdir -p ./packages接著執行 Docker 指令,下載所有必要套件和 etcd 二進位檔:
docker run --rm --platform linux/amd64 -v "$(pwd)/packages:/packages" \
  ubuntu:22.04 bash -c "
  set -e
  apt-get update
  apt-get install -y ca-certificates curl gnupg apt-rdepends

  # Add PostgreSQL Repository
  curl -fsSL https://www.postgresql.org/media/keys/ACCC4CF8.asc | \
    gpg --dearmor -o /etc/apt/trusted.gpg.d/postgresql.gpg
  echo 'deb http://apt.postgresql.org/pub/repos/apt jammy-pgdg main' > \
    /etc/apt/sources.list.d/pgdg.list
  apt-get update

  # Define Application Targets + Explicit dependencies needed for air-gap
  TARGETS='unzip tar pgbouncer patroni netdata postgresql-17 \
    postgresql-client-17 postgresql-contrib-17 \
    postgresql-server-dev-17 postgresql-17-dbgsym \
    python3-psycopg2 python3-click python3-yaml python3-prettytable \
    python3-urllib3 python3-tz python3-pip python3-setuptools \
    python3-cryptography moreutils vim jq acl zstd libjq1 \
    libpython3.10-stdlib libexpat1-dev zlib1g-dev libipc-run-perl \
    libtime-duration-perl libjson-perl libpython3-dev \
    libjs-sphinxdoc python3-wheel'

  # Resolve all recursive dependencies
  ALL_DEPS=\$(apt-cache depends --recurse --no-recommends --no-suggests \
    --no-conflicts --no-breaks --no-replaces --no-enhances \$TARGETS | \
    grep '^\w' | sort -u)

  cd /packages
  for pkg in \$ALL_DEPS; do
    if apt-cache show \"\$pkg\" > /dev/null 2>&1; then
      # Filter system core to avoid VM conflicts/breaks
      # We exclude core OS libraries (libc, systemd, etc.) because these
      # often cause version conflicts if the VM's patch level differs
      # from the online container.
      FILTER='base-files|debianutils|coreutils|findutils|diffutils|sed'
      FILTER+='|grep|gzip|hostname|ncurses|perl-base|libc6|binutils'
      FILTER+='|linux-libc|libc-bin|libc-dev-bin|systemd|dpkg|init'
      if [[ ! \"\$pkg\" =~ \$FILTER ]]; then
        apt-get download \"\$pkg\" || echo \"Failed \$pkg\"
      fi
    fi
  done

  # Download etcd binary
  if [ ! -f etcd-v3.5.25-linux-amd64.tar.gz ]; then
    curl -L https://github.com/etcd-io/etcd/releases/download/v3.5.25/\
etcd-v3.5.25-linux-amd64.tar.gz -o etcd-v3.5.25-linux-amd64.tar.gz
  fi
"
使用 Ansible 將封存檔同時上傳至所有三個目標 VM:
ansible all -i inventory.ini -m copy -a "src=packages.tar.gz dest=/tmp/" -b清除 VM 上所有現有的套件資料,然後解壓縮新的 tar 檔案:
ansible all -i inventory.ini -m shell -a "rm -rf /tmp/packages && \
  mkdir -p /tmp/packages && tar -xzf /tmp/packages.tar.gz -C /tmp/packages" -b
以非互動方式安裝所有下載的
.deb套件。 為避免在無網路連線環境中發生特定前置依附元件的問題,請使用--force-depends標記,然後使用apt-get install -fy在本機解決依附元件樹狀結構問題:ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a dpkg -i --force-depends /tmp/packages/*.deb" -b ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a apt-get install -fy" -b在自動化程序準備就緒前,請立即停止所有服務,避免服務以預設的未設定狀態啟動:
ansible all -i inventory.ini -m shell -a \
  "systemctl stop patroni etcd pgbouncer postgresql || true" -b
最後,移除預設的 PostgreSQL 叢集和所有現有的 etcd 資料,以便進行乾淨的初始化作業:
ansible all -i inventory.ini -m shell -a \
  "pg_dropcluster 17 main --stop || true" -b
ansible all -i inventory.ini -m shell -a \
  "rm -rf /var/lib/postgresql/17/main/* /var/lib/etcd/default.etcd/*" -b
佈建資料庫基礎架構
完成 VM 啟動程序並設定清單後,您現在可以使用 Ansible 搭配 Autobase 自動化劇本,部署高可用性的 PostgreSQL 堆疊。
首先,請執行預檢,確保環境已準備就緒:
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini \
  --tags pre_checks
如果檢查通過,請繼續進行完整部署:
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini
預期輸出內容:劇本應會完成,並顯示「PLAY RECAP」成功,且所有目標 VM 都已連線並更新:
PLAY RECAP ********************************************************************
localhost                  : ok=1    changed=0    unreachable=0    failed=0    skipped=254  rescued=0    ignored=0
postgres-vm-1              : ok=160  changed=53   unreachable=0    failed=0    skipped=514  rescued=0    ignored=2
postgres-vm-2              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
postgres-vm-3              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
驗證 Deployment
部署完成後,請執行幾項檢查,確保所有元件都能正常運作。
檢查 HA 狀態
檢查高可用性管理工具的狀態,查看指派給每個 VM 的角色:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
輸出內容範例:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
驗證健康狀態檢查端點
使用 Patroni 的 REST API,測試 Patroni 是否正確識別領導者和副本。領導者 VM 的健康狀態檢查應會傳回 200 OK,而副本 VM 的健康狀態檢查應會傳回 503 Service Unavailable:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM3_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
驗證個別 VM 的健康狀態
檢查所有 PostgreSQL 執行個體的就緒狀態:
ansible postgres_cluster -i inventory.ini -m shell -a "pg_isready -p 5432" -b
輸出內容範例:
postgres-vm-1 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-2 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-3 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections
驗證 etcd 健康狀態
使用 localhost 做為端點,確認所有 VM 的共識層健康狀態:
ansible all -i inventory.ini -m shell -a "ETCDCTL_API=3 etcdctl \
  --endpoints=https://localhost:2379 \
  --cacert=/etc/etcd/tls/ca.crt \
  --cert=/etc/etcd/tls/server.crt \
  --key=/etc/etcd/tls/server.key \
  endpoint health" -b
輸出內容範例:
postgres-vm-1 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 28.78311ms

postgres-vm-2 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 33.081265ms

postgres-vm-3 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 24.414291ms
設定全域負載平衡器
如要為資料庫堆疊提供穩定的虛擬 IP (VIP),請使用 gdcloud CLI 設定平台原生的全域 L4 負載平衡器。
需求條件:
- 確認您在專案中具備
load-balancer-admin角色。 將標籤套用至 VM,讓負載平衡器能正確指定要服務的執行個體 (請將
kubeconfig參數值替換為每個區域對應的管理 APIkubeconfig檔案):kubectl --kubeconfig=ZONE_A_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM1_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_B_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM2_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_C_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM3_NAME} \ ${VM_LABEL}
- 確認您在專案中具備
定義負載平衡存取層級。如需從專案網路外部連線,請設定
EXTERNAL;如僅需從虛擬私有雲內部存取,請設定INTERNAL。在本教學課程中,我們將使用外部設定:export LB_SCHEME=EXTERNAL建立健康狀態檢查。負載平衡器會使用 Patroni 的 REST API 識別領導者:
gdcloud compute health-checks create https ${CLUSTER_NAME}-hc \
  --project=${PROJECT_ID} \
  --port=8008 \
  --request-path="/primary" \
  --check-interval=10 \
  --timeout=5 \
  --healthy-threshold=2 \
  --unhealthy-threshold=3 \
  --global
為 VM 所在的每個可用區建立專屬的區域後端:
for zone in $(echo $ZONES); do
  gdcloud compute backends create ${CLUSTER_NAME}-backend-${zone} \
    --project=${PROJECT_ID} \
    --zone=${zone} \
    --labels="${VM_LABEL}"
done
建立全域後端服務:
gdcloud compute backend-services create ${CLUSTER_NAME}-bes \
  --project=${PROJECT_ID} \
  --health-check="${CLUSTER_NAME}-hc" \
  --global
將區域後端新增至全域服務:
for zone in $(echo $ZONES); do
  gdcloud compute backend-services add-backend ${CLUSTER_NAME}-bes \
    --project=${PROJECT_ID} \
    --backend=${CLUSTER_NAME}-backend-${zone} \
    --backend-zone=${zone} \
    --global
done
建立通用轉送規則 (VIP)。這項規則會公開 Port
6432上的資料庫:gdcloud compute forwarding-rules create ${CLUSTER_NAME}-fr \ --project=${PROJECT_ID} \ --load-balancing-scheme=${LB_SCHEME} \ --backend-service=${CLUSTER_NAME}-bes \ --ip-protocol-port="TCP:6432" \ --global擷取虛擬 IP 位址:
LB_IP=$(gdcloud compute forwarding-rules describe ${CLUSTER_NAME}-fr \
  --project=${PROJECT_ID} \
  --load-balancing-scheme=${LB_SCHEME} \
  --global \
  --format=json \
  | jq -r '.metadata.annotations["networking.gke.io/forwardingRuleCIDR"]'  \
  | cut -d '/' -f 1)

echo "The load balancer IP is: ${LB_IP}"
建立
ProjectNetworkPolicy(PNP),允許輸入流量傳入 PgBouncer 通訊埠 (將kubeconfig參數值替換為環境的對應全域 APIkubeconfig檔案)。kubectl --kubeconfig=GLOBAL_API_KUBECONFIG apply -f - <<EOF apiVersion: networking.global.gdc.goog/v1 kind: ProjectNetworkPolicy metadata: name: allow-pgbouncer namespace: ${PROJECT_ID} spec: ingress: - ports: - port: 6432 protocol: TCP policyType: Ingress subject: subjectType: UserWorkload EOF
驗證資料複製
如要確認高可用性堆疊是否正常運作,您可以在領導者上建立範例資料,並驗證副本上是否有該資料。
插入範例資料
如果未在 inventory.ini 中提供密碼,自動化程序會在首次部署時為 postgres 使用者產生隨機密碼。您可以從任何 VM 擷取:
export PG_PASSWORD=$(ansible master -i inventory.ini -m shell -a \
  "grep -A10 'authentication:' /etc/patroni/patroni.yml | \
  grep -A3 'superuser' | grep 'password:' | awk '{ print \$2 }'" -b | \
  tail -n 1)
echo $PG_PASSWORD
連線至 PgBouncer 連接埠 (6432) 的負載平衡器 VIP,然後建立範例資料表:
PGPASSWORD="${PG_PASSWORD}" psql -h ${LB_IP} -p 6432 -U postgres -c "
  CREATE TABLE employees (first_name TEXT, last_name TEXT);
  INSERT INTO employees (first_name, last_name) VALUES ('John', 'Doe');
"
預期輸出內容:
INSERT 0 1
驗證複製狀態
在所有 VM 上執行 SELECT 查詢,確保資料已從領導者複製到所有副本:
ansible postgres_cluster -i inventory.ini -m shell -a "psql -U postgres -c \
  'SELECT * FROM employees;'" -b
輸出內容範例:
postgres-vm-1 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-2 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-3 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)
測試手動切換
手動切換可讓您將領導者角色順利移至特定候選 VM。這通常是為了進行計畫性維護、軟體升級,或平衡各區域的資源使用率。
找出目前的領導者
確認 VM 的目前角色和狀態:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
輸出內容範例:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
執行切換
從目前領導者觸發切換至另一個 VM (在本例中,分別從 postgres-vm-1 切換至 postgres-vm-2)。這項指令會使用 --force 略過手動確認提示:
ansible master -i inventory.ini -m shell -a "patronictl switchover \
  --leader ${VM1_NAME} --candidate ${VM2_NAME} --force" -b
輸出內容範例:
Successfully switched over to "postgres-vm-2"
+ Cluster: postgres-cluster (7607933704953386478) -+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | stopped |    |     unknown |     |    unknown |     |
| postgres-vm-2 | 10.253.1.253 | Leader  | running |  1 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | running |  1 |   0/70000A0 |   0 |  0/70000A0 |   0 |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
確認健康檢查班表
切換後,請確認健康狀態檢查狀態已移至新的領導者:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
舊版領導者 (postgres-vm-1) 應傳回 503,而新版領導者 (postgres-vm-2) 應傳回 200。
測試自動容錯移轉
與手動切換不同,自動容錯移轉會在領導者 VM 無法使用時發生。這項測試會確認 Patroni 是否選出新的領導者,以及負載平衡器是否會在沒有人為介入的情況下重新導向流量。假設 postgres-vm-2 是先前手動切換後目前的領導者。
找出目前的領導者
確認 VM 的目前角色和狀態:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
輸出內容範例:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
| postgres-vm-2 | 10.253.1.253 | Leader  | running   |  2 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
模擬 VM 故障
在領導者 VM 上停止 patroni 服務,模擬當機或硬體故障:
ansible master -i inventory.ini -m shell -a "systemctl stop patroni" -b
觀察新選舉
等待 10 到 20 秒,然後從另一個 VM 查看狀態,確認新領導者是否已升級:
ansible replica -i inventory.ini -m shell -a "patronictl list" -b
輸出內容範例:
postgres-vm-3 | CHANGED | rc=0 >>
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  3 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | stopped   |    |     unknown |     |    unknown |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  3 |   0/90003F8 |   0 |  0/90003F8 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
您應該會看到其中一個 VM (postgres-vm-1 或 postgres-vm-3) 成為領導者,而舊領導者 (postgres-vm-2) 則標示為已停止。
確認健康狀態檢查轉移
確認負載平衡器健康狀態檢查現在會正確識別新選出的領導者:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
新領導者應會傳回 200 OK。
復原失敗的 VM
在原始 VM 上重新啟動 patroni 服務,讓該服務以副本形式重新加入堆疊,並補齊所有遺漏的資料:
ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "systemctl start patroni" -b