


이 가이드에서는 Google Distributed Cloud (GDC) 에어 갭 환경의 세 영역에 가용성이 높은 PostgreSQL 스택을 배포하는 포괄적인 안내를 제공합니다. 필요한 소프트웨어 아티팩트를 준비하고, 대상 VM을 부트스트랩하고, Autobase를 사용하여 전체 프로비저닝 프로세스를 자동화하는 방법을 알아봅니다. 이 가이드 전반에서, Patroni는 PostgreSQL 수명 주기를 오케스트레이션하고 자동 장애 조치를 처리하는 기본 관리 레이어로 사용됩니다.
아키텍처
아키텍처는 세 개의 가용성 영역에 분산된 3개의 VM 환경으로 구성됩니다.
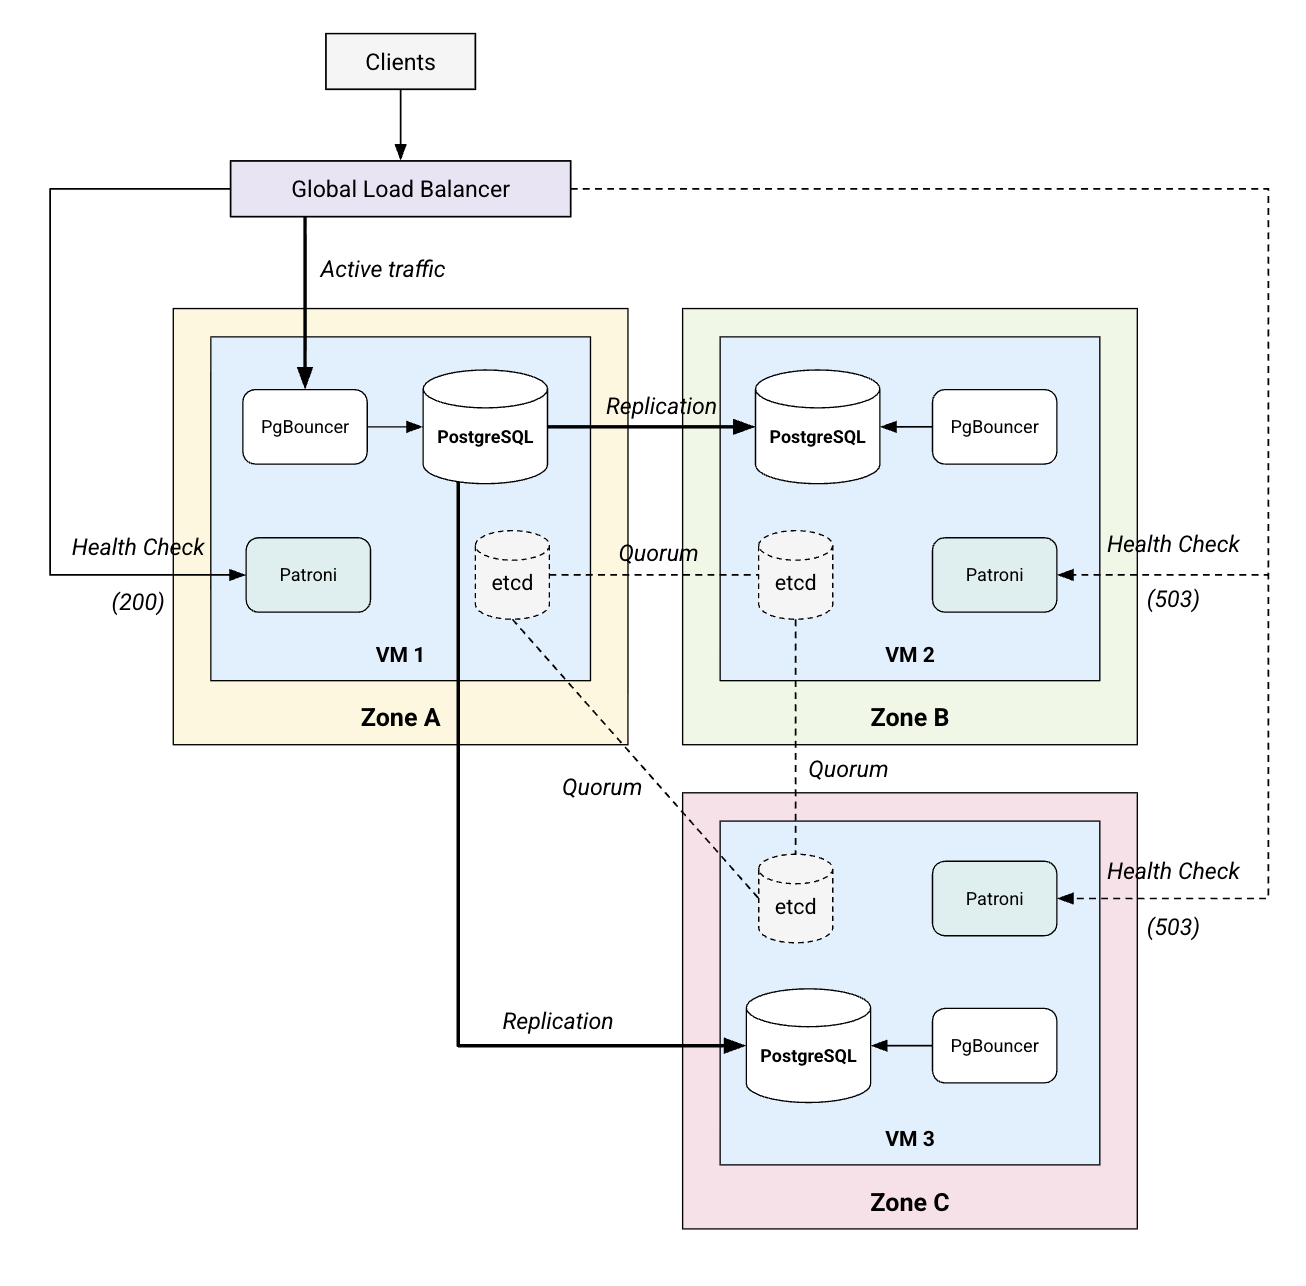
모든 VM은 동일하며 공동 배치된 서비스 스택을 실행합니다.
- PostgreSQL 17: 핵심 관계형 데이터베이스 엔진입니다.
- Patroni: 고가용성 관리자입니다. PostgreSQL 프로세스의 수명 주기를 처리하고 자동 장애 조치를 실행합니다. 부하 분산기에서 현재 리더를 식별하는 데 사용하는 포트
8008(엔드포인트/primary)에서 HTTPS REST API를 노출합니다. - etcd: 분산 구성 저장소 (DCS)입니다. 리더 선택을 위한 합의 레이어를 제공하고 Patroni의 구성을 저장합니다.
- PgBouncer: PostgreSQL 앞에 위치하여 연결 오버헤드를 안정화하는 연결 풀러입니다. 포트
6432에서 애플리케이션 트래픽에 권장되는 진입점을 제공합니다.
스택에는 안정적인 가상 IP(VIP)를 제공하는 플랫폼 관리 서비스인 GDC 에어 갭 전역 L4 부하 분산기도 포함되어 있습니다. 애플리케이션은 포트 6432의 안정적인 VIP에 연결되며, 부하 분산기는 이를 현재 리더 VM의 PgBouncer로 라우팅합니다. 그러면 PgBouncer가 요청을 로컬 PostgreSQL 인스턴스로 프록시합니다. 트래픽 흐름을 관리하기 위해 부하 분산기는 Patroni HTTPS 엔드포인트를 상태 확인으로 계속 폴링합니다.
리더 VM의 상태 확인은 VM이 트래픽을 처리할 준비가 되었음을 알리기 위해 HTTP 200 OK를 반환하는 반면, 복제본 VM의 상태 확인은 부하 분산기가 이를 우회하도록 알리기 위해 HTTP 503 Service Unavailable을 반환합니다. 리더에 장애가 발생하면 새 리더가 선택되고 Patroni 인스턴스가 HTTP 200 OK를 반환하기 시작하여 부하 분산기가 트래픽을 새 VM의 PgBouncer 포트로 자동 리디렉션합니다.
고가용성을 보장하고 데이터 손실을 방지하기 위해 스택은 정족수 개념에 의존합니다. VM이 3개인 경우 시스템은 리더를 선택하고 작동 상태를 유지하기 위해 최소 2명의 구성원이 정상 상태이고 통신 중이어야 합니다. etcd 및 Patroni에서 관리하는 이 다수 기반 합의를 통해 스택은 단일 VM 또는 영역의 전체 장애를 자동으로 허용할 수 있습니다.
성능에 대한 고려사항
배포를 계획할 때는 성능과 안정성을 최적화하기 위해 다음과 같은 구체적인 요소를 고려하세요.
- 하드웨어 크기 조정: 요구사항은 워크로드에 따라 다르지만 이러한 표준 프로필을 각 VM의 시작점으로 사용하세요.
- 개발/개념 증명: vCPU 2개, RAM 8GB (안정적인 작동을 위한 최소값)
- 소규모 프로덕션: vCPU 4개, RAM 16GB. 동시 실행이 적당한 내부 도구에 적합합니다.
- 표준 프로덕션: vCPU 8개, RAM 32GB. 미션 크리티컬 애플리케이션에 권장되는 기준입니다.
- 고처리량: vCPU 16개 이상, RAM 64GB 이상. 메모리에서 광범위한 데이터 캐싱 (PostgreSQL 공유 버퍼)이 필요한 워크로드에 적합합니다.
- 스토리지 성능: 고성능 스토리지는 매우 중요합니다. SSD 디스크는 etcd 안정성에 매우 권장됩니다. etcd는 디스크 쓰기 지연 시간에 매우 민감합니다. 공식 etcd 하드웨어 가이드라인 에서는 p99 디스크 WAL fdatasync 지연 시간이 10ms 미만일 것을 권장합니다.
- 네트워크 지연 시간: VM 간의 지연 시간은 복제 성능에 직접적인 영향을 미칩니다.
- etcd 정족수: 선택 제한 시간 및 클러스터 불안정을 방지하려면 평균 왕복 시간 (RTT)이 50ms 미만 (이상적으로는 10ms 미만)이어야 합니다.
- 동기식 복제: 구성된 경우 모든 쓰기 트랜잭션은 복제본의 승인을 기다려야 합니다. GDC 에어 갭의 영역 간 지연 시간은 일반적으로 1ms 미만으로, 쓰기 오버헤드를 최소화 (일반적으로 10~30%)하는 데 적합합니다.
- PgBouncer의 역할: PostgreSQL은 모든 연결에 대해 새 OS 프로세스를 생성하며, 이는 약 10MB의 RAM을 사용하고 CPU 컨텍스트 전환 비용을 발생시킵니다. PgBouncer는 영구 연결 풀을 유지하여 이 오버헤드를 줄이므로 데이터베이스는 훨씬 적은 백엔드 프로세스로 수천 개의 애플리케이션 연결을 처리할 수 있습니다.
- 사이드카 구성요소: Patroni 및 etcd는 가볍지만 일관된 CPU 가용성이 필요합니다. 부하가 높은 시나리오에서는 하이퍼바이저 수준에서 VM이 과도하게 프로비저닝되지 않도록 하여 하트비트 및 리더 유지보수에 필요한 CPU 주기를 '도용'하지 않도록 하세요.
- 커널 조정: Autobase 자동화는 PostgreSQL에 유용한 최적화
를 자동으로 적용합니다. 예를 들어
sysctl
매개변수 (예:
vm.swappiness,net.core.somaxconn) 구성 및 투명한 대용량 페이지 (THP) 사용 중지 등이 있습니다. 이러한 변경사항은 메모리 관리 오버헤드를 줄이고 트래픽이 많은 데이터베이스 인스턴스의 네트워크 처리량을 개선합니다.
시작하기 전에
배포를 시작하기 전에 환경이 다음 요구사항을 충족하는지 확인해야 합니다.
VM 요구사항 검토
이 가이드에서는 GDC 에어 갭 프로젝트에서 3개의 VM을 만들어야 합니다. VM에 대해 다음 사항과 요구사항을 고려해야 합니다.
- 영역 배포: 이 배포가 영역 장애에 진정으로 복원력을 갖도록 하려면 VM을 세 개의 서로 다른 가용성 영역에 배포해야 합니다. 하지만 VM이 두 영역 또는 단일 영역에 있는 경우에도 배포는 동일하게 유지됩니다. 가장 중요한 것은 모든 VM이 내부 IP 주소를 사용하여 네트워크를 통해 서로 통신할 수 있다는 것입니다.
- 운영체제: 이 가이드에서는 Ubuntu 22.04 이미지를 사용한다고 가정합니다. 다른 배포를 사용하는 경우 이 가이드의 추가 단계가 다를 수 있습니다.
- 리소스: 이 가이드에서는 VM당 CPU 2개와 메모리 8GB 이상을 프로비저닝해야 합니다. 프로덕션에서는 특정 워크로드에 적합한 리소스를 프로비저닝해야 합니다 (성능에 대한 고려사항 참고 ).
- 네트워크 IP: 각 VM의 내부 및 외부 IP 주소를 모두 기록해야 합니다. 이 가이드에서는 외부 워크스테이션에서 명령어를 실행하므로 Ansible 제어에 외부 IP를 사용합니다. 내부 IP는 서비스 간 통신 및 바인딩에 사용됩니다. 네트워크 내부에 부트스트래퍼 VM을 프로비저닝한 경우 내부 IP만 필요합니다.
- 액세스: Ansible 자동화는 비밀번호 프롬프트에 의해 차단되지 않고 관리 작업(패키지 설치, 시스템 구성 수정)을 실행해야 하므로 배포 사용자의 비밀번호 없는 sudo 액세스가 필요합니다.
- SSH: Ansible이 대상 VM에 안전하고 비대화형으로 연결할 수 있도록 키 기반 인증을 사용 설정해야 합니다.
로컬 워크스테이션 소프트웨어 준비
배포를 관리하고 에어 갭 아티팩트를 준비하려면 로컬 워크스테이션에 설치된 자동화 및 컨테이너화 도구 집합이 필요합니다.
- Ansible 2.17.0 이상: 배포 플레이북 및 역할을 실행하는 자동화 엔진입니다.
- Docker: 대상 VM (Ubuntu 22.04)과 동일한 환경 내에서 OS 종속 항목을 가져오고 패키징하는 데 사용됩니다.
- PostgreSQL 클라이언트 (
psql): 로컬 워크스테이션에서 테스트 쿼리를 실행하고 데이터 복제를 확인하는 데 필요합니다. Autobase 저장소:
- 저장소를 클론하여 자동화 플레이북 및 역할에 액세스합니다. https://github.com/vitabaks/autobase
특정 출시 버전을 체크아웃합니다 (이 가이드에서는 버전 2.5.2를 사용합니다).
git checkout 2.5.2다른 배포를 사용하는 경우 이 가이드의 추가 단계가 다를 수 있습니다.
이 가이드의 플레이북을 실행하려면 역할 프리픽스를 확인할 수 있도록 로컬
autobase소스 코드를 Ansible 컬렉션으로 설치해야 합니다.cd autobase/automation ansible-galaxy collection install . --force
몇 가지 환경 변수를 만듭니다.
이 가이드 전반에서 다음 환경 변수를 사용하여 명령어를 간소화합니다. 이러한 변수는 프로젝트 ID, VM의 가용성 영역, 호스트 이름, 부하 분산기에서 클러스터를 식별하는 데 사용하는 라벨과 같은 중요한 매개변수를 저장합니다. 환경의 실제 값으로 현재 셸 세션에서 설정합니다 (영역이 공백으로 구분되어 있는지 확인).
VM에 원하는 이름을 설정할 수 있지만 이 가이드에서는 클러스터 노드의 임의 예시 이름으로 postgres-vm-1, postgres-vm-2, postgres-vm-3을 사용합니다.
export PROJECT_ID="your-project-id"
export ZONES="zone1 zone2 zone3"
export VM1_NAME="postgres-vm-1"
export VM2_NAME="postgres-vm-2"
export VM3_NAME="postgres-vm-3"
export VM_LABEL="app=my-postgres-cluster"
export CLUSTER_NAME="my-postgres-cluster"
Ansible 구성
다음 템플릿을 사용하여 inventory.ini 파일에서 VM 환경을 정의합니다.
[master]
postgres-vm-1 ansible_host=XX.XX.XX.XX hostname=postgres-vm-1 bind_address=XX.XX.XX.XX

[replica]
postgres-vm-2 ansible_host=XX.XX.XX.XX hostname=postgres-vm-2 bind_address=XX.XX.XX.XX
postgres-vm-3 ansible_host=XX.XX.XX.XX hostname=postgres-vm-3 bind_address=XX.XX.XX.XX

[postgres_cluster:children]
master
replica

[etcd_cluster]
postgres-vm-1
postgres-vm-2
postgres-vm-3

[all:vars]
ansible_user=...
ansible_ssh_private_key_file=~/.ssh/...
postgresql_version=17
with_haproxy_load_balancing=false
patroni_superuser_password=...
etcd_package_repo="file:///tmp/packages/etcd-v3.5.25-linux-amd64.tar.gz"
installation_method="packages"
install_postgresql_repo=false
install_timescale_repo=false
install_citus_repo=false
apt_repository=[]
yum_repository=[]
install_system_packages=false
patroni_installation_method=deb
구성 이해:
[master]및[replica]: 기본 및 보조 데이터베이스 VM을 정의합니다.VM1_NAME,VM2_NAME,VM3_NAME환경 변수에 설정된 실제 VM 이름을 사용해야 합니다.[postgres_cluster:children]: 기본 노드와 복제본 노드를 모두 집계하는 그룹으로, Ansible이 단일 명령어로 전체 데이터베이스 클러스터를 타겟팅할 수 있도록 합니다.[etcd_cluster]: etcd 합의 클러스터에 참여할 노드를 정의합니다. 여기에는 고가용성을 보장하기 위해 세 개의 데이터베이스 노드가 모두 포함됩니다.ansible_host: (각 VM의 경우) Ansible이 해당 VM에 연결하는 데 사용하는 VM의 외부 인그레스 IP입니다.XX.XX.XX.XX를 실제 외부 IP로 바꿉니다.bind_address: (각 VM의 경우) VM의 내부 IP 주소입니다.XX.XX.XX.XX를 실제 내부 IP로 바꿉니다.ansible_user: Ansible이 SSH를 사용하여 대상 VM에 연결하는 데 사용하는 원격 사용자입니다....을 실제 사용자 이름으로 바꿉니다.ansible_ssh_private_key_file: 대상 VM에 대한 인증에 사용되는 비공개 SSH 키의 로컬 경로입니다.~/.ssh/...을 실제 경로로 바꿉니다.patroni_superuser_password:postgres사용자의 비밀번호입니다. 여기서는 안전한 비밀번호를 사용해야 합니다.with_haproxy_load_balancing=false: 플랫폼 기본 L4 부하 분산기를 사용하므로 로컬 HAProxy를 사용 중지합니다.etcd_package_repo: VM의 부트스트랩 디렉터리 내에 있는 etcd 바이너리의 로컬 경로를 가리킵니다.installation_method="packages": 소스에서 컴파일하거나 사용하는 대신 OS 패키지로 구성요소를 설치하도록 자동화에 지시합니다. Python pip.install_..._repo=false및_repository=[]: 이러한 재정의는 Ansible이 인터넷에 연결하여 외부 저장소를 추가하거나 패키지 목록을 업데이트하지 못하도록 합니다.install_system_packages=false: 초기화 또는 부트스트랩 단계에서 이미 프로비저닝한 패키지를 자동화가 다운로드하고 설치하지 못하도록 합니다.patroni_installation_method=deb: 설치한.deb패키지를 사용하도록 역할에 구체적으로 지시합니다.
VM 초기화
데이터베이스 스택에는 기본 Ubuntu 이미지에 포함되지 않을 수 있는 여러 OS 패키지 및 라이브러리가 필요합니다. VM은 인터넷 액세스 권한이 없는 에어 갭 환경에 있으므로 이러한 종속 항목을 직접 다운로드할 수 없습니다.
이 문제를 해결하려면 다음 단계를 따르세요.
로컬 워크스테이션에서 Docker 컨테이너를 사용하여 필요한 모든 파일을 다운로드합니다. 다음 명령어는
apt-rdepends를 사용하여 대상 애플리케이션에 필요한 모든 공유 라이브러리 및 종속 항목을 재귀적으로 식별합니다. 컨테이너 내에서 공식 PostgreSQL 저장소를 구성하여 버전 17 아티팩트를 가져온 다음 종속 항목 목록을 반복하여 개별.deb파일을 다운로드하는 동시에 대상 VM의 버전 충돌을 방지하기 위해 핵심 시스템 라이브러리(libc6또는hostname과 같은)를 필터링합니다. 마지막으로 GitHub에서 독립형 etcd 바이너리를 직접 가져옵니다.먼저 패키지를 저장할 디렉터리를 만듭니다.
mkdir -p ./packages그런 다음 Docker 명령어를 실행하여 필요한 모든 패키지와 etcd 바이너리를 다운로드합니다.
docker run --rm --platform linux/amd64 -v "$(pwd)/packages:/packages" \
  ubuntu:22.04 bash -c "
  set -e
  apt-get update
  apt-get install -y ca-certificates curl gnupg apt-rdepends

  # Add PostgreSQL Repository
  curl -fsSL https://www.postgresql.org/media/keys/ACCC4CF8.asc | \
    gpg --dearmor -o /etc/apt/trusted.gpg.d/postgresql.gpg
  echo 'deb http://apt.postgresql.org/pub/repos/apt jammy-pgdg main' > \
    /etc/apt/sources.list.d/pgdg.list
  apt-get update

  # Define Application Targets + Explicit dependencies needed for air-gap
  TARGETS='unzip tar pgbouncer patroni netdata postgresql-17 \
    postgresql-client-17 postgresql-contrib-17 \
    postgresql-server-dev-17 postgresql-17-dbgsym \
    python3-psycopg2 python3-click python3-yaml python3-prettytable \
    python3-urllib3 python3-tz python3-pip python3-setuptools \
    python3-cryptography moreutils vim jq acl zstd libjq1 \
    libpython3.10-stdlib libexpat1-dev zlib1g-dev libipc-run-perl \
    libtime-duration-perl libjson-perl libpython3-dev \
    libjs-sphinxdoc python3-wheel'

  # Resolve all recursive dependencies
  ALL_DEPS=\$(apt-cache depends --recurse --no-recommends --no-suggests \
    --no-conflicts --no-breaks --no-replaces --no-enhances \$TARGETS | \
    grep '^\w' | sort -u)

  cd /packages
  for pkg in \$ALL_DEPS; do
    if apt-cache show \"\$pkg\" > /dev/null 2>&1; then
      # Filter system core to avoid VM conflicts/breaks
      # We exclude core OS libraries (libc, systemd, etc.) because these
      # often cause version conflicts if the VM's patch level differs
      # from the online container.
      FILTER='base-files|debianutils|coreutils|findutils|diffutils|sed'
      FILTER+='|grep|gzip|hostname|ncurses|perl-base|libc6|binutils'
      FILTER+='|linux-libc|libc-bin|libc-dev-bin|systemd|dpkg|init'
      if [[ ! \"\$pkg\" =~ \$FILTER ]]; then
        apt-get download \"\$pkg\" || echo \"Failed \$pkg\"
      fi
    fi
  done

  # Download etcd binary
  if [ ! -f etcd-v3.5.25-linux-amd64.tar.gz ]; then
    curl -L https://github.com/etcd-io/etcd/releases/download/v3.5.25/\
etcd-v3.5.25-linux-amd64.tar.gz -o etcd-v3.5.25-linux-amd64.tar.gz
  fi
"
Ansible을 사용하여 아카이브를 세 개의 대상 VM에 동시에 업로드합니다.
ansible all -i inventory.ini -m copy -a "src=packages.tar.gz dest=/tmp/" -bVM에서 기존 패키지 데이터를 지우고 새 tar 파일을 추출합니다.
ansible all -i inventory.ini -m shell -a "rm -rf /tmp/packages && \
  mkdir -p /tmp/packages && tar -xzf /tmp/packages.tar.gz -C /tmp/packages" -b
다운로드한 모든
.deb패키지를 비대화형으로 설치합니다. 에어 갭 환경에서 특정 사전 종속 항목과 관련된 문제를 방지하려면--force-depends플래그 뒤에apt-get install -fy를 사용하여 종속 항목 트리를 로컬로 해결합니다.ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a dpkg -i --force-depends /tmp/packages/*.deb" -b ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a apt-get install -fy" -b자동화가 준비되기 전에 기본 구성되지 않은 상태로 시작되지 않도록 모든 서비스를 즉시 중지합니다.
ansible all -i inventory.ini -m shell -a \
  "systemctl stop patroni etcd pgbouncer postgresql || true" -b
마지막으로 기본 PostgreSQL 클러스터와 기존 etcd 데이터를 삭제하여 초기화를 깔끔하게 수행할 수 있도록 합니다.
ansible all -i inventory.ini -m shell -a \
  "pg_dropcluster 17 main --stop || true" -b
ansible all -i inventory.ini -m shell -a \
  "rm -rf /var/lib/postgresql/17/main/* /var/lib/etcd/default.etcd/*" -b
데이터베이스 인프라 프로비저닝
VM이 부트스트랩되고 인벤토리가 구성되면 이제 Ansible과 함께 Autobase 자동화 플레이북을 사용하여 가용성이 높은 PostgreSQL 스택을 배포할 수 있습니다.
먼저 사전 검사를 실행하여 환경이 준비되었는지 확인합니다.
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini \
  --tags pre_checks
검사를 통과하면 전체 배포를 진행합니다.
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini
예상 출력: 플레이북은 모든 대상 VM이 도달하고 업데이트되었음을 보여주는 성공적인 'PLAY RECAP'으로 완료되어야 합니다.
PLAY RECAP ********************************************************************
localhost                  : ok=1    changed=0    unreachable=0    failed=0    skipped=254  rescued=0    ignored=0
postgres-vm-1              : ok=160  changed=53   unreachable=0    failed=0    skipped=514  rescued=0    ignored=2
postgres-vm-2              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
postgres-vm-3              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
배포 확인
배포가 완료되면 모든 구성요소가 올바르게 작동하는지 확인하기 위해 여러 검사를 실행해야 합니다.
HA 상태 확인
고가용성 관리자의 상태를 확인하여 각 VM에 할당된 역할을 확인합니다.
ansible master -i inventory.ini -m shell -a "patronictl list" -b
출력 예시:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
상태 확인 엔드포인트 확인
Patroni가 REST API를 사용하여 리더와 복제본을 올바르게 식별하는지 테스트합니다.
리더 VM의 상태 확인은 200 OK를 반환해야 하는 반면, 복제본 VM의 상태 확인은 503 Service Unavailable을 반환해야 합니다.
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM3_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
개별 VM 상태 확인
모든 PostgreSQL 인스턴스의 준비 상태를 확인합니다.
ansible postgres_cluster -i inventory.ini -m shell -a "pg_isready -p 5432" -b
출력 예시:
postgres-vm-1 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-2 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-3 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections
etcd 상태 확인
localhost를 엔드포인트로 사용하여 모든 VM에서 합의 레이어의 상태를 확인합니다.
ansible all -i inventory.ini -m shell -a "ETCDCTL_API=3 etcdctl \
  --endpoints=https://localhost:2379 \
  --cacert=/etc/etcd/tls/ca.crt \
  --cert=/etc/etcd/tls/server.crt \
  --key=/etc/etcd/tls/server.key \
  endpoint health" -b
출력 예시:
postgres-vm-1 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 28.78311ms

postgres-vm-2 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 33.081265ms

postgres-vm-3 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 24.414291ms
전역 부하 분산기 구성
데이터베이스 스택에 안정적인 가상 IP (VIP)를 제공하려면 gdcloud CLI를 사용하여 플랫폼 기본 전역 L4 부하 분산기를 구성합니다.
기본 요건:
- 프로젝트에
load-balancer-admin역할이 있는지 확인합니다. 부하 분산기가 제공해야 하는 인스턴스를 올바르게 타겟팅할 수 있도록 VM에 라벨을 적용합니다 (
kubeconfig매개변수 값을 각 영역의 해당 관리 APIkubeconfig파일로 바꿉니다).kubectl --kubeconfig=ZONE_A_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM1_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_B_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM2_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_C_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM3_NAME} \ ${VM_LABEL}
- 프로젝트에
부하 분산 액세스 수준을 정의합니다. 프로젝트의 네트워크 외부에서 연결해야 하는 경우
EXTERNAL을 설정하고 VPC 내에서만 액세스가 필요한 경우INTERNAL을 설정합니다. 이 가이드에서는 외부 설정을 사용합니다.export LB_SCHEME=EXTERNAL상태 점검을 만듭니다. 부하 분산기는 Patroni의 REST API를 사용하여 리더를 식별합니다.
gdcloud compute health-checks create https ${CLUSTER_NAME}-hc \
  --project=${PROJECT_ID} \
  --port=8008 \
  --request-path="/primary" \
  --check-interval=10 \
  --timeout=5 \
  --healthy-threshold=2 \
  --unhealthy-threshold=3 \
  --global
VM이 있는 각 영역에 별도의 영역별 백엔드를 만듭니다.
for zone in $(echo $ZONES); do
  gdcloud compute backends create ${CLUSTER_NAME}-backend-${zone} \
    --project=${PROJECT_ID} \
    --zone=${zone} \
    --labels="${VM_LABEL}"
done
전역 백엔드 서비스를 만듭니다.
gdcloud compute backend-services create ${CLUSTER_NAME}-bes \
  --project=${PROJECT_ID} \
  --health-check="${CLUSTER_NAME}-hc" \
  --global
영역별 백엔드를 전역 서비스에 추가합니다.
for zone in $(echo $ZONES); do
  gdcloud compute backend-services add-backend ${CLUSTER_NAME}-bes \
    --project=${PROJECT_ID} \
    --backend=${CLUSTER_NAME}-backend-${zone} \
    --backend-zone=${zone} \
    --global
done
전역 전달 규칙 (VIP)을 만듭니다. 이 규칙은 포트
6432에서 데이터베이스를 노출합니다.gdcloud compute forwarding-rules create ${CLUSTER_NAME}-fr \ --project=${PROJECT_ID} \ --load-balancing-scheme=${LB_SCHEME} \ --backend-service=${CLUSTER_NAME}-bes \ --ip-protocol-port="TCP:6432" \ --globalVIP 주소를 검색합니다.
LB_IP=$(gdcloud compute forwarding-rules describe ${CLUSTER_NAME}-fr \ --project=${PROJECT_ID} \ --load-balancing-scheme=${LB_SCHEME} \ --global \ --format=json \ | jq -r '.metadata.annotations["networking.gke.io/forwardingRuleCIDR"]' \ | cut -d '/' -f 1) echo "The load balancer IP is: ${LB_IP}"ProjectNetworkPolicy(PNP)를 만들어 PgBouncer 포트로의 인그레스 트래픽을 허용합니다 (kubeconfig매개변수 값을 해당 환경의 전역 APIkubeconfig파일로 바꿉니다).kubectl --kubeconfig=GLOBAL_API_KUBECONFIG apply -f - <<EOF apiVersion: networking.global.gdc.goog/v1 kind: ProjectNetworkPolicy metadata: name: allow-pgbouncer namespace: ${PROJECT_ID} spec: ingress: - ports: - port: 6432 protocol: TCP policyType: Ingress subject: subjectType: UserWorkload EOF
데이터 복제 확인
고가용성 스택이 예상대로 작동하는지 확인하려면 리더에서 샘플 데이터를 만들고 복제본에 있는지 확인할 수 있습니다.
샘플 데이터 삽입
inventory.ini에 제공되지 않은 경우 자동화는 첫 번째 배포 중에 postgres 사용자의 임의 비밀번호를 생성합니다. 모든 VM에서 검색할 수 있습니다.
export PG_PASSWORD=$(ansible master -i inventory.ini -m shell -a \
  "grep -A10 'authentication:' /etc/patroni/patroni.yml | \
  grep -A3 'superuser' | grep 'password:' | awk '{ print \$2 }'" -b | \
  tail -n 1)
echo $PG_PASSWORD
PgBouncer 포트 (6432)에서 부하 분산기 VIP에 연결하고 샘플 테이블을 만듭니다.
PGPASSWORD="${PG_PASSWORD}" psql -h ${LB_IP} -p 6432 -U postgres -c "
  CREATE TABLE employees (first_name TEXT, last_name TEXT);
  INSERT INTO employees (first_name, last_name) VALUES ('John', 'Doe');
"
예상 출력:
INSERT 0 1
복제 상태 확인
모든 VM에서 SELECT 쿼리를 실행하여 데이터가 리더에서 모든 복제본으로 복제되었는지 확인합니다.
ansible postgres_cluster -i inventory.ini -m shell -a "psql -U postgres -c \
  'SELECT * FROM employees;'" -b
출력 예시:
postgres-vm-1 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-2 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-3 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)
수동 전환 테스트
수동 전환을 사용하면 리더 역할을 특정 후보 VM으로 정상적으로 이동할 수 있습니다. 일반적으로 계획된 유지보수, 소프트웨어 업그레이드 또는 영역 간 리소스 사용률을 균형 있게 조정하기 위해 수행됩니다.
현재 리더 식별
VM의 현재 역할과 상태를 확인합니다.
ansible master -i inventory.ini -m shell -a "patronictl list" -b
출력 예시:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
전환 수행
현재 리더에서 다른 VM으로 전환을 트리거합니다 (이 경우 각각 postgres-vm-1에서 postgres-vm-2로). 이 명령어는 --force를 사용하여 수동 확인 프롬프트를 건너뜁니다.
ansible master -i inventory.ini -m shell -a "patronictl switchover \
  --leader ${VM1_NAME} --candidate ${VM2_NAME} --force" -b
출력 예시:
Successfully switched over to "postgres-vm-2"
+ Cluster: postgres-cluster (7607933704953386478) -+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | stopped |    |     unknown |     |    unknown |     |
| postgres-vm-2 | 10.253.1.253 | Leader  | running |  1 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | running |  1 |   0/70000A0 |   0 |  0/70000A0 |   0 |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
상태 확인 전환 확인
전환 후 상태 확인 상태가 새 리더로 전환되었는지 확인합니다.
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
이전 리더 (postgres-vm-1)는 503을 반환해야 하는 반면, 새 리더(postgres-vm-2)는 200을 반환해야 합니다.
자동 장애 조치 테스트
수동 전환과 달리 자동 장애 조치는 리더 VM을 사용할 수 없게 될 때 발생합니다. 이 테스트는 Patroni가 새 리더를 선택하고 부하 분산기가 수동 개입 없이 트래픽을 리디렉션하는지 확인합니다. 이전에 수행된 수동 전환 후 postgres-vm-2가 현재 리더라고 가정합니다.
현재 리더 식별
VM의 현재 역할과 상태를 확인합니다.
ansible master -i inventory.ini -m shell -a "patronictl list" -b
출력 예시:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
| postgres-vm-2 | 10.253.1.253 | Leader  | running   |  2 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
VM 장애 시뮬레이션
리더 VM에서 patroni 서비스를 중지하여 비정상 종료 또는 하드 장애를 시뮬레이션합니다.
ansible master -i inventory.ini -m shell -a "systemctl stop patroni" -b
새 선택 관찰
10~20초 정도 기다린 후 다른 VM에서 상태를 확인하여 새 리더의 승격을 확인합니다.
ansible replica -i inventory.ini -m shell -a "patronictl list" -b
출력 예시:
postgres-vm-3 | CHANGED | rc=0 >>
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  3 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | stopped   |    |     unknown |     |    unknown |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  3 |   0/90003F8 |   0 |  0/90003F8 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
다른 VM 중 하나 (postgres-vm-1 또는 postgres-vm-3)가 리더가 되고 이전 리더 (postgres-vm-2)가 중지됨으로 표시되는 것을 확인할 수 있습니다.
상태 확인 전환 확인
이제 부하 분산기 상태 확인이 새로 선택된 리더를 올바르게 식별하는지 확인합니다.
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
새 리더는 200 OK를 반환해야 합니다.
실패한 VM 복구
원래 VM에서 patroni 서비스를 다시 시작하여 복제본으로 스택에 다시 참여하고 누락된 데이터를 따라잡도록 합니다.
ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "systemctl start patroni" -b