


Essa arquitetura de referência fornece uma estrutura conceitual para implantar e operar bancos de dados PostgreSQL gerenciados pelo cliente no Google Distributed Cloud (GDC) isolado. Essa solução permite que as organizações mantenham cargas de trabalho de banco de dados críticas aproveitando um cluster de alta disponibilidade (HA) multizonal implantado em máquinas virtuais.
A arquitetura se concentra em uma configuração resiliente de três nós que garante a disponibilidade do banco de dados mesmo em caso de falha de uma única zona ou infraestrutura. Ela abrange todo o ciclo de vida, desde o provisionamento e a rede automatizados até operações de nível de produção, como alta disponibilidade, backup, restauração e observabilidade.
Recursos e funcionalidades
A solução oferece vários componentes funcionais principais para gerenciamento de banco de dados:
- Alta disponibilidade automatizada: use o Patroni e o etcd para fornecer eleição e failover automáticos do líder, garantindo que o banco de dados permaneça operacional sem intervenção manual.
- Resiliência multizonal: distribua nós de banco de dados em três zonas de disponibilidade distintas para proteger contra interrupções localizadas de hardware ou infraestrutura.
- Automação padronizada: provisione toda a pilha usando playbooks baseados em Ansible com o Autobase para garantir implantações repetíveis e consistentes.
- Pool de conexões: serviço PgBouncer integrado para gerenciar contagens de conexões altas e estabilizar o consumo de recursos nos nós do banco de dados.
- Balanceamento de carga global: use o balanceador de carga global L4 gerenciado pela plataforma para fornecer um único IP virtual (VIP) estável que possa ser acessado em todas as zonas.
- Preparação isolada: fluxos de trabalho especializados para empacotar todas as dependências e binários necessários do sistema operacional para implantação em ambientes desconectados.
- Proteção de dados: aproveite ferramentas padrão, como
pg_dumpepg_basebackup, além de snapshots de armazenamento do GDC, para manter uma estratégia robusta de backup e recuperação.
Arquitetura
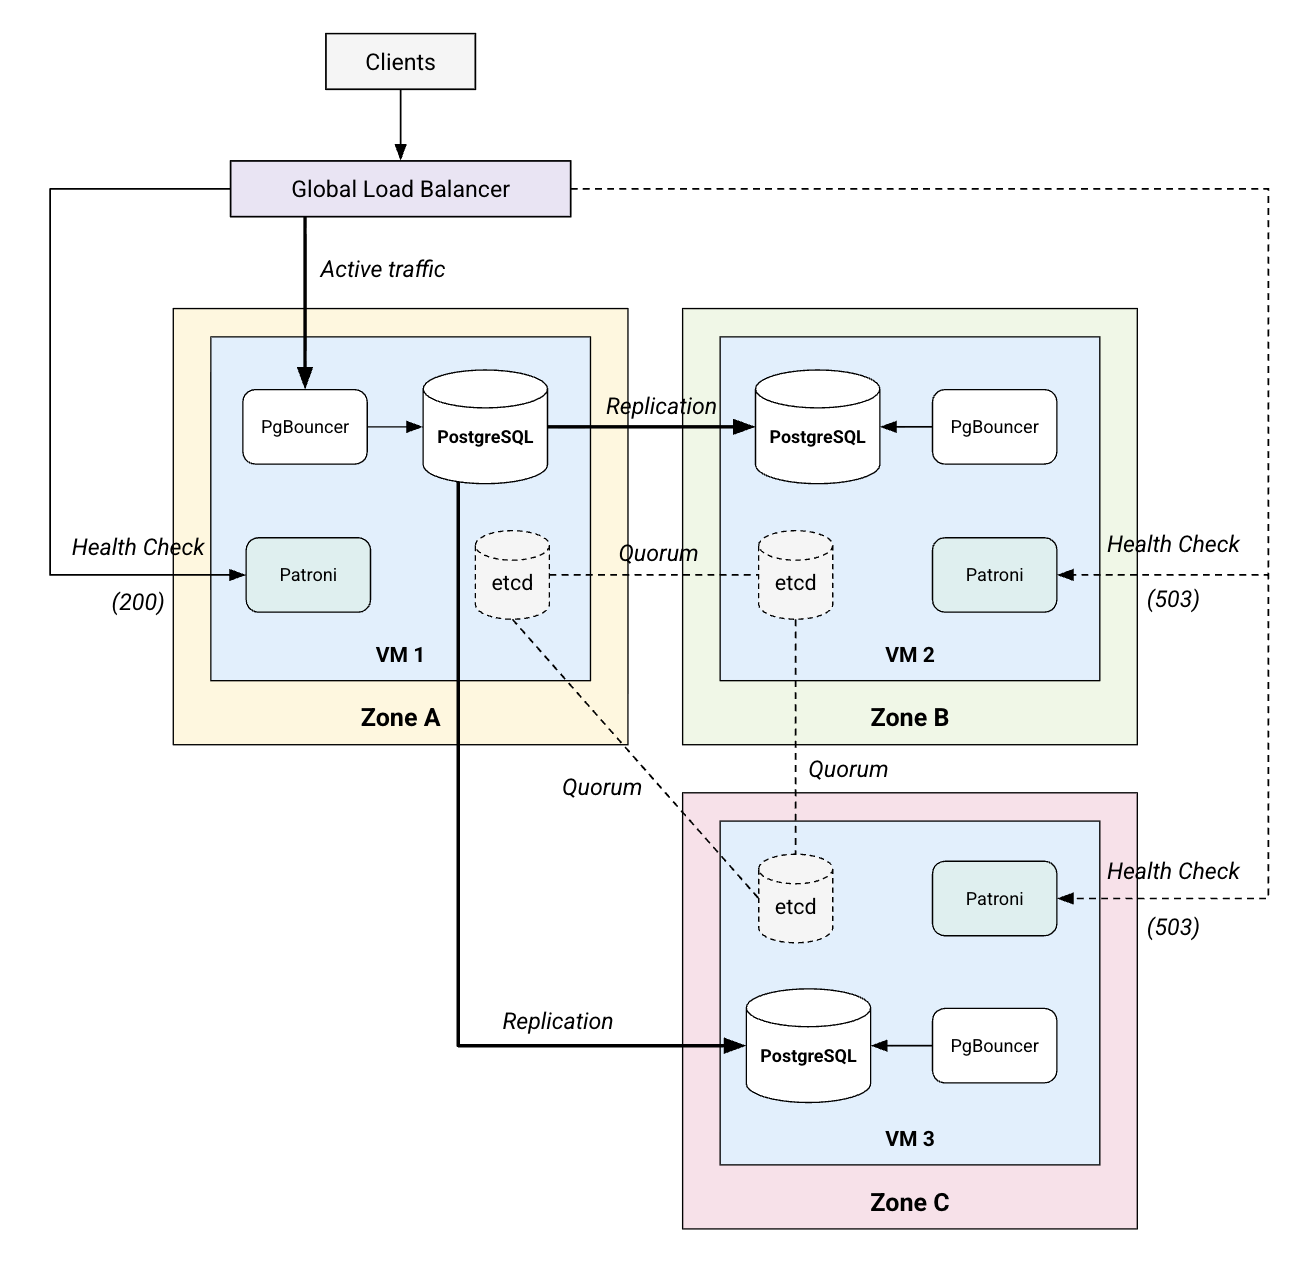
A arquitetura consiste em um ambiente de três VMs distribuídas em três zonas de disponibilidade que executam uma pilha de serviços colocalizados.
Princípios arquitetônicos
- Consenso baseado na maioria: usa um modelo baseado em quórum em que a maioria dos nós (2 de 3) precisa concordar com o estado do cluster, evitando cenários de "cérebro dividido" e garantindo a integridade de dados.
- Separação de interesses: cada VM executa uma pilha de serviços colocalizados, mas distintos (banco de dados, gerenciador de HA, consenso e pooler) para fornecer um nó independente e resiliente.
- Failover com reconhecimento de banco de dados: prioriza as métricas de integridade do banco de dados com a API REST do Patroni para coordenar o redirecionamento de tráfego pelo balanceador de carga da plataforma.
- Infraestrutura como código: depende de playbooks automatizados para todas as tarefas de configuração, reduzindo o risco de erro humano durante a implantação e o escalonamento.
Conceitos e tecnologias
Esta seção detalha os componentes funcionais, as responsabilidades deles e como eles se comunicam no sistema.
Infraestrutura e plataforma
- Máquinas virtuais (VMs): instâncias de computação dedicadas distribuídas em zonas para hospedar a pilha de banco de dados.
- Balanceador de carga global L4: um serviço gerenciado pela plataforma que fornece um IP virtual (VIP) estável que roteia o tráfego para o líder do cluster atual.
- Armazenamento permanente: o armazenamento com suporte a SSD de alto desempenho é necessário para atender aos requisitos rigorosos de latência dos registros de gravação antecipada da camada de consenso.
Serviços e lógica
- PostgreSQL 17: o mecanismo de banco de dados relacional principal responsável pela persistência de dados e execução de consultas.
- Patroni: o gerenciador de alta disponibilidade que monitora o processo local do PostgreSQL e coordena as eleições de líder usando o etcd.
- etcd: o armazenamento de configuração distribuído que fornece a camada de consenso e mantém o estado autoritativo do cluster.
- PgBouncer: um pooler de conexão leve que fica na frente do PostgreSQL para processar conexões de aplicativos recebidas com eficiência.
Fluxo de dados e interfaces
- PgBouncer (porta 6432): o ponto de entrada principal para o tráfego de banco de dados de aplicativos.
- API Patroni (porta 8008): uma interface HTTPS REST usada pelo balanceador de carga para realizar verificações de integridade e identificar o líder atual usando o endpoint
/primary. - etcd (porta 2379): o canal de comunicação para o cluster de consenso manter o estado e realizar eleições.
Considerações
- Escalonabilidade e desempenho:
- Os nós do banco de dados precisam ser dimensionados com base na carga de trabalho, com um mínimo de 2 vCPUs e 8 GiB de RAM. As cargas de trabalho Production normalmente começam com 8 vCPUs e 32 GiB.
- O desempenho depende do armazenamento de baixa latência. Os SSDs são necessários para garantir que o etcd possa processar sincronizações de dados em menos de 10 ms.
- Replicação síncrona: a sobrecarga da replicação síncrona depende diretamente da latência da rede entre zonas. Para garantir o desempenho ideal para configurações de perda zero de dados, é necessária baixa latência entre zonas.
- Gerenciamento de recursos e licenciamento:
- Essa solução depende de componentes de banco de dados de código aberto e sem custo financeiro.
- O Autobase é usado como a ferramenta de automação de referência para simplificar a instalação e a configuração da pilha de HA. No entanto, a arquitetura não está vinculada exclusivamente ao Autobase, e os componentes de código aberto subjacentes podem ser gerenciados usando pipelines personalizados.
- Para organizações que exigem suporte formal para o pacote de automação, o suporte pago de terceiros está disponível.
- O pool de conexões com o PgBouncer é essencial para evitar o esgotamento da CPU e da memória causado por contagens altas de conexões de usuários.
- Disponibilidade e confiabilidade:
- A alta disponibilidade é alcançada por um quórum de três nós. A falha de qualquer nó ou zona não interrompe o serviço.
- Estabilidade do cluster: manter um quórum confiável requer baixa latência de rede entre os nós. Os tempos médios de ida e volta (RTTs) precisam ser inferiores a 10 ms para evitar tempos limite de eleição e instabilidade do cluster.
- Gerenciamento operacional:
- Tarefas de rotina, como aplicação de patches de versão secundária e upgrades principais, continuam sendo de responsabilidade da equipe de operações do cliente.
- As saídas de
stdoutdas VMs são ingeridas automaticamente na plataforma de monitoramento do GDC com isolamento físico. Um guia será publicado no futuro sobre como integrar um monitoramento mais detalhado para os componentes individuais. - Uma estratégia de backup robusta precisa ser implementada usando ferramentas nativas do banco de dados e snapshots da plataforma. Guias detalhados para esses procedimentos serão publicados separadamente.
Decisão de design
As opções arquitetônicas dessa solução fornecem um caminho resiliente para implantações multizonais.
Máquinas virtuais no Kubernetes
Uma abordagem baseada em VM foi selecionada para fornecer alta disponibilidade multizonal. O GDC não oferece suporte a clusters do Kubernetes que abrangem várias zonas físicas. Portanto, é necessário implantar VMs dedicadas em zonas separadas para criar uma arquitetura robusta entre zonas. Essa configuração pode sobreviver à falha total de uma única zona de infraestrutura.
Balanceamento de carga global nativo da plataforma
A arquitetura aproveita o balanceador de carga global L4 do GDC em vez de proxies baseados em software nas VMs. Essa abordagem oferece várias vantagens:
- Alcance global: fornece um IP virtual estável que pode ser acessado em todas as zonas.
- Gerenciado pela plataforma: o VIP é gerenciado de forma independente pelo plano de controle da plataforma.
- Failover simplificado: o failover é gerenciado por probes de verificação de integridade padrão, em vez de configurações de software locais complexas.
- Alta disponibilidade: a remoção da dependência de proxies locais garante que o ponto de entrada do tráfego do banco de dados permaneça resiliente.
Suposições e limitações
Suposições
- O ambiente tem um registro ou mecanismo local para importar binários e dependências do SO empacotados.
- O acesso SSH baseado em chaves está disponível para todas as VMs de destino para automação baseada em Ansible.
- O projeto tem cota suficiente para provisionamento de VM e balanceador de carga multizonal.
Limitações
- Manutenção manual: a aplicação de patches do sistema operacional e os upgrades de versão do PostgreSQL são tarefas manuais e não são automatizadas pela solução.
- Sensibilidade de armazenamento: a camada de consenso (etcd) é altamente sensível à latência do disco. A contenção de armazenamento alta e sustentada pode afetar a estabilidade da camada de consenso.
- Estabilidade da rede: o gerenciador de alta disponibilidade depende de uma conectividade de rede consistente e de baixa latência entre as zonas. Atrasos ou instabilidade da rede podem influenciar o tempo de coordenação do cluster e as transições de papéis.
Outros recursos
- Repositório de código de automação de referência: código-fonte do Autobase no GitHub
- Implementação de referência do banco de dados PostgreSQL