


Este guia oferece um passo a passo abrangente para implantar uma pilha do PostgreSQL de alta disponibilidade em três zonas em um ambiente isolado do Google Distributed Cloud (GDC). Você vai aprender a preparar os artefatos de software necessários, inicializar as VMs de destino e usar o Autobase para automatizar todo o processo de provisionamento. Neste guia, o Patroni é usado como a camada de gerenciamento principal para orquestrar o ciclo de vida do PostgreSQL e processar failovers automáticos.
Arquitetura
A arquitetura consiste em um ambiente de três VMs distribuídas em três zonas de disponibilidade.
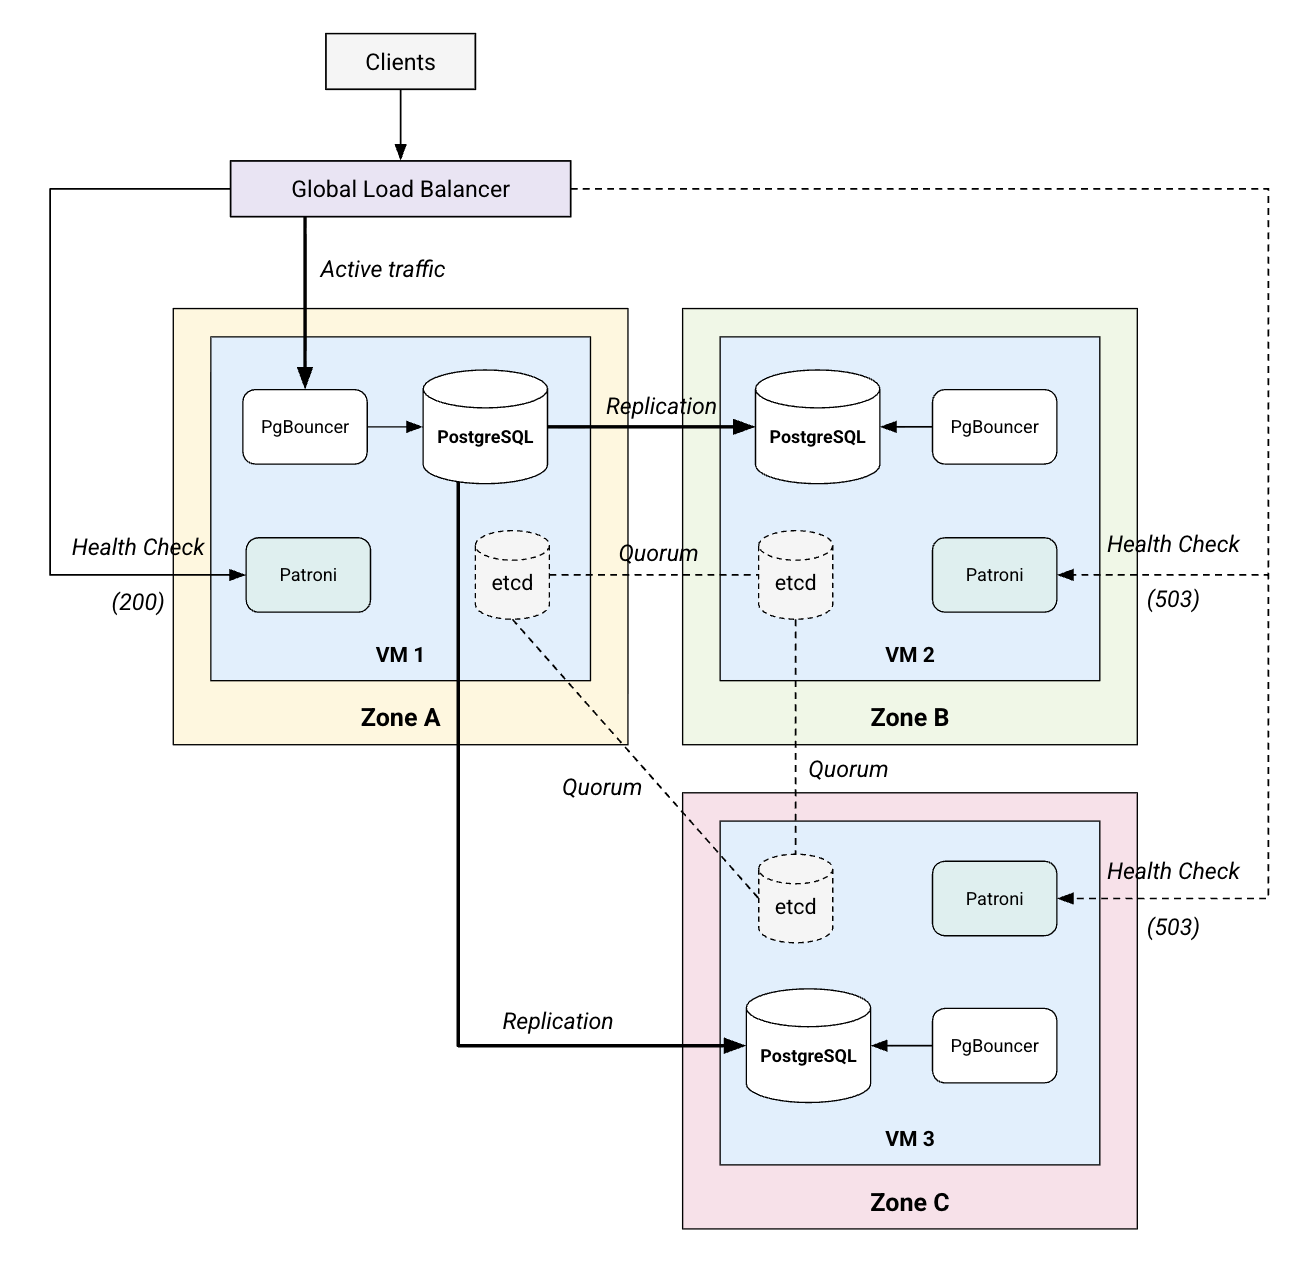
Cada VM é idêntica e executa uma pilha de serviços colocalizados:
- PostgreSQL 17: o mecanismo de banco de dados relacional principal.
- Patroni: o gerenciador de alta disponibilidade. Ele processa o ciclo de vida do processo do PostgreSQL e realiza failovers automáticos. Ele expõe uma API REST HTTPS na porta
8008(endpoint/primary) usada pelo balanceador de carga para identificar o líder atual. - etcd: o armazenamento de configuração distribuída (DCS, na sigla em inglês). Ele fornece a camada de consenso para a eleição de líderes e armazena a configuração do Patroni.
- PgBouncer: um pool de conexões que fica na frente do PostgreSQL para estabilizar a sobrecarga de conexão. Ele fornece o ponto de entrada recomendado para o tráfego de aplicativos na porta
6432.
A pilha também inclui um balanceador de carga global L4 GDC com isolamento físico, que é um serviço gerenciado pela plataforma que fornece um IP virtual (VIP) estável. Os aplicativos se conectam ao VIP estável na porta 6432, que o balanceador de carga roteia para o PgBouncer na VM líder atual. Em seguida, o PgBouncer encaminha a solicitação para a instância local do PostgreSQL. Para gerenciar o fluxo de tráfego, o balanceador de carga pesquisa continuamente os endpoints HTTPS do Patroni como uma verificação de integridade.
A verificação de integridade na VM líder retorna HTTP 200 OK para sinalizar que a VM está pronta para o tráfego, enquanto as verificações de integridade nas VMs de réplica retornam HTTP 503 Service Unavailable para sinalizar ao balanceador de carga que as ignore. Se o líder falhar, um novo será eleito e a instância do Patroni começará a retornar HTTP 200 OK, fazendo com que o balanceador de carga redirecione automaticamente o tráfego para a porta do PgBouncer da nova VM.
Para garantir a alta disponibilidade e evitar a perda de dados, a pilha depende do conceito de quorum. Com três VMs, o sistema exige que a maioria de pelo menos dois membros esteja íntegra e em comunicação para eleger um líder e permanecer operacional. Esse consenso baseado na maioria, gerenciado pelo etcd e pelo Patroni, permite que a pilha tolere automaticamente a falha total de qualquer VM ou zona.
Considerações sobre desempenho
Ao planejar a implantação, considere os seguintes fatores concretos para otimizar o desempenho e a confiabilidade:
- Dimensionamento de hardware: embora os requisitos variem de acordo com a carga de trabalho, use estes perfis padrão como ponto de partida para cada VM:
- Desenvolvimento/prova de conceito: 2 vCPUs, 8 GB de RAM (mínimo para operação estável).
- Produção pequena: 4 vCPUs, 16 GB de RAM. Adequado para ferramentas internas com simultaneidade moderada.
- Produção padrão: 8 vCPUs, 32 GB de RAM. A linha de base recomendada para aplicativos de missão crítica.
- Alta capacidade de processamento: mais de 16 vCPUs, mais de 64 GB de RAM. Para cargas de trabalho que exigem um cache de dados extenso na memória (buffers compartilhados do PostgreSQL).
- Desempenho de armazenamento: o armazenamento de alto desempenho é essencial. Os discos SSD são altamente recomendados para a estabilidade do etcd. O etcd é extremamente sensível à latência de gravação em disco. As diretrizes oficiais de hardware do etcd recomendam uma latência de WAL fdatasync de disco p99 de menos de 10 ms.
- Latência de rede: a latência entre as VMs afeta diretamente o desempenho da replicação:
- Quorum do etcd: o tempo médio de retorno (RTT, na sigla em inglês) precisa ser menor que 50 ms (idealmente menor que 10 ms) para evitar tempos limite de eleição e instabilidade do cluster.
- Replicação síncrona: se configurada, cada transação de gravação precisa aguardar o reconhecimento de uma réplica. A latência entre zonas no GDC com isolamento físico geralmente é menor que 1 ms, o que é excelente para manter a sobrecarga de gravação mínima (normalmente de 10 a 30%).
- O papel do PgBouncer: o PostgreSQL cria um novo processo de SO para cada conexão, que consome cerca de 10 MB de RAM e gera custos de troca de contexto da CPU. O PgBouncer reduz essa sobrecarga mantendo um pool de conexões persistentes, permitindo que o banco de dados processe milhares de conexões de aplicativos com muito menos processos de back-end.
- Componentes de sidecar: o Patroni e o etcd são leves, mas exigem disponibilidade consistente da CPU. Em cenários de alta carga, verifique se as VMs não estão superinscritas no nível do hipervisor para evitar "roubar" ciclos de CPU necessários para pulsações e manutenção de líderes.
- Ajuste do kernel: a automação do Autobase aplica automaticamente otimizações
benéficas para o PostgreSQL, como a configuração de
sysctl (por exemplo,
vm.swappiness,net.core.somaxconn) e a desativação de páginas enormes transparentes (THP, na sigla em inglês). Essas mudanças reduzem a sobrecarga de gerenciamento de memória e melhoram a capacidade de processamento da rede para instâncias de banco de dados de alto tráfego.
Antes de começar
Antes de iniciar a implantação, verifique se o ambiente atende aos seguintes requisitos.
Revisar os requisitos da VM
Para este tutorial, crie três VMs no seu projeto GDC com isolamento físico. Você precisará considerar os seguintes pontos e requisitos para as VMs:
- Distribuição de zona: para tornar essa implantação realmente resiliente a falhas de zona, distribua as VMs em três zonas de disponibilidade diferentes. No entanto, a implantação permanece idêntica se as VMs estiverem localizadas em duas zonas ou até mesmo em uma única zona. O mais importante é que todas as VMs possam se comunicar entre si pela rede com os endereços IP internos.
- Sistema operacional: este tutorial pressupõe que você esteja usando imagens do Ubuntu 22.04. As próximas etapas deste guia poderão ser diferentes se você usar uma distribuição diferente.
- Recursos: provisione pelo menos 2 CPUs e 8 GB de memória por VM para este tutorial. Na produção, provisione recursos adequados para suas cargas de trabalho específicas (consulte Considerações sobre desempenho).
- IPs de rede: anote os endereços IP internos e externos de cada VM. Neste guia, você usa IPs externos para o controle do Ansible porque está executando comandos de uma estação de trabalho externa. Os IPs internos são usados para comunicação e vinculação entre serviços. Se você provisionar uma VM de inicialização na rede, só precisará dos IPs internos.
- Acesso: o acesso sudo sem senha para o usuário de implantação é necessário porque a automação do Ansible precisa realizar tarefas administrativas (instalar pacotes, modificar configurações do sistema) sem ser bloqueada por solicitações de senha.
- SSH: a autenticação baseada em chave precisa ser ativada para permitir que o Ansible se conecte às VMs de destino de maneira segura e não interativa.
Preparar o software da estação de trabalho local
Para gerenciar a implantação e preparar os artefatos isolados, você precisará de um conjunto de ferramentas de automação e contêineres instaladas na estação de trabalho local.
- Ansible 2.17.0 ou mais recente: o mecanismo de automação que executa os playbooks e papéis de implantação.
- Docker: usado para extrair e empacotar dependências do SO em um ambiente idêntico às VMs de destino (Ubuntu 22.04).
- Cliente PostgreSQL (
psql): necessário para executar as consultas de teste e verificar a replicação de dados da estação de trabalho local. O repositório do Autobase:
- Clone o repositório para acessar os playbooks e papéis de automação: https://github.com/vitabaks/autobase
Faça o checkout de uma versão específica (este guia usa a versão 2.5.2):
git checkout 2.5.2As próximas etapas deste guia poderão ser diferentes se você usar uma distribuição diferente.
Para executar os playbooks neste guia, instale o código-fonte local
autobasecomo uma coleção do Ansible para que os prefixos de papel possam ser resolvidos:cd autobase/automation ansible-galaxy collection install . --force
Criar algumas variáveis de ambiente
Neste guia, você usará as seguintes variáveis de ambiente para simplificar os comandos. Essas variáveis armazenam parâmetros críticos, como o ID do projeto, as zonas de disponibilidade das VMs, os nomes de host e os rótulos usados pelo balanceador de carga para identificar o cluster. Defina-os na sessão do shell atual com os valores reais do seu ambiente (verifique se as zonas estão separadas por espaços).
Embora seja possível definir os nomes que você quiser para as VMs, este guia usa postgres-vm-1, postgres-vm-2 e postgres-vm-3 como exemplos de nomes arbitrários para os nós do cluster:
export PROJECT_ID="your-project-id"
export ZONES="zone1 zone2 zone3"
export VM1_NAME="postgres-vm-1"
export VM2_NAME="postgres-vm-2"
export VM3_NAME="postgres-vm-3"
export VM_LABEL="app=my-postgres-cluster"
export CLUSTER_NAME="my-postgres-cluster"
Configurar o Ansible
Defina o ambiente da VM no arquivo inventory.ini usando o seguinte modelo:
[master]
postgres-vm-1 ansible_host=XX.XX.XX.XX hostname=postgres-vm-1 bind_address=XX.XX.XX.XX

[replica]
postgres-vm-2 ansible_host=XX.XX.XX.XX hostname=postgres-vm-2 bind_address=XX.XX.XX.XX
postgres-vm-3 ansible_host=XX.XX.XX.XX hostname=postgres-vm-3 bind_address=XX.XX.XX.XX

[postgres_cluster:children]
master
replica

[etcd_cluster]
postgres-vm-1
postgres-vm-2
postgres-vm-3

[all:vars]
ansible_user=...
ansible_ssh_private_key_file=~/.ssh/...
postgresql_version=17
with_haproxy_load_balancing=false
patroni_superuser_password=...
etcd_package_repo="file:///tmp/packages/etcd-v3.5.25-linux-amd64.tar.gz"
installation_method="packages"
install_postgresql_repo=false
install_timescale_repo=false
install_citus_repo=false
apt_repository=[]
yum_repository=[]
install_system_packages=false
patroni_installation_method=deb
Entender a configuração:
[master]e[replica]: define as VMs de banco de dados principal e secundário. Use os nomes reais das VMs que foram definidos nas variáveis de ambienteVM1_NAME,VM2_NAMEeVM3_NAME.[postgres_cluster:children]: um grupo que agrega os nós mestre e de réplica, permitindo que o Ansible segmenta todo o cluster de banco de dados com um único comando.[etcd_cluster]: define os nós que participarão do cluster de consenso do etcd. Isso inclui todos os três nós de banco de dados para garantir a alta disponibilidade.ansible_host: (para cada VM) o IP de entrada externo da VM usado pelo Ansible para se conectar a ela. SubstituaXX.XX.XX.XXpelo IP externo real.bind_address: (para cada VM) o endereço IP interno da VM. SubstituaXX.XX.XX.XXpelo IP interno real.ansible_user: o usuário remoto que o Ansible usa para se conectar às VMs de destino com SSH. Substitua...pelo nome de usuário real.ansible_ssh_private_key_file: o caminho local para a chave SSH privada usada para autenticação nas VMs de destino. Substitua~/.ssh/...pelo caminho real.patroni_superuser_password: a senha do usuáriopostgres. Use uma senha forte e segura aqui.with_haproxy_load_balancing=false: desativa o HAProxy local, já que você está usando o balanceador de carga L4 nativo da plataforma.etcd_package_repo: aponta para o caminho local do binário etcd no diretório de inicialização da VM.installation_method="packages": instrui a automação a instalar componentes com pacotes do SO em vez de compilar a partir da origem ou usar o pip do Python.install_..._repo=falsee_repository=[]: essas substituições impedem que o Ansible tente acessar a Internet para adicionar repositórios externos ou atualizar listas de pacotes.install_system_packages=false: impede que a automação tente fazer o download e instalar pacotes que você já provisionou durante a fase de inicialização ou de inicialização.patroni_installation_method=deb: informa especificamente ao papel para usar o pacote.debinstalado.
Inicializar as VMs
A pilha de banco de dados exige vários pacotes e bibliotecas do SO que podem não estar incluídos na imagem base do Ubuntu. Como as VMs estão em um ambiente isolado sem acesso à Internet, elas não podem fazer o download dessas dependências.
Para resolver isso, siga estas etapas:
Use um contêiner do Docker na estação de trabalho local para fazer o download de todos os arquivos necessários. O comando a seguir usa
apt-rdependspara identificar recursivamente todas as bibliotecas compartilhadas e dependências exigidas pelos aplicativos de destino. Ele configura o repositório oficial do PostgreSQL no contêiner para buscar artefatos da versão 17 e, em seguida, itera pela lista de dependências para fazer o download de arquivos.debindividuais, filtrando bibliotecas do sistema principal (comolibc6ouhostname) para evitar conflitos de versão nas VMs de destino. Por fim, ele busca o binário etcd independente diretamente do GitHub.Primeiro, crie um diretório para armazenar os pacotes:
mkdir -p ./packagesEm seguida, execute o comando do Docker para fazer o download de todos os pacotes necessários e do binário etcd:
docker run --rm --platform linux/amd64 -v "$(pwd)/packages:/packages" \
  ubuntu:22.04 bash -c "
  set -e
  apt-get update
  apt-get install -y ca-certificates curl gnupg apt-rdepends

  # Add PostgreSQL Repository
  curl -fsSL https://www.postgresql.org/media/keys/ACCC4CF8.asc | \
    gpg --dearmor -o /etc/apt/trusted.gpg.d/postgresql.gpg
  echo 'deb http://apt.postgresql.org/pub/repos/apt jammy-pgdg main' > \
    /etc/apt/sources.list.d/pgdg.list
  apt-get update

  # Define Application Targets + Explicit dependencies needed for air-gap
  TARGETS='unzip tar pgbouncer patroni netdata postgresql-17 \
    postgresql-client-17 postgresql-contrib-17 \
    postgresql-server-dev-17 postgresql-17-dbgsym \
    python3-psycopg2 python3-click python3-yaml python3-prettytable \
    python3-urllib3 python3-tz python3-pip python3-setuptools \
    python3-cryptography moreutils vim jq acl zstd libjq1 \
    libpython3.10-stdlib libexpat1-dev zlib1g-dev libipc-run-perl \
    libtime-duration-perl libjson-perl libpython3-dev \
    libjs-sphinxdoc python3-wheel'

  # Resolve all recursive dependencies
  ALL_DEPS=\$(apt-cache depends --recurse --no-recommends --no-suggests \
    --no-conflicts --no-breaks --no-replaces --no-enhances \$TARGETS | \
    grep '^\w' | sort -u)

  cd /packages
  for pkg in \$ALL_DEPS; do
    if apt-cache show \"\$pkg\" > /dev/null 2>&1; then
      # Filter system core to avoid VM conflicts/breaks
      # We exclude core OS libraries (libc, systemd, etc.) because these
      # often cause version conflicts if the VM's patch level differs
      # from the online container.
      FILTER='base-files|debianutils|coreutils|findutils|diffutils|sed'
      FILTER+='|grep|gzip|hostname|ncurses|perl-base|libc6|binutils'
      FILTER+='|linux-libc|libc-bin|libc-dev-bin|systemd|dpkg|init'
      if [[ ! \"\$pkg\" =~ \$FILTER ]]; then
        apt-get download \"\$pkg\" || echo \"Failed \$pkg\"
      fi
    fi
  done

  # Download etcd binary
  if [ ! -f etcd-v3.5.25-linux-amd64.tar.gz ]; then
    curl -L https://github.com/etcd-io/etcd/releases/download/v3.5.25/\
etcd-v3.5.25-linux-amd64.tar.gz -o etcd-v3.5.25-linux-amd64.tar.gz
  fi
"
Use o Ansible para fazer o upload do arquivo para todas as três VMs de destino simultaneamente:
ansible all -i inventory.ini -m copy -a "src=packages.tar.gz dest=/tmp/" -bLimpe todos os dados de pacote atuais nas VMs e extraia o novo arquivo tar:
ansible all -i inventory.ini -m shell -a "rm -rf /tmp/packages && \
  mkdir -p /tmp/packages && tar -xzf /tmp/packages.tar.gz -C /tmp/packages" -b
Realize uma instalação não interativa de todos os pacotes
.debbaixados. Para evitar problemas com pré-dependências específicas em um ambiente isolado, use a flag--force-dependsseguida porapt-get install -fypara resolver a árvore de dependências localmente:ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a dpkg -i --force-depends /tmp/packages/*.deb" -b ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a apt-get install -fy" -bInterrompa imediatamente todos os serviços para evitar que eles sejam iniciados com estados padrão não configurados antes que a automação esteja pronta:
ansible all -i inventory.ini -m shell -a \
  "systemctl stop patroni etcd pgbouncer postgresql || true" -b
Por fim, remova os clusters padrão do PostgreSQL e todos os dados etcd atuais para permitir uma inicialização limpa:
ansible all -i inventory.ini -m shell -a \
  "pg_dropcluster 17 main --stop || true" -b
ansible all -i inventory.ini -m shell -a \
  "rm -rf /var/lib/postgresql/17/main/* /var/lib/etcd/default.etcd/*" -b
Provisionar a infraestrutura de banco de dados
Com as VMs inicializadas e o inventário configurado, agora é possível usar os playbooks de automação do Autobase com o Ansible para implantar a pilha do PostgreSQL de alta disponibilidade.
Primeiro, execute as verificações de pré-voo para garantir que o ambiente esteja pronto:
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini \
  --tags pre_checks
Se as verificações forem aprovadas, continue com a implantação completa:
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini
Saída esperada: o playbook precisa ser concluído com um "PLAY RECAP" bem-sucedido, mostrando todas as VMs de destino como alcançadas e atualizadas:
PLAY RECAP ********************************************************************
localhost                  : ok=1    changed=0    unreachable=0    failed=0    skipped=254  rescued=0    ignored=0
postgres-vm-1              : ok=160  changed=53   unreachable=0    failed=0    skipped=514  rescued=0    ignored=2
postgres-vm-2              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
postgres-vm-3              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
Verificar a implantação
Após a conclusão da implantação, realize várias verificações para garantir que todos os componentes estejam funcionando corretamente.
Verificar o status de alta disponibilidade
Verifique o status do gerenciador de alta disponibilidade para conferir os papéis atribuídos a cada VM:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Exemplo de saída:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Verificar endpoints de verificação de integridade
Teste se o Patroni identifica corretamente o líder e as réplicas usando a API REST.
A verificação de integridade da VM líder precisa retornar 200 OK, enquanto as verificações de integridade das VMs de réplica precisam retornar 503 Service Unavailable:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM3_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
Verificar a integridade de VMs individuais
Verifique a prontidão de todas as instâncias do PostgreSQL:
ansible postgres_cluster -i inventory.ini -m shell -a "pg_isready -p 5432" -b
Exemplo de saída:
postgres-vm-1 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-2 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-3 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections
Verificar a integridade do etcd
Verifique a integridade da camada de consenso em todas as VMs usando o localhost como endpoint:
ansible all -i inventory.ini -m shell -a "ETCDCTL_API=3 etcdctl \
  --endpoints=https://localhost:2379 \
  --cacert=/etc/etcd/tls/ca.crt \
  --cert=/etc/etcd/tls/server.crt \
  --key=/etc/etcd/tls/server.key \
  endpoint health" -b
Exemplo de saída:
postgres-vm-1 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 28.78311ms

postgres-vm-2 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 33.081265ms

postgres-vm-3 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 24.414291ms
Configurar o balanceador de carga global
Para fornecer um IP virtual (VIP) estável para a pilha de banco de dados, configure o balanceador de carga global L4 nativo da plataforma usando a CLI gdcloud.
Pré-requisitos:
- Verifique se você tem o papel
load-balancer-adminno seu projeto. Aplique um rótulo às VMs para que o balanceador de carga possa segmentar corretamente as instâncias que precisam ser veiculadas (substitua os valores do parâmetro
kubeconfigpelos arquivoskubeconfigda API de gerenciamento correspondentes para cada zona):kubectl --kubeconfig=ZONE_A_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM1_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_B_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM2_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_C_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM3_NAME} \ ${VM_LABEL}
- Verifique se você tem o papel
Defina o nível de acesso ao balanceamento de carga. Defina
EXTERNALse precisar se conectar de fora da rede do projeto ouINTERNALse o acesso for necessário apenas de dentro da VPC. Para este tutorial, vamos usar uma configuração externa:export LB_SCHEME=EXTERNALCriar uma verificação de integridade. O balanceador de carga usa a API REST do Patroni para identificar o líder:
gdcloud compute health-checks create https ${CLUSTER_NAME}-hc \
  --project=${PROJECT_ID} \
  --port=8008 \
  --request-path="/primary" \
  --check-interval=10 \
  --timeout=5 \
  --healthy-threshold=2 \
  --unhealthy-threshold=3 \
  --global
Crie um back-end zonal separado para cada zona em que as VMs estão localizadas:
for zone in $(echo $ZONES); do
  gdcloud compute backends create ${CLUSTER_NAME}-backend-${zone} \
    --project=${PROJECT_ID} \
    --zone=${zone} \
    --labels="${VM_LABEL}"
done
Crie um serviço de back-end global:
gdcloud compute backend-services create ${CLUSTER_NAME}-bes \
  --project=${PROJECT_ID} \
  --health-check="${CLUSTER_NAME}-hc" \
  --global
Adicione os back-ends zonais ao serviço global:
for zone in $(echo $ZONES); do
  gdcloud compute backend-services add-backend ${CLUSTER_NAME}-bes \
    --project=${PROJECT_ID} \
    --backend=${CLUSTER_NAME}-backend-${zone} \
    --backend-zone=${zone} \
    --global
done
Crie uma regra de encaminhamento global (o VIP). Essa regra expõe o banco de dados na porta
6432:gdcloud compute forwarding-rules create ${CLUSTER_NAME}-fr \ --project=${PROJECT_ID} \ --load-balancing-scheme=${LB_SCHEME} \ --backend-service=${CLUSTER_NAME}-bes \ --ip-protocol-port="TCP:6432" \ --globalRecupere o endereço VIP:
LB_IP=$(gdcloud compute forwarding-rules describe ${CLUSTER_NAME}-fr \
  --project=${PROJECT_ID} \
  --load-balancing-scheme=${LB_SCHEME} \
  --global \
  --format=json \
  | jq -r '.metadata.annotations["networking.gke.io/forwardingRuleCIDR"]'  \
  | cut -d '/' -f 1)

echo "The load balancer IP is: ${LB_IP}"
Crie uma
ProjectNetworkPolicy(PNP) para permitir o tráfego de entrada para a porta do PgBouncer (substitua o valor do parâmetrokubeconfigpelo arquivokubeconfigda API global correspondente do seu ambiente).kubectl --kubeconfig=GLOBAL_API_KUBECONFIG apply -f - <<EOF apiVersion: networking.global.gdc.goog/v1 kind: ProjectNetworkPolicy metadata: name: allow-pgbouncer namespace: ${PROJECT_ID} spec: ingress: - ports: - port: 6432 protocol: TCP policyType: Ingress subject: subjectType: UserWorkload EOF
Verificar a replicação de dados
Para confirmar se a pilha de alta disponibilidade está funcionando conforme o esperado, crie dados de amostra no líder e verifique a presença deles nas réplicas.
Inserir dados de amostra
A automação gera uma senha aleatória para o usuário postgres durante a primeira implantação se uma não for fornecida em inventory.ini. É possível recuperá-la de qualquer VM:
export PG_PASSWORD=$(ansible master -i inventory.ini -m shell -a \
  "grep -A10 'authentication:' /etc/patroni/patroni.yml | \
  grep -A3 'superuser' | grep 'password:' | awk '{ print \$2 }'" -b | \
  tail -n 1)
echo $PG_PASSWORD
Conecte-se ao VIP do balanceador de carga na porta do PgBouncer (6432) e crie uma tabela de amostra:
PGPASSWORD="${PG_PASSWORD}" psql -h ${LB_IP} -p 6432 -U postgres -c "
  CREATE TABLE employees (first_name TEXT, last_name TEXT);
  INSERT INTO employees (first_name, last_name) VALUES ('John', 'Doe');
"
Saída esperada:
INSERT 0 1
Verificar o estado de replicação
Execute uma consulta SELECT em todas as VMs para garantir que os dados tenham sido replicados do líder para todas as réplicas:
ansible postgres_cluster -i inventory.ini -m shell -a "psql -U postgres -c \
  'SELECT * FROM employees;'" -b
Exemplo de saída:
postgres-vm-1 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-2 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-3 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)
Testar a troca manual
Uma troca manual permite mover o papel de líder para uma VM candidata específica. Isso geralmente é feito para manutenção planejada, upgrades de software ou para equilibrar a utilização de recursos entre zonas.
Identificar o líder atual
Verifique o papel e o status atuais das VMs:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Exemplo de saída:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Realizar a troca
Acione uma troca do líder atual para outra VM (neste caso, respectivamente, de postgres-vm-1 para postgres-vm-2). O comando usa --force para ignorar as solicitações de confirmação manual:
ansible master -i inventory.ini -m shell -a "patronictl switchover \
  --leader ${VM1_NAME} --candidate ${VM2_NAME} --force" -b
Exemplo de saída:
Successfully switched over to "postgres-vm-2"
+ Cluster: postgres-cluster (7607933704953386478) -+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | stopped |    |     unknown |     |    unknown |     |
| postgres-vm-2 | 10.253.1.253 | Leader  | running |  1 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | running |  1 |   0/70000A0 |   0 |  0/70000A0 |   0 |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
Verificar a mudança de verificação de integridade
Após a troca, verifique se o status da verificação de integridade mudou para o novo líder:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
O líder antigo (postgres-vm-1) precisa retornar 503, enquanto o novo líder (postgres-vm-2) precisa retornar 200.
Testar o failover automático
Ao contrário de uma troca manual, um failover automático ocorre quando a VM líder fica indisponível. Esse teste confirma que o Patroni elege um novo líder e o balanceador de carga redireciona o tráfego sem intervenção manual. Suponha que postgres-vm-2 seja o líder atual após a troca manual realizada anteriormente.
Identificar o líder atual
Verifique o papel e o status atuais das VMs:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Exemplo de saída:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
| postgres-vm-2 | 10.253.1.253 | Leader  | running   |  2 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Simular uma falha de VM
Interrompa o serviço patroni na VM líder para simular uma falha ou falha grave:
ansible master -i inventory.ini -m shell -a "systemctl stop patroni" -b
Observar a nova eleição
Aguarde de 10 a 20 segundos e verifique o status de outra VM para conferir a promoção de um novo líder:
ansible replica -i inventory.ini -m shell -a "patronictl list" -b
Exemplo de saída:
postgres-vm-3 | CHANGED | rc=0 >>
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  3 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | stopped   |    |     unknown |     |    unknown |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  3 |   0/90003F8 |   0 |  0/90003F8 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Você verá que uma das outras VMs (postgres-vm-1 ou postgres-vm-3) se tornou o líder e o líder antigo (postgres-vm-2) está marcado como interrompido.
Verificar a mudança de verificação de integridade
Confirme se as verificações de integridade do balanceador de carga agora identificam corretamente o líder recém-eleito:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
O novo líder precisa retornar 200 OK.
Recuperar a VM com falha
Inicie o serviço patroni novamente na VM original para que ele possa ingressar na pilha como uma réplica e recuperar todos os dados perdidos:
ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "systemctl start patroni" -b