


Questa architettura di riferimento fornisce un framework concettuale per il deployment e l'utilizzo di database PostgreSQL gestiti dal cliente su Google Distributed Cloud (GDC) air-gapped. Questa soluzione consente alle organizzazioni di mantenere i carichi di lavoro di database critici sfruttando un cluster multizona ad alta disponibilità (HA) di cui è stato eseguito il deployment su macchine virtuali.
L'architettura si concentra su una configurazione resiliente a 3 nodi che garantisce la disponibilità del database anche in caso di errore di una singola zona o infrastruttura. Copre l'intero ciclo di vita, dal provisioning e dalla rete automatizzati alle operazioni di livello di produzione come alta affidabilità, backup, ripristino e osservabilità.
Caratteristiche e funzionalità
La soluzione fornisce diversi componenti funzionali di base per la gestione dei database:
- Alta affidabilità automatica: utilizza Patroni ed etcd per fornire l'elezione automatica del leader e il failover, garantendo che il database rimanga operativo senza intervento manuale.
- Resilienza multizona: distribuisci i nodi del database su tre zone di disponibilità distinte per proteggerti da interruzioni localizzate dell'hardware o dell'infrastruttura.
- Automazione standardizzata: esegui il provisioning dell'intero stack utilizzando playbook basati su Ansible con Autobase per garantire deployment ripetibili e coerenti.
- Pool di connessioni: servizio PgBouncer integrato per gestire un numero elevato di connessioni e stabilizzare il consumo di risorse sui nodi del database.
- Bilanciamento del carico globale: utilizza il bilanciatore del carico L4 globale gestito dalla piattaforma per fornire un singolo indirizzo IP virtuale (VIP) stabile accessibile in tutte le zone.
- Preparazione per air-gapped: flussi di lavoro specializzati per il packaging di tutte le dipendenze e i file binari del sistema operativo richiesti per il deployment in ambienti disconnessi.
- Protezione dei dati: utilizza strumenti standard come
pg_dumpepg_basebackupinsieme agli snapshot di archiviazione GDC per mantenere una strategia di backup e ripristino efficace.
Architettura
L'architettura è costituita da un ambiente di tre VM distribuite su tre zone di disponibilità che eseguono uno stack di servizi collocato.
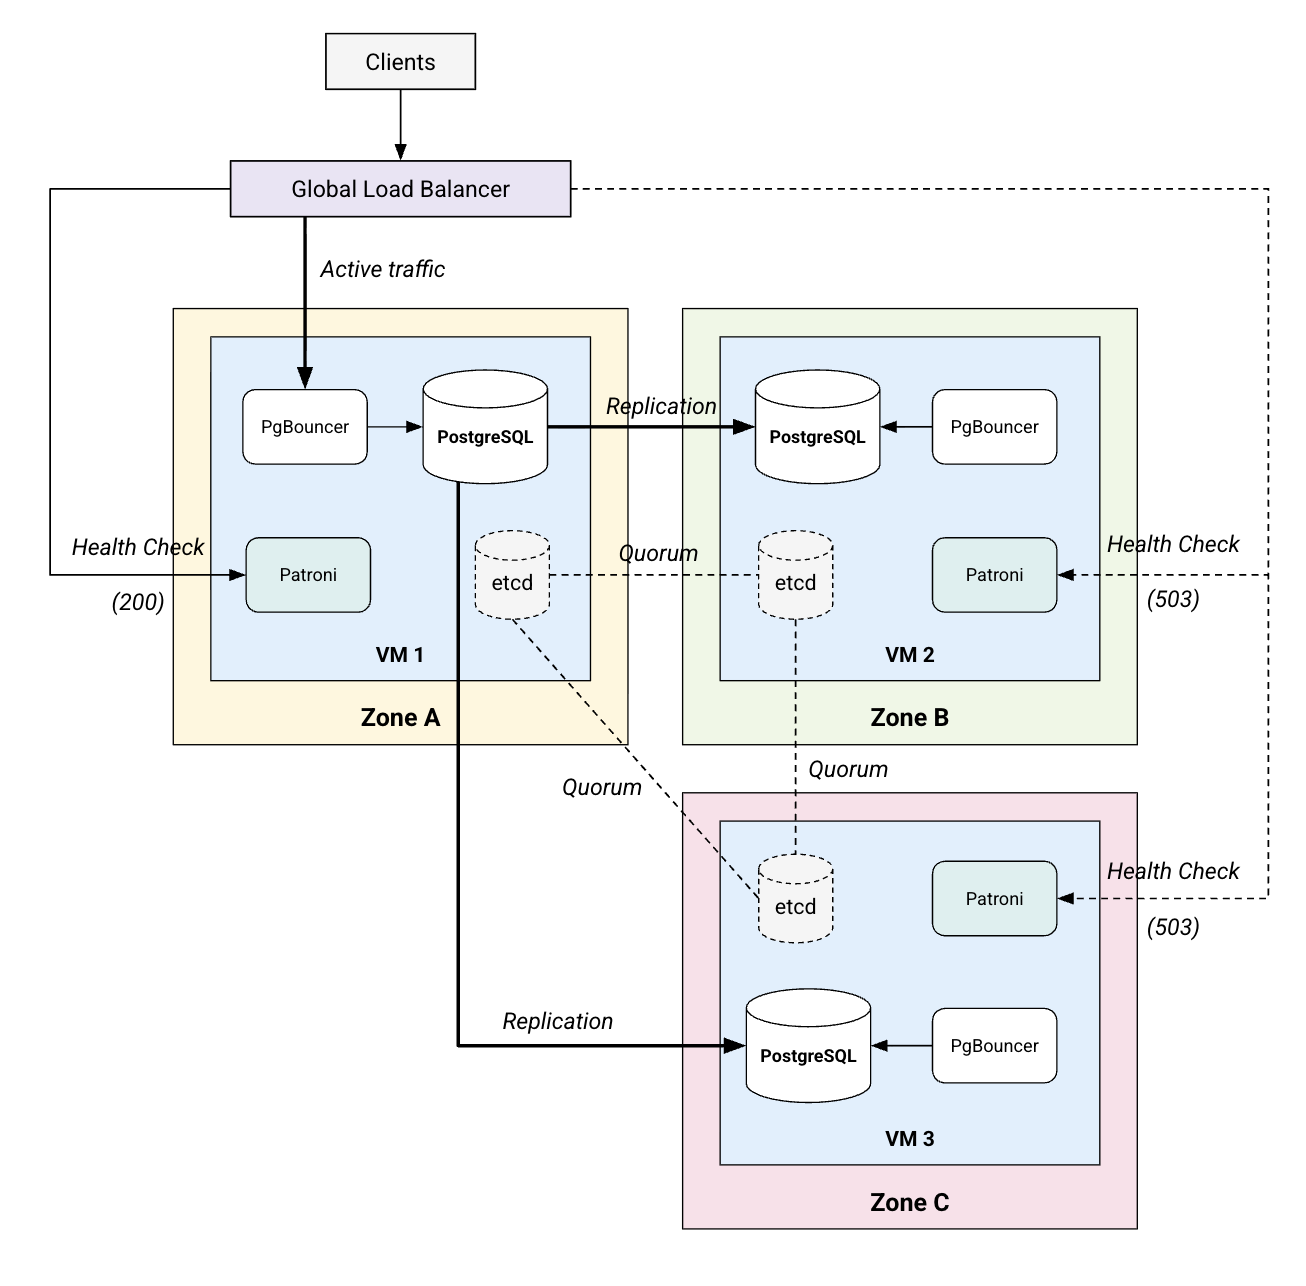
Principi architetturali
- Consenso basato sulla maggioranza: utilizza un modello basato sul quorum in cui la maggior parte dei nodi (2 su 3) deve concordare sullo stato del cluster, impedendo scenari di "split-brain" e garantendo l'integrità dei dati.
- Separazione delle responsabilità: ogni VM esegue uno stack di servizi collocato ma distinto (database, gestore HA, consenso e pooler) per fornire un nodo autonomo e resiliente.
- Failover con riconoscimento del database: assegna la priorità alle metriche di integrità del database con l'API REST di Patroni per coordinare il reindirizzamento del traffico tramite il bilanciatore del carico della piattaforma.
- Infrastructure as Code: si basa su playbook automatizzati per tutte le attività di configurazione, riducendo il rischio di errori umani durante il deployment e la scalabilità.
Concetti e tecnologie
Questa sezione descrive in dettaglio i componenti funzionali, le loro responsabilità e il modo in cui comunicano all'interno del sistema.
Infrastruttura e piattaforma
- Macchine virtuali (VM): istanze di calcolo dedicate distribuite tra le zone per ospitare lo stack del database.
- Bilanciatore del carico L4 globale: un servizio gestito dalla piattaforma che fornisce un indirizzo IP virtuale (VIP) stabile che instrada il traffico al leader del cluster corrente.
- Spazio di archiviazione permanente: è necessario uno spazio di archiviazione basato su SSD ad alte prestazioni per soddisfare i rigorosi requisiti di latenza per i log write-ahead del livello di consenso.
Servizi e logica
- PostgreSQL 17: il motore del database relazionale principale responsabile della persistenza dei dati e dell'esecuzione delle query.
- Patroni: il gestore di alta affidabilità che monitora il processo PostgreSQL locale e coordina le elezioni del leader utilizzando etcd.
- etcd: l'archivio di configurazione distribuito che fornisce il livello di consenso e contiene lo stato autorevole del cluster.
- PgBouncer: un pooler di connessioni leggero che si trova davanti a PostgreSQL per gestire in modo efficiente le connessioni delle applicazioni in entrata.
Flusso di dati e interfacce
- PgBouncer (porta 6432): il punto di ingresso principale per il traffico del database delle applicazioni.
- API Patroni (porta 8008): un'interfaccia REST HTTPS utilizzata dal bilanciatore del carico per eseguire controlli di integrità e identificare il leader corrente utilizzando l'endpoint
/primary. - etcd (porta 2379): il canale di comunicazione per il cluster di consenso per mantenere lo stato ed eseguire le elezioni.
Considerazioni
- Scalabilità e prestazioni:
- Le dimensioni dei nodi del database devono essere basate sul carico di lavoro, con un minimo di 2 vCPU e 8 GiB di RAM. In genere, i carichi di lavoro di produzione iniziano con 8 vCPU e 32 GiB.
- Le prestazioni dipendono dallo spazio di archiviazione a bassa latenza; gli SSD sono necessari per garantire che etcd possa elaborare le sincronizzazioni dei dati in meno di 10 ms.
- Replica sincrona: il sovraccarico della replica sincrona dipende direttamente dalla latenza di rete tra le zone. Per garantire prestazioni ottimali per le configurazioni senza perdita di dati, è necessaria una bassa latenza tra le zone.
- Gestione delle risorse e licenze:
- Questa soluzione si basa su componenti di database open source senza costi.
- Autobase viene utilizzato come strumento di automazione di riferimento per semplificare l'installazione e la configurazione dello stack HA. Tuttavia, l'architettura non è legata esclusivamente ad Autobase e i componenti open source sottostanti possono essere gestiti utilizzando pipeline personalizzate.
- Per le organizzazioni che richiedono assistenza formale per il pacchetto di automazione, è disponibile l'assistenza a pagamento di terze parti.
- Il pool di connessioni con PgBouncer è essenziale per evitare l'esaurimento di CPU e memoria causato da un numero elevato di connessioni utente.
- Disponibilità e affidabilità:
- L'alta affidabilità si ottiene tramite un quorum di 3 nodi. L'errore di un singolo nodo o di una singola zona non interrompe il servizio.
- Stabilità del cluster: il mantenimento di un quorum affidabile richiede una bassa latenza di rete tra i nodi. Idealmente, i tempi di round trip (RTT) medi dovrebbero essere inferiori a 10 ms per evitare timeout di elezione e instabilità del cluster.
- Gestione operativa:
- Le attività di routine, come l'applicazione di patch alla versione secondaria e gli upgrade principali, rimangono di responsabilità del team operativo del cliente.
- Gli output di
stdoutdelle VM vengono acquisiti automaticamente nella piattaforma di monitoraggio GDC con air gap. In futuro verrà pubblicata una guida su come integrare un monitoraggio più dettagliato per i singoli componenti. - È necessario implementare una strategia di backup efficace utilizzando gli strumenti nativi del database e gli snapshot della piattaforma. Le guide dettagliate per queste procedure verranno pubblicate separatamente.
Decisione di progettazione
Le scelte architetturali per questa soluzione forniscono un percorso resiliente per i deployment multizona.
Macchine virtuali su Kubernetes
È stato selezionato un approccio basato su VM per fornire alta affidabilità multizona. GDC non supporta i cluster Kubernetes che si estendono su più zone fisiche. Pertanto, è necessario eseguire il deployment di VM dedicate in zone separate per ottenere un'architettura cross-zone efficace. Questa configurazione può sopravvivere all'errore totale di una singola zona dell'infrastruttura.
Bilanciamento del carico globale nativo della piattaforma
L'architettura sfrutta il bilanciatore del carico L4 globale GDC anziché i proxy basati su software sulle VM. Questo approccio offre diversi vantaggi:
- Portata globale: fornisce un indirizzo IP virtuale stabile accessibile in tutte le zone.
- Gestito dalla piattaforma: l'indirizzo VIP viene gestito in modo indipendente dal piano di controllo della piattaforma.
- Failover semplificato: il failover viene gestito tramite probe di controllo di integrità standard anziché configurazioni software locali complesse.
- Alta disponibilità: la rimozione della dipendenza dai proxy locali garantisce che il punto di ingresso per il traffico del database rimanga resiliente.
Ipotesi e limitazioni
Ipotesi
- L'ambiente dispone di un registro locale o di un meccanismo per importare le dipendenze e i file binari del sistema operativo in pacchetto.
- L'accesso SSH basato su chiavi è disponibile per tutte le VM di destinazione per l'automazione basata su Ansible.
- Il progetto dispone di una quota sufficiente per il provisioning di VM multizona e bilanciatori del carico.
Limitazioni
- Manutenzione manuale: l'applicazione di patch al sistema operativo e gli upgrade della versione di PostgreSQL sono attività manuali e non vengono automatizzate dalla soluzione.
- Sensibilità dello spazio di archiviazione: il livello di consenso (etcd) è molto sensibile alla latenza del disco. Una contesa elevata e sostenuta dello spazio di archiviazione può influire sulla stabilità del livello di consenso.
- Stabilità della rete: il gestore di alta affidabilità si basa su una connettività di rete coerente e a bassa latenza tra le zone. Ritardi o jitter di rete possono influenzare la tempistica del coordinamento del cluster e delle transizioni di ruolo.
Materiali aggiuntivi
- Repository di codice di automazione di riferimento: codice sorgente di Autobase su GitHub
- Implementazione di riferimento del database PostgreSQL