


Questa guida fornisce una procedura dettagliata completa per il deployment di uno stack PostgreSQL a disponibilità elevata in tre zone in un ambiente air-gapped di Google Distributed Cloud (GDC). Scoprirai come preparare gli artefatti software necessari, eseguire il bootstrap delle VM di destinazione e utilizzare Autobase per automatizzare l'intero processo di provisioning. In questa guida, Patroni viene utilizzato come livello di gestione principale per orchestrare il ciclo di vita di PostgreSQL e gestire i failover automatici.
Architettura
L'architettura è costituita da un ambiente con tre VM distribuite in tre zone di disponibilità.
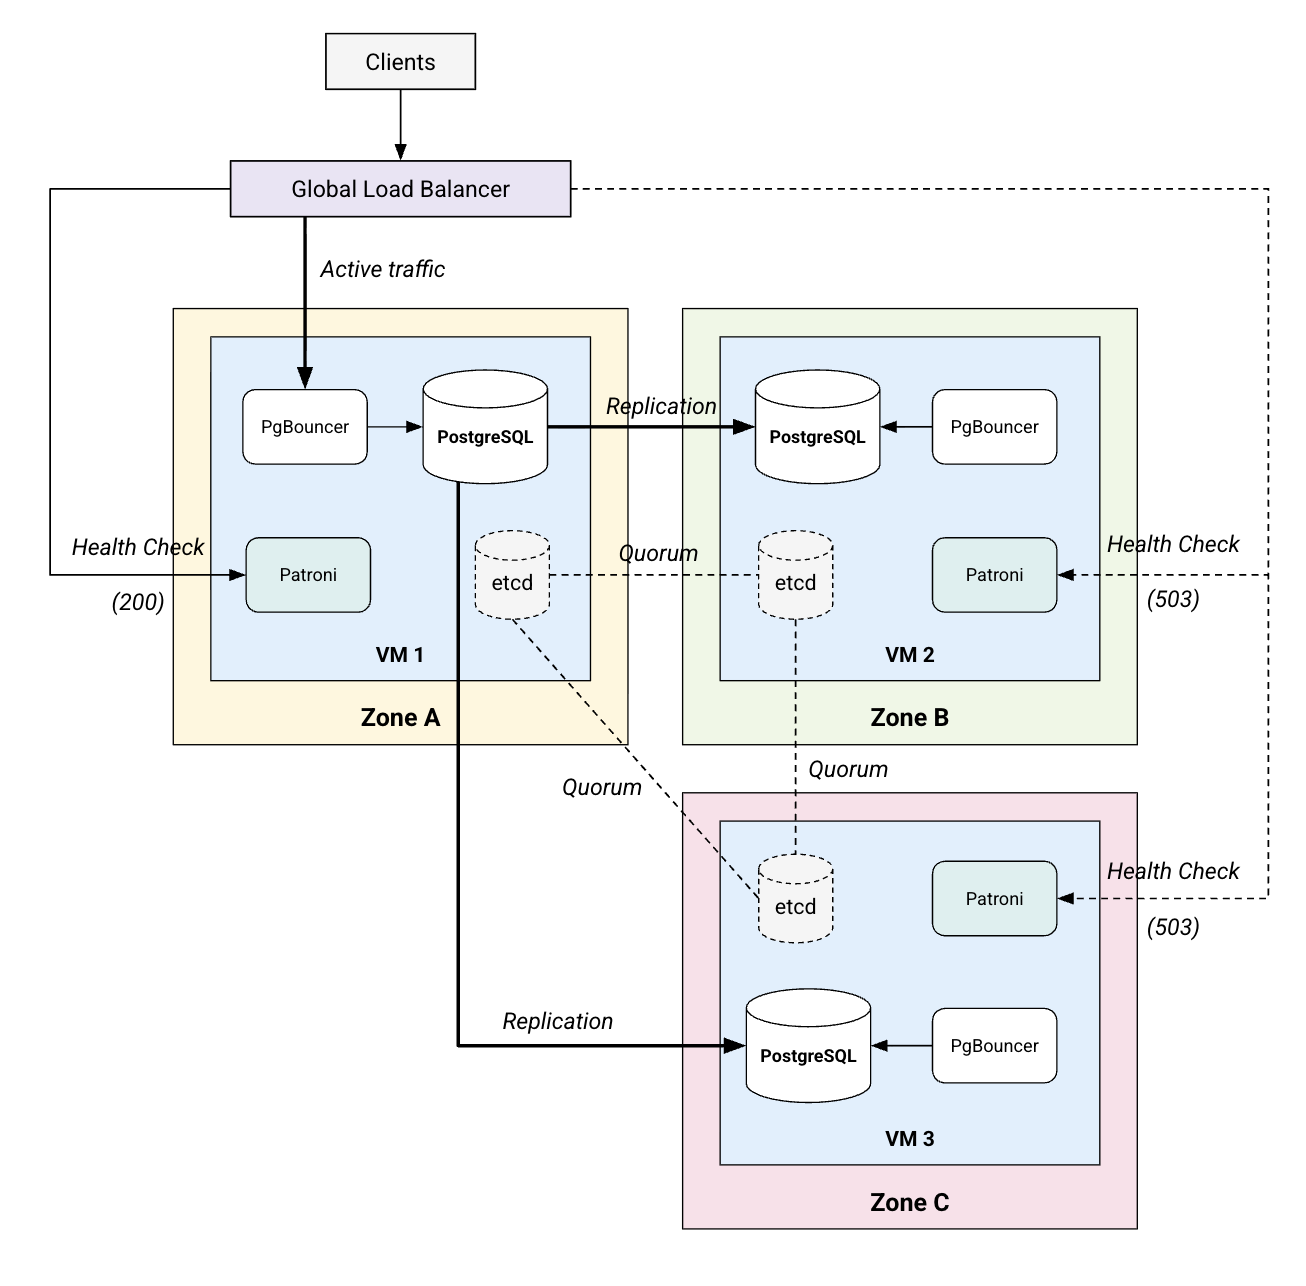
Ogni VM è identica ed esegue uno stack di servizi in colocation:
- PostgreSQL 17: il motore del database relazionale principale.
- Patroni: il gestore di alta disponibilità. Gestisce il ciclo di vita del processo PostgreSQL ed esegue failover automatici. Espone un'API REST HTTPS sulla porta
8008(endpoint/primary) utilizzata dal bilanciatore del carico per identificare il leader corrente. - etcd: l'archivio di configurazione distribuito (DCS). Fornisce il livello di consenso per l'elezione del leader e archivia la configurazione di Patroni.
- PgBouncer: un pool di connessioni che si trova davanti a PostgreSQL per stabilizzare l'overhead di connessione. Fornisce il punto di ingresso consigliato per il traffico delle applicazioni sulla porta
6432.
Lo stack include anche un bilanciatore del carico L4 globale GDC con air gap, un servizio gestito dalla piattaforma che fornisce un IP virtuale (VIP) stabile. Le applicazioni si connettono al VIP stabile sulla porta 6432, che il bilanciatore del carico indirizza a PgBouncer sulla VM leader corrente. PgBouncer esegue il proxy della richiesta all'istanza PostgreSQL locale. Per gestire il flusso di traffico, il bilanciatore del carico esegue continuamente il polling degli endpoint HTTPS di Patroni come controllo di integrità.
Il controllo di integrità sulla VM leader restituisce HTTP 200 OK per indicare che la VM è pronta per il traffico, mentre i controlli di integrità sulle VM di replica restituiscono HTTP 503 Service Unavailable per indicare al bilanciatore del carico di ignorarle. Se il leader non funziona, ne viene eletto uno nuovo e la relativa istanza Patroni inizia a restituire HTTP 200 OK, facendo in modo che il bilanciatore del carico reindirizzi automaticamente il traffico alla porta PgBouncer della nuova VM.
Per garantire l'alta affidabilità ed evitare la perdita di dati, lo stack si basa sul concetto di quorum. Con 3 VM, il sistema richiede che la maggioranza di almeno due membri sia integra e in comunicazione per eleggere un leader e rimanere operativo. Questo consenso basato sulla maggioranza, gestito da etcd e Patroni, consente allo stack di tollerare automaticamente il guasto totale di una singola VM o zona.
Considerazioni sulle prestazioni
Quando pianifichi il deployment, tieni conto dei seguenti fattori concreti per ottimizzare le prestazioni e l'affidabilità:
- Dimensionamento dell'hardware: sebbene i requisiti varino in base al carico di lavoro, utilizza questi profili standard come punto di partenza per ogni VM:
- Sviluppo/Proof-of-Concept: 2 vCPU, 8 GB di RAM (minimo per un funzionamento stabile).
- Produzione su piccola scala: 4 vCPU, 16 GB di RAM. Adatto per strumenti interni con concorrenza moderata.
- Produzione standard: 8 vCPU, 32 GB di RAM. La baseline consigliata per le applicazioni mission-critical.
- Alto throughput: 16+ vCPU, 64 GB+ di RAM. Per i carichi di lavoro che richiedono un'ampia memorizzazione nella cache dei dati in memoria (buffer condivisi di PostgreSQL).
- Prestazioni di archiviazione: lo spazio di archiviazione ad alte prestazioni è fondamentale. I dischi SSD sono altamente consigliati per la stabilità di etcd. etcd è estremamente sensibile alla latenza di scrittura su disco; le linee guida ufficiali sull'hardware etcd consigliano una latenza di fdatasync WAL del disco p99 inferiore a 10 ms.
- Latenza di rete: la latenza tra le VM influisce direttamente sulle prestazioni di replica:
- Quorum etcd: il tempo di round trip (RTT) medio deve essere inferiore a 50 ms (idealmente inferiore a 10 ms) per evitare timeout di elezione e instabilità del cluster.
- Replica sincrona: se configurata, ogni transazione di scrittura deve attendere la conferma di una replica. La latenza tra zone in GDC con air gap è in genere inferiore a 1 ms, il che è eccellente per ridurre al minimo l'overhead di scrittura (in genere 10-30%).
- Il ruolo di PgBouncer: PostgreSQL crea un nuovo processo del sistema operativo per ogni connessione, che consuma circa 10 MB di RAM e comporta costi di cambio di contesto della CPU. PgBouncer riduce questo overhead mantenendo un pool di connessioni permanenti, consentendo al database di gestire migliaia di connessioni di applicazioni con un numero significativamente inferiore di processi di backend.
- Componenti sidecar: Patroni ed etcd sono leggeri, ma richiedono una disponibilità costante della CPU. In scenari di carico elevato, assicurati che le VM non siano in oversubscription a livello di hypervisor per evitare di "rubare" i cicli della CPU necessari per gli heartbeat e la manutenzione del leader.
- Ottimizzazione del kernel: l'automazione di Autobase applica automaticamente le ottimizzazioni
utili per PostgreSQL, ad esempio la configurazione dei
sysctl
sysctl (ad es.
vm.swappiness,net.core.somaxconn) e la disattivazione delle pagine enormi trasparenti (THP). Queste modifiche riducono l'overhead di gestione della memoria e migliorano il throughput di rete per le istanze di database con traffico elevato.
Prima di iniziare
Prima di avviare il deployment, devi assicurarti che il tuo ambiente soddisfi i seguenti requisiti.
Esaminare i requisiti delle VM
Ai fini di questo tutorial, devi creare tre VM nel tuo progetto GDC con air gap. Dovrai tenere conto dei seguenti punti e requisiti per le VM:
- Distribuzione delle zone: per rendere questo deployment davvero resiliente ai guasti delle zone, devi distribuire le VM in tre zone di disponibilità diverse. Tuttavia, il deployment rimane identico se le VM si trovano in due zone o anche in una singola zona. La cosa più importante è che tutte le VM possano comunicare tra loro sulla rete con i rispettivi indirizzi IP interni.
- Sistema operativo: questo tutorial presuppone che tu stia utilizzando immagini Ubuntu 22.04. I passaggi successivi di questa guida potrebbero variare se utilizzi una distribuzione diversa.
- Risorse: per questo tutorial, devi eseguire il provisioning di almeno 2 CPU e 8 GB di memoria per VM. In produzione, devi eseguire il provisioning delle risorse appropriate per i tuoi carichi di lavoro specifici (vedi Considerazioni sulle prestazioni).
- IP di rete: devi prendere nota degli indirizzi IP interni ed esterni di ogni VM. In questa guida, utilizzi gli IP esterni per il controllo di Ansible perché esegui i comandi da una workstation esterna. Gli IP interni vengono utilizzati per la comunicazione e il binding tra i servizi. Se hai eseguito il provisioning di una VM bootstrapper all'interno della rete, avrai bisogno solo degli IP interni.
- Accesso: è necessario l'accesso sudo senza password per l'utente di deployment perché l'automazione di Ansible deve eseguire attività amministrative (installazione di pacchetti, modifica delle configurazioni di sistema) senza essere bloccata da richieste di password.
- SSH: l'autenticazione basata su chiavi deve essere abilitata per consentire ad Ansible di connettersi alle VM di destinazione in modo sicuro e non interattivo.
Preparare il software della workstation locale
Per gestire il deployment e preparare gli artefatti air-gapped, dovrai installare un insieme di strumenti di automazione e containerizzazione sulla tua workstation locale.
- Ansible 2.17.0+: il motore di automazione che esegue i playbook e i ruoli di deployment.
- Docker: utilizzato per eseguire il pull e il packaging delle dipendenze del sistema operativo in un ambiente identico alle VM di destinazione (Ubuntu 22.04).
- Client PostgreSQL (
psql): necessario per eseguire le query di test e verificare la replica dei dati dalla workstation locale. Il repository Autobase:
- Clona il repository per accedere ai playbook e ai ruoli di automazione: https://github.com/vitabaks/autobase
Esegui il checkout di una release specifica (questa guida utilizza la versione 2.5.2):
git checkout 2.5.2I passaggi successivi di questa guida potrebbero variare se utilizzi una distribuzione diversa.
Per eseguire i playbook in questa guida, devi installare il codice sorgente
autobaselocale come raccolta Ansible in modo che i prefissi dei ruoli possano essere risolti:cd autobase/automation ansible-galaxy collection install . --force
Creare alcune variabili di ambiente
In questa guida, utilizzerai le seguenti variabili di ambiente per semplificare i comandi. Queste variabili memorizzano parametri critici come l'ID progetto, le zone di disponibilità delle VM, i relativi nomi host e le etichette utilizzate dal bilanciatore del carico per identificare il cluster. Impostali nella sessione della shell corrente con i valori effettivi per il tuo ambiente (assicurati che le zone siano separate da spazi).
Tieni presente che, anche se puoi impostare i nomi che preferisci per le VM, questa guida utilizza postgres-vm-1, postgres-vm-2 e postgres-vm-3 come nomi di esempio arbitrari per i nodi del cluster:
export PROJECT_ID="your-project-id"
export ZONES="zone1 zone2 zone3"
export VM1_NAME="postgres-vm-1"
export VM2_NAME="postgres-vm-2"
export VM3_NAME="postgres-vm-3"
export VM_LABEL="app=my-postgres-cluster"
export CLUSTER_NAME="my-postgres-cluster"
Configurare Ansible
Definisci l'ambiente VM nel file inventory.ini utilizzando il seguente modello:
[master]
postgres-vm-1 ansible_host=XX.XX.XX.XX hostname=postgres-vm-1 bind_address=XX.XX.XX.XX

[replica]
postgres-vm-2 ansible_host=XX.XX.XX.XX hostname=postgres-vm-2 bind_address=XX.XX.XX.XX
postgres-vm-3 ansible_host=XX.XX.XX.XX hostname=postgres-vm-3 bind_address=XX.XX.XX.XX

[postgres_cluster:children]
master
replica

[etcd_cluster]
postgres-vm-1
postgres-vm-2
postgres-vm-3

[all:vars]
ansible_user=...
ansible_ssh_private_key_file=~/.ssh/...
postgresql_version=17
with_haproxy_load_balancing=false
patroni_superuser_password=...
etcd_package_repo="file:///tmp/packages/etcd-v3.5.25-linux-amd64.tar.gz"
installation_method="packages"
install_postgresql_repo=false
install_timescale_repo=false
install_citus_repo=false
apt_repository=[]
yum_repository=[]
install_system_packages=false
patroni_installation_method=deb
Informazioni sulla configurazione:
[master]e[replica]: definiscono le VM del database primario e secondario. Assicurati di utilizzare i nomi delle VM effettivi impostati nelle variabili di ambienteVM1_NAME,VM2_NAMEeVM3_NAME.[postgres_cluster:children]: un gruppo che aggrega i nodi master e di replica, consentendo ad Ansible di indirizzare l'intero cluster di database con un singolo comando.[etcd_cluster]: definisce i nodi che parteciperanno al cluster di consenso etcd. Include tutti e tre i nodi del database per garantire l'alta disponibilità.ansible_host: (per ogni VM) l'IP in entrata esterno della VM utilizzato da Ansible per connettersi alla VM. SostituisciXX.XX.XX.XXcon l'IP esterno effettivo.bind_address: (per ogni VM) l'indirizzo IP interno della VM. SostituisciXX.XX.XX.XXcon l'IP interno effettivo.ansible_user: l'utente remoto utilizzato da Ansible per connettersi alle VM di destinazione con SSH. Sostituisci...con il nome utente effettivo.ansible_ssh_private_key_file: il percorso locale della chiave SSH privata utilizzata per l'autenticazione alle VM di destinazione. Sostituisci~/.ssh/...con il percorso effettivo.patroni_superuser_password: la password per l'utentepostgres. Assicurati di utilizzare una password efficace e sicura.with_haproxy_load_balancing=false: disattiva HAProxy locale perché utilizzi il bilanciatore del carico L4 nativo della piattaforma.etcd_package_repo: punta al percorso locale del file binario etcd all'interno della directory di bootstrap della VM.installation_method="packages": indica all'automazione di installare i componenti con i pacchetti del sistema operativo anziché compilare dal codice sorgente o utilizzare Python pip.install_..._repo=falsee_repository=[]: questi override impediscono ad Ansible di tentare di raggiungere internet per aggiungere repository esterni o aggiornare gli elenchi di pacchetti.install_system_packages=false: impedisce all'automazione di tentare di scaricare e installare i pacchetti di cui hai già eseguito il provisioning durante la fase di inizializzazione o bootstrap.patroni_installation_method=deb: indica in modo specifico al ruolo di utilizzare il pacchetto.debche hai installato.
Inizializzare le VM
Lo stack di database richiede diversi pacchetti e librerie del sistema operativo che potrebbero non essere inclusi nell'immagine Ubuntu di base. Poiché le VM si trovano in un ambiente air-gapped senza accesso a internet, non possono scaricare autonomamente queste dipendenze.
Per risolvere il problema:
Utilizza un container Docker sulla workstation locale per scaricare tutti i file necessari. Il seguente comando utilizza
apt-rdependsper identificare in modo ricorsivo ogni libreria condivisa e dipendenza richiesta dalle applicazioni di destinazione. Configura il repository PostgreSQL ufficiale all'interno del container per recuperare gli artefatti della versione 17, quindi scorre l'elenco delle dipendenze per scaricare i singoli file.debfiltrando le librerie di sistema principali (comelibc6ohostname) per evitare conflitti di versione sulle VM di destinazione. Infine, recupera il file binario etcd autonomo direttamente da GitHub.Innanzitutto, crea una directory per contenere i pacchetti:
mkdir -p ./packagesQuindi, esegui il comando Docker per scaricare tutti i pacchetti richiesti e il file binario etcd:
docker run --rm --platform linux/amd64 -v "$(pwd)/packages:/packages" \
  ubuntu:22.04 bash -c "
  set -e
  apt-get update
  apt-get install -y ca-certificates curl gnupg apt-rdepends

  # Add PostgreSQL Repository
  curl -fsSL https://www.postgresql.org/media/keys/ACCC4CF8.asc | \
    gpg --dearmor -o /etc/apt/trusted.gpg.d/postgresql.gpg
  echo 'deb http://apt.postgresql.org/pub/repos/apt jammy-pgdg main' > \
    /etc/apt/sources.list.d/pgdg.list
  apt-get update

  # Define Application Targets + Explicit dependencies needed for air-gap
  TARGETS='unzip tar pgbouncer patroni netdata postgresql-17 \
    postgresql-client-17 postgresql-contrib-17 \
    postgresql-server-dev-17 postgresql-17-dbgsym \
    python3-psycopg2 python3-click python3-yaml python3-prettytable \
    python3-urllib3 python3-tz python3-pip python3-setuptools \
    python3-cryptography moreutils vim jq acl zstd libjq1 \
    libpython3.10-stdlib libexpat1-dev zlib1g-dev libipc-run-perl \
    libtime-duration-perl libjson-perl libpython3-dev \
    libjs-sphinxdoc python3-wheel'

  # Resolve all recursive dependencies
  ALL_DEPS=\$(apt-cache depends --recurse --no-recommends --no-suggests \
    --no-conflicts --no-breaks --no-replaces --no-enhances \$TARGETS | \
    grep '^\w' | sort -u)

  cd /packages
  for pkg in \$ALL_DEPS; do
    if apt-cache show \"\$pkg\" > /dev/null 2>&1; then
      # Filter system core to avoid VM conflicts/breaks
      # We exclude core OS libraries (libc, systemd, etc.) because these
      # often cause version conflicts if the VM's patch level differs
      # from the online container.
      FILTER='base-files|debianutils|coreutils|findutils|diffutils|sed'
      FILTER+='|grep|gzip|hostname|ncurses|perl-base|libc6|binutils'
      FILTER+='|linux-libc|libc-bin|libc-dev-bin|systemd|dpkg|init'
      if [[ ! \"\$pkg\" =~ \$FILTER ]]; then
        apt-get download \"\$pkg\" || echo \"Failed \$pkg\"
      fi
    fi
  done

  # Download etcd binary
  if [ ! -f etcd-v3.5.25-linux-amd64.tar.gz ]; then
    curl -L https://github.com/etcd-io/etcd/releases/download/v3.5.25/\
etcd-v3.5.25-linux-amd64.tar.gz -o etcd-v3.5.25-linux-amd64.tar.gz
  fi
"
Utilizza Ansible per caricare l'archivio su tutte e tre le VM di destinazione contemporaneamente:
ansible all -i inventory.ini -m copy -a "src=packages.tar.gz dest=/tmp/" -bCancella tutti i dati dei pacchetti esistenti sulle VM ed estrai il nuovo file tar:
ansible all -i inventory.ini -m shell -a "rm -rf /tmp/packages && \
  mkdir -p /tmp/packages && tar -xzf /tmp/packages.tar.gz -C /tmp/packages" -b
Esegui un'installazione non interattiva di tutti i pacchetti
.debscaricati. Per evitare problemi con dipendenze preliminari specifiche in un ambiente air-gapped, utilizza il flag--force-dependsseguito daapt-get install -fyper risolvere l'albero delle dipendenze localmente:ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a dpkg -i --force-depends /tmp/packages/*.deb" -b ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a apt-get install -fy" -bArresta immediatamente tutti i servizi per impedire che vengano avviati con stati predefiniti e non configurati prima che l'automazione sia pronta:
ansible all -i inventory.ini -m shell -a \
  "systemctl stop patroni etcd pgbouncer postgresql || true" -b
Infine, rimuovi i cluster PostgreSQL predefiniti e tutti i dati etcd esistenti per consentire un'inizializzazione pulita:
ansible all -i inventory.ini -m shell -a \
  "pg_dropcluster 17 main --stop || true" -b
ansible all -i inventory.ini -m shell -a \
  "rm -rf /var/lib/postgresql/17/main/* /var/lib/etcd/default.etcd/*" -b
Eseguire il provisioning dell'infrastruttura di database
Ora che hai eseguito il bootstrap delle VM e configurato l'inventario, puoi utilizzare i playbook di automazione di Autobase con Ansible per eseguire il deployment dello stack PostgreSQL a disponibilità elevata.
Innanzitutto, esegui i controlli preflight per assicurarti che l'ambiente sia pronto:
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini \
  --tags pre_checks
Se i controlli vengono superati, procedi con il deployment completo:
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini
Output previsto: il playbook deve essere completato con un "PLAY RECAP" riuscito che mostra tutte le VM di destinazione raggiunte e aggiornate:
PLAY RECAP ********************************************************************
localhost                  : ok=1    changed=0    unreachable=0    failed=0    skipped=254  rescued=0    ignored=0
postgres-vm-1              : ok=160  changed=53   unreachable=0    failed=0    skipped=514  rescued=0    ignored=2
postgres-vm-2              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
postgres-vm-3              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
Verificare il deployment
Al termine del deployment, devi eseguire diversi controlli per assicurarti che tutti i componenti funzionino correttamente.
Controllare lo stato di alta disponibilità
Controlla lo stato del gestore di alta affidabilità per visualizzare i ruoli assegnati a ogni VM:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Output di esempio:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Verificare gli endpoint controllo di integrità
Verifica che Patroni identifichi correttamente il leader e le repliche utilizzando la relativa API REST.
Il controllo di integrità della VM leader deve restituire 200 OK, mentre i controlli di integrità delle VM di replica devono restituire 503 Service Unavailable:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM3_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
Verificare l'integrità delle singole VM
Controlla la preparazione di tutte le istanze PostgreSQL:
ansible postgres_cluster -i inventory.ini -m shell -a "pg_isready -p 5432" -b
Output di esempio:
postgres-vm-1 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-2 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-3 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections
Verificare l'integrità di etcd
Verifica l'integrità del livello di consenso su tutte le VM utilizzando localhost come endpoint:
ansible all -i inventory.ini -m shell -a "ETCDCTL_API=3 etcdctl \
  --endpoints=https://localhost:2379 \
  --cacert=/etc/etcd/tls/ca.crt \
  --cert=/etc/etcd/tls/server.crt \
  --key=/etc/etcd/tls/server.key \
  endpoint health" -b
Output di esempio:
postgres-vm-1 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 28.78311ms

postgres-vm-2 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 33.081265ms

postgres-vm-3 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 24.414291ms
Configurare il bilanciatore del carico globale
Per fornire un IP virtuale (VIP) stabile per lo stack di database, configura il
bilanciatore del carico L4 globale nativo della piattaforma utilizzando la gdcloud CLI.
Prerequisiti:
- Assicurati di disporre del ruolo
load-balancer-adminnel tuo progetto. Applica un'etichetta alle VM in modo che il bilanciatore del carico possa indirizzare correttamente le istanze che deve gestire (sostituisci i valori dei parametri
kubeconfigcon i filekubeconfigdell'API di gestione corrispondenti per ogni zona):kubectl --kubeconfig=ZONE_A_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM1_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_B_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM2_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_C_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM3_NAME} \ ${VM_LABEL}
- Assicurati di disporre del ruolo
Definisci il livello di accesso al bilanciamento del carico. Imposta
EXTERNALse devi connetterti dall'esterno della rete del progetto oINTERNALse l'accesso è richiesto solo dall'interno del VPC. Per questo tutorial, utilizzeremo una configurazione esterna:export LB_SCHEME=EXTERNALCrea un controllo di integrità. Il bilanciatore del carico utilizza l'API REST di Patroni per identificare il leader:
gdcloud compute health-checks create https ${CLUSTER_NAME}-hc \
  --project=${PROJECT_ID} \
  --port=8008 \
  --request-path="/primary" \
  --check-interval=10 \
  --timeout=5 \
  --healthy-threshold=2 \
  --unhealthy-threshold=3 \
  --global
Crea un backend zonale separato per ogni zona in cui si trovano le VM:
for zone in $(echo $ZONES); do
  gdcloud compute backends create ${CLUSTER_NAME}-backend-${zone} \
    --project=${PROJECT_ID} \
    --zone=${zone} \
    --labels="${VM_LABEL}"
done
Crea un servizio di backend globale:
gdcloud compute backend-services create ${CLUSTER_NAME}-bes \
  --project=${PROJECT_ID} \
  --health-check="${CLUSTER_NAME}-hc" \
  --global
Aggiungi i backend zonali al servizio globale:
for zone in $(echo $ZONES); do
  gdcloud compute backend-services add-backend ${CLUSTER_NAME}-bes \
    --project=${PROJECT_ID} \
    --backend=${CLUSTER_NAME}-backend-${zone} \
    --backend-zone=${zone} \
    --global
done
Crea una regola di forwarding globale (il VIP). Questa regola espone il database sulla porta
6432:gdcloud compute forwarding-rules create ${CLUSTER_NAME}-fr \ --project=${PROJECT_ID} \ --load-balancing-scheme=${LB_SCHEME} \ --backend-service=${CLUSTER_NAME}-bes \ --ip-protocol-port="TCP:6432" \ --globalRecupera l'indirizzo VIP:
LB_IP=$(gdcloud compute forwarding-rules describe ${CLUSTER_NAME}-fr \
  --project=${PROJECT_ID} \
  --load-balancing-scheme=${LB_SCHEME} \
  --global \
  --format=json \
  | jq -r '.metadata.annotations["networking.gke.io/forwardingRuleCIDR"]'  \
  | cut -d '/' -f 1)

echo "The load balancer IP is: ${LB_IP}"
Crea un
ProjectNetworkPolicy(PNP) per consentire il traffico in entrata alla porta PgBouncer (sostituisci il valore parametrokubeconfigcon il filekubeconfigdell'API globale del tuo ambiente).kubectl --kubeconfig=GLOBAL_API_KUBECONFIG apply -f - <<EOF apiVersion: networking.global.gdc.goog/v1 kind: ProjectNetworkPolicy metadata: name: allow-pgbouncer namespace: ${PROJECT_ID} spec: ingress: - ports: - port: 6432 protocol: TCP policyType: Ingress subject: subjectType: UserWorkload EOF
Verificare la replica dei dati
Per verificare che lo stack ad alta affidabilità funzioni come previsto, puoi creare dati di esempio sul leader e verificarne la presenza sulle repliche.
Inserire dati di esempio
L'automazione genera una password casuale per l'utente postgres durante il primo deployment se non ne viene fornita una in inventory.ini. Puoi recuperarla da qualsiasi VM:
export PG_PASSWORD=$(ansible master -i inventory.ini -m shell -a \
  "grep -A10 'authentication:' /etc/patroni/patroni.yml | \
  grep -A3 'superuser' | grep 'password:' | awk '{ print \$2 }'" -b | \
  tail -n 1)
echo $PG_PASSWORD
Connettiti al VIP del bilanciatore del carico sulla porta PgBouncer (6432) e crea una tabella di esempio:
PGPASSWORD="${PG_PASSWORD}" psql -h ${LB_IP} -p 6432 -U postgres -c "
  CREATE TABLE employees (first_name TEXT, last_name TEXT);
  INSERT INTO employees (first_name, last_name) VALUES ('John', 'Doe');
"
Output previsto:
INSERT 0 1
Verificare lo stato della replica
Esegui una query SELECT su tutte le VM per assicurarti che i dati siano stati replicati dal leader a tutte le repliche:
ansible postgres_cluster -i inventory.ini -m shell -a "psql -U postgres -c \
  'SELECT * FROM employees;'" -b
Output di esempio:
postgres-vm-1 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-2 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-3 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)
Testare il cambio manuale
Un cambio manuale ti consente di spostare con facilità il ruolo di leader su una VM candidata specifica. In genere, questa operazione viene eseguita per la manutenzione pianificata, gli upgrade software o per bilanciare l'utilizzo delle risorse tra le zone.
Identificare il leader corrente
Verifica il ruolo e lo stato attuali delle VM:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Output di esempio:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Eseguire il cambio
Attiva un cambio dal leader corrente a un'altra VM (in questo caso, rispettivamente da postgres-vm-1 a postgres-vm-2). Il comando utilizza --force per ignorare le richieste di conferma manuale:
ansible master -i inventory.ini -m shell -a "patronictl switchover \
  --leader ${VM1_NAME} --candidate ${VM2_NAME} --force" -b
Output di esempio:
Successfully switched over to "postgres-vm-2"
+ Cluster: postgres-cluster (7607933704953386478) -+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | stopped |    |     unknown |     |    unknown |     |
| postgres-vm-2 | 10.253.1.253 | Leader  | running |  1 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | running |  1 |   0/70000A0 |   0 |  0/70000A0 |   0 |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
Verificare lo spostamento del controllo di integrità
Dopo il cambio, verifica che lo stato del controllo di integrità sia stato spostato sul nuovo leader:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
Il vecchio leader (postgres-vm-1) deve restituire 503, mentre il nuovo leader (postgres-vm-2) deve restituire 200.
Testare il failover automatico
A differenza di un cambio manuale, un failover automatico si verifica quando la VM leader non è più disponibile. Questo test conferma che Patroni elegge un nuovo leader e il bilanciatore del carico reindirizza il traffico senza intervento manuale. Supponiamo che postgres-vm-2 sia il leader corrente dopo il cambio manuale eseguito in precedenza.
Identificare il leader corrente
Verifica il ruolo e lo stato attuali delle VM:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Output di esempio:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
| postgres-vm-2 | 10.253.1.253 | Leader  | running   |  2 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Simulare un guasto della VM
Arresta il servizio patroni sulla VM leader per simulare un arresto anomalo o un guasto grave:
ansible master -i inventory.ini -m shell -a "systemctl stop patroni" -b
Osservare la nuova elezione
Attendi 10-20 secondi e controlla lo stato da un'altra VM per visualizzare la promozione di un nuovo leader:
ansible replica -i inventory.ini -m shell -a "patronictl list" -b
Output di esempio:
postgres-vm-3 | CHANGED | rc=0 >>
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  3 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | stopped   |    |     unknown |     |    unknown |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  3 |   0/90003F8 |   0 |  0/90003F8 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Dovresti vedere che una delle altre VM (postgres-vm-1 o postgres-vm-3) è diventata il leader e la vecchia VM leader (postgres-vm-2) è contrassegnata come arrestata.
Verificare lo spostamento del controllo di integrità
Verifica che i controlli di integrità del bilanciatore del carico identifichino correttamente il nuovo leader eletto:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
Il nuovo leader deve restituire 200 OK.
Recuperare la VM non riuscita
Riavvia il servizio patroni sulla VM originale per consentirle di rientrare nello stack come replica e recuperare tutti i dati mancanti:
ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "systemctl start patroni" -b