


אם נתקלתם בבעיות בצינור עיבוד הנתונים או במשימה ב-Dataflow, בדף הזה מפורטות הודעות השגיאה שעשויות להופיע והצעות לפתרון כל שגיאה.
שגיאות בסוגי היומנים dataflow.googleapis.com/worker-startup, dataflow.googleapis.com/harness-startup ו-dataflow.googleapis.com/kubelet מצביעות על בעיות בהגדרת המשימה. הם יכולים גם להצביע על תנאים שמונעים את הפעולה של נתיב הרישום הרגיל ביומן.
יכול להיות שצינור עיבוד הנתונים יקפיץ חריגות בזמן עיבוד הנתונים. חלק מהשגיאות האלה הן זמניות, למשל כשמתרחש קושי זמני בגישה לשירות חיצוני. חלק מהשגיאות האלה הן קבועות, כמו שגיאות שנגרמות בגלל נתוני קלט פגומים או שלא ניתנים לניתוח, או מצביעים מסוג null במהלך החישוב.
Dataflow מעבד רכיבים בחבילות שרירותיות ומנסה שוב את כל החבילה כשנזרקת שגיאה לגבי רכיב כלשהו בחבילה. כשמפעילים במצב אצווה, המערכת מנסה שוב ארבע פעמים לשלוח חבילות שכוללות פריט שנכשל. הצינור נכשל לחלוטין כשחבילה אחת נכשלת ארבע פעמים. כשמפעילים במצב סטרימינג, מתבצע ניסיון חוזר ללא הגבלה על חבילה שכוללת פריט שנכשל, מה שעלול לגרום לצינור עיבוד הנתונים להיתקע באופן סופי.
חריגות בקוד המשתמש, למשל במכונות DoFn, מדווחות בממשק המעקב של Dataflow. אם מריצים את הצינור באמצעות BlockingDataflowPipelineRunner, הודעות השגיאה מופיעות גם בחלון הטרמינל או במסוף.
כדי למנוע שגיאות בקוד, כדאי להוסיף מטפלים בחריגים. לדוגמה, אם רוצים להשמיט רכיבים שנכשלו באימות קלט בהתאמה אישית שבוצע ב-ParDo, צריך להשתמש בבלוק try/catch בתוך ה-ParDo כדי לטפל בחריגה, לתעד אותה ביומן ולהשמיט את הרכיב. בעומסי עבודה בסביבת הייצור, כדאי להטמיע דפוס של הודעות שלא עובדו. כדי לעקוב אחרי מספר השגיאות, משתמשים בטרנספורמציות צבירה.
קבצי יומן חסרים
אם לא מופיעים יומנים של המשימות, צריך להסיר את כל מסנני ההחרגה שמכילים את resource.type="dataflow_step" מכל הכיורים של נתב היומנים ב-Cloud Logging.
לפרטים נוספים על הסרת החרגות של יומנים, עיינו במדריך הסרת החרגות.
כפילויות בפלט
כשמריצים משימת Dataflow, הפלט מכיל רשומות כפולות.
הבעיה הזו יכולה לקרות כשמשימת Dataflow משתמשת במצב סטרימינג של צינור עיבוד נתונים לפחות פעם אחת. במצב הזה, הרשומות מעובדות לפחות פעם אחת. עם זאת, במצב הזה יכולות להיות רשומות כפולות.
אם תהליך העבודה שלכם לא יכול לסבול רשומות כפולות, השתמשו במצב הסטרימינג "בדיוק פעם אחת". המצב הזה עוזר לוודא שרשומות לא נמחקות או משוכפלות כשהנתונים עוברים בצינור עיבוד הנתונים.
כדי לבדוק באיזה מצב סטרימינג המשימה משתמשת, קראו את המאמר הצגת מצב הסטרימינג של משימה.
למידע נוסף על מצבי סטרימינג, ראו הגדרת מצב הסטרימינג של צינור עיבוד הנתונים.
שגיאות בצינור עיבוד הנתונים
בקטעים הבאים מפורטות שגיאות נפוצות בצינורות עיבוד נתונים, ומוסבר איך לפתור אותן.
צריך להפעיל חלק מממשקי ה-API של Cloud
כשמנסים להריץ משימה ב-Dataflow, מופיעה השגיאה הבאה:
Some Cloud APIs need to be enabled for your project in order for Cloud Dataflow to run this job.
הבעיה הזו מתרחשת כי חלק מממשקי ה-API הנדרשים לא מופעלים בפרויקט.
כדי לפתור את הבעיה ולהריץ משימת Dataflow, צריך להפעיל בפרויקט את ממשקי ה-API הבאים שלGoogle Cloud :
- Compute Engine API (Compute Engine)
- Cloud Logging API
- Cloud Storage
- Cloud Storage JSON API
- BigQuery API
- Pub/Sub
- Datastore API
הוראות מפורטות להפעלת ממשקי API של Google Cloud מופיעות בקטע תחילת העבודה .
הערכים "@*" ו-"@N" הם מפרטי פיצול שמורים
כשמנסים להריץ משימה, השגיאה הבאה מופיעה בקובצי היומן והמשימה נכשלת:
Workflow failed. Causes: "@*" and "@N" are reserved sharding specs. Filepattern must not contain any of them.
השגיאה הזו מתרחשת אם שם הקובץ של הנתיב ב-Cloud Storage לקבצים זמניים (tempLocation או temp_location) מכיל את הסימן כרוכית (@) ואחריו מספר או כוכבית (*).
כדי לפתור את הבעיה, צריך לשנות את שם הקובץ כך שאחרי הסימן "כרוכית" יופיע תו נתמך.
בקשה פגומה
כשמריצים משימה ב-Dataflow, ביומנים של Cloud Monitoring מופיעה סדרה של אזהרות שדומות לאזהרות הבאות:
Unable to update setup work item STEP_ID error: generic::invalid_argument: Http(400) Bad Request
Update range task returned 'invalid argument'. Assuming lost lease for work with id LEASE_ID
with expiration time: TIMESTAMP, now: TIMESTAMP. Full status: generic::invalid_argument: Http(400) Bad Request
אזהרות לגבי בקשות שגויות מופיעות אם המידע על מצב ה-worker לא עדכני או לא מסונכרן בגלל עיכובים בעיבוד. בדרך כלל, משימת Dataflow תצליח למרות האזהרות על בקשות שגויות. במקרה כזה, אפשר להתעלם מהאזהרות.
אי אפשר לקרוא ולכתוב במיקומים שונים
כשמריצים משימה ב-Dataflow, יכול להיות שתופיע השגיאה הבאה בקובצי היומן:
message:Cannot read and write in different locations: source: SOURCE_REGION, destination: DESTINATION_REGION,reason:invalid
השגיאה הזו מתרחשת כשהמקור והיעד נמצאים באזורים שונים. היא יכולה להתרחש גם כשמיקום ה-staging והיעד נמצאים באזורים שונים. לדוגמה, אם המשימה קוראת מ-Pub/Sub ואז כותבת לקטגוריה של Cloud Storage temp לפני הכתיבה לטבלה ב-BigQuery, הקטגוריה של Cloud Storage temp והטבלה ב-BigQuery צריכות להיות באותו אזור.
מיקומים במספר אזורים נחשבים שונים ממיקומים באזור יחיד, גם אם האזור היחיד נמצא בטווח של המיקום במספר אזורים.
לדוגמה, us (multiple regions in the United States) ו-us-central1 הם אזורים שונים.
כדי לפתור את הבעיה, צריך להגדיר את מיקומי היעד, המקור וההכנה באותו אזור. אי אפשר לשנות את המיקומים של הקטגוריות של Cloud Storage, ולכן יכול להיות שתצטרכו ליצור קטגוריה חדשה של Cloud Storage באזור הנכון.
תם הזמן הקצוב לתפוגה של החיבור
כשמריצים משימה ב-Dataflow, יכול להיות שתופיע השגיאה הבאה בקובצי היומן:
org.springframework.web.client.ResourceAccessException: I/O error on GET request for CONNECTION_PATH: Connection timed out (Connection timed out); nested exception is java.net.ConnectException: Connection timed out (Connection timed out)
הבעיה הזו מתרחשת כש-Dataflow workers לא מצליחים ליצור או לשמור על חיבור עם מקור הנתונים או היעד.
כדי לפתור את הבעיה, צריך לבצע את השלבים הבאים:
- מוודאים שמקור הנתונים פועל.
- מוודאים שהיעד פועל.
- בודקים את פרמטרי החיבור שבהם משתמשים בהגדרת צינור עיבוד הנתונים ב-Dataflow.
- מוודאים שבעיות בביצועים לא משפיעות על המקור או על היעד.
- מוודאים שכללי חומת האש לא חוסמים את החיבור.
אין אובייקט כזה
כשמריצים משימות ב-Dataflow, יכול להיות שתופיע השגיאה הבאה בקובצי היומן:
..., 'server': 'UploadServer', 'status': '404'}>, <content <No such object:...
השגיאות האלה בדרך כלל קורות כשחלק ממשימות Dataflow שפועלות משתמשות באותו temp_location כדי להעביר קובצי משימות זמניים שנוצרו כשהצינור פועל. כשכמה משימות בו-זמניות משתפות את אותו temp_location, הן עלולות לדרוס את הנתונים הזמניים אחת של השנייה, ועלול להתרחש מרוץ תהליכים. כדי למנוע את הבעיה, מומלץ להשתמש ב-temp_location ייחודי לכל משימה.
ל-Dataflow אין אפשרות לקבוע את צבר המשימות
כשמריצים פייפליין זורם מ-Pub/Sub, מופיעה האזהרה הבאה:
Dataflow is unable to determine the backlog for Pub/Sub subscription
כשצינור עיבוד נתונים ב-Dataflow שולף נתונים מ-Pub/Sub, Dataflow צריך לבקש שוב ושוב מידע מ-Pub/Sub. המידע הזה כולל את כמות ההודעות בצבר המשימות במינוי ואת הגיל של ההודעה הישנה ביותר שלא אושרה. לפעמים, בגלל בעיות פנימיות במערכת, Dataflow לא מצליח לאחזר את המידע הזה מ-Pub/Sub, מה שעלול לגרום להצטברות זמנית של צבר משימות.
למידע נוסף, קראו את המאמר סטרימינג באמצעות Cloud Pub/Sub.
DEADLINE_EXCEEDED או Server Unresponsive (השרת לא מגיב)
כשמריצים את המשימות, יכול להיות שתיתקלו בחריגות של זמן קצוב לתפוגה של RPC או באחת מהשגיאות הבאות:
DEADLINE_EXCEEDED
או:
Server Unresponsive
השגיאות האלה בדרך כלל מתרחשות בגלל אחת מהסיבות הבאות:
יכול להיות שברשת של הענן הווירטואלי הפרטי (VPC) שמשמשת למשימה חסר כלל חומת אש. כלל חומת האש צריך לאפשר את כל תעבורת הנתונים ב-TCP בין המכונות הווירטואליות ברשת ה-VPC שציינתם באפשרויות של הצינור. מידע נוסף על כללים של חומת אש ב-Dataflow
במקרים מסוימים, ה-workers לא יכולים לתקשר זה עם זה. כשמריצים משימת Dataflow שלא משתמשת ב-Dataflow Shuffle או ב-Streaming Engine, ה-workers צריכים לתקשר זה עם זה באמצעות יציאות TCP
12345ו-12346בתוך רשת ה-VPC. במקרה כזה, השגיאה כוללת את שם ה-worker harness ואת יציאת ה-TCP החסומה. השגיאה נראית כמו אחת מהדוגמאות הבאות:DEADLINE_EXCEEDED: (g)RPC timed out when SOURCE_WORKER_HARNESS talking to DESTINATION_WORKER_HARNESS:12346.Rpc to WORKER_HARNESS:12345 completed with error UNAVAILABLE: failed to connect to all addresses Server unresponsive (ping error: Deadline Exceeded, UNKNOWN: Deadline Exceeded...)כדי לפתור את הבעיה, משתמשים בדגל rules של
gcloud compute firewall-rules createכדי לאפשר תנועה ברשת ליציאות12345ו-12346. הדוגמה הבאה ממחישה את הפקודה של Google Cloud CLI:gcloud compute firewall-rules create FIREWALL_RULE_NAME \ --network NETWORK \ --action allow \ --direction IN \ --target-tags dataflow \ --source-tags dataflow \ --priority 0 \ --rules tcp:12345-12346מחליפים את מה שכתוב בשדות הבאים:
-
FIREWALL_RULE_NAME: השם של כלל חומת האש -
NETWORK: השם של הרשת
-
העבודה שלכם מוגבלת על ידי Shuffle.
כדי לפתור את הבעיה, צריך לבצע אחד או יותר מהשינויים הבאים.
Java
- אם המשימה לא משתמשת בארגון נתונים מבוסס-שירות, צריך לעבור לשימוש בארגון נתונים של Dataflow מבוסס-שירות על ידי הגדרת
--experiments=shuffle_mode=service. לפרטים ולזמינות, ראו ארגון נתונים של Dataflow. - הוספת עוד עובדים. נסו להגדיר ערך גבוה יותר ל-
--numWorkersכשאתם מריצים את הצינור. - הגדלת הדיסק המצורף ל-workers. נסו להגדיר ערך גבוה יותר ל-
--diskSizeGbכשאתם מריצים את הצינור. - שימוש ב-Persistent Disk שמבוסס על SSD. נסו להגדיר את
--workerDiskType="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"כשאתם מריצים את צינור עיבוד הנתונים.
Python
- אם המשימה לא משתמשת בארגון נתונים מבוסס-שירות, צריך לעבור לשימוש בארגון נתונים של Dataflow מבוסס-שירות על ידי הגדרת
--experiments=shuffle_mode=service. לפרטים ולזמינות, ראו ארגון נתונים של Dataflow. - הוספת עוד עובדים. נסו להגדיר ערך גבוה יותר ל-
--num_workersכשאתם מריצים את צינור עיבוד הנתונים. - הגדלת הדיסק המצורף ל-workers. נסו להגדיר ערך גבוה יותר ל-
--disk_size_gbכשאתם מריצים את הצינור. - שימוש ב-Persistent Disk שמבוסס על SSD. נסו להגדיר את
--worker_disk_type="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"כשאתם מריצים את צינור עיבוד הנתונים.
המשך
- אם המשימה לא משתמשת בארגון נתונים מבוסס-שירות, צריך לעבור לשימוש בארגון נתונים של Dataflow מבוסס-שירות על ידי הגדרת
--experiments=shuffle_mode=service. לפרטים ולזמינות, ראו ארגון נתונים של Dataflow. - הוספת עוד עובדים. נסו להגדיר ערך גבוה יותר ל-
--num_workersכשאתם מריצים את צינור עיבוד הנתונים. - הגדלת הדיסק המצורף ל-workers. נסו להגדיר ערך גבוה יותר ל-
--disk_size_gbכשאתם מריצים את הצינור. - שימוש ב-Persistent Disk שמבוסס על SSD. נסו להגדיר את
--disk_type="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"כשאתם מריצים את צינור עיבוד הנתונים.
- אם המשימה לא משתמשת בארגון נתונים מבוסס-שירות, צריך לעבור לשימוש בארגון נתונים של Dataflow מבוסס-שירות על ידי הגדרת
הוחזר פיצול ריק
כשמריצים משימת Dataflow, יכול להיות שתופיע ההודעה הבאה ביומני ה-worker:
Continuing to process work-id WORK_ID without splitting. Reader split status was: INTERNAL: Empty split returned and SDK split status was: ...
אם המשימה פועלת כמו שצריך, ההודעה הזו לא מזיקה ואפשר להתעלם ממנה. ההודעה הזו יכולה להופיע בגלל מרוץ תהליכים שבו השירות מנסה לפצל עבודה שכבר הושלמה.
שגיאות קידוד, שגיאות IOException או התנהגות לא צפויה בקוד המשתמש
ערכות ה-SDK של Apache Beam וה-workers של Dataflow תלויים ברכיבים נפוצים של צד שלישי. הרכיבים האלה מייבאים רכיבי תלות נוספים. התנגשויות בין גרסאות עלולות לגרום להתנהגות לא צפויה בשירות. בנוסף, חלק מהספריות לא תואמות לגרסאות קודמות. יכול להיות שתצטרכו להצמיד לגרסאות שברשימה שנמצאות בהיקף במהלך ההפעלה. בקטע SDK and Worker Dependencies מפורטות התלויות והגרסאות הנדרשות שלהן.
סוג המכונה מחייב שימוש בסוג הדיסק Hyperdisk Balanced
כשמנסים להריץ משימה ב-Dataflow, מופיעה השגיאה הבאה:
MACHINE_TYPE machine types require the Hyperdisk Balanced disk type.
הבעיה הזו מתרחשת כשמשתמשים בסוג מכונה שדורש דיסקים מסוג Hyperdisk Balanced, כמו C4A או N4, אבל מציינים סוג דיסק לא תואם, כמו pd-standard.
כדי לפתור את הבעיה, אם אתם משתמשים בסוג מכונה שדורש דיסקים מסוג Hyperdisk Balanced, אל תציינו את האפשרות workerDiskType (worker_disk_type ב-Python, disk_type ב-Go) של הצינור, או הגדירו אותה ל-hyperdisk-balanced.
שגיאה בהפעלת LookupEffectiveGuestPolicies
כשמריצים משימה ב-Dataflow, יכול להיות שתופיע השגיאה הבאה בקובצי היומן:
OSConfigAgent Error policies.go:49: Error running LookupEffectiveGuestPolicies:
error calling LookupEffectiveGuestPolicies: code: "Unauthenticated",
message: "Request is missing required authentication credential.
Expected OAuth 2 access token, login cookie or other valid authentication credential.
השגיאה הזו מתרחשת אם ניהול הגדרות מערכת ההפעלה מופעל בכל הפרויקט.
כדי לפתור את הבעיה, צריך להשבית את כללי המדיניות של VM Manager שחלים על כל הפרויקט. אם אי אפשר להשבית את כללי המדיניות של VM Manager בכל הפרויקט, אפשר להתעלם מהשגיאה הזו ולסנן אותה מכלים למעקב אחרי יומנים.
הפרה של אילוץ הגישה לכתובת IP חיצונית
כשמריצים או משכפלים משימת Dataflow, מתקבלת השגיאה הבאה:
Constraint constraints/compute.vmExternalIpAccess violated for project PROJECT_ID.
השגיאה הזו מתרחשת כשאילוץ של מדיניות הארגון אוסר על מכונות וירטואליות להשתמש בכתובות IP חיצוניות, אבל משימת Dataflow מוגדרת להשתמש בכתובות IP חיצוניות.
כדי לפתור את הבעיה, מגדירים במפורש את המשימה כך שתשתמש רק בכתובות IP פנימיות:
- במסוף Google Cloud : ברשימה Worker IP Address Configuration בוחרים באפשרות Private.
- באמצעות ה-SDK: מגדירים את
--usePublicIps=falseהאפשרות pipeline.
מידע נוסף זמין במאמר השבתת כתובות IP חיצוניות.
סביבת זמן הריצה של Java זיהתה שגיאה חמורה
השגיאה הבאה מתרחשת במהלך הפעלת ה-worker:
A fatal error has been detected by the Java Runtime Environment
השגיאה הזו מתרחשת אם הצינור משתמש ב-Java Native Interface (JNI) כדי להריץ קוד שאינו Java, והקוד הזה או קישורי ה-JNI מכילים שגיאה.
שגיאה במפתח המאפיין googclient_deliveryattempt
משימת Dataflow נכשלת עם אחת מהשגיאות הבאות:
The request contains an attribute key that is not valid (key=googclient_deliveryattempt). Attribute keys must be non-empty and must not begin with 'goog' (case-insensitive).
או:
Invalid extensions name: googclient_deliveryattempt
השגיאה הזו מתרחשת כשלמשימת Dataflow יש את המאפיינים הבאים:
- המשימה ב-Dataflow משתמשת במנוע סטרימינג.
- לצינור עיבוד הנתונים יש כיור Pub/Sub.
- צינור עיבוד הנתונים משתמש במינוי שליפה.
- בצינור עיבוד הנתונים נעשה שימוש באחד מממשקי ה-API של שירות Pub/Sub כדי לפרסם הודעות, במקום להשתמש ב-sink המובנה של Pub/Sub I/O.
- Pub/Sub משתמש בספריית הלקוח של Java או של# C.
- למינוי ל-Pub/Sub יש נושא להודעות ללא מוצא.
השגיאה הזו קורית כי כשמשתמשים בספריית הלקוח של Pub/Sub ב-Java או ב-#C, ומופעל נושא להודעות ללא מוצא במינוי, ניסיונות השליחה נמצאים במאפיין ההודעה googclient_deliveryattempt במקום בשדה delivery_attempt. מידע נוסף זמין בקטע מעקב אחרי ניסיונות מסירה בדף "טיפול בהודעות שנכשלו".
כדי לעקוף את הבעיה, אפשר לבצע אחד או יותר מהשינויים הבאים.
- השבתת Streaming Engine.
- משתמשים במחבר המובנה של
PubSubIOApache Beam במקום ב-API של שירות Pub/Sub. - להשתמש בסוג אחר של מינוי Pub/Sub.
- הסרת הנושא להודעות ללא מוצא.
- אל תשתמשו בספריית הלקוח של Java או של C# עם מינוי שליפה של Pub/Sub. לאפשרויות אחרות, ראו דוגמאות קוד של ספריית לקוח.
- בקוד של צינור עיבוד הנתונים, כשמפתחות המאפיינים מתחילים ב-
goog, צריך למחוק את מאפייני ההודעות לפני שמפרסמים את ההודעות.
זוהה מפתח חם ...
השגיאה הבאה מתרחשת:
A hot key HOT_KEY_NAME was detected in...
השגיאות האלה קורות אם הנתונים מכילים מפתח חם. מפתח חם הוא מפתח עם מספיק רכיבים כדי להשפיע לרעה על הביצועים של צינור עיבוד הנתונים. המפתחות האלה מגבילים את היכולת של Dataflow לעבד רכיבים במקביל, מה שמאריך את זמן הביצוע.
כדי להדפיס את המפתח הקריא לאנשים ביומנים כשמזוהה מפתח חם בצינור עיבוד הנתונים, משתמשים באפשרות של צינור עיבוד הנתונים של המפתח החם.
כדי לפתור את הבעיה, צריך לוודא שהנתונים מפוזרים באופן שווה. אם למפתח יש מספר לא פרופורציונלי של ערכים, כדאי לשקול את הפעולות הבאות:
- הצפנה מחדש של הנתונים. מפעילים טרנספורמציה מסוג
ParDoכדי להפיק צמדי מפתח/ערך חדשים. - במשימות ב-Java, משתמשים בטרנספורמציה
Combine.PerKey.withHotKeyFanout. - במשימות Python, משתמשים בטרנספורמציה
CombinePerKey.with_hot_key_fanout. - מפעילים את ארגון הנתונים של Dataflow.
כדי לראות מפתחות חמים בממשק המעקב של Dataflow, קראו את המאמר פתרון בעיות של משימות איטיות במשימות באצווה.
תרשים המשימה גדול מדי
יכול להיות שהמשימה תיכשל ותופיע השגיאה הבאה:
The job graph is too large. Please try again with a smaller job graph,
or split your job into two or more smaller jobs.
השגיאה הזו מתרחשת אם גודל התרשים של המשימה חורג מ-10MB. תנאים מסוימים בצינור עיבוד הנתונים יכולים לגרום לתרשים המשימות לחרוג מהמגבלה. דוגמאות למצבים נפוצים:
- טרנספורמציה של
Createשכוללת כמות גדולה של נתונים בזיכרון. - מכונה גדולה של
DoFnשעוברת סריאליזציה כדי לשלוח אותה לעובדים מרוחקים. DoFnכמופע של מחלקה פנימית אנונימית שמושך (אולי בטעות) כמות גדולה של נתונים שצריך להעביר בסדרתיות.- גרף אציקלי מכוון (DAG) משמש כחלק מלולאה פרוגרמטית שממפה רשימה גדולה.
כדי להימנע מהתנאים האלה, כדאי לשנות את המבנה של צינור עיבוד הנתונים.
ה-commit של המפתח גדול מדי
כשמריצים משימת סטרימינג, השגיאה הבאה מופיעה בקובצי היומן של ה-worker:
KeyCommitTooLargeException
השגיאה הזו מתרחשת בתרחישי סטרימינג בכל פעם שפריט עבודה ספציפי חורג מהגודל המקסימלי של commit. מידע נוסף על מגבלות גודל ה-commit זמין במאמר מכסות ומגבלות.
אם ה-commit חורג מהמגבלה, Dataflow דוחה אותו, מציג את השגיאה KeyCommitTooLargeException ביומני ה-worker ומנסה לעבד מחדש את פריט העבודה באמצעות גודל חבילה התחלתי קטן יותר (חיתוך חבילה):
- חריגות זמניות (קיטוע החבילה מצליח): אם אפשר לפצל את החבילה ל-commits קטנים יותר שהפלט שלהם לא חורג מהמגבלה, יכול להיות שתופיע שגיאת
KeyCommitTooLargeExceptionאחת או שגיאות לא תכופות לפני שהצינור ימשיך להתקדם. עם זאת, מהירות העיבוד יורדת באופן זמני בגלל ניסיונות חוזרים באמצעות חבילות קטנות יותר. - חריגות מתמשכות (עיכובים בעיבוד מפתחות): אם גודל החבילה ההתחלתית מצטמצם עד להודעת קלט או טיימר בודדים, והפלט שנוצר או השינוי במצב עדיין חורגים ממגבלת השמירה, אי אפשר לפצל יותר את פריט העבודה. בגלל ש-Dataflow מנסה שוב ושוב לבצע את ה-commit ונכשל, העיבוד של המפתח הזה נעצר לחלוטין, וביומני ה-worker מופיעים מקרים חוזרים ורציפים של
KeyCommitTooLargeExceptionשלא נפתרים מעצמם.
אסטרטגיות לצמצום הפגיעה
כדי להפחית את הסיכוי להיתקל בשגיאה הזו, אפשר להשתמש באסטרטגיות הבאות:
- חשוב לוודא שעיבוד של רכיב או חלון בודד לא יכול לגרום לפלט או לשינויים במצב שחורגים ממגבלת הגודל של ה-commit. לדוגמה, אם טרנספורמציה מקבלת רכיבי קלט קטנים יחסית ומחזירה פלט גדול בהרבה – כמו קריאת שם קובץ והפקת כל התוכן של קובץ גדול – הפלט שיתקבל יכול לחרוג ממגבלת הגודל של ה-commit, גם כשמעבדים רק רכיב קלט אחד.
- אם כמה רכיבים מקובצים לפי מפתח בלי להשתמש בטרנספורמציה
Combine, כדאי להגדיל את מרחב המפתחות (לדוגמה, על ידי הוספת קטגוריות זמן או מזהים משניים) כדי להפחית את מספר הרכיבים שמקובצים לפי מפתח. - אם אלמנטים של מפתח מסוים נפלטים בתדירות גבוהה בפרק זמן קצר, יכול להיות שייווצרו הרבה אירועים בנפח של ג'יגה-בייט למפתח הזה בחלון. משכתבים את צינור עיבוד הנתונים כדי לזהות מפתחות בתדירות גבוהה, ורק פולטים פלט שמציין שהמפתח היה קיים בתדירות גבוהה בחלון הזה.
- משתמשים בטרנספורמציות של מרחב תת-לינארי
Combineלפעולות חילופיות ואסוציאטיביות. אל תשתמשו בפונקציית combiner אם היא לא מקטינה את גודל הנתונים. לדוגמה, אם משתמשים בפונקציית combiner למחרוזות שמוסיפה מחרוזות זו לזו, עדיף לא להשתמש בפונקציית combiner בכלל.
ההודעה נדחתה כי היא גדולה מ-7,168K
כשמריצים משימת Dataflow שנוצרה מתבנית, יכול להיות שהמשימה תיכשל ותופיע הודעת השגיאה הבאה:
Error: CommitWork failed: status: APPLICATION_ERROR(3): Pubsub publish requests are limited to 10MB, rejecting message over 7168K (size MESSAGE_SIZE) to avoid exceeding limit with byte64 request encoding.
השגיאה הזו מתרחשת כשההודעות שנכתבות לתור ההודעות שלא נמסרו חורגות ממגבלת הגודל של 7,168K. כדי לעקוף את הבעיה, אפשר להפעיל את Streaming Engine, שבו מגבלת הגודל גבוהה יותר. כדי להפעיל את Streaming Engine, משתמשים באפשרות הבאה של צינור עיבוד הנתונים.
Java
--enableStreamingEngine=true
Python
--enable_streaming_engine=true
גוף הבקשה גדול מדי
כששולחים את המשימה, אחת מהשגיאות הבאות מופיעה במסוף או בחלון הטרמינל:
413 Request Entity Too Large
The size of serialized JSON representation of the pipeline exceeds the allowable limit
Failed to create a workflow job: Invalid JSON payload received
Failed to create a workflow job: Request payload exceeds the allowable limit
אם אתם נתקלים בשגיאה לגבי המטען הייעודי (payload) של ה-JSON כשאתם שולחים את המשימה, הייצוג של הצינור ב-JSON חורג מגודל הבקשה המקסימלי של 20MB.
גודל המשימה קשור לייצוג ה-JSON של צינור עיבוד הנתונים. צינור עיבוד נתונים גדול יותר פירושו בקשה גדולה יותר. ב-Dataflow יש מגבלה של 20MB על בקשות.
כדי להעריך את הגודל של בקשת ה-JSON של צינור עיבוד הנתונים, מריצים את צינור עיבוד הנתונים עם האפשרות הבאה:
Java
--dataflowJobFile=PATH_TO_OUTPUT_FILE
Python
--dataflow_job_file=PATH_TO_OUTPUT_FILE
המשך
פלט של המשימה כ-JSON לא נתמך ב-Go.
הפקודה הזו כותבת ייצוג JSON של המשימה לקובץ. גודל הקובץ שעבר סריאליזציה הוא אומדן טוב לגודל הבקשה. הגודל בפועל מעט גדול יותר בגלל מידע נוסף שנכלל בבקשה.
תנאים מסוימים בצינור עיבוד הנתונים יכולים לגרום לייצוג ה-JSON לחרוג מהמגבלה. התנאים הנפוצים כוללים:
- טרנספורמציה של
Createשכוללת כמות גדולה של נתונים בזיכרון. - מכונה גדולה של
DoFnשעוברת סריאליזציה כדי לשלוח אותה לעובדים מרוחקים. DoFnכמופע של מחלקה פנימית אנונימית שמושך (אולי בטעות) כמות גדולה של נתונים לסריאליזציה.
כדי להימנע מהתנאים האלה, כדאי לשנות את המבנה של צינור עיבוד הנתונים.
אפשרויות צינור עיבוד הנתונים של ה-SDK או רשימת קובצי ה-staging חורגות ממגבלת הגודל
כשמריצים צינור עיבוד נתונים, מתרחשת אחת מהשגיאות הבאות:
SDK pipeline options or staging file list exceeds size limit.
Please keep their length under 256K Bytes each and 512K Bytes in total.
או:
Value for field 'resource.properties.metadata' is too large: maximum size
השגיאות האלה מתרחשות אם אי אפשר להפעיל את צינור עיבוד הנתונים בגלל חריגה ממגבלות המטא-נתונים של Compute Engine. אי אפשר לשנות את המגבלות האלה. Dataflow משתמש במטא-נתונים של Compute Engine לאפשרויות של צינור עיבוד הנתונים. המגבלה מתועדת במגבלות המטא-נתונים בהתאמה אישית של Compute Engine.
התרחישים הבאים יכולים לגרום לייצוג ב-JSON לחרוג מהמגבלה:
- יש יותר מדי קובצי JAR להעברה.
- השדה
sdkPipelineOptionsבבקשה גדול מדי.
כדי להעריך את הגודל של בקשת ה-JSON של צינור עיבוד הנתונים, מריצים את צינור עיבוד הנתונים עם האפשרות הבאה:
Java
--dataflowJobFile=PATH_TO_OUTPUT_FILE
Python
--dataflow_job_file=PATH_TO_OUTPUT_FILE
המשך
פלט של המשימה כ-JSON לא נתמך ב-Go.
גודל קובץ הפלט של הפקודה הזו צריך להיות קטן מ-256KB. הגודל 512KB בהודעת השגיאה מתייחס לגודל הכולל של קובץ הפלט ולאפשרויות המטא-נתונים בהתאמה אישית של המכונה הווירטואלית ב-Compute Engine.
כדי לקבל הערכה גסה של האפשרות "מטא-נתונים בהתאמה אישית" למכונה וירטואלית, אפשר להריץ משימות Dataflow בפרויקט. בוחרים משימת Dataflow שפועלת. בוחרים מכונה וירטואלית, נכנסים לדף הפרטים של המכונה הווירטואלית ב-Compute Engine ובודקים את הקטע של המטא-נתונים בהתאמה אישית. הגודל הכולל של המטא-נתונים בהתאמה אישית והקובץ צריך להיות פחות מ-512KB. אי אפשר לקבל אומדן מדויק של המשימה שנכשלה, כי המכונות הווירטואליות לא מופעלות בשביל משימות שנכשלו.
אם רשימת קובצי ה-JAR מגיעה למגבלה של 256KB, כדאי לבדוק אותה ולהסיר קובצי JAR מיותרים. אם הוא עדיין גדול מדי, נסו להריץ את משימת Dataflow באמצעות uber JAR. דוגמה שממחישה איך ליצור Uber JAR ולהשתמש בו מופיעה במאמר פיתוח ופריסה של Uber JAR.
אם השדה sdkPipelineOptions של בקשת ה-API גדול מדי, צריך לכלול את האפשרות הבאה כשמריצים את צינור עיבוד הנתונים. האפשרות של צינור עיבוד הנתונים זהה ב-Java, ב-Python וב-Go.
--experiments=no_display_data_on_gce_metadata
מפתח הערבוב גדול מדי
השגיאה הבאה מופיעה בקובצי היומן של ה-worker:
Shuffle key too large
השגיאה הזו מתרחשת אם המפתח שעבר סריאליזציה ונשלח ל-GroupByKey (או ל-Co-GroupByKey) מסוים גדול מדי אחרי שהקודן התואם הופעל. ב-Dataflow יש מגבלה על מפתחות ערבוב שעברו סריאליזציה.
כדי לפתור את הבעיה, צריך להקטין את המפתחות או להשתמש בקודנים שחוסכים במקום.
מידע נוסף זמין במאמר מגבלות ייצור ב-Dataflow.
שמירה במטמון של קלט צדדי לא עדכני בחלון גלובלי
כשמריצים פייפליין זורם באמצעות Apache Beam SDK ל-Python, יכול להיות שיהיו עיכובים בלתי צפויים בעדכונים של קלט צדדי בחלון הגלובלי. יכול להיות שה-workers ישמרו ערכים ישנים של קלט צדדי למשך תקופות ארוכות, במיוחד כשמעבדים נתונים רציפים של קלט ראשי. הבעיה הזו משפיעה בדרך כלל על צינורות עיבוד נתונים שמשתמשים ב-Pub/Sub גם כקלט ראשי וגם כקלט משני.
כדי לפתור את הבעיה, אם אתם משתמשים ב-Apache Beam SDK בגרסה 2.56.0 ואילך, הפעילו את דגל הניסוי disable_global_windowed_args_caching:
--experiments=disable_global_windowed_args_caching
המספר הכולל של אובייקטים מסוג BoundedSource ... גדול מהמגבלה המותרת
אחת מהשגיאות הבאות עשויה להתרחש כשמריצים משימות באמצעות Java:
Total number of BoundedSource objects generated by splitIntoBundles() operation is larger than the allowable limit
או:
Total size of the BoundedSource objects generated by splitIntoBundles() operation is larger than the allowable limit
Java
השגיאה הזו יכולה להתרחש אם אתם קוראים ממספר גדול מאוד של קבצים באמצעות TextIO, AvroIO, BigQueryIO דרך EXPORT או מקור אחר שמבוסס על קבצים. המגבלה הספציפית תלויה בפרטים של המקור, אבל היא בסדר גודל של עשרות אלפי קבצים בצינור עיבוד נתונים אחד. לדוגמה, הטמעת סכימה ב-AvroIO.Read מאפשרת פחות קבצים.
השגיאה הזו יכולה להתרחש גם אם יצרתם מקור נתונים בהתאמה אישית לצינור עיבוד הנתונים, והשיטה splitIntoBundles של המקור החזירה רשימה של אובייקטים מסוג BoundedSource שתופסים יותר מ-20MB אחרי סריאליזציה.
הגודל הכולל המותר של BoundedSource האובייקטים שנוצרו על ידי הפעולה splitIntoBundles() של המקור בהתאמה אישית הוא 20MB.
כדי לעקוף את המגבלה הזו, אתם יכולים לבצע אחד מהשינויים הבאים:
מפעילים את Portable Runner. Portable Runner ממיר מקורות ל-DoFn שניתנים לפיצול, שאין להם את מגבלת הפיצול הזו.
משנים את מחלקת המשנה המותאמת אישית של
BoundedSourceכך שהגודל הכולל של האובייקטים שנוצרו מסוגBoundedSourceיהיה קטן מהמגבלה של 20MB. לדוגמה, יכול להיות שהמקור ייצור פחות פיצולים בהתחלה, ויסתמך על איזון דינמי של חלוקת העבודה כדי לפצל עוד יותר את הקלט לפי דרישה.
גודל המטען הייעודי (payload) של הבקשה חורג מהמגבלה: 20,971,520 בייטים
כשמריצים צינור עיבוד נתונים, יכול להיות שהמשימה תיכשל ותופיע הודעת השגיאה הבאה:
com.google.api.client.googleapis.json.GoogleJsonResponseException: 400 Bad Request
POST https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs/JOB_ID/workItems:reportStatus
{
  "code": 400,
  "errors": [
    {
      "domain": "global",
      "message": "Request payload size exceeds the limit: 20971520 bytes.",
      "reason": "badRequest"
    }
  ],
  "message": "Request payload size exceeds the limit: 20971520 bytes.",
  "status": "INVALID_ARGUMENT"
}
השגיאה הזו יכולה להתרחש כשמשימה שמשתמשת ב-Dataflow runner כוללת תרשים משימה גדול מאוד. תרשים משימה גדול יכול ליצור מספר גדול של מדדים שצריך לדווח עליהם בחזרה לשירות Dataflow. אם הגודל של המדדים האלה חורג מהמגבלה של 20MB לבקשת API, המשימה נכשלת.
כדי לפתור את הבעיה, צריך להעביר את צינור עיבוד הנתונים לשימוש ב-Dataflow Portable Runner. ב-Portable Runner נעשה שימוש בשיטה יעילה יותר לדיווח על מדדים, ואין בו את המגבלה של 20MB.
ModuleNotFoundError: No module named 'pkg_resources'
כשמריצים משימת Dataflow, השגיאה הבאה מתרחשת במהלך הפעלת ה-worker או התקנת יחסי התלות:
ModuleNotFoundError: No module named 'pkg_resources'
הבעיה הזו מתרחשת כי החל מגרסה 82.0.0 של setuptools (שיצאה ב-8 בפברואר 2026), המודול pkg_resources הוסר. המודול הזה הוצא משימוש והוחלף על ידי importlib.resources ו-importlib.metadata.
כדי לפתור את הבעיה, אתם יכולים להשתמש באחת מהשיטות הבאות:
הצמדה של
setuptools: אם יחסי התלות דורשים גרסה שלsetuptoolsשתואמת לדורות קודמים כדי לבצע את ה-build, צריך לאלץ דרישה לגרסה ספציפית באמצעות הארגומנטsetup_requiresבקובץsetup.py. לדוגמה:import setuptools setuptools.setup( name='PACKAGE-NAME', version='PACKAGE-VERSION', # Pin to a version prior to 82.0.0 setup_requires=['setuptools<82.0.0'], install_requires=['incompatible-package', ...], packages=setuptools.find_packages() )עדכון יחסי התלות: בודקים את הדרישות של הספרייה ויחסי התלות כדי לעדכן לגרסאות חדשות יותר שתואמות לגרסה העדכנית של
setuptoolsולא מסתמכות עלpkg_resources.הסרת ספריות מיותרות: מסירים מהדרישות או מקובץ ההגדרה את כל הספריות שלא נדרשות למשימה. לדוגמה, זוהו כמה גרסאות קודמות של
cx_Oracleשגורמות לבעיה הזו במהלך תהליך ה-build.
NameError
כשמריצים את צינור עיבוד הנתונים באמצעות שירות Dataflow, מתקבלת השגיאה הבאה:
NameError
השגיאה הזו לא מתרחשת כשמריצים באופן מקומי, למשל כשמריצים באמצעות DirectRunner.
השגיאה הזו מתרחשת אם ה-DoFn משתמשים בערכים במרחב השמות הגלובלי שלא זמינים ב-worker של Dataflow.
כברירת מחדל, ייבואים, פונקציות ומשתנים גלובליים שמוגדרים בסשן הראשי לא נשמרים במהלך הסריאליזציה של משימת Dataflow.
כדי לפתור את הבעיה, אתם יכולים להשתמש באחת מהשיטות הבאות. אם הפונקציות מסוג DoFn מוגדרות בקובץ הראשי ומפנות לייבואים ולפונקציות במרחב השמות הגלובלי, צריך להגדיר את האפשרות --save_main_session של צינור עיבוד הנתונים לערך True. השינוי הזה שומר את המצב של מרחב השמות הגלובלי וטוען אותו ב-worker של Dataflow.
אם יש לכם אובייקטים במרחב השמות הגלובלי שלא ניתן לבצע להם פיקלינג, תתרחש שגיאת פיקלינג. אם השגיאה קשורה למודול שאמור להיות זמין בהפצה של Python, מייבאים את המודול באופן מקומי, במקום שבו משתמשים בו.
לדוגמה, במקום:
import re
…
def myfunc():
  # use re module
שימוש:
def myfunc():
  import re
  # use re module
לחלופין, אם ה-DoFns שלכם משתרעים על פני כמה קבצים, השתמשו בגישה אחרת לאריזת תהליך העבודה ולניהול יחסי התלות.
האובייקט כפוף למדיניות שמירת הנתונים של הקטגוריה
כשמפעילים משימת Dataflow שכותבת לקטגוריה של Cloud Storage, המשימה נכשלת ומופיעה השגיאה הבאה:
Object 'OBJECT_NAME' is subject to bucket's retention policy or object retention and cannot be deleted or overwritten
יכול להיות שתופיע גם השגיאה הבאה:
Unable to rename "gs://BUCKET"
השגיאה הראשונה מתרחשת כששמירת האובייקטים מופעלת בקטגוריה של Cloud Storage שאליה משימת Dataflow כותבת. מידע נוסף זמין במאמר הפעלה ושימוש בהגדרות של שמירת אובייקטים.
כדי לפתור את הבעיה, אתם יכולים להשתמש באחד מהפתרונות הבאים:
כותבים לקטגוריה של Cloud Storage שאין בה מדיניות שמירת נתונים בתיקייה
temp.מסירים את מדיניות שמירת הנתונים מהקטגוריה שאליה המשימה כותבת. למידע נוסף, קראו את המאמר הגדרת שמירה של אובייקט.
השגיאה השנייה יכולה להצביע על כך ששמירת האובייקטים מופעלת בקטגוריה של Cloud Storage, או שאין לחשבון השירות של ה-worker VM ב-Dataflow הרשאה לכתוב בקטגוריה של Cloud Storage.
אם מופיעה השגיאה השנייה ושמירת האובייקטים מופעלת בקטגוריה של Cloud Storage, נסו את הפתרונות החלופיים שמתוארים למעלה. אם שמירת האובייקטים לא מופעלת בקטגוריה של Cloud Storage, צריך לבדוק אם לחשבון השירות של ה-worker VM ב-Dataflow יש הרשאת כתיבה בקטגוריה של Cloud Storage. מידע נוסף זמין במאמר גישה לקטגוריות של Cloud Storage.
העיבוד נתקע או שהפעולה נמשכת
אם Dataflow משקיע יותר זמן בביצוע DoFn מהזמן שצוין ב-TIME_INTERVAL בלי להחזיר, תוצג ההודעה הבאה.
Java
אחת משתי הודעות היומן הבאות, בהתאם לגרסה:
Processing stuck in step STEP_NAME for at least TIME_INTERVAL
Operation ongoing in bundle BUNDLE_ID for at least TIME_INTERVAL without outputting or completing: at STACK_TRACE
Python
Operation ongoing for over TIME_INTERVAL in state STATE in step STEP_ID without returning. Current Traceback: TRACEBACK
המשך
Operation ongoing in transform TRANSFORM_ID for at least TIME_INTERVAL without outputting or completing in state STATE
יש שתי סיבות אפשריות להתנהגות הזו:
- הקוד של
DoFnאיטי, או שהוא ממתין להשלמה של פעולה חיצונית איטית. - יכול להיות שהקוד של
DoFnתקוע, במצב של מבוי סתום או שהעיבוד שלו איטי באופן חריג.
כדי לדעת מה המקרה, מרחיבים את הרשומה ביומן של Cloud Monitoring ורואים את דוח הקריסות. מחפשים הודעות שמציינות שהקוד של DoFn תקוע או שנתקל בבעיות אחרות. אם לא מופיעות הודעות, יכול להיות שהבעיה היא במהירות הביצוע של קוד ה-DoFn. כדאי להשתמש ב-Cloud Profiler או בכלי אחר כדי לבדוק את ביצועי הקוד.
אם הצינור שלכם מבוסס על Java VM (באמצעות Java או Scala), אתם יכולים לבדוק מה גרם לקוד להיתקע. כדי ליצור קובץ dump מלא של כל ה-JVM (ולא רק של ה-thread שנתקע), פועלים לפי השלבים הבאים:
- רושמים את שם ה-worker מרשומת היומן.
- בקטע Compute Engine במסוף Google Cloud , מאתרים את המכונה של Compute Engine עם שם ה-worker שציינתם.
- משתמשים ב-SSH כדי להתחבר למכונה עם השם הזה.
מריצים את הפקודה הבאה:
curl http://localhost:8081/threadz
הפעולה מתבצעת בחבילה
כשמריצים צינור עיבוד נתונים שקורא מ-JdbcIO, הקריאות המפוצלות מ-JdbcIO איטיות, וההודעה הבאה מופיעה בקובצי היומן של ה-worker:
Operation ongoing in bundle process_bundle-[0-9-]* for PTransform{id=Read from JDBC with Partitions\/JdbcIO.Read\/JdbcIO.ReadAll\/ParDo\(Read\)\/ParMultiDo\(Read\).*, state=process} for at least (0[1-9]h[0-5][0-9]m[0-5][0-9]s) without outputting or completing:
כדי לפתור את הבעיה, מבצעים אחד או יותר מהשינויים הבאים בצינור עיבוד הנתונים:
להשתמש במחיצות כדי להגדיל את מספר המשימות שמתבצעות במקביל. קריאה עם יותר מחיצות קטנות יותר, כדי לשפר את קנה המידה.
בודקים אם עמודת החלוקה למחיצות היא עמודת אינדקס או עמודת חלוקה למחיצות אמיתית במקור. כדי לשפר את הביצועים, כדאי להפעיל הוספה לאינדקס וחלוקה למחיצות בעמודה הזו במסד הנתונים של המקור.
כדי לדלג על מציאת הגבולות, משתמשים בפרמטרים
lowerBoundו-upperBound.
שגיאות במכסות של Pub/Sub
כשמריצים פייפליין זורם מ-Pub/Sub, מתרחשות השגיאות הבאות:
429 (rateLimitExceeded)
או:
Request was throttled due to user QPS limit being reached
השגיאות האלה קורות אם בפרויקט אין מספיק מכסות Pub/Sub.
כדי לבדוק אם המכסה בפרויקט לא מספיקה, בודקים אם יש שגיאות בצד הלקוח:
- נכנסים למסוףGoogle Cloud .
- בתפריט שמימין, לוחצים על APIs & services.
- בתיבת החיפוש, מחפשים את Cloud Pub/Sub.
- לוחצים על הכרטיסייה שימוש.
- בודקים את קודי התגובה ומחפשים קודי שגיאה של לקוח מסוג
(4xx).
הבקשה אסורה לפי מדיניות הארגון
כשמריצים צינור עיבוד נתונים, מתקבלת השגיאה הבאה:
Error trying to get gs://BUCKET_NAME/FOLDER/FILE:
{"code":403,"errors":[{"domain":"global","message":"Request is prohibited by organization's policy","reason":"forbidden"}],
"message":"Request is prohibited by organization's policy"}
השגיאה הזו מתרחשת אם הקטגוריה של Cloud Storage נמצאת מחוץ להיקף השירות.
כדי לפתור את הבעיה, צריך ליצור כלל תעבורת נתונים יוצאת שמאפשר גישה לקטגוריה מחוץ לגבולות הגזרה לשירות.
החבילה בשלבי הכנה...לא נגישה
יכול להיות שמשימות שהצליחו בעבר ייכשלו עם השגיאה הבאה:
Staged package...is inaccessible
כדי לפתור את הבעיה:
- מוודאים שבקטגוריה של Cloud Storage שמשמשת להעברה ל-Staging אין הגדרות TTL שגורמות למחיקת החבילות שהועברו ל-Staging.
מוודאים שלחשבון השירות של ה-worker VM בפרויקט Dataflow יש הרשאת גישה לקטגוריה של Cloud Storage שמשמשת להכנת הנתונים. יכולות להיות כמה סיבות לפערים בהרשאות:
- הקטגוריה של Cloud Storage שמשמשת להכנה נמצאת בפרויקט אחר.
- הקטגוריה של Cloud Storage שמשמשת להעברה הועברה מגישה מפורטת לגישה אחידה ברמת הקטגוריה. בגלל חוסר העקביות בין כללי המדיניות של IAM ושל ACL, העברת קטגוריית ה-Staging לגישה אחידה ברמת הקטגוריה לא מאפשרת רשימות ACL למשאבים של Cloud Storage. רשימות ה-ACL כוללות את ההרשאות שיש לחשבון השירות של ה-worker VM בפרויקט Dataflow בקטגוריית ה-staging.
מידע נוסף זמין במאמר גישה לקטגוריות של Cloud Storage בפרויקטים שלGoogle Cloud.
פריט עבודה נכשל 4 פעמים
השגיאה הבאה מתקבלת כשמשימה באצווה נכשלת:
The job failed because a work item has failed 4 times.
השגיאה הזו מתרחשת אם פעולה אחת במשימה באצווה גורמת לקוד ה-worker להיכשל ארבע פעמים. המשימה נכשלת ב-Dataflow ומוצגת ההודעה הזו.
כשמריצים במצב סטרימינג, חבילה שכוללת פריט שנכשל מנסה שוב ללא הגבלה, מה שעלול לגרום לצינור עיבוד הנתונים להיתקע באופן סופי.
אי אפשר לשנות את סף הכישלונות הזה. למידע נוסף, קראו את המאמר טיפול בשגיאות ובחריגות בצינור עיבוד הנתונים.
כדי לפתור את הבעיה, חפשו את ארבעת הכשלים הנפרדים ביומני Cloud Monitoring של המשימה. ביומני ה-worker, חפשו רשומות ביומן ב-רמת שגיאה או ב-רמה קריטית שמציגות חריגות או שגיאות. החריגה או השגיאה צריכות להופיע לפחות ארבע פעמים. אם היומנים מכילים רק שגיאות כלליות של זמן קצוב לתפוגה שקשורות לגישה למשאבים חיצוניים, כמו MongoDB, צריך לוודא שלחשבון השירות של ה-worker VM יש הרשאה לגשת לרשת המשנה של המשאב.
פג הזמן הקצוב לקבלת קובץ תוצאות הסקר
למידע מלא על פתרון השגיאה "Timeout in polling result file", קראו את המאמר פתרון בעיות בתבניות Flex.
הפעולה Write Correct File/Write/WriteImpl/PreFinalize נכשלה
כשמריצים משימה, היא נכשלת מדי פעם ומופיעה השגיאה הבאה:
Workflow failed. Causes: S27:Write Correct File/Write/WriteImpl/PreFinalize failed., Internal Issue (ID): ID:ID, Unable to expand file pattern gs://BUCKET_NAME/temp/FILE
השגיאה הזו מתרחשת כשמשתמשים באותה תיקיית משנה כמיקום האחסון הזמני של כמה משימות שפועלות בו-זמנית.
כדי לפתור את הבעיה, אל תשתמשו באותה תיקיית משנה כמיקום האחסון הזמני של כמה צינורות עיבוד נתונים. לכל צינור עיבוד נתונים, צריך לספק תיקיית משנה ייחודית שתשמש כמיקום האחסון הזמני.
הרכיב חורג מהגודל המקסימלי של הודעת protobuf
כשמריצים משימות ב-Dataflow ובצינור עיבוד הנתונים יש רכיבים גדולים, יכול להיות שיופיעו שגיאות כמו בדוגמאות הבאות:
Exception serializing message!
ValueError: Message org.apache.beam.model.fn_execution.v1.Elements exceeds maximum protobuf size of 2GB
או:
Buffer size ... exceeds GRPC limit 2147483548. This is likely due to a single element that is too large.
או:
Output element size exceeds the allowed limit. (... > 83886080) See https://cloud.google.com/dataflow/quotas#limits for more details.
יכול להיות שתופיע גם אזהרה דומה לדוגמה הבאה:
Data output stream buffer size ... exceeds 536870912 bytes. This is likely due to a large element in a PCollection.
השגיאות האלה מתרחשות כשהצינור מכיל רכיבים גדולים.
כדי לפתור את הבעיה, אם אתם משתמשים ב-Python SDK, שדרגו לגרסה 2.57.0 ואילך של Apache Beam. גרסאות Python SDK מ-2.57.0 ואילך משפרות את העיבוד של רכיבים גדולים ומוסיפות רישום רלוונטי ביומן.
אם השגיאות נמשכות אחרי השדרוג או אם אתם לא משתמשים ב-Python SDK, זהו את השלב במשימה שבו מתרחשת השגיאה ונסו להקטין את גודל הרכיבים בשלב הזה.
כשאובייקטים מסוג PCollection בצינור עיבוד הנתונים מכילים רכיבים גדולים, דרישות ה-RAM של צינור עיבוד הנתונים גדלות. רכיבים גדולים יכולים גם לגרום לשגיאות זמן ריצה, במיוחד כשהם חוצים את הגבולות של שלבים ממוזגים.
רכיבים גדולים יכולים להיווצר כשצינור עיבוד נתונים יוצר בטעות איטרציה גדולה. לדוגמה, צינור עיבוד נתונים שמעביר את הפלט של פעולת GroupByKey לפעולת Reshuffle מיותרת, מממש רשימות כרכיבים בודדים. הרשימות האלה יכולות להכיל מספר גדול של ערכים לכל מפתח.
אם השגיאה מתרחשת בשלב שמשתמש בקלט צדדי, חשוב לזכור ששימוש בקלט צדדי יכול להוביל למחסום מיזוג. צריך לבדוק אם הטרנספורמציה שמפיקה רכיב גדול והטרנספורמציה שצורכת אותו שייכות לאותו שלב.
כשאתם בונים את צינור עיבוד הנתונים, כדאי לפעול לפי השיטות המומלצות הבאות:
- ב-
PCollections, כדאי להשתמש בכמה רכיבים קטנים במקום ברכיב אחד גדול. - אחסון של אובייקטים גדולים במערכות אחסון חיצוניות. אפשר להשתמש ב-
PCollectionsכדי להעביר את המטא-נתונים שלהם, או להשתמש במקודד מותאם אישית שמקטין את גודל הרכיב. - אם אתם חייבים להעביר מערך נתונים מורכב (PCollection) שיכול לחרוג מ-2GB כקלט צדדי, השתמשו בתצוגות שניתנות לחזרה, כמו
AsIterableו-AsMultiMap.
הגודל המקסימלי של רכיב יחיד במשימת Dataflow מוגבל ל-2GB (או ל-80MB ב-Streaming Engine). מידע נוסף זמין במאמר מכסות ומגבלות.
Dataflow לא יכול לעבד טרנספורמציות מנוהלות…
צינורות עיבוד נתונים שמשתמשים ב-Managed I/O עלולים להיכשל עם השגיאה הזו אם Dataflow לא יכול לשדרג באופן אוטומטי את טרנספורמציות הקלט/פלט לגרסה העדכנית ביותר שנתמכת. ה-URN ושמות השלבים שמופיעים בשגיאה אמורים לציין בדיוק אילו טרנספורמציות Dataflow לא הצליח לשדרג.
יכול להיות שפרטים נוספים על השגיאה הזו מופיעים ב-Logs Explorer, בשמות של יומני Dataflow managed-transforms-worker ו-managed-transforms-worker-startup.
אם ב-Logs Explorer אין מספיק מידע כדי לפתור את הבעיה, פנו ל-Cloud Customer Care.
שגיאות במשימות ארכיון
בקטעים הבאים מפורטות שגיאות נפוצות שאתם עשויים להיתקל בהן כשאתם מנסים להעביר משימת Dataflow לארכיון באמצעות ה-API.
לא צוין ערך
כשמנסים להעביר משימת Dataflow לארכיון באמצעות ה-API, יכול להיות שתופיע השגיאה הבאה:
The field mask specifies an update for the field job_metadata.user_display_properties.archived in job JOB_ID, but no value is provided. To update a field, please provide a field for the respective value.
השגיאה הזו מתרחשת בגלל אחת מהסיבות הבאות:
הנתיב שצוין בשדה
updateMaskלא תואם לפורמט הנכון. הבעיה הזו יכולה לקרות בגלל שגיאות הקלדה.המאפיין
JobMetadataלא צוין בצורה נכונה. בשדהJobMetadata, עבורuserDisplayProperties, משתמשים בצמד מפתח/ערך"archived":"true".
כדי לפתור את השגיאה, צריך לוודא שהפקודה שמועברת ל-API תואמת לפורמט הנדרש. למידע נוסף, קראו את המאמר העברת משימה לארכיון.
ה-API לא מזהה את הערך
כשמנסים להעביר משימת Dataflow לארכיון באמצעות ה-API, יכול להיות שתופיע השגיאה הבאה:
The API does not recognize the value VALUE for the field job_metadata.user_display_properties.archived for job JOB_ID. REASON: Archived display property can only be set to 'true' or 'false'
השגיאה הזו מתקבלת כשהערך שצוין בצמד המפתח/ערך של משימות הארכיון אינו ערך נתמך. הערכים הנתמכים לצמד מפתח/ערך של משימות ארכיון הם "archived":"true" ו-"archived":"false".
כדי לפתור את השגיאה, צריך לוודא שהפקודה שאתם מעבירים ל-API תואמת לפורמט הנדרש. למידע נוסף, קראו את המאמר העברת משימה לארכיון.
אי אפשר לעדכן גם את המצב וגם את המסכה
כשמנסים להעביר משימת Dataflow לארכיון באמצעות ה-API, יכול להיות שתופיע השגיאה הבאה:
Cannot update both state and mask.
השגיאה הזו מתרחשת כשמנסים לעדכן גם את מצב המשימה וגם את סטטוס הארכיון באותה קריאה ל-API. אי אפשר לעדכן גם את מצב המשימה וגם את פרמטר השאילתה updateMask באותה קריאה ל-API.
כדי לפתור את השגיאה, צריך לעדכן את מצב המשימה בקריאה נפרדת ל-API. לפני שמעדכנים את סטטוס הארכיון של המשימה, צריך לעדכן את סטטוס המשימה.
השינוי של תהליך העבודה נכשל
כשמנסים להעביר משימת Dataflow לארכיון באמצעות ה-API, יכול להיות שתופיע השגיאה הבאה:
Workflow modification failed.
השגיאה הזו מתרחשת בדרך כלל כשמנסים להעביר לארכיון משימה שפועלת.
כדי לפתור את השגיאה הזו, צריך להמתין עד שהמשימה תסתיים לפני שמעבירים אותה לארכיון. למשימות שהושלמו יש אחד ממצבי המשימה הבאים:
JOB_STATE_CANCELLEDJOB_STATE_DRAINEDJOB_STATE_DONEJOB_STATE_FAILEDJOB_STATE_UPDATED
מידע נוסף זמין במאמר זיהוי השלמת משימה ב-Dataflow.
שגיאות בקובץ אימג' של קונטיינר
בקטעים הבאים מפורטות שגיאות נפוצות שאתם עשויים להיתקל בהן כשאתם משתמשים בקונטיינרים בהתאמה אישית, ושלבים לפתרון השגיאות או לפתרון הבעיות. בדרך כלל, לפני השגיאות מופיעה ההודעה הבאה:
Unable to pull container image due to error: DETAILED_ERROR_MESSAGE
ההרשאה containeranalysis.occurrences.list נדחתה
השגיאה הבאה מופיעה בקובצי היומן:
Error getting old patchz discovery occurrences: generic::permission_denied: permission "containeranalysis.occurrences.list" denied for project "PROJECT_ID", entity ID "" [region="REGION" projectNum=PROJECT_NUMBER projectID="PROJECT_ID"]
Container Analysis API לא מופעל. במקרים מסוימים, נדרש Container Analysis API כדי לבצע בדיקת נקודות חולשה.
API.
למידע נוסף, קראו את המאמרים סקירה כללית על סריקת מערכת הפעלה והגדרת בקרת גישה במאמרי העזרה של Artifact Analysis.
שגיאה בסנכרון pod ... נכשל "StartContainer"
השגיאה הבאה מתרחשת במהלך הפעלת ה-worker:
Error syncing pod POD_ID, skipping: [failed to "StartContainer" for CONTAINER_NAME with CrashLoopBackOff: "back-off 5m0s restarting failed container=CONTAINER_NAME pod=POD_NAME].
Pod הוא קבוצה של קונטיינרים ב-Docker שפועלים באותו מיקום ב-worker של Dataflow. השגיאה הזו מתרחשת כשאחד ממארזי Docker ב-pod לא מצליח להתחיל. אם אי אפשר לתקן את הכשל, ה-worker של Dataflow לא יכול להתחיל, ובסופו של דבר משימות ה-batch של Dataflow נכשלות עם שגיאות כמו:
The Dataflow job appears to be stuck because no worker activity has been seen in the last 1h.
השגיאה הזו בדרך כלל מתרחשת כשאחד מהקונטיינרים קורס שוב ושוב במהלך ההפעלה.
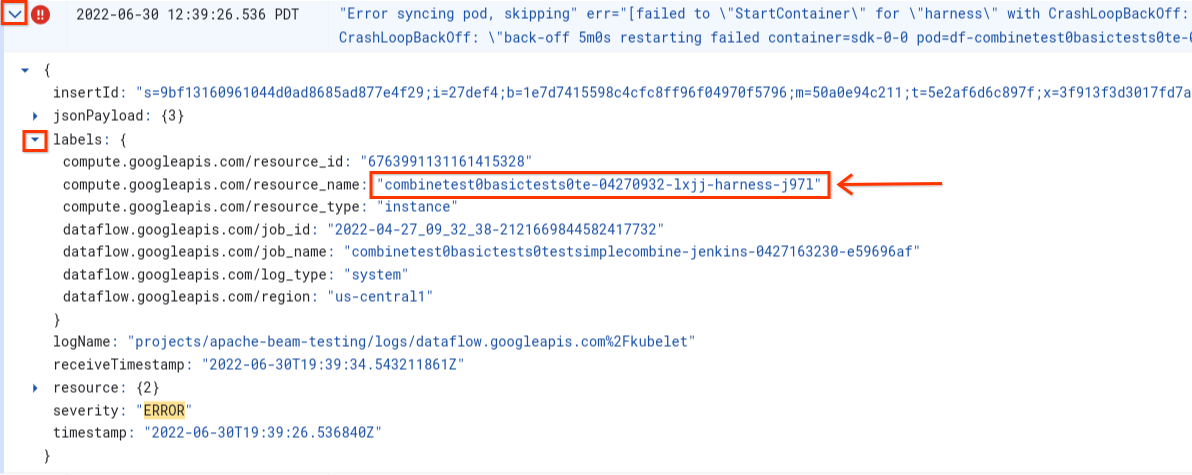
כדי להבין את שורש הבעיה, חפשו את היומנים שתועדו מיד לפני הכשל. כדי לנתח את היומנים, משתמשים ב-Logs Explorer. ב-Logs Explorer, מגבילים את קובצי היומן לרשומות ביומן שהופקו מה-worker עם שגיאות ההפעלה של מאגר הנתונים. כדי להגביל את רשומות היומן, מבצעים את השלבים הבאים:
- ב-Logs Explorer, מאתרים את רשומת היומן של
Error syncing pod. - כדי לראות את התוויות שמשויכות לרשומה ביומן, מרחיבים את הרשומה.
- לוחצים על התווית שמשויכת ל-
resource_nameואז על Show matching entries.
ב-Logs Explorer, היומנים של Dataflow מאורגנים בכמה מקורות נתונים של יומנים. ההודעה Error syncing pod מופיעה ביומן שנקרא kubelet. עם זאת, יכול להיות שהיומנים מהקונטיינר שנכשל נמצאים בזרם יומנים אחר. לכל מאגר יש שם. אתם יכולים להיעזר בטבלה הבאה כדי לזהות איזה זרם יומנים עשוי להכיל יומנים שרלוונטיים לקונטיינר שנכשל.
| שם המאגר | שמות של יומני ביקורת |
|---|---|
| sdk, sdk0, sdk1, sdk-0-0 ודומיהם | docker |
| רתמה | harness, harness-startup |
| python, java-batch, java-streaming | worker-startup, worker |
| ארטיפקט | ארטיפקט |
כששולחים שאילתה ל-Logs Explorer, חשוב לוודא שהשאילתה כוללת את שמות היומנים הרלוונטיים בממשק של הכלי ליצירת שאילתות, או שאין הגבלות על שם היומן.
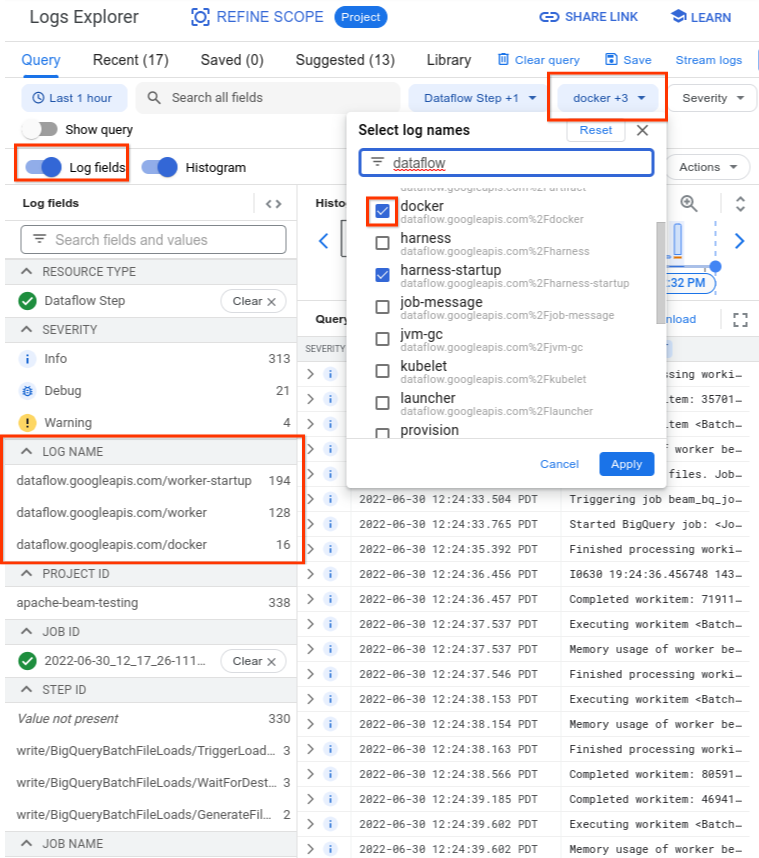
אחרי שבוחרים את היומנים הרלוונטיים, תוצאת השאילתה עשויה להיראות כמו בדוגמה הבאה:
resource.type="dataflow_step"
resource.labels.job_id="2022-06-29_08_02_54-JOB_ID"
labels."compute.googleapis.com/resource_name"="testpipeline-jenkins-0629-DATE-cyhg-harness-8crw"
logName=("projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fdocker"
OR
"projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fworker-startup"
OR
"projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fworker")
מכיוון שהיומנים שמדווחים על התסמין של כשל בקונטיינר מדווחים לפעמים בתור INFO, צריך לכלול יומני INFO בניתוח.
הנה כמה סיבות נפוצות לכשלים בקונטיינרים:
- לצינור עיבוד הנתונים ב-Python יש יחסי תלות נוספים שמותקנים בזמן הריצה, וההתקנה נכשלה. יכול להיות שיופיעו שגיאות כמו
pip install failed with error. הבעיה הזו יכולה לקרות בגלל דרישות סותרות, או בגלל הגדרת רשת מוגבלת שמונעת מ-worker של Dataflow לשלוף יחסי תלות חיצוניים ממאגר ציבורי באינטרנט. ה-worker נכשל באמצע ההרצה של צינור עיבוד הנתונים בגלל שגיאת אין זיכרון פנוי (OOM). יכול להיות שתופיע אחת מהודעות השגיאה הבאות:
java.lang.OutOfMemoryError: Java heap spaceShutting down JVM after 8 consecutive periods of measured GC thrashing. Memory is used/total/max = 24453/42043/42043 MB, GC last/max = 58.97/99.89 %, #pushbacks=82, gc thrashing=true. Heap dump not written.
כדי לנפות באגים בבעיה של אין זיכרון פנוי, קראו את המאמר פתרון בעיות של שגיאות אין זיכרון פנוי ב-Dataflow.
ל-Dataflow אין אפשרות לשלוף את קובץ האימג' של הקונטיינר. למידע נוסף, קראו את המאמר בקשת משיכת תמונה נכשלה עם שגיאה.
הקונטיינר שבו משתמשים לא תואם לארכיטקטורת המעבד (CPU) של ה-worker VM. ביומני ההפעלה של הרתמה, יכול להיות שתופיע שגיאה כמו:
exec
/opt/apache/beam/boot: exec format error
. כדי לבדוק את הארכיטקטורה של קובץ האימג' של הקונטיינר, מריצים אתdocker image inspect $IMAGE:$TAGומחפשים את מילת המפתחArchitecture. אם מופיעError: No such image: $IMAGE:$TAG, יכול להיות שתצטרכו קודם להוריד את קובץ האימג' באמצעות הפקודהdocker pull $IMAGE:$TAG. מידע נוסף על פיתוח קובצי אימג' עם כמה ארכיטקטורות זמין במאמר פיתוח קובץ אימג' של קונטיינר עם כמה ארכיטקטורות.
אחרי שמזהים את השגיאה שגרמה לכישלון של הקונטיינר, מנסים לטפל בה ואז שולחים מחדש את הצינור.
הפעלת התבנית נכשלה עם שגיאה
במהלך ההפעלה של תבנית Flex, מופיעה השגיאה הבאה ביומני המשימות:
Error: Template launch failed: exit status 13
Error occurred in the launcher container: Template launch failed. See console logs.
יומני ה-worker מכילים דוחות קריסות שדומים ליומני המעקב הבאים:
TypeError: canonicalize_version() got an unexpected keyword argument 'strip_trailing_zero'
ERROR:absl:Internal Error Type : RuntimeError
ERROR:absl:Error Message : Full trace: Traceback (most recent call last):
File "/usr/local/lib/python3.9/site-packages/apache_beam/utils/processes.py", line 89, in check_output
out = subprocess.check_output(*args, **kwargs)
IFile "/usr/local/lib/python3.9/subprocess.py", line 424, in check_output
return run(*popenargs, stdout=PIPE, timeout=timeout, check=True,
File "/usr/local/lib/python3.9/subprocess.py", line 528, in run
raise CalledProcessError(retcode, process.args,
subprocess.CalledProcessError: Command '['/usr/local/bin/python', 'setup.py', 'sdist', '--dist-dir', '/tmp/tmp196n6g8d']' returned non-zero exit status 1.
השגיאות האלה מתרחשות אם מרכז האפליקציות של התבנית מוצא יחסי תלות סותרים במהלך ההגדרה, במיוחד כשחבילת setuptools מעודכנת לגרסה גבוהה או שווה ל-71.0. בודקים את יחסי התלות של צינור עיבוד הנתונים ומוודאים שיחס התלות של האריזה גדול מ-25.0 או שווה לו.
בקשת משיכת התמונה נכשלה עם שגיאה
במהלך הפעלת ה-worker, אחת מהשגיאות הבאות מופיעה ביומני ה-worker או המשימה:
Image pull request failed with error
pull access denied for IMAGE_NAME
manifest for IMAGE_NAME not found: manifest unknown: Failed to fetch
Get IMAGE_NAME: Service Unavailable
השגיאות האלה מתרחשות אם ה-worker לא יכול להתחיל לפעול כי הוא לא יכול לשלוף קובץ אימג' של קונטיינר Docker. הבעיה הזו מתרחשת בתרחישים הבאים:
- כתובת ה-URL של קובץ האימג' של קונטיינר ה-SDK בהתאמה אישית שגויה
- ל-worker אין פרטי כניסה או גישה לרשת לתמונה המרוחקת
כדי לפתור את הבעיה:
- אם אתם משתמשים בקובץ אימג' של קונטיינר בהתאמה אישית במשימה, ודאו שכתובת ה-URL של קובץ האימג' נכונה ושיש לה תג או סיכום תקינים. גם ה-workers של Dataflow צריכים גישה לאימג'.
- כדי לוודא שאפשר למשוך תמונות ציבוריות באופן מקומי, מריצים את הפקודה
docker pull
$image
ממכונה לא מאומתת.
לתמונות פרטיות או ל-worker פרטיים:
- אם אתם משתמשים ב-Container Registry כדי לארח את קובץ האימג' של הקונטיינר, מומלץ להשתמש ב-Artifact Registry במקום זאת. החל מ-15 במאי 2023, Container Registry הוצא משימוש. אם אתם משתמשים ב-Container Registry, אתם יכולים לעבור ל-Artifact Registry. אם התמונות נמצאות בפרויקט אחר מזה שמשמש להרצת המשימה ב-Google Cloud , צריך להגדיר את בקרת הגישה לחשבון השירות שמוגדר כברירת מחדל ב-Google Cloud .
- אם אתם משתמשים בענן וירטואלי פרטי (VPC) משותף, ודאו של-workers יש גישה למארח של מאגר הקונטיינרים בהתאמה אישית.
- משתמשים ב-
sshכדי להתחבר ל-worker VM של משימה שפועלת, ומריצים אתdocker pull $imageכדי לוודא ישירות שה-worker מוגדר כמו שצריך.
אם ה-workers נכשלים כמה פעמים ברצף בגלל השגיאה הזו, והעבודה על משימה כבר התחילה, המשימה יכולה להיכשל עם שגיאה שדומה להודעה הבאה:
Job appears to be stuck.
אם תסירו את הגישה לתמונה בזמן שהמשימה פועלת, על ידי הסרת התמונה עצמה או ביטול פרטי הכניסה לחשבון השירות של ה-worker VM של Dataflow או הגישה לאינטרנט כדי לגשת לתמונות, Dataflow רק יתעד שגיאות ביומן. Dataflow לא נכשל בביצוע המשימה. בנוסף, ב-Dataflow נמנעים כשלים בפייפליינים זורמים ארוכים, כדי למנוע אובדן של מצב הפייפליין.
יכולות להיות שגיאות אחרות שנובעות מבעיות במכסות של המאגר או מהפסקות זמניות בשירות. אם נתקלתם בבעיות שחורגות מהמכסה של Docker Hub לשליפת קובצי אימג' ציבוריים, או בהפסקות כלליות בשירות של מאגר צד שלישי, כדאי להשתמש ב- Artifact Registry כמאגר קובצי האימג'.
SystemError: unknown opcode
יכול להיות שצינור עיבוד הנתונים של קונטיינר בהתאמה אישית ב-Python ייכשל עם השגיאה הבאה מיד אחרי שליחת המשימה:
SystemError: unknown opcode
בנוסף, דוח הקריסות עשוי לכלול
apache_beam/internal/pickler.py
כדי לפתור את הבעיה, ודאו שגרסת Python שבה אתם משתמשים באופן מקומי תואמת לגרסה בקובץ האימג' של הקונטיינר, עד לגרסה הראשית והמשנית. ההבדל בגרסת התיקון, למשל 3.6.7 לעומת 3.6.8, לא יוצר בעיות תאימות. ההבדל בגרסה המשנית, כמו 3.6.8 לעומת 3.8.2, יכול לגרום לכשלים בצינור עיבוד הנתונים.
שדרוג שגיאות בפייפליין זורם
במאמר פתרון בעיות בשדרוג של פייפליין זורם מוסבר איך לפתור שגיאות כשמשדרגים פייפליין זורם באמצעות תכונות כמו הפעלת משימת החלפה מקבילה.
עדכון של רתמת Portable Runner
הודעת המידע הבאה מופיעה ביומני המשימות של משימת Portable Runner
The Dataflow Portable Runner container image of this job's workers will be ready for update in 7 days.
כלומר, גרסת התהליך של ה-runner harness תתעדכן אוטומטית בשלב כלשהו, 7 ימים אחרי המסירה הראשונית של ההודעה, וכתוצאה מכך תהיה הפסקה קצרה בעיבוד. אם אתם רוצים לשלוט במועד ההשהיה, תוכלו לעיין במאמר עדכון צינור עיבוד נתונים קיים כדי להפעיל משימה חלופית שתכלול את הגרסה העדכנית ביותר של רתמת ה-runner.
שגיאות של עובדים
בקטעים הבאים מפורטות שגיאות נפוצות של Worker שאתם עשויים להיתקל בהן, ושלבים לפתרון הבעיות או לפתרון השגיאות.
הקריאה מ-Java worker harness ל-Python DoFn נכשלת עם שגיאה
אם קריאה מ-Java worker harness ל-DoFn של Python נכשלת, מוצגת הודעת שגיאה רלוונטית.
כדי לבדוק את השגיאה, מרחיבים את הרשומה ביומן השגיאות של Cloud Monitoring ומעיינים בהודעת השגיאה ובמעקב לאחור. הוא מראה איזה קוד נכשל כדי שתוכלו לתקן אותו במידת הצורך. אם לדעתכם השגיאה היא באג ב-Apache Beam או ב-Dataflow, דווחו על הבאג.
EOFError: marshal data too short
השגיאה הבאה מופיעה ביומני ה-worker:
EOFError: marshal data too short
השגיאה הזו מתרחשת לפעמים כשנגמר המקום בכונן של ה-workers בצינור עיבוד הנתונים של Python.
כדי לפתור את הבעיה, קראו את המאמר לא נשאר מקום במכשיר.
הדיסק לא צורף
כשמנסים להפעיל משימת Dataflow שמשתמשת במכונות וירטואליות מסוג C3 עם Persistent Disk, המשימה נכשלת ומופיעה אחת מהשגיאות הבאות או שתיהן:
Failed to attach disk(s), status: generic::invalid_argument: One or more operations had an error
Can not allocate sha384 (reason: -2), Spectre V2 : WARNING: Unprivileged eBPF is enabled with eIBRS on...
השגיאות האלה מתקבלות כשמשתמשים במכונות וירטואליות מסוג C3 עם Persistent Disk מסוג שלא נתמך. מידע נוסף זמין במאמר סוגי הדיסקים שנתמכים ב-C3.
כדי להשתמש במכונות וירטואליות מסוג C3 במשימת Dataflow, צריך לבחור את סוג הדיסק של ה-worker pd-ssd. מידע נוסף זמין במאמר אפשרויות ברמת ה-worker.
Java
--workerDiskType=pd-ssd
Python
--worker_disk_type=pd-ssd
המשך
disk_type=pd-ssd
אין מקום פנוי במכשיר
אם נגמר המקום בכונן במהלך משימה, יכול להיות שתופיע השגיאה הבאה ביומני ה-worker:
No space left on device
השגיאה הזו יכולה להופיע מהסיבות הבאות:
- נגמר המקום הפנוי באחסון המתמיד של ה-worker, מה שיכול לקרות בגלל אחת מהסיבות הבאות:
- משימה מורידה יחסי תלות גדולים בזמן הריצה
- משימה שמשתמשת בקונטיינרים גדולים בהתאמה אישית
- משימה כותבת הרבה נתונים זמניים בדיסק המקומי
- כשמשתמשים בארגון נתונים של Dataflow, המערכת מגדירה גודל דיסק קטן יותר כברירת מחדל. כתוצאה מכך, השגיאה הזו עלולה להתרחש במשימות שעוברות מ-shuffle מבוסס-worker.
- דיסק האתחול של ה-worker מתמלא כי הוא רושם יותר מ-50 רשומות בשנייה.
כדי לפתור את הבעיה, צריך לבצע את השלבים הבאים לפתרון בעיות:
כדי לראות את משאבי הדיסק שמשויכים ל-worker יחיד, חפשו את פרטי מכונת ה-VM של ה-worker VM שמשויכים למשימה שלכם. חלק מהמקום בכונן מנוצל על ידי מערכת ההפעלה, קבצים בינאריים, יומנים וקונטיינרים.
כדי להגדיל את מקום בכונן בדיסק הקבוע או בדיסק האתחול, משנים את אפשרות הצינור לעיבוד נתונים של גודל הדיסק.
מעקב אחרי השימוש במקום בכונן במכונות הווירטואליות של ה-worker באמצעות Cloud Monitoring. במאמר קבלת מדדים של worker VM מסוכן Monitoring מוסבר איך להגדיר את זה.
כדי לבדוק אם יש בעיות שקשורות למקום בדיסק האתחול, מציגים את הפלט של היציאה הטורית במכונות הווירטואליות של ה-worker ומחפשים הודעות כמו:
Failed to open system journal: No space left on device
אם יש לכם הרבה worker VM, אתם יכולים ליצור סקריפט כדי להריץ את gcloud
compute instances get-serial-port-output בכולן בבת אחת. במקום זאת, אתם יכולים לבדוק את הפלט הזה.
צינור עיבוד נתונים ב-Python נכשל אחרי שעה של חוסר פעילות של ה-worker
כשמשתמשים ב-Apache Beam SDK ל-Python עם Dataflow Portable Runner במכונות של Worker עם הרבה ליבות מעבד, צריך להשתמש ב-Apache Beam SDK בגרסה 2.35.0 ואילך. אם המשימה משתמשת בקונטיינר בהתאמה אישית, צריך להשתמש ב-Apache Beam SDK בגרסה 2.46.0 ואילך.
כדאי לבנות מראש את מאגר Python. השלב הזה יכול לשפר את זמני האתחול של המכונות הווירטואליות ואת הביצועים של ההתאמה האוטומטית לעומס של קנה המידה לרוחב. כדי להשתמש בתכונה הזו, צריך להפעיל את Cloud Build API בפרויקט ולשלוח את צינור עיבוד הנתונים עם הפרמטר הבא:
‑‑prebuild_sdk_container_engine=cloud_build.
מידע נוסף זמין במאמר Dataflow Portable Runner.
אפשר גם להשתמש בקובץ אימג' של קונטיינר בהתאמה אישית שבו כל יחסי התלות מותקנים מראש.
RESOURCE_POOL_EXHAUSTED או IP_SPACE_EXHAUSTED_WITH_DETAILS
כשיוצרים משאב Google Cloud , יכול להיות שתופיע אחת מהשגיאות הבאות ביצירת מאגר ה-workers.
השם של המכונה הווירטואלית INSTANCE_NAME מייצג את השם של ה-worker VM. מכונות וירטואליות של Worker הן מכונות מנוהלות באופן מלא של Compute Engine, שמבצעות את המשימות של צינור עיבוד הנתונים.
ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS
Startup of the worker pool in zone ZONE_NAME failed to bring up any of the desired NUMBER workers. ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS: Instance 'INSTANCE_NAME' creation failed: The zone 'projects/PROJECT_ID/zones/ZONE_NAME' does not have enough resources available to fulfill the request. '(resource type:RESOURCE_TYPE)'.
השגיאה הזו מתרחשת בגלל חוסר זמינות זמני של סוג ה-worker VM המבוקש. כברירת מחדל, Dataflow בוחר את סוג המכונה של מכונות ה-VM של ה-worker שמריצות את המשימה, וגם את הגודל והסוג של Persistent Disk.
כדי לפתור את הבעיה, אפשר להשתמש באחת מהאסטרטגיות הבאות:
- מעדכנים את ה-worker VM לסוג מכונה אחר ומנסים שוב להריץ את המשימה.
- מפעילים את משימת Dataflow מאזור אחר.
מפעילים את האפשרות Auto VM Selection באמצעות הצעות למשאבים
min_ramאוcpu_count. כשמשתמשים בבחירה אוטומטית של מכונות וירטואליות, ה-workers מוקצים מרשימה של סוגי מכונות שעומדים בדרישות שלכם לגבי זיכרון RAM ומעבד (CPU). כך אפשר למנוע בעיות של ניצול יתר של מאגר המשאבים.הערה: כשמפעילים את Auto VM Selection, המערכת מתעלמת מכל סוג מכונה שצוין באפשרויות של צינור עיבוד הנתונים.
כדי לטפל בשגיאות בתרחיש כזה, אפשר גם ליצור לולאת ניסיון חוזר (retry loop) למשימות. אם מתרחשת שגיאה של מיצוי משאבים, המשימה מנסה שוב באופן אוטומטי עד שהמשאבים זמינים. כדי ליצור לולאת ניסיון חוזר, פועלים לפי תהליך העבודה הבא:
- יוצרים משימת Dataflow ומקבלים את מזהה המשימה.
- בודקים את סטטוס המשימה עד שהוא משתנה ל-
RUNNINGאו ל-FAILED.- אם סטטוס המשימה הוא
RUNNING, יוצאים מלולאת הניסיון החוזר. - אם סטטוס המשימה הוא
FAILED, משתמשים ב-Cloud Logging API כדי לשלוח שאילתה על יומני המשימה למחרוזתZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS. מידע נוסף זמין במאמר עבודה עם יומני צינור עיבוד נתונים.- אם היומנים לא מכילים את המחרוזת, יוצאים מלולאת הניסיון החוזר.
- אם היומנים מכילים את המחרוזת, יוצרים משימת Dataflow, מקבלים את מזהה המשימה ומפעילים מחדש את לולאת הניסיון החוזר.
- אם סטטוס המשימה הוא
לסיום, כדאי לאמץ את השיטה המומלצת של הפצת המשאבים במספר אזורים כדי להתמודד עם הפסקות זמניות בשירות.
IP_SPACE_EXHAUSTED_WITH_DETAILS
Startup of the worker pool in REGION_NAME failed to bring up any of the desired NUMBER workers. ... IP_SPACE_EXHAUSTED_WITH_DETAILS: Instance 'INSTANCE_NAME' creation failed: IP space of 'projects/PROJECT_ID/regions/REGION_NAME/subnetworks/SUBNETWORK_NAME' is exhausted. Insufficient free IP addresses in the IP range 'IP_RANGE'. Consider expanding the current IP range or selecting an alternative IP range. If this is a secondary range, consider adding an additional secondary range.
השגיאה הזו מתקבלת כשברשת המשנה שהוקצתה למשימת Dataflow אין מספיק כתובות IP פנויות כדי להקצות את המספר המבוקש של worker VM.
כדי לפתור את הבעיה, אפשר להשתמש באחת מהאסטרטגיות הבאות:
- הרחבת טווח ה-IP הראשי של רשת המשנה.
- אם אתם משתמשים בטווח משני, הוסיפו עוד טווח משני.
- צריך לבחור רשת משנה או טווח כתובות IP אחרים עם מספיק כתובות IP זמינות.
שגיאות שקשורות לתלות בזמן ריצה
כשמריצים משימת Dataflow שמשתמשת ב-Apache Beam SDK ל-Python עם טרנספורמציות בשפות שונות, יכול להיות שהמשימה תיכשל עם שגיאת HTTP Error
403: Forbidden בזמן ההורדה של קובצי JAR מ-Maven Central.
הבעיה נגרמת בגלל שינוי בספק ה-CDN של Maven Central, שחוסם בקשות מספריית urllib של Python שמשמשת את Apache Beam SDK.
כדי לפתור את הבעיה, צריך לשדרג לגרסה 2.69.0 ומעלה של Apache Beam. אם אתם לא יכולים לשדרג, תוכלו להיעזר בפתרונות העקיפים שבקטע הזה.
תיקונים ב-Apache Beam בגרסה 2.69.0 ואילך
Apache Beam בגרסה 2.69.0 ואילך כולל את התיקונים הבאים:
כתובת URL של מאגר Maven בהתאמה אישית: אתם יכולים לציין מאגר Maven בהתאמה אישית באמצעות האפשרות
--maven_repository_urlבצינור עיבוד הנתונים. לדוגמה:--maven_repository_url https://maven-central.storage-download.googleapis.com/maven2/זיהוי סוכן משתמש: ה-SDK של Apache Beam שולח כותרת
User-Agentספציפית כדי למנוע חסימה של בקשות.
פתרונות עקיפים לערכות SDK ישנות יותר
אם אתם לא יכולים לשדרג לגרסה 2.69.0 ומעלה של Apache Beam, אתם יכולים להשתמש באחת מהדרכים החלופיות הבאות:
- אריזה מראש של קובצי JAR בקונטיינר בהתאמה אישית (מומלץ): אורזים מראש את קובצי ה-JAR הנדרשים בקובץ אימג' של קונטיינר בהתאמה אישית. כדי למנוע מה-SDK להוריד את קובצי ה-JAR בזמן הריצה, צריך להציב אותם בספריית המטמון של Apache Beam (
/root/.apache_beam/cache/jars/). שימוש ברפליקציה של Maven ב-Google: משתמשים באפשרות הצינור
--expansion_serviceכדי להורות ל-Apache Beam SDK להוריד את קובצי ה-JAR הנדרשים מהרפליקציה של Maven Central ב-Google. לדוגמה:--expansion_service https://maven-central.storage-download.googleapis.com/maven2/org/apache/beam/beam-sdks-java-extensions-schemaio-expansion-service/BEAM_VERSION/beam-sdks-java-extensions-schemaio-expansion-service-BEAM_VERSION.jarהעלאת קובצי JAR ל-Cloud Storage: מורידים את קובצי ה-JAR הנדרשים, מעלים אותם לקטגוריה של Cloud Storage ואז מספקים את הנתיב של קובץ ה-JAR ב-Cloud Storage לאפשרות הצינור
--expansion_service.
במכונות עם מאיצים אורחים אין תמיכה במיגרציה פעילה
צינור עיבוד נתונים ב-Dataflow נכשל בשליחת המשימה, ומופיעה הודעת השגיאה הבאה:
UNSUPPORTED_OPERATION: Instance <worker_instance_name> creation failed:
Instances with guest accelerators do not support live migration
השגיאה הזו יכולה להתרחש כשמבקשים סוג מכונה של Worker עם מאיצי חומרה, אבל לא מגדירים את Dataflow לשימוש במאיצים.
כדי לבקש מאיצי חומרה, משתמשים באפשרות השירות של --worker_accelerator Dataflow או בהנחיית המשאבים של accelerator.
אם אתם משתמשים בתבניות Flex, אתם יכולים להשתמש באפשרות --additionalExperiments כדי לספק אפשרויות שירות של Dataflow. אם הכל בוצע כמו שצריך, האפשרות worker_accelerator תופיע ב-Job info panel של המשימה במסוףGoogle Cloud .
מכסת הפרויקט ... או כללי מדיניות בקרת גישה שמונעים את הפעולה
השגיאה הבאה מתרחשת:
Startup of the worker pool in zone ZONE_NAME failed to bring up any of the desired NUMBER workers. The project quota may have been exceeded or access control policies may be preventing the operation; review the Cloud Logging 'VM Instance' log for diagnostics.
השגיאה הזו מתרחשת בגלל אחת מהסיבות הבאות:
- חרגתם מאחת המכסות של Compute Engine שעליהן מתבססת יצירת ה-workers ב-Dataflow.
- בארגון שלכם יש אילוצים שאוסרים על היבט מסוים בתהליך היצירה של מכונות וירטואליות, כמו החשבון שבו משתמשים או אזור היעד.
כדי לפתור את הבעיה, צריך לבצע את השלבים הבאים לפתרון בעיות:
בדיקת היומן של המכונה הווירטואלית
- כניסה למציג היומנים של Cloud Logging
- ברשימה הנפתחת Audited Resource, בוחרים באפשרות VM Instance.
- ברשימה הנפתחת All logs, בוחרים באפשרות compute.googleapis.com/activity_log.
- סורקים את היומן כדי למצוא רשומות שקשורות לכשל ביצירת מכונת VM.
בדיקת השימוש במכסות של Compute Engine
כדי לראות את השימוש במשאבים של Compute Engine בהשוואה למכסות של Dataflow באזור הרצוי, מריצים את הפקודה הבאה:
gcloud compute regions describe [REGION]בודקים את התוצאות של המשאבים הבאים כדי לראות אם יש חריגה מהמכסה:
- מעבדים (CPU)
- DISKS_TOTAL_GB
- IN_USE_ADDRESSES
- INSTANCE_GROUPS
- מכונות
- REGIONAL_INSTANCE_GROUP_MANAGERS
במקרה הצורך, מבקשים שינוי מכסות.
בדיקת המגבלות של מדיניות הארגון
- נכנסים לדף Organization policies.
- בודקים את האילוצים כדי לראות אם יש אילוץ שמגביל את היצירה של מכונות וירטואליות בחשבון שבו אתם משתמשים (כברירת מחדל, חשבון השירות של Dataflow) או באזור שאליו אתם מטרגטים.
- אם יש לכם מדיניות שמגבילה את השימוש בכתובות IP חיצוניות, השביתו את כתובות ה-IP החיצוניות במשימה הזו. מידע נוסף על השבתת כתובות IP חיצוניות זמין במאמר הגדרת גישה לאינטרנט וכללים של חומת אש.
הזמן הקצוב לתפוגה חלף בזמן ההמתנה לעדכון מה-worker
כשמשימה ב-Dataflow נכשלת, מופיעה השגיאה הבאה:
Root cause: Timed out waiting for an update from the worker. For more information, see https://cloud.google.com/dataflow/docs/guides/common-errors#worker-lost-contact.
יש כמה סיבות אפשריות לשגיאה הזו, כולל:
עומס עבודה על העובדים
לפעמים, שגיאת זמן קצוב לתפוגה מתרחשת כשנגמר הזיכרון הפנוי (OOM) או שטח ההחלפה של ה-worker. כדי לפתור את הבעיה, קודם כל נסו להריץ את המשימה שוב. אם המשימה עדיין נכשלת ומופיעה אותה שגיאה, נסו להשתמש ב-worker עם יותר זיכרון ומקום בכונן. לדוגמה, מוסיפים את אפשרות ההפעלה הבאה של צינור עיבוד הנתונים:
--worker_machine_type=m1-ultramem-40 --disk_size_gb=500
שינוי סוג העובד יכול להשפיע על עלות החיוב. למידע נוסף, קראו את המאמר פתרון שגיאות של אין זיכרון פנוי (OOM) ב-Dataflow.
השגיאה הזו יכולה להתרחש גם כשהנתונים מכילים מפתח חם. בתרחיש הזה, ניצול המעבד (CPU) גבוה בחלק מה-workers ברוב משך הזמן של המשימה. עם זאת, מספר ה-workers לא מגיע למקסימום המותר. למידע נוסף על מפתחות חמים ופתרונות אפשריים, קראו את המאמר כתיבת צינורות עיבוד נתונים ב-Dataflow תוך התחשבות ביכולת ההתרחבות.
לפתרונות נוספים לבעיה הזו, ראו זוהה מפתח חם….
Python: Global Interpreter Lock (GIL)
אם קוד Python קורא לקוד C/C++ באמצעות מנגנון התוסף של Python, צריך לבדוק אם קוד התוסף משחרר את Python Global Interpreter Lock (GIL) בחלקים של הקוד שדורשים הרבה משאבי מחשוב ולא ניגשים למצב של Python. אם ה-GIL לא משתחרר במשך זמן רב, יכול להיות שיופיעו הודעות שגיאה כמו: Unable to retrieve status info from SDK harness <...> within allowed time ו-SDK worker appears to be permanently unresponsive. Aborting the SDK.
בספריות שמאפשרות אינטראקציות עם תוספים כמו Cython ו-PyBind יש פרימיטיבים לשליטה בסטטוס של GIL. אפשר גם לשחרר את ה-GIL באופן ידני ולהחזיר אותו לפני שמחזירים את השליטה למפרש Python, באמצעות פקודות המאקרו Py_BEGIN_ALLOW_THREADS ו-Py_END_ALLOW_THREADS. מידע נוסף זמין במאמר Thread State and the Global Interpreter Lock במסמכי התיעוד של Python.
יכול להיות שאפשר לאחזר את דוחות קריסות ה-stacktrace של שרשור שמחזיק את ה-GIL ב-worker פעיל של Dataflow, באופן הבא:
# SSH into a running Dataflow worker VM that is currently a straggler, for example:
gcloud compute ssh --zone "us-central1-a" "worker-that-emits-unable-to-retrieve-status-messages" --project "project-id"

# Install nerdctl to inspect a running container with ptrace privileges.
wget https://github.com/containerd/nerdctl/releases/download/v2.0.2/nerdctl-2.0.2-linux-amd64.tar.gz
sudo tar Cxzvvf /var/lib/toolbox  nerdctl-2.0.2-linux-amd64.tar.gz
alias nerdctl="sudo /var/lib/toolbox/nerdctl -n k8s.io"

# Find a container running the Python SDK harness.
CONTAINER_ID=`nerdctl ps | grep sdk-0-0 | awk '{print $1}'`

# Start a shell in the running container.
nerdctl exec --privileged -it $CONTAINER_ID /bin/bash

# Inspect python processes in the running container.
ps -A | grep python
PYTHON_PID=$(ps -A | grep python | head -1 | awk '{print $1}')

# Use pystack to retrieve stacktraces from the python process.
pip install pystack

pystack remote --native $PYTHON_PID

# Find which thread holds the GIL and inspect the stacktrace.
pystack remote --native $PYTHON_PID | grep -iF "Has the GIL" -A 100

# Alternately, use inspect with gdb.
apt update && apt install -y gdb
gdb --quiet \
  --eval-command="set pagination off" \
  --eval-command="thread apply all bt" \
  --eval-command "set confirm off" \
  --eval-command="quit"  -p $PYTHON_PID
בצינורות עיבוד נתונים ב-Python, בהגדרת ברירת המחדל, Dataflow מניח שכל תהליך Python שפועל ב-workers משתמש ביעילות בליבת vCPU אחת. אם קוד הצינור עוקף את מגבלות ה-GIL, למשל באמצעות ספריות שמוטמעות ב-C++, רכיבי העיבוד עשויים להשתמש במשאבים מיותר מליבת vCPU אחת, ויכול להיות שה-workers לא יקבלו מספיק משאבי מעבד (CPU). כדי לעקוף את הבעיה, מפחיתים את מספר ה-threads ב-workers.
הגדרה של DoFn לטווח ארוך
אם אתם לא משתמשים ב-Portable Runner, קריאה ארוכה ל-DoFn.Setup עלולה לגרום לשגיאה הבאה:
Timed out waiting for an update from the worker
באופן כללי, כדאי להימנע מפעולות שדורשות זמן רב בתוך DoFn.Setup.
שגיאות זמניות בפרסום בנושא
כשמשימת הסטרימינג משתמשת במצב הסטרימינג "לפחות פעם אחת" ומפרסמת בכיור Pub/Sub, השגיאה הבאה מופיעה ביומני המשימה:
There were transient errors publishing to topic
אם המשימה פועלת כמו שצריך, השגיאה הזו לא מזיקה ואפשר להתעלם ממנה. Dataflow מנסה באופן אוטומטי לשלוח מחדש את ההודעות של Pub/Sub עם השהיה (backoff delay).
אי אפשר לאחזר את הנתונים כי אין התאמה בין האסימון למפתח
השגיאה הבאה מציינת שפריט העבודה שעובר עיבוד הוקצה מחדש ל-worker אחר:
Unable to fetch data due to token mismatch for key
בדרך כלל זה קורה במהלך התאמה אוטומטית לעומס, אבל זה יכול לקרות בכל שלב. המערכת תנסה שוב לבצע את כל העבודות שהושפעו. אפשר להתעלם מהשגיאה הזו.
בעיות ביחסי התלות של Java
מחלקות וספריות לא תואמות עלולות לגרום לבעיות ביחסי התלות של Java. אם יש בעיות בתלויות של Java בצינור עיבוד הנתונים, יכול להיות שתופיע אחת מהשגיאות הבאות:
-
NoClassDefFoundError: השגיאה הזו מתרחשת כשמחלקה שלמה לא זמינה בזמן הריצה. היא יכולה להיגרם מבעיות כלליות בהגדרות או מחוסר תאימות בין גרסת ה-protobuf של Beam לבין הפרוטוקולים שנוצרו על ידי הלקוח (לדוגמה, הבעיה הזו).-
NoSuchMethodError: השגיאה הזו מתרחשת כשהמחלקה ב-classpath משתמשת בגרסה שלא מכילה את ה-method הנכונה, או כשחתימת ה-method השתנתה.
-
-
NoSuchFieldError: השגיאה הזו מתרחשת כשהמחלקה ב-classpath משתמשת בגרסה שאין בה שדה שנדרש בזמן הריצה. -
FATAL ERROR in native method: השגיאה הזו מתרחשת כשאי אפשר לטעון כמו שצריך תלות מובנית. כשמשתמשים ב-uber JAR (מוצלל), אל תכללו באותו JAR ספריות שמשתמשות בחתימות (כמו Conscrypt).
אם הצינור מכיל קוד והגדרות ספציפיים למשתמש, הקוד לא יכול להכיל גרסאות מעורבות של ספריות. אם אתם משתמשים בספרייה לניהול יחסי תלות, מומלץ להשתמש ב-Google Cloud Libraries BOM.
אם אתם משתמשים ב-Apache Beam SDK, כדי לייבא את ה-BOM של הספריות הנכונות, השתמשו ב-beam-sdks-java-io-google-cloud-platform-bom:
Maven
<dependencyManagement>
  <dependencies>
    <dependency>
      <groupId>org.apache.beam</groupId>
      <artifactId>beam-sdks-java-google-cloud-platform-bom</artifactId>
      <version>BEAM_VERSION</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>
Gradle
dependencies {
    implementation(platform("org.apache.beam:beam-sdks-java-google-cloud-platform-bom:BEAM_VERSION"))
}
מידע נוסף זמין במאמר ניהול יחסי תלות של צינורות עיבוד נתונים ב-Dataflow.
InaccessibleObjectException ב-JDK 17 ואילך
כשמריצים צינורות עיבוד נתונים עם Java Platform, Standard Edition Development Kit (JDK) בגרסה 17 ואילך, יכול להיות שהשגיאה הבאה תופיע בקובצי היומן של ה-worker:
Unable to make protected METHOD accessible:
    module java.MODULE does not "opens java.MODULE" to ...
הבעיה הזו מתרחשת כי החל מגרסה 9 של Java, צריך אפשרויות של מכונה וירטואלית של Java (JVM) במודול פתוח כדי לגשת לרכיבים הפנימיים של ה-JDK. בגרסאות Java 16 ואילך, תמיד צריך להגדיר אפשרויות JVM של מודולים פתוחים כדי לגשת לרכיבים הפנימיים של ה-JDK.
כדי לפתור את הבעיה, כשמעבירים מודולים לפתיחה בצינור עיבוד הנתונים ב-Dataflow, צריך להשתמש בפורמט MODULE/PACKAGE=TARGET_MODULE(,TARGET_MODULE)* עם האפשרות jdkAddOpenModules של צינור עיבוד הנתונים. הפורמט הזה מאפשר גישה לספרייה הנדרשת.
לדוגמה, אם השגיאה היא module java.base does not "opens java.lang" to
unnamed module @..., צריך לכלול את האפשרות הבאה כשמריצים את צינור עיבוד הנתונים:
--jdkAddOpenModules=java.base/java.lang=ALL-UNNAMED
מידע נוסף זמין במסמכי התיעוד של המחלקה DataflowPipelineOptions.
התקדמות פריט העבודה ב-Error Reporting
בצינורות עיבוד נתונים ב-Java, אם אתם לא משתמשים ב-Portable Runner, יכול להיות שתופיע השגיאה הבאה:
Error reporting workitem progress update to Dataflow service: ...
השגיאה הזו נגרמת בגלל חריגה שלא טופלה במהלך עדכון ההתקדמות של פריט עבודה, למשל במהלך פיצול של מקור. ברוב המקרים, אם קוד המשתמש של Apache Beam גורם לחריגה לא מטופלת, פריט העבודה נכשל וגורם לצינור עיבוד הנתונים להיכשל.עם זאת, חריגות ב-Source.split לא מטופלות, כי החלק הזה של הקוד נמצא מחוץ לפריט העבודה. כתוצאה מכך, רק יומן השגיאות נרשם.
השגיאה הזו בדרך כלל לא מזיקה אם היא מתרחשת רק מדי פעם. עם זאת, כדאי לטפל בחריגות בצורה חלקה בתוך הקוד של Source.split.
שגיאות במחבר ל-BigQuery
בקטעים הבאים מפורטות שגיאות נפוצות במחבר ל-BigQuery, ומוסבר איך לפתור אותן.
quotaExceeded
כשמשתמשים במחבר ל-BigQuery כדי לכתוב ב-BigQuery באמצעות הזנות זרם נתונים, תפוקת הכתיבה נמוכה מהצפוי, ויכולה להתרחש השגיאה הבאה:
quotaExceeded
יכול להיות שקצב העיבוד איטי כי הצינור חורג ממכסת הזנת זרם הנתונים הזמינה ב-BigQuery. אם כן, הודעות השגיאה שקשורות למכסות מ-BigQuery מופיעות ביומני ה-worker של Dataflow (חפשו שגיאות מסוג quotaExceeded).
אם מופיעות שגיאות מסוג quotaExceeded, כדי לפתור את הבעיה:
- כשמשתמשים ב-Apache Beam SDK ל-Java, מגדירים את האפשרות
ignoreInsertIds()של BigQuery sink. - כשמשתמשים ב-Apache Beam SDK ל-Python, משתמשים באפשרות
ignore_insert_ids.
ההגדרות האלה מאפשרות לכם להזין זרם נתונים ב-BigQuery בקצב של 1GB לשנייה לכל פרויקט. למידע נוסף על אזהרות שקשורות לביטול כפילויות אוטומטי של הודעות, קראו את המסמכים של BigQuery. כדי להגדיל את המכסה של הזנת זרם נתונים ב-BigQuery ליותר מ-1GBps, שלחו בקשה דרך מסוףGoogle Cloud .
אם לא מופיעות שגיאות שקשורות למכסות ביומני ה-worker, יכול להיות שהבעיה היא שהפרמטרים שקשורים לאיסוף או לאיסוף באצווה כברירת מחדל לא מספקים מספיק מקביליות כדי להרחיב את צינור עיבוד הנתונים. כדי להגיע לביצועים הרצויים כשכותבים ב-BigQuery באמצעות הזנת זרם נתונים, אפשר לשנות כמה הגדרות שקשורות למחבר ל-BigQuery של Dataflow. לדוגמה, ב-Apache Beam SDK ל-Java, צריך להתאים את numStreamingKeys למספר המקסימלי של ה-workers, ואולי להגדיל את insertBundleParallelism כדי להגדיר את המחבר ל-BigQuery כך שיכתוב ל-BigQuery באמצעות יותר שרשורים מקבילים.
ב-BigQueryPipelineOptions מפורטות ההגדרות שאפשר להשתמש בהן ב-Apache Beam SDK ל-Java, ובטרנספורמציה WriteToBigQuery מפורטות ההגדרות שאפשר להשתמש בהן ב-Apache Beam SDK ל-Python.
rateLimitExceeded
כשמשתמשים במחבר ל-BigQuery, מופיעה השגיאה הבאה:
rateLimitExceeded
השגיאה הזו מוצגת אם נשלחות יותר מדי בקשות API של BigQuery בפרק זמן קצר. ל-BigQuery יש מכסות לטווח קצר. יכול להיות שצינור עיבוד הנתונים ב-Dataflow יחרוג זמנית מהמכסה הזו. בתרחיש הזה, יכול להיות שבקשות ה-API מצינור עיבוד הנתונים של Dataflow ל-BigQuery ייכשלו, וכתוצאה מכך יופיעו שגיאות rateLimitExceeded ביומני ה-worker.
Dataflow מנסה שוב במקרה של כשלים כאלה, כך שאפשר להתעלם מהשגיאות האלה. אם לדעתכם צינור עיבוד הנתונים שלכם מושפע משגיאות rateLimitExceeded, פנו אל Cloud Customer Care.
שגיאות שונות
בקטעים הבאים מפורטות שגיאות שונות שאתם עשויים להיתקל בהן, ושלבים לפתרון הבעיות.
לא ניתן להקצות sha384
המשימה פועלת כמו שצריך, אבל ביומני המשימה מופיעה השגיאה הבאה:
ima: Can not allocate sha384 (reason: -2)
אם המשימה פועלת כמו שצריך, השגיאה הזו לא מזיקה ואפשר להתעלם ממנה. לפעמים ההודעה הזו מופיעה בגלל קובצי האימג' הבסיסיים של ה-worker VM. Dataflow מגיב באופן אוטומטי ומטפל בבעיה הבסיסית.
יש בקשה להוספת תכונה כדי לשנות את הרמה של ההודעה הזו מ-WARN ל-INFO. למידע נוסף, קראו את המאמר הורדת רמת יומן השגיאות של הפעלת מערכת Dataflow ל-WARN או ל-INFO.
שגיאה באתחול של בודק הפלאגינים הדינמיים
המשימה פועלת כמו שצריך, אבל ביומני המשימה מופיעה השגיאה הבאה:
Error initializing dynamic plugin prober" err="error (re-)creating driver directory: mkdir /usr/libexec/kubernetes: read-only file system
אם המשימה פועלת כמו שצריך, השגיאה הזו לא מזיקה ואפשר להתעלם ממנה. השגיאה הזו מתרחשת כשמשימת Dataflow מנסה ליצור ספרייה בלי הרשאות הכתיבה הנדרשות, והמשימה נכשלת. אם המשימה תצליח, סימן שהספרייה לא הייתה נחוצה או ש-Dataflow טיפל בבעיה הבסיסית.
יש בקשה להוספת תכונה כדי לשנות את הרמה של ההודעה הזו מ-WARN ל-INFO. למידע נוסף, קראו את המאמר הורדת רמת יומן השגיאות של הפעלת מערכת Dataflow ל-WARN או ל-INFO.
אין אובייקט כזה: pipeline.pb
כשמציגים רשימת משימות באמצעות האפשרות JOB_VIEW_ALL, מתקבלת השגיאה הבאה:
No such object: BUCKET_NAME/PATH/pipeline.pb
השגיאה הזו יכולה להתרחש אם מוחקים את הקובץ pipeline.pb מקובצי ה-staging של המשימה.
דילוג על סנכרון הפודים
המשימה פועלת כמו שצריך, אבל אחת מהשגיאות הבאות מופיעה ביומני המשימה:
Skipping pod synchronization" err="container runtime status check may not have completed yet"
או:
Skipping pod synchronization" err="[container runtime status check may not have completed yet, PLEG is not healthy: pleg has yet to be successful]"
אם המשימה פועלת כמו שצריך, השגיאות האלה לא מזיקות ואפשר להתעלם מהן.
ההודעה container runtime status check may not have completed yet מופיעה כש-kubelet של Kubernetes מדלג על הסנכרון של pod-ים כי הוא ממתין לאתחול של סביבת זמן הריצה של הקונטיינר. התרחיש הזה קורה מכמה סיבות, למשל כשסביבת זמן הריצה של הקונטיינר התחילה לאחרונה או מופעלת מחדש.
כשההודעה כוללת את PLEG is not healthy: pleg has yet to be
successful, ה-kubelet ממתין עד שה-PLEG (מחולל אירועים במחזור החיים של pod) יהיה תקין לפני סנכרון ה-pods. ה-PLEG אחראי ליצירת אירועים שמשמשים את ה-kubelet למעקב אחרי מצב ה-pods.
יש בקשה להוספת תכונה כדי לשנות את הרמה של ההודעה הזו מ-WARN ל-INFO. למידע נוסף, קראו את המאמר הורדת רמת יומן השגיאות של הפעלת מערכת Dataflow ל-WARN או ל-INFO.
המלצות
במאמר תובנות מוסבר איך להשתמש בהמלצות שנוצרו על ידי Dataflow Insights.