


BigQuery 會在查詢工作中嵌入診斷查詢計畫和時間點資訊。這與其他資料庫和分析系統中,EXPLAIN 等陳述式提供的資訊類似。這項資訊可從 jobs.get 等方法的 API 回應中擷取。
如果是長時間執行的查詢,BigQuery 會定期更新這些統計資料。這些更新與輪詢作業狀態的頻率無關,但通常不會超過每 30 秒一次。此外,如果查詢作業未使用執行資源 (例如模擬測試要求或可從快取結果提供的結果),就不會包含額外的診斷資訊,但可能會有其他統計資料。
背景
BigQuery 執行查詢時,會將 SQL 轉換為由階段組成的執行圖。階段是由步驟組成,這些是執行查詢邏輯的基本作業。BigQuery 採用高度分散的平行架構,可平行執行階段,縮短延遲時間。階段 使用隨機重組 (快速分散式記憶體架構) 相互通訊。
查詢計畫會使用「工作單元」和「工作者」這兩個詞彙,描述階段平行處理。在 BigQuery 的其他位置,您可能會看到「運算單元」一詞,這是查詢執行多個層面的抽象表示法,包括運算、記憶體和 I/O 資源。Slot 會平行執行階段的個別工作單元。頂層工作統計資料會根據這項抽象會計作業,使用 totalSlotMs 提供個別查詢費用。
查詢執行的另一項重要屬性是,BigQuery 可以在查詢執行期間修改查詢計畫。舉例來說,BigQuery 會導入重新分割階段,改善查詢工作站之間的資料分配情形,進而提升平行處理能力並縮短查詢延遲時間。
除了查詢計畫外,查詢工作也會顯示執行時間軸,其中會列出已完成、待處理和進行中的工作單元。查詢可以有多個階段,同時有作用中的工作人員,時間軸則會顯示查詢的整體進度。
使用 Google Cloud 控制台查看執行圖
在 Google Cloud 控制台中,按一下「執行作業詳細資料」按鈕,即可查看已完成查詢的查詢計畫詳細資料。
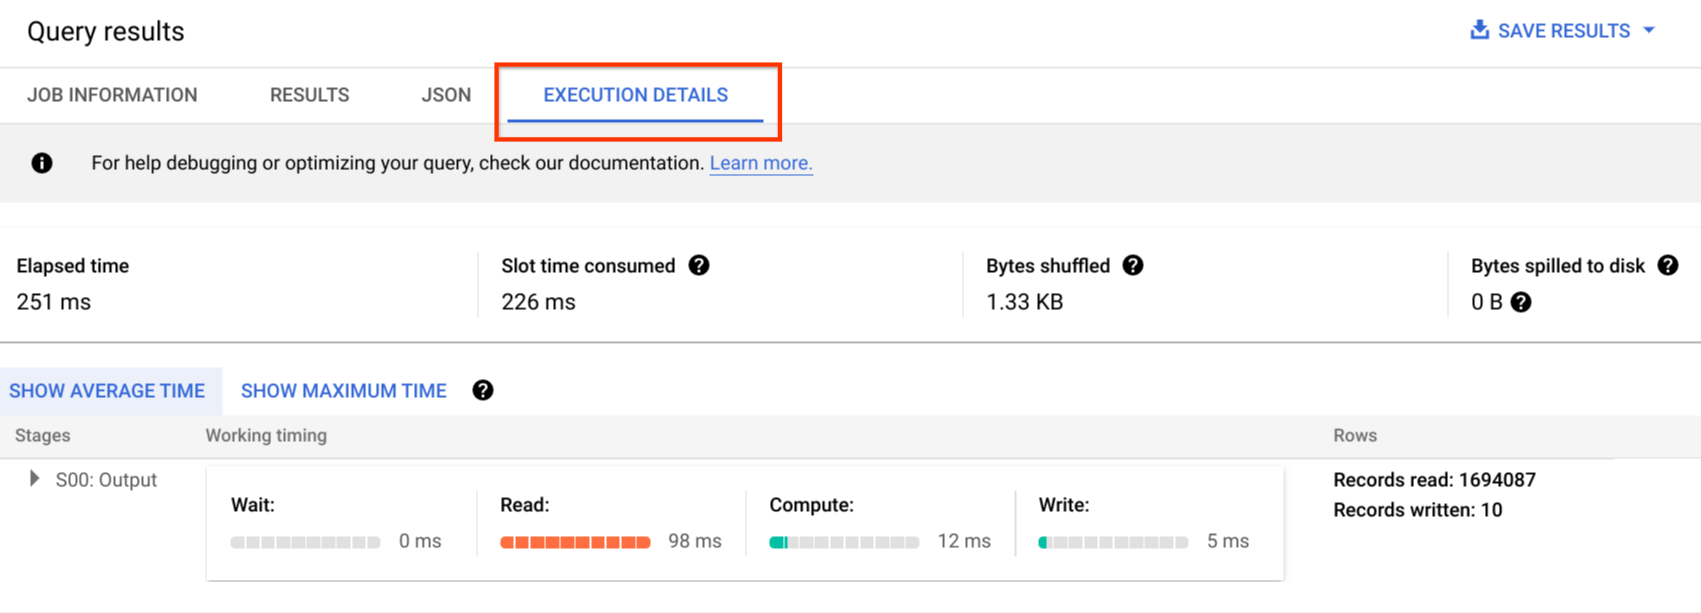
查詢計畫資訊
在 API 回應中,查詢計畫會以查詢階段清單的形式呈現。 清單中的每個項目都會顯示各階段的總覽統計資料、詳細步驟資訊和階段時間分類。 Google Cloud 控制台不會顯示所有詳細資料,但 API 回應中可能包含所有詳細資料。
瞭解執行圖
在 Google Cloud 控制台中,按一下「執行圖」分頁標籤,即可查看查詢計畫詳細資料。
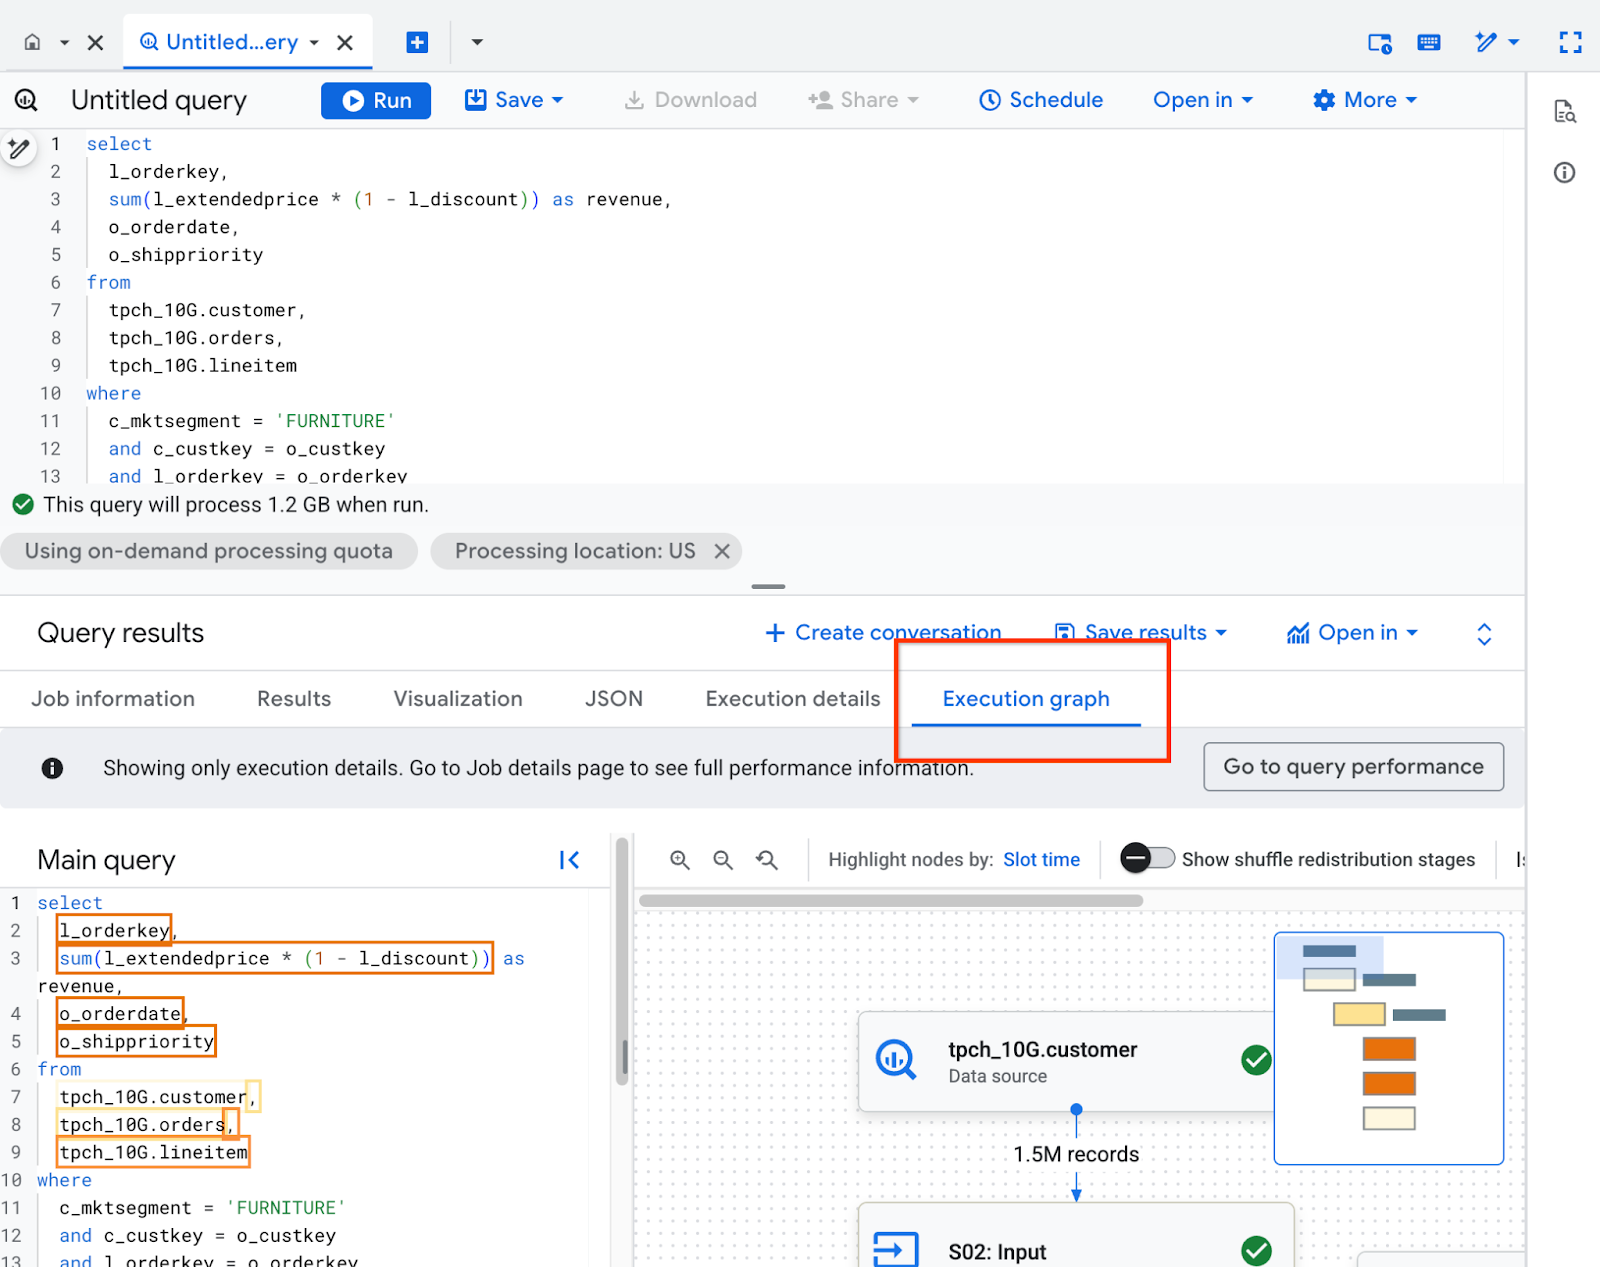
「執行圖」面板的編排方式如下:
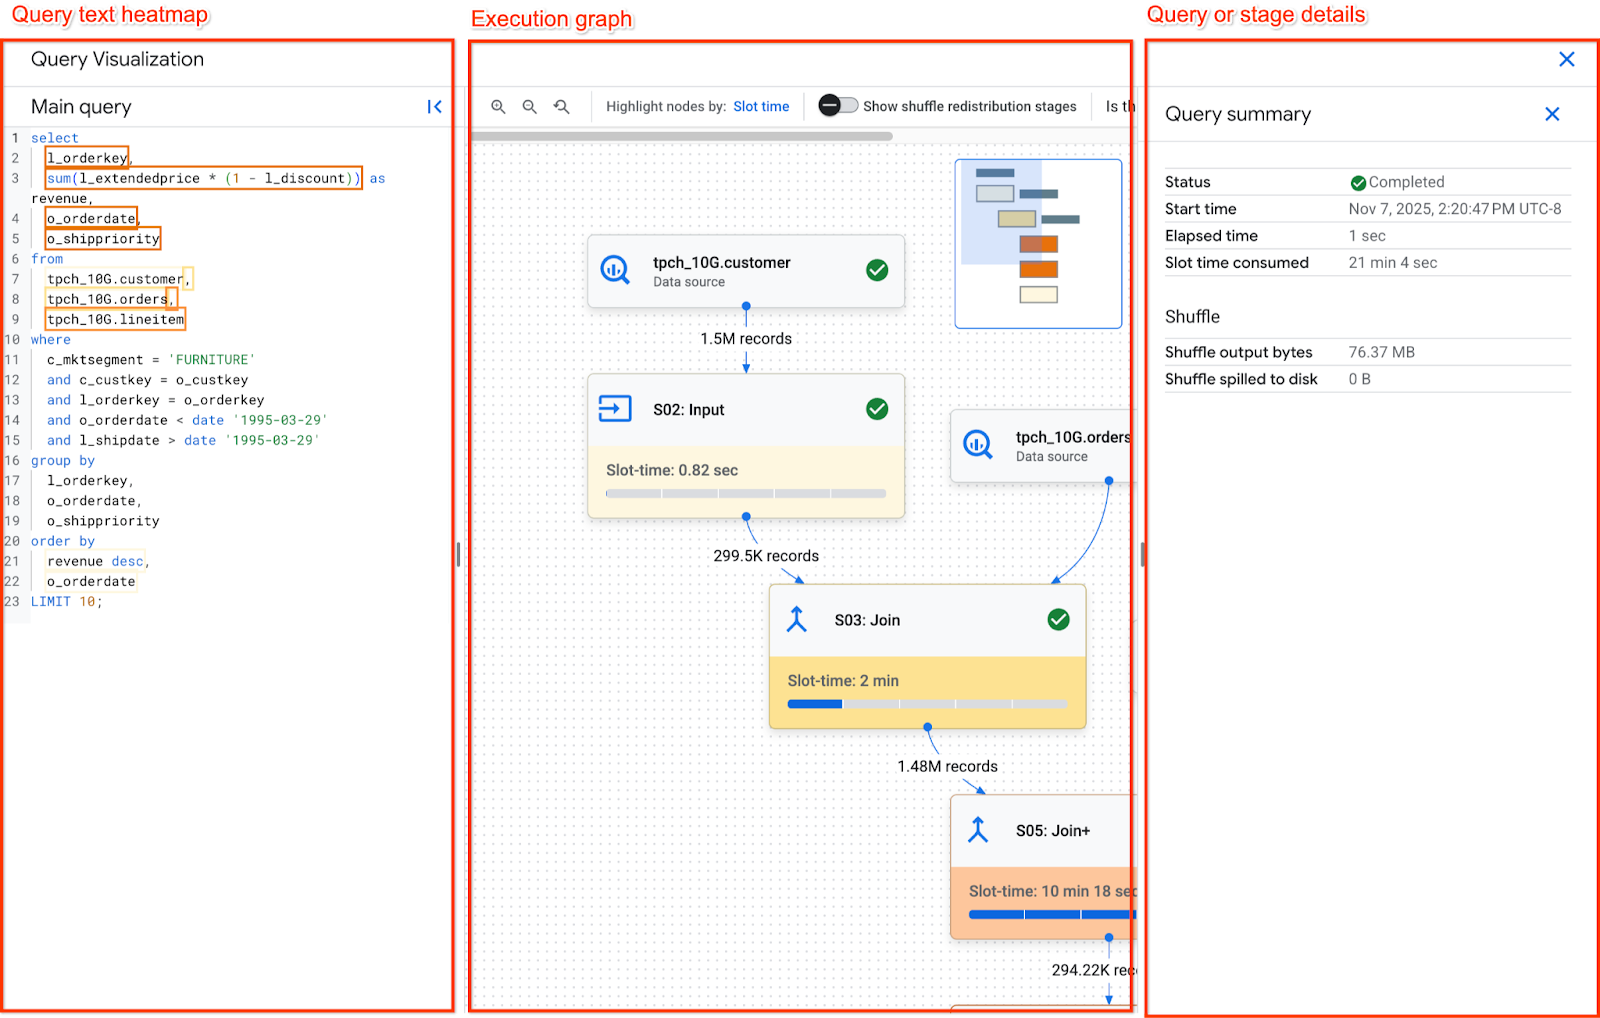
- 中間是執行圖。這個圖表會將階段顯示為節點,並將階段間交換的隨機記憶體顯示為邊緣。
- 左側面板會顯示查詢文字熱視圖。顯示查詢執行的主要查詢文字,以及任何參照的檢視區塊。
- 右側面板會顯示查詢或階段詳細資料。
瀏覽執行圖
執行圖會根據運算單元時間,為圖中的節點套用色彩配置。相較於圖中的其他階段,深紅色的節點會占用較多運算單元時間。
如要瀏覽執行圖,可以:
- 按住圖表背景並拖曳,即可平移至圖表的不同區域。
- 使用滑鼠滾輪縮放圖表。
- 按住右上方的迷你地圖,即可平移至圖表的不同區域。
按一下圖表中的階段,即可查看所選階段的詳細資料。階段詳細資料包含:
- 統計資料。如要瞭解統計資料的詳細資訊,請參閱「階段總覽」。
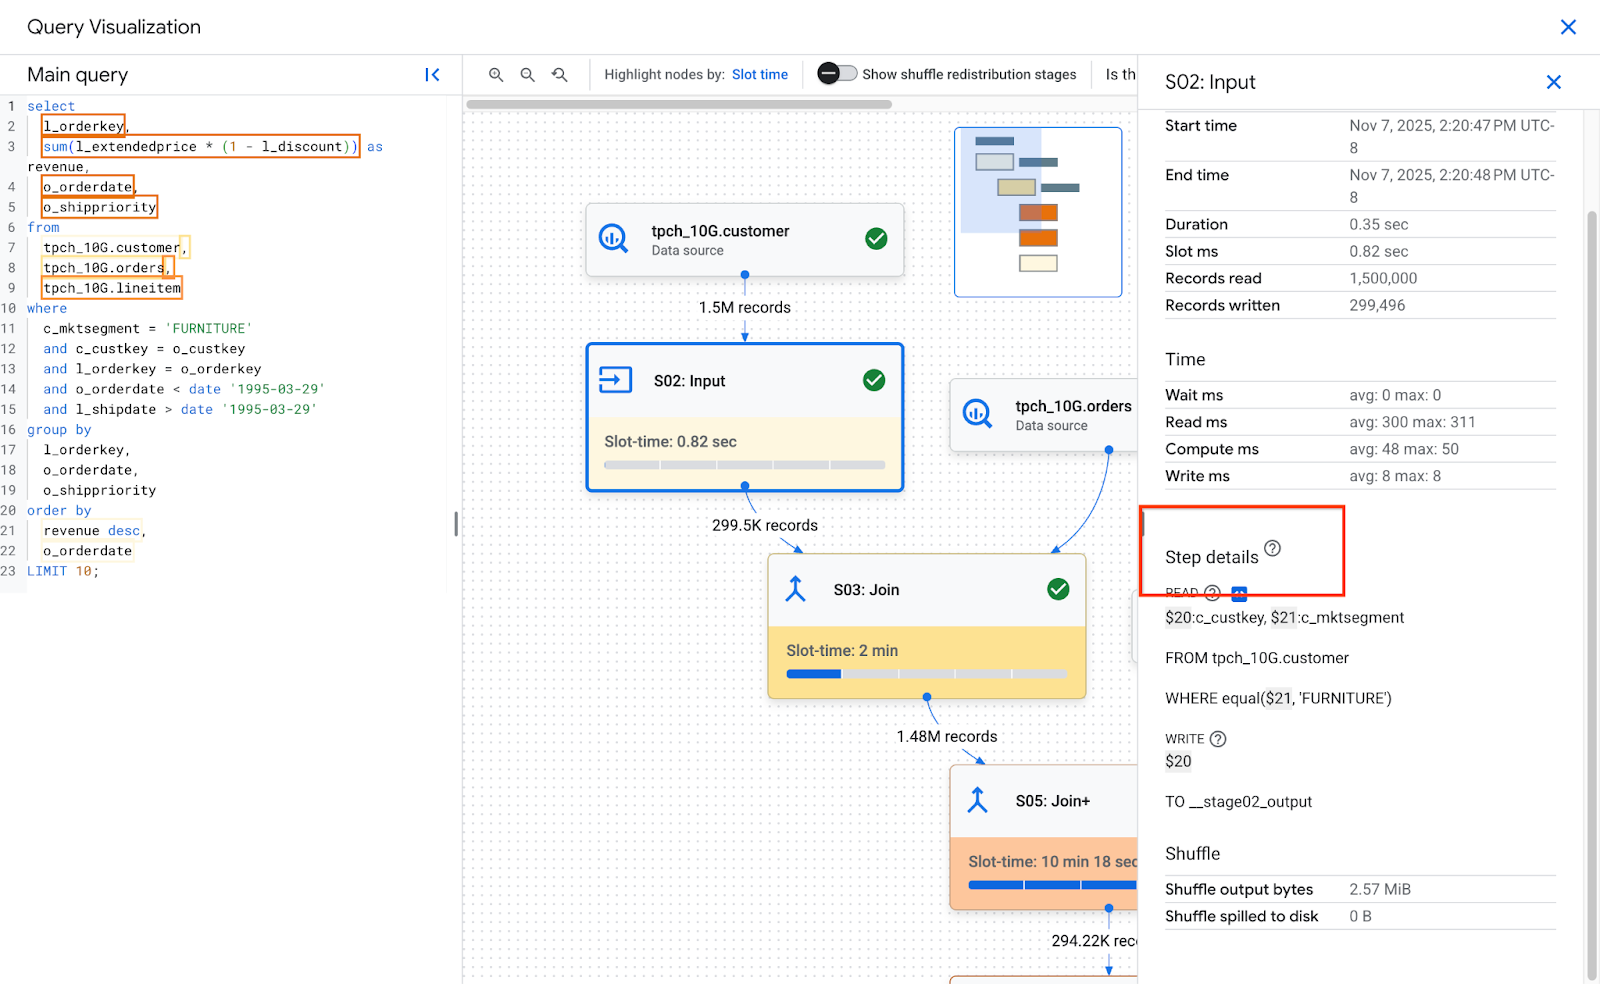
- 步驟詳細資料。步驟說明執行查詢邏輯的個別作業。
步驟詳細資料
階段由步驟組成,步驟是執行查詢邏輯的個別作業。步驟包含子步驟,說明步驟在虛擬程式碼中的作用。 子步驟會使用變數來描述步驟之間的關係。變數開頭為貨幣符號,後面接著不重複的數字。變數編號不會在各階段之間共用。
下圖顯示階段的步驟:
以下是階段步驟的範例:
  READ
  $30:l_orderkey, $31:l_quantity
  FROM lineitem

  AGGREGATE
  GROUP BY $100 := $30
  $70 := SUM($31)

  WRITE
  $100, $70
  TO __stage00_output
  BY HASH($100)
範例步驟說明下列事項:
- 這個階段從資料表 lineitem 讀取 l_orderkey 和 l_quantity 欄,並分別將值儲存在 $30 和 $31 變數中。
- 這個階段會匯總 $30 和 $31 變數,並分別將匯總結果儲存至 $100 和 $70 變數。
- 這個階段會將 $100 和 $70 變數的結果寫入 shuffle。這個階段會根據 $100,在隨機記憶體中排序結果。
如要瞭解步驟類型和最佳化方式的完整詳細資料,請參閱「解讀及最佳化步驟」。
如果查詢的執行圖表夠複雜,提供完整子步驟會導致擷取查詢資訊時發生酬載大小問題,BigQuery 就可能會截斷子步驟。
查詢文字熱視圖
BigQuery 可以將部分階段步驟對應至查詢文字。查詢文字熱視圖會顯示所有對應的查詢文字和階段步驟。系統會根據階段的總運算單元時間,醒目顯示查詢文字,這些階段的步驟已對應查詢文字。
下圖顯示醒目顯示的查詢文字:
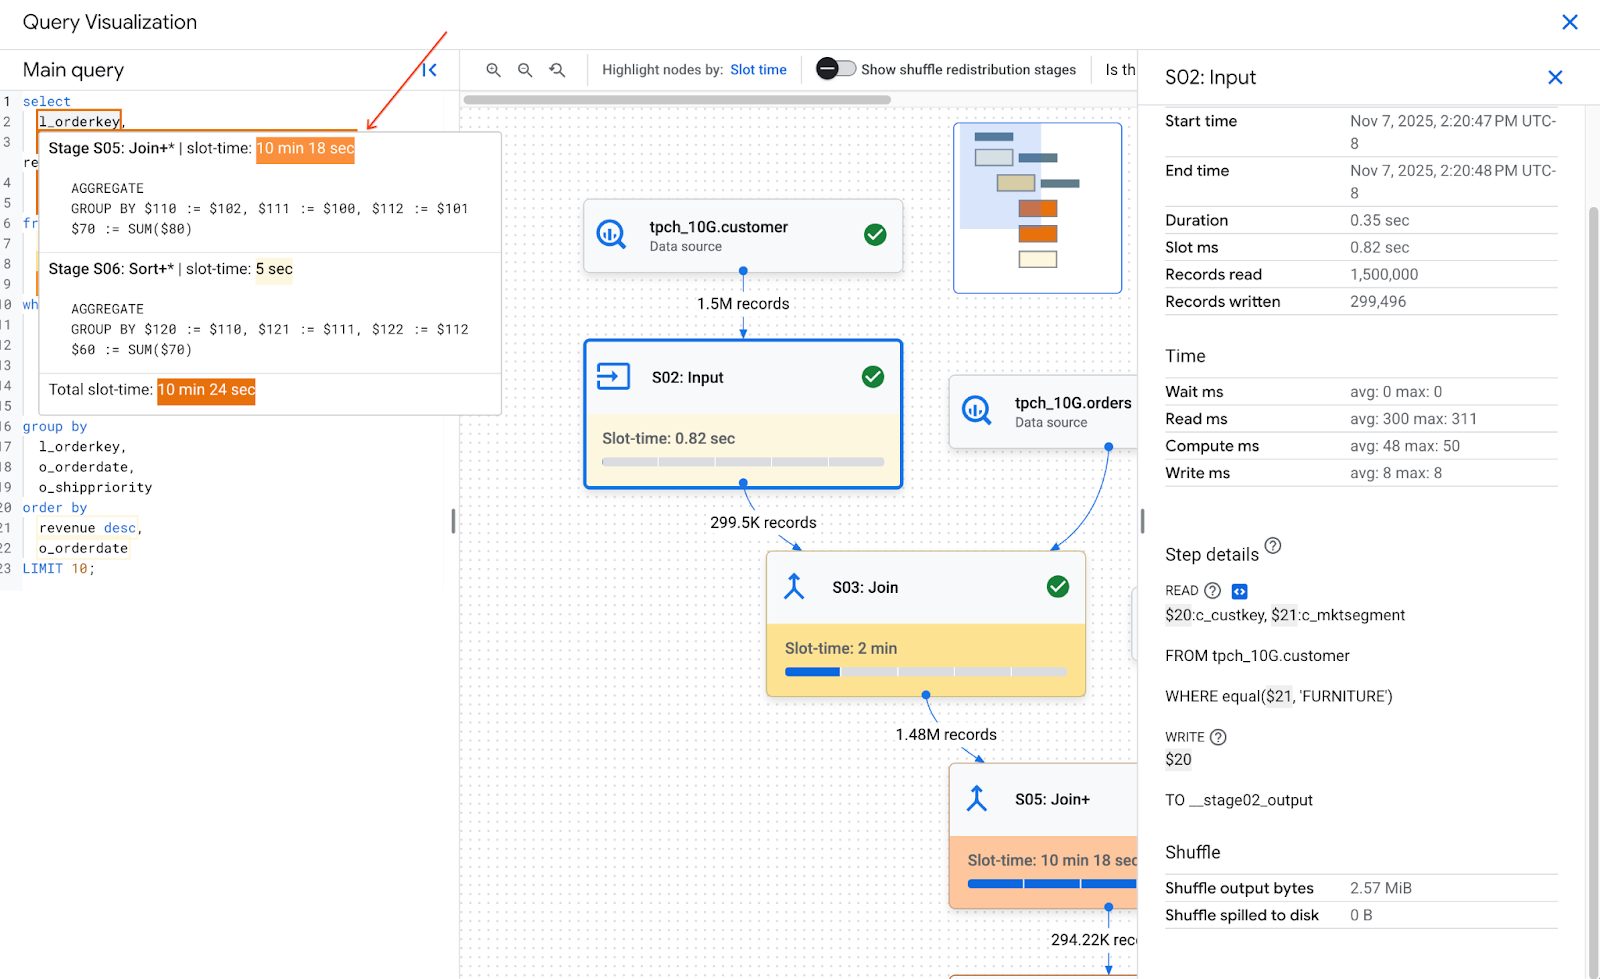
將指標懸停在查詢文字的對應部分上,會顯示工具提示,列出對應查詢文字的所有階段步驟,以及階段運算單元時間。點選對應的查詢文字,即可選取執行圖中的階段,並在右側面板開啟階段詳細資料。

查詢文字的單一部分可以對應至多個階段。工具提示會列出每個對應的階段及其時段。按一下查詢文字,即可醒目顯示對應的階段,並將圖表的其餘部分設為灰色。隨後點選特定階段,即可查看詳細資料。
下圖顯示查詢文字與步驟詳細資料的關聯:
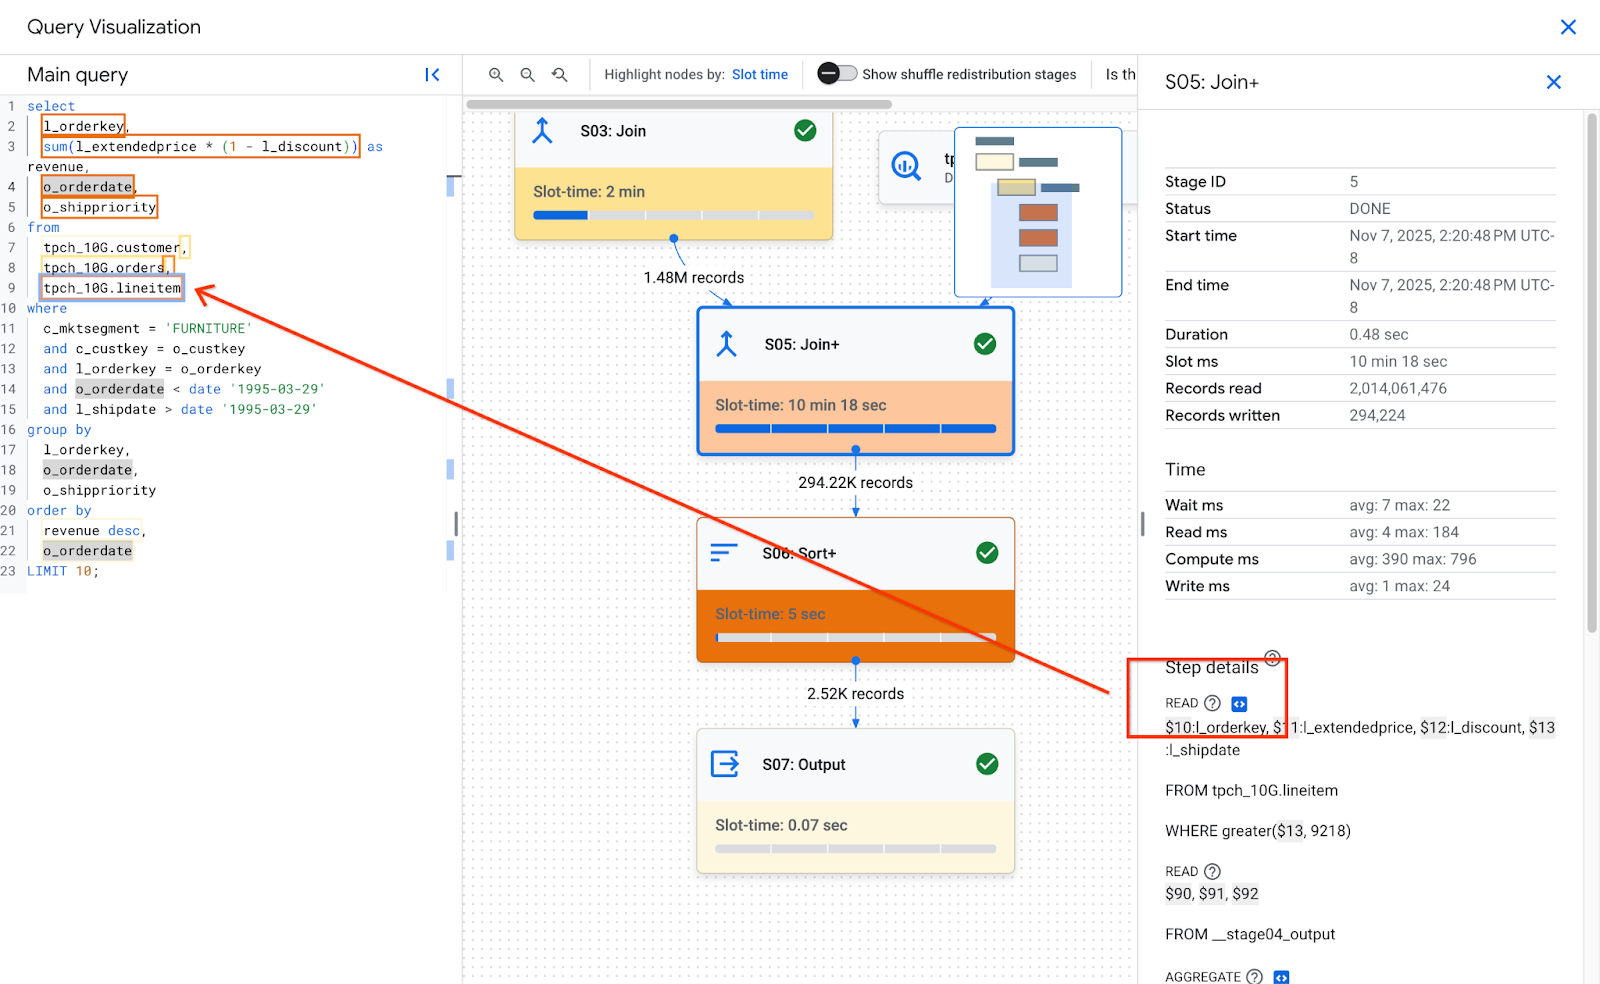
在階段的「步驟詳細資料」部分中,如果步驟對應至查詢文字,該步驟會顯示程式碼圖示。按一下程式碼圖示,即可醒目顯示左側查詢文字中對應的部分。
請務必注意,熱度圖顏色是根據整個階段的時段而定。由於 BigQuery 不會測量步驟的時段,熱度圖不會顯示對應查詢文字特定部分的實際時段。在大多數情況下,階段只會執行單一複雜步驟,例如聯結或匯總。因此熱視圖顏色是適當的。不過,如果階段是由執行多項複雜作業的步驟組成,熱視圖顏色可能會過度呈現熱視圖中的實際時段。在這種情況下,請務必瞭解組成階段的其他步驟,以便更全面地掌握查詢的效能。
如果查詢使用檢視區塊,且階段的步驟已對應至檢視區塊的查詢文字,查詢文字熱度圖就會顯示檢視區塊的名稱和查詢文字,以及對應項目。不過,如果檢視區塊遭到刪除,或是您失去檢視區塊的 bigquery.tables.get IAM 權限,查詢文字熱度圖就不會顯示檢視區塊的階段步驟對應。
階段總覽
各階段的總覽欄位可包含下列項目:
| API 欄位 | 說明 |
|---|---|
id |
階段的專屬數字 ID。 |
name |
階段的簡式摘要名稱。階段中的 steps 提供執行步驟的額外詳細資料。 |
status |
階段的執行狀態。可能的狀態包括「待處理」、「執行中」、「已完成」、「失敗」及「已取消」。 |
inputStages |
構成階段相依關係圖的 ID 清單。例如,JOIN 階段通常需要兩個相依階段,用來準備 JOIN 關係左右兩側的資料。 |
startMs |
時間戳記 (以 Epoch 時間毫秒為單位),代表階段內第一個工作人員開始執行的時間。 |
endMs |
代表上次工作人員完成執行的時間戳記 (以 Epoch 毫秒為單位)。 |
steps |
階段內執行步驟的詳細清單。詳情請參閱下一節。 |
recordsRead |
以記錄數的形式輸入階段大小,適用於所有階段工作站。 |
recordsWritten |
所有階段工作站中階段的輸出大小,以記錄數表示。 |
parallelInputs |
階段中可平行執行的工作單元數。視階段和查詢而定,這可能代表資料表中的直欄區隔數量,或是中間隨機播放中的分割數量。 |
completedParallelInputs |
階段中已完成的工作單元數。在某些查詢中,不一定要完成階段中的所有輸入後,該階段才能完成。 |
shuffleOutputBytes |
代表某一查詢階段中所有工作站上的寫入位元組總數。 |
shuffleOutputBytesSpilled |
在階段之間傳輸大量資料的查詢,可能需要以磁碟型傳輸為備用方法。溢出位元組統計資料會顯示溢出至磁碟的資料量。取決於最佳化演算法,因此無法針對任何指定查詢進行判斷。 |
每階段時間分類
查詢階段會提供階段時間分類,包括相對和絕對形式。由於每個執行階段代表一或多個獨立工作站執行的工作,因此系統會提供平均時間和最差情況時間。這些時間代表某個階段中所有工作人員的平均績效,以及特定分類中績效最差的工作人員的長尾績效。此外,平均時間和最長時間會進一步細分為絕對和相對表示法。如果是以比率為準的統計資料,系統會以分數形式提供資料,代表任何 worker 在任何區隔中花費的最長時間。
Google Cloud 控制台會使用相對時間表示法呈現階段時間。
階段時間資訊的報告如下所示:
| 相對時間 | 絕對時間 | 比率分子 |
|---|---|---|
waitRatioAvg |
waitMsAvg |
一般工作站在等待排程上花費的時間。 |
waitRatioMax |
waitMsMax |
最慢的工作站在等待排程上花費的時間。 |
readRatioAvg |
readMsAvg |
平均工作站讀取輸入資料所花費的時間。 |
readRatioMax |
readMsMax |
最慢的 worker 讀取輸入資料所花費的時間。 |
computeRatioAvg |
computeMsAvg |
平均工作站耗用 CPU 作業時間。 |
computeRatioMax |
computeMsMax |
最慢的工作站耗用 CPU 綁定時間。 |
writeRatioAvg |
writeMsAvg |
一般工作站在寫入輸出資料上花費的時間。 |
writeRatioMax |
writeMsMax |
最慢的工作站在寫入輸出資料上花費的時間。 |
步驟總覽
步驟包含階段中每個工作者執行的作業,以作業的排序清單呈現。每個步驟作業都有類別,部分作業會提供更詳細的資訊。查詢計畫中顯示的作業類別包括:
| 步驟類別 | 說明 |
|---|---|
READ |
從輸入資料表或中繼重組中讀取一或多個資料欄。步驟詳細資料只會顯示讀取的前 16 欄。 |
WRITE |
將一或多個資料欄寫入輸出資料表或中繼重組中。若是階段的 HASH 分區輸出,這也包含做為分區索引鍵使用的資料欄。 |
COMPUTE |
運算式評估和 SQL 函式。 |
FILTER |
由 WHERE、OMIT IF 和 HAVING 子句使用。 |
SORT |
ORDER BY 作業,包括資料欄索引鍵和排序順序。 |
AGGREGATE |
為 GROUP BY 或 COUNT 等子句實作匯總。 |
LIMIT |
實作 LIMIT 子句。 |
JOIN |
為 JOIN 等子句實作彙整,包括彙整類型和可能的彙整條件。 |
ANALYTIC_FUNCTION |
呼叫視窗函式 (又稱「分析函式」)。 |
USER_DEFINED_FUNCTION |
使用者定義函式的呼叫。 |
UPDATE |
修改 UPDATE 陳述式的目標資料表中的現有資料列,包括修改過的資料欄和目標資料表。 |
DELETE |
從 DELETE 陳述式的目標資料表中移除資料列,包括參照的資料欄和目標資料表。 |
MERGE |
修改 MERGE 陳述式中目標資料表的資料列,包括修改後的資料欄和目標資料表。 |
EXPORT |
將輸出資料欄寫入資料操縱語言 (DML) 陳述式或查詢結果匯出的目的地資料表。 |
解讀及最佳化步驟
以下各節說明如何解讀查詢計畫中的步驟,並提供查詢最佳化的方法。
READ 步
READ 步驟表示某個階段正在存取資料以進行處理。資料可直接從查詢參照的資料表讀取,或從隨機存取記憶體讀取。讀取前一階段的資料時,BigQuery 會從隨機存取記憶體讀取資料。使用隨選時段時,掃描的資料量會影響費用;使用預訂時段時,則會影響效能。
潛在的效能問題
- 掃描未分區的資料表:如果查詢只需要一小部分資料,這可能表示資料表掃描效率不彰。分區是個不錯的最佳化策略。
- 掃描大型表格,但篩選比例很小:這表示篩選器無法有效減少掃描的資料。建議您修改篩選條件。
- 溢出至磁碟的 Shuffle 位元組:這表示資料未透過分群等最佳化技術有效儲存,而分群可將類似資料保留在叢集中。
最佳化
- 目標篩選:策略性地使用
WHERE子句,盡可能在查詢的早期階段篩除不相關的資料。進而減少查詢需要處理的資料量。 - 分區和分群:BigQuery 會使用資料表分區和分群,有效找出特定資料區隔。請確保資料表是根據一般查詢模式分區和叢集,以盡量減少
READ步驟期間掃描的資料量。 - 選取相關資料欄:避免使用
SELECT *陳述式。請改為選取特定資料欄,或使用SELECT * EXCEPT避免讀取不必要的資料。 - 具體化檢視表:具體化檢視表可以預先計算及儲存常用的匯總,進而減少在查詢的
READ步驟中讀取基礎資料表的需要。
COMPUTE 步
在 COMPUTE 步驟中,BigQuery 會對您的資料執行下列動作:
- 評估查詢的
SELECT、WHERE、HAVING和其他子句中的運算式,包括計算、比較和邏輯運算。 - 執行內建 SQL 函式和使用者定義函式。
- 根據查詢中的條件篩選資料列。
最佳化
查詢計畫可找出 COMPUTE 步驟中的瓶頸。尋找需要大量運算或處理大量資料列的階段。
- 將
COMPUTE步驟與資料量相互關聯:如果某個階段顯示大量運算,且處理大量資料,則可能適合進行最佳化。 - 資料偏斜:如果某個階段的運算上限明顯高於運算平均值,表示該階段處理少量資料切片時,花費的時間不成比例。建議查看資料分布情形,確認是否有資料偏斜。
- 考慮資料類型:為資料欄使用適當的資料類型。舉例來說,使用整數、日期時間和時間戳記,而非字串,可以提升效能。
WRITE 步
WRITE 步驟會處理中繼資料和最終輸出內容。
- 寫入重組記憶體:在多階段查詢中,
WRITE步驟通常會將處理過的資料傳送至其他階段,以進行進一步處理。這在重組記憶體中很常見,因為重組記憶體會合併或匯總多個來源的資料。這個階段寫入的資料通常是中繼結果,而非最終輸出內容。 - 最終輸出:查詢結果會寫入目的地或暫時性資料表。
雜湊分區
當查詢計畫中的階段將資料寫入雜湊分區輸出內容時,BigQuery 會寫入輸出內容中包含的資料欄,以及選為分區鍵的資料欄。
最佳化
雖然 WRITE 步驟本身可能無法直接最佳化,但瞭解其角色有助於找出早期階段的潛在瓶頸:
- 盡可能減少寫入的資料:著重於透過篩選和匯總功能,將前幾個階段最佳化,以減少這個步驟寫入的資料量。
分區:資料表分區可大幅提升寫入效能。如果寫入的資料僅限於特定分區,BigQuery 就能加快寫入速度。
如果 DML 陳述式含有
WHERE子句,且該子句針對資料表分區資料欄設有靜態條件,則 BigQuery 只會修改相關資料表分區。去正規化取捨:去正規化有時會導致中間
WRITE步驟中的結果集較小。不過,這類做法也有缺點,例如儲存空間用量增加,以及資料一致性問題。
JOIN 步
在 JOIN 步驟中,BigQuery 會合併兩個資料來源的資料。
聯結可包含聯結條件。聯結作業會耗用大量資源。在 BigQuery 中彙整大型資料時,系統會獨立重組彙整索引鍵,使其排列在相同時段,以便在每個時段執行本機彙整作業。
JOIN 步驟的查詢計畫通常會顯示下列詳細資料:
- Join pattern:指出使用的彙整類型。每種型別都會定義結果集中包含的聯結資料表資料列數量。
- 彙整資料欄:這些資料欄用於比對資料來源之間的資料列。選擇的資料欄會直接影響彙整作業的效能。
加入模式
- 廣播聯結:當一個資料表 (通常是較小的資料表) 可容納於單一 worker 節點或運算單元的記憶體中時,BigQuery 可以將其廣播至所有其他節點,有效執行聯結。在步驟詳細資料中尋找
JOIN EACH WITH ALL。 - 雜湊聯結:如果資料表很大或不適合廣播聯結,系統可能會使用雜湊聯結。BigQuery 會使用雜湊和重組作業重組左側和右側資料表,讓相符的鍵最終位於同一個運算單元,以執行本機聯結。雜湊聯結是耗費資源的作業,因為需要移動資料,但可有效率地比對雜湊中的資料列。在步驟詳細資料中尋找
JOIN EACH WITH EACH。 - Self join:SQL 反模式,是指資料表與自身彙整。
- 交叉聯結:SQL 反模式,會產生比輸入資料更大的輸出資料,因此可能導致嚴重的效能問題。
- 傾斜的聯結:一個資料表中的聯結鍵資料分配非常傾斜,可能導致效能問題。查詢計畫中的最長運算時間遠大於平均運算時間時,詳情請參閱「高基數聯結」和「分區傾斜」。
偵錯
- 資料量過大:如果查詢計畫顯示在
JOIN步驟中處理了大量資料,請調查聯結條件和聯結鍵。建議您篩選或使用更具選擇性的聯結鍵。 - 資料分布不均:分析聯結鍵的資料分布情形。如果某個資料表非常傾斜,請探索查詢分割或預先篩選等策略。
- 高基數彙整:產生的資料列數量遠多於左側和右側輸入資料列數量的彙整作業,可能會大幅降低查詢效能。避免產生大量資料列的聯結。
- 資料表排序錯誤:請確認您已選擇適當的聯結類型,例如
INNER或LEFT,並根據查詢需求,將資料表從大到小排序。
最佳化
- 選擇性聯結鍵:盡可能使用
INT64,而非STRING做為聯結鍵。STRING比較比INT64比較慢,因為前者會比較字串中的每個字元。整數只需要單一比較。 - 先篩選再加入:在加入前,先在個別表格上套用
WHERE子句篩選器。進而減少聯結作業涉及的資料量。 - 避免在聯結資料欄上使用函式:避免在聯結資料欄上呼叫函式。請改用 ELT SQL 管道,在擷取或擷取後程序中,將表格資料標準化。這種做法可免除動態修改聯結資料欄的需求,因此能更有效率地聯結資料,同時確保資料完整性。
- 避免自我聯結:自我聯結通常用於計算列相關的關係。不過,自我聯結可能會使輸出資料列的數量增加四倍,導致效能問題。建議您改用 window (分析) 函式,而非依賴自我聯結。
- 先處理大型資料表:即使 SQL 查詢最佳化工具可以判斷聯結的哪一側應使用哪個資料表,仍請適當排序聯結的資料表。最佳做法是先放置最大的表格,接著是最小的表格,然後依大小遞減順序放置。
- 去正規化:在某些情況下,策略性地去正規化資料表 (新增多餘資料) 可完全消除聯結。不過,這種做法會導致儲存空間和資料一致性有所取捨。
- 分區和叢集:根據聯結鍵分割資料表,並將共置資料叢集化,可讓 BigQuery 以相關資料分區為目標,大幅加快聯結速度。
- 最佳化傾斜彙整:為避免傾斜彙整導致效能問題,請盡可能預先篩選資料表中的資料,或將查詢作業拆分成兩個以上的查詢作業。
AGGREGATE 步
在 AGGREGATE 步驟中,BigQuery 會彙整及分組資料。
偵錯
- 階段詳細資料:檢查匯總的輸入和輸出資料列數量,以及重組大小,判斷匯總步驟減少了多少資料,以及是否涉及資料重組。
- 隨機重組大小:如果隨機重組大小很大,可能表示在彙整期間,大量資料在工作站節點之間移動。
- 檢查資料分布情形:確保資料均勻分布在各個分區。資料分布不均可能會導致匯總步驟中的工作負載不平衡。
- 檢查匯總:分析匯總子句,確認這些子句是否必要且有效率。
最佳化
- 分群:針對經常在
GROUP BY、COUNT或其他匯總子句中使用的資料欄,將資料表分群。 - 分區:選擇與查詢模式一致的分區策略。建議使用擷取時間分區資料表,減少彙整期間掃描的資料量。
- 提早匯總:盡可能在查詢管道中提早執行匯總。這樣可以減少彙整期間需要處理的資料量。
- 重組最佳化:如果重組是瓶頸,請設法盡量減少重組。舉例來說,您可以取消正規化表格,或使用叢集將相關資料歸入同一個位置。
極端案例
- DISTINCT 聚合:含有
DISTINCT聚合的查詢可能需要大量運算資源,尤其是處理大型資料集時。如要取得近似結果,請考慮使用APPROX_COUNT_DISTINCT等替代方案。 - 大量群組:如果查詢產生大量群組,可能會耗用大量記憶體。在這種情況下,請考慮限制群組數量或使用其他匯總策略。
REPARTITION 步
REPARTITION 和 COALESCE 都是最佳化技術,BigQuery 會直接套用至查詢中的隨機資料。
REPARTITION:這項作業的目的是重新平衡工作站節點的資料分配。假設在重組後,某個 worker 節點的資料量過大,REPARTITION步驟會更平均地重新分配資料,避免任何單一 worker 成為效能瓶頸。對於聯結等需要大量運算的作業,這一點尤其重要。COALESCE:當您在隨機排序後有許多小型資料 bucket 時,就會發生這個步驟。COALESCE步驟會將這些儲存區合併為較大的儲存區,減少管理大量小型資料片段的負擔。處理非常小的中繼結果集時,這項功能特別實用。
如果查詢計畫中顯示 REPARTITION 或 COALESCE 步驟,不一定表示查詢有問題。這通常表示 BigQuery 主動最佳化資料分配,以提升效能。不過,如果這些作業重複出現,可能表示資料本身有偏差,或是查詢導致資料過度重組。
最佳化
如要減少 REPARTITION 步驟,請嘗試下列做法:
- 資料分配:確保資料表已有效分區和叢集化。資料分布越平均,洗牌後出現顯著不平衡的可能性就越低。
- 查詢結構:分析查詢,找出可能導致資料偏斜的來源。 舉例來說,是否有高選擇性的篩選器或聯結,導致單一工作站處理的資料子集很小?
- 聯結策略:嘗試不同的聯結策略,看看是否能讓資料分配更平均。
如要減少 COALESCE 步驟,請嘗試下列做法:
- 匯總策略:考慮在查詢管道中較早執行匯總作業。這有助於減少可能導致
COALESCE步驟的小型中繼結果集數量。 - 資料量:如果處理的資料集非常小,
COALESCE可能就不是重大問題。
不要過度最佳化。過早最佳化可能會使查詢變得更複雜,但不會帶來顯著效益。
UPDATE、DELETE 和 MERGE 步驟
UPDATE、DELETE 和 MERGE 步驟會分階段顯示,針對目標資料表執行資料操縱語言 (DML) 陳述式。
步驟詳細資料通常包含下列子步驟:
- 資料欄:從目標資料表讀取或寫入的資料欄。
- 目標資料表 (
FROM或INTO):由陳述式修改的目標資料表,UPDATE和DELETE步驟使用FROM,MERGE步驟使用INTO。
EXPORT 步
EXPORT 步驟會將輸出資料寫入目的地資料表。這個步驟通常會出現在 DML 陳述式的最後階段,例如 INSERT、UPDATE、DELETE 和 MERGE 陳述式,以及將結果具體化至目的地資料表的查詢。
步驟詳細資料通常包含下列子步驟:
- 輸出資料欄:寫入目的地資料表的變數清單。
- 目的地資料表 (
TO):接收匯出資料列的目的地資料表。
聯合查詢說明
聯合查詢可讓您使用 EXTERNAL_QUERY 函式,將查詢陳述式傳送至外部資料來源。聯合查詢會受到稱為 SQL 下推的最佳化技術影響,查詢計畫會顯示下推至外部資料來源的作業 (如有)。舉例來說,如果您執行下列查詢:
SELECT id, name
FROM EXTERNAL_QUERY("<connection>", "SELECT * FROM company")
WHERE country_code IN ('ee', 'hu') AND name like '%TV%'
查詢計畫會顯示下列階段步驟:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, country_code
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
  WHERE in(country_code, 'ee', 'hu')
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
在這個計畫中,table_for_external_query_$_0(...) 代表 EXTERNAL_QUERY 函式。您可以在括號中看到外部資料來源執行的查詢。根據上述內容,您可以發現:
- 外部資料來源只會傳回 3 個選取的資料欄。
- 外部資料來源只會傳回
country_code為'ee'或'hu'的資料列。 LIKE運算子不會下推,而是由 BigQuery 評估。
為進行比較,如果沒有下推,查詢計畫會顯示下列階段步驟:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, description, country_code, primary_address, secondary address
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
這次外部資料來源會傳回 company 資料表的所有資料欄和資料列,並由 BigQuery 執行篩選作業。
時程中繼資料
查詢時間軸會報告特定時間點的進度,提供整體查詢進度的快照檢視畫面。時間軸會以一系列樣本表示,並回報下列詳細資料:
| 欄位 | 說明 |
|---|---|
elapsedMs |
自查詢執行開始經過的毫秒數。 |
totalSlotMs |
查詢使用的時段毫秒數累計表示。 |
pendingUnits |
已排定並等待執行的工作單元總數。 |
activeUnits |
工作站處理中的工作單元總數。 |
completedUnits |
執行這項查詢時已完成的工作單元總數。 |
查詢範例
下列查詢會計算莎士比亞公開資料集中的資料列數量,並進行第二次條件式計數,將結果限制為參照「hamlet」的資料列:
SELECT
  COUNT(1) as rowcount,
  COUNTIF(corpus = 'hamlet') as rowcount_hamlet
FROM `publicdata.samples.shakespeare`
按一下「執行作業詳細資料」即可查看查詢計畫:

顏色指標會顯示所有階段中所有步驟的相對時間。
如要進一步瞭解執行階段的步驟,請按一下 展開階段詳細資料:
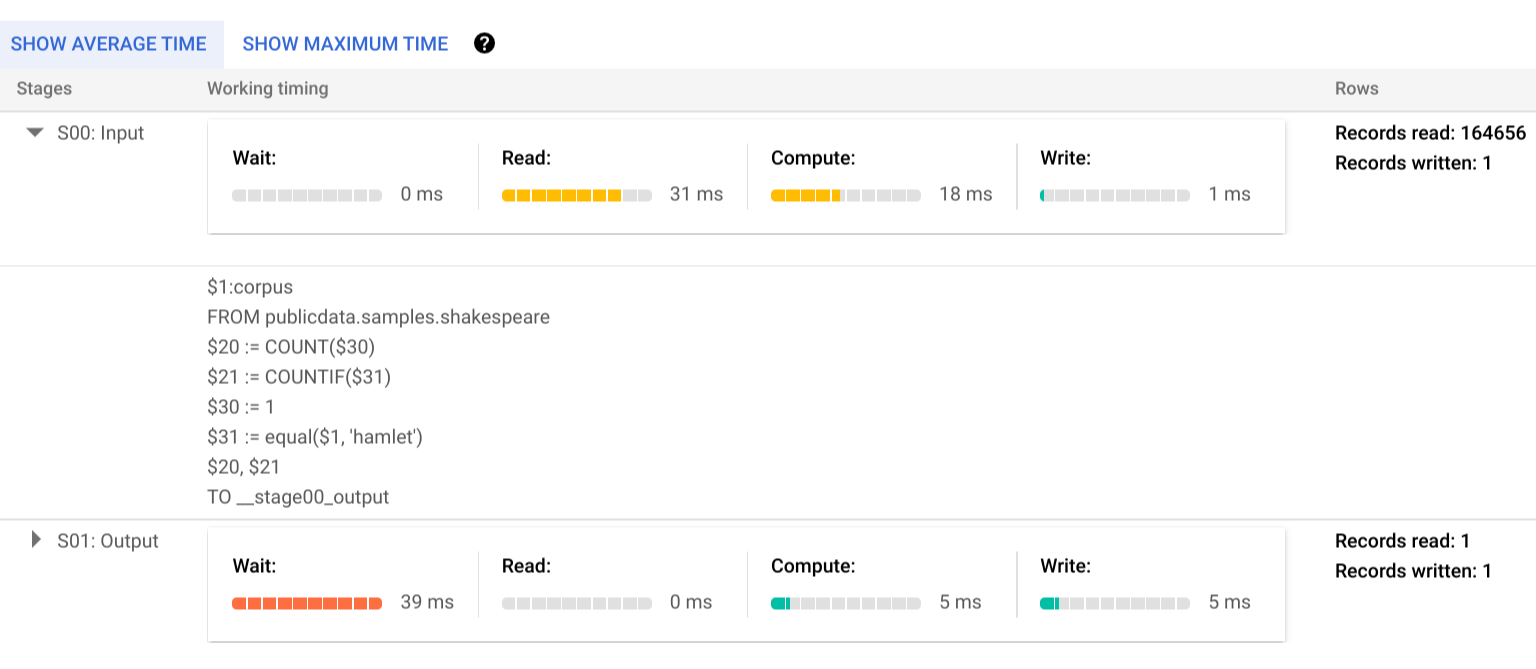
在本例中,任何區隔中最長的時間是第 01 階段的單一 worker 等待第 00 階段完成的時間。這是因為階段 01 依附於階段 00 的輸入內容,且必須等到第一個階段將輸出內容寫入中繼隨機播放程序後,才能開始執行。
錯誤報告
查詢工作可能會在執行中失敗。由於計畫資訊會定期更新,因此您可以觀察執行圖表中的失敗位置。在 Google Cloud 控制台中,成功或失敗的階段會在階段名稱旁標上勾號或驚嘆號。
如要進一步瞭解如何解讀及解決錯誤,請參閱疑難排解指南。
API 表示法範例
查詢計畫資訊會嵌入工作回應資訊中,您可以呼叫 jobs.get 擷取該資訊。舉例來說,以下是工作傳回樣本哈姆雷特查詢的 JSON 回應摘錄,其中顯示查詢計畫和時間軸資訊。
"statistics": {
  "creationTime": "1576544129234",
  "startTime": "1576544129348",
  "endTime": "1576544129681",
  "totalBytesProcessed": "2464625",
  "query": {
    "queryPlan": [
      {
        "name": "S00: Input",
        "id": "0",
        "startMs": "1576544129436",
        "endMs": "1576544129465",
        "waitRatioAvg": 0.04,
        "waitMsAvg": "1",
        "waitRatioMax": 0.04,
        "waitMsMax": "1",
        "readRatioAvg": 0.32,
        "readMsAvg": "8",
        "readRatioMax": 0.32,
        "readMsMax": "8",
        "computeRatioAvg": 1,
        "computeMsAvg": "25",
        "computeRatioMax": 1,
        "computeMsMax": "25",
        "writeRatioAvg": 0.08,
        "writeMsAvg": "2",
        "writeRatioMax": 0.08,
        "writeMsMax": "2",
        "shuffleOutputBytes": "18",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "164656",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$1:corpus",
              "FROM publicdata.samples.shakespeare"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$20 := COUNT($30)",
              "$21 := COUNTIF($31)"
            ]
          },
          {
            "kind": "COMPUTE",
            "substeps": [
              "$30 := 1",
              "$31 := equal($1, 'hamlet')"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$20, $21",
              "TO __stage00_output"
            ]
          }
        ]
      },
      {
        "name": "S01: Output",
        "id": "1",
        "startMs": "1576544129465",
        "endMs": "1576544129480",
        "inputStages": [
          "0"
        ],
        "waitRatioAvg": 0.44,
        "waitMsAvg": "11",
        "waitRatioMax": 0.44,
        "waitMsMax": "11",
        "readRatioAvg": 0,
        "readMsAvg": "0",
        "readRatioMax": 0,
        "readMsMax": "0",
        "computeRatioAvg": 0.2,
        "computeMsAvg": "5",
        "computeRatioMax": 0.2,
        "computeMsMax": "5",
        "writeRatioAvg": 0.16,
        "writeMsAvg": "4",
        "writeRatioMax": 0.16,
        "writeMsMax": "4",
        "shuffleOutputBytes": "17",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "1",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$20, $21",
              "FROM __stage00_output"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$10 := SUM_OF_COUNTS($20)",
              "$11 := SUM_OF_COUNTS($21)"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$10, $11",
              "TO __stage01_output"
            ]
          }
        ]
      }
    ],
    "estimatedBytesProcessed": "2464625",
    "timeline": [
      {
        "elapsedMs": "304",
        "totalSlotMs": "50",
        "pendingUnits": "0",
        "completedUnits": "2"
      }
    ],
    "totalPartitionsProcessed": "0",
    "totalBytesProcessed": "2464625",
    "totalBytesBilled": "10485760",
    "billingTier": 1,
    "totalSlotMs": "50",
    "cacheHit": false,
    "referencedTables": [
      {
        "projectId": "publicdata",
        "datasetId": "samples",
        "tableId": "shakespeare"
      }
    ],
    "statementType": "SELECT"
  },
  "totalSlotMs": "50"
},
使用執行資訊
BigQuery 查詢計畫會提供服務執行查詢的方式相關資訊,但由於服務屬於代管性質,因此某些詳細資料是否可直接採取行動會受到限制。使用這項服務時,系統會自動執行許多最佳化作業,這與其他環境不同,因為在其他環境中,調整、佈建和監控作業可能需要專門的專業人員。
如需可提升查詢執行和效能的具體技巧,請參閱最佳做法文件。查詢計畫和時間軸統計資料可協助您瞭解特定階段是否佔用大部分資源。舉例來說,如果 JOIN 階段產生的輸出資料列遠多於輸入資料列,表示您可以在查詢中較早的階段進行篩選。
此外,時間軸資訊有助於判斷特定查詢是否單獨執行緩慢,或是因為其他查詢爭用相同資源而導致緩慢。如果您發現查詢的整個生命週期內,有效單元數量仍有限,但排隊等候的單元工作量仍高,這可能表示減少並行查詢數量,可大幅縮短特定查詢的整體執行時間。