


Storage Write API (gRPC) 簡介
您可以使用 BigQuery Storage Write API (gRPC) 將資料串流至 BigQuery。本文說明 Storage Write API (gRPC) 的架構、功能和用途。
新專案建議使用 Storage Write API (gRPC),而非 Storage Write API (REST)。Storage Write API (gRPC) 的定價較低且功能齊全 (包括單次傳送語意),
所需權限
如要使用 Storage Write API (gRPC),您必須具備 bigquery.tables.updateData 權限。
下列預先定義的 Identity and Access Management (IAM) 角色包含 bigquery.tables.updateData 權限:
bigquery.dataEditorbigquery.dataOwnerbigquery.admin
如要進一步瞭解 BigQuery 中的 IAM 角色和權限,請參閱「預先定義的角色與權限」。
驗證範圍
如要使用 Storage Write API (gRPC),必須具備下列任一 OAuth 範圍:
https://www.googleapis.com/auth/bigqueryhttps://www.googleapis.com/auth/cloud-platformhttps://www.googleapis.com/auth/bigquery.insertdata
詳情請參閱驗證總覽一文。
Storage Write API (gRPC) 總覽
Storage Write API (gRPC) 的核心抽象概念是「串流」。串流會將資料寫入 BigQuery 資料表。多個串流可以同時寫入同一個資料表。
預設串流
Storage Write API (gRPC) 提供預設串流,適用於持續接收資料的串流情境。具有下列特徵:
- 寫入預設串流的資料可立即查詢。
- 預設串流支援「至少一次」語意。
- 您不需要明確建立預設串流。
如果您要從 Storage Write API (REST) 遷移,建議使用預設串流。寫入語意與其類似,但資料復原能力更強,縮放限制也較少。
API 流程:
AppendRows(迴圈)
如需更多資訊和程式碼範例,請參閱「使用預設串流來確保至少傳送一次訊息」。
應用程式建立的串流
如需下列任一行為,您可以明確建立串流:
- 透過使用串流偏移,實現僅一次寫入語意。
- 支援其他 ACID 屬性。
一般來說,應用程式建立的串流可提供更多功能控制權,但會增加複雜度。
建立串流時,您需要指定類型。這個類型會控管寫入串流的資料何時會在 BigQuery 中顯示,供您讀取。
待處理類型
在「待處理類型」中,記錄會緩衝處理為待處理狀態,直到您提交串流為止。提交串流後,所有待處理資料都會開放讀取。提交作業是不可分割的作業。使用這類工作負載處理批次工作,做為 BigQuery 載入工作的替代方案。詳情請參閱「使用 Storage Write API (gRPC) 批次載入資料」。
API 流程:
承諾類型
在「已提交類型」中,您將記錄寫入串流後,即可立即讀取。如果串流工作負載需要最低讀取延遲,請使用這種類型。預設串流會使用「至少一次」形式的已提交類型。 詳情請參閱「使用已提交類型,確保語意為「僅一次」。
API 流程:
CreateWriteStreamAppendRows(迴圈)FinalizeWriteStream(選填)
緩衝類型
緩衝類型是進階類型,一般不應使用,除非搭配 Apache Beam BigQuery I/O 連接器。如要確保小批次一起顯示,請使用已提交類型,並在一個要求中傳送每個批次。這類型的資料會提供資料列層級的提交,並緩衝處理記錄,直到資料列透過排清串流提交為止。
API 流程:
CreateWriteStreamAppendRows⇒FlushRows(迴圈)FinalizeWriteStream(選填)
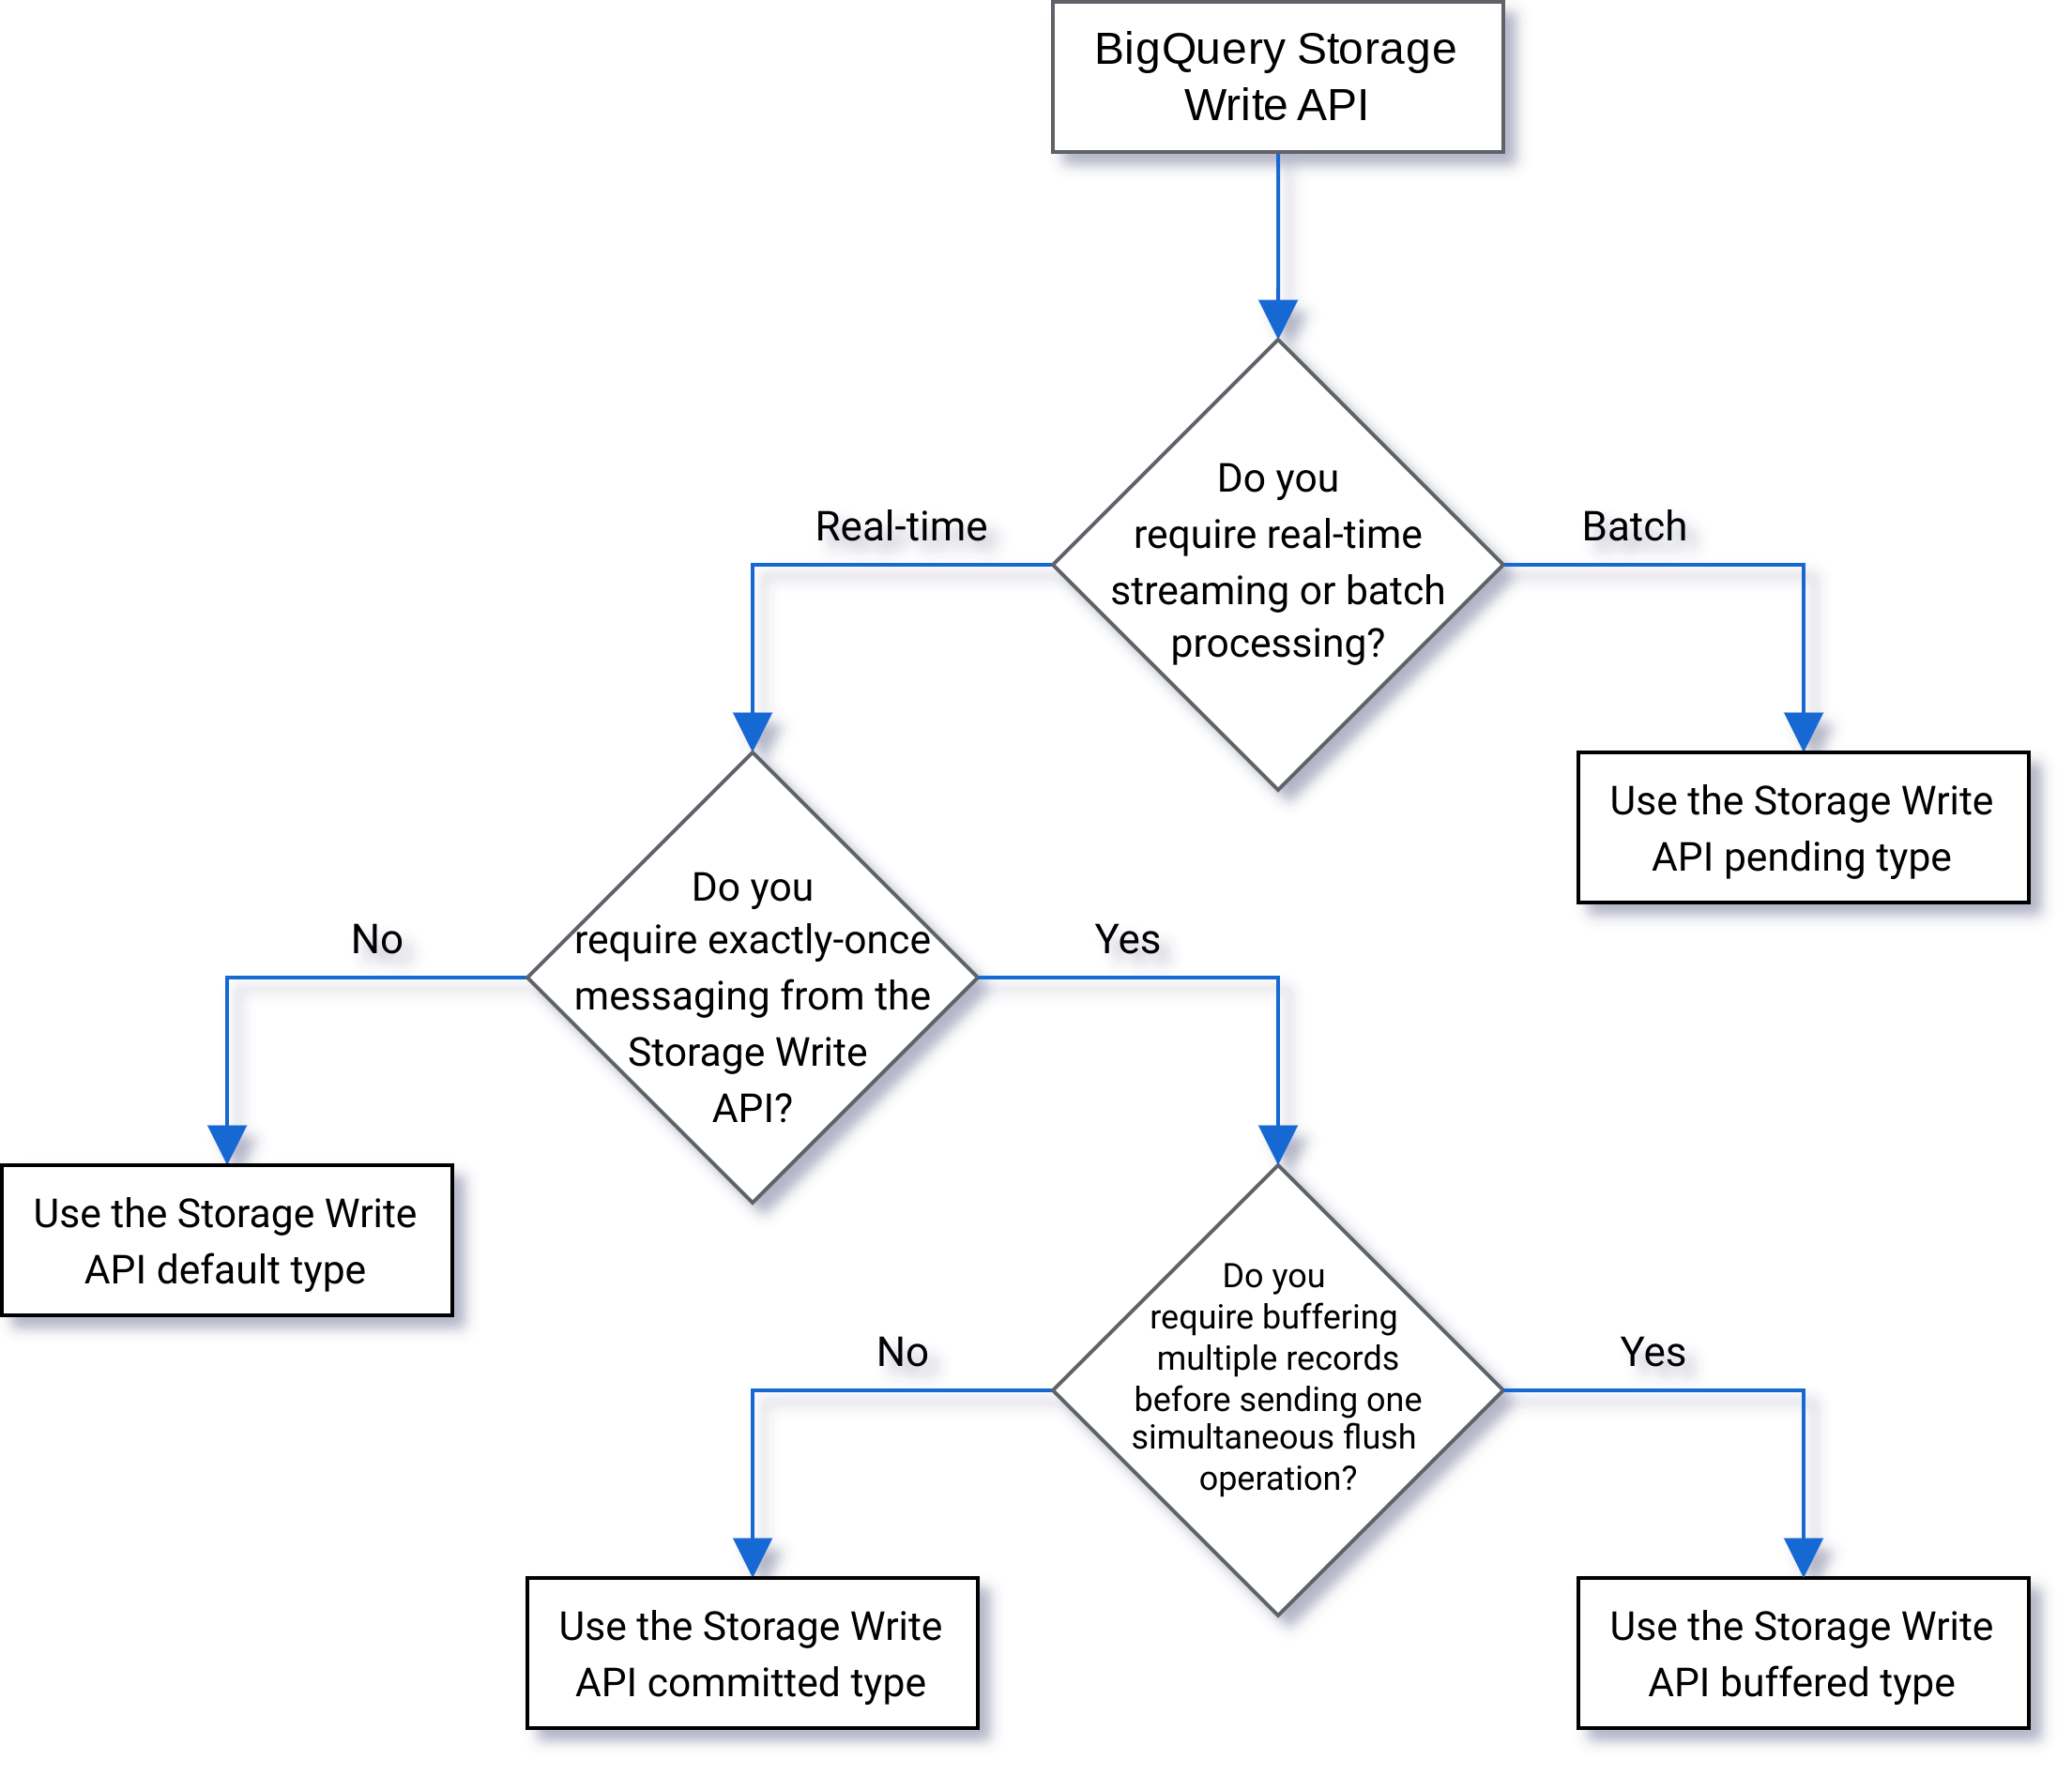
選取類型
請參考下列流程圖,判斷哪種型別最適合您的工作負載:
API 詳細資料
使用 Storage Write API 時,請注意下列事項:
AppendRows
AppendRows 方法會將一或多筆記錄附加至串流。第一次呼叫 AppendRows 時,必須包含串流名稱和資料結構定義 (指定為 DescriptorProto)。或者,如果您是以 Apache Arrow 格式擷取資料,可以在第一次呼叫 AppendRows 時加入序列化箭頭結構定義。最佳做法是在每次 AppendRows 呼叫中傳送一批資料列。請勿一次傳送一列資料。
通訊協定緩衝區處理
通訊協定緩衝區提供語言中立、平台中立的可擴充機制,可將結構化資料序列化,並確保向前和向後相容。這類格式的優點是可提供精簡的資料儲存空間,並快速有效率地剖析資料。如要進一步瞭解通訊協定緩衝區,請參閱「通訊協定緩衝區總覽」。
如果您要使用預先定義的通訊協定緩衝區訊息直接使用 API,通訊協定緩衝區訊息就不能使用 package 規範符,且所有巢狀或列舉型別都必須在頂層根訊息中定義。不得參照外部訊息。如需範例,請參閱 sample_data.proto。
Java 和 Go 用戶端支援任意通訊協定緩衝區,因為用戶端程式庫會將通訊協定緩衝區結構定義標準化。
Apache Arrow 處理
Apache Arrow 是通用的資料處理直欄格式和多語言工具箱。Apache Arrow 提供與語言無關的欄位導向記憶體格式,適用於平面和階層式資料,並經過整理,可在現代硬體上執行高效的分析作業。Storage Write API (gRPC) 支援使用序列化 Arrow 結構定義和 AppendRowsRequest 類別中的資料進行 Arrow 擷取。Python、Java 和 Rust 用戶端程式庫內建支援 Apache Arrow 擷取作業。
FinalizeWriteStream
FinalizeWriteStream 方法會完成串流,因此無法再將新資料附加至串流。在 Pending 類型中,這個方法為必要方法,在 Committed 和 Buffered 類型中則為選用方法。預設串流不支援這個方法。
處理錯誤
如果發生錯誤,傳回的 google.rpc.Status 可能會包含StorageError,詳情請參閱錯誤詳細資料。請查看
StorageErrorCode,找出特定錯誤類型。如要進一步瞭解 Google API 錯誤模型,請參閱「錯誤」。
連線
Storage Write API (gRPC) 是使用雙向連線的 gRPC API。AppendRows 方法會建立串流的連線。您可以在預設串流上開啟多個連線。這些附加作業是非同步,因此您可以同時傳送一系列寫入作業。每個雙向連線的回應訊息都會按照要求傳送的順序送達。
應用程式建立的串流只能有一個有效連線。最佳做法是限制有效連線數量,並盡可能使用單一連線寫入多筆資料。在 Java、Go 或 Rust 中使用預設串流時,您可以透過儲存空間寫入 API (gRPC) 多工處理,使用共用連線寫入多個目的地資料表。
一般來說,單一連線至少支援 1 MBps 的輸送量。上限取決於多項因素,例如網路頻寬、資料結構定義和伺服器負載。連線達到處理量上限時,系統可能會拒絕或將傳入要求排入佇列,直到執行中的要求數量減少為止。如需更多處理量,請建立更多連線。
如果連線閒置時間過長,BigQuery 會關閉 gRPC 連線。如果發生這種情況,回應代碼為 HTTP 409。如果伺服器重新啟動或發生其他情況,gRPC 連線也可能會關閉。如果發生連線錯誤,請建立新連線。如果連線已關閉,Java、Go 和 Rust 用戶端程式庫會自動重新連線。
用戶端程式庫支援
Storage Write API (gRPC) 的用戶端程式庫支援多種程式設計語言,並公開以 gRPC 為基礎的 API 建構函式。這項 API 會運用雙向串流等進階功能,因此可能需要額外的開發工作才能支援。為此,這個 API 提供多種高階抽象化功能,可簡化這些互動,並減少開發人員的疑慮。建議您盡可能使用這些其他程式庫抽象化。
本節將進一步說明語言和程式庫,這些語言和程式庫為開發人員提供超出所產生 API 的額外功能。
如要查看與 Storage Write API (gRPC) 相關的程式碼範例,請參閱所有 BigQuery 程式碼範例。
Java 用戶端
Java 用戶端程式庫提供兩個寫入器物件:
StreamWriter:接受通訊協定緩衝區格式的資料。JsonStreamWriter:接受 JSON 格式的資料,並在透過網路傳送資料前,將其轉換為通訊協定緩衝區。JsonStreamWriter也支援自動更新結構定義。如果資料表結構定義變更,寫入器會自動重新連線至新結構定義,讓用戶端使用新結構定義傳送資料。
這兩種寫入器的程式設計模型類似。主要差異在於酬載的格式。
寫入器物件會管理 Storage Write API (gRPC) 連線。寫入器物件會自動清除要求、在要求中加入區域性轉送標頭,並在發生連線錯誤後重新連線。如果您直接使用 gRPC API,就必須處理這些詳細資料。
您也可以使用 Apache Arrow 擷取格式,做為替代通訊協定,透過 Storage Write API (gRPC) 擷取資料。詳情請參閱「使用 Apache Arrow 格式擷取資料」。
Go 用戶端
Go 用戶端會使用用戶端伺服器架構,透過 proto2 將訊息編碼為通訊協定緩衝區格式。如要瞭解如何使用 Go 用戶端,請參閱 Go 說明文件,其中提供範例程式碼。
Python 用戶端
Python 用戶端是包裝 gRPC API 的低階用戶端。如要使用這個用戶端,您必須按照指定類型的 API 流程,以通訊協定緩衝區的形式傳送資料。
請避免在 Python 中使用動態 Proto 訊息產生,因為該程式庫的效能不佳。
如要進一步瞭解如何搭配使用 Python 與通訊協定緩衝區,請參閱「Python 中的通訊協定緩衝區基礎教學課程」。
您也可以使用 Apache Arrow 擷取格式,做為透過 Storage Write API 擷取資料的替代通訊協定。詳情請參閱「使用 Apache Arrow 格式擷取資料」。
NodeJS 用戶端
NodeJS 用戶端程式庫接受 JSON 輸入內容,並提供自動重新連線支援。如要瞭解如何使用用戶端,請參閱說明文件。
Rust 用戶端
Rust 用戶端程式庫會為每個串流類型 (DefaultWriter、CommittedWriter、PendingWriter 和 BufferedWriter) 提供 Write 用戶端和型別寫入器物件。寫入器會接受 Apache Arrow 格式的資料,並自動管理 Storage Write API (gRPC) 連線、路由標頭、重試,以及連線錯誤後的重新連線。如要擷取 JSON 資料,可以使用 arrow-json Crate 將 JSON 記錄轉換為 Apache Arrow 記錄批次。
如要進一步瞭解如何使用 Rust 用戶端,請參閱 Rust 說明文件,並參閱「使用 Apache Arrow 格式擷取資料」一文中的範例程式碼。
處理無法預訂的情況
採用指數輪詢策略重試可減輕隨機錯誤和短暫的服務中斷問題,但如要避免在服務長時間無法使用時捨棄資料列,則需要更周全的考量。具體來說,如果用戶持續無法插入資料列,該怎麼做?
這取決於您的需求。舉例來說,如果 BigQuery 用於營運分析,且可接受部分資料列遺失,用戶可以在幾次重試後放棄並捨棄資料。如果每個資料列對業務都至關重要 (例如財務資料),則您需要制定策略,持續保留資料,直到稍後可以插入為止。
處理持續性錯誤的常見方法,是將資料列發布至 Pub/Sub 主題,以供日後評估及可能插入。另一種常見方法是在用戶端暫時保留資料。這兩種方法都能確保用戶端不會遭到封鎖,同時確保系統在恢復可用性後,可以插入所有資料列。
將資料串流至分區資料表
Storage Write API (gRPC) 支援將資料串流至分區資料表。
資料串流時,系統會先將資料放入 __UNPARTITIONED__ 分區。收集足夠的未經分割資料後,BigQuery 會重新分割資料,並將資料放入適當的分割區。不過,服務水準協議 (SLA) 並未定義資料移出 __UNPARTITIONED__ 分區所需的時間。
如果是擷取時間分區和時間單位資料欄分區資料表,只要使用其中一個偽欄 (_PARTITIONTIME 或 _PARTITIONDATE,視偏好的資料型別而定),篩除 __UNPARTITIONED__ 分區中的 NULL 值,即可從查詢中排除未分區的資料。
擷取時間分區
將資料串流至擷取時間分區資料表時,Storage Write API (gRPC) 會根據目前的系統 UTC 時間推斷目的地分區。
如果將資料串流至每日分區資料表,則可以在要求中提供分區修飾符,藉此覆寫日期推論。在 tableID 參數中加入裝飾器。舉例來說,您可以使用 table1$20250601 分區修飾符,將資料串流至資料表 table1 對應 2025 年 6 月 1 日的分區。
使用分割區裝飾器串流時,您可以串流至過去 31 天到未來 16 天的分割區。如要寫入這些範圍以外日期的分區,請改用載入或查詢作業,詳情請參閱「將資料寫入特定分區」。
使用分區修飾符串流資料時,系統僅支援每日分區資料表,不支援每小時、每月或每年分區的資料表。
按時間單位資料欄分區
將資料串流至時間單位資料欄分區資料表時,BigQuery 會根據資料表預先定義的 DATE、DATETIME 或 TIMESTAMP 分區資料欄值,自動將資料放入正確的分區。如果分區資料欄參照的資料介於過去 10 年和未來 1 年之間,您可以將資料串流至時間單位分區資料表。
整數範圍分區
將資料串流至整數範圍分區資料表時,BigQuery 會根據資料表預先定義的INTEGER分區資料欄值,自動將資料放入正確的分區。
Fluent Bit Storage Write API (gRPC) 輸出外掛程式
Fluent Bit Storage Write API (gRPC) 輸出外掛程式可自動將 JSON 記錄擷取至 BigQuery,因此您不必編寫程式碼。有了這個外掛程式,您只需要設定相容的輸入外掛程式,並設定設定檔,即可開始串流資料。Fluent Bit 是開放原始碼的跨平台記錄處理器和轉送器,可使用輸入和輸出外掛程式處理不同類型的資料來源和接收器。
此外掛程式支援下列項目:
- 使用預設型別的「至少一次」語意。
- 使用已提交型別的「僅一次」語意。
- 在出現背壓時,動態調整預設串流的規模。
支援 Apache Iceberg
您可以使用 Storage Write API (gRPC),將資料串流至 Iceberg 資料表。詳情請參閱「Apache Iceberg 代管資料表」。
Storage Write API (gRPC) 專案指標
如要監控使用 Storage Write API (gRPC) 擷取的資料,請使用 INFORMATION_SCHEMA.WRITE_API_TIMELINE 檢視畫面,或參閱 Google Cloud 指標。
使用資料操縱語言 (DML) 處理最近串流的資料
您可以使用資料操縱語言 (DML),例如 UPDATE、DELETE 或 MERGE 陳述式,修改最近由 BigQuery Storage Write API (gRPC) 寫入 BigQuery 資料表的資料列。最近寫入的資料是指過去 30 分鐘內寫入的資料。
如要進一步瞭解如何使用 DML 修改串流資料,請參閱「使用資料操縱語言」。
限制
- 針對最近串流的資料執行變動 DML 陳述式的支援,不適用於使用 Storage Write API (REST) 串流的資料。
- 不支援在多陳述式交易中,對最近串流的資料執行變異 DML 陳述式。
使用 max_staleness 查詢串流資料
根據預設,每次對含有串流資料的資料表執行查詢時,BigQuery 都會納入查詢執行時間前串流的資料列,傳回最新結果。
如果您的用途不需要即時資料更新間隔 (例如在資訊主頁或報表查詢中),您可以設定資料過時時間,減少查詢延遲和費用。如要設定資料過時時間,請使用下列其中一種方法:
- 在資料表層級設定過時程度 (變更資料擷取或具體化檢視表):在目的地資料表上設定
max_staleness選項,允許查詢根據過時間隔內的近期資料快照傳回結果。詳情請參閱「變更資料擷取max_staleness」和「使用max_staleness具體化檢視區塊」。 - 覆寫查詢或工作階段的過時狀態:在多重陳述式查詢或工作階段中設定
@@max_staleness_override系統變數,動態覆寫過時狀態,而不變更資料表層級的設定,例如SET @@max_staleness_override = INTERVAL 10 MINUTE;。
Storage Write API (gRPC) 配額
如要瞭解 Storage Write API (gRPC) 配額和限制,請參閱「BigQuery Storage Write API (gRPC) 配額和限制」。
您可以在Google Cloud 控制台的「配額」頁面,監控並行連線和輸送量配額用量。
計算處理量
假設您的目標是從 1 億個端點收集記錄,每分鐘建立 1,500 筆記錄。接著,您就可以估算輸送量,如下所示:
100 million * 1,500 / 60 seconds = 2.5 GB per second。
您必須預先確認有足夠配額,才能提供此處理量。
Storage Write API (gRPC) 價格
如需定價資訊,請參閱「資料擷取定價」。
用途範例
假設管道會處理端點記錄中的事件資料。 系統會持續產生事件,且需要盡快在 BigQuery 中提供查詢。由於資料更新間隔是這個用途的重中之重,因此Storage Write API (gRPC) 是將資料擷取至 BigQuery 的最佳選擇。建議採用這種架構,將事件傳送至 Pub/Sub,然後由串流 Dataflow 管道取用,直接串流至 BigQuery,讓這些端點保持精簡。
這項架構的主要可靠性問題,是處理無法將記錄插入 BigQuery 的情況。如果每筆記錄都很重要,且不能遺失,請先緩衝處理資料,再嘗試插入。在上述建議架構中,Pub/Sub 可透過訊息保留功能做為緩衝區。Dataflow 管道應設定為使用截斷指數輪詢重試 BigQuery 串流插入作業。如果 Pub/Sub 的緩衝區容量用盡 (例如 BigQuery 長時間無法使用或發生網路故障),資料就必須保留在用戶端,且用戶端需要一種機制,以便在恢復可用性後繼續插入保留的記錄。如要進一步瞭解如何處理這種情況,請參閱 Google Pub/Sub 可靠性指南網誌文章。
要處理的另一個失敗案例是有害記錄。如果記錄因發生無法重試的錯誤而無法插入,或重試次數達到上限後仍無法順利插入,就會遭到 BigQuery 拒絕,成為 Poison 記錄。這兩種類型的記錄都應由 Dataflow 管道儲存在「無法傳送的訊息佇列」中,以供進一步調查。
如需「只傳送一次」語意,請建立已提交類型的寫入串流,並由用戶端提供記錄偏移。這樣可避免重複,因為只有在位移值與下一個附加位移相符時,才會執行寫入作業。如果不提供偏移值,記錄會附加至串流目前的結尾,且重試失敗的附加作業可能會導致記錄在串流中出現多次。
如果不需要「只傳送一次」保證,寫入預設串流可提高處理量,且不會計入建立寫入串流的配額限制。
預估網路的處理量,並預先確保您有足夠的配額來提供該處理量。
如果工作負載產生或處理資料的速度非常不穩定,請盡量平緩用戶端上的任何負載尖峰,並以恆定的處理量將資料串流至 BigQuery。這有助於簡化容量規劃。如果無法這樣做,請確保您已準備好在短時間內尖峰流量超過配額時,處理 429 (資源耗盡) 錯誤。
如需如何使用 Storage Write API (gRPC) 的詳細範例,請參閱「使用 Storage Write API (gRPC) 串流資料」。
後續步驟
- 使用 Storage Write API (gRPC) 串流資料
- 使用 Storage Write API (gRPC) 批次載入資料
- 支援的通訊協定緩衝區和 Arrow 資料類型
- Storage Write API (gRPC) 最佳做法