


מבוא ל-Storage Write API (gRPC)
BigQuery Storage Write API (gRPC) מאפשר להעביר רשומות בסטרימינג ולטעון אותן באצווה ל-BigQuery, באמצעות חיבורי gRPC דו-כיווניים.
בפרויקטים חדשים, מומלץ להשתמש ב-Storage Write API (gRPC) במקום ב-Storage Write API (REST). המחיר של Storage Write API (gRPC) נמוך יותר והוא כולל תכונות מקיפות יותר, כולל טרנזקציות ברמת הסטרימינג וסמנטיקה של מסירה חד-פעמית.
ההרשאות הנדרשות
כדי להשתמש ב-Storage Write API (gRPC), אתם צריכים את ההרשאות bigquery.tables.updateData.
התפקידים המוגדרים מראש הבאים של ניהול זהויות והרשאות גישה (IAM) כוללים את ההרשאות של bigquery.tables.updateData:
bigquery.dataEditorbigquery.dataOwnerbigquery.admin
במאמר תפקידים והרשאות מוגדרים מראש תוכלו לקרוא מידע נוסף על תפקידים והרשאות של IAM ב-BigQuery.
היקפי הרשאות לאימות
כדי להשתמש ב-Storage Write API (gRPC), צריך אחד מהיקפי ההרשאות הבאים של OAuth:
https://www.googleapis.com/auth/bigqueryhttps://www.googleapis.com/auth/cloud-platformhttps://www.googleapis.com/auth/bigquery.insertdata
מידע נוסף זמין בסקירה הכללית על אימות.
סקירה כללית על Storage Write API (gRPC)
ההפשטה העיקרית ב-Storage Write API (gRPC) היא stream. הנתונים נכתבים לטבלה ב-BigQuery באמצעות זרם. יותר מסטרים אחד יכול לכתוב בו-זמנית לאותה טבלה.
השידור שמוגדר כברירת מחדל
ב-Storage Write API (gRPC) יש זרם ברירת מחדל, שמיועד לתרחישים של סטרימינג שבהם הנתונים מגיעים באופן רציף. המאפיינים שלו:
- נתונים שנכתבים ב-stream שמוגדר כברירת מחדל זמינים מיד לשאילתות.
- הסטרימינג שמוגדר כברירת מחדל תומך בסמנטיקה של "לפחות פעם אחת".
- אין צורך ליצור את הסטרימינג שמוגדר כברירת מחדל באופן מפורש.
אם אתם עוברים מ-Storage Write API (REST), כדאי להשתמש בסטרימינג שמוגדר כברירת מחדל. יש לו סמנטיקה דומה של כתיבה, עם עמידות גבוהה יותר של נתונים ופחות הגבלות על התאמה לעומס.
תהליך ה-API:
AppendRows(לולאה)
למידע נוסף ולקוד לדוגמה, ראו שימוש בסטרימינג שמוגדר כברירת מחדל לסמנטיקה של לפחות פעם אחת.
שידורים שנוצרו על ידי אפליקציה
אתם יכולים ליצור סטרימינג באופן מפורש אם אתם צריכים אחת מההתנהגויות הבאות:
- סמנטיקה של כתיבה פעם אחת בדיוק באמצעות שימוש בהיסטים של זרמים.
- תמיכה במאפייני ACID נוספים.
באופן כללי, סטרימינג שנוצר על ידי אפליקציה נותן יותר שליטה על הפונקציונליות, אבל הוא מורכב יותר.
כשיוצרים שידור, מציינים סוג. הסוג קובע מתי הנתונים שנכתבים בסטרימינג יהיו גלויים לקריאה ב-BigQuery.
סוג ההמתנה
בסוג בהמתנה, הרשומות נשמרות במאגר נתונים במצב המתנה עד שמבצעים את הסטרימינג. כשמבצעים commit לסטרים, כל הנתונים בהמתנה הופכים לזמינים לקריאה. ה-commit הוא פעולה אטומית. השתמשו בסוג הזה לעומסי עבודה באצווה, כחלופה למשימות טעינה של BigQuery. מידע נוסף זמין במאמר טעינת נתונים באצווה באמצעות Storage Write API (gRPC).
תהליך ה-API:
סוג ההתחייבות
בסוג מחויב, הרשומות זמינות לקריאה מיד כשכותבים אותן בסטרימינג. הסוג הזה מתאים לעומסי עבודה של סטרימינג שדורשים זמן אחזור מינימלי לקריאה. הסטרימינג שמוגדר כברירת מחדל משתמש בפורמט "לפחות פעם אחת" של הסוג "בוצע". מידע נוסף זמין במאמר שימוש בסוג מחויב לסמנטיקה של פעם אחת בדיוק.
תהליך ה-API:
CreateWriteStreamAppendRows(לולאה)-
FinalizeWriteStream(אופציונלי)
סוג מאגר נתונים זמני
Buffered type הוא סוג מתקדם שבדרך כלל לא צריך להשתמש בו, אלא עם מחבר הקלט/פלט של Apache Beam BigQuery. אם יש לכם קבוצות קטנות שאתם רוצים להבטיח שיופיעו ביחד, השתמשו בסוג committed ושלחו כל קבוצה בבקשה אחת. בסוג הזה, מתבצעים אישורים ברמת השורה, והרשומות נשמרות במאגר נתונים זמני עד שהשורות מאושרות על ידי ניקוי ה-stream.
תהליך ה-API:
CreateWriteStreamAppendRows⇒FlushRows(לולאה)-
FinalizeWriteStream(אופציונלי)
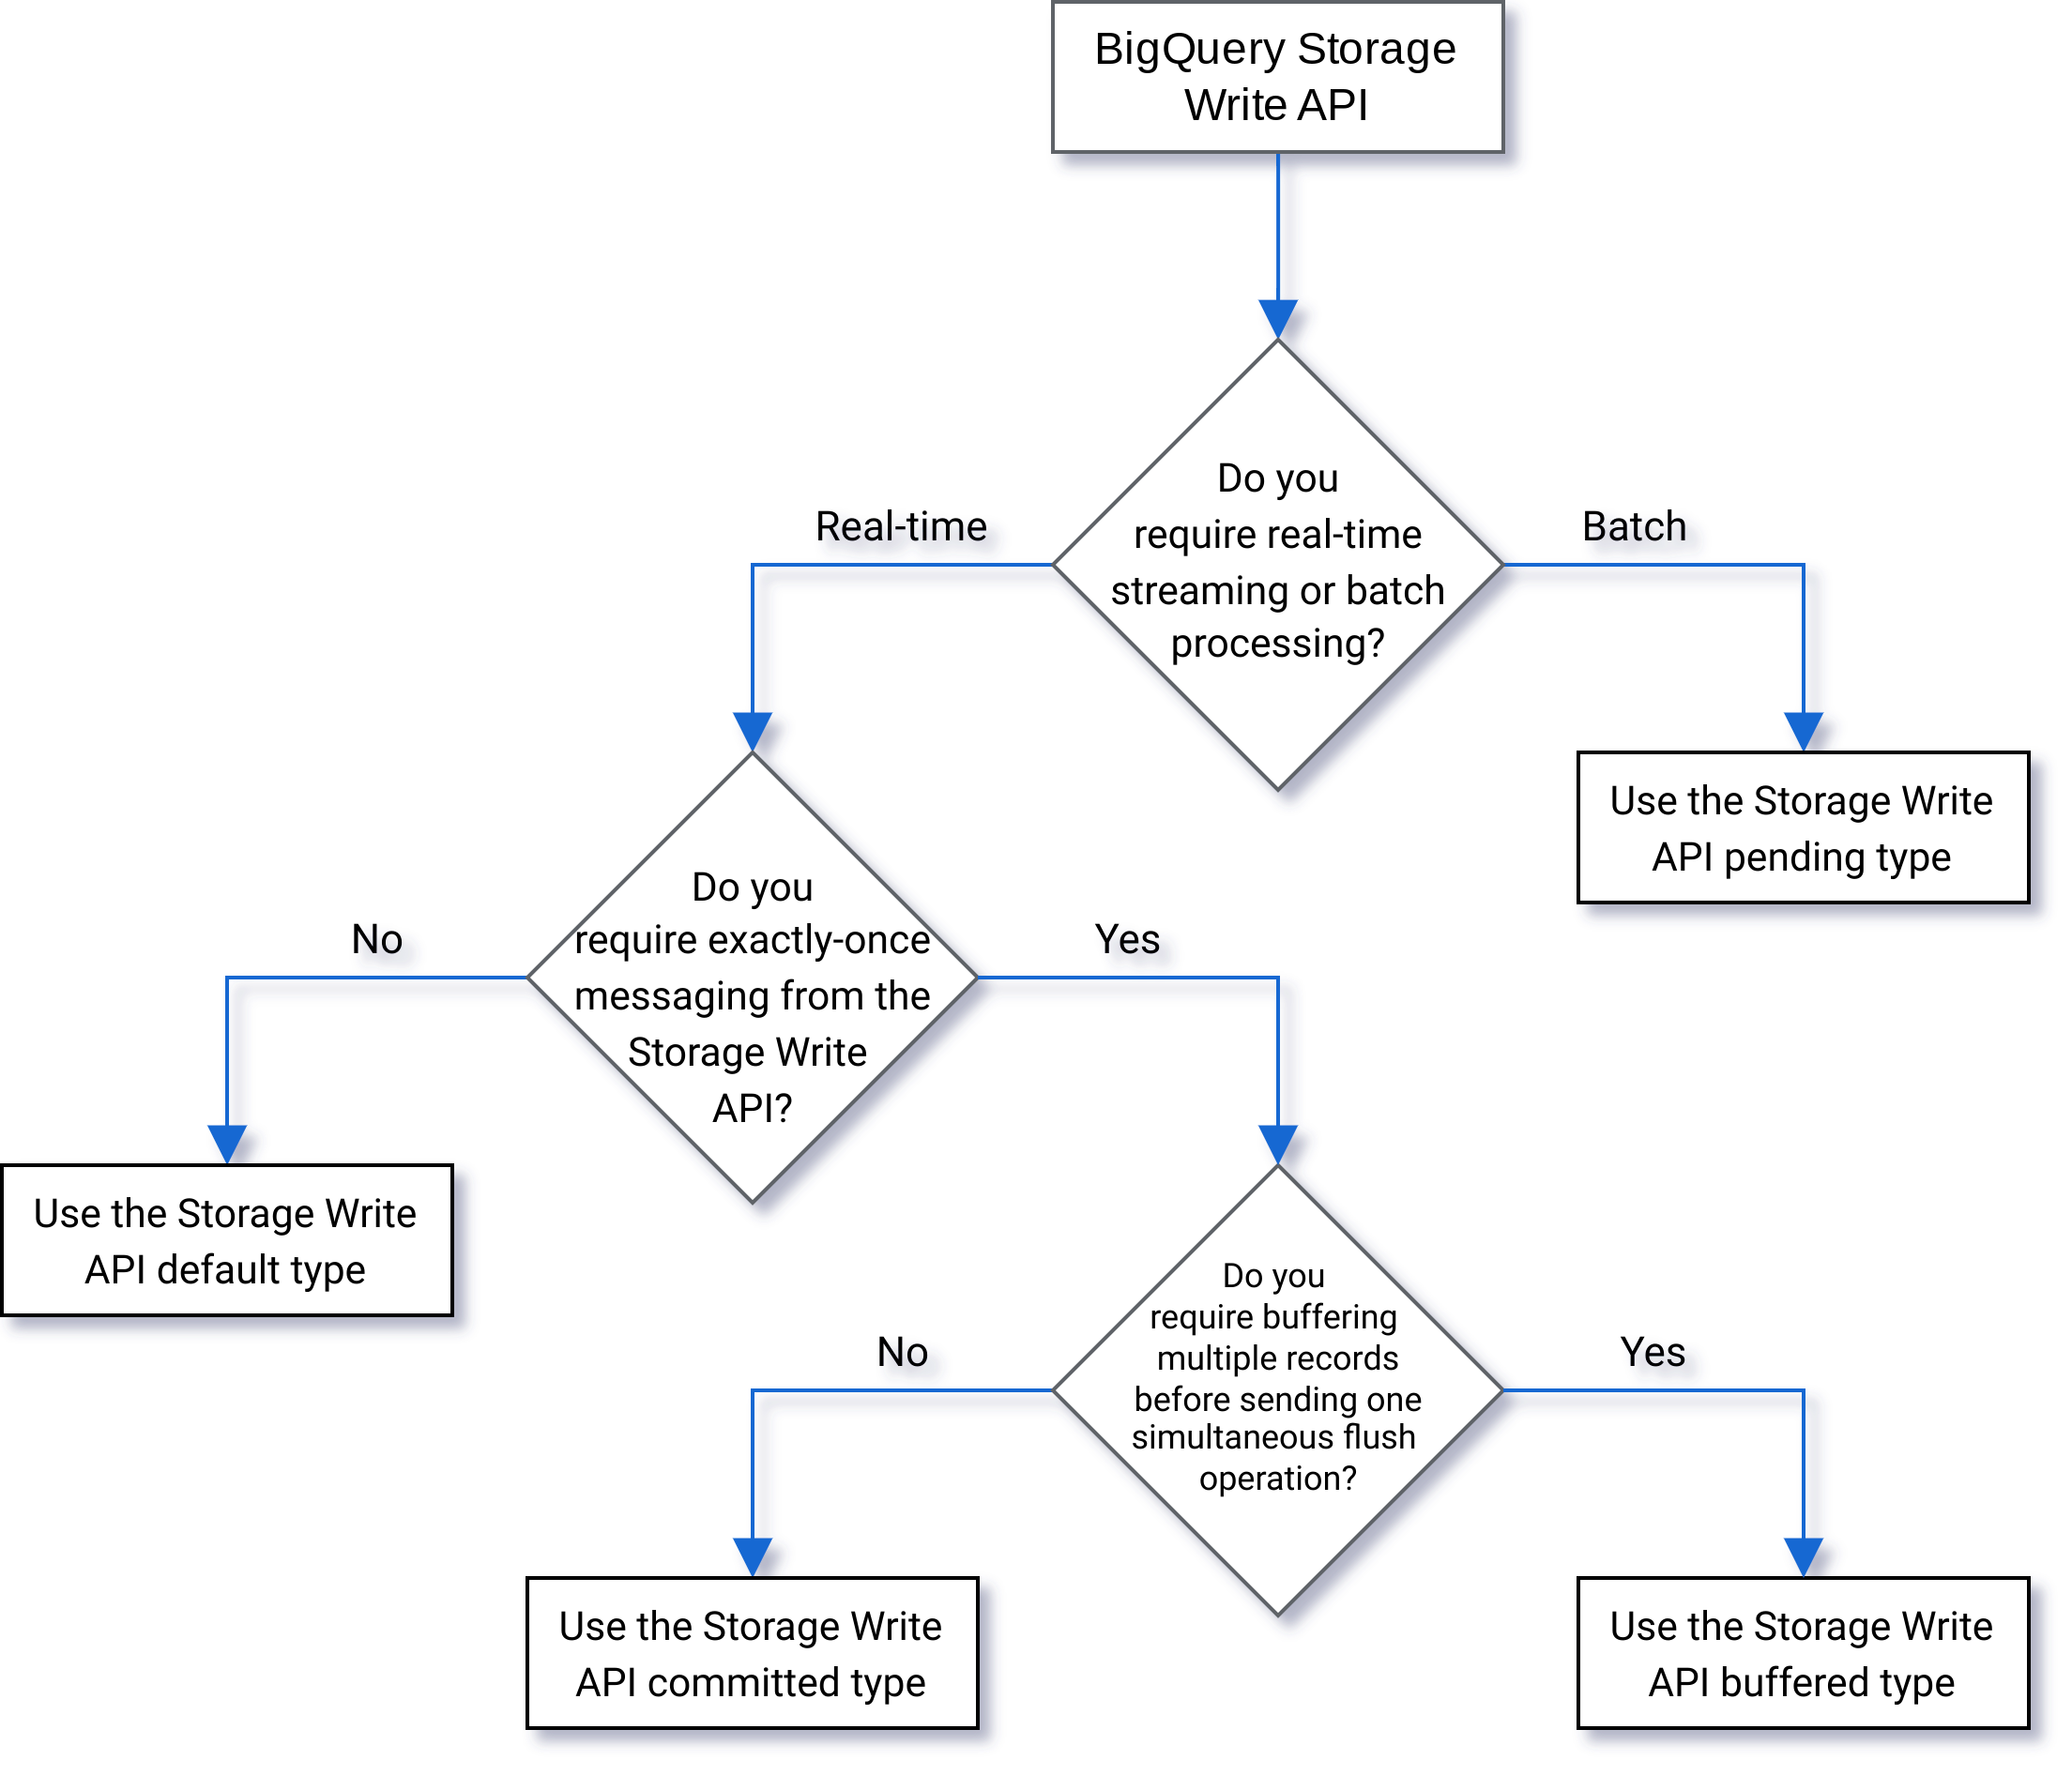
בחירת סוג
אתם יכולים להיעזר בתרשים הזרימה הבא כדי להחליט איזה סוג הכי מתאים לעומס העבודה שלכם:
פרטי ה-API
כשמשתמשים ב-Storage Write API, חשוב להביא בחשבון את הנקודות הבאות:
AppendRows
השיטה AppendRows מוסיפה רשומה אחת או יותר ל-stream. הקריאה הראשונה ל-AppendRows חייבת להכיל שם של מקור נתונים יחד עם סכימת הנתונים, שצוינה בתור DescriptorProto. לחלופין, אתם יכולים להוסיף סכימת Arrow שעברה סריאליזציה בקריאה הראשונה ל-AppendRows אם אתם מטמיעים נתונים בפורמט Apache Arrow. מומלץ לשלוח קבוצה של שורות בכל קריאה ל-AppendRows. אל תשלחו שורה אחת בכל פעם.
טיפול במאגר אחסון לפרוטוקולים
מאגרי אחסון לפרוטוקולים מספקים מנגנון ניטרלי מבחינת שפה ופלטפורמה, שניתן להרחבה, לסריאליזציה של נתונים מובְנים באופן שתואם לדורות קודמים ולדורות הבאים. היתרון שלהם הוא שהם מספקים אחסון נתונים קומפקטי עם ניתוח מהיר ויעיל. מידע נוסף על מאגרי אחסון לפרוטוקולים זמין בסקירה הכללית על מאגרי אחסון לפרוטוקולים.
אם אתם מתכוונים להשתמש ב-API ישירות עם הודעה מוגדרת מראש של מאגר אחסון לפרוטוקולים, ההודעה לא יכולה להשתמש במפרט package, וכל הסוגים המקוננים או סוגי הטיפוסים המוגדרים על ידי המשתמש צריכים להיות מוגדרים בהודעת הבסיס ברמה העליונה.
אסור להשתמש בהפניות להודעות חיצוניות. לדוגמה, ראו sample_data.proto.
הלקוחות של Java ו-Go תומכים במאגרי אחסון לפרוטוקולים שרירותיים, כי ספריית הלקוח מנרמלת את הסכימה של מאגר האחסון לפרוטוקולים.
טיפול ב-Apache Arrow
Apache Arrow הוא פורמט אוניברסלי של עמודות וארגז כלים רב-לשוני לעיבוד נתונים. Apache Arrow מספק פורמט זיכרון מבוסס-עמודות שלא תלוי בשפה, לנתונים שטוחים והיררכיים, שמאורגנים לפעולות ניתוח יעילות בחומרה מודרנית. Storage Write API (gRPC) תומך בהטמעת Arrow באמצעות סכימה ונתונים של Arrow שעברו סריאליזציה במחלקה AppendRowsRequest.
ספריות הלקוח של Python, Java ו-Rust כוללות תמיכה מובנית בהטמעת Apache Arrow.
FinalizeWriteStream
ה-method FinalizeWriteStream מסיימת את ה-stream כך שלא ניתן להוסיף לו נתונים חדשים. השיטה הזו נדרשת בסוג Pending והיא אופציונלית בסוגים Committed ו-Buffered. השיטה הזו לא נתמכת בשידור ברירת המחדל.
טיפול בשגיאות
אם מתרחשת שגיאה, הערך המוחזר של google.rpc.Status יכול לכלול StorageError בפרטי השגיאה. כדי למצוא את סוג השגיאה הספציפי, עיינו בStorageErrorCode. מידע נוסף על מודל השגיאות של Google API זמין במאמר שגיאות.
חיבורים
Storage Write API (gRPC) הוא ממשק API של gRPC שמשתמש בחיבורים דו-כיווניים. ה-method AppendRows יוצרת חיבור לסטרימינג. אפשר לפתוח כמה חיבורים בסטרימינג שמוגדר כברירת מחדל. פעולות ה-append האלה הן אסינכרוניות, מה שמאפשר לשלוח סדרה של פעולות כתיבה בו-זמנית. הודעות התגובה בכל חיבור דו-כיווני מגיעות באותו סדר שבו נשלחו הבקשות.
לסטרימינג שנוצר על ידי אפליקציה יכול להיות רק חיבור פעיל אחד. מומלץ להגביל את מספר החיבורים הפעילים ולהשתמש בחיבור אחד לכמה שיותר כתיבות נתונים. כשמשתמשים בזרם ברירת המחדל ב-Java, ב-Go או ב-Rust, אפשר להשתמש בריבוב של Storage Write API (gRPC) כדי לכתוב לכמה טבלאות יעד עם חיבורים משותפים.
בדרך כלל, חיבור יחיד תומך בנפח תעבורת נתונים של לפחות 1MBps. הגבול העליון תלוי בכמה גורמים, כמו רוחב הפס של הרשת, הסכימה של הנתונים והעומס על השרת. כשחיבור מגיע למגבלת הקיבולת, יכול להיות שבקשות נכנסות יידחו או יועברו לתור עד שמספר הבקשות הפעילות יירד. אם אתם צריכים קצב העברת נתונים גבוה יותר, צרו עוד חיבורים.
BigQuery סוגר את חיבור ה-gRPC אם החיבור נשאר במצב של חוסר פעילות במשך זמן רב מדי. במקרה כזה, קוד התגובה הוא HTTP 409. החיבור ל-gRPC יכול להיסגר גם במקרה של הפעלה מחדש של השרת או מסיבות אחרות. אם יש שגיאת חיבור, צריך ליצור חיבור חדש. ספריות הלקוח של Java, Go ו-Rust מתחברות מחדש באופן אוטומטי אם החיבור נסגר.
תמיכה בספריית הלקוח
ספריות הלקוח של Storage Write API (gRPC) קיימות בכמה שפות תכנות, וחושפות את המבנים הבסיסיים של ה-API שמבוסס על gRPC. ה-API הזה משתמש בתכונות מתקדמות כמו סטרימינג דו-כיווני, ויכול להיות שתידרש עבודת פיתוח נוספת כדי לתמוך בו. לשם כך, יש כמה הפשטות ברמה גבוהה יותר שזמינות ל-API הזה, שמפשטות את האינטראקציות האלה ומפחיתות את החששות של המפתחים. מומלץ להשתמש בהפשטות האחרות האלה של הספרייה כשאפשר.
בקטע הזה מפורט מידע נוסף על שפות וספריות שבהן המפתחים קיבלו יכולות נוספות מעבר ל-API שנוצר.
כל דוגמאות הקוד של BigQuery, כולל דוגמאות קוד שקשורות ל-Storage Write API (gRPC).
לקוח Java
ספריית הלקוח של Java מספקת שני אובייקטים של כותבים:
StreamWriter: מקבל נתונים בפורמט של מאגר אחסון לפרוטוקולים.
JsonStreamWriter: מקבל נתונים בפורמט JSON וממיר אותם למאגרי אחסון לפרוטוקולים לפני השליחה שלהם.JsonStreamWriterתומך גם בעדכוני סכימה אוטומטיים. אם סכימת הטבלה משתנה, הכותב מתחבר מחדש באופן אוטומטי לסכימה החדשה, וכך הלקוח יכול לשלוח נתונים באמצעות הסכימה החדשה.
מודל התכנות דומה בשני הכותבים. ההבדל העיקרי הוא בפורמט של המטען הייעודי (payload).
האובייקט writer מנהל חיבור של Storage Write API (gRPC). האובייקט writer מנקה בקשות באופן אוטומטי, מוסיף לבקשות את כותרות הניתוב האזורי ומתחבר מחדש אחרי שגיאות בחיבור. אם אתם משתמשים ישירות ב-gRPC API, אתם צריכים לטפל בפרטים האלה.
אתם יכולים גם להשתמש בפורמט ההטמעה של Apache Arrow כפרוטוקול חלופי להטמעת נתונים באמצעות Storage Write API (gRPC). מידע נוסף זמין במאמר שימוש בפורמט Apache Arrow להטמעת נתונים.
לקוח Go
הלקוח של Go משתמש בארכיטקטורת לקוח-שרת כדי לקודד הודעות בפורמט של מאגר אחסון לפרוטוקולים באמצעות proto2. במסמכי התיעוד של Go מוסבר איך להשתמש בלקוח Go, כולל דוגמאות קוד.
לקוח Python
לקוח Python הוא לקוח ברמה נמוכה יותר שעוטף את gRPC API. כדי להשתמש בלקוח הזה, צריך לשלוח את הנתונים כמאגרי אחסון לפרוטוקולים, בהתאם לתהליך ה-API של הסוג שציינתם.
אל תשתמשו ביצירת הודעות פרוטו דינמיות ב-Python, כי הביצועים של הספרייה הזו לא מספיק טובים.
במדריך הזה מוסבר איך משתמשים במאגרי אחסון לפרוטוקולים ב-Python.
אתם יכולים גם להשתמש בפורמט הטמעת הנתונים Apache Arrow כפרוטוקול חלופי להטמעת נתונים באמצעות Storage Write API. מידע נוסף זמין במאמר שימוש בפורמט Apache Arrow להטמעת נתונים.
לקוח NodeJS
ספריית הלקוח של NodeJS מקבלת קלט בפורמט JSON ומספקת תמיכה בחיבור מחדש באופן אוטומטי. במאמרי העזרה מוסבר איך להשתמש בלקוח.
לקוח Rust
ספריית הלקוח של Rust מספקת לקוח Write ואובייקטים של כותבים עם סוגים לכל סוג של סטרימינג (DefaultWriter, CommittedWriter, PendingWriter ו-BufferedWriter). הכותבים מקבלים נתונים בפורמט Apache Arrow ומנהלים באופן אוטומטי את החיבורים ל-Storage Write API (gRPC), את כותרות הניתוב, את הניסיונות החוזרים ואת החיבורים מחדש אחרי שגיאות בחיבור. כדי להטמיע נתוני JSON, אתם יכולים להמיר רשומות JSON לקבוצות של רשומות Apache Arrow באמצעות ה-crate arrow-json.
במסמכי התיעוד של Rust מוסבר איך משתמשים בלקוח Rust, ובמאמר הטמעת נתונים בפורמט Apache Arrow יש דוגמאות לקוד.
מה עושים אם הכינוי לא זמין
ניסיון חוזר עם השהיה מעריכית לפני ניסיון חוזר (exponential backoff) יכול לצמצם שגיאות אקראיות ותקופות קצרות של חוסר זמינות של השירות, אבל כדי להימנע מהשמטת שורות במהלך תקופות ארוכות של חוסר זמינות, צריך להשקיע יותר מחשבה. במיוחד אם לקוח לא מצליח להוסיף שורה באופן עקבי, מה הוא צריך לעשות?
התשובה תלויה בדרישות שלכם. לדוגמה, אם משתמשים ב-BigQuery לניתוח תפעולי, שבו אפשר לקבל כמה שורות חסרות, הלקוח יכול לוותר אחרי כמה ניסיונות חוזרים ולמחוק את הנתונים. לעומת זאת, אם כל שורה חיונית לעסק, כמו בנתונים פיננסיים, צריך אסטרטגיה לשמירת הנתונים עד שיהיה אפשר להוסיף אותם מאוחר יותר.
דרך נפוצה אחת להתמודד עם שגיאות מתמשכות היא לפרסם את השורות בנושא Pub/Sub, כדי להעריך אותן מאוחר יותר ואולי להוסיף אותן. שיטה נפוצה נוספת היא לשמור את הנתונים באופן זמני בצד הלקוח. שתי השיטות יכולות למנוע חסימה של לקוחות, ובו-זמנית להבטיח שכל השורות יוכנסו ברגע שהזמינות תחזור.
העברה בסטרימינג לטבלאות מחולקות למחיצות (Partitions)
Storage Write API (gRPC) תומך בהעברת נתונים בסטרימינג לטבלאות מחולקות למחיצות.
כשהנתונים מועברים בסטרימינג, הם ממוקמים בהתחלה במחיצה __UNPARTITIONED__. אחרי שנאספים מספיק נתונים לא מחולקים למחיצות, המערכת של BigQuery מחלקת מחדש את הנתונים למחיצות וממקמת אותם במחיצה המתאימה.
עם זאת, אין הסכם רמת שירות (SLA) שמגדיר כמה זמן ייקח לנתונים לצאת מהמחיצה של __UNPARTITIONED__.
בטבלאות שמחולקות למחיצות לפי זמן הטמעה ולפי עמודת יחידת זמן, אפשר להחריג נתונים שלא חולקו למחיצות משאילתה על ידי סינון הערכים של NULL מהמחיצה __UNPARTITIONED__ באמצעות אחת מהעמודות המדומות (_PARTITIONTIME או _PARTITIONDATE, בהתאם לסוג הנתונים המועדף).
חלוקה למחיצות לפי זמן הטמעה
כשמעבירים נתונים בסטרימינג לטבלה שמחולקת למחיצות לפי זמני כתיבת הנתונים, ה-Storage Write API (gRPC) מסיק את המחיצה של היעד מהזמן הנוכחי של המערכת ב-UTC.
אם אתם מעבירים נתונים בסטרימינג לטבלה שמחולקת למחיצות לפי יום, אתם יכולים לשנות את הסקת התאריך על ידי הוספת מעצב מחיצה כחלק מהבקשה.
כוללים את ה-decorator בפרמטר tableID. לדוגמה, אפשר להעביר בסטרימינג למחיצה שתואמת לתאריך 2025-06-01 בטבלה table1 באמצעות מעטר המחיצה table1$20250601.
כשמבצעים סטרימינג עם מעטר מחיצה, אפשר להעביר בסטרימינג למחיצות מ-31 ימים בעבר ועד 16 ימים בעתיד. כדי לכתוב למחיצות של תאריכים מחוץ לגבולות האלה, צריך להשתמש במקום זאת במשימת טעינה או במשימת שאילתה, כפי שמתואר בקטע כתיבת נתונים למחיצה ספציפית.
אפשר להשתמש ב-partition decorator רק בטבלאות שמחולקות למחיצות לפי יום, ולא בטבלאות שמחולקות למחיצות לפי שעה, חודש או שנה.
חלוקה למחיצות לפי עמודת יחידת זמן
כשמעבירים נתונים בסטרימינג לטבלה שמחולקת לפי עמודת יחידת זמן, הנתונים ב-BigQuery מועברים באופן אוטומטי למחיצה הנכונה על סמך הערכים של עמודת החלוקה למחיצות DATE, DATETIME או TIMESTAMP שהוגדרה מראש בטבלה. אפשר להעביר נתונים בסטרימינג לטבלה שמחולקת לפי עמודת יחידת זמן, אם הנתונים שאליהם מתייחסת עמודת החלוקה הם בין 10 שנים בעבר לשנה אחת בעתיד.
חלוקה למחיצות לפי טווח של מספרים שלמים
כשמעבירים נתונים בסטרימינג לטבלה מחולקת למחיצות לפי טווח של מספרים שלמים, המערכת של BigQuery ממקמת את הנתונים באופן אוטומטי במחיצה הנכונה, על סמך הערכים של עמודת החלוקה למחיצות INTEGER שהוגדרה מראש בטבלה.
פלאגין הפלט של Fluent Bit Storage Write API (gRPC)
הפלאגין של פלט Fluent Bit Storage Write API (gRPC) מאפשר להטמיע באופן אוטומטי רשומות JSON ב-BigQuery, בלי שתצטרכו לכתוב קוד. כדי להתחיל להעביר נתונים בסטרימינג באמצעות הפלאגין הזה, צריך רק להגדיר פלאגין קלט תואם וקובץ תצורה. Fluent Bit הוא מעבד ומעביר יומנים בקוד פתוח וחוצה-פלטפורמות, שמשתמש בפלאגינים של קלט ופלט כדי לטפל בסוגים שונים של מקורות נתונים וכיורים.
הפלאגין הזה תומך באפשרויות הבאות:
- סמנטיקה של "לפחות פעם אחת" באמצעות סוג ברירת המחדל.
- סמנטיקה של פעם אחת בדיוק באמצעות הסוג המחויב.
- התאמה דינמית של סטרימינג כברירת מחדל, כשמצוין לחץ נגדי.
תמיכה ב-Apache Iceberg
אתם יכולים להשתמש ב-Storage Write API (gRPC) כדי להעביר נתונים בסטרימינג לטבלאות Iceberg. מידע נוסף זמין במאמר טבלאות מנוהלות של Apache Iceberg.
מדדי פרויקט של Storage Write API (gRPC)
כדי לעקוב אחרי הטמעת הנתונים באמצעות Storage Write API (gRPC), אתם יכולים להשתמש בתצוגה INFORMATION_SCHEMA.WRITE_API_TIMELINE או לעיין במדדים שלGoogle Cloud .
שימוש בשפת טיפול בנתונים (DML) עם נתונים שהועברו לאחרונה בסטרימינג
אתם יכולים להשתמש בשפת הטיפול בנתונים (DML), כמו ההצהרות UPDATE, DELETE או MERGE, כדי לשנות שורות שנכתבו לאחרונה בטבלה ב-BigQuery באמצעות BigQuery Storage Write API (gRPC). כתיבות שבוצעו ב-30 הדקות האחרונות נחשבות כתיבות מהזמן האחרון.
במאמר שימוש בשפת טיפול בנתונים (DML) מוסבר איך משתמשים ב-DML כדי לשנות את הנתונים שמועברים בסטרימינג.
מגבלות
- התמיכה בהרצת פקודות DML לשינוי נתונים שהועברו לאחרונה בסטרימינג לא חלה על נתונים שהועברו בסטרימינג באמצעות Storage Write API (REST).
- אי אפשר להריץ פקודות DML לשינוי נתונים בתוך טרנזקציה עם כמה פקודות על נתונים שהועברו בסטרימינג לאחרונה.
שאילתות על נתונים בסטרימינג באמצעות max_staleness
כברירת מחדל, בכל פעם שמריצים שאילתה על טבלה עם נתונים בסטרימינג, BigQuery מחזיר את התוצאות העדכניות ביותר, כולל שורות שהועברו בסטרימינג עד לזמן הרצת השאילתה.
אם תרחיש השימוש שלכם לא דורש עדכניות נתונים בזמן אמת – לדוגמה, במרכזי בקרה או בשאילתות דיווח – אתם יכולים להגדיר את התיישנות הנתונים כדי לצמצם את זמן האחזור של השאילתות ואת העלות שלהן. כדי להגדיר את עדכניות הנתונים, משתמשים באחת מהשיטות הבאות:
- הגדרת עדכניות ברמת הטבלה (CDC או תצוגות מהותיות): מגדירים את האפשרות
max_stalenessבטבלת היעד כדי לאפשר לשאילתות להחזיר תוצאות על סמך תמונות מצב של נתונים אחרונים בתוך מרווח העדכניות. מידע נוסף זמין במאמרים סימון נתונים שהשתנו (CDC) ב-max_stalenessותצוגות מהותיות ב-max_staleness. - שינוי הגדרת העדכניות של שאילתה או סשן: מגדירים את משתנה המערכת
@@max_staleness_overrideבשאילתה עם כמה הצהרות או בסשן כדי לשנות את הגדרת העדכניות באופן דינמי בלי לשנות את ההגדרות ברמת הטבלה, למשלSET @@max_staleness_override = INTERVAL 10 MINUTE;.
מכסות של Storage Write API (gRPC)
במאמר המכסות והמגבלות של BigQuery Storage Write API (gRPC) מפורט מידע נוסף בנושא.
אפשר לעקוב אחרי השימוש במכסות של החיבורים בו-זמנית ושל קצב הנתונים בדף Quotas במסוףGoogle Cloud .
חישוב קצב העברת הנתונים
נניח שהמטרה שלכם היא לאסוף יומנים מ-100 מיליון נקודות קצה, וליצור 1,500 רשומות ביומן לדקה. אחר כך אפשר להעריך את קצב העברת הנתונים באמצעות הנוסחה 100 million * 1,500 / 60 seconds = 2.5 GB per second.
אתם צריכים לוודא מראש שיש לכם מכסה מספיקה כדי לשרת את התפוקה הזו.
התמחור של Storage Write API (gRPC)
למידע על התמחור, ראו תמחור הטמעת נתונים.
תרחיש שימוש לדוגמה
נניח שיש צינור עיבוד נתונים שמעבד נתוני אירועים מיומני נקודות קצה. האירועים נוצרים באופן רציף וצריכים להיות זמינים לשאילתות ב-BigQuery בהקדם האפשרי. עדכניות הנתונים היא קריטית בתרחיש לדוגמה הזה, ולכן Storage Write API (gRPC) הוא האפשרות הטובה ביותר להטמעת נתונים ב-BigQuery. ארכיטקטורה מומלצת כדי לשמור על נקודות הקצה האלה קלות היא לשלוח אירועים ל-Pub/Sub, ומשם הם נצרכים על ידי צינור עיבוד נתונים בסטרימינג של Dataflow שמעביר אותם ישירות ל-BigQuery.
אחד מהחששות העיקריים בנוגע לאמינות בארכיטקטורה הזו הוא איך להתמודד עם כשל בהוספת רשומה ל-BigQuery. אם כל רשומה חשובה ואי אפשר לאבד אותה, צריך להעביר את הנתונים למאגר נתונים זמני לפני שמנסים להוסיף אותם. בארכיטקטורה המומלצת שלמעלה, Pub/Sub יכול לשמש כמאגר זמני (buffer) באמצעות יכולות שמירת ההודעות שלו. צריך להגדיר את צינור עיבוד הנתונים ב-Dataflow כך שינסה שוב להזין את זרם הנתונים ב-BigQuery באמצעות השהיה מעריכית קצרה לפני ניסיון חוזר. אחרי שהקיבולת של Pub/Sub כמאגר נתונים זמני מוצתה, למשל במקרה של חוסר זמינות ממושך של BigQuery או כשל ברשת, צריך לשמור את הנתונים בלקוח, והלקוח צריך מנגנון להמשך הוספת הרשומות שנשמרו ברגע שהזמינות משוחזרת. בפוסט Google Pub/Sub Reliability Guide בבלוג מוסבר איך לטפל במצב כזה.
מקרה כשל נוסף שצריך לטפל בו הוא רשומה פגומה. רשומה פגומה היא רשומה שנדחתה על ידי BigQuery כי היא נכשלה בהוספה עם שגיאה שלא ניתן לנסות שוב, או רשומה שלא נוספה בהצלחה אחרי מספר הניסיונות המקסימלי. כדי להמשיך בבדיקה, שני סוגי הרשומות צריכים להישמר בתור הודעות שלא נמסרו באמצעות צינור עיבוד הנתונים של Dataflow.
אם נדרשת סמנטיקה של פעם אחת בדיוק, יוצרים זרם כתיבה בסוג מחויב, עם היסטים של רשומות שסופקו על ידי הלקוח. כך נמנעות כפילויות, כי פעולת הכתיבה מתבצעת רק אם ערך ההיסט תואם להיסט של פעולת ה-append הבאה. אם לא מציינים היסט, הרשומות מתווספות לסוף הנוכחי של ה-stream, וניסיון חוזר של פעולת append שנכשלה עלול לגרום לכך שהרשומה תופיע יותר מפעם אחת ב-stream.
אם לא נדרשות הבטחות של פעם אחת בדיוק, כתיבה לזרם ברירת המחדל מאפשרת תפוקה גבוהה יותר וגם לא נספרת כחלק ממגבלת המכסה ליצירת זרמי כתיבה.
העריכו את קצב העברת הנתונים ברשת וודאו מראש שיש לכם מכסה מספיקה כדי לשרת את קצב העברת הנתונים.
אם עומס העבודה יוצר או מעבד נתונים בקצב לא אחיד, נסו להחליק את קפיצות העומס בלקוח ולהעביר את הנתונים ל-BigQuery בקצב קבוע. כך תוכלו לפשט את תכנון הקיבולת. אם זה לא אפשרי, ודאו שאתם מוכנים לטפל בשגיאות 429 (משאבים מוצו) אם וכאשר קצב הנתונים חורג מהמכסה במהלך קפיצות קצרות.
דוגמה מפורטת לשימוש ב-Storage Write API (gRPC) מופיעה במאמר העברת נתונים בסטרימינג באמצעות Storage Write API (gRPC).
המאמרים הבאים
- העברת נתונים בסטרימינג באמצעות Storage Write API (gRPC)
- טעינת נתונים באצווה באמצעות Storage Write API (gRPC)
- סוגי נתונים נתמכים של מאגר אחסון לפרוטוקולים ו-Arrow
- שיטות מומלצות ל-Storage Write API (gRPC)