


Ce tutoriel vous explique comment effectuer une recherche par similarité sur des embeddings stockés dans des tables BigQuery à l'aide de la fonction VECTOR_SEARCH et d'un index vectoriel.
La recherche vectorielle est une technique permettant de comparer des objets similaires à l'aide d'embeddings. Elle est utilisée pour alimenter les produits Google, y compris la recherche Google, YouTube et Google Play. Vous pouvez utiliser la recherche vectorielle pour effectuer des recherches sémantiques à grande échelle ou une recherche hybride qui combine une recherche sémantique avec une recherche lexicale (par mot clé). Lorsque vous utilisez des index vectoriels avec la recherche vectorielle, vous pouvez profiter de technologies fondamentales telles que l'indexation de fichiers inversés (IVF) et l'algorithme ScaNN.
La recherche vectorielle repose sur les embeddings. Les embeddings sont des vecteurs numériques de grande dimension qui représentent une entité donnée, comme un exemple de texte ou un fichier audio. Les modèles de machine learning (ML) utilisent des embeddings pour encoder la sémantique concernant ces entités afin de faciliter leur raisonnement et leur comparaison. Par exemple, une opération courante dans les modèles de clustering, de classification et de recommandation consiste à mesurer la distance entre les vecteurs dans un espace d'embedding afin de trouver les éléments les plus sémantiquement similaires.
Objectifs
- Effectuez une recherche de similarité sur les embeddings stockés dans les tables BigQuery à l'aide de la fonction
VECTOR_SEARCH. - Utilisez un index vectoriel pour améliorer les performances de la recherche vectorielle.
- Effectuez une recherche qui utilise un index vectoriel et une recherche qui n'en utilise pas.
- Évaluez le rappel en comparant les résultats des recherches avec un index et des recherches sans index.
Coûts
La fonction VECTOR_SEARCH utilise la tarification du calcul BigQuery.
La recherche de similarité vous est facturée selon la tarification à la demande ou par édition.
- À la demande : vous êtes facturé en fonction du nombre d'octets analysés dans la table de base, l'index et la requête de recherche.
Tarification des éditions : les emplacements nécessaires à l'exécution du job dans votre édition de réservation vous sont facturés. Les calculs de similarité plus volumineux et plus complexes entraînent des frais plus élevés.
Pour en savoir plus, consultez la page relative aux tarifs de BigQuery.
Avant de commencer
-
Dans la console Google Cloud , sur la page de sélection du projet, sélectionnez ou créez un projet Google Cloud .
Rôles requis pour sélectionner ou créer un projet
- Sélectionnez un projet : la sélection d'un projet ne nécessite pas de rôle IAM spécifique. Vous pouvez sélectionner n'importe quel projet pour lequel un rôle vous a été attribué.
-
Créer un projet : pour créer un projet, vous devez disposer du rôle Créateur de projet (
roles/resourcemanager.projectCreator), qui contient l'autorisationresourcemanager.projects.create. Découvrez comment attribuer des rôles.
-
Vérifiez que la facturation est activée pour votre projet Google Cloud .
-
Activez l'API BigQuery si elle ne l'est pas déjà.
Rôles requis pour activer les API
Pour activer les API, vous devez disposer de l'autorisation
serviceusage.services.enable. Si vous avez créé le projet, vous disposez probablement déjà de cette autorisation grâce au rôle Propriétaire (roles/owner). Sinon, vous pouvez obtenir cette autorisation grâce au rôle Administrateur Service Usage (roles/serviceusage.serviceUsageAdmin). Découvrez comment attribuer des rôles.
Rôles requis
Pour obtenir les autorisations nécessaires pour suivre ce tutoriel, demandez à votre administrateur de vous accorder les rôles IAM suivants sur le projet :
-
Créer des ensembles de données, des tables et des index vectoriels : Éditeur de données BigQuery (
roles/bigquery.dataEditor) -
Exécuter des jobs BigQuery : Utilisateur de job BigQuery (
roles/bigquery.jobUser)
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Vous pouvez également obtenir les autorisations requises avec des rôles personnalisés ou d'autres rôles prédéfinis.
Créer un ensemble de données
Pour créer un ensemble de données BigQuery, sélectionnez l'une des options suivantes :
Console
Dans la console Google Cloud , accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Explorateur :
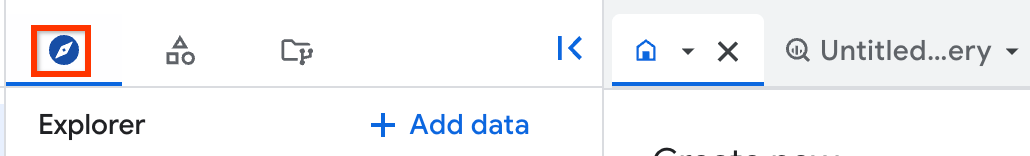
Si le volet de gauche ne s'affiche pas, cliquez sur Développer le volet de gauche pour l'ouvrir.
Dans l'explorateur, développez votre projet, puis cliquez sur Ensembles de données.
Sur la page Ensembles de données, cliquez sur Créer un ensemble de données.
Dans le volet Créer un ensemble de données, procédez comme suit :
Dans le champ ID de l'ensemble de données, saisissez
bqml_tutorial.Pour Emplacement des données, sélectionnez US.
Ne modifiez pas les autres paramètres par défaut.
Cliquez sur Créer un ensemble de données.
bq
Pour créer un ensemble de données, utilisez la commande bq mk --dataset.
Créez un ensemble de données nommé
bqml_tutorialavec l'emplacement des données défini surUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Vérifiez que l'ensemble de données a été créé :
bq ls
API
Appelez la méthode datasets.insert avec une ressource d'ensemble de données définie :
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Créer des tables pour stocker les données et les embeddings
Dans cette section, vous allez créer la table patents contenant les embeddings de brevets. Les embeddings sont basés sur un sous-ensemble de l'ensemble de données public Google Brevets. Vous créez également la table patents2 contenant un embedding de brevet afin de trouver les voisins les plus proches.
Pour créer les tables, procédez comme suit :
Pour créer la table
patents, collez le code suivant dans l'éditeur de requête, puis cliquez sur Exécuter :CREATE TABLE bqml_tutorial.patents AS SELECT * FROM `patents-public-data.google_patents_research.publications` WHERE ARRAY_LENGTH(embedding_v1) > 0 AND publication_number NOT IN ('KR-20180122872-A') LIMIT 1000000;
Vous recevez un message de confirmation semblable à celui-ci :
This statement
created a new table named patents.
Pour créer la table
patents2contenant un embedding de brevet afin de trouver les voisins les plus proches, collez le code suivant dans l'éditeur de requête, puis cliquez sur Exécuter :CREATE TABLE bqml_tutorial.patents2 AS SELECT * FROM `patents-public-data.google_patents_research.publications` WHERE publication_number = 'KR-20180122872-A';
Vous recevez un message de confirmation semblable à celui-ci :
This statement
created a new table named patents2.
Créer un index vectoriel
Lorsque vous utilisez VECTOR_SEARCH avec un index vectoriel, VECTOR_SEARCH utilise la méthode Approximate Nearest Neighbor pour améliorer les performances de la recherche vectorielle, avec le compromis consistant à réduire le rappel et ainsi renvoyer des résultats plus approximatifs. Sans index vectoriel, VECTOR_SEARCH utilise la recherche par force brute pour mesurer la distance de chaque enregistrement.
Dans cette section, vous allez créer l'index vectoriel my_index sur la colonne embedding_v1 de la table patents. Vous vérifiez ensuite que l'index est disponible.
Pour créer l'index vectoriel, procédez comme suit :
Pour créer l'index vectoriel
my_indexsur la colonneembedding_v1de la tablepatents, collez le code suivant dans l'éditeur de requête, puis cliquez sur Exécuter :CREATE OR REPLACE VECTOR INDEX my_index ON bqml_tutorial.patents(embedding_v1) STORING(publication_number, title) OPTIONS(distance_type='COSINE', index_type='IVF');
Vous recevez un message de confirmation semblable à celui-ci :
The vector index
creation on table bqml_tutorial.patents was initiated. Please query
bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES to check the progress
of the index.
Pour confirmer que l'index vectoriel est prêt, collez ce qui suit dans l'éditeur de requête, puis cliquez sur Exécuter :
SELECT * FROM bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES;
Dans les résultats de la requête, vérifiez que
index_statusest défini surACTIVEet que la valeurcoverage_percentageest100. Plusieurs minutes peuvent s'écouler avant quecoverage_percentagen'atteigne100.
Utiliser la fonction VECTOR_SEARCH avec un index
Une fois l'index vectoriel créé et rempli, utilisez la fonction VECTOR_SEARCH pour trouver le voisin le plus proche de l'embedding dans la colonne embedding_v1 de la table patents2. Cette requête utilise l'index vectoriel dans la recherche. Par conséquent, VECTOR_SEARCH utilise une méthode approximative du voisin le plus proche pour trouver le voisin le plus proche de l'embedding.
Pour utiliser la fonction VECTOR_SEARCH avec un index, collez le code suivant dans l'éditeur de requête, puis cliquez sur
Exécuter :
SELECT query.publication_number AS query_publication_number,
  query.title AS query_title,
  base.publication_number AS base_publication_number,
  base.title AS base_title,
  distance
FROM
  VECTOR_SEARCH(
    TABLE bqml_tutorial.patents,
    'embedding_v1',
    TABLE bqml_tutorial.patents2,
    top_k => 5,
    distance_type => 'COSINE',
    options => '{"fraction_lists_to_search": 0.005}');
Les résultats ressemblent à ce qui suit :
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
| query_publication_number |                         query_title                         | base_publication_number |                                                        base_title                                                        |      distance       |
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-106599080-B          | A kind of rapid generation for keeping away big vast transfer figure based on GIS                                        | 0.14471956347590609 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-114118544-A          | Urban waterlogging detection method and device                                                                           | 0.17472108931171348 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | KR-20200048143-A        | Method and system for mornitoring dry stream using unmanned aerial vehicle                                               | 0.17561990745619782 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | KR-101721695-B1         | Urban Climate Impact Assessment method of Reflecting Urban Planning Scenarios and Analysis System using the same         | 0.17696129365559843 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-109000731-B          | The experimental rig and method that research inlet for stom water chocking-up degree influences water discharged amount | 0.17902723269642917 |
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
Utiliser la fonction VECTOR_SEARCH avec la méthode par force brute
Dans cette section, vous allez utiliser la fonction VECTOR_SEARCH pour trouver le voisin le plus proche de l'embedding dans la colonne embedding_v1 de la table patents2.
Cette requête n'utilise pas l'index vectoriel dans la recherche. Par conséquent, VECTOR_SEARCH trouve le voisin le plus proche de l'embedding.
Pour utiliser VECTOR_SEARCH avec la force brute, collez ce qui suit dans l'éditeur de requête, puis cliquez sur
Exécuter :
SELECT query.publication_number AS query_publication_number,
  query.title AS query_title,
  base.publication_number AS base_publication_number,
  base.title AS base_title,
  distance
FROM
  VECTOR_SEARCH(
    TABLE bqml_tutorial.patents,
    'embedding_v1',
    TABLE bqml_tutorial.patents2,
    top_k => 5,
    distance_type => 'COSINE',
    options => '{"use_brute_force":true}');
Les résultats ressemblent à ce qui suit :
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
| query_publication_number |                         query_title                         | base_publication_number |                                                        base_title                                                        |      distance       |
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-106599080-B          | A kind of rapid generation for keeping away big vast transfer figure based on GIS                                        |  0.1447195634759062 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-114118544-A          | Urban waterlogging detection method and device                                                                           |  0.1747210893117136 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | KR-20200048143-A        | Method and system for mornitoring dry stream using unmanned aerial vehicle                                               | 0.17561990745619782 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | KR-101721695-B1         | Urban Climate Impact Assessment method of Reflecting Urban Planning Scenarios and Analysis System using the same         | 0.17696129365559843 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-109000731-B          | The experimental rig and method that research inlet for stom water chocking-up degree influences water discharged amount | 0.17902723269642928 |
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
Évaluer le rappel
Lorsque vous effectuez une recherche vectorielle avec un index, celle-ci renvoie des résultats approximatifs, mais réduit le rappel. Vous pouvez calculer le rappel en comparant les résultats renvoyés par la recherche vectorielle avec un index et ceux renvoyés par la recherche vectorielle avec la force brute. La valeur publication_number identifie un brevet de manière unique. Elle est donc utilisée pour la comparaison dans la requête suivante.
Pour évaluer le rappel, collez ce qui suit dans l'éditeur de requête, puis cliquez sur Exécuter :
WITH approx_results AS (
  SELECT query.publication_number AS query_publication_number,
    base.publication_number AS base_publication_number
  FROM
    VECTOR_SEARCH(
      TABLE bqml_tutorial.patents,
      'embedding_v1',
      TABLE bqml_tutorial.patents2,
      top_k => 5,
      distance_type => 'COSINE',
      options => '{"fraction_lists_to_search": 0.005}')
),
  exact_results AS (
  SELECT query.publication_number AS query_publication_number,
    base.publication_number AS base_publication_number
  FROM
    VECTOR_SEARCH(
      TABLE bqml_tutorial.patents,
      'embedding_v1',
      TABLE bqml_tutorial.patents2,
      top_k => 5,
      distance_type => 'COSINE',
      options => '{"use_brute_force":true}')
)

SELECT
  a.query_publication_number,
  SUM(CASE WHEN a.base_publication_number = e.base_publication_number THEN 1 ELSE 0 END) / 5 AS recall
FROM exact_results e LEFT JOIN approx_results a
  ON e.query_publication_number = a.query_publication_number
GROUP BY a.query_publication_number;
Les résultats se présentent comme suit :
+--------------------------+--------+
| query_publication_number | recall |
+--------------------------+--------+
| KR-20180122872-A         |    1.0 |
+--------------------------+--------+
Si le rappel est inférieur à ce que vous souhaitez, vous pouvez augmenter la valeur fraction_lists_to_search, mais vous risquez de rencontrer une latence et une utilisation des ressources potentiellement plus élevées. Pour ajuster votre recherche vectorielle, vous pouvez essayer plusieurs exécutions de VECTOR_SEARCH avec différentes valeurs d'arguments, enregistrer les résultats dans des tableaux, puis les comparer.
Effectuer un nettoyage
Pour éviter que les ressources utilisées lors de ce tutoriel soient facturées sur votre compte Google Cloud, supprimez le projet contenant les ressources, ou conservez le projet et supprimez les ressources individuelles.
- Dans la console Google Cloud , accédez à la page Gérer les ressources.
- Dans la liste des projets, sélectionnez le projet que vous souhaitez supprimer, puis cliquez sur Supprimer.
- Dans la boîte de dialogue, saisissez l'ID du projet, puis cliquez sur Arrêter pour supprimer le projet.
Vous pouvez également conserver le projet et supprimer les ressources utilisées dans ce tutoriel en procédant comme suit :
Accédez à la page BigQuery.
Dans le volet de gauche, développez votre projet, puis cliquez sur Ensembles de données.
Pour l'ensemble de données
bqml_tutorial, cliquez sur Ouvrir les actions > Supprimer.Dans la boîte de dialogue Supprimer l'ensemble de données, cliquez sur Supprimer pour confirmer l'opération.