


In dieser Anleitung wird gezeigt, wie Sie mit der Funktion VECTOR_SEARCH und einem Vektorindex eine Ähnlichkeitssuche für in BigQuery-Tabellen gespeicherte Einbettungen durchführen.
Die Vektorsuche ist eine Technik zum Vergleichen ähnlicher Objekte mithilfe von Einbettungen. Sie wird in Google-Produkten wie der Google Suche, YouTube und Google Play eingesetzt. Sie können die Vektorsuche verwenden, um semantische Suchen im großen Maßstab durchzuführen, oder eine Hybridsuche, die eine semantische Suche mit einer lexikalischen (Keyword-)Suche kombiniert. Wenn Sie Vektorindizes mit der Vektorsuche verwenden, können Sie grundlegende Technologien wie IVF (Inverted File Indexing) und den ScaNN-Algorithmus nutzen.
Die Vektorsuche basiert auf Einbettungen. Einbettungen sind hochdimensionale numerische Vektoren, die eine bestimmte Entität darstellen, z. B. einen Text oder eine Audiodatei. Modelle für maschinelles Lernen (ML) verwenden Einbettungen, um semantische Informationen zu solchen Entitäten zu codieren und so das Vergleichen und die Ableitung von Schlussfolgerungen zu erleichtern. Eine gängige Operation in Clustering-, Klassifizierungs- und Empfehlungsmodellen besteht beispielsweise darin, den Abstand zwischen Vektoren in einem Einbettungsbereich zu messen, um Elemente zu finden, die semantisch am ähnlichsten sind.
Ziele
- Ähnlichkeitssuche für Einbettungen durchführen, die in BigQuery-Tabellen gespeichert sind, indem Sie die Funktion
VECTOR_SEARCHverwenden. - Verwenden Sie einen Vektorindex, um die Leistung der Vektorsuche zu verbessern.
- Führen Sie eine Suche mit einem Vektorindex und eine Suche ohne Index aus.
- Recall bewerten, indem Sie die Ergebnisse von Suchanfragen mit einem Index mit den Ergebnissen von Suchanfragen ohne Index vergleichen.
Kosten
Für die Funktion VECTOR_SEARCH gelten die Preise für BigQuery-Computing.
Die Ähnlichkeitssuche wird Ihnen nach On-Demand- oder Editions-Preisen in Rechnung gestellt.
- On-Demand: Ihnen wird die Anzahl der Byte in Rechnung gestellt, die in der Basistabelle, im Index und in der Suchanfrage gescannt wurden.
Preise für Versionen: Ihnen werden die Slots in Rechnung gestellt, die für die Ausführung des Jobs in Ihrer Reservierungsversion erforderlich sind. Größere, komplexere Ähnlichkeitsberechnungen verursachen höhere Kosten.
Weitere Informationen finden Sie unter BigQuery-Preise.
Hinweis
-
Wählen Sie in der Google Cloud Console auf der Seite für die Projektauswahl ein Google Cloud -Projekt aus oder erstellen Sie eines.
Rollen, die zum Auswählen oder Erstellen eines Projekts erforderlich sind
- Projekt auswählen: Für die Auswahl eines Projekts ist keine bestimmte IAM-Rolle erforderlich. Sie können jedes Projekt auswählen, für das Ihnen eine Rolle zugewiesen wurde.
-
Projekt erstellen: Zum Erstellen eines Projekts benötigen Sie die Rolle „Projektersteller“ (
roles/resourcemanager.projectCreator), die die Berechtigungresourcemanager.projects.createenthält. Weitere Informationen zum Zuweisen von Rollen
-
Prüfen Sie, ob die Abrechnung für Ihr Google Cloud Projekt aktiviert ist.
-
Aktivieren Sie die BigQuery API, falls sie noch nicht aktiviert ist.
Rollen, die zum Aktivieren von APIs erforderlich sind
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Rolle „Inhaber“ (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen
Erforderliche Rollen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen für das Projekt zuzuweisen, damit Sie die nötigen Berechtigungen für diese Anleitung haben:
-
Datasets, Tabellen und Vektorindexe erstellen:
BigQuery-Dateneditor (
roles/bigquery.dataEditor) -
BigQuery-Jobs ausführen:
BigQuery Job User (
roles/bigquery.jobUser)
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Sie können die erforderlichen Berechtigungen auch über benutzerdefinierte Rollen oder andere vordefinierte Rollen erhalten.
Dataset erstellen
Wählen Sie eine der folgenden Optionen aus, um ein BigQuery-Dataset zu erstellen:
Console
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Klicken Sie im linken Bereich auf Explorer:
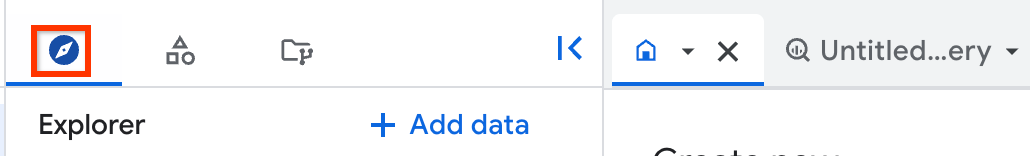
Wenn das linke Steuerfeld nicht angezeigt wird, klicken Sie auf Linkes Steuerfeld maximieren, um es zu öffnen.
Maximieren Sie im Explorer Ihr Projekt und klicken Sie dann auf Datasets.
Klicken Sie auf der Seite Datasets auf Dataset erstellen.
Führen Sie im Bereich Dataset erstellen die folgenden Schritte aus:
Geben Sie unter Dataset-ID
bqml_tutorialein.Wählen Sie unter Speicherort der Daten die Option USA aus.
Übernehmen Sie die anderen Standardeinstellungen.
Klicken Sie auf Dataset erstellen.
bq
Verwenden Sie den Befehl bq mk --dataset, um ein neues Dataset zu erstellen.
Erstellen Sie ein Dataset mit dem Namen
bqml_tutorialund dem DatenspeicherortUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Prüfen Sie, ob das Dataset erstellt wurde:
bq ls
API
Rufen Sie die Methode datasets.insert mit einer definierten Dataset-Ressource auf:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Tabellen zum Speichern von Daten und Einbettungen erstellen
In diesem Abschnitt erstellen Sie die Tabelle patents, die Patent-Embeddings enthält. Die Einbettungen basieren auf einer Teilmenge des öffentlichen Datasets Google Patentsuche. Sie erstellen auch die Tabelle patents2 mit einer Patenteinbettung, um die nächsten Nachbarn zu finden.
So erstellen Sie die Tabellen:
Um die Tabelle
patentszu erstellen, fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:CREATE TABLE bqml_tutorial.patents AS SELECT * FROM `patents-public-data.google_patents_research.publications` WHERE ARRAY_LENGTH(embedding_v1) > 0 AND publication_number NOT IN ('KR-20180122872-A') LIMIT 1000000;
Sie erhalten eine Bestätigungsnachricht wie die folgende:
This statement
created a new table named patents.
Um die Tabelle
patents2mit einer Patenteinbettung zu erstellen, um die nächsten Nachbarn zu finden, fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:CREATE TABLE bqml_tutorial.patents2 AS SELECT * FROM `patents-public-data.google_patents_research.publications` WHERE publication_number = 'KR-20180122872-A';
Sie erhalten eine Bestätigungsnachricht wie die folgende:
This statement
created a new table named patents2.
Vektorindex erstellen
Wenn Sie VECTOR_SEARCH mit einem Vektorindex verwenden, nutzt VECTOR_SEARCH die Methode Annäherung an den nächsten Nachbarn, um die Leistung der Vektorsuchleistung zu verbessern, mit dem Kompromiss: Reduzierung der Trefferquote und damit die Rückgabe von ungefähren Ergebnissen. Ohne Vektorindex verwendet VECTOR_SEARCH die Brute-Force-Suche, um die Distanz für jeden Datensatz zu messen.
In diesem Abschnitt erstellen Sie den Vektorindex my_index für die Spalte embedding_v1 der Tabelle patents. Anschließend prüfen Sie, ob der Index verfügbar ist.
So erstellen Sie den Vektorindex:
Um den Vektorindex
my_indexfür die Spalteembedding_v1der Tabellepatentszu erstellen, fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf Ausführen:CREATE OR REPLACE VECTOR INDEX my_index ON bqml_tutorial.patents(embedding_v1) STORING(publication_number, title) OPTIONS(distance_type='COSINE', index_type='IVF');
Sie erhalten eine Bestätigungsnachricht wie die folgende:
The vector index
creation on table bqml_tutorial.patents was initiated. Please query
bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES to check the progress
of the index.
Um zu prüfen, ob der Vektorindex bereit ist, fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie auf Ausführen:
SELECT * FROM bqml_tutorial.INFORMATION_SCHEMA.VECTOR_INDEXES;
Prüfen Sie in den Abfrageergebnissen, ob
index_statusgleichACTIVEist und der Wertcoverage_percentagegleich100ist. Es kann einige Minuten dauern, biscoverage_percentage100erreicht.
Funktion VECTOR_SEARCH mit einem Index verwenden
Nachdem der Vektorindex erstellt und ausgefüllt wurde, verwenden Sie die Funktion VECTOR_SEARCH, um den nächsten Nachbarn für die Einbettung in der Spalte embedding_v1 der Tabelle patents2 zu finden. Diese Abfrage verwendet den Vektorindex in der Suche. Daher verwendet VECTOR_SEARCH eine Methode Annäherung an den nächsten Nachbarn, um den nächsten Nachbarn der Einbettung zu finden.
Wenn Sie die Funktion VECTOR_SEARCH mit einem Index verwenden möchten, fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie dann auf
Ausführen:
SELECT query.publication_number AS query_publication_number,
  query.title AS query_title,
  base.publication_number AS base_publication_number,
  base.title AS base_title,
  distance
FROM
  VECTOR_SEARCH(
    TABLE bqml_tutorial.patents,
    'embedding_v1',
    TABLE bqml_tutorial.patents2,
    top_k => 5,
    distance_type => 'COSINE',
    options => '{"fraction_lists_to_search": 0.005}');
Die Ergebnisse sehen in etwa so aus:
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
| query_publication_number |                         query_title                         | base_publication_number |                                                        base_title                                                        |      distance       |
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-106599080-B          | A kind of rapid generation for keeping away big vast transfer figure based on GIS                                        | 0.14471956347590609 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-114118544-A          | Urban waterlogging detection method and device                                                                           | 0.17472108931171348 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | KR-20200048143-A        | Method and system for mornitoring dry stream using unmanned aerial vehicle                                               | 0.17561990745619782 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | KR-101721695-B1         | Urban Climate Impact Assessment method of Reflecting Urban Planning Scenarios and Analysis System using the same         | 0.17696129365559843 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-109000731-B          | The experimental rig and method that research inlet for stom water chocking-up degree influences water discharged amount | 0.17902723269642917 |
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
Funktion VECTOR_SEARCH mit Brute-Force verwenden
In diesem Abschnitt verwenden Sie die Funktion VECTOR_SEARCH, um den nächsten Nachbarn für die Einbettung in der Spalte embedding_v1 der Tabelle patents2 zu finden.
Diese Abfrage verwendet den Vektorindex nicht in der Suche, sodass VECTOR_SEARCH den genauen nächsten Nachbarn der Einbettung findet.
Wenn Sie VECTOR_SEARCH mit Brute Force verwenden möchten, fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie auf
Ausführen:
SELECT query.publication_number AS query_publication_number,
  query.title AS query_title,
  base.publication_number AS base_publication_number,
  base.title AS base_title,
  distance
FROM
  VECTOR_SEARCH(
    TABLE bqml_tutorial.patents,
    'embedding_v1',
    TABLE bqml_tutorial.patents2,
    top_k => 5,
    distance_type => 'COSINE',
    options => '{"use_brute_force":true}');
Die Ergebnisse sehen in etwa so aus:
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
| query_publication_number |                         query_title                         | base_publication_number |                                                        base_title                                                        |      distance       |
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-106599080-B          | A kind of rapid generation for keeping away big vast transfer figure based on GIS                                        |  0.1447195634759062 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-114118544-A          | Urban waterlogging detection method and device                                                                           |  0.1747210893117136 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | KR-20200048143-A        | Method and system for mornitoring dry stream using unmanned aerial vehicle                                               | 0.17561990745619782 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | KR-101721695-B1         | Urban Climate Impact Assessment method of Reflecting Urban Planning Scenarios and Analysis System using the same         | 0.17696129365559843 |
| KR-20180122872-A         | Rainwater management system based on rainwater keeping unit | CN-109000731-B          | The experimental rig and method that research inlet for stom water chocking-up degree influences water discharged amount | 0.17902723269642928 |
+--------------------------+-------------------------------------------------------------+-------------------------+--------------------------------------------------------------------------------------------------------------------------+---------------------+
Recall bewerten
Wenn Sie eine Vektorsuche mit einem Index ausführen, werden ungefähre Ergebnisse zurückgegeben, aber die Trefferquote wird reduziert. Zur Berechnung des Recalls können Sie die von der Vektorsuche zurückgegebenen Ergebnisse mit einem Index und die Vektorsuche mit Brute-Force vergleichen. Der Wert publication_number identifiziert ein Patent eindeutig, daher wird er in der folgenden Abfrage zum Vergleich verwendet.
Um den Recall zu bewerten, fügen Sie Folgendes in den Abfrageeditor ein und klicken Sie auf Ausführen:
WITH approx_results AS (
  SELECT query.publication_number AS query_publication_number,
    base.publication_number AS base_publication_number
  FROM
    VECTOR_SEARCH(
      TABLE bqml_tutorial.patents,
      'embedding_v1',
      TABLE bqml_tutorial.patents2,
      top_k => 5,
      distance_type => 'COSINE',
      options => '{"fraction_lists_to_search": 0.005}')
),
  exact_results AS (
  SELECT query.publication_number AS query_publication_number,
    base.publication_number AS base_publication_number
  FROM
    VECTOR_SEARCH(
      TABLE bqml_tutorial.patents,
      'embedding_v1',
      TABLE bqml_tutorial.patents2,
      top_k => 5,
      distance_type => 'COSINE',
      options => '{"use_brute_force":true}')
)

SELECT
  a.query_publication_number,
  SUM(CASE WHEN a.base_publication_number = e.base_publication_number THEN 1 ELSE 0 END) / 5 AS recall
FROM exact_results e LEFT JOIN approx_results a
  ON e.query_publication_number = a.query_publication_number
GROUP BY a.query_publication_number;
Das Ergebnis sieht in etwa so aus:
+--------------------------+--------+
| query_publication_number | recall |
+--------------------------+--------+
| KR-20180122872-A         |    1.0 |
+--------------------------+--------+
Wenn der Recall niedriger als gewünscht ist, können Sie den Wert fraction_lists_to_search erhöhen. Dies kann jedoch zu einer potenziell höheren Latenz und Ressourcennutzung führen. Zur Optimierung Ihrer Vektorsuche können Sie mehrere Ausführungen von VECTOR_SEARCH mit unterschiedlichen Argumentwerten testen, die Ergebnisse in Tabellen speichern und dann die Ergebnisse vergleichen.
Bereinigen
Damit Ihrem Google Cloud-Konto die in dieser Anleitung verwendeten Ressourcen nicht in Rechnung gestellt werden, löschen Sie entweder das Projekt, das die Ressourcen enthält, oder Sie behalten das Projekt und löschen die einzelnen Ressourcen.
- Wechseln Sie in der Google Cloud -Console zur Seite Ressourcen verwalten.
- Wählen Sie in der Projektliste das Projekt aus, das Sie löschen möchten, und klicken Sie dann auf Löschen.
- Geben Sie im Dialogfeld die Projekt-ID ein und klicken Sie auf Shut down (Beenden), um das Projekt zu löschen.
Wenn Sie das Projekt beibehalten und die in dieser Anleitung verwendeten Ressourcen löschen möchten, gehen Sie so vor:
Rufen Sie die Seite BigQuery auf.
Maximieren Sie im linken Bereich Ihr Projekt und klicken Sie dann auf Datasets.
Klicken Sie für das Dataset
bqml_tutorialauf Aktionen öffnen > Löschen.Klicken Sie im Dialogfeld Dataset löschen zur Bestätigung auf Löschen.